Nota do autor: a partir da análise do experimento em que Astra modificou os pesos do Qwen3.5-0.8B, vamos esclarecer a diferença entre “responder errado” e “não terminar a resposta” na avaliação de modelos de raciocínio, além de mostrar como separar os resultados por truncamento.
Em 2 de novembro, quatro pesquisadores do MIT CSAIL publicaram o artigo “Faíscas de programação no espaço de pesos”. Segundo o texto, o GPT-6 Astra alterou apenas cerca de 0,016% dos parâmetros do Qwen3.5-0.8B, e a pontuação no MATH-500 subiu de 7,9% para 48,1%. Os resultados no GSM8K e no IFEval também cresceram bastante, e a notícia logo foi amplamente compartilhada como um marco da “IA modificando o cérebro de outra IA”.
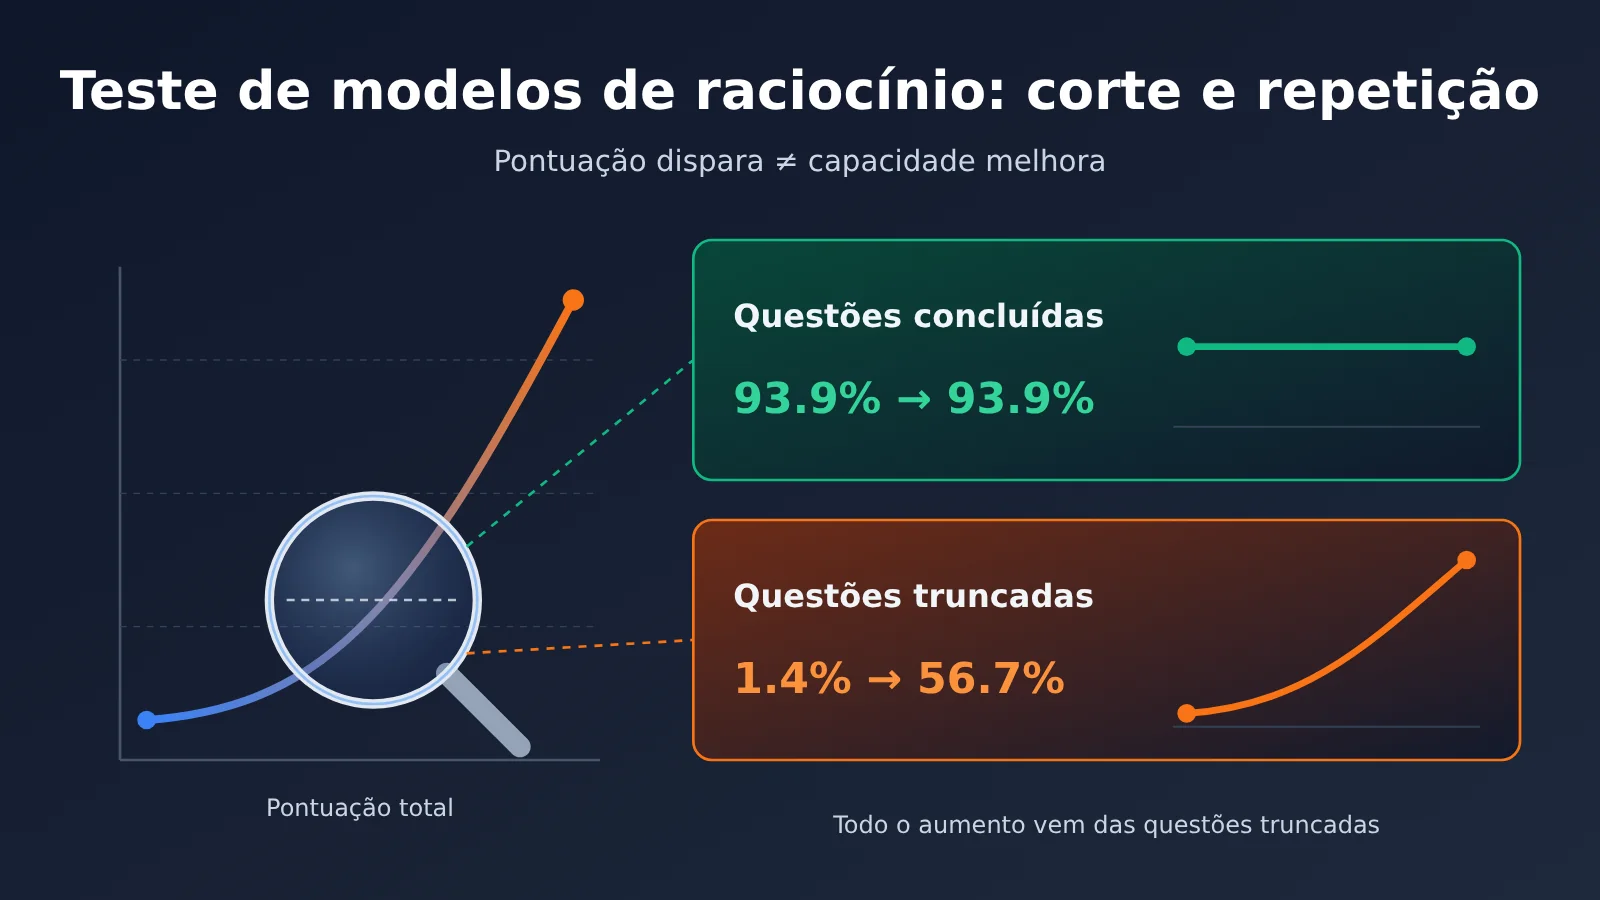
Isso não é uma tentativa de desmerecer a pesquisa. O repositório público do estudo contém registros detalhados de 1.125 invocações. Ao recontar os resultados questão por questão, uma análise da imprensa chegou a uma conclusão mais modesta: quase todo o aumento na pontuação veio do fato de que “o modelo finalmente conseguiu terminar as respostas”, e não de que “o modelo ficou melhor em matemática”.
O valor central: não vamos voltar a discutir se houve RSI. Em vez disso, organizamos essa análise em um método reutilizável para avaliar modelos de raciocínio. A ideia é ajudar você a descobrir, ao escolher um modelo, ajustar seus parâmetros ou colocá-lo em produção, se uma mudança na pontuação reflete uma diferença de capacidade ou um truncamento causado por loops repetitivos.
Resumo dos fatos sobre a avaliação do modelo de raciocínio
Vamos começar pelos principais fatos relacionados à avaliação. Os dados abaixo vêm do blog original e de análises da mídia sobre o repositório público.
| Item | Detalhes |
|---|---|
| Data de publicação | 2 de novembro de 2026, no blog de pesquisadores do MIT CSAIL |
| Modelo modificado | Qwen3.5-0.8B, com alterações em 131,072 pesos, cerca de 0.016% do total |
| Resultados declarados | MATH-500 7.9%→48.1%; GSM8K 13.8%→67.1%; IFEval 21.0%→62.3% |
| Configuração da avaliação | Modo de raciocínio ativado, limite de saída de 32,768 tokens, temperatura 0.6 |
| Resultado de referência | Cerca de 93% das respostas atingiram o limite sem que o modelo parasse |
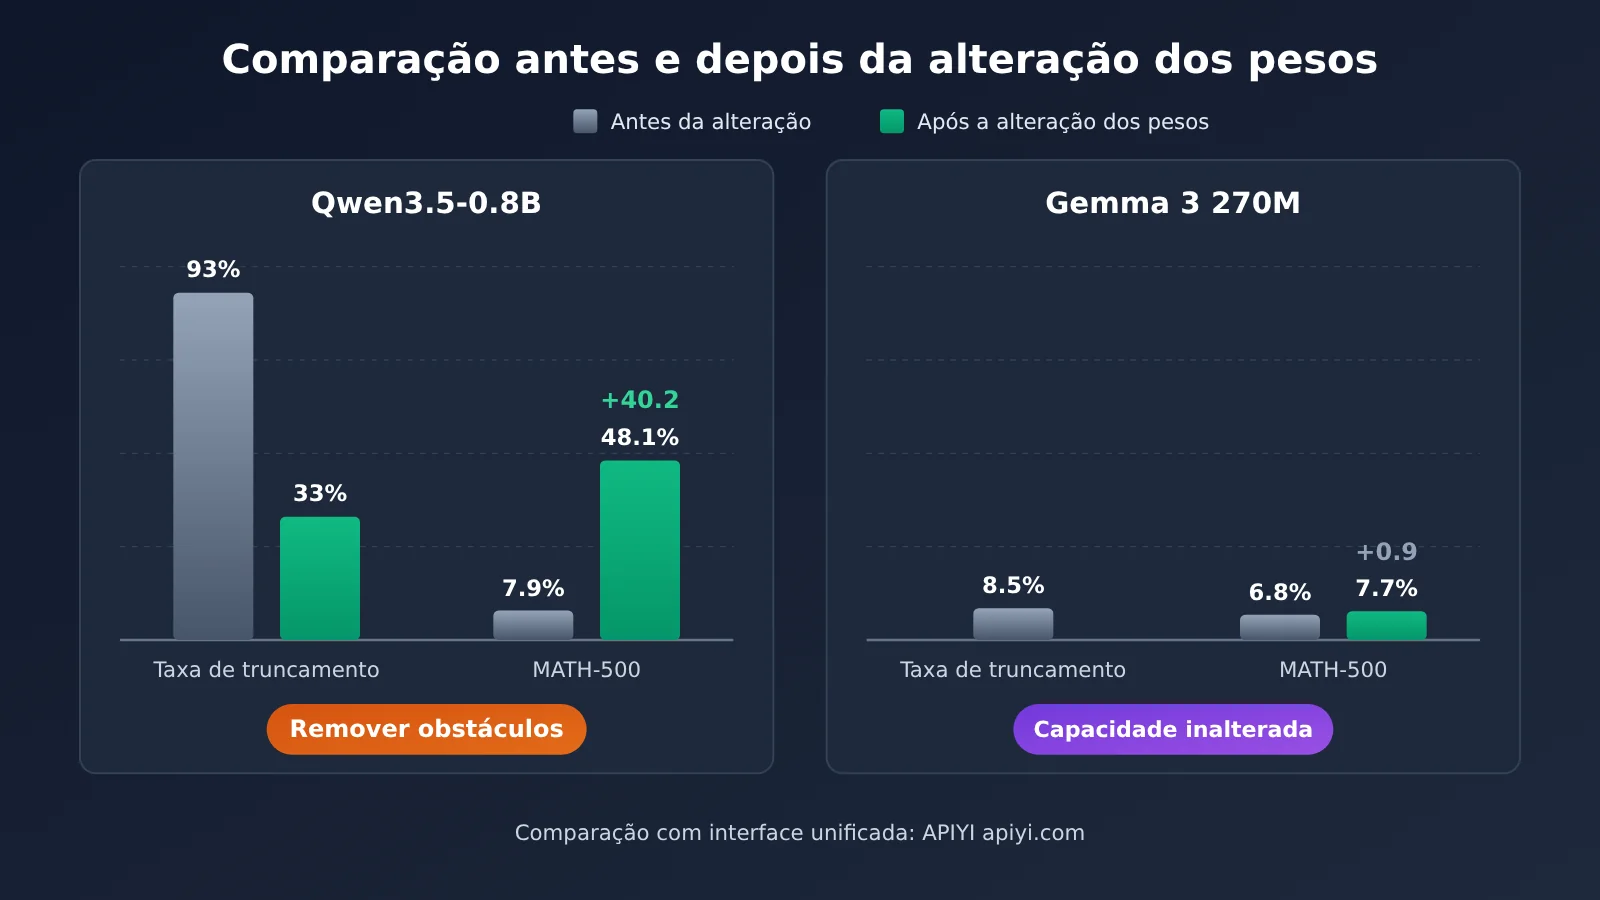
| Resultado após a modificação | A proporção de respostas que atingiram o limite caiu de 93% para 33% |
| Conclusão da análise | O patch corrigiu principalmente ciclos de repetição, sem melhorar a capacidade matemática |
De onde vem o “truncamento” nas avaliações de modelos de raciocínio
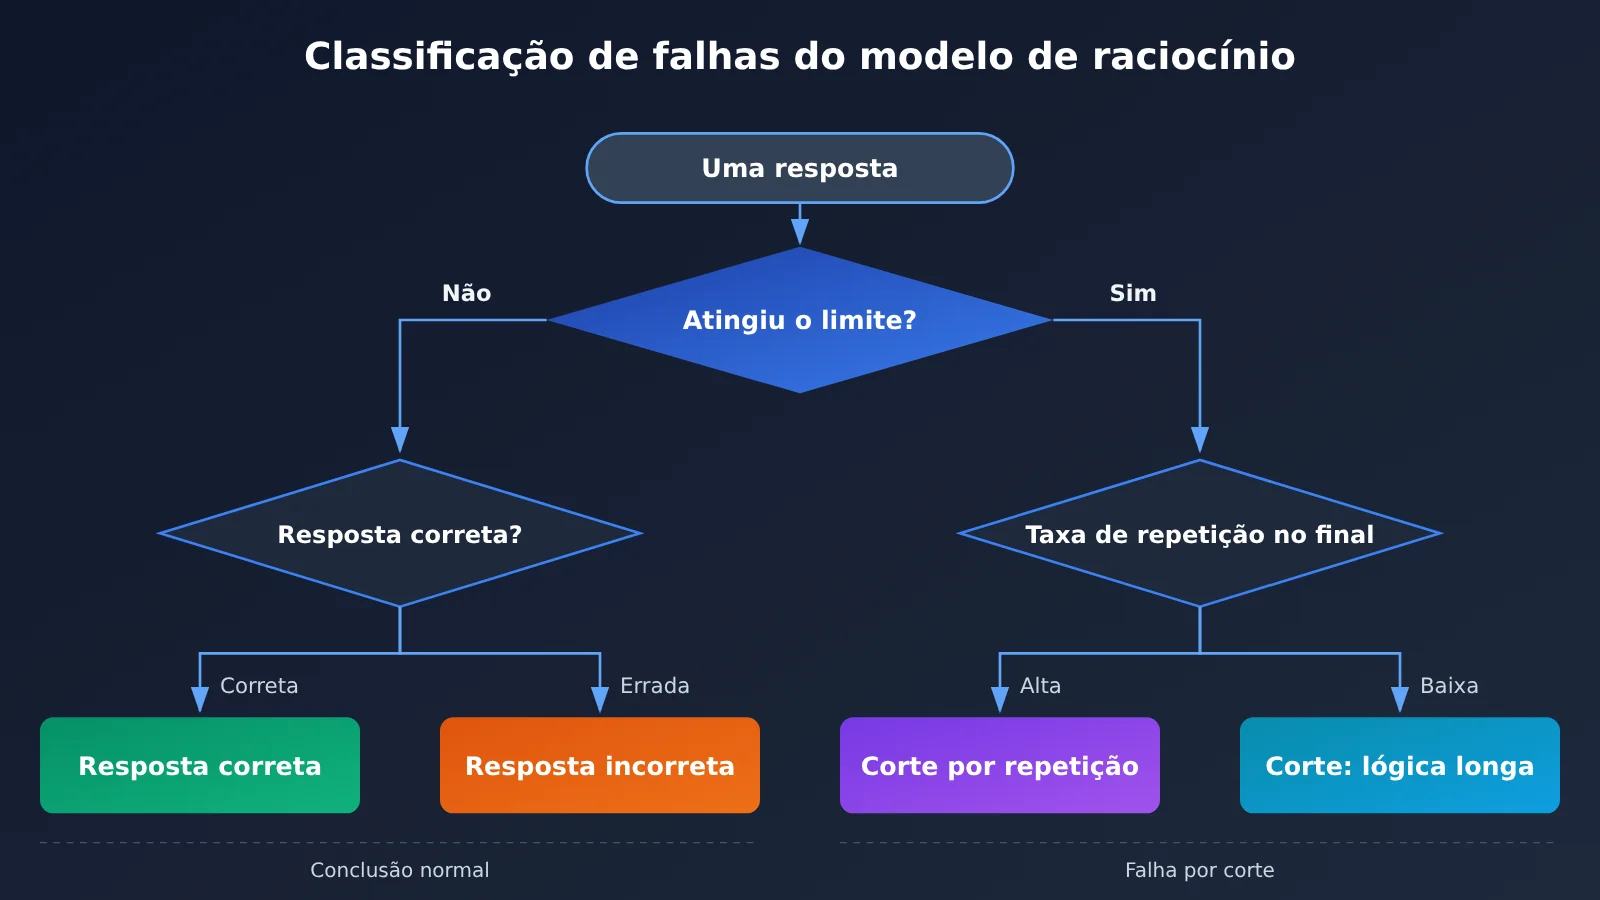
Na primeira vez que Astra colocou o Qwen para resolver 96 exercícios, ele acertou apenas 11. Os outros 85 não foram necessariamente resolvidos de forma errada: em todos eles, o modelo atingiu o limite de comprimento sem parar. Ao analisar o final dos textos truncados em trechos de oito palavras, cerca de 95% do conteúdo era repetitivo. Das 11 questões em que o modelo terminou normalmente, todas foram respondidas corretamente.
Isso indica que a principal causa do baixo resultado de referência era “não conseguir entregar a prova”, e não “não saber resolver”. Vale destacar que, no primeiro comando dado a Astra, os pesquisadores já haviam incluído “ser truncado pelo limite de tokens, muitas vezes por repetir o próprio raciocínio” como um dos tipos de falha, e citaram “corrigir o que causa a repetição” como exemplo de melhoria válida. O relatório final de Astra também deixou claro que o alvo era a repetição, não o conhecimento matemático.
Análise dos dados de avaliação do modelo de raciocínio: todo o ganho veio das questões truncadas
O dado mais convincente da análise vem de um teste pareado, antes e depois da alteração, com 1,152 questões de prática reservadas para avaliação. Ao dividir as questões conforme tenham sido truncadas ou não originalmente, o resultado fica claro.
| Grupo de questões | Quantidade | Taxa de acerto antes | Taxa de acerto depois | Variação |
|---|---|---|---|---|
| Originalmente concluídas | 114 | 93.9% | 93.9% | Sem mudança |
| Originalmente truncadas | 1,038 | 1.4% | 56.7% | Origem de todo o ganho |
| Passaram de erradas a certas | 579 | — | — | Destas, 576 haviam sido truncadas |
| Passaram de certas a erradas | 5 | — | — | Na faixa de ruído |
Outro detalhe fácil de passar despercebido: antes da alteração, apenas 7 questões foram concluídas com resposta errada; depois, esse número subiu para 245. Quando os loops pararam, os erros de cálculo do modelo ficaram visíveis. No MATH-500 oficial, o comprimento médio das respostas caiu de 30,868 para 22,037 tokens. Essa redução também se concentrou nas respostas que antes atingiam o limite.
Validando as conclusões com um modelo de comparação
Os pesquisadores também perceberam isso e fizeram o mesmo experimento com o Gemma 3 270M. A comparação entre os dois testes mostra como “remover um obstáculo” e “aumentar a capacidade” são coisas diferentes.
| Comparação | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| Proporção de respostas que atingiram o limite | Cerca de 93% | Cerca de 8.5% |
| Principal tipo de falha | Loops repetitivos, sem concluir a resposta | Erros aritméticos e etapas de raciocínio inválidas |
| MATH-500 após alteração dos pesos | 7.9%→48.1% | 6.8%→no máximo 7.7% |
| Natureza da melhoria | Removeu um obstáculo que impedia o uso da capacidade existente | Praticamente não acrescentou capacidades que o modelo não tinha |
O próprio post original reconhece: alterar os pesos pode remover um obstáculo que bloqueia uma capacidade, mas não acrescenta capacidades que o modelo não possui. Para quem avalia modelos, a lição é: um mesmo “grande salto na pontuação” pode ter significados completamente diferentes, dependendo da estrutura das falhas.
A armadilha dos parâmetros na avaliação de modelos de raciocínio: temperatura e modo de raciocínio
Há outro ponto dessa controvérsia que costuma passar despercebido: a própria configuração da avaliação pode induzir loops. As informações do cartão oficial do modelo Qwen3.5-0.8B, citadas na análise do caso, diferem das configurações usadas pelos pesquisadores.
| Parâmetro | Orientação do cartão do modelo | Configuração da avaliação | Impacto |
|---|---|---|---|
| Modo de raciocínio | Desativado por padrão no 0.8B | Ativado à força | O modelo pequeno fica mais propenso a entrar em loops de raciocínio |
| Temperatura (tarefas de texto no modo de raciocínio) | Recomendação: 1.0 | 0.6 | No cartão do modelo, 0.6 corresponde a tarefas de análise de imagens e escrita de código |
| Recomendação para lidar com loops | Ajustar os parâmetros de amostragem e interromper a geração a tempo na saída em streaming | Gerar até o limite de 32,768 tokens | Muitas respostas foram classificadas como falhas |
Vale esclarecer que as informações acima sobre o cartão do modelo foram reproduzidas a partir de uma análise da imprensa. Antes de fazer uma avaliação, confira diretamente o cartão oficial do Qwen. O ponto central é metodológico: para um mesmo modelo, basta mudar os parâmetros de amostragem para que a “linha de base” seja completamente diferente. Se essa linha de base foi medida com configurações propensas a loops, qualquer alteração que faça o modelo “conseguir parar” vai parecer um salto de capacidade.
Checklist para avaliar modelos de raciocínio: separe os casos truncados antes de tirar conclusões
As lições desta análise podem ser transformadas em um processo de avaliação aplicável a qualquer modelo de raciocínio. Seja para escolher um modelo, ajustar parâmetros ou validar uma mudança no ajuste fino ou no comando, confira cada item da tabela.
| Item | Como verificar | Sinal para interpretação |
|---|---|---|
| 1. Separar por truncamento | Calcule a proporção de finish_reason == "length" e a taxa de acerto de cada grupo |
Se a taxa de truncamento passar de 10%, as pontuações gerais não podem ser comparadas diretamente |
| 2. Verificar a taxa de repetição | Calcule a repetição de n-gramas no final das respostas truncadas | Uma taxa alta indica um ciclo de repetição, não um raciocínio longo demais |
| 3. Conferir os parâmetros de amostragem | Confira temperatura, top_p e ativação do modo de raciocínio no cartão do modelo | Se forem diferentes das recomendações oficiais, registre isso separadamente |
| 4. Comparar questão por questão | Compare as respostas antes e depois da mudança e conte as que passaram de erradas para certas e de certas para erradas | Se o ganho se concentrar no grupo truncado, trata-se de “remover um obstáculo” |
| 5. Comparar com outro modelo | Inclua um modelo de comparação com baixa taxa de truncamento, usando os mesmos comandos e parâmetros | Se o modelo de comparação não melhorar, isso indica que o ganho não veio de um aumento de capacidade |
🎯 Dica de avaliação: na comparação entre modelos, uma das partes mais trabalhosas é escrever código de invocação separado para cada fornecedor. Com a interface compatível com OpenAI da APIYI, em apiyi.com, você pode invocar modelos populares de vários fornecedores com o mesmo script e o mesmo conjunto de comandos e parâmetros. Assim, fica fácil incluir a “taxa de truncamento” como uma coluna fixa nas estatísticas.
Script de avaliação de modelos de raciocínio: exemplo mínimo
O código abaixo calcula a proporção de questões cujas respostas foram truncadas pelo limite de comprimento. Quando finish_reason é length, significa que a resposta atingiu o limite de max_tokens:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface da APIYI compatível com OpenAI
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # Substitua pelo nome do modelo usado
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
Veja a implementação completa (com taxa de acerto por grupo e taxa de repetição no final)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """Calcula a proporção de n-gramas repetidos no final do texto (para chinês, pode-se dividir por caracteres)"""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)], judge: função que verifica se a resposta está correta"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
Os parâmetros para ativar ou desativar o modo de raciocínio variam entre os modelos: alguns usam um campo na requisição, outros são distinguidos pelo nome do modelo e outros dependem do template do comando. Se o conteúdo do raciocínio conta para max_tokens ou é retornado separadamente também depende do modelo. Antes de avaliar, consulte a documentação de cada um.
🚀 Comece rapidamente: se quiser apenas validar essa forma de separar os resultados, cadastre-se na APIYI apiyi.com e use os créditos gratuitos de teste. Escolha dois ou três modelos de raciocínio, execute algumas dezenas de questões e compare primeiro as taxas de truncamento. Depois, decida se vale ampliar a avaliação.
Análise dos impactos do caso de avaliação de modelos de raciocínio
Impactos para desenvolvedores
- A pontuação geral já não é suficiente: olhar apenas para a taxa geral de acerto mistura respostas incompletas com respostas erradas. Antes do lançamento, o relatório de avaliação deve incluir pelo menos a taxa de truncamento e a taxa de acerto por grupo.
- O ganho com ajustes de parâmetros pode ser mal interpretado: aumentar o limite de saída, ajustar a temperatura ou adicionar uma penalidade por repetição pode melhorar bastante a pontuação. Mas isso é apenas “remover obstáculos”, não significa que o modelo mudou.
- O ambiente de produção também é afetado: o truncamento observado na avaliação pode se manifestar em produção como respostas longas demais, custos fora de controle e usuários esperando. O próprio cartão do modelo recomenda usar saída em streaming com detecção de loops e truncamento antecipado.
Impactos para a pesquisa em avaliação de modelos
- “Grandes melhorias” exigem evidências mais detalhadas: essa análise mostrou que um resultado que parece um salto de capacidade pode ser apenas a correção de um bug, quando os dados são separados por truncamento. Daqui em diante, vale questionar como a taxa de truncamento mudou em qualquer alegação de melhoria em modelos pequenos ou modelos de raciocínio.
- O desenho dos grupos de controle ganha importância: tanto o experimento complementar com o Gemma 3 270M quanto o controle com direção aleatória feito pela própria Astra (cujo resultado variou apenas cerca de 1,5 ponto percentual) mostram que o desenho dos controles é fundamental para distinguir sinais reais de ruído.
Perguntas frequentes (FAQ)
Q1: O que é a “armadilha do truncamento” na avaliação de modelos de raciocínio?
Ela ocorre quando o modelo entra em um ciclo de repetição durante o raciocínio e continua escrevendo até atingir o limite de tokens, sem dar uma resposta. O sistema de avaliação então marca a resposta como incorreta. Nesse caso, a nota baixa indica que o modelo “não terminou”, e não que “não soube resolver”.
Q2: Como distinguir uma nota baixa causada por truncamento de uma causada por falta de capacidade?
Divida as questões em dois grupos, conforme tenham atingido o limite ou não, e calcule a taxa de acerto de cada grupo. Se a taxa for alta nas questões concluídas e próxima de zero nas truncadas, o problema está no ciclo de repetição. Se houver muitos erros mesmo nas questões concluídas, isso indica falta de capacidade. A comparação entre Qwen e Gemma exemplifica esses dois casos.
Q3: Quando foi publicado o experimento em que a Astra modificou o Qwen?
O post original foi publicado em 2 de novembro de 2026, e o artigo da imprensa que revisou o experimento com base nos registros do repositório público saiu em 5 de novembro. Os dados deste artigo seguem essa revisão; para conferir os detalhes do cartão do modelo, consulte o texto oficial da Qwen.
Q4: Para quais cenários esse método de avaliação é adequado?
– **Escolha de modelos**: comparar o desempenho de diferentes modelos de raciocínio em tarefas de matemática ou programação
– **Ajuste de parâmetros**: avaliar o efeito real de mudanças na temperatura, no limite de tokens e na ativação do modo de raciocínio
– **Validação de melhorias**: verificar se o ajuste fino, os comandos ou a edição de pesos trouxeram ganhos de capacidade ou apenas removeram obstáculos
Q5: Como avaliar vários modelos de raciocínio lado a lado usando uma interface unificada?
1. Crie uma conta na APIYI apiyi.com e obtenha uma chave API
2. Defina o base_url do script deste artigo como `https://api.apiyi.com/v1`
3. Mantenha fixos os comandos, a temperatura e max_tokens, altere apenas o nome do modelo e gere a taxa de truncamento e as taxas de acerto por grupo
A forma de ativar o raciocínio varia entre os modelos, então é preciso ajustar os parâmetros da requisição de acordo com a documentação de cada um.
Q6: Quais são as limitações desse método de divisão?
A divisão por truncamento só identifica respostas que “não foram concluídas”; ela não permite saber se uma resposta concluída foi acertada por sorte. O limite de repetição no final da resposta precisa ser ajustado conforme o idioma e a tarefa; para textos em chinês, recomenda-se dividir por caracteres, e não por espaços. Além disso, alguns modelos não retornam o conteúdo completo do raciocínio, por isso é preciso consultar também as estatísticas de tokens em usage. Se o orçamento for limitado, você pode começar com uma amostra pequena na APIYI apiyi.com e ampliar a escala depois de confirmar os critérios de cálculo.
Principais pontos da avaliação de modelos de raciocínio
- Origem do ganho: nas 114 questões que o Qwen respondeu por completo, a taxa de acerto foi de 93,9% antes e depois da alteração; todo o ganho veio das respostas truncadas
- Tipo de falha: 93% das respostas na avaliação de referência atingiram o limite de tokens, e cerca de 95% do trecho final era repetitivo
- Diferença nos parâmetros: a temperatura de 0,6 usada na avaliação não corresponde à temperatura de 1,0 recomendada no model card para textos de raciocínio
- Evidência de controle: o Gemma 3 270M teve uma taxa de truncamento baixa e, após a alteração dos pesos, melhorou menos de 1 ponto percentual no MATH-500
- Método principal: primeiro, separar as respostas truncadas por
finish_reason; depois, comparar as taxas de acerto - Como começar: use a interface unificada da APIYI apiyi.com para medir o truncamento de vários modelos com os mesmos parâmetros
Resumo
A polêmica sobre a “alteração dos pesos do Qwen pela Astra” serve de alerta para quem avalia modelos de raciocínio:
- Detalhe os aumentos expressivos de pontuação: agrupe as respostas conforme tenham ou não atingido o limite de tokens e veja de qual grupo veio o ganho
- Os parâmetros fazem parte da referência: confira a temperatura, a ativação do raciocínio e o limite de saída no model card e registre tudo no relatório
- Diferencie a remoção de obstáculos do aumento de capacidade: use um modelo de controle com baixa taxa de truncamento para verificar a verdadeira natureza da melhoria
Da próxima vez que encontrar a conclusão de que “uma alteração multiplicou o desempenho”, faça primeiro esta pergunta: quanto mudou a taxa de truncamento? Muitas vezes, ela revela mais do que a pontuação geral.
Se você está preparando a avaliação de alguns modelos de raciocínio antes de colocá-los em produção, vale usar a APIYI apiyi.com para medir a taxa de truncamento com os mesmos scripts e parâmetros antes de decidir qual modelo escolher.
📚 Referências
- Análise retrospectiva do Silicon Star Pro (republicada pelo 36氪): O viral “Astra reformula o cérebro do Qwen” tem pouco a ver com a RSI que buscamos
- Link:
36kr.com/p/4056494372181124 -
Descrição: Dados de testes pareados recalculados com base nos registros de cada questão no repositório público; principal fonte dos dados deste artigo
-
Blog de um pesquisador do MIT CSAIL: Sparks of Weight-Space Programming
-
Descrição: Descrição original dos experimentos e tabela de resultados. Vale consultar a configuração do experimento 8 no texto original
-
Cartão oficial do modelo Qwen3.5-0.8B: Parâmetros de amostragem e explicação do modo de raciocínio
- Descrição: Consulte para verificar o estado padrão do modo de raciocínio, a temperatura recomendada e as orientações para lidar com loops
Autor: Equipe técnica da APIYI
Contato técnico: Fale conosco pelo site oficial da APIYI, em apiyi.com. Para mais informações sobre invocação, acesse a documentação em docs.apiyi.com