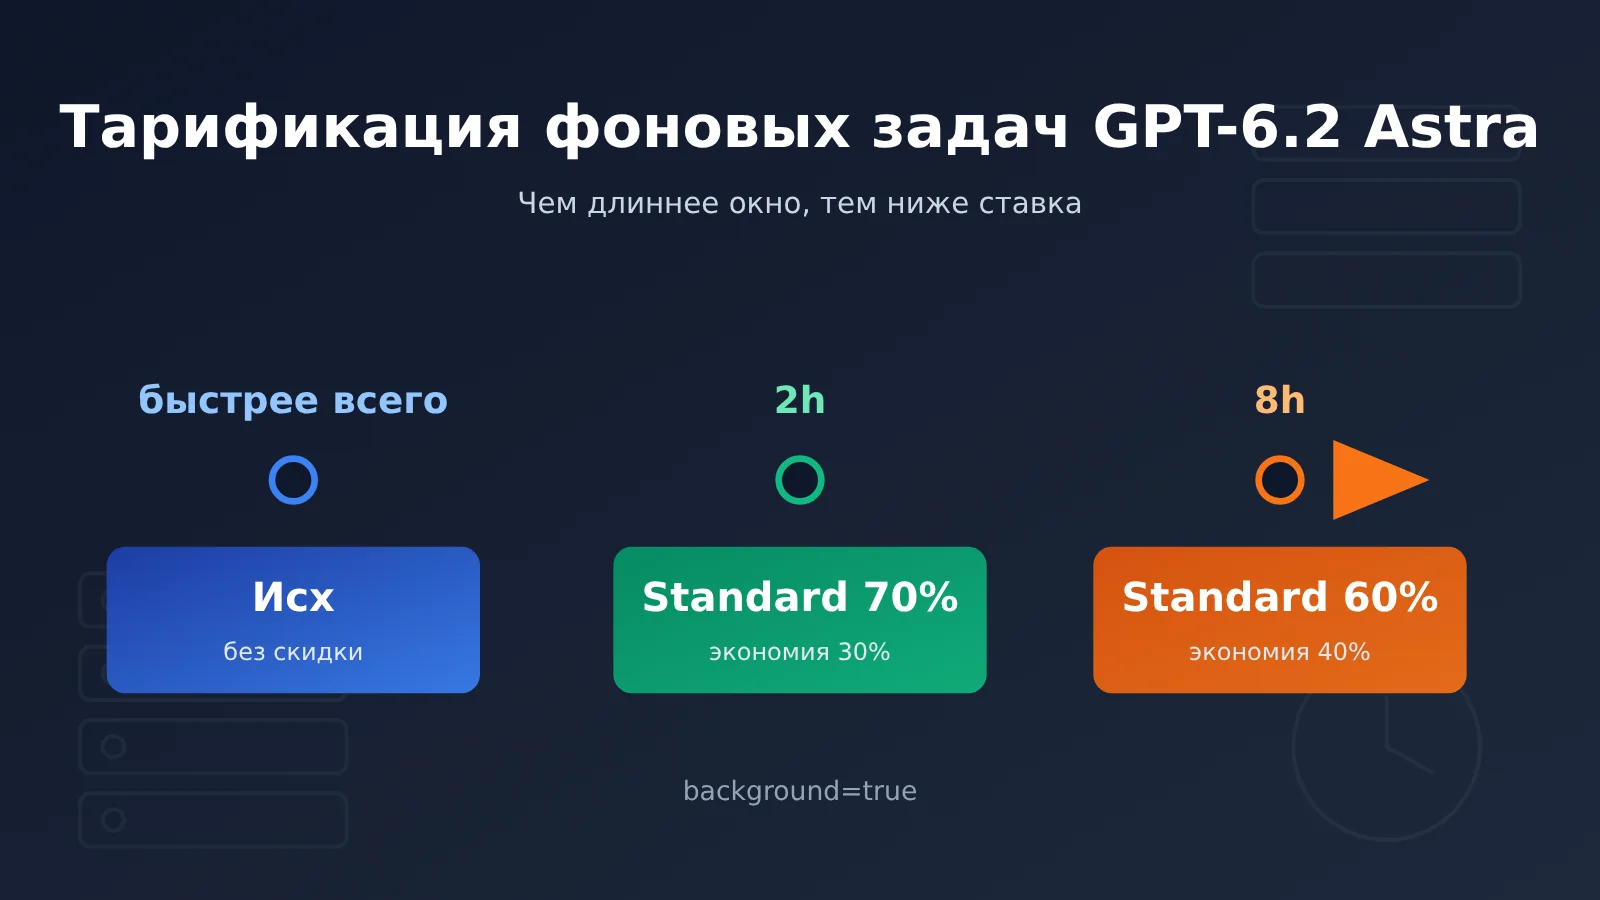
Правило тарификации фоновых задач GPT-6.2 Astra можно свести к одной фразе: если готовы ждать — платите меньше. С 17 ноября 2026 года окно фонового завершения в Responses API выходит в открытую бету. Окно soonest по умолчанию тарифицируется по полной цене используемого уровня обработки. Для запросов, подходящих под условия, окно 2h считается по 70% от ставки за токены модели Standard, а окно 8h — по 60%, то есть скидка составляет 30% и 40% соответственно.
Какое окно выбрать, зависит от двух вопросов: к какому моменту нужен результат и есть ли между запросами зависимость от промежуточных результатов предыдущего шага. Сначала ответьте на эти два вопроса, а уже потом оценивайте расходы по объёму использования — так надёжнее, чем просто сравнивать цены за единицу.
Что вы узнаете из этой статьи?
- Что такое окна завершения soonest, 2h и 8h, с какого момента начинается отсчёт и от какой базы считается цена
- Сколько именно стоит один и тот же объём использования (100 тыс. входных + 10 тыс. выходных токенов) в 7 режимах
- Какие параметры нужно соблюсти, чтобы запрос получил скидку, и каковы ограничения по лимитам очереди и повторному использованию кеша
- Какой способ отправки подходит для интерактивных вопросов-ответов, сводок по тикетам, ночной проверки и независимых задач классификации
Содержание: сначала таблица понятий и краткий обзор влияния, чтобы договориться о терминах. В разделе «Объективные факты» последовательно разберём правила окон завершения, цены по уровням, условия скидки и обработку последующих шагов в многошаговых рабочих процессах. В разделе «Анализ и выводы» обсудим, складываются ли скидки, бюджет времени для многошаговых задач, компромиссы из-за кеша и лимитов очереди, а также дадим рекомендации по выбору окна под конкретную рабочую нагрузку.
GPT-6.2 Astra: биллинг фоновых задач (To Know) — объяснение понятий
| Понятие | Краткое объяснение |
|---|---|
| Standard | Стандартный уровень обработки OpenAI API; скидки для фоновых окон 2 ч и 8 ч рассчитываются на основе его ставки за токены модели |
| Fast | Текущий ускоренный уровень Astra; ставка за токены модели в 2 раза выше, чем в Standard |
| Ultrafast | Ещё более быстрый уровень обработки: в промопериод — в 3 раза выше Standard, затем по прайс-листу — в 6 раз |
| Фоновый режим | Запрос сначала возвращает ID ответа, а приложение позже проверяет статус и забирает результат |
| Окно завершения | Целевой срок выполнения, используемый для планирования после того, как фоновый ответ принят; бывает soonest, 2h и 8h |
| soonest | Окно по умолчанию для фоновых запросов: выполняется как можно скорее, применяется ставка модели того уровня обработки, который используется |
| Batch API | Независимые друг от друга запросы упаковываются в файл JSONL и асинхронно выполняются как одна задача |
| continuation_id | Идентификатор, который приложение задаёт для одного и того же фонового рабочего процесса, чтобы связывать подходящие последующие запросы |
| Ставка за токены модели | Цена за единицу для каждой отдельной метрики: обычный ввод, ввод с попаданием в кэш и вывод |
Краткий обзор: как фоновые задачи GPT-6.2 Astra влияют на тарификацию
- API-разработчики: у асинхронных задач появилось ещё два варианта со скидкой — что-то среднее между вызовами в реальном времени и Batch. Но придётся перевести работу в фоновый режим и организовать опрос статуса (polling) или webhook.
- Продакт-менеджеры: в требованиях нужно явно прописать «к какому моменту результат должен быть доступен максимум». Если функция допускает выдачу результата через 2 или 8 часов, стоимость токенов модели падает на 30% или 40% соответственно.
- Ответственные за затраты и эксплуатацию: 2h, 8h и Batch используют одну общую квоту очереди. Крупные пакетные задания Batch и фоновые задачи со скидкой нужно планировать вместе — оценивать ёмкость для каждого направления отдельно нельзя.
Объективные факты: правила тарификации фоновых задач GPT-6.2 Astra
Какие три окна завершения есть у фоновых задач GPT-6.2 Astra
17 ноября 2026 года OpenAI выпустила GPT-6.2 Astra и GPT-6.2 Sol. Astra предназначена для сложных рассуждений, программирования и профессиональных задач; ID модели в API — gpt-6.2-astra. В тот же день в журнале обновлений OpenAI API появилась запись о том, что фоновые окна завершения Responses API вышли в публичную бету.
Для асинхронных запросов Astra нужно установить background=true; окна бывают трёх видов:
- soonest (по умолчанию): выполняется как можно скорее; токены модели тарифицируются по фактически использованному уровню обработки, без скидки.
- 2h: для подходящих запросов токены модели тарифицируются по 70% ставки Standard.
- 8h: для подходящих запросов токены модели тарифицируются по 60% ставки Standard.
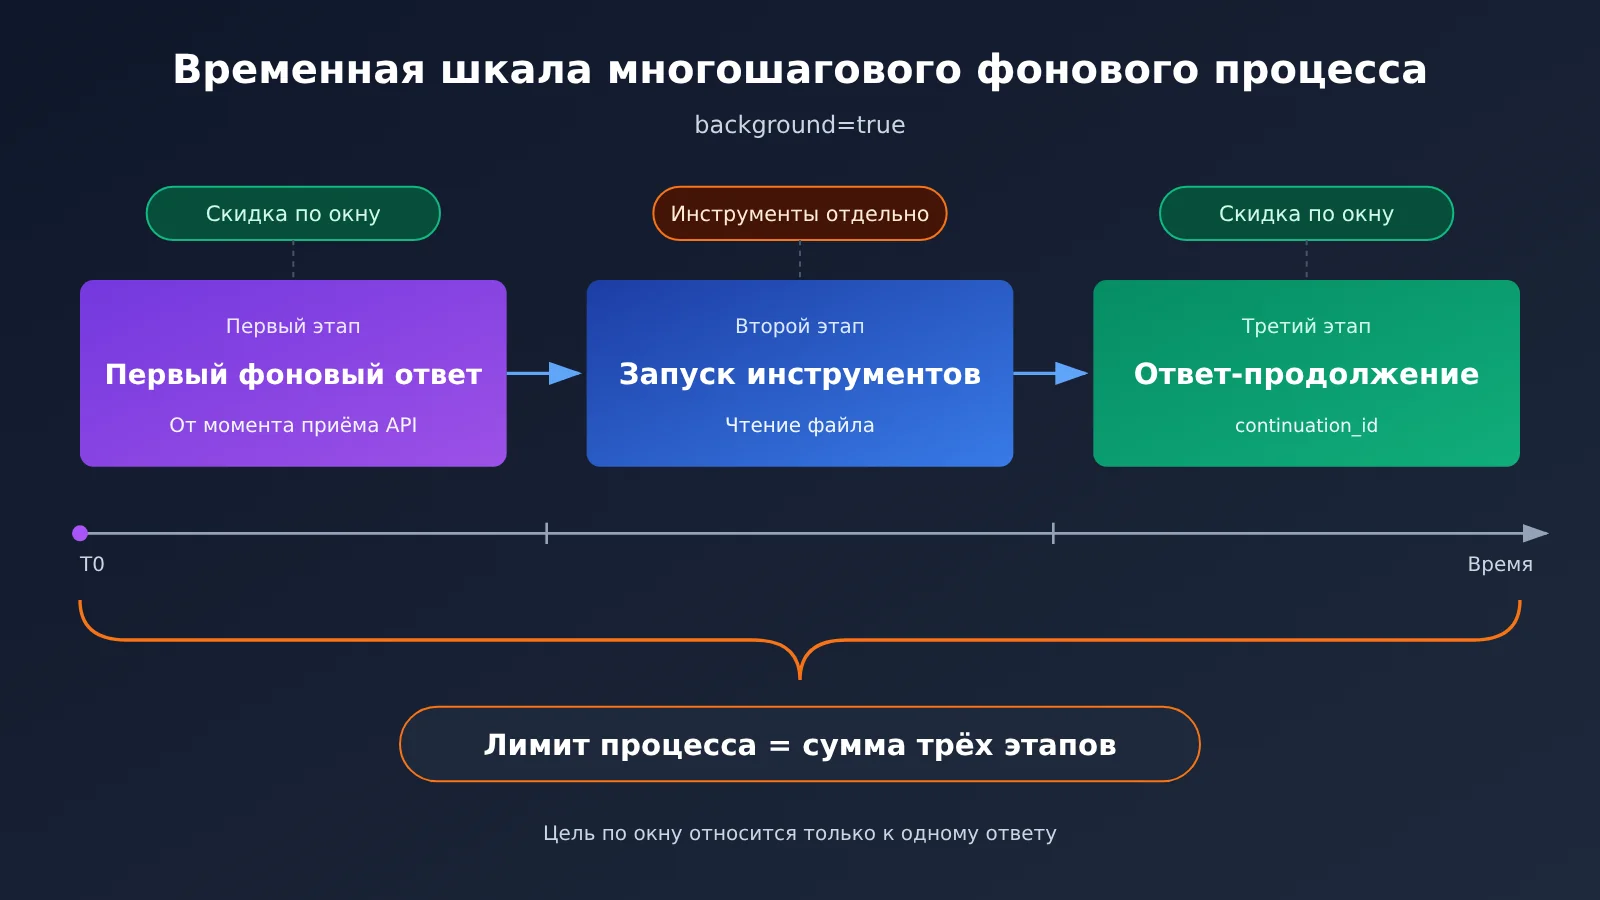
Отсчёт начинается с момента, когда API принимает исходный запрос; цель окна относится именно к этому ответу. Если по ходу задачи приложению нужно выполнить инструмент и затем отправить следующий ответ, время на это выполнение и последующие шаги рассчитывается отдельно в рамках общего лимита времени рабочего процесса.
Возьмём пример «сначала проверить файл, затем продолжить проверку»: первый ответ завершается внутри окна и возвращает вызов инструмента, который должно выполнить приложение. После чтения файла приложение отправляет результат как follow-up-запрос, и модель продолжает проверку. Общее время всей операции равно сумме трёх отрезков — первого ответа, выполнения инструмента и ответа-продолжения, — а не одному окну.
Сколько стоит один и тот же запрос в разных режимах GPT-6.2 Astra
В таблице ниже — тарифы GPT-6.2 Astra для короткого контекста, в долларах за миллион токенов. Строки 2h и 8h пересчитаны по официальным коэффициентам скидки; для Ultrafast даты цен указаны по тихоокеанскому времени США.
| Режим | Относительно Standard | Обычный ввод | Ввод с попаданием в кэш | Вывод |
|---|---|---|---|---|
| Standard | 1× | $8.00 | $0.40 | $40.00 |
| Fast | 2× | $16.00 | $0.80 | $80.00 |
| Ultrafast (до 2027-02-28) | 3× | $24.00 | $1.20 | $120.00 |
| Ultrafast (с 2027-03-01) | 6× | $48.00 | $2.40 | $240.00 |
| Фоновый 2h | 0.70× | $5.60 | $0.28 | $28.00 |
| Фоновый 8h | 0.60× | $4.80 | $0.24 | $24.00 |
| Batch | 0.50× | $4.00 | $0.20 | $20.00 |
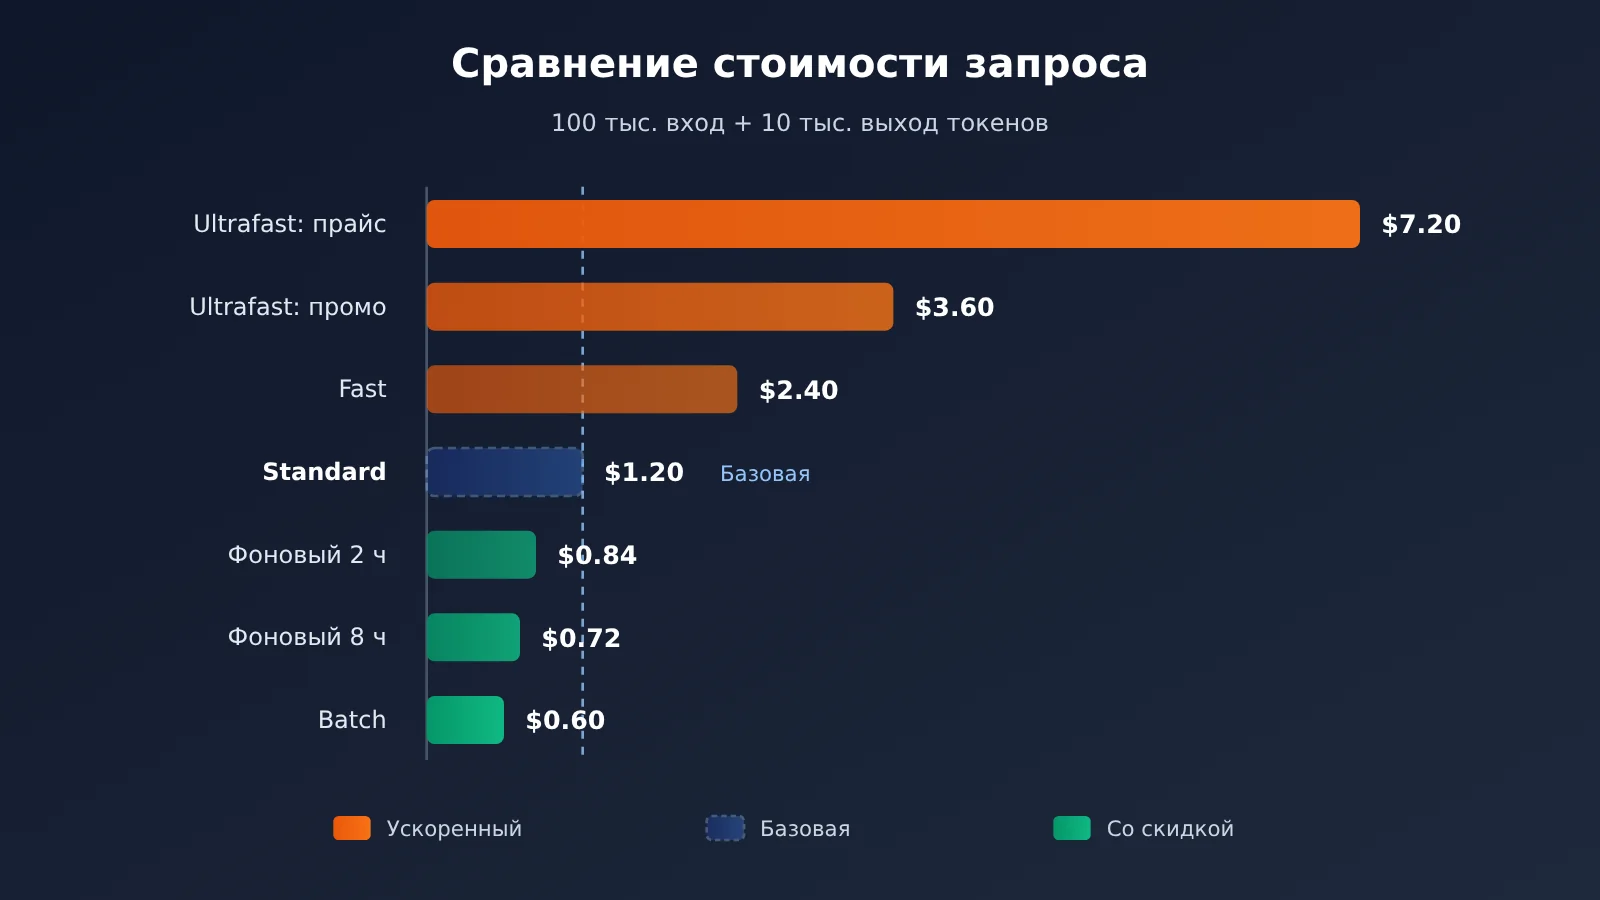
Возьмём фиксированный объём для сравнения: 100 000 обычных входных токенов + 10 000 тарифицируемых выходных токенов. Для Standard расчёт такой: 0.1 × $8 + 0.01 × $40 = $1.20; остальные режимы пересчитываются тем же способом:
| Режим | Стоимость токенов модели за один запрос | Разница с Standard |
|---|---|---|
| Ultrafast по прайсу | $7.20 | +$6.00 |
| Ultrafast по промоцене | $3.60 | +$2.40 |
| Fast | $2.40 | +$1.20 |
| Standard | $1.20 | База |
| Фоновый 2h | $0.84 | −$0.36 |
| Фоновый 8h | $0.72 | −$0.48 |
| Batch | $0.60 | −$0.60 |
В этом примере учитываются только токены модели. Вызовы Web Search, контейнеры Shell / Code Interpreter и прочие расходы считаются отдельно по своим тарифам; запись в кэш также оплачивается отдельно.
Кроме того, в карточке модели указано: если ввод превышает 272K токенов, ко всему запросу применяется тариф длинного контекста — цены на ввод и кэш умножаются на 2, цена вывода — на 1.5, после чего применяется выбранный режим или положенная скидка. По этому правилу для длинноконтекстного запроса в 8h-окне обычный ввод составит $16 × 0.6 = $9.6, а вывод — $60 × 0.6 = $36 (за миллион токенов).
Приведённые выше тарифы рассчитаны по официальному прайс-листу OpenAI и коэффициентам скидок. Если вы вызываете модель через APIYI apiyi.com, фактический расчёт смотрите на странице тарифов платформы; рекомендуем сначала проверить счёт на небольшом трафике, а уже потом выводить в продакшен.
Как добиться скидки при фоновом биллинге для запросов к GPT-6.2 Astra
Скидка не применяется автоматически — нужно одновременно выполнить все условия ниже:
| Параметр / условие | Допустимое значение | Пояснение |
|---|---|---|
| Интерфейс | /v1/responses |
Фоновое окно завершения определяется Responses API |
background |
true |
Включает фоновый режим: сначала возвращается ID ответа |
background_options.completion_window |
2h или 8h |
По умолчанию soonest — без скидки |
service_tier |
default (Standard) |
auto соответствует условиям, только если в итоге запрос идёт через Standard |
stream |
пропущен или false |
Потоковый вывод не подходит под условия скидки |
Что касается квот: окна 2h, 8h и Batch делят общую очередь Batch/Background — при постановке в очередь считаются входные токены. soonest же расходует обычные лимиты по числу запросов и токенов. С кэшем есть нюанс: обычные запросы Standard не могут переиспользовать кэш промптов, созданный в этих двух скидочных окнах. И ещё: в карточке модели сказано, что запросы с reasoning.effort, установленным в none, отклоняются.
Вот минимальный пример. background_options может ещё не быть в типовых определениях SDK, поэтому передаём его через extra_body:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.responses.create(
    model="gpt-6.2-astra",
    input="请汇总以下 50 张支持工单的共性问题……",
    background=True,
    service_tier="default",          # через Standard — соответствует условиям скидки
    extra_body={"background_options": {"completion_window": "2h"}},
)
print(resp.id, resp.status)  # сохраните response ID, чтобы забрать результат позже
Получив response ID, можно читать статус через webhook или опрос. Пока статус queued или in_progress, продолжаем опрашивать с тем же ID; допустимые ошибки по ёмкости API автоматически повторяет — приложению не нужно переотправлять запрос самому.
Посмотреть полный пример опроса и последующих запросов
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # единый доступ через APIYI
)

WINDOW = "8h"

def submit(input_items, previous_id=None):
    """Отправляет один запрос в фоновом режиме со скидкой.
    Точное место передачи continuation_id смотрите в руководстве OpenAI Background mode."""
    return client.responses.create(
        model="gpt-6.2-astra",
        input=input_items,
        background=True,
        service_tier="default",
        previous_response_id=previous_id,
        extra_body={
            "background_options": {"completion_window": WINDOW},
            # "continuation_id": "audit-2026-11-19-batch-01",  # в рамках одного рабочего процесса значение не меняется
        },
    )

def wait(response_id, interval=60):
    """Опрашивает состояние до завершения; при статусах queued / in_progress продолжает запросы с тем же ID."""
    while True:
        r = client.responses.retrieve(response_id)
        if r.status not in ("queued", "in_progress"):
            return r
        time.sleep(interval)

first = wait(submit("审核合同,需要时调用 read_file 工具读取附件").id)

# Если вернулся вызов инструмента, за который отвечает приложение: приложение выполняет инструмент,
# затем с теми же проектом, моделью, уровнем обслуживания, окном и continuation_id
# отправляет последующий запрос — так последующие шаги получают право на приоритетную очередь
for item in first.output:
    if item.type == "function_call":
        tool_result = "……read_file 的实际返回内容……"
        follow = submit(
            [{"type": "function_call_output",
              "call_id": item.call_id,
              "output": tool_result}],
            previous_id=first.id,
        )
        print(wait(follow.id).output_text)
В многошаговом рабочем процессе последующие запросы должны использовать те же проект, модель, уровень обслуживания, окно и continuation_id — только тогда они получают право на приоритетную очередь. Подходящие follow-up запросы тарифицируются каждый по своей скидке.
🚀 Совет по подключению: окно фонового завершения сейчас — публичная бета OpenAI Responses API. При вызове через агрегатор вроде APIYI apiyi.com лучше сначала на бесплатном тестовом лимите убедиться, что параметры
backgroundиcompletion_windowпередаются полностью и что биллинг считается по скидке, и только потом переносить продакшн-задачи.
Разбираемся: как правильно использовать тарификацию фоновых задач GPT-6.2 Astra
Фоновая скидка и ускоренный режим GPT-6.2 Astra не суммируются
Условие для скидки требует, чтобы service_tier был default или чтобы auto в итоге попадал на Standard. Отсюда можно сделать вывод: Fast и Ultrafast не могут одновременно получать скидки 2h и 8h. Компромисс здесь очевиден: ускоренный режим — это больше денег за меньшую задержку, а фоновое окно — более долгое ожидание за более низкую цену. Эти два направления противоположны.
Есть ещё одна деталь, которую легко упустить: soonest тоже относится к фоновому режиму, но цена следует за уровнем обработки. Если использовать soonest вместе с Fast, вы всё равно платите по цене Fast — просто взаимодействие становится асинхронным. Смысл soonest в том, чтобы интерфейс сначала вернул управление пользователю; сам по себе он не экономит деньги.
Для многошаговых задач бюджет времени нужно рассчитывать на «весь рабочий процесс»
Целевое окно ограничивает только один ответ и не охватывает весь рабочий процесс. Задача проверки, где требуется три раунда вызовов инструментов, теоретически может пройти через три цикла планирования окна, а ещё нужно учесть время, которое приложение тратит на выполнение инструментов. Если бизнес обещает «результат до 9 утра», при обработке ночной задачи в 8h-окне нужно оставлять запас на продолжение шагов, а не отправлять запрос впритык к восьмичасовой отметке.
Именно в этом и ценность continuation_id. continuation_id не продлевает и не объединяет окна, но даёт шагам продолжения приоритет в очереди и сокращает ожидание в конце многошагового процесса. С инженерной точки зрения рекомендуется ставить continuation_id в однозначное соответствие с ID бизнес-задачи — так удобнее и для разбора логов, и для учёта затрат.
8h и Batch: разница в цене 10 процентных пунктов, разные сценарии применения
При указанном в примере объёме 8h стоит $0.72, Batch — $0.60, разница всего $0.12. Batch дешевле, но требует, чтобы запросы можно было заранее собрать в JSONL, они были независимы друг от друга и допускали 24-часовое окно доставки. 8h же позволяет запросу продолжать рассуждение на основе результатов инструментов.
Поэтому выбирать нужно не по принципу «что дешевле», а по структуре задач:
- Запросы зависят друг от друга (следующий шаг должен увидеть результат предыдущего): выбирайте 8h или 2h
- Запросы независимы друг от друга и их можно перечислить за один раз: выбирайте Batch
Скидка 50% в Batch и скидка за фоновое окно — это две независимые схемы тарификации, они не суммируются.
Скрытые издержки кэширования и квот в очереди
Кэш промптов, созданный в окне со скидкой, нельзя повторно использовать для обычных запросов Standard. Если один и тот же длинный системный промпт используется и для ответов в реальном времени, и для фоновой пакетной обработки, кэш будет создаваться отдельно для каждого сценария, и запись в кэш может оплачиваться дважды. Кроме того, входные токены с попаданием в кэш сами по себе уже дешёвые: $0.40 для Standard и $0.24 для 8h. Для нагрузок с высокой долей попаданий в кэш доля экономии от фоновой скидки в общем счёте будет ниже, чем у задач с интенсивным выводом.
Совместное использование квоты очереди тоже нужно планировать заранее. 2h, 8h и Batch делят общую квоту Batch/Background, а в очередь они попадают с учётом количества входных токенов. Если ночью одновременно запустить большую партию Batch-заданий и поток проверок на 8h, они начнут конкурировать за одну и ту же квоту.
💡 Совет по стоимости: прежде чем выбирать тариф, оцените расходы по каждому тарифу отдельно — по распределению токенов в реальном промпте (доля обычных входных данных, попаданий в кэш и выходных данных). С единым интерфейсом APIYI apiyi.com один и тот же код, достаточно поменять параметры, позволяет сравнить счета для пути в реальном времени и асинхронного пути.
Как встроить сервисные уровни GPT-6.2 Astra в реальные рабочие нагрузки
Ниже — примеры рабочих нагрузок. Критерии для решения по порядку: сколько можно ждать, важны ли промежуточные результаты и есть ли расходы на инструменты.
| Рабочая нагрузка | Рекомендуемый способ отправки | Обоснование |
|---|---|---|
| Интерактивные вопросы-ответы в реальном времени, анализ, которого кто-то ждёт | Начинать со Standard; Fast / Ultrafast рассматривать после проверки задержки и стоимости | Пользователь ждёт, и доплата за скорость должна быть подкреплена данными |
| Асинхронный интерфейс: сначала вернуть управление, потом показать результат | soonest | Управление возвращается сразу, а цена — по используемому уровню обработки |
| Сводка по тикетам поддержки к полудню | фоновый режим 2h | Доставка за несколько часов, стоимость токенов модели ниже на 30% |
| Многошаговая проверка, которую можно оставить на ночь и которая вызывает инструменты | фоновый режим 8h + continuation_id | Скидка 40%, плюс время в запасе на работу инструментов и продолжение шагов |
| Независимые задачи классификации, которые можно подготовить заранее | Batch (JSONL) | Задачи независимы друг от друга и допускают окно в 24 часа, скидка 50% |
Важно учитывать: как только в задаче используется Web Search или контейнер Code Interpreter, на эти расходы скидка на токены модели не распространяется. Чем выше доля расходов на инструменты, тем ниже общий процент экономии при фоновом окне.
🎯 Совет по выбору: сначала прогоните одну и ту же выборку примеров на APIYI apiyi.com через Standard, 2h и 8h, запишите фактическое время выполнения и счета, а потом решайте, какой уровень использовать по умолчанию для каждого типа задач. Так вы будете ближе к реальной стоимости, чем если просто смотреть на таблицу цен за единицу.
Изменения, за которыми стоит следить
Окно фонового завершения пока остаётся публичной бетой: названия параметров, условия допуска и размер скидки могут измениться до официального релиза, поэтому перед запуском стоит ориентироваться на официальное руководство OpenAI. Ещё два момента стоит запомнить: акционная цена Ultrafast действует до 28 февраля 2027 года (по тихоокеанскому времени), а с 1 марта тариф вырастет с 3× до 6×, так что продуктам, которые надолго завязаны на Ultrafast, нужно заранее пересмотреть бюджет. У GPT-6.2 Astra и Sol сейчас нет тарифа Flex — если он появится позже, выбор для асинхронных задач станет шире.
Командам, которые сейчас планируют асинхронные возможности Astra, можно сначала на APIYI apiyi.com, используя тестовый лимит, отработать фоновый режим и логику опроса, записать дедлайны и зависимости задач в документ с требованиями — а уже потом обсуждать тарифы.
В «Лунь юй» (глава «Цзы Лу») есть фраза: «Кто торопится, тот цели не достигнет». В прайс-листе GPT-6.2 Astra эта фраза внезапно получила цену: готов подождать несколько лишних часов — платишь за модель на 30–40% меньше.
📚 Справочные материалы
-
Анонс OpenAI: Introducing GPT-6.2 Astra and Sol (2026-11-17)
- Ссылка:
openai.com/index/introducing-gpt-6-2-astra-sol/ - Описание: позиционирование моделей и описание изменения цен
- Ссылка:
-
Карточка модели GPT-6.2 Astra: спецификации, тарифы для короткого и длинного контекста
- Ссылка:
developers.openai.com/api/docs/models/gpt-6.2-astra - Описание: длина контекста, правила тарификации длинного контекста 272K
- Ссылка:
-
Журнал обновлений OpenAI API: выпуск моделей от 2026-11-17 и запись о фоновом окне
- Ссылка:
developers.openai.com/api/docs/changelog - Описание: публичная бета окна фонового завершения и размер скидки
- Ссылка:
-
Прайс-лист OpenAI API: стоимость по каждому уровню обработки
- Ссылка:
developers.openai.com/api/docs/pricing - Описание: тарифы Standard, Fast, Ultrafast, Batch
- Ссылка:
-
Руководство по Background mode: фоновый режим, окно завершения и follow-up запросы
- Ссылка:
developers.openai.com/api/docs/guides/background - Описание: условия скидки, continuation_id, лимиты очереди и границы кэширования
- Ссылка:
-
Руководство по Batch API / Fast / Ultrafast
- Ссылка:
developers.openai.com/api/docs/guides/batch,developers.openai.com/api/docs/guides/fast-mode,developers.openai.com/api/docs/guides/ultrafast-mode - Описание: условия применимости каждого способа отправки
- Ссылка:
Автор: техническая команда APIYI
Обсудить технические вопросы: обращайтесь к нам на главной странице APIYI apiyi.com; больше материалов по подключению — в документации docs.apiyi.com