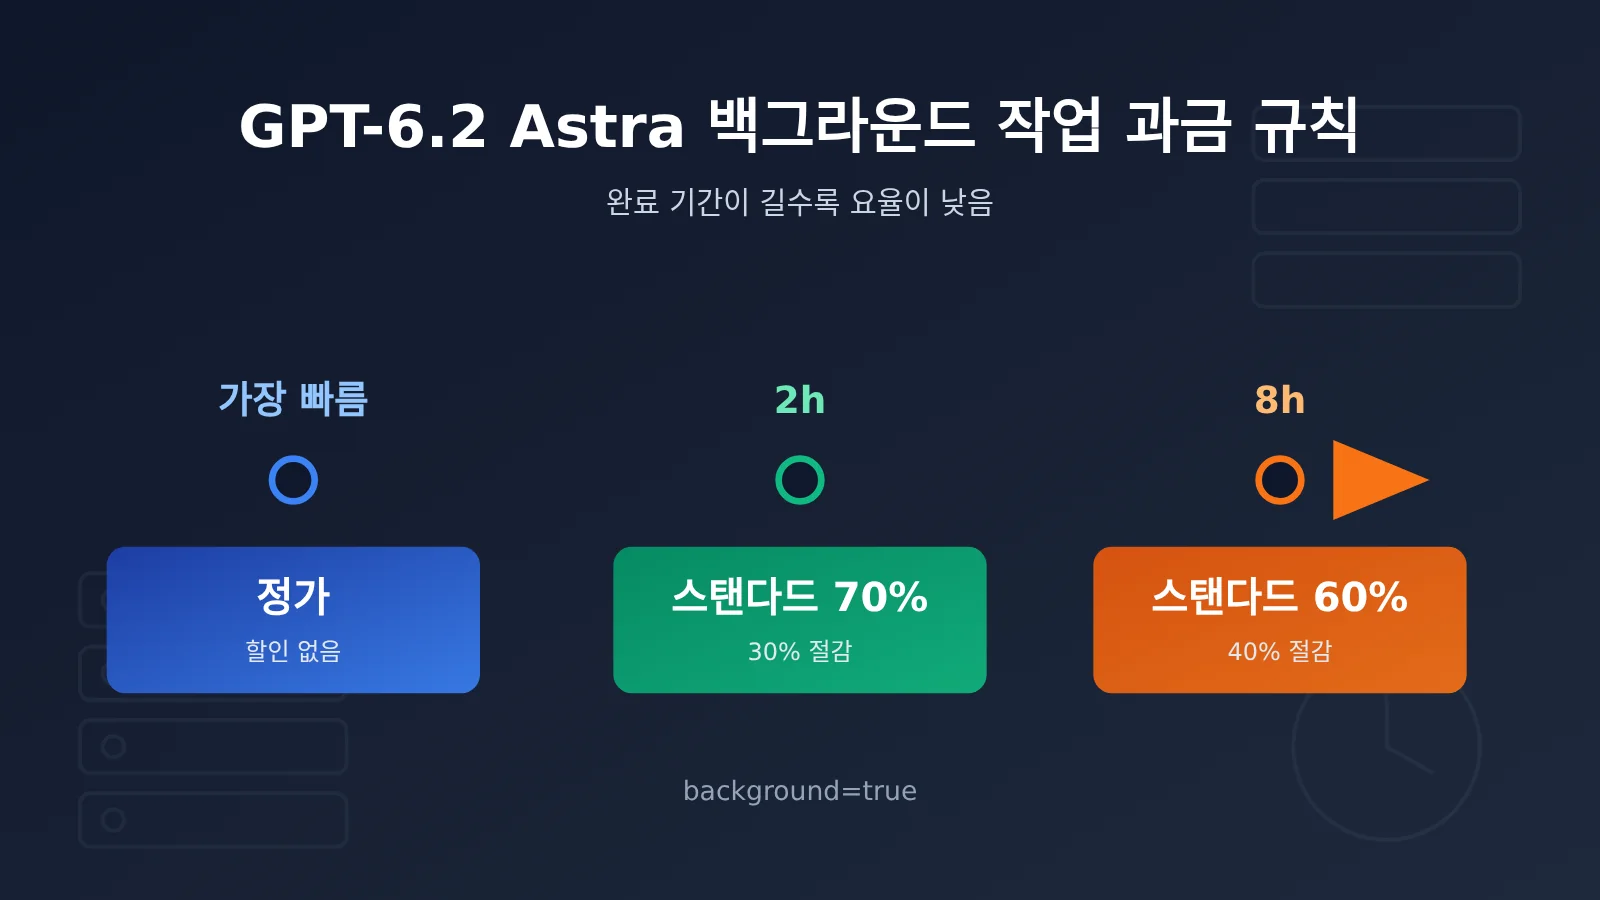
GPT-6.2 Astra의 백그라운드 작업 과금 규칙은 한 문장으로 요약할 수 있어요. 기다릴 수 있으면 더 저렴하다. 2026년 11월 17일부터 Responses API의 백그라운드 완료 윈도우가 공개 베타에 들어갑니다. 기본값인 soonest 윈도우는 사용한 처리 티어의 정가로 과금돼요. 2h 윈도우를 선택한 자격 요청은 Standard 모델 토큰 요율의 70%로, 8h 윈도우는 60%로 과금되는데, 각각 30%와 40% 저렴한 셈이에요.
어느 티어를 고를지는 두 가지 질문에 달려 있어요. 결과가 늦어도 언제까지 필요한지, 그리고 요청들 사이에서 이전 단계의 중간 결과에 의존해야 하는지예요. 이 두 질문에 먼저 답한 다음 사용량으로 비용을 추산하는 편이, 단가만 직접 비교하는 것보다 훨씬 믿을 만해요.
이 글을 읽고 무엇을 알 수 있나요?
- soonest, 2h, 8h 세 가지 완료 윈도우의 정의와 타이머 시작 시점, 과금 기준
- 동일한 사용량(입력 10만 + 출력 1만 토큰)이 7가지 모드에서 실제로 얼마인지
- 요청이 할인을 받기 위해 갖춰야 할 파라미터 조건, 그리고 대기열 할당량과 캐시 재사용의 경계
- 대화형 질의응답, 티켓 요약, 야간 심사, 독립 분류 작업이 각각 어떤 제출 방식에 적합한지
인덱스: 먼저 개념 표와 영향 요약으로 용어를 통일해 볼게요. 「객관적 사실」 부분에서는 완료 윈도우 규칙, 티어별 가격, 할인 조건, 다단계 워크플로에서의 연속 단계 처리를 차례로 설명해요. 「분석과 판단」 부분에서는 할인끼리 중첩될 수 있는지, 다단계 작업의 시간 예산, 캐시와 대기열 할당량이 만드는 트레이드오프를 논의하고, 워크로드에 따라 티어를 고르는 권장안을 제시해요.
GPT-6.2 Astra 백그라운드 작업 과금 알아보기: 개념 설명
| 개념 | 간단한 설명 |
|---|---|
| Standard | OpenAI API의 표준 처리 등급으로, 2시간·8시간 백그라운드 윈도의 할인은 이 등급의 모델 요율을 기준으로 계산해요 |
| Fast | Astra의 현재 가속 등급으로, 모델 토큰 요율이 Standard의 2배예요 |
| Ultrafast | 더 빠른 처리 등급으로, 프로모션 기간에는 Standard의 3배, 이후 정가는 6배예요 |
| 백그라운드 모드 | 요청이 먼저 응답 ID를 반환하고, 앱이 나중에 상태를 조회해 결과를 받아오는 방식이에요 |
| 완료 윈도우 | 백그라운드 응답이 접수된 뒤 스케줄링에 사용되는 완료 목표로, soonest·2h·8h로 나뉘어요 |
| soonest | 백그라운드 요청의 기본 윈도로, 가능한 한 빨리 실행되며 사용한 처리 등급의 모델 요율을 그대로 적용해요 |
| Batch API | 서로 독립적인 요청을 JSONL 파일에 담아 하나의 작업으로 비동기 실행해요 |
| continuation_id | 앱이 동일한 백그라운드 워크플로에 지정하는 식별자로, 조건을 충족하는 후속 요청을 연결하는 데 사용해요 |
| 모델 토큰 요율 | 일반 입력, 캐시 적중 입력, 출력 등 각 계량 항목에 대응하는 단가예요 |
GPT-6.2 Astra 백그라운드 작업 과금 영향 한눈에 보기
- API 개발자: 비동기 작업에 실시간 호출과 Batch 사이의 할인 옵션이 두 개 늘었어요. 다만 백그라운드 모드로 개조해야 하고, 폴링이나 webhook을 처리해야 해요.
- 제품 관리자: 요구사항에 “결과가 늦어도 언제까지 사용 가능한지”를 명확히 적어야 해요. 2시간 또는 8시간 내 전달을 받아들일 수 있는 기능은 모델 토큰 비용을 각각 30%, 40% 낮출 수 있어요.
- 비용·운영 책임자: 2h·8h와 Batch는 동일한 대기 할당량을 공유해요. 대규모 Batch 작업과 백그라운드 할인 작업은 함께 계획해야 하며, 각각 독립적으로 용량을 추정하면 안 돼요.
객관적 사실: GPT-6.2 Astra 백그라운드 작업 과금 규칙
GPT-6.2 Astra 백그라운드 작업의 세 가지 완료 윈도우
OpenAI는 2026년 11월 17일에 GPT-6.2 Astra와 GPT-6.2 Sol을 공개했어요. Astra는 복잡한 추론, 코딩, 전문 업무를 겨냥하며 API 모델 ID는 gpt-6.2-astra예요. 같은 날 OpenAI API 변경 로그에는 Responses API 백그라운드 완료 윈도우가 공개 베타에 진입했다는 내용이 기록됐어요.
Astra의 비동기 요청은 background=true로 설정해야 하며, 윈도우는 세 가지로 나뉘어요.
- soonest(기본값): 최대한 빨리 실행되고, 모델 토큰은 실제 사용된 처리 티어 기준으로 과금되며 할인은 없어요.
- 2h: 조건을 충족한 요청은 Standard 모델 토큰 요율의 70%로 과금돼요.
- 8h: 조건을 충족한 요청은 Standard 모델 토큰 요율의 60%로 과금돼요.
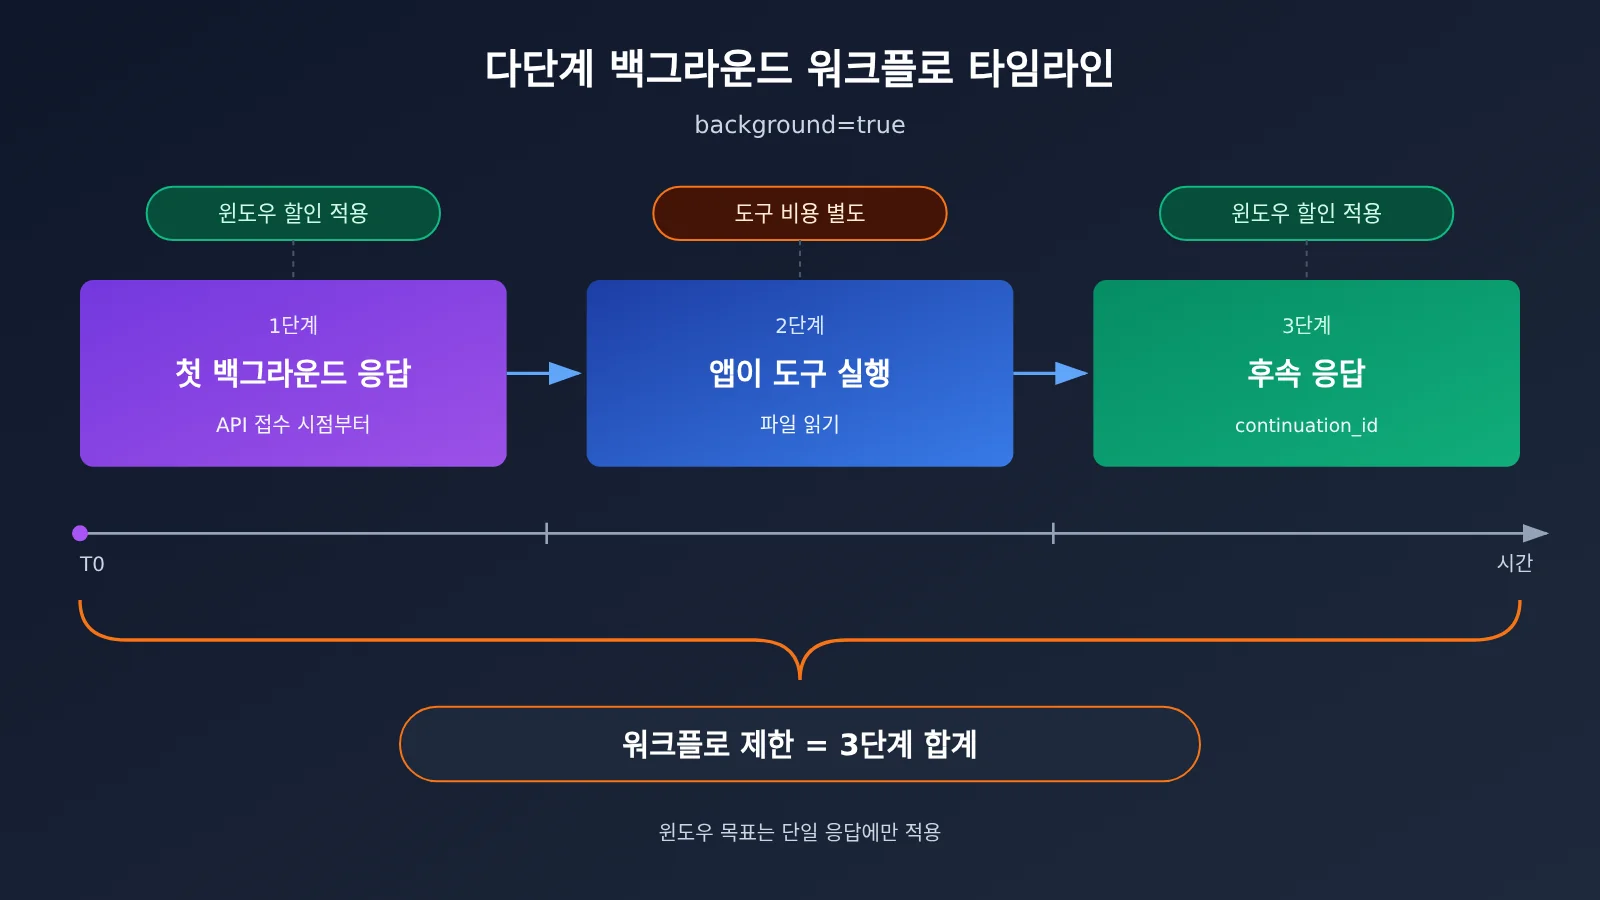
시간 측정의 기점은 API가 초기 요청을 수락한 순간이고, 윈도우가 목표로 하는 것은 바로 이 응답 하나예요. 만약 작업이 진행 도중에 앱이 도구를 실행한 뒤 다음 응답을 다시 시작해야 한다면, 이 실행 시간과 이어지는 단계의 시간은 전체 워크플로의 시간 제한 안에서 별도로 계산해야 해요.
‘먼저 파일을 확인하고, 이어서 검토를 계속한다’를 예로 들어볼게요. 첫 번째 응답은 윈도우 안에서 완료되고, 앱이 실행해야 할 도구 호출을 하나 반환해요. 앱이 파일을 읽은 뒤 그 결과를 후속 요청으로 제출하면, 모델이 이어서 검토를 진행해요. 전체 작업 시간은 첫 응답, 도구 실행, 이어지는 응답 세 구간을 모두 더한 값이지, 하나의 윈도우와 같지 않아요.
GPT-6.2 Astra, 각 티어에서 같은 요청의 비용은 얼마일까요
아래 표는 GPT-6.2 Astra의 짧은 컨텍스트 요율이며, 단위는 백만 토큰당 미국 달러예요. 2h와 8h 두 행은 공식 할인 비율로 환산했고, Ultrafast 가격 날짜는 미국 태평양 시간 기준으로 계산했어요.
| 모드 | Standard 대비 | 일반 입력 | 캐시 적중 입력 | 출력 |
|---|---|---|---|---|
| Standard | 1배 | $8.00 | $0.40 | $40.00 |
| Fast | 2배 | $16.00 | $0.80 | $80.00 |
| Ultrafast(2027-02-28까지) | 3배 | $24.00 | $1.20 | $120.00 |
| Ultrafast(2027-03-01부터) | 6배 | $48.00 | $2.40 | $240.00 |
| 백그라운드 2h | 0.70배 | $5.60 | $0.28 | $28.00 |
| 백그라운드 8h | 0.60배 | $4.80 | $0.24 | $24.00 |
| Batch | 0.50배 | $4.00 | $0.20 | $20.00 |
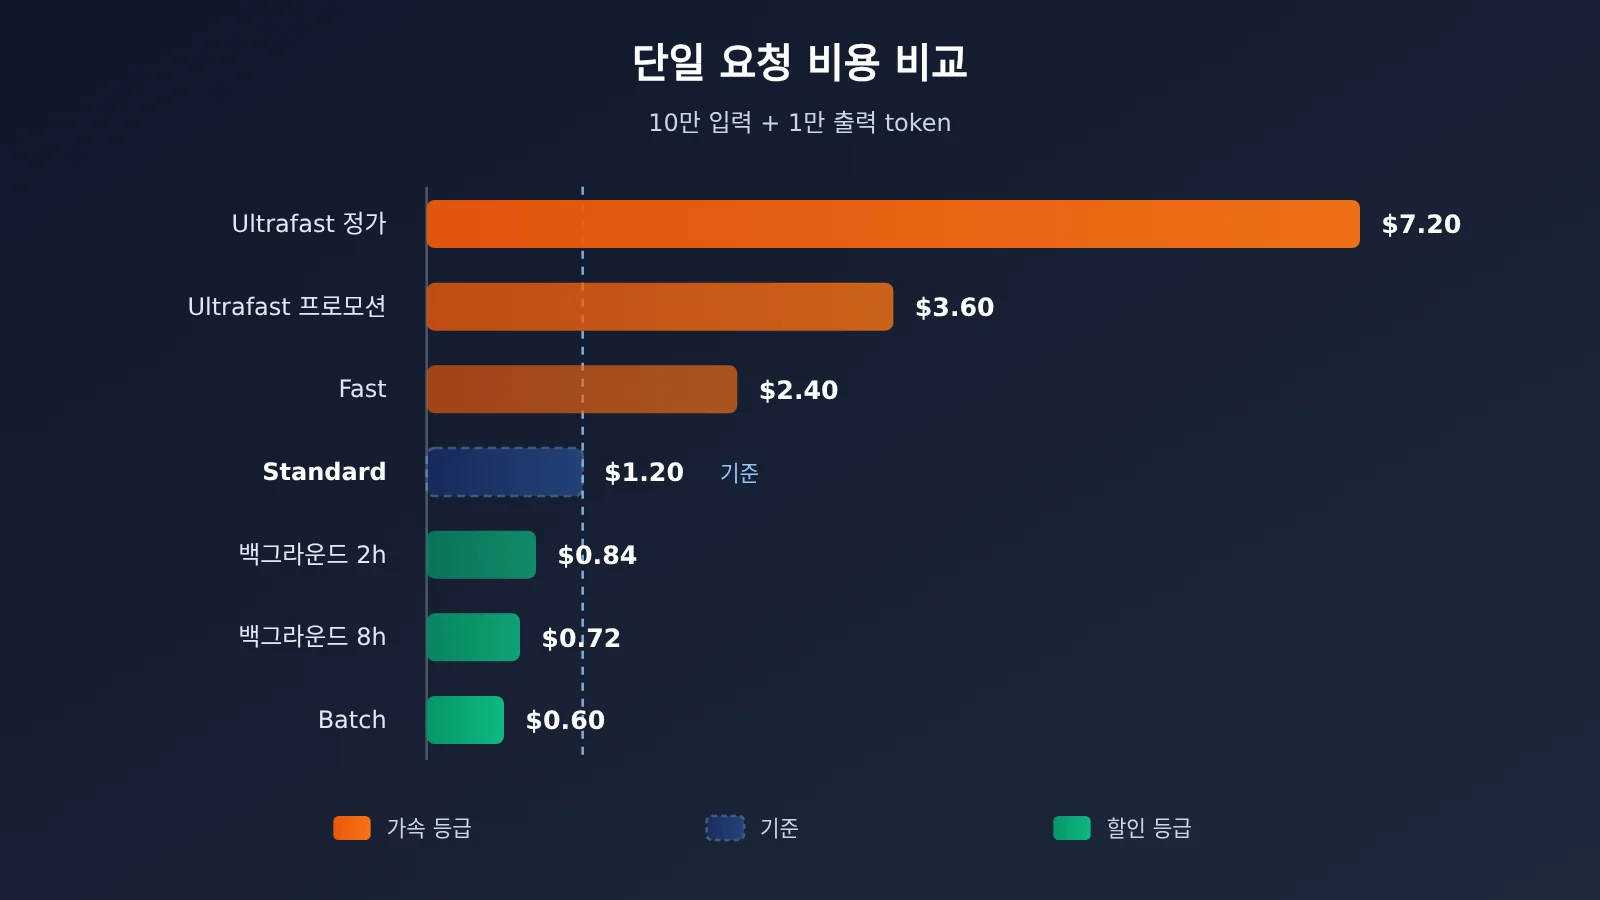
고정 사용량으로 비교해 볼게요: 일반 입력 토큰 100,000개 + 과금 출력 토큰 10,000개. Standard는 0.1 × $8 + 0.01 × $40 = $1.20으로 계산되며, 나머지 티어도 같은 방식으로 환산했어요.
| 모드 | 요청 1회당 모델 토큰 비용 | Standard 대비 차액 |
|---|---|---|
| Ultrafast 정가 | $7.20 | +$6.00 |
| Ultrafast 프로모션가 | $3.60 | +$2.40 |
| Fast | $2.40 | +$1.20 |
| Standard | $1.20 | 기준 |
| 백그라운드 2h | $0.84 | −$0.36 |
| 백그라운드 8h | $0.72 | −$0.48 |
| Batch | $0.60 | −$0.60 |
이 예시는 모델 토큰만 계산했어요. Web Search 호출, Shell / Code Interpreter 컨테이너 등의 비용은 각 항목에서 별도로 계산하고, 캐시 쓰기도 따로 과금돼요.
또한 모델 카드에는 입력이 272K 토큰을 초과하면 요청 전체에 긴 컨텍스트 요금이 적용되어 입력 및 캐시 가격은 2배, 출력 가격은 1.5배가 되고, 이후 선택한 티어나 적용 가능한 할인에 따라 계산된다고 명시되어 있어요. 이 규칙으로 계산하면 8h 윈도우의 긴 컨텍스트 요청은 일반 입력이 $16 × 0.6 = $9.6, 출력이 $60 × 0.6 = $36(백만 토큰당)이에요.
위 요금은 OpenAI 공식 가격표와 할인 비율로 환산한 것이에요. APIYI apiyi.com을 통해 호출한다면 실제 정산은 플랫폼 요금 페이지를 기준으로 하니, 먼저 소량 트래픽으로 청구서를 확인한 뒤 프로덕션 환경으로 확대하는 것을 권장해요.
GPT-6.2 Astra 요청이 백그라운드 청구 할인을 받도록 맞추는 방법
할인은 자동으로 적용되지 않아요. 아래 조건을 동시에 충족해야 해요:
| 파라미터 / 조건 | 충족 값 | 설명 |
|---|---|---|
| 인터페이스 | /v1/responses |
백그라운드 완료 윈도우는 Responses API를 기준으로 해요 |
background |
true |
백그라운드 모드로 진입하고, 먼저 응답 ID를 반환해요 |
background_options.completion_window |
2h 또는 8h |
기본값인 soonest는 할인이 없어요 |
service_tier |
default(Standard) |
auto는 최종적으로 Standard로 처리될 때만 조건을 충족해요 |
stream |
생략 또는 false |
스트리밍 출력은 할인 조건에 맞지 않아요 |
할당량 측면에서는 2h, 8h, Batch가 Batch/Background 대기 할당량을 공유하고, 대기열에 들어갈 때 입력 token 기준으로 계산해요. soonest는 일반 요청 수와 token 한도를 사용해요. 캐시에는 경계가 하나 있어요: Standard의 일반 요청은 이 두 할인 윈도우에서 생성된 프롬프트 캐시를 재사용할 수 없어요. 또 모델 카드에 따르면 reasoning.effort를 none으로 설정한 요청은 거부된다는 점에 주의해야 해요.
아래는 아주 간단한 예시예요. background_options는 SDK 타입 정의에 아직 포함되지 않았을 수 있어서 extra_body로 전달해요:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.responses.create(
    model="gpt-6.2-astra",
    input="请汇总以下 50 张支持工单的共性问题……",
    background=True,
    service_tier="default",          # Standard로 처리되어 할인 조건 충족
    extra_body={"background_options": {"completion_window": "2h"}},
)
print(resp.id, resp.status)  # response ID를 저장한 뒤 나중에 다시 조회
response ID를 받은 뒤에는 webhook 또는 폴링으로 상태를 읽을 수 있어요. 상태가 queued 또는 in_progress라면 같은 ID로 계속 조회해요. 조건에 맞는 용량 오류는 API가 자동으로 재시도하므로, 애플리케이션이 직접 다시 보낼 필요가 없어요.
폴링과 후속 요청의 전체 예시 보기
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI를 통해 통합 접속
)

WINDOW = "8h"

def submit(input_items, previous_id=None):
    """백그라운드 할인 요청을 하나 제출해요.
    continuation_id의 구체적인 전달 위치는 OpenAI Background mode 가이드를 참고하세요."""
    return client.responses.create(
        model="gpt-6.2-astra",
        input=input_items,
        background=True,
        service_tier="default",
        previous_response_id=previous_id,
        extra_body={
            "background_options": {"completion_window": WINDOW},
            # "continuation_id": "audit-2026-11-19-batch-01",  # 동일 워크플로 내에서 일관성 유지
        },
    )

def wait(response_id, interval=60):
    """끝날 때까지 폴링해요. `queued` / `in_progress`일 때는 같은 ID로 계속 조회해요."""
    while True:
        r = client.responses.retrieve(response_id)
        if r.status not in ("queued", "in_progress"):
            return r
        time.sleep(interval)

first = wait(submit("审核合同,需要时调用 read_file 工具读取附件").id)

# 애플리케이션이 처리해야 할 도구 호출이 반환되면: 애플리케이션에서 도구를 실행한 뒤, 동일한 프로젝트, 모델, 서비스 등급,
# 윈도우 및 continuation_id로 후속 요청을 보내면 후속 단계에서 우선 대기열 자격을 얻을 수 있어요
for item in first.output:
    if item.type == "function_call":
        tool_result = "……read_file 的实际返回内容……"
        follow = submit(
            [{"type": "function_call_output",
              "call_id": item.call_id,
              "output": tool_result}],
            previous_id=first.id,
        )
        print(wait(follow.id).output_text)
다단계 워크플로에서는 후속 단계 요청이 동일한 프로젝트, 모델, 서비스 등급, 윈도우 및 continuation_id를 사용해야 우선 대기열 자격을 갖출 수 있어요. 조건을 충족하는 후속 요청은 각각 해당 할인으로 청구돼요.
🚀 연동 가이드: 백그라운드 완료 윈도우는 현재 OpenAI Responses API의 공개 베타 기능이에요. APIYI(apiyi.com) 같은 API 중계 서비스 플랫폼을 통해 호출할 때는 먼저 무료 테스트 크레딧으로
background와completion_window파라미터가 온전히 전달되는지, 과금이 할인 가격으로 정산되는지 확인한 뒤 프로덕션 작업을 이전하는 걸 권장해요.
분석과 판단: GPT-6.2 Astra 백그라운드 작업 과금을 제대로 활용하는 방법
GPT-6.2 Astra 백그라운드 할인과 가속 등급은 중복 적용할 수 없어요
할인 조건을 충족하려면 service_tier가 default이거나, auto의 최종 처리 등급이 Standard여야 해요. 여기서 Fast와 Ultrafast가 2h, 8h 할인을 동시에 받을 수 없다는 점을 알 수 있어요. 선택은 명확해요. 가속 등급은 더 많은 비용을 내고 지연 시간을 줄이는 쪽이고, 백그라운드 윈도우는 더 오래 기다리는 대신 더 낮은 가격을 얻는 쪽이라 방향이 정반대예요.
자주 놓치는 디테일도 하나 있어요. soonest도 백그라운드 모드이긴 하지만, 가격은 처리 등급을 따라가요. soonest와 Fast를 조합하면 여전히 Fast 가격을 내고, 다만 상호작용 방식이 비동기로 바뀌어요. soonest의 역할은 UI가 먼저 사용자에게 제어권을 돌려주게 하는 것일 뿐, 그것 자체로 비용을 아껴 주지는 않아요.
여러 단계 작업은 ‘전체 워크플로’ 기준으로 시간 예산을 잡아야 해요
윈도우 목표는 단일 응답에만 제약을 걸 뿐, 전체 워크플로를 포괄하지 않아요. 도구 호출을 세 번 거치는 검토 작업이라고 하면, 이론적으로 세 번의 윈도우 스케줄링을 겪을 수 있고 여기에 애플리케이션이 도구를 실행하는 시간까지 더해져요. 업무에서 “오전 9시 전까지 결과를 내준다”고 약속했다면, 8h 윈도우로 야간 작업을 처리할 때 제출 시간에 이어지는 단계를 위한 여유를 남겨야 해요. 8시간에 딱 맞춰 제출하면 안 되고요.
continuation_id의 가치가 바로 여기에 있어요. 윈도우를 늘리거나 합치지는 않지만, 이어지는 단계가 우선 대기열에 들어갈 자격을 얻어 다단계 프로세스의 꼬리 대기 시간을 줄여 줘요. 엔지니어링 측면에서는 continuation_id를 업무 작업 ID와 일대일로 대응시키는 걸 권장해요. 로그 추적과 비용 집계도 함께 편해져요.
8h와 Batch: 10%p 차이, 적용 시나리오는 달라요
예시 사용량 기준으로 8h는 $0.72, Batch는 $0.60이라 둘의 차이는 $0.12에 불과해요. Batch가 더 저렴하지만, 요청을 미리 JSONL로 구성할 수 있어야 하고 서로 독립적이어야 하며, 24시간의 전달 창을 감수할 수 있어야 해요. 반면 8h는 도구 결과를 바탕으로 요청이 이어서 추론할 수 있어요.
따라서 판단 기준은 어느 쪽이 더 저렴한가가 아니라 작업 구조예요.
- 요청 간에 의존성이 있는 경우(다음 단계가 이전 단계의 결과를 봐야 하는 경우): 8h 또는 2h를 선택
- 요청 간에 서로 독립적이고 한 번에 나열할 수 있는 경우: Batch를 선택
Batch의 50% 할인과 백그라운드 시간대 할인은 서로 독립적인 청구 경로라 중복 적용되지 않아요.
캐시와 대기열 할당량이 만드는 숨은 비용
할인 시간대에 생성된 프롬프트 캐시는 Standard 일반 요청에서 재사용할 수 없어요. 같은 긴 시스템 프롬프트를 실시간 질의응답과 백그라운드 배치 처리 양쪽에 사용한다면 양쪽에 각각 캐시가 생겨 캐시 쓰기 비용이 중복 발생할 수 있어요. 또한 캐시 적중 입력 자체는 이미 저렴해요. Standard는 $0.40, 8h는 $0.24예요. 캐시 적중률이 높은 워크로드에서는 백그라운드 할인이 전체 청구서에서 차지하는 절감 비율이 출력 집약적 작업보다 낮아질 수 있어요.
대기열 할당량 공유도 미리 계획해야 해요. 2h, 8h, Batch는 Batch/Background 할당량을 공유하며 입력 토큰 수를 기준으로 대기열에 등록돼요. 야간에 대량의 Batch 작업과 8h 검토 흐름을 동시에 제출하면 같은 할당량을 두고 경쟁하게 돼요.
💡 비용 조언: 티어를 확정하기 전에 실제 프롬프트의 토큰 분포(일반 입력, 캐시 적중 입력, 출력의 비율)로 각 티어 비용을 각각 추정해 볼 수 있어요. APIYI apiyi.com의 통합 인터페이스를 활용하면 동일한 코드에서 파라미터만 바꿔 실시간 경로와 비동기 경로의 청구서 차이를 비교할 수 있어요.
GPT-6.2 Astra 서비스 티어를 실제 워크로드에 적용하기
다음은 워크로드 예시예요. 의사결정 기준은 순서대로 “얼마나 기다릴 수 있는가”, “중간 결과에 의존하는가”, “도구 비용이 있는가”예요.
| 워크로드 | 권장 제출 방식 | 근거 |
|---|---|---|
| 즉시 대화형 Q&A, 누군가 기다리는 분석 | Standard부터 시작하고, 지연 시간과 비용을 검증한 뒤 Fast / Ultrafast 고려 | 사용자가 기다리고 있으니, 비용을 더 내고 속도를 얻으려면 데이터가 뒷받침되어야 함 |
| 비동기 UI, 먼저 반환한 뒤 결과를 표시 | soonest | 제어권을 돌려주고, 가격은 사용한 처리 티어를 따름 |
| 오후 전에 끝내야 하는 지원 티켓 요약 | 백그라운드 2h | 몇 시간 안에 전달하고, 모델 토큰 비용 30% 절감 |
| 밤샘 허용, 도구 호출이 필요한 다단계 검토 | 백그라운드 8h + continuation_id | 40% 절감하고, 도구 실행과 연속 단계를 위한 시간 확보 |
| 미리 조립할 수 있는 독립 분류 작업 | Batch(JSONL) | 서로 독립적이고 24시간 윈도를 허용하므로 50% 절감 |
주의할 점은 작업에서 Web Search나 Code Interpreter 컨테이너를 사용하는 순간, 이 부분 비용에는 모델 토큰 할인이 적용되지 않는다는 점이에요. 도구 비용 비중이 높을수록 백그라운드 윈도의 전체 절감률은 낮아져요.
🎯 선택 팁: 먼저 APIYI apiyi.com에서 동일한 샘플 배치로 Standard, 2h, 8h를 각각 실행해 실제 완료 시간과 청구서를 기록한 다음, 각 작업 유형의 기본 티어를 정하세요. 이는 단가표만 보는 것보다 실제 비용에 더 가까워요.
계속 주목해야 할 변화
백그라운드 완료 윈도우는 아직 공개 베타 상태예요. 파라미터 이름, 적용 조건, 할인 비율은 정식 출시 전에 바뀔 수 있으니, 실제 도입 전에는 반드시 OpenAI 공식 가이드를 기준으로 삼아야 합니다. 함께 기억해 둘 시점이 두 개 더 있어요. Ultrafast 프로모션 가격은 2027년 2월 28일(태평양 시간)까지 유효하고, 3월 1일부터는 배율이 3배에서 6배로 오릅니다. Ultrafast에 장기적으로 의존하는 제품이라면 미리 예산을 따져 봐야겠죠. GPT-6.2 Astra와 Sol은 현재 Flex 등급이 없는데, 나중에 추가되면 비동기 작업 선택지가 더 넓어질 거예요.
Astra의 비동기 기능을 계획 중인 팀이라면 먼저 APIYI apiyi.com에서 테스트 크레딧으로 백그라운드 모드와 폴링 로직을 끝까지 돌려 보고, 마감 시간과 작업 의존성을 요구사항 문서에 적어 둔 뒤에 등급 선택을 논의하는 걸 권합니다.
《논어·자로》에 「욕속부달(欲速則不達)」, 즉 “서두르면 이루지 못한다”는 말이 있죠. GPT-6.2 Astra의 가격표 위에서 이 말은 곧 가격이 됩니다. 몇 시간만 더 기다리면 모델 비용을 30~40% 덜 낼 수 있으니까요.
📚 참고 자료
-
OpenAI 발표 공지: Introducing GPT-6.2 Astra and Sol (2026-11-17)
- 링크:
openai.com/index/introducing-gpt-6-2-astra-sol/ - 설명: 모델 포지셔닝 및 가격 조정 안내
- 링크:
-
GPT-6.2 Astra 모델 카드: 사양, 단문맥 및 장문맥 요율
- 링크:
developers.openai.com/api/docs/models/gpt-6.2-astra - 설명: 컨텍스트 길이, 272K 장문맥 가격 책정 규칙
- 링크:
-
OpenAI API 업데이트 로그: 2026-11-17 모델 출시 및 백그라운드 윈도우 항목
- 링크:
developers.openai.com/api/docs/changelog - 설명: 백그라운드 완료 윈도우 공개 베타 및 할인 비율
- 링크:
-
OpenAI API 가격표: 처리 등급별 단가
- 링크:
developers.openai.com/api/docs/pricing - 설명: Standard, Fast, Ultrafast, Batch 요율
- 링크:
-
Background mode 가이드: 백그라운드 모드, 완료 윈도우 및 후속 요청
- 링크:
developers.openai.com/api/docs/guides/background - 설명: 할인 조건, continuation_id, 대기 할당량 및 캐시 경계
- 링크:
-
Batch API / Fast / Ultrafast 가이드
- 링크:
developers.openai.com/api/docs/guides/batch,developers.openai.com/api/docs/guides/fast-mode,developers.openai.com/api/docs/guides/ultrafast-mode - 설명: 각 제출 방식의 적용 조건
- 링크:
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 홈페이지에서 저희에게 연락해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.