著者メモ:H3-Imageは、H3のマルチモーダル基盤アーキテクチャを再利用し、画像専用のコンポーネントを組み合わせたうえで、学習と推論のパイプラインも最適化し直した、独立した画像生成モデルです。この記事では、何を継承し、何を削り、何を新たに加えたのかを順に見ていきます。
MiniMax H3のアーキテクチャを理解する前に押さえたい6つの用語
以降の本文で繰り返し登場する概念を、まず一言ずつ説明しておきます。
| 用語 | やさしい説明 | MiniMax H3での役割 |
|---|---|---|
| Transformer | 系列データを処理するニューラルネットワークで、系列内の各要素同士の関係を捉えるのが得意 | H3-Omni-Transformerはモデルファミリー全体の中核 |
| DiT | Transformerで実装した拡散モデル。少しずつノイズを取り除きながらコンテンツを生成する | H3-Imageの本体は、33.1Bパラメータのシングルストリam DiT |
| VAE | ピクセルと圧縮表現の間でエンコードとデコードを行うモデル。「圧縮器+解凍器」のようなもの | H3は映像用VAEと音声用VAEを使い、H3-Imageでは画像専用VAEに置き換え |
| 潜在変数 | 元データを圧縮したコンパクトな表現。この空間で計算すれば、ピクセルを直接処理するよりずっと効率的 | Transformerが予測する対象は、ピクセルではなく潜在変数 |
| RoPE | 回転位置エンコーディング。各トークンが系列のどこにあるかをモデルに伝える | H3は3D Multimodal RoPEで時間と空間の位置を表現 |
| 蒸留 | 本来は多くのステップが必要な複雑なプロセスを、少ないステップで完了できるように学習し直すこと | H3-Imageはわずか6回のサンプリングステップに蒸留されている |
2026年11月、MiniMaxはH3-Image画像生成モデルの重みを公開しました。3か月前にオープンソース化されたH3は、ステレオ音声付きの動画を生成できるモデルでした。今回の新モデルもパラメータ規模は同じ33B級で、中核となるアーキテクチャもH3から来ています。
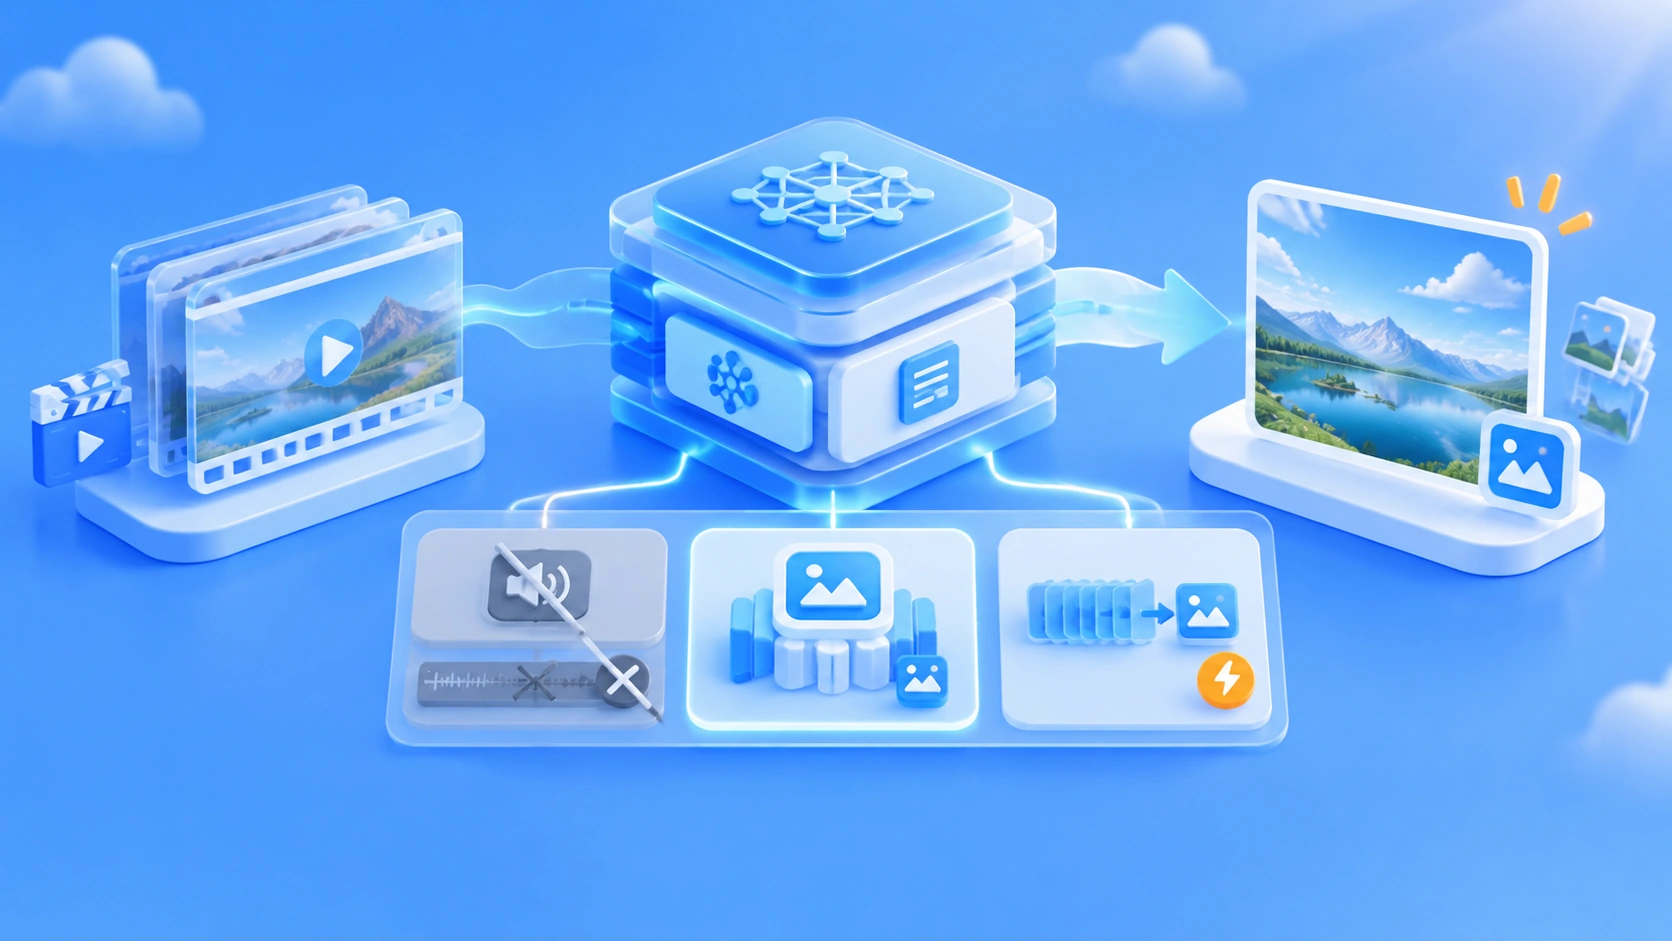
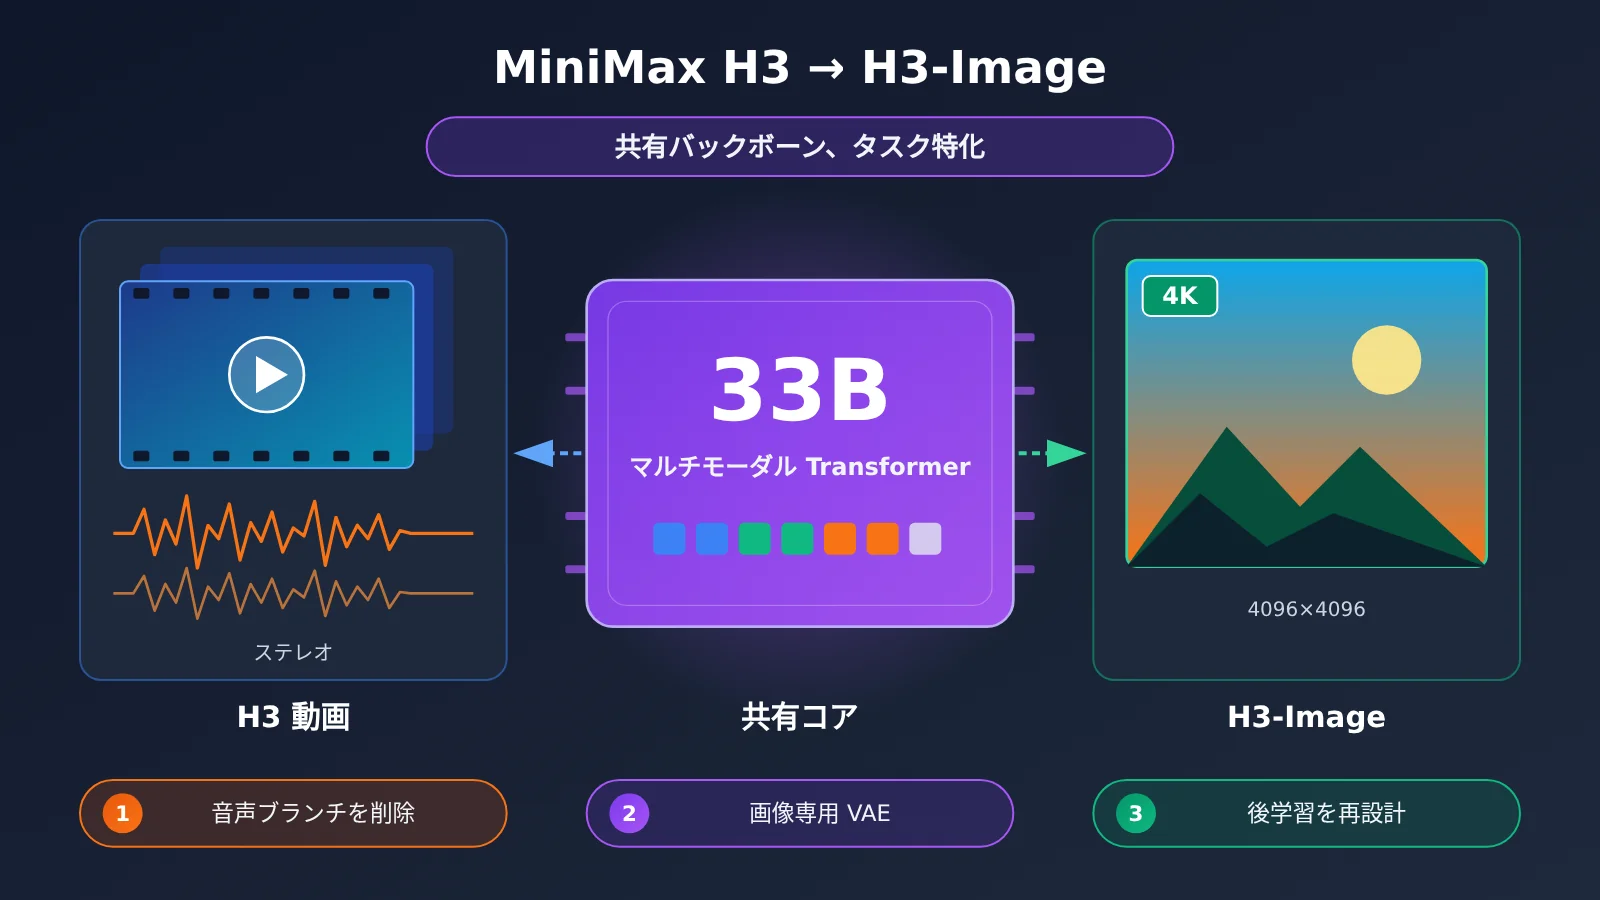
これは「動画モデルの出力を1フレームにしただけ」という単純な話ではありません。 H3-Imageの公式モデルカードとリリースブログによると、H3の中核であるマルチモーダルTransformerとテキストエンコーダーは引き続き使われています。一方で、音声生成のブランチは取り除かれ、画像専用のVAEに置き換えられ、画像タスク向けに後学習(ポストトレーニング)と推論のフローも作り直されています。
この記事で得られること:同じ33Bアーキテクチャを動画から画像へ展開する際に、具体的にどこを変更したのか、それぞれなぜ変更が必要だったのかがわかります。さらに、公式が確認している事実と、業界レベルの推測にとどまるものも区別して整理します。
MiniMax H3:動画から画像へ、MiniMaxが公開したもの
まずは時系列を整理しておきましょう。「MiniMax H3がオープンソース化」というニュースを見て、2回の公開を混同してしまう人は少なくありません。実際には、H3とH3-Imageは別々のリリースで、間には約3か月の開きがあります。
| 時期 | イベント | 説明 |
|---|---|---|
| 2026-07-31 | MiniMaxがH3モデルを発表 | 公式技術ブログでH3のアーキテクチャを初めて公開 |
| 2026-08-03 | MiniMax H3の重みを正式公開 | 全モダリティ対応の動画生成モデル。オープンソース化されたのはH3-Base |
| 2026-11-10 | H3-Image Community Licenseの記載日 | 画像生成モデルの重みを公開 |
| 2026-11-11 | MiniMaxの英語版公式ブログでH3-Imageを紹介 | ポストトレーニングと推論最適化の詳細を公開 |
MiniMax H3とH3-Imageのタスク上の位置づけ
2つのモデルが担うタスクはまったく異なります。H3は全モダリティ対応の動画生成システムで、テキスト・画像・動画・音声の入力を同時に理解できます。出力は4〜15秒、24 FPSで、32kHzのネイティブステレオ音声付きの動画です。デフォルトの出力は短辺768pxで、フルワークフローでは最大2Kまで対応します。一方のH3-Imageは、高解像度の画像生成と編集に特化しています。公式スペックでは最大約16MP(4096×4096など)で、10秒以内に4K画像を生成できるとされています。
そこで、本記事の核心となる疑問が浮かびます。「音声付きの動画」を作るモデルと、「高解像度の静止画」を作るモデルが、なぜ同じ技術ファミリーに属しているのでしょうか。その答えは、H3の基盤設計の中にあります。
MiniMax H3 の基盤アーキテクチャ:統合マルチモーダル Transformer
H3 の中核は H3-Omni-Transformer と呼ばれています。公式の技術紹介によると、約 33B パラメータのシングルストリーム型・Dense 型 Transformer です。「シングルストリーム」とは、モダリティごとに独立したネットワークを使うのではなく、あらゆる情報を 1 本のシーケンスにまとめ、同じパラメータで一括処理する方式を指します。「Dense 型」とは、MoE のように一部のエキスパートだけを活性化するのではなく、すべてのトークンが全パラメータを通って計算されることを意味します。
MiniMax H3 は各モダリティをどうエンコードするのか
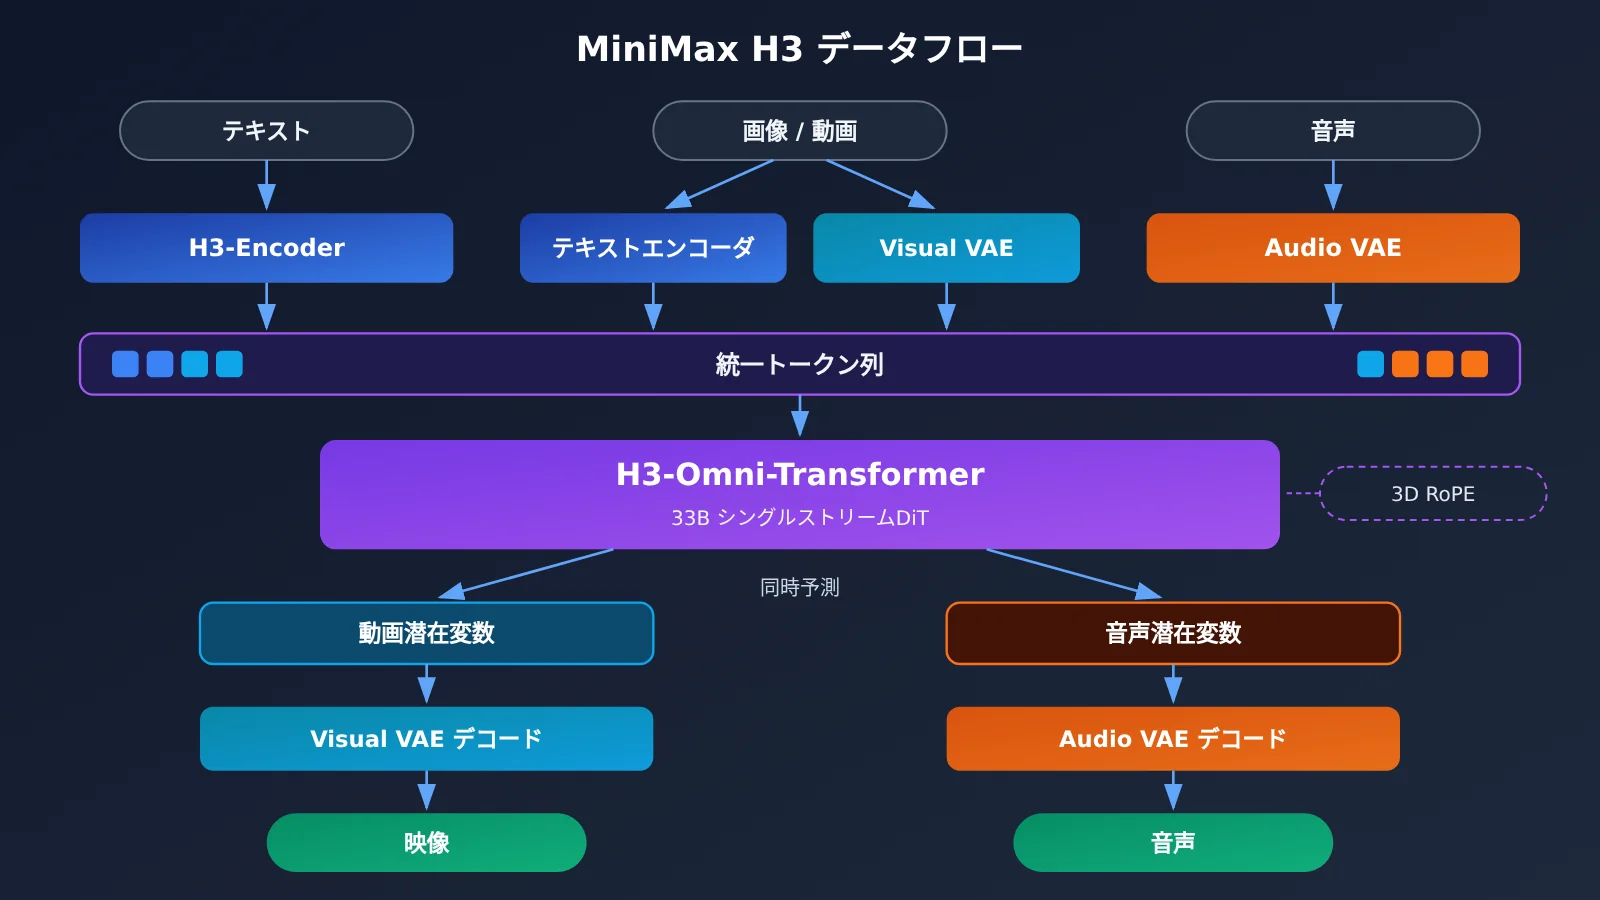
公式が公開している処理の流れは、おおよそ次のとおりです。
- テキスト:H3-Encoder で意味表現にエンコードし、「画面で何を起こしたいのか」をモデルに伝えます。
- 画像と動画:テキストエンコーダーと Visual VAE の両方を通します。前者は画面内容の意味を理解する役割、後者はピクセルを潜在変数に圧縮する役割を担います。
- 音声:Audio VAE で音声の潜在変数に圧縮します。
- 統合シーケンス:上記の各モダリティの表現を 1 本のシーケンスにまとめ、Transformer に入力します。
- 同時予測:Transformer が動画と音声の潜在変数を同時に予測し、それぞれ対応する VAE でデコードして映像と音を生成します。
これは「みんなが同じ言語を話している」状態だと考えるとわかりやすいでしょう。元の入力が一文でも、一枚の画像でも、一曲の音楽でも、Transformer に入る前にはトークン列へと変換されます。モデルはトークンがどのモダリティから来たかを気にせず、トークン同士の関係を見つけ出して、目的のトークンを生成することだけに集中します。
3D Multimodal RoPE の役割
動画には時間軸と 2 次元の空間があります。そのため H3 は、位置のエンコードに 3D Multimodal RoPE を採用しています。各トークンは、画面内の縦横の座標だけでなく、自分が何フレーム目に属しているかも把握できます。公式もこの設計を明確に確認しています。これは後ほど H3-Image を理解するうえで重要なポイントです。なぜなら、1 枚の画像は「時間次元がわずか 1 フレームしかない」特殊なケースとみなせるからです。
【私たちの推論】 H3 は最初から「統合シーケンス+統合 Transformer」として設計されています。「テキストを入れて動画を出す」という単一タスク向けのパイプラインではありません。だからこそ、そのバックボーンネットワークには、ほかの生成タスクへ転用できる土台があるのだと考えられます。この点について公式は直接このようには述べておらず、アーキテクチャ設計から私たちが導き出した判断です。
MiniMax H3-Image が継承したもの、削除したもの、追加したもの
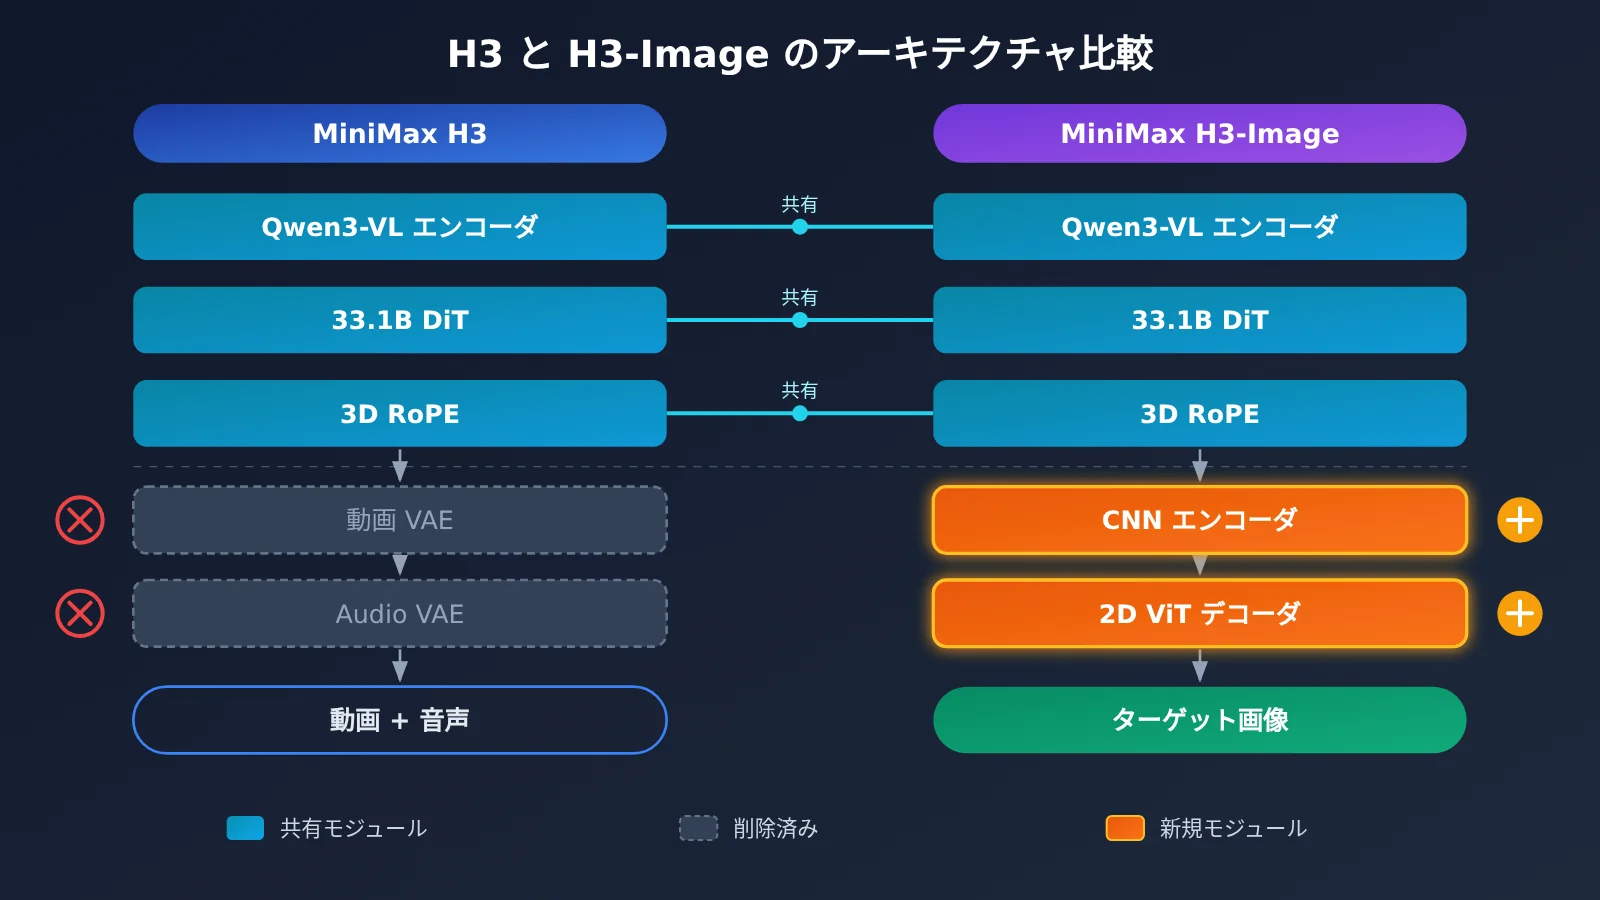
ここは、H3-Image の技術的な進化の中でもとくに注目したいパートです。次の表は、H3-Image の公式モデルカードをもとに整理しました。
| 区分 | コンポーネント | 具体的な内容 |
|---|---|---|
| 継承 | Qwen3-VL テキストエンコーダー | H3 のテキストエンコーダーをそのまま踏襲し、第 50 層の隠れ状態を使用 |
| 継承 | 33.1B シングルストリーム DiT | H3-Omni-Transformer のコアアーキテクチャを維持 |
| 継承 | 3D Multimodal RoPE | 位置関係のエンコードに引き続き使用 |
| 削除 | 音声ブランチ | 動画と音声の同時生成は行わない |
| 置換 | 画像専用 VAE | CNN エンコーダー + 24 層の 2D ViT デコーダー |
| 変更 | 生成ターゲット | テキストと参照画像を統一シーケンスとしてエンコードし、ターゲット画像の潜在変数を予測 |
継承その1:Qwen3-VL テキストエンコーダーと第 50 層の隠れ状態
H3-Image のモデルカードによると、H3 で使われていた Qwen3-VL ベースのテキストエンコーダーをそのまま引き継ぎ、第 50 層の隠れ状態を条件入力として使っています。Qwen3-VL はそもそも視覚言語モデルなので、テキストを読み取れるだけでなく、参照画像の内容も理解できます。これは、複数の参照画像を使った編集に欠かせない能力です。
【業界でよくある手法】 なぜ最終層ではなく中間層を使うのかについて、公式は詳しく説明していません。一般的には、言語モデルの最後の数層は「次の単語を予測する」ことに特化していくため、中間層のほうがより豊かで汎用的な意味特徴を保持していると考えられています。多くの拡散モデルでも、似たようなアプローチが採用されています。
継承その2:33.1B の DiT と 3D RoPE
H3-Image の DiT 本体のスペックは次のとおりです。
| パラメータ | 数値 | わかりやすく言うと |
|---|---|---|
| パラメータ数 | 33.1B | H3 の約 33B のバックボーンと同じ規模 |
| 層数 | 50 層 | 情報が 50 回の変換を通る |
| Hidden Size | 5376 | 各トークンの表現次元 |
| Attention Heads | 56 | 56 通りの視点で、トークン同士の関係を同時に捉える |
| FFN Size | 14336 | 各層のフィードフォワードネットワークの中間幅 |
| VAE 空間ダウンサンプリング | 16 倍 | 一辺 4096 ピクセルを 256 に圧縮 |
| 潜在変数チャンネル | 24 | 潜在変数の各位置が 24 個の数値を持つ |
| 1 トークンがカバーする範囲 | 約 32×32 ピクセル | シーケンス長と計算量を左右する |
「1 トークンが約 32×32 ピクセルに対応する」として計算すると、4096×4096 の画像はおよそ 128×128 = 16384 トークンになります(これは公式のパラメータをもとに私たちが行った推定です)。さらに複数の参照画像を加えるとシーケンスはいっそう長くなり、推論速度の最適化がこのモデルにとって重要な理由もここにあります。
【私たちの推論】 3D RoPE は画像タスクでも引き続き役立つと考えられます。ターゲット画像は 1 フレームだけですが、複数の参照画像とターゲット画像をシーケンス内で「どれがどれか」区別する必要があり、追加された次元がその区別を担えるからです。公式は具体的な位置の割り当て方式を公表していないため、ここで述べたのはあくまで筋の通った一つの解釈です。
削除:音声ブランチを外す
画像には時間的な長さも音声もありません。音声ブランチを残しても、学習と推論のリソースを無駄にするだけです。これを取り除くことで、モデルの学習目標は「動画と音声の同時分布」から「画像の分布」へと絞り込まれ、学習シグナルもより集中したものになります。
置き換え:画像専用VAE
H3のVisual VAEは、動画の時間的な連続性にも対応する必要がありました。一方、H3-Imageでは、静止画専用に設計されたVAEに置き換えられています。エンコーダにはCNNを採用しており、局所的なテクスチャを効率よく抽出するのが得意です。デコーダは24層の2D ViTで、ピクセルを復元する際に全体の構造も考慮できます。16倍のダウンサンプリングと24チャンネルの組み合わせは、少ない空間位置と多めのチャンネルで情報を保持するということです。これは16MPクラスの高解像度出力にとって重要なポイントになります。公式も、H3-Imageの高解像度の結果は直接生成されたものであり、従来のような超解像アップスケーラーに頼っているわけではないと強調しています。
変化:「動画+音声の予測」から「ターゲット画像の予測」へ
最終的な生成の流れはこうです。テキストプロンプトと参照画像をまとめて1つの統一シーケンスにエンコードし、DiT が潜在変数空間で少しずつノイズを除去して、ターゲット画像の潜在変数を予測します。それを画像 VAE でデコードすると、最終的な画像になります。参照画像の枚数については、モデルカードでは上限が16枚とされていますが、vLLM のデプロイ手順(レシピ)では最大9枚と書かれています。基準が異なるため、実際に使える枚数は利用する推論フレームワークに合わせて確認してください。
MiniMax H3-Image は、より速く・より使いやすくするためにどんな最適化をしたのか
アーキテクチャを変えるだけでは十分ではありません。MiniMax は H3-Image のリリースブログで、H3 の事前学習で得た能力を引き継ぎつつ、後続の学習工程を5つの面で改善したと述べています。具体的には、学習データ、強化学習、サンプリングステップ数の圧縮、プロンプト拡張(Prompt Enhancement)、デプロイの最適化です。データと強化学習の詳細は公式から公開されていないため、ここでは公開情報が比較的多い部分を中心に紹介します。
6ステップのサンプリング蒸留とCFGの廃止
拡散モデルの画像生成は「ノイズから出発して、一歩ずつノイズを取り除いていく」プロセスで、通常は数十ステップが必要です。さらに、従来の拡散モデルでは CFG(Classifier-Free Guidance)もよく使われます。これは、各ステップで「プロンプトあり」と「プロンプトなし」の2回を別々に実行し、その結果を一定の比率で混合することで、プロンプトへの忠実度を高める手法です。
H3-Image は蒸留によってサンプリングを6ステップまで圧縮し、そのうえ CFG も不要にしました。前者はステップ数を大幅に減らし、後者は各ステップのフォワード計算を1回だけに抑えます。33.1B パラメータで、1枚の画像が1万トークン以上になるモデルにとって、この2つを組み合わせることが、公式の「10秒で4K生成」という主張を支える技術的な土台になっています。ただし、10秒というのはベンダーの公表値であり、実際の速度はハードウェアやデプロイ構成によって変わる点にご注意ください。
プロンプト拡張:短い説明を実行可能な指示に書き広げる
H3-Image には、オプションの PE(Prompt Enhancement)モデルが用意されています。重みは約17.9GBで、ユーザーが入力した短い説明を、より詳細でモデルが理解しやすいプロンプトに書き広げる役割を担います。この追加モデルをすぐにデプロイしたくない場合は、汎用の大規模言語モデルを使って同様の前処理を行うこともできます。以下は最小限のサンプルです。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェースを使用
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把这句扩写成详细的图像生成提示词:雨夜的赛博朋克街头"}]
)
print(resp.choices[0].message.content)
プロンプト拡張の完全な実装を見る
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是图像生成提示词工程师。请把用户的简短描述扩写为结构化提示词,"
    "依次包含:主体、构图、光线、材质细节、色彩、镜头与画幅。"
    "如果用户提供了参考图说明,请明确每张参考图在画面中的作用。"
    "只输出提示词正文,不要解释。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"参考图{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# 例:空き部屋 + 家具の参照画像によるリビングの合成
print(enhance_prompt(
    "把这些家具摆进空客厅,北欧风,午后自然光",
    ["空房间照片", "灰色布艺沙发", "橡木茶几", "落地灯"],
))
おすすめ:画像生成ワークフローを構築する際、プロンプトの前処理は、まず APIYI(apiyi.com)経由で複数の主要な大規模言語モデルに接続し、モデルごとの拡張結果を比較してから、専用の PE モデルをデプロイするかどうかを決めるとよいでしょう。モデル名はプラットフォームのモデル一覧に従ってください。
デプロイ最適化と高解像度対応
公式が推奨するデプロイフレームワークは SGLang、vLLM-Omni、Diffusers、ComfyUI です。対応ハードウェアとしては NVIDIA H200、RTX PRO 6000 Blackwell、AMD Instinct MI350X などが挙げられており、マルチ GPU 並列の構成も用意されています。画像 VAE の高い圧縮率、CFG なしの 6 ステップサンプリング、フレームワークレベルの推論最適化。この 3 つが組み合わさって、はじめて 16:9(5472×3072)、9:16(3072×5472)、21:9(6272×2688)といった高解像度の画角を直接出力できるようになっています。
MiniMax H3 のアーキテクチャ再利用がもたらす影響
開発者への影響
- 土台は共有しているが、入れ替えはできない:H3 と H3-Image はテキストエンコーダーを共有しており、モデルカードでは「共有の H3 テキストエンコーダー」(約 66.7GB)と記載されています。ただし DiT の重みと VAE はそれぞれ独立しているため、H3 の動画用重みをそのまま使って画像を生成することはできません。
- デプロイのハードルは依然として高い:画像メインモデルは約 68.65GB で、テキストエンコーダーを加えると完全なダウンロードサイズは約 135.35GB になります。これはあくまでストレージ容量の話で、必要な VRAM 容量とは別物です。
- ライセンスは別々に確認が必要:H3 と H3-Image はそれぞれ別の Community License で、適用条件にも明確な違いがあります。詳しくは下の表をご覧ください。
| 項目 | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| オープンソース範囲 | H3-Base のみ。Context-IR と Regenerate-2K は公式 API の利用が必要 | 画像モデルの重み、共有テキストエンコーダー、オプションの PE モデル |
| ローカルで得られる効果 | 768p の音声付き動画生成。2K のフルワークフローは公式 API に依存 | 公式によると最大約 16MP を直接出力可能 |
| 商用ライセンスの適用条件 | 商用製品・サービスの年間収益が 2000 万ドルを超える場合 | あなた自身や関連会社の年換算収益が 100 万ドルを超える場合、または第三者にホスティングサービスを提供する場合 |
| その他の義務 | 地域制限などはライセンス原文を要確認 | 地域制限、出力物の利用、製品表示などはライセンス原文を要確認 |
比較に関する注意:上の表は 2 つのライセンス原文と公式モデルカードをもとに整理したもので、技術選定の参考用です。法的アドバイスではありません。自前でのデプロイやライセンス取得がすぐには難しい場合は、まず APIYI(apiyi.com)経由で他の主要な画像モデルやマルチモーダルモデルを呼び出し、ワークフローのプロトタイプを作ってみるのもおすすめです。
業界への影響
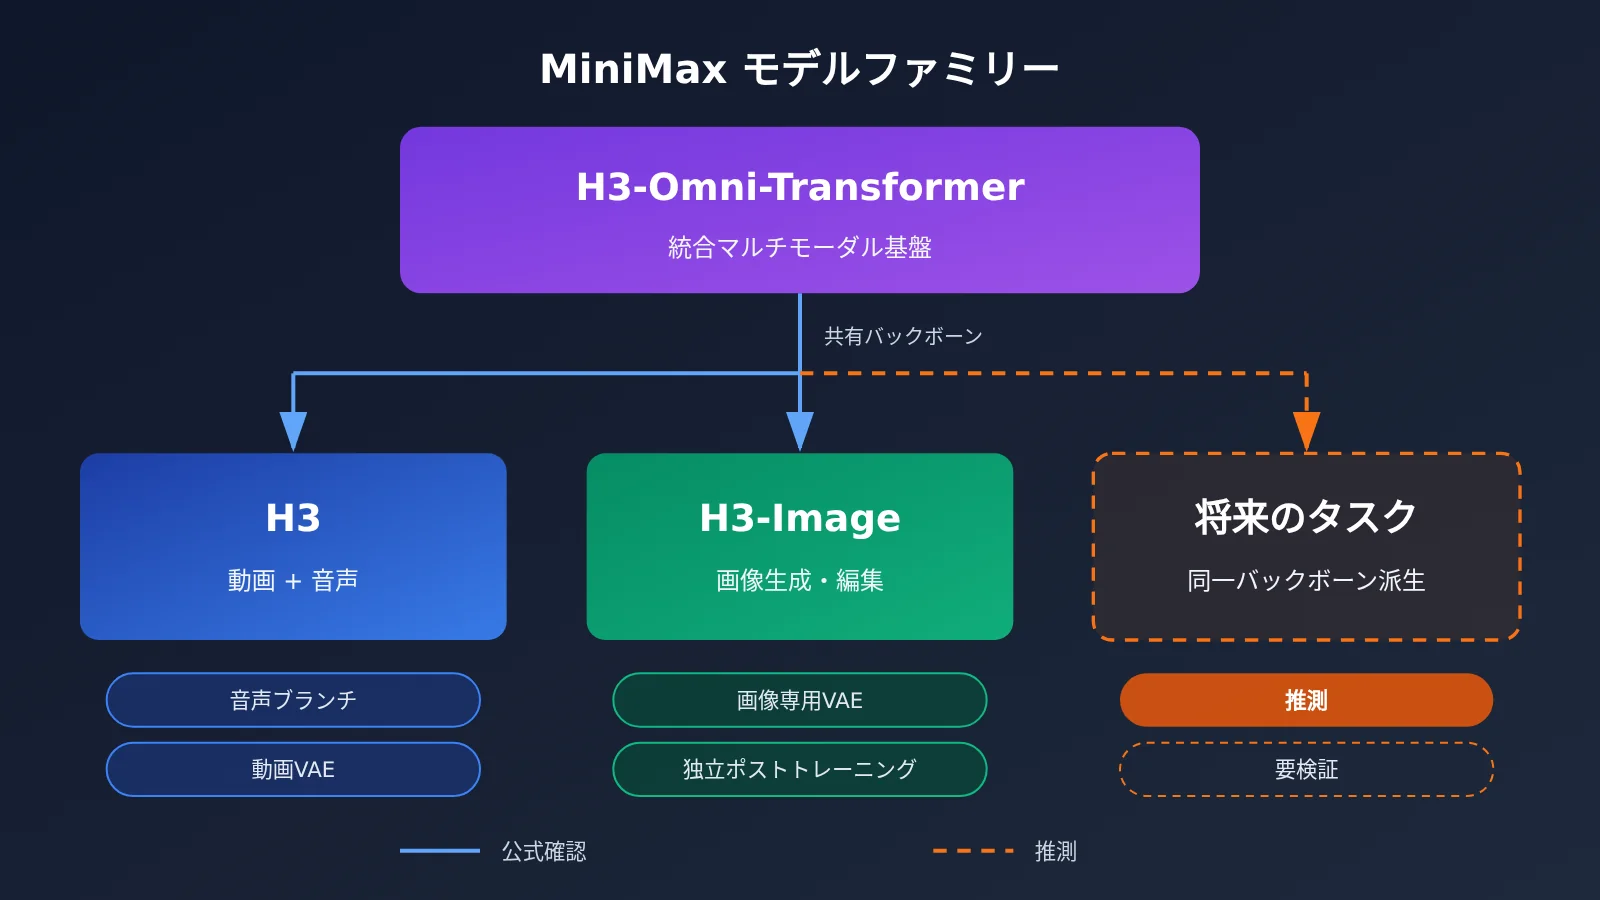
【公式確認】 H3-Image は H3 のコア Transformer とテキストエンコーダーを再利用しつつ、専用の VAE と独立したポストトレーニングのプロセスを採用しています。
【当方の推論】 このことから、動画生成と画像生成は、意味理解、マルチモーダルのアラインメント、空間位置のモデリングといった基礎能力の多くを共有できる一方で、タスクごとに専用のエンコード・デコード部品と、それに合わせた学習が必要だと考えられます。MiniMax のアプローチは、生成タスクごとにモデルをゼロから学習するのではなく、「まず統一されたマルチモーダルの土台を作り、そこからタスク別に特化させる」という形に近いと言えそうです。この路線がうまくいけば、同じバックボーンをベースにした派生モデルが今後さらに増える可能性がありますが、現時点では業界内での推測にとどまります。
よくある質問 FAQ
Q1:H3-Image は H3 の動画モデルを、そのまま画像出力に切り替えたものですか?
いいえ、違います。H3-Image は H3 の Qwen3-VL テキストエンコーダ、33.1B のシングルストリーム DiT アーキテクチャ、3D RoPE を引き継いでいます。一方で音声ブランチは取り除かれ、画像専用の VAE(CNN エンコーダ+2D ViT デコーダ)に置き換えられています。さらに、データ、強化学習、蒸留などの後学習も個別に行われています。
Q2:MiniMax H3 と H3-Image は、なぜパラメータ数がほぼ同じなのですか?
両者のコアとなる Transformer が同じアーキテクチャに基づいているためです。H3 は約 33B、H3-Image の DiT は 33.1B です。パラメータ数が近いのは、バックボーンネットワークがそのまま保持されているからで、違いは主にエンコーダ/デコーダ部分と学習目標に表れています。
Q3:H3-Image は結局、何枚の参照画像に対応していますか?
公式モデルカードに記載されている上限は 16 枚ですが、vLLM のデプロイレシピでは最大 9 枚となっています。前者はメーカーによる公称値、後者は特定のフレームワークでのテスト構成です。実際に使うときは、選んだ推論フレームワークの仕様に従ってください。
Q4:6 ステップサンプリングで CFG をなくしても、画質に影響はありませんか?
公式は、蒸留後も高品質な出力を維持できるとしています。ただ、現時点で公開されているのは主にメーカー自身によるデモです。実際のユースケースで比較テストを行い、複雑な指示への追従性や、複数の参照画像を組み合わせたときの結果を重点的に確認することをおすすめします。
Q5:H200 クラスの GPU がない場合、画像生成ワークフローはどう検証すればよいですか?
まずはクラウド API でワークフローを動かしてみましょう。
1. APIYI(apiyi.com)に登録し、APIキーと無料のテスト枠を入手します
2. 本記事のプロンプト拡張コード(base_url は `https://api.apiyi.com/v1`)で前処理部分を組みます
3. プラットフォームにある主要な画像生成モデルを接続し、パイプライン全体を検証してから、自前でのデプロイを検討します
Q6:H3-Image をデプロイして、外部向けに API サービスを提供できますか?
十分に慎重な判断が必要です。H3-Image のライセンスでは、第三者にホスティングサービスを提供する場合、収益規模にかかわらず、事前に MiniMax からの書面による許可が必要とされています。詳細な条項はライセンス原文を必ず確認し、必要に応じて法務の専門家にご相談ください。
MiniMax H3 アーキテクチャ進化の要点 Key Takeaways
- 同じ土台、異なる用途:H3-Image は H3 のコア Transformer とテキストエンコーダーを再利用しており、単に出力モードを切り替えただけではありません
- 3つの重要な改造:音声ブランチの削除、画像専用 VAE への置き換え、生成ターゲットを画像の潜在変数予測に変更
- 意味理解は Qwen3-VL から:第50層の隠れ状態を取り出し、テキストと参照画像を同時に理解します
- 速度は蒸留によるもの:6ステップのサンプリングで CFG が不要。公式の「10秒で4K」という主張を支える技術的な基盤です
- ライセンスは分けて考える:H3-Image のホスティングサービスと、収益100万ドルのしきい値は、どちらもライセンス取得の対象になります
- 検証してからデプロイ:まず APIYI(apiyi.com)で複数モデルを使ってプロトタイプを作り、そのうえでセルフホストのコストを検討するのがおすすめです
まとめ
MiniMax H3 が動画から画像へと進化した流れは、次の3点に集約できます。
- 共通の土台:33B クラスのシングルストリーム・マルチモーダル Transformer、Qwen3-VL テキストエンコーダー、3D RoPE がそのまま引き継がれています。
- タスク専用化:音声ブランチを削除し、CNN + 2D ViT の画像 VAE を採用。生成ターゲットも、動画+音声の潜在変数から画像の潜在変数へと変わりました。
- 学習と推論の作り直し:データ、強化学習、6ステップ・CFG なしの蒸留、プロンプト拡張、デプロイ最適化が組み合わさり、16MP クラスの出力を支えています。
開発者にとって本当に掘り下げる価値があるのは、「どの能力を共有でき、どの能力は専用に学習する必要があるのか」、そしてモデルの重みの裏にあるハードウェアコストとライセンス上の義務です。セルフホストするかどうかを決める前に、まず APIYI(apiyi.com)の統一インターフェースで複数のモデルを比較し、画像ワークフローを素早く動かしてみることをおすすめします。
📚 参考資料
- MiniMax H3 公式技術紹介:H3-Omni-Transformer アーキテクチャの説明
- リンク:
minimax.io/blog/minimax-h3 -
説明:マルチモーダルのエンコードパスと 3D Multimodal RoPE についての公式解説
-
MiniMax H3-Image 公式リリースブログ:ポストトレーニングと推論の最適化
- リンク:
minimax.io/blog/minimax-h3-image -
説明:データ、強化学習、6ステップ蒸留、プロンプト拡張などの改善点
-
H3-Image Hugging Face モデルカード:アーキテクチャの全パラメータ
- リンク:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
説明:DiT、VAE、テキストエンコーダーの具体的なスペック
-
H3 オリジナルモデルカードとライセンス:動画モデルのスペックと利用許諾条件
- リンク:
huggingface.co/MiniMaxAI/MiniMax-H3 -
説明:H3 のスペックと、
blob/main/LICENSEに記載されたライセンス原文 -
H3-Image ライセンス原文:商用利用の条件
- リンク:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
説明:ホスティングサービスや収益のしきい値などの条項
-
vLLM デプロイレシピ:フレームワークでのテスト構成
- リンク:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - 説明:参照画像の枚数など、フレームワーク側の基準
著者:APIYI 技術チーム
技術交流:APIYI(apiyi.com)のトップページからお気軽にお問い合わせください。さらに詳しい資料は docs.apiyi.com のドキュメントセンターでご覧いただけます。