
Примечание автора: H3-Image унаследовала от H3 мультимодальную базовую архитектуру, получила специализированные компоненты для изображений, а обучение и инференс для неё оптимизировали заново. В итоге получилась самостоятельная модель генерации изображений. В статье разбираем, что именно она унаследовала, что убрали и что добавили.
6 терминов, которые нужно знать, чтобы разобраться в архитектуре MiniMax H3
Ниже несколько понятий, которые будут часто встречаться дальше. Сначала объясним каждое одной фразой.
| Термин | Простыми словами | Роль в MiniMax H3 |
|---|---|---|
| Transformer | Нейросеть для обработки последовательностей, хорошо улавливает связи между элементами последовательности | H3-Omni-Transformer — ядро всего семейства моделей |
| DiT | Диффузионная модель на базе Transformer, генерирует контент путём постепенного удаления шума | Основа H3-Image — однопоточный DiT на 33,1 млрд параметров |
| VAE | Модель, которая кодирует и декодирует данные между пикселями и сжатым представлением — своего рода «упаковщик + распаковщик» | В H3 используются визуальный и аудио VAE, в H3-Image — VAE, специализированный под изображения |
| Латентные переменные | Компактное представление исходных данных после сжатия. Считать в этом пространстве заметно дешевле, чем работать с пикселями напрямую | Transformer предсказывает именно латентные переменные, а не пиксели |
| RoPE | Ротационное позиционное кодирование: подсказывает модели, где в последовательности стоит каждый токен | H3 использует 3D Multimodal RoPE для кодирования времени и пространственных позиций |
| Дистилляция | Обучение модели выполнять сложный многошаговый процесс всего за несколько шагов | H3-Image дистиллирована до 6 шагов сэмплирования |
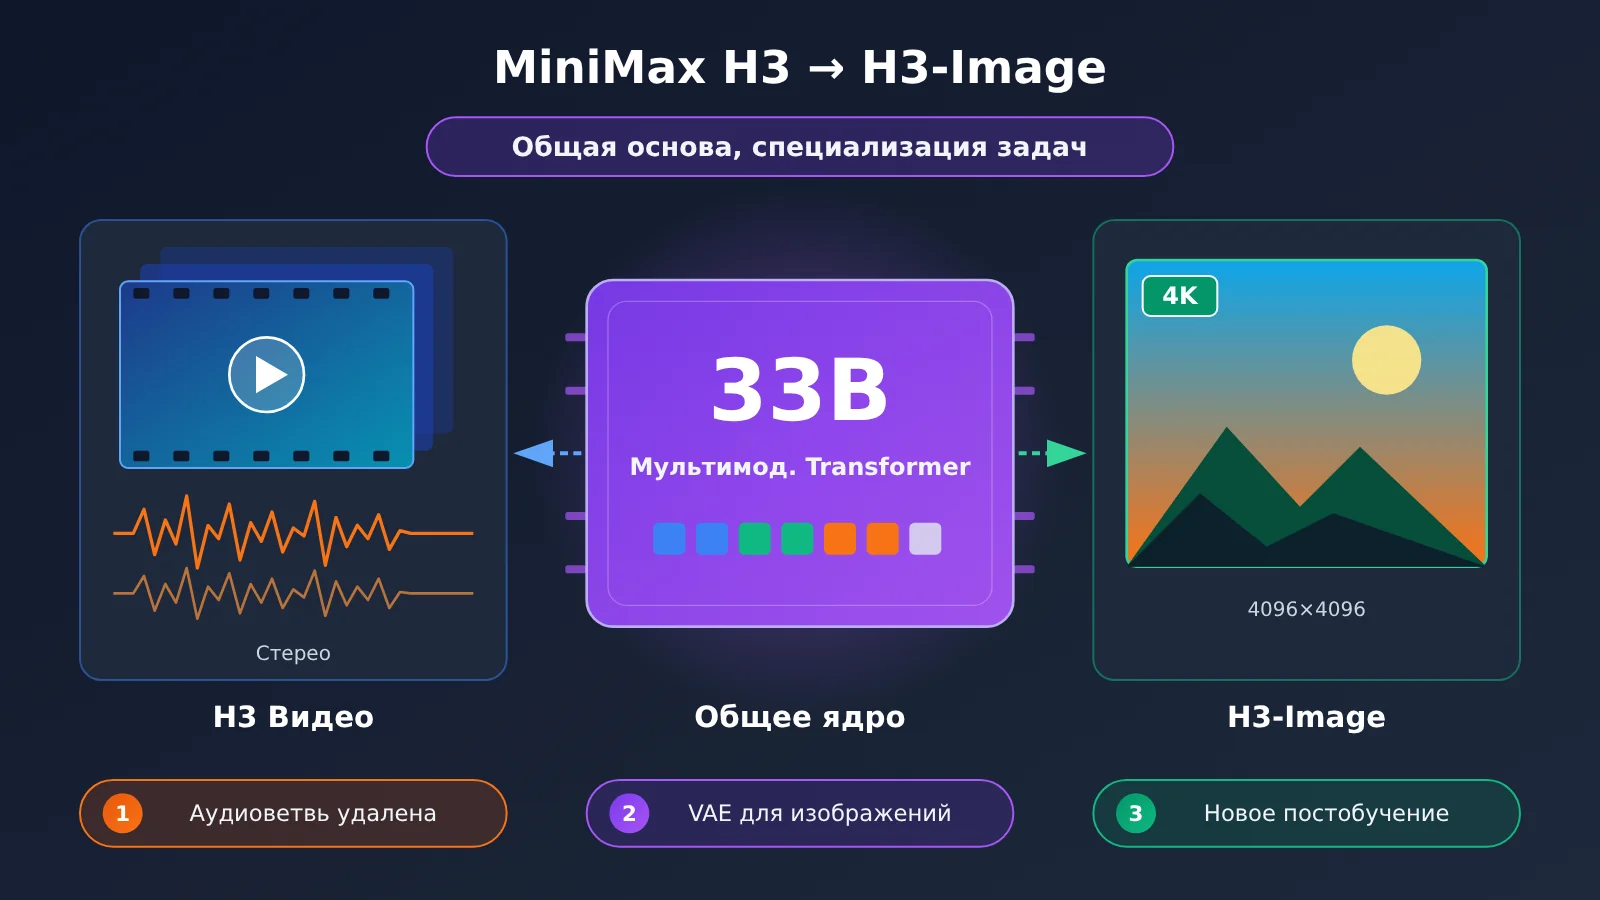
В ноябре 2026 года MiniMax открыла веса модели генерации изображений H3-Image. H3, открытая тремя месяцами ранее, умеет генерировать видео со стереозвуком. Новая модель близка к ней по размеру (порядка 33 млрд параметров), а её ядро тоже пришло из H3.
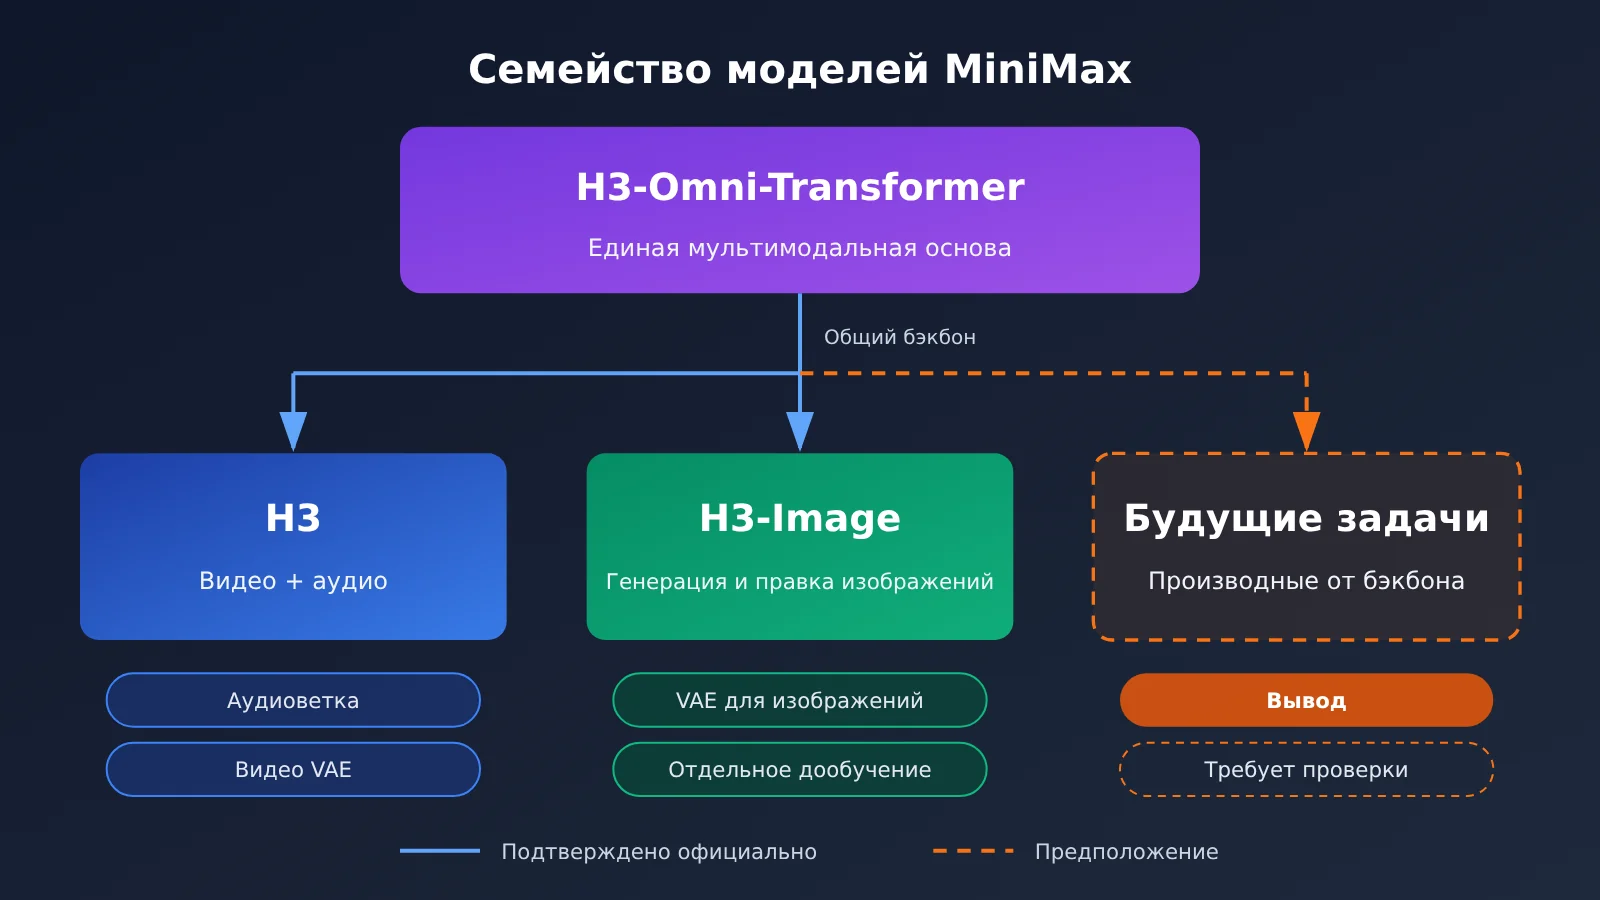
Это не просто «видеомодель, у которой на выходе один кадр». В официальной карточке модели и в блоге о релизе H3-Image говорится: она сохранила основной мультимодальный Transformer и текстовый энкодер из H3, лишилась ветки генерации аудио, получила специализированный VAE для изображений, а пост-обучение и инференс для неё перерабатывали под задачи работы с картинками.
Что вы получите от статьи: поймёте, какие именно части одной и той же 33B-архитектуры изменились при переходе от видео к изображениям, зачем это сделали, а также что подтверждено официально, а что остаётся лишь отраслевыми предположениями.
MiniMax H3: от видео к изображениям — что выпустила MiniMax
Сначала разберёмся с хронологией. Когда люди видят новость «MiniMax H3 в open source», они часто путают два разных релиза. H3 и H3-Image — это разные модели, и между их выходами прошло около трёх месяцев.
| Дата | Событие | Пояснение |
|---|---|---|
| 2026-07-31 | MiniMax представила модель H3 | В официальном техническом блоге впервые раскрыта архитектура H3 |
| 2026-08-03 | MiniMax H3 официально открыла веса | Омни-модальная модель генерации видео; в открытый доступ вышла H3-Base |
| 2026-11-10 | Дата в лицензии H3-Image Community License | Открыты веса модели генерации изображений |
| 2026-11-11 | В официальном англоязычном блоге MiniMax вышел материал о H3-Image | Опубликованы детали посттренинга и оптимизации инференса |
Для каких задач нужны MiniMax H3 и H3-Image
Задачи у этих моделей совершенно разные. H3 — это омни-модальная система генерации видео. Она одновременно понимает текст, изображения, видео и аудио на входе, а на выходе выдаёт ролики длиной 4–15 секунд, 24 FPS, с нативным стереозвуком 32 кГц. По умолчанию короткая сторона кадра — 768 px, а в полном рабочем процессе разрешение доходит до 2K. H3-Image, в свою очередь, сфокусирована на генерации и редактировании изображений в высоком разрешении. По официальным характеристикам, максимальный размер — около 16 МП (например, 4096×4096), а 4K-изображение, как заявляется, создаётся менее чем за 10 секунд.
Отсюда главный вопрос этой статьи: одна модель делает «видео со звуком», другая — «статичные картинки в высоком разрешении». Почему они вообще относятся к одному технологическому семейству? Ответ кроется в базовой архитектуре H3.
Базовая архитектура MiniMax H3: единый мультимодальный Transformer
Ядро H3 называется H3-Omni-Transformer. Согласно официальному техническому описанию, это одноструйный (single-stream) плотный (dense) Transformer примерно на 33B параметров. «Одноструйный» значит, что информация разных модальностей идёт не через отдельные независимые сети, а склеивается в одну последовательность и обрабатывается одним и тем же набором параметров. «Плотный» значит, что каждый токен проходит через все параметры, а не только через часть экспертов, как в MoE.
Как MiniMax H3 кодирует разные модальности
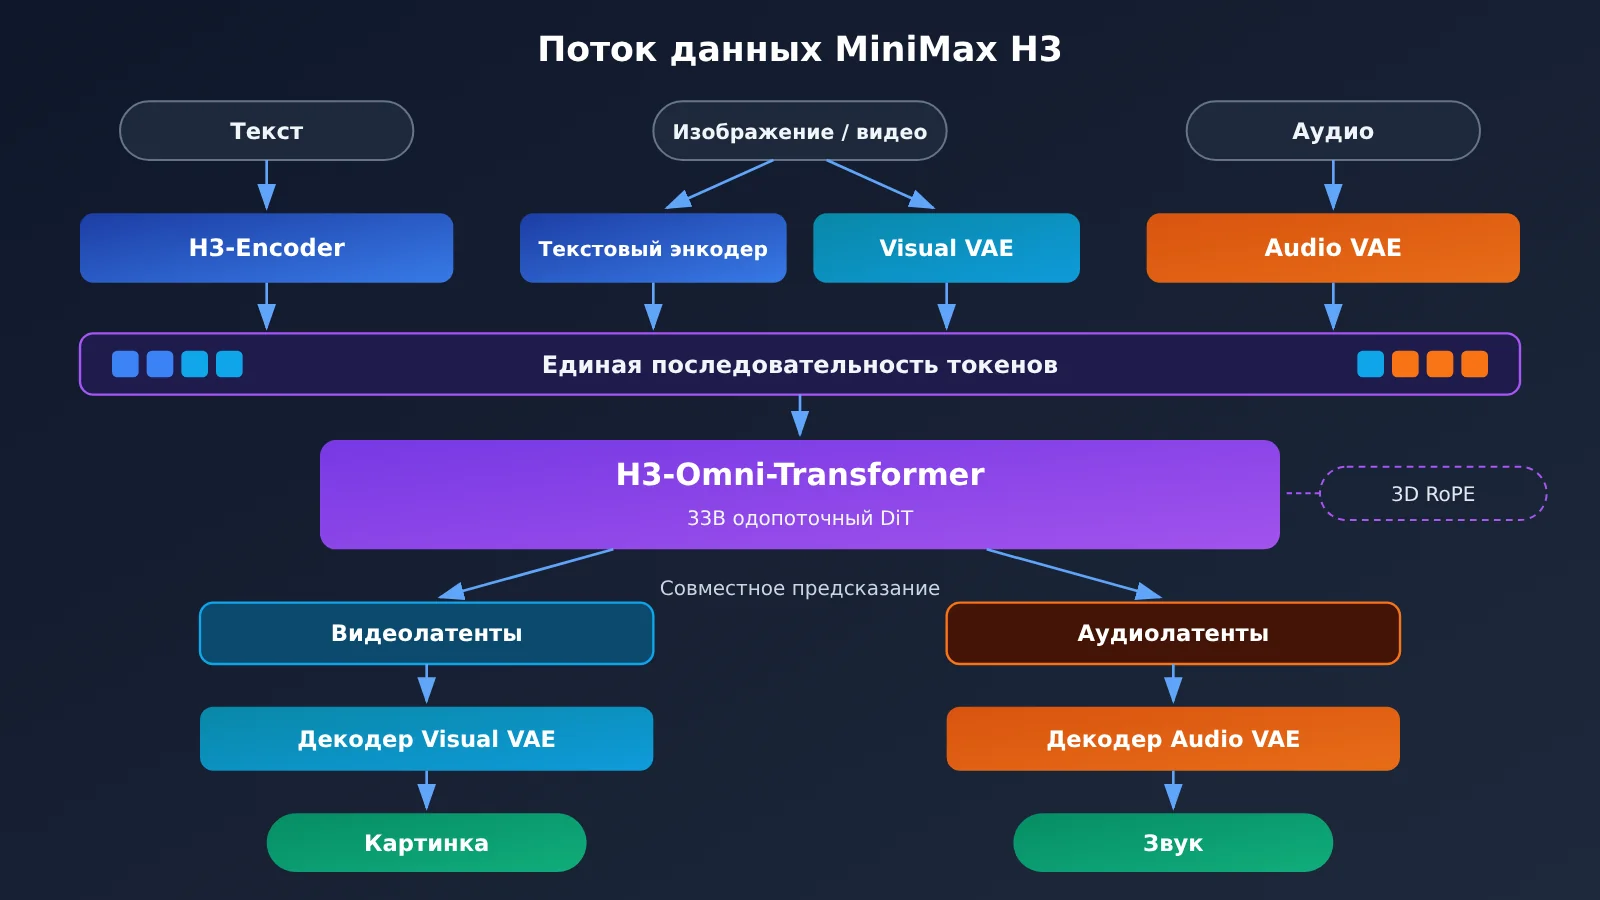
Официально заявленный путь обработки выглядит примерно так:
- Текст: кодируется в семантическое представление через H3-Encoder. Так модель узнаёт, что именно вы хотите увидеть в кадре.
- Изображения и видео: проходят сразу через текстовый кодировщик и Visual VAE. Первый отвечает за семантику, то есть за понимание содержимого кадра, а второй сжимает пиксели в латентные переменные.
- Аудио: сжимается в аудиолатенты через Audio VAE.
- Единая последовательность: представления всех перечисленных модальностей собираются в одну последовательность и подаются в Transformer.
- Совместное предсказание: Transformer одновременно предсказывает латенты видео и аудио, после чего каждый из них декодируется своим VAE в картинку и звук.
Можно представить, что все «говорят на одном языке». Будь то фраза, картинка или музыка, перед входом в Transformer всё превращается в последовательность токенов. Модели всё равно, из какой модальности пришёл токен: её задача — найти связи между токенами и сгенерировать целевые.
Зачем нужен 3D Multimodal RoPE
У видео есть и временная ось, и двумерное пространство, поэтому H3 кодирует позиции с помощью 3D Multimodal RoPE. Токену нужно знать не только свои координаты по горизонтали и вертикали, но и номер кадра, к которому он относится. Эту схему официально подтвердили. Она важна для понимания H3-Image: изображение можно считать частным случаем, когда по оси времени всего один кадр.
【Наш вывод】 Раз H3 с самого начала строился как «единая последовательность + единый Transformer», а не как узкий конвейер «текст на входе — видео на выходе», его базовую сеть можно переносить на другие задачи генерации. Официально так это не формулировали, это наше суждение, сделанное на основе архитектуры.
Что MiniMax H3-Image унаследовала, а что убрала и добавила
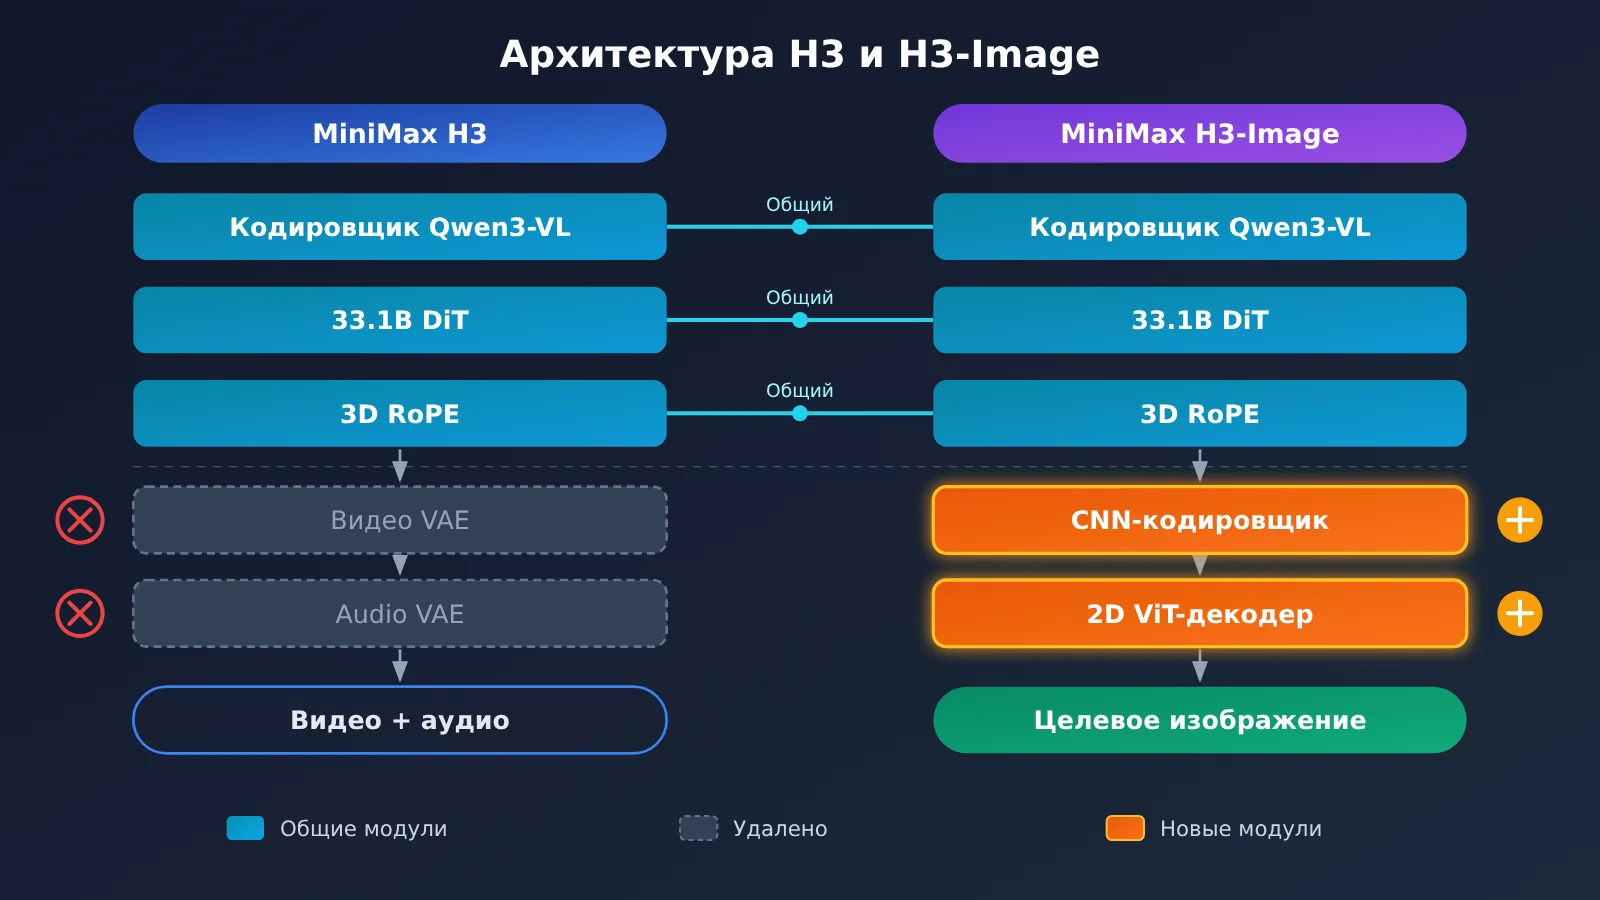
Эта часть эволюции модели самая интересная. Таблица ниже составлена по официальной карточке модели H3-Image:
| Категория | Компонент | Что сделано |
|---|---|---|
| Унаследовано | Текстовый энкодер Qwen3-VL | Взят полный текстовый энкодер из H3, используются скрытые состояния 50-го слоя |
| Унаследовано | 33.1B одно-потоковый DiT | Сохранена базовая архитектура H3-Omni-Transformer |
| Унаследовано | 3D Multimodal RoPE | По-прежнему кодирует позиционные связи |
| Удалено | Аудиоветка | Совместная генерация видео и аудио больше не поддерживается |
| Заменено | VAE, специализированный для изображений | CNN-энкодер + 2D ViT-декодер из 24 слоёв |
| Изменено | Цель генерации | Текст и эталонные изображения кодируются в единую последовательность, а модель предсказывает латенты целевого изображения |
Что унаследовано: текстовый энкодер Qwen3-VL и скрытые состояния 50-го слоя
Как сказано в карточке модели, H3-Image использует текстовый энкодер на базе Qwen3-VL из H3, а в качестве условного входа берёт скрытые состояния его 50-го слоя. Qwen3-VL — это визуально-языковая модель, поэтому она понимает не только текст, но и содержимое эталонных изображений. Именно это и нужно для редактирования по нескольким эталонным изображениям.
【Распространённая практика в индустрии】 Почему берётся промежуточный слой, а не последний, официально не объясняется. В индустрии обычно считают так: последние слои языковой модели больше заточены под «предсказание следующего слова», а промежуточные хранят более богатые и универсальные семантические признаки. Похожий подход используют многие диффузионные модели.
Наследие второе: 33.1B DiT и 3D RoPE
Основные параметры DiT в H3-Image такие:
| Параметр | Значение | Простыми словами |
|---|---|---|
| Число параметров | 33.1B | Тот же порядок, что и у базовой сети H3 (около 33B) |
| Число слоёв | 50 | Информация проходит через 50 преобразований |
| Hidden Size | 5376 | Размерность представления каждого токена |
| Attention Heads | 56 | Связи между токенами учитываются сразу с 56 разных сторон |
| FFN Size | 14336 | Промежуточная ширина feed-forward-сети в каждом слое |
| Пространственный даунсэмплинг VAE | 16× | Сторона в 4096 пикселей сжимается до 256 |
| Каналы латента | 24 | Каждая позиция латента несёт 24 числа |
| Покрытие одним токеном | около 32×32 пикселей | Определяет длину последовательности и объём вычислений |
Если считать, что один токен соответствует примерно 32×32 пикселям, то изображение 4096×4096 даёт около 128×128 = 16384 токенов (это наша оценка на основе официальных параметров). Добавьте несколько эталонных изображений — и последовательность станет ещё длиннее. Отсюда понятно, почему оптимизация скорости инференса так важна для этой модели.
【Наш вывод】 3D RoPE полезен и в задачах с изображениями. Целевое изображение состоит всего из одного кадра, но эталонные изображения и целевое нужно как-то различать в последовательности: «кто есть кто». Дополнительная ось как раз может взять эту роль на себя. Конкретную схему распределения позиций официально не раскрывали, так что это лишь разумное предположение.
Удаляем: аудиоветку
У изображения нет ни длительности, ни звука, так что держать аудиоветку — значит зря тратить ресурсы на обучение и инференс. Когда её убирают, цель обучения модели сужается: вместо «совместного распределения видео и аудио» остаётся просто «распределение изображений», и обучающий сигнал становится более сфокусированным.
Заменяем: VAE для изображений
Visual VAE в H3 приходится учитывать временную непрерывность видео. В H3-Image его заменили на VAE, который с самого начала проектировали для статичных изображений. Энкодер построен на CNN и хорошо справляется с эффективным извлечением локальных текстур. Декодер — 2D ViT из 24 слоёв, который при восстановлении пикселей учитывает ещё и глобальную структуру. Даунсэмплинг в 16 раз в сочетании с 24 каналами означает, что информация хранится в меньшем числе пространственных позиций, но в большем числе каналов. Для вывода в высоком разрешении уровня 16 МП это критически важно. Разработчики также подчёркивают: результаты H3-Image в высоком разрешении генерируются напрямую, а не получаются с помощью традиционных апскейлеров.
Что изменилось: от «предсказания видео и аудио» к «предсказанию целевого изображения»
Итоговый процесс генерации выглядит так: текстовый промпт и эталонные изображения кодируются в единую последовательность, DiT шаг за шагом убирает шум в латентном пространстве и предсказывает латент целевого изображения, а затем VAE для изображений декодирует его в финальную картинку. Что касается числа эталонных изображений, в карточке модели указан максимум в 16 штук, а в рецепте развёртывания для vLLM — не более 9. Цифры считаются по-разному, поэтому реальное количество зависит от того, какой фреймворк инференса вы используете.
Какие оптимизации MiniMax сделала, чтобы H3-Image работала быстрее и удобнее
Одной смены архитектуры недостаточно. В блоге о выходе H3-Image MiniMax пишет, что, сохранив возможности предобучения H3, компания улучшила процесс пост-обучения по пяти направлениям: обучающие данные, обучение с подкреплением, сжатие числа шагов сэмплирования, улучшение промптов (Prompt Enhancement) и оптимизация развёртывания. Подробности про данные и обучение с подкреплением официально не раскрываются, поэтому дальше сосредоточимся на тех частях, о которых известно больше.
6-шаговая дистилляция сэмплирования и отказ от CFG
Диффузионная модель генерирует изображение так: стартует с шума и шаг за шагом его убирает. Обычно для этого нужно несколько десятков шагов. Кроме того, классические диффузионные модели почти всегда используют CFG (Classifier-Free Guidance): на каждом шаге модель прогоняется дважды — с промптом и без него, — после чего результаты смешиваются в нужной пропорции. Это помогает точнее следовать промпту.
H3-Image с помощью дистилляции сжимает сэмплирование до 6 шагов и при этом обходится без CFG. Первое резко сокращает количество шагов, второе позволяет выполнять на каждом шаге только один прямой проход. Для модели на 33,1B параметров, где одно изображение занимает больше десяти тысяч токенов, именно сочетание этих двух приёмов лежит в основе официального заявления «4K за 10 секунд». Учтите: 10 секунд — это заявление производителя, а реальная скорость зависит от железа и конфигурации развёртывания.
Усиление промпта: превращаем короткое описание в готовую инструкцию
В H3-Image есть необязательная PE-модель (Prompt Enhancement), вес которой около 17,9 ГБ. Она расширяет короткое описание пользователя до более подробного промпта, который модели проще понять. Если разворачивать дополнительную модель пока не хочется, похожую предобработку можно сделать с помощью универсальной большой языковой модели. Вот минимальный пример:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Используем единый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把这句扩写成详细的图像生成提示词:雨夜的赛博朋克街头"}]
)
print(resp.choices[0].message.content)
Полная реализация усиления промпта
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是图像生成提示词工程师。请把用户的简短描述扩写为结构化提示词,"
    "依次包含:主体、构图、光线、材质细节、色彩、镜头与画幅。"
    "如果用户提供了参考图说明,请明确每张参考图在画面中的作用。"
    "只输出提示词正文,不要解释。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"参考图{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# Пример: композиция гостиной из пустой комнаты и эталонных изображений мебели
print(enhance_prompt(
    "把这些家具摆进空客厅,北欧风,午后自然光",
    ["空房间照片", "灰色布艺沙发", "橡木茶几", "落地灯"],
))
Совет: когда выстраиваете воркфлоу генерации изображений, этап предобработки промпта можно сначала подключить через APIYI (apiyi.com) к нескольким популярным большим языковым моделям, сравнить, как каждая из них расширяет описание, и только потом решать, стоит ли разворачивать отдельную PE-модель. Актуальные названия моделей смотрите в списке моделей на платформе.
Оптимизация развёртывания и поддержка высоких разрешений
Официально рекомендуемые фреймворки для развёртывания: SGLang, vLLM-Omni, Diffusers и ComfyUI. Из поддерживаемого железа заявлены NVIDIA H200, RTX PRO 6000 Blackwell, AMD Instinct MI350X и другие, а для нескольких GPU есть схемы параллельного запуска. Высокая степень сжатия в VAE для изображений, 6-шаговая выборка без CFG и оптимизации инференса на уровне фреймворка работают вместе, и только благодаря этому модель может напрямую выдавать изображения в высоком разрешении: 16:9 (5472×3072), 9:16 (3072×5472), 21:9 (6272×2688) и других форматах.
Влияние переиспользования архитектуры MiniMax H3
Что это значит для разработчиков
- Общая основа, но не взаимозаменяемость: H3 и H3-Image используют один и тот же текстовый энкодер. В карточке модели он указан как «общий текстовый энкодер H3» (около 66,7 ГБ). Но веса DiT и VAE у них свои, так что видеовеса H3 нельзя просто взять и использовать для генерации изображений.
- Порог для развёртывания по-прежнему высокий: основная модель для изображений занимает около 68,65 ГБ, вместе с текстовым энкодером полная загрузка составляет примерно 135,35 ГБ. И это только объём хранилища, а не требования к видеопамяти.
- Лицензии нужно читать отдельно: у H3 и H3-Image две разные Community License, и условия, при которых нужна коммерческая лицензия, заметно отличаются. Подробности в таблице ниже.
| Параметр | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| Что открыто | Только H3-Base; Context-IR и Regenerate-2K доступны через официальный API | Веса модели для изображений, общий текстовый энкодер, опциональная PE-модель |
| Что можно получить локально | Генерация аудио и видео в 768p; полный 2K-пайплайн зависит от официального API | По заявлению разработчиков, можно напрямую получать изображения до ~16 МП |
| Когда нужна коммерческая лицензия | Годовой доход от коммерческих продуктов и сервисов превышает 20 млн долларов США | Ваш годовой доход и/или доход аффилированных лиц превышает 1 млн долларов США или вы предоставляете хостинг-сервис третьим лицам |
| Прочие обязательства | Региональные ограничения и т. п. — смотрите в оригинале лицензии | Региональные ограничения, использование результатов, маркировка продукта и т. п. — смотрите в оригинале лицензии |
Пояснение к сравнению: таблица составлена по текстам двух лицензий и официальным карточкам моделей и носит справочный характер для технического выбора. Это не юридическая консультация. Если самостоятельное развёртывание или получение лицензии пока невозможны, можно собрать прототип пайплайна, вызывая другие популярные модели для изображений и мультимодальные модели через APIYI (apiyi.com).
Что это значит для индустрии
【Подтверждено официально】 H3-Image переиспользует основной Transformer и текстовый энкодер H3, но при этом имеет специализированный VAE и отдельный процесс пост-обучения.
【Наш вывод】 Похоже, что генерация видео и изображений может делить немалую часть базовых способностей: понимание семантики, мультимодальное выравнивание, моделирование пространственного положения. Однако для каждой задачи всё равно нужны свои компоненты кодирования и декодирования и целевое обучение. Подход MiniMax больше похож на «сначала сделать единую мультимодальную основу, а затем специализировать её под задачи», а не на обучение модели с нуля для каждого типа генерации. Если этот путь сработает, скорее всего, появится больше производных моделей на одной и той же базовой сети, но пока это лишь отраслевое предположение.
Часто задаваемые вопросы (FAQ)
Q1: H3-Image — это просто видеомодель H3, переключённая на вывод изображений?
Нет. H3-Image унаследовала от H3 текстовый энкодер Qwen3-VL, одноканальную (single-stream) архитектуру DiT на 33,1B параметров и 3D RoPE, но аудиоветку убрали. Вместо неё используется VAE, заточенный под изображения: CNN-энкодер и 2D ViT-декодер. Кроме того, для неё отдельно провели пост-обучение: подготовили данные, применили обучение с подкреплением и дистилляцию.
Q2: Почему у MiniMax H3 и H3-Image почти одинаковое число параметров?
Потому что в основе обеих моделей лежит один и тот же Transformer: у H3 около 33B параметров, у DiT в H3-Image — 33,1B. Близкие цифры говорят о том, что базовую сеть сохранили целиком. Различия в основном в компонентах кодирования и декодирования и в целях обучения.
Q3: Сколько эталонных изображений на самом деле поддерживает H3-Image?
В официальной карточке модели указан максимум в 16 изображений, а в рецепте развёртывания для vLLM — не более 9. Первое — заявление разработчика, второе — тестовая конфигурация конкретного фреймворка. На практике ориентируйтесь на тот инференс-фреймворк, который вы выбрали.
Q4: Не страдает ли качество картинки из-за 6-шагового сэмплирования и отказа от CFG?
По заявлению разработчиков, после дистилляции модель по-прежнему выдаёт качественный результат. Но пока в открытом доступе в основном демонстрации от самой компании. Советую провести сравнительные тесты на ваших задачах и обратить особое внимание на следование сложным инструкциям и на работу с несколькими эталонными изображениями одновременно.
Q5: У меня нет видеокарты уровня H200. Как заранее проверить рабочий процесс генерации изображений?
Сначала можно отладить весь процесс через облачный API:
1. Зарегистрируйтесь на APIYI (apiyi.com), получите API-ключ и бесплатный тестовый лимит.
2. Возьмите код улучшения промптов из этой статьи (base_url — `https://api.apiyi.com/v1`) и настройте этап предобработки.
3. Подключите любую из доступных на платформе популярных моделей для генерации изображений, проверьте всю цепочку и только потом решайте, стоит ли разворачивать модель у себя.
Q6: Можно ли развернуть H3-Image и предоставлять API-сервис другим?
Тут нужна особая осторожность. По лицензии H3-Image, для предоставления хостинга любым третьим лицам нужно заранее получить письменное разрешение MiniMax, причём независимо от размера выручки. Точные условия смотрите в оригинале лицензии, а при необходимости проконсультируйтесь с юристом.
Ключевые выводы: эволюция архитектуры MiniMax H3 (Key Takeaways)
- Один фундамент, разные задачи: H3-Image использует то же ядро Transformer и тот же текстовый энкодер, что и H3. Это не просто переключение режима вывода.
- Три ключевые доработки: убрана аудиоветка, подключён VAE, заточенный под изображения, а цель генерации теперь — предсказание латентов изображения.
- Семантика — от Qwen3-VL: берутся скрытые состояния 50-го слоя, и модель одновременно понимает и текст, и эталонные изображения.
- Скорость даёт дистилляция: 6 шагов сэмплирования без CFG — техническая основа официального заявления «4K за 10 секунд».
- С лицензиями разбирайтесь отдельно: и хостинговый сервис H3-Image, и порог выручки в 1 млн долларов требуют получения лицензии.
- Сначала проверьте, потом разворачивайте: можно собрать прототип на нескольких моделях через APIYI (apiyi.com), а затем оценить стоимость самостоятельного развёртывания.
Итоги
Путь MiniMax H3 от видео к изображениям можно свести к трём пунктам:
- Общая основа: однопоточный мультимодальный Transformer уровня 33B, текстовый энкодер Qwen3-VL и 3D RoPE сохранены полностью.
- Специализация под задачу: аудиоветку убрали, поставили VAE для изображений на базе CNN + 2D ViT, а цель генерации сменилась с латентов видео и аудио на латенты изображения.
- Переделанные обучение и инференс: данные, обучение с подкреплением, дистилляция до 6 шагов без CFG, улучшение промптов и оптимизация развёртывания вместе обеспечивают вывод уровня 16MP.
Разработчикам стоит присмотреться к двум вопросам: какие способности можно переиспользовать, а какие обязательно нужно обучать отдельно, и сколько стоит железо под весами и какие лицензионные обязательства за ними стоят. Прежде чем решать, разворачивать ли модель у себя, лучше сначала сравнить несколько моделей через единый интерфейс APIYI (apiyi.com) и быстро прогнать свой пайплайн работы с изображениями.
📚 Справочные материалы
- Официальное техническое описание MiniMax H3: архитектура H3-Omni-Transformer
- Ссылка:
minimax.io/blog/minimax-h3 -
Описание: официальный разбор мультимодального пути кодирования и 3D Multimodal RoPE
-
Официальный блог о релизе MiniMax H3-Image: пост-обучение и оптимизация инференса
- Ссылка:
minimax.io/blog/minimax-h3-image -
Описание: улучшения в данных, обучении с подкреплением, 6-шаговой дистилляции, усилении промптов и не только
-
Карточка модели H3-Image на Hugging Face: полные параметры архитектуры
- Ссылка:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
Описание: конкретные спецификации DiT, VAE и текстового энкодера
-
Исходная карточка модели H3 и лицензия: характеристики видеомодели и условия использования
- Ссылка:
huggingface.co/MiniMaxAI/MiniMax-H3 -
Описание: спецификации H3 и полный текст лицензии в
blob/main/LICENSE -
Полный текст лицензии H3-Image: условия коммерческого использования
- Ссылка:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
Описание: условия по хостингу сервисов, порогам по выручке и другие положения
-
Рецепт развёртывания через vLLM: тестовая конфигурация фреймворка
- Ссылка:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - Описание: параметры на стороне фреймворка, например количество эталонных изображений
Автор: техническая команда APIYI
Обсуждение: пишите нам на главной странице APIYI apiyi.com, а больше материалов найдёте в центре документации docs.apiyi.com


