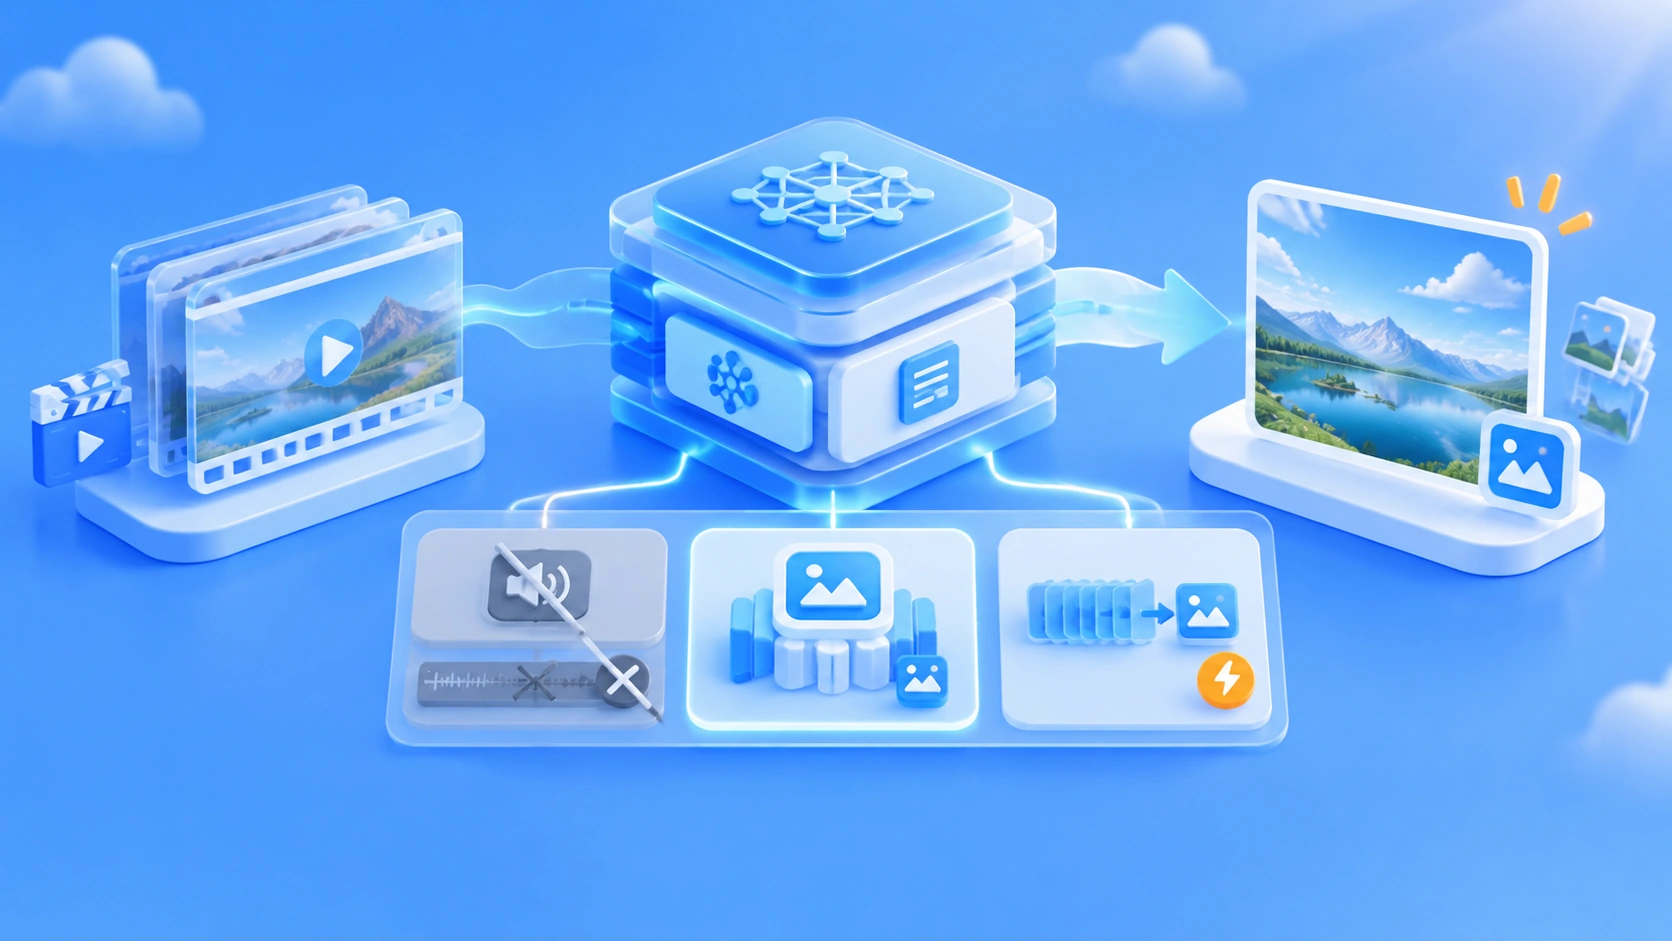
Nota do autor: o H3-Image reaproveita a base multimodal do H3, ganha componentes específicos para imagem e passa por um treinamento e um pipeline de inferência reotimizados, até virar um modelo independente de geração de imagens. Este artigo mostra o que ele herdou, o que removeu e o que acrescentou.
6 termos para entender antes de ler sobre a arquitetura do MiniMax H3
Os conceitos abaixo aparecem várias vezes ao longo do texto, então vamos explicar cada um em uma frase.
| Termo | Explicação simples | Papel no MiniMax H3 |
|---|---|---|
| Transformer | Rede neural que processa dados em sequência e é boa em capturar as relações entre os elementos dessa sequência | O H3-Omni-Transformer é o núcleo de toda a família de modelos |
| DiT | Modelo de difusão implementado com Transformer, que gera conteúdo removendo ruído passo a passo | O corpo do H3-Image é um DiT de fluxo único com 33,1B de parâmetros |
| VAE | Modelo que codifica e decodifica entre pixels e uma representação comprimida, como um “compressor + descompressor” | O H3 usa um VAE visual e um VAE de áudio; o H3-Image troca por um VAE específico para imagem |
| Variável latente | Representação compacta dos dados originais depois de comprimidos; calcular nesse espaço sai bem mais barato do que trabalhar direto com pixels | O que o Transformer prevê são as variáveis latentes, não os pixels |
| RoPE | Codificação de posição rotacional, que diz ao modelo a posição de cada token na sequência | O H3 usa o 3D Multimodal RoPE para expressar posições no tempo e no espaço |
| Destilação | Treinar um processo complexo, que originalmente precisava de muitos passos, para ser concluído em poucos passos | O H3-Image foi destilado para precisar de apenas 6 passos de amostragem |
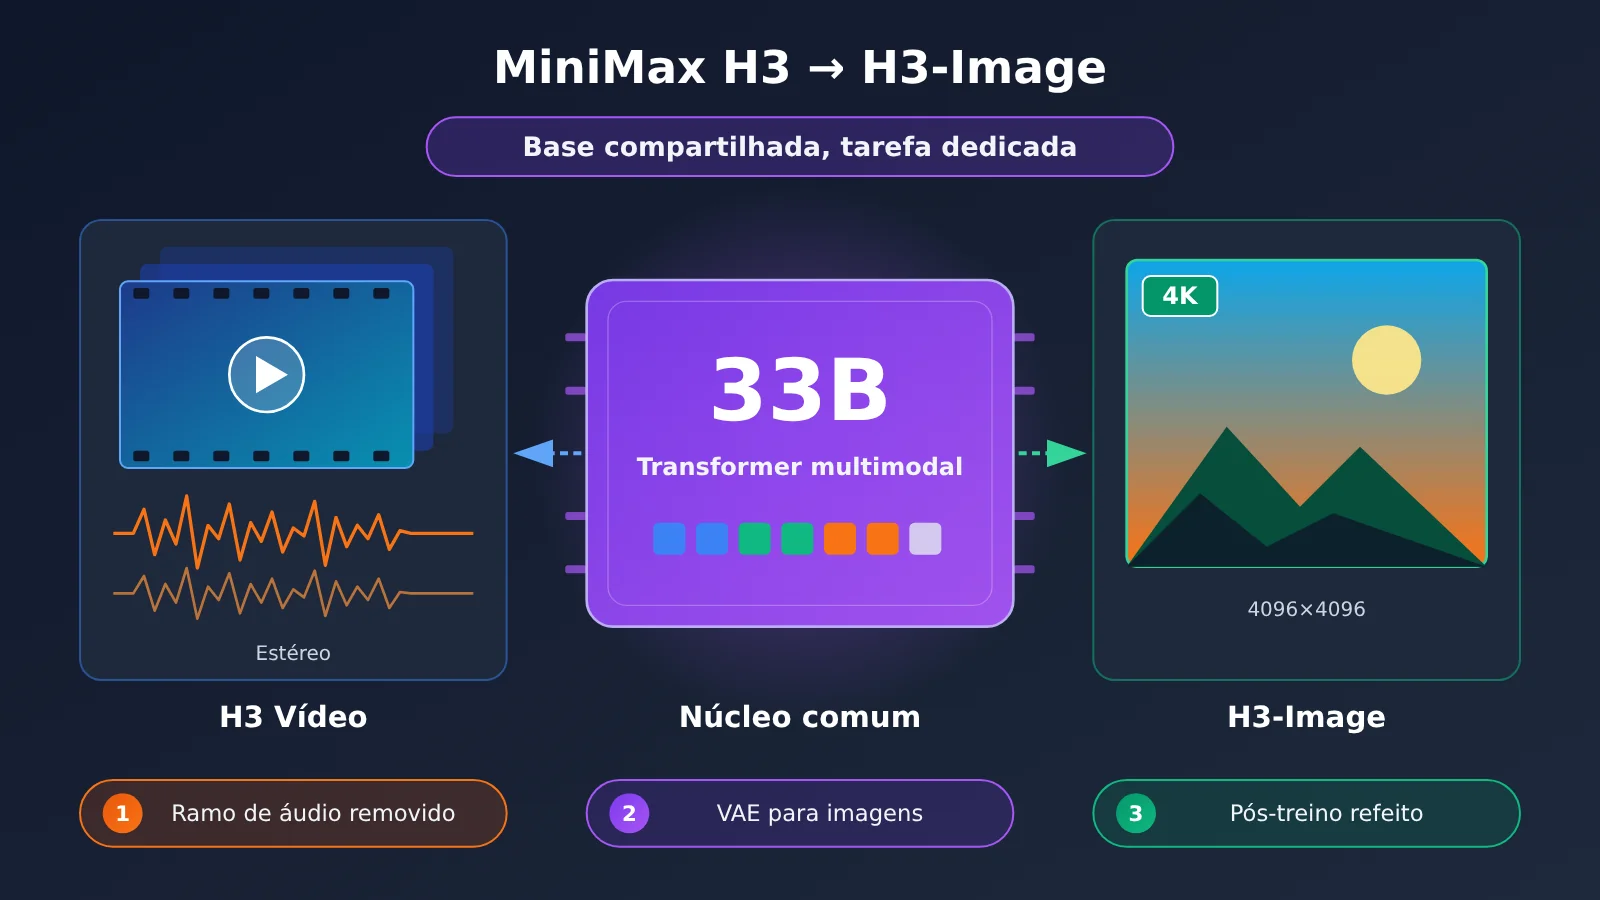
Em novembro de 2026, a MiniMax abriu os pesos do modelo de geração de imagens H3-Image. O H3, aberto três meses antes, é um modelo que gera vídeo com áudio estéreo. O novo modelo tem uma escala de parâmetros parecida, na casa dos 33B, e a arquitetura central também vem do H3.
Isso não é simplesmente “trocar a saída do modelo de vídeo para um único frame”. O model card oficial e o blog de lançamento do H3-Image deixam claro: ele mantém o Transformer multimodal central e o codificador de texto do H3, remove o ramo de geração de áudio, passa a usar um VAE específico para imagem e refaz o pós-treinamento e o pipeline de inferência para as tarefas de imagem.
O que você leva daqui: depois de ler este artigo, você vai saber quais pontos mudaram quando a mesma arquitetura de 33B saiu do vídeo e foi para a imagem, por que cada mudança foi feita e o que é fato confirmado oficialmente e o que é só inferência do mercado.
MiniMax H3: do vídeo à imagem — o que a MiniMax lançou
Vamos organizar a linha do tempo primeiro. Muita gente vê a notícia de que o “MiniMax H3 virou open source” e acaba misturando dois lançamentos diferentes. Mas o H3 e o H3-Image são coisas distintas, com cerca de três meses de diferença entre elas.
| Data | Evento | Descrição |
|---|---|---|
| 2026-07-31 | A MiniMax apresenta o modelo H3 | O blog técnico oficial revela pela primeira vez a arquitetura do H3 |
| 2026-08-03 | MiniMax H3 tem os pesos oficialmente abertos | Modelo de geração de vídeo omnimodal; o que foi aberto é o H3-Base |
| 2026-11-10 | Data indicada na H3-Image Community License | Pesos do modelo de geração de imagens são liberados |
| 2026-11-11 | O blog oficial da MiniMax em inglês publica a apresentação do H3-Image | Divulgação dos detalhes de pós-treinamento e otimização de inferência |
O papel de cada um: MiniMax H3 e H3-Image
As tarefas dos dois são completamente diferentes. O H3 é um sistema omnimodal de geração de vídeo: ele entende ao mesmo tempo entradas de texto, imagem, vídeo e áudio, e gera vídeos de 4 a 15 segundos, a 24 FPS, com áudio estéreo nativo de 32 kHz. Por padrão, o lado menor da saída tem 768 px, e o fluxo de trabalho completo chega a 2K. Já o H3-Image é focado em geração e edição de imagens em alta resolução. A especificação oficial é de no máximo cerca de 16 MP (por exemplo, 4096×4096), e a empresa afirma que consegue gerar imagens em 4K em até 10 segundos.
Isso nos leva à pergunta central deste artigo: um modelo faz “vídeo com som” e o outro faz “imagens estáticas em alta resolução”. Por que os dois pertencem à mesma família técnica? A resposta está no design de base do H3.
A arquitetura por trás do MiniMax H3: um Transformer multimodal unificado
O núcleo do H3 se chama H3-Omni-Transformer. De acordo com a apresentação técnica oficial, ele é um Transformer de fluxo único e denso, com cerca de 33B de parâmetros. “Fluxo único” quer dizer que as informações de modalidades diferentes não passam por redes independentes: elas são concatenadas numa mesma sequência e processadas pelo mesmo conjunto de parâmetros. Já “denso” significa que cada token passa por todos os parâmetros no cálculo, em vez de ativar só alguns especialistas, como acontece nas arquiteturas MoE.
Como o MiniMax H3 codifica cada modalidade
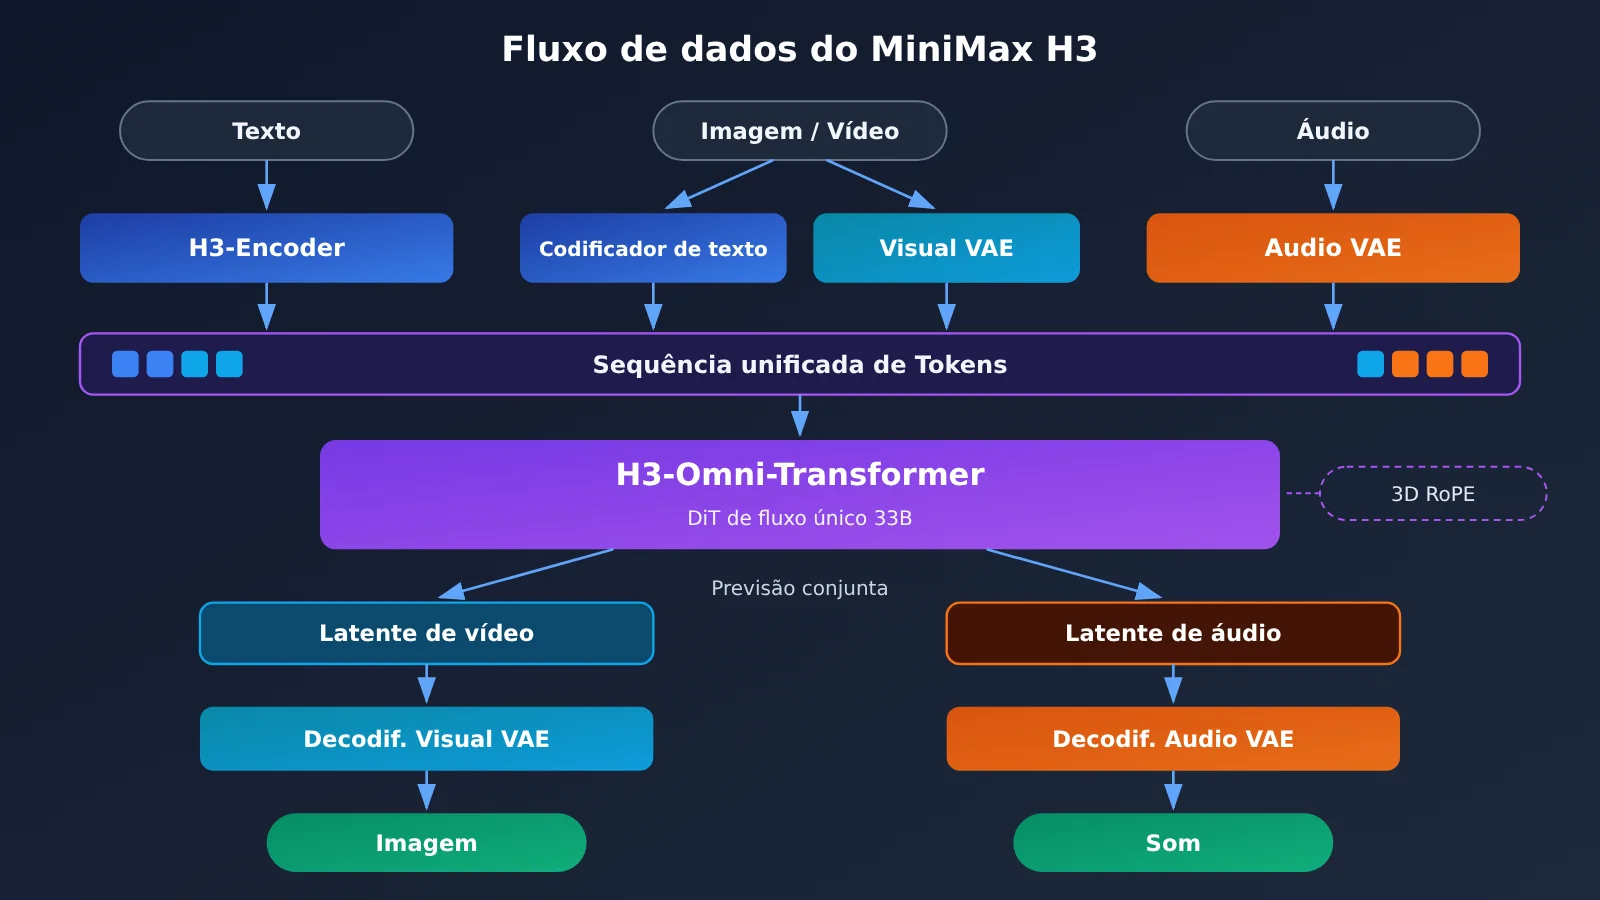
O caminho de processamento divulgado oficialmente é, em linhas gerais, este:
- Texto: é codificado em uma representação semântica pelo H3-Encoder, que diz ao modelo “o que você quer que aconteça na imagem”.
- Imagem e vídeo: passam ao mesmo tempo pelo codificador de texto e pelo Visual VAE. O primeiro cuida da semântica, ou seja, de entender o conteúdo da cena; o segundo comprime os pixels em variáveis latentes.
- Áudio: é comprimido em variáveis latentes de áudio pelo Audio VAE.
- Sequência unificada: as representações de todas essas modalidades são combinadas em uma única sequência e enviadas ao Transformer.
- Previsão conjunta: o Transformer prevê ao mesmo tempo as variáveis latentes de vídeo e de áudio, que depois são entregues aos respectivos VAEs para decodificar em imagem e som.
Dá para pensar nisso como “todo mundo falando a mesma língua”. Não importa se a entrada original é um texto, uma imagem ou uma música: antes de entrar no Transformer, tudo vira uma sequência de tokens. O modelo não se importa de qual modalidade cada token veio. Ele só se preocupa em descobrir as relações entre eles e gerar os tokens-alvo.
O papel do 3D Multimodal RoPE
O vídeo tem eixo temporal e duas dimensões espaciais, então o H3 usa o 3D Multimodal RoPE para codificar posições: cada token precisa saber não só suas coordenadas horizontal e vertical no quadro, mas também a qual frame pertence. A equipe oficial confirmou explicitamente esse design. Ele é essencial para entender o H3-Image mais adiante, já que uma imagem pode ser vista como um caso particular em que a dimensão temporal tem apenas um frame.
【Nossa inferência】 Justamente porque o H3 foi projetado desde o início com “sequência unificada + Transformer unificado”, e não como um pipeline de tarefa única do tipo “entra texto, sai vídeo”, sua rede de base tem fundamento para ser transferida para outras tarefas de geração. A documentação oficial não coloca a questão exatamente assim; essa é uma conclusão nossa, tirada do design da arquitetura.
O que o MiniMax H3-Image herdou, removeu e acrescentou
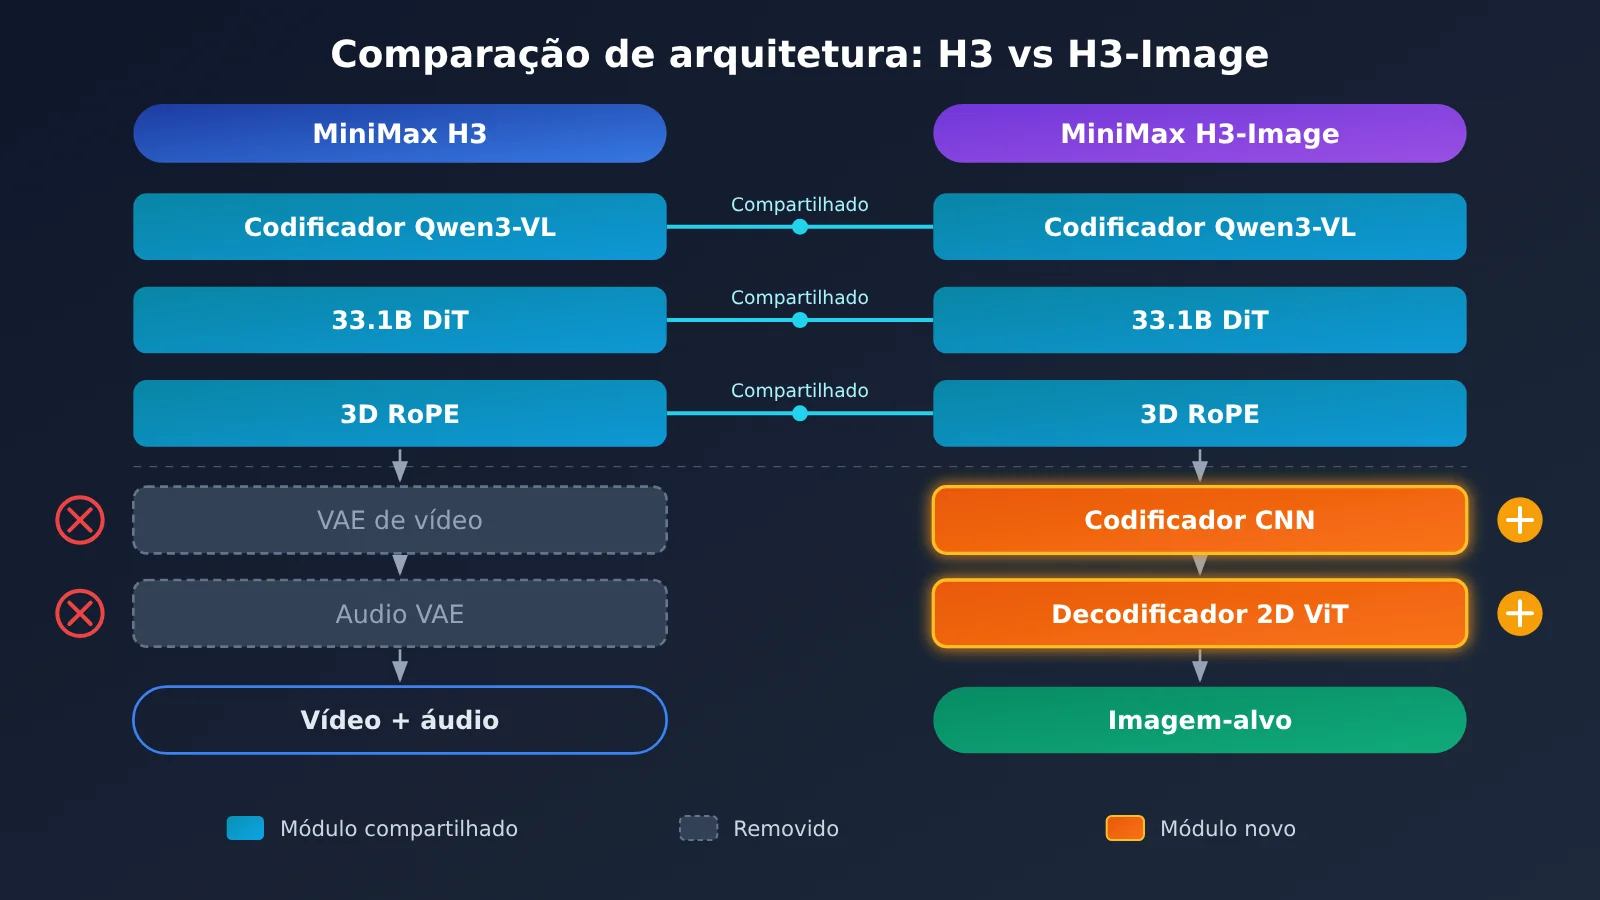
Esta é a parte mais interessante de toda a evolução técnica. A tabela abaixo foi organizada a partir do model card oficial do H3-Image:
| Categoria | Componente | O que foi feito |
|---|---|---|
| Herdado | Codificador de texto Qwen3-VL | Mantém o codificador de texto completo do H3, usando o estado oculto da camada 50 |
| Herdado | DiT de fluxo único com 33,1B de parâmetros | Preserva a arquitetura central do H3-Omni-Transformer |
| Herdado | RoPE multimodal 3D | Continua sendo usado para codificar relações de posição |
| Removido | Ramo de áudio | Não faz mais geração conjunta de vídeo e áudio |
| Substituído | VAE dedicado a imagens | Codificador CNN + decodificador ViT 2D de 24 camadas |
| Alterado | Objetivo de geração | Texto e imagens de referência são codificados em uma sequência unificada, e o modelo prevê o latente da imagem alvo |
Herança nº 1: codificador de texto Qwen3-VL e o estado oculto da camada 50
O model card do H3-Image explica que o modelo reaproveita o codificador de texto do H3, baseado no Qwen3-VL, e usa o estado oculto da camada 50 como condição de entrada. O Qwen3-VL é, por natureza, um modelo de visão e linguagem, então ele não só entende texto, como também compreende o conteúdo das imagens de referência. É exatamente essa capacidade que a edição com múltiplas imagens de referência exige.
【Prática comum no mercado】 Por que usar uma camada intermediária e não a última? A documentação oficial não entra em detalhes. De modo geral, o pessoal da área entende que as últimas camadas de um modelo de linguagem são mais voltadas para “prever a próxima palavra”, enquanto as camadas intermediárias guardam características semânticas mais ricas e mais gerais. Muitos modelos de difusão adotam uma abordagem parecida.
Herança 2: DiT de 33,1B e RoPE 3D
As especificações do corpo principal do DiT do H3-Image são as seguintes:
| Parâmetro | Valor | Em linguagem simples |
|---|---|---|
| Quantidade de parâmetros | 33,1B | Mesma ordem de grandeza do backbone de cerca de 33B do H3 |
| Número de camadas | 50 camadas | A informação passa por 50 transformações |
| Hidden Size | 5376 | Dimensão da representação de cada token |
| Attention Heads | 56 | Observa as relações entre tokens a partir de 56 ângulos ao mesmo tempo |
| FFN Size | 14336 | Largura intermediária da rede feed-forward em cada camada |
| Downsampling espacial do VAE | 16 vezes | Um lado de 4096 pixels é comprimido para 256 |
| Canais latentes | 24 | Cada posição latente carrega 24 valores numéricos |
| Cobertura por token | cerca de 32×32 pixels | Define o tamanho da sequência e o custo computacional |
Considerando que “cada token corresponde a cerca de 32×32 pixels”, uma imagem de 4096×4096 tem aproximadamente 128×128 = 16384 tokens (essa é uma estimativa nossa, feita a partir dos parâmetros oficiais). Se ainda somarmos várias imagens de referência, a sequência fica ainda mais longa, e isso explica por que a otimização da velocidade de inferência é tão importante para ele.
【Nossa inferência】 O RoPE 3D continua sendo útil em tarefas de imagem. A imagem de destino tem apenas um quadro, mas as várias imagens de referência e a imagem de destino precisam ser distinguidas dentro da sequência, ou seja, “quem é quem”, e a dimensão extra pode cumprir esse papel. A documentação oficial não divulga o esquema exato de alocação de posições, então isso é só uma interpretação razoável da nossa parte.
Remover: o ramo de áudio
Uma imagem não tem duração nem som, então manter o ramo de áudio só desperdiça recursos de treinamento e de inferência. Ao removê-lo, o objetivo de aprendizado do modelo deixa de ser a “distribuição conjunta de vídeo + áudio” e passa a ser apenas a “distribuição de imagens”, o que deixa o sinal de treinamento mais concentrado.
Substituir: um VAE dedicado a imagens
O Visual VAE do H3 precisava lidar com a continuidade temporal do vídeo. Já o H3-Image trocou essa peça por um VAE projetado especificamente para imagens estáticas. O codificador usa uma CNN, que é boa em extrair texturas locais de forma eficiente. O decodificador é uma ViT 2D de 24 camadas, capaz de levar em conta a estrutura global na hora de reconstruir os pixels. A redução de resolução (downsampling) de 16x combinada com 24 canais significa guardar a informação em menos posições espaciais e mais canais, algo fundamental para saídas de alta resolução na casa dos 16MP. A equipe também destaca que os resultados em alta resolução do H3-Image são gerados diretamente, sem depender de um upscaler de super-resolução tradicional.
Mudança: de “prever vídeo + áudio” para “prever a imagem de destino”
O fluxo de geração final funciona assim: o comando (texto) e as imagens de referência são codificados juntos em uma sequência unificada, o DiT vai removendo o ruído passo a passo no espaço latente para prever os latentes da imagem de destino, e depois o VAE de imagem decodifica tudo na imagem final. Sobre a quantidade de imagens de referência, o model card indica um limite de 16, enquanto a receita de implantação do vLLM fala em no máximo 9. Os dois números seguem critérios diferentes, então a quantidade realmente utilizável depende do framework de inferência que você estiver usando.
Quais otimizações o MiniMax H3-Image recebeu para ser mais rápido e mais fácil de usar
Mudar só a arquitetura não basta. No blog de lançamento do H3-Image, a MiniMax conta que, partindo da capacidade de pré-treinamento do H3, fez melhorias em cinco frentes no pós-treinamento: dados de treinamento, aprendizado por reforço, compressão do número de passos de amostragem, aprimoramento de comandos (Prompt Enhancement) e otimização de implantação. A empresa não divulgou os detalhes de dados e aprendizado por reforço, então vamos focar nas partes sobre as quais há mais informação pública.
Destilação em 6 passos de amostragem e remoção do CFG
O processo de geração de imagens dos modelos de difusão é “partir do ruído e ir removendo-o passo a passo”, e a abordagem convencional costuma exigir dezenas de passos. Além disso, os modelos de difusão tradicionais geralmente usam CFG (Classifier-Free Guidance): a cada passo é preciso rodar duas vezes, uma “com comando” e outra “sem comando”, e depois misturar os resultados em determinada proporção para reforçar a aderência ao comando.
O H3-Image usa destilação para comprimir a amostragem em 6 passos e, ao mesmo tempo, dispensa o CFG. O primeiro ponto reduz bastante o número de passos; o segundo faz com que cada passo precise de apenas um forward pass. Para um modelo de 33,1B de parâmetros e com dezenas de milhares de tokens por imagem, a combinação dos dois é justamente a base técnica da afirmação oficial de “gerar 4K em 10 segundos”. Vale lembrar que os 10 segundos são uma declaração do fabricante: a velocidade real depende do hardware e da configuração de implantação.
Aprimoramento de comando: transformando uma descrição curta em instruções executáveis
O H3-Image oferece um modelo PE (Prompt Enhancement) opcional, com pesos de cerca de 17,9GB, que expande a descrição curta do usuário em um comando mais detalhado e mais fácil de o modelo entender. Se você não quer implantar esse modelo extra por enquanto, também dá para usar um Modelo de Linguagem Grande de uso geral e seguir a mesma ideia de pré-processamento. Veja um exemplo bem simples:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Usa a interface unificada da APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把这句扩写成详细的图像生成提示词:雨夜的赛博朋克街头"}]
)
print(resp.choices[0].message.content)
Ver a implementação completa do aprimoramento de comando
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是图像生成提示词工程师。请把用户的简短描述扩写为结构化提示词,"
    "依次包含:主体、构图、光线、材质细节、色彩、镜头与画幅。"
    "如果用户提供了参考图说明,请明确每张参考图在画面中的作用。"
    "只输出提示词正文,不要解释。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"参考图{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# Exemplo: composição de sala de estar com cômodo vazio + imagens de referência de móveis
print(enhance_prompt(
    "把这些家具摆进空客厅,北欧风,午后自然光",
    ["空房间照片", "灰色布艺沙发", "橡木茶几", "落地灯"],
))
Dica: ao montar um fluxo de trabalho de geração de imagens, na etapa de pré-processamento do comando você pode começar conectando vários Modelos de Linguagem Grande populares pela APIYI (apiyi.com), comparar a qualidade da expansão de cada um e só depois decidir se vale a pena implantar um modelo PE dedicado. Os nomes dos modelos seguem o que consta na lista de modelos da plataforma.
Otimização de implantação e suporte a alta resolução
Os frameworks de implantação recomendados oficialmente incluem SGLang, vLLM-Omni, Diffusers e ComfyUI. Entre os hardwares compatíveis estão NVIDIA H200, RTX PRO 6000 Blackwell e AMD Instinct MI350X, e há também soluções de paralelismo multi-GPU. A combinação de alta taxa de compressão do VAE de imagem, amostragem em 6 passos sem CFG e otimizações de inferência em nível de framework é o que sustenta a saída direta em formatos de alta resolução, como 16:9 (5472×3072), 9:16 (3072×5472) e 21:9 (6272×2688).
Impacto da reutilização da arquitetura do MiniMax H3
Impacto para desenvolvedores
- Base compartilhada, mas não intercambiável: o H3 e o H3-Image compartilham o codificador de texto, que o model card descreve como “codificador de texto H3 compartilhado” (cerca de 66,7 GB). Porém, os pesos do DiT e o VAE são independentes, então você não consegue pegar os pesos de vídeo do H3 e usá-los direto para gerar imagens.
- A barreira de implantação continua alta: o modelo principal de imagem tem cerca de 68,65 GB. Somando o codificador de texto, o download completo chega a cerca de 135,35 GB. E isso é só o tamanho em disco, que não equivale à necessidade de VRAM.
- As licenças precisam ser analisadas separadamente: o H3 e o H3-Image têm duas Community Licenses diferentes, com condições de ativação bem distintas. Veja a tabela abaixo.
| Item | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| Escopo de código aberto | Apenas o H3-Base; Context-IR e Regenerate-2K exigem chamada à API oficial | Pesos do modelo de imagem, codificador de texto compartilhado e modelo PE opcional |
| Resultado disponível localmente | Geração de áudio e vídeo em 768p; o fluxo completo em 2K depende da API oficial | Segundo a fabricante, gera diretamente até cerca de 16 MP |
| Condição para licença comercial | Receita anual de produtos e serviços comerciais acima de US$ 20 milhões | Receita anualizada sua e/ou de afiliadas acima de US$ 1 milhão, ou oferta de serviço hospedado a qualquer terceiro |
| Outras obrigações | Restrições regionais etc.; consulte o texto original da licença | Restrições regionais, uso da saída, identificação do produto etc.; consulte o texto original da licença |
Nota sobre a comparação: a tabela foi organizada a partir do texto original das duas licenças e dos model cards oficiais, servindo apenas como referência para a escolha técnica, sem constituir aconselhamento jurídico. Se você ainda não tem condições de implantar por conta própria ou de obter a licença, dá para começar chamando outros modelos populares de imagem e multimodais pela APIYI (apiyi.com) e montar um protótipo do fluxo de trabalho.
Impacto para o setor
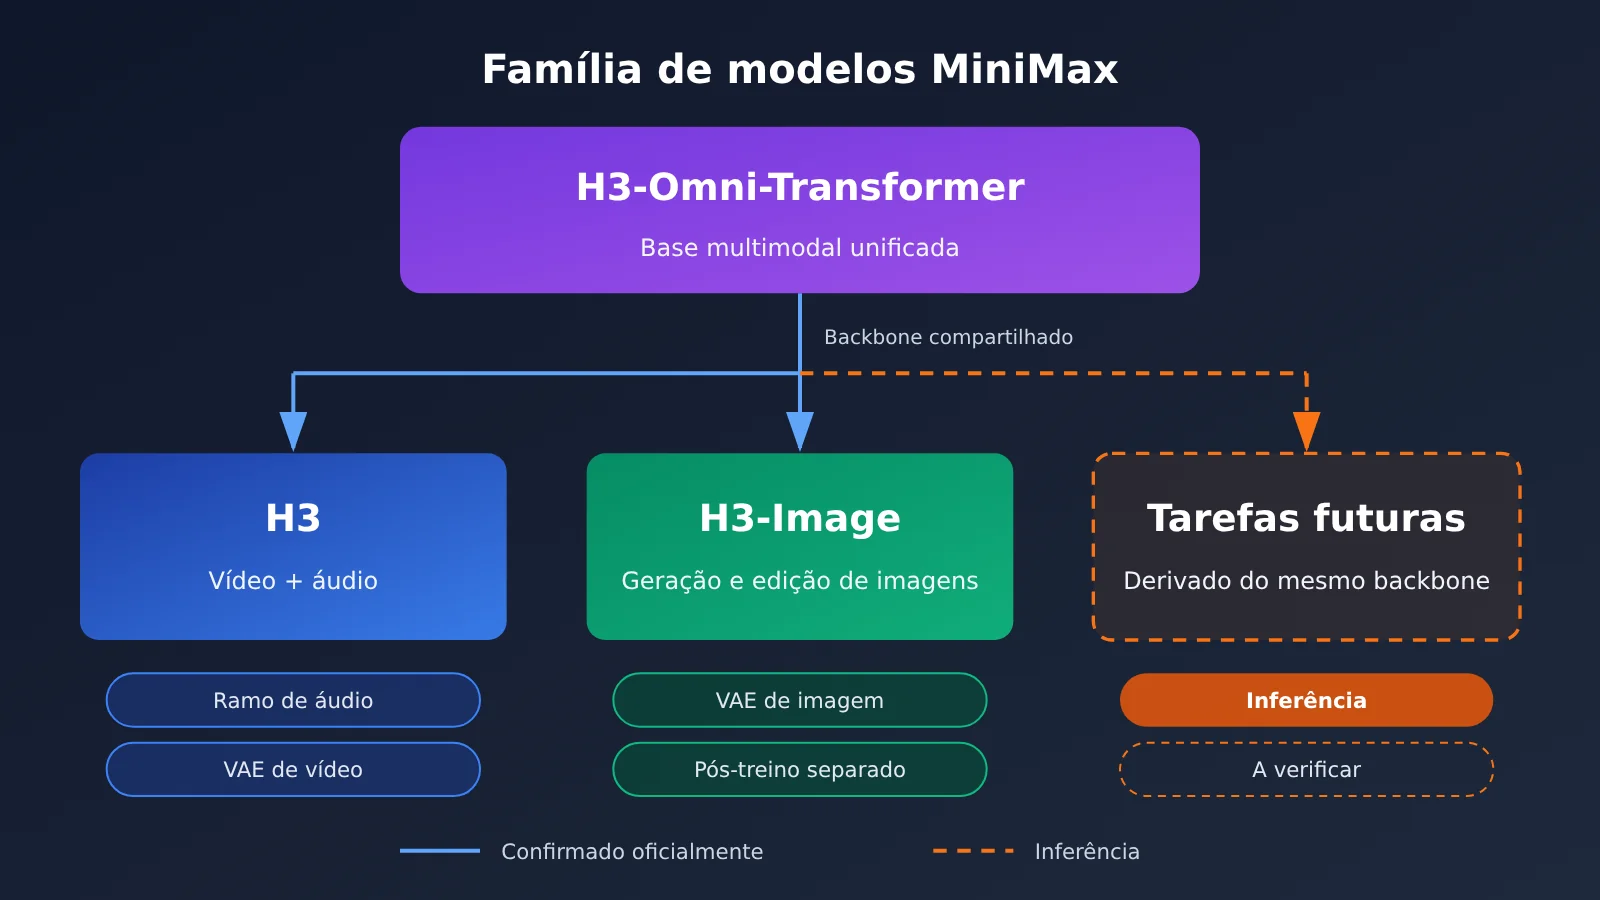
【Confirmado oficialmente】 O H3-Image reutiliza o Transformer principal e o codificador de texto do H3, ao mesmo tempo que usa um VAE dedicado e um processo de pós-treinamento independente.
【Nossa inferência】 Isso indica que a geração de vídeo e a de imagem podem compartilhar muitas capacidades de base, como compreensão semântica, alinhamento multimodal e modelagem de posição espacial, mas cada tarefa ainda precisa de componentes de codificação/decodificação próprios e de treinamento direcionado. A estratégia da MiniMax parece ser “primeiro construir uma base multimodal unificada e depois especializar por tarefa”, em vez de treinar um modelo do zero para cada tipo de geração. Se esse caminho der certo, é bem provável que surjam mais modelos derivados do mesmo backbone, mas por enquanto isso é só especulação do setor.
Perguntas frequentes (FAQ)
Q1: O H3-Image é basicamente o modelo de vídeo H3 só que trocando a saída para imagem?
Não. O H3-Image herda do H3 o codificador de texto Qwen3-VL, a arquitetura DiT de fluxo único com 33,1B de parâmetros e o 3D RoPE, mas remove o ramo de áudio e usa um VAE específico para imagens, com codificador CNN e decodificador 2D ViT. Além disso, passa por um pós-treinamento próprio, com dados, aprendizado por reforço e destilação separados.
Q2: Por que o MiniMax H3 e o H3-Image têm quase a mesma quantidade de parâmetros?
Porque o Transformer central dos dois vem da mesma arquitetura: o H3 tem cerca de 33B, e o DiT do H3-Image tem 33,1B. Essa proximidade mostra que a rede principal foi mantida por inteiro. A diferença fica nos componentes de codificação/decodificação e nos objetivos de treinamento.
Q3: Afinal, quantas imagens de referência o H3-Image suporta?
O modelo card oficial fala em até 16 imagens, enquanto a receita de implantação com vLLM indica no máximo 9. O primeiro número é a declaração do fabricante; o segundo é a configuração testada em um framework específico. Na prática, vale o limite do framework de inferência que você escolher.
Q4: Amostragem em 6 passos e sem CFG prejudica a qualidade da imagem?
Segundo o fabricante, a qualidade continua alta depois da destilação, mas o que está disponível publicamente são principalmente demonstrações feitas por ele mesmo. Recomendo fazer testes comparativos no seu cenário real, prestando atenção especialmente em instruções complexas e em combinações de várias imagens de referência.
Q5: Não tenho uma GPU da classe H200. Como validar primeiro o fluxo de geração de imagens?
Dá para fazer o fluxo funcionar primeiro com uma API na nuvem:
1. Crie uma conta na APIYI (apiyi.com) e pegue sua chave API e os créditos gratuitos de teste
2. Use o código de aprimoramento de comando deste artigo (com `base_url` igual a `https://api.apiyi.com/v1`) para montar a etapa de pré-processamento
3. Conecte os modelos de imagem mais usados que já estão na plataforma, valide o fluxo completo e só depois avalie se vale a pena fazer a implantação própria
Q6: Posso implantar o H3-Image e oferecer um serviço de API para terceiros?
Aqui é preciso cuidado. De acordo com a licença do H3-Image, oferecer serviço hospedado a qualquer terceiro exige autorização prévia por escrito da MiniMax, independentemente do volume de receita. Para os termos exatos, consulte o texto original da licença e, se necessário, busque orientação jurídica.
Pontos-chave da evolução da arquitetura do MiniMax H3 (Key Takeaways)
- Mesma origem, usos diferentes: o H3-Image reaproveita o Transformer central e o codificador de texto do H3. Não se trata de simplesmente trocar o modo de saída.
- Três mudanças importantes: remoção do ramo de áudio, troca por um VAE específico para imagens e mudança do objetivo de geração para prever latentes de imagem.
- A compreensão semântica vem do Qwen3-VL: usa o estado oculto da camada 50 e entende ao mesmo tempo o texto e as imagens de referência.
- A velocidade vem da destilação: amostragem em 6 passos e sem CFG, que é a base técnica da afirmação oficial de “4K em 10 segundos”.
- As licenças precisam ser analisadas separadamente: tanto o serviço hospedado do H3-Image quanto o limite de US$ 1 milhão em receita exigem autorização.
- Valide antes de implantar: dá para montar um protótipo com vários modelos pelo APIYI (apiyi.com) e só depois avaliar o custo de hospedar por conta própria.
Resumo
A evolução do MiniMax H3 de vídeo para imagem pode ser resumida em três pontos:
- Base compartilhada: o Transformer multimodal de fluxo único na casa dos 33B, o codificador de texto Qwen3-VL e o 3D RoPE foram totalmente mantidos.
- Especialização na tarefa: o ramo de áudio foi removido e entrou um VAE de imagem com CNN + 2D ViT. O alvo de geração deixou de ser latentes de vídeo + áudio e passou a ser latentes de imagem.
- Treinamento e inferência refeitos: dados, aprendizado por reforço, destilação em 6 passos sem CFG, aprimoramento de comandos e otimizações de implantação sustentam juntos uma saída na faixa de 16MP.
Para quem desenvolve, o que realmente vale estudar é “quais capacidades podem ser compartilhadas e quais precisam de treinamento específico”, além do custo de hardware por trás dos pesos e das obrigações de licença. Antes de decidir se vai hospedar por conta própria, recomendo comparar vários modelos por uma interface unificada no APIYI (apiyi.com) e colocar seu fluxo de trabalho de imagens para rodar rapidamente.
📚 Referências
- Introdução técnica oficial do MiniMax H3: descrição da arquitetura H3-Omni-Transformer
- Link:
minimax.io/blog/minimax-h3 -
Observação: descrição oficial do caminho de codificação multimodal e do 3D Multimodal RoPE
-
Blog oficial de lançamento do MiniMax H3-Image: pós-treinamento e otimização de inferência
- Link:
minimax.io/blog/minimax-h3-image -
Observação: melhorias em dados, aprendizado por reforço, destilação em 6 passos, aprimoramento de comandos e mais
-
Model card do H3-Image no Hugging Face: parâmetros completos da arquitetura
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
Observação: especificações detalhadas do DiT, do VAE e do codificador de texto
-
Model card original do H3 e licença: especificações do modelo de vídeo e termos de uso
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3 -
Observação: especificações do H3 e o texto original da licença em
blob/main/LICENSE -
Texto original da licença do H3-Image: condições de uso comercial
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
Observação: termos sobre serviços hospedados, limite de receita e outros
-
Receita de implantação no vLLM: configuração de testes do framework
- Link:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - Observação: critérios do lado do framework, como a quantidade de imagens de referência
Autor: equipe técnica da APIYI
Troca de experiências: fale com a gente na página inicial da APIYI (apiyi.com). Mais materiais estão disponíveis na central de documentação em docs.apiyi.com