作者注:H3-Image 複用了 H3 的多模態基礎架構,再配上圖像專用組件,並重新優化訓練和推理流程,最終成爲一個獨立的圖像生成模型。本文拆解它到底繼承了什麼、刪掉了什麼、又新增了什麼。
讀懂 MiniMax H3 架構前的 6 個術語
後文會反覆用到下面幾個概念,先用一句話講清楚。
| 術語 | 通俗解釋 | 在 MiniMax H3 中的角色 |
|---|---|---|
| Transformer | 處理序列數據的神經網絡,擅長捕捉序列中各元素之間的關係 | H3-Omni-Transformer 是整個模型家族的核心 |
| DiT | 用 Transformer 實現的擴散模型,通過逐步去噪生成內容 | H3-Image 的主體是 33.1B 參數的單流 DiT |
| VAE | 在像素和壓縮表示之間做編碼與解碼的模型,相當於“壓縮器 + 解壓器” | H3 用視覺 VAE 和音頻 VAE,H3-Image 換成圖像專用 VAE |
| 潛變量 | 原始數據被壓縮後的緊湊表示,模型在這個空間裏計算比直接處理像素省很多 | Transformer 預測的對象就是潛變量,而不是像素 |
| RoPE | 旋轉位置編碼,告訴模型每個 token 在序列中的位置 | H3 使用 3D Multimodal RoPE 表達時間和空間位置 |
| 蒸餾 | 把原本需要很多步的複雜過程,訓練成只需少數幾步就能完成 | H3-Image 被蒸餾到只需 6 個採樣步驟 |
2026 年 11 月,MiniMax 開放了 H3-Image 圖像生成模型的權重。三個月前開源的 H3 是一個能生成帶立體聲音頻視頻的模型,而這次的新模型參數規模同樣在 33B 量級,核心架構也來自 H3。
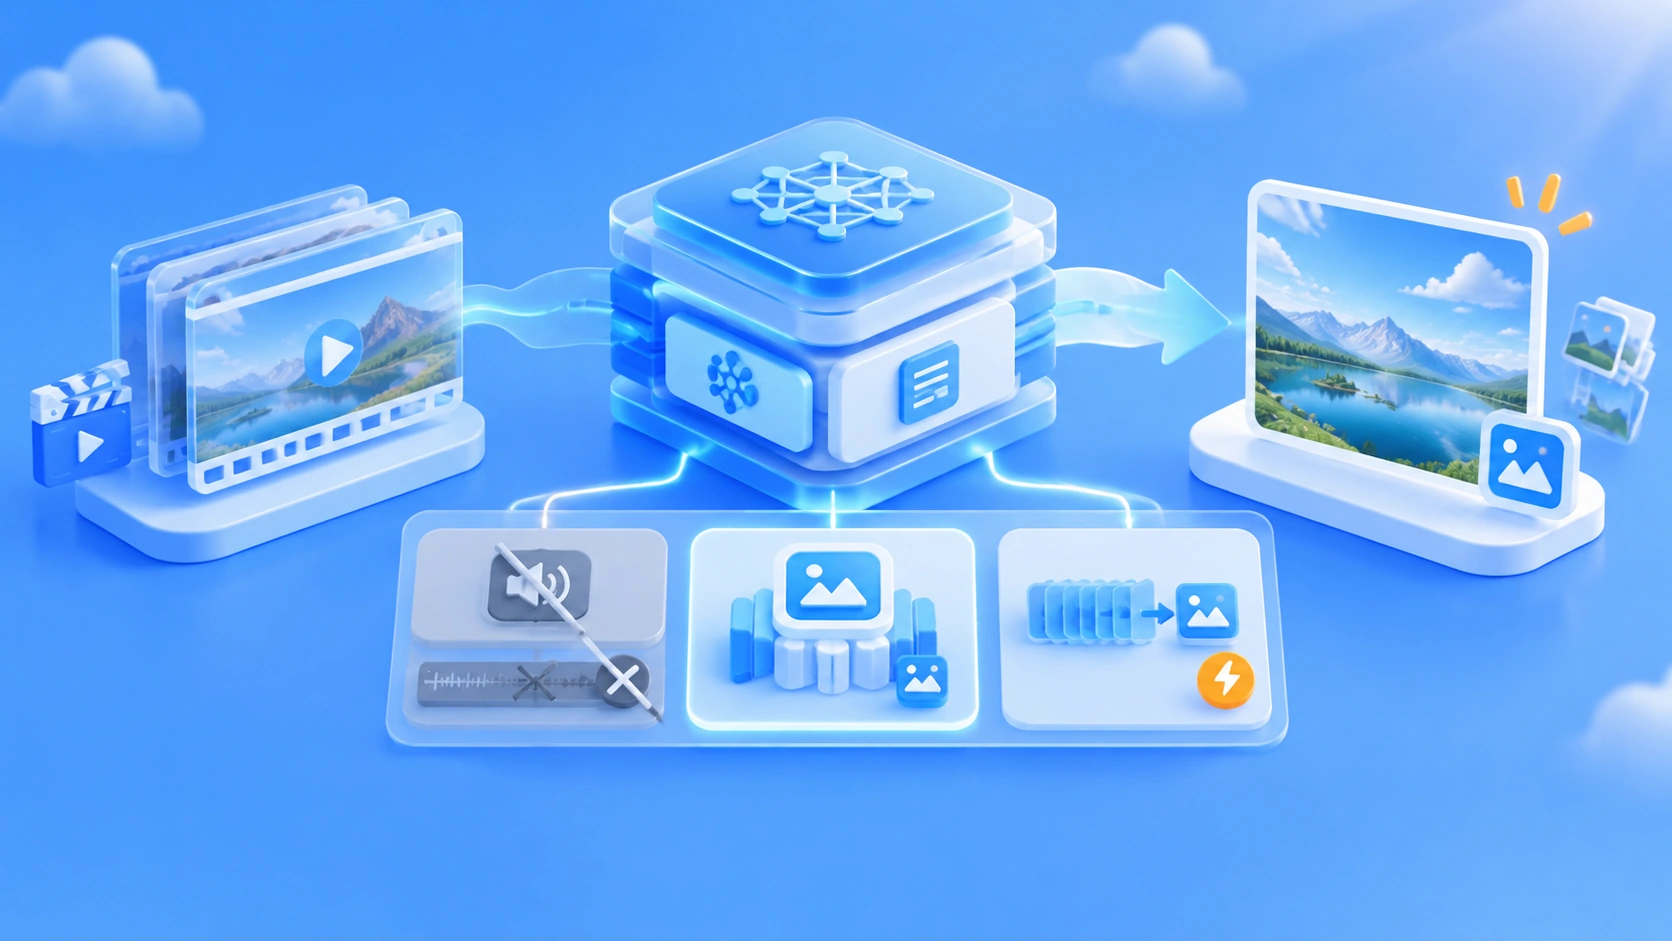
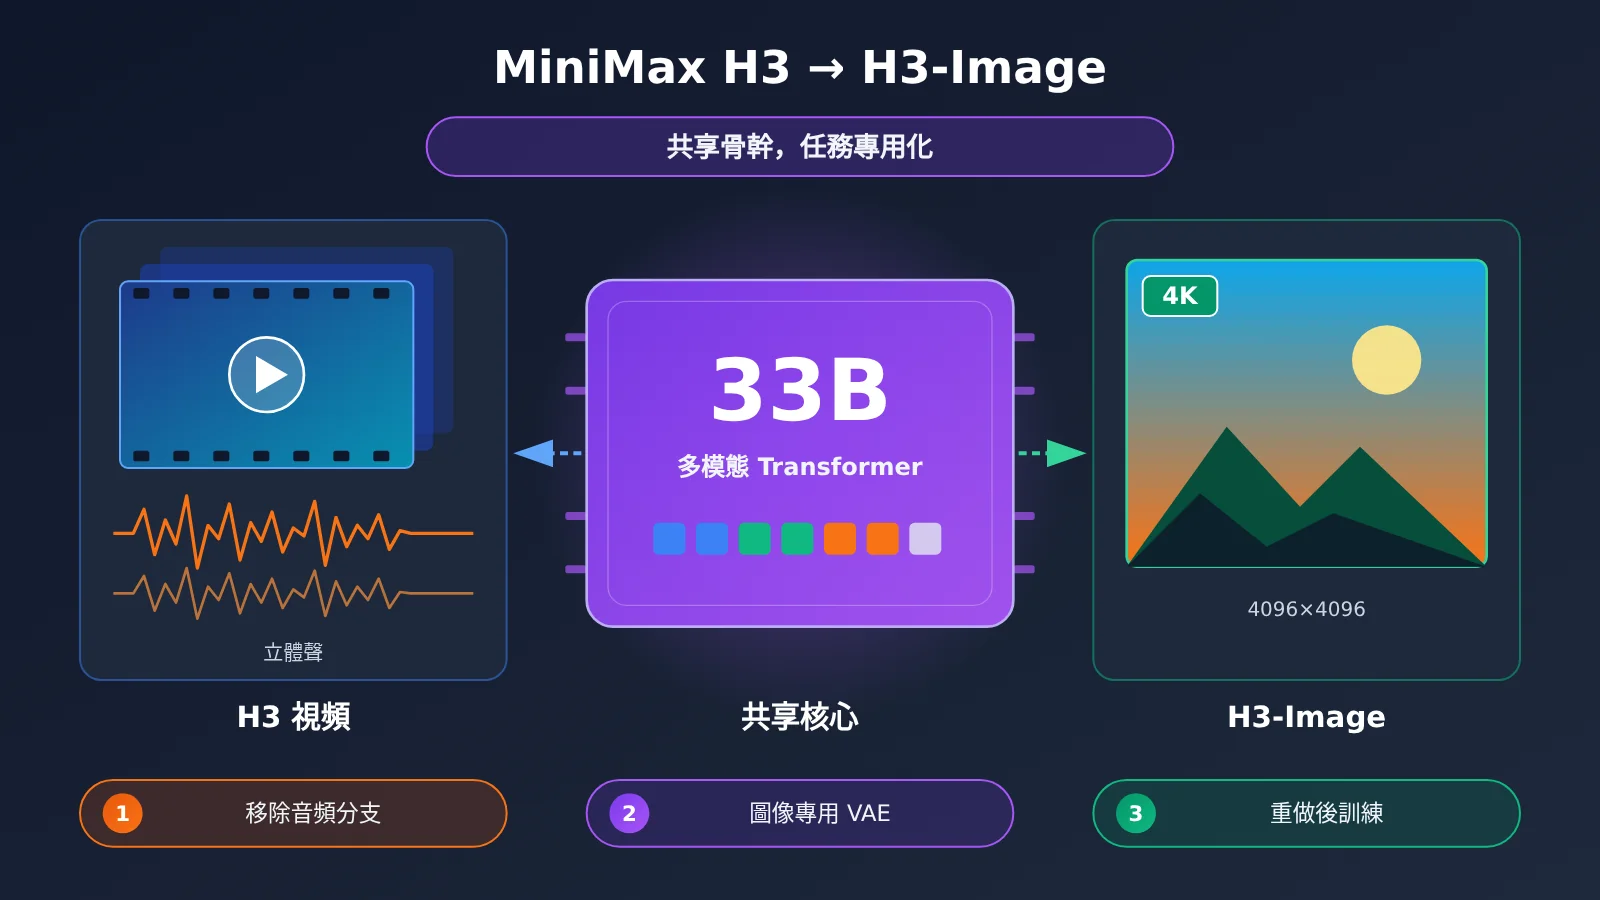
這不是“把視頻模型的輸出改成一幀”那麼簡單。 H3-Image 官方模型卡和發佈博客已經說明:它沿用了 H3 的核心多模態 Transformer 和文本編碼器,移除了音頻生成分支,換上了圖像專用 VAE,並且針對圖像任務重做了後訓練和推理流程。
核心價值:讀完本文,你會知道同一套 33B 架構從視頻走向圖像時具體改了哪幾處、每一處爲什麼要改,以及哪些是官方確認的事實、哪些只是行業層面的推論。
MiniMax H3 從視頻到圖像:MiniMax 發佈了什麼
先把時間線理清楚。很多人看到“MiniMax H3 開源”的新聞時,容易把兩次發佈混爲一談,但 H3 和 H3-Image 是兩件事,相隔約三個月。
| 時間 | 事件 | 說明 |
|---|---|---|
| 2026-07-31 | MiniMax 發佈 H3 模型介紹 | 官方技術博客首次公開 H3 架構 |
| 2026-08-03 | MiniMax H3 正式開放權重 | 全模態視頻生成模型,開源的是 H3-Base |
| 2026-11-10 | H3-Image Community License 標註日期 | 圖像生成模型權重開放 |
| 2026-11-11 | MiniMax 英文官方博客發佈 H3-Image 介紹 | 公佈後訓練與推理優化細節 |
MiniMax H3 與 H3-Image 的任務定位
兩者的任務完全不同。H3 是全模態視頻生成系統,可以同時理解文本、圖片、視頻和音頻輸入,輸出 4–15 秒、24 FPS、帶 32kHz 原生立體聲的視頻,默認輸出短邊 768px,完整工作流最高 2K。H3-Image 則專注高分辨率圖像生成與編輯,官方規格是最大約 16MP(如 4096×4096),並稱 10 秒內可以生成 4K 圖像。
這就引出了本文的核心問題:一個做“帶聲音的視頻”,一個做“高分辨率靜態圖”,爲什麼會屬於同一個技術家族?答案藏在 H3 的底層設計裏。
MiniMax H3 的底層架構:統一的多模態 Transformer
H3 的核心叫 H3-Omni-Transformer。根據官方技術介紹,它是一個約 33B 參數的單流、密集型 Transformer。“單流”指的是不同模態的信息不走各自獨立的網絡,而是拼進同一條序列,由同一套參數統一處理;“密集型”則意味着每個 token 都經過全部參數計算,而不是 MoE 那樣只激活部分專家。
MiniMax H3 如何編碼不同模態
官方公佈的處理路徑大致如下:
- 文本:通過 H3-Encoder 編碼成語義表示,告訴模型“你想讓畫面發生什麼”。
- 圖像和視頻:同時經過文本編碼器和 Visual VAE。前者負責理解畫面內容的語義,後者把像素壓縮成潛變量。
- 音頻:通過 Audio VAE 壓縮成音頻潛變量。
- 統一序列:以上各模態的表示被組合成一條序列,送入 Transformer。
- 聯合預測:Transformer 同時預測視頻和音頻的潛變量,再分別交給對應的 VAE 解碼成畫面和聲音。
可以把它理解成“大家說同一種語言”。不管原始輸入是一段話、一張圖還是一段音樂,進入 Transformer 之前都會被翻譯成 token 序列。模型並不關心 token 來自哪個模態,它只負責找出這些 token 之間的關係,並生成目標 token。
3D Multimodal RoPE 的作用
視頻同時有時間軸和二維空間,所以 H3 使用 3D Multimodal RoPE 來編碼位置:一個 token 不僅要知道自己在畫面中的橫縱座標,還要知道它屬於第幾幀。官方明確確認了這一設計。它對後面理解 H3-Image 很關鍵,因爲一張圖片可以看作“時間維度只有一幀”的特例。
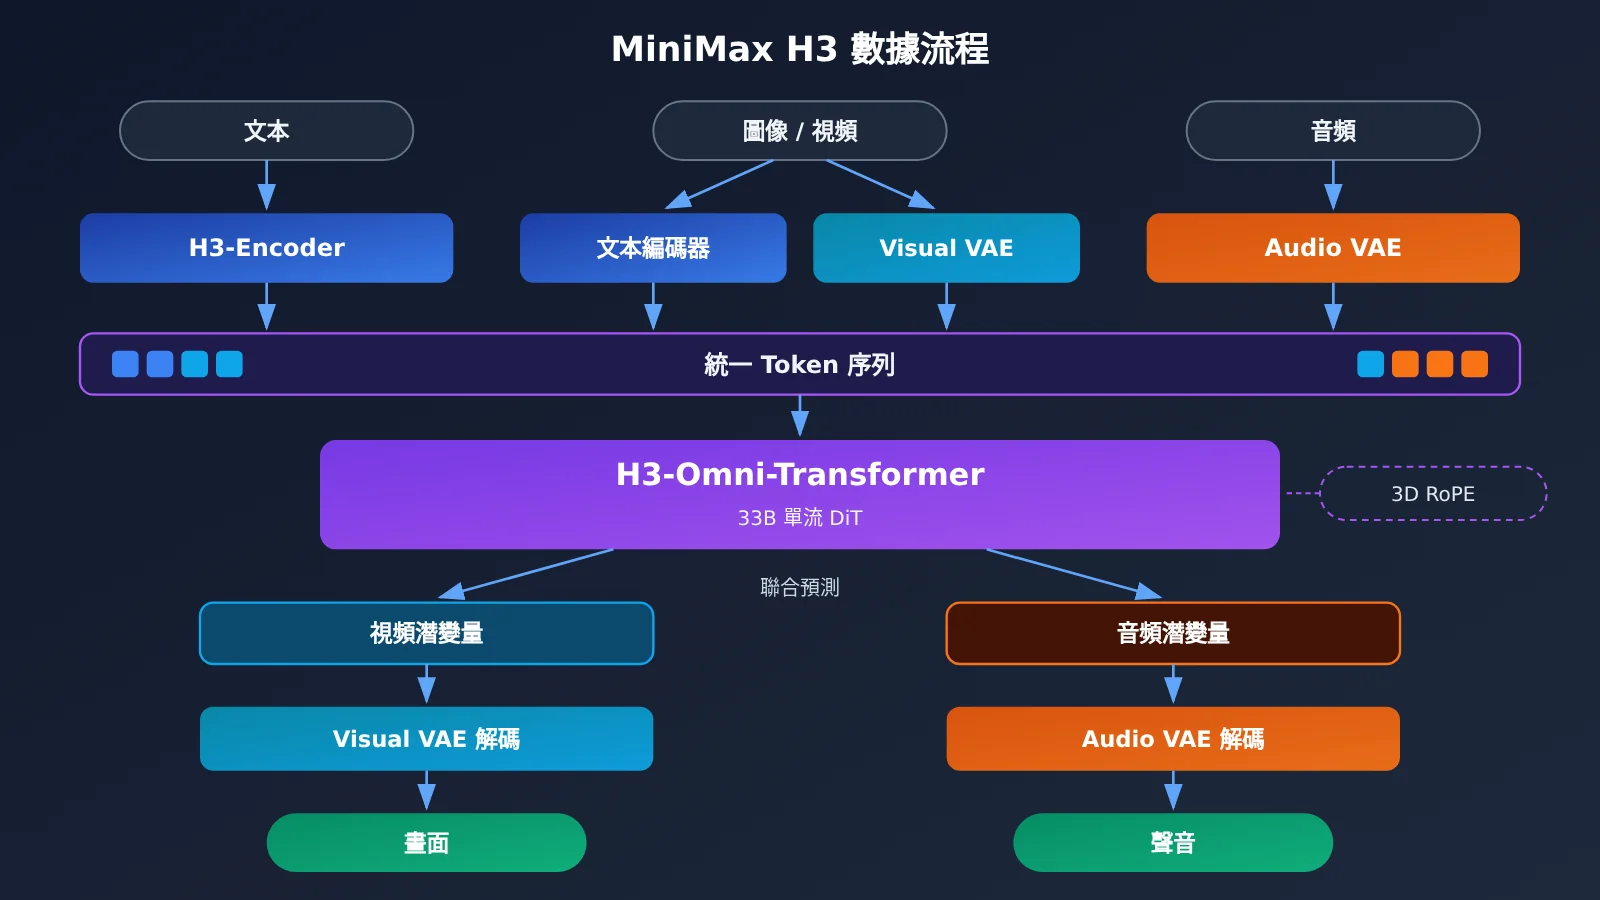
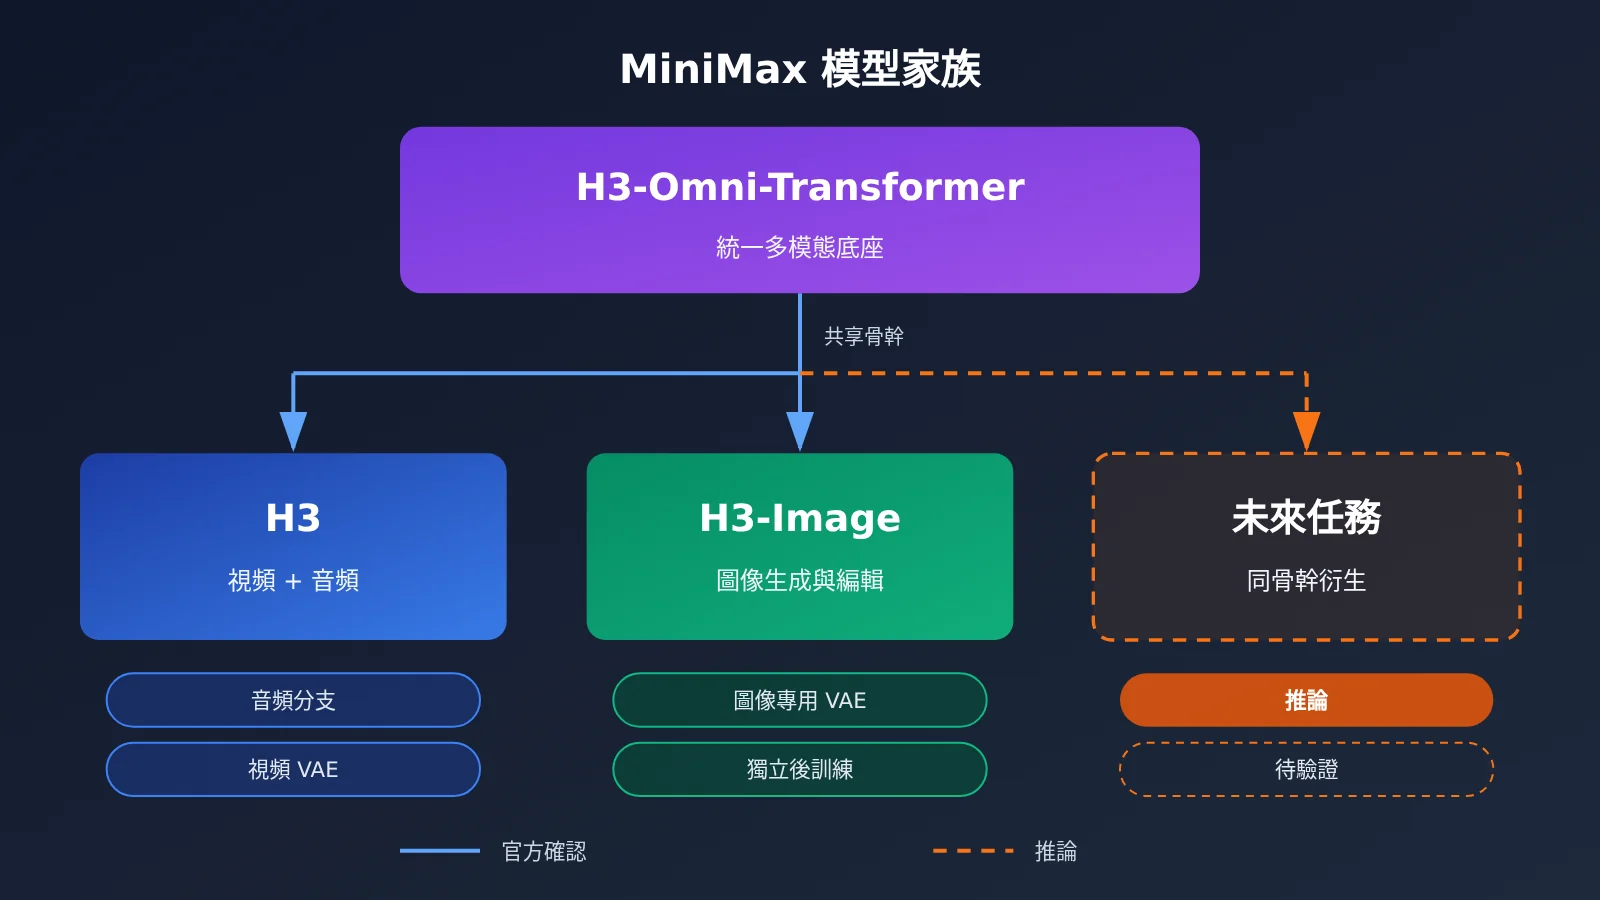
【我們的推論】 正因爲 H3 從一開始就是“統一序列 + 統一 Transformer”的設計,而不是“文本進、視頻出”的單任務管線,它的骨幹網絡才具備被遷移到其他生成任務的基礎。這一點官方沒有直接這樣表述,是我們從架構設計中得出的判斷。
MiniMax H3-Image 繼承了什麼,又刪除和增加了什麼
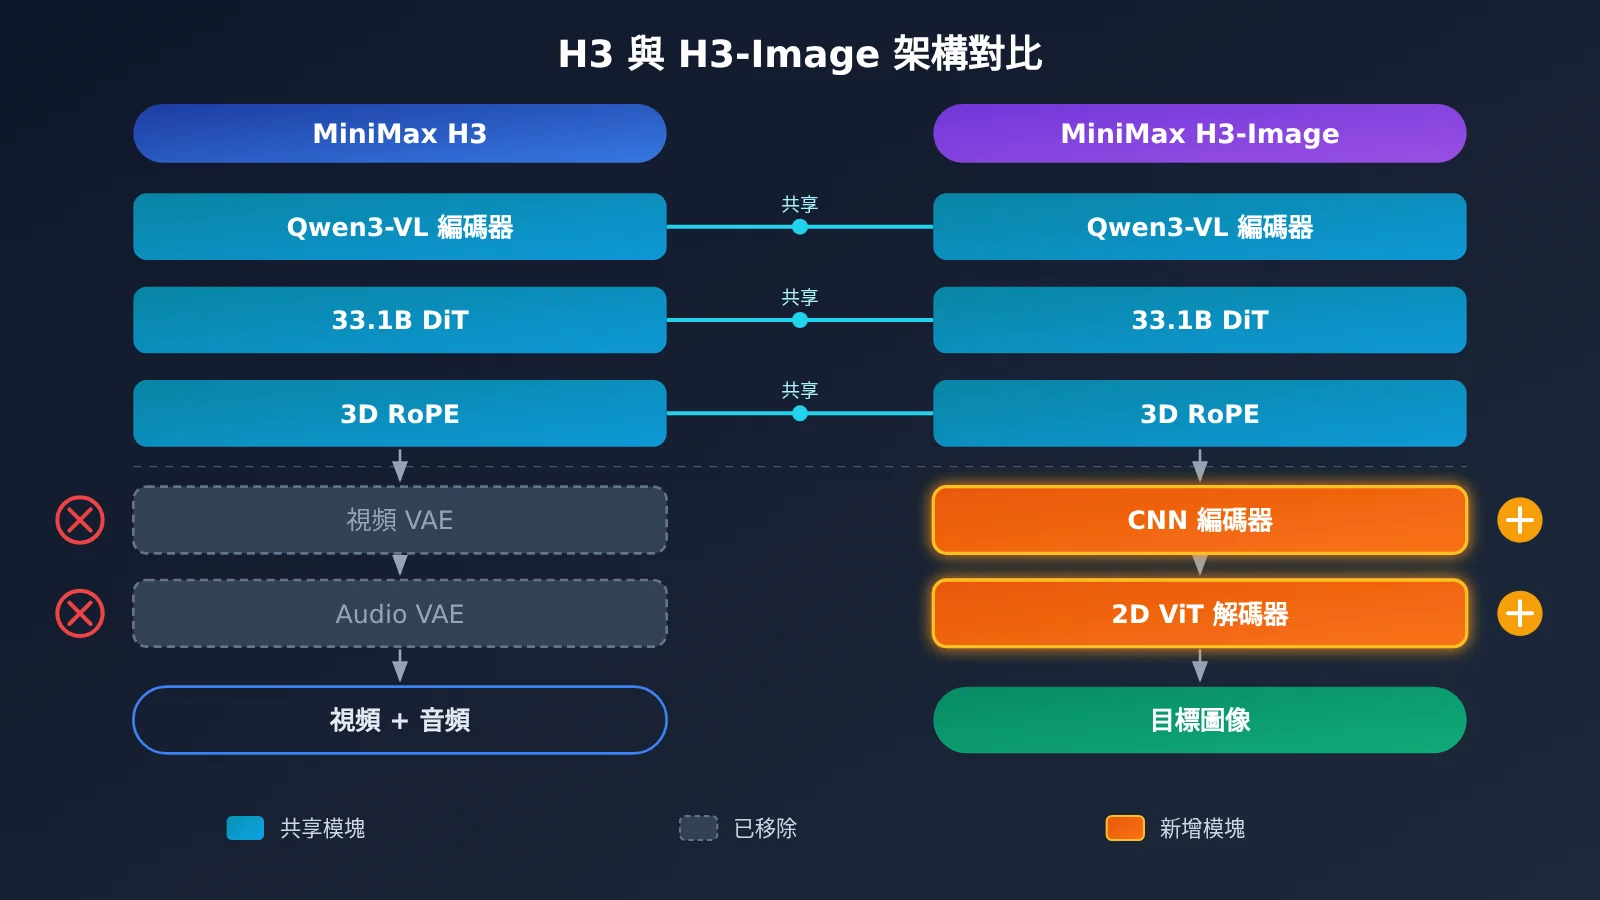
這是整個技術演化中最值得細看的部分。下表依據 H3-Image 官方模型卡整理:
| 類別 | 組件 | 具體做法 |
|---|---|---|
| 繼承 | Qwen3-VL 文本編碼器 | 沿用 H3 的完整文本編碼器,取第 50 層隱藏狀態 |
| 繼承 | 33.1B 單流 DiT | 保留 H3-Omni-Transformer 核心架構 |
| 繼承 | 3D Multimodal RoPE | 繼續用於編碼位置關係 |
| 刪除 | 音頻分支 | 不再做視頻與音頻聯合生成 |
| 替換 | 圖像專用 VAE | CNN 編碼器 + 24 層 2D ViT 解碼器 |
| 改變 | 生成目標 | 文本與參考圖編碼爲統一序列,預測目標圖像潛變量 |
繼承一:Qwen3-VL 文本編碼器與第 50 層隱藏狀態
H3-Image 模型卡說明,它沿用了 H3 中基於 Qwen3-VL 的文本編碼器,並使用其第 50 層的隱藏狀態作爲條件輸入。Qwen3-VL 本身是視覺語言模型,所以它不僅能讀懂文字,也能理解參考圖片的內容,這正是多參考圖編輯所需要的能力。
【行業常見做法】 至於爲什麼取中間層而不是最後一層,官方沒有展開解釋。業界通常認爲,語言模型最後幾層更偏向“預測下一個詞”,中間層保留的語義特徵更豐富、更通用。不少擴散模型都採用類似的做法。
繼承二:33.1B DiT 與 3D RoPE
H3-Image 的 DiT 主體規格如下:
| 參數 | 數值 | 通俗理解 |
|---|---|---|
| 參數量 | 33.1B | 與 H3 的約 33B 骨幹同一量級 |
| 層數 | 50 層 | 信息要經過 50 次變換 |
| Hidden Size | 5376 | 每個 token 的表示維度 |
| Attention Heads | 56 | 同時從 56 個角度關注 token 間關係 |
| FFN Size | 14336 | 每層前饋網絡的中間寬度 |
| VAE 空間下采樣 | 16 倍 | 4096 像素邊長壓縮到 256 |
| 潛變量通道 | 24 | 每個潛變量位置攜帶 24 個數值 |
| 單 token 覆蓋 | 約 32×32 像素 | 決定序列長度和計算量 |
按照“每個 token 約對應 32×32 像素”計算,一張 4096×4096 的圖像大約是 128×128 = 16384 個 token(這是我們根據官方參數做的估算)。如果再加上多張參考圖,序列會更長,這也解釋了爲什麼推理速度優化對它如此重要。
【我們的推論】 3D RoPE 在圖像任務裏依然有用。目標圖像只有一幀,但多張參考圖和目標圖需要在序列中區分“誰是誰”,額外的維度可以承擔這類區分。官方沒有公佈具體的位置分配方案,這裏只是一種合理的理解。
刪除:移除音頻分支
圖像沒有時間長度,也沒有聲音,保留音頻分支只會浪費訓練和推理資源。移除它之後,模型的學習目標從“視頻 + 音頻聯合分佈”收斂到“圖像分佈”,訓練信號也更集中。
替換:圖像專用 VAE
H3 的 Visual VAE 需要兼顧視頻的時間連續性,H3-Image 則換成了專門爲靜態圖像設計的 VAE。編碼器用 CNN,擅長高效提取局部紋理;解碼器是 24 層 2D ViT,可以在還原像素時兼顧全局結構。16 倍下采樣配合 24 個通道,意味着用較少的空間位置、較多的通道來保存信息,這對 16MP 級別的高分辨率輸出很關鍵。官方也強調,H3-Image 的高分辨率結果是直接生成的,而不是依賴傳統的超分放大器。
改變:從“預測視頻+音頻”到“預測目標圖像”
最終的生成流程是:文本提示詞和參考圖片一起編碼成統一序列,DiT 在潛變量空間裏逐步去噪,預測出目標圖像的潛變量,再由圖像 VAE 解碼成最終圖片。參考圖數量方面,模型卡給出的上限是 16 張,而 vLLM 部署配方中寫的是最多 9 張。兩者口徑不同,實際可用數量要以所用推理框架爲準。
MiniMax H3-Image 爲了更快更好用做了哪些優化
只改架構還不夠。MiniMax 在 H3-Image 發佈博客中提到,它在繼承 H3 預訓練能力的基礎上,對後訓練流程做了五方面改進:訓練數據、強化學習、採樣步數壓縮、提示詞增強(Prompt Enhancement)以及部署優化。官方沒有公開數據和強化學習的細節,下面重點講公開信息較多的部分。
6 步採樣蒸餾與取消 CFG
擴散模型生成圖像的過程是“從噪聲出發,一步步去噪”,常規做法通常需要數十步。另外,傳統擴散模型還普遍使用 CFG(Classifier-Free Guidance):每一步都要分別跑“有提示詞”和“無提示詞”兩次,再按比例混合結果,以增強對提示詞的遵循程度。
H3-Image 通過蒸餾把採樣壓縮到 6 步,同時不再需要 CFG。前者大幅減少了步數,後者讓每一步只需跑一次前向計算。對一個 33.1B 參數、單張圖上萬 token 的模型來說,兩者疊加正是“10 秒生成 4K”這一官方說法的技術基礎。需要注意,10 秒是廠商聲明,實際速度取決於硬件和部署配置。
提示詞增強:把簡短描述擴寫成可執行指令
H3-Image 提供了一個可選的 PE(Prompt Enhancement)模型,權重約 17.9GB,用來把用戶簡短的描述擴寫成更詳細、更適合模型理解的提示詞。如果你暫時不想部署這個額外模型,也可以用通用大模型實現類似的預處理思路。下面是一個極簡示例:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 API易 統一接口
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把這句擴寫成詳細的圖像生成提示詞:雨夜的賽博朋克街頭"}]
)
print(resp.choices[0].message.content)
查看完整的提示詞增強實現
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是圖像生成提示詞工程師。請把用戶的簡短描述擴寫爲結構化提示詞,"
    "依次包含:主體、構圖、光線、材質細節、色彩、鏡頭與畫幅。"
    "如果用戶提供了參考圖說明,請明確每張參考圖在畫面中的作用。"
    "只輸出提示詞正文,不要解釋。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"參考圖{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# 示例:空房間 + 傢俱參考圖的客廳合成
print(enhance_prompt(
    "把這些傢俱擺進空客廳,北歐風,午後自然光",
    ["空房間照片", "灰色布藝沙發", "橡木茶几", "落地燈"],
))
建議:搭建圖像生成工作流時,提示詞預處理環節可以先通過 API易 apiyi.com 接入多個主流大模型,對比不同模型的擴寫效果,再決定是否部署專用的 PE 模型。模型名稱以平臺模型列表爲準。
部署優化與高分辨率支持
官方推薦的部署框架包括 SGLang、vLLM-Omni、Diffusers 和 ComfyUI,適配硬件列出了 NVIDIA H200、RTX PRO 6000 Blackwell、AMD Instinct MI350X 等,並提供多 GPU 並行方案。圖像 VAE 的高壓縮率、6 步無 CFG 採樣和框架級推理優化組合在一起,才支撐起 16:9(5472×3072)、9:16(3072×5472)、21:9(6272×2688)等高分辨率畫幅的直接輸出。
MiniMax H3 架構複用的影響分析
對開發者的影響
- 共享底座,但不能互換:H3 和 H3-Image 共享文本編碼器,模型卡將其標註爲“共享的 H3 文本編碼器”(約 66.7GB),但 DiT 權重和 VAE 是各自獨立的,不能拿 H3 視頻權重直接出圖。
- 部署門檻依然很高:圖像主模型約 68.65GB,加上文本編碼器,完整下載約 135.35GB,這還只是存儲規模,不等於顯存需求。
- 許可證必須分開看:H3 和 H3-Image 是兩份不同的 Community License,觸發條件差異明顯,詳見下表。
| 項目 | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| 開源範圍 | 僅 H3-Base;Context-IR 和 Regenerate-2K 需調用官方 API | 圖像模型權重、共享文本編碼器、可選 PE 模型 |
| 本地可得效果 | 768p 音視頻生成;完整 2K 工作流依賴官方 API | 官方稱可直接輸出最高約 16MP |
| 商業授權觸發條件 | 商業產品及服務年收入超過 2000 萬美元 | 你和/或關聯方年化收入超過 100 萬美元,或向任何第三方提供託管服務 |
| 其他義務 | 地區限制等須查許可證原文 | 地區限制、輸出使用、產品標識等須查許可證原文 |
對比說明:上表整理自兩份許可證原文和官方模型卡,僅供技術選型參考,不構成法律意見。如果暫時不具備自部署或授權條件,可以先通過 API易 apiyi.com 調用其他主流圖像與多模態模型,搭建工作流原型。
對行業的影響
【官方確認】 H3-Image 複用 H3 的核心 Transformer 和文本編碼器,同時使用專用 VAE 和獨立的後訓練流程。
【我們的推論】 這說明視頻和圖像生成可以共享大量基礎能力,比如語義理解、多模態對齊和空間位置建模,但每個任務仍然需要專用的編解碼組件和針對性訓練。MiniMax 的路線更像是“先做一個統一的多模態底座,再按任務做專用化”,而不是爲每種生成任務從零訓練模型。如果這條路線走通,後續很可能出現更多基於同一骨幹網絡的衍生模型,但這目前只是行業推測。
常見問題 FAQ
Q1:H3-Image 是不是 H3 視頻模型直接切換成圖片輸出?
不是。H3-Image 繼承了 H3 的 Qwen3-VL 文本編碼器、33.1B 單流 DiT 架構和 3D RoPE,但移除了音頻分支,換用 CNN 編碼器加 2D ViT 解碼器的圖像專用 VAE,並單獨做了數據、強化學習、蒸餾等後訓練。
Q2:MiniMax H3 和 H3-Image 的參數量爲什麼幾乎一樣?
因爲兩者的核心 Transformer 來自同一套架構,H3 約 33B,H3-Image 的 DiT 爲 33.1B。參數量相近說明骨幹網絡被整體保留了,差異主要體現在編解碼組件和訓練目標上。
Q3:H3-Image 到底支持多少張參考圖?
官方模型卡給出的上限是 16 張,vLLM 部署配方寫的是最多 9 張。前者是廠商聲明,後者是特定框架的測試配置,實際使用時以你選用的推理框架爲準。
Q4:6 步採樣、取消 CFG 會不會影響畫質?
官方認爲蒸餾後仍能保持高質量輸出,但目前公開的主要是廠商自己的展示。建議在你的實際場景中做對比測試,重點觀察複雜指令遵循和多參考圖組合的效果。
Q5:沒有 H200 級別顯卡,如何先驗證圖像生成工作流?
可以先用雲端 API 把工作流跑通:
1. 在 API易 apiyi.com 註冊並獲取 API Key 和免費測試額度
2. 用本文的提示詞增強代碼(base_url 爲 `https://api.apiyi.com/v1`)搭好預處理環節
3. 接入平臺上已有的主流圖像模型,驗證整條鏈路後再評估是否自部署
Q6:能否部署 H3-Image 後對外提供 API 服務?
需要特別謹慎。根據 H3-Image 許可證,向任何第三方提供託管服務都需要事先獲得 MiniMax 的書面授權,與收入規模無關。具體條款請以許可證原文爲準,必要時諮詢法律意見。
MiniMax H3 架構演化核心要點 Key Takeaways
- 同源不同用:H3-Image 複用 H3 的核心 Transformer 和文本編碼器,並不是簡單切換輸出模式
- 三處關鍵改造:移除音頻分支、換用圖像專用 VAE、生成目標改爲預測圖像潛變量
- 語義理解來自 Qwen3-VL:取第 50 層隱藏狀態,同時理解文字和參考圖
- 速度來自蒸餾:6 步採樣且無需 CFG,是官方“10 秒 4K”說法的技術基礎
- 許可證分開看:H3-Image 的託管服務和 100 萬美元收入門檻都會觸發授權要求
- 先驗證再部署:可以先通過 API易 apiyi.com 用多模型搭原型,再評估自部署成本
總結
MiniMax H3 從視頻到圖像的演化,核心可以概括爲三點:
- 共享底座:33B 級單流多模態 Transformer、Qwen3-VL 文本編碼器和 3D RoPE 被完整保留。
- 任務專用化:刪掉音頻分支,換上 CNN + 2D ViT 的圖像 VAE,生成目標從視頻+音頻潛變量變爲圖像潛變量。
- 訓練與推理重做:數據、強化學習、6 步無 CFG 蒸餾、提示詞增強和部署優化共同支撐起 16MP 級輸出。
對開發者來說,真正值得研究的是“哪些能力可以共享、哪些必須專門訓練”,以及權重背後的硬件成本和許可義務。在決定是否自部署之前,推薦先通過 API易 apiyi.com 用統一接口對比多個模型,快速跑通你的圖像工作流。
📚 參考資料
- MiniMax H3 官方技術介紹:H3-Omni-Transformer 架構說明
- 鏈接:
minimax.io/blog/minimax-h3 -
說明:多模態編碼路徑與 3D Multimodal RoPE 的官方描述
-
MiniMax H3-Image 官方發佈博客:後訓練與推理優化
- 鏈接:
minimax.io/blog/minimax-h3-image -
說明:數據、強化學習、6 步蒸餾、提示詞增強等改進
-
H3-Image Hugging Face 模型卡:完整架構參數
- 鏈接:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
說明:DiT、VAE、文本編碼器的具體規格
-
H3 原始模型卡與許可證:視頻模型規格與授權條款
- 鏈接:
huggingface.co/MiniMaxAI/MiniMax-H3 -
說明:H3 規格以及
blob/main/LICENSE許可證原文 -
H3-Image 許可證原文:商業授權條件
- 鏈接:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
說明:託管服務與收入門檻等條款
-
vLLM 部署配方:框架測試配置
- 鏈接:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - 說明:參考圖數量等框架側口徑
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心