著者注:同じ中国発のオープンソースモデルが、Menlo Venturesの支出ランキングとOpenRouterのリクエストランキングでは逆の順位になっています。この記事では、両ランキングの集計方法を解きほぐし、すぐに実践できる5ステップのモデル選定方法を紹介します。
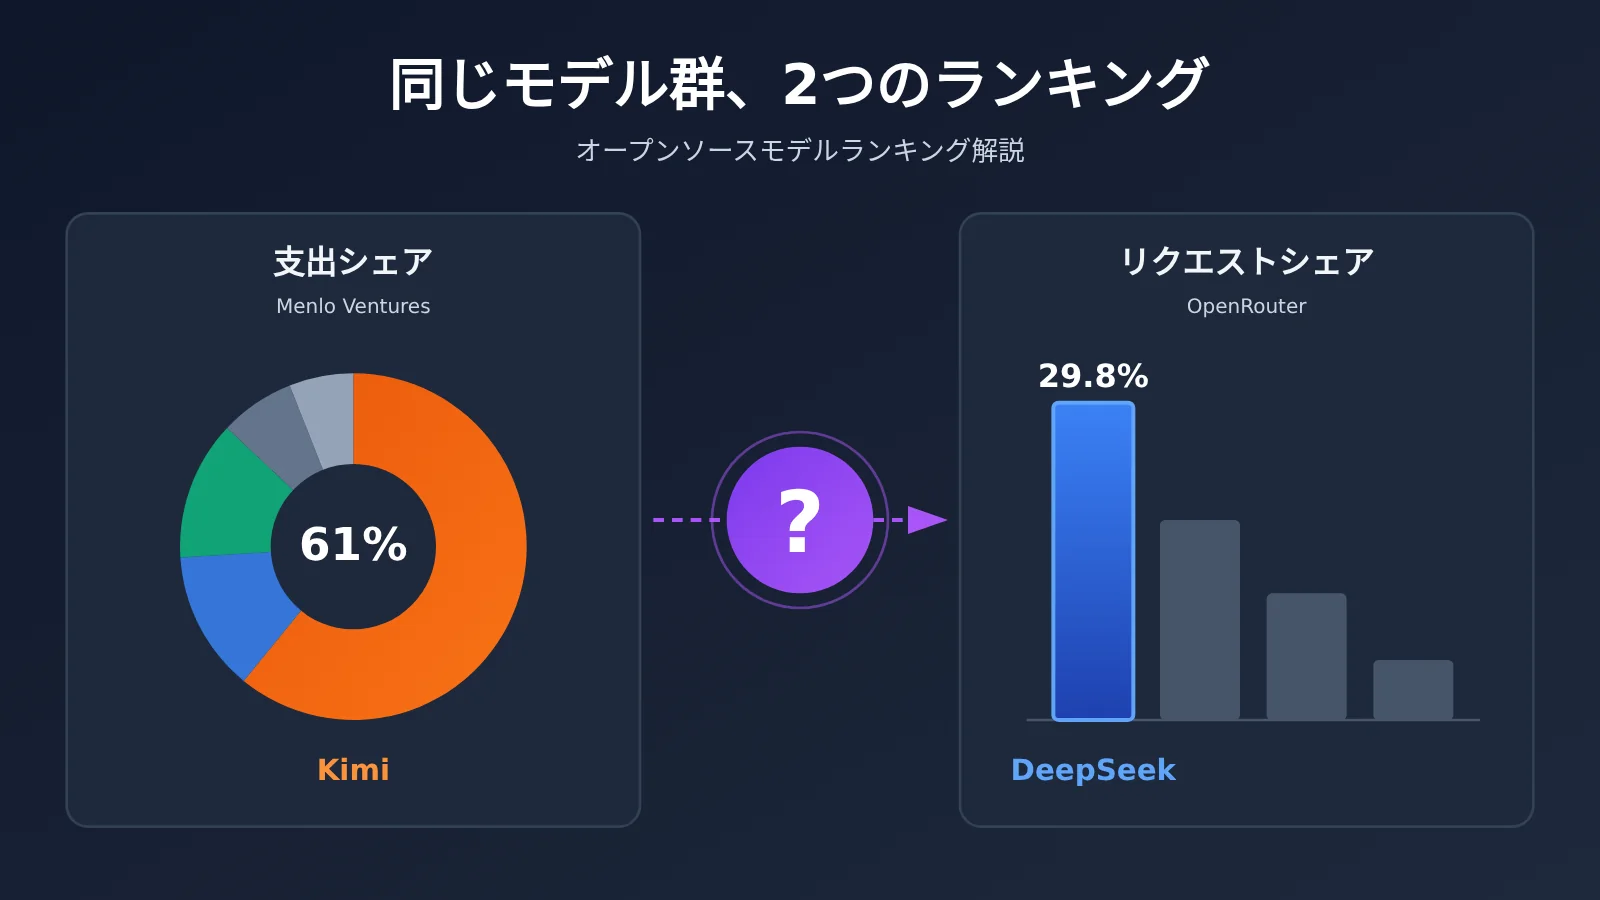
11月初めに、2つのデータが発表されました。Menlo Venturesのレポートによると、Kimiは米国企業のオープンソースモデルへの支出の61%を占めています。一方、OpenRouterの週間ランキングでは、DeepSeekがプラットフォーム上のテキストリクエストの29.8%を占めています。両者の1位は異なり、順位はほぼ逆です。多くの技術責任者が最初に抱く疑問は、「いったいどちらを信じればいいのか?」でしょう。
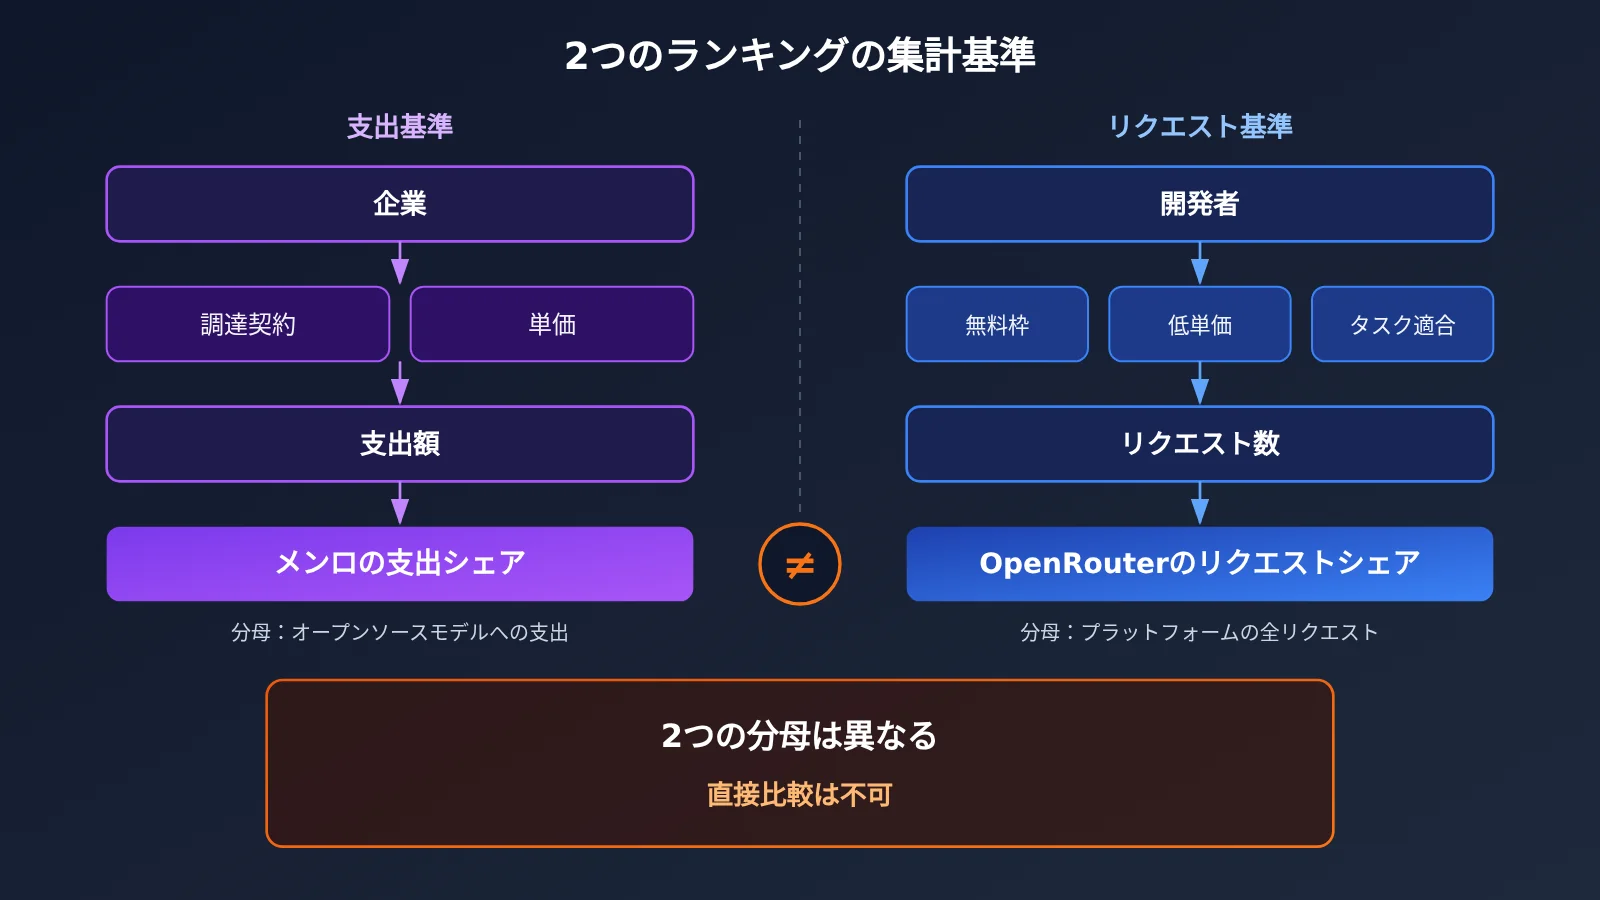
結論から言えば、2つのランキングは矛盾していません。測っているものが違うからです。支出ランキングは「企業がどこにお金を払ったか」を、リクエストランキングは「開発者が特定のプラットフォーム上でどのモデルを呼び出したか」を示しています。モデル選定では、どちらか一方のランキングをそのまま参考にするのではなく、自社のタスクの種類やコストの捉え方に基づいて判断する必要があります。ランキングは候補を絞り込む助けにはなりますが、選定の判断までは代わりにしてくれません。
この記事は、単にランキングを紹介するだけではありません。それぞれのランキングの調査対象、集計期間、適用できる範囲を説明したうえで、「単価が下がり、利用量が増える」ことがコスト構造にどう影響するかを解説します。最後に、5ステップのモデル選定チェックリストを紹介します。
オープンソースモデルのランキング要点:KimiとDeepSeekがそれぞれ1位になった理由
結論から言うと、メンロ・ベンチャーズは企業の支出を、OpenRouterはプラットフォーム上のリクエストを測定しています。両者はサンプル、期間、集計対象がいずれも異なります。
この2つのデータは一緒に議論されることがよくありますが、「分母」はまったく異なります。メンロ・ベンチャーズのデータは、米国企業のAIに関する意思決定者を対象としたアンケートに基づく推計であり、監査済みの請求額ではありません。一方、OpenRouterのデータは自社プラットフォーム上のリクエスト統計に基づくもので、そのプラットフォームのユーザー行動を反映しているにすぎず、市場全体を代表するものではありません。
| ランキング | 測定対象 | サンプル・期間 | 主な順位 | 判断に役立つこと |
|---|---|---|---|---|
| メンロ・ベンチャーズ 2026年企業AI現状レポート | 米国企業によるオープンソースモデルへの支出シェア | 米国企業のAI意思決定者約400人を対象に、2026年9月8日〜26日に調査、11月3日公開 | Kimi 61%、DeepSeek 15%、GLM 11%、Meta Llama 7%、Qwen 3% | 企業の調達傾向、予算の流れ、どのモデルが正式な契約に採用されたか |
| OpenRouter週間ランキング | プラットフォーム上のテキストリクエストシェア | OpenRouterプラットフォーム、10月26日〜11月1日 | DeepSeek 29.8%、OpenAI 18.8%、Z.ai 11.9%、Qwen 5.6%(6位) | 開発者の利用状況、価格に敏感なモデル呼び出し、コミュニティでの人気 |
表を見ると、2つのランキングは「参加者」さえ異なることがわかります。メンロ・ベンチャーズはオープンソースモデルのみを集計していますが、OpenRouterはOpenAIやGoogleのようなクローズドソースの企業も含めています。2つの割合を直接比較すること自体、集計基準がかみ合っていません。
Menlo Venturesの支出ランキングをどう読むか:Kimiがオープンソースモデル支出の61%を占める
結論から言うと、Menlo Venturesのデータは、中国のオープンソースモデルが米国企業の予算に組み込まれていることを示しています。ただし、これは調査に基づく推計であり、性能ランキングではありません。
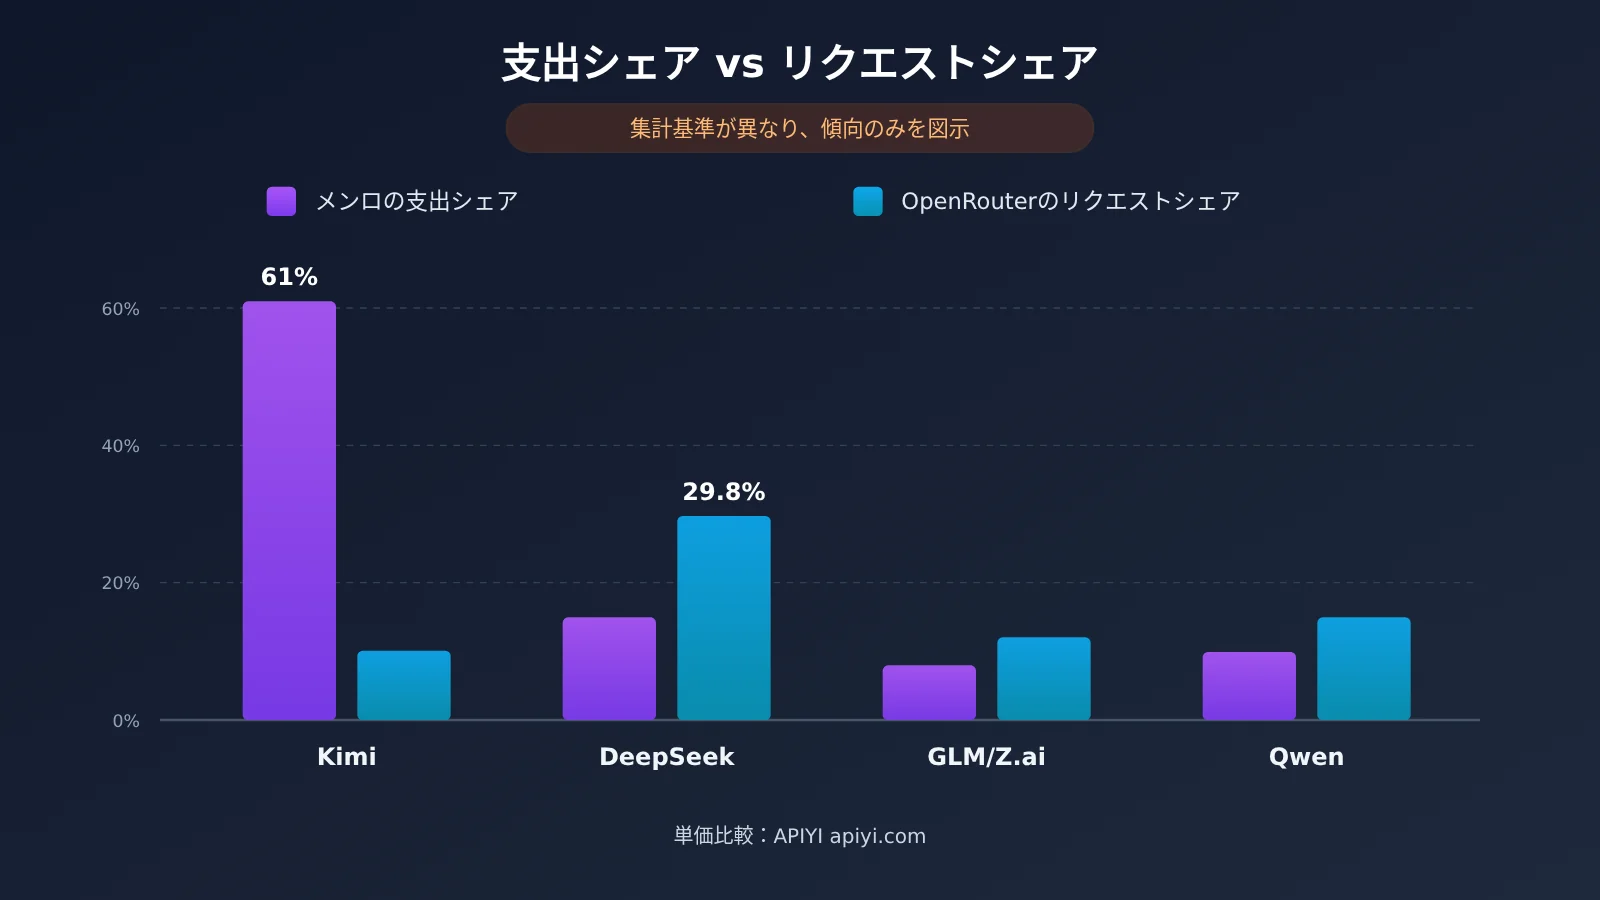
レポートで最も注目を集めたのは、米国企業のオープンソースモデル支出の89%を中国のモデルが占めるという数字です。内訳はKimiが単独で61%、DeepSeekが15%、GLMが11%、Qwenが3%です。中国以外のモデルでは、Meta Llamaが7%を占めています。
| モデル | 米国企業のオープンソースモデル支出に占める割合 | 読み解くポイント |
|---|---|---|
| Kimi | 61% | シェアが最も高く、企業の調達経路や単価が関係している可能性がある |
| DeepSeek | 15% | 支出額は2位だが、呼び出しの面ではより活発 |
| GLM | 11% | 企業予算に安定して組み込まれている |
| Meta Llama | 7% | 中国以外のオープンソースモデルで最もシェアが高い |
| Qwen | 3% | 支出シェアは小さいが、呼び出しの面では一定の存在感がある |
これらの数字を全体像の中で見ると、より分かりやすくなります。レポートによると、世界の企業によるAI導入支出は年換算で約1768億ドルと推計され、3年間で100倍以上に増加しました。最先端のAI研究開発企業が導入支出の69%を占める一方、オープンソースモデルはモデル全体の支出のわずか4%にとどまります。つまり、「Kimiが61%を占める」というのは、オープンソースという小さな枠の中での61%であり、企業向けAI市場全体の61%ではありません。
また、アンケートのデータは回答者による自社予算の見積もりに依存しており、約400件のサンプルも米国企業に限られています。企業の調達動向を示すデータとして参考にしつつ、具体的な割合は調査に基づく推計であり、さらに多くのデータによる検証が必要だと捉えるのが妥当です。
OpenRouterのリクエストランキングの読み方:DeepSeekが29.8%を占める
結論から言うと、OpenRouterの週間ランキングは、このプラットフォーム上での開発者によるモデル呼び出しの人気を反映したものです。トレンドは読み取れますが、市場全体のシェアを示すものではありません。
10月26日から11月1日までの週は、テキストリクエストのシェアでDeepSeekが29.8%を獲得して1位となり、前週比で7%増加しました。OpenAIは18.8%で2位、Googleのシェアは14.4%から低下し、Z.aiは11.9%で4位、Qwenは5.6%で6位でした。
| 順位情報 | 提供元 | リクエストシェア | 変化 |
|---|---|---|---|
| 1位 | DeepSeek | 29.8% | 前週比 +7% |
| 2位 | OpenAI | 18.8% | — |
| 下落 | 14.4%から低下 | シェアが低下 | |
| 4位 | Z.ai | 11.9% | — |
| 6位 | Qwen | 5.6% | — |
ほかにも、注目したいトレンドが2つあります。中国のモデルのトークン利用量は、27週連続で米国のモデルを上回っています。また、モデル別の週間利用量トップ5のうち、4つを中国のモデルが占めました。同じ時期にDeepSeekはモデルを DeepSeek V4.1-Flash-1017 にアップグレードしましたが、APIの呼び出し方法と料金は変わっていません。すでに導入している開発者にとっては、移行コストが低く抑えられます。
安定性にも注意が必要です。11月3日には、DeepSeekのWeb版とAPIで約1時間の部分的な障害が発生しました。利用量が多くても、常に利用できるとは限りません。これが、後ほど説明する「予備のモデルを用意しておく」理由です。新バージョン公開後の具体的なモデルIDと料金については、APIYI apiyi.comのコンソールにあるモデル一覧を確認してください。
なぜオープンソースモデルの支出ランキングとリクエストランキングは逆転するのか
結論から言うと、ランキングが逆転する主な要因は、単価、調達方法、無料枠、タスクとの相性、集計対象の5つです。どちらかのランキングが「間違っている」わけではありません。
支出シェアは、おおむね「呼び出し回数 × 単価」に、契約や調達の条件を加味して決まります。一方、リクエストシェアは呼び出し回数だけを数え、1回あたりの費用は考慮しません。単価が高く、企業が調達契約を結ぶモデルは、支出ランキングで上位に入りやすくなります。単価が低く、多くの開発者に使われるモデルは、リクエストランキングで上位に入りやすくなります。
| 影響する要因 | 支出シェアへの影響 | リクエストシェアへの影響 |
|---|---|---|
| 単価 | 単価が高いと、同じ使用量でも費用がかさみ、支出シェアが大きくなる | 単価が低いと試しやすくなり、リクエスト数が増える |
| 企業調達 | 契約、プライベート環境へのデプロイ、サービス契約が支出に計上される | 必ずしも OpenRouter を経由するわけではなく、プラットフォーム上では把握できない |
| 無料枠 | 無料の呼び出しは支出を生まない | 無料の呼び出しもリクエスト数に計上される |
| タスクとの相性 | 長文書やエージェントなど、トークン消費の多いタスクが費用を押し上げる | 短い対話や小規模なタスクの一括処理が回数を押し上げる |
| 集計対象 | 調査対象となった米国企業のみ | OpenRouter ユーザーのみ |
この枠組みで見ると、Kimi は企業の調達チャネルや単価の面で有利なため、支出シェアが高い可能性があります。一方、DeepSeek は単価が低く、開発者コミュニティが活発なため、リクエスト数が多いと考えられます。ただし、これは集計対象の違いに基づく合理的な推測であり、両レポート自体には項目ごとの内訳は示されていません。
見落とされがちな点として、同じモデルでもバージョン、接続チャネル、キャッシュヒット率の違いによって、支出と呼び出しの数字に差が生じます。あるチームでキャッシュが頻繁にヒットする場合、リクエスト回数はそのまま計上されますが、実際の支出は大幅に低くなります。
オープンソースモデルの価格と利用量:単価約7割減、利用量22.5倍が意味すること
結論から言うと、単価の下落は総コストの削減を意味しません。100万トークンあたりの単価よりも、「1つのタスクを完了するためのコスト」で比較するほうが確実です。
メンロのレポートには、重要な数字が示されています。トークンの平均価格は 0.45 米ドル/100万トークン から 0.13 米ドル/100万トークン へと約7割下がった一方、同じ期間に利用量は22.5倍に増えました。この2つの数字から大まかに計算すると、総支出は減るどころか、もとの約6.5倍になります。これはあくまでレポートの平均値を使った試算であり、実際の状況はチームによって異なります。
オープンソースモデルでは、この傾向がより顕著です。企業のトークン利用量の19%を占める一方、モデルへの支出に占める割合はわずか4%です。つまり、大量のトークンが安価なオープンソースモデルで使われているものの、支出の大部分は最先端のクローズドモデルに向かっています。
開発者にとって、単価の下落は呼び出し回数の増加につながります。特に、Agentやバッチ処理ではその傾向が顕著です。実際のコストを考える際は、次の変数も考慮する必要があります。
- キャッシュヒット:繰り返し使うシステムプロンプトや長いコンテキストがキャッシュにヒットするかどうかで、実質的な単価が大きく変わります。
- コンテキストの長さ:長い文書を扱うタスクでは、入力トークンが出力トークンを大幅に上回ることがよくあります。
- 再試行回数:出力が安定しなかったり、形式に誤りがあったりして再試行すると、コストが何倍にも増えることがあります。
- ツール呼び出しのラウンド数:Agentのタスクでは、1回の処理で十数ラウンドのやり取りが発生することもあり、単価が安くても回数が増えます。
価格を比較する際は、まず APIYI apiyi.com のコンソールで候補モデルの表示価格と課金方式を確認し、入力・出力・キャッシュがそれぞれどう計算されるかを把握しましょう。そのうえで、自分のタスクで少数のサンプルを実行し、「1つのタスクの完了にいくらかかったか」を計算します。この数字のほうが、表示単価よりも参考になります。
オープンモデルの選び方:ランキングで候補を絞り、タスクに合わせて決める
結論から言うと、ランキングは候補を絞るためのものです。最終的な判断は、タスクとの相性、コスト、安定性、少数のサンプルによる検証を踏まえて行いましょう。
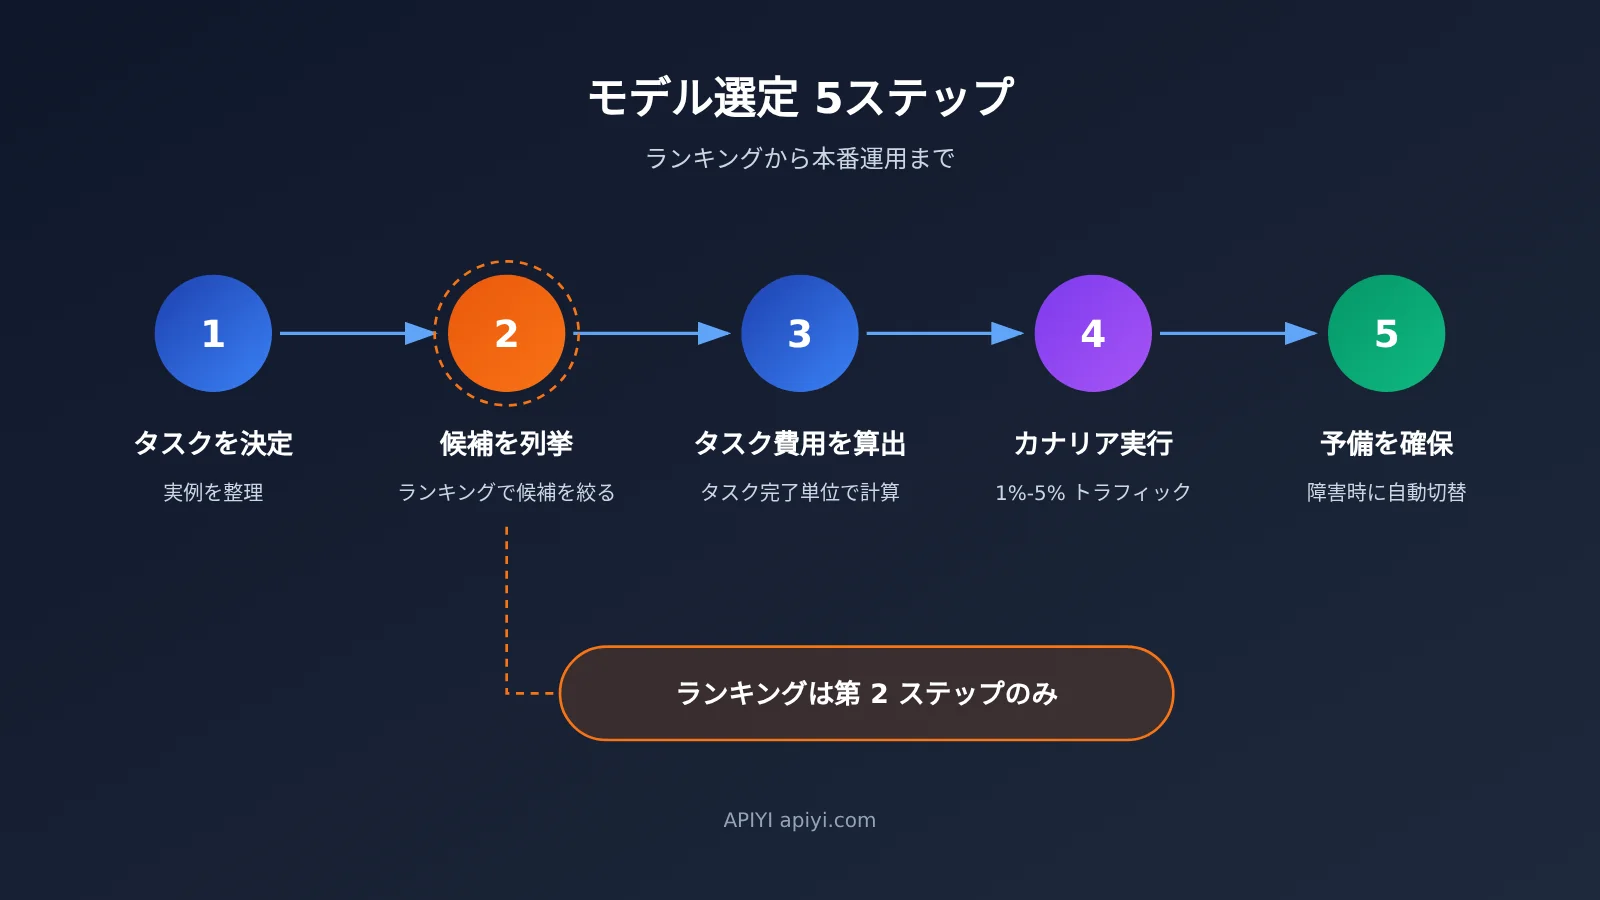
モデル選定は「タスク → コスト → 安定性 → 検証 → 代替モデル」の順に進められます。以下の表に、各項目で確認したい質問と検証方法をまとめました。
| 項目 | 確認したい質問 | 検証方法 | コストへの影響 |
|---|---|---|---|
| タスクとの相性 | 主な用途はプログラミング、長文ドキュメント、マルチモーダル、Agentのツール呼び出しのどれか? | 実際のタスクから30-100件のサンプルを用意し、出力を人手で評価する | 相性が悪いと再試行や手作業での修正が増える |
| 単価とキャッシュ | 入力、出力、キャッシュヒット時の料金はそれぞれいくらか? | コンソールのモデル一覧と料金説明を確認し、キャッシュヒット率を集計する | 100万トークンあたりの実質単価が決まる |
| コンテキスト | 最大でどのくらいの長さを入力するか?長すぎる場合に性能は低下するか? | 実際に扱う最長のドキュメントで、切り詰めと情報の検索精度をテストする | 長いコンテキストは入力トークン数を直接押し上げる |
| レート制限 | 同時リクエスト数と1分あたりのリクエスト上限は十分か? | ピーク時のトラフィックに合わせて負荷テストを行う | 制限された場合は待機や切り替えが必要になり、レイテンシに影響する |
| 地域での可用性 | デプロイ先の地域から安定してアクセスできるか? | 本番環境のある地域から実際に呼び出す | 利用できなければ別の接続手段を探す必要がある |
| 安定性 | 最近サービスの中断はあったか?復旧までにどのくらいかかるか? | 障害履歴を調べ、エラー率のログを確認する | 中断は再試行コストやビジネス上の損失につながる |
複数モデルの比較は、この段階で最も時間がかかる作業です。候補モデルごとに登録し、個別にSDKを連携するとなると、接続だけで数日かかることもあります。APIYI apiyi.com なら、1つのAPIキーでOpenAI、Claude、Gemini、DeepSeek、Kimiなど、さまざまなモデルを呼び出せます。インターフェースはOpenAI形式と互換性があり、base_urlを https://api.apiyi.com/v1 に設定したうえで、リクエストのmodelパラメータを変更するだけでモデルを切り替えられます。同じサンプルを使った横断比較も素早く実施できます。
安定性は、提供元の発表だけで判断できません。DeepSeekの11月3日のサービス中断は、どのモデルも一時的に利用できなくなる可能性があることを示しています。APIYI apiyi.com のコンソールでは、モデルごとの使用量や呼び出しログを確認でき、エラー率、レイテンシ、トークン消費量も記録されるため、カナリアリリースの段階で候補モデルの実際の性能を観察するのに役立ちます。プラットフォームは複数ノードでのデプロイとインテリジェントルーティングを採用し、自動フェイルオーバーも提供しています。アプリケーション側でも代替モデルを設定し、メインモデルでエラーが発生したら切り替えることで、単一障害点の影響を小さく抑えられます。
カナリアリリースは、実際のトラフィックの1%-5%から始め、数日間にわたってエラー率、レイテンシ、タスクあたりのコストを観察することをおすすめします。データが安定してから徐々にトラフィックを増やしましょう。ランキングを見ただけで、一度にすべてを切り替えるのは避けてください。
オープンソースモデルランキングのよくある質問 FAQ
結論:以下の5つの質問では、オープンソースモデルのランキングを読む際によくある誤解を取り上げます。
Q1:Kimiの支出シェアが61%ということは、Kimiのモデルのほうが優れているのですか?
いいえ。支出シェアはどこにお金が流れたかを示すもので、単価や企業の調達契約、利用チャネルに左右されます。モデルの能力と直接対応するものではありません。また、メンロのデータは調査に基づく推計で、対象も米国企業のオープンソースモデルへの支出に限られています。「支出が1位」と「能力が1位」は別の話です。能力は自社のタスクで評価しましょう。
Q2:OpenRouterのリクエストランキングは企業の調達状況を反映していますか?
いいえ。OpenRouterが集計しているのは自社プラットフォーム上のリクエストシェアで、ユーザーの中心は開発者や中小規模のチームです。企業の直接契約やプライベート環境へのデプロイ、その他のチャネルは集計に含まれていません。開発者の間での人気や、価格に敏感なモデル呼び出しの傾向を見るには適していますが、企業の予算配分を推測するには適していません。
Q3:単価が安いモデルは、総コストも必ず安くなりますか?
必ずしもそうではありません。単価が安いモデルでも、リトライの回数が増えたり、より長いプロンプトやツール呼び出しの繰り返しが必要になったりすると、総トークン消費量がかえって増える場合があります。「1つのタスクを完了する」単位でコストを計算するのがおすすめです。APIYI apiyi.comのコンソールで各呼び出しのトークン使用量と料金ログを確認し、同じタスク群を完了するための総費用をモデル間で比較しましょう。
Q4:オープンソースモデルはクローズドソースモデルを完全に置き換えられますか?
タスクによって異なります。メンロのデータによると、オープンソースモデルは企業のトークン使用量の19%を担っていますが、支出に占める割合はわずか4%です。多くのチームが大量処理や定型タスクをオープンソースモデルに任せ、複雑なタスクは引き続き最先端のクローズドソースモデルに任せていることがうかがえます。堅実な方法は、両者を併用することです。APIYI apiyi.comを通じて同じキーでオープンソースとクローズドソースの両モデルにアクセスし、タスクの難易度に応じて振り分けましょう。
Q5:オープンソースモデルのランキングはどのくらいの頻度で確認すればよいですか?
週間ランキングは月に1回程度チェックし、単週の変動を追うよりも傾向を見ましょう。年次・四半期の調査レポートは公開時にじっくり読み、集計方法やサンプルに変化がないか確認します。意思決定に本当に影響するのは自社の業務指標を継続的に監視することです。エラー率、タスクあたりのコスト、ユーザーフィードバックなどは、週ごとに振り返ることをおすすめします。
オープンソースモデルのランキング解説まとめ:5ステップの選定チェックリスト
結論:2つのランキングが測っているものは異なります。まず集計基準を確認し、次にサンプルを見て、最後に自分のタスクで検証しましょう。
要点を振り返ります。
- 支出 ≠ 呼び出し:Menlo Venturesは企業の支出、OpenRouterはプラットフォーム上のリクエストを集計しています。母数が異なるため、直接比較はできません。
- 調査 ≠ 監査:Menlo Venturesのデータは、米国企業の意思決定者約400人を対象とした調査に基づく推計です。OpenRouterのデータは同プラットフォームのみを対象としています。
- 安い ≠ 節約できる:単価が約7割下がっても、利用量が22.5倍になれば総支出は増えます。タスク単位のコストで計算しましょう。
- 人気 ≠ 安定:呼び出し数が1位のモデルでも中断は起こります。バックアップはあらかじめ用意しておく必要があります。
- ランキングは候補を絞り込むためのものです。選定そのものを代わりに行ってはくれません。
次のモデル選定には、以下のチェックリストをそのまま活用できます。
- タスクを定義する:主なタスクの種類(プログラミング、長文書、マルチモーダル、Agent)を明確にし、30〜100件の実際のサンプルと評価基準を用意します。
- 候補を挙げる:支出ランキングとリクエストランキングからそれぞれ2〜3モデルを参考に選び、比較基準としてクローズドモデルを1つ加えます。候補は合計3〜5個に絞りましょう。
- タスク単位のコストを計算する:同じサンプルをすべての候補で実行し、token使用量、キャッシュヒット、リトライ回数を記録して、1タスクあたりのコストと品質スコアを算出します。
- カナリアリリースを実施する:選んだモデルにまず実トラフィックの1%〜5%を流し、数日間のエラー率、レイテンシ、コストを観察します。基準を満たしてから段階的にトラフィックを増やします。
- バックアップを用意する:少なくとも1つ、異なるベンダーのバックアップモデルを設定し、切り替えルールを定めて定期的に訓練します。
ステップ3〜5を同じ環境で進めたい場合は、APIYI apiyi.com を通じて1つのキーで候補モデルにアクセスし、コンソールで価格・使用量・ログを比較できます。プラットフォームの自動フォールバック機能と組み合わせれば、バックアップへの切り替えも設定できます。新規ユーザーには無料のテスト枠があるため、まずは少数のサンプルで検証するのに適しています。
本記事のデータソース
- Menlo Ventures 2026年企業AI現状レポート:2026年11月3日公開
- リンク:
menlovc.com -
説明: 企業のAI支出、オープンソースモデルの支出シェア、token価格の変化に関する調査推計
-
OpenRouter モデルランキング:2026年10月26日〜11月1日の週間ランキング
- リンク:
openrouter.ai/rankings - 説明: プラットフォーム上のテキストリクエストのシェアとtoken呼び出しの動向。同プラットフォームのみを対象
著者: APIYI 技術チーム
技術に関するお問い合わせ: モデル選定中に価格、レート制限、切り替えについてお困りの場合は、APIYI apiyi.com のホームページからお問い合わせください。導入に関する詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。