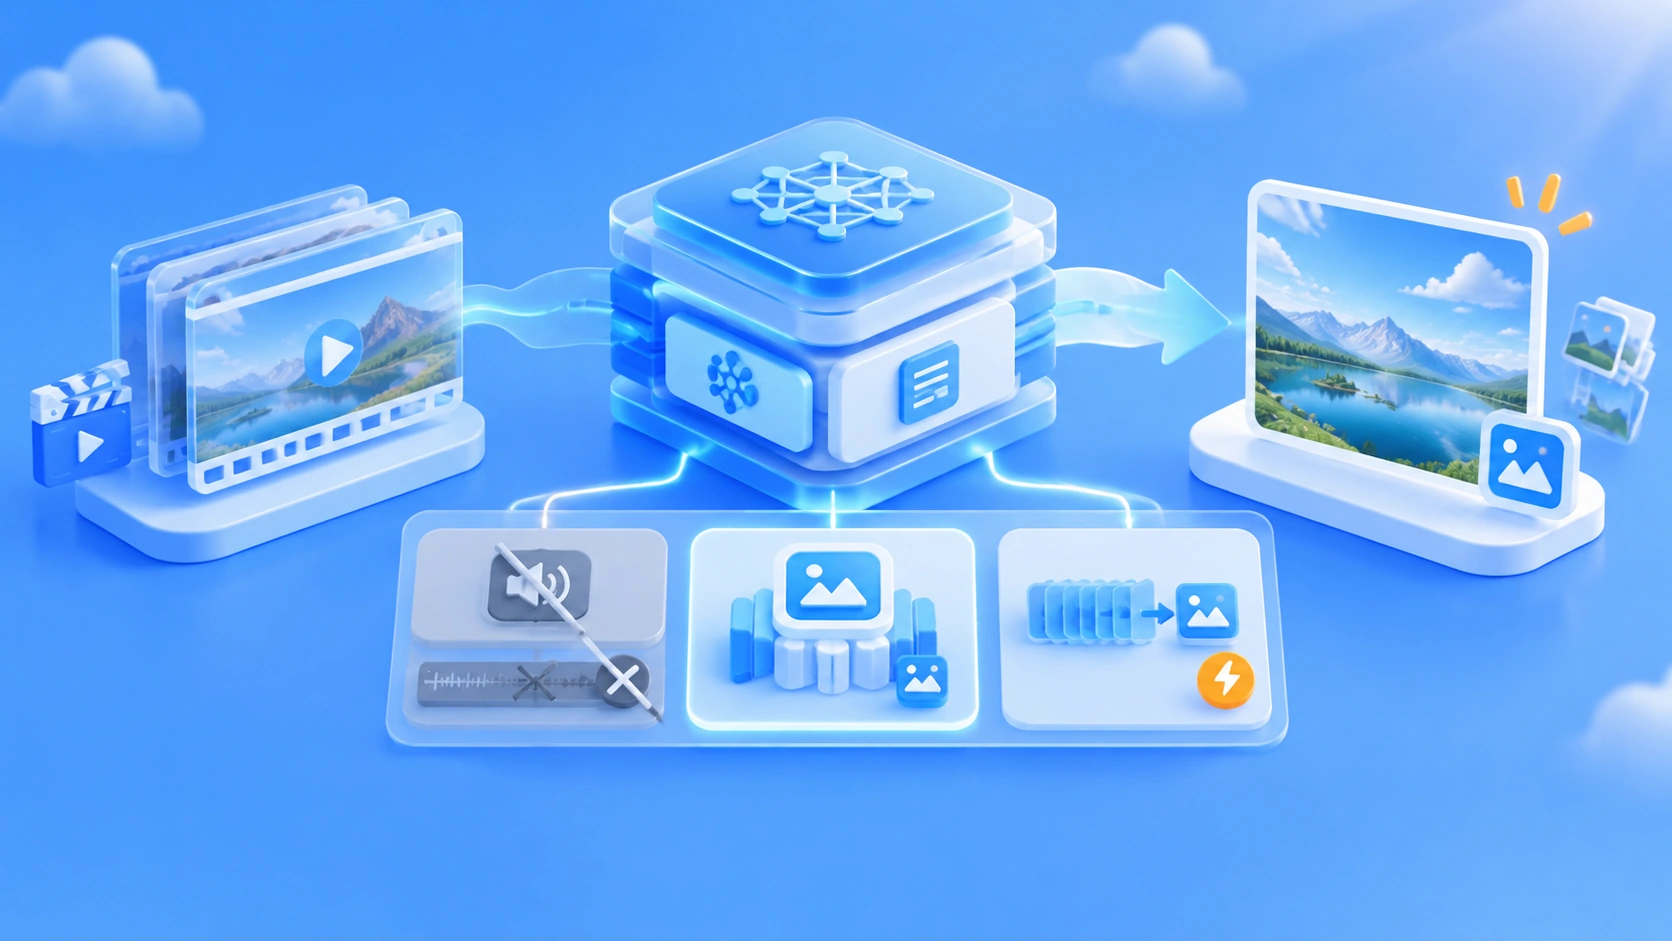
Note de l’auteur : H3-Image reprend l’architecture multimodale de base de H3, y ajoute des composants spécifiques à l’image et réoptimise l’entraînement comme l’inférence. Le résultat est un modèle de génération d’images à part entière. Cet article passe en revue ce qu’il a hérité de H3, ce qui a été retiré et ce qui a été ajouté.
Les 6 termes à connaître avant de plonger dans l’architecture de MiniMax H3
Les concepts ci-dessous reviennent souvent dans la suite de l’article. Voici d’abord une définition en une phrase pour chacun.
| Terme | Explication simple | Rôle dans MiniMax H3 |
|---|---|---|
| Transformer | Réseau de neurones qui traite des données séquentielles et capte bien les relations entre les éléments d’une séquence | H3-Omni-Transformer est le cœur de toute la famille de modèles |
| DiT | Modèle de diffusion construit avec un Transformer, qui génère du contenu par débruitage progressif | Le corps de H3-Image est un DiT à flux unique de 33,1 milliards de paramètres |
| VAE | Modèle qui encode et décode entre les pixels et une représentation compressée, un peu comme un « compresseur + décompresseur » | H3 utilise un VAE visuel et un VAE audio ; H3-Image passe à un VAE spécifique à l’image |
| Variable latente | Représentation compacte des données d’origine après compression ; calculer dans cet espace coûte bien moins cher que de travailler directement sur les pixels | Ce que le Transformer prédit, ce sont les variables latentes, pas les pixels |
| RoPE | Encodage positionnel rotatif, qui indique au modèle la position de chaque token dans la séquence | H3 utilise un RoPE multimodal 3D pour exprimer les positions dans le temps et dans l’espace |
| Distillation | Entraîner un modèle pour qu’un processus complexe, qui demandait beaucoup d’étapes, s’exécute en quelques étapes seulement | H3-Image est distillé pour ne nécessiter que 6 étapes d’échantillonnage |
En novembre 2026, MiniMax a ouvert les poids de son modèle de génération d’images H3-Image. H3, ouvert trois mois plus tôt, génère des vidéos accompagnées d’un son stéréo. Le nouveau modèle compte lui aussi environ 33 milliards de paramètres, et son architecture centrale vient de H3.
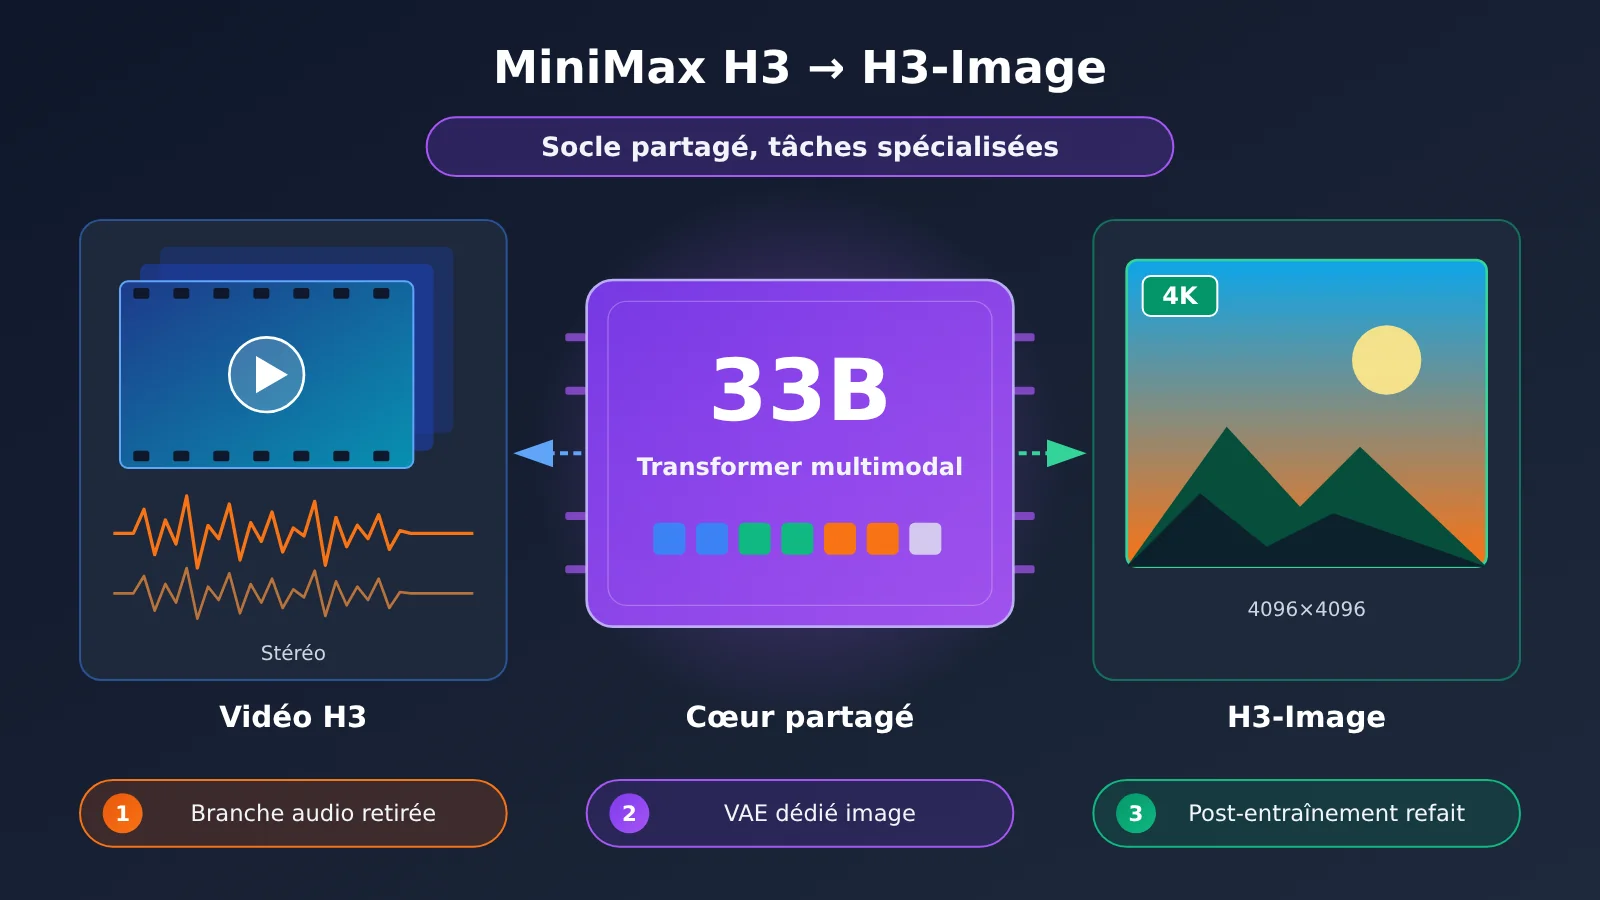
Il ne s’agit pas simplement de « transformer la sortie d’un modèle vidéo en une seule image ». La fiche de modèle officielle et l’article de blog de lancement de H3-Image l’expliquent : le modèle conserve le Transformer multimodal central et l’encodeur de texte de H3, supprime la branche de génération audio, adopte un VAE spécifique à l’image et refait l’post-entraînement ainsi que le processus d’inférence pour les tâches d’image.
Ce que vous allez en retirer : après cette lecture, vous saurez quels éléments ont été modifiés quand la même architecture de 33 milliards de paramètres est passée de la vidéo à l’image, pourquoi chacun l’a été, et quelles informations sont confirmées officiellement ou relèvent seulement d’une déduction du secteur.
MiniMax H3 : de la vidéo à l’image, ce que MiniMax a publié
Commençons par remettre la chronologie à plat. Quand on lit l’annonce « MiniMax H3 en open source », il est facile de confondre deux publications distinctes : H3 et H3-Image sont deux choses différentes, séparées d’environ trois mois.
| Date | Événement | Description |
|---|---|---|
| 2026-07-31 | MiniMax présente le modèle H3 | Le blog technique officiel dévoile pour la première fois l’architecture de H3 |
| 2026-08-03 | MiniMax H3 ouvre officiellement ses poids | Modèle de génération vidéo omni-modal ; c’est H3-Base qui est publié en open source |
| 2026-11-10 | Date indiquée dans la licence H3-Image Community License | Ouverture des poids du modèle de génération d’images |
| 2026-11-11 | Le blog officiel anglais de MiniMax publie la présentation de H3-Image | Détails sur le post-entraînement et l’optimisation de l’inférence |
Positionnement de MiniMax H3 et de H3-Image
Les deux modèles n’ont pas du tout la même vocation. H3 est un système de génération vidéo omni-modal : il comprend en entrée du texte, des images, de la vidéo et de l’audio, et produit des vidéos de 4 à 15 secondes à 24 FPS, avec un son stéréo natif en 32 kHz. Par défaut, le petit côté fait 768 px, et le workflow complet monte jusqu’à 2K. H3-Image, lui, se concentre sur la génération et l’édition d’images en haute résolution : la spécification officielle annonce un maximum d’environ 16 MP (par exemple 4096×4096), et affirme qu’une image 4K peut être générée en moins de 10 secondes.
D’où la question centrale de cet article : l’un fait de la « vidéo avec du son », l’autre des « images fixes en haute résolution ». Pourquoi appartiennent-ils à la même famille technique ? La réponse se cache dans la conception de base de H3.
L’architecture sous-jacente de MiniMax H3 : un Transformer multimodal unifié
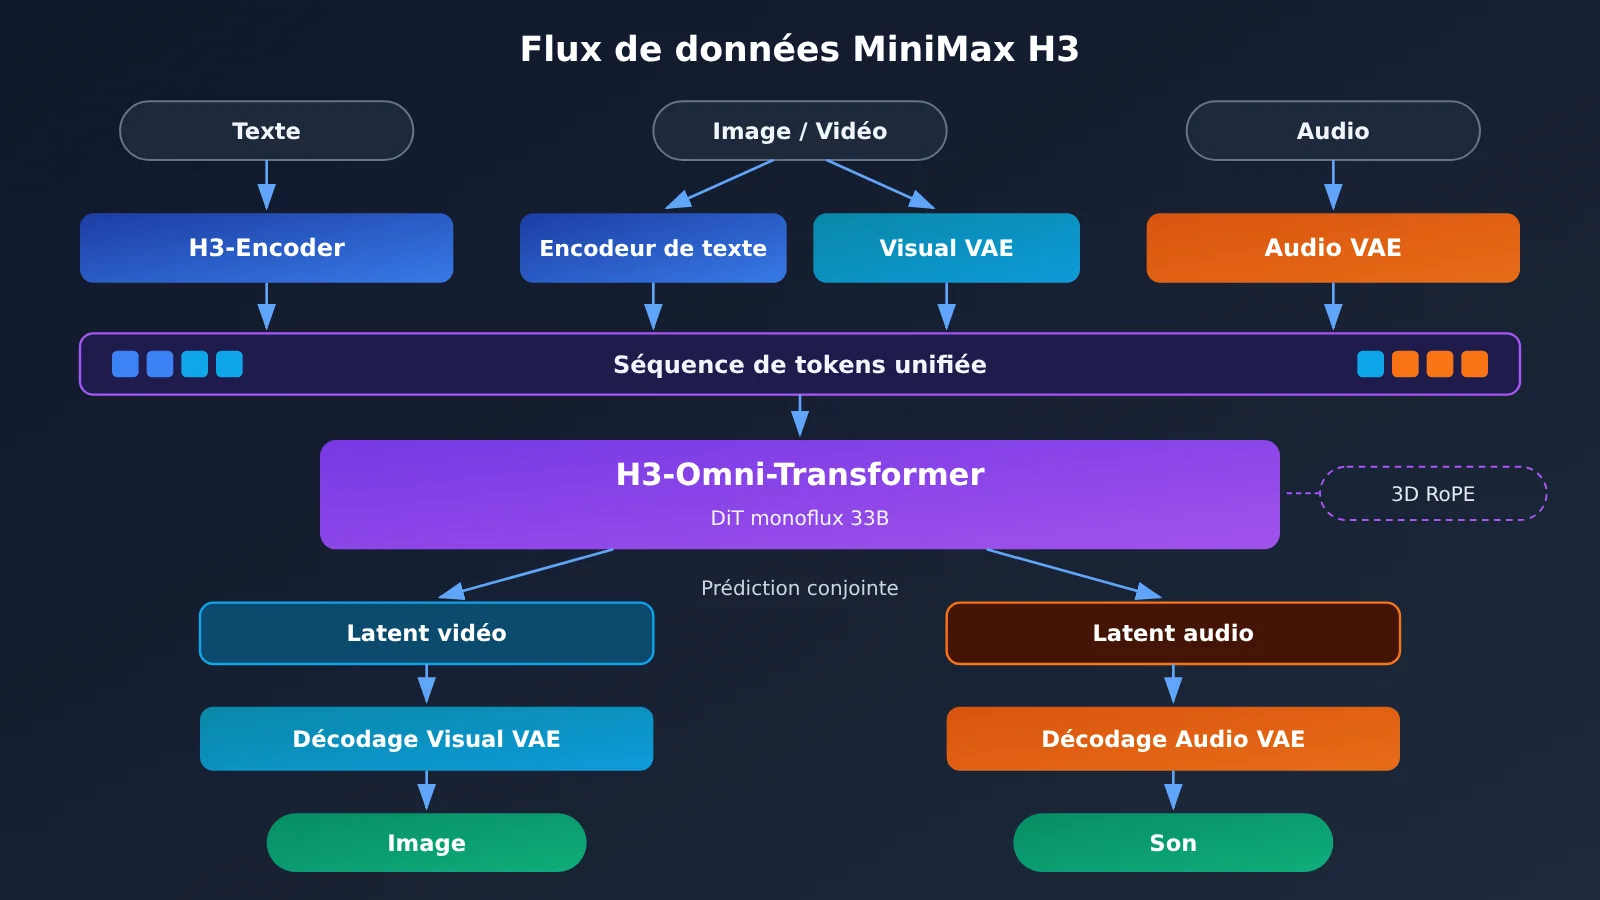
Au cœur de H3, on trouve le H3-Omni-Transformer. D’après la présentation technique officielle, c’est un Transformer à flux unique et dense d’environ 33 milliards de paramètres. « Flux unique » signifie que les informations de chaque modalité ne passent pas par des réseaux indépendants : elles sont assemblées dans une même séquence et traitées par le même jeu de paramètres. « Dense » veut dire que chaque token traverse l’ensemble des paramètres, contrairement à un MoE (mélange d’experts), qui n’active qu’une partie des experts.
Comment MiniMax H3 encode les différentes modalités
Voici, dans les grandes lignes, le circuit de traitement annoncé officiellement :
- Texte : il est encodé par le H3-Encoder en une représentation sémantique, qui indique au modèle « ce que vous voulez voir se passer à l’écran ».
- Images et vidéo : elles passent à la fois par l’encodeur de texte et par le Visual VAE. Le premier s’occupe de comprendre la sémantique du contenu visuel, le second compresse les pixels en variables latentes.
- Audio : il est compressé en variables latentes audio par l’Audio VAE.
- Séquence unifiée : les représentations de toutes ces modalités sont combinées en une seule séquence, envoyée au Transformer.
- Prédiction conjointe : le Transformer prédit simultanément les variables latentes de la vidéo et de l’audio, qui sont ensuite confiées aux VAE correspondants pour être décodées en images et en sons.
On peut y voir une façon de faire parler tout le monde la même langue. Que l’entrée d’origine soit une phrase, une image ou un morceau de musique, elle est traduite en séquence de tokens avant d’entrer dans le Transformer. Le modèle ne se soucie pas de la modalité d’origine des tokens : il se contente de repérer les relations entre eux et de générer les tokens cibles.
Le rôle du 3D Multimodal RoPE
Une vidéo possède à la fois un axe temporel et un espace en deux dimensions. H3 utilise donc le 3D Multimodal RoPE pour encoder les positions : un token doit connaître non seulement ses coordonnées horizontale et verticale dans l’image, mais aussi le numéro de la trame à laquelle il appartient. Cette conception a été confirmée explicitement par l’éditeur. Elle est essentielle pour comprendre H3-Image par la suite, car une image peut être vue comme un cas particulier où la dimension temporelle ne comporte qu’une seule trame.
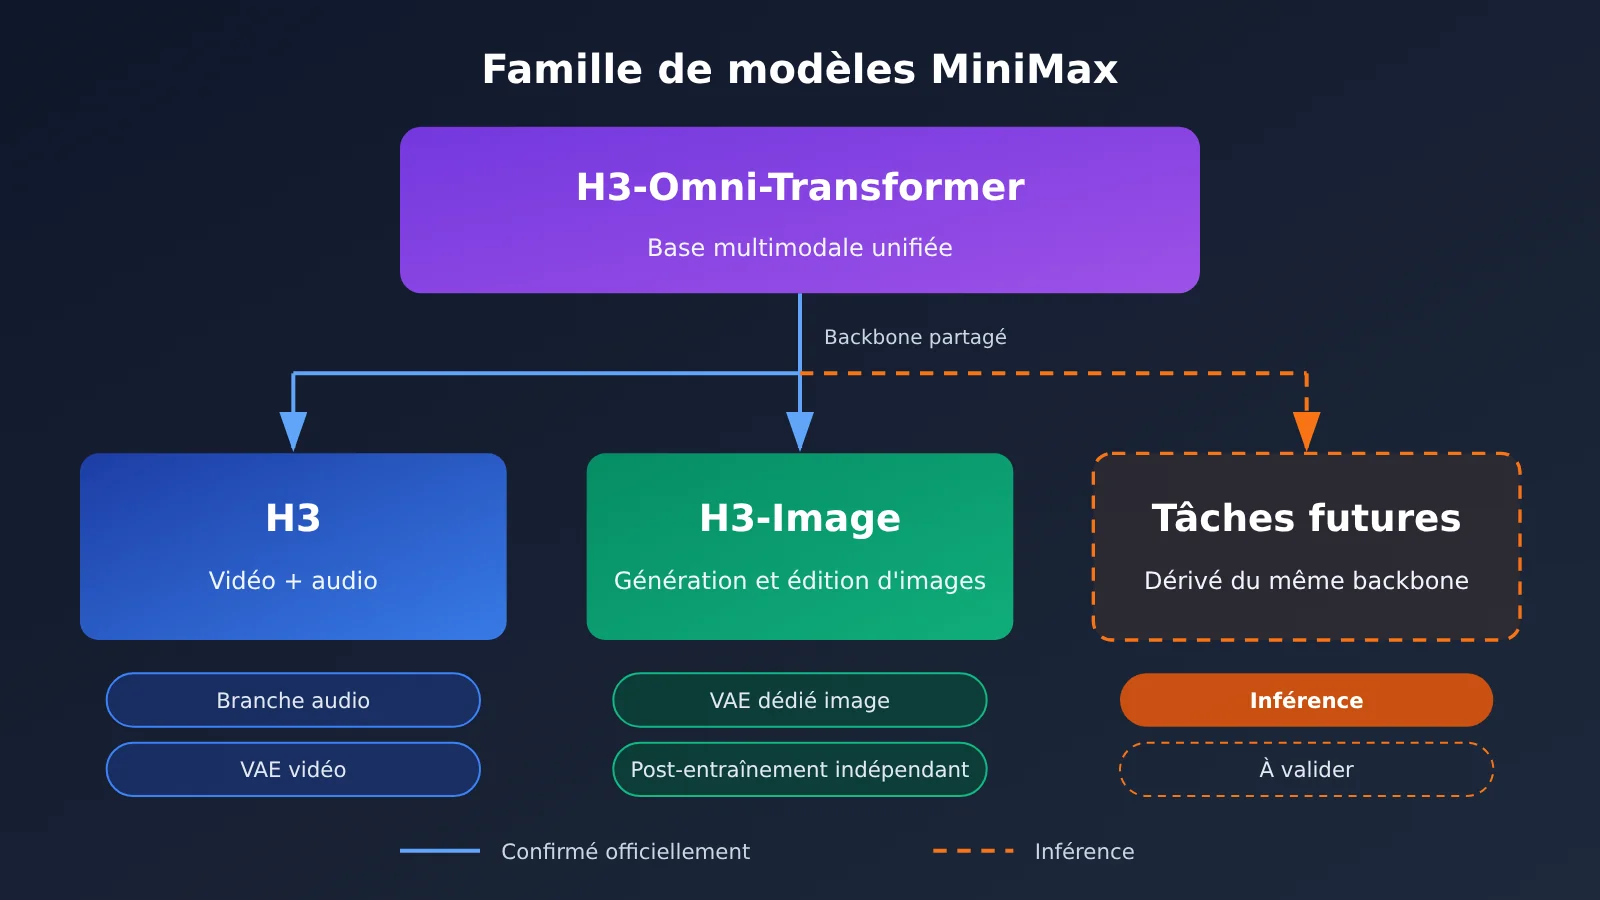
【Notre déduction】 C’est précisément parce que H3 repose dès le départ sur une conception « séquence unifiée + Transformer unifié », et non sur un pipeline mono-tâche du type « texte en entrée, vidéo en sortie », que son réseau principal peut être transféré à d’autres tâches de génération. L’éditeur ne l’affirme pas directement : c’est une conclusion que nous tirons de l’architecture.
Ce que MiniMax H3-Image hérite, supprime et ajoute
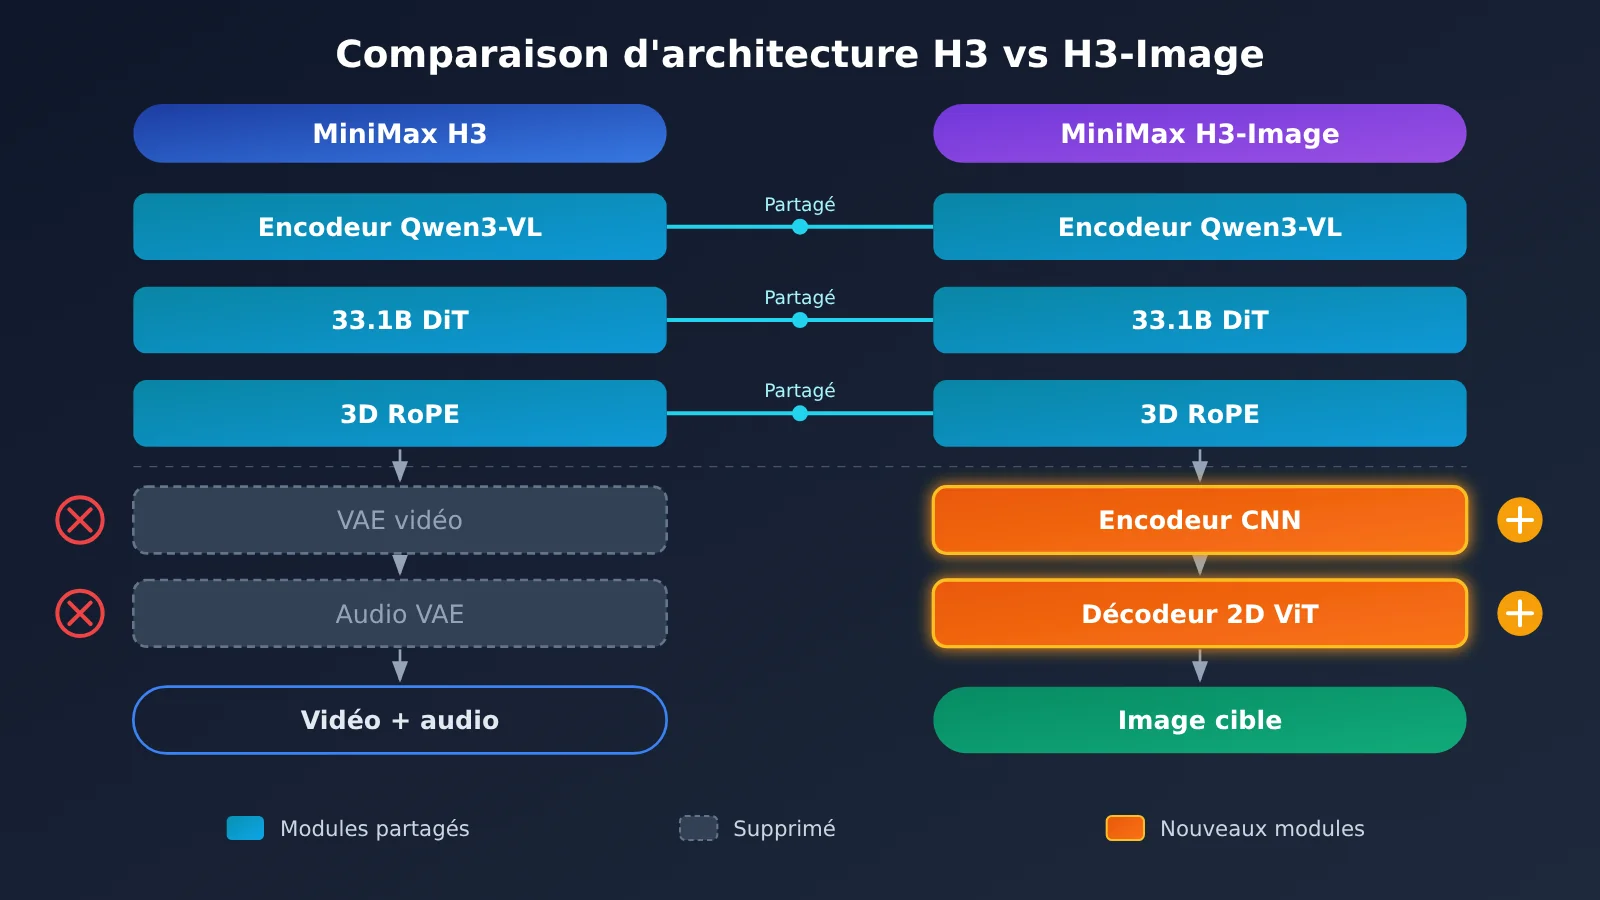
C’est la partie la plus intéressante de toute cette évolution technique. Le tableau ci-dessous est établi d’après la fiche officielle du modèle H3-Image :
| Catégorie | Composant | Ce qui est fait concrètement |
|---|---|---|
| Hérité | Encodeur de texte Qwen3-VL | Reprend l’encodeur de texte complet de H3, en prenant l’état caché de la 50e couche |
| Hérité | DiT à flux unique de 33,1 Md de paramètres | Conserve l’architecture centrale H3-Omni-Transformer |
| Hérité | RoPE multimodal 3D | Continue d’encoder les relations de position |
| Supprimé | Branche audio | Plus de génération conjointe vidéo et audio |
| Remplacé | VAE dédié à l’image | Encodeur CNN + décodeur ViT 2D à 24 couches |
| Modifié | Objectif de génération | Le texte et les images de référence sont encodés en une séquence unifiée, et le modèle prédit les latents de l’image cible |
Héritage n° 1 : l’encodeur de texte Qwen3-VL et l’état caché de la 50e couche
La fiche du modèle H3-Image précise que le modèle reprend l’encodeur de texte de H3, basé sur Qwen3-VL, et utilise l’état caché de sa 50e couche comme entrée de conditionnement. Qwen3-VL étant lui-même un modèle vision-langage, il ne se contente pas de comprendre le texte : il saisit aussi le contenu des images de référence, une capacité indispensable pour l’édition à partir de plusieurs images de référence.
【Pratique courante dans le secteur】 Pourquoi une couche intermédiaire plutôt que la dernière ? L’équipe ne l’explique pas. On considère généralement que les dernières couches d’un modèle de langage sont plutôt orientées vers la « prédiction du mot suivant », alors que les couches intermédiaires conservent des caractéristiques sémantiques plus riches et plus générales. Beaucoup de modèles de diffusion procèdent de la même façon.
Héritage n°2 : un DiT de 33,1 B et la RoPE 3D
Voici les caractéristiques du cœur DiT de H3-Image :
| Paramètre | Valeur | En clair |
|---|---|---|
| Nombre de paramètres | 33,1 B | Du même ordre de grandeur que le socle d’environ 33 B de H3 |
| Nombre de couches | 50 couches | L’information subit 50 transformations successives |
| Hidden Size | 5376 | Dimension de la représentation de chaque token |
| Attention Heads | 56 | Le modèle observe les relations entre tokens sous 56 angles différents en même temps |
| FFN Size | 14336 | Largeur intermédiaire du réseau feed-forward de chaque couche |
| Sous-échantillonnage spatial du VAE | 16 fois | Un côté de 4096 pixels est compressé à 256 |
| Canaux latents | 24 | Chaque position latente porte 24 valeurs |
| Couverture par token | environ 32×32 pixels | Détermine la longueur de la séquence et le coût de calcul |
Si l’on compte environ 32×32 pixels par token, une image de 4096×4096 représente à peu près 128×128 = 16 384 tokens (il s’agit d’une estimation de notre part, à partir des paramètres officiels). Si l’on ajoute plusieurs images de référence, la séquence s’allonge encore, ce qui explique pourquoi l’optimisation de la vitesse d’inférence est si importante pour ce modèle.
【Notre déduction】 La RoPE 3D reste utile pour les tâches d’image. L’image cible n’a qu’une seule frame, mais quand on a plusieurs images de référence en plus de l’image cible, il faut pouvoir les distinguer dans la séquence : les dimensions supplémentaires peuvent servir à cela. Le schéma exact d’attribution des positions n’a pas été publié officiellement, donc ce n’est qu’une interprétation plausible.
Suppression : retirer la branche audio
Une image n’a ni durée ni son. Conserver une branche audio ne ferait donc que gaspiller des ressources d’entraînement et d’inférence. Sans elle, l’objectif d’apprentissage du modèle passe de la « distribution conjointe vidéo + audio » à la seule « distribution des images », et le signal d’entraînement devient plus concentré.
Remplacement : un VAE dédié aux images
Le VAE visuel de H3 doit gérer la continuité temporelle de la vidéo. H3-Image, lui, adopte un VAE conçu spécialement pour les images statiques. L’encodeur est un CNN, très efficace pour extraire les textures locales. Le décodeur est un ViT 2D à 24 couches, capable de prendre en compte la structure globale au moment de reconstruire les pixels. Un sous-échantillonnage ×16 associé à 24 canaux signifie que l’information est stockée sur moins de positions spatiales, mais avec davantage de canaux. C’est un point clé pour produire des sorties haute résolution de l’ordre de 16 MP. Les concepteurs insistent d’ailleurs sur le fait que les résultats haute résolution de H3-Image sont générés directement, sans recourir à un suréchantillonneur (upscaler) classique.
Ce qui change : on ne prédit plus « vidéo + audio », mais « l’image cible »
Voici le flux de génération final : l’invite textuelle et les images de référence sont encodées ensemble dans une séquence unifiée, puis le DiT débruite progressivement dans l’espace latent pour prédire les variables latentes de l’image cible, qui sont ensuite décodées en image finale par le VAE d’image. Côté nombre d’images de référence, la fiche du modèle annonce une limite de 16, alors que la recette de déploiement vLLM indique 9 au maximum. Les deux chiffres ne reposent pas sur le même périmètre : le nombre réellement utilisable dépend du framework d’inférence employé.
Les optimisations de MiniMax H3-Image pour aller plus vite et être plus pratique
Modifier l’architecture ne suffit pas. Dans le billet de blog annonçant H3-Image, MiniMax explique que, tout en héritant des capacités de pré-entraînement de H3, l’équipe a amélioré le processus de post-entraînement sur cinq points : les données d’entraînement, l’apprentissage par renforcement, la compression du nombre d’étapes d’échantillonnage, l’amélioration de l’invite (Prompt Enhancement) et l’optimisation du déploiement. Les détails sur les données et sur l’apprentissage par renforcement n’ont pas été rendus publics ; nous nous concentrons donc ci-dessous sur les parties les mieux documentées.
Distillation en 6 étapes d’échantillonnage et suppression du CFG
Un modèle de diffusion génère une image en « partant du bruit et en le retirant pas à pas ». Concrètement, il faut généralement plusieurs dizaines d’étapes. Les modèles de diffusion classiques utilisent en plus le CFG (Classifier-Free Guidance) : à chaque étape, on exécute deux passes, l’une avec l’invite et l’autre sans, puis on mélange les résultats selon un ratio donné pour mieux coller à l’invite.
Grâce à la distillation, H3-Image ramène l’échantillonnage à 6 étapes et n’a plus besoin du CFG. La première optimisation réduit fortement le nombre d’étapes, la seconde permet de ne faire qu’un seul calcul avant (forward) par étape. Pour un modèle de 33,1 milliards de paramètres, qui manipule plus de 10 000 tokens par image, la combinaison des deux est ce qui rend techniquement possible l’annonce officielle de « 4K en 10 secondes ». Attention : ces 10 secondes sont une valeur annoncée par le fabricant, la vitesse réelle dépend du matériel et de la configuration de déploiement.
Amélioration de l’invite : transformer une description courte en instructions exploitables
H3-Image propose un modèle PE (Prompt Enhancement) facultatif, dont les poids pèsent environ 17,9 Go. Il sert à développer une description courte en une invite plus détaillée et plus facile à interpréter pour le modèle. Si vous ne souhaitez pas déployer ce modèle supplémentaire pour le moment, vous pouvez reprendre la même idée de prétraitement avec un Grand modèle de langage généraliste. Voici un exemple minimaliste :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Utiliser l'interface unifiée d'APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把这句扩写成详细的图像生成提示词:雨夜的赛博朋克街头"}]
)
print(resp.choices[0].message.content)
Voir l’implémentation complète de l’amélioration d’invite
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是图像生成提示词工程师。请把用户的简短描述扩写为结构化提示词,"
    "依次包含:主体、构图、光线、材质细节、色彩、镜头与画幅。"
    "如果用户提供了参考图说明,请明确每张参考图在画面中的作用。"
    "只输出提示词正文,不要解释。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"参考图{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# Exemple : composition d'un salon à partir d'une pièce vide + des images de référence de meubles
print(enhance_prompt(
    "把这些家具摆进空客厅,北欧风,午后自然光",
    ["空房间照片", "灰色布艺沙发", "橡木茶几", "落地灯"],
))
Conseil : lorsque vous montez un workflow de génération d’images, vous pouvez d’abord brancher plusieurs Grands modèles de langage grand public via APIYI (apiyi.com) pour l’étape de prétraitement de l’invite, comparer la qualité de leurs enrichissements, puis décider si le déploiement d’un modèle PE dédié vaut le coup. Les noms de modèles sont ceux de la liste des modèles de la plateforme.
Optimisation du déploiement et prise en charge des hautes résolutions
Les frameworks de déploiement recommandés officiellement sont SGLang, vLLM-Omni, Diffusers et ComfyUI. Côté matériel, la liste comprend notamment les NVIDIA H200, RTX PRO 6000 Blackwell et AMD Instinct MI350X, avec des solutions de parallélisme multi-GPU. Le taux de compression élevé du VAE image, l’échantillonnage en 6 étapes sans CFG et les optimisations d’inférence au niveau du framework travaillent ensemble pour produire directement des formats en haute résolution : 16:9 (5472×3072), 9:16 (3072×5472) ou encore 21:9 (6272×2688).
Impact de la réutilisation de l’architecture MiniMax H3
Ce que ça change pour les développeurs
- Une base commune, mais pas interchangeable : H3 et H3-Image partagent l’encodeur de texte, que la fiche du modèle désigne comme « encodeur de texte H3 partagé » (environ 66,7 Go). En revanche, les poids du DiT et le VAE sont indépendants : impossible d’utiliser les poids vidéo de H3 pour générer des images.
- Un seuil de déploiement toujours élevé : le modèle image principal pèse environ 68,65 Go ; avec l’encodeur de texte, le téléchargement complet atteint environ 135,35 Go. Et ce n’est que la taille de stockage, qui ne dit rien de la mémoire vidéo nécessaire.
- Les licences sont à lire séparément : H3 et H3-Image relèvent de deux Community License distinctes, dont les conditions de déclenchement diffèrent nettement (voir le tableau ci-dessous).
| Critère | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| Périmètre open source | Uniquement H3-Base ; Context-IR et Regenerate-2K passent par l’API officielle | Poids du modèle image, encodeur de texte partagé, modèle PE optionnel |
| Ce que l’on obtient en local | Génération audio-vidéo en 768p ; le workflow 2K complet dépend de l’API officielle | Sortie directe jusqu’à environ 16 MP, selon le fournisseur |
| Condition de déclenchement de la licence commerciale | Chiffre d’affaires annuel des produits et services commerciaux supérieur à 20 millions de dollars | Chiffre d’affaires annualisé de votre part et/ou de vos affiliés supérieur à 1 million de dollars, ou fourniture d’un service hébergé à un tiers |
| Autres obligations | Restrictions géographiques, etc. : à vérifier dans le texte de la licence | Restrictions géographiques, usage des sorties, identification du produit, etc. : à vérifier dans le texte de la licence |
À propos de cette comparaison : le tableau ci-dessus est tiré des deux licences originales et des fiches officielles des modèles. Il ne sert qu’à orienter votre choix technique et ne constitue pas un avis juridique. Si vous n’avez pas encore les moyens de l’auto-hébergement ou les autorisations nécessaires, vous pouvez commencer par appeler d’autres modèles d’images et multimodaux grand public via APIYI (apiyi.com) pour prototyper votre workflow.
Ce que ça change pour le secteur
【Confirmé officiellement】 H3-Image réutilise le Transformer central et l’encodeur de texte de H3, tout en s’appuyant sur un VAE dédié et sur un processus de post-entraînement indépendant.
【Notre analyse】 Cela montre que la génération vidéo et la génération d’images peuvent partager une grande partie des capacités de base, comme la compréhension sémantique, l’alignement multimodal et la modélisation des positions spatiales, mais que chaque tâche exige toujours ses propres composants d’encodage/décodage et un entraînement ciblé. La stratégie de MiniMax ressemble à « construire d’abord une base multimodale unifiée, puis la spécialiser selon la tâche », plutôt que d’entraîner un modèle de zéro pour chaque type de génération. Si cette voie fait ses preuves, on verra probablement apparaître d’autres modèles dérivés d’un même réseau principal, mais pour l’instant, ce n’est qu’une hypothèse sur l’évolution du secteur.
FAQ – Questions fréquentes
Q1 : H3-Image, c’est simplement le modèle vidéo H3 avec une sortie image ?
Non. H3-Image reprend de H3 l’encodeur de texte Qwen3-VL, l’architecture DiT à flux unique de 33,1 B de paramètres et le 3D RoPE. En revanche, la branche audio a été supprimée, et le VAE est désormais spécialisé dans l’image (encodeur CNN et décodeur ViT 2D). Le post-entraînement (données, apprentissage par renforcement, distillation) a lui aussi été mené séparément.
Q2 : Pourquoi MiniMax H3 et H3-Image ont-ils presque le même nombre de paramètres ?
Parce que leur Transformer central vient de la même architecture : environ 33 B pour H3, 33,1 B pour le DiT de H3-Image. Des tailles aussi proches montrent que le réseau principal a été conservé tel quel. Les différences se situent surtout dans les composants d’encodage et de décodage, ainsi que dans les objectifs d’entraînement.
Q3 : Combien d’images de référence H3-Image prend-il réellement en charge ?
La fiche officielle du modèle annonce un maximum de 16 images, tandis que la recette de déploiement vLLM indique 9 au plus. La première valeur est une déclaration du constructeur, la seconde correspond à une configuration de test propre à un framework donné. En pratique, fiez-vous aux limites du framework d’inférence que vous utilisez.
Q4 : L’échantillonnage en 6 étapes et la suppression du CFG dégradent-ils la qualité d’image ?
Selon le constructeur, la distillation permet de conserver une sortie de haute qualité, mais les résultats publics viennent pour l’instant surtout de ses propres démonstrations. Je vous conseille de faire vos propres comparaisons sur vos cas d’usage, en vous concentrant sur le respect des instructions complexes et sur les combinaisons de plusieurs images de référence.
Q5 : Je n’ai pas de carte graphique de la classe H200. Comment valider d’abord mon workflow de génération d’images ?
Vous pouvez commencer par faire tourner le workflow via une API dans le cloud :
1. Inscrivez-vous sur APIYI (apiyi.com) pour obtenir une clé API et un crédit de test gratuit
2. Utilisez le code d’amélioration d’invite de cet article (avec `base_url` réglé sur `https://api.apiyi.com/v1`) pour mettre en place l’étape de prétraitement
3. Branchez les principaux modèles d’image déjà disponibles sur la plateforme, validez toute la chaîne, puis décidez si un auto-hébergement vaut le coup
Q6 : Puis-je déployer H3-Image et proposer un service d’API à des tiers ?
Soyez très prudent sur ce point. D’après la licence de H3-Image, proposer un service hébergé à un tiers, quel qu’il soit, nécessite une autorisation écrite préalable de MiniMax, quel que soit votre chiffre d’affaires. Pour les conditions exactes, reportez-vous au texte original de la licence et, si besoin, demandez conseil à un juriste.
MiniMax H3 : les points clés de l’évolution de l’architecture
- Même base, usage différent : H3-Image réutilise le Transformer central et l’encodeur de texte de H3. Il ne s’agit pas simplement de changer de mode de sortie.
- Trois modifications clés : suppression de la branche audio, adoption d’un VAE spécifique à l’image, et objectif de génération réorienté vers la prédiction de variables latentes d’image.
- La compréhension sémantique vient de Qwen3-VL : on prélève l’état caché de la 50e couche, ce qui permet de comprendre à la fois le texte et les images de référence.
- La vitesse vient de la distillation : un échantillonnage en 6 étapes, sans CFG, est la base technique de l’annonce officielle « 4K en 10 secondes ».
- Les licences se lisent séparément : le service hébergé de H3-Image et le seuil de 1 million de dollars de revenus déclenchent tous deux une obligation d’autorisation.
- Valider avant de déployer : vous pouvez d’abord prototyper avec plusieurs modèles via APIYI (apiyi.com), puis évaluer le coût d’un auto-hébergement.
Conclusion
L’évolution de MiniMax H3, de la vidéo vers l’image, tient en trois points :
- Une base commune : le Transformer multimodal à flux unique de 33B, l’encodeur de texte Qwen3-VL et le 3D RoPE sont conservés tels quels.
- Une spécialisation pour la tâche : la branche audio disparaît, un VAE d’image (CNN + ViT 2D) prend le relais, et l’objectif de génération passe des variables latentes vidéo + audio aux variables latentes d’image.
- Un entraînement et une inférence refaits : les données, l’apprentissage par renforcement, la distillation en 6 étapes sans CFG, l’enrichissement des invites et les optimisations de déploiement soutiennent ensemble une sortie jusqu’à 16 MP.
Pour les développeurs, ce qui mérite vraiment d’être étudié, c’est de savoir quelles capacités peuvent être partagées et lesquelles exigent un entraînement dédié, sans oublier le coût matériel derrière les poids et les obligations de licence. Avant de décider d’auto-héberger, nous vous conseillons de comparer plusieurs modèles via l’interface unifiée d’APIYI (apiyi.com) pour faire tourner rapidement votre workflow d’images.
📚 Références
- Présentation technique officielle de MiniMax H3 : description de l’architecture H3-Omni-Transformer
- Lien :
minimax.io/blog/minimax-h3 -
Notes : description officielle du chemin d’encodage multimodal et du 3D Multimodal RoPE
-
Billet de blog officiel sur la sortie de MiniMax H3-Image : post-entraînement et optimisation de l’inférence
- Lien :
minimax.io/blog/minimax-h3-image -
Notes : améliorations sur les données, l’apprentissage par renforcement, la distillation en 6 étapes, l’enrichissement des invites, etc.
-
Fiche modèle H3-Image sur Hugging Face : paramètres complets de l’architecture
- Lien :
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
Notes : spécifications détaillées du DiT, du VAE et de l’encodeur de texte
-
Fiche modèle H3 d’origine et licence : spécifications du modèle vidéo et conditions d’utilisation
- Lien :
huggingface.co/MiniMaxAI/MiniMax-H3 -
Notes : spécifications de H3 et texte original de la licence (
blob/main/LICENSE) -
Texte original de la licence H3-Image : conditions d’utilisation commerciale
- Lien :
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
Notes : clauses sur les services hébergés, les seuils de revenus, etc.
-
Recette de déploiement vLLM : configuration testée côté framework
- Lien :
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - Notes : informations côté framework, comme le nombre d’images de référence
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI (apiyi.com). Plus de ressources sur le centre de documentation docs.apiyi.com