作者注:MiniMax H3 と H3-Image はモデルの重みが公開されましたが、開発や商用利用の範囲は、システムコンポーネント、クラウドサービス、コミュニティライセンスによって決まります。本記事ではモジュールごと、ライセンスごとに順番に整理します。
2026年11月10日、MiniMax は H3-Image のモデル重みを公開しました。それに先立つ2026年8月3日には、オールモーダル動画生成モデルの MiniMax H3 がオープンソース化されています。2つの発表は3か月以上離れていますが、よく一緒くたに語られがちです。実際には、モデルもライセンスもそれぞれ別物です。
この記事は「偽のオープンソース」を批判するものではありません。公式発表、Hugging Face のモデルカード、ライセンス原文には、いずれもはっきり書かれています。MiniMax が公開したのは、中核となる生成モデルを中心とした重みと推論関連の資料であり、クラウド上のシステム全体ではありません。本記事では、「何が公開され、何が公開されておらず、どう使えるのか」を一つずつ整理していきます。
この記事で得られること:MiniMax H3 の3つのモジュールそれぞれの公開状況がわかります。H3-Image でローカル実行できるコンポーネントも把握できます。さらに、2つの Community License で収益のしきい値とホスティングサービスの扱いがどう違うのかも理解できます。
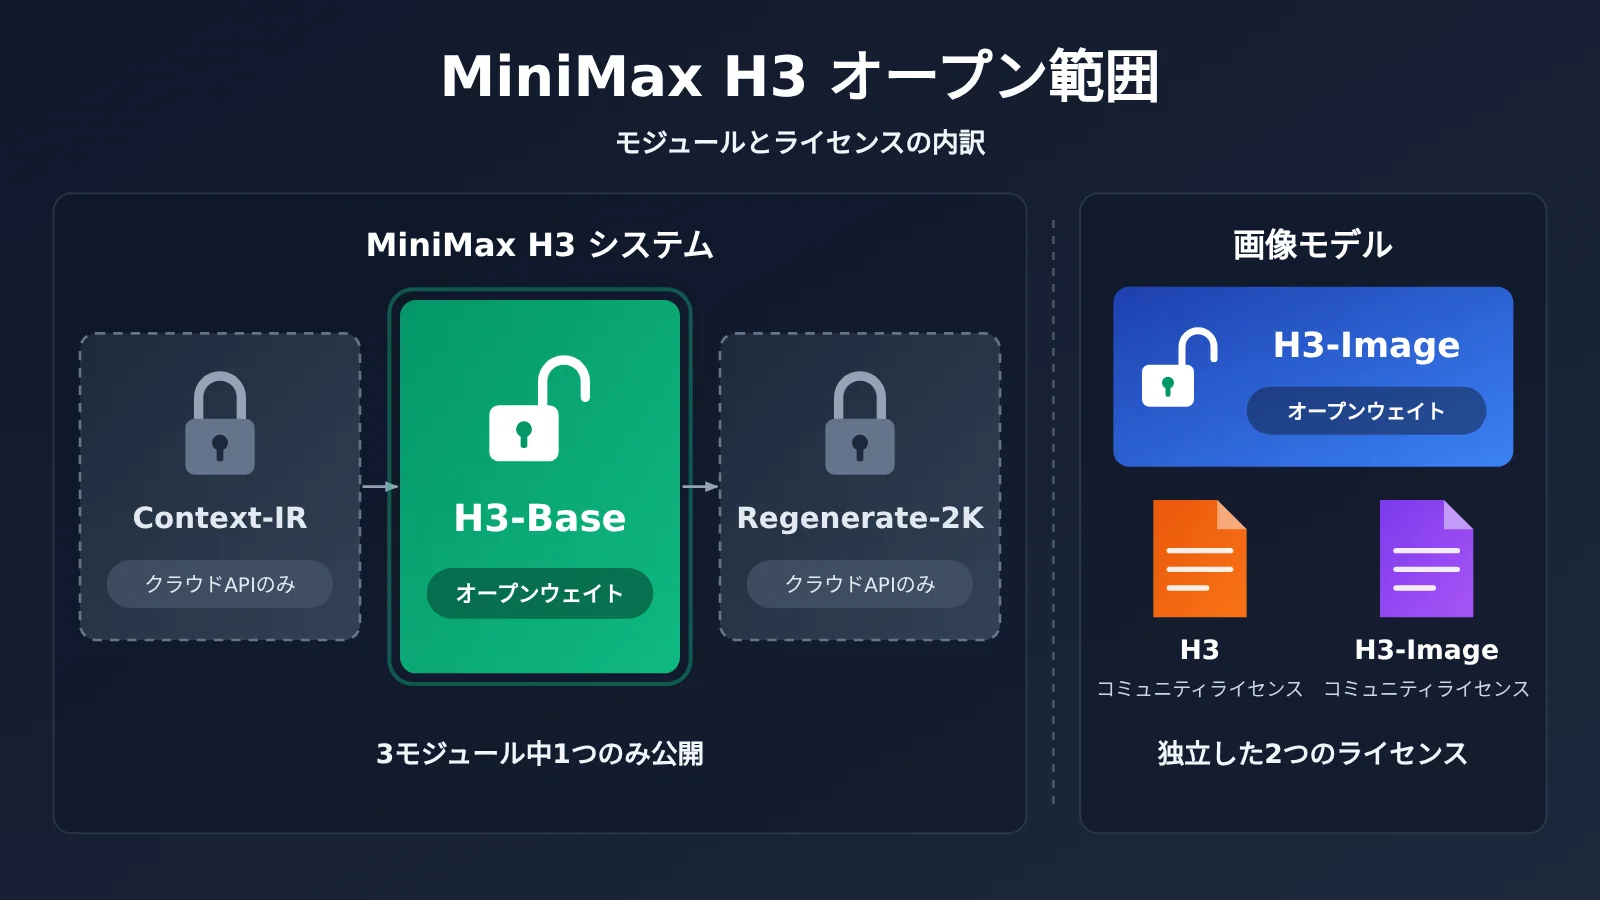
MiniMax H3 オープンソースの要点まとめ
まずは、時系列と基本的な事実を1つの表にまとめます。以下の判断はすべて公式発表、モデルカード、ライセンス原文に基づいており、確認時点は 2026 年 11 月 11 日です。
| 項目 | MiniMax H3(動画) | MiniMax H3-Image(画像) |
|---|---|---|
| 公開日 | 2026 年 8 月 3 日 | 2026 年 11 月 10 日 |
| モデルの位置づけ | 全モーダル動画生成。ネイティブのステレオ音声付き動画を出力 | H3 から派生した、高解像度の画像生成・編集モデル |
| 主な規模 | 33B パラメータ | 33.1B パラメータの DiT |
| 公開内容 | H3-Base の重みと推論用資料(FL2VA、Ref2VA の 2 つの checkpoint) | DiT、Image VAE、Tokenizer/Processor、PE モデルなど |
| クラウド依存のもの | Context-IR、Regenerate-2K | H3-Image-Context-IR |
| ライセンス | H3 Community License | H3-Image Community License |
読む前に押さえておきたい MiniMax H3 の 6 つの用語
- オープンウェイト:学習済みのモデルパラメータを入手できる形式です。ただし、利用範囲はライセンスによって決まります。学習データや全体の開発プロセスまで公開されるわけではありません。
- Community License:モデル提供元が独自に定めた利用許諾契約です。MIT や Apache 2.0 のような汎用のオープンソースライセンスではありません。
- Checkpoint:モデルを読み込むためのパラメータファイルです。1 つのモデルがタスクごとに複数の checkpoint を提供することもあります。
- Context-IR:マルチモーダル入力の理解、指示の解析、コンテキストの整理を行う公式サービスです。現在は API 形式で提供されています。
- ホスティングサービス:ネットワーク経由で第三者にモデルの機能を提供することです。たとえば API を外部に公開するケースがこれにあたり、ライセンスによる制限の中心となる場面です。
- スパースアテンション:アテンションの関係の一部だけを計算することで、長いシーケンスの計算コストを抑える技術です。
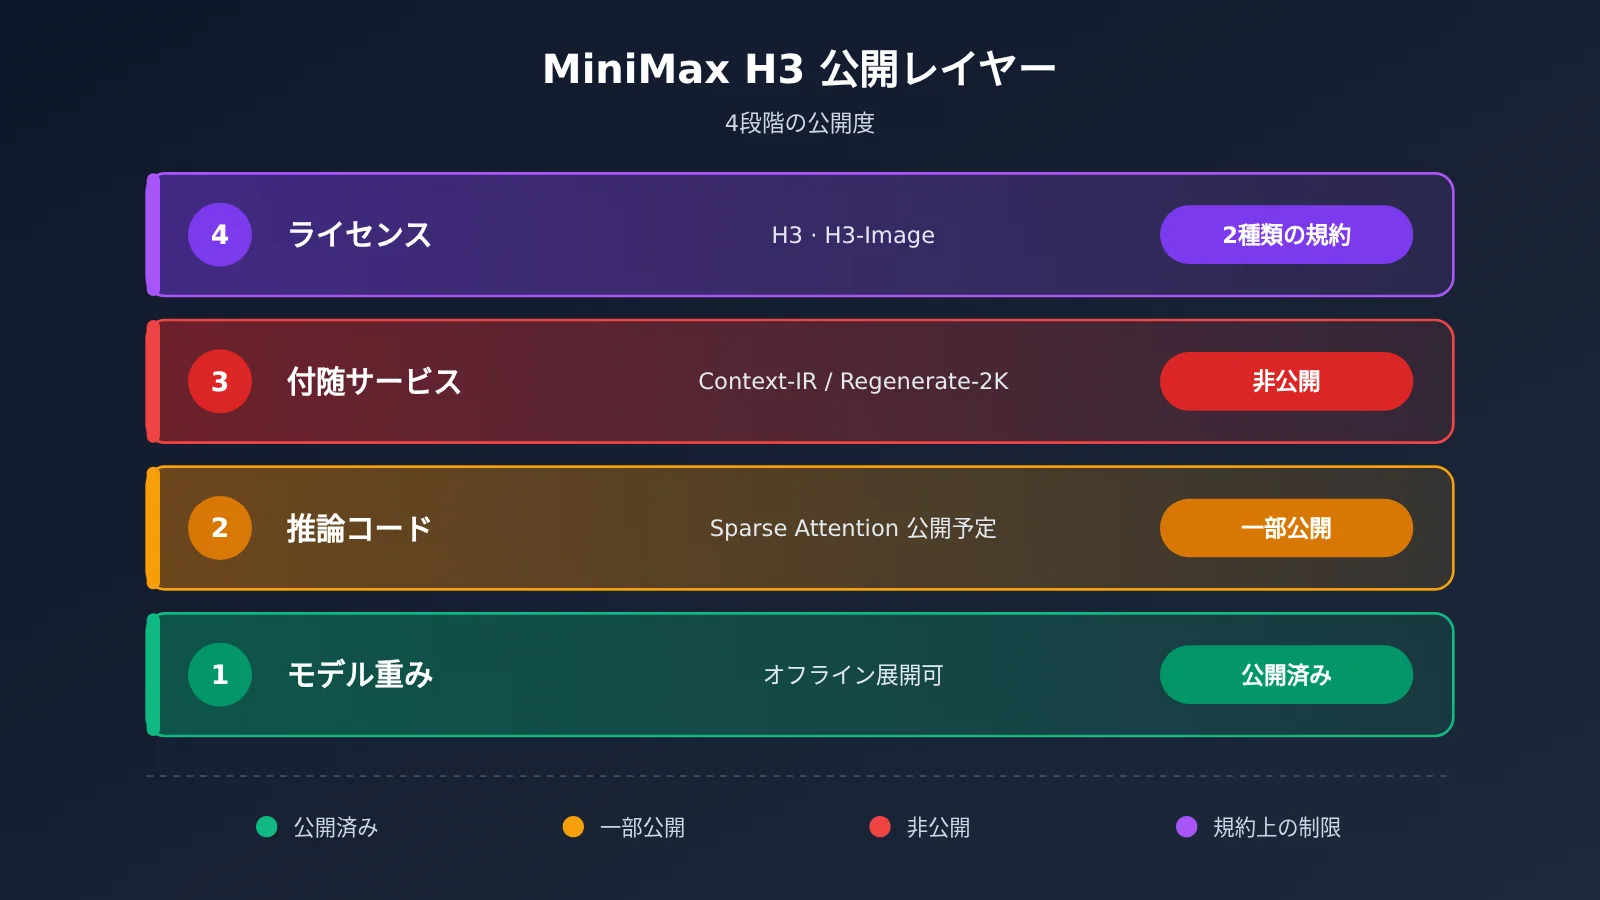
MiniMax H3 動画モデル:3つのモジュールのうち公開されたのは1つだけ
公式の原文アナウンスでは、MiniMax H3 のシステム全体が3つのモジュールに分けられています。この区分を理解することが、「オープンソースだが完全には公開されていない」という状況を読み解くカギになります。
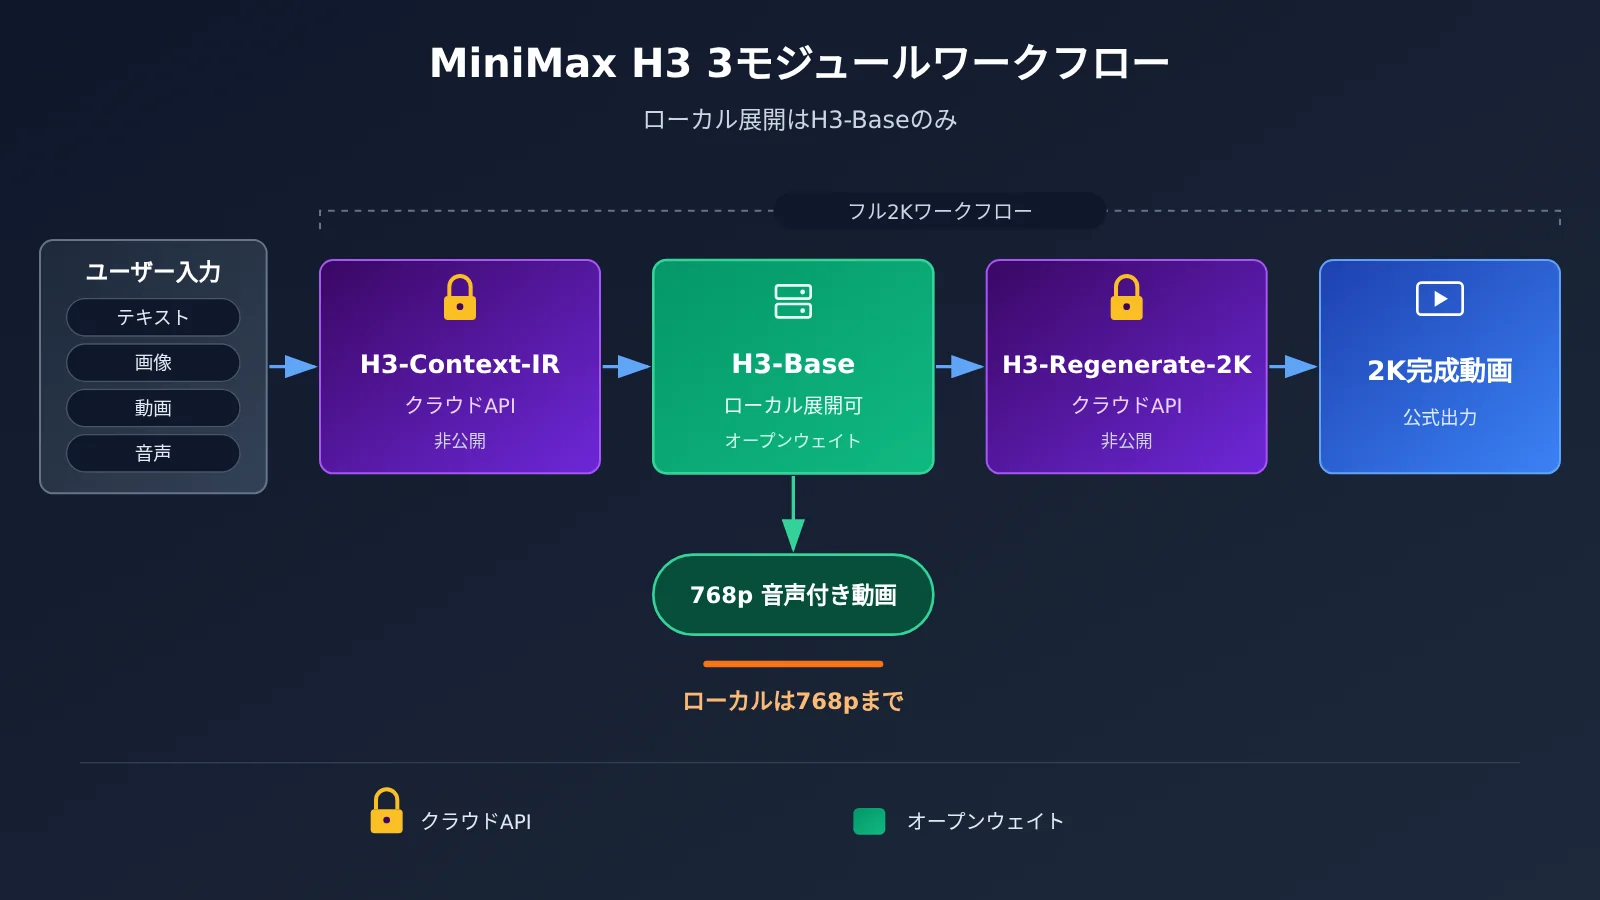
| モジュール | 役割 | 公開状況 | ローカル利用 |
|---|---|---|---|
| H3-Context-IR | マルチモーダル入力の理解、指示の解析、コンテキストの構造化 | 非公開(公式APIを提供) | 不可 |
| H3-Base | 動画・音声生成のコアモデル | 重みと関連する推論資料を公開 | 可 |
| H3-Regenerate-2K | 元のコンテキストをもとに、低解像度の結果を2Kで再生成 | 非公開(公式APIを提供) | 不可 |
MiniMax H3-Base の2つのチェックポイント
H3-Base は単一の重みファイルではなく、タスク別に用意された2つのチェックポイントで構成されています。FL2VA は、テキストから動画生成、先頭フレームからの動画生成、末尾フレームからの動画生成、先頭+末尾フレームからの動画生成に対応します。一方の Ref2VA は、画像・動画・音声を同時に参照として使えるため、より複雑な生成や編集をこなせます。たとえば、元の動画の人物の外見やシーンはそのまま残し、動作・口の動き・セリフだけを変更するといった使い方です。
どちらのチェックポイントにも、processor、tokenizer、text encoder、transformer、visual VAE、audio VAE などのコンポーネントが付属しています。つまり公開されているのは、実際に推論を動かせるモデルリポジトリであり、足りない部品を自分で補う必要がある「素の重み」ではありません。この点は、重みだけを置く多くのリリースよりも充実しています。
ローカルの768pと完全な2Kワークフローの違い
公式スペックによると、H3 のデフォルト出力は短辺768px、動画の長さは4〜15秒、フレームレートは24 FPS、音声は32kHzのステレオです。オープンソースの H3-Base だけをデプロイすれば、ローカルで768pの音声付き動画を生成できます。公式と同じ2K出力を再現するには、Context-IR と Regenerate-2K の2つのAPIを呼び出す必要があります。
したがって、より正確に言うなら、H3-Base は単独で動かせるものの、H3 のシステム全体を MiniMax のサービスから完全に切り離すことはできません。ローカル環境で入力の理解や指示の整理を行うには、開発者自身で設計する必要があります。Context-IR のローカル版が存在するとは考えないでください。
見落とされがちな Sparse Attention
公式は初回のオープンソース公開時に、H3 モデル自体はスパースアテンションの学習と推論にネイティブ対応しており、長いシーケンスのマルチモーダル計算コストを抑えられると明言しています。ただし、初回に公開された推論コードには Full Attention しか含まれておらず、Sparse Attention の実装は今後のアップデートで別途公開される予定です。
つまり、重みが公開されたからといって、内部の推論最適化まですべて公開されたわけではありません。現在公開されているコードで長尺動画を推論すると、公式クラウドの実際のパフォーマンスより計算コストが高くなる可能性があります。性能を評価する際には、この点も考慮すべき変数です。
MiniMax H3-Image ではどのコンポーネントが公開されているのか?
H3-Image の公開方式は H3 とよく似ています。コアモデルはダウンロードできますが、コンテキスト処理にはクラウドへの依存が残っています。次の表は、Hugging Face のモデルリポジトリの情報をもとに整理したものです。
| コンポーネント | 公開状況 | 説明 |
|---|---|---|
| 33.1B DiT 画像生成モデル | 公開 | シングルストリームの Diffusion Transformer、約 68.65 GB |
| Image VAE | 公開 | 画像の潜在表現のエンコード/デコード |
| Tokenizer / Processor | 公開 | 入力の前処理 |
| PDD 出力ヘッドとサンプリング設定 | 公開 | 6 ステップのサンプリングと CFG 不要の動作を支える |
| Qwen3-VL テキストエンコーダー | 公開(H3 リポジトリの重みを再利用) | 第 50 層の隠れ状態を使用、約 66.7 GB |
| H3-Image-PE プロンプト拡張モデル | 公開(別途ダウンロード) | 約 17.9 GB、ローカルで実行可能 |
| H3-Image-Context-IR | 非公開 | 公式 API として提供 |
テキストエンコーダーを H3 リポジトリからダウンロードする理由
H3-Image は H3 の Qwen3-VL テキストエンコーダーをそのまま引き継いでいます。重みは H3 リポジトリに置かれていて、H3-Image リポジトリには重複して置かれていません。そのため H3-Image をデプロイするときは、2 つのリポジトリの内容を両方ダウンロードする必要があります。メインモデルとテキストエンコーダーを合わせると約 135.35 GB のストレージが必要です。ただし、これはあくまでファイルサイズであり、必要な VRAM 容量とは別物です。
公式が推奨するデプロイ用フレームワークは SGLang、vLLM-Omni、Diffusers、ComfyUI などです。対応ハードウェアとしては NVIDIA H200、RTX PRO 6000 Blackwell、AMD Instinct MI350X などが挙げられており、マルチ GPU 並列の構成も用意されています。個人の開発者にとっては、このハードウェア要件はかなり高めと言えるでしょう。
Context-IR と PE は別物
H3-Image-Context-IR は公式のクラウドサービスで、短い指示を完全な生成用の記述に拡張し、適切な画像サイズも決定してくれます。一方、H3-Image-PE は単体でダウンロードしてローカルで動かせるプロンプト拡張モデルで、公式が提示しているローカル向けの代替手段です。
PE が公開されているからといって、Context-IR のマルチステージなホスティング型ワークフローまで公開されているわけではありません。画像モデルと PE だけをダウンロードすれば、実用的なローカル環境は構築できますが、公式クラウドの効果を完全に再現できるわけではない点に注意してください。
ベンダーの主張とフレームワークでのテストは分けて考える
「10 秒以内に 4K 画像を生成」「参照画像は最大 16 枚」といった数字は、公式のモデルカードや発表に記載されたもので、ベンダー側の主張にあたります。一方、vLLM のデプロイ用レシピでは、参照画像の上限が最大 9 枚と書かれており、両者は基準が異なります。実際に何枚の参照画像を使えるかは、採用する推論フレームワークや設定によって変わります。評価する際は、ご自身での実測結果を基準にしてください。
MiniMax H3の2つのライセンスは、何を制限しているのか?
ここは、2回のリリースの中でも特に誤解されやすい部分です。H3とH3-Imageは2つの異なるCommunity Licenseを採用しており、商用利用の条件も大きく違います。同じ結論を当てはめることはできません。
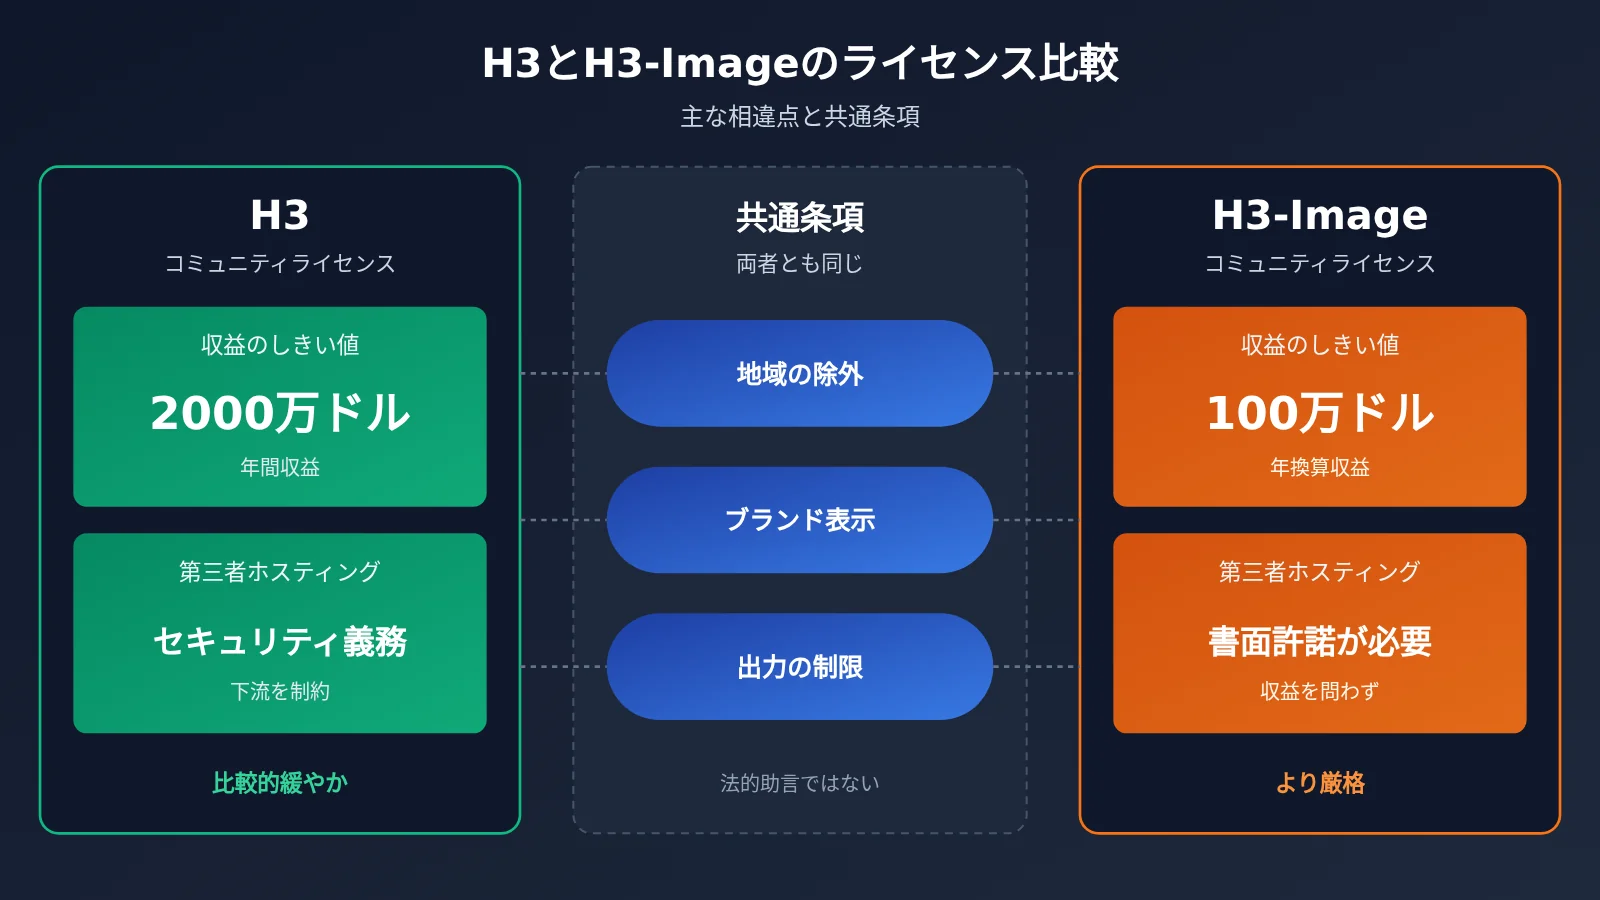
| 条件 | H3 Community License | H3-Image Community License |
|---|---|---|
| 対象地域 | 米国、EU、英国、韓国を除外 | 同じ |
| 収益に関する許諾のしきい値 | 商用製品・サービスの年間収益が2,000万ドルを超える場合は、事前の書面による許諾が必要 | 利用者および/または関連会社の年換算収益が100万ドルを超える場合は、事前の書面による許諾が必要 |
| 第三者向けホスティングサービス | 合理的なセキュリティ対策を講じ、下流のユーザーにも利用制限を遵守させる必要がある | 第三者にホスティングサービスを提供する場合は、事前の書面による許諾が必要 |
| 商用製品での表示 | UIにMiniMax H3を目立つ形で表示 | UIにMiniMax-H3-Imageを目立つ形で表示 |
| 出力を他のAIモデルの改善に利用 | 不可 | 不可 |
📌 補足:上記はライセンス原文の条項を要約したもので、法的助言ではありません。地域制限やその他の義務の詳細は、2つのLICENSE原文をご確認ください。まず生成系モデルや対話系モデルの効果を見極めたい場合は、APIYI(apiyi.com)の統一インターフェースで主要モデルを呼び出して方式を比較し、そのうえでローカル展開やライセンス申請に進むかどうかを判断するとよいでしょう。
H3の境界線:商用利用は可能だが、義務がある
H3は、対象地域内であればロイヤリティフリーの限定ライセンスを提供しており、商用利用も認められています。実質的なハードルは次の2つです。年間収益が2,000万ドルを超える場合は書面による許諾が必要です。また、第三者にモデルサービスを提供する場合は、セキュリティ対策を講じたうえで、利用制限を下流のユーザーにも引き継ぐ必要があります。
H3-Imageの境界線:ホスティングサービスが最大のハードル
H3-Imageの条件は、はるかに厳しくなっています。年換算収益のしきい値は100万ドルまで下がります。さらに、第三者にホスティングサービスを提供する場合は、収益の多寡にかかわらず、事前に書面による許諾を得なければなりません。ライセンスには、個別のライセンスを申請するためのMiniMaxへの連絡窓口も用意されています。
APIプラットフォームやモデルホスティングプラットフォーム、SaaS開発者にとって、これは「重みをダウンロードできる」ことが「デプロイして外部にAPIを公開してよい」ことを意味しないということです。この境界線の厳しさは、H3とH3-Imageでまったく異なります。
MiniMax H3オープンソース化が開発者に与える影響
モジュールの開放範囲とライセンスをあわせて見ると、利用シーンごとに開発者が得られる自由度はかなり異なります。
| 利用シーン | できること | 主な制約 |
|---|---|---|
| 個人の研究・ローカルでの実験 | 重みのダウンロード、ローカル推論、アーキテクチャの研究、二次開発 | 地域除外条項、出力を他モデルの改善に使うことは不可、ハードウェア要件が高い |
| 企業内での商用利用 | ローカルにデプロイし、生成コンテンツを自社業務で利用 | H3 は 2,000 万ドル、H3-Image は 100 万ドルの基準額が分かれ目 |
| ユーザー向け商用プロダクト | 自社アプリへの組み込み | 画面上に該当モデルの名称を目立つ形で表示する必要あり |
| 第三者向けの API ホスティング提供 | H3 は安全面の義務を果たせば提供可能 | H3-Image は事前に書面での許可が必要 |
| 公式の完全な品質の再現 | ローカルでの 768p 動画、ローカルでの画像生成+PE | 2K 動画と Context-IR は引き続き公式 API が必要 |
開放がもたらす本物の自由
重みが公開されたことで得られる自由は、確かなものです。オフラインでのデプロイができ、データを社内ネットワークの外に出さずに運用でき、33B 規模のオムニモーダルモデルの構造を研究することもできます。ローカルのパイプラインでは、前処理・後処理の工程を差し替えたり改造したりすることも可能です。両モデルとも推論用のコンポーネント一式が付属しているので、コミュニティが再現するときのハードルも下がっています。
それでも残る 3 つの境界
1 つ目はシステムの境界です。Context-IR と Regenerate-2K は公開の対象外です。2 つ目は実装の境界で、H3 の Sparse Attention のコードは初回リリースには含まれていませんでした。3 つ目はライセンスの境界で、地域、収益規模、ホスティングサービス、ブランド表示に関する条項が、商用利用の可否を総合的に左右します。
つまり、オープンな重みとクラウド API は、どちらか一方に置き換わるものではなく併存する関係です。GPU の調達、推論の最適化、高並行時のスケジューリング、プロンプトの強化、コンプライアンスの審査といったコストは、重みが公開されても消えません。多くのチームにとっては、まず APIYI(apiyi.com)のような集約プラットフォームで事業ニーズを検証し、そのうえで自前で構築する価値があるかを見極めるほうが、堅実な進め方でしょう。
MiniMax H3 ローカルフローの前処理ステップ例
Context-IR は公開されていないため、H3-Base をローカルで動かす場合は、入力を整理するステップを自分で用意する必要があります。よく使われる方法は、汎用の大規模言語モデルで短いアイデアを構造化された記述に展開し、それをローカルモデルに渡すというものです。ただし、これはあくまでエンジニアリング上の代替案であり、公式の Context-IR と同等の効果が得られるわけではない点にご注意ください。
最小限のサンプル
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": "把简短视频创意扩写为详细镜头描述,包含主体、动作、镜头、光线和声音。"},
        {"role": "user", "content": "雨夜街头,一只猫跳上霓虹灯招牌"}
    ]
)
print(resp.choices[0].message.content)
完全な実装コードを見る
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = """你是视频生成提示词工程师。
请把用户的简短创意扩写为 JSON,字段包括:
- prompt: 详细的画面与动作描述
- camera: 镜头运动
- audio: 环境声与音乐描述
- duration: 视频时长(秒,取值 4 到 15)
只输出 JSON。"""

def build_context(idea: str, model: str = "gpt-4o-mini") -> dict:
    """汎用の大規模言語モデルで入力を整理し、ローカルの H3-Base に渡す前処理ステップとする"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": idea},
        ],
        response_format={"type": "json_object"},
    )
    ctx = json.loads(resp.choices[0].message.content)
    # H3 の公式仕様に合わせて、動画の長さを 4〜15 秒に制限する
    ctx["duration"] = max(4, min(15, int(ctx.get("duration", 5))))
    return ctx

if __name__ == "__main__":
    ctx = build_context("雨夜街头,一只猫跳上霓虹灯招牌")
    print(json.dumps(ctx, ensure_ascii=False, indent=2))
    # 次のステップ:ctx をローカルの H3-Base 推論フローに渡す
    # (公式 GitHub リポジトリにある FL2VA の推論サンプルを参照)
🚀 クイックスタート:ローカルの VRAM が足りない場合は、まず APIYI(apiyi.com)で無料のテスト枠を取得し、プロンプト整理のステップを動かしてみるのがおすすめです。このプラットフォームは OpenAI 互換のインターフェースを提供しており、1 つの API キーでさまざまなモデルを切り替えられます。前処理の展開役としてどのモデルが向いているか、手軽に比較できます。
MiniMax H3 オープンソース FAQ
Q1:MiniMax H3 は本当のオープンソースですか?
より正確には「オープンウェイトモデル」と呼ぶのが適切です。H3-Base の重みと推論関連の資料は公開されていますが、Context-IR と Regenerate-2K は公開されていません。さらにライセンスも MIT や Apache 2.0 ではなく、利用に制限のある Community License が採用されています。
Q2:MiniMax H3 と H3-Image のライセンスは同じですか?
いいえ、異なります。対象外となる地域の範囲は両者で共通ですが、収益の基準は H3 が年間収益 2,000 万ドル超、H3-Image が年換算収益 100 万ドル超となっています。また、H3-Image はサードパーティへのホスティングサービスの提供にあたり、事前の書面による許諾が必須です。一方 H3 では、安全対策の実施と下流利用者への制約を課す義務を果たす必要があります。
Q3:H3-Base だけをデプロイすれば 2K 動画を生成できますか?
できません。ローカルの H3-Base は、デフォルトでは短辺 768px の出力になります。2K 出力には、公式の Context-IR と Regenerate-2K の API が必要です。
Q4:H3-Image-PE は Context-IR の代わりになりますか?
PE は公式が提供するローカル向けのプロンプト拡張ソリューションで、単独でダウンロードして動かせます。ただし、Context-IR のようなマルチステージのホスティング型ワークフロー全体と同じものではありません。公式に近い結果を得たい場合は、自分でテストと調整を重ねる必要があります。
Q5:ローカルデプロイのハードルが高すぎます。代わりになる方法はありますか?
H3-Image は、メインモデルとテキストエンコーダだけでも約 135.35 GB のストレージが必要です。公式が対応を想定しているハードウェアも、H200 や MI350X といったデータセンター級の GPU が中心です。現段階では方式の検証が目的なら、まず APIYI(apiyi.com)で、すでに利用可能な主要モデルを呼び出してみるのがおすすめです。統一されたインターフェースで効果を手早く比較でき、そのうえで自前の環境を構築する価値があるかどうかを判断できます。
Q6:H3 の出力を使って、自分のモデルを学習させてもよいですか?
どちらのライセンスでも、モデルやその出力を使って他の AI モデルを改良することは認められていません。データ合成や蒸留を行う前に、必ずライセンスの原文を確認してください。
MiniMax H3 オープンソース化の重要ポイント Key Takeaways
- 3つのモジュールのうち公開されるのは1つだけ:H3-Base は公開されましたが、Context-IR と Regenerate-2K は引き続き公式 API での提供です。
- checkpoint は完全版:FL2VA と Ref2VA のどちらにも、tokenizer や VAE などの推論用コンポーネントが付属しています。
- ローカル実行は 768p まで:2K 動画のワークフローをフルに使うには、公式クラウドサービスが必要です。
- スパースアテンションは未公開:初めて公開された推論コードには、Full Attention しか含まれていません。
- 2つのライセンスは条件が異なる:H3 のしきい値は 2000 万米ドル、H3-Image は 100 万米ドルです。
- ホスティングサービスはレッドライン:H3-Image を第三者向けにホスティング提供する場合は、事前の書面による許諾が必要です。
- 自前で構築する前にまず検証を:APIYI(apiyi.com)の統一インターフェースを使えば、低コストでビジネス要件を検証できます。
まとめ
MiniMax H3 オープンソース化の重要ポイントは次の3つです。
- 公開されたのはコアとなる生成モデル:H3-Base と H3-Image のメインモデルはダウンロードしてデプロイでき、推論コンポーネントもひととおり揃っています。
- クラウドサービスは依然としてシステムの一部:Context-IR と Regenerate-2K が、完全な効果の上限を左右します。
- ライセンスが商用利用の境界を決める:2つの Community License は条件が異なり、H3-Image はホスティングサービスに対する要件が明らかに厳しくなっています。
モデルがどこまで公開されているかを判断するには、重みをダウンロードできるかどうかだけでなく、コンポーネント、推論コード、付随するサービス、ライセンスという4つの観点から見る必要があります。今回の MiniMax の公開は誠実な取り組みですが、開発者はデプロイや商用利用に着手する前に、この4つのレイヤーの境界をひとつずつ確認しておきましょう。
生成系ソリューションを評価している方は、まず APIYI(apiyi.com)の無料枠でビジネスフローをすばやく検証してから、ローカルデプロイやライセンス申請に進むかどうかを判断することをおすすめします。
📚 参考資料
- MiniMax H3 公式オープンソース発表:3つのモジュール構成と Sparse Attention の解説
- リンク:
minimax.io/news/minimax-h3-open-source -
説明: H3 のシステム構造と公開範囲について確認できる一次情報です
-
Hugging Face – MiniMax-H3 モデルリポジトリ:FL2VA・Ref2VA のチェックポイントとコンポーネント
- リンク:
huggingface.co/MiniMaxAI/MiniMax-H3 -
説明: 共有の Qwen3-VL テキストエンコーダーの重みを含みます
-
MiniMax H3 Community License 原文
- リンク:
huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/LICENSE -
説明: 収益のしきい値、対象地域、下流側の義務については、こちらが正となります
-
Hugging Face – MiniMax-H3-Image モデルリポジトリ:コンポーネント一覧とデプロイ手順
- リンク:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
説明: 公式モデルカードで、参照画像の上限などベンダーの公式見解を含みます
-
MiniMax H3-Image Community License 原文
- リンク:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
説明: ホスティングサービスのライセンスと、100万米ドルのしきい値に関する条項です
-
vLLM デプロイレシピ – MiniMax-H3-Image
- リンク:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image -
説明: フレームワーク側のテスト構成です。参照画像の上限の扱いがモデルカードと異なります
-
GitHub – MiniMax-H3 ソースコードとデプロイ資料
- リンク:
github.com/MiniMax-AI/MiniMax-H3 - 説明: ローカル推論のサンプルとデプロイスクリプトを収録しています
著者: APIYI 技術チーム
技術交流: APIYI 公式サイトのトップページからお気軽にご連絡ください。より詳しい接続資料は docs.apiyi.com のドキュメントセンターでご覧いただけます