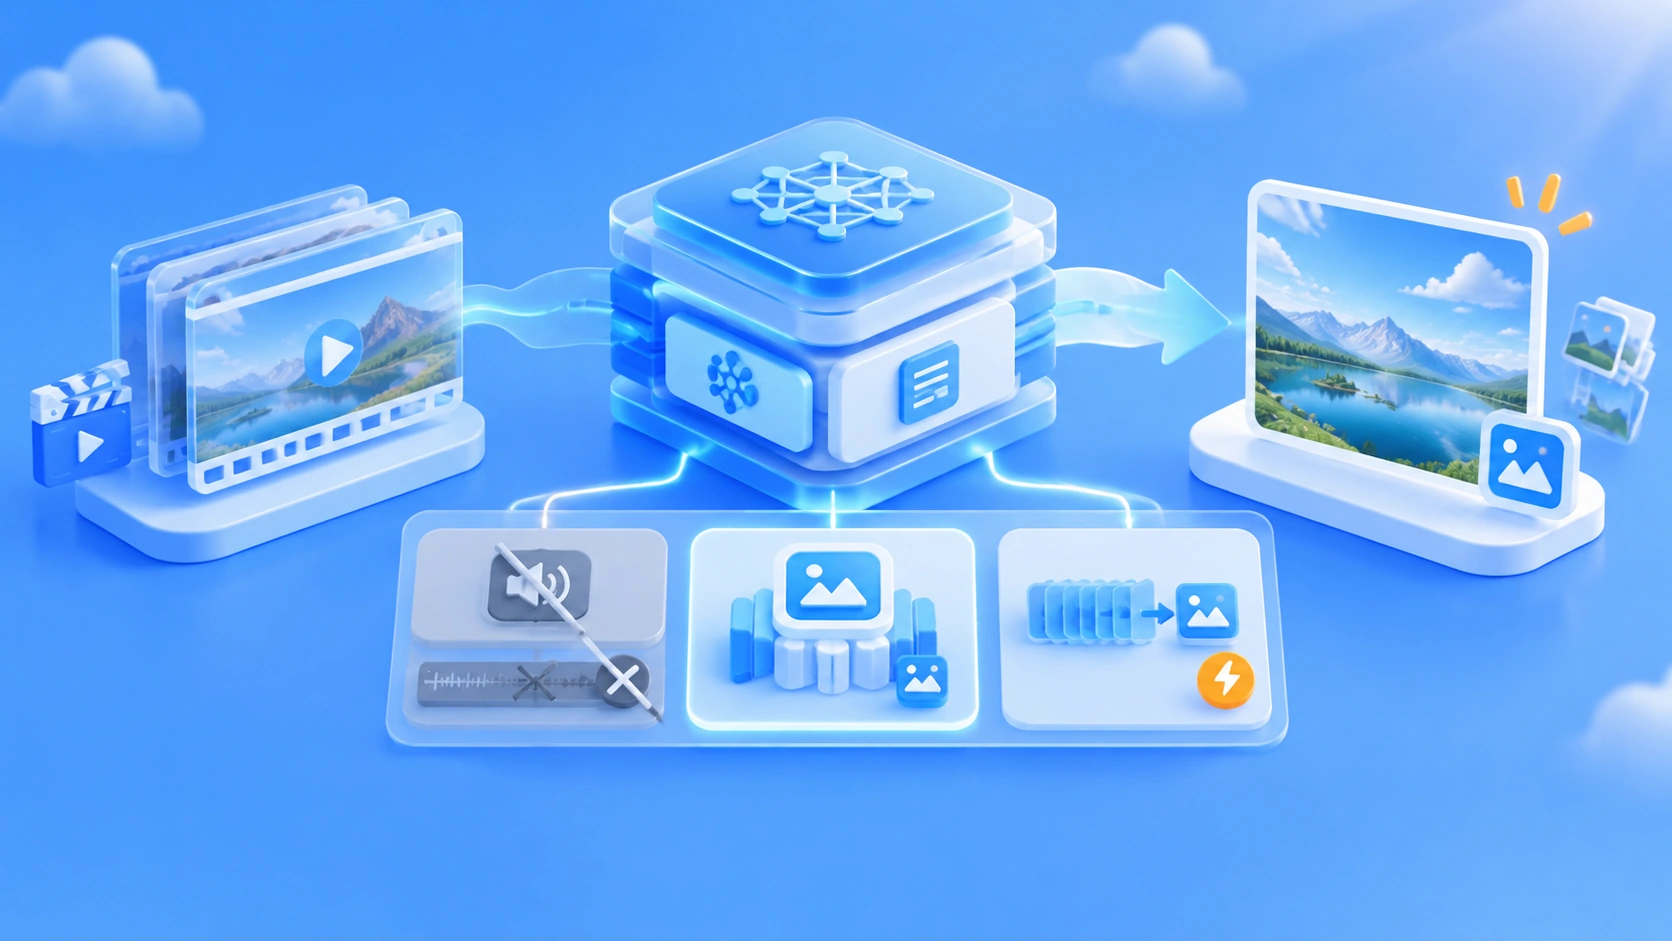
작성자 노트: H3-Image는 H3의 멀티모달 기반 아키텍처를 재사용하고, 여기에 이미지 전용 구성 요소를 붙였어요. 훈련과 추론 과정도 다시 최적화해 독립적인 이미지 생성 모델로 완성했습니다. 이 글에서는 H3-Image가 H3에서 무엇을 물려받고, 무엇을 덜어내고, 무엇을 새로 추가했는지 하나씩 짚어 볼게요.
MiniMax H3 아키텍처를 이해하기 전에 알아둘 용어 6가지
뒤에서 계속 등장하는 개념들이에요. 먼저 한 줄씩 정리해 둘게요.
| 용어 | 쉬운 설명 | MiniMax H3에서의 역할 |
|---|---|---|
| Transformer | 시퀀스 데이터를 처리하는 신경망으로, 시퀀스 안의 각 요소 사이의 관계를 잘 포착해요 | H3-Omni-Transformer가 모델 패밀리 전체의 핵심이에요 |
| DiT | Transformer로 구현한 확산 모델로, 노이즈를 단계적으로 제거하면서 콘텐츠를 생성해요 | H3-Image의 본체는 파라미터 33.1B의 단일 스트림(single-stream) DiT예요 |
| VAE | 픽셀과 압축 표현 사이를 인코딩·디코딩하는 모델로, “압축기 + 압축 해제기”라고 보면 돼요 | H3는 비주얼 VAE와 오디오 VAE를 쓰고, H3-Image는 이미지 전용 VAE로 바꿨어요 |
| 잠재 변수(latent) | 원본 데이터를 압축한 간결한 표현이에요. 모델이 이 공간에서 계산하면 픽셀을 직접 다루는 것보다 훨씬 효율적이에요 | Transformer가 예측하는 대상은 픽셀이 아니라 잠재 변수예요 |
| RoPE | 회전 위치 인코딩(Rotary Position Embedding)으로, 각 토큰이 시퀀스에서 어디에 있는지 모델에 알려줘요 | H3는 3D Multimodal RoPE로 시간과 공간 위치를 표현해요 |
| 증류(distillation) | 원래 여러 단계가 필요한 복잡한 과정을 몇 단계만으로 끝낼 수 있게 학습시키는 기법이에요 | H3-Image는 샘플링 단계가 6번만 필요하도록 증류됐어요 |
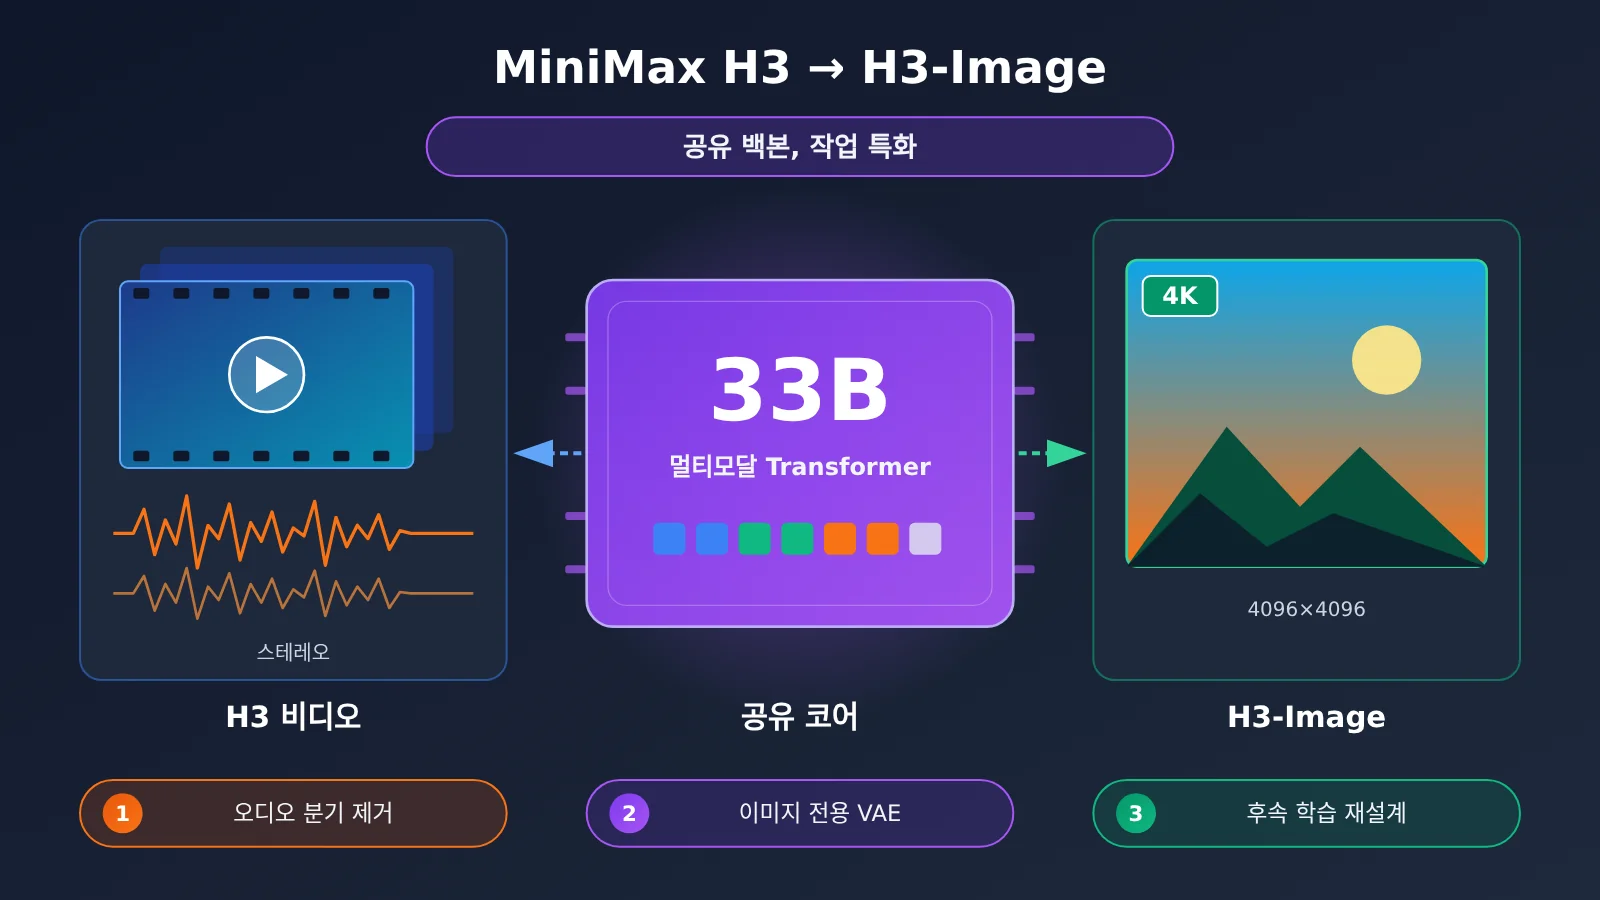
2026년 11월, MiniMax는 H3-Image 이미지 생성 모델의 가중치를 공개했어요. 3개월 전에 오픈소스로 공개된 H3는 스테레오 오디오가 포함된 영상을 생성하는 모델이었는데, 이번 신규 모델도 파라미터 규모가 비슷한 33B급이고 핵심 아키텍처 역시 H3에서 가져왔어요.
“비디오 모델의 출력을 한 프레임으로 바꾼 것”이라고 하면 너무 단순한 설명이에요. 공식 모델 카드와 발표 블로그에 따르면 H3-Image는 H3의 핵심 멀티모달 Transformer와 텍스트 인코더를 그대로 쓰고, 오디오 생성 브랜치를 제거했어요. 대신 이미지 전용 VAE를 달고, 이미지 작업에 맞춰 후훈련(post-training)과 추론 과정을 새로 설계했습니다.
핵심 가치: 이 글을 읽고 나면 같은 33B 아키텍처가 비디오에서 이미지로 넘어오면서 구체적으로 어떤 부분이 바뀌었는지, 각각 왜 바꿨는지 알 수 있어요. 또 어떤 내용이 공식적으로 확인된 사실이고, 어떤 내용이 업계 차원의 추론인지도 구분해 드릴게요.
MiniMax H3 비디오에서 이미지까지: MiniMax가 공개한 것들
먼저 타임라인부터 정리해 볼게요. “MiniMax H3 오픈소스” 소식을 접하면 두 번의 발표를 하나로 착각하기 쉬운데, H3와 H3-Image는 서로 다른 발표이고 약 3개월의 간격이 있어요.
| 시기 | 이벤트 | 설명 |
|---|---|---|
| 2026-07-31 | MiniMax, H3 모델 소개 발표 | 공식 기술 블로그에서 H3 아키텍처를 처음 공개 |
| 2026-08-03 | MiniMax H3 가중치 정식 공개 | 올모달리티 비디오 생성 모델이며, 오픈소스로 공개된 것은 H3-Base |
| 2026-11-10 | H3-Image Community License 표기 날짜 | 이미지 생성 모델 가중치 공개 |
| 2026-11-11 | MiniMax 영문 공식 블로그에 H3-Image 소개 게재 | 후속 학습(post-training) 및 추론 최적화 세부 내용 공개 |
MiniMax H3와 H3-Image의 역할 구분
두 모델이 맡은 작업은 완전히 달라요. H3는 텍스트, 이미지, 비디오, 오디오 입력을 동시에 이해하는 올모달리티 비디오 생성 시스템이에요. 4~15초 길이, 24 FPS, 32kHz 네이티브 스테레오 사운드가 포함된 비디오를 출력하고, 기본 출력은 짧은 변 기준 768px, 전체 워크플로에서는 최대 2K까지 지원해요. 반면 H3-Image는 고해상도 이미지 생성과 편집에 집중해요. 공식 사양상 최대 약 16MP(예: 4096×4096)까지 지원하고, 10초 이내에 4K 이미지를 생성할 수 있다고 밝히고 있어요.
여기서 이 글의 핵심 질문이 나와요. 하나는 “소리가 있는 비디오”를, 다른 하나는 “고해상도 정지 이미지”를 만드는데, 왜 같은 기술 계열에 속할까요? 그 답은 H3의 밑바탕 설계에 숨어 있어요.
MiniMax H3의 기반 아키텍처: 통합 멀티모달 Transformer
H3의 핵심은 H3-Omni-Transformer예요. 공식 기술 소개에 따르면 약 33B 파라미터 규모의 단일 스트림(single-stream), 밀집형(dense) Transformer입니다. “단일 스트림”은 모달리티마다 별도의 네트워크를 거치지 않고, 하나의 시퀀스로 합쳐서 같은 파라미터로 한꺼번에 처리한다는 뜻이에요. “밀집형”은 MoE처럼 일부 전문가(expert)만 활성화하지 않고, 모든 token이 전체 파라미터를 거쳐 계산된다는 의미입니다.
MiniMax H3는 모달리티를 어떻게 인코딩할까
공식적으로 공개된 처리 경로는 대략 다음과 같아요.
- 텍스트: H3-Encoder로 의미 표현(semantic representation)을 만들어요. 모델에게 “화면에서 무슨 일이 일어나길 원하는지”를 알려주는 역할이에요.
- 이미지와 비디오: 텍스트 인코더와 Visual VAE를 동시에 거쳐요. 텍스트 인코더는 화면 내용의 의미를 이해하고, Visual VAE는 픽셀을 잠재 변수(latent)로 압축해요.
- 오디오: Audio VAE를 통해 오디오 잠재 변수로 압축해요.
- 통합 시퀀스: 위의 각 모달리티 표현을 하나의 시퀀스로 합쳐서 Transformer에 넣어요.
- 공동 예측: Transformer가 비디오와 오디오의 잠재 변수를 동시에 예측하고, 각각 해당하는 VAE가 디코딩해서 화면과 소리로 만들어요.
“모두가 같은 언어로 말한다”고 생각하면 이해하기 쉬워요. 원본 입력이 한 문장이든, 한 장의 이미지든, 한 곡의 음악이든 Transformer에 들어가기 전에는 모두 token 시퀀스로 번역돼요. 모델은 token이 어느 모달리티에서 왔는지는 신경 쓰지 않고, token 사이의 관계를 찾아 목표 token을 생성하는 일만 해요.
3D Multimodal RoPE의 역할
비디오에는 시간 축과 2차원 공간이 함께 있어요. 그래서 H3는 3D Multimodal RoPE로 위치를 인코딩합니다. token 하나가 화면 안에서 가로·세로 좌표가 어디인지뿐 아니라, 몇 번째 프레임에 속하는지도 알아야 하기 때문이에요. 이 설계는 공식적으로 확인된 내용이에요. 뒤에서 H3-Image를 이해할 때 아주 중요한데, 이미지 한 장은 “시간 차원이 한 프레임뿐인” 특수한 경우로 볼 수 있기 때문이에요.
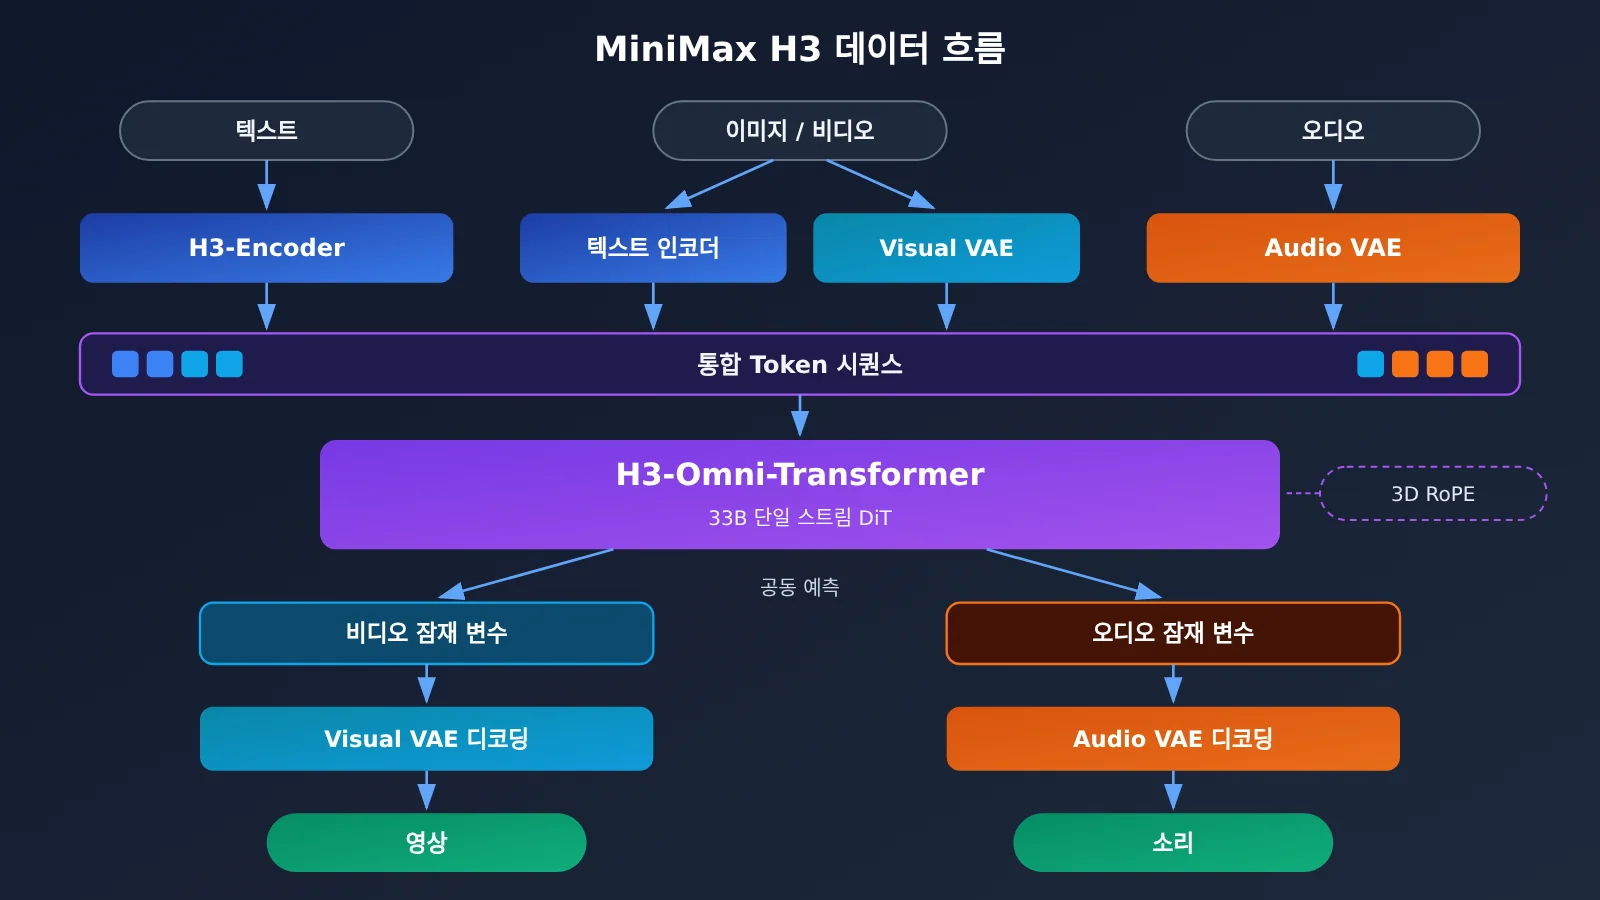
【저희의 추론】 H3는 처음부터 “텍스트를 넣으면 비디오가 나오는” 단일 작업 파이프라인이 아니라 “통합 시퀀스 + 통합 Transformer” 구조로 설계됐어요. 그래서 백본 네트워크를 다른 생성 작업으로 옮겨 쓸 수 있는 기반이 갖춰져 있다고 볼 수 있어요. 공식에서 이렇게 직접 밝힌 것은 아니고, 아키텍처 설계를 바탕으로 저희가 내린 판단이에요.
MiniMax H3-Image가 물려받은 것, 삭제한 것, 새로 추가한 것
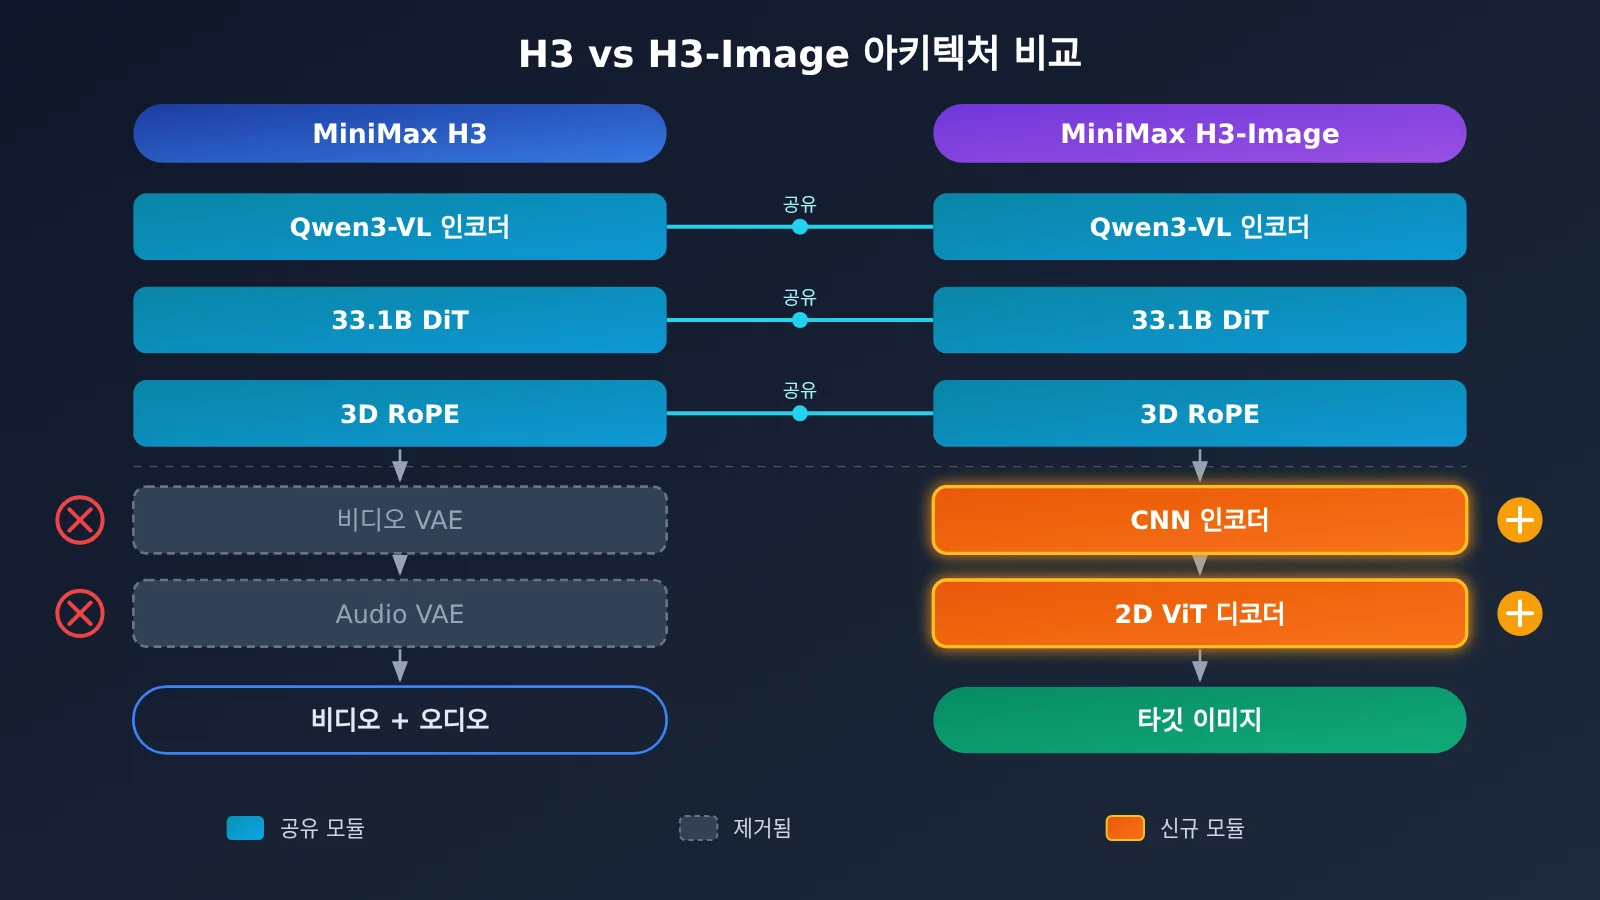
이 부분이 전체 기술 발전 과정에서 가장 눈여겨볼 만한 대목이에요. 아래 표는 H3-Image 공식 모델 카드를 바탕으로 정리했어요.
| 구분 | 구성 요소 | 구체적인 방식 |
|---|---|---|
| 계승 | Qwen3-VL 텍스트 인코더 | H3의 텍스트 인코더를 그대로 가져와 50번째 레이어의 은닉 상태를 사용 |
| 계승 | 33.1B 단일 스트림 DiT | H3-Omni-Transformer 핵심 아키텍처 유지 |
| 계승 | 3D Multimodal RoPE | 위치 관계를 인코딩하는 데 계속 사용 |
| 삭제 | 오디오 브랜치 | 영상과 오디오를 함께 생성하는 기능은 더 이상 지원하지 않음 |
| 교체 | 이미지 전용 VAE | CNN 인코더 + 24층 2D ViT 디코더 |
| 변경 | 생성 목표 | 텍스트와 참조 이미지를 하나의 통합 시퀀스로 인코딩하고, 목표 이미지의 잠재 변수를 예측 |
계승 1: Qwen3-VL 텍스트 인코더와 50번째 레이어 은닉 상태
H3-Image 모델 카드에 따르면, H3에서 쓰던 Qwen3-VL 기반 텍스트 인코더를 그대로 가져와 50번째 레이어의 은닉 상태를 조건 입력으로 사용해요. Qwen3-VL은 그 자체로 비전-언어 모델이라서 텍스트를 이해할 뿐 아니라 참조 이미지의 내용까지 파악할 수 있어요. 다중 참조 이미지 편집에 꼭 필요한 능력이죠.
【업계에서 흔히 쓰는 방식】 마지막 레이어가 아니라 중간 레이어를 쓰는 이유는 공식 문서에서 따로 설명하지 않았어요. 업계에서는 보통 언어 모델의 마지막 몇 개 레이어는 “다음 단어 예측”에 더 치우쳐 있고, 중간 레이어는 더 풍부하고 범용적인 의미 특징을 담고 있다고 봐요. 실제로 많은 확산 모델이 비슷한 방식을 채택하고 있어요.
계승 2: 33.1B DiT와 3D RoPE
H3-Image의 DiT 본체 사양은 다음과 같아요.
| 파라미터 | 수치 | 쉽게 이해하기 |
|---|---|---|
| 파라미터 수 | 33.1B | H3의 약 33B 백본과 같은 규모 |
| 레이어 수 | 50층 | 정보가 50번의 변환을 거쳐요 |
| Hidden Size | 5376 | 각 토큰의 표현 차원 |
| Attention Heads | 56 | 56가지 관점에서 동시에 토큰 간 관계를 살펴봐요 |
| FFN Size | 14336 | 각 층 피드포워드 네트워크의 중간 너비 |
| VAE 공간 다운샘플링 | 16배 | 한 변 4096픽셀을 256으로 압축해요 |
| 잠재 변수 채널 | 24 | 잠재 변수 위치마다 24개의 값을 담고 있어요 |
| 토큰당 커버 범위 | 약 32×32 픽셀 | 시퀀스 길이와 연산량을 결정해요 |
“토큰 하나가 대략 32×32 픽셀에 대응한다”는 기준으로 계산하면, 4096×4096 이미지 한 장은 약 128×128 = 16384개의 토큰이 돼요(공식 파라미터를 바탕으로 저희가 추정한 값이에요). 여기에 참조 이미지를 여러 장 더하면 시퀀스는 더 길어져요. 추론 속도 최적화가 이 모델에 그토록 중요한 이유도 여기에 있어요.
【저희의 추론】 3D RoPE는 이미지 작업에서도 여전히 쓸모가 있어요. 목표 이미지는 한 프레임뿐이지만, 여러 장의 참조 이미지와 목표 이미지가 시퀀스 안에서 “어느 것이 무엇인지” 구분되어야 하는데, 추가된 차원이 이런 구분을 맡을 수 있어요. 공식에서는 구체적인 위치 할당 방식을 공개하지 않았으니, 여기서는 어디까지나 합리적인 해석 중 하나로 봐 주세요.
삭제: 오디오 브랜치 제거
이미지에는 시간 길이도 없고 소리도 없어요. 그래서 오디오 브랜치를 남겨 두면 학습과 추론 자원만 낭비하게 돼요. 이 브랜치를 없애면 모델의 학습 목표가 “비디오 + 오디오 결합 분포”에서 “이미지 분포”로 좁혀지고, 학습 신호도 더 집중돼요.
교체: 이미지 전용 VAE
H3의 Visual VAE는 비디오의 시간적 연속성까지 고려해야 했어요. 반면 H3-Image는 정지 이미지만을 위해 설계한 전용 VAE로 바꿨어요. 인코더는 CNN을 사용해서 국소적인 텍스처를 효율적으로 뽑아내는 데 강점이 있고, 디코더는 24층 2D ViT라서 픽셀을 복원할 때 전체적인 구조까지 함께 살필 수 있어요. 16배 다운샘플링에 24개 채널을 조합한다는 건, 적은 수의 공간 위치와 많은 채널로 정보를 담는다는 뜻이에요. 이 방식은 16MP급 고해상도 출력에 특히 중요해요. 공식 설명에 따르면 H3-Image의 고해상도 결과물은 기존의 초해상도(super-resolution) 업스케일러에 의존하지 않고 직접 생성한 것이라고 해요.
변화: “비디오+오디오 예측”에서 “목표 이미지 예측”으로
최종 생성 흐름은 이렇습니다. 텍스트 프롬프트와 참조 이미지를 하나의 통합 시퀀스로 인코딩하고, DiT가 잠재 변수 공간에서 단계적으로 노이즈를 제거해 목표 이미지의 잠재 변수를 예측해요. 그다음 이미지 VAE가 이를 디코딩해 최종 이미지를 만들어 냅니다. 참조 이미지 수는 모델 카드에서 최대 16장으로 안내하는 반면, vLLM 배포 레시피에는 최대 9장으로 적혀 있어요. 두 기준이 서로 다르므로, 실제로 쓸 수 있는 수는 사용하는 추론 프레임워크를 기준으로 판단해야 해요.
MiniMax H3-Image는 더 빠르고 쓰기 편하게 만들려고 무엇을 최적화했을까
아키텍처만 바꾼다고 끝나지 않아요. MiniMax는 H3-Image 발표 블로그에서 H3의 사전 학습 능력을 계승하면서 후속 학습(post-training) 과정을 다섯 가지 측면에서 개선했다고 밝혔어요. 학습 데이터, 강화 학습, 샘플링 스텝 압축, 프롬프트 증강(Prompt Enhancement), 그리고 배포 최적화예요. 공식적으로는 데이터와 강화 학습의 세부 내용을 공개하지 않았기 때문에, 아래에서는 공개된 정보가 비교적 많은 부분을 중심으로 살펴볼게요.
6단계 샘플링 증류와 CFG 제거
확산 모델은 “노이즈에서 출발해 한 단계씩 노이즈를 제거하며” 이미지를 만들어요. 보통은 수십 단계가 필요해요. 게다가 기존 확산 모델은 대부분 CFG(Classifier-Free Guidance)를 함께 사용해요. 매 단계마다 “프롬프트가 있는 경우”와 “프롬프트가 없는 경우”를 각각 한 번씩, 총 두 번 실행한 뒤 결과를 일정 비율로 섞어서 프롬프트를 더 잘 따르도록 만드는 방식이에요.
H3-Image는 증류를 통해 샘플링을 6단계로 줄였고, CFG도 더 이상 필요 없어요. 앞의 것은 단계 수를 크게 줄여 주고, 뒤의 것은 매 단계의 순전파 연산을 한 번만 하게 해 줘요. 33.1B 파라미터에 이미지 한 장당 토큰이 수만 개에 달하는 모델에서는 이 두 가지가 합쳐져 “4K 이미지를 10초 만에 생성한다”는 공식 설명의 기술적 바탕이 돼요. 다만 10초는 제조사가 밝힌 수치이고, 실제 속도는 하드웨어와 배포 설정에 따라 달라진다는 점은 알아 두세요.
프롬프트 향상: 짧은 설명을 실행 가능한 지시문으로 확장하기
H3-Image는 선택 사항으로 PE(Prompt Enhancement) 모델을 제공해요. 가중치는 약 17.9GB이고, 사용자가 쓴 짧은 설명을 더 자세하고 모델이 이해하기 좋은 프롬프트로 확장해 줘요. 이 추가 모델을 당장 배포하고 싶지 않다면, 범용 대규모 언어 모델로 비슷한 전처리를 할 수도 있어요. 아래는 아주 간단한 예시예요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스 사용
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把这句扩写成详细的图像生成提示词:雨夜的赛博朋克街头"}]
)
print(resp.choices[0].message.content)
프롬프트 향상 전체 구현 보기
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是图像生成提示词工程师。请把用户的简短描述扩写为结构化提示词,"
    "依次包含:主体、构图、光线、材质细节、色彩、镜头与画幅。"
    "如果用户提供了参考图说明,请明确每张参考图在画面中的作用。"
    "只输出提示词正文,不要解释。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"参考图{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# 예시: 빈 방 + 가구 참조 이미지로 거실 합성하기
print(enhance_prompt(
    "把这些家具摆进空客厅,北欧风,午后自然光",
    ["空房间照片", "灰色布艺沙发", "橡木茶几", "落地灯"],
))
추천: 이미지 생성 워크플로를 구성할 때 프롬프트 전처리 단계는 먼저 APIYI(apiyi.com)를 통해 여러 주요 대규모 언어 모델을 연결해 보고, 모델별 확장 결과를 비교한 뒤 전용 PE 모델을 배포할지 결정하면 좋아요. 모델 이름은 플랫폼의 모델 목록을 기준으로 하세요.
배포 최적화와 고해상도 지원
공식적으로 추천하는 배포 프레임워크는 SGLang, vLLM-Omni, Diffusers, ComfyUI예요. 지원 하드웨어로는 NVIDIA H200, RTX PRO 6000 Blackwell, AMD Instinct MI350X 등이 있고, 멀티 GPU 병렬 방식도 제공해요. 이미지 VAE의 높은 압축률, CFG 없이 6단계로 끝나는 샘플링, 프레임워크 수준의 추론 최적화가 함께 맞물려야 16:9(5472×3072), 9:16(3072×5472), 21:9(6272×2688) 같은 고해상도 화면비를 바로 출력할 수 있어요.
MiniMax H3 아키텍처 재사용이 미치는 영향
개발자에게 미치는 영향
- 기반은 공유하지만 서로 바꿔 쓸 수는 없어요: H3와 H3-Image는 텍스트 인코더를 공유해요. 모델 카드에는 “공유 H3 텍스트 인코더”(약 66.7GB)로 표기되어 있어요. 하지만 DiT 가중치와 VAE는 각각 독립적이라서, H3 비디오 가중치로 곧바로 이미지를 생성할 수는 없어요.
- 배포 문턱은 여전히 높아요: 이미지 메인 모델이 약 68.65GB이고 텍스트 인코더까지 더하면 전체 다운로드 용량은 약 135.35GB예요. 이건 저장 공간 기준일 뿐, 필요한 VRAM 용량과는 달라요.
- 라이선스는 따로 살펴봐야 해요: H3와 H3-Image는 서로 다른 Community License를 쓰고, 상업 이용 조건이 적용되는 기준도 뚜렷하게 달라요. 자세한 내용은 아래 표를 참고하세요.
| 항목 | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| 오픈소스 공개 범위 | H3-Base만 공개. Context-IR과 Regenerate-2K는 공식 API 호출 필요 | 이미지 모델 가중치, 공유 텍스트 인코더, 선택형 PE 모델 |
| 로컬에서 얻을 수 있는 결과 | 768p 오디오·비디오 생성. 전체 2K 워크플로는 공식 API에 의존 | 공식 설명에 따르면 최대 약 16MP까지 바로 출력 가능 |
| 상업 라이선스 적용 조건 | 상업 제품 및 서비스의 연간 매출이 2,000만 달러 초과 | 본인 및/또는 계열사의 연환산 매출이 100만 달러 초과, 또는 제3자에게 호스팅 서비스를 제공하는 경우 |
| 기타 의무 | 지역 제한 등은 라이선스 원문 확인 필요 | 지역 제한, 출력물 사용, 제품 표기 등은 라이선스 원문 확인 필요 |
비교 참고: 위 표는 두 라이선스 원문과 공식 모델 카드를 바탕으로 정리한 내용이며, 기술 선정을 위한 참고용이에요. 법률 자문은 아니에요. 당장 자체 배포나 라이선스 조건을 갖추기 어렵다면 APIYI(apiyi.com)를 통해 다른 주요 이미지 모델과 멀티모달 모델을 호출해서 워크플로 프로토타입부터 만들어 볼 수 있어요.
업계에 미치는 영향
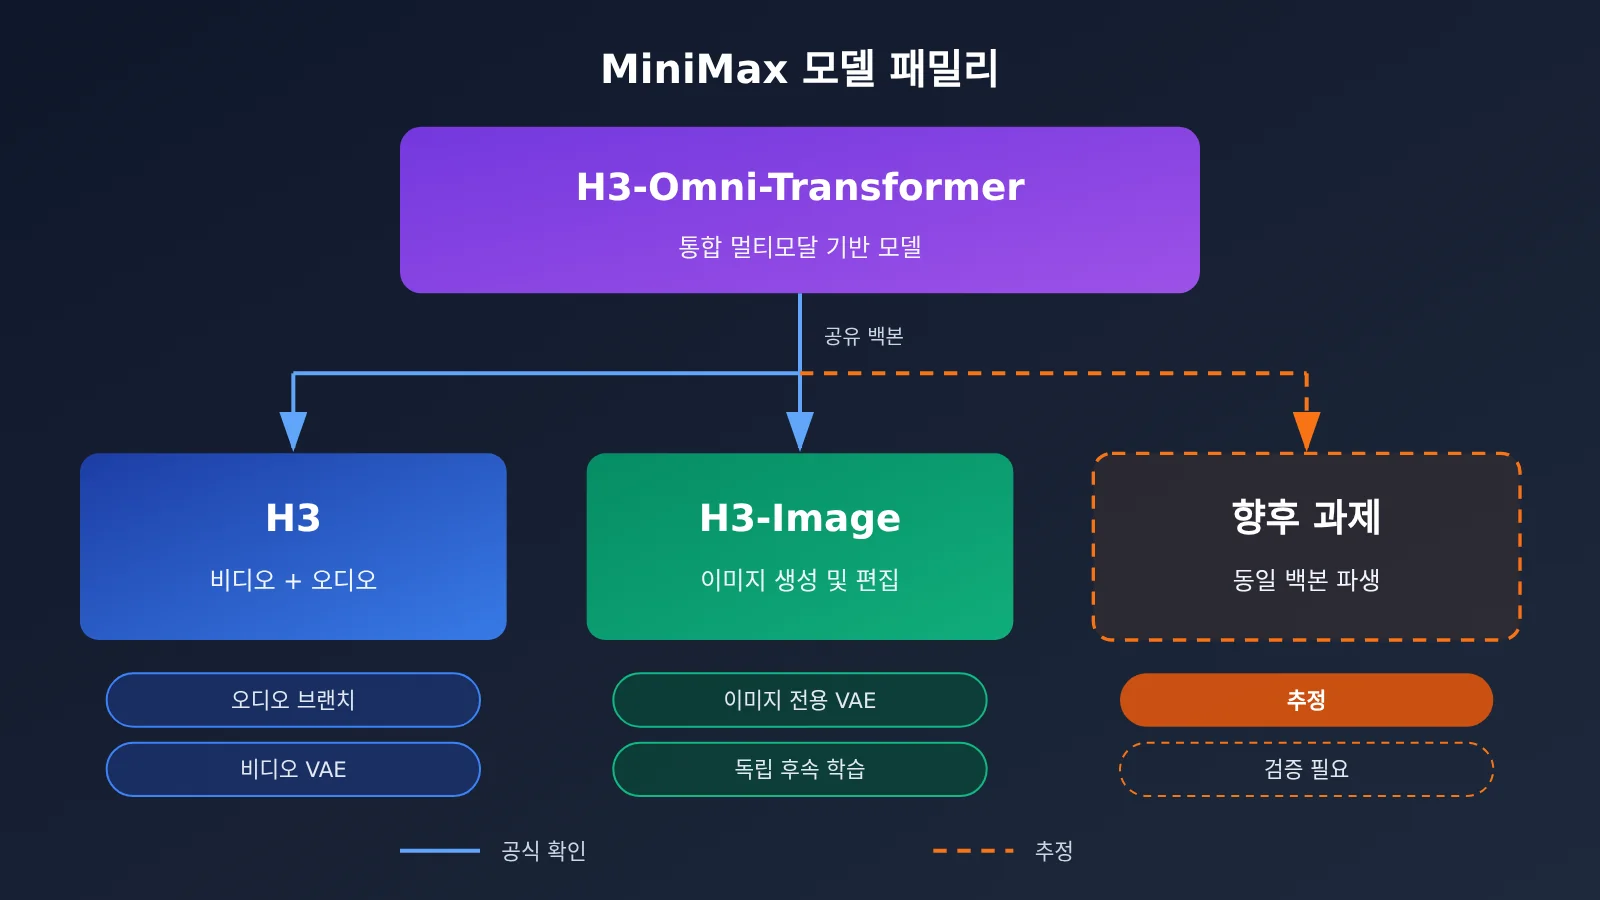
【공식 확인】 H3-Image는 H3의 핵심 Transformer와 텍스트 인코더를 재사용하면서, 전용 VAE와 독립적인 후속 학습(post-training) 과정을 사용해요.
【저희의 추론】 이는 비디오 생성과 이미지 생성이 의미 이해, 멀티모달 정렬, 공간 위치 모델링 같은 기초 능력을 상당 부분 공유할 수 있다는 뜻이에요. 다만 작업마다 전용 인코딩·디코딩 구성 요소와 맞춤형 학습은 여전히 필요해요. MiniMax의 방향은 생성 작업마다 모델을 처음부터 학습시키기보다는 “통합 멀티모달 기반을 먼저 만들고, 이후 작업별로 특화한다”는 쪽에 가까워 보여요. 이 방식이 잘 자리 잡는다면 같은 백본 네트워크에서 파생된 모델이 더 많이 나올 가능성이 있지만, 현재로서는 업계의 추측일 뿐이에요.
자주 묻는 질문 FAQ
Q1: H3-Image는 H3 비디오 모델의 출력만 이미지로 바꾼 건가요?
아니에요. H3-Image는 H3의 Qwen3-VL 텍스트 인코더, 33.1B 싱글 스트림 DiT 아키텍처, 3D RoPE를 이어받았지만, 오디오 브랜치는 제거했어요. 대신 CNN 인코더와 2D ViT 디코더로 구성된 이미지 전용 VAE를 사용하고, 데이터 구성과 강화 학습, 증류 같은 후속 학습도 별도로 진행했어요.
Q2: MiniMax H3와 H3-Image의 파라미터 수가 거의 같은 이유가 뭔가요?
두 모델의 핵심 Transformer가 같은 아키텍처에서 나왔기 때문이에요. H3는 약 33B, H3-Image의 DiT는 33.1B예요. 파라미터 수가 비슷하다는 건 백본 네트워크를 통째로 유지했다는 뜻이고, 차이는 주로 인코더·디코더 구성 요소와 학습 목표에서 나타나요.
Q3: H3-Image는 참조 이미지를 정확히 몇 장까지 지원하나요?
공식 모델 카드에는 최대 16장으로 나와 있고, vLLM 배포 레시피에는 최대 9장으로 적혀 있어요. 앞쪽은 제조사가 밝힌 수치이고, 뒤쪽은 특정 프레임워크의 테스트 설정이에요. 실제로 사용할 때는 선택한 추론 프레임워크 기준을 따르시면 돼요.
Q4: 6단계 샘플링과 CFG 제거가 화질에 영향을 주지는 않나요?
공식 측은 증류 후에도 높은 품질의 출력을 유지한다고 밝히지만, 현재 공개된 자료는 대부분 제조사가 직접 보여준 사례예요. 실제 사용 환경에서 비교 테스트를 해보시길 권해요. 특히 복잡한 지시 사항을 얼마나 잘 따르는지, 여러 참조 이미지를 조합했을 때 결과가 어떤지를 중점적으로 살펴보세요.
Q5: H200급 GPU가 없는데, 이미지 생성 워크플로를 먼저 검증할 방법이 있나요?
클라우드 API로 먼저 워크플로를 돌려볼 수 있어요.
1. APIYI(apiyi.com)에 가입해서 API 키와 무료 테스트 크레딧을 받으세요.
2. 이 글의 프롬프트 개선 코드(base_url은 `https://api.apiyi.com/v1`)로 전처리 단계를 구성하세요.
3. 플랫폼에 이미 올라와 있는 주요 이미지 생성 모델을 연결해 전체 파이프라인을 검증한 뒤, 자체 배포를 할지 판단하세요.
Q6: H3-Image를 배포해서 외부에 API 서비스로 제공해도 되나요?
특히 조심하셔야 해요. H3-Image 라이선스에 따르면 제3자에게 호스팅 서비스를 제공하려면 매출 규모와 관계없이 사전에 MiniMax의 서면 승인을 받아야 해요. 구체적인 조항은 라이선스 원문을 기준으로 확인하시고, 필요하면 법률 자문을 받으세요.
MiniMax H3 아키텍처 진화 핵심 요약 Key Takeaways
- 같은 뿌리, 다른 쓰임새: H3-Image는 H3의 핵심 Transformer와 텍스트 인코더를 재사용해요. 단순히 출력 모드만 바꾼 게 아니에요.
- 세 가지 핵심 개조: 오디오 브랜치를 제거하고, 이미지 전용 VAE로 교체하고, 생성 목표를 이미지 잠재 변수(latent) 예측으로 바꿨어요.
- 의미 이해는 Qwen3-VL에서: 50번째 레이어의 은닉 상태를 가져와 텍스트와 참조 이미지를 함께 이해해요.
- 속도는 증류에서: 6스텝 샘플링에 CFG도 필요 없어요. 공식적으로 말하는 “10초 만에 4K”의 기술적 토대예요.
- 라이선스는 따로 확인하세요: H3-Image의 호스팅 서비스와 매출 100만 달러 기준 모두 라이선스 요건이 적용될 수 있어요.
- 검증 먼저, 배포는 나중에: 먼저 APIYI(apiyi.com)에서 여러 모델로 프로토타입을 만든 다음, 자체 배포 비용을 따져 보세요.
정리
MiniMax H3가 비디오에서 이미지로 진화한 과정은 크게 세 가지로 요약할 수 있어요.
- 공유 기반: 33B급 싱글 스트림 멀티모달 Transformer, Qwen3-VL 텍스트 인코더, 3D RoPE를 그대로 유지했어요.
- 작업 특화: 오디오 브랜치를 없애고 CNN + 2D ViT 구조의 이미지 VAE를 얹었어요. 생성 목표도 비디오+오디오 잠재 변수에서 이미지 잠재 변수로 바뀌었고요.
- 학습과 추론의 재설계: 데이터, 강화 학습, 6스텝 CFG-free 증류, 프롬프트 증강, 배포 최적화가 함께 맞물려 16MP급 출력을 뒷받침해요.
개발자 입장에서 정말 눈여겨볼 부분은 “어떤 능력은 공유할 수 있고, 어떤 능력은 반드시 따로 학습해야 하는가”예요. 그리고 가중치 뒤에 숨은 하드웨어 비용과 라이선스 의무도 꼭 살펴봐야 해요. 자체 배포를 결정하기 전에 APIYI(apiyi.com)의 통합 인터페이스로 여러 모델을 비교해 보면서 이미지 워크플로를 빠르게 검증해 보세요.
📚 참고 자료
- MiniMax H3 공식 기술 소개: H3-Omni-Transformer 아키텍처 설명
- 링크:
minimax.io/blog/minimax-h3 -
설명: 멀티모달 인코딩 경로와 3D Multimodal RoPE에 대한 공식 설명
-
MiniMax H3-Image 공식 출시 블로그: 후속 학습 및 추론 최적화
- 링크:
minimax.io/blog/minimax-h3-image -
설명: 데이터, 강화 학습, 6단계 증류, 프롬프트 향상 등 개선 사항
-
H3-Image Hugging Face 모델 카드: 전체 아키텍처 파라미터
- 링크:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
설명: DiT, VAE, 텍스트 인코더의 구체적인 사양
-
H3 원본 모델 카드 및 라이선스: 비디오 모델 사양과 사용 허가 조건
- 링크:
huggingface.co/MiniMaxAI/MiniMax-H3 -
설명: H3 사양 및
blob/main/LICENSE라이선스 원문 -
H3-Image 라이선스 원문: 상업적 이용 허가 조건
- 링크:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
설명: 호스팅 서비스 및 수익 기준 등의 조항
-
vLLM 배포 레시피: 프레임워크 테스트 구성
- 링크:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - 설명: 참조 이미지 개수 등 프레임워크 측 기준
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 홈페이지에서 언제든 문의해 주세요. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.