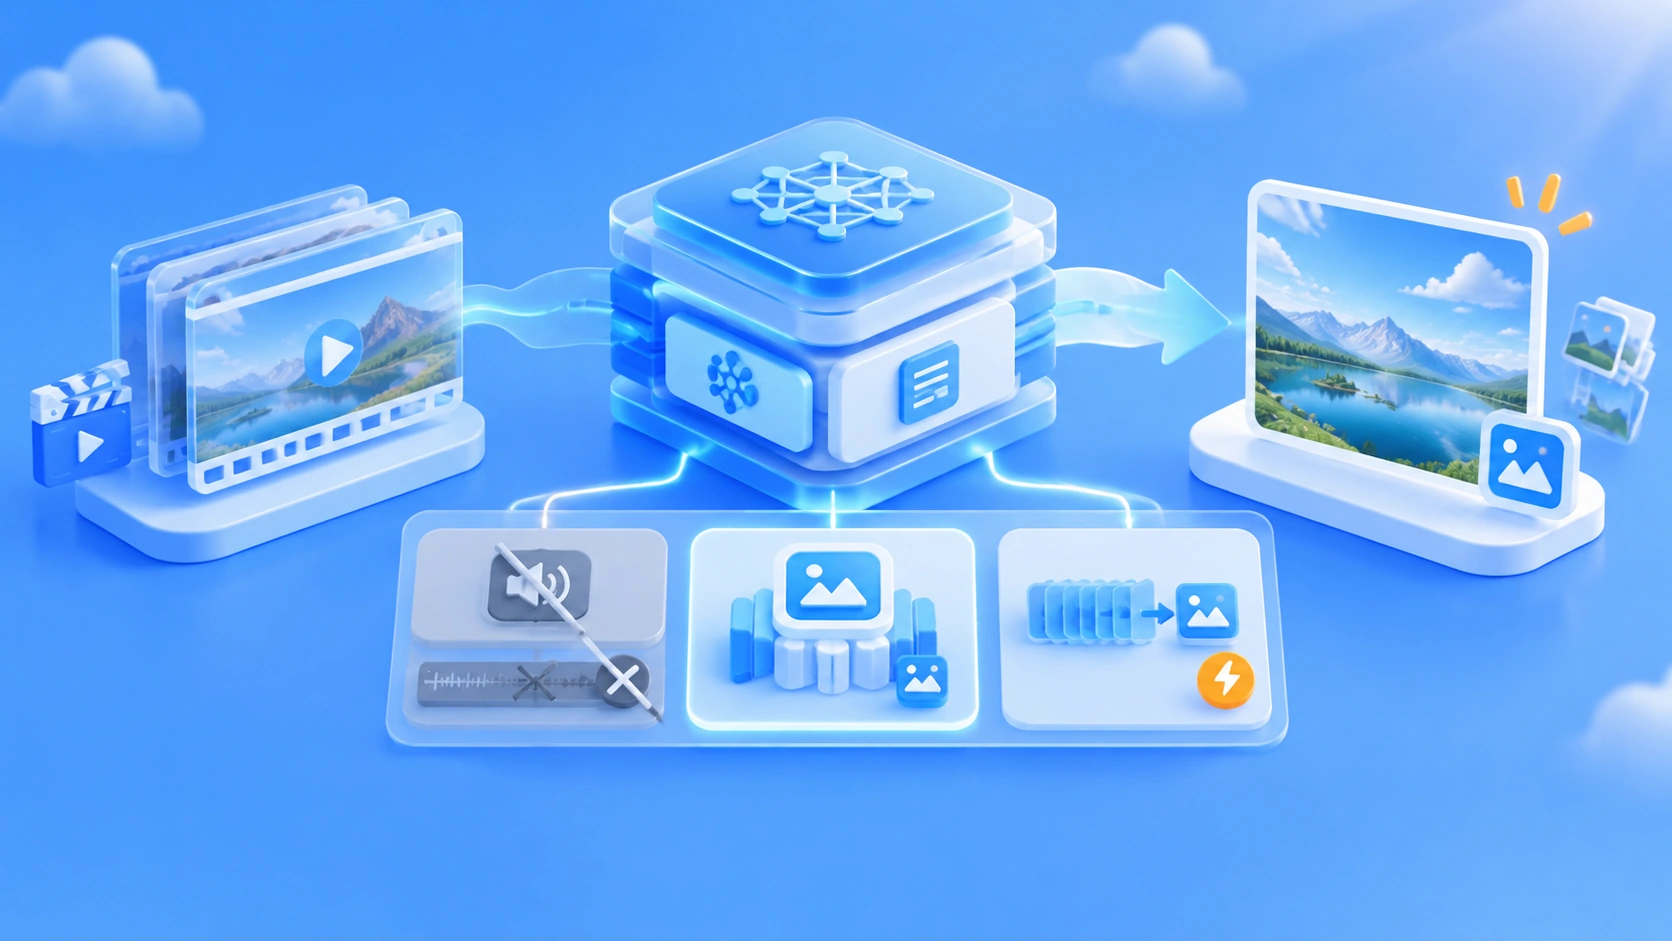
Anmerkung des Autors: H3-Image übernimmt die multimodale Grundarchitektur von H3, ergänzt sie um bildspezifische Komponenten und optimiert Training und Inferenz neu. Heraus kommt ein eigenständiges Modell zur Bilderzeugung. In diesem Artikel schauen wir uns an, was es geerbt, was es gestrichen und was es neu dazubekommen hat.
6 Begriffe, die Sie vor der MiniMax-H3-Architektur kennen sollten
Die folgenden Konzepte tauchen im weiteren Verlauf immer wieder auf. Hier zunächst jeweils in einem Satz erklärt.
| Begriff | Einfach erklärt | Rolle in MiniMax H3 |
|---|---|---|
| Transformer | Neuronales Netz zur Verarbeitung von Sequenzdaten, das Beziehungen zwischen den einzelnen Elementen einer Sequenz gut erfasst | Der H3-Omni-Transformer ist das Herzstück der gesamten Modellfamilie |
| DiT | Diffusionsmodell auf Transformer-Basis, das Inhalte durch schrittweises Entrauschen erzeugt | Der Kern von H3-Image ist ein Single-Stream-DiT mit 33,1 Mrd. Parametern |
| VAE | Modell, das zwischen Pixeln und einer komprimierten Darstellung kodiert und dekodiert, also eine Art „Kompressor + Dekompressor“ | H3 nutzt einen visuellen und einen Audio-VAE, H3-Image setzt stattdessen einen bildspezifischen VAE ein |
| Latente Variablen | Kompakte Darstellung der komprimierten Rohdaten. Im latenten Raum zu rechnen ist deutlich sparsamer, als Pixel direkt zu verarbeiten | Der Transformer sagt latente Variablen voraus, keine Pixel |
| RoPE | Rotary Position Embedding, das dem Modell mitteilt, an welcher Position in der Sequenz ein Token steht | H3 verwendet 3D Multimodal RoPE, um zeitliche und räumliche Positionen abzubilden |
| Destillation | Ein ursprünglich vielstufiger, aufwendiger Prozess wird so trainiert, dass er mit wenigen Schritten auskommt | H3-Image wurde auf nur 6 Sampling-Schritte destilliert |
Im November 2026 hat MiniMax die Gewichte des Bilderzeugungsmodells H3-Image freigegeben. Der drei Monate zuvor als Open Source veröffentlichte H3 kann Videos mit Stereo-Audio erzeugen. Das neue Modell bewegt sich bei der Parameterzahl in derselben 33B-Größenordnung, und auch die Kernarchitektur stammt von H3.
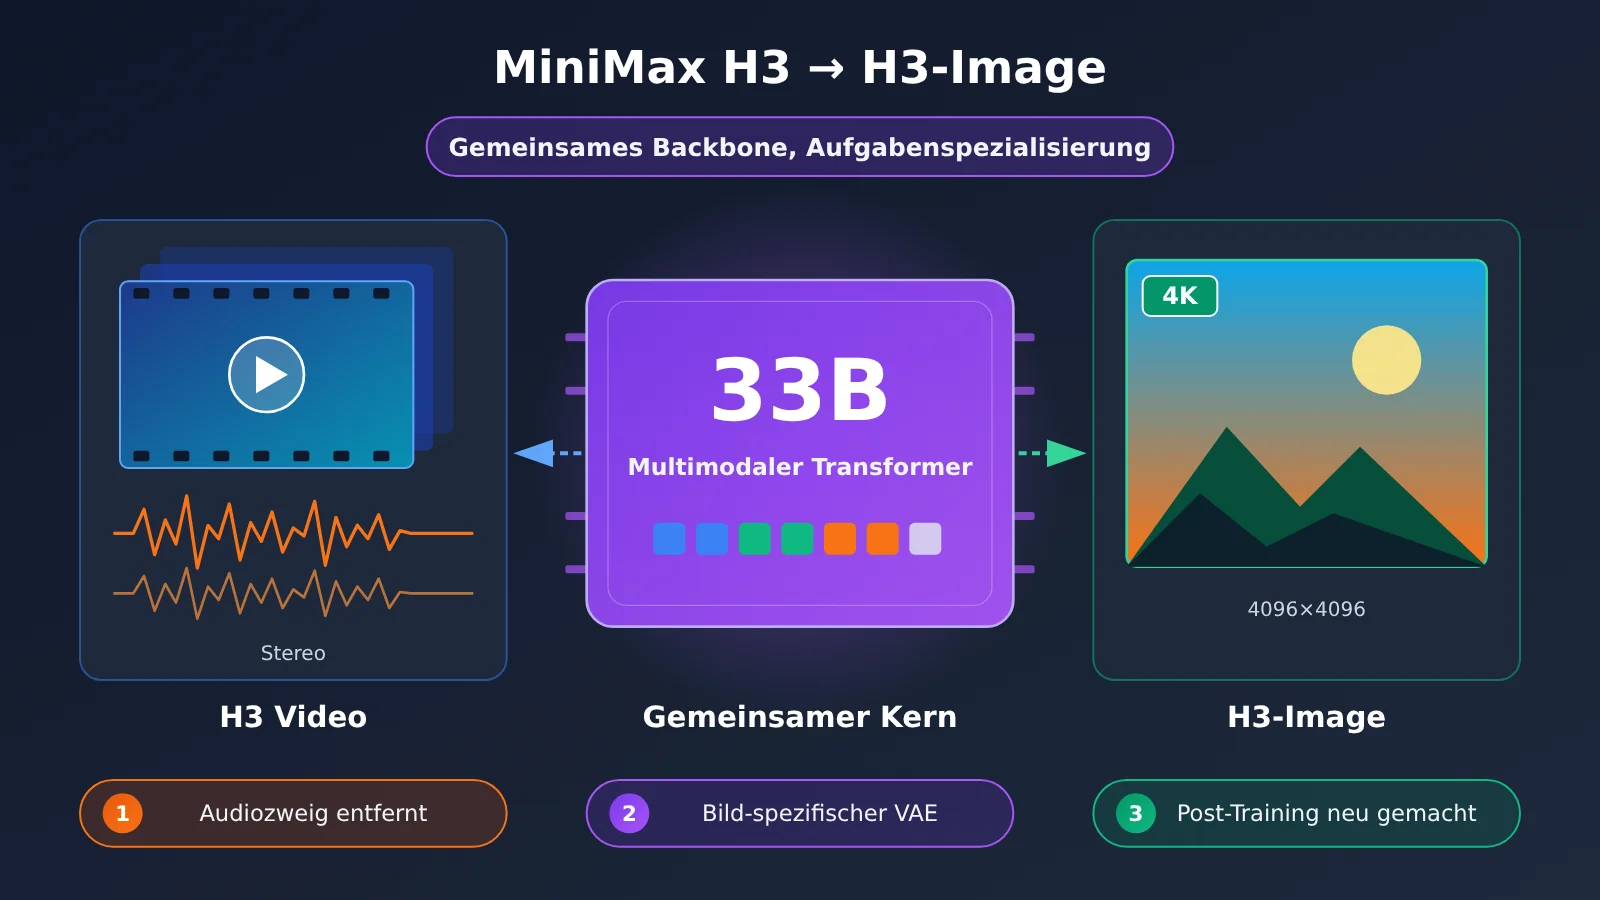
Es ist nicht einfach ein Videomodell, dessen Ausgabe auf ein einzelnes Frame gekürzt wurde. Laut Modellkarte und Release-Blog von H3-Image nutzt es weiterhin den multimodalen Kern-Transformer und den Text-Encoder von H3. Der Audio-Zweig wurde entfernt, ein bildspezifischer VAE kam hinzu, und Nachtraining sowie Inferenz wurden für Bildaufgaben neu aufgesetzt.
Der Mehrwert für Sie: Nach der Lektüre wissen Sie, an welchen Stellen die 33B-Architektur beim Wechsel von Video zu Bild konkret verändert wurde und warum jeweils. Außerdem sehen Sie, was offiziell bestätigt ist und was lediglich Schlussfolgerungen aus der Branche sind.
MiniMax H3: Vom Video zum Bild – was MiniMax veröffentlicht hat
Zuerst die Zeitleiste, denn bei der Meldung „MiniMax H3 ist Open Source“ werden oft zwei Veröffentlichungen in einen Topf geworfen. H3 und H3-Image sind zwei verschiedene Dinge, die rund drei Monate auseinanderliegen.
| Datum | Ereignis | Beschreibung |
|---|---|---|
| 2026-07-31 | MiniMax veröffentlicht die Vorstellung des H3-Modells | Der offizielle Technik-Blog macht die H3-Architektur erstmals öffentlich |
| 2026-08-03 | MiniMax H3 offiziell mit offenen Gewichten | Videogenerierungsmodell für alle Modalitäten, als Open Source erscheint H3-Base |
| 2026-11-10 | Datum der H3-Image Community License | Gewichte des Bilderzeugungsmodells werden freigegeben |
| 2026-11-11 | MiniMax veröffentlicht englischen offiziellen Blogbeitrag zu H3-Image | Details zu Post-Training und Inferenzoptimierung werden bekannt gegeben |
Aufgabenbereiche von MiniMax H3 und H3-Image
Die beiden Modelle haben völlig unterschiedliche Aufgaben. H3 ist ein Videogenerierungssystem für alle Modalitäten: Es versteht Text-, Bild-, Video- und Audioeingaben gleichzeitig und liefert Videos von 4 bis 15 Sekunden Länge mit 24 FPS und nativem 32-kHz-Stereoton. Standardmäßig liegt die kurze Kante bei 768 px, im vollständigen Workflow sind bis zu 2K möglich. H3-Image konzentriert sich dagegen auf hochauflösende Bilderzeugung und Bildbearbeitung. Laut offizieller Spezifikation sind maximal etwa 16 MP möglich (z. B. 4096×4096), und ein 4K-Bild soll sich innerhalb von 10 Sekunden erzeugen lassen.
Damit sind wir bei der zentralen Frage dieses Artikels: Das eine Modell macht „Video mit Ton“, das andere „hochauflösende Standbilder“ – warum gehören sie dann zur selben Technologiefamilie? Die Antwort steckt im grundlegenden Design von H3.
Die Architektur von MiniMax H3: ein einheitlicher multimodaler Transformer
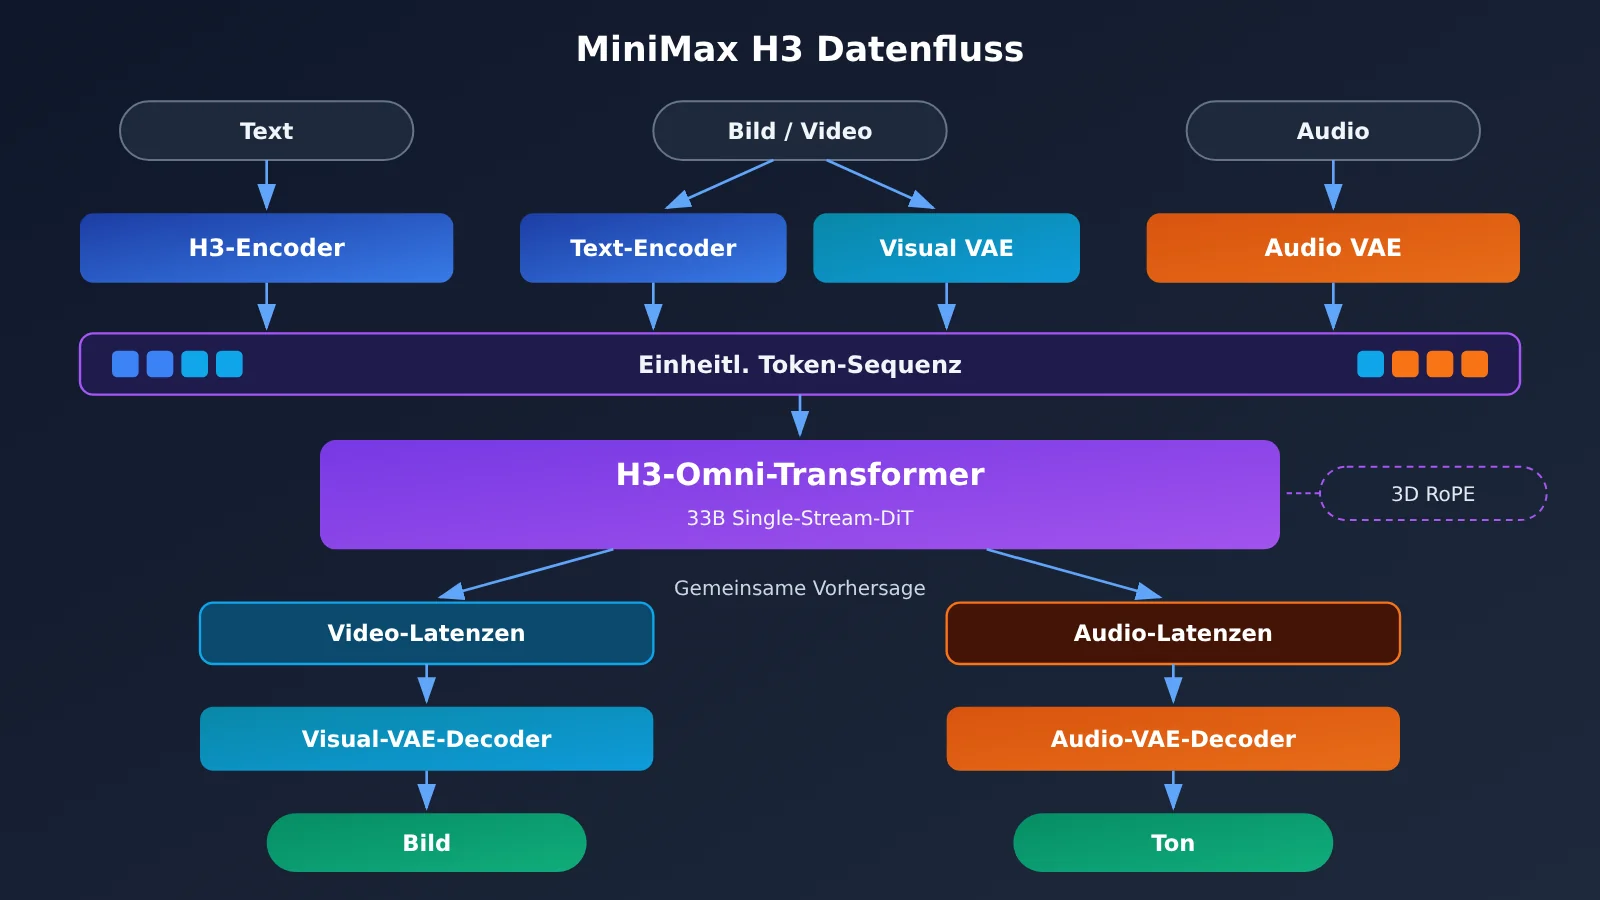
Das Herzstück von H3 heißt H3-Omni-Transformer. Laut der offiziellen technischen Beschreibung ist er ein Single-Stream-Dense-Transformer mit rund 33 Mrd. Parametern. „Single-Stream“ bedeutet: Die Informationen der einzelnen Modalitäten laufen nicht durch getrennte Netze. Sie werden in dieselbe Sequenz gepackt und von denselben Parametern verarbeitet. „Dense“ heißt, dass jedes Token durch sämtliche Parameter gerechnet wird. Bei einem MoE-Modell dagegen wird nur ein Teil der Experten aktiviert.
Wie MiniMax H3 die einzelnen Modalitäten kodiert
Die offiziell beschriebenen Verarbeitungswege sehen in etwa so aus:
- Text: Der H3-Encoder wandelt ihn in eine semantische Repräsentation um. Sie sagt dem Modell, „was im Bild passieren soll“.
- Bild und Video: Beides läuft sowohl durch den Text-Encoder als auch durch einen Visual VAE. Der Text-Encoder erfasst die Semantik des Bildinhalts, der Visual VAE komprimiert die Pixel in latente Variablen.
- Audio: Ein Audio VAE komprimiert das Signal in Audio-Latents.
- Einheitliche Sequenz: Die Repräsentationen aller Modalitäten werden zu einer einzigen Sequenz zusammengefügt und in den Transformer geschickt.
- Gemeinsame Vorhersage: Der Transformer sagt die Latents für Video und Audio gleichzeitig voraus. Anschließend dekodieren die jeweiligen VAEs sie zu Bild und Ton.
Man kann sich das so vorstellen, dass „alle dieselbe Sprache sprechen“. Ob die Eingabe ein Satz, ein Bild oder ein Musikstück ist: Vor dem Transformer wird sie in eine Token-Sequenz übersetzt. Dem Modell ist egal, aus welcher Modalität ein Token stammt. Es muss nur die Beziehungen zwischen den Tokens herausfinden und die Ziel-Tokens erzeugen.
Wozu 3D Multimodal RoPE dient
Ein Video hat eine Zeitachse und zwei räumliche Dimensionen. Deshalb kodiert H3 Positionen mit 3D Multimodal RoPE. Ein Token kennt damit nicht nur seine horizontale und vertikale Koordinate im Bild, sondern auch seine Frame-Nummer. Diese Designentscheidung wurde offiziell bestätigt. Sie ist wichtig, um H3-Image zu verstehen, denn ein Bild lässt sich als Sonderfall betrachten, bei dem die Zeitdimension nur einen einzigen Frame hat.
【Unsere Schlussfolgerung】 Gerade weil H3 von Anfang an als „einheitliche Sequenz + einheitlicher Transformer“ konzipiert ist und nicht als Single-Task-Pipeline nach dem Muster „Text rein, Video raus“, eignet sich sein Backbone grundsätzlich auch für andere Generierungsaufgaben. Diese Aussage stammt nicht direkt von offizieller Seite, sondern ist unser eigener Schluss aus dem Architekturdesign.
Was MiniMax H3-Image erbt, streicht und neu hinzufügt
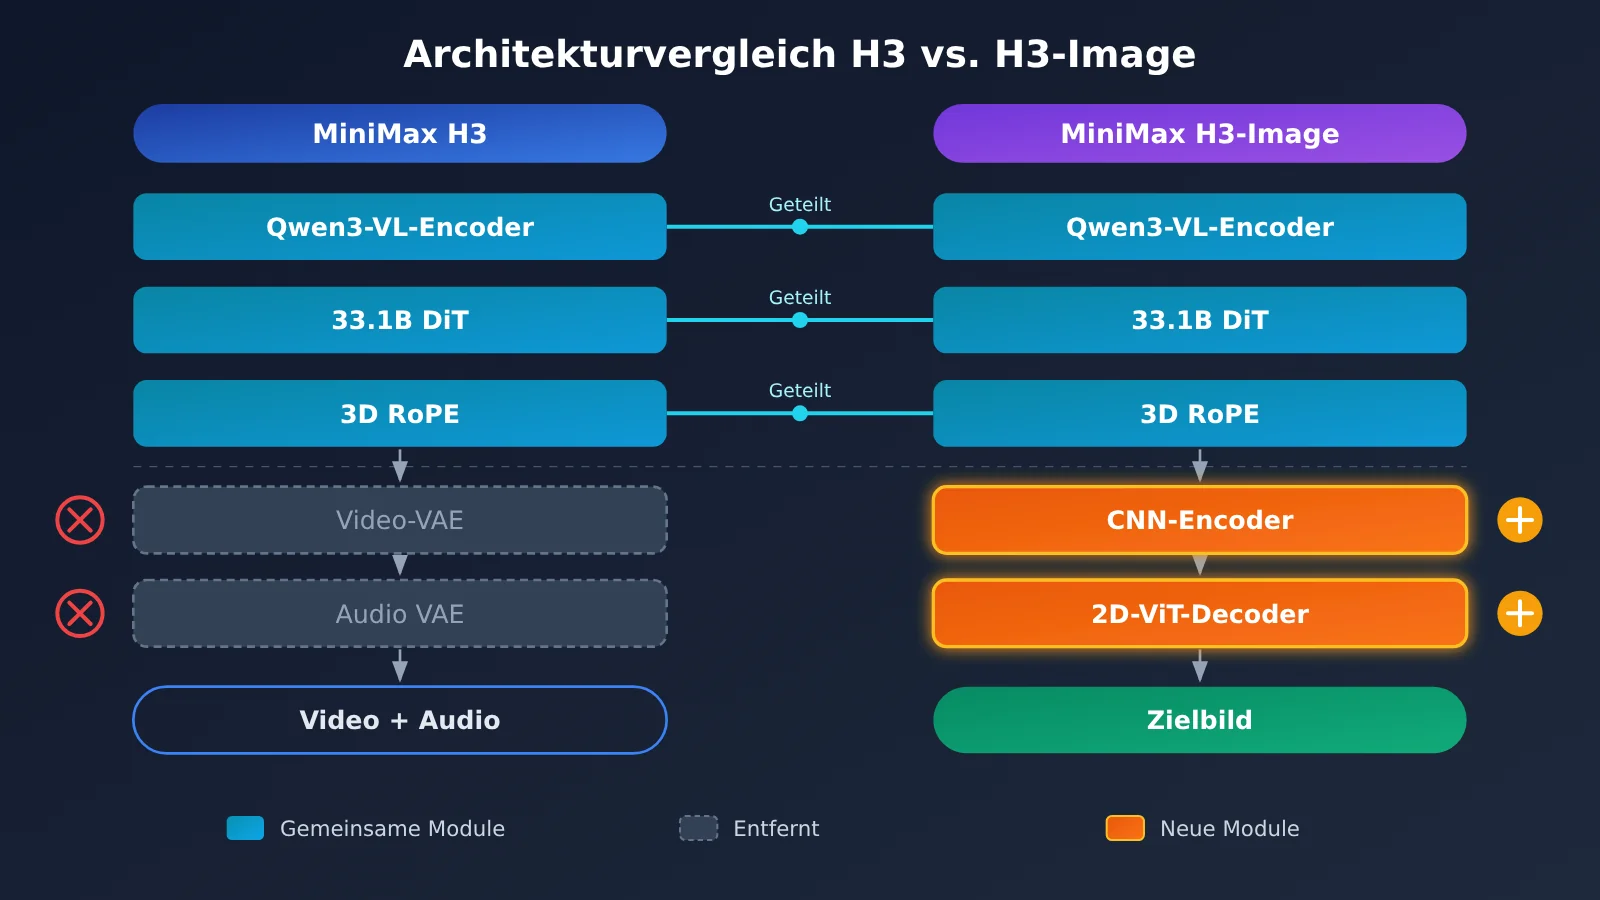
Dieser Abschnitt ist der interessanteste Teil der gesamten technischen Entwicklung. Die folgende Tabelle basiert auf der offiziellen Modellkarte von H3-Image:
| Kategorie | Komponente | Umsetzung |
|---|---|---|
| Übernommen | Qwen3-VL-Textencoder | Der vollständige Textencoder von H3 bleibt erhalten; verwendet wird der Hidden State der 50. Schicht |
| Übernommen | 33,1B Single-Stream-DiT | Die Kernarchitektur des H3-Omni-Transformers bleibt erhalten |
| Übernommen | 3D Multimodal RoPE | Kodiert weiterhin die Positionsbeziehungen |
| Gestrichen | Audiozweig | Die gemeinsame Erzeugung von Video und Audio entfällt |
| Ersetzt | Bildspezifischer VAE | CNN-Encoder + 2D-ViT-Decoder mit 24 Schichten |
| Geändert | Generierungsziel | Text und Referenzbilder werden zu einer einheitlichen Sequenz kodiert, vorhergesagt wird der Latent des Zielbilds |
Übernommen (1): Der Qwen3-VL-Textencoder und der Hidden State der 50. Schicht
Laut Modellkarte übernimmt H3-Image den Textencoder auf Basis von Qwen3-VL aus H3 und nutzt den Hidden State der 50. Schicht als Konditionierung. Qwen3-VL ist selbst ein Vision-Sprachmodell. Es versteht also nicht nur Text, sondern auch den Inhalt von Referenzbildern – genau die Fähigkeit, die man für die Bearbeitung mit mehreren Referenzbildern braucht.
【Branchenübliche Praxis】 Warum eine mittlere Schicht statt der letzten gewählt wird, erklärt die offizielle Seite nicht näher. In der Branche geht man meist davon aus, dass die letzten Schichten eines Sprachmodells stark auf die „Vorhersage des nächsten Tokens“ ausgerichtet sind, während mittlere Schichten reichhaltigere und allgemeinere semantische Merkmale behalten. Viele Diffusionsmodelle gehen ähnlich vor.
Erbe Nr. 2: 33,1B-DiT mit 3D-RoPE
Die Spezifikationen des DiT-Hauptteils von H3-Image im Überblick:
| Parameter | Wert | Einfach erklärt |
|---|---|---|
| Parameterzahl | 33,1B | In derselben Größenordnung wie das rund 33B große Rückgrat von H3 |
| Anzahl der Schichten | 50 Schichten | Die Information durchläuft 50 Transformationen |
| Hidden Size | 5376 | Dimension der Darstellung pro Token |
| Attention Heads | 56 | Betrachtet die Beziehungen zwischen Tokens gleichzeitig aus 56 Blickwinkeln |
| FFN Size | 14336 | Mittlere Breite des Feedforward-Netzes in jeder Schicht |
| VAE-Downsampling (räumlich) | 16-fach | 4096 Pixel Kantenlänge werden auf 256 komprimiert |
| Latente Kanäle | 24 | Jede latente Position trägt 24 Zahlenwerte |
| Abdeckung pro Token | ca. 32×32 Pixel | Bestimmt Sequenzlänge und Rechenaufwand |
Geht man davon aus, dass jedes Token etwa 32×32 Pixeln entspricht, ergeben sich für ein Bild mit 4096×4096 Pixeln ungefähr 128×128 = 16.384 Tokens (das ist unsere eigene Schätzung auf Basis der offiziellen Parameter). Kommen noch mehrere Referenzbilder hinzu, wird die Sequenz noch länger. Das erklärt auch, warum die Optimierung der Inferenzgeschwindigkeit hier so wichtig ist.
【Unsere Schlussfolgerung】 3D-RoPE ist auch bei Bildaufgaben nützlich. Das Zielbild besteht zwar nur aus einem einzelnen Frame, aber mehrere Referenzbilder und das Zielbild müssen in der Sequenz auseinandergehalten werden – „wer ist wer“. Die zusätzliche Dimension kann diese Unterscheidung übernehmen. Das konkrete Schema für die Positionszuweisung hat der Hersteller nicht veröffentlicht; das hier ist lediglich eine plausible Deutung.
Entfernen: der Audio-Zweig
Bilder haben weder eine zeitliche Dauer noch einen Ton. Ein beibehaltener Audio-Zweig würde daher nur Trainings- und Inferenzressourcen verschwenden. Ohne ihn verengt sich das Lernziel des Modells von der „gemeinsamen Verteilung aus Video und Audio“ auf die „Bildverteilung“, und das Trainingssignal wird fokussierter.
Ersetzen: ein VAE speziell für Bilder
Der Visual-VAE von H3 muss die zeitliche Kontinuität von Videos berücksichtigen. H3-Image verwendet stattdessen einen VAE, der eigens für statische Bilder entwickelt wurde. Der Encoder basiert auf einem CNN, das lokale Texturen effizient extrahiert. Der Decoder ist ein 2D-ViT mit 24 Schichten, der beim Rekonstruieren der Pixel auch die globale Struktur im Blick behält. Die 16-fache Abwärtsskalierung in Kombination mit 24 Kanälen bedeutet: Die Informationen werden auf weniger räumliche Positionen, dafür aber auf mehr Kanäle verteilt. Das ist entscheidend für hochauflösende Ausgaben im Bereich von 16 MP. Laut offizieller Angabe entstehen die hochauflösenden Ergebnisse von H3-Image außerdem direkt bei der Generierung und nicht mithilfe eines herkömmlichen Super-Resolution-Upscalers.
Änderung: Von „Video + Audio vorhersagen“ zu „Zielbild vorhersagen“
Der finale Erzeugungsablauf sieht so aus: Der Text-Prompt und die Referenzbilder werden gemeinsam zu einer einheitlichen Sequenz kodiert. Der DiT entrauscht im latenten Raum Schritt für Schritt und sagt die Latents des Zielbilds voraus. Anschließend dekodiert der Bild-VAE diese zum fertigen Bild. Bei der Anzahl der Referenzbilder nennt die Modellkarte eine Obergrenze von 16, im vLLM-Deployment-Rezept stehen dagegen maximal 9. Die beiden Angaben folgen unterschiedlichen Maßstäben – wie viele Referenzbilder tatsächlich nutzbar sind, hängt vom verwendeten Inferenz-Framework ab.
Welche Optimierungen MiniMax H3-Image für mehr Tempo und Praxistauglichkeit vornimmt
Allein die Architektur anzupassen, reicht nicht. Im Release-Blog zu H3-Image schreibt MiniMax, dass das Modell die Pretraining-Fähigkeiten von H3 erbt und der Post-Training-Prozess in fünf Punkten verbessert wurde: Trainingsdaten, Reinforcement Learning, Komprimierung der Sampling-Schritte, Prompt Enhancement (Verbesserung der Eingabeaufforderung) und Deployment-Optimierung. Zu den Daten und zum Reinforcement Learning hat MiniMax keine Details veröffentlicht. Deshalb konzentrieren wir uns im Folgenden auf die Teile, zu denen mehr öffentliche Informationen vorliegen.
6-Schritt-Sampling-Destillation und Verzicht auf CFG
Diffusionsmodelle erzeugen Bilder, indem sie ausgehend von Rauschen Schritt für Schritt entrauschen. Üblich sind dafür meist mehrere Dutzend Schritte. Hinzu kommt: Klassische Diffusionsmodelle nutzen in der Regel CFG (Classifier-Free Guidance). In jedem Schritt laufen dabei zwei Durchgänge, einer mit und einer ohne Eingabeaufforderung. Anschließend werden die Ergebnisse in einem bestimmten Verhältnis gemischt, damit das Modell die Eingabeaufforderung besser befolgt.
H3-Image drückt das Sampling per Destillation auf 6 Schritte und kommt zugleich ohne CFG aus. Das eine reduziert die Zahl der Schritte drastisch, das andere sorgt dafür, dass pro Schritt nur noch ein einziger Forward-Pass nötig ist. Bei einem Modell mit 33,1 Mrd. Parametern und mehreren zehntausend Token pro Bild bilden beide Maßnahmen zusammen die technische Grundlage für die offizielle Angabe „4K in 10 Sekunden“. Dabei gilt: Die 10 Sekunden sind eine Herstellerangabe. Die tatsächliche Geschwindigkeit hängt von der Hardware und der Deployment-Konfiguration ab.
Eingabeaufforderung verbessern: Aus kurzen Beschreibungen ausführbare Anweisungen machen
H3-Image bietet ein optionales PE-Modell (Prompt Enhancement) mit rund 17,9 GB Gewichten. Es erweitert kurze Beschreibungen des Nutzers zu ausführlicheren Eingabeaufforderungen, die das Modell besser versteht. Wenn Sie dieses zusätzliche Modell vorerst nicht selbst betreiben möchten, können Sie die Vorverarbeitung auch mit einem allgemeinen Großen Sprachmodell umsetzen. Hier ein minimales Beispiel:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche Schnittstelle von APIYI verwenden
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把这句扩写成详细的图像生成提示词:雨夜的赛博朋克街头"}]
)
print(resp.choices[0].message.content)
Vollständige Implementierung der Prompt-Verbesserung anzeigen
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是图像生成提示词工程师。请把用户的简短描述扩写为结构化提示词,"
    "依次包含:主体、构图、光线、材质细节、色彩、镜头与画幅。"
    "如果用户提供了参考图说明,请明确每张参考图在画面中的作用。"
    "只输出提示词正文,不要解释。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"参考图{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# Beispiel: Wohnzimmer-Komposition aus leerem Raum + Referenzbildern von Möbeln
print(enhance_prompt(
    "把这些家具摆进空客厅,北欧风,午后自然光",
    ["空房间照片", "灰色布艺沙发", "橡木茶几", "落地灯"],
))
Empfehlung: Wenn Sie einen Workflow für die Bilderzeugung aufbauen, können Sie für die Vorverarbeitung der Eingabeaufforderung zunächst über APIYI (apiyi.com) mehrere gängige Große Sprachmodelle anbinden und deren Ergebnisse vergleichen. Erst danach entscheiden Sie, ob sich der Betrieb eines eigenen PE-Modells lohnt. Die verfügbaren Modellnamen richten sich nach der Modellliste der Plattform.
Deployment-Optimierung und Unterstützung hoher Auflösungen
Als offizielle Deployment-Frameworks werden SGLang, vLLM-Omni, Diffusers und ComfyUI empfohlen. Als Hardware sind unter anderem NVIDIA H200, RTX PRO 6000 Blackwell und AMD Instinct MI350X aufgeführt, dazu gibt es Lösungen für Multi-GPU-Parallelisierung. Erst das Zusammenspiel aus der hohen Kompressionsrate des Bild-VAE, dem 6-Schritt-Sampling ohne CFG und den Inferenzoptimierungen auf Framework-Ebene macht die direkte Ausgabe hoher Auflösungen möglich, etwa 16:9 (5472×3072), 9:16 (3072×5472) oder 21:9 (6272×2688).
Auswirkungen der Architektur-Wiederverwendung bei MiniMax H3
Auswirkungen für Entwickler
- Gemeinsame Basis, aber nicht austauschbar: H3 und H3-Image teilen sich den Textencoder, den die Model Card als „geteilten H3-Textencoder“ ausweist (ca. 66,7 GB). DiT-Gewichte und VAE sind dagegen jeweils eigenständig. Die H3-Videogewichte lassen sich also nicht einfach für die Bilderzeugung verwenden.
- Die Einstiegshürde bleibt hoch: Das Hauptmodell für Bilder umfasst rund 68,65 GB. Zusammen mit dem Textencoder kommt der komplette Download auf etwa 135,35 GB. Das ist wohlgemerkt nur der Speicherbedarf und sagt noch nichts über den VRAM-Bedarf aus.
- Die Lizenzen müssen getrennt betrachtet werden: H3 und H3-Image haben zwei unterschiedliche Community Licenses, deren Auslösebedingungen sich deutlich unterscheiden (siehe Tabelle unten).
| Punkt | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| Umfang der Open-Source-Freigabe | Nur H3-Base; Context-IR und Regenerate-2K erfordern den Aufruf der offiziellen API | Bildmodell-Gewichte, geteilter Textencoder, optionales PE-Modell |
| Lokal verfügbare Leistung | Audio-/Videoerzeugung in 768p; der vollständige 2K-Workflow hängt von der offiziellen API ab | Laut Hersteller direkte Ausgabe von bis zu etwa 16 MP |
| Auslöser für die kommerzielle Lizenzpflicht | Jahresumsatz mit kommerziellen Produkten und Diensten über 20 Mio. US-Dollar | Annualisierter Umsatz von Ihnen und/oder verbundenen Unternehmen über 1 Mio. US-Dollar, oder Bereitstellung von Hosting-Diensten für beliebige Dritte |
| Weitere Pflichten | Regionale Beschränkungen usw.: Lizenztext prüfen | Regionale Beschränkungen, Nutzung der Ausgaben, Produktkennzeichnung usw.: Lizenztext prüfen |
Hinweis zum Vergleich: Die Tabelle fasst die beiden Lizenztexte und die offiziellen Model Cards zusammen. Sie dient nur als Orientierung für die technische Auswahl und ist keine Rechtsberatung. Wenn Selbst-Hosting oder Lizenzierung vorerst nicht infrage kommen, können Sie über APIYI (apiyi.com) zunächst andere gängige Bild- und multimodale Modelle aufrufen und einen Workflow-Prototyp aufbauen.
Auswirkungen auf die Branche
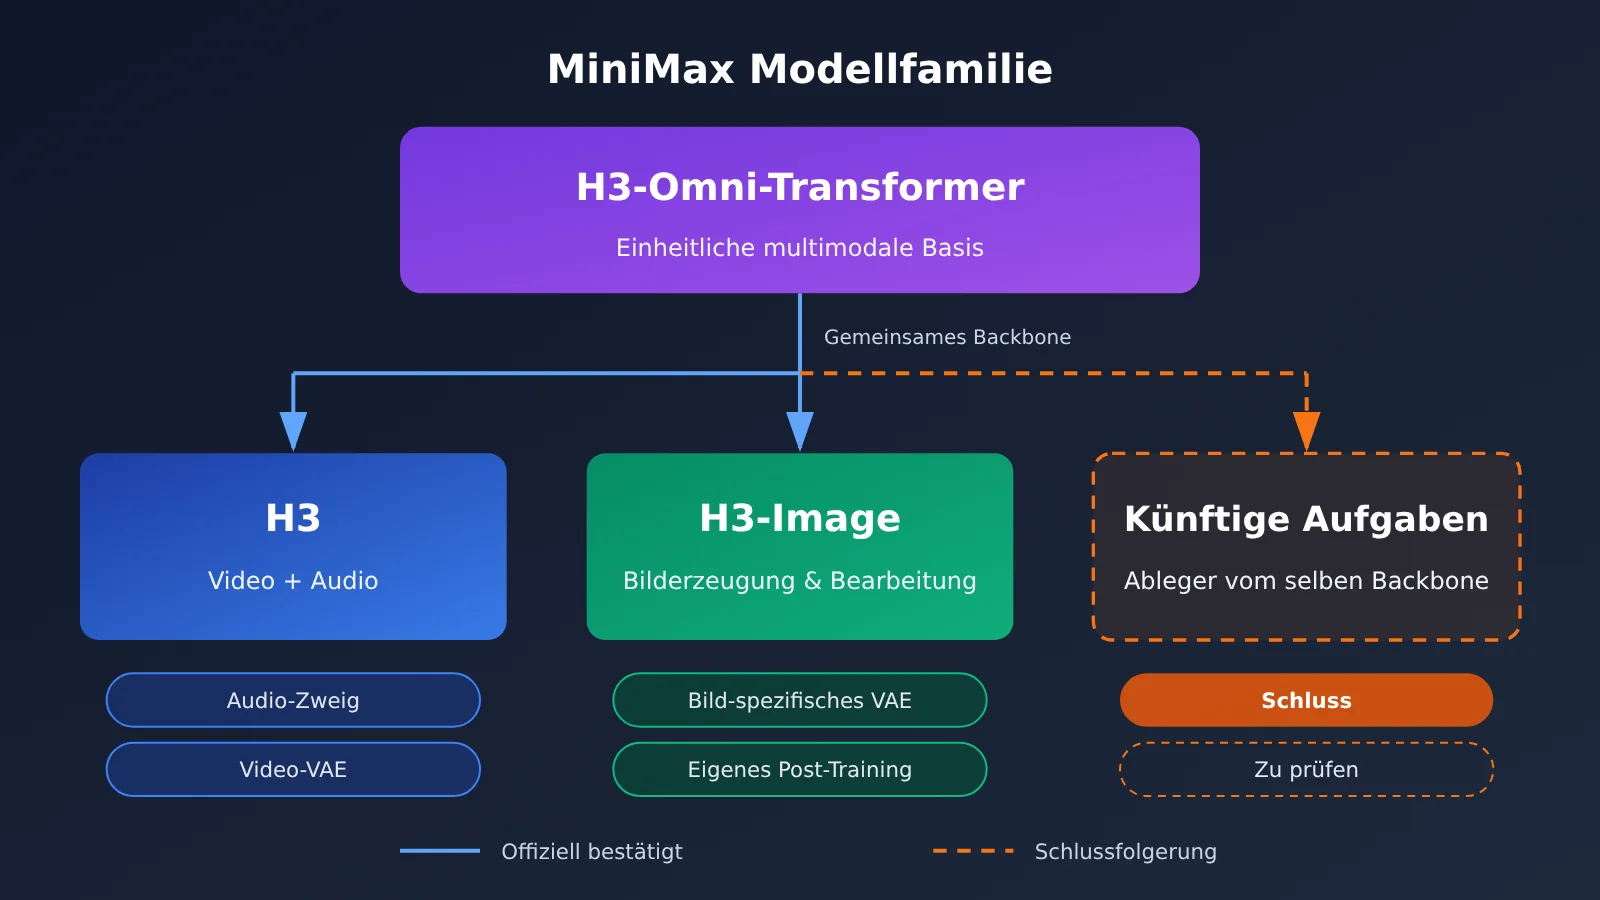
【Offiziell bestätigt】 H3-Image verwendet den zentralen Transformer und den Textencoder von H3 erneut, setzt aber einen eigenen VAE und einen separaten Post-Training-Prozess ein.
【Unsere Schlussfolgerung】 Das legt nahe, dass sich Video- und Bilderzeugung viele grundlegende Fähigkeiten teilen können, etwa semantisches Verständnis, multimodales Alignment und räumliche Positionsmodellierung. Für jede Aufgabe braucht es aber weiterhin spezialisierte Encoder-/Decoder-Komponenten und gezieltes Training. MiniMax geht offenbar so vor: erst eine einheitliche multimodale Basis bauen und diese dann je Aufgabe spezialisieren, statt für jede Generierungsaufgabe ein Modell von Grund auf zu trainieren. Geht dieser Ansatz auf, dürften künftig mehr abgeleitete Modelle auf demselben Backbone entstehen. Das ist derzeit aber nur eine Vermutung aus der Branche.
Häufige Fragen (FAQ)
Q1: Ist H3-Image einfach das H3-Videomodell mit Bildausgabe?
Nein. H3-Image übernimmt von H3 den Qwen3-VL-Textencoder, die 33,1B-Single-Stream-DiT-Architektur und 3D RoPE. Der Audiozweig entfällt jedoch, und statt des bisherigen VAE kommt ein bildspezifischer VAE mit CNN-Encoder und 2D-ViT-Decoder zum Einsatz. Dazu kommen eigene Daten sowie ein separates Post-Training mit Reinforcement Learning, Destillation und weiteren Schritten.
Q2: Warum haben MiniMax H3 und H3-Image fast die gleiche Parameterzahl?
Weil beide Modelle denselben Transformer-Kern verwenden: H3 hat rund 33B Parameter, das DiT von H3-Image kommt auf 33,1B. Die ähnliche Größe zeigt, dass das Backbone als Ganzes erhalten geblieben ist. Die Unterschiede liegen vor allem in den Encoder- und Decoder-Komponenten sowie in den Trainingszielen.
Q3: Wie viele Referenzbilder unterstützt H3-Image tatsächlich?
Laut offizieller Model Card sind es maximal 16 Bilder, im vLLM-Deployment-Rezept stehen maximal 9. Die erste Angabe stammt vom Hersteller, die zweite ist eine Testkonfiguration für ein bestimmtes Framework. In der Praxis zählt das, was Ihr gewähltes Inferenz-Framework zulässt.
Q4: Leidet die Bildqualität unter 6-Schritt-Sampling und dem Verzicht auf CFG?
Laut Hersteller bleibt die Qualität nach der Destillation hoch. Öffentlich verfügbar sind bislang aber vor allem die Demos des Herstellers selbst. Wir empfehlen, in Ihrem eigenen Anwendungsfall Vergleichstests durchzuführen und dabei besonders auf die Befolgung komplexer Anweisungen und auf Kombinationen mehrerer Referenzbilder zu achten.
Q5: Wie kann ich meinen Workflow zur Bilderzeugung testen, wenn ich keine GPU der H200-Klasse habe?
Sie können den Workflow zunächst über eine Cloud-API zum Laufen bringen:
1. Registrieren Sie sich bei APIYI (apiyi.com) und holen Sie sich einen API-Schlüssel samt kostenlosem Testkontingent
2. Bauen Sie die Vorverarbeitung mit dem Code zur Verbesserung der Eingabeaufforderung aus diesem Artikel auf (base_url ist `https://api.apiyi.com/v1`)
3. Binden Sie ein gängiges Bildmodell der Plattform an, prüfen Sie die gesamte Kette und entscheiden Sie erst danach, ob sich ein Self-Hosting lohnt
Q6: Darf ich H3-Image selbst betreiben und als API-Dienst nach außen anbieten?
Hier ist besondere Vorsicht geboten. Laut der Lizenz von H3-Image brauchen Sie für jedes gehostete Angebot an Dritte vorab eine schriftliche Genehmigung von MiniMax, unabhängig von der Umsatzgröße. Maßgeblich ist der Originaltext der Lizenz; ziehen Sie im Zweifel rechtlichen Rat hinzu.
MiniMax H3 Architektur-Evolution: Die wichtigsten Erkenntnisse (Key Takeaways)
- Gleiche Basis, anderer Einsatz: H3-Image verwendet den Kern-Transformer und den Text-Encoder von H3 wieder. Es handelt sich nicht einfach um einen umgeschalteten Ausgabemodus.
- Drei zentrale Umbauten: Der Audiozweig wird entfernt, ein bildspezifischer VAE kommt zum Einsatz, und das Generierungsziel wechselt zur Vorhersage von Bild-Latents.
- Das semantische Verständnis stammt von Qwen3-VL: Es nutzt die Hidden States der 50. Schicht und versteht dabei Text und Referenzbilder gleichzeitig.
- Die Geschwindigkeit kommt aus der Destillation: 6 Sampling-Schritte ohne CFG bilden die technische Grundlage für die offizielle Aussage „4K in 10 Sekunden“.
- Lizenzen getrennt betrachten: Sowohl der gehostete Dienst von H3-Image als auch die Umsatzschwelle von 1 Million US-Dollar lösen Lizenzpflichten aus.
- Erst validieren, dann deployen: Über APIYI (apiyi.com) lässt sich zunächst ein Prototyp mit mehreren Modellen aufbauen, bevor Sie die Kosten für ein Self-Hosting abschätzen.
Fazit
Die Entwicklung von MiniMax H3 vom Video- zum Bildmodell lässt sich im Kern auf drei Punkte zusammenfassen:
- Gemeinsame Basis: Der einstufige multimodale Transformer der 33B-Klasse (Single-Stream), der Qwen3-VL-Text-Encoder und die 3D-RoPE bleiben vollständig erhalten.
- Spezialisierung auf die Aufgabe: Der Audiozweig fliegt raus, dafür kommt ein Bild-VAE aus CNN + 2D-ViT hinzu. Das Generierungsziel wechselt von Video- und Audio-Latents zu Bild-Latents.
- Training und Inferenz neu aufgesetzt: Daten, Reinforcement Learning, 6-Schritt-Destillation ohne CFG, Erweiterung der Eingabeaufforderung (Prompt Enhancement) und Deployment-Optimierung tragen gemeinsam die Ausgabe im 16-MP-Bereich.
Für Entwickler ist vor allem spannend, welche Fähigkeiten sich teilen lassen und welche gezielt trainiert werden müssen – dazu kommen die Hardwarekosten hinter den Gewichten und die Lizenzpflichten. Bevor Sie sich für Self-Hosting entscheiden, empfehlen wir, über APIYI (apiyi.com) mit einer einheitlichen Schnittstelle mehrere Modelle zu vergleichen und Ihren Bild-Workflow schnell zum Laufen zu bringen.
📚 Referenzen
- Offizielle technische Vorstellung von MiniMax H3: Beschreibung der H3-Omni-Transformer-Architektur
- Link:
minimax.io/blog/minimax-h3 -
Hinweis: Offizielle Beschreibung des multimodalen Kodierungspfads und von 3D Multimodal RoPE
-
Offizieller Release-Blog zu MiniMax H3-Image: Post-Training und Inferenzoptimierung
- Link:
minimax.io/blog/minimax-h3-image -
Hinweis: Verbesserungen bei Daten, Reinforcement Learning, 6-Schritt-Destillation, Erweiterung der Eingabeaufforderung u. a.
-
H3-Image-Modellkarte auf Hugging Face: Vollständige Architekturparameter
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
Hinweis: Konkrete Spezifikationen von DiT, VAE und Textencoder
-
Ursprüngliche H3-Modellkarte und Lizenz: Spezifikationen des Videomodells und Lizenzbedingungen
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3 -
Hinweis: H3-Spezifikationen sowie der Originaltext der Lizenz unter
blob/main/LICENSE -
Originaltext der H3-Image-Lizenz: Bedingungen für die kommerzielle Nutzung
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
Hinweis: Regelungen zu gehosteten Diensten, Umsatzschwellen und weiteren Punkten
-
vLLM-Deployment-Rezept: Testkonfiguration des Frameworks
- Link:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - Hinweis: Angaben auf Framework-Seite, etwa zur Anzahl der Referenzbilder
Autor: APIYI-Technikteam
Fachaustausch: Schreiben Sie uns gern über die Startseite von APIYI (apiyi.com). Weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com