Nota del autor: H3-Image reutiliza la arquitectura multimodal base de H3, le suma componentes específicos para imagen y rehace el entrenamiento y el flujo de inferencia, hasta convertirse en un modelo de generación de imágenes independiente. Este artículo desglosa qué heredó, qué eliminó y qué añadió.
6 términos que conviene conocer antes de entender la arquitectura de MiniMax H3
Los siguientes conceptos aparecerán varias veces más adelante, así que los explicamos primero en una frase.
| Término | Explicación sencilla | Papel en MiniMax H3 |
|---|---|---|
| Transformer | Red neuronal que procesa datos secuenciales y es muy buena capturando las relaciones entre los elementos de una secuencia | H3-Omni-Transformer es el núcleo de toda la familia de modelos |
| DiT | Modelo de difusión implementado con un Transformer, que genera contenido eliminando ruido paso a paso | El cuerpo de H3-Image es un DiT de flujo único con 33.1B de parámetros |
| VAE | Modelo que codifica y decodifica entre píxeles y una representación comprimida; es como un «compresor + descompresor» | H3 usa un VAE visual y un VAE de audio; H3-Image lo cambia por un VAE específico para imagen |
| Variable latente | Representación compacta de los datos originales una vez comprimidos; calcular en este espacio es mucho más barato que trabajar directamente con píxeles | Lo que predice el Transformer son las variables latentes, no los píxeles |
| RoPE | Codificación de posición rotatoria, que le indica al modelo en qué posición de la secuencia está cada token | H3 usa 3D Multimodal RoPE para expresar la posición en tiempo y espacio |
| Destilación | Entrenar un proceso complejo que normalmente requiere muchos pasos para que se complete en solo unos pocos | H3-Image se destiló para necesitar solo 6 pasos de muestreo |
En noviembre de 2026, MiniMax liberó los pesos de H3-Image, su modelo de generación de imágenes. H3, que se publicó como código abierto hace tres meses, es un modelo capaz de generar vídeo con audio estéreo; el nuevo modelo tiene una escala de parámetros similar, en torno a los 33B, y su arquitectura central también proviene de H3.
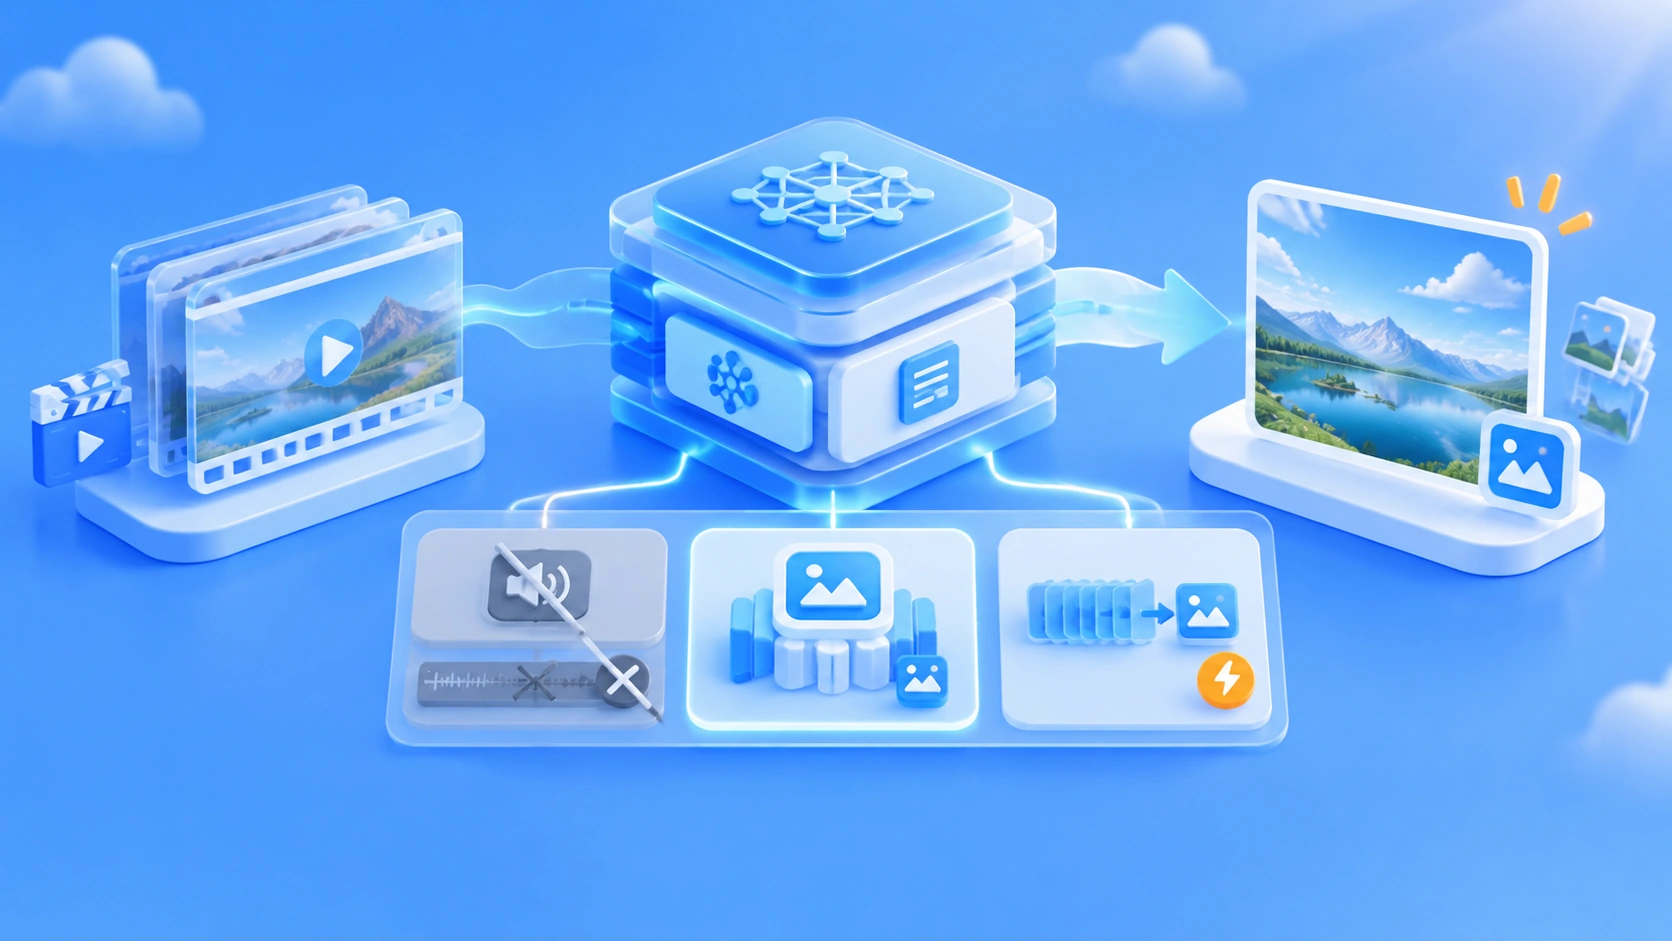
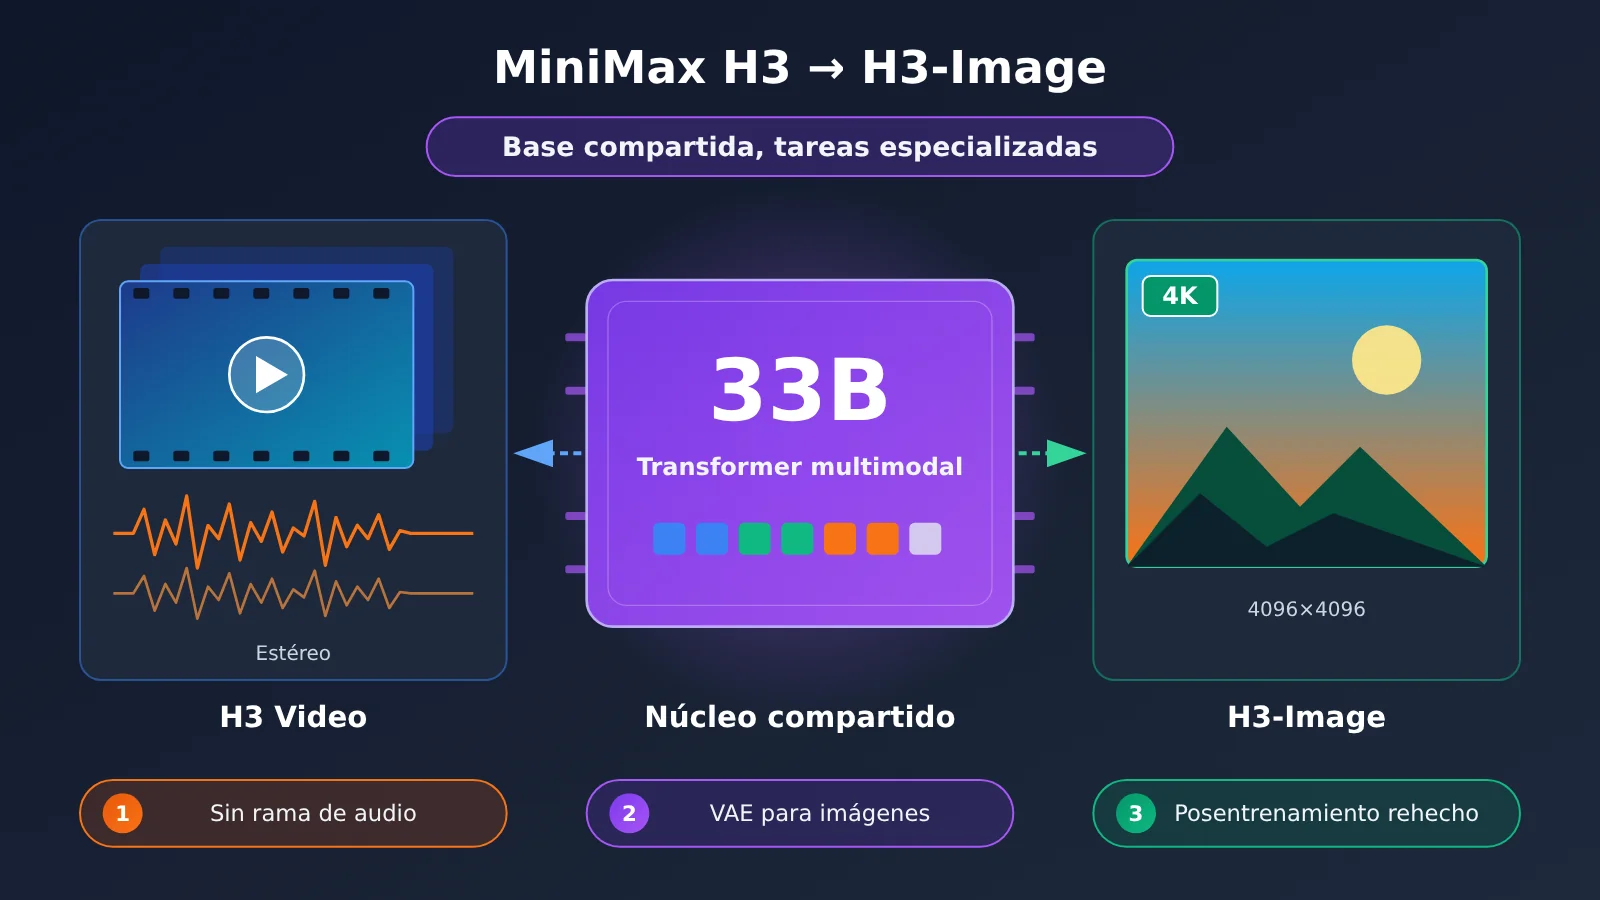
No se trata simplemente de «cambiar la salida del modelo de vídeo para que devuelva un solo fotograma». La ficha del modelo y el blog de lanzamiento oficiales de H3-Image explican que conserva el Transformer multimodal central y el codificador de texto de H3, elimina la rama de generación de audio, incorpora un VAE específico para imagen y rehace el posentrenamiento y el flujo de inferencia para las tareas de imagen.
Lo que te llevas: al terminar de leer sabrás qué partes cambiaron exactamente cuando la misma arquitectura de 33B pasó del vídeo a la imagen, por qué se cambió cada una, y qué es un hecho confirmado oficialmente y qué es solo una inferencia del sector.
MiniMax H3: del vídeo a la imagen, qué ha lanzado MiniMax
Primero conviene aclarar la línea temporal. Mucha gente que ve la noticia de que «MiniMax H3 es de código abierto» mezcla dos lanzamientos distintos, pero H3 y H3-Image son cosas diferentes y los separan unos tres meses.
| Fecha | Evento | Descripción |
|---|---|---|
| 2026-07-31 | MiniMax presenta el modelo H3 | El blog técnico oficial muestra por primera vez la arquitectura de H3 |
| 2026-08-03 | MiniMax H3 abre sus pesos oficialmente | Modelo de generación de vídeo omnimodal; lo que se publica es H3-Base |
| 2026-11-10 | Fecha que figura en la H3-Image Community License | Se abren los pesos del modelo de generación de imágenes |
| 2026-11-11 | El blog oficial en inglés de MiniMax publica la presentación de H3-Image | Se dan a conocer los detalles del posentrenamiento y de la optimización de la inferencia |
Qué hace cada uno: MiniMax H3 frente a H3-Image
Las tareas de ambos modelos no tienen nada que ver. H3 es un sistema de generación de vídeo omnimodal que entiende a la vez texto, imágenes, vídeo y audio como entrada, y produce vídeos de 4 a 15 segundos a 24 FPS, con sonido estéreo nativo a 32 kHz. Por defecto genera con el lado corto a 768 px, y el flujo de trabajo completo llega hasta 2K. H3-Image, por su parte, se centra en la generación y edición de imágenes de alta resolución: la especificación oficial indica un máximo de unos 16 MP (por ejemplo, 4096×4096) y asegura que puede generar imágenes 4K en menos de 10 segundos.
Esto nos lleva a la pregunta central del artículo: uno hace «vídeo con sonido» y el otro «imágenes estáticas en alta resolución». ¿Por qué pertenecen a la misma familia tecnológica? La respuesta está en el diseño de base de H3.
La arquitectura base de MiniMax H3: un Transformer multimodal unificado
El núcleo de H3 se llama H3-Omni-Transformer. Según la presentación técnica oficial, es un Transformer de flujo único y denso de unos 33B de parámetros. «Flujo único» significa que la información de las distintas modalidades no pasa por redes independientes, sino que se junta en una misma secuencia que procesa un único conjunto de parámetros. «Denso» quiere decir que cada token pasa por todos los parámetros, en lugar de activar solo una parte de los expertos, como ocurre en una MoE.
Cómo codifica MiniMax H3 cada modalidad
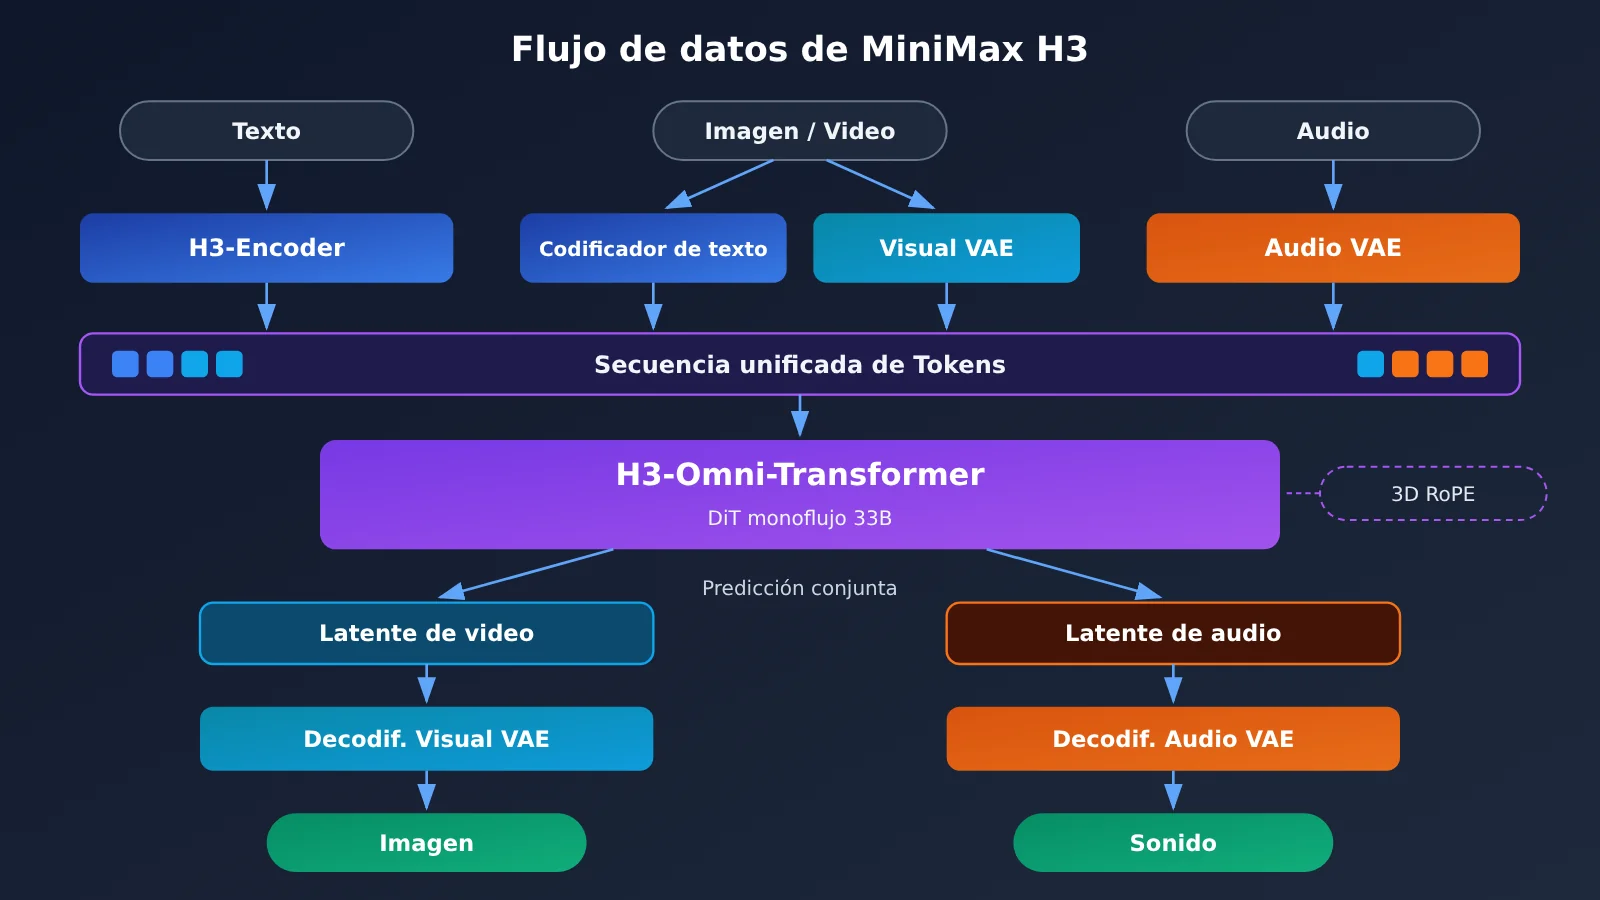
La ruta de procesamiento que se ha hecho pública es, a grandes rasgos, esta:
- Texto: se codifica con H3-Encoder en una representación semántica que le indica al modelo «qué quieres que ocurra en la escena».
- Imagen y vídeo: pasan a la vez por el codificador de texto y por el Visual VAE. El primero se encarga de entender la semántica del contenido visual; el segundo comprime los píxeles en variables latentes.
- Audio: se comprime en variables latentes de audio mediante el Audio VAE.
- Secuencia unificada: las representaciones de todas las modalidades anteriores se combinan en una sola secuencia que entra al Transformer.
- Predicción conjunta: el Transformer predice a la vez las variables latentes de vídeo y de audio, y cada una se entrega a su VAE correspondiente para decodificarse en imagen y sonido.
Se puede entender como que «todos hablan el mismo idioma». Da igual que la entrada original sea una frase, una imagen o un fragmento de música: antes de entrar al Transformer se traduce a una secuencia de tokens. Al modelo no le importa de qué modalidad viene cada token; solo se ocupa de encontrar las relaciones entre ellos y de generar los tokens objetivo.
Para qué sirve el 3D Multimodal RoPE
El vídeo tiene un eje temporal y además dos dimensiones espaciales, así que H3 usa 3D Multimodal RoPE para codificar la posición: un token no solo debe saber sus coordenadas horizontal y vertical dentro de la imagen, sino también a qué fotograma pertenece. La documentación oficial confirma explícitamente este diseño. Es clave para entender después H3-Image, porque una imagen puede verse como un caso particular en el que «la dimensión temporal tiene un solo fotograma».
【Nuestra inferencia】 Precisamente porque H3 está diseñado desde el principio como «secuencia unificada + Transformer unificado», y no como una tubería de una sola tarea del tipo «entra texto, sale vídeo», su red troncal tiene la base necesaria para trasladarse a otras tareas de generación. La documentación oficial no lo plantea así de forma directa; es una conclusión que sacamos nosotros a partir del diseño de la arquitectura.
Qué heredó MiniMax H3-Image, y qué eliminó y añadió
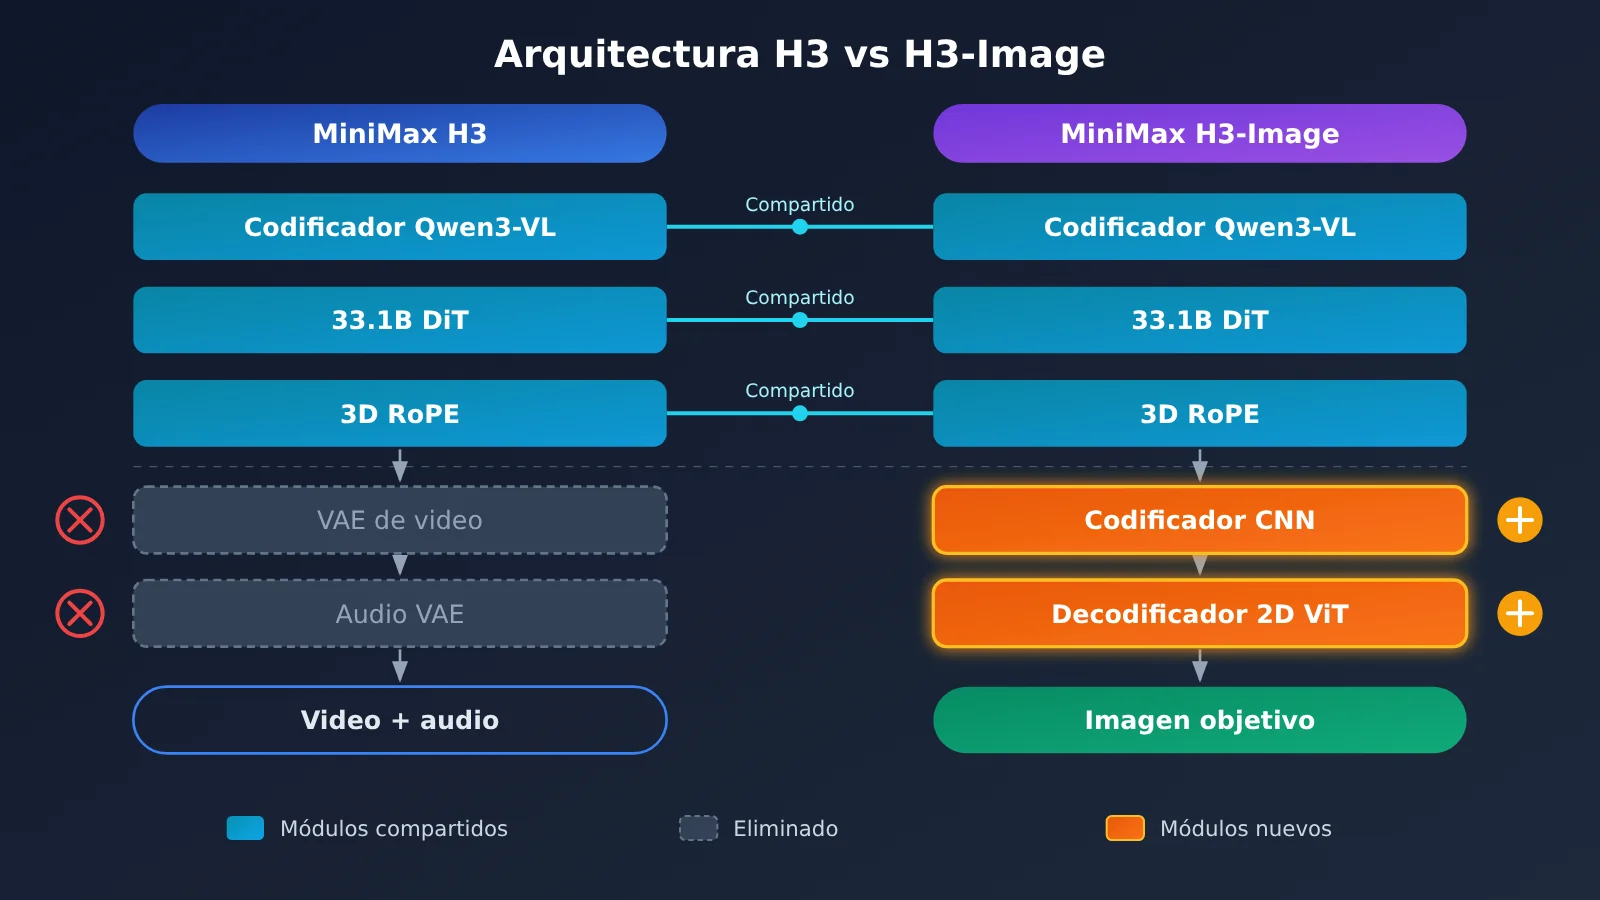
Esta es la parte más interesante de toda la evolución técnica. La siguiente tabla está elaborada a partir de la model card oficial de H3-Image:
| Categoría | Componente | Cómo se hizo |
|---|---|---|
| Heredado | Codificador de texto Qwen3-VL | Se reutiliza el codificador de texto completo de H3 y se toman los estados ocultos de la capa 50 |
| Heredado | DiT de flujo único de 33.1B | Se conserva la arquitectura central H3-Omni-Transformer |
| Heredado | 3D Multimodal RoPE | Se sigue usando para codificar las relaciones de posición |
| Eliminado | Rama de audio | Ya no se hace generación conjunta de vídeo y audio |
| Reemplazado | VAE específico para imágenes | Codificador CNN + decodificador ViT 2D de 24 capas |
| Modificado | Objetivo de generación | El texto y las imágenes de referencia se codifican en una secuencia unificada, y se predice el latente de la imagen objetivo |
Herencia 1: el codificador de texto Qwen3-VL y los estados ocultos de la capa 50
La model card de H3-Image indica que reutiliza el codificador de texto de H3 basado en Qwen3-VL y usa los estados ocultos de su capa 50 como entrada de condicionamiento. Qwen3-VL es en sí mismo un modelo de visión y lenguaje, así que no solo entiende el texto, sino también el contenido de las imágenes de referencia, justo la capacidad que necesita la edición con múltiples imágenes de referencia.
【Práctica habitual en el sector】 Sobre por qué se toma una capa intermedia en lugar de la última, la documentación oficial no da explicaciones. En el sector se suele considerar que las últimas capas de un modelo de lenguaje están más orientadas a «predecir la siguiente palabra», mientras que las capas intermedias conservan características semánticas más ricas y generales. Muchos modelos de difusión adoptan un enfoque similar.
Herencia 2: DiT de 33.1B y RoPE 3D
Las especificaciones del cuerpo principal DiT de H3-Image son las siguientes:
| Parámetro | Valor | Cómo entenderlo |
|---|---|---|
| Número de parámetros | 33.1B | Del mismo orden que el backbone de unos 33B de H3 |
| Número de capas | 50 capas | La información pasa por 50 transformaciones |
| Hidden Size | 5376 | Dimensión de la representación de cada token |
| Attention Heads | 56 | Atiende a las relaciones entre tokens desde 56 perspectivas a la vez |
| FFN Size | 14336 | Ancho intermedio de la red feed-forward de cada capa |
| Submuestreo espacial del VAE | 16 veces | Un lado de 4096 píxeles se comprime a 256 |
| Canales latentes | 24 | Cada posición latente lleva 24 valores |
| Cobertura por token | Aprox. 32×32 píxeles | Determina la longitud de la secuencia y el coste de cómputo |
Si tomamos como referencia que cada token corresponde a unos 32×32 píxeles, una imagen de 4096×4096 equivale a unos 128×128 = 16384 tokens (es una estimación nuestra a partir de los parámetros oficiales). Si además se añaden varias imágenes de referencia, la secuencia se alarga todavía más, y eso explica por qué optimizar la velocidad de inferencia es tan importante para este modelo.
【Nuestra inferencia】 El RoPE 3D sigue siendo útil en tareas de imagen. La imagen objetivo tiene un solo fotograma, pero cuando hay varias imágenes de referencia junto con la imagen objetivo, hay que distinguir dentro de la secuencia «quién es quién», y la dimensión adicional puede encargarse de esa distinción. La documentación oficial no detalla cómo se asignan las posiciones, así que esto es solo una interpretación razonable.
Eliminar: la rama de audio
Una imagen no tiene duración ni sonido, así que mantener la rama de audio solo gasta recursos de entrenamiento e inferencia. Al quitarla, el objetivo de aprendizaje del modelo pasa de la «distribución conjunta de vídeo + audio» a la «distribución de imágenes», y la señal de entrenamiento queda más concentrada.
Reemplazar: un VAE específico para imágenes
El Visual VAE de H3 tenía que encargarse también de la continuidad temporal del vídeo, mientras que H3-Image usa un VAE diseñado específicamente para imágenes estáticas. El codificador es una CNN, buena para extraer de forma eficiente las texturas locales; el decodificador es un ViT 2D de 24 capas, que puede tener en cuenta la estructura global al reconstruir los píxeles. Un submuestreo de 16x combinado con 24 canales significa que la información se guarda en menos posiciones espaciales pero con más canales, algo clave para generar salidas de alta resolución de nivel 16MP. Además, los responsables del modelo insisten en que los resultados en alta resolución de H3-Image se generan directamente, sin depender de un escalador de superresolución tradicional.
Cambio: de «predecir vídeo + audio» a «predecir la imagen objetivo»
El flujo de generación final es este: la indicación de texto y las imágenes de referencia se codifican juntas en una secuencia unificada, el DiT va eliminando el ruido paso a paso en el espacio latente para predecir el latente de la imagen objetivo, y después el VAE de imagen lo decodifica en la imagen final. En cuanto al número de imágenes de referencia, la ficha del modelo indica un máximo de 16, mientras que la receta de despliegue con vLLM habla de un máximo de 9. Cada fuente usa un criterio distinto, así que el número realmente utilizable depende del framework de inferencia que uses.
Qué optimizaciones hizo MiniMax en H3-Image para que sea más rápido y más útil
Cambiar solo la arquitectura no basta. En el blog de lanzamiento de H3-Image, MiniMax cuenta que, partiendo de las capacidades de preentrenamiento de H3, mejoró el proceso de posentrenamiento en cinco frentes: datos de entrenamiento, aprendizaje por refuerzo, compresión del número de pasos de muestreo, mejora de indicaciones (Prompt Enhancement) y optimización del despliegue. La compañía no ha publicado los detalles sobre los datos ni sobre el aprendizaje por refuerzo, así que a continuación nos centramos en las partes sobre las que hay más información pública.
Destilación a 6 pasos de muestreo y eliminación de CFG
Generar una imagen con un modelo de difusión consiste en «partir del ruido y eliminarlo paso a paso», y lo habitual es que haga falta decenas de pasos. Además, los modelos de difusión tradicionales suelen usar CFG (Classifier-Free Guidance): en cada paso hay que ejecutar dos veces el modelo, una con indicación y otra sin ella, y luego mezclar los resultados en cierta proporción para que la imagen siga mejor la indicación.
H3-Image comprime el muestreo a 6 pasos mediante destilación y, además, ya no necesita CFG. Lo primero reduce muchísimo el número de pasos; lo segundo hace que cada paso requiera una sola pasada hacia adelante. En un modelo de 33.1B parámetros y con decenas de miles de tokens por imagen, la combinación de ambos factores es la base técnica de la afirmación oficial de «4K en 10 segundos». Ojo: esos 10 segundos son una cifra declarada por el fabricante; la velocidad real depende del hardware y de la configuración del despliegue.
Mejora de indicaciones: convertir una descripción breve en instrucciones ejecutables
H3-Image ofrece un modelo PE (Prompt Enhancement) opcional, con unos 17.9GB de pesos, que sirve para ampliar la descripción breve del usuario y convertirla en una indicación más detallada y más fácil de entender para el modelo. Si por ahora no quieres desplegar este modelo adicional, también puedes aplicar una idea de preprocesamiento similar con un Modelo de Lenguaje Grande de propósito general. Aquí tienes un ejemplo mínimo:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Usa la interfaz unificada de APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把这句扩写成详细的图像生成提示词:雨夜的赛博朋克街头"}]
)
print(resp.choices[0].message.content)
Ver la implementación completa de la mejora de indicaciones
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是图像生成提示词工程师。请把用户的简短描述扩写为结构化提示词,"
    "依次包含:主体、构图、光线、材质细节、色彩、镜头与画幅。"
    "如果用户提供了参考图说明,请明确每张参考图在画面中的作用。"
    "只输出提示词正文,不要解释。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"参考图{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# Ejemplo: composición de una sala de estar con una habitación vacía + imágenes de referencia de muebles
print(enhance_prompt(
    "把这些家具摆进空客厅,北欧风,午后自然光",
    ["空房间照片", "灰色布艺沙发", "橡木茶几", "落地灯"],
))
Recomendación: al montar un flujo de trabajo de generación de imágenes, para el paso de preprocesamiento de indicaciones puedes conectar varios Modelos de Lenguaje Grande populares a través de APIYI (apiyi.com), comparar cómo amplía cada uno y después decidir si merece la pena desplegar un modelo PE específico. Los nombres de los modelos dependen de la lista de modelos de la plataforma.
Optimización del despliegue y soporte de alta resolución
Los frameworks de despliegue que recomienda el equipo oficial son SGLang, vLLM-Omni, Diffusers y ComfyUI. Entre el hardware compatible figuran NVIDIA H200, RTX PRO 6000 Blackwell y AMD Instinct MI350X, y además se ofrece una solución de paralelismo multi-GPU. La combinación de la alta tasa de compresión del VAE de imagen, el muestreo de 6 pasos sin CFG y las optimizaciones de inferencia a nivel de framework es lo que permite generar directamente formatos de alta resolución como 16:9 (5472×3072), 9:16 (3072×5472) y 21:9 (6272×2688).
Impacto de la reutilización de la arquitectura de MiniMax H3
Qué significa para los desarrolladores
- Base compartida, pero no intercambiable: H3 y H3-Image comparten el codificador de texto, que la ficha del modelo describe como «codificador de texto H3 compartido» (unos 66,7 GB). Sin embargo, los pesos del DiT y el VAE son independientes en cada modelo, así que no puedes usar los pesos de vídeo de H3 para generar imágenes directamente.
- La barrera de despliegue sigue siendo alta: el modelo principal de imagen pesa unos 68,65 GB y, con el codificador de texto, la descarga completa ronda los 135,35 GB. Y eso es solo el tamaño en almacenamiento, no equivale a la VRAM necesaria.
- Las licencias hay que leerlas por separado: H3 y H3-Image tienen dos Community License distintas, con condiciones de activación bastante diferentes, como verás en la tabla.
| Aspecto | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| Alcance del código abierto | Solo H3-Base; Context-IR y Regenerate-2K requieren llamar a la API oficial | Pesos del modelo de imagen, codificador de texto compartido y modelo PE opcional |
| Resultados disponibles en local | Generación de audio y vídeo a 768p; el flujo completo a 2K depende de la API oficial | Según el equipo oficial, salida directa de hasta unos 16 MP |
| Condición que activa la licencia comercial | Ingresos anuales de productos y servicios comerciales superiores a 20 millones de dólares | Ingresos anualizados tuyos y/o de tus afiliadas superiores a 1 millón de dólares, o prestar servicios alojados a terceros |
| Otras obligaciones | Restricciones regionales, etc.; consulta el texto original de la licencia | Restricciones regionales, uso de las salidas, identificación del producto, etc.; consulta el texto original de la licencia |
Nota sobre la comparación: la tabla anterior se ha elaborado a partir del texto original de ambas licencias y de las fichas oficiales de los modelos. Sirve solo como referencia para la selección técnica y no constituye asesoramiento legal. Si por ahora no cuentas con las condiciones para autodesplegar o con la licencia necesaria, puedes empezar llamando a otros modelos de imagen y multimodales de referencia a través de APIYI (apiyi.com) para montar el prototipo de tu flujo de trabajo.
Qué significa para la industria
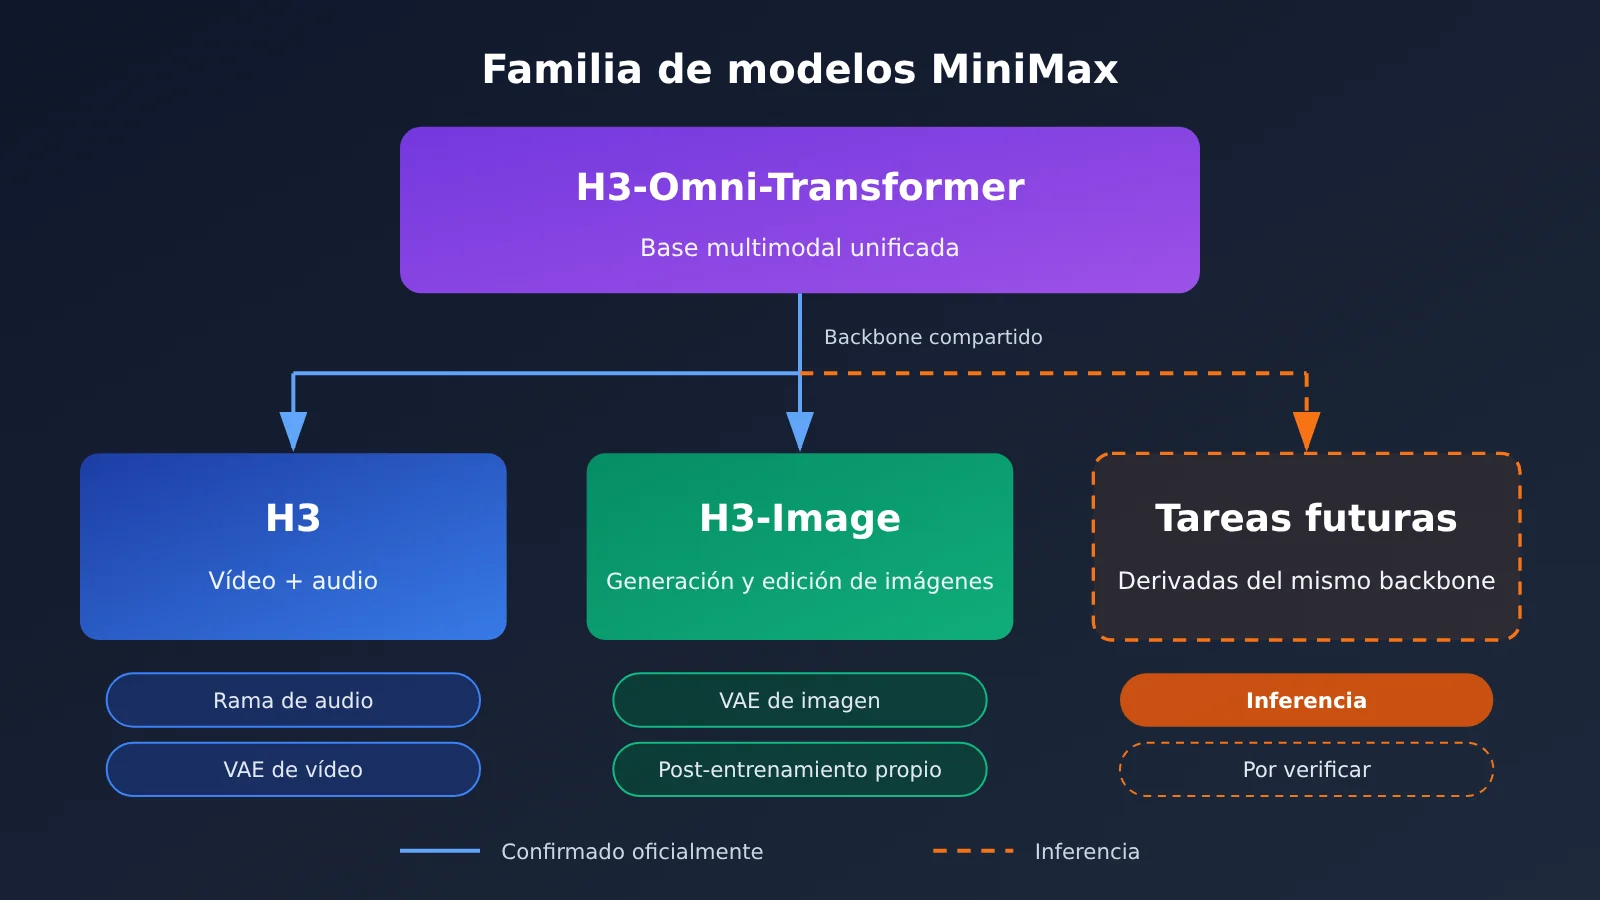
【Confirmado oficialmente】 H3-Image reutiliza el Transformer central y el codificador de texto de H3, pero usa un VAE específico y un proceso de posentrenamiento independiente.
【Nuestra inferencia】 Esto sugiere que la generación de vídeo y la de imágenes pueden compartir buena parte de las capacidades básicas, como la comprensión semántica, la alineación multimodal y el modelado de posiciones espaciales, aunque cada tarea sigue necesitando sus propios componentes de codificación y decodificación y un entrenamiento específico. La estrategia de MiniMax parece ser «construir primero una base multimodal unificada y después especializarla por tarea», en lugar de entrenar un modelo desde cero para cada tipo de generación. Si esta vía funciona, es probable que veamos más modelos derivados de un mismo backbone, pero por ahora esto es solo una conjetura del sector.
Preguntas frecuentes (FAQ)
P1: ¿H3-Image es simplemente el modelo de vídeo H3 con la salida cambiada a imágenes?
No. H3-Image hereda de H3 el codificador de texto Qwen3-VL, la arquitectura DiT de flujo único con 33.1B de parámetros y el 3D RoPE, pero elimina la rama de audio y usa un VAE específico para imágenes, con codificador CNN y decodificador ViT 2D. Además, tiene su propio posentrenamiento: datos, aprendizaje por refuerzo y destilación.
P2: ¿Por qué MiniMax H3 y H3-Image tienen casi el mismo número de parámetros?
Porque el Transformer central de ambos sale de la misma arquitectura: H3 ronda los 33B y el DiT de H3-Image tiene 33.1B. Que los tamaños sean tan parecidos indica que la red principal se conservó completa, y que las diferencias están sobre todo en los componentes de codificación y decodificación y en los objetivos de entrenamiento.
P3: ¿Cuántas imágenes de referencia admite realmente H3-Image?
La ficha oficial del modelo habla de un máximo de 16, mientras que la receta de despliegue con vLLM indica un máximo de 9. La primera cifra es lo que declara el fabricante; la segunda es la configuración probada en un framework concreto. En la práctica, guíate por el framework de inferencia que uses.
P4: ¿El muestreo en 6 pasos y la eliminación de CFG afectan a la calidad de imagen?
Según el fabricante, tras la destilación se mantiene una salida de alta calidad, pero por ahora lo que se ha publicado son sobre todo sus propias demostraciones. Te recomiendo hacer pruebas comparativas en tus escenarios reales y fijarte especialmente en el seguimiento de instrucciones complejas y en las combinaciones con varias imágenes de referencia.
P5: Si no tengo una GPU de nivel H200, ¿cómo puedo validar primero el flujo de generación de imágenes?
Puedes empezar por poner a punto el flujo con una API en la nube:
1. Regístrate en APIYI (apiyi.com) y obtén tu clave API junto con crédito gratuito para pruebas.
2. Usa el código de mejora de indicaciones de este artículo (con `base_url` igual a `https://api.apiyi.com/v1`) para montar la fase de preprocesamiento.
3. Conecta los modelos de imagen principales que ya están disponibles en la plataforma, valida todo el recorrido y, después, decide si merece la pena autoalojarlo.
P6: ¿Puedo desplegar H3-Image y ofrecer un servicio de API a terceros?
Hay que ser muy cuidadoso. Según la licencia de H3-Image, ofrecer un servicio alojado a cualquier tercero requiere autorización previa por escrito de MiniMax, sin importar el nivel de ingresos. Para los términos exactos, consulta el texto original de la licencia y, si hace falta, pide asesoría legal.
Puntos clave de la evolución de la arquitectura MiniMax H3 (Key Takeaways)
- Misma base, distinto uso: H3-Image reutiliza el Transformer central y el codificador de texto de H3; no se trata de simplemente cambiar el modo de salida.
- Tres modificaciones clave: se elimina la rama de audio, se cambia a un VAE específico para imágenes y el objetivo de generación pasa a ser la predicción de variables latentes de imagen.
- La comprensión semántica viene de Qwen3-VL: se toma el estado oculto de la capa 50, que entiende a la vez el texto y las imágenes de referencia.
- La velocidad viene de la destilación: muestreo en 6 pasos y sin CFG, que es la base técnica de la afirmación oficial de «4K en 10 segundos».
- Las licencias se miran por separado: tanto el servicio alojado de H3-Image como el umbral de ingresos de 1 millón de dólares activan requisitos de licencia.
- Primero valida, luego despliega: puedes montar un prototipo con varios modelos a través de APIYI (apiyi.com) y después evaluar el costo de un autoalojamiento.
Resumen
La evolución de MiniMax H3 de vídeo a imagen se puede resumir en tres puntos:
- Base compartida: se conservan íntegros el Transformer multimodal de flujo único de nivel 33B, el codificador de texto Qwen3-VL y el 3D RoPE.
- Especialización de la tarea: se elimina la rama de audio, se incorpora un VAE de imagen con CNN + 2D ViT y el objetivo de generación pasa de variables latentes de vídeo + audio a variables latentes de imagen.
- Entrenamiento e inferencia rehechos: los datos, el aprendizaje por refuerzo, la destilación en 6 pasos sin CFG, la mejora de indicaciones y la optimización del despliegue sostienen juntos una salida de nivel 16MP.
Para los desarrolladores, lo realmente interesante de estudiar es qué capacidades se pueden compartir y cuáles hay que entrenar de forma específica, además del costo de hardware y las obligaciones de licencia que hay detrás de los pesos. Antes de decidir si autoalojar, te recomendamos comparar varios modelos con una interfaz unificada a través de APIYI (apiyi.com) y poner a funcionar rápidamente tu flujo de trabajo de imágenes.
📚 Referencias
- Introducción técnica oficial de MiniMax H3: descripción de la arquitectura H3-Omni-Transformer
- Enlace:
minimax.io/blog/minimax-h3 -
Descripción: explicación oficial de la ruta de codificación multimodal y del 3D Multimodal RoPE
-
Blog oficial del lanzamiento de MiniMax H3-Image: posentrenamiento y optimización de la inferencia
- Enlace:
minimax.io/blog/minimax-h3-image -
Descripción: mejoras en datos, aprendizaje por refuerzo, destilación a 6 pasos, mejora de indicaciones, etc.
-
Model card de H3-Image en Hugging Face: parámetros completos de la arquitectura
- Enlace:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
Descripción: especificaciones concretas del DiT, el VAE y el codificador de texto
-
Model card original de H3 y licencia: especificaciones del modelo de vídeo y condiciones de uso
- Enlace:
huggingface.co/MiniMaxAI/MiniMax-H3 -
Descripción: especificaciones de H3 y texto íntegro de la licencia en
blob/main/LICENSE -
Texto íntegro de la licencia de H3-Image: condiciones de uso comercial
- Enlace:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
Descripción: cláusulas sobre servicios alojados, umbrales de ingresos, etc.
-
Receta de despliegue con vLLM: configuración de pruebas del framework
- Enlace:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - Descripción: criterios del lado del framework, como el número de imágenes de referencia
Autor: equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página principal de APIYI apiyi.com; encontrarás más recursos en el centro de documentación docs.apiyi.com