Note de l’auteur : les mêmes modèles chinois open source apparaissent dans un ordre presque inverse dans le classement des dépenses de Menlo Ventures et celui des requêtes d’OpenRouter. Cet article décortique les critères des deux classements et propose une méthode de sélection en 5 étapes, directement applicable.
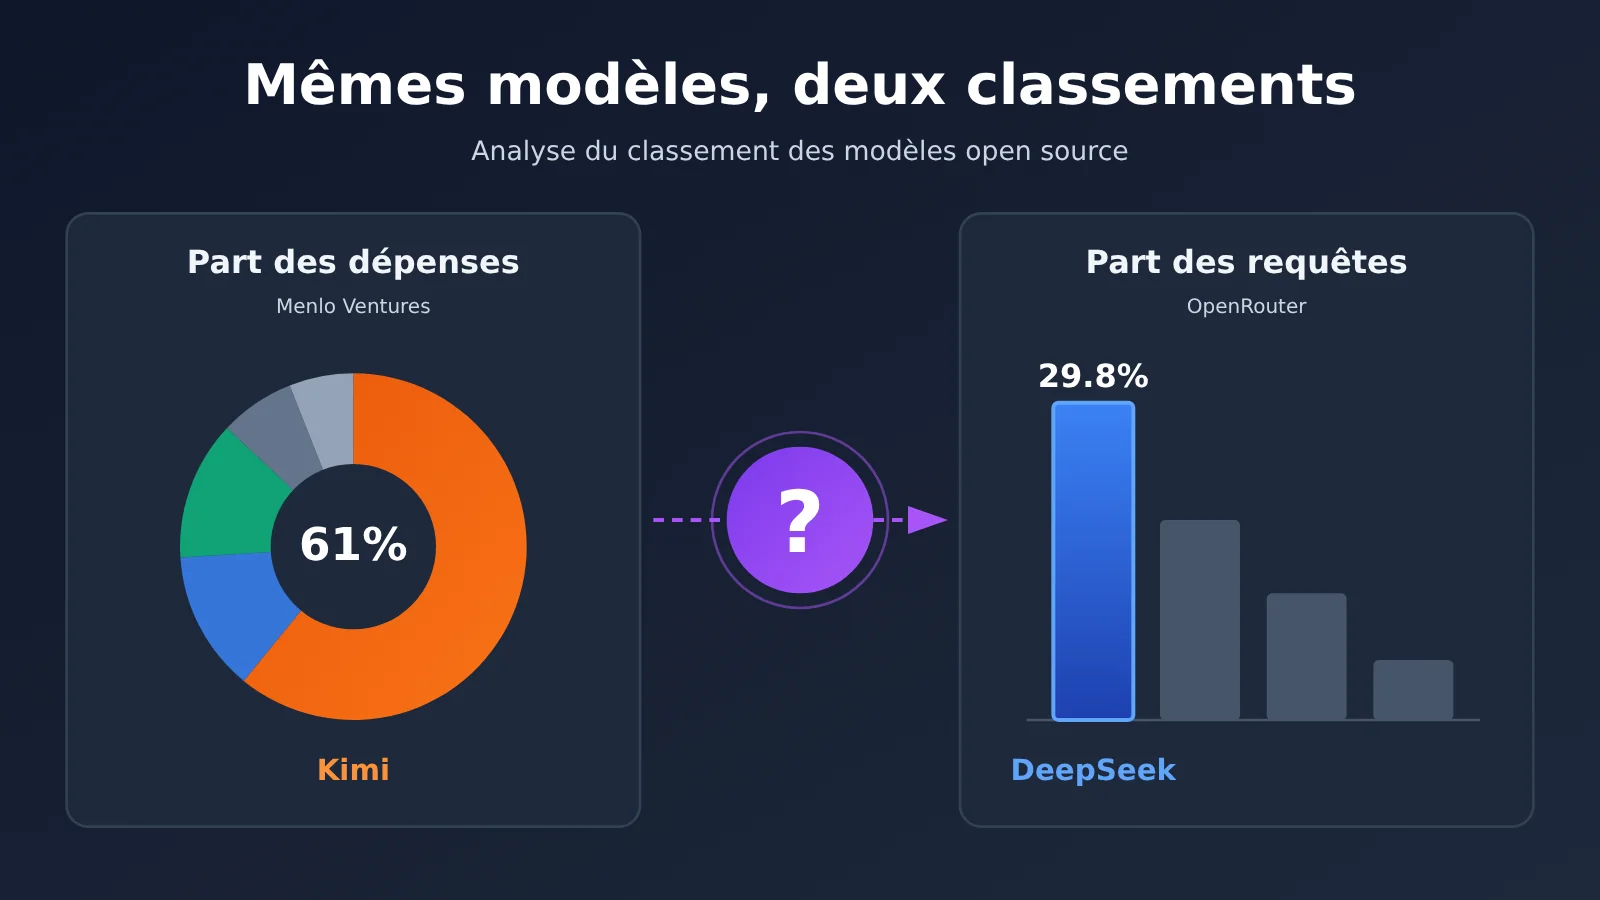
Début novembre, deux séries de données ont été publiées. Selon le rapport de Menlo Ventures, Kimi représente 61% des dépenses des entreprises américaines en modèles open source. Dans le classement hebdomadaire d’OpenRouter, DeepSeek représente 29.8% des requêtes textuelles sur la plateforme. Les deux classements n’ont pas le même numéro un et leur ordre est presque inversé. La première réaction de nombreux responsables techniques : auquel faut-il se fier ?
Les deux classements ne se contredisent pas : ils mesurent deux choses différentes. Le classement des dépenses indique à qui les entreprises versent leur argent ; celui des requêtes montre quels modèles les développeurs utilisent sur une plateforme donnée. Pour choisir un modèle, on ne peut pas simplement reprendre un classement : il faut tenir compte de ses propres tâches et de sa façon de mesurer les coûts. Les classements peuvent réduire la liste des candidats, mais ils ne peuvent pas choisir à votre place.
Cet article ne se contente pas de répéter les classements. Nous examinerons les échantillons, les périodes couvertes et les limites de chaque classement. Nous verrons ensuite comment la baisse des prix unitaires et la hausse de l’utilisation modifient la structure des coûts, avant de proposer une liste de sélection en 5 étapes.
Classements des modèles open source : pourquoi Kimi et DeepSeek arrivent chacun en tête
En bref : Menlo Ventures mesure les dépenses des entreprises, tandis qu’OpenRouter mesure les requêtes sur sa plateforme. Les échantillons, les périodes et les indicateurs sont donc différents.
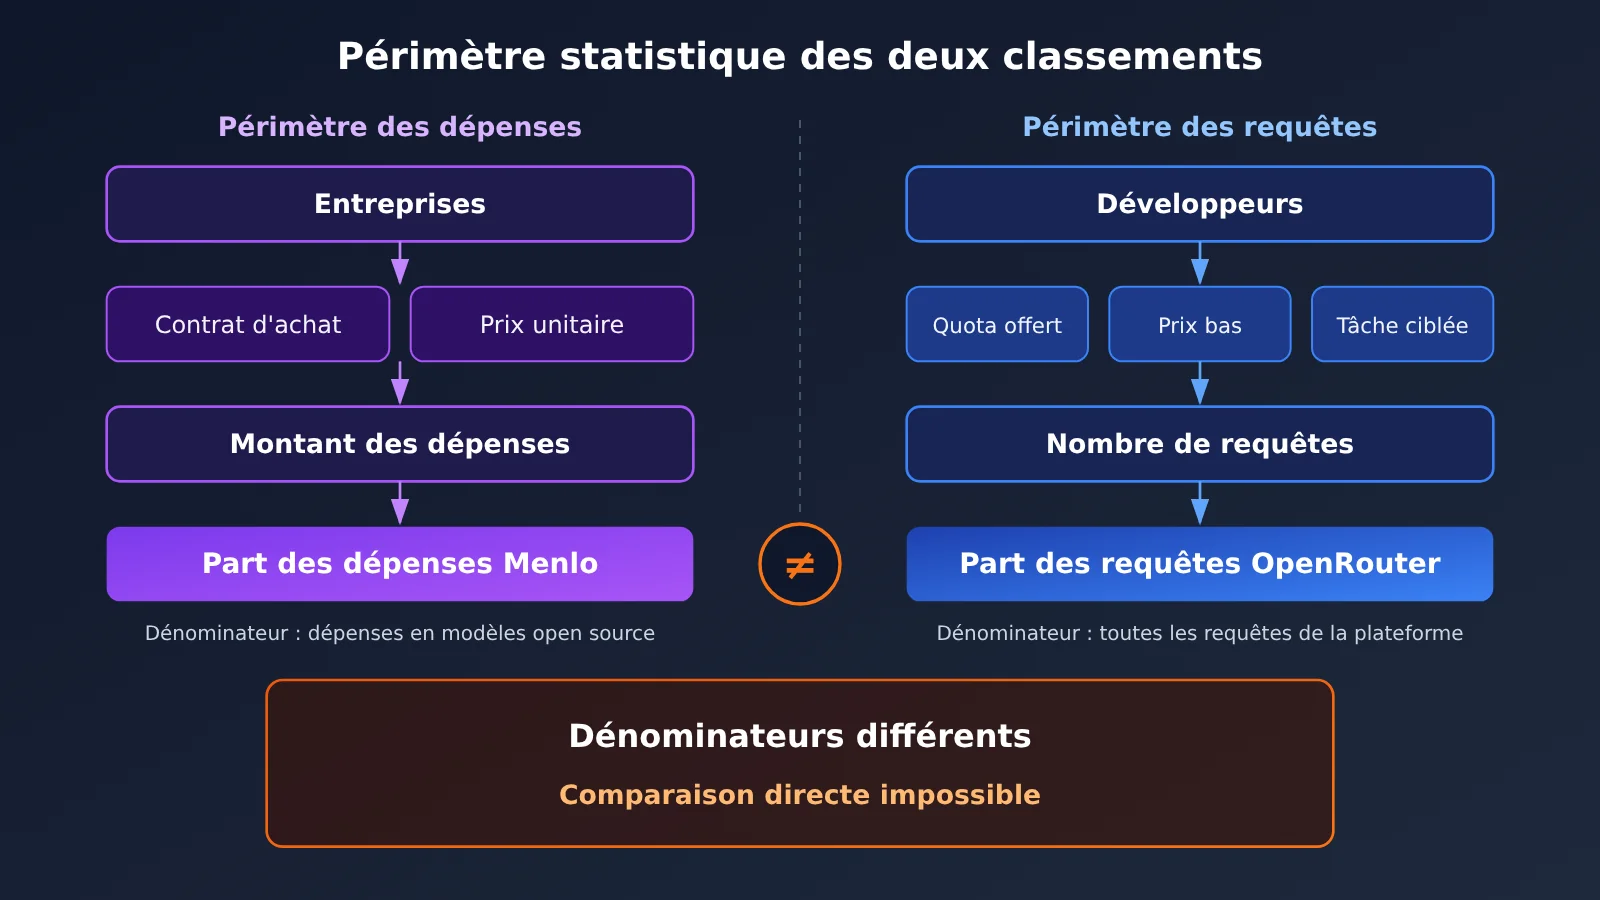
Ces deux séries de données sont souvent comparées, mais leurs « dénominateurs » n’ont rien à voir. Les chiffres de Menlo Ventures viennent d’une enquête auprès de décideurs américains en matière d’IA d’entreprise : ce sont des estimations, pas des factures auditées. Ceux d’OpenRouter proviennent des requêtes enregistrées sur sa propre plateforme. Ils reflètent donc uniquement le comportement de ses utilisateurs, pas celui de l’ensemble du marché.
| Classement | Indicateur mesuré | Échantillon/période | Principaux résultats | Utile pour évaluer |
|---|---|---|---|---|
| Rapport 2026 de Menlo Ventures sur l’état de l’IA en entreprise | Part des dépenses des entreprises américaines consacrées aux modèles open source | Près de 400 décideurs américains en matière d’IA d’entreprise, interrogés du 8 au 26 septembre 2026 ; rapport publié le 3 novembre | Kimi 61 %, DeepSeek 15 %, GLM 11 %, Meta Llama 7 %, Qwen 3 % | Les préférences d’achat des entreprises, la répartition des budgets et les modèles intégrés dans des contrats officiels |
| Classement hebdomadaire d’OpenRouter | Part des requêtes textuelles sur la plateforme | Plateforme OpenRouter, du 26 octobre au 1er novembre | DeepSeek 29,8 %, OpenAI 18,8 %, Z.ai 11,9 %, Qwen 5,6 % (sixième) | L’activité des développeurs, les invocations sensibles au prix et la popularité dans la communauté |
Le tableau montre que les deux classements ne portent même pas sur les mêmes acteurs. Menlo Ventures ne comptabilise que les modèles open source, tandis qu’OpenRouter inclut aussi des fournisseurs de modèles fermés comme OpenAI et Google. Comparer directement ces pourcentages revient donc à mélanger des indicateurs différents.
Comment lire le classement des dépenses de Menlo Ventures : Kimi capte 61 % des dépenses consacrées aux modèles open source
L’essentiel : les données de Menlo Ventures montrent que les modèles open source chinois ont trouvé leur place dans les budgets des entreprises américaines. Mais il s’agit d’estimations issues d’une enquête, pas d’un classement des performances.
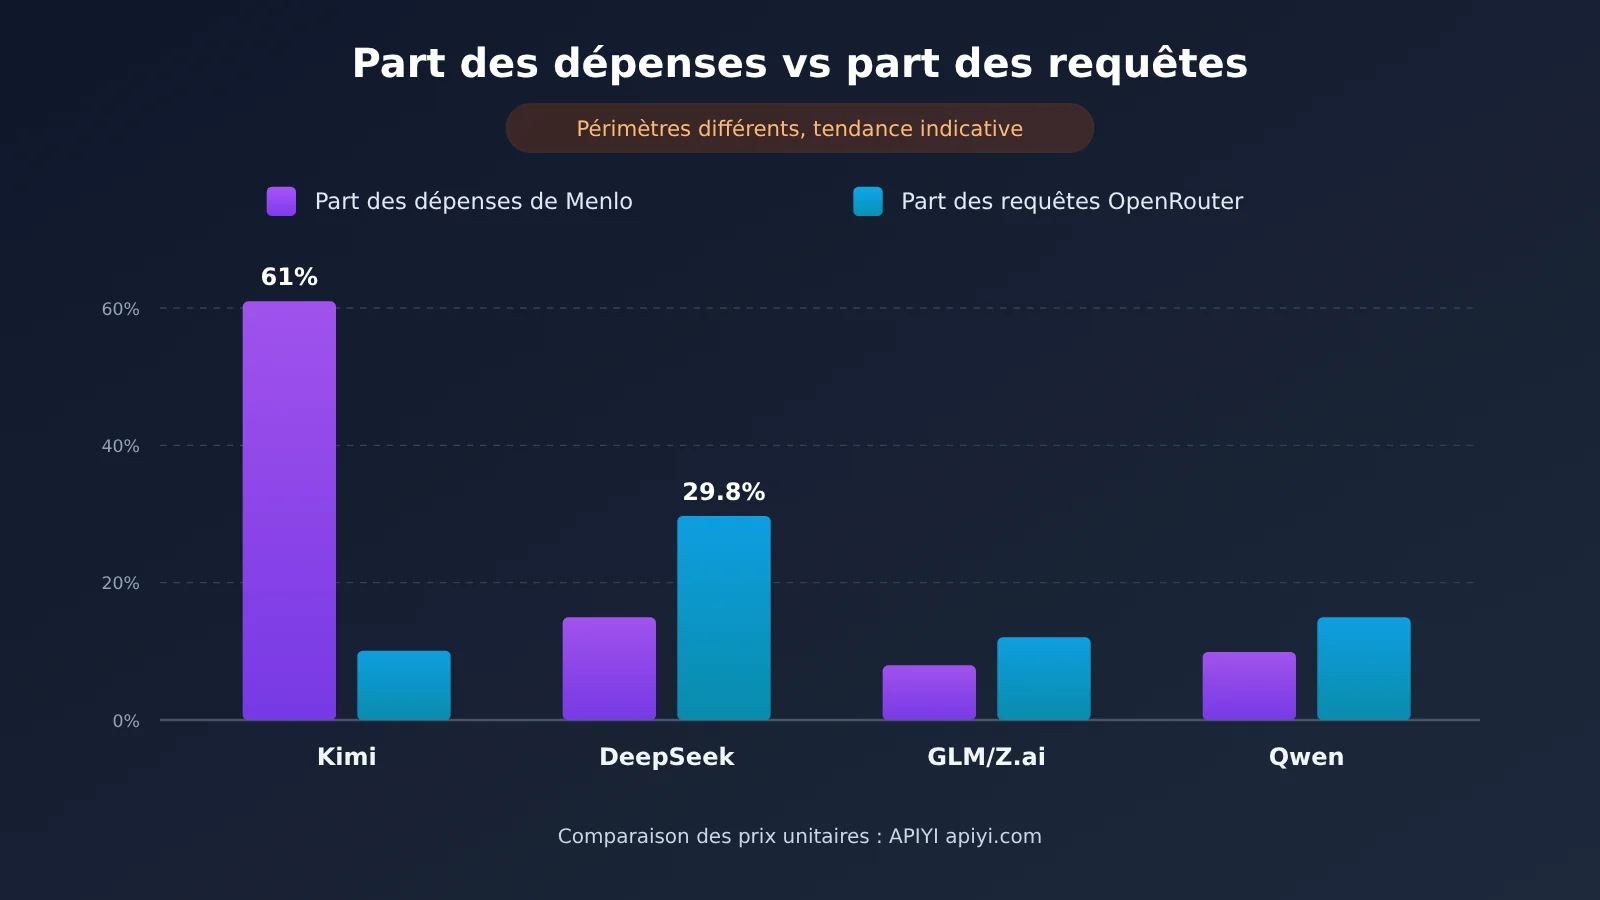
Le chiffre qui a le plus retenu l’attention dans le rapport est le suivant : les modèles chinois représentent 89 % des dépenses des entreprises américaines consacrées aux modèles open source. À lui seul, Kimi en capte 61 %, contre 15 % pour DeepSeek, 11 % pour GLM et 3 % pour Qwen. Parmi les modèles non chinois, Meta Llama représente 7 %.
| Modèle | Part des dépenses des entreprises américaines consacrées aux modèles open source | À retenir |
|---|---|---|
| Kimi | 61 % | La part la plus élevée, peut-être en raison des canaux d’achat des entreprises et des prix unitaires |
| DeepSeek | 15 % | Deuxième en matière de dépenses, mais davantage utilisé du côté des appels |
| GLM | 11 % | Présent de façon stable dans les budgets des entreprises |
| Meta Llama | 7 % | La part la plus élevée parmi les modèles open source non chinois |
| Qwen | 3 % | Une faible part des dépenses, mais une présence notable du côté des appels |
Ces chiffres prennent tout leur sens quand on les replace dans leur contexte. Le rapport estime que les dépenses mondiales des entreprises consacrées au déploiement de l’IA atteignent environ 176,8 milliards de dollars en rythme annualisé, soit plus de 100 fois leur niveau d’il y a trois ans. Les laboratoires à la pointe de l’IA représentent 69 % des dépenses de déploiement, tandis que les modèles open source ne comptent que pour 4 % des dépenses totales consacrées aux modèles. Quand on dit que « Kimi capte 61 % », il s’agit donc de 61 % de cette petite part consacrée à l’open source, et non de 61 % de l’ensemble du marché de l’IA en entreprise.
Par ailleurs, les données du questionnaire reposent sur les estimations que les personnes interrogées font du budget de leur entreprise, et l’échantillon de près de 400 répondants ne couvre que des entreprises américaines. La bonne lecture est donc la suivante : ces données indiquent une tendance dans les achats des entreprises, mais les proportions exactes restent des estimations issues d’une enquête, à confirmer par d’autres données.
Comment lire le classement des requêtes OpenRouter : DeepSeek capte 29,8 % des requêtes
À retenir : le classement hebdomadaire d’OpenRouter reflète la popularité des modèles auprès des développeurs sur cette plateforme. Il permet de suivre des tendances, mais ne représente pas les parts de l’ensemble du marché.
Pendant la semaine du 26 octobre au 1er novembre, DeepSeek s’est classé premier avec 29,8 % des requêtes texte, soit une hausse de 7 % par rapport à la semaine précédente. OpenAI arrive deuxième avec 18,8 %, tandis que la part de Google recule par rapport à 14,4 %. Z.ai occupe la quatrième place avec 11,9 % et Qwen la sixième avec 5,6 %.
| Classement | Fournisseur | Part des requêtes | Évolution |
|---|---|---|---|
| 1er | DeepSeek | 29,8 % | +7 % par rapport à la semaine précédente |
| 2e | OpenAI | 18,8 % | — |
| En baisse | En recul par rapport à 14,4 % | Part en baisse | |
| 4e | Z.ai | 11,9 % | — |
| 6e | Qwen | 5,6 % | — |
Deux autres tendances méritent l’attention. Le volume de tokens utilisés par les modèles chinois dépasse celui des modèles américains depuis 27 semaines consécutives, et quatre des cinq modèles les plus sollicités de la semaine sont chinois. Sur la même période, DeepSeek a mis à niveau son modèle vers DeepSeek V4.1-Flash-1017 sans modifier ni le mode d’appel de l’API ni les tarifs. Pour les développeurs qui l’utilisent déjà, le coût de migration reste donc très faible.
La stabilité est aussi à surveiller. Le 3 novembre, l’interface web et l’API de DeepSeek ont subi une interruption partielle d’environ une heure. Un volume d’utilisation élevé ne garantit pas une disponibilité permanente : c’est pourquoi il est utile de « prévoir un modèle de secours », comme nous le verrons plus loin. Après le lancement d’une nouvelle version, consultez la liste des modèles dans la console APIYI sur apiyi.com pour vérifier l’ID exact du modèle et sa tarification.
Pourquoi les classements des modèles open source par dépenses et par requêtes sont-ils inversés ?
En bref : cinq facteurs expliquent principalement cette inversion : les prix unitaires, les modes d’achat, les quotas gratuits, l’adéquation aux tâches et le périmètre des plateformes. Cela ne signifie pas que l’un des classements est « faux ».
La part des dépenses correspond approximativement au « volume d’invocations × prix unitaire », auquel s’ajoutent les effets des contrats et des achats. La part des requêtes compte uniquement le nombre d’appels, quel que soit leur coût. Si un modèle coûte plus cher à l’unité et que les entreprises sont prêtes à signer des contrats pour l’utiliser, il remontera dans le classement des dépenses. Si son prix est bas et que les développeurs l’utilisent beaucoup, il remontera dans celui des requêtes.
| Facteur | Effet sur la part des dépenses | Effet sur la part des requêtes |
|---|---|---|
| Prix unitaire | Un prix élevé augmente les dépenses à volume égal et amplifie leur part | Un prix bas encourage les essais et augmente le nombre de requêtes |
| Achats des entreprises | Les contrats, les déploiements privés et les accords de service sont comptabilisés dans les dépenses | Ils ne passent pas forcément par OpenRouter et ne sont donc pas toujours visibles sur la plateforme |
| Quotas gratuits | Les appels gratuits ne génèrent pas de dépenses | Les appels gratuits sont comptabilisés dans les requêtes |
| Adéquation aux tâches | Les tâches gourmandes en tokens, comme le traitement de longs documents ou les agents, augmentent les coûts | Les conversations courtes et les petits traitements par lots augmentent le nombre d’appels |
| Périmètre des plateformes | Couvre uniquement les entreprises américaines interrogées | Couvre uniquement les utilisateurs d’OpenRouter |
Dans ce cadre, Kimi pourrait bénéficier d’un avantage sur le plan des canaux d’achat des entreprises et des prix unitaires, ce qui expliquerait sa part élevée des dépenses. DeepSeek, lui, affiche des prix unitaires plus bas et bénéficie d’une communauté de développeurs active, d’où son volume élevé de requêtes. C’est une hypothèse plausible compte tenu des périmètres mesurés : les deux rapports ne fournissent pas de ventilation détaillée pour chaque facteur.
Autre détail souvent négligé : les différentes versions d’un même modèle, les canaux d’accès et les taux d’utilisation du cache peuvent tous créer des écarts entre les dépenses et le nombre d’appels. Si une équipe utilise souvent le cache, ses requêtes sont toujours comptabilisées, mais ses dépenses réelles seront bien plus faibles.
Prix et usage des modèles open source : que signifient une baisse du prix unitaire d’environ 70 % et une multiplication de l’usage par 22,5 ?
En bref : une baisse du prix unitaire ne signifie pas une baisse du coût total. Comparer le coût par tâche accomplie est plus fiable que de comparer le prix par million de tokens.
Le rapport Menlo présente deux chiffres clés : le prix moyen des tokens est passé de 0.45 dollar/million de tokens à 0.13 dollar/million de tokens, soit une baisse d’environ 70 %, tandis que l’usage a été multiplié par 22,5 sur la même période. Un calcul approximatif à partir de ces chiffres montre que la dépense totale, loin de baisser, aurait été multipliée par environ 6,5. Il s’agit d’une estimation illustrative fondée sur les moyennes du rapport : la situation réelle varie d’une équipe à l’autre.
Le cas des modèles open source est encore plus parlant. Ils représentent 19 % des tokens utilisés en entreprise, mais seulement 4 % des dépenses consacrées aux modèles. Autrement dit, une grande quantité de tokens est traitée par des modèles open source peu coûteux, mais l’essentiel des dépenses va aux modèles fermés de pointe.
Pour les développeurs, la baisse du prix unitaire encourage davantage d’invocations, notamment pour les agents et les tâches par lots. Le coût réel dépend aussi de plusieurs facteurs :
- Taux de succès du cache : la possibilité de réutiliser les invites système et les contextes longs depuis le cache détermine directement le prix réel.
- Longueur du contexte : pour les tâches sur des documents longs, les tokens d’entrée sont souvent bien plus nombreux que les tokens de sortie.
- Nombre de tentatives : les nouvelles tentatives causées par des sorties instables ou des erreurs de format peuvent multiplier le coût.
- Nombre de cycles d’appel aux outils : une tâche confiée à un agent peut nécessiter une dizaine d’allers-retours ou plus. Le prix unitaire est bas, mais les cycles s’accumulent.
Pour comparer les prix, commencez par consulter les tarifs et les modalités de facturation des modèles envisagés dans la console APIYI apiyi.com. Vérifiez comment les entrées, les sorties et le cache sont facturés. Exécutez ensuite un petit lot de vos propres tâches et calculez le coût par tâche accomplie : ce chiffre est plus utile que le prix unitaire affiché.
Choisir un modèle open source : les classements pour présélectionner, les tâches pour décider
En bref : les classements servent à établir une liste de candidats. La décision finale repose sur l’adéquation aux tâches, le coût, la stabilité et une validation sur un petit échantillon.
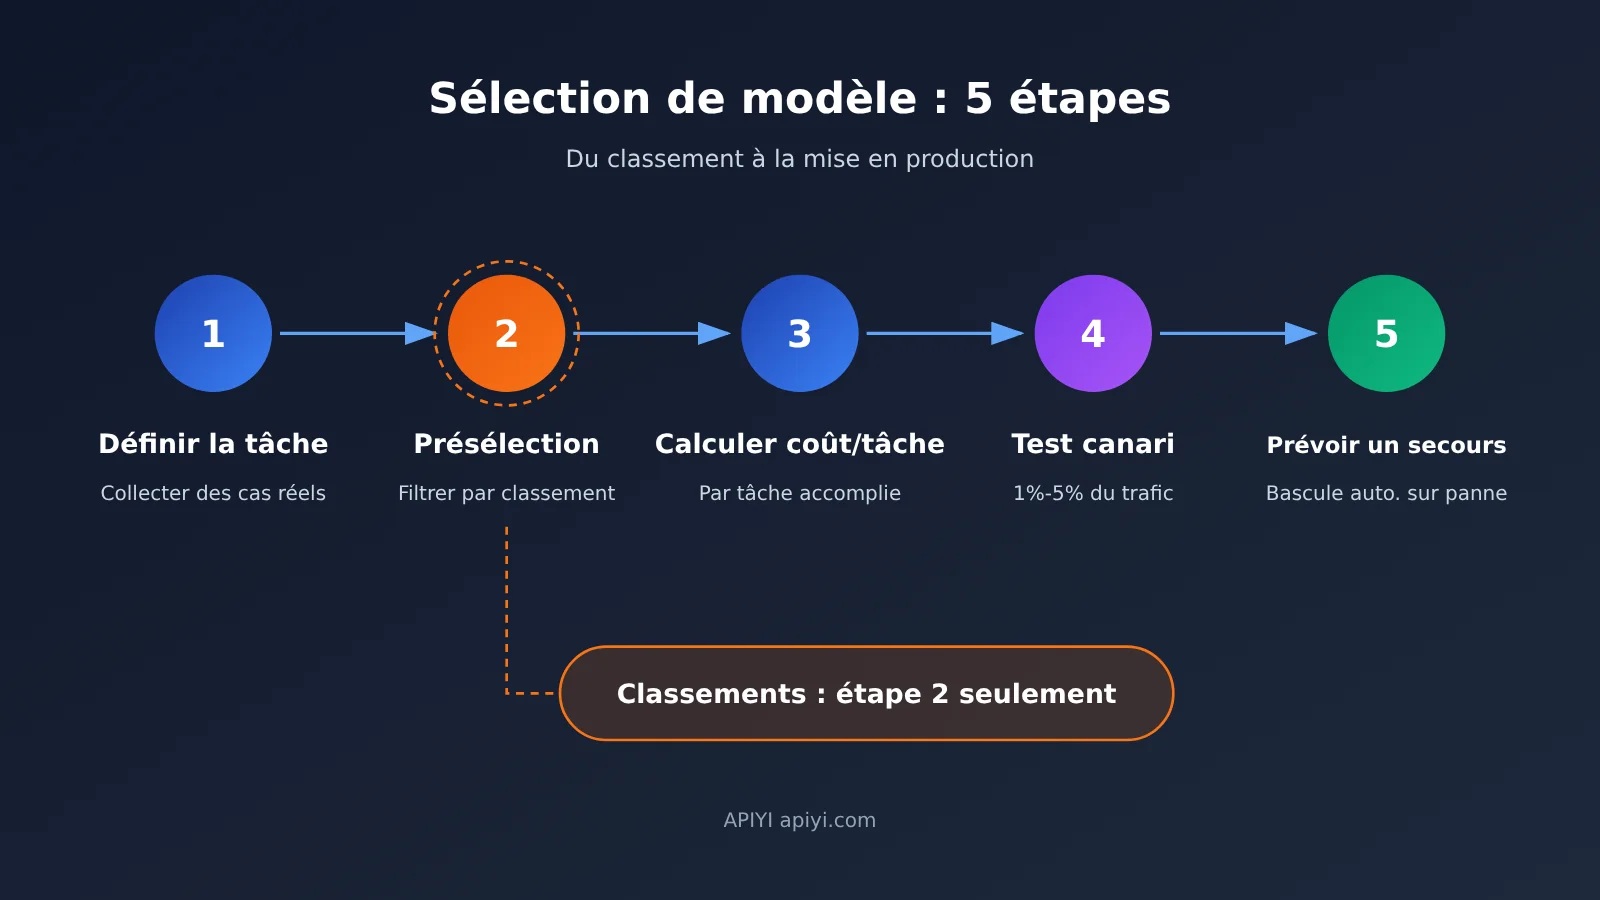
Vous pouvez procéder dans cet ordre : « tâches → coût → stabilité → validation → solution de secours ». Le tableau ci-dessous récapitule les questions à se poser et les vérifications à effectuer pour chaque critère.
| Critère | Questions à se poser | Comment vérifier | Incidence sur le coût |
|---|---|---|---|
| Adéquation aux tâches | S’agit-il surtout de programmation, de documents longs, de multimodal ou d’appels d’outils par un agent ? | Préparer 30-100 exemples de tâches réelles et évaluer les réponses manuellement | Une mauvaise adéquation augmente le nombre de tentatives et de corrections manuelles |
| Tarifs et cache | Quels sont les tarifs de l’entrée, de la sortie et des accès au cache ? | Consulter la liste des modèles et les informations de facturation dans la console, puis mesurer le taux d’accès au cache | Détermine le prix réel par million de tokens |
| Contexte | Quelle est la longueur maximale des entrées ? Les performances baissent-elles sur les entrées très longues ? | Tester la troncature et la restitution d’informations avec les documents réels les plus longs | Un contexte long augmente directement le nombre de tokens en entrée |
| Limites de débit | Les plafonds de requêtes simultanées et de requêtes par minute sont-ils suffisants ? | Effectuer des tests de charge au niveau du trafic de pointe | En cas de limitation, les requêtes doivent attendre ou basculer vers un autre modèle, ce qui augmente la latence |
| Disponibilité régionale | Le modèle est-il accessible de façon stable dans la région de déploiement ? | Effectuer des appels depuis la région de production | S’il n’est pas disponible, il faut trouver un autre canal |
| Stabilité | Y a-t-il eu des interruptions récentes ? Combien de temps faut-il pour rétablir le service ? | Consulter l’historique des incidents et les journaux de taux d’erreur | Les interruptions entraînent des coûts de nouvelles tentatives et des pertes pour l’activité |
La comparaison des modèles est l’étape la plus chronophage. Si vous devez créer un compte et intégrer un SDK séparément pour chaque candidat, la seule mise en place peut prendre plusieurs jours. Avec APIYI apiyi.com, une seule clé API permet d’appeler des modèles de plusieurs fournisseurs, dont OpenAI, Claude, Gemini, DeepSeek et Kimi. L’interface est compatible avec le format OpenAI : définissez base_url sur https://api.apiyi.com/v1, puis modifiez le paramètre model dans la requête pour changer de modèle. Vous pouvez ainsi comparer rapidement les candidats sur le même jeu d’exemples.
Pour évaluer la stabilité, ne vous fiez pas uniquement aux annonces des fournisseurs. L’interruption de DeepSeek le 3 novembre rappelle que tout modèle peut devenir temporairement indisponible. Dans la console APIYI apiyi.com, vous pouvez consulter l’utilisation et les journaux d’appels par modèle : taux d’erreur, latence et consommation de tokens y sont enregistrés. C’est utile pour observer les performances réelles des candidats pendant un déploiement canari. La plateforme utilise un déploiement multinœud et un routage intelligent, et propose un mécanisme de repli automatique. En configurant aussi un modèle de secours côté application, vous pouvez basculer vers celui-ci en cas d’erreur du modèle principal et limiter ainsi l’impact d’une défaillance unique.
Pour le déploiement canari, commencez avec 1%-5% du trafic réel et surveillez pendant quelques jours le taux d’erreur, la latence et le coût par tâche. Si les données restent stables, augmentez progressivement le trafic. Ne basculez pas tout d’un coup sur la seule foi d’un classement.
FAQ : les questions fréquentes sur les classements de modèles open source
En bref : ces cinq questions couvrent les erreurs les plus courantes dans la lecture des classements de modèles open source.
Q1 : Kimi représente 61 % des dépenses. Cela signifie-t-il que ses modèles sont meilleurs ?
Non. La part des dépenses indique où va l’argent. Elle dépend notamment des prix unitaires, des contrats d’achat des entreprises et des canaux utilisés, sans lien direct avec les capacités du modèle. De plus, les données de Menlo sont des estimations issues d’une enquête qui couvre uniquement les dépenses des entreprises américaines en modèles open source. Être « premier en dépenses » ne signifie pas être « premier en capacités » : évaluez le modèle sur vos propres tâches.
Q2 : Le classement des requêtes sur OpenRouter reflète-t-il les achats des entreprises ?
Non. OpenRouter mesure la part des requêtes sur sa propre plateforme, utilisée principalement par des développeurs et des petites et moyennes équipes. Les contrats directs des entreprises, les déploiements privés et les autres canaux ne sont pas inclus. Ce classement permet de suivre la popularité auprès des développeurs et les tendances des invocations sensibles au prix, mais pas de déduire la répartition des budgets des entreprises.
Q3 : Un modèle au prix unitaire plus bas coûte-t-il forcément moins cher au total ?
Pas forcément. Si ce modèle nécessite davantage de tentatives, des invites plus longues ou plus de cycles d’appel aux outils, la consommation totale de tokens peut être plus élevée. Calculez plutôt le coût pour « accomplir une tâche » : dans la console APIYI apiyi.com, consultez la consommation de tokens et les journaux de coûts de chaque invocation, puis comparez les dépenses totales de différents modèles sur un même ensemble de tâches.
Q4 : Les modèles open source peuvent-ils remplacer complètement les modèles à code fermé ?
Cela dépend de la tâche. Selon les données de Menlo, les modèles open source traitent 19 % des tokens des entreprises, mais ne représentent que 4 % de leurs dépenses. Cela suggère que de nombreuses équipes leur confient les tâches courantes et en grand volume, tout en réservant les tâches complexes aux modèles de pointe à code fermé. Une approche prudente consiste à combiner les deux : avec APIYI apiyi.com, accédez aux modèles open source et à code fermé avec une même clé API, puis répartissez les tâches selon leur difficulté.
Q5 : À quelle fréquence consulter les classements de modèles open source ?
Vous pouvez parcourir les classements hebdomadaires une fois par mois pour suivre les tendances sans vous focaliser sur les fluctuations d’une seule semaine. À la publication des rapports d’enquête annuels ou trimestriels, prenez le temps de les lire en vérifiant si leur périmètre et leurs échantillons ont changé. Ce qui compte vraiment pour vos décisions, c’est le suivi continu de vos propres indicateurs : taux d’erreur, coût par tâche et retours des utilisateurs. Faites le point sur ces données chaque semaine.
Comprendre les classements de modèles open source : une checklist en 5 étapes
En bref : les deux classements ne mesurent pas la même chose. Pour bien les lire, commencez par vérifier ce qui est mesuré, examinez les échantillons, puis validez les résultats sur vos propres tâches.
Les points essentiels :
- Dépenses ≠ invocations : Menlo mesure les dépenses des entreprises, OpenRouter les requêtes sur sa plateforme. Les bases de comparaison diffèrent : on ne peut pas les comparer directement.
- Enquête ≠ audit : les données de Menlo sont des estimations issues d’une enquête auprès de près de 400 décideurs d’entreprises américaines. OpenRouter ne représente que sa propre plateforme.
- Moins cher ≠ économies : le prix unitaire a baissé d’environ 70 %, mais l’usage a été multiplié par 22,5. La dépense totale a donc augmenté : il faut calculer le coût par tâche.
- Populaire ≠ stable : même le modèle en tête du classement par nombre d’invocations peut subir des interruptions. Mieux vaut préparer une solution de secours à l’avance.
- Les classements permettent de réduire la liste des candidats, mais ne choisissent pas le modèle à votre place.
Vous pouvez utiliser cette checklist lors de votre prochaine sélection de modèle :
- Définir les tâches : précisez les principaux types de tâches (programmation, documents longs, multimodal, Agent), puis rassemblez 30 à 100 exemples réels et définissez les critères d’évaluation.
- Lister les candidats : retenez 2 à 3 modèles dans chacun des classements par dépenses et par requêtes, puis ajoutez un modèle propriétaire comme référence. Limitez la liste finale à 3 à 5 modèles.
- Calculer le coût par tâche : testez tous les candidats sur le même ensemble d’exemples. Relevez la consommation de tokens, les accès au cache et le nombre de nouvelles tentatives, puis calculez le coût par tâche et le score de qualité.
- Effectuer un déploiement canari : confiez d’abord 1 % à 5 % du trafic réel au modèle retenu. Surveillez pendant quelques jours le taux d’erreur, la latence et les coûts avant d’augmenter le trafic si les résultats sont satisfaisants.
- Prévoir une solution de secours : configurez au moins un modèle de secours provenant d’un autre fournisseur, définissez les règles de bascule et testez-les régulièrement.
Pour réaliser les étapes 3 à 5 depuis un seul point d’accès, APIYI apiyi.com permet d’accéder aux modèles candidats avec une seule clé API. Vous pouvez comparer les prix, l’usage et les journaux dans la console, puis configurer une bascule de secours à l’aide de la fonction de repli automatique de la plateforme. Les nouveaux utilisateurs bénéficient d’un crédit de test gratuit, pratique pour commencer par une validation sur un petit échantillon.
Sources des données
- Rapport 2026 de Menlo Ventures sur l’état de l’IA en entreprise : publié le 3 novembre 2026
- Lien :
menlovc.com -
Précisions : les dépenses des entreprises en IA, la part des dépenses consacrée aux modèles open source et l’évolution du prix des tokens sont des estimations issues d’une enquête
-
Classement des modèles OpenRouter : classement hebdomadaire du 26 octobre au 1er novembre 2026
- Lien :
openrouter.ai/rankings - Précisions : la part des requêtes textuelles et les tendances d’utilisation des tokens ne représentent que cette plateforme
Auteur : équipe technique d’APIYI
Échanges techniques : si vous rencontrez des questions de prix, de limites de débit ou de bascule lors de la sélection d’un modèle, contactez-nous depuis la page d’accueil d’APIYI apiyi.com. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com.