Fin septembre et début octobre, les grands modèles de pointe se sont succédé à un rythme soutenu : Anthropic a lancé Claude Opus 5.5 le 22 septembre, puis Google a présenté Gemini 4 Argon, seulement huit jours plus tard. Les deux modèles occupent un créneau très similaire : raisonnement en plusieurs étapes, programmation agentique et travail de connaissance en entreprise. Leurs tarifs officiels sont également identiques : 4 $ par million de tokens en entrée et 20 $ en sortie. La question « Gemini 4 Argon ou Claude Opus 5.5 ? » revient donc souvent chez les développeurs qui doivent choisir un modèle.
Les informations publiques restent limitées. La source la plus complète à ce jour est un tableau comparatif de 19 benchmarks publié par Google dans sa documentation d’évaluation d’Argon, qui inclut Claude Opus 5.5. Cet article s’appuie sur ce tableau pour examiner les résultats un par un, puis les complète avec des évaluations indépendantes d’Artificial Analysis, de Vals et d’autres acteurs, ainsi qu’avec des critères pratiques comme le prix, la limite de sortie et la disponibilité. L’objectif : vous aider à déterminer dans quels cas chaque modèle est le plus adapté.
À retenir : à la fin de cet article, vous saurez quels chiffres du tableau d’évaluation de Google sont fiables et lesquels sont à prendre avec des pincettes. Vous pourrez aussi choisir entre Gemini 4 Argon et Claude Opus 5.5 en fonction de votre cas d’usage.
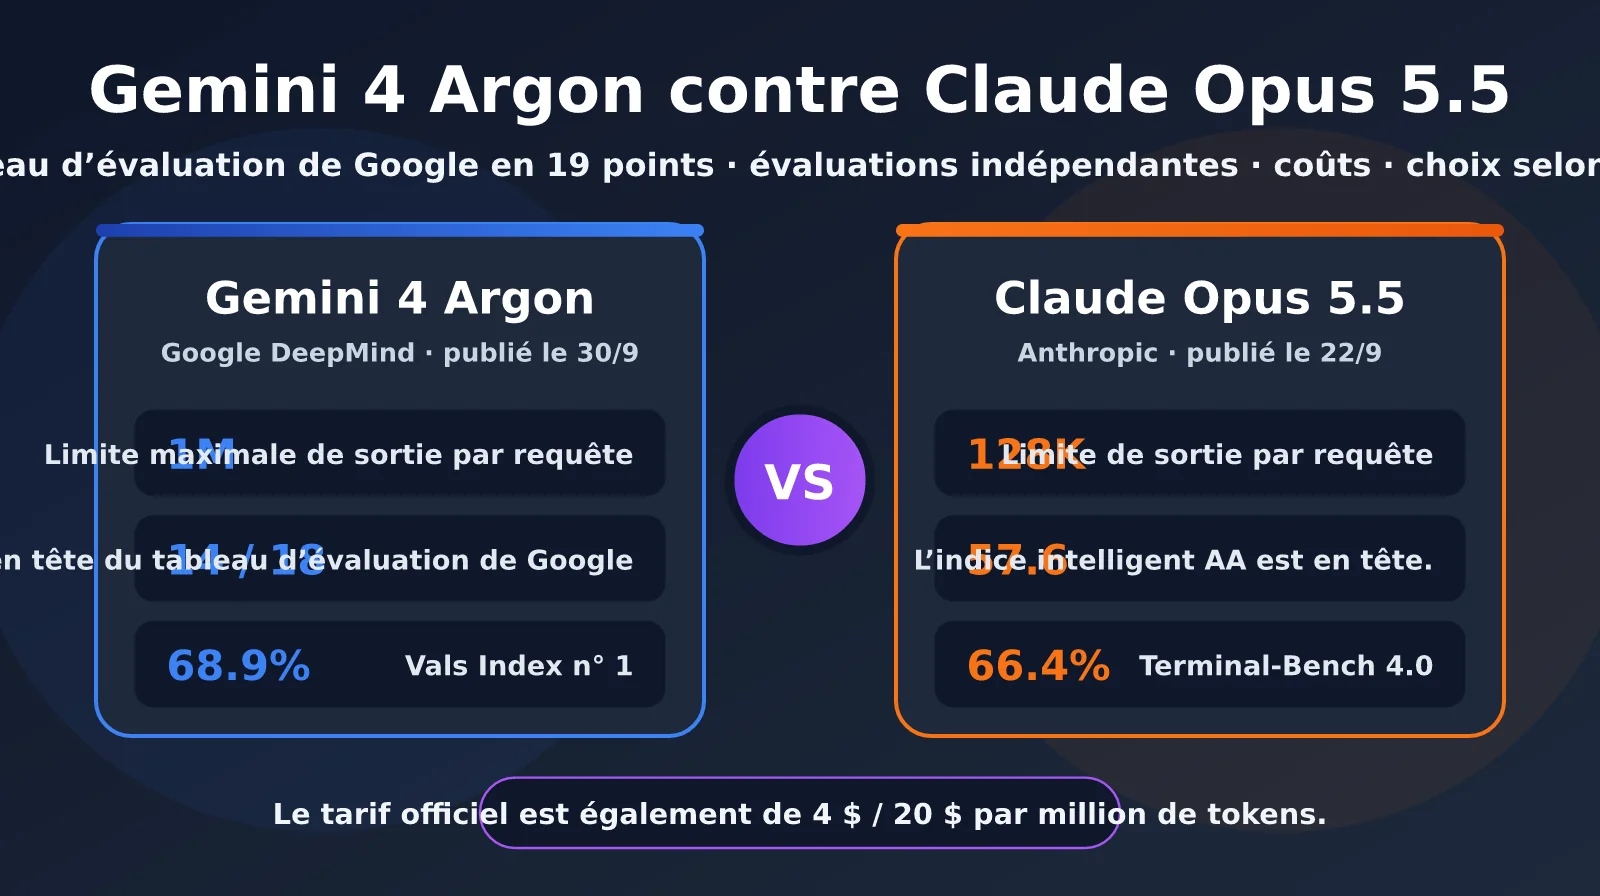
Comparaison des caractéristiques de base de Gemini 4 Argon et Claude Opus 5.5
Avant d’examiner les scores des évaluations, comparons les caractéristiques de base des deux modèles. Leurs tarifs officiels sont identiques. Les différences se situent surtout au niveau de la limite de sortie, de la disponibilité et du tarif de lancement.
| Critère | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Date de lancement | 30 septembre 2026 | 22 septembre 2026 |
| Disponibilité actuelle | Déploiement progressif via le programme Fairwind et Vertex AI ; l’API payante n’est pas encore ouverte à tous | Disponible partout : Claude API, Bedrock, Vertex AI et Foundry |
| ID du modèle | Pas encore communiqué officiellement | claude-opus-5-5 |
| Prix (entrée/sortie) | Tarif de lancement : 2 $/10 $ ; tarif officiel : 4 $/20 $ | 4 $/20 $ |
| Lecture du cache | Réduction de 95 % sur le prix d’entrée (à partir de 0,10 $) | 0,20 $ |
| Tarif Batch | Pas encore communiqué | 2 $/10 $ |
| Fenêtre de contexte | Pas encore communiquée officiellement (1 M selon des sources tierces) | 1 M, sans frais supplémentaires pour les longs contextes |
| Limite de sortie par requête | 1 M de tokens | 128 k tokens |
| Contrôle du raisonnement | Plusieurs niveaux, dont High | Cinq niveaux d’effort, de low à max, avec réflexion adaptative |
Le principal avantage concret d’Argon est sa limite de sortie de 1 M de tokens, soit environ huit fois celle d’Opus 5.5. Il convient donc à la génération de code très longue et aux migrations à grande échelle. Le principal atout d’Opus 5.5, c’est qu’il est disponible dès aujourd’hui et de manière stable : son ID de modèle est connu, il est proposé sur les principales plateformes cloud et inclut un tarif Batch réduit de moitié ainsi que cinq niveaux de contrôle de l’effort. Son intégration dans les environnements de production est nettement plus aboutie.
🎯 Conseil pour choisir : les tarifs officiels des deux modèles étant identiques, le choix dépend surtout du type de tâche. Nous vous conseillons d’utiliser la plateforme APIYI, sur apiyi.com, pour appeler Claude Opus 5.5 et les modèles Gemini avec la même interface. Un test comparatif sur vos propres tâches sera plus fiable qu’une simple consultation des classements.
Gemini 4 Argon vs Claude Opus 5.5 : analyse détaillée du tableau d’évaluation de Google
Voici les données comparatives publiées par Google dans sa documentation d’évaluation d’Argon. Seules les colonnes Argon et Opus 5.5 sont conservées, et les résultats sont classés par catégorie. À noter : il s’agit d’un tableau fourni par un éditeur. Google a évalué Argon lui-même, tandis que les résultats d’Opus 5.5 proviennent principalement de classements publics ou de la fiche système d’Anthropic. Google a également relancé certains tests de manière uniforme.
| Catégorie | Test de référence | Gemini 4 Argon | Claude Opus 5.5 | En tête |
|---|---|---|---|---|
| Travail intellectuel | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| Travail intellectuel | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| Travail intellectuel | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| Travail intellectuel | Agent juridique Harvey | 19.6% | 3.8% | Argon +15.8 |
| Programmation agentique | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| Programmation agentique | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| Programmation agentique | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| Programmation agentique | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| Ingénierie du machine learning | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| Sciences et mathématiques | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| Sciences et mathématiques | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| Sciences et mathématiques | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| Long contexte | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| Long contexte | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| Utilisation d’un ordinateur | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| Multimodal | Chartography | 71.6% | 66.3% | Argon +5.3 |
| Multimodal | LVBench — vidéos longues | 91.7% | 83.7% | Argon +8.0 |
| Cybersécurité | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
Sur les 18 tests de référence pour lesquels les deux modèles ont un résultat, Argon en remporte 14, contre 4 pour Opus 5.5. Les quatre victoires d’Opus 5.5 suivent un schéma clair : FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench et Terminal-Bench Science impliquent tous des tâches menées dans un véritable environnement de terminal, avec de longues séquences d’opérations et d’exécution de commandes. Les plus grands écarts en faveur d’Argon se concentrent sur le long contexte (17.4 points d’avance sur GraphWalks 256K–1M), les agents juridiques et les sciences de la vie (LABBench 2).
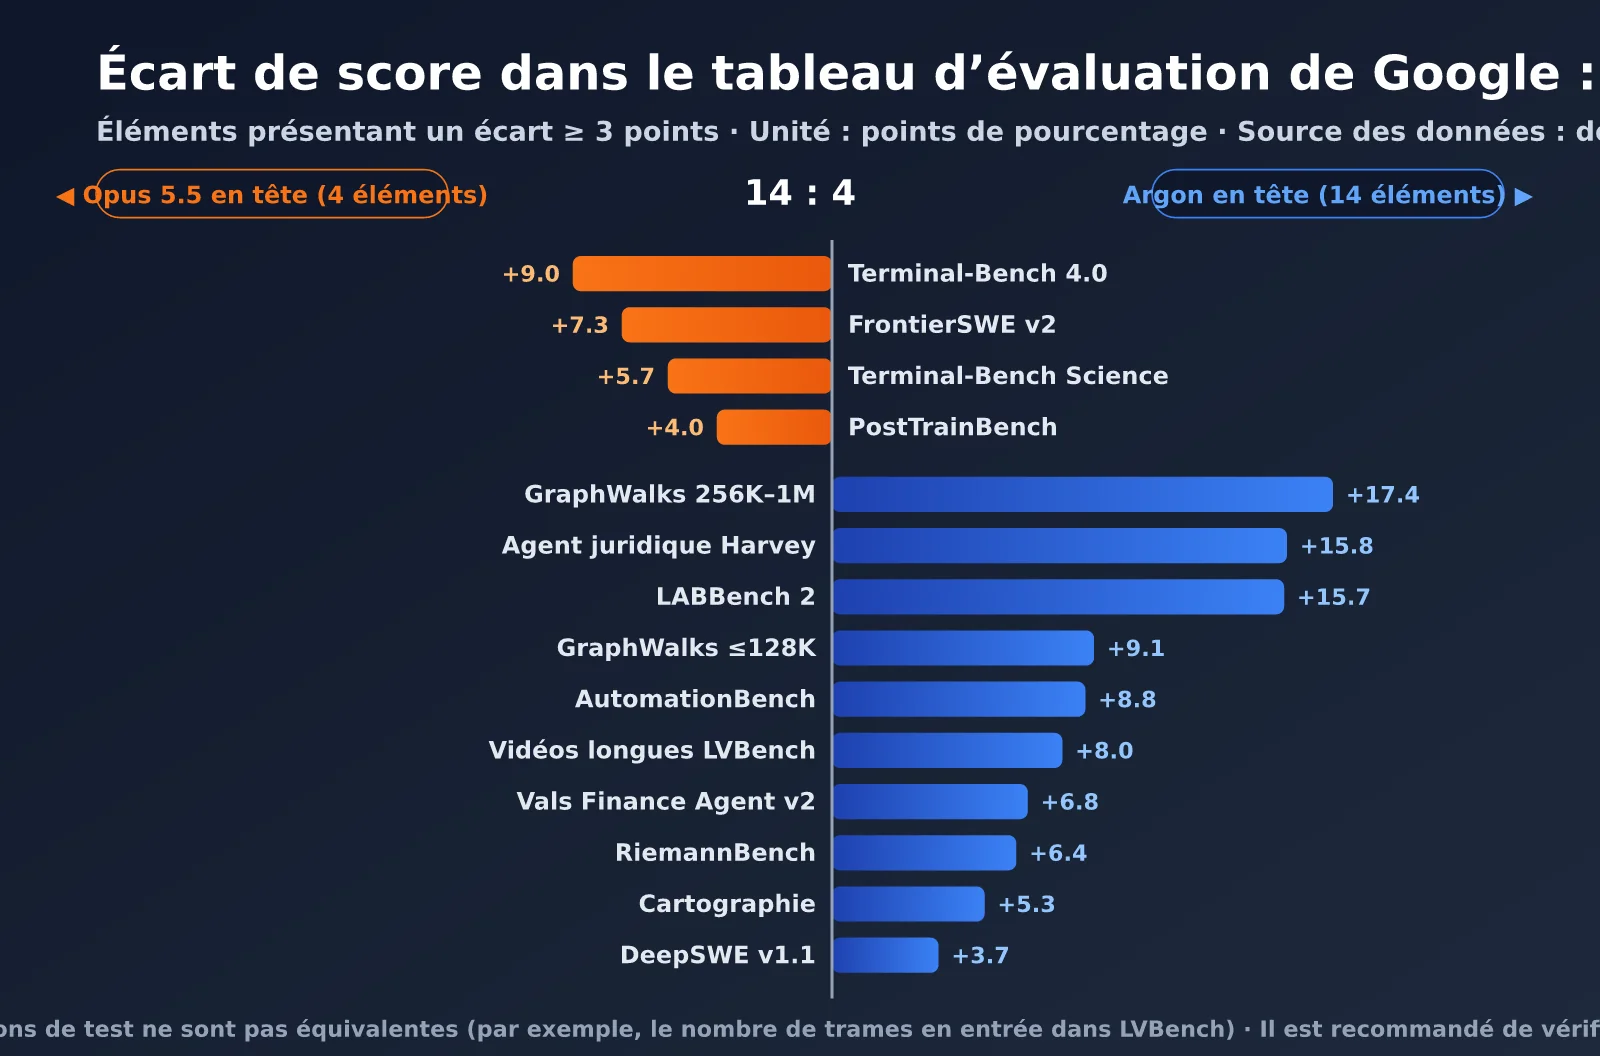
Les points du tableau d’évaluation de Google à relativiser
Les évaluations publiées par un éditeur favorisent naturellement son propre modèle. Les notes de bas de page de ce tableau contiennent aussi plusieurs détails à garder à l’esprit. Les comprendre permet d’interpréter correctement les écarts entre Gemini 4 Argon et Claude Opus 5.5 :
- Nombre d’images vidéo différent pour LVBench : Argon traite la vidéo complète à raison d’une image par seconde, tandis qu’Opus 5.5 est limité à 600 images par les contraintes de l’API. Une partie de l’écart sur les vidéos longues s’explique donc par des conditions d’entrée différentes.
- Délai d’attente plus long pour Terminal-Bench Science : le délai d’expiration de la validation d’Argon est six fois supérieur à la valeur par défaut. Malgré cela, Argon reste derrière Opus 5.5 de 5.7 points.
- Cadres de test différents pour DeepSWE : Argon est évalué avec le cadre mini-swe agent, tandis que le résultat de Claude provient de la fiche système d’Anthropic. Les deux modèles n’ont donc pas été testés avec le même cadre.
- Écarts avec les données publiées par Anthropic : dans ses propres résultats pour Opus 5.5, Anthropic indique 40.0% à AutomationBench, 89.0% à Chartography avec outils et 81.8% à OSWorld 2.0. Dans le tableau de Google, Chartography est indiqué à seulement 66.3%, tandis que la case OSWorld est laissée vide.
Autrement dit, lorsque les conditions de test sont harmonisées, l’écart entre les deux modèles est moins grand que ne le laisse penser le tableau. L’avance d’Argon sur le long contexte, les tâches juridiques et les sciences de la vie est suffisamment importante pour être considérée comme crédible. En revanche, pour des tests comme Vals Index, Vibe Code et CWE-bench, où l’écart n’est que de 1 à 2 points, on peut pratiquement parler d’égalité.
Résultats d’évaluations indépendantes : Gemini 4 Argon vs Claude Opus 5.5
Les conclusions des évaluations indépendantes menées par des tiers ne concordent pas avec celles du tableau de Google. Elles vont même dans le sens opposé pour l’indice global d’intelligence. Le tableau ci-dessous récapitule les données publiques d’Artificial Analysis (AA) et de Vals.
| Évaluation indépendante | Gemini 4 Argon | Claude Opus 5.5 | Modèle en tête |
|---|---|---|---|
| Indice d’intelligence AA v4.3 | 52,6 | 57,6 | Opus +5,0 |
| Classement Vals Index | 68,90 % (1er) | 66,97 % (3e) | Argon +1,9 |
| AA Terminal-Bench 4.0 | 57,1 % | 59,6 % | Opus +2,5 |
| AA Humanity’s Last Exam | 57,1 % | 61,4 % | Opus +4,3 |
| AA SciCode | 61,8 % | 66,9 % | Opus +5,1 |
| Raisonnement sur un long contexte (AA) | 79,7 % | 84,7 % | Opus +5,0 |
| AA GDPval (Elo) | 1 611 | 1 846 | Opus +235 |
| AA AutomationBench | 77,5 % | 69,5 % | Argon +8,0 |
| Vitesse de sortie (AA) | 48,9 jetons/s | 92,2 jetons/s | Opus, environ 1,9 fois plus rapide |
Dans les tests d’AA, Opus 5.5 domine Argon en raisonnement, en programmation scientifique, en raisonnement sur un long contexte et dans les tâches professionnelles de GDPval. Argon ne l’emporte nettement que sur AutomationBench, consacré à l’automatisation des processus métier. La comparaison d’AA n’est toutefois pas entièrement équitable : Argon a été testé uniquement en mode High, tandis qu’Opus 5.5 utilisait le mode Max avec raisonnement adaptatif. Une partie de l’écart peut donc s’expliquer par les paramètres d’intensité du raisonnement, et pas uniquement par une différence de capacités.
Vals Index classe Argon en tête des 41 modèles évalués et Opus 5.5 en troisième position. Mais l’écart entre les deux est d’environ 1,5 erreur standard : Argon a un léger avantage, sans que celui-ci soit certain. En résumé, Gemini 4 Argon et Claude Opus 5.5 se situent dans la même catégorie en matière de capacités générales ; aucun des deux ne surclasse nettement l’autre.
💡 Conseil pour vos évaluations : les conclusions peuvent varier d’un organisme d’évaluation à l’autre. Au bout du compte, rien ne vaut des tests sur vos propres données. La plateforme APIYI apiyi.com permet de passer d’un modèle Claude, Gemini ou GPT à un autre avec une interface unifiée, ce qui facilite la création rapide d’un petit jeu de tests personnalisé.
Gemini 4 Argon vs Claude Opus 5.5 : comprendre les principales différences
Au-delà des scores, les différences de conception entre les deux modèles sont plus utiles pour choisir celui qui vous convient que les écarts sur un benchmark donné.
Deux approches des tâches en plusieurs étapes
Gemini 4 Argon mise sur un espace plus grand pour chaque réponse. Avec une limite de sortie de 1 million de jetons, il peut générer des centaines de milliers de lignes de code ou de très longs rapports en une seule requête. En interne, Google l’a utilisé pour migrer vers Rust plus de 800 000 lignes de code C/C++ du noyau Fuchsia Zircon, ainsi que pour remplacer 32 000 lignes de code SIMD dans libgav1. Cette approche limite le découpage des tâches et l’assemblage de contextes. Elle convient particulièrement aux situations où il faut produire beaucoup de contenu d’un seul coup.
Claude Opus 5.5 cherche plutôt à rendre le raisonnement plus contrôlable. Il ne mise pas sur des sorties très longues, mais propose cinq niveaux d’effort, de low à max, ainsi qu’une réflexion adaptative toujours activée. Les développeurs peuvent ainsi ajuster la profondeur du raisonnement et le coût en fonction de la difficulté de la tâche. Associé à des cadres d’agents comme Claude Code, Opus 5.5 est plus à l’aise pour exécuter des outils au fil de plusieurs interactions, observer les résultats et corriger sa trajectoire. Cela explique aussi ses performances nettement supérieures dans les tâches d’interaction avec un terminal, comme Terminal-Bench.
Vitesse, latence et stabilité
Les tests d’Artificial Analysis indiquent une vitesse de sortie d’environ 92 jetons/s pour Opus 5.5, soit près du double des 48,9 jetons/s d’Argon. Pour les assistants de programmation interactifs et les agents de service client, cet écart se répercute directement sur l’expérience utilisateur. Argon a l’avantage de réaliser davantage de travail en une seule requête : il est donc adapté aux tâches de fond volumineuses, moins sensibles à la réactivité.
Par ailleurs, Opus 5.5 fonctionne de manière stable sur plusieurs plateformes cloud depuis plusieurs semaines. La documentation sur les quotas, la limitation du débit et la gestion des erreurs est déjà bien établie. Argon est encore en phase de déploiement progressif, et ses règles de quotas et de limitation du débit restent floues. Pour les systèmes de production soumis à des exigences élevées en matière de SLA, ce facteur ne devrait pas peser moins lourd que les résultats des benchmarks.
Sécurité et protection contre les injections d’invite
Les deux entreprises font de la sécurité des agents une priorité. Google affirme qu’Argon est son modèle le plus résistant à ce jour aux injections d’invite indirectes et qu’il arrive en tête du benchmark Gray Swan IPI, sans toutefois publier de score précis. De son côté, l’analyse d’entreprises tierces spécialisées en sécurité indique qu’Opus 5.5 affiche, à égalité avec Claude Fable 5.1, le taux de réussite des injections le plus faible sur ce même benchmark. Autrement dit, les deux modèles se situent dans le peloton de tête pour la protection contre les injections d’invite, et chacun peut revendiquer un avantage. Pour les agents qui doivent lire des pages Web, des courriels ou des documents externes, quel que soit le modèle choisi, il reste indispensable d’isoler les autorisations des outils et de prévoir une validation humaine.
Comparaison des coûts : Gemini 4 Argon vs Claude Opus 5.5
Leurs tarifs officiels sont identiques, mais ils ne consomment pas le même nombre de tokens pour une même tâche : le coût réel peut donc varier considérablement. Le tableau ci-dessous présente le coût par tâche, mesuré par un organisme tiers.
| Base de calcul | Gemini 4 Argon | Claude Opus 5.5 | Écart |
|---|---|---|---|
| Coût moyen par tâche sur AA | 1,99 $ (tarif de lancement) | 5,98 $ | Argon coûte environ un tiers du prix |
| Coût total pour exécuter l’intégralité de l’indice AA | 2 407 $ | 8 708 $ | Argon coûte environ 28 % du prix |
| Coût d’un test Vals | 15,68 $ | 32,14 $ | Argon coûte environ 49 % du prix |
| Coût par tâche sur AA au tarif officiel | Environ 3,98 $ | 5,98 $ | Argon reste environ un tiers moins cher |
| Traitement par lots (Batch) | Non communiqué | Moitié prix : 2 $/10 $ | Opus propose une remise sur les traitements par lots clairement définie |
Même en calculant Argon au tarif officiel de 4 $/20 $, son coût par tâche dans les tests AA reste environ un tiers inférieur à celui d’Opus 5.5. Cela s’explique en partie par le fait qu’Opus 5.5 consacre davantage de temps au raisonnement avec le niveau d’effort Max. En réglant son effort sur medium ou high, le coût baisse nettement : c’est tout l’intérêt pratique des cinq niveaux de contrôle de l’effort d’Opus 5.5. Par ailleurs, pour les traitements hors ligne par lots, la remise de 50 % proposée par Opus 5.5 est déjà confirmée. Elle offre donc davantage de visibilité que le tarif de traitement par lots d’Argon, qui n’a pas encore été communiqué.
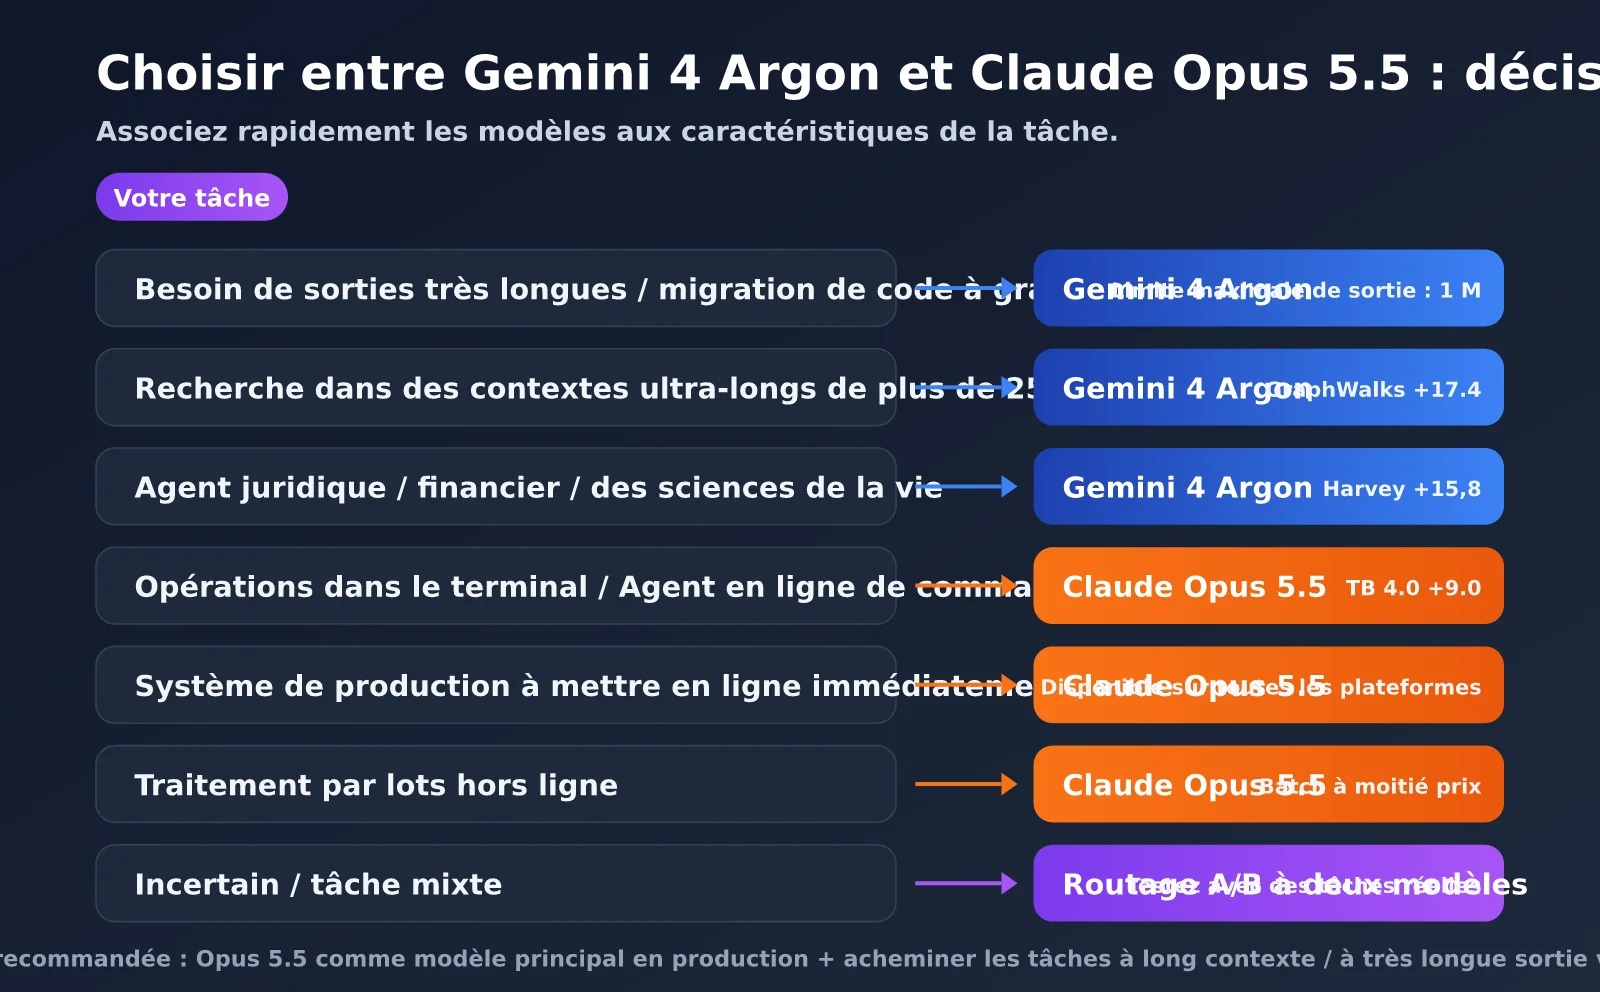
Gemini 4 Argon vs Claude Opus 5.5 : recommandations par cas d’usage et conseils pour faire son choix
En croisant les benchmarks de Google, les évaluations indépendantes, les coûts et la disponibilité, on peut formuler des recommandations assez nettes selon les cas d’usage :
| Cas d’usage | Modèle recommandé | Principale raison |
|---|---|---|
| Migration de code à grande échelle / génération de très longs blocs de code | Gemini 4 Argon | Limite de sortie de 1 M, avance de 3,7 points sur DeepSWE |
| Recherche dans un très long contexte de plus de 256K | Gemini 4 Argon | Avance de 17,4 points sur GraphWalks entre 256K et 1M |
| Agents spécialisés en droit ou en finance | Gemini 4 Argon | Avance de 15,8 points sur Harvey et de 6,8 points sur Finance Agent |
| Compréhension de longues vidéos et de graphiques | Gemini 4 Argon | En tête sur LVBench et Chartography |
| Opérations dans un terminal et agents en ligne de commande | Claude Opus 5.5 | Avance de 9 points sur Terminal-Bench 4.0 |
| Programmation scientifique et raisonnement complexe | Claude Opus 5.5 | En tête sur SciCode, HLE et CritPt d’AA |
| Systèmes de production à déployer immédiatement | Claude Opus 5.5 | Disponible sur toutes les plateformes, avec des identifiants de modèle et des quotas clairement définis |
| Traitement par lots hors ligne | Claude Opus 5.5 | La remise de 50 % sur Batch (2 $/10 $) est confirmée |
Mise en pratique du routage entre Gemini 4 Argon et Claude Opus 5.5
Pour la plupart des équipes, la stratégie la plus pragmatique n’est pas de choisir un seul modèle, mais de les utiliser tous les deux avec un système de routage : commencer par Opus 5.5 comme modèle principal en production, puis rediriger progressivement vers Argon les tâches qui tirent parti d’un long contexte ou d’une très grande limite de sortie. Voici un exemple minimal basé sur une interface compatible avec OpenAI.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # 以平台实际上线 ID 为准

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # 超长上下文或超长输出走 Argon,其余默认 Opus 5.5
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
Afficher le code complet : comparaison A/B de deux modèles sur la même tâche
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
Ce script A/B enregistre la latence, le nombre de tokens générés et le coût de chaque modèle pour une même tâche. Nous vous conseillons de préparer 30 à 50 tâches représentatives de votre activité, puis de les faire évaluer par une personne ou un modèle de notation avant de décider de la proportion de requêtes à router vers chaque modèle.
🚀 Pour commencer rapidement : vous pouvez vous inscrire sur APIYI, à l’adresse apiyi.com, pour obtenir un crédit d’essai et tester le script A/B avec Claude Opus 5.5. Dès qu’Argon sera officiellement disponible sur la plateforme, il suffira de modifier le nom du modèle dans la variable d’environnement pour lancer la comparaison.
Questions fréquentes
Q1 : Gemini 4 Argon ou Claude Opus 5.5, lequel est le plus performant ?
Il n’y a pas de réponse absolue. Dans le tableau d’évaluation de Google, Argon arrive en tête sur 14 tests, contre 4 pour Opus 5.5. Mais dans l’indice global d’intelligence d’Artificial Analysis, Opus 5.5 mène avec un score de 57,6 contre 52,6. Les deux modèles jouent dans la même catégorie : Argon se distingue par sa longue fenêtre de contexte, ses très longs résultats et ses agents spécialisés, tandis qu’Opus 5.5 excelle dans les opérations sur terminal, le raisonnement complexe et la maturité technique.
Q2 : Les données du tableau d’évaluation de Google sont-elles fiables ?
Elles peuvent servir de référence, mais sont à prendre avec des pincettes. Il s’agit d’un tableau publié par Google, et les conditions de test ne sont pas toujours équivalentes d’un benchmark à l’autre : c’est le cas, par exemple, du nombre d’images utilisées en entrée pour LVBench ou des paramètres de délai d’expiration de Terminal-Bench Science. Certains résultats d’Opus 5.5 sont également inférieurs à ceux qu’Anthropic a publiés de son côté. Il est préférable de se concentrer sur les tests où l’écart dépasse 5 points ; un écart de 1 ou 2 points peut être considéré comme une égalité.
Q3 : Peut-on déjà utiliser les deux modèles ?
Claude Opus 5.5 est pleinement disponible via l’API Claude, Bedrock, Vertex AI et Foundry. Gemini 4 Argon est encore déployé progressivement. Il est déjà accessible sur Vertex AI, mais les API payantes ne sont pas encore ouvertes à tous. Vous pouvez commencer par intégrer Opus 5.5 et les modèles Gemini via APIYI apiyi.com, puis comparer les modèles en changeant simplement le paramètre `model` dès qu’Argon sera officiellement disponible.
Q4 : Les deux modèles coûtent le même prix. Lequel revient vraiment moins cher ?
D’après des tests indépendants, le coût par tâche d’Argon représente environ un tiers à la moitié de celui d’Opus 5.5, un avantage encore plus marqué pendant la période de découverte. Mais Opus 5.5 permet de réduire considérablement les coûts en diminuant le niveau d’effort et en utilisant Batch à moitié prix. La méthode la plus fiable consiste à enregistrer l’usage sur des tâches réelles, puis à calculer le coût. La facturation unifiée de la plateforme APIYI apiyi.com permet de comparer facilement les dépenses réelles des deux modèles.
Conclusion
Gemini 4 Argon et Claude Opus 5.5 se livrent un duel serré. D’après le tableau d’évaluation de Google, Argon se démarque par sa longue fenêtre de contexte, ses agents spécialisés en droit et en finance, ses capacités en sciences de la vie et son approche multimodale. Sa limite de sortie de 1 million de tokens le distingue également de tous les autres. Les évaluations indépendantes, quant à elles, donnent l’avantage à Opus 5.5 en matière de raisonnement, de programmation scientifique et d’opérations sur terminal. Le modèle est aussi déjà disponible sur toutes les plateformes et bénéficie d’une solide maturité technique.
À ce stade, nous recommandons la stratégie suivante : utiliser Claude Opus 5.5 comme modèle principal en production et intégrer progressivement Gemini 4 Argon pour les tâches nécessitant une longue fenêtre de contexte ou de très longs résultats, tout en comparant régulièrement les deux modèles à l’aide de vos propres tâches réelles. Lorsque l’API payante d’Argon sera pleinement disponible et que davantage d’évaluations indépendantes auront été publiées, vous pourrez ajuster la répartition du trafic en fonction des résultats.
Nous vous conseillons d’intégrer les modèles Claude et Gemini via la plateforme APIYI apiyi.com. Vous pourrez ainsi comparer et acheminer les requêtes vers plusieurs modèles avec une seule interface et une seule facture, et fonder vos choix sur des données réelles.
Références :
- Article officiel de Google annonçant Gemini 4 Argon : blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Annonce de Claude Opus 5.5 par Anthropic : anthropic.com/news
- Indice d’intelligence et comparatifs de modèles d’Artificial Analysis : artificialanalysis.ai
- Classement des modèles de Vals AI : vals.ai
- Compilation complète des résultats de Gemini 4 Argon (ToolScout) : toolscout.ai/news/gemini-4-argon-benchmarks
Auteur : APIYI Team | Nous suivons de près les évaluations des derniers grands modèles de langage et vous aidons à choisir les bons outils. Pour en savoir plus sur l’intégration des modèles, rendez-vous sur APIYI apiyi.com.