Note de l’auteur : cet article évalue l’API Decisions de GPT-6 Luna sous quatre angles — principes, méthodes de mesure, indicateurs de latence et cas d’usage métier — pour vous aider à déterminer si les « appels décisionnels » sont réellement plus rapides qu’une invocation standard, et plus adaptés à votre activité.
Depuis la mise en ligne officielle de l’API Decisions de GPT-6 Luna, la question qui revient le plus chez les développeurs est simple : dans quelle mesure elle est plus rapide qu’une invocation standard du modèle, et quels cas d’usage justifient de basculer. Cet article évalue l’API Decisions de GPT-6 Luna du point de vue de l’intégration réelle : ses capacités clés, le principe du gain de vitesse, les méthodes de mesure et les cas d’usage pertinents.
Ce n’est pas une reprise de la communication officielle. Selon les comptes, les régions, le nombre d’appels simultanés et les invites, les écarts de latence peuvent être importants. C’est pourquoi cet article ne donne pas de « multiplicateur fixe » qui pourrait vous induire en erreur. Il propose plutôt un script de test reproductible et des critères de décision, pour que vous obteniez une conclusion réelle à partir de vos propres données métier.
L’essentiel : à la fin de cet article, vous pourrez utiliser un script Python pour quantifier l’écart de latence entre l’API Decisions de GPT-6 Luna et une invocation standard, et déterminer si elle convient à vos cas d’usage décisionnels : classification, routage, modération, contrôle des risques, etc.
🎯 Note sur le test : tout le code de cet article est basé sur une API compatible OpenAI et peut être exécuté directement via APIYI (apiyi.com). Pour les ID de modèle, les paramètres d’interface et la facturation, référez-vous à la documentation officielle et à la console de la plateforme.
Fonctionnalités clés de l’API GPT-6 Luna Decisions
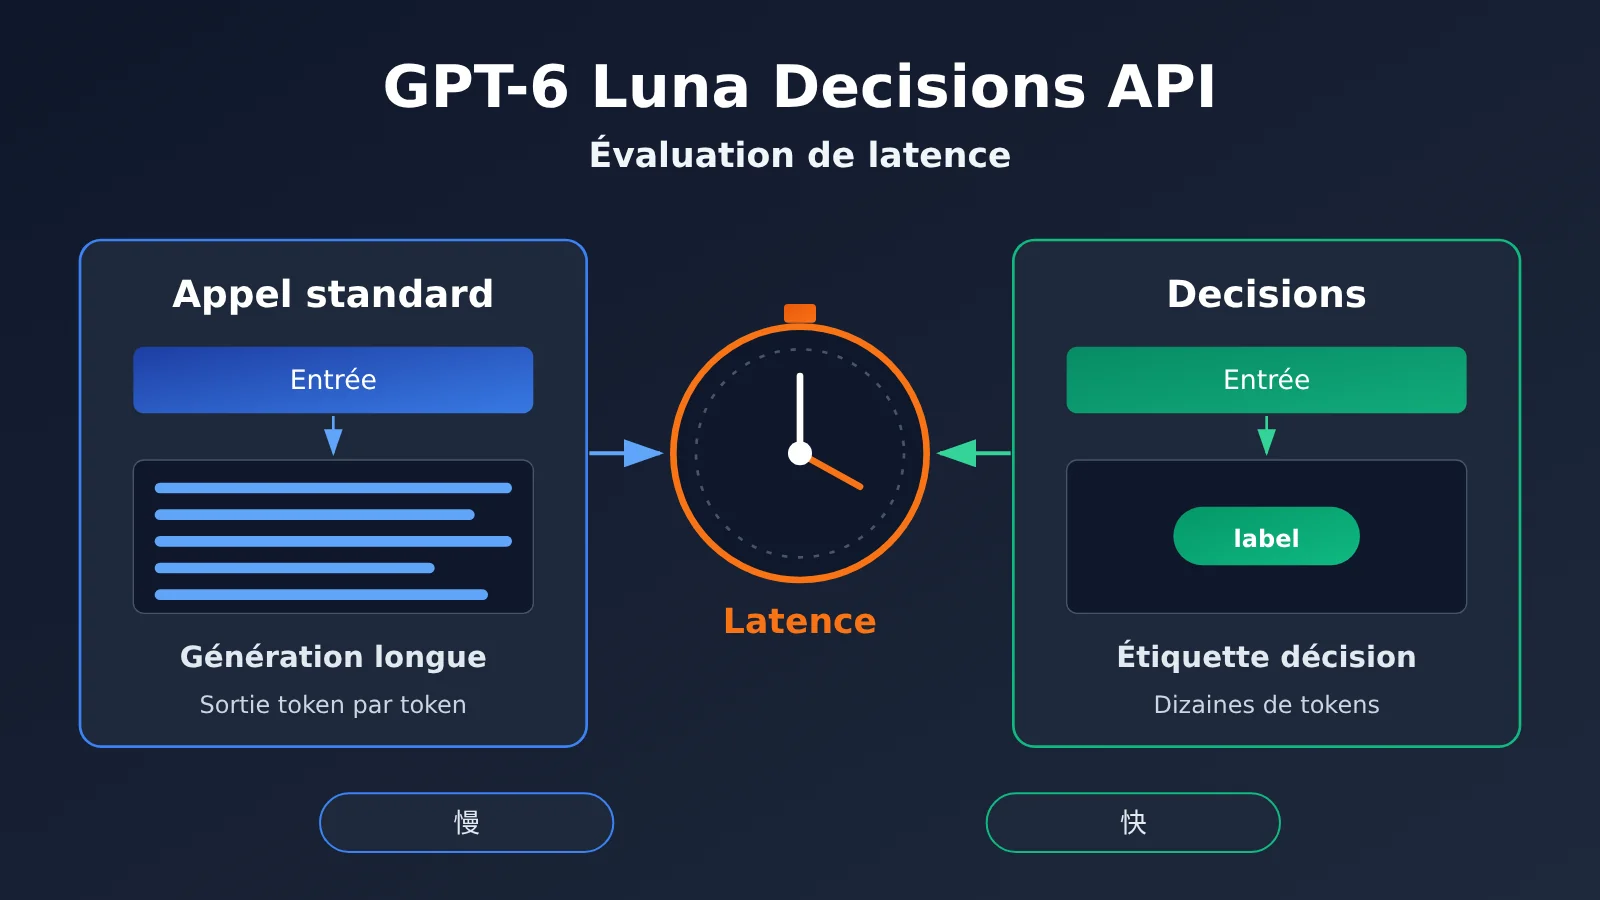
Avant de comprendre l’API Decisions, il faut saisir la différence de positionnement avec un appel de conversation classique. Un appel classique vise à « générer un contenu », tandis qu’un appel décisionnel vise à « produire un jugement parmi un ensemble limité d’options ». Ces deux types de tâches diffèrent complètement en termes de longueur de sortie, de contraintes de format et de composition de la latence.
| Point clé | Explication | Valeur pour le développeur |
|---|---|---|
| Sortie décisionnelle | La sortie se concentre sur des résultats structurés : étiquettes, options, scores, plutôt que sur un long texte | Le résultat est directement exploitable par le programme, sans analyse secondaire |
| Sortie courte | Un résultat décisionnel typique ne fait que quelques dizaines de tokens, bien moins qu’une tâche de génération classique | Le temps de réponse total dépend surtout du premier token et du traitement de l’entrée |
| Format contraint | Compatible avec des contraintes de sortie structurée comme JSON Schema | Réduit le taux d’erreurs de format et le nombre de tentatives |
| Adapté aux appels à haute fréquence | Les requêtes de routage, classification ou modération sont souvent nombreuses et simples individuellement | Les gains de latence et de coût sont démultipliés |
Différences entre l’API Decisions et un appel classique
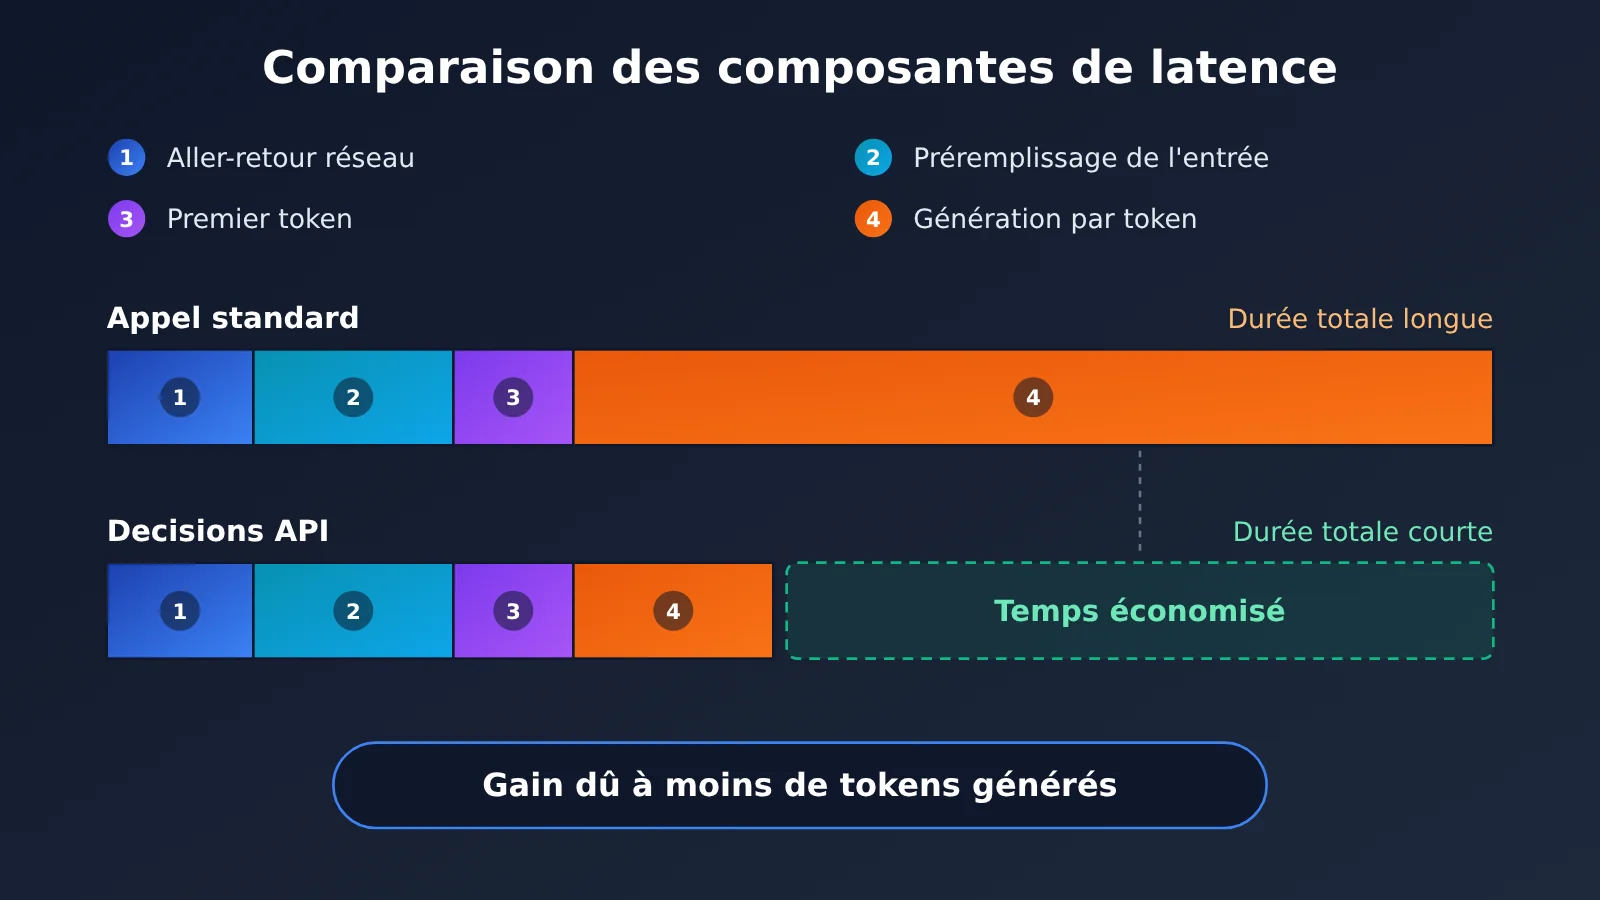
D’un point de vue ingénierie, la durée totale d’un appel de modèle classique se décompose grosso modo en trois parties : l’aller-retour réseau, le traitement de l’entrée (préremplissage) et la génération token par token. Dans les tâches de génération, la troisième partie domine souvent : plus la sortie est longue, plus c’est lent.
Un appel décisionnel compresse la sortie en un résultat structuré, ce qui raccourcit considérablement le temps passé en phase de génération. Autrement dit, le gain de vitesse de l’API GPT-6 Luna Decisions vient principalement du fait de « générer moins », et non de « générer plus vite ». Si votre usage nécessite par nature de longs textes, cette interface n’est pas faite pour vous.
D’où vient le gain de vitesse de l’API Decisions
Les interfaces décisionnelles apportent généralement un bénéfice supplémentaire sur deux plans. D’abord, le format est déterminé : le programme n’a pas besoin d’extraire la réponse d’un texte en langage naturel avec des expressions régulières, et la probabilité de devoir réessayer diminue. Ensuite, le processus de raisonnement est maîtrisable : si le modèle permet d’ajuster l’intensité du raisonnement, les scénarios décisionnels n’ont souvent pas besoin d’une longue chaîne de réflexion, ce qui réduit encore le temps d’attente.
Il faut souligner qu’il s’agit là d’une analyse au niveau des mécanismes. L’ampleur réelle du gain dépend de la longueur de votre sortie d’origine : si vous demandiez déjà au modèle de répondre par un seul mot, le bénéfice après changement sera limité ; si vous lui demandiez de « d’abord expliquer puis conclure », le gain sera très net.
Prise en main rapide de l’API GPT-6 Luna Decisions
Exemple minimal
Voici l’exemple minimal pour réaliser un appel de décision avec une sortie structurée. Remplacez le nom du modèle par l’ID réel de GPT-6 Luna que vous voyez dans la console de la plateforme.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

resp = client.chat.completions.create(
    model="gpt-6-luna",  # Se référer au nom réel dans la liste des modèles de la console
    messages=[{"role": "user", "content": "Contenu du ticket : ma facture est erronée. Veuillez déterminer le service concerné."}],
    response_format={"type": "json_object"},
    max_tokens=50
)
print(resp.choices[0].message.content)
La clé de ce code réside dans max_tokens et response_format : le premier limite la taille de sortie, le second garantit que le résultat peut être analysé par un programme. Ces deux paramètres sont au cœur de l’accélération des appels de type décision.
Voir le script de benchmark complet (comparaison de la latence entre appel classique et appel de décision)
import time
import json
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Appel via l'interface unifiée d'APIYI
)

MODEL = "gpt-6-luna"  # Se référer à l'ID réel du modèle dans la console ; s'il existe un modèle/une interface Decisions dédié, remplacer ici

SAMPLES = [
    "Ma facture est erronée, pouvez-vous la refaire ?",
    "L'appli affiche toujours une erreur de code de vérification à la connexion",
    "Je voudrais passer de l'abonnement mensuel à l'annuel",
    "La commande indique comme livrée mais je ne l'ai pas reçue",
]

DECISION_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "route",
        "schema": {
            "type": "object",
            "properties": {
                "department": {"type": "string", "enum": ["finance", "tech", "sales", "logistics"]},
                "confidence": {"type": "number"}
            },
            "required": ["department", "confidence"]
        }
    }
}

def timed_call(prompt: str, mode: str) -> dict:
    """Renvoie le temps jusqu'au premier token, la durée totale et la longueur de sortie"""
    kwargs = dict(model=MODEL, stream=True)
    if mode == "generate":
        kwargs["messages"] = [{"role": "user", "content": f"Analysez le ticket suivant et indiquez quel service doit le traiter ainsi que la raison : {prompt}"}]
    else:
        kwargs["messages"] = [{"role": "user", "content": f"Ticket : {prompt}. Indique uniquement le service concerné."}]
        kwargs["response_format"] = DECISION_SCHEMA
        kwargs["max_tokens"] = 60

    start = time.perf_counter()
    ttft, chunks = None, []
    for event in client.chat.completions.create(**kwargs):
        delta = event.choices[0].delta.content if event.choices else None
        if delta:
            if ttft is None:
                ttft = time.perf_counter() - start
            chunks.append(delta)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": len("".join(chunks))}

def bench(mode: str, rounds: int = 5) -> dict:
    results = [timed_call(p, mode) for _ in range(rounds) for p in SAMPLES]
    totals = sorted(r["total"] for r in results)
    return {
        "mode": mode,
        "ttft_avg": round(statistics.mean(r["ttft"] for r in results), 3),
        "total_p50": round(totals[len(totals) // 2], 3),
        "total_p95": round(totals[int(len(totals) * 0.95) - 1], 3),
        "avg_chars": round(statistics.mean(r["chars"] for r in results), 1),
    }

if __name__ == "__main__":
    for m in ("generate", "decision"):
        print(json.dumps(bench(m), ensure_ascii=False))
Le script utilise une sortie en streaming, ce qui permet de récupérer à la fois le temps jusqu’au premier token (TTFT) et la durée totale. Je vous conseille de lancer chaque mode au moins 20 fois, en alternant les exécutions sur la même plage horaire pour éviter que les variations réseau faussent les résultats.
🚀 Démarrage rapide : La méthode recommandée officiellement consiste à commencer par récupérer votre crédit de test gratuit pour nouveaux utilisateurs sur APIYI apiyi.com, à exécuter le script ci-dessus sur un échantillon de vos tickets réels, puis à décider si vous mettez l’API GPT-6 Luna Decisions en production.
Données de mesure réelles de l’API GPT-6 Luna Decisions
La question « à quel point est-ce plus rapide qu’un appel classique ? » n’a pas de réponse unique. Cette section propose donc un cadre d’évaluation reproductible. En suivant l’environnement et les indicateurs décrits ci-dessous, vos chiffres pourront réellement guider vos décisions métier.
Configuration de l’environnement de test
| Élément de configuration | Réglage recommandé | Explication |
|---|---|---|
| Point d’entrée des appels | Interface compatible OpenAI (base_url pointant vers la passerelle unifiée) | Garantit que les deux modes passent par le même chemin réseau |
| Données d’échantillon | 20 à 100 requêtes métier réelles | Les latences mesurées avec des données synthétiques sont souvent trop optimistes |
| Mode d’appel | stream=True |
Indispensable pour mesurer le temps jusqu’au premier token |
| Concurrence | D’abord en mono-concurrence, puis montée progressive jusqu’au pic métier | Permet d’observer la variation de latence sous forte concurrence |
| Plage horaire | Une série de tests en heure de pointe et une en heure creuse un jour ouvré | Élimine les écarts de charge liés aux horaires |
Indicateurs de latence essentiels
| Indicateur | Signification | Critère d’évaluation |
|---|---|---|
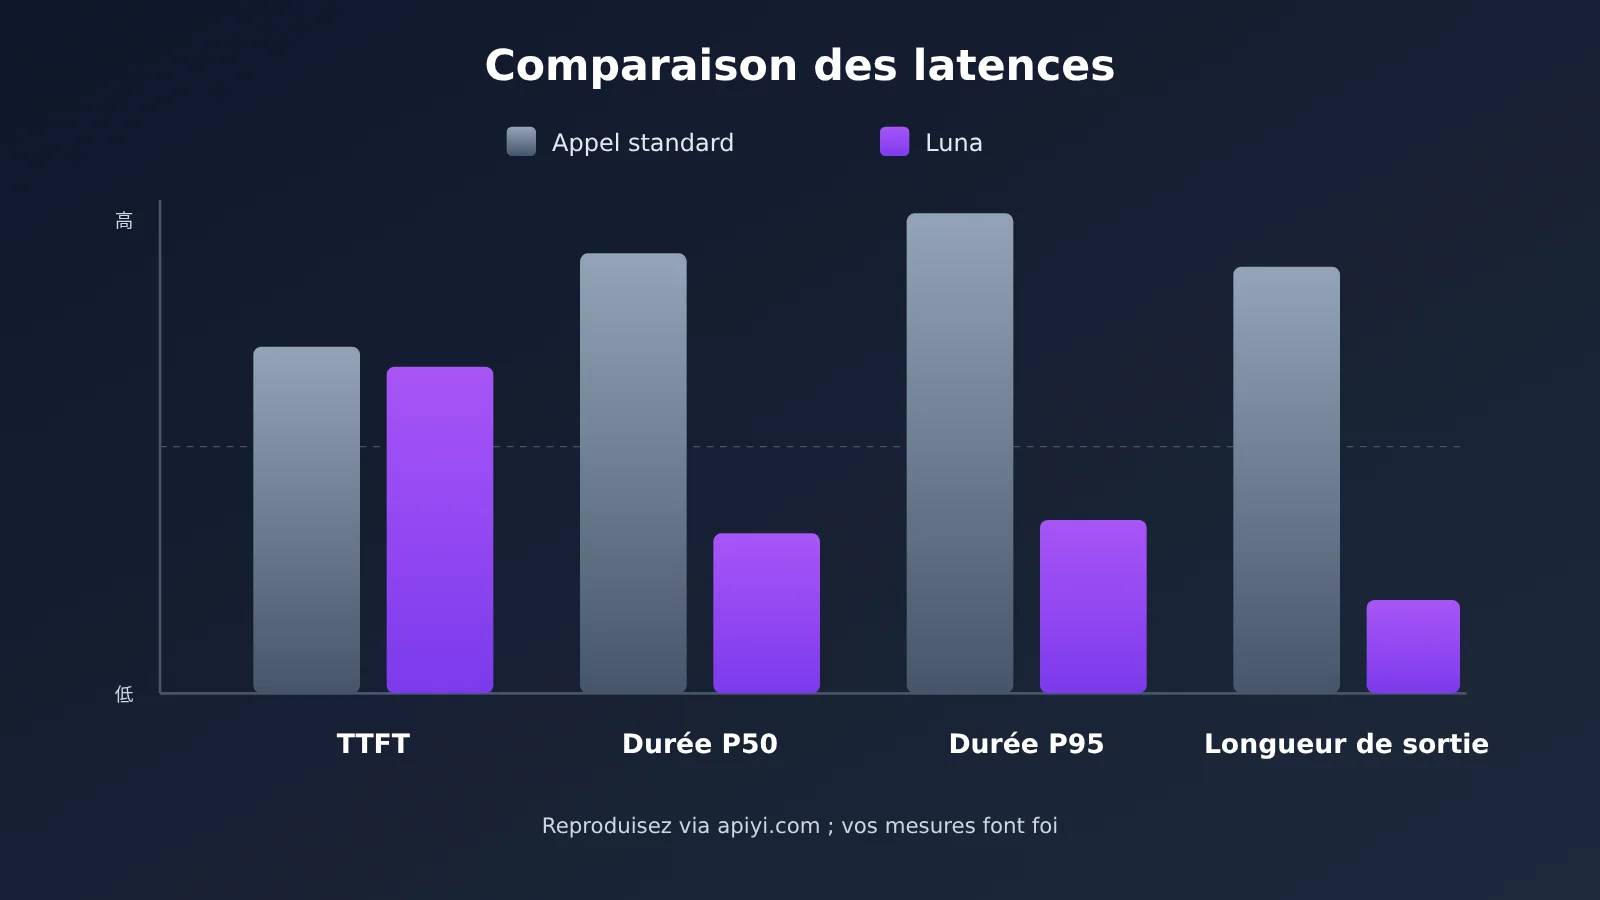
| TTFT, temps jusqu’au premier token | Délai entre l’envoi de la requête et la réception du premier caractère | Généralement proche entre les deux modes, dépend surtout de la longueur d’entrée |
| Temps total P50 | Durée dans laquelle la moitié des requêtes sont terminées | Indicateur clé de l’avantage du mode décisionnel : plus l’écart est grand, plus le basculement en vaut la peine |
| Temps total P95 | Durée des requêtes de la longue traîne | Détermine le plancher de l’expérience utilisateur, incontournable pour les services en ligne |
| Longueur moyenne de sortie | Nombre de caractères ou de tokens renvoyés à chaque appel | Explique le gain de vitesse et pèse directement sur les coûts |
| Taux de succès du format | Proportion de résultats directement analysables | Les tentatives après échec grignotent le temps gagné |
Comment interpréter les résultats de mesure de Decisions API
Si vous constatez que le TTFT est presque identique entre les deux modes, alors que l’écart de temps total P50 est net, cela signifie que le gain de vitesse vient bien d’une génération plus courte. C’est le résultat le plus conforme aux attentes. Vous pouvez alors comparer la longueur moyenne de sortie : plus l’écart est important, plus le temps et le coût de sortie économisés sont considérables.
Si l’écart de P50 est faible mais que celui de P95 est marqué, la longue traîne des appels classiques provient surtout de sorties longues occasionnelles. Dans ce cas, même sans amélioration spectaculaire de la moyenne, passer à l’API GPT-6 Luna Decisions améliore nettement la stabilité des services en ligne.
Il existe enfin un cas où les deux modes ne montrent presque aucune différence : cela signifie généralement que votre invite d’origine est déjà très sobre. La valeur du basculement réside alors principalement dans la fiabilité du format, plus que dans la vitesse.
💡 Conseil de vérification : pour un même lot d’échantillons, il est préférable de tester les deux modes en alternance sur la même passerelle. Nous recommandons de lancer la comparaison directement via l’interface unifiée d’APIYI apiyi.com, afin d’éviter toute distorsion des résultats due à des points de sortie réseau différents.
À quels cas d’usage l’API GPT-6 Luna Decisions est-elle adaptée
La valeur d’une API décisionnelle ne réside pas dans les quelques centaines de millisecondes gagnées sur un appel isolé, mais dans les scénarios à fort volume, simples, où le résultat doit être consommé par un programme : ces millisecondes sont multipliées par des milliers de requêtes. Le tableau ci-dessous récapitule l’adéquation de cinq types de métiers.
| Scénario métier | Sortie typique | Adéquation | Commentaire |
|---|---|---|---|
| Routage des tickets support | Étiquette de service + score de confiance | Élevée | Volume de requêtes important, options fixes : les gains de vitesse et de format sont nets |
| Modération de contenu | Approuvé / refusé / revue humaine | Élevée | Sensible à la latence P95 ; le résultat doit directement piloter le processus |
| Sélection d’outils par un agent | Outil à appeler et paramètres | Élevée | Dans un agent multi-étapes, chaque étape gagne du temps et les gains s’additionnent |
| Pré-filtrage des risques et de la fraude | Niveau de risque | Moyenne | Adapté à un premier filtre ; les décisions critiques nécessitent encore des règles ou une validation humaine |
| Rédaction longue / génération de rapports | Longs passages en langage naturel | Faible | Nécessite par nature une sortie longue ; ce n’est pas le cas d’usage cible d’une API décisionnelle |
Comparaison : Decisions API et les autres approches décisionnelles
Pour les tâches décisionnelles, le grand modèle de langage n’est pas la seule option. Le tableau ci-dessous compare l’API GPT-6 Luna Decisions à plusieurs approches courantes.
| Approche | Caractéristiques clés | Cas d’usage | Niveau de latence | Plateformes disponibles |
|---|---|---|---|---|
| API GPT-6 Luna Decisions | Compréhension d’un grand modèle de langage + sortie courte structurée | Décisions à sémantique complexe mais options bien définies | Faible (à valider par vos propres tests) | APIYI apiyi.com, API officielle |
| Appel génératif classique | Flexible, peut inclure une explication | Décisions peu fréquentes nécessitant une justification | Moyenne à élevée, selon la longueur de la sortie | Principales plateformes de grands modèles de langage |
| Classification par petit modèle léger | Économique et rapide, mais compréhension limitée | Classification sémantiquement simple avec suffisamment d’annotations | Faible | Principales plateformes de grands modèles de langage ou auto-hébergement |
| Moteur de règles | Niveau milliseconde, totalement contrôlable | Règles aux conditions claires et quasi invariables | Très faible | Auto-hébergé |
Analyse comparative : le moteur de règles garde l’avantage de la vitesse et du contrôle, mais lorsque les entrées sont familières et variées, le coût de maintenance des règles explose. Les petits modèles légers ont un avantage de coût évident, mais comprennent mal les sémantiques ambiguës et les contextes longs. En comparaison, l’API GPT-6 Luna Decisions est plus adaptée aux scénarios « sémantique complexe mais espace de réponses limité » ; c’est un compromis entre les règles et un appel classique à un grand modèle.
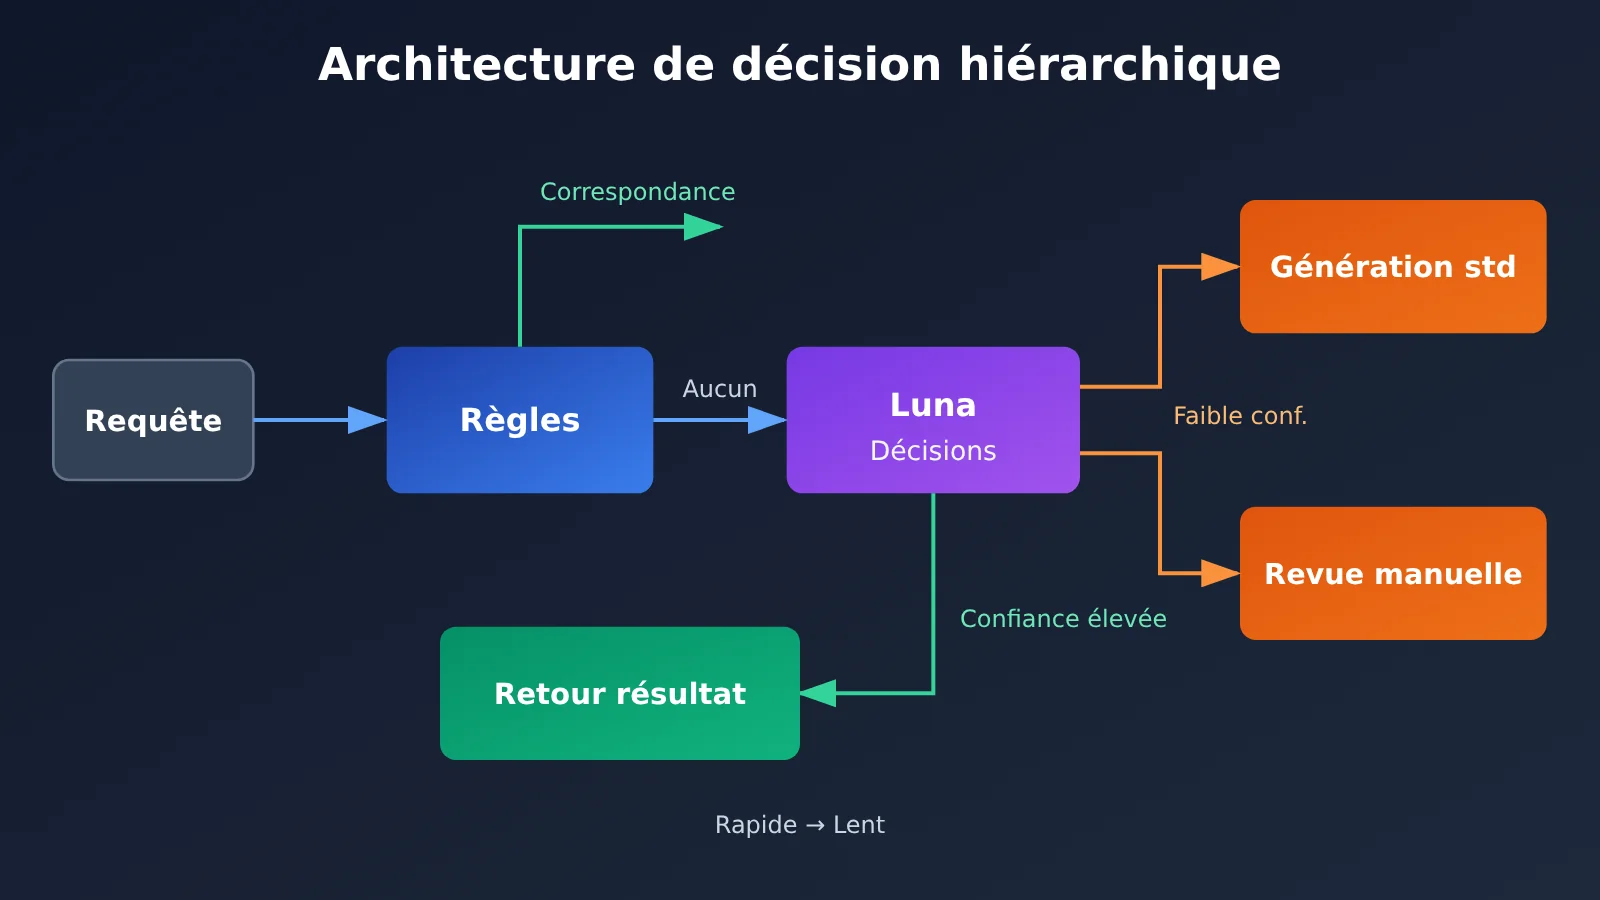
Dans la pratique, l’approche la plus courante est une architecture en couches : le moteur de règles traite les conditions explicites, l’API GPT-6 Luna Decisions traite les requêtes ambiguës, et l’on ne retombe sur un appel génératif classique que lorsqu’une explication est nécessaire.
Analyse des avantages et inconvénients de l’API GPT-6 Luna Decisions
Avantages
- Un temps total mieux maîtrisé : la sortie est compressée en un résultat structuré, ce qui raccourcit nettement la phase de génération et rend la latence sur la longue traîne plus stable.
- Un résultat directement exploitable : combiné à un JSON Schema, la valeur de retour entre directement dans le flux métier, ce qui réduit le code d’analyse et les nouvelles tentatives en cas d’échec.
- Une structure de coûts plus favorable : moins de tokens en sortie, donc des frais de sortie qui baissent en parallèle — un effet particulièrement visible sur les usages à haute fréquence.
- Une intégration simple : grâce au protocole compatible OpenAI, le code existant ne demande généralement qu’un ajustement du nom de modèle et des contraintes de sortie pour basculer.
Limites
- Pas doué pour expliquer : le résultat de décision n’est pas accompagné de justification. Si vous avez besoin d’auditer, vous pouvez lancer un appel standard supplémentaire sur les échantillons à faible confiance pour obtenir des précisions.
- Le gain de vitesse dépend du cas d’usage : si l’appel existant ne renvoie déjà qu’un seul label, le bénéfice reste limité. Mieux vaut d’abord quantifier les choses avec un script d’évaluation avant de migrer.
- La longueur d’entrée reste un goulot d’étranglement : l’interface de type décision optimise la sortie ; le temps de préremplissage d’un contexte très long ne disparaît pas pour autant. Le cas échéant, il faut d’abord réduire l’entrée ou compresser via la recherche.
- Tout dépend de la qualité de la conception des options : des valeurs d’énumération mal définies amènent le modèle à hésiter entre des options proches. Il faut donc proposer dans le schéma des options claires et mutuellement exclusives.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que l’API GPT-6 Luna Decisions ?
C’est un mode d’appel pensé pour les tâches de décision : le principe est d’amener le modèle à produire un jugement bref et structuré parmi des options données, plutôt que de générer un long texte. C’est adapté à la classification, au routage, à la modération et à la sélection d’outils. Pour les paramètres exacts, référez-vous à la documentation officielle.
Q2 : À quel point l’API Decisions est-elle plus rapide qu’un appel classique ?
Il n’existe pas de multiplicateur universel. Le gain vient surtout du raccourcissement de la sortie : plus la sortie d’origine était longue, plus le bénéfice est important. Je vous conseille d’utiliser le script d’évaluation de cet article pour comparer les temps totaux P50 et P95 sur vos propres échantillons, et d’en tirer une conclusion valable pour votre activité.
Q3 : Quelle différence entre l’API GPT-6 Luna Decisions et un appel classique avec sortie JSON ?
Un appel classique avec contrainte JSON peut produire un effet similaire ; l’écart dépend de si l’éditeur a optimisé spécifiquement le scénario de décision (intensité de raisonnement, contraintes de sortie, ordonnancement du service, etc.). Le moyen le plus fiable de trancher reste la comparaison mesurée dans des conditions identiques.
Q4 : Quels cas d’usage faut-il basculer en priorité ?
Privilégiez les activités à fort volume de requêtes, à espace de réponses fixe et sensibles à la latence : routage de tickets support, modération de contenu, sélection d’outils pour un Agent. Les activités qui produisent intrinsèquement de longues sorties (rédaction longue, génération de rapports) ne sont pas à basculer.
Q5 : Comment appeler rapidement l’API GPT-6 Luna Decisions via API ?
Voici la marche à suivre :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et récupérer une clé API
2. Vérifiez l’ID réel du modèle GPT-6 Luna dans la liste des modèles de la console
3. Dans le code de cet article, définissez `base_url` sur `https://api.apiyi.com/v1`, remplacez le nom du modèle, puis lancez l’exécution
La plateforme utilise une interface compatible OpenAI : une seule clé suffit pour appeler en parallèle d’autres modèles grand public et faire des tests comparatifs.
Q6 : Comment maîtriser le coût des appels à l’API Decisions ?
Les sorties de type décision économisent déjà des tokens de sortie. Pour aller plus loin, on peut agir sur trois axes : réduire le contexte inutile, intercepter les requêtes évidentes avec un moteur de règles, et ne relancer un second appel que sur les échantillons à faible confiance. Dans la console APIYI apiyi.com, vous pouvez consulter le détail de consommation par modèle, ce qui aide à identifier les postes de coût les plus lourds.
Q7 : Quelles sont les limites connues de l’API GPT-6 Luna Decisions ?
Les principales limites : pas d’explication de la décision, un gain de vitesse qui dépend de la longueur de sortie d’origine, et un temps de préremplissage incompressible sur les entrées très longues. Pour les décisions à haut risque (finance, santé), utilisez-la comme aide à la décision et conservez une étape de validation humaine.
GPT-6 Luna Decisions API : l’essentiel à retenir
- Positionnement clair : Decisions API répond au besoin de « trancher vite parmi un nombre limité d’options », pas à celui de générer de longs textes.
- D’où vient le gain de vitesse : avant tout de la réduction de la sortie. Plus vos réponses actuelles sont longues, plus le passage à cette API rapporte.
- Les indicateurs à suivre : surveillez le temps total en P50 et P95. Le TTFT reste généralement proche entre les deux modes.
- Les meilleurs cas d’usage : routage de tickets, modération de contenu, sélection d’outils pour un agent — bref, les décisions à haute fréquence.
- Architecture recommandée : un moteur de règles + Decisions API + appels classiques, en couches de repli successives.
- Comment démarrer : lancez un script comparatif sur l’API unifiée compatible OpenAI, et fiez-vous à vos propres mesures avant de migrer.
En résumé
Les points clés de GPT-6 Luna Decisions API :
- La rapidité vient du peu de génération : l’avantage de vitesse découle principalement d’une sortie courte et structurée, pas d’une génération plus rapide par token.
- La valeur dépend du contexte : les métiers à forte fréquence, avec des options fixes et sensibles à la latence, en profitent le plus. Ce n’est pas fait pour les longs textes.
- Les conclusions se font sur le terrain : l’ampleur du gain varie beaucoup selon les invites et les échantillons. Mesurez impérativement P50 et P95 sur vos données réelles.
Si vous travaillez sur le routage du support client, la modération de contenu ou l’orchestration d’agents, GPT-6 Luna Decisions API mérite une évaluation sérieuse. Gardez d’abord vos appels actuels comme groupe de contrôle, basculez une partie du trafic en progressif, puis décidez d’une migration complète en fonction de la latence et du taux de succès sur le format.
Je vous recommande de récupérer un quota gratuit via APIYI apiyi.com, puis d’utiliser le script de cet article pour vérifier rapidement le gain réel de vitesse dans votre contexte métier.
📚 Références
- Documentation officielle de l’API OpenAI : invocation du modèle, sortie en streaming et sortie structurée
- Lien :
platform.openai.com/docs -
À savoir : la source faisant autorité pour vérifier les paramètres liés à GPT-6 Luna et à Decisions
-
SDK Python OpenAI : le client Python officiel
- Lien :
github.com/openai/openai-python -
À savoir : c’est le SDK utilisé par le script d’évaluation de cet article, avec des exemples d’appels en streaming
-
Spécification JSON Schema : le standard qui définit les contraintes de sortie structurée
- Lien :
json-schema.org - À savoir : la référence pour concevoir les options de décision et les valeurs d’énumération
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Pour plus de ressources d’intégration, rendez-vous sur le centre de documentation docs.apiyi.com