Note de l’auteur : découvrez les 4 composants d’un agent de veille et de synthèse exécuté à intervalles réguliers, la façon dont une interface compatible OpenAI découple la couche d’invocation du modèle d’un SDK précis, ainsi qu’un exemple Python prêt à l’emploi.
OpenRouter a récemment publié un tutoriel dans lequel @openrouter/agent 0.11.0 sert à créer, en TypeScript, un agent IA permanent qui surveille automatiquement Hacker News et en résume le contenu à intervalles réguliers. Ce cas d’usage est représentatif : beaucoup d’équipes aimeraient disposer d’un outil similaire pour compiler chaque matin l’actualité de leur secteur, les mouvements de la concurrence ou les sujets populaires des communautés techniques. Nous allons nous en inspirer pour décomposer une architecture générique d’agent de veille et de synthèse, indépendante de tout SDK.
Il ne s’agit pas d’une reprise de ce tutoriel. Seules des informations résumées sur le tutoriel original ont été rendues publiques ; nous ne faisons donc aucune supposition sur son implémentation. Nous nous intéressons ici à une question plus générale : quels sont les composants d’un agent de veille et de synthèse, et comment concevoir la couche d’invocation du modèle pour pouvoir changer de modèle et de fournisseur à tout moment ?
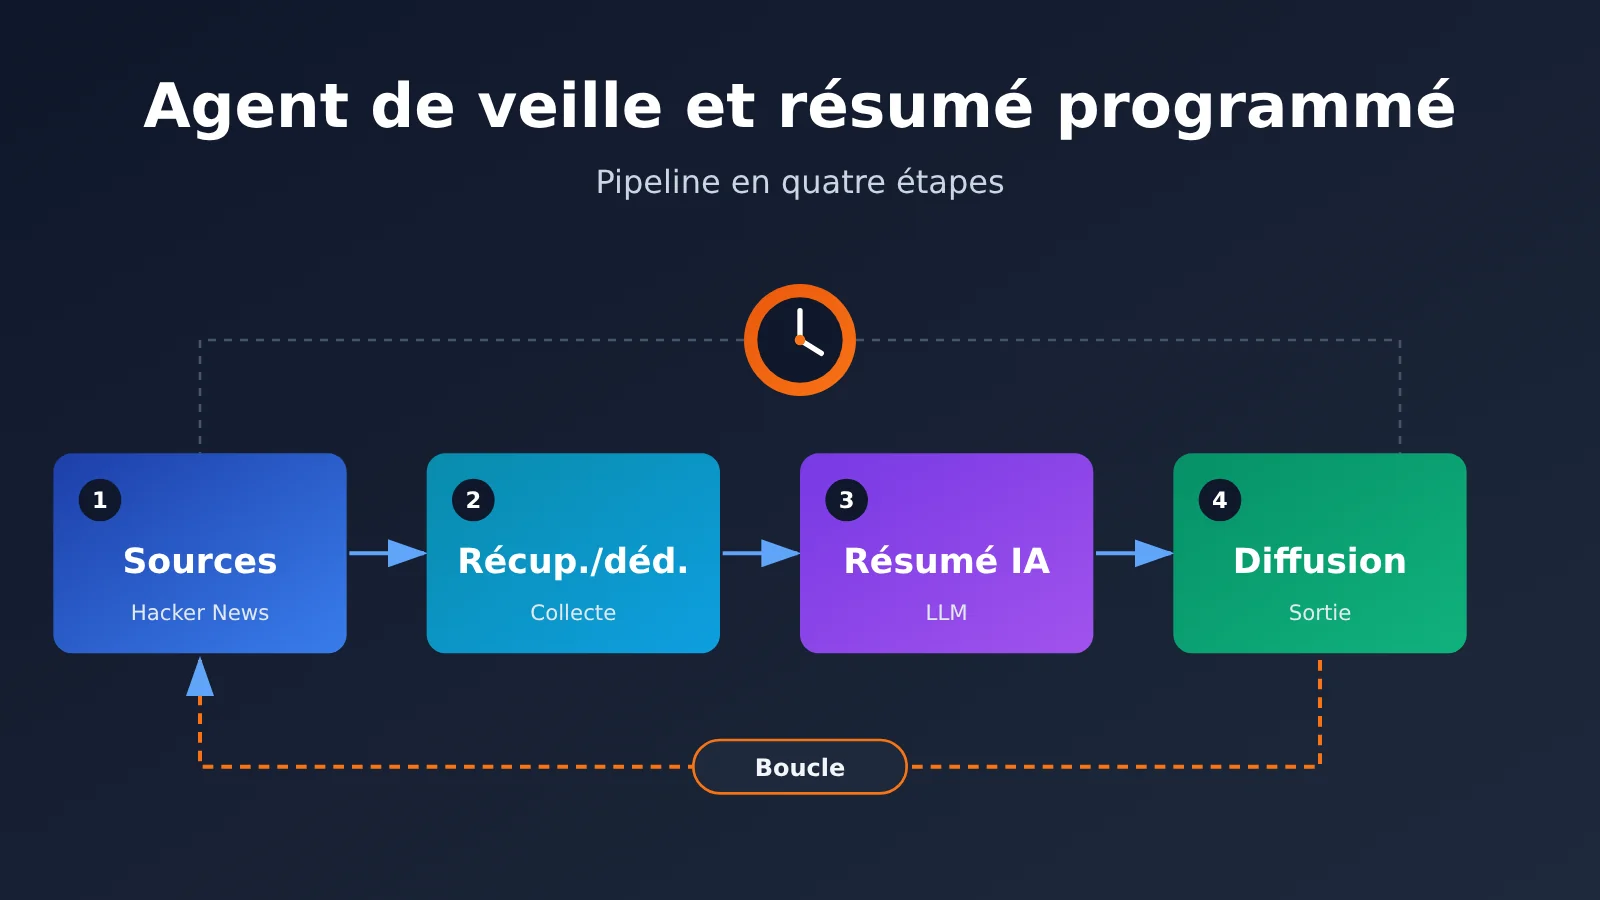
Ce que vous allez en retirer : à la fin de cet article, vous maîtriserez une structure en quatre étapes — déclenchement planifié, collecte des données, synthèse par le modèle et diffusion des résultats — et disposerez d’une implémentation Python basée sur une interface compatible OpenAI, prête à être adaptée.
Les points clés d’un agent de veille et de résumé
Ce tableau résume les conclusions de l’article. Les sections suivantes détaillent chaque point.
| Point clé | Explication | Avantage |
|---|---|---|
| Structure en quatre étapes | Déclenchement planifié → récupération des données → résumé par le modèle → diffusion du résultat | Chaque étape peut être remplacée et testée indépendamment |
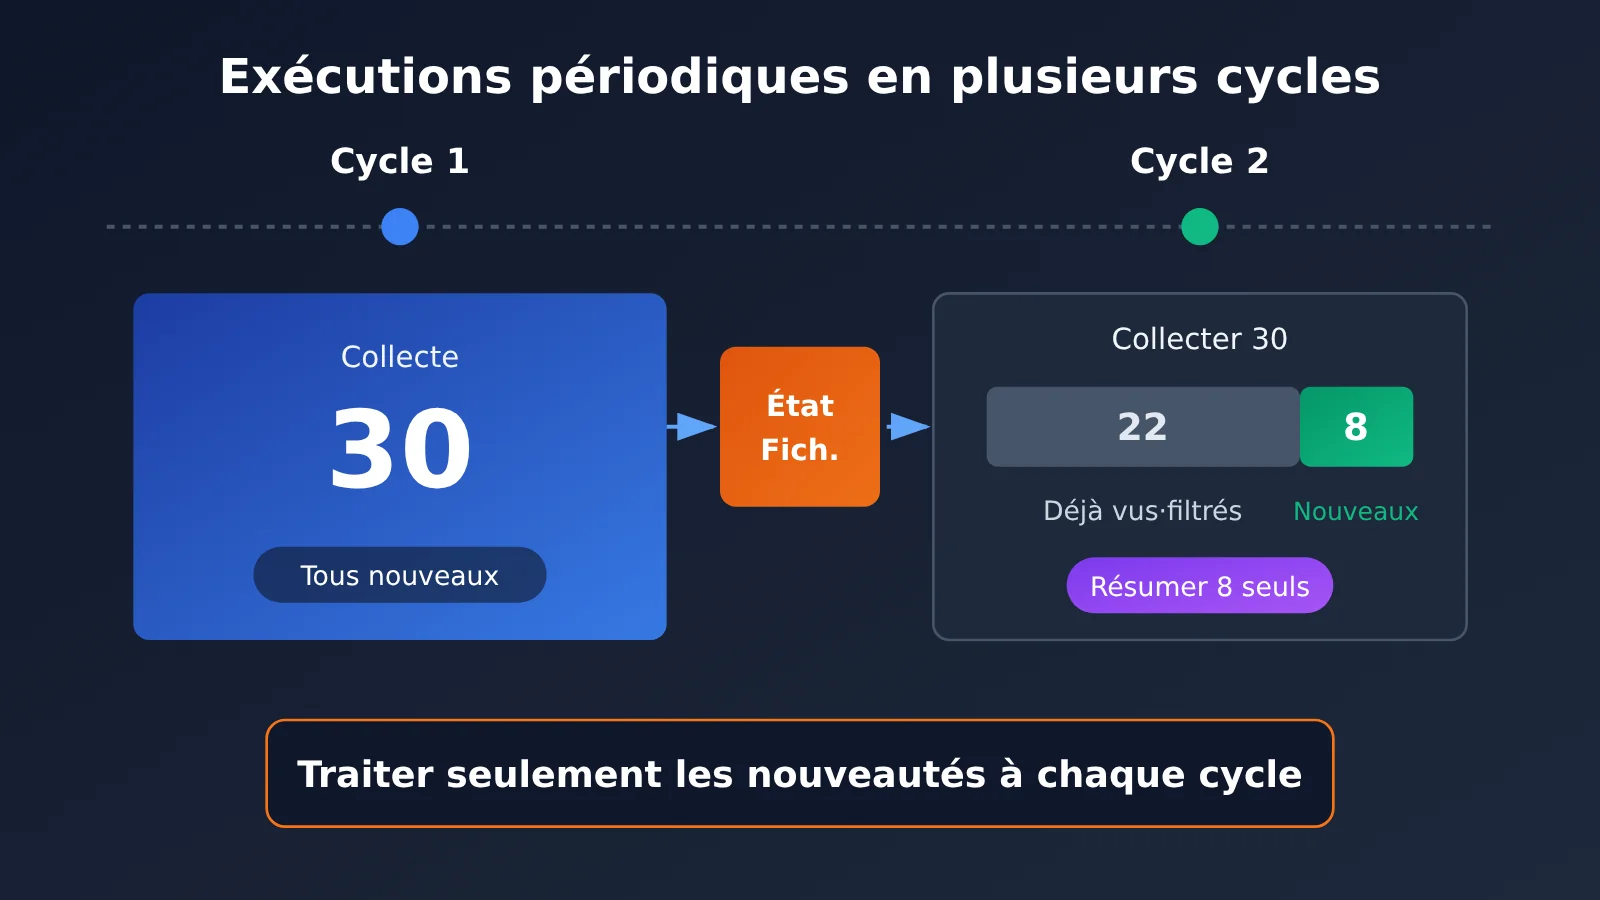
| Gestion de l’état | Enregistrer les éléments déjà traités pour éviter les résumés en double | Moins d’appels au modèle et des résultats plus lisibles |
| Découplage de la couche d’invocation du modèle | Le code métier dépend uniquement d’une interface de résumé, pas directement du SDK d’un fournisseur | Changer de modèle ou de fournisseur ne demande qu’une modification de la configuration |
| Protocole compatible OpenAI | Utiliser le format unifié Chat Completions comme base de la couche d’invocation | Un écosystème mature, compatible avec les modèles de plusieurs fournisseurs |
| Choix du modèle selon la tâche | Pour le résumé, évaluer la longueur du contexte, le respect des instructions, la stabilité et le coût | Éviter de payer trop cher pour une tâche simple |
Les quatre composants d’un agent de veille et de résumé
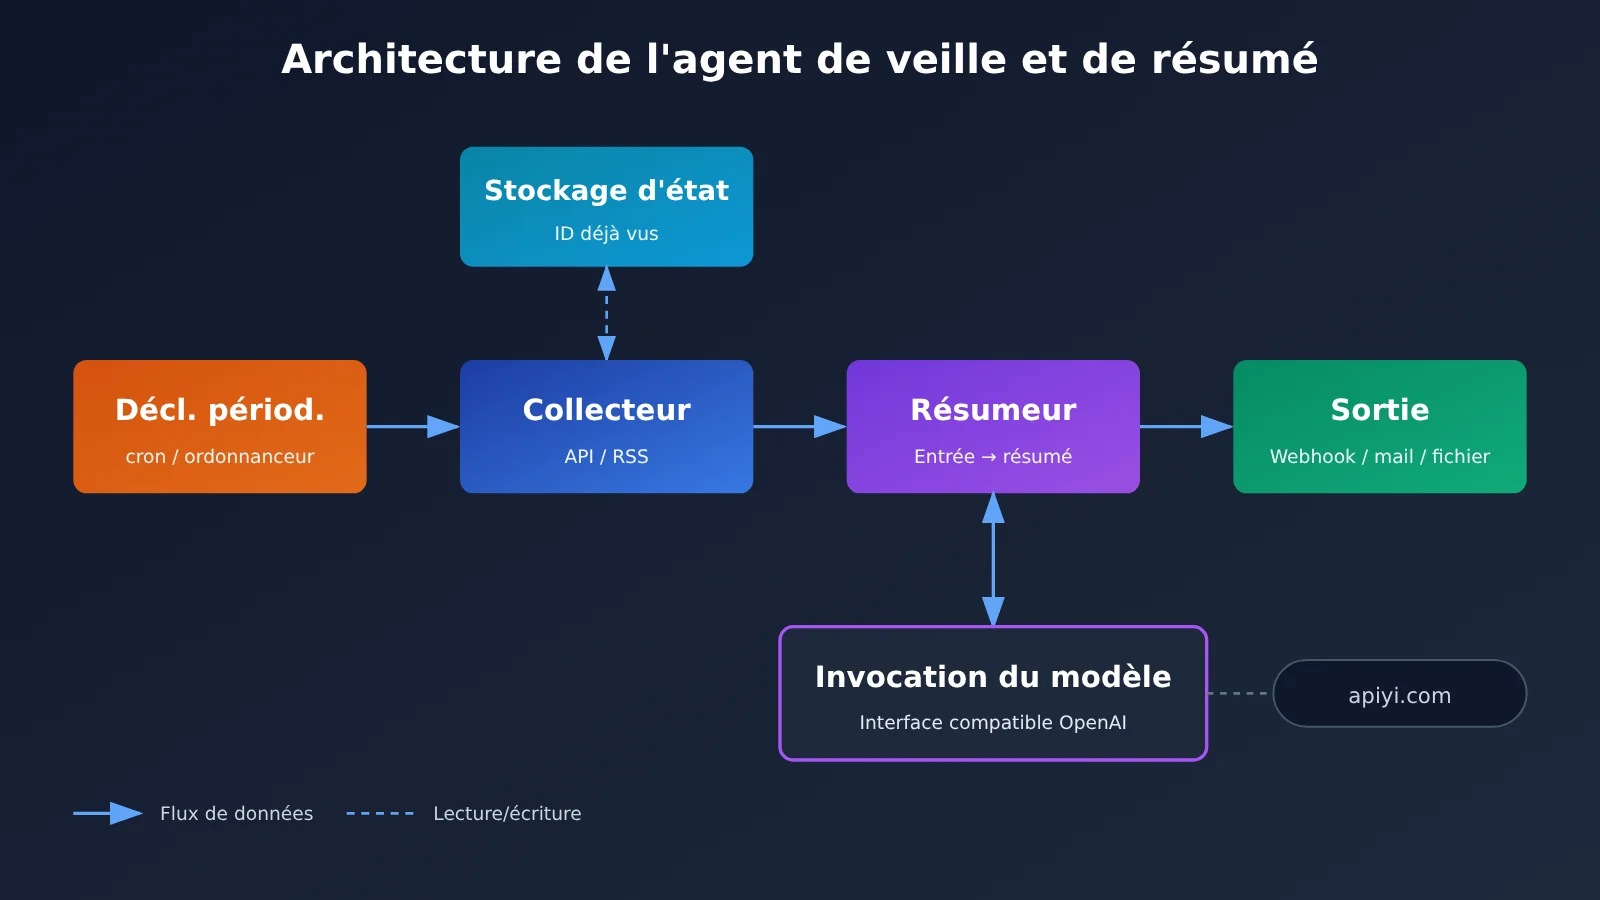
Un « agent permanent » est essentiellement un pipeline réveillé à intervalles réguliers par un planificateur. Il n’a pas besoin d’un raisonnement complexe en plusieurs étapes, mais il doit être très fiable : personne ne surveille son exécution en permanence. Le découper en quatre composants aux responsabilités claires est une condition essentielle pour qu’il fonctionne durablement.
| Composant | Rôle | Implémentations courantes | Points de conception |
|---|---|---|---|
| Déclencheur planifié | Lancer la tâche à intervalles réguliers | cron, timer systemd, planificateur de fonction cloud, workflow CI planifié, bibliothèque de planification intégrée au processus | Séparer le déclenchement de la logique métier et permettre une nouvelle exécution en cas d’échec |
| Collecteur de données | Récupérer les nouveaux contenus auprès des sources | API publique, RSS, extraction de pages web | Définir un délai d’expiration, limiter le nombre d’éléments et enregistrer les ID déjà vus |
| Générateur de résumés | Appeler un grand modèle de langage pour produire un résumé | Interface Chat Completions | Limiter la taille des entrées, utiliser une invite fixe et imposer un format de sortie |
| Diffuseur | Envoyer le résultat là où il sera consulté | Courriel, webhook de bot de messagerie instantanée, fichier Markdown, base de données | Prévoir une solution de repli si l’envoi échoue, par exemple enregistrer le résultat sur disque |
Ces quatre composants communiquent uniquement au moyen de structures de données simples : le collecteur produit une « liste d’éléments », le générateur produit un « texte de résumé » et le diffuseur prend ce texte en charge. Cette conception permet d’isoler les problèmes : si la qualité des résumés est mauvaise, on ajuste uniquement le générateur ; si l’envoi échoue, on vérifie uniquement le diffuseur.
Dans une première version, on a souvent tendance à réunir toute la logique dans un seul script. Ça fonctionne, mais c’est difficile à maintenir. Dès qu’on veut remplacer Hacker News par GitHub Trending ou changer de fournisseur de modèle, il faut modifier une grande partie du code. Avec une architecture par composants, ajouter une source d’information revient à créer un collecteur, et changer la couche de modèle ne demande qu’une modification de la configuration.
Choisir le déclenchement planifié de l’agent de surveillance et de synthèse
C’est le déclenchement planifié qui permet à l’agent de rester actif dans la durée. Dans son tutoriel, OpenRouter utilise un processus permanent, mais plusieurs options sont possibles en production. Le bon choix dépend surtout de votre infrastructure existante.
| Mode de déclenchement | Fonctionnement | Avantages | Points d’attention |
|---|---|---|---|
| Cron système | Lance un nouveau processus à chaque exécution, qui s’arrête une fois le travail terminé | Simple et fiable ; pas de processus permanent ni de fuite de mémoire persistante | L’état doit être enregistré sur disque et les variables d’environnement configurées séparément |
| Bibliothèque de planification intégrée au processus | Processus permanent qui exécute les tâches à intervalles réguliers | Facilite le partage des connexions et du cache | Nécessite un mécanisme de supervision en cas de plantage, comme systemd ou une politique de redémarrage des conteneurs |
| Planificateur de fonctions cloud | Déclenchement planifié sans serveur à gérer | Pas de maintenance serveur, facturation à l’appel | Durée d’exécution limitée et état à stocker à l’extérieur |
| Workflow CI planifié | Exécution programmée sur une plateforme CI | Aucun coût de serveur, journaux consultables | Déclenchement parfois retardé, peu adapté aux tâches fréquentes |
Pour une synthèse exécutée toutes les heures ou tous les jours, cron associé à un script qui s’arrête une fois son travail terminé offre généralement le meilleur rapport simplicité-coût. Cette approche évite naturellement l’accumulation de mémoire d’un processus permanent et, en cas d’échec, une nouvelle tentative aura lieu à l’exécution suivante. Un processus permanent devient surtout intéressant si vous avez besoin d’une surveillance à la minute ou si vous devez partager des ressources coûteuses entre plusieurs exécutions.
Comment découpler la couche d’invocation du modèle d’un agent de synthèse de veille
C’est le point central de cet article. Le tutoriel d’OpenRouter utilise son propre SDK, @openrouter/agent, ce qui facilite la prise en main. Mais les informations publiques disponibles ne précisent pas si ce SDK prend en charge les endpoints personnalisés compatibles avec OpenAI. Nous ne l’avons pas vérifié non plus : nous n’aborderons donc pas son raccordement à d’autres plateformes.
Adoptons plutôt une autre approche : au lieu de rendre le code métier directement dépendant du SDK d’un fournisseur, ajoutons une fine couche intermédiaire sous forme d’« interface de synthèse ». Le code métier appelle uniquement summarize(items) ; le choix du modèle et de l’endpoint est entièrement géré par cette couche, selon la configuration.
Concevoir l’interface de la couche d’invocation
La conception de cette couche repose sur trois principes simples, qui peuvent éviter beaucoup de travail par la suite :
- Exposer uniquement la logique métier : fournir
summarize(items) -> strsans laisser les paramètres de bas niveau, commemessagesoutemperature, se propager dans le code métier. - Utiliser un protocole commun en interne : employer le format Chat Completions compatible avec OpenAI, avec
base_url,api_keyetmodellus dans les variables d’environnement. - Prévoir un mode de repli : en cas d’échec, réessayer un nombre limité de fois, puis renvoyer la liste brute des titres si l’appel échoue toujours. On dispose ainsi au moins d’un résultat lisible pour la journée.
Le protocole compatible avec OpenAI constitue une bonne base parce qu’il est devenu un format de référence dans les faits : le SDK officiel et de nombreux outils tiers permettent de modifier base_url. Tant que le serveur prend en charge ce format, changer de modèle revient à modifier une ligne de configuration.
| Choix d’interface | Coût d’un changement de modèle | Écosystème et outils | Cas d’usage |
|---|---|---|---|
| SDK d’agent propre à un fournisseur | Changer de fournisseur nécessite généralement de modifier le code | Fonctionnalités intégrées au SDK, prêtes à l’emploi | Utilisation à long terme d’une plateforme déjà choisie, avec un intérêt pour ses fonctions intégrées |
| SDK officiel OpenAI + endpoint compatible | Il suffit de modifier base_url et model |
Écosystème le plus mature, avec le plus d’exemples | La plupart des tâches de synthèse de veille |
| Appels HTTP encapsulés dans une couche maison | Il suffit de modifier la configuration, mais la maintenance reste à votre charge | Minimum de dépendances | Environnements où la taille des dépendances est une contrainte majeure |
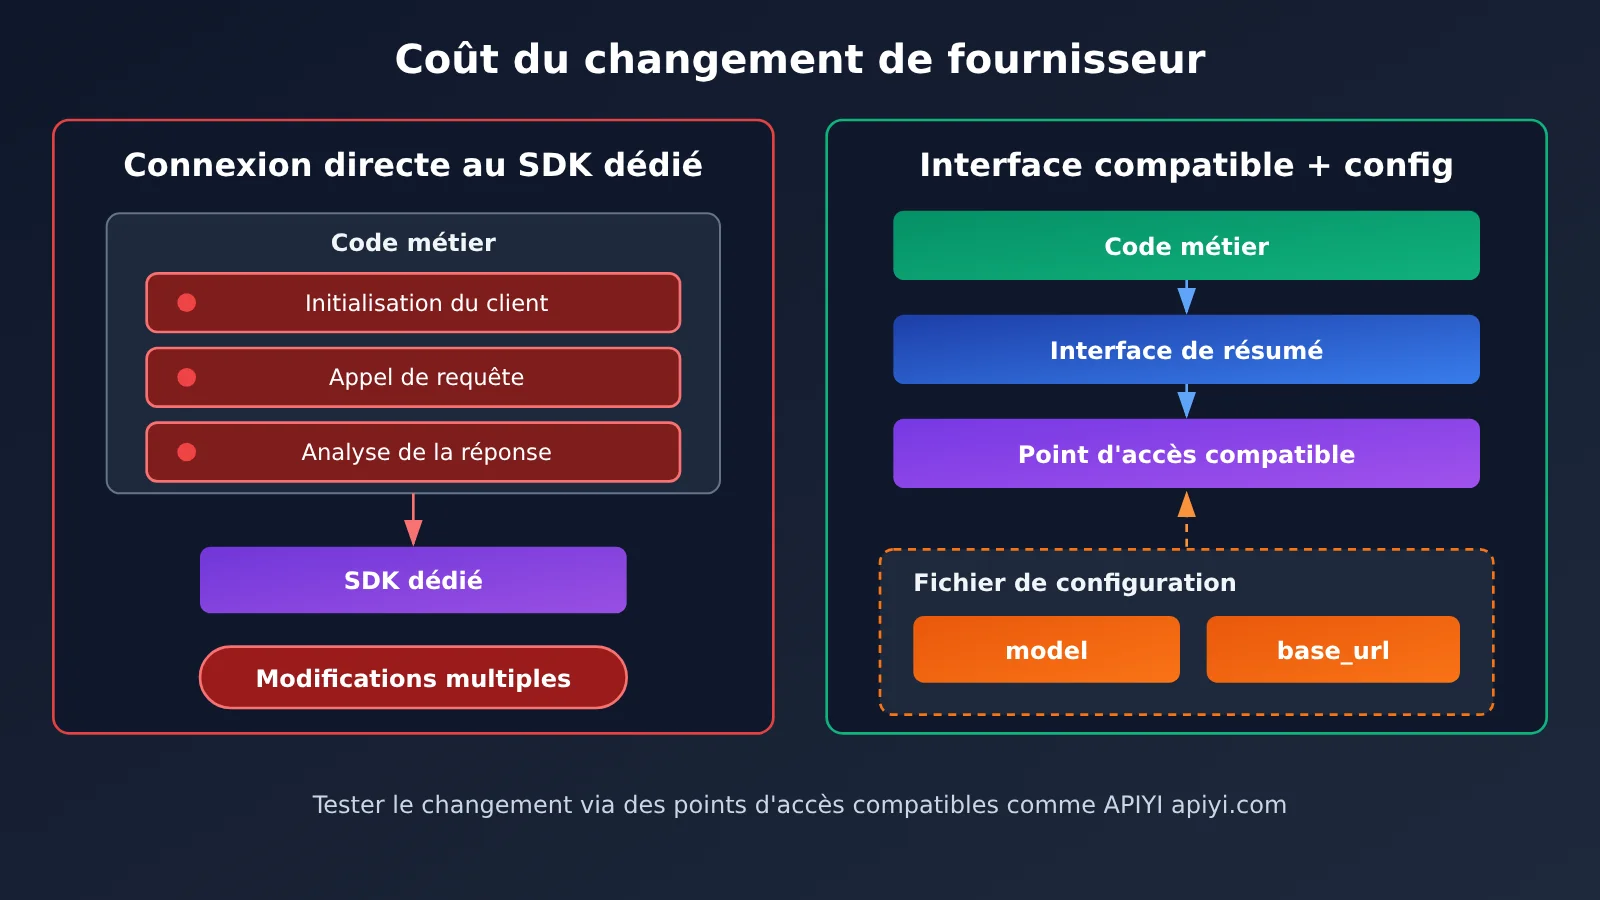
Avec cette architecture, une plateforme d’agrégation comme APIYI peut servir d’option pour la couche d’invocation du modèle. APIYI est compatible avec le format de l’API OpenAI et prend en charge le SDK officiel OpenAI ; pour changer de modèle, il suffit de modifier son nom. Pour un agent de synthèse de veille, cela signifie que vous pouvez comparer les synthèses de différents modèles avec une même clé API, sans écrire une intégration distincte pour chaque fournisseur.
Comment choisir un modèle pour les résumés de veille
Les tâches de résumé semblent simples, mais les exigences varient beaucoup selon les sources d’information. Nous ne disposons pas encore de données de test systématiques pour ce type de tâche. Plutôt que de désigner « le meilleur modèle », voici les critères à mettre en balance.
| Critère | Pourquoi c’est important | Conseil pratique |
|---|---|---|
| Longueur du contexte | Il faut parfois fournir des dizaines de titres, voire le texte intégral des articles | Réduisez d’abord la taille des entrées, puis choisissez un modèle adapté à leur longueur |
| Respect des instructions | Les résumés doivent suivre un format fixe pour faciliter leur diffusion et leur analyse | Effectuez plusieurs essais avec une invite identique et vérifiez que le format reste stable |
| Compétences linguistiques | Les sources en anglais doivent être résumées en chinois | Vérifiez surtout que les termes techniques sont traduits avec précision |
| Coût des appels | Les tâches planifiées tournent sur la durée et les frais s’accumulent | Limitez-vous à un appel par exécution et maîtrisez le nombre d’éléments en entrée ainsi que la longueur des réponses |
| Stabilité du service | En l’absence de supervision, un échec peut ne passer inaperçu que le lendemain | Configurez des tentatives de réessai et un mécanisme de repli, et prévoyez un modèle de secours |
💡 Conseil : il n’existe pas de modèle de résumé idéal pour tous les cas. Le plus fiable est de comparer plusieurs modèles pendant quelques jours avec vos propres sources. Sur APIYI apiyi.com, utilisez le même code pour passer d’un modèle candidat à l’autre, puis comparez la stabilité du format et la qualité de l’expression en chinois avant de choisir celui que vous utiliserez à long terme.
Premiers pas avec un agent de veille et de synthèse
Voici une version minimale en Python. Elle utilise l’API publique de Hacker News (hacker-news.firebaseio.com/v0), comme dans le tutoriel OpenRouter, pour faciliter la comparaison.
Exemple minimal : récupérer et résumer
Ce code récupère les 10 titres les plus populaires de Hacker News et les transmet au modèle pour générer un résumé en chinois. Il permet de vérifier que toute la chaîne fonctionne :
import requests
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI 兼容端点
)

HN = "https://hacker-news.firebaseio.com/v0"
ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:10]
titles = [requests.get(f"{HN}/item/{i}.json", timeout=10).json().get("title", "") for i in ids]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 示例模型名,以平台模型列表为准
    messages=[{"role": "user", "content": "用中文分 3 点总结这些热帖的主题:\n" + "\n".join(titles)}]
)
print(resp.choices[0].message.content)
Ce code fonctionne, mais il n’est pas encore prêt à tourner en continu : il ne gère ni les doublons ni les échecs, et le modèle comme le point de terminaison sont définis en dur. La version complète ci-dessous sépare les quatre composants et ajoute une gestion de l’état.
Voir le code complet (quatre composants + déduplication + solution de repli)
import json
import os
import time
from pathlib import Path

import openai
import requests

HN = "https://hacker-news.firebaseio.com/v0"
STATE_FILE = Path(os.getenv("STATE_FILE", "seen_ids.json"))
TOP_N = int(os.getenv("TOP_N", "30"))


# ---------- 数据获取器 ----------
def fetch_new_stories(seen: set) -> list:
    ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:TOP_N]
    items = []
    for i in ids:
        if i in seen:
            continue
        item = requests.get(f"{HN}/item/{i}.json", timeout=10).json() or {}
        if item.get("title"):
            items.append({"id": i, "title": item["title"],
                          "url": item.get("url", ""), "score": item.get("score", 0)})
    return items


# ---------- 状态管理 ----------
def load_seen() -> set:
    return set(json.loads(STATE_FILE.read_text())) if STATE_FILE.exists() else set()

def save_seen(seen: set) -> None:
    STATE_FILE.write_text(json.dumps(sorted(seen)[-2000:]))  # 只保留最近的 ID


# ---------- 摘要器(模型调用层) ----------
class Summarizer:
    def __init__(self):
        self.client = openai.OpenAI(
            api_key=os.environ["LLM_API_KEY"],
            base_url=os.getenv("LLM_BASE_URL", "https://api.apiyi.com/v1"),
        )
        self.model = os.getenv("SUMMARY_MODEL", "gpt-4o-mini")

    def summarize(self, items: list, retries: int = 2) -> str:
        lines = "\n".join(f"- [{x['score']}] {x['title']}" for x in items)
        prompt = ("你是技术资讯编辑。请用中文把下面的 Hacker News 新热帖归纳为 3-5 个主题,"
                  "每个主题一句话,并列出最值得关注的 3 条标题。\n" + lines)
        for attempt in range(retries + 1):
            try:
                resp = self.client.chat.completions.create(
                    model=self.model,
                    messages=[{"role": "user", "content": prompt}],
                    max_tokens=800,
                )
                return resp.choices[0].message.content
            except Exception as e:
                print(f"摘要失败(第 {attempt + 1} 次):{e}")
                time.sleep(2 ** attempt)
        return "【模型暂不可用,以下为原始标题】\n" + lines  # 降级输出


# ---------- 输出器 ----------
def deliver(text: str) -> None:
    webhook = os.getenv("WEBHOOK_URL")
    if webhook:
        try:
            requests.post(webhook, json={"text": text}, timeout=10).raise_for_status()
            return
        except Exception as e:
            print(f"推送失败,改为落盘:{e}")
    Path(f"digest-{time.strftime('%Y%m%d-%H%M')}.md").write_text(text, encoding="utf-8")


# ---------- 一次运行(由定时器触发) ----------
def run_once() -> None:
    seen = load_seen()
    items = fetch_new_stories(seen)
    if not items:
        print("没有新条目,本轮跳过")
        return
    deliver(Summarizer().summarize(items))
    save_seen(seen | {x["id"] for x in items})


if __name__ == "__main__":
    run_once()
Quelques choix de conception de cette version complète méritent d’être expliqués. D’abord, Summarizer n’expose que summarize : le nom du modèle, le point d’accès et la clé API proviennent tous de variables d’environnement. C’est le découplage de la couche d’invocation évoqué plus haut. Ensuite, le fichier d’état ne conserve que les derniers ID pour éviter qu’il ne grossisse indéfiniment. Enfin, si le modèle échoue, les titres d’origine sont renvoyés ; si l’envoi échoue, le résultat est enregistré sur disque. Chaque exécution laisse ainsi une trace exploitable.
Déploiement planifié de l’agent de synthèse
Le script est conçu pour s’exécuter une fois, puis s’arrêter. On peut donc le confier directement à cron. La configuration suivante le lance chaque jour à 8 h et à 20 h :
# crontab -e
0 8,20 * * * cd /opt/hn-digest && LLM_API_KEY=xxx SUMMARY_MODEL=gpt-4o-mini /usr/bin/python3 agent.py >> run.log 2>&1
Pour comparer un autre modèle, il suffit de remplacer SUMMARY_MODEL par son nom, sans modifier une ligne de code. En production, mieux vaut placer la clé dans un fichier .env ou un service de gestion des secrets, plutôt que de l’écrire directement dans crontab.
🚀 Pour démarrer rapidement : vérifiez d’abord que tout fonctionne avec un exemple minimal, puis passez à la version complète et intégrez-la à cron. APIYI apiyi.com propose aux nouveaux utilisateurs un crédit d’essai gratuit. Une seule clé permet de passer d’un modèle OpenAI à Claude, Gemini ou d’autres modèles : pratique pour comparer rapidement la qualité des résumés pendant le prototypage.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce qu’un agent de veille et de synthèse exécuté à intervalles réguliers ?
C’est un programme automatisé qu’un planificateur réveille périodiquement : il récupère les nouveaux contenus de sources d’information, les transmet à un grand modèle de langage pour les résumer, puis envoie la synthèse par courriel ou messagerie instantanée, ou l’enregistre dans un fichier. Contrairement à un agent conversationnel, il fonctionne sans surveillance sur le long terme : la stabilité et la déduplication sont donc plus importantes qu’un raisonnement complexe.
Q2 : Quelle différence entre un SDK d’agent dédié et une interface compatible avec OpenAI ?
Un SDK dédié intègre souvent l’appel d’outils, la planification et d’autres fonctionnalités, ce qui facilite le démarrage. En contrepartie, le code métier devient lié à la plateforme. Une interface compatible avec OpenAI est plus bas niveau : il faut gérer soi-même la planification et la déduplication, mais il suffit ensuite de modifier la configuration pour changer de modèle ou de fournisseur. Pour une tâche de synthèse simple, cette flexibilité est généralement plus utile.
Q3 : Peut-on adapter directement le tutoriel @openrouter/agent d’OpenRouter à une autre plateforme ?
Les informations de synthèse publiées indiquent seulement que ce tutoriel utilise `@openrouter/agent` 0.11.0 avec TypeScript. Elles ne précisent pas si le SDK prend en charge un point de terminaison personnalisé, et nous ne l’avons pas vérifié. Si vous souhaitez garder la possibilité de changer de plateforme, mieux vaut vous inspirer du cas d’usage et réaliser votre propre implémentation avec une couche d’appel compatible avec OpenAI, comme dans cet article.
Q4 : À quels cas d’usage concrets un agent de veille et de synthèse convient-il ?
– **Bilan quotidien des discussions populaires dans les communautés techniques** : synthèse des sujets du jour sur Hacker News ou les forums techniques
– **Suivi des concurrents** : surveillance des blogues ou journaux des modifications des concurrents et synthèse des nouveautés
– **Actualités des projets open source** : regroupement des nouvelles versions et des issues importantes des dépôts suivis
– **Bulletin matinal sectoriel** : agrégation de plusieurs flux RSS et envoi chaque matin d’un bulletin en chinois
Q5 : Comment appeler rapidement un modèle par API pour produire une synthèse ?
Nous recommandons d’utiliser une plateforme d’agrégation compatible avec le format OpenAI :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et obtenir une clé API ainsi qu’un crédit d’essai gratuit
2. Définissez `base_url` dans le code de cet article sur `https://api.apiyi.com/v1`
3. Utilisez la variable d’environnement `SUMMARY_MODEL` pour changer de modèle et comparer la qualité des synthèses
Q6 : Comment maîtriser le coût des appels sur le long terme ?
L’idée est de ne traiter que les nouveaux éléments et de n’appeler le modèle qu’une fois par exécution. Utilisez un fichier d’état pour filtrer les éléments déjà vus, limitez le nombre d’éléments en entrée et `max_tokens`, puis réglez la fréquence d’exécution selon vos besoins. Les prix varient beaucoup d’un modèle à l’autre : comparez-les sur la page des tarifs des modèles d’APIYI apiyi.com pour choisir un modèle plus économique pour une tâche légère comme la synthèse.
Q7 : Quelles sont les limites connues d’un agent de veille et de synthèse ?
– **Les titres seuls donnent peu d’informations** : une synthèse fondée uniquement sur les titres peut mal interpréter le contenu. Au besoin, récupérez le texte complet, en faisant attention à la longueur des entrées et au respect des règles de collecte
– **Le modèle peut inventer des détails** : l’invite doit lui demander de s’appuyer uniquement sur le contenu fourni ; conservez les liens d’origine pour les conclusions importantes
– **Les sources d’information peuvent changer** : une modification du format d’une interface ou des limites de débit peut faire échouer la collecte ; il faut donc surveiller les journaux d’exécution
Agent de synthèse et de veille : points clés
- Une structure en quatre étapes : le déclenchement planifié, la récupération des données, la synthèse par le modèle et la sortie des résultats sont indépendants, ce qui facilite leur remplacement et le diagnostic des problèmes
- Terminer puis quitter est plus fiable : pour les synthèses peu fréquentes, un script ponctuel lancé par cron est plus simple à gérer qu’un processus permanent
- Le suivi de l’état détermine la qualité : enregistrez les ID déjà vus et ne résumez que les nouveautés à chaque exécution pour éviter les répétitions et le gaspillage
- Découplez la couche d’invocation : la logique métier dépend uniquement de l’interface
summarize; le modèle, le point de terminaison et la clé proviennent tous de la configuration - Appuyez-vous sur un protocole compatible : le format compatible OpenAI permet de changer de modèle en modifiant une seule variable d’environnement
- Choisissez le modèle par des tests : comparez la fenêtre de contexte, le respect des instructions, la langue, le coût et la stabilité. Sur APIYI apiyi.com, vous pouvez passer d’un modèle à l’autre avec le même code pour les tester
- Prévoyez des solutions de repli : si le modèle échoue, affichez les titres d’origine ; si l’envoi échoue, enregistrez les résultats sur disque
Conclusion
Pour créer un Agent de synthèse et de veille qui s’exécute à intervalles réguliers, l’essentiel n’est pas d’utiliser un framework complexe, mais de bien séparer les étapes :
- Séparation des composants : le déclenchement, la récupération, la synthèse et la sortie sont reliés par des structures de données simples ; chaque étape peut être testée séparément
- Découplage des interfaces : une fine couche d’interface de synthèse isole le SDK utilisé, avec le protocole compatible OpenAI en dessous
- Priorité à la fiabilité : la déduplication, les nouvelles tentatives et les solutions de repli sont indispensables pour une tâche qui fonctionne sans surveillance
Le tutoriel Hacker News d’OpenRouter fournit un bon exemple de cas d’usage. L’architecture générique présentée ici vous permet de reprendre la même approche avec n’importe quelle source d’information et n’importe quel modèle. Commencez par faire fonctionner toute la chaîne avec un exemple minimal, puis configurez cron pour l’exécuter pendant quelques jours. Observez ensuite la qualité des synthèses avant de choisir le modèle à utiliser à long terme.
Pour vérifier rapidement les résultats, vous pouvez utiliser APIYI apiyi.com : une seule clé API permet de passer d’un grand modèle de langage à l’autre. Les nouveaux utilisateurs disposent aussi de crédits de test gratuits pour comparer les modèles pendant la phase de prototypage.
📚 Références
- Résumé du tutoriel OpenRouter : créer un agent IA permanent avec l’Agent SDK pour surveiller Hacker News
- Lien :
aihot.news/items/upl3hjjdokqe13w3ieo9opr0v -
Description : point de départ de cet article, qui présente la création en TypeScript d’un agent exécuté à intervalles réguliers avec
@openrouter/agent0.11.0 -
API officielle de Hacker News : interface de données publique en lecture seule
- Lien :
github.com/HackerNews/API -
Description : documentation de la source de données utilisée dans les exemples, avec les champs des endpoints topstories et item
-
SDK Python d’OpenAI : bibliothèque cliente officielle
- Lien :
github.com/openai/openai-python - Description : explique comment se connecter à un endpoint compatible avec le paramètre
base_url
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour plus de ressources sur l’intégration, consultez la documentation sur docs.apiyi.com.