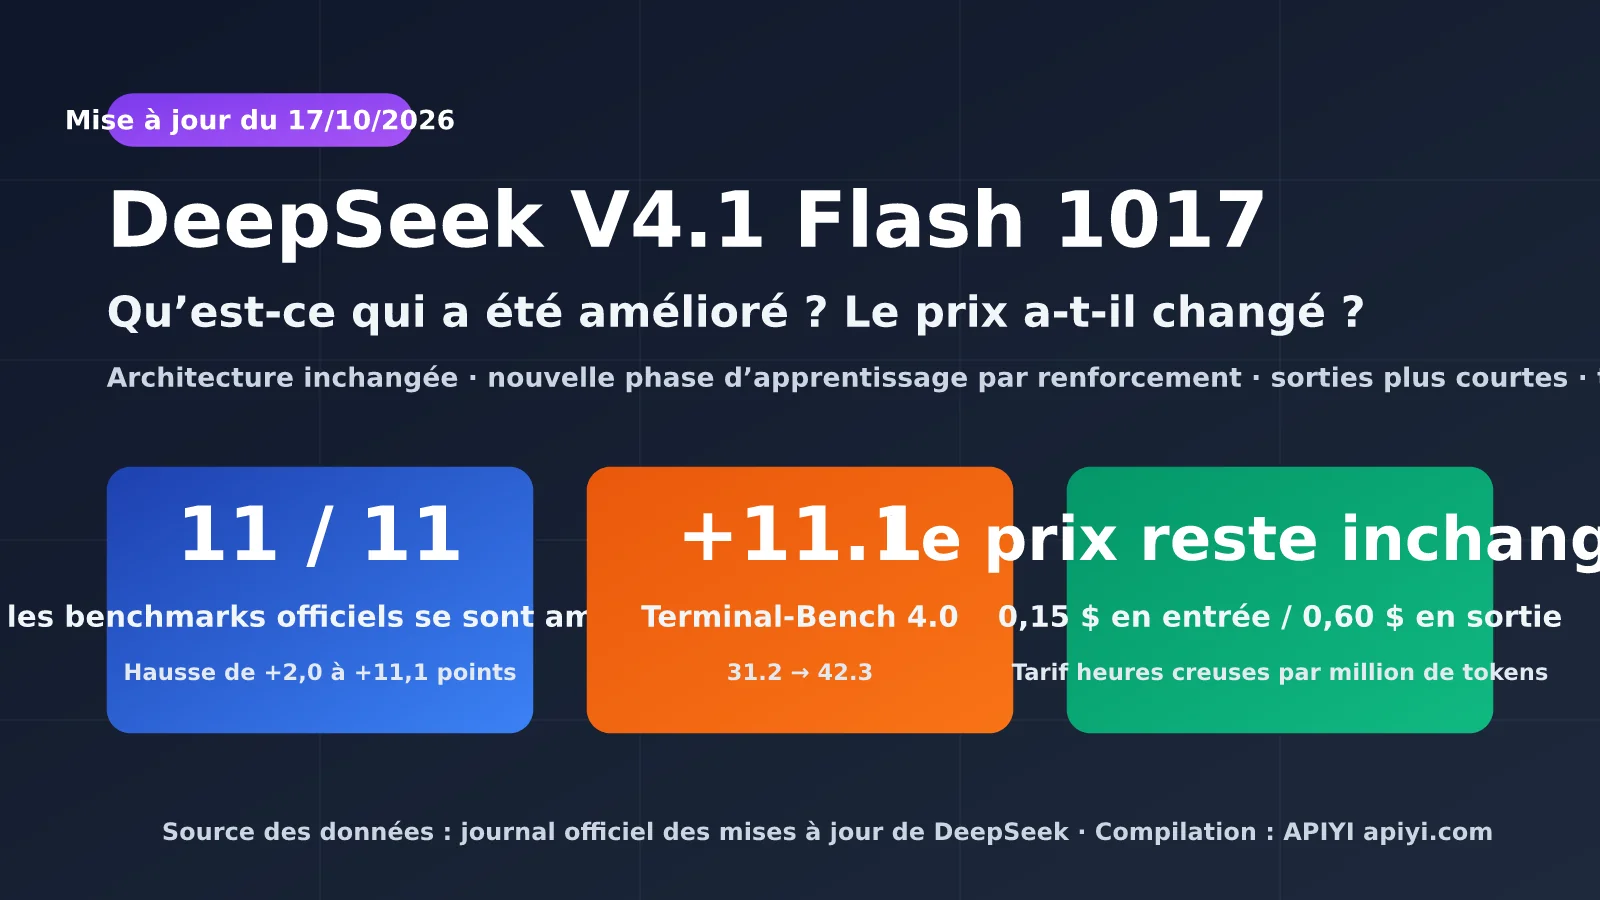
Le 17 octobre 2026, DeepSeek a discrètement mis à niveau V4.1 Flash vers DeepSeek-V4.1-Flash-1017. La société présente cette mise à jour comme une évolution mineure. Pourtant, d’après les chiffres publiés, les 11 benchmarks officiels sont en hausse, et Terminal-Bench 4.0 gagne 11,1 points : difficile de parler d’un simple ajustement.
La plupart des développeurs se posent surtout deux questions : qu’est-ce qui a changé dans DeepSeek V4.1 Flash 1017 ? Le prix a-t-il évolué ? Cet article s’appuie uniquement sur le journal des mises à jour officiel de DeepSeek, sa page tarifaire et la fiche du modèle sur Hugging Face. Les informations provenant de tiers sont signalées séparément.
À retenir : vous découvrirez l’ampleur réelle des progrès de la version 1017, pourquoi un « prix inchangé » signifie en réalité une baisse du coût, et comment réduire de moitié vos dépenses d’API DeepSeek en décalant vos appels vers les heures creuses.
DeepSeek V4.1 Flash 1017 : une mise à jour mineure sans changement d’architecture
DeepSeek V4.1 Flash est le modèle le plus compact de la nouvelle famille d’architectures lancée le 10 septembre 2026. Il prend nativement en charge la compréhension des images. La version 1017 est sa première itération, environ un mois après sa sortie. Le journal des mises à jour officiel est succinct : le modèle passe à DeepSeek-V4.1-Flash-1017, les versions Web et application sont mises à jour en même temps, et les modalités d’appel de l’API ainsi que les prix restent inchangés.
D’après les informations techniques publiées sur Hugging Face, la version 1017 conserve la même architecture : 552 milliards de paramètres pour le modèle principal, environ 8 milliards de paramètres activés par jeton lors du préremplissage et 16 milliards pendant le décodage, auxquels s’ajoutent 196 milliards de paramètres de mémoire conditionnelle Engram. Selon les analyses généralement partagées dans les communautés anglophones, les changements seraient dus à une nouvelle phase de post-entraînement par apprentissage par renforcement. La configuration, le tokenizer et l’encodage des invites n’ont pas été modifiés : le code existant ne nécessite donc aucune adaptation.
| Élément | DeepSeek V4.1 Flash 1017 | Détails |
|---|---|---|
| Date de sortie | 2026-10-17 | Première itération depuis la sortie initiale du 10 septembre |
| Nom du modèle API | deepseek-flash |
Cet alias pointe automatiquement vers la version la plus récente |
| Anciens noms de modèle | deepseek-v4-flash, etc. |
Toujours utilisables, ils sont redirigés vers la version 1017 et facturés au tarif Flash |
| Architecture | MoE, 552B de paramètres principaux, 8B/16B activés | Identique à la version initiale |
| Contexte / sortie maximale | 1M / 384K | Données de la page tarifaire officielle |
| Mode de raisonnement | Avec raisonnement (par défaut) et sans raisonnement | Les deux modes sont disponibles |
| Multimodal | Entrées d’images prises en charge | La version Pro ne prend pas encore en charge les images |
| Licence open source | MIT | Les poids sont disponibles sur Hugging Face et ModelScope |
| Limite de concurrence | 2 500 | 500 pour la version Pro |
Un point mérite d’être souligné : DeepSeek indique que la version 1017 a été optimisée pour DeepSeek Harness, Tencent CodeBuddy et WorkBuddy. La société recommande d’utiliser DeepSeek Harness 0.2.1-rc.1 ou une version ultérieure. Cela indique que l’entraînement a surtout ciblé les scénarios de programmation avec des agents. Si vous utilisez votre propre boucle d’agent, les gains réels pourraient être moins importants que ceux annoncés dans les chiffres officiels.
🎯 Conseil technique : l’alias du modèle pointe automatiquement vers la nouvelle version. Avant d’y transférer votre trafic de production, effectuez des tests de régression avec des exemples représentatifs de vos propres usages. APIYI (apiyi.com) permet d’appeler DeepSeek et d’autres modèles de premier plan à l’aide d’une même clé, ce qui facilite leur comparaison dans un seul et même script d’évaluation.
Quelles améliorations apporte DeepSeek V4.1 Flash 1017 ? Comparaison de 11 benchmarks
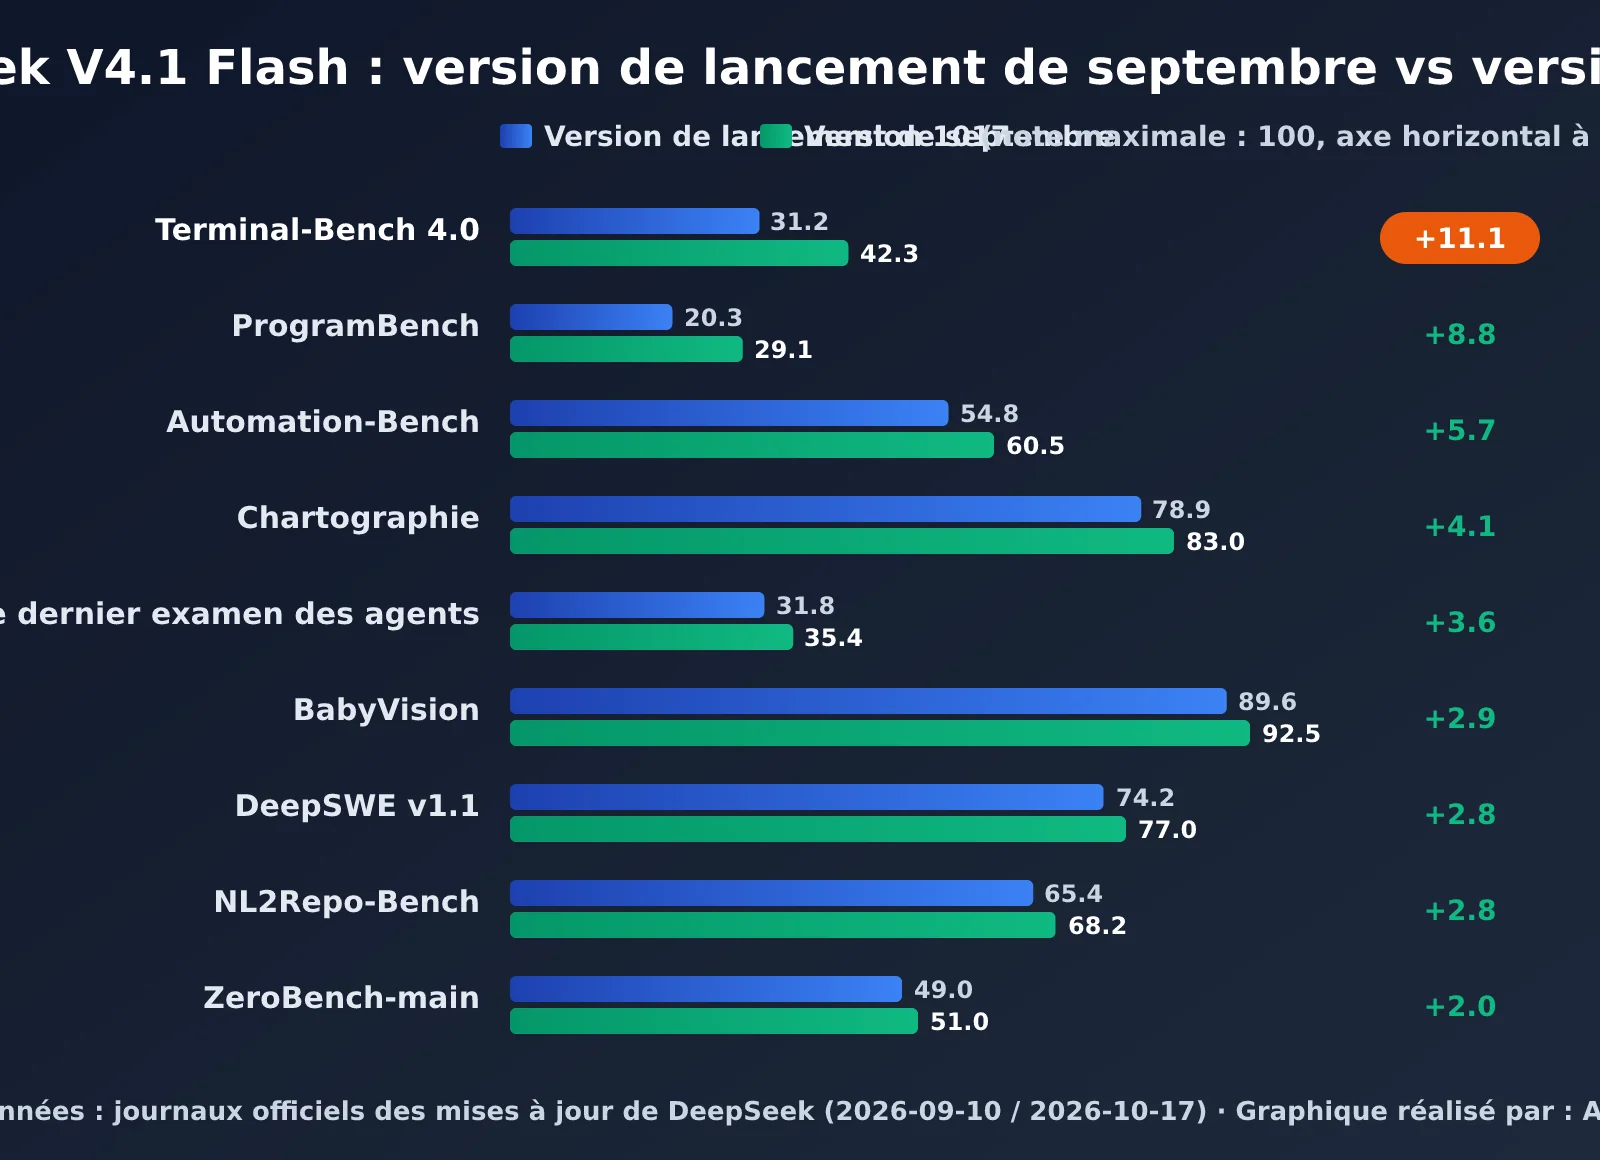
Pour répondre à la question « qu’est-ce qui a été amélioré ? », le plus simple est de comparer les résultats de la version initiale de septembre et ceux de la version 1017 d’octobre. Les données du tableau proviennent toutes du journal des mises à jour officiel de DeepSeek. Le journal ne mentionnant pas l’ancien score d’Apex Bench, celui-ci est tiré d’une compilation de la communauté anglophone et reste donc indicatif.
| Benchmark | Capacité évaluée | Version initiale de septembre | Version 1017 | Progression |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Tâches d’agent en terminal | 31.2 | 42.3 | +11.1 |
| ProgramBench | Génération de programmes | 20.3 | 29.1 | +8.8 |
| Apex Bench v1.1 | Raisonnement général (ancien score issu d’une source tierce) | 64.6 | 72.1 | +7.5 |
| HLE (sans outils) | Raisonnement sur des connaissances complexes | 36.8 | 42.6 | +5.8 |
| Automation-Bench | Flux de travail automatisés | 54.8 | 60.5 | +5.7 |
| Chartography (avec outils) | Compréhension de graphiques | 78.9 | 83.0 | +4.1 |
| Agents’ Last Exam | Agent généraliste | 31.8 | 35.4 | +3.6 |
| BabyVision (avec outils) | Compréhension visuelle | 89.6 | 92.5 | +2.9 |
| DeepSWE v1.1 | Génie logiciel | 74.2 | 77.0 | +2.8 |
| NL2Repo-Bench | Génération de dépôts à partir du langage naturel | 65.4 | 68.2 | +2.8 |
| ZeroBench-main (avec outils) | Raisonnement visuel | 49.0 | 51.0 | +2.0 |
Trois tendances se dégagent du tableau. Premièrement, les plus fortes progressions concernent les tâches liées aux agents et à la programmation. Les hausses relatives de Terminal-Bench 4.0 et de ProgramBench dépassent toutes deux 35 %, ce qui correspond à l’annonce officielle d’une optimisation ciblant Harness et CodeBuddy. Deuxièmement, les benchmarks visuels progressent eux aussi de façon régulière, de 2 à 4 points : cet entraînement complémentaire n’a donc pas sacrifié les capacités multimodales. Enfin, les protocoles de test ne sont pas tout à fait identiques d’un benchmark à l’autre : la nouvelle version d’Automation-Bench est indiquée comme v1.0.6, tandis que la version initiale de HLE ne précise pas si les outils étaient autorisés. Il vaut donc mieux éviter de tirer des conclusions à partir d’un seul chiffre.
Les gains d’efficacité de DeepSeek V4.1 Flash 1017 : des réponses plus courtes et des tâches plus rapides
Au-delà des scores, DeepSeek insiste aussi sur une évolution facile à négliger : la version 1017 accomplit les tâches plus rapidement et produit des réponses plus courtes. Pour une API facturée au nombre de tokens, c’est tout aussi important que les scores : si une tâche génère moins de tokens, la facture diminue directement.
À noter toutefois que DeepSeek n’a pas publié le pourcentage exact de réduction, et que la communauté anglophone ne dispose pas encore de mesures comparatives fiables entre les deux versions. Le plus prudent est de mesurer l’évolution de usage.completion_tokens sur vos propres exemples métier et de vous appuyer sur ces données réelles pour évaluer les économies.
La communauté anglophone résume cette méthode d’entraînement par l’expression « programmation guidée par les objectifs » (Wish-Driven Programming) : le modèle réalise un projet de bout en bout, évalue lui-même son résultat par rapport à l’objectif, puis recommence pour l’améliorer. Parmi les exemples présentés par DeepSeek figurent une reconstitution 3D de la Cité interdite, un jeu de course dans un navigateur et une reproduction de Portal 2 avec Godot. Ces projets, qui mobilisent de longues chaînes d’actions, correspondent précisément à des benchmarks comme Terminal-Bench et ProgramBench, ce qui aide à comprendre pourquoi les scores liés aux agents ont le plus progressé.
Le prix de DeepSeek V4.1 Flash 1017 a-t-il changé ? Explications sur les tarifs heures creuses et heures de pointe
Pour aller droit au but : le prix de l’API DeepSeek V4.1 Flash 1017 n’a pas changé. Il est identique à celui de la version lancée en septembre. Mais il faut replacer ce « prix inchangé » dans son contexte : le tarif avait déjà baissé lors du lancement de septembre, et DeepSeek applique désormais deux grilles tarifaires, selon les heures creuses ou les heures de pointe. Le prix réel peut donc varier du simple au double selon le moment de l’appel.
| Poste facturé (par million de tokens) | Flash, heures creuses | Flash, heures de pointe | V4 Pro, heures creuses | V4 Pro, heures de pointe |
|---|---|---|---|---|
| Entrée (cache utilisé) | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrée (cache non utilisé) | $0.15 | $0.30 | $0.66 | $1.32 |
| Sortie | $0.60 | $1.20 | $1.98 | $3.96 |
Les heures de pointe définies par DeepSeek sont du lundi au vendredi, de 01:00 à 04:00 et de 06:00 à 10:00 UTC. En heure de Pékin, cela correspond aux jours ouvrés, de 09:00 à 12:00 et de 14:00 à 18:00. Les jours fériés légaux en Chine ne sont pas considérés comme des heures de pointe. Le reste du temps — la nuit, pendant la pause de midi, les week-ends et toute la journée les jours fériés — est facturé au tarif heures creuses, soit la moitié du tarif de pointe.
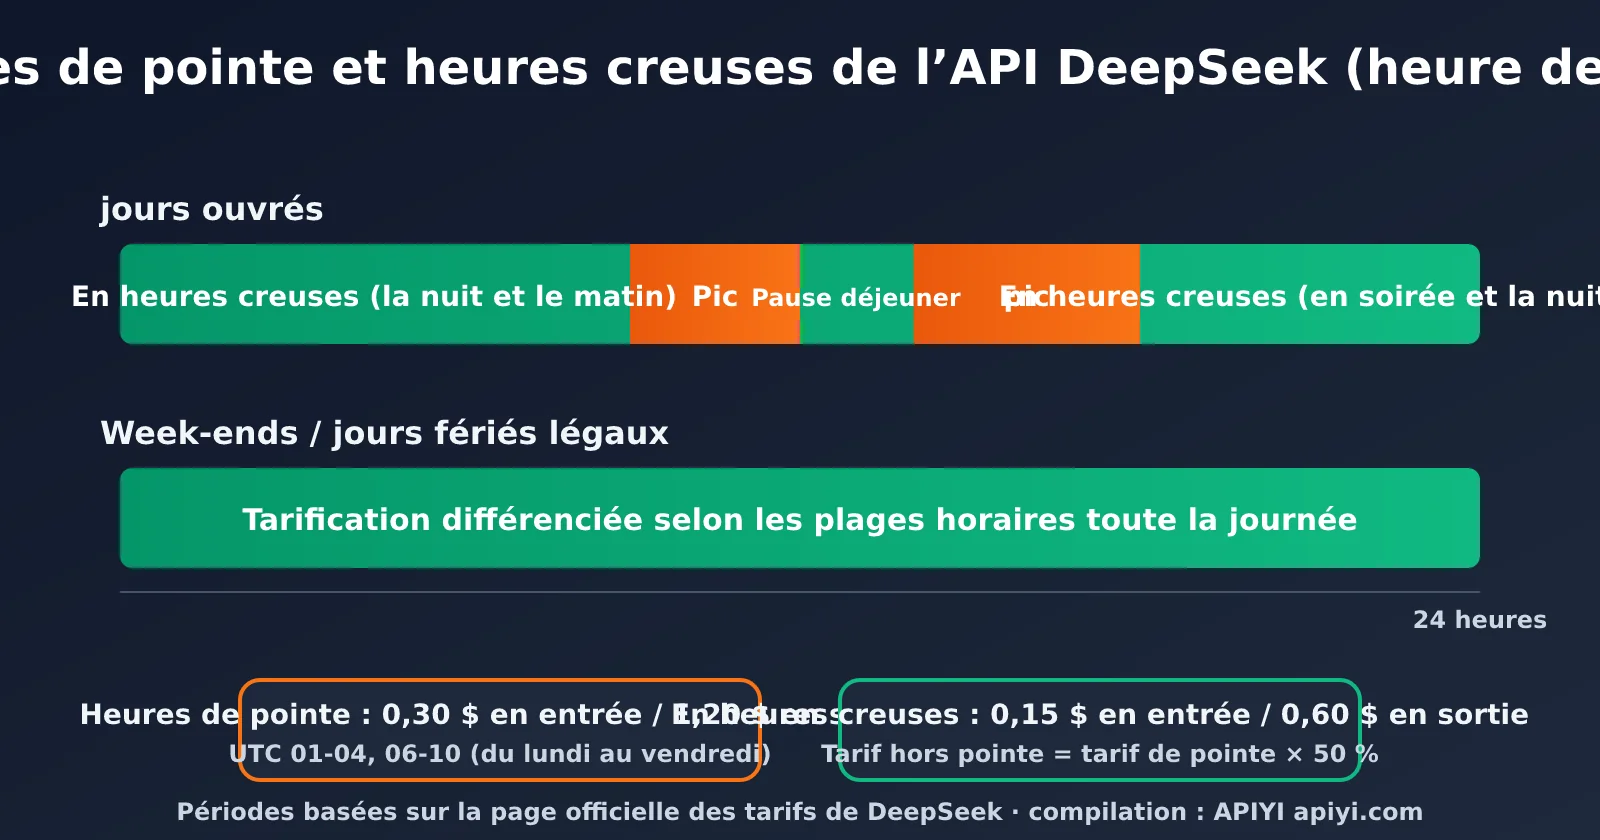
Ce découpage horaire a un impact direct sur les équipes en Chine : les heures de pointe couvrent presque entièrement leur journée de travail. Si vos tâches — traduction par lots, annotation de données hors ligne ou analyse de dépôts de code — n’exigent pas de réponse en temps réel, planifiez-les après 18 h ou le week-end : le tarif est alors immédiatement divisé par deux. C’est plus direct que n’importe quelle optimisation des invites.
Évolution des prix de DeepSeek V4.1 Flash
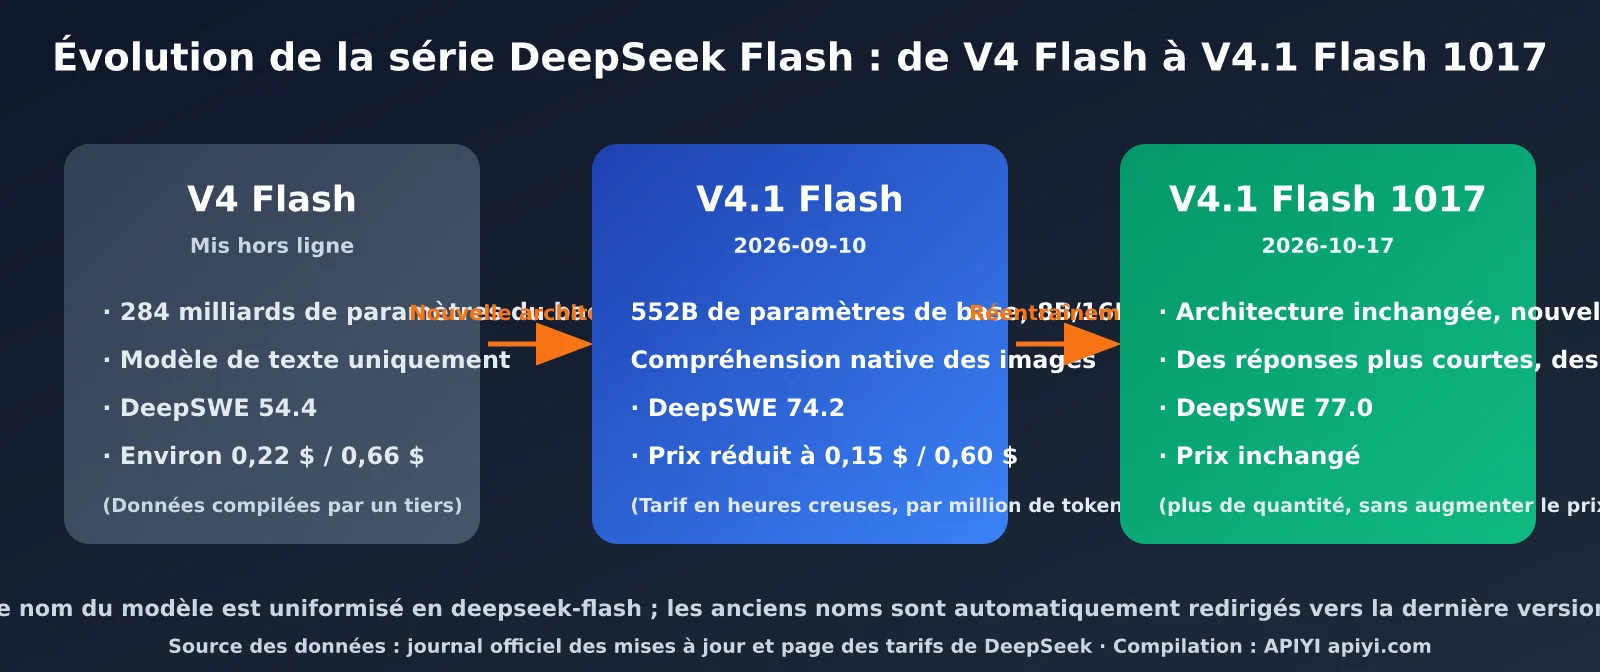
Sur une période plus longue, la série Flash a connu une « baisse de prix, puis davantage de capacité sans hausse de tarif » en l’espace de deux mois. Les tarifs de l’époque V4 Flash proviennent de compilations de la communauté anglophone et sont donnés à titre indicatif. Les données des versions de septembre et d’octobre proviennent des annonces officielles.
| Version | Date de sortie | Entrée (cache non utilisé) | Entrée (cache utilisé) | Sortie | Évolution |
|---|---|---|---|---|---|
| V4 Flash | Avant septembre 2026 | Environ $0.22 | Environ $0.007 | Environ $0.66 | Retirée |
| V4.1 Flash | 2026-09-10 | $0.15 | $0.003 | $0.60 | Baisse de prix annoncée officiellement |
| V4.1 Flash 1017 | 2026-10-17 | $0.15 | $0.003 | $0.60 | Tarif inchangé, capacités améliorées |
Les tarifs de la série V4.1 indiqués dans le tableau correspondent aux heures creuses. Les prix doublent pendant les heures de pointe.
Pourquoi un « prix inchangé » revient en pratique à une baisse de prix
Le tarif unitaire n’a pas bougé, mais le coût total de chaque tâche dépend du « prix unitaire × nombre de tokens ». DeepSeek confirme que les sorties de la version 1017 sont plus courtes : une même tâche consomme donc moins de tokens en sortie. Or, le prix des tokens de sortie est quatre fois supérieur à celui des tokens d’entrée. Réduire la longueur des sorties permet donc de réaliser davantage d’économies que de réduire celle des entrées.
Prenons un exemple à titre indicatif : une tâche d’agent consomme, en heures creuses, 1 million de tokens en entrée (sans cache) et 200 000 tokens en sortie. Elle coûte environ $0.15 + $0.12 = $0.27. Si le volume de sortie diminue de 20 % (hypothèse à vérifier selon vos mesures), son coût passe de $0.12 à environ $0.096. En réutilisant de longs contextes avec le tarif de $0.003 par million de tokens lorsque le cache est utilisé, le coût réel peut encore baisser.
💰 Optimisation des coûts : pour les appels par lots et les projets sensibles au budget, planifiez les tâches non urgentes pendant les heures creuses et réutilisez autant que possible les invites système fixes pour augmenter le taux d’utilisation du cache. En passant par la plateforme APIYI apiyi.com, vous pouvez aussi consulter les détails d’utilisation de différents modèles au même endroit et calculer le coût réel de chaque type de tâche.
API Search et Fetch : de nouveaux frais avec la version 1017
La version 1017 s’accompagne d’une autre nouveauté : DeepSeek ouvre aux développeurs externes ses fonctionnalités Search (recherche sur le Web) et Fetch (récupération de pages Web). Ces deux fonctions sont facturées séparément, à l’usage : $0.75 par millier de requêtes abouties, en plus du coût des tokens du modèle.
La page de tarification officielle prévoit également une période de transition : les requêtes de ce type lancées via DeepSeek Harness, Claude Code ou Codex sont actuellement gratuites. La facturation à l’usage commencera à 0 h, heure de Pékin, le 1er novembre 2026. Si votre flux de travail d’agent dépend fortement de la recherche sur le Web, pensez à comptabiliser vos appels avant novembre pour évaluer ce nouveau coût à l’avance.
Bien démarrer avec DeepSeek V4.1 Flash 1017 : exemple d’appel API
Comme la version 1017 conserve le nom de modèle deepseek-flash, votre code existant utilisera automatiquement la nouvelle version, sans aucune modification. Voici un exemple minimal compatible avec le SDK OpenAI :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

resp = client.chat.completions.create(
    model="deepseek-flash",  # 实际可用模型名以平台模型列表为准
    messages=[{"role": "user", "content": "用 Python 写一个读取 CSV 并按列求和的函数"}],
)
print(resp.choices[0].message.content)
print(resp.usage)  # 记录 Token 用量,便于对比新旧版本输出长度
Voir le code complet : script de comparaison de la longueur des réponses des anciennes et nouvelles versions
import time
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 调用多个模型
)

PROMPTS = [
    "解释 Python 中生成器和迭代器的区别,并给出示例",
    "写一个带重试和指数退避的 HTTP 请求函数",
    "把下面的 SQL 改写成 pandas 代码:SELECT city, AVG(price) FROM orders GROUP BY city",
]

def run(model: str, prompts: list[str]) -> dict:
    out_tokens, latency = [], []
    for p in prompts:
        start = time.time()
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": p}],
        )
        latency.append(time.time() - start)
        out_tokens.append(resp.usage.completion_tokens)
    return {
        "model": model,
        "avg_output_tokens": statistics.mean(out_tokens),
        "avg_latency_s": round(statistics.mean(latency), 2),
    }

if __name__ == "__main__":
    # 将历史记录中的 completion_tokens 与本次结果对比,即可估算 1017 的输出缩短幅度
    print(run("deepseek-flash", PROMPTS))
Quelques conseils pratiques pour démarrer rapidement :
- Mode réflexion :
deepseek-flashactive le mode réflexion par défaut. Pour les questions simples ou les tâches de conversion de format, vous pouvez passer en mode sans réflexion afin de réduire davantage le nombre de Tokens générés. Consultez la documentation officielle pour connaître la syntaxe exacte du paramètre. - Paramètres d’échantillonnage : la fiche du modèle sur Hugging Face recommande
temperature=1.0ettop_p=0.95. Si vous aviez réglé la température pour l’ancienne version, pensez à refaire des tests. - Ancien nom du modèle :
deepseek-v4-flashreste utilisable, mais redirige désormais vers la version 1017. Il est recommandé d’adopter partoutdeepseek-flashafin d’éviter les problèmes lorsque l’ancien alias sera retiré. - Tests de régression : des réponses plus courtes peuvent perturber les traitements en aval qui dépendent d’un format ou d’une longueur fixe. Avant de migrer, testez le modèle avec des exemples réels.
🚀 Pour démarrer rapidement : la plateforme APIYI, sur apiyi.com, permet de créer facilement un prototype. Son interface compatible avec OpenAI est prête à l’emploi : en quelques minutes, vous pouvez intégrer DeepSeek V4.1 Flash 1017 à votre projet existant et le comparer à d’autres modèles dans le cadre d’un test A/B.
Dans quels cas choisir DeepSeek V4.1 Flash 1017 ? Comparaison avec V4 Pro
Après la mise à jour 1017, une question se pose : est-il encore nécessaire d’utiliser le V4 Pro, plus cher ? D’après la page officielle des tarifs, Flash se démarque par son prix, sa capacité de traitement en parallèle et ses capacités visuelles. Pro reste toutefois le plus grand modèle actuellement proposé par DeepSeek.
| Critère | deepseek-flash (V4.1 Flash 1017) | deepseek-v4-pro (V4 Pro 0813) | Recommandation |
|---|---|---|---|
| Prix de sortie (heures creuses) | 0,60 $ / million de Tokens | 1,98 $ / million de Tokens | Flash coûte environ 30 % du prix de Pro |
| Contexte / sortie maximale | 1 M / 384 K | 1 M / 384 K | Équivalents |
| Compréhension visuelle | Oui | Non | Choisissez Flash si vous fournissez des images |
| Limite de requêtes simultanées | 2 500 | 500 | Choisissez Flash pour le traitement par lots à forte concurrence |
| Optimisation pour les agents de programmation | Optimisé spécifiquement pour Harness et CodeBuddy | Généraliste | Essayez Flash en priorité pour les agents de programmation |
| Plateformes disponibles | DeepSeek officiel, APIYI sur apiyi.com, etc. | Idem | Une interface unifiée facilite le changement |
À partir de ces éléments, voici quelques pistes selon les usages :
- Agents de programmation et automatisation du terminal : privilégiez Flash 1017. C’est le domaine où cette mise à jour apporte le plus, et son prix représente environ un tiers de celui de Pro.
- Compréhension de graphiques, de captures d’écran et de documents : Flash est le seul choix possible, car Pro ne prend actuellement pas en charge les entrées visuelles.
- Traitement hors ligne à grande échelle : avec une limite de 2 500 requêtes simultanées et des tarifs réduits en heures creuses, Flash offre le meilleur rapport qualité-prix.
- Tâches de raisonnement complexe exigeant une qualité de réponse optimale : comparez Flash et Pro sur le même échantillon avant de trancher. Ne vous fiez pas uniquement aux scores de benchmark.
💡 Conseil pour choisir : le modèle à privilégier dépend avant tout du type de tâche et du niveau de qualité recherché. Avec la plateforme APIYI, sur apiyi.com, vous pouvez tester Flash et Pro sur les mêmes exemples réels. Une interface unifiée permet de passer de l’un à l’autre en changeant simplement le nom du modèle, pour tirer rapidement une conclusion.
Questions fréquentes
Q1 : Faut-il modifier le code pour DeepSeek V4.1 Flash 1017 ?
Non. DeepSeek confirme que la méthode d’appel de l’API reste inchangée : deepseek-flash pointe automatiquement vers la version 1017, et l’ancien nom deepseek-v4-flash est lui aussi redirigé vers la nouvelle version. Il est toutefois recommandé d’effectuer des tests de régression pour vérifier que l’analyse en aval fonctionne toujours correctement avec des sorties plus courtes. La plateforme APIYI, apiyi.com, propose un quota de test qui vous permet d’évaluer rapidement les performances de cette nouvelle version pour votre activité.
Q2 : Le prix de DeepSeek V4.1 Flash 1017 a-t-il changé ?
Le tarif unitaire n’a pas changé : en heures creuses, l’entrée coûte 0,15 $ en cas de défaut de cache et 0,003 $ en cas de succès du cache, tandis que la sortie coûte 0,60 $ (par million de tokens). Les tarifs doublent aux heures de pointe. Toutefois, comme la version 1017 génère des sorties plus courtes, le coût total d’une même tâche devrait généralement diminuer. Seule nouveauté : Search et Fetch sont facturés à l’utilisation, à 0,75 $ pour 1 000 requêtes réussies chacun.
Q3 : À quelles heures correspondent les heures de pointe, heure de Pékin ?
En semaine, les heures de pointe à Pékin sont de 9 h à 12 h et de 14 h à 18 h. Cela correspond à 1 h–4 h et à 6 h–10 h UTC. Les jours fériés officiels chinois ne sont pas considérés comme des périodes de pointe. Le reste du temps, le tarif des heures creuses s’applique, soit la moitié du tarif de pointe.
Q4 : Les progrès de la version 1017 aux tests de référence sont-ils fiables ?
Les scores proviennent des résultats publiés par DeepSeek. Leur reproduction indépendante par des tiers est toujours en cours. Certains tests dépendent d’un framework particulier : Terminal-Bench 4.0 utilise le framework Claude Code, tandis que DeepSWE utilise Mini-SWE-V2. Les résultats peuvent donc différer avec une boucle d’agent développée en interne. La méthode la plus fiable reste de tester le modèle sur vos propres exemples et avec votre propre framework avant de décider de migrer.
Q5 : Peut-on déployer DeepSeek V4.1 Flash 1017 localement ?
Oui. Les poids sont publiés sous licence MIT sur Hugging Face et ModelScope, et le modèle est compatible avec des frameworks d’inférence comme vLLM, SGLang et Transformers. Toutefois, ses 552 milliards de paramètres principaux nécessitent une grande quantité de mémoire vidéo. Pour les équipes de taille petite ou moyenne, l’appel direct à l’API est généralement plus rentable.
Points clés à retenir
- Ce qui a été amélioré : l’architecture reste inchangée, mais le modèle a bénéficié d’un nouveau cycle d’apprentissage par renforcement. Les 11 tests de référence publiés par DeepSeek affichent tous une progression. Terminal-Bench 4.0 passe ainsi de 31,2 à 42,3.
- Évolution de l’efficacité : les tâches sont réalisées plus rapidement et les sorties sont plus courtes. Comme la facturation se fait au token, le coût par tâche diminue directement.
- Le prix a-t-il changé ? Non, le tarif unitaire reste inchangé : 0,15 $ pour l’entrée et 0,60 $ pour la sortie en heures creuses. Il double aux heures de pointe, en semaine de 9 h à 12 h et de 14 h à 18 h, heure de Pékin.
- Nouveaux frais : Search et Fetch coûtent chacun 0,75 $ pour 1 000 requêtes. À partir du 1er novembre, les appels via Harness, Claude Code et Codex seront facturés.
- Intégration : continuez à utiliser
deepseek-flash, sans modifier le code. Il suffit d’effectuer un test de régression avant la migration.
En résumé
Pour répondre aux deux questions du titre, voici l’essentiel en trois points :
- Qu’est-ce qui a été amélioré ? DeepSeek V4.1 Flash 1017 est une version réentraînée reposant sur la même architecture. Les progrès sont particulièrement marqués en programmation d’agents, tandis que la compréhension visuelle progresse elle aussi. Les réponses sont plus courtes et le modèle plus rapide.
- Le prix a-t-il changé ? Non, il reste au niveau fixé après la baisse de septembre. Les réponses plus courtes réduisent le coût réel, et les tarifs sont encore divisés par deux pendant les heures creuses.
- Que faut-il faire ? Aucune modification du code n’est nécessaire, mais il est recommandé d’effectuer un test de régression et d’évaluer l’impact de la facturation à l’usage de Search/Fetch, à partir de novembre, sur les workflows d’agents.
Pour les équipes qui utilisent ou envisagent d’utiliser DeepSeek pour des agents de programmation, du traitement par lots ou la compréhension de graphiques, la version 1017 est une mise à jour qui apporte davantage sans coûter plus cher. Elle mérite d’être testée rapidement. Vous pouvez vérifier ses performances facilement avec APIYI apiyi.com : comparez DeepSeek V4.1 Flash 1017 à d’autres modèles majeurs sur le même échantillon, via une interface unifiée, puis décidez comment répartir le trafic de production.
Pour aller plus loin — Articles connexes
Si la série de modèles DeepSeek vous intéresse, voici quelques lectures recommandées :
- 📘 Décryptage de DeepSeek V4.1 Flash : nouvelle architecture et multimodal natif — Découvrez les changements architecturaux de la version lancée en septembre.
- 📊 Guide d’optimisation des coûts de l’API DeepSeek : cache et planification en heures creuses — Découvrez des astuces pratiques pour réduire le coût des jetons.
- 🚀 Choisir un modèle pour un agent de programmation : comparaison entre Flash, Pro et les principaux modèles propriétaires — Explorez les meilleures combinaisons selon les cas d’usage.
Références
- Journal des mises à jour de l’API DeepSeek : notes de version officielles et données de benchmark pour V4.1 Flash et la version 1017
- Lien :
api-docs.deepseek.com/updates -
Remarque : principale source des scores de benchmark et des informations sur les versions mentionnés dans cet article
-
Modèles et tarifs DeepSeek : tarifs officiels, périodes de pointe et règles de facturation de Search/Fetch
- Lien :
api-docs.deepseek.com/quick_start/pricing -
Remarque : les tarifs en vigueur sont ceux indiqués sur la page officielle
-
Fiche du modèle sur Hugging Face : architecture, paramètres et paramètres d’échantillonnage recommandés pour DeepSeek-V4.1-Flash
- Lien :
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash -
Remarque : référence pour le déploiement local et la configuration des paramètres
-
Article comparatif de Regolo : comparaison des tarifs et des benchmarks de V4 Flash et V4.1 Flash
- Lien :
regolo.ai - Remarque : le tarif historique de V4 Flash cité dans l’article provient de cette compilation tierce
Auteur : équipe technique d’APIYI
Échanges techniques : n’hésitez pas à participer à la discussion dans les commentaires. Pour en savoir plus, consultez le centre de documentation APIYI à l’adresse docs.apiyi.com.