Note de l’auteur : les deux modèles ont le même prix en heures de pointe, mais excellent dans des tâches différentes. Cet article compare leurs caractéristiques, leurs prix, leurs scores et leurs usages dans quatre tableaux, pour vous aider à choisir le bon modèle selon la tâche.
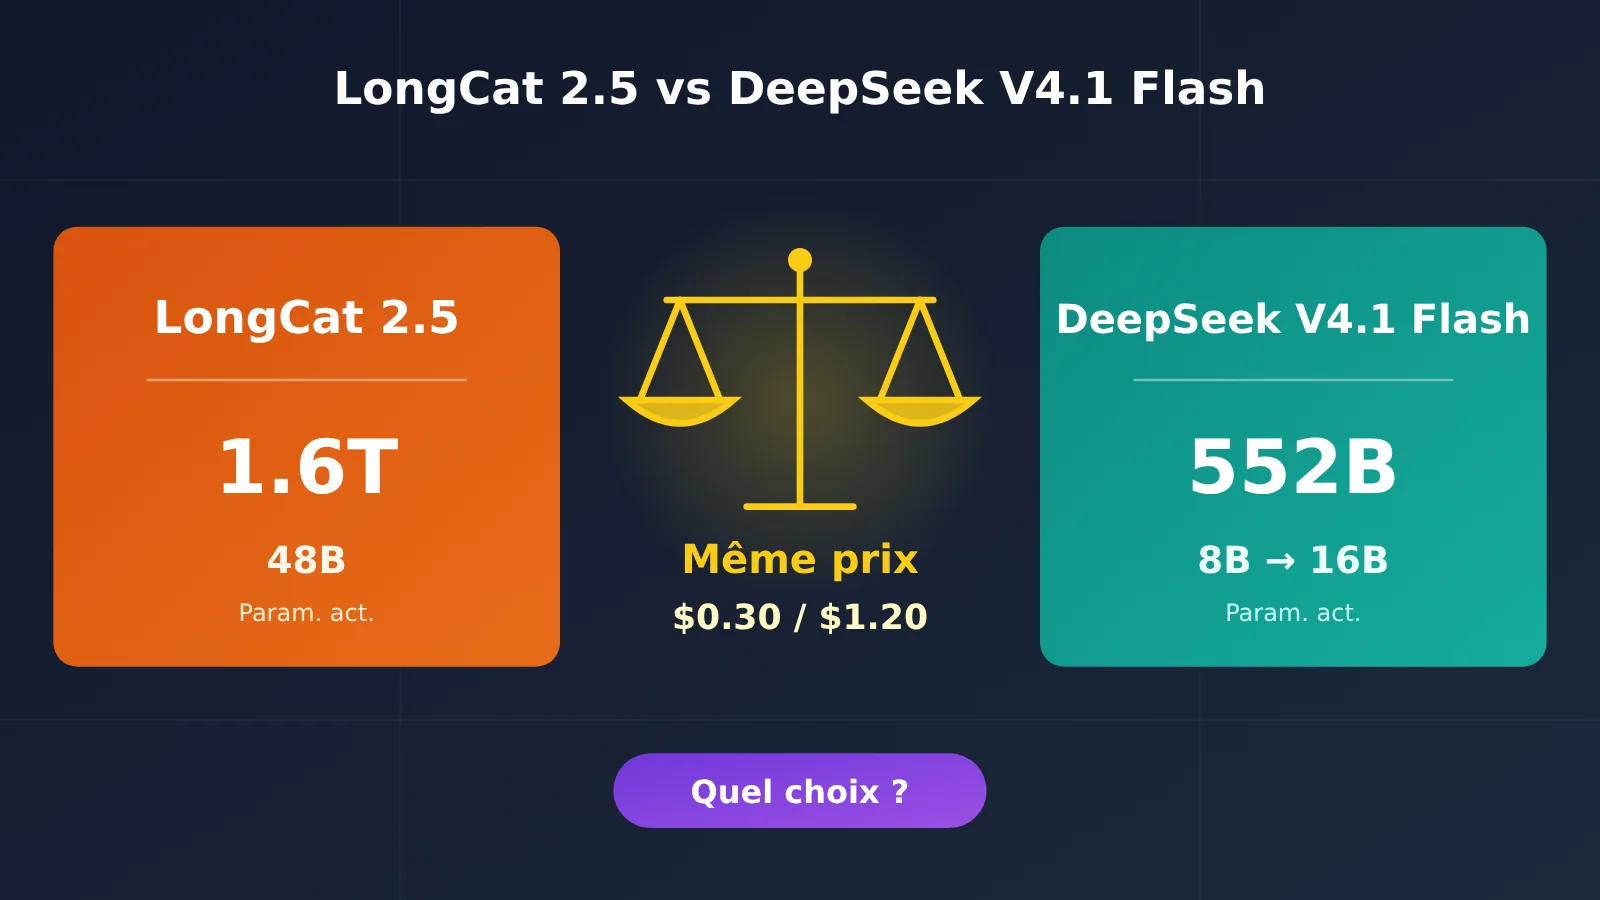
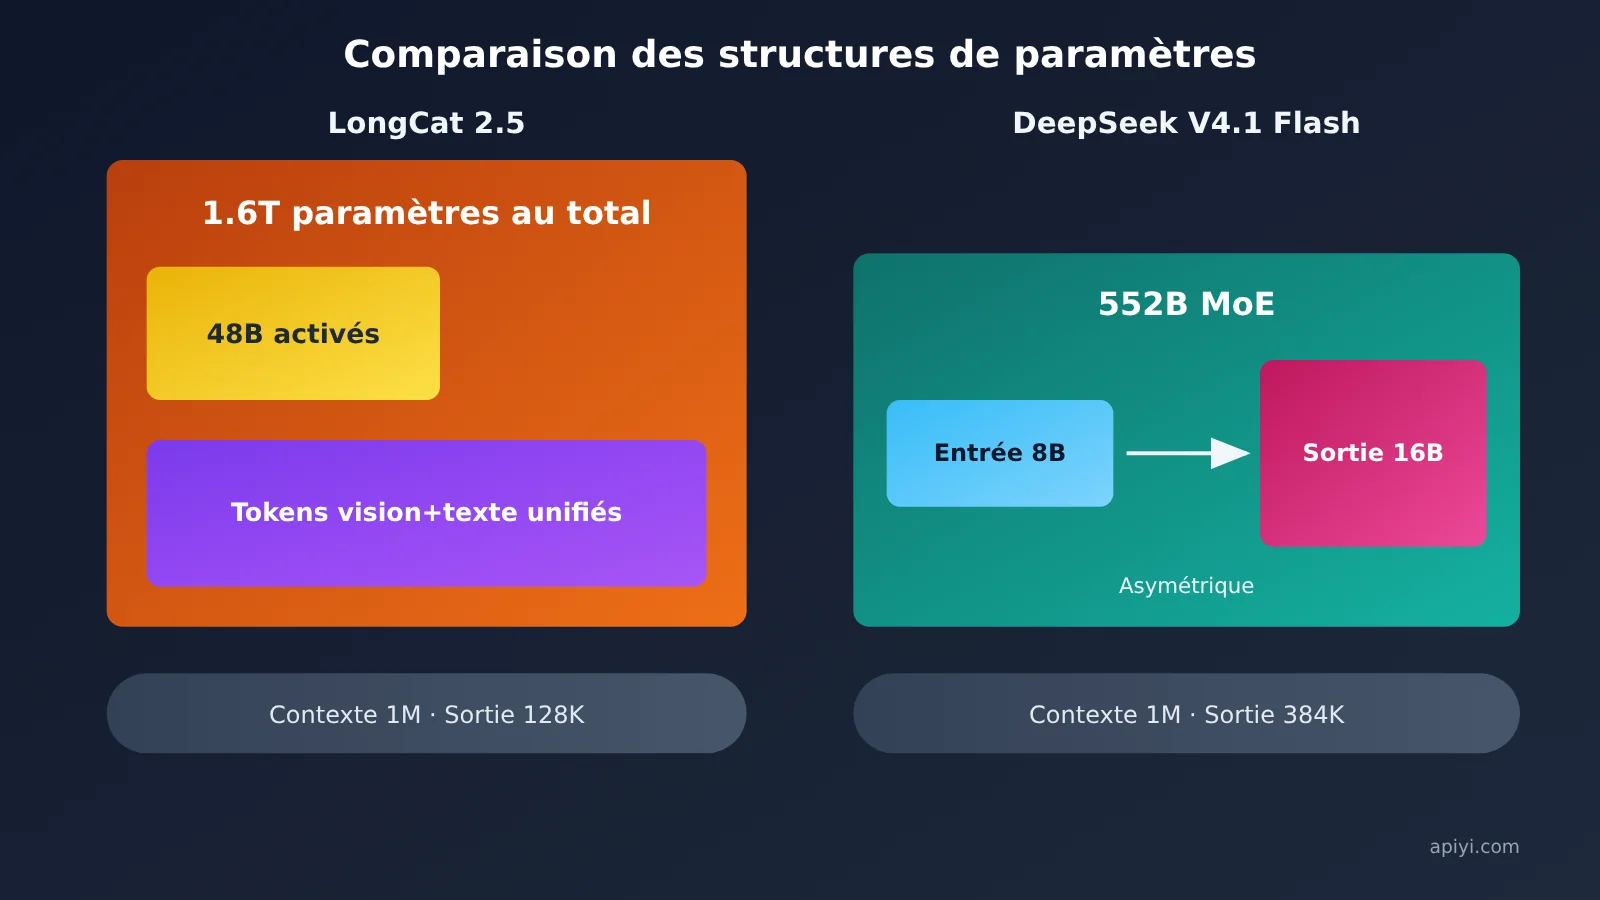
Les tarifs en heures de pointe sont identiques : 0,30 $ en entrée, 0,006 $ pour le cache et 1,20 $ en sortie, par million de tokens. La différence tient aux tâches dans lesquelles chaque modèle excelle : le bon choix dépend donc de vos besoins. LongCat 2.5 est un modèle nativement multimodal qui compte 1 600 milliards de paramètres au total et en active environ 48 milliards par token. DeepSeek V4.1 Flash est un MoE asymétrique de 552 milliards de paramètres, qui en active 8 milliards en entrée et 16 milliards en sortie. Ses poids sont disponibles en open source.
Cet article ne cherche pas à conclure que « les deux se valent ». Tous les chiffres ci-dessous proviennent des blogs officiels, des rapports techniques et des pages tarifaires des deux fournisseurs. Les scores ont été mesurés par les fournisseurs eux-mêmes : ils servent ici de points de comparaison à niveau équivalent, sans classement général ni prétention à rapporter des tests que nous n’avons pas effectués.
Ce que vous allez en tirer : vous pourrez comparer les tâches de votre projet une par une, choisir votre modèle principal et celui à utiliser en complément, puis calculer les économies possibles en déplaçant vos traitements par lots vers les heures creuses.
LongCat 2.5 face à DeepSeek V4.1 Flash : les deux modèles en bref
En résumé : LongCat 2.5 possède plus de paramètres et en active davantage à chaque étape. DeepSeek V4.1 Flash est plus compact, active moins de paramètres et offre une limite de sortie plus élevée. Ses poids sont aussi directement téléchargeables. Les deux modèles disposent d’une fenêtre de contexte de 1M. Pour choisir, trois critères comptent surtout : la sortie maximale de 128K contre 384K, la disponibilité des poids en open source et le nombre de paramètres activés.
| Critère | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Nombre total de paramètres | 1,6T (1 600 milliards) | 552B |
| Paramètres activés | Environ 48B par token | 8B en entrée, 16B en sortie |
| Architecture | Modèle multimodal natif conçu pour les agents, avec un traitement unifié de l’image et du texte sous forme de tokens | MoE, architecture asymétrique Causal-Encoder-Decoder |
| Fenêtre de contexte | 1M | 1M |
| Sortie maximale | 128K | 384K |
| Vision native | Prise en charge, avec des signaux visuels représentés par des tokens discrets à plusieurs niveaux | Prise en charge (Vision) |
| Poids open source | Poids non publiés ; GitHub et Hugging Face indiquent qu’ils sont à venir | Poids publiés en open source sur Hugging Face, accompagnés d’un rapport technique |
| Mode de réflexion | Évaluations officielles réalisées avec le mode thinking activé | Mode de réflexion activé par défaut, ajustable avec reasoning_effort |
Les points clés de l’architecture de LongCat 2.5
Le positionnement de LongCat 2.5 est clair : il vise les tâches d’agents de longue durée. Par rapport à la version 2.0, il renforce surtout la compréhension visuelle native et la programmation agentique. Pour la partie visuelle, les images sont discrétisées à leur résolution native avec SAE+RVQ, puis prétraitées hors ligne en tokens visuels avant un apprentissage conjoint avec le modèle principal. Celui-ci traite les données visuelles et textuelles avec le même ensemble de tokens : c’est ce qui en fait un modèle multimodal natif.
Pour l’entraînement, LongCat 2.5 utilise massivement des données de trajectoires longues et de l’apprentissage par renforcement (RL) à grande échelle sur ces trajectoires. Le blog officiel donne quelques détails : les trajectoires d’échec d’agents réels sont transformées en tâches vérifiables ; le RL asynchrone utilise des partial rollouts et filtre les groupes d’échantillons dont les réponses sont toutes correctes ou toutes incorrectes, et qui produisent donc un gradient nul ; les raisonnements et les appels d’outils répétitifs sont pénalisés. Ce dernier point compte pour les développeurs d’agents : le modèle risque moins de tourner en rond dans une boucle d’appels d’outils, et gaspille moins de tokens.
Côté infrastructure d’inférence, par rapport à W8A8 INT8, W4A4 augmente le débit de prefill de 43,3 % et celui de decode de 42,77 %, tout en réduisant le TTFT de 15,91 % et le TPOT de 19,72 %. Pour l’entraînement, le FSDP à double partitionnement augmente de 86 % le débit par GPU du SFT sur de longues séquences par rapport à la référence DDP. Ces chiffres montrent que le modèle de 1,6 trillion de paramètres a fait l’objet d’optimisations spécifiques côté serveur, mais les limites de débit n’ont pas été publiées officiellement.
Points clés de l’architecture de DeepSeek V4.1 Flash
DeepSeek V4.1 Flash est le plus petit modèle de cette nouvelle famille d’architectures. Il se distingue par une asymétrie entre l’entrée et la sortie : il n’active que 8B de paramètres pour lire l’entrée, contre 16B pour générer la sortie. Dans les usages d’agents, les entrées sont souvent bien plus volumineuses que les sorties : lecture de dépôts de code, de journaux ou de résultats d’outils. Cette architecture réduit justement le calcul nécessaire à la lecture.
La différence est encore plus marquée côté coûts. La nouvelle génération de cache KV est nettement plus compacte : les besoins en HBM passent à un quart de ceux de la génération précédente, et ceux en SSD à un huitième. Par rapport au modèle de première génération, le cache KV a été réduit au total d’un facteur 437. Autre changement à noter : à partir du 14 septembre 2026 à 12 h, les requêtes adressées à deepseek-v4-pro seront redirigées vers V4.1 Flash et facturées au tarif Flash, jusqu’au lancement de V4.1 Pro. Les projets qui utilisent encore l’ancien nom de modèle invoquent donc en réalité Flash.
Prix de LongCat 2.5 face à DeepSeek V4.1 Flash : mêmes tarifs uniquement en heures de pointe
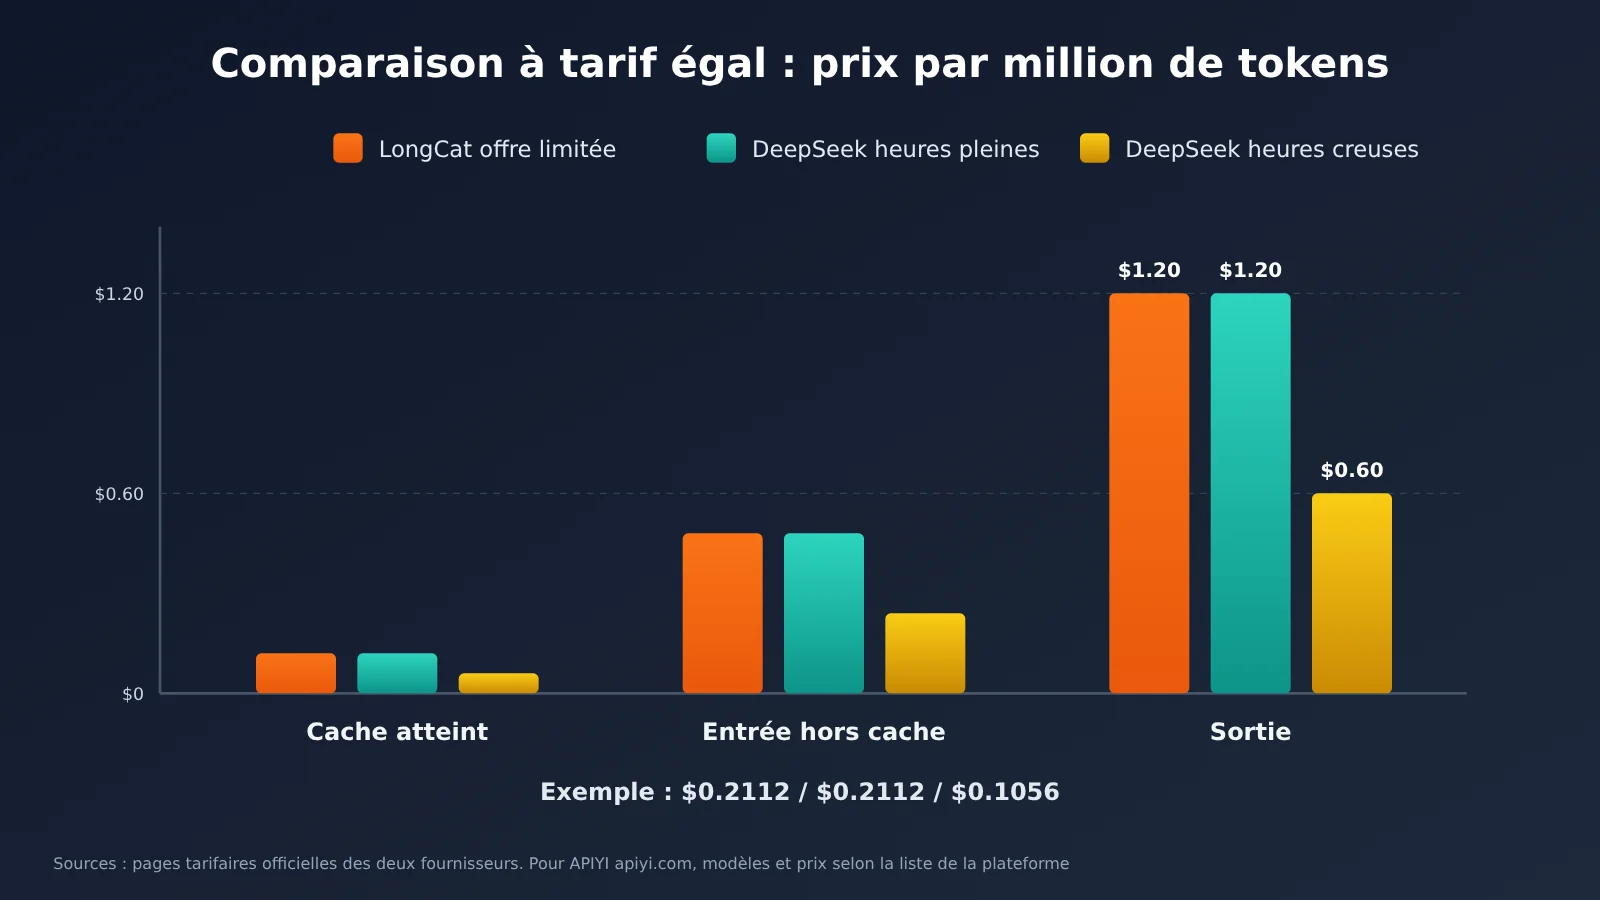
En bref : les tarifs promotionnels de LongCat 2.5 sont identiques, poste par poste, à ceux de DeepSeek V4.1 Flash en heures de pointe. En heures creuses, DeepSeek applique une réduction de 50 % : la même tâche coûte donc moitié moins cher. Les deux modèles ne sont au même prix que pendant certaines plages horaires en semaine.
| Pour 1 million de tokens (dollars) | LongCat 2.5 (promotion temporaire) | DeepSeek heures de pointe | DeepSeek heures creuses |
|---|---|---|---|
| Entrée avec cache atteint | $0.006 | $0.006 | $0.003 |
| Entrée sans cache atteint | $0.30 | $0.30 | $0.15 |
| Sortie | $1.20 | $1.20 | $0.60 |
Prenons un exemple. Une tâche d’agent consomme 500 000 tokens d’entrée, dont 300 000 sans cache atteint et 200 000 avec cache atteint, ainsi que 100 000 tokens de sortie :
- LongCat 2.5 (promotion temporaire) : 0,3 × 0,30 + 0,2 × 0,006 + 0,1 × 1,20 = $0.2112
- DeepSeek en heures de pointe : même calcul, $0.2112
- DeepSeek en heures creuses : 0,3 × 0,15 + 0,2 × 0,003 + 0,1 × 0,60 = $0.1056
Pour une seule tâche, l’écart d’environ 10 cents semble modeste. Mais pour 1 000 tâches similaires par jour, LongCat et DeepSeek en heures de pointe coûtent chacun $211.2, contre $105.6 pour DeepSeek en heures creuses. Sur un mois, la différence devient considérable pour une équipe qui traite des lots.
Chez DeepSeek, les heures de pointe correspondent aux jours ouvrables de 09 h à 12 h et de 14 h à 18 h, heure de Pékin, soit du lundi au vendredi de 01 h à 04 h et de 06 h à 10 h UTC, hors jours fériés officiels en Chine. Le reste du temps, le tarif est réduit de moitié : pendant la pause de midi, le soir et la nuit en semaine, ainsi que toute la journée les week-ends et les jours fériés. Autrement dit, sur les 168 heures d’une semaine, les heures de pointe ne représentent que 7 heures par jour ouvrable.
Quelques détails de facturation de LongCat 2.5 méritent aussi d’être notés :
- Seules les réponses HTTP 200 sont facturées : les réponses 401, 403, 429 et 500 ne le sont pas. Les nouvelles tentatives qui échouent ne coûtent donc rien.
- Forfaits de tokens : des ventes flash en quantité limitée ont lieu chaque jour à 10 h, 16 h, 21 h et 23 h, heure de Pékin. Les forfaits sont valables 30 jours et la part non consommée est intégralement remboursable. Les tokens servis depuis le cache ne sont pas décomptés du forfait.
- Tokens offerts : 10 millions pour les nouveaux utilisateurs et 5 millions pour les utilisateurs existants, crédités automatiquement. Les tokens servis depuis le cache ne sont pas décomptés de cette allocation.
- Les prix sont indiqués comme une promotion temporaire. Pour connaître les éventuelles modifications, consultez la page officielle des tarifs.
Chez DeepSeek, la recherche sur le Web et l’extraction de pages Web sont des API facturées séparément, à $0.75 pour 1 000 requêtes réussies, au même tarif pour les deux services. Si votre agent accède fréquemment au Web, pensez à les ajouter à votre budget.
💰 Conseil sur les coûts : si vous utilisez DeepSeek V4.1 Flash via APIYI apiyi.com, la facturation dépend des tarifs des modèles indiqués sur la plateforme, qui ne correspondent pas forcément aux tarifs officiels heures pleines/heures creuses. Lancez d’abord un petit lot de tâches depuis la console et vérifiez la facture avant de choisir votre stratégie de traitement par lots.
LongCat 2.5 face à DeepSeek V4.1 Flash : résultats officiels aux benchmarks
En bref : sur la plupart des benchmarks d’agents, l’écart entre les deux modèles est inférieur à 3 points. Ils jouent donc globalement dans la même cour. LongCat 2.5 mène sur Terminal Bench v4.0, Program Bench, JobBench et la génération 3D ; DeepSeek V4.1 Flash prend l’avantage sur DeepSWE, NL2Repo et AutomationBench, avec des écarts plus importants.
| Benchmark | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 |
| Terminal Bench v4.0 | 38.5 | 31.2 |
| Program Bench | 25.5 | 20.3 |
| DeepSWE v1.1 | 64.6 | 74.2 |
| NL2Repo | 60.5 | 65.4 |
| BrowseComp | 91.9 | 91.5 |
| HLE w/tools | 63.1 | 63.9 |
| AutomationBench | 51.8 | 54.8 |
| MCP Atlas | 83.1 | 84.4 |
| JobBench | 65.4 | 63.2 |
| 3DCodeBench (texte vers 3D) | 55.4 | 53.3 |
| Vision2Web | 78.6 | 79.2 |
Précisions sur les conditions de test (à lire) : les chiffres des deux modèles proviennent de tests réalisés par leurs concepteurs. LongCat 2.5 a été évalué avec son propre harness, le mode thinking activé, temperature=1.0 et top_p=0.95. La plupart des résultats de la colonne DeepSeek proviennent de son rapport technique public, avec son propre harness et le niveau de raisonnement Max. Les harness, les dates d’évaluation et les niveaux de raisonnement diffèrent : ce tableau donne seulement un ordre de grandeur pour des modèles comparables et ne constitue pas un classement.
Comment lire les scores
Les deux écarts les plus importants vont dans des directions opposées. Sur Terminal Bench v4.0, LongCat 2.5 devance DeepSeek de 7,3 points (38,5 contre 31,2) ; sur DeepSWE v1.1, DeepSeek devance LongCat de 9,6 points (74,2 contre 64,6). Le premier évalue des tâches de terminal plus longues et plus difficiles ; le second mesure la capacité à corriger des bugs dans de vrais dépôts. Les forces des deux modèles se distinguent donc : l’un excelle dans les longues chaînes d’opérations en terminal, l’autre dans les modifications précises d’une base de code existante.
Sur l’ancienne version Terminal Bench v2.1, c’est au contraire DeepSeek qui mène de 2,2 points. L’avantage de LongCat apparaît donc surtout lorsque la difficulté augmente. Sur Program Bench, LongCat gagne 5,2 points ; sur NL2Repo, DeepSeek en gagne 4,9. NL2Repo consiste à générer un dépôt entier à partir d’une description en langage naturel : le test se rapproche davantage de la création d’un projet complet à partir de zéro.
Les écarts sont faibles sur les tests liés à la vision. Sur Vision2Web, DeepSeek mène de 0,6 point ; sur 3DCodeBench, LongCat mène de 2,1 points. Dans le tableau officiel, LongCat obtient 90,2 contre 87,7 sur CharXiv-RQ w/tools, tandis que DeepSeek obtient 97,4 contre 96,5 sur MathVision w/tools. En matière de compréhension visuelle pure, les deux modèles se valent à peu près. LongCat se démarque surtout lorsqu’il combine cette compréhension avec la génération de contenus 3D et de pages interactives. Parmi ses huit démonstrations officielles figurent une simulation de fluides en temps réel, une présentation interactive d’objets patrimoniaux en 3D, une maquette urbaine et des éléments pour scènes miniatures : l’orientation est claire.
Sur BrowseComp, HLE w/tools et MCP Atlas, les écarts ne dépassent pas 1,3 point. On peut donc considérer que les deux modèles sont à égalité sur les capacités générales d’agent, comme la recherche en ligne et l’invocation d’outils MCP.
Les niveaux de raisonnement de DeepSeek : un levier pour maîtriser les coûts
La section 5.3.3 du rapport technique de DeepSeek présente des données très utiles. Lorsque le niveau de reasoning effort passe de 25 à 100, le score moyen Pass@1 sur huit benchmarks de raisonnement grimpe de 67,1 % à 76,3 %, et celui de DeepSWE v1.1 passe de 66,0 à 74,2. En contrepartie, le nombre de tokens de sortie est multiplié par environ 2,5. Les niveaux 60 à 80 offrent déjà une précision proche du maximum, avec un budget de tokens inférieur à la moitié de celui du niveau 100. Pour atteindre ce dernier, la longueur des trajectoires de l’agent augmente encore de 1,6 à 1,8 fois, pour un gain marginal.
Autre point à noter : le paramètre reasoning_effort de l’API DeepSeek est réglé sur high par défaut, alors que les scores officiels ont été obtenus au niveau Max. Pour reproduire les scores de la colonne DeepSeek dans le tableau ci-dessus, il faut donc le régler explicitement sur max. Pour les tâches courantes, utilisez un niveau moyen et réservez le niveau maximal aux plus difficiles. Les tokens de sortie constituent le poste le plus coûteux sur les factures des deux fournisseurs (1,20 $) : ce réglage détermine directement où part votre budget.
LongCat 2.5 face à DeepSeek V4.1 Flash : comment répartir les tâches
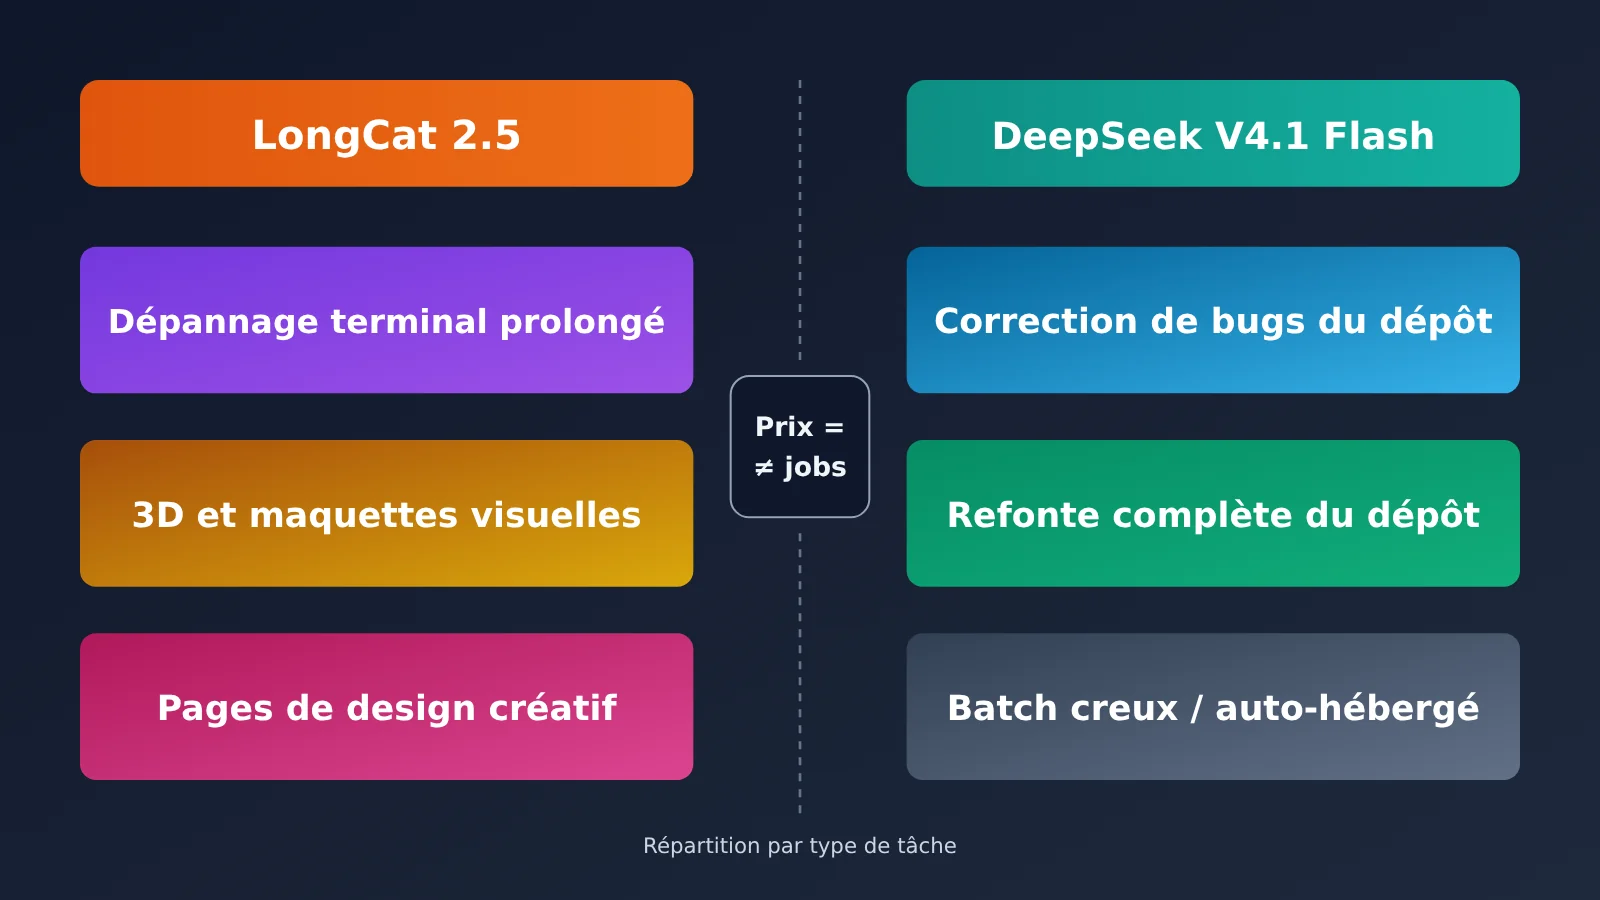
En bref : même prix, usages différents. Confiez à LongCat 2.5 les tâches longues dans le terminal, le travail visuel et 3D, ainsi que les pages créatives. Choisissez DeepSeek V4.1 Flash pour modifier du code dans de vrais dépôts, corriger des bugs, exécuter des pipelines automatisés et répondre aux besoins d’autohébergement.
| Plutôt LongCat 2.5 | Plutôt DeepSeek V4.1 Flash |
|---|---|
| Dépannage long dans le terminal : connexion au serveur, examen des journaux, modification de la configuration et vérification après redémarrage (7,3 points d’avance sur Terminal Bench v4.0) | Correction de bugs dans de vrais dépôts : lecture d’une issue, localisation des fichiers, modification du code et validation par les tests (9,6 points d’avance sur DeepSWE) |
| Ressources 3D et maquettes visuelles : génération de scènes 3D à partir de texte, pages de présentation interactives (55,4 sur 3DCodeBench) | Refactorisation de dépôts entiers et création de dépôts à partir de zéro : génération de projets multifichiers à partir d’une description des besoins (4,9 points d’avance sur NL2Repo) |
| Pages créatives : invitations à des événements, pages aux couleurs stylisées, rapports de visualisation de données (types d’usages présentés dans les démonstrations officielles) | Pipelines automatisés et traitements par lots : traitements nocturnes, nettoyage de données, génération de rapports (3,0 points d’avance sur AutomationBench, tarif réduit de moitié en heures creuses) |
| Construction de programmes sous forme d’exercices de programmation et tâches professionnelles polyvalentes (en tête sur Program Bench et JobBench) | Besoin d’autohébergement ou de déploiement privé : poids publiés en open source sur HuggingFace ; longues sorties en une seule génération (384K maximum) |
Pourquoi choisir LongCat 2.5
Le chiffre le plus convaincant pour LongCat 2.5 concerne Terminal Bench v4.0. Alors qu’il accusait un retard de 2,2 points sur la v2.1, il prend 7,3 points d’avance sur la v4.0. Cela suggère que son avantage relatif grandit avec la longueur et la difficulté des tâches. C’est cohérent avec son entraînement, qui utilise beaucoup de trajectoires longues et pénalise les appels d’outils répétitifs. Si votre agent doit souvent enchaîner des dizaines d’étapes dans un terminal, LongCat 2.5 mérite d’être testé en priorité.
Autre raison de le choisir : les tâches qui combinent vision et génération. Ses capacités multimodales natives et son entraînement axé sur la 3D et les pages interactives le rendent particulièrement adapté à des usages comme la création à partir d’une image ou la génération de contenu 3D à partir d’un texte. Les nouveaux utilisateurs reçoivent aussi 10 millions de tokens, et les requêtes servies depuis le cache ne sont pas déduites de ce crédit. Le coût initial pour l’essayer est donc très faible.
Pourquoi choisir DeepSeek V4.1 Flash
Le chiffre phare de DeepSeek V4.1 Flash est son score de 74,2 sur DeepSWE : c’est là que l’écart entre les deux modèles est le plus marqué. Or, modifier un dépôt existant fait partie des tâches de programmation les plus courantes au quotidien, et c’est justement son point fort. Sa sortie maximale de 384K est trois fois supérieure à celle de LongCat, ce qui réduit le risque de troncature lors de la génération de longs fichiers ou de correctifs volumineux.
Autre raison : la structure tarifaire. Le tarif est réduit de moitié pendant les heures creuses et le niveau de raisonnement est réglable. Combinés, ces deux leviers offrent une bien plus grande souplesse de coûts pour les traitements par lots que le tarif fixe à durée limitée de LongCat. La limite de 2 500 requêtes simultanées figure aussi dans la documentation officielle, ce qui donne un chiffre précis pour planifier le débit. Les équipes qui ont besoin d’un déploiement privé peuvent également télécharger directement les poids. Attention toutefois : selon la documentation officielle, un déploiement à grande échelle exige des ressources de l’ordre de 2 000 GPU. Les petites équipes ont donc intérêt à évaluer leurs besoins matériels avant de se lancer.
💡 Conseil pour choisir : le tableau permet de réduire les options, mais tout dépend de vos propres tâches. Sélectionnez 10 à 20 tâches représentatives de votre projet, faites-les exécuter par les deux modèles, puis comparez leur taux de réussite et leur consommation de tokens. Pour tester DeepSeek V4.1 Flash, vous pouvez passer par APIYI, sur apiyi.com, sans avoir à ouvrir un compte séparé.
Comment intégrer LongCat 2.5 et DeepSeek V4.1 Flash
En bref : les deux sont compatibles avec les formats d’API OpenAI et Anthropic. Pour les connecter à Claude Code, il suffit de modifier quelques variables d’environnement dans ~/.claude/settings.json. DeepSeek prend aussi en charge la Responses API.
Intégrer LongCat 2.5
- Format OpenAI (avec n’importe quel SDK OpenAI) : définissez
base_urlsurhttps://api.longcat.ai/openaiet le nom du modèle surLongCat-2.5. - Format Anthropic (SDK Anthropic) : définissez
base_urlsurhttps://api.longcat.ai/anthropic. - Claude Code (modifiez le champ
envde~/.claude/settings.json) : renseignez les quatre variables suivantes : ANTHROPIC_AUTH_TOKEN: votre clé LongCatANTHROPIC_BASE_URL:https://api.longcat.ai/anthropicANTHROPIC_MODEL:LongCat-2.5CLAUDE_CODE_MAX_OUTPUT_TOKENS:131072- Gestion des limites de débit (dans votre propre code d’appel) : en cas de dépassement, l’API renvoie une erreur 429 (
rate_limit_exceeded,retry_after60). La documentation officielle recommande une temporisation exponentielle. Elle ne publie pas de chiffres RPM/TPM et les erreurs 429 ne sont pas facturées.
Intégrer DeepSeek V4.1 Flash
- Format OpenAI (avec n’importe quel SDK OpenAI) : définissez le nom du modèle sur
deepseek-flash. Les anciens nomsdeepseek-v4-flashetdeepseek-v4-flash-vision-exprestent utilisables : ils sont redirigés vers V4.1-Flash-1017 et facturés au tarif Flash. - Claude Code (modifiez le champ
envde~/.claude/settings.json) : ANTHROPIC_AUTH_TOKEN: votre clé DeepSeekANTHROPIC_BASE_URL:https://api.deepseek.com/anthropicANTHROPIC_MODEL:deepseek-flash- Niveau de raisonnement (paramètre de requête du SDK OpenAI) : au quotidien, réglez
reasoning_effortsur le niveau moyen ; passez àmaxpour les problèmes difficiles. - Outils prêts à l’emploi : WorkBuddy (qui inclut CodeBuddy) et OpenCode sont des outils partenaires officiels qui prennent déjà le modèle entièrement en charge.
Centraliser les appels avec APIYI
Si vous souhaitez comparer plusieurs modèles, APIYI vous permet de passer de l’un à l’autre avec un seul compte et une seule clé API, sans ouvrir de compte chez chaque fournisseur.
- Configuration du SDK OpenAI (dans le code de votre projet) : définissez
base_urlsurhttps://api.apiyi.com/v1etapi_keysur la clé générée dans la console APIYI. - Nom du modèle (à changer dans le même paramètre de requête) : pour DeepSeek V4.1 Flash, utilisez
deepseek-v4.1-flashoudeepseek-v4.1-flash-1017. La facturation suit la liste des modèles de la plateforme. - Tests comparatifs (avec le même code) : modifiez uniquement le paramètre
modelpour exécuter les mêmes tâches avec d’autres modèles de la plateforme. La valeur debase_urlrestehttps://api.apiyi.com/v1.
Consultez la liste des modèles de la plateforme pour connaître les modèles disponibles et leurs tarifs. LongCat-2.5 n’est pas encore disponible sur APIYI, mais devrait l’être prochainement. En attendant, utilisez le point d’accès officiel pour LongCat 2.5 et centralisez la gestion de DeepSeek sur APIYI apiyi.com.
🚀 Démarrage rapide : les nouveaux utilisateurs inscrits sur APIYI apiyi.com reçoivent un crédit de test gratuit. Intégrez d’abord DeepSeek V4.1 Flash à votre projet existant avec le SDK OpenAI : il suffit de modifier la ligne
base_urlpour commencer.
Questions fréquentes sur LongCat 2.5 et DeepSeek V4.1 Flash
Q1 : Les deux tarifs sont-ils vraiment identiques ?
Uniquement pendant les heures pleines de DeepSeek. Le tarif promotionnel à durée limitée de LongCat 2.5 est de $0.30 / $0.006 / $1.20, identique à celui de DeepSeek en heures pleines pour chaque catégorie. DeepSeek applique une réduction de 50 % pendant les heures creuses, soit en dehors des plages 09:00-12:00 et 14:00-18:00 les jours ouvrables. Le tarif de LongCat est une promotion à durée limitée et pourrait évoluer.
Q2 : Les benchmarks permettent-ils de dire lequel est le meilleur ?
Pas de les classer directement. Les deux entreprises ont réalisé leurs propres tests, avec des harness, des dates et des niveaux de raisonnement différents. De plus, les résultats de DeepSeek correspondent au niveau Max. Le plus pertinent est de regarder les tests où l’écart est important : LongCat devance DeepSeek de 7,3 points sur Terminal Bench v4.0, tandis que DeepSeek prend 9,6 points d’avance sur DeepSWE. Pour les écarts de 1 à 2 points, mieux vaut considérer les résultats comme équivalents.
Q3 : Quand LongCat 2.5 sera-t-il disponible en open source ?
Aucun calendrier officiel n’a été annoncé. Pour l’instant, GitHub et HuggingFace indiquent tous deux « à venir », sans publication des poids. Pour les projets qui nécessitent un déploiement autonome, seul DeepSeek V4.1 Flash est envisageable à ce jour : ses poids et son rapport technique sont déjà publics.
Q4 : Peut-on invoquer les deux modèles sur APIYI ?
Pour l’instant, seul DeepSeek V4.1 Flash est disponible, sous les identifiants `deepseek-v4.1-flash` et `deepseek-v4.1-flash-1017`. La facturation suit la liste des modèles de la plateforme. LongCat-2.5 n’est pas encore disponible sur APIYI, mais sera proposé dès que possible. Pour les modèles et les tarifs, consultez la liste sur apiyi.com.
Q5 : Comment réduire les coûts des tâches par lots ?
Avec DeepSeek, combinez deux réglages : planifiez les tâches pendant les heures creuses pour diviser le tarif par deux, puis réglez `reasoning_effort` à un niveau intermédiaire. Le rapport indique que les niveaux 60-80 atteignent une précision proche du niveau maximal, avec moins de la moitié de son budget de tokens. Un accès au cache coûte seulement 1/50 du prix d’une requête sans accès au cache. Pour augmenter le taux de réussite du cache, placez les invites système fixes et les définitions d’outils au début de la requête.
Bilan : comment choisir entre LongCat 2.5 et DeepSeek V4.1 Flash
La conclusion est simple : à prix comparable, chacun a ses points forts. Répartissez les tâches selon leurs capacités et lancez les traitements par lots en heures creuses.
- Taille : 1,6 T de paramètres, dont 48 B activés, pour LongCat ; 552 B, dont 8 B activés en entrée et 16 B en sortie, pour DeepSeek. Les deux ont une fenêtre de contexte de 1 M de tokens.
- Limite de sortie : 128 K pour LongCat, 384 K pour DeepSeek. Pour les sorties longues, choisissez DeepSeek.
- Prix : le tarif promotionnel de LongCat correspond au tarif de DeepSeek en heures pleines. DeepSeek coûte deux fois moins cher en heures creuses : dans l’exemple, 0,2112 $ contre 0,1056 $.
- Benchmarks : LongCat devance DeepSeek de 7,3 points sur les tâches longues dans un terminal ; DeepSeek prend 9,6 points d’avance sur la correction de bugs dans un dépôt. Sur la plupart des autres tests, ils sont à égalité.
- Open source : DeepSeek est déjà open source ; LongCat n’a pas publié ses poids.
- Intégration : les deux sont compatibles avec les formats OpenAI et Anthropic. Dans Claude Code, il suffit de modifier les variables d’environnement pour passer de l’un à l’autre.
À retenir : choisissez votre modèle principal selon les tâches à accomplir et gardez l’autre en complément. Dans la mesure du possible, planifiez les traitements par lots en heures creuses. Pour DeepSeek V4.1 Flash, vous pouvez commencer par un test à petite échelle via l’interface unifiée d’APIYI, sur apiyi.com, avant de décider de votre solution principale.
📚 Références
- Blog officiel de LongCat-2.5 : positionnement du modèle, architecture, entraînement et détails techniques
- Lien :
longcat.ai/blog/longcat-2.5 -
Contenu : nombre de paramètres, approche des tokens visuels, données d’inférence W4A4 et tableau des évaluations officielles
-
Documentation de la plateforme ouverte LongCat : tarifs, points de terminaison et intégration à Claude Code
- Lien :
longcat.ai/platform/docs -
Contenu : tarifs promotionnels à durée limitée, gestion des erreurs 429, forfaits de crédits et règles d’attribution des crédits offerts
-
Annonce de DeepSeek V4.1 Flash : architecture, publication en open source et modifications de l’API
- Lien :
deepseek.com/news/deepseek-v4-1-flash -
Contenu : MoE asymétrique, compression du cache KV et migration des noms de modèles
-
Page des tarifs de l’API DeepSeek : tarifs en heures pleines et creuses et limites de concurrence
- Lien :
api-docs.deepseek.com/quick_start/pricing -
Contenu : définition des heures pleines et creuses, limite de 2 500 requêtes simultanées et facturation distincte de la recherche et de l’extraction de pages
-
Dépôt des poids de DeepSeek-V4.1-Flash : poids open source et rapport technique
- Lien :
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash - Contenu : résultats du tableau 3 et analyse des niveaux de raisonnement à la section 5.3.3
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI sur apiyi.com. Pour en savoir plus sur l’intégration, consultez le centre de documentation docs.apiyi.com.