Le 1er novembre, l’équipe DeepSeek Harness a publié sur X un long article intitulé « Explorer la conception d’un super-agent », consacré à l’architecture d’un super-agent. Environ 15 heures après sa publication, l’article comptait quelque 1,3 million de vues et 9,4 K mentions J’aime. Il s’agit d’un article sur les principes d’architecture, pas d’une présentation des fonctionnalités d’un produit.
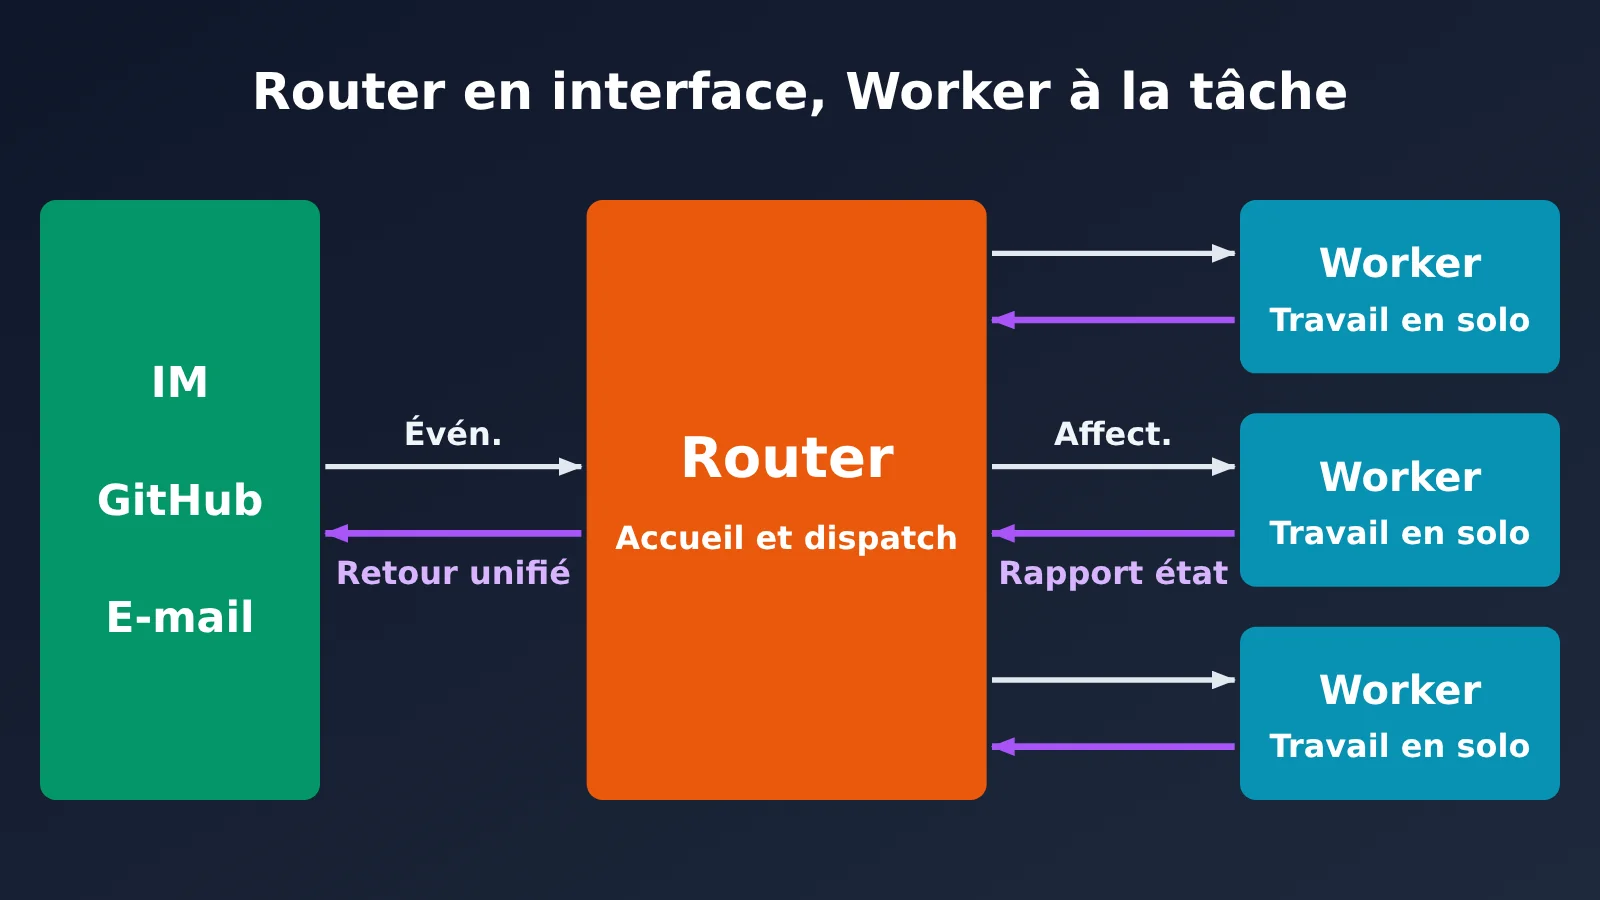
En une phrase : cette conception confie la gestion des sessions au système, tandis que l’utilisateur n’a qu’un seul point d’entrée. Le Router (aiguillage en première ligne) accueille les demandes et distribue le travail ; les Workers (sessions en arrière-plan) exécutent les tâches en parallèle. L’humain ne prend que les décisions de haut niveau et donne la validation finale.
Pourquoi le super-agent de DeepSeek veut dépasser la session unique
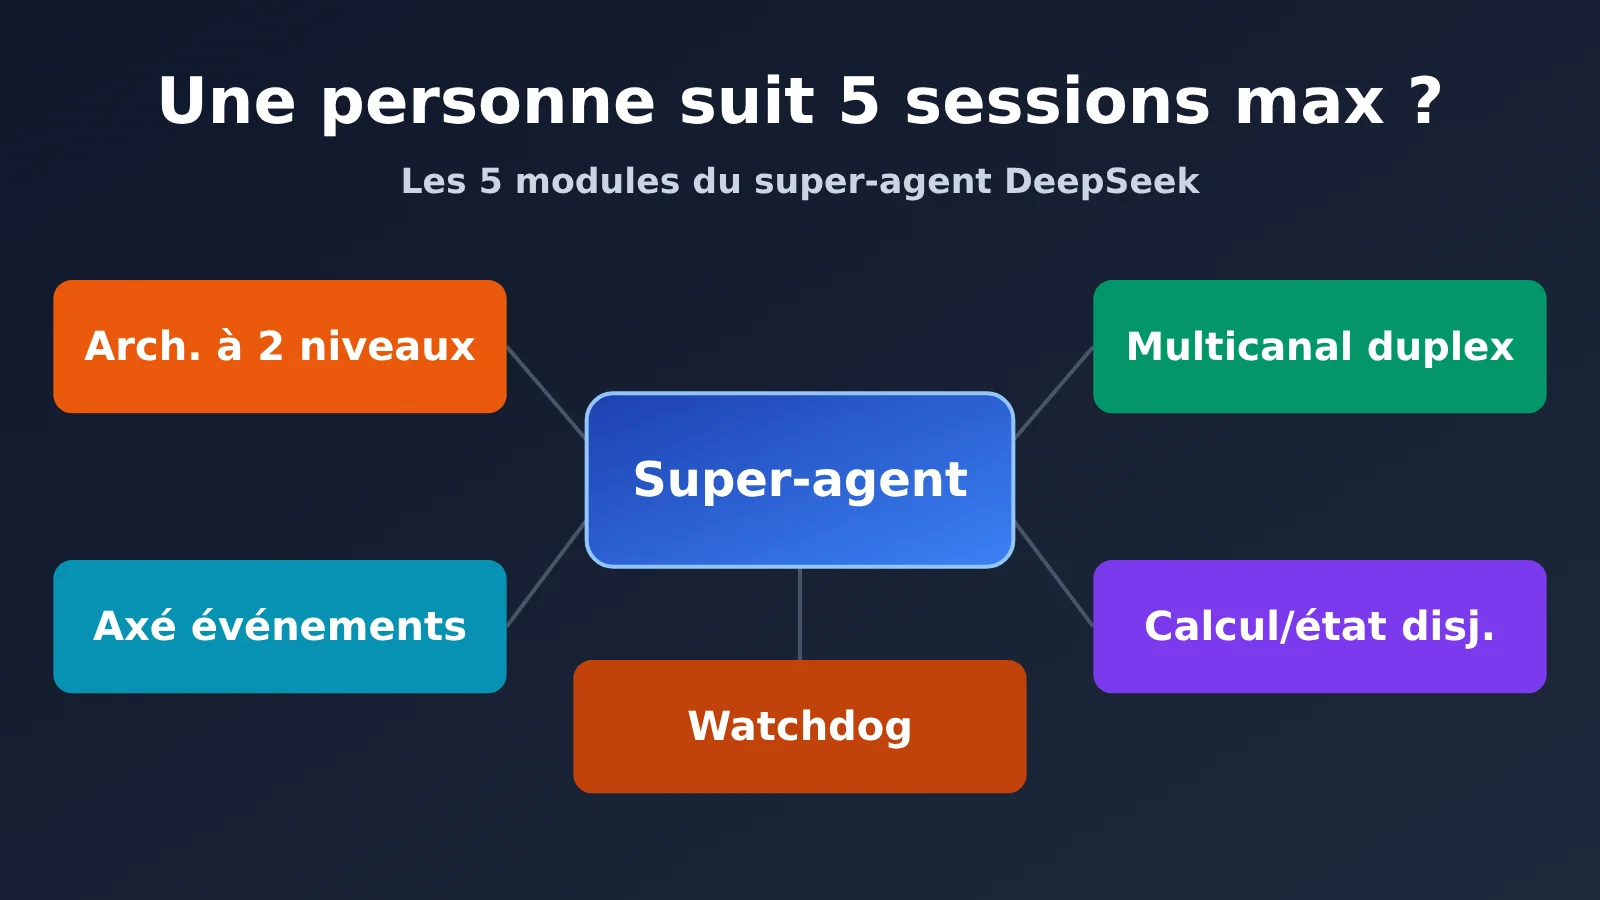
Aujourd’hui, les agents les plus répandus travaillent encore dans une seule session à la fois. Pour exécuter plusieurs tâches simultanément, l’utilisateur doit passer manuellement d’une session à l’autre et garder le contexte en tête. Selon l’expérience de l’équipe DeepSeek Harness, une personne peut généralement gérer de 3 à 5 sessions actives à la fois. Ce chiffre reflète l’expérience de l’équipe, pas une statistique universelle, mais il met en évidence un goulot d’étranglement : une tâche unique est limitée par les capacités du modèle ; plusieurs tâches sont limitées par l’attention humaine.
Ajouter des outils en ligne de commande et des connecteurs externes à un agent local lui permet seulement de recevoir des messages de l’extérieur. Trois limites subsistent :
- Blocage synchrone : dans une boucle ReAct classique, qui alterne raisonnement et appels d’outils, une opération longue bloque l’exécution et empêche l’agent de répondre aux nouveaux messages pendant ce temps.
- Mélange des contextes : les détails intermédiaires de différentes tâches se retrouvent dans une même fenêtre de contexte et interfèrent entre eux.
- Dépendance à l’appareil : dès que l’appareil local se met en veille ou se déconnecte, l’agent cesse de fonctionner.
L’article propose donc de découpler l’agent de toute session individuelle pilotée manuellement, pour en faire une entité continue. Il doit réunir les quatre caractéristiques suivantes. Une simple boucle ReAct ne suffit pas : il faut une architecture système autour d’elle.
| Caractéristique du super-agent | En clair | Principaux modules concernés |
|---|---|---|
| Continu | Dans la messagerie instantanée comme sur GitHub, on échange toujours avec ce qui semble être le même agent | Architecture à deux niveaux, interactions multicanales |
| Efficace | Il peut recevoir de nouvelles instructions avant la fin de la commande précédente et exécuter plusieurs tâches en parallèle | Architecture à deux niveaux, interactions full-duplex |
| Proactif | Il surveille les événements de son environnement et n’agit que lorsqu’ils méritent une intervention | Pilotage par événements |
| Persistant | Il reste disponible et peut se rétablir automatiquement en cas d’anomalie | Séparation du calcul et de l’état, Watchdog |
Les cinq modules du super-agent DeepSeek à la loupe
Commençons par le tableau d’ensemble. La colonne « Disponible aujourd’hui ? » mérite une attention particulière : l’article décrit des orientations de conception, pas nécessairement des fonctionnalités prêtes à l’emploi.
| Module | Problème résolu | Approche | Disponible aujourd’hui ? |
|---|---|---|---|
| Architecture à deux niveaux | Difficulté à concilier continuité et exécution simultanée | Le Router gère les interactions et répartit les tâches ; les Workers les exécutent de façon isolée | Le prototype propose un fonctionnement similaire, mais l’architecture complète reste à construire soi-même |
| Architecture pilotée par les événements | L’agent ne fait qu’attendre des instructions et les événements génèrent beaucoup de bruit | Le code effectue un premier tri rapide, le modèle affine l’analyse, et les abonnements Thread transmettent directement les événements | Le prototype peut surveiller GitHub, avec une intégration Feishu en option |
| Communication multicanal en duplex intégral | Les tâches longues bloquent la conversation et les journaux perturbent l’utilisateur | Appels d’outils asynchrones et règles de réponse adaptées à chaque canal | DeepSeek Harness prend déjà en charge les tâches asynchrones, mais elles ne sont pas activées par défaut |
| Séparation du calcul, de l’état et de l’environnement | Tout s’arrête si l’appareil est hors ligne, et les autres environnements restent inaccessibles | La boucle s’exécute dans le cloud, l’état est stocké en base de données et les points d’accès restent sur place | La source ne précise pas si cette architecture est disponible ; il faut la construire soi-même |
| Watchdog | Le processus tourne toujours, mais la tâche est bloquée ou dévie de son objectif | Une session indépendante du système principal effectue des contrôles réguliers | La source ne précise pas si cette fonctionnalité est disponible ; il faut la construire soi-même |
Module 1 : l’architecture à deux niveaux Router/Worker du super-agent DeepSeek
Analogie : le Router joue le rôle de l’accueil d’un restaurant : il reçoit les clients et transmet les commandes. Les Workers sont en cuisine : chaque poste ne prépare qu’un seul plat.
Si tous les événements passent par une seule session, le contexte reste cohérent, mais le débit est faible. À l’inverse, ouvrir une session pour chaque événement permet de traiter davantage de tâches en parallèle, mais fait perdre la vue d’ensemble et peut créer de la confusion si plusieurs sessions répondent séparément à l’utilisateur. L’architecture à deux niveaux sépare ces responsabilités : le Router, actif en continu, gère les échanges avec les utilisateurs et la coordination globale. Il peut même fonctionner sans outil Bash. Les Workers disposent chacun d’un contexte isolé et ne s’occupent que d’une seule tâche. Ils ne communiquent pas directement avec l’extérieur : ils transmettent tous leur état au Router. L’idée de l’article est que les sessions devraient rester un détail d’implémentation du système, plutôt qu’une préoccupation pour l’utilisateur.
Le Router peut sembler être un goulot d’étranglement, mais les Triggers — les événements de l’environnement — qui arrivent pendant un cycle de raisonnement sont mis en file d’attente, puis regroupés au cycle suivant. Ses requêtes ont généralement une entrée longue et une sortie courte. Les événements regroupés sont traités en parallèle pendant le Prefill, la phase où le modèle traite l’entrée : le temps d’une requête augmente donc moins vite que la taille du lot. Selon l’expérience de l’équipe, le travail du Router est souvent plus simple qu’on ne l’imagine, et un modèle léger suffit généralement. Pour commencer, vous pouvez accéder à deepseek-v4.1-flash via APIYI · apiyi.com, l’essayer comme Router et observer la précision avec laquelle il répartit les tâches.
Les Workers déterminent directement le résultat des tâches et la qualité du code. L’article recommande donc généralement d’utiliser le modèle le plus performant pour ce rôle. Sur APIYI · apiyi.com, vous pouvez comparer deepseek-v4-pro et claude-opus-5-5 sur un même ensemble de tâches, puis choisir le modèle par défaut.
Module deux : le déclenchement événementiel du super-agent DeepSeek
Analogie : un gardien filtre d’abord les visiteurs à l’aide d’une liste. En cas de doute, il demande au responsable de trancher. Les demandes suivantes d’un client existant sont directement transmises à la personne qui s’en occupe déjà.
Pour qu’un agent travaille de manière proactive, ses principales entrées doivent passer des invites humaines aux événements de son environnement : messages de groupe, résultats de CI ou commentaires de revue de code, par exemple. Les flux d’événements réels contiennent beaucoup de bruit : demander à un grand modèle de langage d’évaluer chaque événement serait trop coûteux en latence et en calcul. L’article propose donc deux niveaux de filtrage :
- Fast Path (filtrage rapide par code) : des vérifications déterministes s’appuient sur des listes d’autorisation par source, groupe, utilisateur ou bot. Pour chaque source, on peut choisir de « répondre uniquement aux demandes explicites », de « traiter comme événement candidat » ou d’« ignorer ».
- Slow Path (évaluation par le modèle) : seuls les événements candidats ayant passé le filtre rapide sont transmis au LLM. Celui-ci décide d’agir ou non en tenant compte du contexte et d’une stratégie formulée dans une invite.
Le routage suit lui aussi une voie rapide et une voie lente. Les événements successifs liés à une même PR, à un sujet de messagerie instantanée ou à une chaîne d’e-mails forment un Thread. Une fois qu’un Worker s’y est abonné, les événements suivants lui sont directement transmis par le code, sans nouvelle décision du Router. Si plusieurs Workers sont abonnés au même Thread, ils reçoivent les mêmes notifications et peuvent ainsi détecter et résoudre eux-mêmes les conflits.
Le contexte est quant à lui géré comme un cache. Les informations nécessaires à court terme sont placées directement dans la fenêtre de contexte (Inline). Les informations complètes rarement utilisées restent hors de la fenêtre, avec seulement une référence ou un résumé dans celle-ci (Spill). L’article évoque aussi les actions anticipées : consulter un calendrier ou reproduire une issue en arrière-plan, puis ne livrer que les résultats utiles et abandonner le reste. On utilise ainsi davantage de puissance de calcul pour réduire l’attente et les interventions humaines.
Module 3 : interaction full-duplex multicanal du super-agent DeepSeek
Analogie : Quand vous faites bouillir de l’eau, inutile de rester à côté de la bouilloire : elle vous avertit quand l’eau est prête. Entre-temps, vous pouvez continuer à discuter avec quelqu’un.
Le ReAct asynchrone remplace les appels longs par start() et stop(). start() renvoie immédiatement la main, puis l’outil s’exécute en arrière-plan. Une fois terminé, son résultat est renvoyé à la conversation sous forme d’un nouvel événement. Le modèle peut aussi utiliser stop() pour arrêter une commande qui prend trop de temps. Les nouveaux messages de l’utilisateur peuvent ainsi être traités dès la fin de l’étape de raisonnement en cours. L’article précise que DeepSeek Harness a déjà mis en place ce mécanisme de tâches asynchrones, mais qu’il n’est pas encore activé par défaut.
Le multicanal répond à une autre question : « comment communiquer ? » Sur une messagerie instantanée, les échanges doivent rester légers et peu intrusifs : l’agent ne notifie l’utilisateur que lorsqu’une décision ou une validation est nécessaire. L’équipe a testé une règle stricte : pas plus de 100 mots par réponse. Sur GitHub, dans les courriels et les documents, les réponses doivent au contraire être structurées et riches en informations. Dans une PR, par exemple, il faut expliquer clairement le contexte du problème, les modifications apportées et les résultats des vérifications.
Module 4 : séparation du calcul, de l’état et de l’environnement du super-agent DeepSeek
Analogie : Les dossiers sont conservés dans les archives de l’entreprise : un employé peut changer de bureau et reprendre son travail. Et si un outil se trouve sur une machine précise, il suffit d’envoyer quelqu’un l’utiliser sur place.
L’article présente ce découplage en deux étapes. D’abord, la boucle de l’agent s’exécute dans un conteneur cloud sans état, tandis que l’état de la session est stocké dans une base de données. Le redémarrage ou le remplacement du conteneur n’interrompt donc pas la tâche. Ensuite, l’environnement d’exécution reste sur place : chaque appareil ne reçoit qu’un daemon léger, un petit programme qui tourne en arrière-plan. Il ne conserve pas l’état de la session ; il se contente d’exécuter les commandes et de renvoyer les résultats.
Cette architecture prend aussi en charge le BYOM (Bring Your Own Machine), qui permet de connecter son propre ordinateur à l’agent cloud. Il n’est donc pas nécessaire de synchroniser dans le cloud toutes les modifications non commitées et les informations d’authentification locales. Lorsque l’appareil se reconnecte, l’agent cloud peut reprendre les tâches qui doivent s’exécuter sur cette machine. L’article « Decoupling the brain from the hands » d’Anthropic adopte une approche similaire du découplage et peut être lu en complément.
Module cinq : la surveillance externe par le Watchdog de DeepSeek Super Agent
Analogie : un responsable de garde ne participe pas au travail lui-même. Il vérifie régulièrement qui s’est arrêté et qui s’est écarté de sa mission.
Beaucoup d’Agents ne plantent pas vraiment : leur processus tourne toujours, mais le modèle reste bloqué dans une boucle improductive. Les sondes de disponibilité classiques ne détectent pas ce genre de problème. Le Watchdog est une session indépendante, exécutée en dehors du système principal et déclenchée par des messages programmés. Il gère les pannes d’infrastructure, comme les erreurs d’API ou les échecs de restauration d’état, et utilise aussi un modèle pour déterminer si chaque Worker progresse réellement. Les responsables de maintenance peuvent lui demander en langage naturel « pourquoi ça a échoué », mais aussi lui faire ajuster les invites et les règles de déclenchement pendant que le système fonctionne.
Que peut-on déjà essayer avec le prototype de DeepSeek Super Agent ?
Le dépôt associé est github.com/deepseek-ai/dsh-superagent-prototype. Il est distribué sous licence MIT et comptait 8 636 stars et 863 forks lors du relevé du 2 novembre 2026. C’est un prototype de recherche, pas un produit officiel de DeepSeek. Il ne correspond pas non plus à la version interne de l’équipe ni à l’implémentation complète décrite dans l’article : certaines conceptions évoquées sont des pistes pour l’avenir et ne sont pas implémentées dans le prototype.
Le prototype est un Agent de programmation proactif conçu pour travailler sur un seul dépôt GitHub, distribué sous forme de bundle DeepSeek Harness. Il surveille GitHub et peut aussi être connecté à Feishu. Lorsqu’on lui confie une tâche, il crée un élément de travail, l’exécute dans sa propre session et son propre répertoire, puis revient répondre dans la conversation d’origine, par exemple en soumettant une PR. Un tableau de bord web affiche également les points qui nécessitent une intervention humaine.
Que nous apprennent les deux séries de tests du super-agent DeepSeek ?
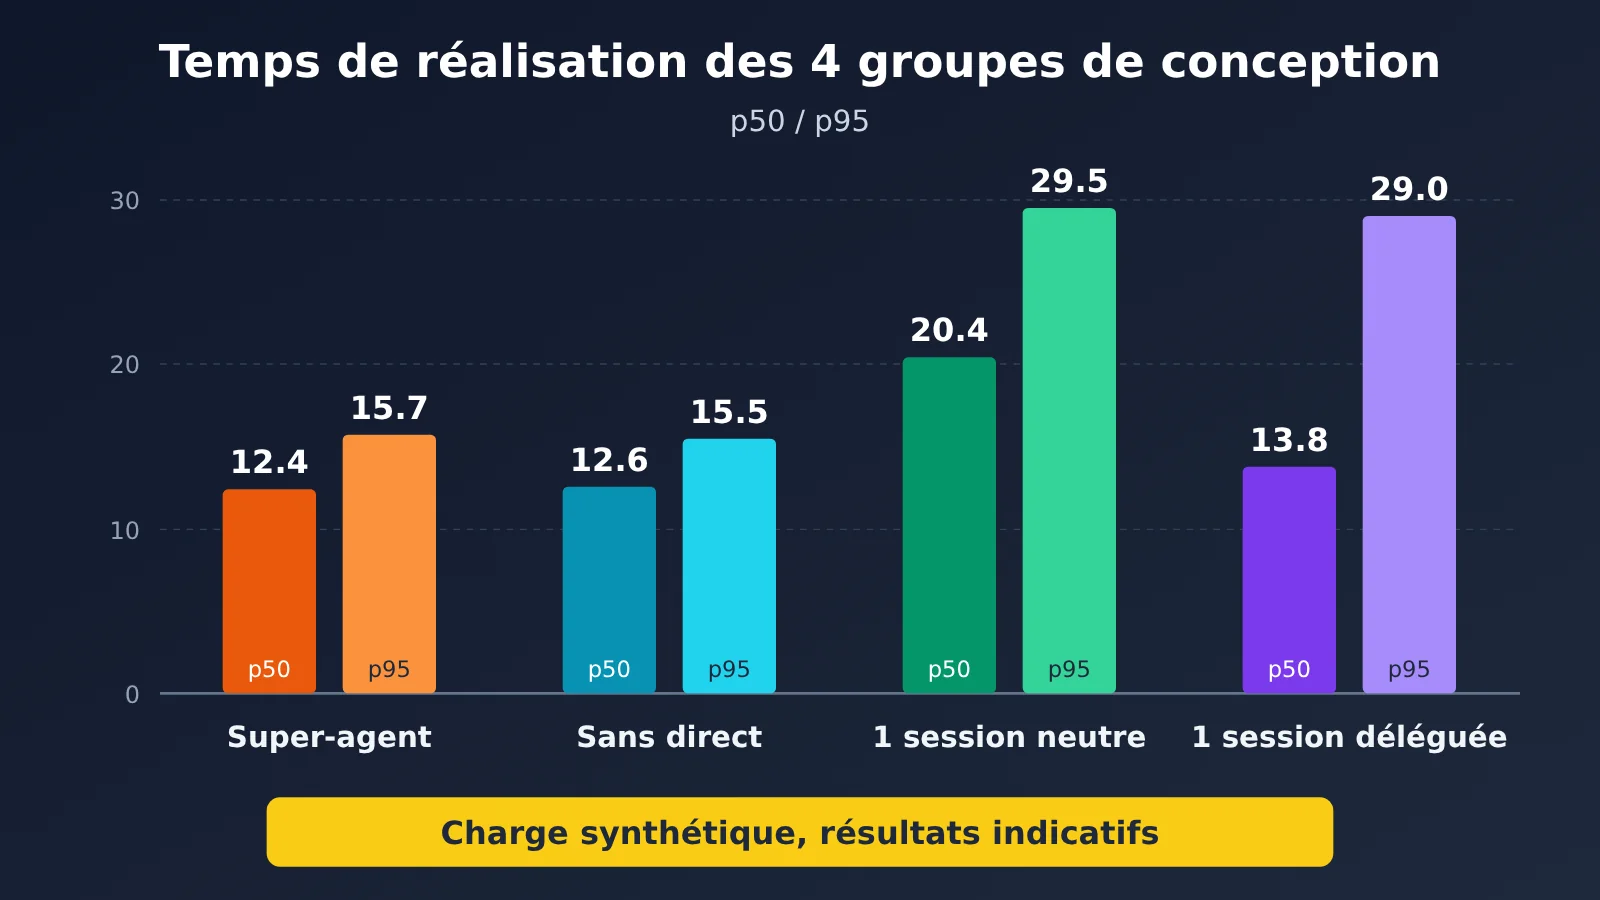
Les chiffres ci-dessous sont publiés par les auteurs dans leur article officiel. Les tests utilisent une charge synthétique et un environnement simplifié ; les auteurs précisent que les résultats sont purement indicatifs. Dans la première série, chaque exécution compte environ 300 messages, dont une vingtaine de demandes de travail. Chaque configuration a été testée cinq fois. Les tâches de programmation sont simulées par des outils qui ne font que consommer du temps : le test mesure donc l’ordonnancement et la coordination, pas la qualité d’exécution des tâches.
Dans le tableau, p50 indique le délai dans lequel la moitié des tâches sont terminées, et p95 celui dans lequel 95 % des tâches sont terminées. Les cache-read tokens sont les tokens lus depuis le cache : le contexte déjà mis en cache est réutilisé directement, sans être retraité. Le chiffre indiqué correspond au total de toutes les sessions.
| Configuration | p50 (minutes) | p95 (minutes) | cache-read tokens / exécution |
|---|---|---|---|
| Super-agent | 12.4 | 15.7 | 23.2M |
| Sans Pass-through (transmission directe des événements abonnés) | 12.6 | 15.5 | 31.8M |
| Session unique + sous-agents (invite neutre) | 20.4 | 29.5 | 6.1M |
| Session unique + sous-agents (invite privilégiant la délégation) | 13.8 | 29.0 | 10.8M |
Avec l’invite neutre, le modèle n’a appelé aucun sous-agent lors des cinq exécutions. Avec l’invite privilégiant la délégation, il a délégué quatre fois sur cinq ; la dernière fois, il a jugé la tâche assez petite pour la réaliser lui-même. Cela montre que, pour cette charge, les performances d’une session unique dépendent fortement de l’invite et du jugement du modèle au moment de l’exécution, tandis que l’architecture à deux niveaux inscrit la délégation dans le système. La contrepartie est claire : le Super-agent consomme nettement plus de tokens lus depuis le cache. Il utilise donc plus de tokens pour obtenir des délais d’exécution plus courts et plus stables.
Sans la transmission directe, les délais restent presque inchangés, mais le nombre de décisions du Router augmente d’environ 30 % et les cache-read tokens d’environ 37 %. Pour cette charge, la transmission directe n’a donc pas accéléré le traitement : elle a surtout réduit la surcharge du Router.
La deuxième série soumet la couche Router à un test de charge séparé : le Router appelle un vrai modèle, tandis que le Worker utilise un modèle simulé. Le taux d’arrivée des Trigger nécessitant une décision du Router augmente progressivement.
| Taux d’arrivée (par minute) | Taille moyenne des lots | Temps par requête | Temps d’inférence amorti par décision |
|---|---|---|---|
| Environ 1 | 1.0 | 2.5 secondes | 6.4 secondes |
| Environ 40 | 2.8 | 3.9 secondes | 1.6 seconde |
Une décision peut nécessiter plusieurs requêtes LLM : le temps amorti peut donc dépasser le temps par requête. Ces données montrent qu’en cas d’afflux soudain d’événements, le regroupement automatique peut améliorer le débit effectif du Router. Elles ne prouvent toutefois pas que les résultats seraient identiques dans un environnement de production réel et ne disent rien de la qualité des tâches ni des performances sur différentes bases de code.
Les quatre questions ouvertes autour du super-agent DeepSeek
L’article reconnaît clairement que les questions suivantes restent sans réponse. Il faut donc en tenir compte lors de l’évaluation d’une solution concrète :
- Comment faire évoluer l’architecture : lorsque les tâches deviennent plus importantes et plus interdépendantes, faut-il partitionner le Router et, si oui, à quel niveau de granularité ? Quand les Workers doivent-ils communiquer directement ? Rien n’est encore tranché. Plus le partitionnement est fin, plus la concurrence augmente, mais moins la mémoire et le contexte sont partagés. La mémoire à long terme constitue elle aussi un obstacle majeur.
- Comment l’utiliser sans session : il reste à inventer de nouveaux modes d’interaction pour présenter les tâches et permettre aux utilisateurs d’intervenir sur des détails importants sans interrompre le travail en arrière-plan.
- Limites du contexte et A2A : le terme A2A (agent-to-agent) désigne la communication et la collaboration entre différents agents. À mesure que l’organisation grandit, configurer un super-agent revient à décider quels contextes sont partagés et lesquels sont isolés. La question de la collaboration sécurisée entre différents niveaux d’autorisation reste ouverte.
- Sécurité et confidentialité : c’est le point à évaluer en priorité. La boucle d’exécution dans le cloud reçoit en permanence des événements externes, tandis que les points de terminaison détiennent du code privé et des identifiants locaux. Si le serveur est compromis ou si la boucle est détournée par une injection de prompt (des instructions malveillantes dissimulées dans les données d’entrée), tous les points de terminaison connectés risquent de passer sous le contrôle d’un attaquant. Selon l’article, les agents ont besoin d’un moyen « d’utiliser les identifiants sans les voir ».
DeepSeek : liste minimale pour déployer un super-agent en petite équipe
L’ordre proposé ci-dessous s’appuie sur les idées de l’article d’origine, mais ne constitue pas une feuille de route officielle. Commencez par un projet pilote dans un seul dépôt et un périmètre de confiance. Laissez le sharding du Router pour plus tard.
Première étape : séparer Router et Worker
- Code : créez un point d’entrée Router disponible en permanence, sans lui donner accès à l’outil Bash. Lancez un Worker distinct pour chaque tâche, avec son propre contexte et son propre répertoire de travail. Les Workers transmettent leurs résultats uniquement au Router.
- Modèles : utilisez un modèle léger pour le Router et un modèle plus performant pour les Workers. Configurez-les séparément pour pouvoir les remplacer indépendamment.
- Humain : échangez uniquement avec le Router. Définissez les limites des tâches, répondez aux demandes de décision et validez le résultat final.
Deuxième étape : ajouter le filtrage Trigger
- Code : configurez une liste de sources autorisées et trois niveaux de stratégie. Associez les PR et les sujets de messagerie instantanée à des Threads. Les événements suivants auxquels le Worker est déjà abonné lui sont transmis directement.
- Modèle : effectuez une analyse sémantique uniquement sur les événements candidats, pour déterminer s’il faut agir et s’il faut lancer un nouveau Worker.
- Humain : définissez clairement les conditions d’action dans une invite. Vérifiez régulièrement les déclenchements à tort et les déclenchements manqués, puis ajustez la liste des sources autorisées et les stratégies.
Troisième étape : ajouter le Watchdog
- Code : déployez-le en dehors du système principal et activez-le au moyen de messages planifiés. Il vérifie les problèmes d’infrastructure, comme les erreurs d’API ou les échecs de restauration de l’état.
- Modèle : lisez les journaux de progression des Workers pour déterminer s’ils avancent réellement, sont bloqués ou s’écartent de leur objectif.
- Humain : définissez les droits de réparation du Watchdog, approuvez ses modifications des invites et des règles de déclenchement, puis analysez les causes des échecs.
Dès le premier jour, évitez de placer directement les identifiants de production dans le contexte du modèle et configurez les droits selon le principe du moindre privilège. Les appels d’outils asynchrones et la séparation des ressources de calcul peuvent attendre que les trois premières étapes fonctionnent de manière stable et que vous rencontriez réellement des blocages ou des équipements hors ligne.
Choix des modèles et estimation des coûts pour le super-agent DeepSeek
Le tableau ci-dessous reprend les tarifs des modèles APIYI · apiyi.com consultés le 2 novembre 2026, en dollars par million de tokens. Consultez la liste des modèles de la plateforme pour connaître les modèles et les prix en vigueur ; les frais réels sont indiqués dans la console.
| Modèle | Entrée | Sortie | Lecture du cache |
|---|---|---|---|
| deepseek-v4.1-flash | 0,3 | 1,2 | 0,006 |
| deepseek-v4-flash | 0,44 | 1,32 | 0,01408 |
| deepseek-v4-pro | 1,32 | 3,96 | 0,043996 |
| claude-opus-5-5 | 4 | 20 | 0,2 |
Les chiffres suivants sont des estimations calculées à partir des tarifs publics, et non des mesures réelles. On suppose qu’une invocation consomme 20 000 tokens en entrée et 2 000 en sortie, sans tenir compte du cache pour l’instant :
- Environ 0,0084 $ avec
deepseek-v4.1-flash, 0,0343 $ avecdeepseek-v4-proet 0,12 $ avecclaude-opus-5-5. - Une invocation du Router avec
deepseek-v4.1-flashet une du Worker avecdeepseek-v4-procoûtent environ 0,0427 $ au total. Avecclaude-opus-5-5des deux côtés, le coût atteint environ 0,24 $, soit 5,6 fois plus. - Pour 20 séries par jour avec cette consommation, la combinaison de modèles coûte environ 0,85 $, contre 4,8 $ en utilisant uniquement
claude-opus-5-5. En pratique, un Worker effectue souvent plusieurs invocations : recalculez donc ces montants avec le nombre de tokens indiqué dans vos journaux.
Pour les systèmes qui fonctionnent sur de longues périodes, il faut aussi calculer séparément le coût de lecture du cache. Pour les 23,2 millions de tokens lus depuis le cache dans l’expérience, le coût estimé serait d’environ 0,14 $ avec deepseek-v4.1-flash, 1,02 $ avec deepseek-v4-pro et 4,64 $ avec claude-opus-5-5. Ce ne sont que des ordres de grandeur : l’expérience n’a pas communiqué la répartition des tokens entre les différentes couches, et ces montants n’incluent pas les frais d’entrée et de sortie.
Il vaut mieux rendre les modèles du Router et du Worker configurables. Avec APIYI · apiyi.com, vous pouvez passer d’un modèle à l’autre avec une seule clé API. Le base_url de l’interface compatible OpenAI est https://api.apiyi.com/v1 ; pour changer de modèle, il suffit principalement de modifier son nom. Cela facilite la comparaison de la qualité et des coûts sur un même ensemble de tâches. Le prix n’est toutefois qu’un critère parmi d’autres : le choix du modèle par défaut du Worker dépend aussi du taux de réussite des tâches et du travail à reprendre.
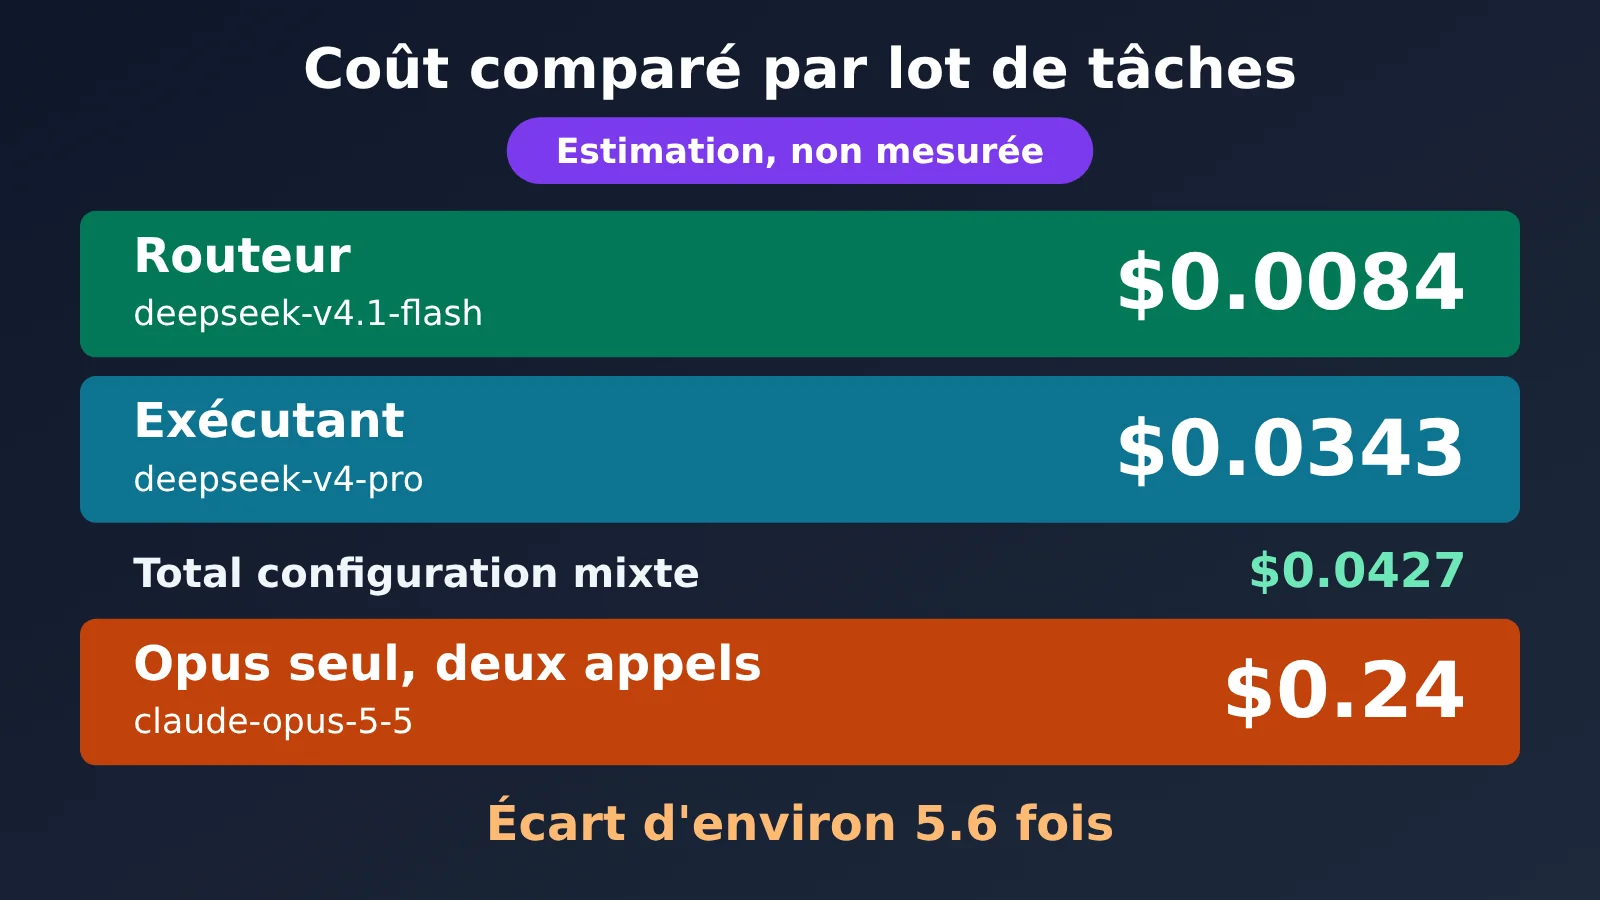
Le graphique ci-dessus est une estimation basée sur les tarifs par défaut de la liste des modèles APIYI · apiyi.com. Utilisez votre propre consommation de tokens pour établir votre budget.
FAQ sur le Super-agent DeepSeek
Q1 : Est-ce un nouveau modèle ?
Non. Il s’agit d’un article sur l’architecture d’un système d’agents. Il explique comment le système qui entoure le modèle organise les sessions, les événements, les états et la surveillance. Aucun nouveau modèle n’a été annoncé.
Q2 : Les développeurs peuvent-ils l’utiliser directement ?
Les cinq modules ne sont pas disponibles clés en main. Pour l’instant, vous pouvez essayer le prototype de recherche ou créer votre propre système en suivant les principes de l’article. La seule implémentation existante explicitement mentionnée dans l’article d’origine est le mécanisme de tâches asynchrones de DeepSeek Harness, désactivé par défaut.
Q3 : dsh-superagent-prototype est-il un produit officiel ?
Non. Son README précise qu’il est destiné uniquement à la recherche. Ce n’est pas un produit officiel de DeepSeek et il ne correspond pas à une version interne ni à l’implémentation complète décrite dans l’article.
Q4 : Un système multi-agents coûte-t-il plus cher ?
Dans cette série d’expériences, le nombre de tokens lus depuis le cache est effectivement plus élevé : 23,2 millions pour le Super-agent, contre 6,1 à 10,8 millions pour la solution à session unique. En contrepartie, les temps d’exécution sont plus courts et plus stables. Le coût total dépend aussi des modèles utilisés et de la taille des tâches. Utiliser un modèle léger pour le Router et activer le passage direct par le Thread permet de limiter les dépenses.
Q5 : Comment accéder à ces modèles depuis la Chine ?
Vous pouvez vous inscrire sur APIYI · apiyi.com pour obtenir une clé API. Les nouveaux utilisateurs bénéficient d’un crédit gratuit pour les tests. Modifiez ensuite le base_url du client avec l’adresse indiquée plus haut et renseignez le nom du modèle figurant dans le tableau. Ces modèles DeepSeek et Claude prennent tous en charge les endpoints chat et messages. Avant la mise en production, il est conseillé de les tester avec un faible volume de requêtes.
Conclusion
L’intérêt de cet article sur le super-agent DeepSeek, c’est qu’il applique aux agents des principes classiques d’ingénierie système. Voici les points à retenir :
- Le problème : pour une tâche unique, les modèles ont de moins en moins besoin d’intervention humaine. Avec plusieurs tâches, c’est désormais l’attention humaine qui devient le facteur limitant.
- Les cinq modules : architecture à deux niveaux, fonctionnement piloté par les événements, communication multicanale en duplex intégral, séparation entre calcul, état et environnement, et Watchdog. Ensemble, ils visent quatre caractéristiques : continuité, efficacité, proactivité et persistance.
- Les limites des résultats : les deux expériences reposent sur des charges synthétiques et leurs résultats sont rapportés par l’auteur. Ils servent donc de pistes de conception, pas de preuve générale.
- L’ordre de mise en place : commencez par séparer Router et Worker, ajoutez ensuite le filtrage par Trigger, puis le Watchdog. Gardez les limites de sécurité en tête à chaque étape.
Pas besoin de figer le choix des modèles dès le départ : avec APIYI · apiyi.com, vous pouvez comparer plusieurs configurations à petite échelle sur les mêmes tâches, puis choisir en fonction du taux de réussite et de la facture.
Commencez par vous libérer du rôle de « Router humain » avant d’envisager d’ajouter plus d’agents.
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour en savoir plus, consultez le centre de documentation docs.apiyi.com.