Note de l’auteur : cet article explique en 5 étapes comment concevoir des jalons de validation pour un agent, afin qu’une exécution longue dispose d’un point d’arrivée clair, de retours fiables et de coûts maîtrisés.
Après plusieurs heures, voire plusieurs jours, d’exécution continue, un agent renvoie un résultat qui semble complet, mais personne n’ose le fusionner directement. C’est un problème que rencontrent de nombreuses équipes de développement. Cet article présente la méthode de conception en 5 étapes des jalons de validation de l’agent, pour vous aider, avant de lancer une tâche longue, à définir « terminé » comme un ensemble de critères que la machine peut vérifier de manière répétée.
Le 27 octobre 2026, Gregory Kurtzer, l’un des fondateurs de CentOS, a dévoilé le projet Ginux. Selon les rapports, il a produit environ 139 000 lignes de code en 11 jours, principalement grâce à une tâche Codex exécutée en continu, permettant à ce noyau indépendant de démarrer Rocky Linux 10 et d’exécuter systemd. Quand on lui a demandé comment remettre sur les rails un agent qui partait en vrille, sa réponse a été simple : multiplier les jalons de validation.
Ce n’est pas un énième recueil d’astuces sur les invites : cet article s’intéresse à la structure d’ingénierie dont dépendent réellement les tâches longues — objectifs, jalons, preuves, régression et conditions d’arrêt.
Valeur clé : à la fin de cet article, vous saurez rédiger un ensemble de jalons de validation d’agent pour votre propre projet, et déterminer quelles étapes confier à la machine et quelles décisions doivent rester humaines.
Points clés des jalons d’acceptation de l’Agent
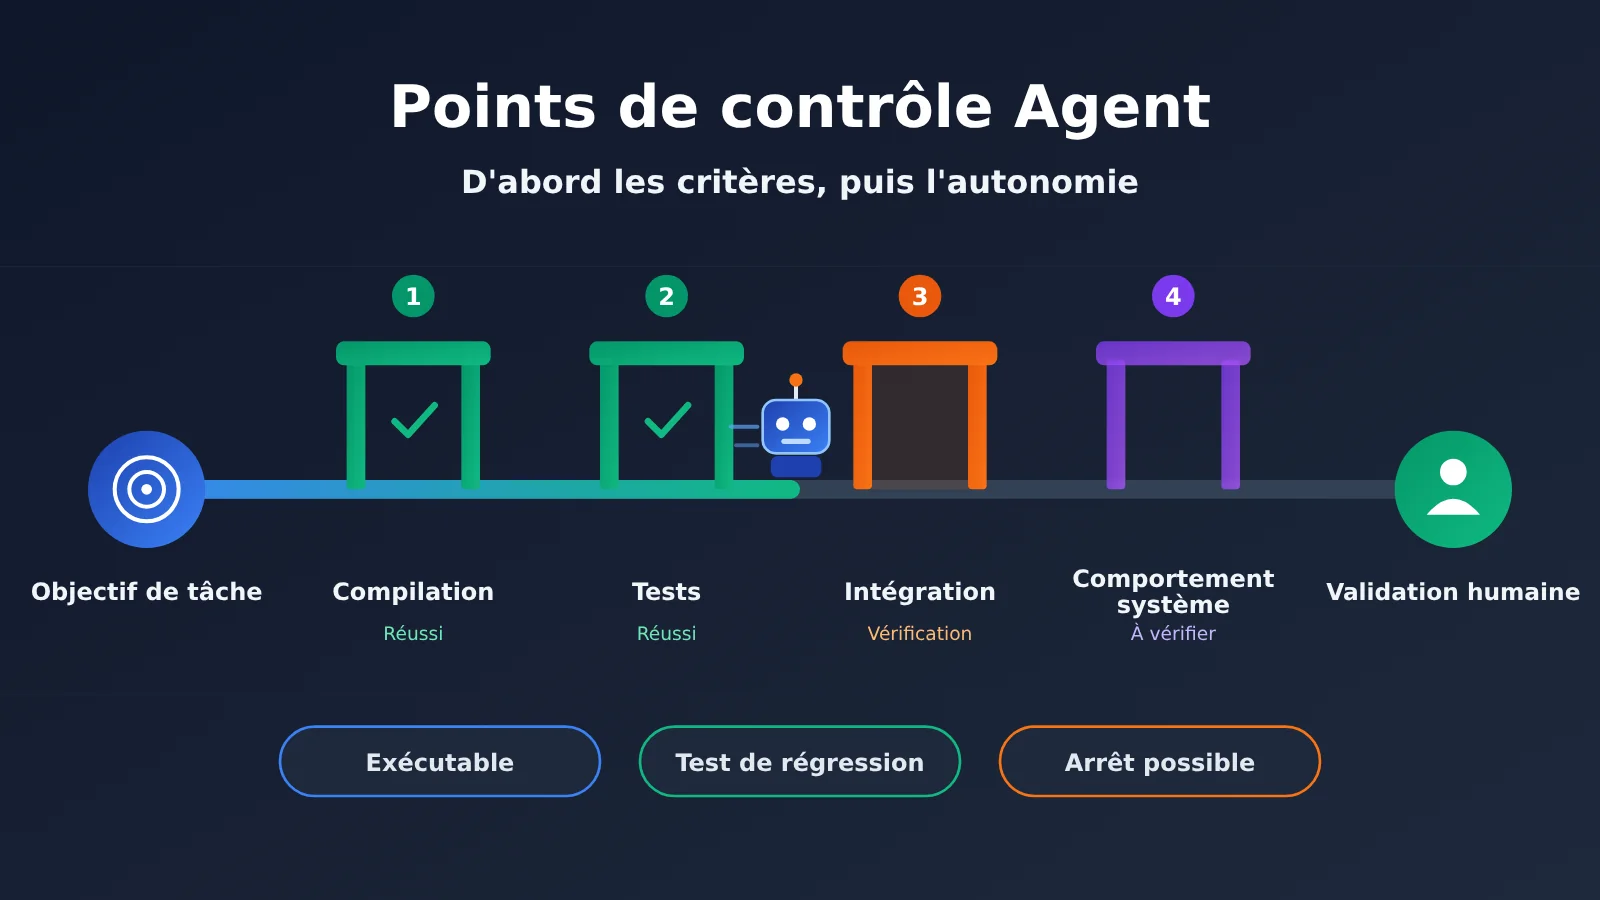
Un jalon d’acceptation de l’Agent est un ensemble de points de contrôle prédéfinis et reproductibles. Il indique à l’Agent si le résultat actuel est à la hauteur, et il indique aussi à l’humain quelles preuves méritent d’être examinées.
| Point clé | Description | Valeur |
|---|---|---|
| Critères d’acceptation définis en amont | Écrire noir sur blanc le point d’arrivée et les objectifs intermédiaires avant de lancer une tâche longue | Évite que l’Agent prenne un succès local pour un achèvement global |
| Des jalons exécutables | Le verdict repose sur des commandes, des scripts, la CI ou de vrais résultats d’exécution | L’Agent peut itérer seul, sans attendre un humain |
| Vérifier le comportement du système | S’intéresser à ce que le programme fait réellement à l’exécution | Repérer les sorties erronées « qui paraissent crédibles » |
| Responsabilités réparties entre humain et machine | L’humain fixe l’architecture et les critères d’acceptation, l’Agent implémente et fait les tests de régression | L’humain n’est plus le maillon le plus lent de la boucle |
| Budget maîtrisé | Définir à l’avance le nombre d’échecs, le volume consommé et les conditions de mise en pause | Évite qu’une tâche longue continue de consommer dans la mauvaise direction |
Les jalons d’acceptation de l’Agent dans le cas Ginux
Kurtzer n’a pas simplement confié « écrire un noyau » à l’Agent. Il a choisi des jalons impératifs du genre : un programme en espace utilisateur Linux peut-il s’exécuter, systemd peut-il démarrer ? systemd dépend d’un grand nombre de composants système et constitue le processus central du démarrage et du fonctionnement de toute la machine : c’est donc un excellent test pour savoir si le noyau est réellement utilisable.
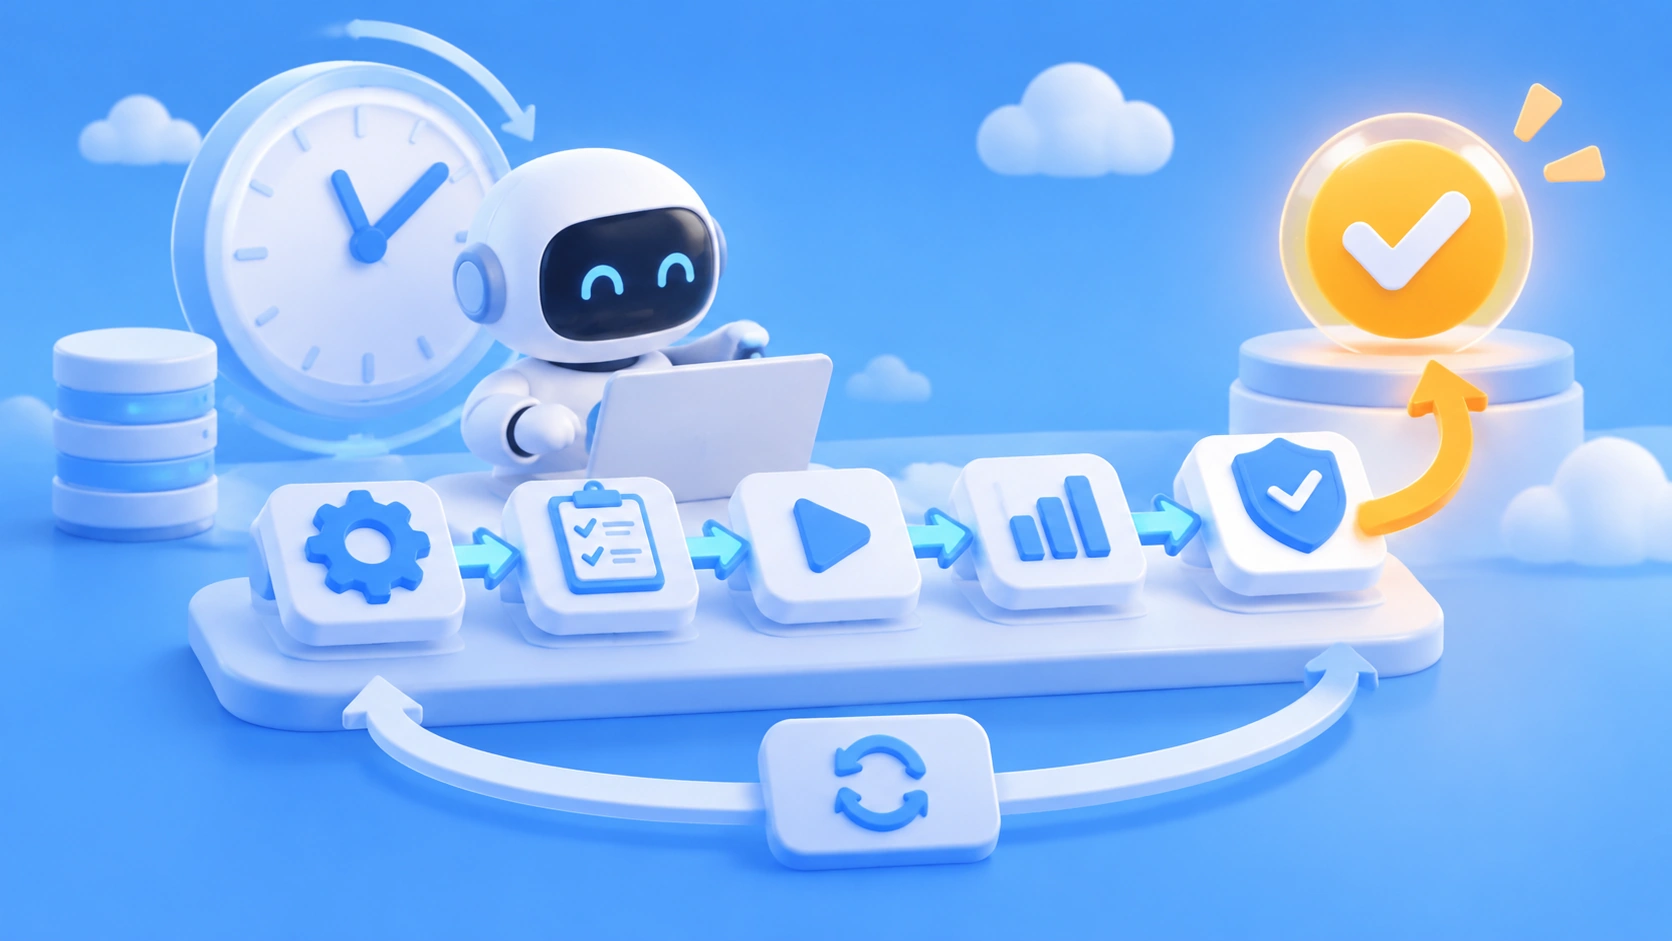
Le projet tourne selon deux boucles qui s’articulent. La boucle externe est pilotée par l’humain : de la vision à l’architecture et aux contraintes, puis aux jalons d’acceptation, jusqu’à l’examen du comportement réel et la décision de corriger ou d’accepter. La boucle interne est assurée par l’Agent : implémentation, build et exécution dans QEMU, mesure et analyse des pannes, corrections, puis tests de régression.
Kurtzer prévient également : beaucoup de pannes produisent des sorties très crédibles alors qu’elles violent en réalité la sémantique, les exigences d’isolation ou le comportement attendu du cycle de vie. Sans jalons, on finit facilement avec du code qui tourne en apparence, mais dont la structure est fragile.
Pourquoi les jalons d’acceptation de l’Agent doivent s’exécuter automatiquement
Lauren Tan, ingénieure chez Cursor, considère elle aussi la vérification comme la compétence la plus importante lorsqu’on utilise des agents. Par vérification, elle entend notamment faire réellement exécuter le code par l’Agent, capturer des traces CPU ou des instantanés de tas mémoire, ouvrir le simulateur iOS et manipuler l’application comme le ferait un utilisateur.
Elle affirme publiquement pouvoir fusionner 4 000 PR par mois en production. Même à seulement 5 minutes de relecture humaine par PR, cela représente environ 333 heures cumulées : à cette échelle, le système de vérification doit donc pouvoir fonctionner sans intervention. Ce cas extrême suscite pas mal de débats, mais il illustre une leçon valable pour n’importe quelle équipe : c’est seulement si l’Agent peut vérifier sa propre sortie qu’il peut travailler en continu ; s’il ne le peut pas, il ne lui reste qu’à vous tendre le diff et à s’arrêter.
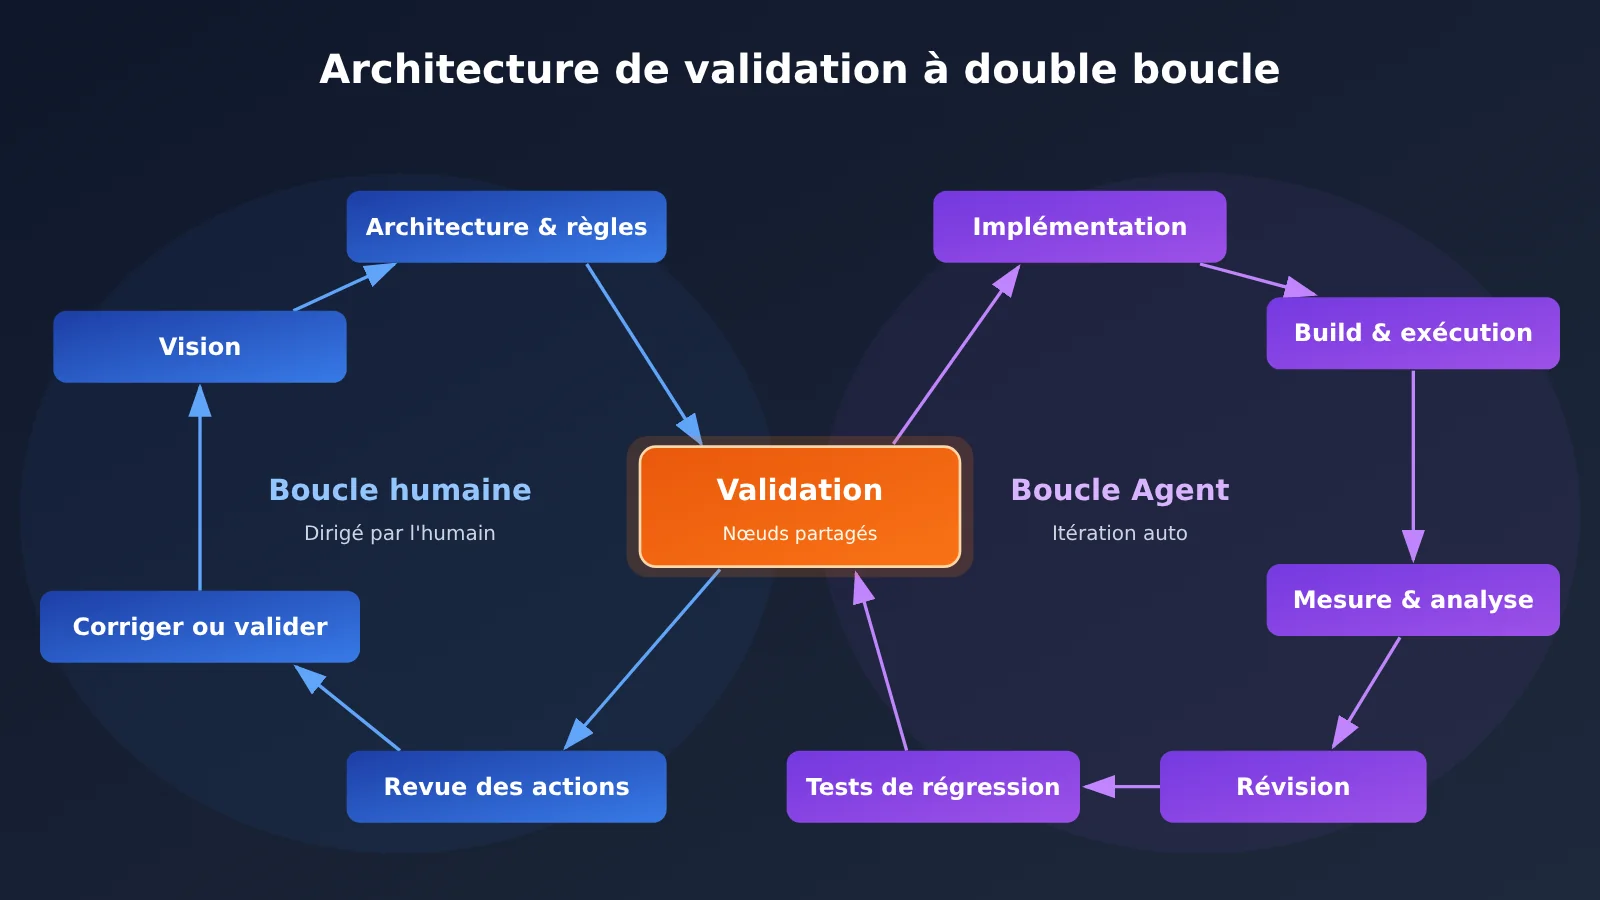
La double boucle du schéma se transpose directement dans les projets du quotidien. Si vous voulez confier l’implémentation et la revue à des modèles différents, vous pouvez y accéder via APIYI apiyi.com, puis intégrer l’invocation des modèles dans la boucle interne.
Prise en main rapide des points de contrôle d’acceptation pour les agents : la méthode de conception en 5 étapes
Prenons une tâche courante comme exemple : demander à un agent de migrer un ancien service REST vers un nouveau framework, tout en veillant à ce que les clients existants ne soient pas impactés. Vous pouvez remplacer les éléments de vérification de l’exemple par les processus de build, de test et de déploiement de votre propre projet.
Étape 1 : définir un point d’arrivée au niveau système pour les points de contrôle d’acceptation de l’agent
Commencez par écrire une phrase observable qui décrit ce qui doit se produire dans le système à la fin de la tâche. « Migration du service terminée » est trop vague ; en revanche, « avec le même lot de requêtes de rejeu, les codes d’état et les champs clés des réponses des anciens et nouveaux services restent identiques » peut être vérifié.
Un bon point d’arrivée découle généralement d’un parcours d’usage réel. Pour Ginux, le point d’arrivée est Rocky Linux 10 qui démarre jusqu’à la cible multi-user.target de systemd ; pour une application web, cela peut être le bon déroulement des parcours utilisateurs clés ; pour une tâche de données, cela peut être la concordance des résultats de sortie avec le jeu de données de référence.
Étape 2 : décomposer les points de contrôle d’acceptation de l’Agent en cinq niveaux
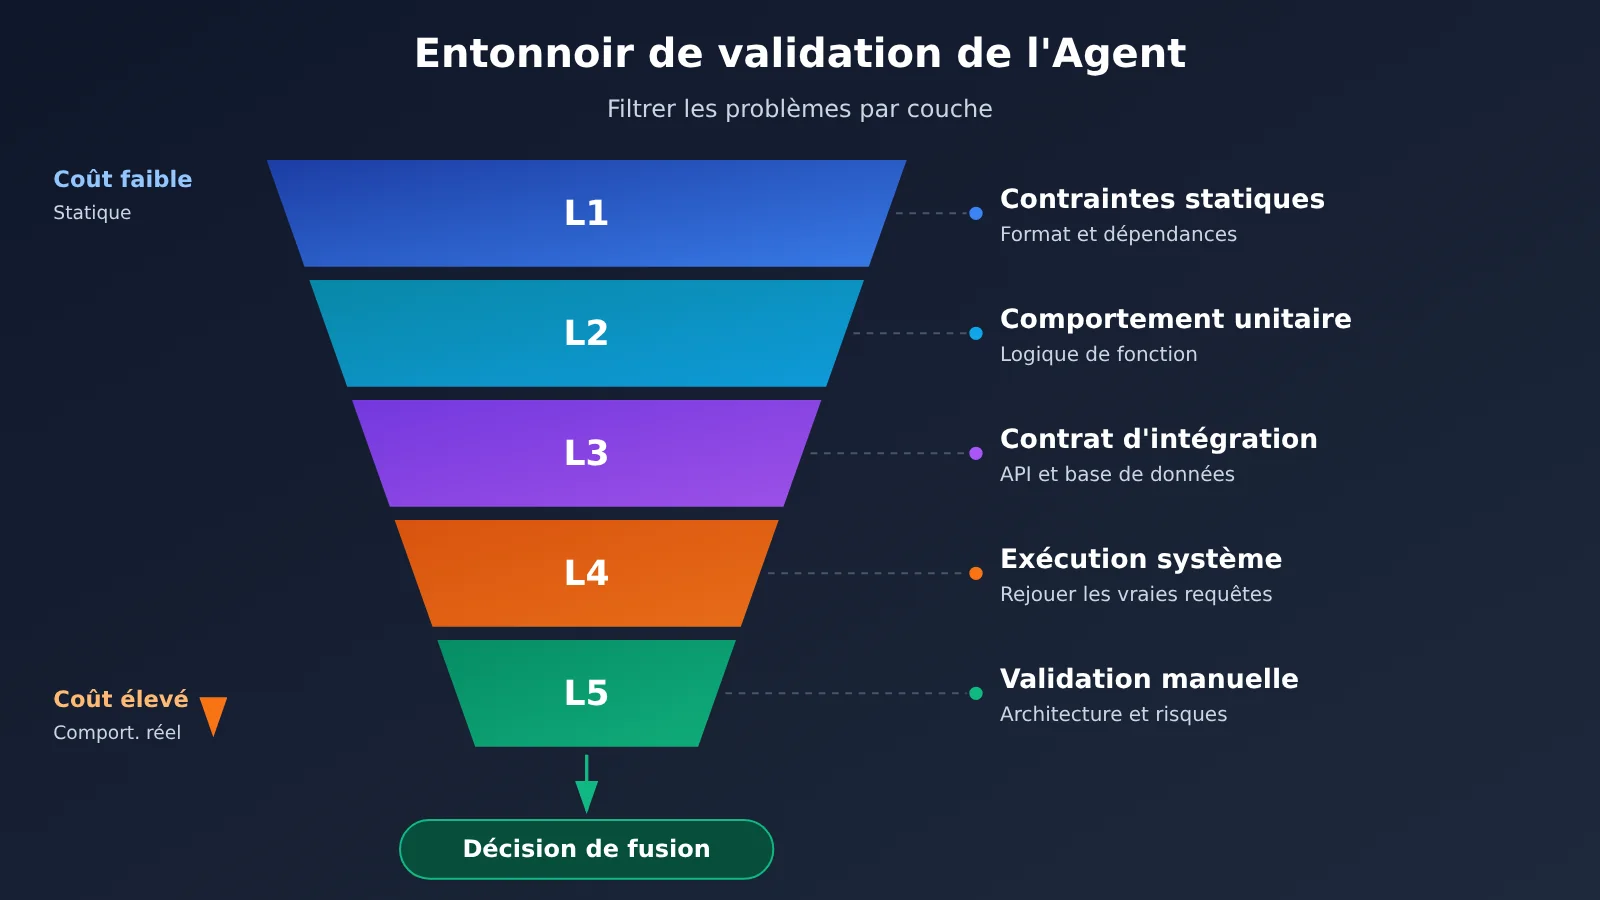
Un seul retour de test final est trop lent, et lorsqu’un Agent échoue, il est difficile d’identifier la cause du problème. Il est recommandé de définir des points de contrôle en allant du coût d’exécution le plus faible au plus élevé, afin que les vérifications les moins coûteuses bloquent d’abord les erreurs évidentes.
| Niveau du point de contrôle | Éléments vérifiés | Exemple | Action en cas d’échec |
|---|---|---|---|
| L1 Contraintes statiques | Format, types, frontières de dépendances | Interdiction des imports croisés entre modules | L’Agent corrige immédiatement |
| L2 Comportement unitaire | Logique des fonctions et des modules | Tests unitaires du cœur | L’Agent localise et corrige |
| L3 Contrat d’intégration | Interfaces, base de données, dépendances externes | Tests de contrat d’interface | L’Agent compare les écarts puis révise |
| L4 Fonctionnement du système | Comportement réel du service complet | Démarrer le service et rejouer des requêtes | L’Agent collecte les journaux et les données de performance |
| L5 Acceptation humaine | Architecture, risques et arbitrages métier | Examiner le dossier de preuves et décider de l’intégration | Une personne fournit de nouvelles contraintes ou arrête la tâche |
L’architecture Dune de Lauren Tan constitue un exemple extrême de L1. Elle a refactorisé le projet à travers plus de 600 PR et fait vérifier le graphe de dépendances par la CI, afin de garantir que les répertoires main et renderer d’Electron ne s’importent pas mutuellement ; elle interdit aussi useEffect et l’écriture de commentaires. Ces règles ne conviendront pas forcément à votre base de code, mais l’idée de transformer les contraintes d’équipe en vérifications automatiques mérite d’être reprise.
Étape 3 : transformer les portes d’acceptation de l’Agent en fiches exécutables
Chaque porte de validation doit tenir dans une fiche courte, placée dans la documentation du projet que l’Agent peut lire au démarrage. Une fois la fiche bien rédigée, l’Agent n’a plus à deviner ce que signifie « réussi », et les humains peuvent retrouver les preuves à partir de là.
| Champ | Consigne de rédaction | Exemple de migration de service |
|---|---|---|
| Nom de la porte | La nommer d’après le comportement attendu | Cohérence des requêtes rejouées |
| Environnement d’exécution | Figer les versions et les dépendances | Environnement de test isolé, avec un instantané de données figé |
| Point d’entrée d’exécution | Fournir une commande explicite | make gate-replay (commande d’exemple) |
| Critère de réussite | S’appuyer sur des résultats comparables | Codes de statut et champs clés tous identiques |
| Artefacts de preuve | Conserver des fichiers vérifiables | Rapport de différences, journaux du service, relevés de performance |
| Règles de protection | Indiquer les éléments non modifiables | Échantillons d’acceptation et script de décision en lecture seule |
| Stratégie en cas d’échec | Décrire l’action suivante | Suspendre si la même erreur persiste sur 3 cycles consécutifs |
Parmi ces champs, les règles de protection sont les plus faciles à négliger. L’Agent a tendance à choisir le chemin le plus simple sur le moment : s’il peut modifier les échantillons d’acceptation ou assouplir le script de décision, les résultats des tests perdent leur sens. Je recommande de placer cette partie dans un répertoire protégé et de vérifier les modifications correspondantes dans la CI.
Étape 4 : faire entrer les points de contrôle d’acceptation de l’Agent dans une boucle de régression automatique
Intégrez la boucle interne dans la description de la tâche : réalisez d’abord une petite modification, exécutez les points de contrôle du niveau courant, lisez les preuves d’échec, corrigez, puis relancez les points de contrôle déjà validés. Cette régression est essentielle : sans elle, l’Agent peut corriger un endroit et en casser silencieusement un autre.
À la fin de chaque cycle, demandez à l’Agent de consigner les modifications apportées, les points de contrôle exécutés, les résultats et les problèmes non résolus. Le contexte des tâches longues ne cesse de croître ; ce journal aide les sessions suivantes à retrouver rapidement leur état, et permet aussi aux humains de juger si l’Agent progresse réellement ou tourne en rond.
Les points de contrôle d’acceptation doivent aussi se prémunir des « faux succès ». Voici plusieurs cas particulièrement fréquents lors d’exécutions prolongées :
| Type de faux succès | Manifestation typique | Ligne de défense correspondante |
|---|---|---|
| Tests modifiés | Des cas d’échec sont supprimés ou les critères sont assouplis | Fichiers d’acceptation en lecture seule, la CI vérifie les changements |
| Seul le chemin heureux est testé | Les requêtes normales passent, les scénarios d’exception plantent | Ajouter de l’injection de fautes et des échantillons limites |
| Les mocks remplacent les vraies dépendances | Tous les mocks sont au vert, l’environnement d’intégration échoue | Le L4 doit exécuter les vrais services |
| La sortie semble correcte mais la sémantique est erronée | Les logs sont complets, mais le comportement du cycle de vie est faux | Comparer l’état, la chronologie et les effets de bord |
| Un succès local masque un risque | Un indicateur s’améliore, la stabilité globale baisse | Exécuter une régression complète à chaque jalon |
Étape 5 : définir des points de décision humaine et des conditions d’arrêt pour les jalons de validation de l’Agent
Le travail humain doit se concentrer sur les jugements que l’Agent ne peut difficilement remplacer. Kurtzer prend en charge l’architecture, les objectifs de compatibilité Linux, le modèle opérationnel, l’interprétation des pannes et les décisions d’arrêt ; lorsqu’il n’est pas satisfait du code généré par l’Agent, il va jusqu’à fermer son IDE, refréner son envie de modifier lui-même, et fournir de nouvelles instructions à la place.
Il est conseillé de prévoir au moins trois types de conditions de pause : plusieurs échecs successifs sur un même jalon, une tentative de l’Agent de modifier du contenu protégé, ou une consommation de la tâche proche du budget. Après la pause, l’examen doit aussi se déplacer en amont vers le paquet de preuves : observer d’abord le comportement du système et les risques, avant de décider s’il faut lire le diff en profondeur.
Conseil pour démarrer rapidement : choisissez d’abord un petit jalon réalisable en une journée, et rédigez seulement 3 à 5 fiches de jalon. APIYI apiyi.com propose l’appel API aux séries de modèles GPT, Claude et autres mentionnées dans cet article, et reste compatible avec les formats d’interface OpenAI et Anthropic ; les outils existants n’ont généralement besoin que d’ajuster l’adresse de l’interface et la clé selon la documentation, et les modèles disponibles peuvent être confirmés sur la page tarifaire d’APIYI.
Comment les points de validation de l’agent changent le coût des tâches longues
Le coût d’une tâche longue ne se résume pas à « combien de tokens ont été consommés au total ». L’article indique que les statistiques de tokens de la page d’accueil de Cursor incluent au moins quatre catégories : entrée normale, sortie du modèle, écriture de cache et lecture de cache, avec des écarts de prix importants. La communauté a déjà estimé une facture à partir d’un même volume de 1 500 milliards de tokens, et les résultats varient fortement selon l’algorithme utilisé, principalement à cause de la base de facturation et de la part de cache.
| Élément de facturation | Principale source dans les tâches longues | Méthode de contrôle | Référentiel tarifaire |
|---|---|---|---|
| Entrée normale | Description de la tâche, journaux, extraits de code | Ne transmettre que les preuves liées à l’échec | Selon les données réelles de la page tarifaire APIYI |
| Sortie du modèle | Code, analyse et plan de révision | Limiter l’étendue de la sortie à chaque tour | Selon les données réelles de la page tarifaire APIYI |
| Écriture de cache | Contexte stable ajouté ou modifié | Garder une structure stable des règles du projet | Selon les données réelles de la page tarifaire APIYI |
| Lecture de cache | Contexte réutilisé sur plusieurs tours | Surveiller le taux de succès et éviter de modifier fréquemment le préfixe | Selon les données réelles de la page tarifaire APIYI |
Le coût total d’un cas public permet de comprendre l’échelle d’un projet, mais il ne se convertit pas directement en prix unitaire. Les frais d’appel API de Ginux sont rapportés à environ 8 000 dollars, tandis que l’expérience de Nicholas Carlini, qui a construit un compilateur C avec 16 agents Claude en parallèle, a coûté environ 20 000 dollars. Derrière ces chiffres, les modèles, les caches et la structure des tâches diffèrent : votre projet doit donc encore faire l’objet d’un calcul séparé.
Une approche plus sûre consiste à réaliser d’abord un jalon complet, à enregistrer les quatre types de consommation de tokens et le nombre d’échecs aux points de validation, puis à calculer à partir des données actuelles de la page tarifaire APIYI https://docs.apiyi.com/models. Le budget obtenu reflète ainsi la forme réelle de vos tâches et reste plus fiable que l’application directe du prix unitaire moyen d’un autre projet.
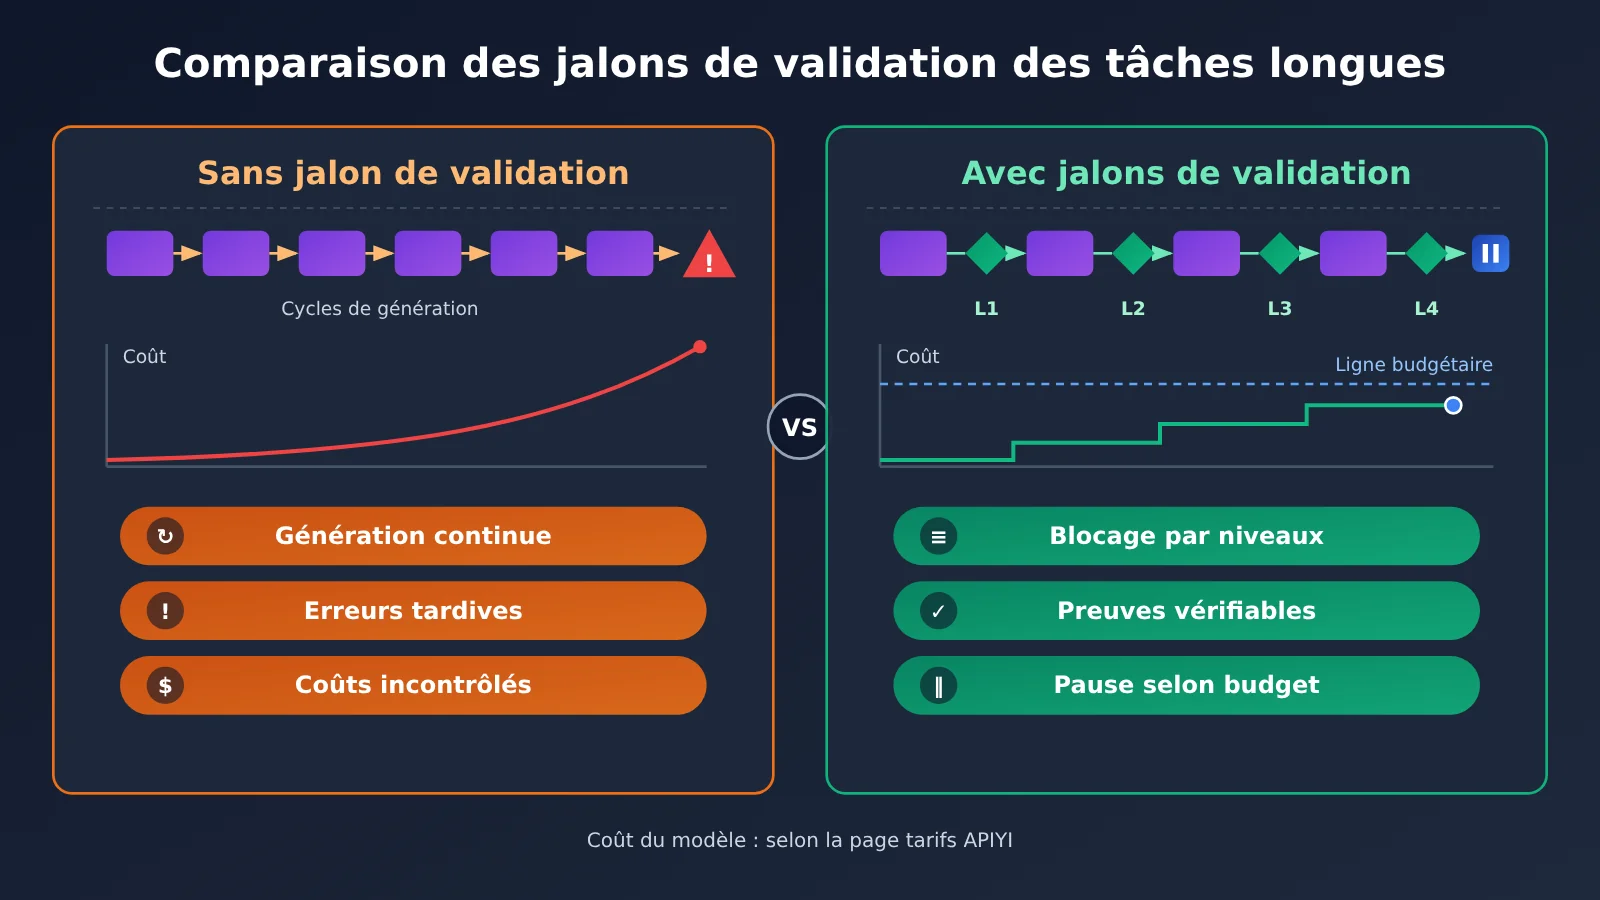
Le schéma ci-dessus veut montrer que le point de validation consomme lui aussi des ressources, mais qu’il permet d’exposer les échecs plus tôt. Pour une équipe classique, l’objectif doit être d’échanger un budget limité contre un niveau de confiance suffisant, plutôt que de lancer la vérification complète la plus coûteuse à chaque modification.
FAQ : questions fréquentes sur les points de contrôle de validation des Agents
Q1 : qu’est-ce qu’un point de contrôle de validation d’Agent ?
Il s’agit d’un point de contrôle exécutable prédéfini, destiné à déterminer si les livrables d’une étape de l’Agent atteignent le niveau attendu. Un point de contrôle complet comprend l’environnement d’exécution, le point d’entrée d’exécution, les critères de réussite, les artefacts de preuve et la stratégie en cas d’échec.
Q2 : quelle différence entre un point de contrôle de validation d’Agent et une CI classique ?
La CI est un support d’exécution courant ; le point de contrôle de validation est une conception de contrôle de tâche plus complète. En plus de vérifier si le code passe les tests, il définit aussi le comportement du système, les preuves, le périmètre de régression, les points de décision humaine et les conditions de mise en pause.
Q3 : quand faut-il obligatoirement concevoir un point de contrôle de validation d’Agent ?
Dès que la tâche nécessite plusieurs cycles de modification, touche plusieurs modules, s’exécute longtemps, ou produit des erreurs difficiles à repérer à l’œil nu, il faut le concevoir en amont. Un petit script ponctuel peut rester simple, mais il doit au minimum définir une méthode de vérification exécutable.
Q4 : avec un point de contrôle de validation d’Agent, faut-il encore une revue de code humaine ?
Oui. Les points de contrôle automatiques conviennent pour juger des critères connus, mais les humains restent responsables des choix d’architecture, des arbitrages de risque et de la validation finale. Kurtzer souligne lui aussi que l’expérience reste essentielle pour juger si un résultat est complet et si un succès local introduit un risque au niveau système.
Q5 : comment connecter un modèle via une API pour faire tourner ce processus ?
1. Inscrivez-vous sur APIYI apiyi.com et créez une clé API.
2. Consultez le centre de documentation `docs.apiyi.com` pour vérifier l’adresse de l’interface et le mode d’appel.
3. Selon l’outil utilisé, configurez le format d’interface OpenAI ou Anthropic.
4. Après avoir vérifié le modèle et le tarif sur `https://docs.apiyi.com/models`, lancez un premier test à petite échelle.
Q6 : avec un budget limité, comment alléger les points de contrôle de validation d’Agent ?
Conservez en priorité les points de contrôle L1 et L2, les moins coûteux, et exécutez-les à chaque tour ; placez L3 et L4 au moment où la fonctionnalité est terminée ou aux jalons du projet. Les statistiques de Jellyfish portant sur 12 000 développeurs montrent qu’un utilisateur typique consomme environ 51 millions de tokens par mois, avec un écart considérable par rapport aux cas extrêmes : il faut donc fixer la fréquence de vérification selon le risque de la tâche. Pour les frais de modèle, référez-vous aux données réelles de la page tarifaire d’APIYI.
Q7 : quelles sont les limites des points de contrôle de validation d’Agent ?
Un point de contrôle ne couvre que les risques qui ont été définis, et des tests tous verts ne signifient pas que le code est adapté à une maintenance à long terme. Ginux parvient à démarrer Rocky Linux 10, mais il reste encore loin d’un noyau de qualité production : le support matériel, la stabilité des interfaces, l’audit de sécurité et la maintenance communautaire ne peuvent pas être démontrés par une seule exécution. Les critiques de la communauté envers le modèle de PR à haute fréquence nous rappellent aussi qu’il faut rester attentif en permanence à la maintenabilité du code.
Points clés des points de contrôle d’acceptation d’un Agent
- Définir d’abord la ligne d’arrivée : décrivez l’achèvement d’une tâche par un comportement système observable, pour éviter les objectifs flous.
- Des points de contrôle par étapes : progressez des contraintes statiques vers l’exécution réelle, puis vers la validation humaine.
- Conserver les preuves : à chaque exécution, enregistrez les journaux, les rapports de différences et les relevés de performance.
- Un verdict non modifiable : les échantillons et les scripts d’acceptation doivent être protégés pour empêcher l’Agent de prendre des raccourcis.
- Régression systématique : après avoir corrigé un nouveau problème, relancez les points de contrôle connexes déjà validés.
- L’humain garde la décision : l’architecture, les risques, l’arrêt et la validation finale relèvent du responsable.
- Tester d’abord le coût : validez à petite échelle via APIYI apiyi.com, puis estimez le budget d’après la page des tarifs.
En résumé : construire un workflow autonome à partir des points de contrôle d’acceptation d’un Agent
La capacité d’un Agent à travailler de façon autonome sur la durée dépend de la clarté de ses objectifs et de la fiabilité de ses retours. Pour concevoir les points de contrôle d’acceptation d’un Agent, gardez trois idées en tête :
- Transformer « terminé » en critère exécutable : que l’Agent juge de sa progression à partir des résultats d’exécution.
- Confier la vérification à haute fréquence à la machine : points de contrôle par étapes, régressions automatiques et dossiers de preuves raccourcissent le cycle de retour.
- Réserver les décisions clés à l’humain : c’est le responsable qui fixe l’orientation de l’architecture, les limites de risque et le moment de l’arrêt.
Nous vous conseillons de commencer par une tâche de taille moyenne : rédigez d’abord la fiche du point de contrôle, puis lancez l’Agent. Pour tester différents modèles, vous pouvez passer par APIYI apiyi.com et utiliser des interfaces compatibles avec les formats OpenAI et Anthropic ; la configuration est décrite dans le centre de documentation docs.apiyi.com, et les tarifs des modèles ainsi que les modalités de facturation doivent être vérifiés à partir des données réelles de https://docs.apiyi.com/models.
📚 Références
- InfoQ – Reportage sur le projet Ginux : le processus de construction d’un noyau compatible Linux par Codex et sa méthode de validation
- Lien :
infoq.cn/article/OiyNEtFwV05opvsLTcvK -
Contenu : analyse de la double boucle HDAE, de l’échelle du projet et de ses limites
-
InfoQ – Reportage sur la facture de tokens d’un ingénieur Cursor : workflows Agent à forte intensité et controverse sur les coûts
- Lien :
infoq.cn/article/q9iebpvFozfy4bgCYUyE -
Contenu : boucle de validation, architecture Dune et critiques de la communauté
-
Rapport technique Ginux : rapport technique publié par Gregory Kurtzer
- Lien :
zenodo.org/records/23682548 -
Contenu : idéal pour approfondir les objectifs de recherche, la méthodologie et les limites des résultats
-
Dépôt GitHub Ginux : code source du projet
- Lien :
github.com/gmkurtzer/ginux -
Contenu : permet de consulter le code du projet et les informations de licence open source
-
Documentation et page tarifaire APIYI : configuration de l’interface et tarification des modèles
- Lien documentation :
docs.apiyi.com - Lien tarifs :
https://docs.apiyi.com/models - Contenu : les modèles, les prix et les modalités de facturation sont ceux affichés sur la page
Auteur : équipe technique APIYI
Échanges techniques : venez discuter de nos pratiques d’ingénierie Agent sur APIYI apiyi.com ; pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com.