Nota del autor: Tres momentos para activar la compresión del contexto de un agente, estrategias de resumen y código ejecutable para ahorrar tokens sin perder información clave.
Después de trabajar durante horas con un agente de programación como Codex, muchos desarrolladores se hacen la misma pregunta: cerca del cuadro de entrada solo aparecen el modo de permisos y el modelo actual, pero no cuánto contexto se ha utilizado. Entonces, ¿cuándo conviene abrir una nueva ventana? Cuanto más larga es la conversación, más historial debe incluir cada solicitud y más rápido se consume la cuota. En este artículo veremos cuándo se activa la compresión automática del contexto de un agente (Context Compaction) y qué estrategias de resumen utiliza, para entender cómo funcionan herramientas como Codex e implementar la misma capacidad en tu propio agente.
Esto no es otro consejo genérico de «recuerda limpiar el historial de chat», sino una solución práctica basada en los mecanismos de compresión publicados en la documentación oficial de OpenAI y Anthropic, junto con experiencia de ingeniería.
Lo esencial: al terminar de leer, sabrás cuándo se activa la compresión automática del contexto de un agente, qué conservar y qué descartar en el resumen, y tendrás una implementación en Python que puedes adaptar y utilizar directamente.
Puntos clave de la compresión automática del contexto de un agente
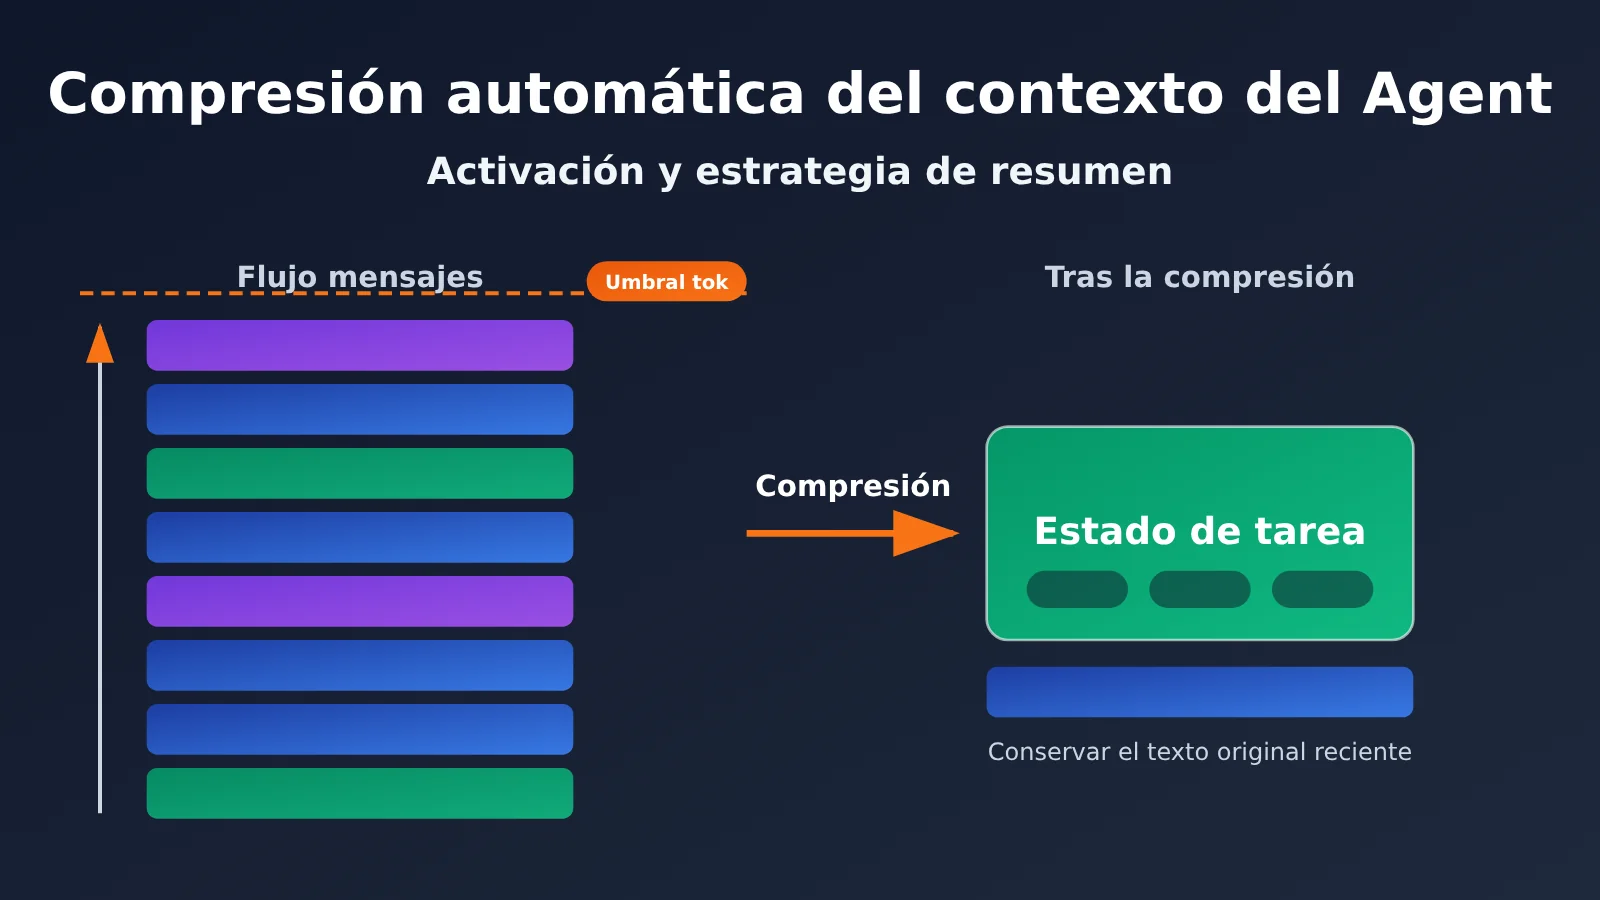
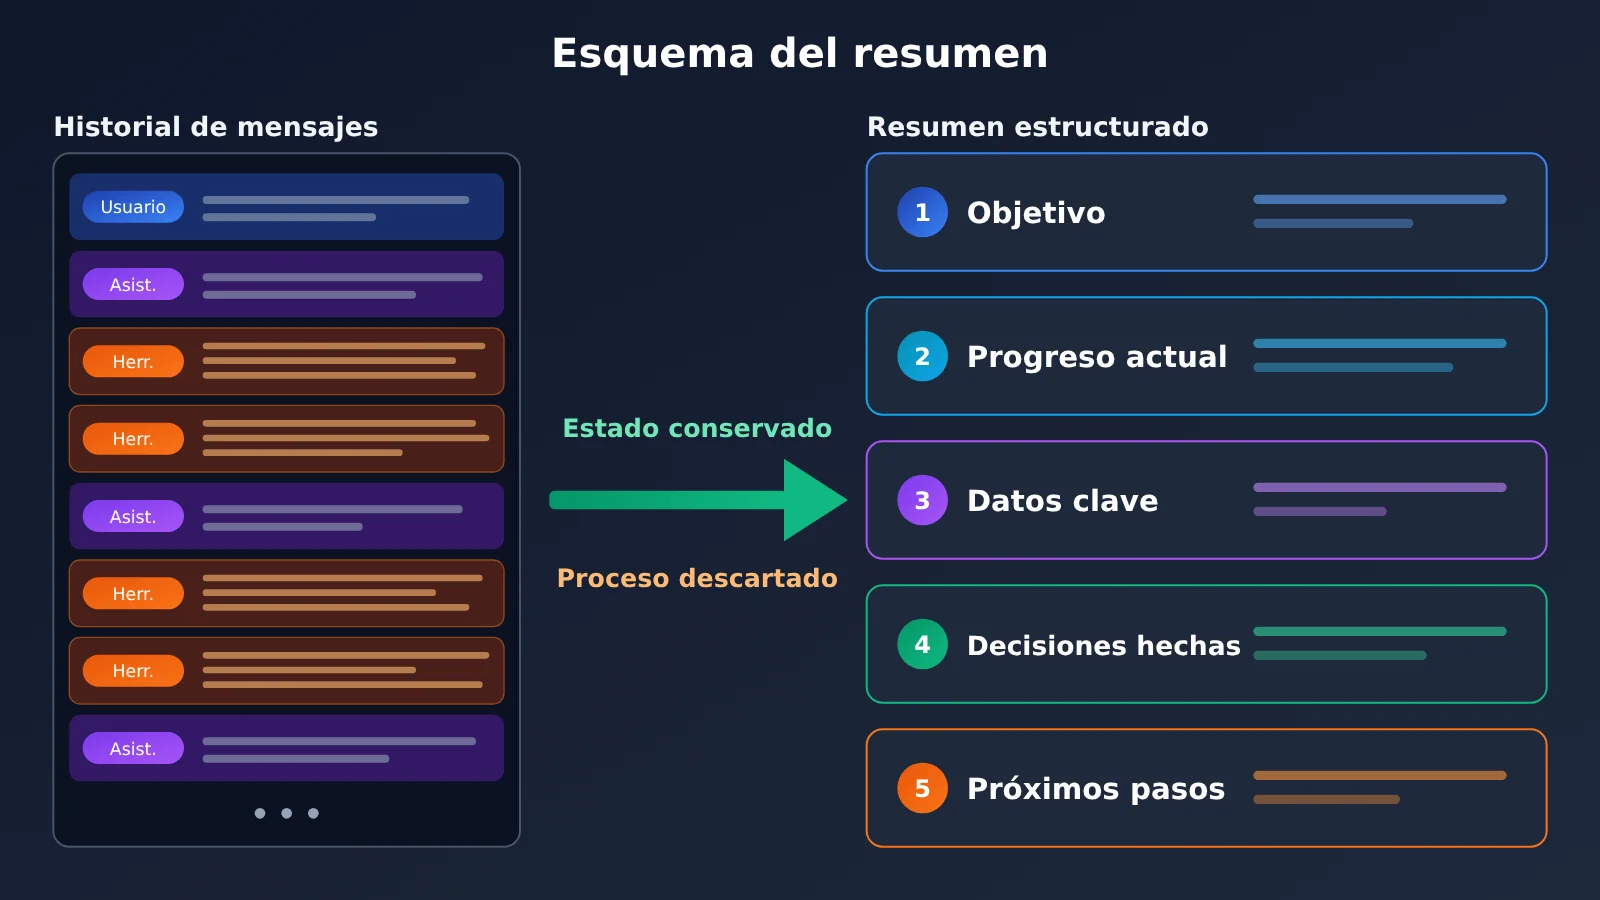
La idea principal es esta: la compresión automática del contexto de un agente suele activarse cuando se alcanza un umbral determinado de tokens. En ese momento, las conversaciones anteriores y los registros de llamadas a herramientas se condensan en una descripción del estado que permite seguir trabajando. El objetivo no es solo acortar el historial, sino conservar el progreso de la tarea, los datos importantes, las acciones realizadas, las decisiones clave y los próximos pasos, eliminando los detalles redundantes del proceso.
| Punto clave | Descripción | Ventaja |
|---|---|---|
| Activación por umbral de tokens | El contexto se comprime automáticamente al alcanzar una cantidad predefinida de tokens | Evita llenar la ventana sin intervención manual |
| Compresión proactiva | La aplicación solicita la compresión en momentos concretos, como al terminar una fase de la tarea | Comprime en un límite semántico y reduce la pérdida de información |
| Gestión automática del framework | El SDK o el entorno de ejecución del agente decide según la presión sobre el contexto | Funciona sin configuración adicional y permite empezar rápido |
| Resumen en lugar de truncamiento | Conserva el progreso, los datos, las decisiones y los próximos pasos | El agente puede continuar trabajando después de la compresión |
| Compresión por fases | No se recomienda comprimir en cada turno | Equilibra el aprovechamiento de la caché y la integridad de la información |
Por qué un agente necesita la compresión automática del contexto
La API de un Modelo de Lenguaje Grande no mantiene estado por sí sola. Una «conversación de varios turnos» consiste, en esencia, en volver a enviar al modelo todo el historial de mensajes en cada turno. Así, la solicitud del turno 50 incluye todo el contenido de los 49 anteriores y los tokens de entrada aumentan de forma lineal o incluso más rápido. En un agente, la situación es más complicada: los resultados de las llamadas a herramientas —contenido de archivos, salida de la terminal o resultados de búsqueda— suelen ser muy extensos, y unas pocas llamadas pueden ocupar más de la mitad de la ventana.
Esto plantea dos problemas directos. El primero es el costo: cuantos más tokens de entrada haya en cada turno, más rápido se consume la cuota. El segundo es la calidad: cuando el contexto es demasiado largo, la atención del modelo a la información clave de los primeros turnos puede diluirse. Incluso puede superarse la ventana y producirse un error. La compresión automática del contexto busca un equilibrio entre ambos problemas: mientras la información aún está completa y la ventana no se ha llenado, «pliega» el historial en un estado conciso para que las siguientes solicitudes sean más ligeras.
Por qué Codex no muestra el uso del contexto
No hemos visto una explicación oficial clara sobre por qué el cliente ya no muestra el tamaño de la ventana de contexto, así que no vamos a especular. Lo que sí sabemos es que Codex incorpora un mecanismo de compresión del contexto: las conversaciones largas no acumulan todo el historial original de forma indefinida. Si quieres observar con precisión el consumo de cada turno, lo más fiable es consultar los registros de llamadas a nivel de API. Más adelante explicaremos cómo hacerlo.
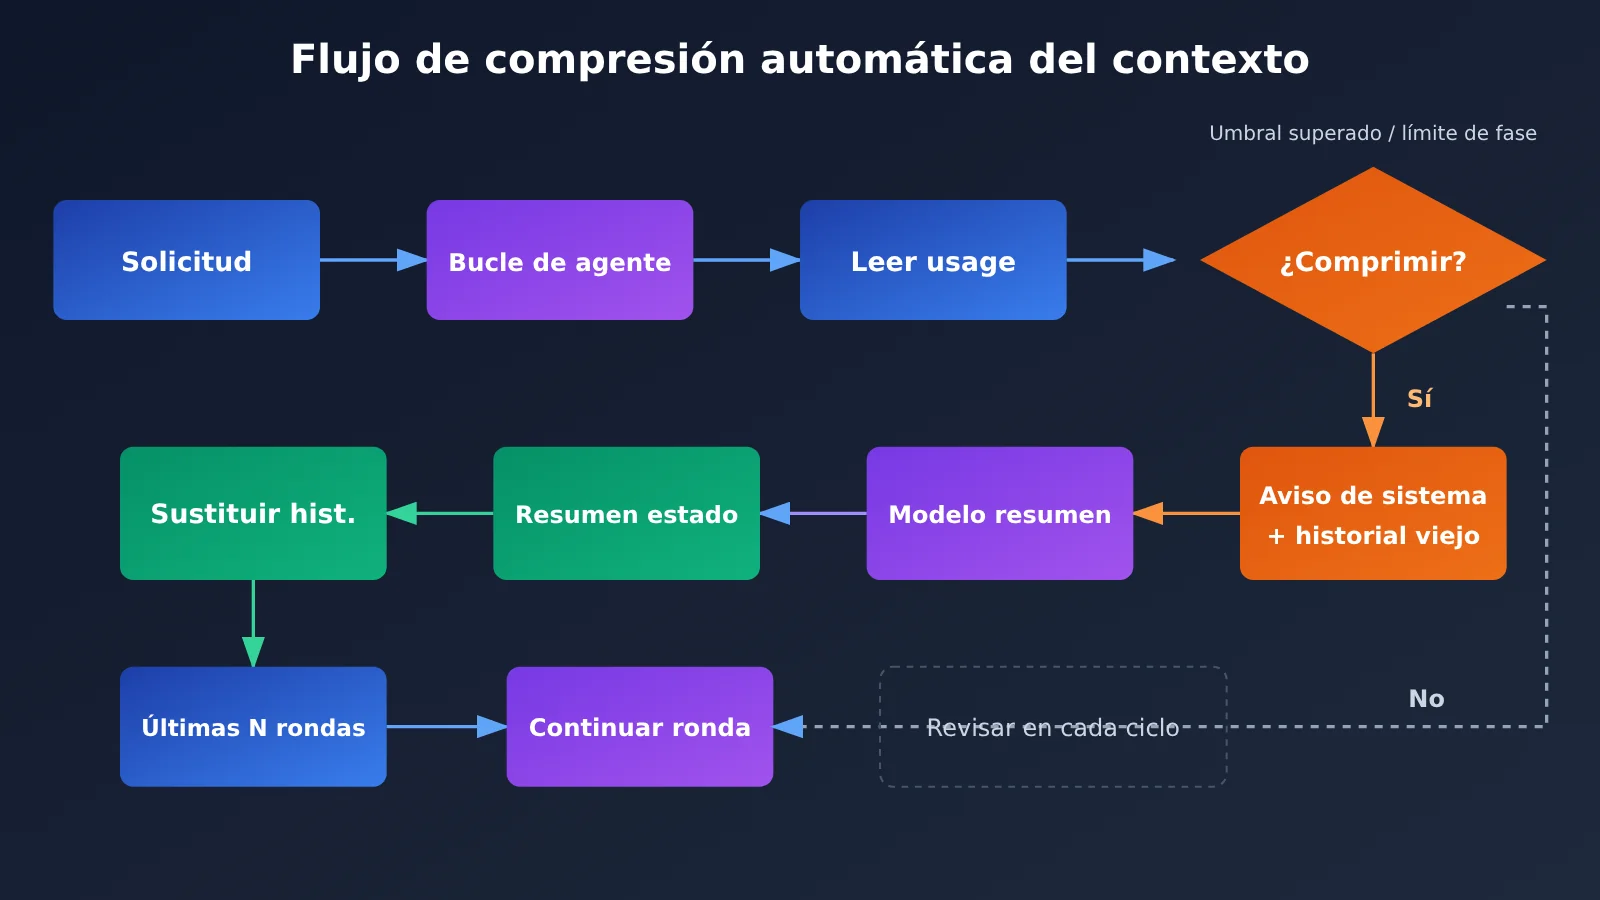
3 momentos para activar la compresión automática del contexto de un agente
Mucha gente da por hecho que «el contexto se comprime al llegar al 80 %», pero esa no es la regla oficial. La documentación de las API define las condiciones principalmente mediante umbrales de cantidad de tokens, no mediante un porcentaje fijo de la ventana. Además, no hace falta esperar a estar cerca del límite: tanto OpenAI como Anthropic permiten iniciar la compresión de forma proactiva.
Comparación de las reglas de activación oficiales
| Implementación | Regla de activación automática | Descripción oficial |
|---|---|---|
| OpenAI Responses API | La cantidad de tokens del contexto renderizado alcanza compact_threshold |
El umbral es configurable y el servidor gestiona la compresión automáticamente |
| OpenAI Agents SDK | Presión sobre el contexto o una política de umbral explícita | Permite la compresión automática, por umbral fijo y forzada |
| Anthropic Messages API | Los tokens de entrada alcanzan trigger.value |
Valor predeterminado: 150.000; mínimo: 50.000 |
| Anthropic Tool Runner | Se alcanza context_token_threshold |
Valor predeterminado: 100.000 |
| Compresión bajo demanda de Anthropic | La aplicación la inicia de forma proactiva | Puede invocarse al finalizar un turno completo de conversación |
La tabla muestra un patrón común: casi todas las activaciones automáticas se basan en la cantidad de tokens de entrada y permiten configurar el umbral. Al mismo tiempo, todas ofrecen una forma de que la aplicación decida cuándo comprimir.
Momento 1: activación por umbral de tokens
Este es el mecanismo de respaldo más básico. Al terminar cada invocación, lee la cantidad de tokens de entrada que devuelve la API y comprime el contexto cuando supere el umbral definido. No conviene situar el umbral demasiado cerca del límite de la ventana: la propia compresión requiere volver a enviar el historial anterior a un modelo que genere el resumen, y también hay que reservar espacio para la salida de las herramientas en el siguiente turno.
Como punto de partida, puedes seguir la lógica de los valores predeterminados de Anthropic: en modelos con ventanas largas, establece el umbral en el orden de los cien mil tokens y asegúrate de que quede espacio suficiente por encima para recibir el resultado completo de una llamada a una herramienta.
Momento 2: compresión proactiva al terminar una fase de la tarea
Esta es la forma de minimizar la pérdida de información. OpenAI recomienda comprimir después de completar una fase de trabajo significativa, en lugar de hacerlo en cada turno. Por ejemplo, si el agente acaba de completar la secuencia «localizar el bug → modificar el código → ejecutar las pruebas correctamente», los intentos intermedios ya no aportan valor. Basta con recordar qué archivo se modificó, por qué se modificó y que las pruebas pasaron.
Comprimir entre fases facilita la creación de un resumen preciso, porque la tarea se encuentra en un estado «limpio», sin llamadas a herramientas a medio resolver.
Momento 3: dejar que el framework gestione la presión sobre el contexto
Si usas un framework como Agents SDK o Tool Runner, puedes activar su política de compresión integrada y dejar que el entorno de ejecución decida automáticamente según la presión sobre el contexto. Es una opción cómoda, aunque ofrece menos control sobre el contenido del resumen. Encaja bien en prototipos o escenarios generales.
🎯 Consejo técnico: Los tres momentos no son excluyentes. Una combinación recomendable es usar principalmente la compresión proactiva entre fases y dejar el umbral de tokens como respaldo. Si quieres comprobar si los umbrales son adecuados para distintos modelos, puedes usar APIYI apiyi.com para probar y comparar modelos como OpenAI, Claude y Gemini con una misma clave API.
Estrategia de resumen para la compresión automática del contexto de un agente
El momento de activación resuelve «cuándo comprimir»; la estrategia de resumen, «qué conservar». Los fallos más comunes aparecen cuando, después de la compresión, el agente olvida las restricciones iniciales del usuario o repite acciones que ya realizó. La causa de fondo es que el resumen solo registra «de qué se habló», pero no «cuál es el estado de la tarea».
Qué conservar y qué descartar del resumen
| Categoría | Conservar | Descartar |
|---|---|---|
| Objetivo de la tarea | Solicitud original del usuario, restricciones obligatorias y criterios de aceptación | Saludos y confirmaciones repetidas |
| Progreso de la tarea | Pasos completados y etapa actual | Razonamiento detallado de cada paso |
| Datos importantes | Rutas de archivos, nombres de funciones, valores de configuración y líneas clave de errores | Contenido completo de archivos y registros extensos |
| Decisiones clave | Solución elegida y motivo | Debates detallados sobre alternativas descartadas |
| Próximas acciones | Lista de tareas pendientes y problemas sin resolver | Detalles de acciones completadas sin impacto posterior |
Estrategia de resumen en 5 pasos
- Conservar siempre la indicación del sistema: la indicación del sistema no se comprime y permanece al principio de messages.
- Conservar los últimos N turnos sin cambios: los turnos más recientes suelen estar estrechamente relacionados con la operación actual. Consérvalos tal cual y comprime solo los anteriores.
- Usar una plantilla de resumen estructurada: pide al modelo que genere el resumen en cinco secciones: «objetivo / progreso / datos / decisiones / próximos pasos». Así evitas omisiones provocadas por un resumen demasiado libre.
- Reducir primero los resultados de las herramientas: cuando una herramienta devuelva una respuesta muy extensa, conserva solo los fragmentos clave, como las primeras y últimas líneas de un error o los títulos y conclusiones de los resultados de búsqueda.
- Guardar por separado las palabras originales del usuario: conviene conservar literalmente las restricciones explícitas, como «no modifiques la interfaz pública», sin pedirle al modelo que las reformule.
La plantilla estructurada es el paso más importante. Cuando el modelo hace un «resumen libre», tiende a generalizar el tono de la conversación; en cambio, las secciones estructuradas lo obligan a revisar cada punto y conservar la información de estado necesaria para seguir trabajando.
Guía rápida para comprimir automáticamente el contexto de un agente
A continuación, implementaremos una versión general que gestiona messages manualmente desde el cliente y funciona con cualquier interfaz compatible con OpenAI. La idea es leer el número de tokens de entrada en usage.prompt_tokens después de cada llamada. Si supera el umbral, se envía el historial más antiguo a un modelo para que lo resuma.
Ejemplo mínimo
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "system", "content": "你是一个编码助手。"}]
messages.append({"role": "user", "content": "帮我检查这个函数的边界条件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 每轮记录输入 Token,作为是否压缩的判断依据
print("本轮输入 Token:", resp.usage.prompt_tokens)
Ver el código completo para la compresión automática del contexto de un agente
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 主任务模型,可按需替换
SUMMARY_MODEL = "gpt-4o-mini"   # 摘要模型,可用更便宜的模型
TOKEN_THRESHOLD = 100_000       # 输入 Token 阈值,兜底触发
KEEP_RECENT = 6                 # 保留最近 N 条消息原文

SUMMARY_PROMPT = """请把以下 Agent 对话历史压缩为任务状态摘要,严格按五个栏目输出:
【任务目标】用户原始需求与硬性约束(约束请逐字保留)
【当前进度】已完成的步骤与当前阶段
【关键事实】文件路径、函数名、配置值、关键报错
【已做决策】采用的方案及原因
【下一步行动】待办事项与未解决问题
不要记录寒暄和推理过程,不要编造历史中没有的信息。"""


def compact(messages: list) -> list:
    """把早期历史压缩为一条摘要消息,保留系统提示与最近对话。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下为之前对话的压缩摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 时机一:上一轮输入 Token 超过阈值时先压缩
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 时机二:完成一个任务阶段后主动压缩
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一个严谨的编码助手。")
print(agent.chat("帮我定位登录接口偶发 500 的原因"))
agent.finish_stage()  # 修复完成后,在阶段边界主动压缩
🚀 Inicio rápido: Regístrate en APIYI apiyi.com para obtener crédito de prueba gratuito. Solo tienes que reemplazar la clave API para ejecutar el código anterior. La plataforma ofrece una interfaz compatible con OpenAI y permite elegir modelos de distintos proveedores para la tarea principal y los resúmenes, lo que facilita el control de costos.
Comparación de soluciones para comprimir automáticamente el contexto de un agente
| Solución | Características principales | Casos de uso | Plataformas disponibles |
|---|---|---|---|
| Compresión manual en el cliente | Se ensamblan los mensajes manualmente y se controla por completo la lógica de resumen | Agentes propios que necesitan plantillas de resumen personalizadas | APIYI apiyi.com y las API oficiales |
| Compresión por umbral en el servidor | Por ejemplo, compact_threshold de la API Responses |
Cuando se busca reducir la gestión del estado en el cliente | Plataformas compatibles con esa interfaz |
| Compresión integrada en el framework | Agents SDK y Tool Runner gestionan la compresión automáticamente | Creación de prototipos y tareas generales | Depende del SDK correspondiente |
| Abrir una sesión nueva | Se resume manualmente y se abre una ventana nueva | Uso diario de clientes como Codex | Cualquier cliente |
La compresión manual en el cliente ofrece el mayor control, pero exige gestionar el recuento de tokens y la calidad de los resúmenes. La compresión en el servidor evita tener que ensamblar el historial, aunque los detalles del resumen no son visibles para el desarrollador. Para un agente propio, combinar un resumen estructurado en el cliente con un umbral como mecanismo de respaldo suele ser una opción más fiable.
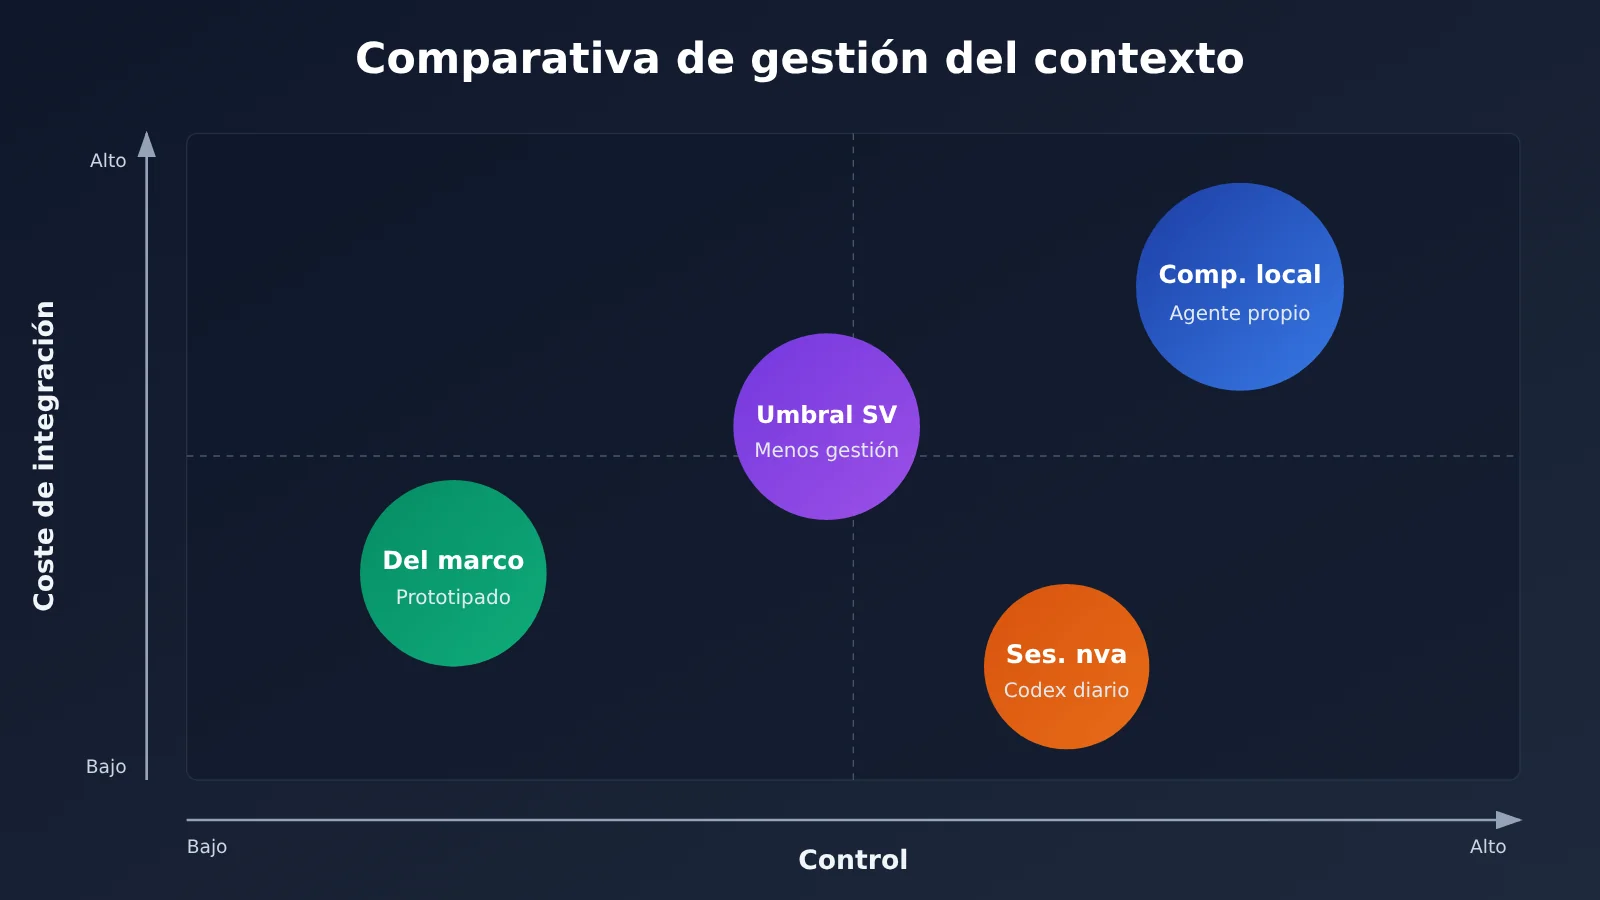
Relación entre la compresión automática del contexto de un agente y el coste de la caché
La compresión parece una forma segura de ahorrar, pero también hay que tener en cuenta el almacenamiento en caché de indicaciones, o Prompt Caching. Según la información de APIYI sobre la facturación de la caché de OpenAI, la parte de la entrada que se recupera de la caché se cobra al 10 % del precio de entrada. En conversaciones largas, si el prefijo del historial no cambia, es fácil aprovechar la caché. En ese caso, los tokens nuevos que se pagan a precio completo en cada turno no son tantos.
Cuando se comprime el contexto, el prefijo de los mensajes se sustituye por un nuevo resumen. En la siguiente solicitud, la caché deja de ser válida y hay que volver a procesar esa entrada a precio completo. Por eso, la recomendación oficial es no comprimir en cada turno: hacerlo con demasiada frecuencia interrumpe el uso de la caché y, a veces, puede salir más caro que no comprimir. Un ritmo más razonable es dejar que el historial crezca de forma estable durante una etapa, aprovechar bien la caché y comprimirlo una sola vez al terminar esa etapa o al acercarse al umbral.
Preguntas frecuentes FAQ
Q1: ¿Qué es la compresión automática del contexto de un agente?
Consiste en comprimir las conversaciones anteriores y los registros de invocación de herramientas en un resumen del estado de la tarea cuando el contexto alcanza una cantidad determinada de tokens o termina una fase del trabajo. Este resumen sustituye al historial original. El objetivo es reducir los tokens de entrada en cada turno sin perder el progreso, los hechos, las decisiones y las próximas acciones que el agente necesita para seguir trabajando.
Q2: ¿En qué se diferencia comprimir el contexto de simplemente truncar el historial?
Truncar consiste en eliminar los mensajes más antiguos. Es sencillo de implementar, pero puede hacer que se pierdan los requisitos y las restricciones iniciales del usuario. En cambio, la compresión usa un modelo para condensar el historial en un resumen estructurado, lo que conserva mucha más información. A cambio, requiere una invocación adicional para generar el resumen y obliga a reconstruir la caché después de comprimir.
Q3: ¿Existe una regla universal de «comprimir al llegar al 80 %»?
No. La documentación oficial suele definir las condiciones de activación mediante umbrales de tokens. Por ejemplo, Anthropic Messages API usa 150.000 por defecto, con un mínimo de 50.000, mientras que Tool Runner usa 100.000 por defecto. Conviene ajustar el umbral según el tamaño de la ventana de contexto del modelo y el volumen de cada salida de las herramientas.
Q4: ¿Cuándo conviene abrir una ventana nueva en Codex?
Es recomendable hacerlo al terminar una fase completa de la tarea, por ejemplo, cuando una funcionalidad ya está desarrollada y ha pasado las pruebas. Antes de abrirla, puedes pedirle al agente un resumen con «objetivo / progreso / hechos / decisiones / próximos pasos» y pegarlo al inicio de la nueva sesión. Si vas a cambiar a un tema que no tiene relación con la tarea actual, también conviene abrir una ventana nueva para evitar que el historial irrelevante siga consumiendo cuota.
Q5: Si el cliente no muestra el uso de contexto, ¿cómo puedo supervisar el consumo de tokens?
Puedes consultarlo en la capa de API. Según la documentación de casos de uso de OpenAI Codex, si configuras la interfaz de Codex para usar APIYI, cada llamada dejará registros detallados y estadísticas de uso en el panel de APIYI en apiyi.com. Así podrás ver cómo crecen los tokens de entrada en cada turno de una conversación larga y decidir cuándo comprimir o iniciar una sesión nueva.
Q6: ¿Cómo puedo comprobar rápidamente si mi estrategia de compresión funciona?
Usa el código completo de este artículo para ejecutar la misma tarea de varios pasos en tres modos: «sin compresión», «compresión por umbral» y «compresión por fases». Después, compara el consumo total de tokens y la calidad del resultado. Con APIYI en apiyi.com puedes usar una sola clave API para acceder a modelos de distintos proveedores, uno como modelo principal y otro para generar resúmenes, lo que facilita encontrar un equilibrio entre costo y calidad.
Q7: ¿Cuáles son las limitaciones conocidas de la compresión del contexto?
La primera es que el resumen puede omitir detalles, especialmente valores de configuración que pasan desapercibidos en el código. La segunda es que cada compresión invalida la caché, por lo que comprimir con demasiada frecuencia puede aumentar los costos. La tercera es que el modelo de resumen a veces «completa» información que no existe. Para reducir estos riesgos, usa plantillas estructuradas, conserva literalmente las restricciones del usuario y guarda los datos clave, como las rutas de archivos, en un archivo externo de notas de la tarea en lugar de depender solo del resumen.
Puntos clave de la compresión automática del contexto de un agente
- La esencia de la compresión: convertir un historial extenso en un estado de la tarea que permita seguir trabajando, no simplemente eliminar registros.
- Tres momentos para activarla: al alcanzar un umbral de tokens como medida de respaldo, al cerrar una fase de forma proactiva o según la presión sobre el contexto que gestione el framework.
- No existe una regla del 80 %: la referencia oficial es un umbral de tokens, que debe ajustarse al tamaño de la ventana y al volumen de salida de las herramientas.
- Resumen estructurado: organizarlo en cinco apartados: objetivo, progreso, hechos, decisiones y próximos pasos. Las restricciones del usuario se conservan literalmente.
- No comprimas en cada turno: hacerlo con demasiada frecuencia puede reducir los aciertos de caché. Es más económico concentrar la compresión al final de cada fase.
- Usa los registros para cubrir los puntos ciegos: si el cliente no muestra el consumo, puedes observar el aumento de tokens en cada turno en los registros de invocaciones de APIYI apiyi.com.
Resumen
Los puntos clave de la compresión automática del contexto de un agente son:
- Cuándo activarla: comprimir de forma proactiva al cerrar una fase y usar el umbral de tokens como respaldo. La estrategia integrada en el framework es útil para empezar rápido.
- Estrategia de resumen: conservar la indicación del sistema y el texto original de los últimos turnos, y comprimir el historial anterior en un resumen estructurado de cinco apartados.
- Equilibrio de costes: la compresión invalida la caché, por lo que conviene mantener un crecimiento estable durante cada fase y concentrar la compresión al final.
Si usas Codex a diario, puedes resumir y abrir una ventana nueva al terminar cada fase como versión manual de la compresión. Si estás desarrollando tu propio agente, puedes adaptar directamente el código de este artículo. Para comprobar los resultados rápidamente, puedes usar APIYI apiyi.com: la plataforma ofrece saldo gratuito de prueba y una interfaz unificada para varios modelos. Con los registros de invocaciones podrás ver claramente cómo cambia el número de tokens antes y después de la compresión.
📚 Referencias
- Documentación de OpenAI Responses API: compresión del contexto y configuración de
compact_threshold - Enlace:
platform.openai.com/docs/api-reference/responses -
Descripción: explicación oficial de la compresión automática en el servidor y la gestión del estado
-
Documentación de OpenAI Agents SDK: estrategias de gestión del contexto durante la ejecución de agentes
- Enlace:
openai.github.io/openai-agents-python -
Descripción: configuración de estrategias como la compresión automática, por umbral fijo o forzada
-
Documentación de Anthropic sobre la compresión del contexto: parámetros que activan la compresión en Messages API y Tool Runner
- Enlace:
docs.anthropic.com - Descripción: valores predeterminados de
trigger.valueycontext_token_threshold, y uso de la compresión bajo demanda
Autor: Equipo técnico de APIYI
Consultas técnicas: Puedes contactarnos desde la página principal de APIYI. Para más información sobre la configuración de Codex, las conversaciones de varios turnos y la facturación de la caché, visita el centro de documentación en docs.apiyi.com