Nota del autor: esta evaluación de GPT-6 Luna Decisions API aborda cuatro perspectivas —principios, método de prueba real, métricas de latencia y escenarios de negocio— para ayudarte a decidir si las invocaciones de decisión son más rápidas y encajan mejor en tu negocio que las invocaciones normales del modelo.
Tras el lanzamiento oficial de la API Decisions de GPT-6 Luna, la pregunta que más debate entre los desarrolladores es cuánto más rápida es realmente frente a una invocación normal del modelo y qué casos de negocio merecen la pena migrar. Este artículo evalúa las capacidades clave, los principios de aceleración, los métodos de prueba y los escenarios de uso de GPT-6 Luna Decisions API desde la perspectiva de una integración real.
Esto no es un refrito de la propaganda oficial. La latencia puede variar mucho según la cuenta, la región, la concurrencia y la indicación. Por eso no damos un «multiplicador fijo» que pueda inducirte a error, sino que ofrecemos un conjunto de scripts de evaluación reproducibles y criterios de decisión para que obtengas conclusiones reales con los datos de tu propio negocio.
Valor principal: después de leer este artículo, podrás usar un script de Python para cuantificar la diferencia de latencia entre GPT-6 Luna Decisions API y una invocación normal, y decidir si encaja en tus tareas de decisión: clasificación, enrutamiento, revisión y control de riesgos, entre otras.
🎯 Nota sobre la evaluación: todo el código de este artículo está escrito sobre una interfaz compatible con OpenAI y se puede ejecutar directamente a través de APIYI apiyi.com. Los IDs de modelo, los parámetros de la interfaz y la facturación concretos se rigen por la documentación oficial y la consola de la plataforma.
Funciones principales de GPT-6 Luna Decisions API
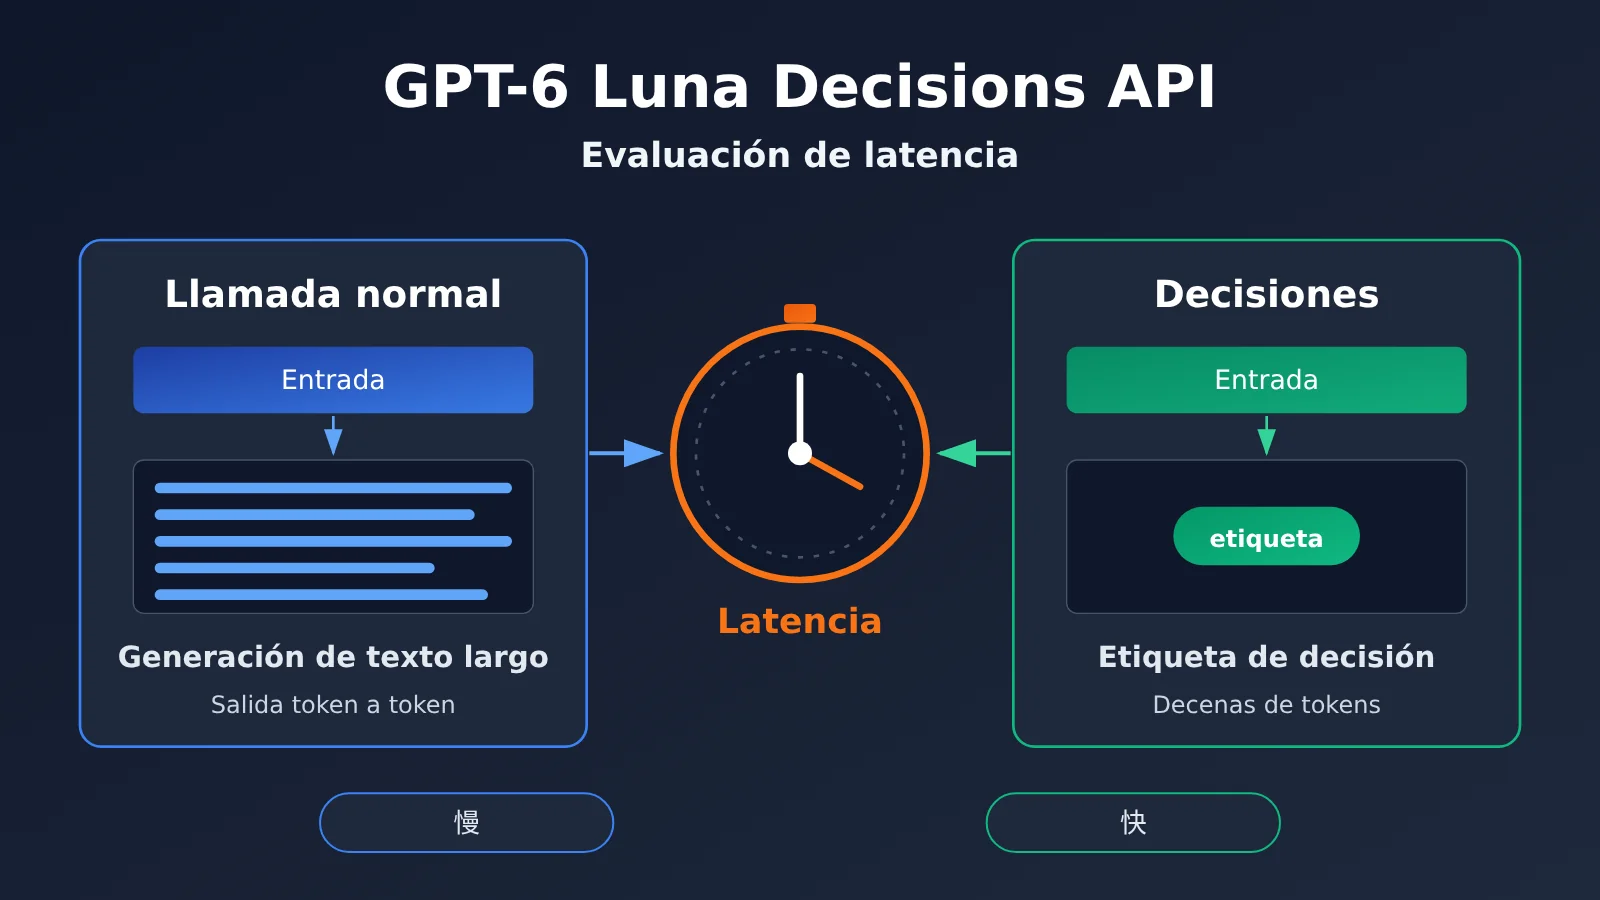
Antes de entender la API de Decisiones, conviene ver la diferencia de enfoque frente a una llamada de chat normal. El objetivo de una llamada normal es “generar un contenido”; el de una llamada de decisión es “dar un juicio entre opciones limitadas”. La longitud de salida, las restricciones de formato y la composición de la latencia son completamente distintas en ambos tipos de tarea.
| Punto | Descripción | Valor para el desarrollador |
|---|---|---|
| Salida orientada a decisiones | La salida se centra en etiquetas, opciones, puntuaciones y otros resultados estructurados, no en textos largos | El resultado se puede consumir directamente por el programa, sin necesidad de un segundo análisis |
| Longitud de salida corta | Un resultado de decisión típico tiene solo unas decenas de tokens, mucho menos que una tarea de generación normal | El tiempo total de respuesta depende principalmente del primer token y del procesamiento de entrada |
| Formato acotable | Se puede combinar con restricciones de salida estructurada como JSON Schema | Reduce la tasa de errores de formato y los reintentos |
| Adecuada para llamadas de alta frecuencia | Solicitudes como enrutamiento, clasificación y moderación suelen ser numerosas y simples por llamada | Las mejoras de latencia y costo se amplifican |
Diferencias entre la API de Decisiones y las llamadas normales
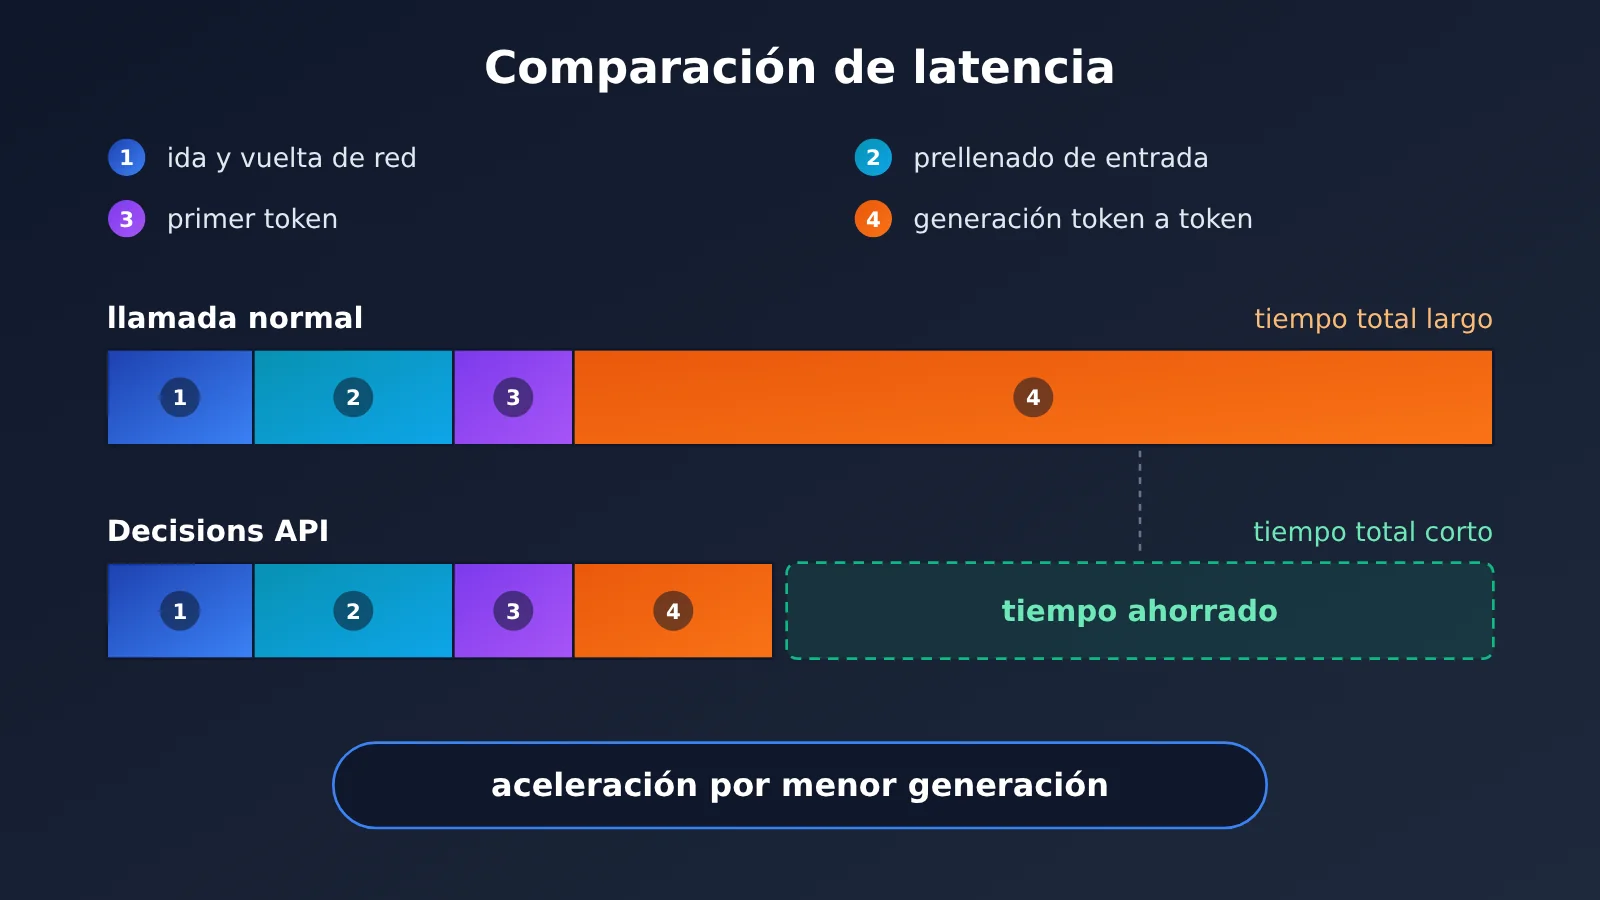
Desde el punto de vista de la ingeniería, el tiempo total de una llamada normal a un modelo se compone, a grandes rasgos, de tres partes: ida y vuelta por la red, procesamiento de entrada (prefill) y generación token a token. En las tareas de generación, la tercera parte suele llevarse la mayor parte, y cuanto más larga es la salida, más lento va.
Las llamadas de decisión comprimen la salida en un resultado estructurado, por lo que el tiempo de la fase de generación se reduce mucho. Esto significa que la aceleración de GPT-6 Luna Decisions API viene sobre todo de “generar menos”, no de “generar más rápido”. Si tu negocio necesita textos largos por naturaleza, esta interfaz no está pensada para ti.
De dónde viene la aceleración de la API de Decisiones
Las interfaces de decisión suelen aportar beneficios adicionales en dos aspectos. El primero es la certeza del formato: el programa no necesita usar expresiones regulares para extraer la respuesta del lenguaje natural, y la probabilidad de fallos y reintentos es menor. El segundo es el control del proceso de razonamiento: si el modelo permite ajustar la intensidad de razonamiento, en los escenarios de decisión a menudo no hace falta una cadena de pensamiento larga, lo que reduce aún más el tiempo de espera.
Hay que insistir en que todo esto es un análisis a nivel de mecanismo. La magnitud real de la aceleración depende de la longitud de salida que tuvieras antes: si ya hacías que el modelo respondiera solo con una palabra, el beneficio al cambiar será muy limitado; si antes le pedías al modelo “primero explica y luego da la conclusión”, el beneficio será muy evidente.
Primeros pasos con la API de decisiones de GPT-6 Luna
Ejemplo mínimo
Aquí tienes el ejemplo mínimo para completar una llamada de decisión con salida estructurada. Sustituye el nombre del modelo por el ID real de GPT-6 Luna que veas en la consola de la plataforma.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="gpt-6-luna",  # Usa el nombre real de la lista de modelos de la consola
    messages=[{"role": "user", "content": "工单内容:我的发票开错了。请判断归属部门。"}],
    response_format={"type": "json_object"},
    max_tokens=50
)
print(resp.choices[0].message.content)
La clave de este código está en max_tokens y response_format: el primero limita el máximo de salida y el segundo garantiza que el resultado se pueda analizar por programa. Estos dos parámetros son precisamente el corazón de la mejora de velocidad en las llamadas de decisión.
Ver el script completo de evaluación (compara la latencia de llamadas normales y de decisión)
import time
import json
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Llamada mediante la interfaz unificada de APIYI
)

MODEL = "gpt-6-luna"  # Usa el ID real del modelo en la consola; si hay un modelo/interfaz Decisions independiente, cámbialo aquí

SAMPLES = [
    "我的发票开错了,能重开吗?",
    "App 登录一直提示验证码错误",
    "想把套餐从月付改成年付",
    "订单显示已签收但我没收到",
]

DECISION_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "route",
        "schema": {
            "type": "object",
            "properties": {
                "department": {"type": "string", "enum": ["finance", "tech", "sales", "logistics"]},
                "confidence": {"type": "number"}
            },
            "required": ["department", "confidence"]
        }
    }
}

def timed_call(prompt: str, mode: str) -> dict:
    """Devuelve el tiempo hasta el primer token, el tiempo total y la longitud de salida"""
    kwargs = dict(model=MODEL, stream=True)
    if mode == "generate":
        kwargs["messages"] = [{"role": "user", "content": f"请分析下面工单并说明应由哪个部门处理及理由:{prompt}"}]
    else:
        kwargs["messages"] = [{"role": "user", "content": f"工单:{prompt}。只输出部门判断。"}]
        kwargs["response_format"] = DECISION_SCHEMA
        kwargs["max_tokens"] = 60

    start = time.perf_counter()
    ttft, chunks = None, []
    for event in client.chat.completions.create(**kwargs):
        delta = event.choices[0].delta.content if event.choices else None
        if delta:
            if ttft is None:
                ttft = time.perf_counter() - start
            chunks.append(delta)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": len("".join(chunks))}

def bench(mode: str, rounds: int = 5) -> dict:
    results = [timed_call(p, mode) for _ in range(rounds) for p in SAMPLES]
    totals = sorted(r["total"] for r in results)
    return {
        "mode": mode,
        "ttft_avg": round(statistics.mean(r["ttft"] for r in results), 3),
        "total_p50": round(totals[len(totals) // 2], 3),
        "total_p95": round(totals[int(len(totals) * 0.95) - 1], 3),
        "avg_chars": round(statistics.mean(r["chars"] for r in results), 1),
    }

if __name__ == "__main__":
    for m in ("generate", "decision"):
        print(json.dumps(bench(m), ensure_ascii=False))
El script usa salida en streaming, así que puedes obtener a la vez el tiempo hasta el primer token (TTFT) y el tiempo total. Se recomienda ejecutar cada modo al menos 20 veces y alternarlos dentro del mismo periodo de tiempo para evitar desviaciones por fluctuaciones de red.
🚀 Inicio rápido: La práctica recomendada oficialmente es reclamar primero el crédito de prueba gratuito para nuevos usuarios en APIYI apiyi.com, ejecutar una ronda con el script anterior usando tus propias muestras reales de tickets de trabajo, y luego decidir si conectas GPT-6 Luna Decisions API al entorno de producción.
Datos de pruebas reales de GPT-6 Luna Decisions API
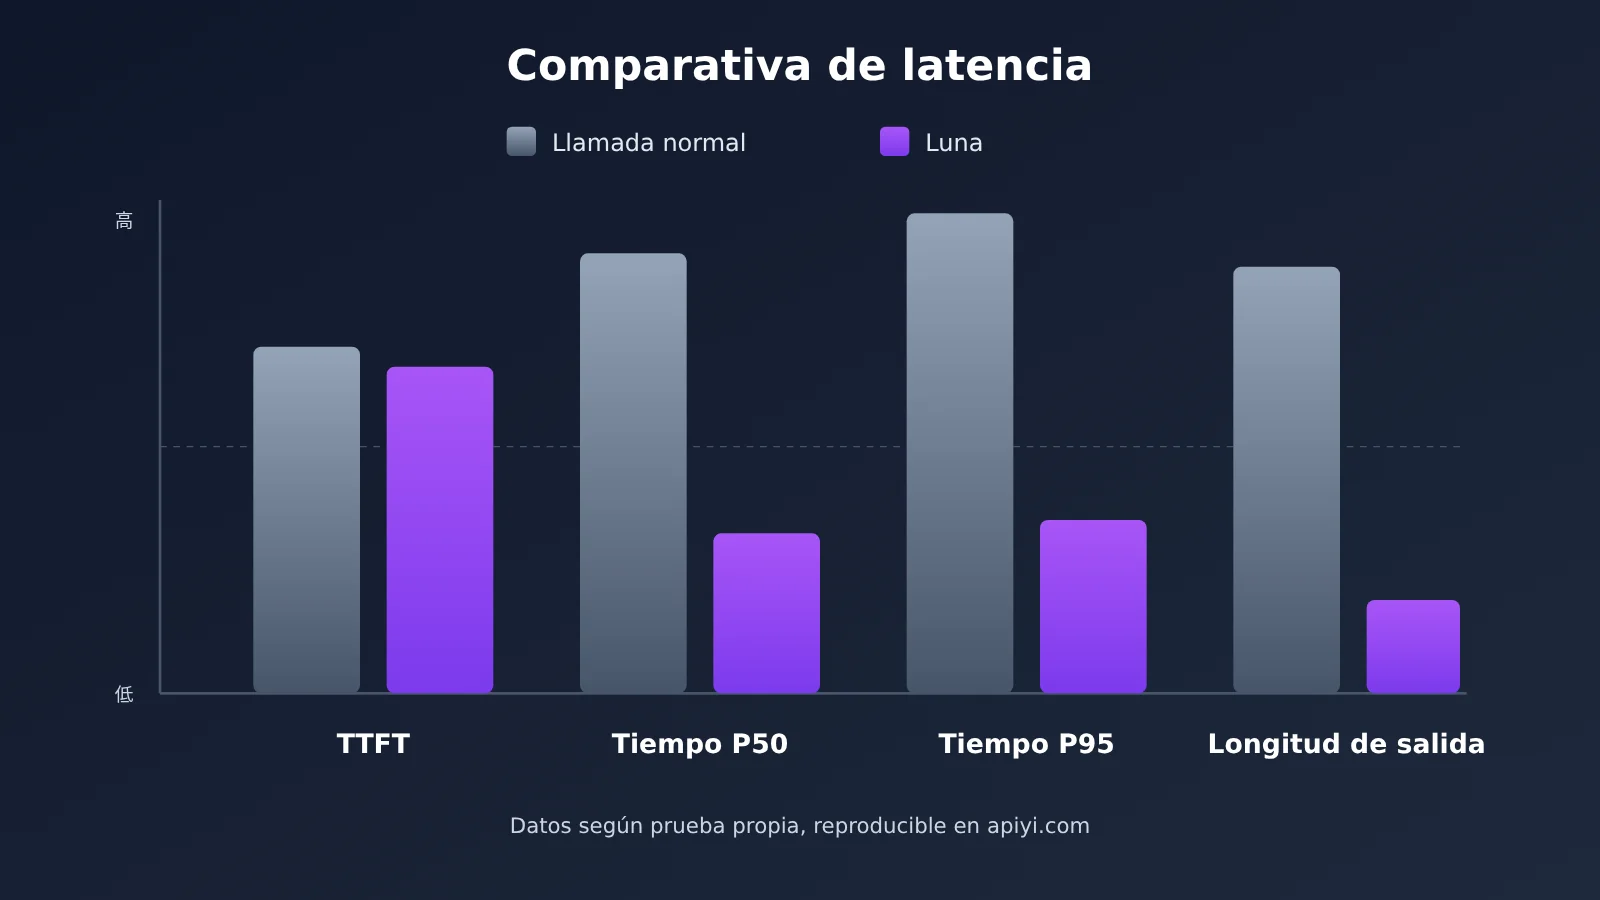
No existe una respuesta única a “cuánto más rápido que una llamada normal”, así que esta sección ofrece un marco de evaluación reproducible. Ejecuta las pruebas según el entorno y los indicadores de abajo; solo así tus cifras podrán guiar de verdad las decisiones de negocio.
Configuración del entorno de prueba
| Elemento de configuración | Ajuste recomendado | Descripción |
|---|---|---|
| Punto de entrada de llamadas | Interfaz compatible con OpenAI (base_url apunta a la puerta de enlace unificada) | Garantiza que ambos modos usen la misma ruta de red |
| Datos de muestra | 20-100 solicitudes reales de negocio | Los tiempos de latencia medidos con datos sintéticos suelen ser demasiado optimistas |
| Modo de llamada | stream=True |
Solo así se puede medir el tiempo hasta el primer token |
| Concurrencia | Primero una sola concurrencia y luego subir gradualmente hasta el pico del negocio | Observar la fluctuación de latencia bajo alta concurrencia |
| Franja horaria | Probar una ronda en hora pico y otra en hora valle de un día laborable | Eliminar diferencias de carga por franja horaria |
Indicadores clave de latencia
| Indicador | Significado | Criterio de evaluación |
|---|---|---|
| TTFT: tiempo hasta el primer token | Desde que se envía la solicitud hasta que se recibe el primer carácter | Ambos modos suelen ser parecidos; depende principalmente de la longitud de entrada |
| Tiempo total P50 | Tiempo en el que se completa la mitad de las solicitudes | Indicador central de la ventaja del modo de decisión; cuanto mayor sea la diferencia, más vale la pena cambiar |
| Tiempo total P95 | Tiempo de las solicitudes de cola larga | Determina el límite inferior de la experiencia de usuario; imprescindible en negocios en línea |
| Longitud media de salida | Número de caracteres o tokens devueltos en cada respuesta | Explica la mejora de velocidad y también se relaciona directamente con el costo |
| Tasa de éxito de formato | Proporción de resultados que se pueden analizar directamente | Los reintentos por fallo se comen el tiempo ahorrado |
Cómo interpretar los resultados de evaluación de Decisions API
Si ves que el TTFT de ambos modos es casi igual, pero la diferencia en el tiempo total P50 es clara, significa que la mejora de velocidad sí proviene de “generar menos”; este es el resultado más esperado. En ese caso, puedes comparar además la longitud media de salida: cuanto mayor sea la diferencia entre ambas, más considerables serán el tiempo y el costo de salida que ahorras.
Si la diferencia en P50 no es grande pero la de P95 es evidente, significa que la cola larga de la llamada normal se debe principalmente a salidas largas ocasionales. En este caso, aunque el promedio no muestre una mejora llamativa, cambiar a GPT-6 Luna Decisions API sigue mejorando de forma notable la estabilidad del negocio en línea.
También puede ocurrir que ambos modos casi no presenten diferencias; normalmente significa que tus indicaciones actuales ya son bastante contenidas. En ese caso, el valor de cambiar está principalmente en la fiabilidad del formato, no en la velocidad.
💡 Sugerencia de validación: Para un mismo lote de muestras, se recomienda probar de forma alterna bajo la misma puerta de enlace. Recomendamos ejecutar la comparación directamente a través de la interfaz unificada de APIYI apiyi.com, para evitar que los resultados se distorsionen por usar distintas salidas de red.
Para qué negocios encaja la API GPT-6 Luna Decisions
El valor de una API orientada a decisiones no está en que una llamada aislada tarde unos cientos de milisegundos menos, sino en que, en escenarios de alta frecuencia, simples y donde el programa necesita consumir el resultado, esos milisegundos se multiplican por miles de peticiones. La siguiente tabla resume el grado de adecuación en cinco tipos de negocio habituales.
| Escenario de negocio | Salida típica | Adecuación | Descripción |
|---|---|---|---|
| Enrutamiento de tickets de soporte | Etiqueta de departamento + nivel de confianza | Alta | Volumen de peticiones elevado y opciones fijas: tanto la mejora de velocidad como la de formato se notan claramente |
| Moderación de contenido | Aprobar / Rechazar / Revisión humana | Alta | Sensible a la latencia P95; el resultado debe accionar el flujo directamente |
| Selección de herramientas en un Agent | Qué herramienta invocar y con qué parámetros | Alta | En un Agent de varios pasos cada paso ahorra tiempo y la ganancia se acumula |
| Precribado de riesgo y antifraude | Nivel de riesgo | Media | Sirve como primer filtro; las decisiones críticas siguen necesitando reglas o revisión humana como respaldo |
| Redacción de textos largos / generación de informes | Bloques extensos de lenguaje natural | Baja | Requiere salidas largas por naturaleza; no es el escenario objetivo de una API de decisiones |
Comparativa: Decisions API frente a otras alternativas
Para tareas de decisión no todo pasa por un Modelo de Lenguaje Grande. La siguiente tabla compara la API GPT-6 Luna Decisions con varias alternativas habituales.
| Solución | Característica clave | Escenario de uso | Latencia | Plataformas disponibles |
|---|---|---|---|---|
| API GPT-6 Luna Decisions | Capacidad de comprensión del Modelo de Lenguaje Grande + salida corta estructurada | Decisiones con semántica compleja y opciones bien definidas | Baja (según pruebas propias) | APIYI apiyi.com, API oficial |
| Invocación generativa estándar | Flexible, puede incluir explicaciones | Decisiones de baja frecuencia que necesitan justificación | Media a alta, crece con la longitud de la salida | Plataformas principales de Modelos de Lenguaje Grande |
| Clasificación con modelos ligeros | Barata y rápida, pero con comprensión limitada | Clasificación con semántica simple y etiquetado suficiente | Baja | Plataformas principales de Modelos de Lenguaje Grande o despliegue propio |
| Motor de reglas | Milisegundos y control total | Reglas con condiciones claras y prácticamente invariables | Muy baja | Autoconstruido |
Análisis comparativo: el motor de reglas sigue liderando en velocidad y control, pero cuando la entrada es coloquial y muy variable, el coste de mantener las reglas se dispara. Los modelos ligeros tienen una ventaja clara en coste, aunque se quedan cortos ante semántica ambigua y contextos largos. Frente a ambos, la API GPT-6 Luna Decisions encaja mejor en escenarios de «semántica compleja pero espacio de respuestas acotado», y se sitúa como un punto intermedio entre las reglas y la invocación generativa convencional.
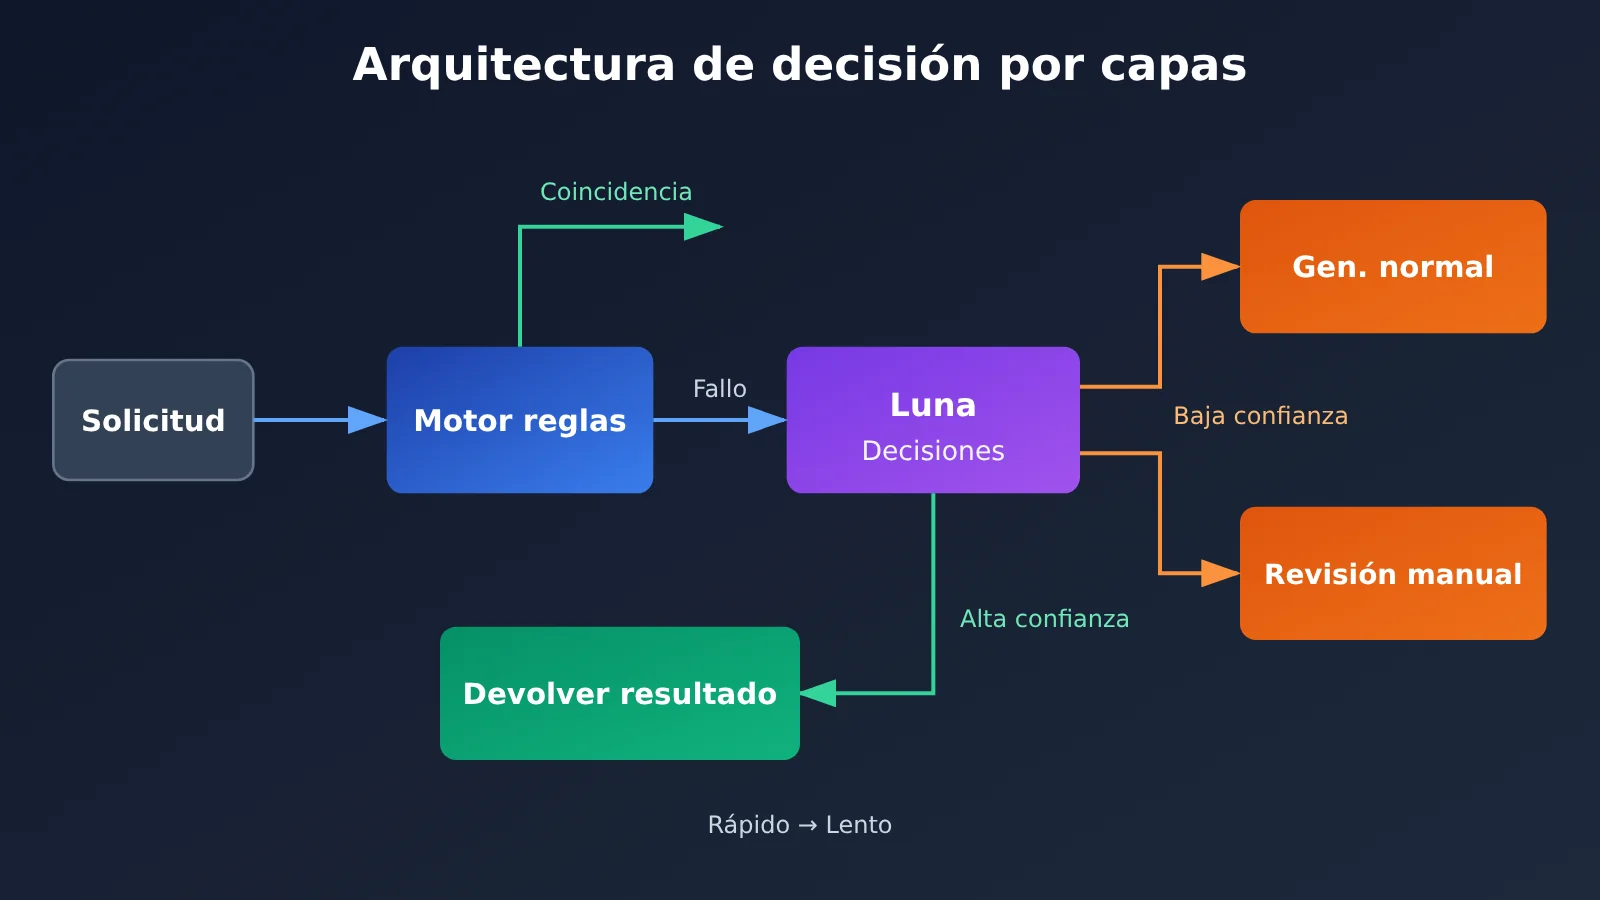
En la práctica, lo más habitual es una arquitectura por capas: el motor de reglas resuelve las condiciones claras, la API GPT-6 Luna Decisions se ocupa de las peticiones ambiguas y solo se recurre a la invocación generativa estándar cuando hace falta una explicación.
Análisis de ventajas y desventajas de la API GPT-6 Luna Decisions
Ventajas
- Tiempo total más controlable: la salida se compacta en resultados estructurados, lo que reduce notablemente el tiempo de la fase de generación y hace más estable la latencia de cola.
- Resultados directamente consumibles: junto con JSON Schema, los valores devueltos pueden entrar directamente en el flujo de negocio, lo que reduce el código de análisis y los reintentos fallidos.
- Estructura de costos más favorable: menos tokens de salida implica también menores costos de salida, algo especialmente visible en escenarios de alta frecuencia.
- Baja barrera de integración: al basarse en un protocolo compatible con OpenAI, normalmente basta con ajustar el nombre del modelo y las restricciones de salida en el código existente para hacer el cambio.
Limitaciones
- No está pensada para explicar: el resultado de la decisión no incluye justificación. Si necesitas auditoría, puedes hacer una llamada normal adicional sobre las muestras de baja confianza para obtener una explicación complementaria.
- La mejora de velocidad depende del escenario: si la llamada actual ya solo devuelve una etiqueta, el beneficio del cambio será limitado. Conviene cuantificarlo primero con un script de evaluación antes de migrar.
- La longitud de entrada sigue siendo un cuello de botella: la interfaz orientada a decisiones optimiza la salida; el tiempo de prellenado en contextos muy largos no desaparece por ello. Cuando sea necesario, primero hay que recortar la entrada o comprimir el contexto mediante recuperación.
- Depende de la calidad del diseño de opciones: una definición poco clara de los valores de enumeración hará que el modelo dude entre opciones similares. En el Schema deben darse opciones claras y mutuamente excluyentes.
Preguntas frecuentes FAQ
Q1: ¿Qué es la API GPT-6 Luna Decisions?
Es un modo de invocación orientado a tareas de decisión. La clave está en que el modelo entregue un resultado breve y estructurado entre las opciones dadas, en lugar de generar textos largos. Resulta ideal para escenarios de clasificación, enrutamiento, moderación y selección de herramientas. Los parámetros concretos se rigen por la documentación oficial.
Q2: ¿Cuánto más rápida es la API Decisions frente a una invocación normal del modelo?
No existe un factor de multiplicación universal. La ganancia de velocidad proviene sobre todo de acortar la salida: cuanto más larga era la salida original, mayor es el beneficio tras el cambio. Recomendamos usar el script de evaluación de este artículo para comparar el tiempo total P50 y P95 con tus muestras reales y sacar una conclusión válida para tu negocio.
Q3: ¿En qué se diferencia la API GPT-6 Luna Decisions de una invocación normal con salida JSON?
Una invocación normal con restricciones JSON también logra un efecto similar; la diferencia entre ambas depende de si el proveedor aplicó optimizaciones específicas para escenarios de decisión, como la intensidad de razonamiento, las restricciones de salida y la programación del servicio. La forma más fiable de decidir sigue siendo una comparación práctica en las mismas condiciones.
Q4: ¿Qué tipos de negocio conviene migrar primero?
Prioriza los negocios con gran volumen de solicitudes, un espacio de respuestas fijo y sensibilidad a la latencia, como el enrutamiento de tickets de atención al cliente, la moderación de contenido y la selección de herramientas de Agent. Para tareas que en sí mismas requieren salidas largas, como redacción extensa o generación de informes, no se recomienda el cambio.
Q5: ¿Cómo llamar rápidamente a la API GPT-6 Luna Decisions a través de la API?
Recomendamos seguir estos pasos:
1. Visita APIYI apiyi.com, crea una cuenta y obtén tu clave API
2. En la lista de modelos de la consola, confirma el ID real del modelo GPT-6 Luna
3. Configura `base_url` como `https://api.apiyi.com/v1` en el código de este artículo y sustituye el nombre del modelo para ejecutarlo
La plataforma usa una interfaz compatible con OpenAI, por lo que con una sola clave puedes invocar también otros modelos principales y hacer pruebas comparativas.
Q6: ¿Cómo controlar el costo de las llamadas a la API Decisions?
Las salidas de tipo decisión ya ahorran tokens de salida; para optimizar más puedes actuar en tres frentes: recortar el contexto innecesario, usar un motor de reglas para interceptar solicitudes claras y hacer una segunda llamada solo con las muestras de baja confianza. En la consola de APIYI apiyi.com puedes consultar el detalle de uso por modelo, lo que facilita identificar dónde se concentra el costo.
Q7: ¿Qué limitaciones conocidas tiene la API GPT-6 Luna Decisions?
Las principales limitaciones son que no ofrece justificación de la decisión, que la mejora de velocidad depende de la longitud de salida original y que el tiempo de prellenado (prefill) de entradas muy largas no se puede eliminar. Para decisiones de alto riesgo, como en finanzas o salud, se recomienda usarlo como apoyo al juicio y mantener una revisión humana.
Puntos clave de la API Decisions de GPT-6 Luna
- Posicionamiento claro: la API Decisions resuelve «decidir rápido entre opciones limitadas», no la generación de textos largos.
- De dónde viene la velocidad: sobre todo de respuestas más cortas; cuanto más larga era la salida original, más se nota el cambio.
- Métricas clave: fíjate en el tiempo total P50 y P95; el TTFT suele ser muy parecido en ambos modos.
- Mejores escenarios: tareas de decisión de alta frecuencia como enrutamiento de tickets, moderación de contenido o selección de herramientas en un Agent.
- Arquitectura recomendada: motor de reglas + API Decisions + llamadas normales como respaldo por capas.
- Cómo empezar: ejecuta un script comparativo con la interfaz compatible con OpenAI y migra solo cuando tengas tus propios datos.
Conclusión
Los puntos clave de la API Decisions de GPT-6 Luna:
- Rápida porque genera poco: su ventaja de velocidad viene de salidas cortas y estructuradas, no de una mejora en la velocidad de generación por token.
- El valor depende del escenario: los mayores beneficios están en operaciones de alta frecuencia, con opciones fijas y sensibles a la latencia; no aplica a escenarios de texto largo.
- Las conclusiones salen de medir: la mejora de velocidad varía mucho según la indicación y la muestra, así que calcula P50 y P95 con datos reales.
Si estás trabajando en enrutamiento de atención al cliente, moderación de contenido u orquestación de Agents, vale la pena evaluar en serio la API Decisions de GPT-6 Luna. Te sugiero mantener primero las llamadas actuales como grupo de control, migrar poco a poco una parte del tráfico y después decidir si pasas todo según la latencia y la tasa de éxito del formato.
Recomiendo reclamar crédito gratuito en APIYI apiyi.com y usar el script de este artículo para validar rápido la mejora real de velocidad en tu caso de uso.
📚 Referencias
- Documentación oficial de la API de OpenAI: explicaciones sobre la invocación del modelo, la salida en streaming y la salida estructurada
- Enlace:
platform.openai.com/docs -
Nota: fuente autorizada para confirmar los parámetros relacionados con GPT-6 Luna y Decisions
-
OpenAI Python SDK: cliente oficial de Python
- Enlace:
github.com/openai/openai-python -
Nota: el SDK utilizado por los scripts de evaluación de este artículo, incluye ejemplos de llamadas en streaming
-
Especificación JSON Schema: el estándar de definición de las restricciones de salida estructurada
- Enlace:
json-schema.org - Nota: especificación de referencia para diseñar las opciones de decisión y los valores de enumeración
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal del sitio de APIYI; para más material de integración, visita el centro de documentación docs.apiyi.com