A finales de septiembre y principios de octubre se sucedieron las actualizaciones de los modelos de lenguaje más avanzados: Anthropic lanzó Claude Opus 5.5 el 22 de septiembre, y solo 8 días después Google presentó Gemini 4 Argon. Ambos modelos tienen un enfoque muy similar: destacan en razonamiento de varios pasos, programación con agentes y trabajo empresarial basado en el conocimiento. Además, sus precios oficiales son idénticos: $4 por millón de tokens de entrada y $20 por millón de tokens de salida. Por eso, Gemini 4 Argon vs Claude Opus 5.5 se ha convertido en una de las comparaciones más habituales entre los desarrolladores que deben elegir un modelo.
Por ahora, la información pública es limitada. Los datos primarios más completos aparecen en una tabla comparativa de 19 pruebas de referencia que Google incluyó en su documentación de evaluación de Argon y que también contempla Claude Opus 5.5. En este artículo analizamos esa tabla punto por punto y añadimos evaluaciones independientes de terceros, como Artificial Analysis y Vals, además de factores de ingeniería como el precio, el límite de salida y la disponibilidad. El objetivo es ayudarte a determinar qué modelo encaja mejor en cada caso.
Qué te llevas: al terminar de leer, sabrás qué cifras de la tabla de evaluación de Google son fiables y cuáles conviene tomar con cautela. También podrás elegir entre Gemini 4 Argon y Claude Opus 5.5 según las necesidades de tu negocio.
Comparación de los parámetros básicos de Gemini 4 Argon y Claude Opus 5.5
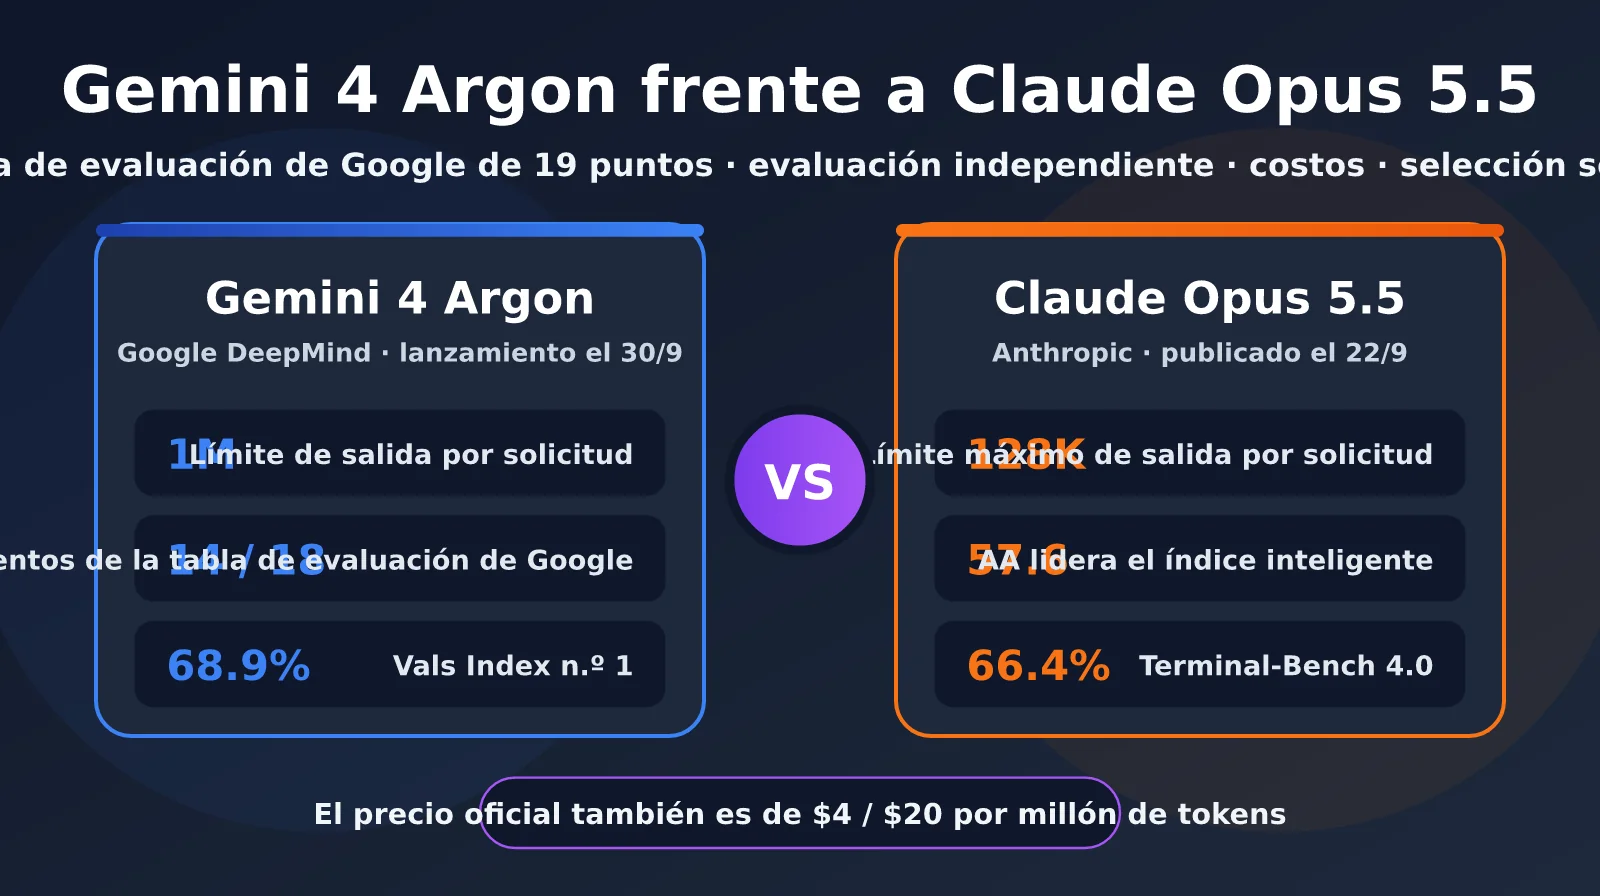
Antes de revisar los resultados de las evaluaciones, comparemos los parámetros básicos de ambos modelos. Sus precios oficiales son exactamente iguales; las diferencias principales están en el límite de salida, la disponibilidad y el precio promocional.
| Aspecto | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Fecha de lanzamiento | 30 de septiembre de 2026 | 22 de septiembre de 2026 |
| Disponibilidad actual | Plan Fairwind y despliegue gradual en Vertex AI; la API de pago aún no está disponible de forma general | Disponible de forma general: Claude API, Bedrock, Vertex AI y Foundry |
| ID del modelo | Aún no anunciado oficialmente | claude-opus-5-5 |
| Precio (entrada/salida) | Promocional: $2/$10; oficial: $4/$20 | $4/$20 |
| Lectura de caché | 95 % de descuento sobre el precio de entrada (desde $0.10) | $0.20 |
| Precio por lotes (Batch) | No anunciado | $2/$10 |
| Ventana de contexto | No anunciada oficialmente (terceros indican 1M) | 1M, sin recargo por contexto largo |
| Límite de salida por solicitud | 1M de tokens | 128K tokens |
| Control del razonamiento | Niveles de razonamiento, como High | Cinco niveles de esfuerzo, de low a max, con pensamiento adaptativo |
La tabla muestra que la mayor ventaja técnica de Argon es su límite de salida de 1M de tokens, unas 8 veces el de Opus 5.5, lo que lo hace adecuado para generar grandes cantidades de código y realizar migraciones a gran escala. La principal ventaja de Opus 5.5 es que ya se puede usar de forma estable: tiene un ID de modelo definido, está disponible en las principales plataformas en la nube e incluye precios a mitad de coste para procesamiento por lotes y cinco niveles de esfuerzo. En términos de madurez para ingeniería, está claramente más avanzado.
🎯 Recomendación: los precios oficiales de ambos modelos son iguales, así que la elección depende sobre todo del tipo de tarea. Te recomendamos probar Claude Opus 5.5 y los modelos Gemini con el mismo conjunto de interfaces a través de la plataforma APIYI apiyi.com. Compararlos con tus propias tareas reales es más fiable que basarse únicamente en las tablas de clasificación.
Gemini 4 Argon vs. Claude Opus 5.5: análisis punto por punto de la tabla de evaluación de Google
A continuación se muestran los datos comparativos publicados por Google en su documento de evaluación de Argon. Aquí solo se incluyen las columnas de Argon y Opus 5.5, organizadas por categoría. Conviene tener en cuenta que se trata de una tabla publicada por uno de los fabricantes: Google obtuvo por su cuenta los resultados de Argon, mientras que la mayoría de los resultados de Opus 5.5 proceden de tablas públicas o de la ficha del sistema de Anthropic. Google volvió a ejecutar algunos de los benchmarks con un procedimiento unificado.
| Categoría | Benchmark | Gemini 4 Argon | Claude Opus 5.5 | Quién va por delante |
|---|---|---|---|---|
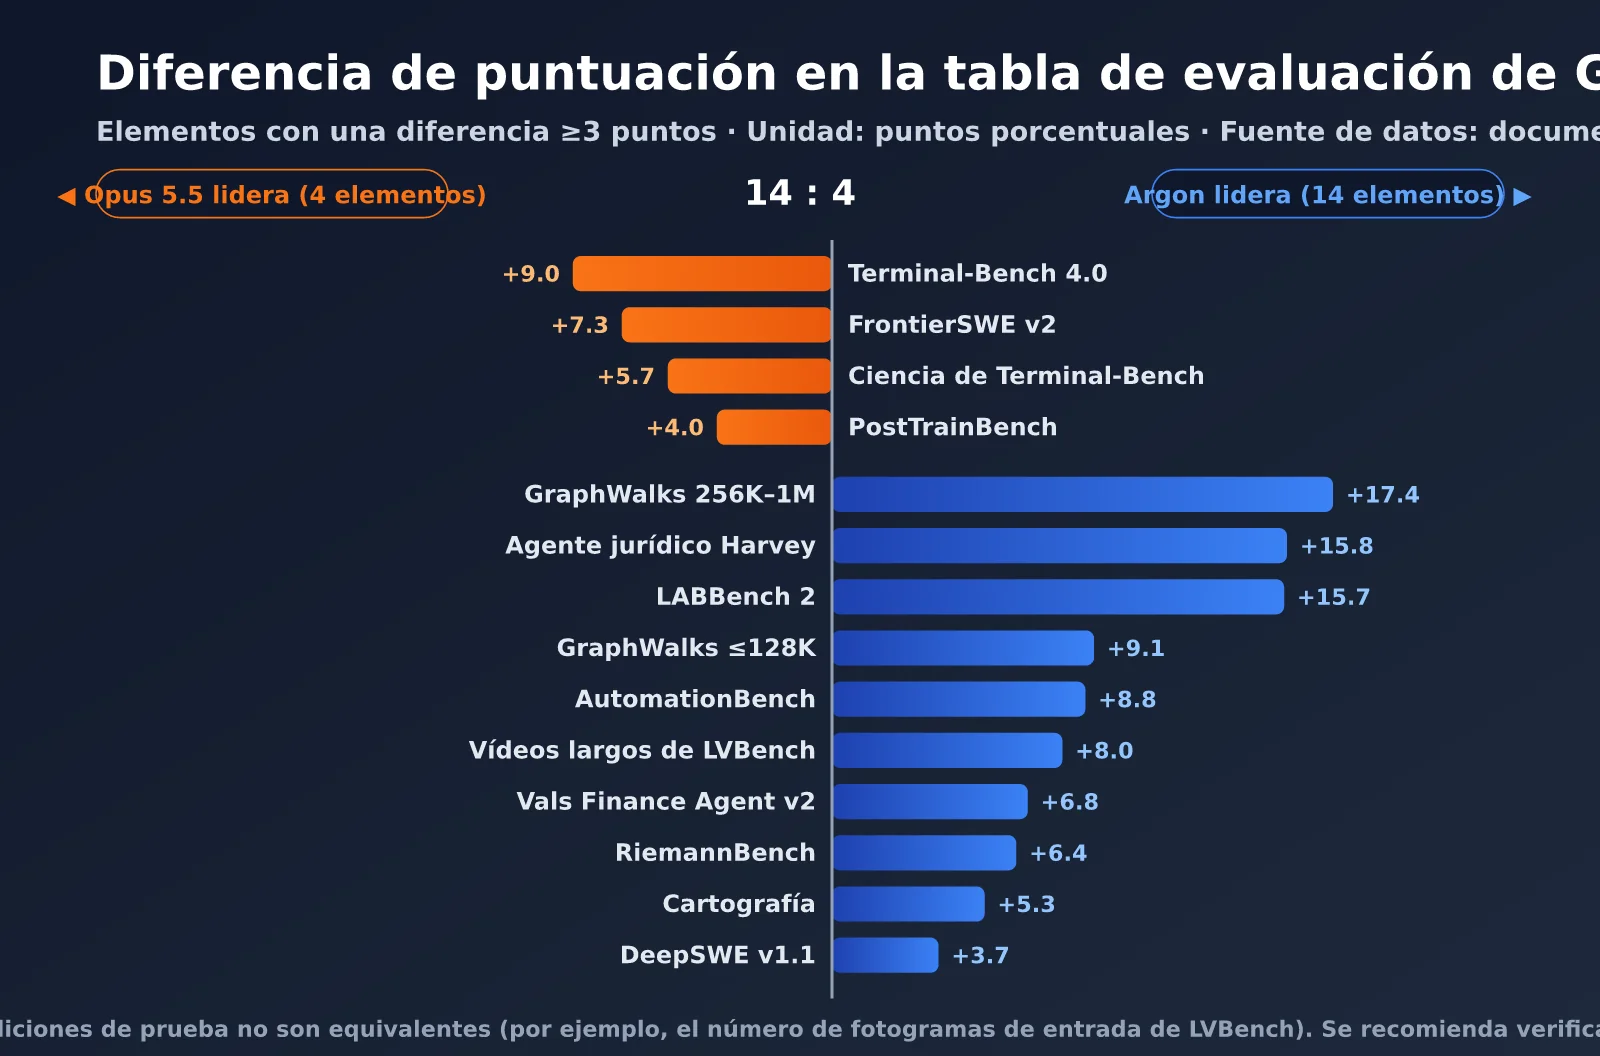
| Trabajo del conocimiento | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| Trabajo del conocimiento | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| Trabajo del conocimiento | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| Trabajo del conocimiento | Harvey Legal Agent | 19.6% | 3.8% | Argon +15.8 |
| Programación con agentes | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| Programación con agentes | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| Programación con agentes | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| Programación con agentes | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| Ingeniería de ML | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| Ciencia y matemáticas | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| Ciencia y matemáticas | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| Ciencia y matemáticas | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| Contexto largo | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| Contexto largo | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| Operación de computadoras | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| Multimodal | Chartography | 71.6% | 66.3% | Argon +5.3 |
| Multimodal | LVBench, vídeos largos | 91.7% | 83.7% | Argon +8.0 |
| Ciberseguridad | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
De los 18 benchmarks en los que ambos tienen resultados, Argon va por delante en 14 y Opus 5.5 en 4. Las cuatro victorias de Opus 5.5 se concentran en tareas que requieren trabajar durante mucho tiempo en entornos de terminal y ejecutar comandos repetidamente: FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench y Terminal-Bench Science. Las mayores ventajas de Argon se dan en contexto largo (17.4 puntos de diferencia en GraphWalks 256K–1M), agentes legales y ciencias de la vida (LABBench 2).
Aspectos de la tabla de evaluación de Google que conviene matizar
Las tablas de evaluación publicadas por los propios fabricantes suelen favorecer a sus modelos, y las notas al pie de esta también incluyen varios detalles que vale la pena tener en cuenta. Entenderlos ayuda a interpretar correctamente las diferencias entre Gemini 4 Argon y Claude Opus 5.5:
- Distinto número de fotogramas de entrada en LVBench: Argon procesa el vídeo completo a razón de 1 fotograma por segundo, mientras que Opus 5.5, debido a las limitaciones de la API, solo puede recibir 600 fotogramas. Parte de la diferencia en los resultados con vídeos largos se debe a que las condiciones de entrada no son equivalentes.
- Se amplió el límite de tiempo de Terminal-Bench Science: el tiempo de espera de verificación de Argon se fijó en seis veces el valor predeterminado. Aun así, Argon quedó 5.7 puntos por detrás de Opus 5.5.
- Marcos de prueba distintos en DeepSWE: Argon se evaluó internamente con el marco mini-swe agent, mientras que el resultado de Claude procede de la ficha del sistema de Anthropic. Por tanto, los marcos de evaluación no coinciden.
- Diferencias con los datos publicados por Anthropic: en los resultados que Anthropic publicó para Opus 5.5, AutomationBench alcanza el 40.0%, Chartography con herramientas llega al 89.0% y OSWorld 2.0 obtiene un 81.8%. En la tabla de Google, Chartography figura con solo un 66.3% y la casilla de OSWorld se deja en blanco.
En otras palabras, cuando se igualan las condiciones de prueba, la diferencia entre ambos es menor de lo que sugiere la tabla. La ventaja de Argon en contexto largo, tareas legales y ciencias de la vida es suficientemente amplia como para considerarla bastante fiable. En cambio, en pruebas como Vals Index, Vibe Code y CWE-bench, donde la diferencia es de apenas 1 o 2 puntos, los resultados pueden considerarse prácticamente un empate.
Resultados de evaluaciones independientes: Gemini 4 Argon vs Claude Opus 5.5
Las conclusiones de las evaluaciones independientes de terceros no coinciden con las de Google; incluso apuntan en direcciones opuestas en el índice de inteligencia general. La siguiente tabla resume los datos públicos de Artificial Analysis (AA) y Vals.
| Evaluación independiente | Gemini 4 Argon | Claude Opus 5.5 | Modelo líder |
|---|---|---|---|
| AA Intelligence Index v4.3 | 52.6 | 57.6 | Opus +5.0 |
| Clasificación de Vals Index | 68.90 % (n.º 1) | 66.97 % (n.º 3) | Argon +1.9 |
| AA Terminal-Bench 4.0 | 57.1 % | 59.6 % | Opus +2.5 |
| AA Humanity’s Last Exam | 57.1 % | 61.4 % | Opus +4.3 |
| AA SciCode | 61.8 % | 66.9 % | Opus +5.1 |
| AA razonamiento con contexto largo | 79.7 % | 84.7 % | Opus +5.0 |
| AA GDPval (Elo) | 1611 | 1846 | Opus +235 |
| AA AutomationBench | 77.5 % | 69.5 % | Argon +8.0 |
| Velocidad de salida de AA | 48.9 tokens/s | 92.2 tokens/s | Opus, unas 1.9 veces más rápido |
En las pruebas de AA, Opus 5.5 supera a Argon en razonamiento, programación científica, razonamiento con contexto largo y tareas profesionales de GDPval. Argon solo destaca claramente en AutomationBench, que mide la automatización de procesos empresariales. Sin embargo, la comparación de AA no es del todo equitativa: Argon se evaluó únicamente en el nivel High, mientras que Opus 5.5 utilizó el nivel Max, con razonamiento adaptativo. Por tanto, parte de la diferencia podría deberse a la configuración de la intensidad del razonamiento y no exclusivamente a las capacidades de los modelos.
Vals Index sitúa a Argon en primer lugar entre 41 modelos y a Opus 5.5 en el tercero. Sin embargo, la diferencia entre ambos es de aproximadamente 1.5 errores estándar: Argon tiene una ligera ventaja, pero no es concluyente. En conjunto, Gemini 4 Argon y Claude Opus 5.5 pertenecen a la misma categoría en cuanto a capacidades generales; ninguno domina claramente al otro.
💡 Consejo sobre las evaluaciones: Las conclusiones pueden variar según la organización que realiza las pruebas; al final, lo que importa son tus propios datos. La plataforma APIYI, apiyi.com, permite cambiar entre modelos de las familias Claude, Gemini, GPT y otras desde una interfaz unificada, lo que facilita crear rápidamente un conjunto pequeño de pruebas propio.
Diferencias clave entre Gemini 4 Argon y Claude Opus 5.5
Más allá de las puntuaciones, las diferencias en el enfoque de diseño de estos dos modelos pueden servir más para elegir uno que las diferencias en pruebas individuales.
Dos enfoques para las tareas de larga duración
El enfoque de Gemini 4 Argon consiste en ampliar el espacio disponible para cada respuesta. El límite de salida de 1M permite generar cientos de miles de líneas de código o informes muy extensos en una sola solicitud. Google lo ha utilizado internamente para migrar más de 800 000 líneas de código C/C++ del kernel Fuchsia Zircon a Rust, así como para sustituir 32 000 líneas de código SIMD en libgav1, entre otras tareas. Este diseño reduce la necesidad de dividir el trabajo y recomponer el contexto, por lo que resulta especialmente útil cuando se necesita generar mucho contenido de una sola vez.
El enfoque de Claude Opus 5.5 consiste en hacer más controlable el proceso de razonamiento. En lugar de priorizar una salida enorme, ofrece cinco niveles de esfuerzo, desde low hasta max, y mantiene activado el razonamiento adaptativo. Así, los desarrolladores pueden ajustar la profundidad del razonamiento y el costo según la dificultad de cada tarea. En combinación con marcos de agentes como Claude Code, Opus 5.5 se desenvuelve mejor en tareas que requieren ejecutar herramientas varias veces, observar los resultados y corregir el rumbo. Esto también ayuda a explicar por qué destaca en tareas de interacción con terminales como las de Terminal-Bench.
Velocidad, latencia y estabilidad
Las pruebas de Artificial Analysis muestran que Opus 5.5 genera unas 92 tokens/s, casi el doble que Argon, con 48.9 tokens/s. Para asistentes de programación interactivos y agentes de atención al cliente, esta diferencia se nota directamente en la experiencia de usuario. Argon, en cambio, puede completar más trabajo en una sola solicitud, por lo que resulta adecuado para tareas de fondo de gran volumen que no exigen una respuesta inmediata.
Además, Opus 5.5 lleva varias semanas funcionando de forma estable en distintas plataformas en la nube, y cuenta con documentación consolidada sobre cuotas, límites de uso y gestión de errores. Argon aún está en las primeras etapas de su despliegue a gran escala, y sus políticas de cuotas y límites de uso no están claras. En sistemas de producción con requisitos exigentes de SLA, este aspecto debería pesar tanto como las puntuaciones de las pruebas.
Seguridad y protección frente a la inyección de indicaciones
Ambas compañías consideran prioritaria la seguridad de los agentes. Google afirma que Argon es su modelo más resistente hasta la fecha frente a la inyección indirecta de indicaciones y que lidera la prueba Gray Swan IPI, aunque no ha publicado puntuaciones concretas. Por otro lado, el análisis de proveedores externos de seguridad indica que Opus 5.5 comparte con Claude Fable 5.1 la tasa más baja de éxito de inyección en esa misma prueba. En otras palabras, ambos modelos se encuentran entre los mejores en protección frente a la inyección de indicaciones y cada uno puede afirmar que lidera en este ámbito. Si un agente necesita leer páginas web, correos electrónicos o documentos externos, sea cual sea el modelo elegido, también habrá que aislar los permisos de las herramientas y establecer mecanismos de confirmación humana.
Comparación de costos: Gemini 4 Argon vs. Claude Opus 5.5
Los precios oficiales de ambos modelos son iguales, pero el consumo de tokens varía según la tarea, por lo que el costo real puede ser muy distinto. La siguiente tabla muestra el costo por tarea medido por una entidad independiente.
| Criterio de costo | Gemini 4 Argon | Claude Opus 5.5 | Diferencia |
|---|---|---|---|
| Costo promedio por tarea en AA | $1.99 (precio promocional) | $5.98 | Argon cuesta aproximadamente un tercio |
| Costo total de AA para completar todo el índice | $2,407 | $8,708 | Argon cuesta aproximadamente el 28 % |
| Costo por prueba de Vals | $15.68 | $32.14 | Argon cuesta aproximadamente el 49 % |
| Costo por tarea de AA calculado con el precio oficial | Aproximadamente $3.98 | $5.98 | Argon sigue siendo aproximadamente un tercio más barato |
| Tareas por lotes (Batch) | Sin anunciar | Mitad de precio: $2/$10 | Opus ofrece un descuento por lotes confirmado |
Incluso calculando Argon con el precio oficial de $4/$20, su costo por tarea en las pruebas de AA sigue siendo aproximadamente un tercio menor que el de Opus 5.5. Una de las razones es que Opus 5.5 puede tardar más en razonar en el nivel Max. Si se configura su nivel de esfuerzo (effort) en medium o high, el costo baja de forma notable; ahí está el valor práctico de los cinco niveles de effort de Opus 5.5. Por otro lado, para tareas de procesamiento por lotes sin conexión, el descuento confirmado del 50 % de Opus 5.5 ofrece más certidumbre que el precio por lotes de Argon, que todavía no se ha anunciado.
Recomendaciones por escenario y criterios de decisión: Gemini 4 Argon vs. Claude Opus 5.5
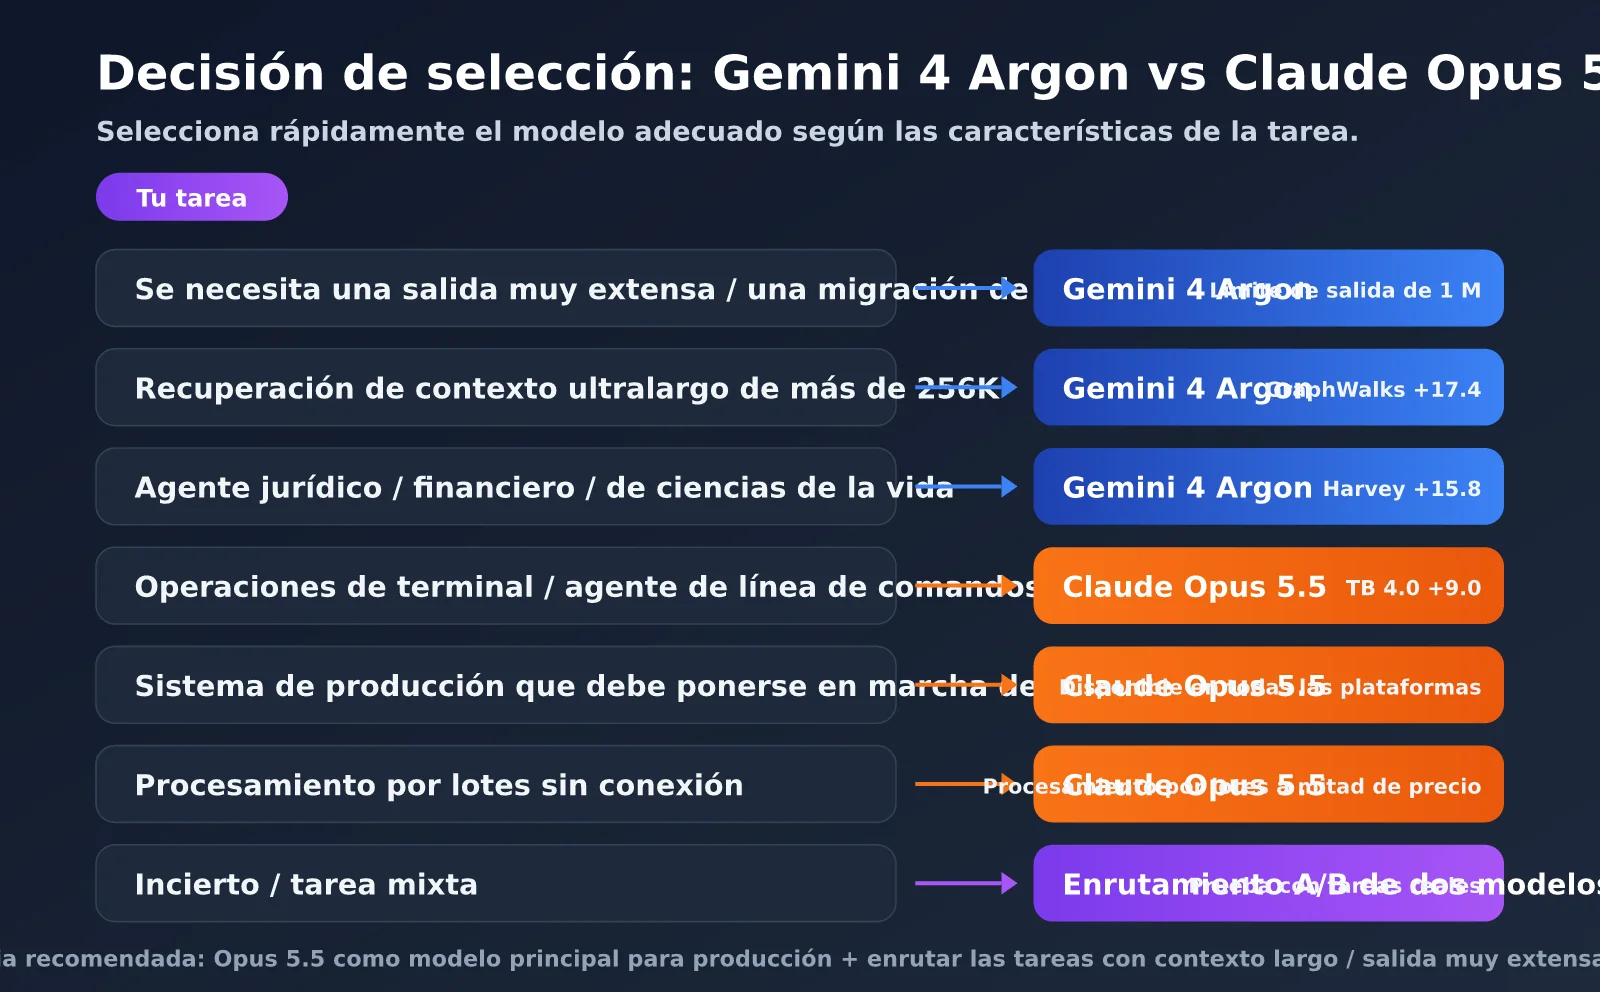
A partir de las tablas de evaluación de Google, las evaluaciones independientes, los costos y la disponibilidad, se pueden hacer recomendaciones bastante claras según el tipo de tarea:
| Escenario de uso | Modelo recomendado | Motivo principal |
|---|---|---|
| Migraciones de código a gran escala / generación de código muy extensa | Gemini 4 Argon | Límite de salida de 1 M; supera a otros modelos por 3,7 puntos en DeepSWE |
| Búsqueda con contextos muy largos, de más de 256K | Gemini 4 Argon | Supera a otros modelos por 17,4 puntos en GraphWalks, entre 256K y 1M |
| Agentes especializados en derecho y finanzas | Gemini 4 Argon | Ventaja de 15,8 puntos en Harvey y de 6,8 en Finance Agent |
| Comprensión de videos largos y gráficos | Gemini 4 Argon | Supera a otros modelos tanto en LVBench como en Chartography |
| Operaciones en terminal y agentes de línea de comandos | Claude Opus 5.5 | Supera a otros modelos por 9 puntos en Terminal-Bench 4.0 |
| Programación científica y razonamiento complejo | Claude Opus 5.5 | Obtiene mejores resultados en SciCode, HLE y CritPt de AA |
| Sistemas de producción que deben ponerse en marcha de inmediato | Claude Opus 5.5 | Disponible en todas las plataformas, con ID de modelo y cuotas claramente definidos |
| Procesamiento por lotes sin conexión | Claude Opus 5.5 | Descuento del 50 % en Batch confirmado: $2/$10 |
Práctica de enrutamiento entre Gemini 4 Argon y Claude Opus 5.5
Para la mayoría de los equipos, la estrategia más práctica no es elegir uno u otro, sino enrutar las tareas entre ambos modelos: usar Opus 5.5 como modelo principal en producción y derivar gradualmente a Argon las tareas para las que destaca, como las de contexto extenso y salida muy larga. Aquí tienes un ejemplo sencillo basado en una interfaz compatible con OpenAI.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # 以平台实际上线 ID 为准

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # 超长上下文或超长输出走 Argon,其余默认 Opus 5.5
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
Ver el código completo: comparación A/B de dos modelos para la misma tarea
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
Este script A/B registra la latencia, los tokens de salida y el costo de cada modelo para una misma tarea. Te recomendamos preparar entre 30 y 50 tareas reales que representen bien tu actividad, evaluarlas manualmente o con un modelo de puntuación y, después, decidir qué proporción de tareas asignar a cada modelo.
🚀 Para empezar rápidamente: puedes registrarte en APIYI, en apiyi.com, y obtener crédito de prueba. Ejecuta el script A/B con Claude Opus 5.5. Cuando Argon esté disponible oficialmente en la plataforma, solo tendrás que cambiar el nombre del modelo en la variable de entorno para completar la comparación.
Preguntas frecuentes
Q1: ¿Cuál es realmente más potente, Gemini 4 Argon o Claude Opus 5.5?
No hay una respuesta absoluta. En la tabla de evaluación de Google, Argon lidera en 14 pruebas y Opus 5.5 en 4; sin embargo, en el índice de inteligencia general de Artificial Analysis, Opus 5.5 supera a Argon con 57,6 frente a 52,6. Ambos están en la misma categoría: Argon destaca por su ventana de contexto larga, sus respuestas muy extensas y sus agentes especializados; Opus 5.5 sobresale en el uso del terminal, el razonamiento complejo y su madurez de ingeniería.
Q2: ¿Son fiables los datos de la tabla de evaluación de Google?
Sirven como referencia, pero conviene tomarlos con cautela. Es una tabla publicada por Google y las condiciones de algunas pruebas no son equivalentes; por ejemplo, el número de fotogramas de entrada en LVBench y el límite de tiempo de Terminal-Bench Science. Además, algunos resultados de Opus 5.5 son más bajos que los publicados por Anthropic. Recomendamos prestar atención sobre todo a las pruebas con diferencias superiores a 5 puntos; una diferencia de 1 o 2 puntos puede considerarse un empate.
Q3: ¿Se pueden invocar ya ambos modelos?
Claude Opus 5.5 ya está disponible por completo en Claude API, Bedrock, Vertex AI y Foundry. Gemini 4 Argon sigue desplegándose por fases: ya se puede acceder a él en Vertex AI, pero la API de pago aún no está disponible de forma generalizada. Recomendamos conectar primero Opus 5.5 y los modelos de la serie Gemini a través de APIYI apiyi.com. Cuando Argon se lance oficialmente, bastará con cambiar el parámetro `model` para compararlos.
Q4: Si ambos modelos cuestan lo mismo, ¿cuál resulta más económico en la práctica?
Según pruebas de terceros, el coste por tarea de Argon equivale aproximadamente a entre un tercio y la mitad del de Opus 5.5, una ventaja aún más notable durante el periodo inicial. Sin embargo, Opus 5.5 permite reducir mucho los costes al bajar el nivel de esfuerzo y usar Batch, que cuesta la mitad. La forma más precisa de compararlos es registrar el uso con tareas reales y calcularlo. La factura unificada de la plataforma APIYI apiyi.com facilita comparar directamente el gasto real de ambos modelos.
Conclusión
Gemini 4 Argon vs Claude Opus 5.5 es un duelo muy reñido. Según la tabla de evaluación de Google, Argon destaca en ventanas de contexto largas, agentes para los sectores legal y financiero, ciencias de la vida y capacidades multimodales. Su límite de salida de 1M es, además, una capacidad sin igual. En cambio, las evaluaciones independientes muestran que Opus 5.5 ofrece mejores resultados en razonamiento, programación científica y uso del terminal. También está disponible en todas las plataformas y tiene una ingeniería más madura.
Por ahora, recomendamos esta estrategia: usar Claude Opus 5.5 como modelo principal en producción e incorporar Gemini 4 Argon de forma gradual para tareas que requieran una ventana de contexto larga o respuestas muy extensas. Al mismo tiempo, conviene seguir haciendo pruebas A/B con un conjunto de tareas reales. Cuando la API de pago de Argon esté disponible de forma generalizada y se publiquen más evaluaciones independientes, se podrá ajustar la proporción de solicitudes en función de los datos.
Recomendamos conectar los modelos de las series Claude y Gemini a través de la plataforma APIYI apiyi.com para compararlos y distribuir las solicitudes desde una sola interfaz y con una única factura. Así, las decisiones sobre qué modelo elegir se basan en datos reales.
Referencias:
- Artículo oficial de Google sobre el lanzamiento de Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Anuncio de lanzamiento de Claude Opus 5.5 de Anthropic: anthropic.com/news
- Índice de inteligencia y comparativas de modelos de Artificial Analysis: artificialanalysis.ai
- Clasificación de evaluaciones de modelos de Vals AI: vals.ai
- Recopilación de la tabla completa de evaluación de Gemini 4 Argon (ToolScout): toolscout.ai/news/gemini-4-argon-benchmarks
Autor: APIYI Team | Seguimos de cerca las evaluaciones y la selección de los modelos de lenguaje grandes más avanzados. Para más información sobre la integración de modelos, visita APIYI apiyi.com