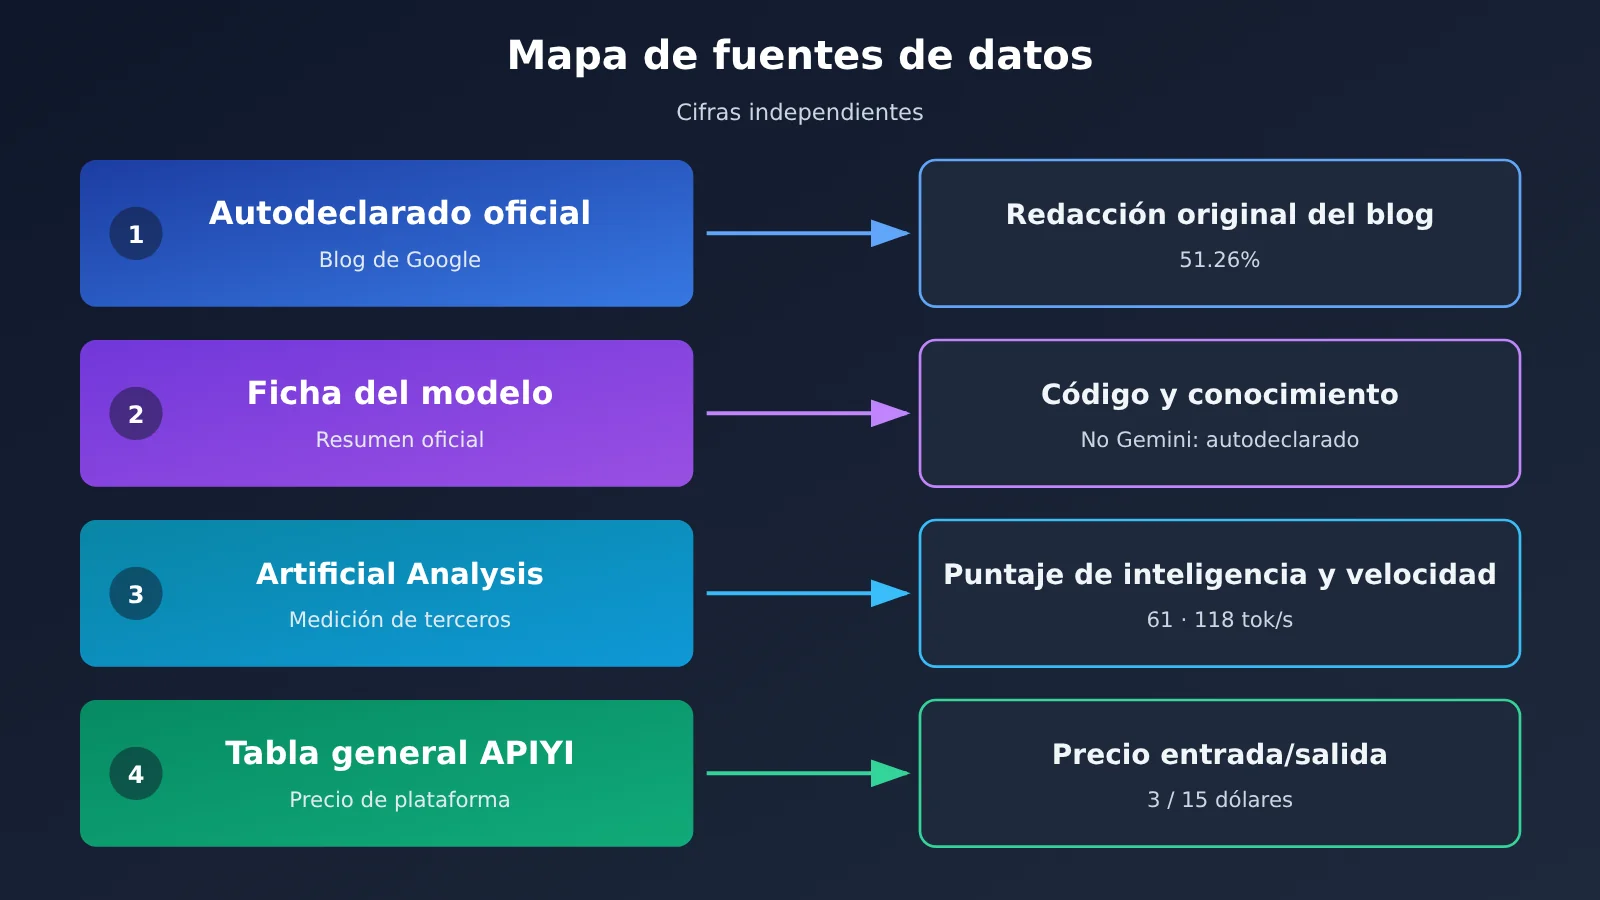
Nota del autor: este artículo analiza por separado las cifras públicas de Gemini 4 Neon y Claude Opus 5.5 en las dos líneas de programación y trabajo del conocimiento, e indica punto por punto si las cifras proceden de datos oficiales autodeclarados, de la ficha del modelo, de la página del modelo en Artificial Analysis, de un artículo de Artificial Analysis, de la tabla general de APIYI o de la interfaz de precios.
Si tu flujo de trabajo ya tiene integrado Claude Opus 5.5, Gemini 4 Neon, lanzado el 2026-11-18, plantea una pregunta directa: en un mismo proyecto, cuál da cifras más altas y si esas cifras se midieron con la misma vara. El blog de Google, la ficha del modelo de DeepMind y Artificial Analysis publicaron cifras el día del lanzamiento, pero sus criterios de medición, niveles y marcos de evaluación no coinciden.
La fecha de verificación de datos de este artículo es 2026-11-19. Todas las cifras provienen de material público y cada una lleva indicada su fuente. La programación y el trabajo del conocimiento se tratan por separado; la ficha del modelo y Artificial Analysis ocupan dos secciones distintas. Qué modelo te conviene más depende de qué filas mires.
Valor clave: al terminar este artículo, sabrás cómo leer la tabla de tres columnas de la ficha del modelo Gemini 4 Neon, qué representan la puntuación de inteligencia, el coste por tarea, el tiempo de ejecución y la velocidad de salida en Artificial Analysis, y cómo consultar en APIYI la versión del modelo y el precio de lista de Claude Opus 5.5.
Gemini 4 Neon y Claude Opus 5.5: puntos clave
Primero, una tabla de lectura rápida. Cada fila indica el nivel y la fuente; las condiciones de medición de ambos números dentro de una misma fila no son necesariamente idénticas.
| Dimensión | Gemini 4 Neon | Claude Opus 5.5 | Fuente |
|---|---|---|---|
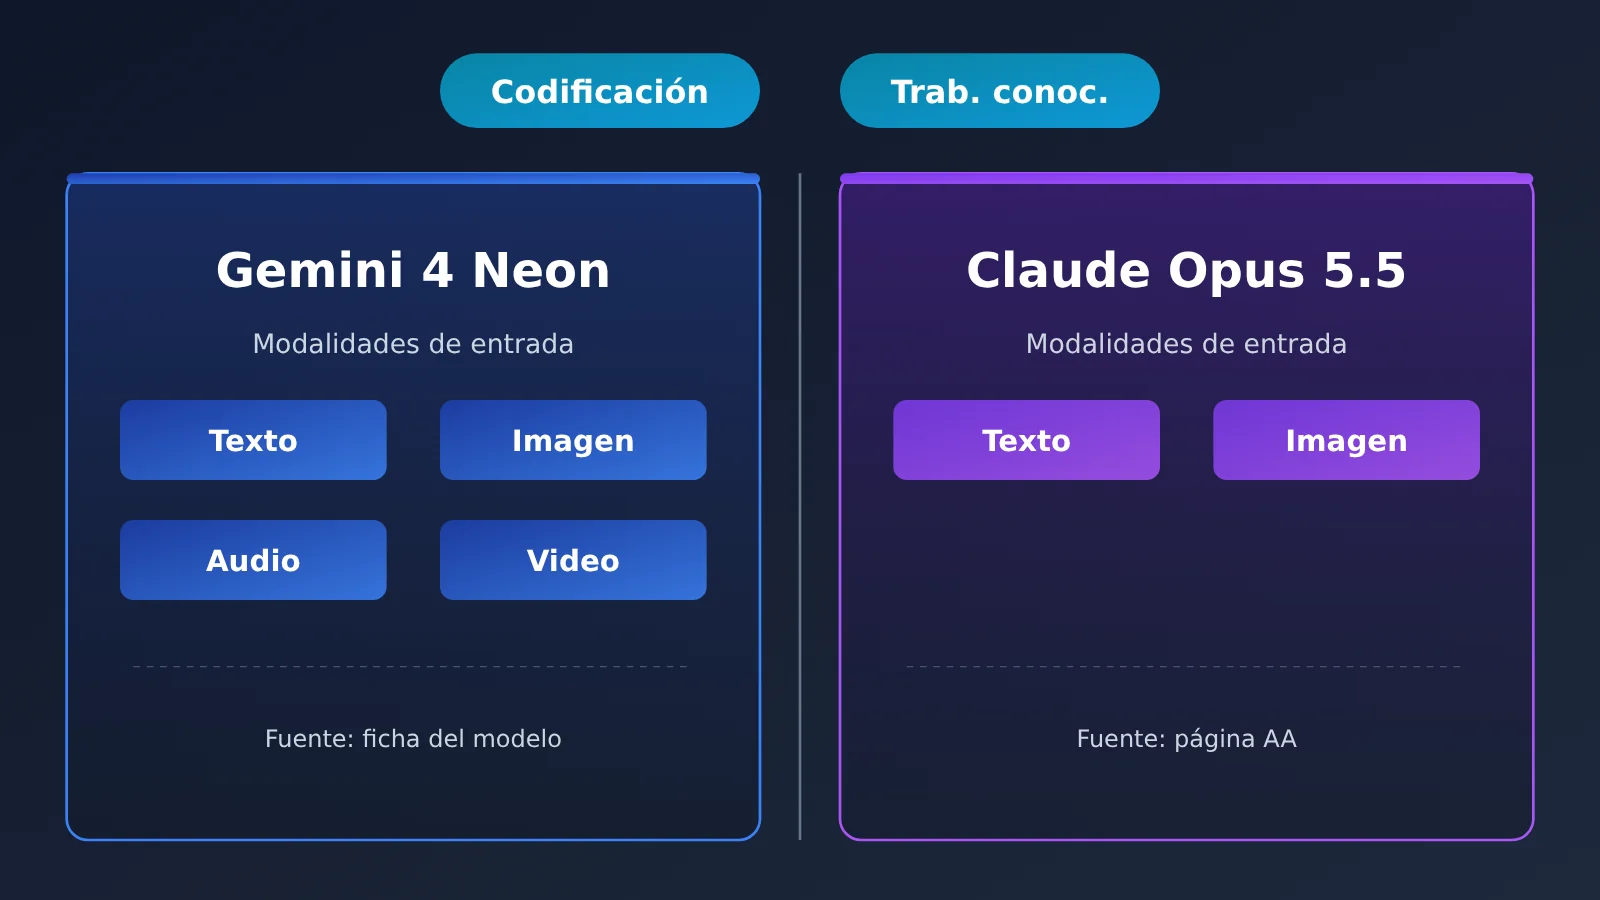
| Modalidades de entrada | Texto, imagen, audio, video | Texto, imagen | Ficha del modelo / página del modelo en Artificial Analysis |
| Puntuación de inteligencia (índice v5.0.1) | 61 (xhigh) | 59 (max) | Página del modelo en Artificial Analysis |
| Terminal-bench 4.1 (tras ajuste por trampas) | 65.2% | 65.8% | Ficha del modelo (los resultados que no son de Gemini son reportados por cada proveedor) |
| FrontierCode 2.0 | 46.2% (high predeterminado) | 47.3% | Ficha del modelo |
| Costo por tarea | 6.44 USD | 10.04 USD | Página del modelo en Artificial Analysis |
| Velocidad de salida | 110 tokens/segundo | 118 tokens/segundo | Página del modelo en Artificial Analysis |
| Precio de lista (entrada / salida, por millón de tokens) | 3 / 15 USD | 4 / 20 USD | Página de precios de Google AI Studio / página del modelo en Artificial Analysis |
Distribución de cifras entre Gemini 4 Neon y Claude Opus 5.5
En esta tabla, ambas partes tienen filas en las que van por delante. En la mayoría de los desgloses de la ficha del modelo y en la puntuación de inteligencia de Artificial Analysis (61 frente a 59), Gemini 4 Neon es superior. En Terminal-bench 4.1 (65.8% frente a 65.2%), FrontierCode 2.0 (47.3% frente a 46.2%) y la velocidad de salida (118 frente a 110 tokens/segundo), Claude Opus 5.5 es superior.
Las modalidades de entrada merecen una explicación aparte. Según la ficha del modelo, Gemini 4 Neon puede recibir texto, imágenes, audio y video. Según la página del modelo en Artificial Analysis, las entradas de Claude Opus 5.5 son texto e imagen. Si tu tarea implica procesar audio o video directamente, este punto determinará la elección. Si la tarea solo involucra texto y capturas de pantalla, este punto no marca ninguna diferencia.
Gemini 4 Neon frente a Claude Opus 5.5: cómo leer la tabla de tres columnas de la ficha del modelo
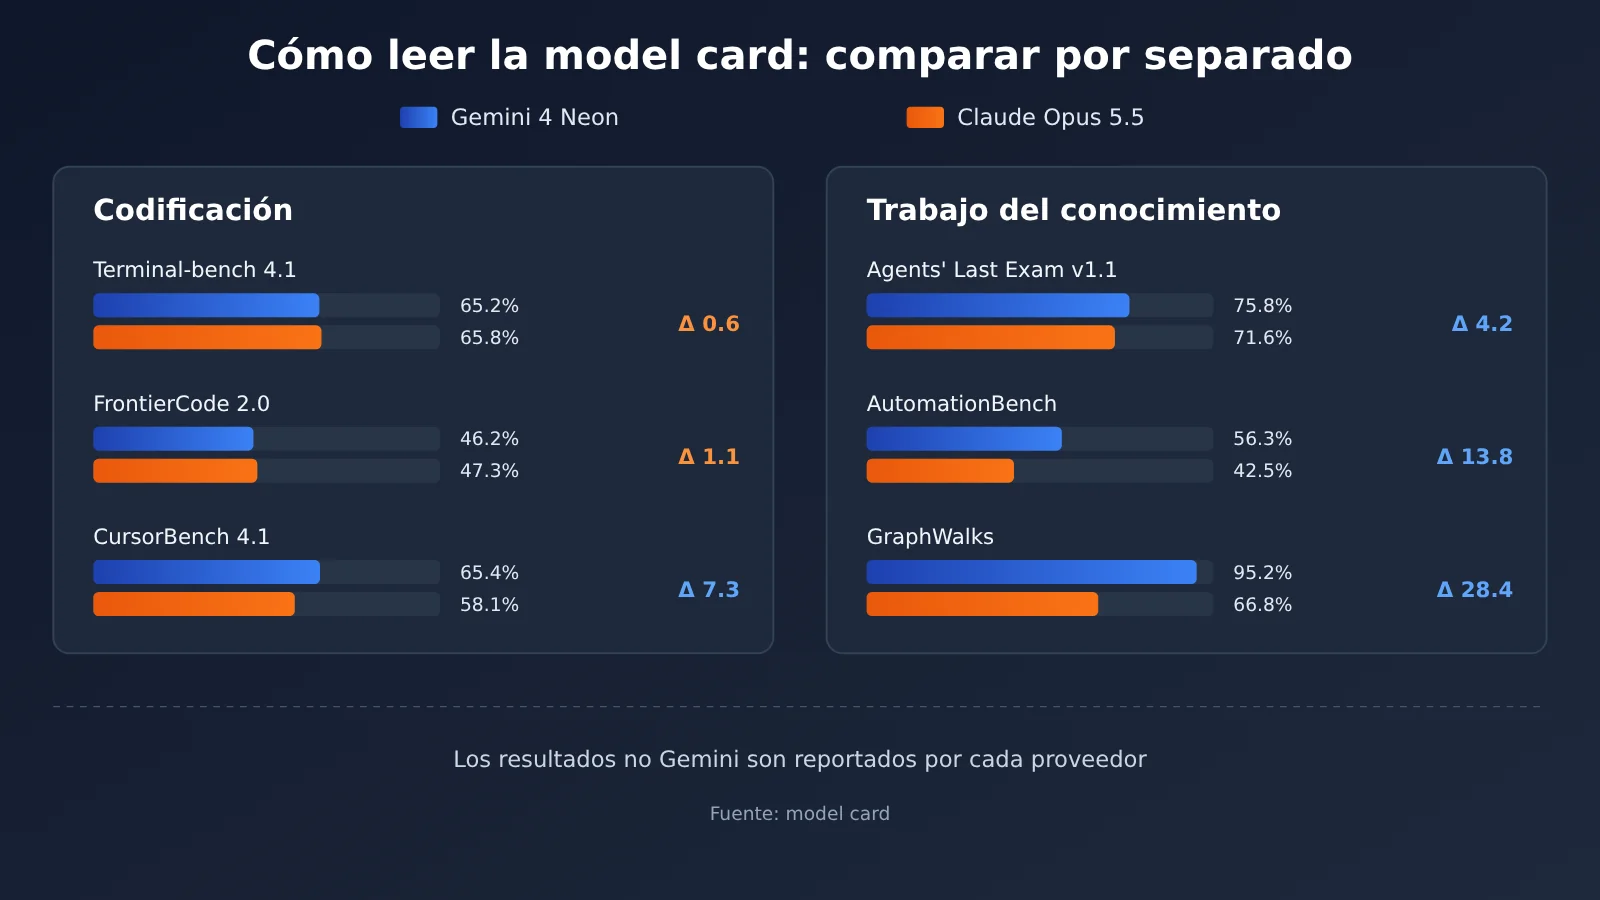
La tabla comparativa de la ficha del modelo de DeepMind tiene solo tres columnas: Gemini 4 Neon, Claude Opus 5.5 y GPT-6.2 Sol. Aquí vamos a leer únicamente las dos primeras. El PDF de notas de evaluación indica claramente que los resultados que no son de Gemini provienen, por defecto, de lo que cada empresa reporta por su cuenta. Por eso esta tabla es un resumen oficial: cada columna no fue medida de nuevo por el mismo laboratorio ni el mismo día, así que conviene leer cada celda como una declaración pública.
Subcategorías de programación en Gemini 4 Neon y Claude Opus 5.5
Estas son las filas de la ficha relacionadas con programación y programación segura.
| Subcategoría (ficha del modelo) | Gemini 4 Neon | Claude Opus 5.5 | Quién va por delante |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | Neon |
| Terminal-bench 4.1 (precisión ajustada por trampas) | 65.2% | 65.8% | Opus |
| FrontierCode 2.0 | 46.2% (high por defecto) | 47.3% | Opus |
| SWE-sweep con harness del fabricante | 39.0% | 10.1% | Neon |
| SWE-sweep con harness mini-SWE | 12.8% | 3.6% | Neon |
| CWE-Bench v2 | 70.7% | 67.1% | Neon |
| WebExploitBench v1.2 | 51.3% | 37.1% | Neon |
A la hora de leer esta tabla hay tres cosas que conviene tener en cuenta.
- Las dos subcategorías en las que Opus gana pertenecen a la línea principal de programación. Terminal-bench 4.1 y FrontierCode 2.0 miden operaciones de terminal y tareas de código, y las diferencias son de 0.6 y 1.1 puntos porcentuales respectivamente. El resultado de Neon en FrontierCode está anotado como nivel high por defecto.
- Las dos filas de SWE-sweep usan harness distintos. Neon obtiene 39.0% en Google Antigravity y 12.8% en el harness mini-SWE. El blog de Google atribuye esta diferencia al desbloqueo del harness, así que no conviene interpretarla como si los modelos en sí difirieran en un factor de tres. Al comparar los dos modelos hay que hacerlo bajo el mismo harness, es decir, 39.0% frente a 10.1%, o 12.8% frente a 3.6%.
- Un mismo número aparece escrito de forma distinta según la fuente. WebExploitBench es 51.3% en la ficha del modelo y 51.26% en el blog de Google. Ambas grafías se conservan tal cual, sin elegir una.
Gemini 4 Neon y Claude Opus 5.5: métricas de conocimiento y ciencia
Hay más métricas de trabajo de conocimiento, razonamiento científico y contexto largo; en esta parte, Neon es superior en la mayoría.
| Métrica (ficha del modelo) | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| AA Index v5.0.1 | 61 | 59 |
| Vals Index v2.2 | 70.9% | 70.1% |
| AutomationBench | 56.3% | 42.5% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% |
| RiemannBench | 84.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% |
| HLE-Diamond | 71.3% | 67.9% |
| MKA Climb WSR | 56.5% | 53.0% |
| Chartography | 73.5% | 66.3% |
| LVBench | 89.0% | 83.7% |
| GraphWalks (256k a 1M, F1 de BFS) | 95.2% | 66.8% |
Las diferencias entre filas varían. En Vals Index solo hay 0.8 puntos porcentuales de diferencia, mientras que en GraphWalks son 28.4 puntos; este último mide el recorrido de grafos en contextos ultralargos de 256k a 1M tokens. Si tu trabajo de conocimiento consiste en recuperar información y razonar sobre documentos extensos, conviene fijarse sobre todo en la fila de GraphWalks. Si se trata de automatización de negocio, el 56.3% frente al 42.5% de AutomationBench se acerca más a tu caso de uso.
El blog de Google también enumera algunos rankings como resultados autodeclarados oficialmente, por ejemplo, el primer puesto en Legal Research Bench y Tax Agent Bench, y la mayoría de primeros puestos en Surge en finanzas, contabilidad y modelado de hojas de cálculo. El blog no proporciona los porcentajes de estas pruebas ni los números correspondientes de Opus, así que esos rankings no pueden entrar directamente en la tabla comparativa de los dos modelos.
Gemini 4 Neon frente a Claude Opus 5.5: cómo interpretar los cuatro números de Artificial Analysis
Artificial Analysis hace mediciones de terceros y se mueve en un sistema distinto al de las fichas de modelo. Su página de modelo muestra, para cada nivel de pensamiento, la puntuación de inteligencia, el costo por tarea, el tiempo y la velocidad de salida. La comparación principal de esta sección es Neon xhigh frente a Opus max: son los niveles más altos que cada proveedor muestra en su página de modelo, pero no son equivalentes.
| Métrica (página del modelo de Artificial Analysis, v5.0.1) | Gemini 4 Neon (xhigh) | Claude Opus 5.5 (max) |
|---|---|---|
| Puntuación de inteligencia | 61 | 59 |
| Costo por tarea | 6.44 USD | 10.04 USD |
| Tiempo por tarea | 21.5 minutos | 24.5 minutos |
| Velocidad de salida | 110 tokens/s | 118 tokens/s |
| Primer token de respuesta | 56.51 segundos | 335.85 segundos |
| Tokens de salida de la ejecución del índice | 283 millones | 218 millones |
| Precio de lista (entrada / salida) | 3.00 / 15.00 USD | 4.00 / 20.00 USD |
| Precio combinado | 2.21 USD | 2.94 USD |
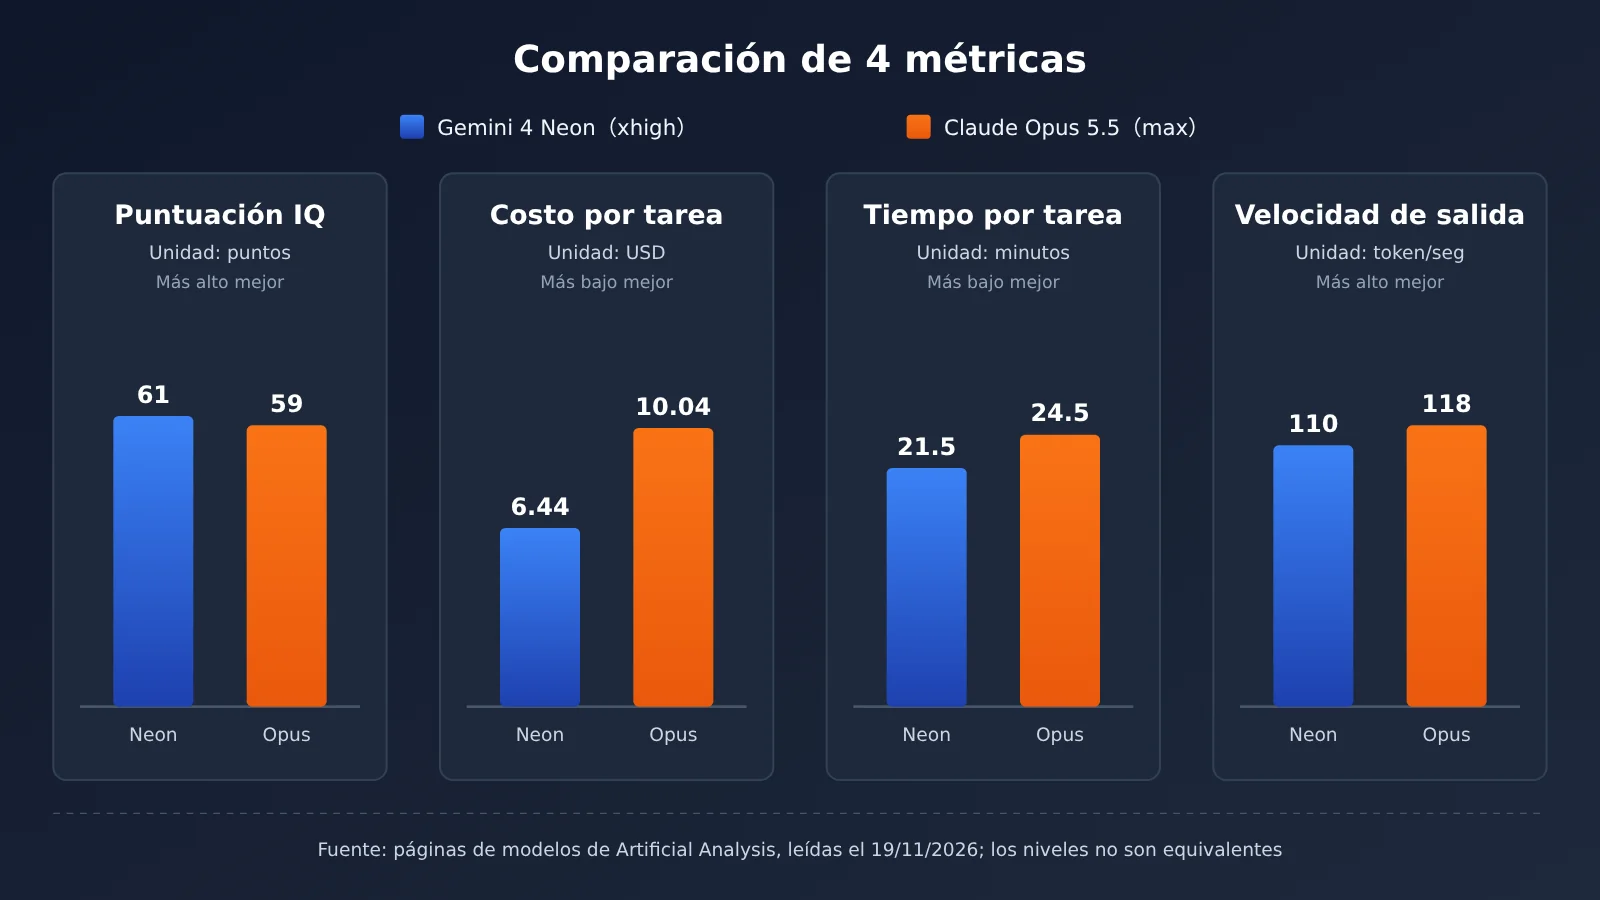
📊 Nota del gráfico: las cifras de la imagen superior provienen de la página del modelo de Artificial Analysis y reflejan las cuentas del índice ejecutado por un tercero. Al invocar Claude Opus 5.5 en APIYI apiyi.com, toma como referencia la lista de modelos y los precios de lista de la plataforma.
Costo por tarea: una cuenta anotada en el ranking
El costo por tarea, 6.44 USD frente a 10.04 USD, es la cifra que resulta de la conversión una vez que Artificial Analysis termina de ejecutar su índice; es una cuenta del ranking y no equivale a tu factura en APIYI. Este número depende tanto del precio unitario como del volumen de uso. Según los datos de la página del modelo, al ejecutar el índice Neon generó 283 millones de tokens, más que los 218 millones de Opus, pero su precio unitario es de 3/15 USD, mientras que el de Opus es de 4/20 USD. Tu costo real depende de la longitud de entrada de tus tareas, la longitud de salida y la tasa de aciertos de caché.
Duración, velocidad de salida y tiempo hasta el primer token
La velocidad de salida es mayor en Opus: 118 frente a 110 tokens/segundo. Sin embargo, la duración por tarea es menor en Neon: 21.5 frente a 24.5 minutos. Ambas cifras no se contradicen, porque la duración también incluye la espera del primer token y el volumen total de salida. Según la página del modelo, el primer token de respuesta de Opus max es de 335.85 segundos, y el de Neon xhigh es de 56.51 segundos. En escenarios interactivos, el tiempo hasta el primer token influye más en la percepción que el throughput.
Comparación en la misma gama y puntuaciones de codificación
Si bajamos de nivel, las cifras de la página del modelo también cambian. Neon high: 60 puntos, 14.8 minutos y 101 tokens/segundo; Opus xhigh: 57 puntos, 16.1 minutos y 107 tokens/segundo; Opus high: 52 puntos, 9.3 minutos y 108 tokens/segundo. Los tiempos hasta el primer token de Neon en los tres niveles high, medium y low son 40.64 segundos, 20.14 segundos y 13.93 segundos, respectivamente. Estas cifras provienen de las FAQ de la página del modelo y no están en la misma columna que la tabla resumen anterior.
En codificación, el artículo de Artificial Analysis presenta el Coding Agent Index: Neon xhigh obtiene 59 en Antigravity CLI y Opus 5.5 max obtiene 58 en Claude Code; ambos se ejecutan en CLI distintas. El blog de Google indica 58.6, una cifra reportada oficialmente, que es un número distinto del 59 del artículo. El mismo artículo también ofrece el costo por tarea de codificación: 6.86 USD para Neon y 12.61 USD para Opus 5.5 max.
Escenarios recomendados para Gemini 4 Neon y Claude Opus 5.5
Lo siguiente son juicios basados en las cifras anteriores; son recomendaciones, no hechos. Contrasta con tus propias muestras de tareas.
Escenarios en los que Gemini 4 Neon tiene ventaja
- Audio y video como entrada directa: según la ficha del modelo, Neon admite audio y video, mientras que la entrada de Opus es texto e imágenes.
- Recuperación y razonamiento con contexto ultralargo: GraphWalks, 95.2% frente a 66.8%; la ventana unificada de Neon llega hasta 1048576 tokens (Guía para desarrolladores de Google Cloud).
- Automatización de negocio y agentes de trabajo del conocimiento: AutomationBench, 56.3% frente a 42.5%; Agents’ Last Exam v1.1, 75.8% frente a 71.6% (ficha del modelo).
- Interacciones sensibles a la espera del primer token: según la página del modelo de Artificial Analysis, Neon xhigh tarda 56.51 segundos hasta el primer token, mientras que Opus max tarda 335.85 segundos.
Escenarios en los que conviene seguir usando Claude Opus 5.5
- Codificación orientada a operaciones de terminal: Terminal-bench 4.1, 65.8% frente a 65.2% (ficha del modelo).
- Tareas de código tipo FrontierCode: 47.3% frente a 46.2% (ficha del modelo; Neon usa high por defecto).
- Rendimiento en salidas largas: velocidad de salida de 118 frente a 110 tokens/segundo (página del modelo de Artificial Analysis).
- Flujos de trabajo ya muy integrados con Claude Code o el endpoint messages: el propio costo de migración también debe tenerse en cuenta.
Cómo invocar Claude Opus 5.5 en APIYI y verificar el estado de Gemini 4 Neon
Modelos y precios de Claude Opus 5.5 en APIYI
Quienes ya usan Opus pueden verificar el modelo y el precio con la misma clave en APIYI (apiyi.com). La tabla general de APIYI docs.apiyi.com/models.md indica una fecha de actualización del 2026-11-16 09:39 (UTC+8). El endpoint de precios api.apiyi.com/api/pricing se consultó el 2026-11-19, con versión shell-api-modelmak-v1 y 285 modelos en total.
| ID de modelo | Entrada / lectura de caché / salida (USD por millón de tokens) | Endpoint | Grupo (tabla general de APIYI) | ID de grupo (endpoint de precios) |
|---|---|---|---|---|
claude-opus-5-5 |
4 / 0.2 / 20 | chat, messages | ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
claude-opus-5-5-thinking |
4 / 0.2 / 20 | chat, messages | Igual que arriba | Igual que arriba |
gemini-4-neon |
No disponible | — | — | — |
Los nombres de los dos conjuntos de grupos no coinciden del todo, así que en la tabla se conservaron ambos. En el endpoint de precios, cuando model_ratio es 1, corresponde a 2 USD de entrada por millón de tokens; cuando completion_ratio es 5, significa que el precio unitario de salida es 5 veces el de entrada. Esto coincide con la primera franja de la tabla general, y puedes usar esta regla para verificar por tu cuenta los precios de la tabla anterior.
Ni la tabla general de APIYI ni el endpoint de precios incluyen gemini-4-neon, y tampoco hay una página de modelo independiente para él. Aún no está disponible; publicaremos este modelo lo antes posible. El modelo y el precio se rigen por la lista de modelos de la plataforma. Como referencia, la página de precios de Google AI Studio indica que el precio de pago de Neon es 3.00 USD de entrada, 15.00 USD de salida (incluidos los tokens de razonamiento) y 0.15 USD de caché, por millón de tokens; no tiene nível gratuito y solo admite caché implícita.
Pasos para la invocación
- Coloca la clave en una variable de entorno, por ejemplo
APIYI_API_KEY; en el código, lee solo la variable de entorno y no escribas la clave en texto plano. - Si usas un cliente compatible con OpenAI, establece base_url en
https://api.apiyi.com/v1. - En el campo
model, escribeclaude-opus-5-5oclaude-opus-5-5-thinking; elige el endpoint chat o messages según lo que necesites. - Elige el grupo según las necesidades de tu negocio. Los nombres de los grupos se rigen por lo indicado en la tabla general y en el endpoint de precios.
- Cuando Neon esté disponible y hagas pruebas comparativas, ten en cuenta lo siguiente: la guía para desarrolladores de Google Cloud especifica que sus niveles de razonamiento son solo low, medium, high y xhigh, y que el predeterminado es high. Si pasas
thinking_budgetoMINIMAL, devolverá HTTP400. No admite caché de contexto explícita; la caché implícita se activa automáticamente para prefijos compartidos de más de 4096 tokens.
🚀 Empieza rápido: primero ejecuta una docena o así de tus tareas reales en Opus para establecer una línea base, y registra los tokens de salida y el tiempo de ejecución. Cuando Neon esté disponible en APIYI apiyi.com, compara con el mismo lote de muestras y el mismo nivel de razonamiento; así obtendrás números reales para tu propio negocio.
Recomendaciones de decisión entre Gemini 4 Neon y Claude Opus 5.5
💡 Recomendación de elección: Si tu trabajo se centra sobre todo en tareas de terminal y código, las diferencias que muestran la model card y Artificial Analysis son mínimas; Opus es ligeramente superior en Terminal-bench 4.1 y FrontierCode 2.0, y no hay un motivo claro para cambiar. Si tu trabajo se inclina más hacia la organización de conocimiento, las ventanas de contexto largas y las entradas multimodales, la mayoría de los apartados de la model card favorecen a Neon, así que vale la pena hacer una prueba comparativa en cuanto esté disponible. Lo anterior es una opinión, no un hecho.
En cuanto a los costos, no tomes directamente los 6,44 y 10,04 dólares de Artificial Analysis como base para tu presupuesto. Tampoco apliques a Opus esa frase del blog de Google —«el costo por tarea en modo high predeterminado es un 32 % menor que Carbon»—, porque ese es el algoritmo propio de Google y el objeto de comparación tampoco es Opus.
Preguntas frecuentes (FAQ)
P1: ¿Cuál es el posicionamiento de Gemini 4 Neon?
Según el blog de Google (datos autoinformados) y la guía para desarrolladores de Google Cloud, Neon se sitúa entre Hydrogen (ejecución rápida del día a día) y Carbon (tareas complejas de largo alcance), y está pensado para flujos complejos de alta frecuencia. La ficha del modelo especifica que deriva de Gemini 4 Carbon, con conocimiento hasta marzo de 2026.
P2: En codificación, ¿quién tiene números más altos, Gemini 4 Neon o Claude Opus 5.5?
Hay que verlo prueba por prueba. En la ficha del modelo, Opus es superior en Terminal-bench 4.1 (65.8% frente a 65.2%) y FrontierCode 2.0 (47.3% frente a 46.2%), mientras que Neon gana en CursorBench 4.1 y SWE-sweep. El Coding Agent Index del artículo de Artificial Analysis es 59 frente a 58, pero ambos modelos se ejecutan en CLI diferentes.
P3: ¿La puntuación de inteligencia 61 frente a 59 se obtuvo en la misma configuración?
No. Se trata de Neon xhigh frente a Opus max, tomando en cada caso el nivel más alto de la página del modelo. Si comparas Neon high (60) con Opus xhigh (57), la diferencia cambia. La puntuación de inteligencia 61 coincide en el blog de Google, la ficha del modelo y Artificial Analysis.
P4: ¿Puedo tomar el costo por tarea de 6.44 USD frente a 10.04 USD como si fuera mi factura?
No. Esa es la contabilidad del ranking cuando Artificial Analysis ejecuta el índice, y depende de su conjunto de tareas y de la cantidad de tokens de salida. Tu factura real se calcula con tus propios consumos de entrada, salida y caché, junto con el precio de lista de la plataforma. En APIYI (apiyi.com), el precio de lista de Opus es 4 USD de entrada, 0.2 USD de lectura de caché y 20 USD de salida (por millón de tokens).
P5: ¿Ya se puede invocar Gemini 4 Neon en APIYI?
Ni la tabla general de APIYI (actualizada el 2026-11-16) ni el endpoint de precios (consultado el 2026-11-19) incluyen `gemini-4-neon`. Aún no está disponible; incorporaremos este modelo lo antes posible. El nombre del modelo y el precio se rigen por la lista de modelos de la plataforma. Por ahora puedes ejecutar muestras de línea base con `claude-opus-5-5` en apiyi.com para preparar la comparación posterior.
P6: ¿Por qué Opus genera más rápido pero tarda más por tarea?
El tiempo total incluye la espera hasta el primer token. Según la página del modelo de Artificial Analysis, el primer token de respuesta de Opus max tarda 335.85 segundos, mientras que Neon xhigh tarda 56.51 segundos. La velocidad de salida solo refleja el rendimiento una vez que ya empezó la generación.
P7: ¿Qué limitaciones tienen estas comparaciones?
En la ficha del modelo, los resultados que no son de Gemini provienen por defecto de datos autoinformados por cada fabricante. El Coding Agent Index aparece en dos versiones, 58.6 y 59, y MKA en 56.5% y 56%; aquí mantenemos ambas tal cual. Los valores 12.8% y 39.0% de SWE-sweep provienen de dos harness distintos. Los rankings y las cifras de seguridad del blog de Google son datos autoinformados oficiales, no resultados de pruebas independientes de terceros.
Gemini 4 Neon y Claude Opus 5.5: puntos clave
- Cada modelo gana en algunas cifras: Neon es superior en la mayoría de las subcategorías de la ficha del modelo y en el puntaje de inteligencia; Opus es superior en dos puntajes de codificación y en velocidad de salida.
- La ficha del modelo es un resumen oficial: los resultados de modelos que no son Gemini son autodeclarados por cada proveedor, no una nueva prueba realizada el mismo día.
- La configuración debe quedar clara: la comparación del puntaje de inteligencia es Neon xhigh frente a Opus max.
- El costo por tarea es la cifra que aparece en la tabla: 6.44 frente a 10.04 USD no equivale a la factura de la plataforma.
- Hay diferencias de modalidad: Neon puede recibir audio y video; Opus, texto e imágenes.
- Cómo empezar: Opus ya está disponible en APIYI; Neon aún no, así que consulta la lista de modelos de la plataforma para confirmarlo.
Resumen
La comparación entre Gemini 4 Neon y Claude Opus 5.5 debe analizarse por separado según se trate de codificación o de trabajo del conocimiento:
- Línea de codificación: Opus es ligeramente superior en Terminal-bench 4.1 y FrontierCode 2.0; Neon es superior en CursorBench 4.1 y en SWE-sweep con el mismo harness.
- Línea de trabajo del conocimiento: en la mayoría de las subcategorías de la ficha del modelo, Neon obtiene mejores resultados; las diferencias más marcadas están en GraphWalks y AutomationBench.
- Los cuatro datos de Artificial Analysis: puntaje de inteligencia 61 frente a 59; costo por tarea 6.44 frente a 10.04 USD; tiempo 21.5 frente a 24.5 minutos; velocidad de salida 110 frente a 118 token/s. La configuración es Neon xhigh frente a Opus max.
Se recomienda establecer primero una línea base de Opus con tus propias muestras de tareas y, cuando Neon esté disponible, compararlo con la misma configuración. Puedes consultar en APIYI apiyi.com los precios y grupos de claude-opus-5-5 y claude-opus-5-5-thinking, y usar la misma clave para realizar la invocación y el cambio posterior.
📚 Referencias
-
Publicación de Sundar Pichai: canales de lanzamiento de Gemini 4 Neon
- Enlace:
x.com/sundarpichai/status/2123167780988125621 - Nota: alcance de lanzamiento según lo declarado por la propia compañía
- Enlace:
-
Blog de Google «Introducing Gemini 4 Neon»: cifras oficiales de benchmark, precios y seguridad
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Nota: Coding Agent Index 58.6, explicación del harness de SWE-sweep
- Enlace:
-
Model card de DeepMind: tabla comparativa de tres columnas y notas de evaluación
- Enlace:
deepmind.google/models/model-cards/gemini-4-neon/ - Nota: los resultados de modelos que no son Gemini provienen, por defecto, de lo reportado por cada proveedor
- Enlace:
-
Guía para desarrolladores de Google Cloud: ID del modelo, niveles de razonamiento (thinking levels) y reglas de caché
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Nota: condiciones que disparan un HTTP 400
- Enlace:
-
Página de precios de Google AI Studio: precio de pago de Neon
- Enlace:
aistudio.google.com/docs/pricing - Nota: no hay nivel gratuito, solo admite caché implícita
- Enlace:
-
Artículo de Artificial Analysis: puntuación de inteligencia de Neon y coste por tarea de codificación
- Enlace:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Nota: medición de terceros, Coding Agent Index 59
- Enlace:
-
Página del modelo en Artificial Analysis: datos por tramos de Neon y Opus 5.5
- Enlace:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/claude-opus-5-5 - Nota: consultado el 2026-11-19, índice v5.0.1
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: puedes escribirnos desde la página principal del sitio de APIYI; los modelos y precios están disponibles en el centro de documentación docs.apiyi.com