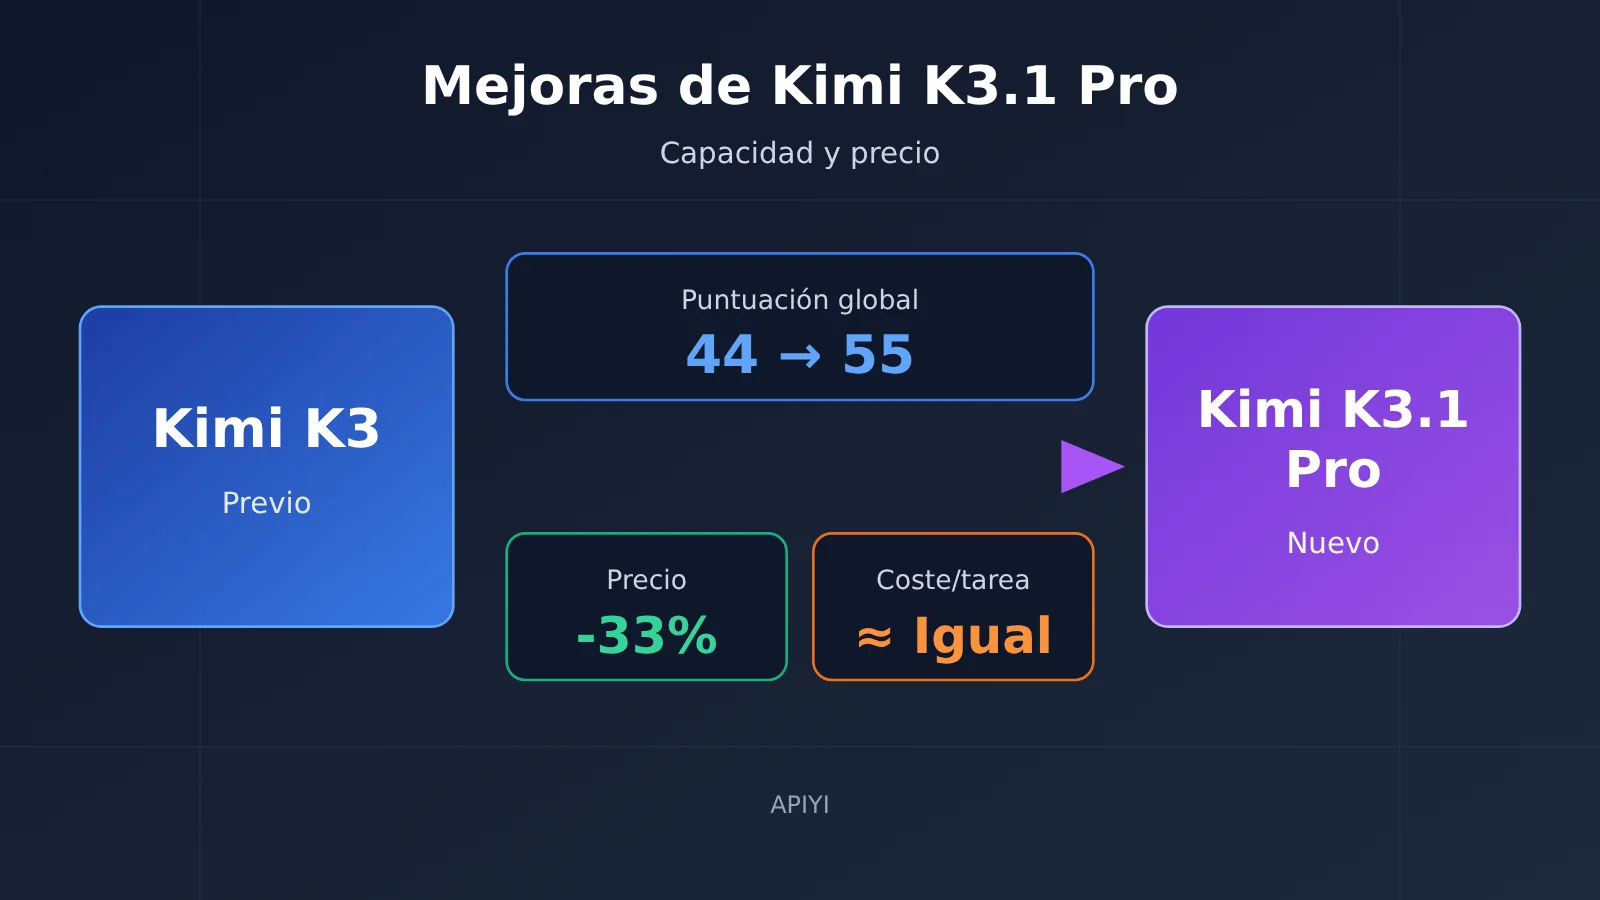
En capacidades, Kimi K3.1 Pro mejora claramente respecto a K3: la puntuación general de Artificial Analysis, un evaluador externo, sube de 44 a 55, y su resultado en Terminal-Bench 4.0, un benchmark de terminales para agentes de programación, pasa del 13 % al 67 %. Sin embargo, el precio baja un 33 %: las tarifas de entrada, salida y caché son todas un 33 % inferiores a las de K3. Aun así, sus respuestas son más largas y el modelo siempre razona, por lo que el coste real de ejecutar una tarea acaba siendo similar al de K3.
A continuación se presentan los datos y se indica la fuente de cada uno con una de estas tres categorías: «declarado por la empresa», «terceros» o «sin verificar». Este artículo no es un resumen de la presentación ni pretende convencer a todo el mundo de que cambie de modelo cuanto antes. Su objetivo es ayudar a los desarrolladores que ya usan K3 a decidir si deberían migrar sus aplicaciones, cuándo hacerlo y qué deben tener en cuenta durante la migración.
1. Cinco diferencias clave entre Kimi K3.1 Pro y su predecesor
K3.1 Pro no es un modelo nuevo entrenado desde cero, sino una versión de K3 sometida a un «posentrenamiento» a gran escala. El posentrenamiento consiste en ajustar el comportamiento del modelo una vez terminado el entrenamiento inicial, usando más datos y comentarios. La empresa lo describe como «el primer modelo de la serie K3.1» y «el modelo de pesos abiertos más potente de la categoría 3T». Que tenga pesos abiertos significa que los archivos con los parámetros del modelo se harán públicos y se podrán descargar para desplegarlo por cuenta propia. Artificial Analysis registra 2,8 T de parámetros en total, de los cuales 104 B se activan y participan en los cálculos en cada momento.
| Dimensión | Kimi K3 | Kimi K3.1 Pro | Fuente |
|---|---|---|---|
| Método de entrenamiento | Versión base | Posentrenamiento sobre K3, con un aumento considerable de la capacidad de cálculo dedicada al posentrenamiento | Declarado por la empresa |
| Capacidad general | Intelligence Index: 44 | 55, cuarto puesto en la clasificación general | Terceros (AA, 2026-10-23) |
| Precio unitario | Entrada: $3 / salida: $15 | Entrada: $2 / salida: $10; reducción del 33 % | Precio oficial |
| Tokens de salida por tarea | 48K tokens de media | 55K tokens de media, un 14 % más | Terceros (AA) |
| Contexto / modalidades | 1M / texto e imagen | 1M / texto e imagen, sin cambios | Declarado por la empresa |
Los tokens son la unidad básica que se usa para medir y facturar el uso del modelo. A grandes rasgos, se pueden entender como «fragmentos de palabras»: un carácter chino suele equivaler a uno o dos tokens. Al leer la tabla, conviene fijarse primero en dos cambios: la puntuación de capacidad ha subido y el precio unitario ha bajado. La tercera columna, «Tokens de salida por tarea», determina cuánto se ahorra realmente tras la bajada de precio. La sección 4 lo explica en detalle.
En cuanto a los pesos, la empresa se ha comprometido a publicar los pesos completos antes del 2026-11-04. A fecha de hoy (2026-10-24), sigue siendo un compromiso pendiente de cumplirse y, por tanto, está «sin verificar». Artificial Analysis considera que, una vez publicados, K3.1 Pro será el modelo de pesos abiertos con mejor puntuación de su clasificación. La diferencia entre el modelo de pesos abiertos mejor puntuado y el modelo cerrado mejor puntuado se reducirá de 12 puntos a 3.
2. Comparativa de benchmarks de Kimi K3.1 Pro: datos oficiales y de terceros
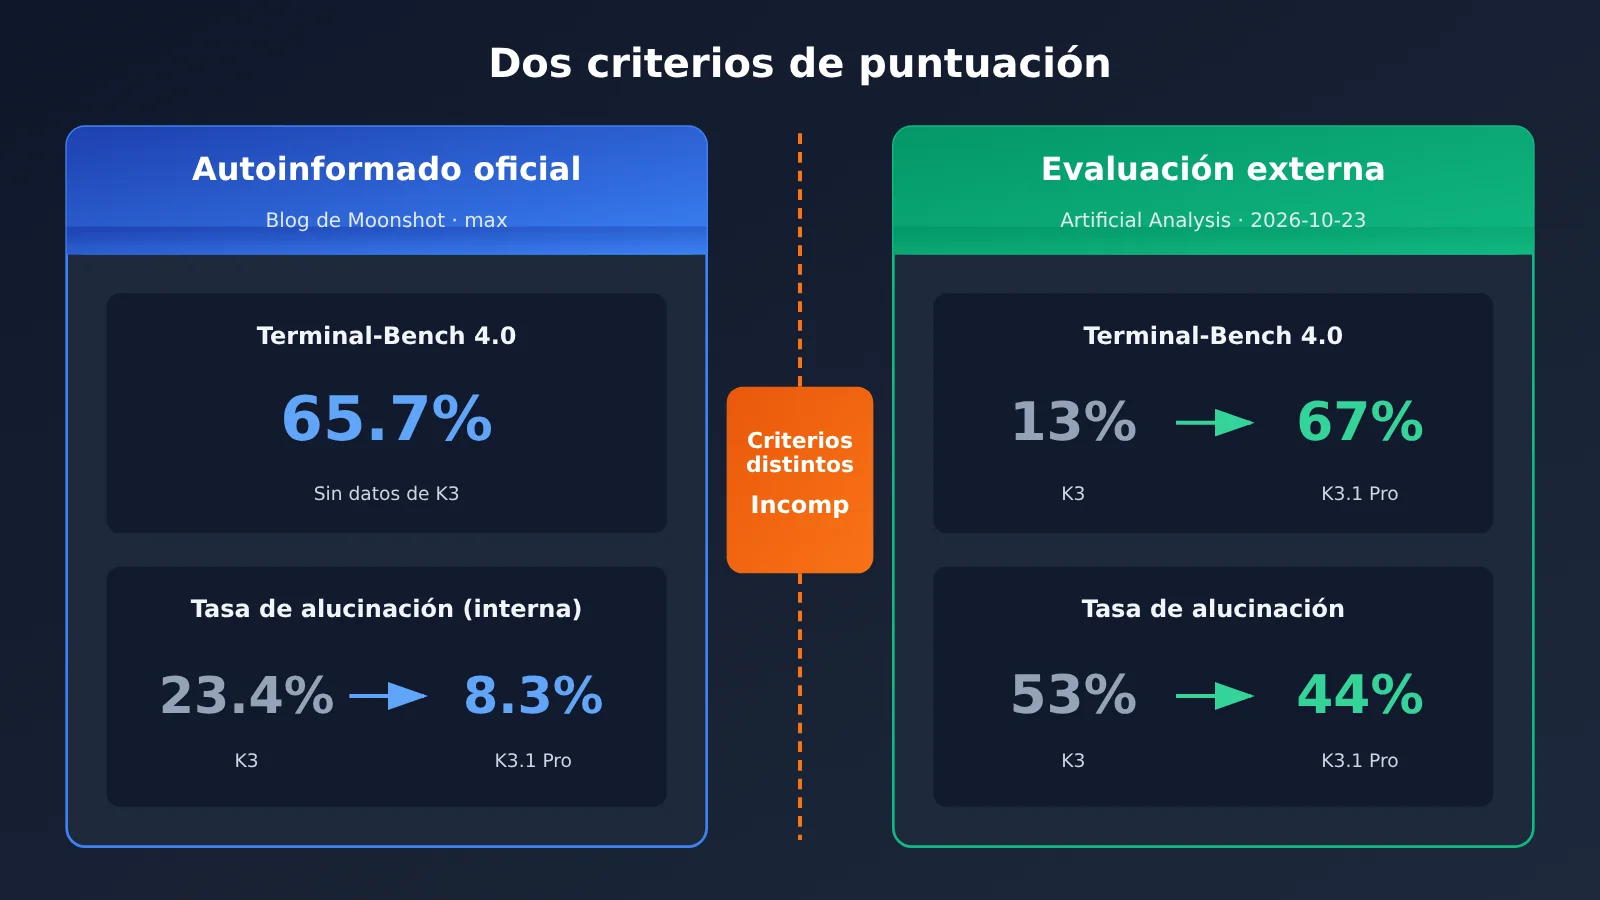
Primero, una aclaración: las dos tablas siguientes proceden de distintas organizaciones y entornos de prueba, así que no se pueden comparar entre sí. El ejemplo más claro es Terminal-Bench 4.0: la cifra oficial es del 65,7 %, mientras que Artificial Analysis obtuvo un 67 % en una prueba independiente. Son dos resultados de pruebas distintas, no dos estimaciones de un mismo resultado. Moonshot tampoco ha publicado una puntuación de K3 en Terminal-Bench 4.0: el 13 % de K3 procede únicamente de Artificial Analysis.
2.1 Resultados oficiales de Kimi K3.1 Pro
Fuente: blog oficial de Moonshot. Condiciones de prueba: salvo que se indique lo contrario, todas las pruebas usan reasoning_effort=max (nivel máximo de razonamiento), temperature=1.0 y top_p=0.95. Las pruebas marcadas como «internas» usan conjuntos de datos creados por Moonshot que no pueden reproducirse desde fuera.
| Prueba | K3.1 Pro | Comparación | Observaciones |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | GPT-6 Astra: 58,2 %; Claude Opus 5.5: 66,4 % | Opus 5.5 se ejecutó con el harness de Claude Code |
| Kimi Code Bench 3.0 Long-horizon | 61,2 % | K3: 55,95 % | Interna; tareas de programación con cadenas de ejecución largas |
| BenchCAD | 92,7 % (con herramientas) | Opus 5.5: 96,2 %; GPT-6 Astra: 95,9 % | Conversión de planos con varias vistas a código CAD |
| OfficeQA Pro v2 | 64,4 | Por encima de K3 | Análisis de documentos financieros reales; Moonshot afirma que es SOTA |
| Financial Modeling / Research | 7,2 / 11,6 puntos más que K3 | K3 | Interna |
| Business Operation | Aproximadamente 4,2 veces la puntuación de K3 | K3 | Simulación interna de gestión empresarial |
| Kimi Hallu Bench Hard | Tasa de alucinaciones a nivel de afirmación: 8,3 % | K3: 23,4 % | Prueba interna de estrés de factualidad |
| xdev-bench-hard (pass@3) | 81,0 % | Versión de comparación sin filtros de seguridad: 90,5 % | Detección de vulnerabilidades |
Algunos términos: un harness es el «marco de ejecución» que envuelve al modelo durante la prueba; se encarga de llamar a las herramientas y ejecutar comandos. Como la puntuación puede variar según el marco, conviene analizar por separado el resultado de Opus 5.5. pass@3 significa que se dan tres oportunidades para responder a una misma pregunta y basta con acertar una vez para aprobar. La última fila indica que, por seguridad, Moonshot redujo deliberadamente la capacidad del modelo para encontrar vulnerabilidades: la versión oficial obtuvo unos 9,5 puntos porcentuales menos que la versión interna sin restricciones.
2.2 Evaluaciones de terceros de Kimi K3.1 Pro (Artificial Analysis)
Fuente: Artificial Analysis. Datos del 2026-10-23. La organización ejecutó todas las pruebas con el mismo proceso; K3 y K3.1 Pro se evaluaron con la misma metodología.
| Métrica | K3.1 Pro | K3 | Cambio |
|---|---|---|---|
| Intelligence Index | 55 (puesto 4) | 44 | +11 |
| GDPval-AA (Elo en tareas de trabajo reales) | 1846 (puesto 3) | 1534 | +312 |
| Terminal-Bench 4.0 | 67% | 13% | +54 puntos porcentuales |
| AutomationBench-AA (flujos de trabajo SaaS) | 73% | 58% | +15 |
| Humanity’s Last Exam | 52% | 47% | +5 |
| CritPt / SciCode | 25% / 61% | 23% / 59% | +2 / +2 |
| AA-Omniscience Index | 30 | 20 | +10 |
| Tasa de alucinación / precisión | 44% / 51% | 53% / 48% | Alucinaciones: −9 |
| Promedio de tokens de salida por tarea | 55K | 48K | +14% |
En la clasificación de Artificial Analysis, K3.1 Pro ocupa el puesto 4, por detrás de Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) y Muse Wonder Full (56). Su puntuación del 67% en Terminal-Bench 4.0 es la más alta entre todos los modelos evaluados por la organización; Sonnet 5.5 obtuvo un 64%.
Las dos evaluaciones coinciden en la tendencia de las alucinaciones, pero sus cifras difieren mucho: la prueba de estrés interna oficial bajó del 23,4% al 8,3%, mientras que la de AA pasó del 53% al 44%. No se usó el mismo conjunto de preguntas y también varían la dificultad de las pruebas y los métodos estadísticos. Al citar estos datos, indica la fuente y no los combines en una frase como «la tasa de alucinación bajó al 8%».
3. 5 áreas en las que Kimi K3.1 Pro ha mejorado claramente
En esta sección solo se incluyen áreas en las que los datos de ambas fuentes apuntan a una mejora o en las que el avance es lo bastante significativo.
- Agentes de programación y tareas de terminal. Un agente es un asistente de IA capaz de dividir tareas por su cuenta, usar herramientas y ejecutar varios pasos. AA registró una subida en Terminal-Bench 4.0, del 13 % al 67 %, y en las pruebas internas oficiales de programación con cadenas largas, del 55,95 % al 61,2 %. Si al usar K3 como agente de código se te suele atascar la ejecución de comandos, la manipulación de archivos o la depuración en varios pasos, esta es la mejora más destacada.
- Tareas de trabajo reales. GDPval-AA mide con una puntuación Elo la capacidad del modelo para realizar tareas profesionales reales. Elo es un sistema de clasificación competitiva: se usa, por ejemplo, en el ajedrez. Cuanto mayor es la diferencia de puntuación, mayor es la diferencia en la probabilidad de ganar. K3.1 Pro supera a K3 por 312 puntos Elo y ocupa el tercer puesto, lo que indica una mejora notable en tareas cotidianas como redactar propuestas, crear hojas de cálculo y organizar materiales.
- Automatización de flujos de trabajo SaaS. AutomationBench-AA mide la capacidad del modelo para completar flujos automatizados en distintas aplicaciones en línea, por ejemplo, leer correos, modificar tickets y sincronizar hojas de cálculo. La puntuación subió del 58 % al 73 %. En la prueba interna oficial de simulación empresarial (Business Operation), el resultado fue aproximadamente 4,2 veces superior al de K3. Esto también apunta a una mejora en la ejecución de procesos largos, aunque se trata de datos internos y conviene tomarlos como referencia.
- Veracidad y alucinaciones. Una alucinación se produce cuando el modelo inventa hechos inexistentes con total seguridad. En las pruebas internas oficiales, la tasa de alucinaciones por afirmación —es decir, calculada para cada afirmación factual— bajó del 23,4 % al 8,3 %. La cantidad de respuestas con al menos un error factual se redujo al 42,4 % de la registrada con K3. En las pruebas de AA, la tasa de alucinaciones bajó del 53 % al 44 % y la precisión subió del 48 % al 51 %.
- Modelado financiero e informes de investigación. Según la información oficial, la puntuación de OfficeQA Pro v2 fue de 64,4, un resultado SOTA (el mejor hasta la fecha). En las pruebas internas, Financial Modeling y Financial Research superaron a K3 por 7,2 y 11,6 puntos, respectivamente. Estos resultados aún no se han verificado de forma independiente por terceros, por lo que se consideran «datos declarados por la empresa».
Los indicadores de razonamiento científico (Humanity’s Last Exam, CritPt y SciCode) también mejoraron, pero solo entre 2 y 5 puntos porcentuales. Si tu actividad se centra en preguntas académicas o código para investigación científica, la mejora de K3.1 Pro no es tan grande como en las tareas de tipo agente. No hace falta que quienes trabajan en esos ámbitos se apresuren a migrar solo por estos resultados.
4. Qué cambia poco en Kimi K3.1 Pro y cuánto cuesta en la práctica
4.1 Tres cosas que no han cambiado en Kimi K3.1 Pro
- El contexto sigue siendo de 1M: 1.048.576 tokens, igual que en K3. El contexto se puede entender como la cantidad total de contenido que el modelo puede «ver» de una sola vez.
- Las modalidades siguen siendo texto e imágenes: no se han añadido nuevas formas de entrada, como audio o vídeo.
- No hay cifras oficiales de velocidad: AA midió una velocidad de generación de 80,7 tokens por segundo, lo que la sitúa en el nivel 2 de los 4 niveles de velocidad de esa institución. La versión highspeed, según la compañía, es entre 2 y 3 veces más rápida, pero no se han publicado condiciones de prueba que permitan reproducir el resultado. Por ahora, esta afirmación queda como «no verificada».
4.2 Comparación de precios de las cinco modalidades de Kimi K3.1 Pro
Estos son los precios oficiales, consultados el 24 de octubre de 2026, en dólares por millón de tokens, sin impuestos.
| Modelo | Entrada | Salida | Acierto de caché | Escritura durante 5 minutos | Escritura durante 1 hora |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Un acierto de caché se produce cuando se vuelve a enviar el mismo contenido de prefijo —por ejemplo, una indicación fija del sistema o el mismo documento extenso— y, a partir de la segunda vez, se cobra a una tarifa reducida. La escritura durante 5 minutos y durante 1 hora corresponde al costo de guardar contenido en la caché; cuanto más tiempo se conserva, más cuesta. La caché puede ser muy útil para agentes o consultas sobre documentos extensos. Si la estructura de las indicaciones es estable, permite reducir bastante el costo de entrada en la factura.
4.3 El costo de Kimi K3.1 Pro: una rebaja no siempre significa ahorrar
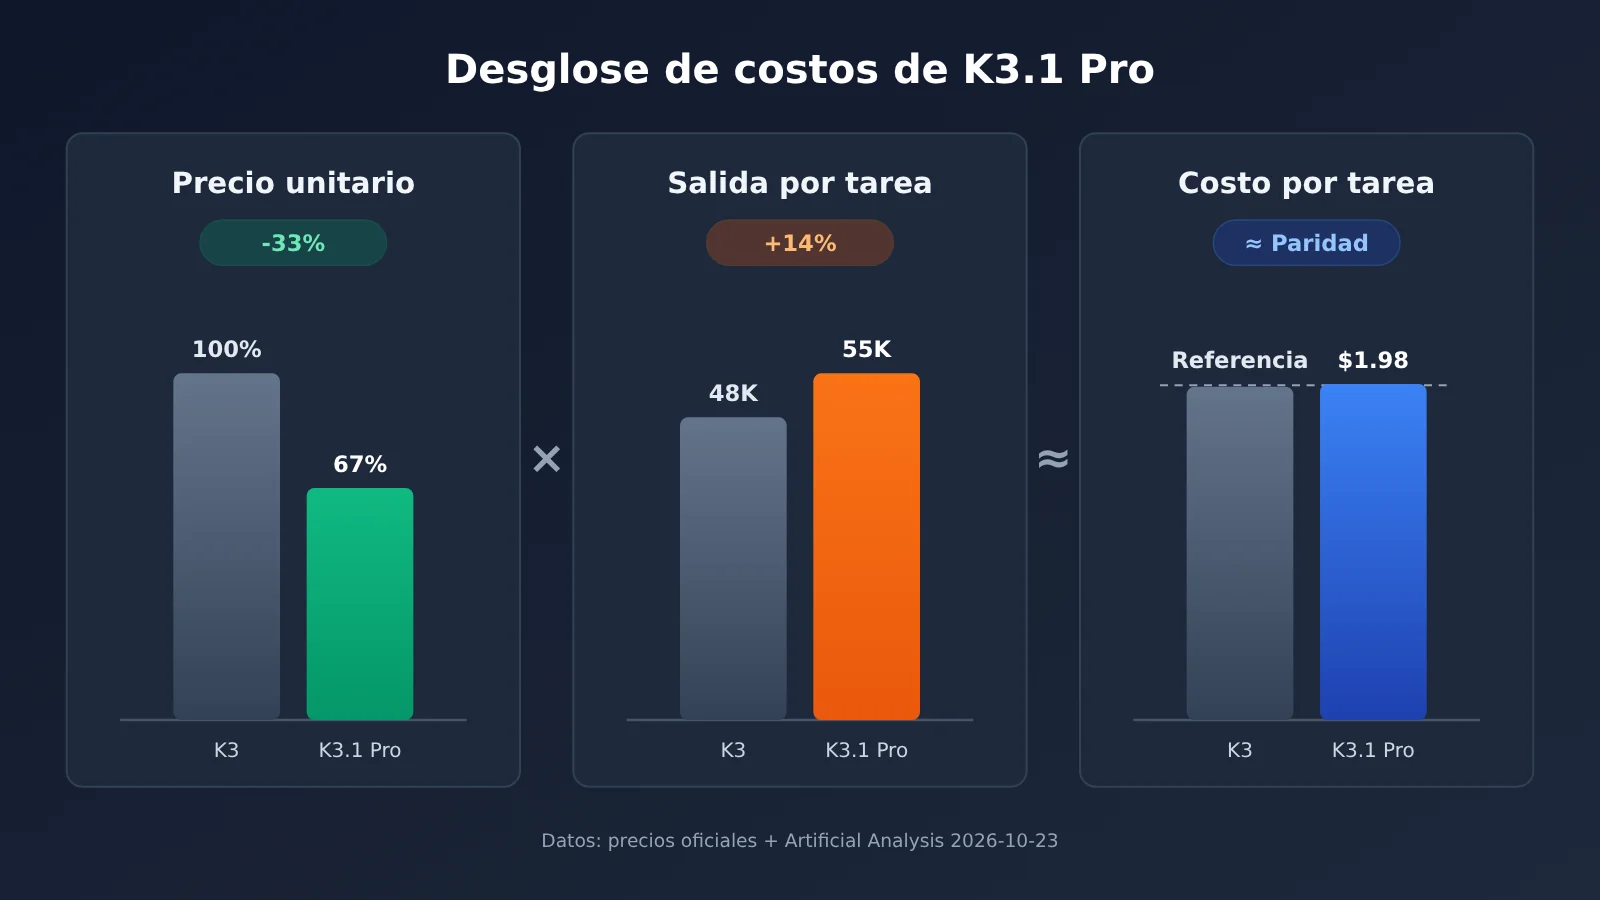
K3.1 Pro siempre razona: antes de cada respuesta, realiza una fase de razonamiento interno que se cobra como tokens de salida. AA midió una media de 55K tokens de salida por tarea, un 14 % más que los 48K de K3.
Según el precio por token, la rebaja del 33 % debería suponer un ahorro considerable. Sin embargo, AA midió un costo aproximado de $1.98 por tarea (la página de detalles del modelo indica $2.11), prácticamente igual que el de K3. La institución no publicó el desglose de costos, así que no hay una explicación oficial de por qué no se materializa el ahorro. Una posibilidad es que, en las llamadas de varias rondas de las tareas de agente, también aumenten los tokens de entrada. Es solo una hipótesis y, por tanto, está «sin verificar».
Además, la versión highspeed cuesta el doble que la estándar. Si el costo es una prioridad para tu equipo, antes de cambiar conviene probar una muestra de tareas reales y comparar el gasto total, en lugar de fijarse solo en el precio por token.
Si quieres comparar el gasto real de K3 y K3.1 Pro con el mismo código, puedes empezar por conectar la interfaz compatible con OpenAI de APIYI en apiyi.com y usar kimi-k3 como referencia. El modelo y el precio de K3.1 Pro en la plataforma dependerán de la lista de modelos disponible; esperamos ofrecer este modelo pronto.
5. Recomendaciones de uso de Kimi K3.1 Pro: cuándo cambiar y cuándo no hay prisa
Conclusiones según el tipo de tarea, como referencia para quienes ya usan K3.
| Tipo de tarea | Conclusión | Motivo |
|---|---|---|
| Agentes de programación y automatización de terminal | Conviene cambiar cuanto antes | En Terminal-Bench 4.0, la puntuación de terceros pasa del 13 % al 67 %; en programación con cadenas largas, la puntuación oficial mejora en más de 5 puntos |
| Análisis de documentos, informes de investigación y modelado financiero | Conviene cambiar | GDPval Elo mejora en +312; K3.1 Pro supera a K3 en todas las pruebas oficiales sobre informes financieros y de investigación, y las alucinaciones disminuyen claramente |
| Flujos de trabajo SaaS y procesos empresariales de varios pasos | Conviene cambiar | AutomationBench-AA pasa del 58 % al 73 % |
| Tareas sencillas por lotes (clasificación, extracción y reformulación) | No hay prisa | El coste por tarea es similar al de K3. El razonamiento continuo aumenta la cantidad de tokens de salida, y la mejora de capacidad aporta poco en tareas sencillas |
| Escenarios sensibles a la latencia (conversaciones en tiempo real y atención al cliente en línea) | Primero, haz pruebas | No hay datos oficiales de velocidad. El razonamiento continuo puede alargar el tiempo hasta el primer token, y el precio de highspeed se duplica |
Que «no haya prisa» no significa que K3 no sea suficiente. K3 ya funciona bien para tareas sencillas, y tanto la latencia como el gasto son más fáciles de prever. No hace falta reescribir todo el flujo de procesamiento por lotes solo para obtener una puntuación global más alta. Puedes esperar a que se publiquen los pesos de K3.1 Pro y haya más datos de velocidad de terceros antes de reevaluarlo; no será tarde.
5.1 Escenarios típicos para elegir Kimi K3.1 Pro
- Corregir errores, refactorizar y escribir pruebas a nivel de repositorio de código; el modelo debe ejecutar comandos, revisar los errores y volver a modificar el código por su cuenta.
- Responder preguntas y resumir informes financieros, contratos e informes de investigación extensos, donde la precisión de los datos es fundamental.
- Automatizar procesos que abarcan varias herramientas en línea y requieren más de una decena de pasos por tarea.
5.2 Escenarios típicos para seguir usando Kimi K3 por ahora
- Clasificar etiquetas o extraer campos de cientos de miles de registros al día, con un coste que se calcula por número de registros.
- Interacciones en tiempo real que requieren una latencia baja y estable, y cuyos parámetros de tiempo de espera y reintentos ya se han ajustado para K3.
Recomendación: lo más fiable es tomar entre 50 y 100 muestras reales de tu negocio y ejecutar cada una con ambos modelos para comparar la tasa de finalización y el coste total. Con una sola clave API, APIYI apiyi.com permite cambiar entre distintos modelos, por lo que resulta práctico para hacer este tipo de pruebas comparativas. Antes del lanzamiento de K3.1 Pro, puedes usar
kimi-k3para establecer una línea de base. Consulta la lista de modelos de la plataforma para conocer el nombre y el precio de K3.1 Pro; ofreceremos este modelo lo antes posible.
6. Recomendaciones y precauciones para migrar a Kimi K3.1 Pro
6.1 Calendario de retirada de la serie Kimi K2
Si todavía tienes invocaciones de la serie K2, prioriza su migración. La documentación oficial indica que, a partir del 31 de octubre de 2026, la serie K2 dejará de estar disponible para los nuevos usuarios y se retirará por completo antes de que termine 2026. Aunque los usuarios actuales podrán seguir utilizándola temporalmente, te recomendamos completar la migración durante los próximos dos meses y pasar directamente a K3 o K3.1 Pro, en lugar de esperar hasta el último momento.
6.2 Tres recomendaciones para cambiar a Kimi K3.1 Pro
- Inicia una sesión nueva; no cambies de modelo a mitad de una conversación. La recomendación oficial es usar K3.1 Pro en una sesión nueva. Continuar en K3.1 Pro una conversación anterior de K3 puede causar problemas de compatibilidad con el formato del contexto o el contenido del razonamiento.
- Prioriza las interfaces nativas. Según la recomendación oficial, las interfaces nativas Responses, Chat Completions y Messages son las opciones más estables.
- Escribe el nombre del modelo con precisión. Si escribes mal
kimi-k3.1-proen una herramienta de terceros, la solicitud recurrirá a K2.8 Preview y el modelo no razonará. El error no se notifica: simplemente obtendrás resultados peores, lo que puede llevar mucho tiempo detectar. Antes de ponerlo en producción, comprueba el campo del modelo en la respuesta.
6.3 Diferencias entre los planes de Kimi Code
Para usar los modelos nuevos en Kimi Code, necesitas cumplir ciertos requisitos de suscripción:
k3.1-prorequiere una suscripción Plus o superior.- El contexto de 1M requiere una suscripción Pro o superior.
- La versión highspeed requiere una suscripción Pro o superior y consume aproximadamente el doble de cuota.
Con una suscripción Plus puedes usar K3.1 Pro, pero no tendrás acceso al contexto completo de 1M. Si dependes principalmente de un contexto muy extenso para leer repositorios de código completos, comprueba tu plan antes de decidir si quieres actualizarlo.
6.4 Lista de comprobación para conectar mediante API
- Configura
base_urlcomohttps://api.apiyi.com/v1, la dirección compatible con OpenAI de APIYI (apiyi.com). En el código existente del SDK de OpenAI, solo tendrás que cambiar este valor y la clave. - Para empezar, usa
kimi-k3y comprueba que el flujo funciona. Después, indica el nombre exacto de K3.1 Pro según la lista de modelos de la plataforma. El nombre y el precio de K3.1 Pro dependerán de esa lista; esperamos ofrecer este modelo pronto. - Aumenta adecuadamente el tiempo de espera: el razonamiento continuo puede alargar cada respuesta.
- No configures
max_tokenscon un límite demasiado bajo; de lo contrario, el contenido del razonamiento podría reducir el espacio disponible para la respuesta principal.
Preguntas frecuentes
P1: ¿Qué es Kimi K3.1 Pro y qué relación tiene con K3?
K3.1 Pro es una nueva versión de Moonshot, desarrollada a partir de K3 con más recursos de computación para el posentrenamiento. La empresa lo describe como el primer modelo de la serie K3.1. Tiene la misma ventana de contexto y las mismas modalidades de entrada que K3. Sus principales mejoras están en los agentes de programación, las tareas de trabajo reales y la precisión factual.
P2: ¿La puntuación de Kimi K3.1 Pro en Terminal-Bench es del 65,7 % o del 67 %?
Ambas cifras son correctas, pero proceden de fuentes distintas. El 65,7 % es el resultado que declara la propia empresa; el 67 % lo midió de forma independiente Artificial Analysis. Los entornos de prueba y los harness son diferentes, así que no se pueden considerar la misma puntuación. Al citarla, indica la fuente.
P3: Si el precio por unidad de Kimi K3.1 Pro bajó un 33 %, ¿por qué no es más barato usarlo?
El modelo siempre razona y, en promedio, genera un 14 % más de salida por tarea que K3. Según las pruebas de AA, el costo por tarea ronda los $1,98 (en la página del modelo figura como $2,11), prácticamente igual que el de K3. La organización no ha desglosado los motivos; te recomendamos probarlo con tus propias tareas.
P4: ¿Cuándo estarán disponibles los pesos de Kimi K3.1 Pro?
La empresa se comprometió a publicar los pesos completos antes del 4 de noviembre de 2026. A fecha de 24 de octubre de 2026, sigue siendo un compromiso pendiente. Si planeas desplegarlo por tu cuenta, consulta el anuncio oficial cuando se publiquen.
P5: ¿Cómo puedo comparar rápidamente Kimi K3.1 Pro y K3 a través de la API?
Puedes registrarte en APIYI, en apiyi.com, para obtener una clave API y crédito gratuito de prueba. Usa primero la interfaz compatible con OpenAI para probar `kimi-k3` como referencia. El nombre del modelo y el precio de K3.1 Pro en la plataforma dependerán de la lista de modelos disponible. Lo incorporaremos lo antes posible; cuando esté disponible, solo tendrás que cambiar el parámetro `model` para compararlos.
P6: ¿Qué limitaciones conocidas tiene Kimi K3.1 Pro?
– La empresa no ha publicado pruebas de velocidad; la versión highspeed cuesta el doble.
– Siempre razona, así que no es adecuado para casos que requieren una latencia muy baja.
– Algunos resultados destacados proceden de conjuntos de prueba internos y no se pueden reproducir externamente.
– Su capacidad para detectar vulnerabilidades está limitada por medidas de seguridad y es inferior a la de la versión sin filtrar.
P7: Sigo usando K2. ¿Debería pasar directamente a K3.1 Pro?
La serie K2 dejará de estar disponible para nuevos usuarios a partir del 31 de octubre de 2026 y se retirará antes de fin de año, así que tendrás que migrar. Para agentes de programación y tareas con documentos, puedes pasar directamente a K3.1 Pro; para tareas pequeñas en lote, K3 es una opción más sencilla. En APIYI, en apiyi.com, puedes empezar la migración con `kimi-k3`. El nombre del modelo y el precio de K3.1 Pro dependerán de la lista de modelos de la plataforma. Lo incorporaremos lo antes posible.
Puntos clave de Kimi K3.1 Pro
- Mejora notable de capacidades: la puntuación global de AA sube de 44 a 55. Ocupa el cuarto puesto, solo por detrás de tres modelos cerrados.
- El mayor avance está en los agentes de programación: en las pruebas de terceros de Terminal-Bench 4.0, la puntuación pasa del 13 % al 67 %.
- Conviene distinguir las dos fuentes de datos: las cifras publicadas por el fabricante y las de AA usan criterios distintos; al citarlas, hay que indicar la fuente.
- Bajar el precio no implica reducir el coste: el precio unitario baja un 33 %, pero el coste por tarea se mantiene prácticamente igual que con K3.
- Las especificaciones básicas no cambian: ventana de contexto de 1M, compatibilidad con texto e imágenes; el fabricante no publica datos de velocidad.
- Al migrar, hay que especificar bien el nombre del modelo: si se escribe mal, se vuelve a K2.8 Preview y el modelo no razona.
- Cómo empezar: puedes usar primero APIYI apiyi.com para establecer una línea de base con K3. El nombre y el precio de K3.1 Pro dependerán de la lista de modelos de la plataforma. Lo incorporaremos lo antes posible.
Resumen: ¿vale la pena migrar de K3 a Kimi K3.1 Pro?
Los cambios de Kimi K3.1 Pro respecto a la generación anterior se resumen en tres puntos:
- Capacidades: mejora notable en agentes de programación, tareas de terminal, tareas de trabajo reales, automatización SaaS y factualidad. Los datos de terceros y los oficiales apuntan en la misma dirección.
- Precio: el precio unitario es un 33 % más bajo en las cinco categorías, pero el razonamiento continuo genera respuestas más largas, por lo que el coste por tarea apenas baja.
- Migración: recomendamos cambiar cuanto antes en los servicios de agentes de programación y en los que trabajan con documentos e informes de investigación. Para tareas pequeñas en lote y escenarios sensibles a la latencia, conviene probar antes de decidir. Los usuarios de K2 deben completar la migración antes de fin de año.
APIYI apiyi.com ofrece actualmente modelos de Kimi como kimi-k3 (entrada: $3 / salida: $15). Puedes usar la misma clave y una interfaz compatible con OpenAI para establecer primero una línea de base de costes y resultados. El nombre y el precio de Kimi K3.1 Pro en la plataforma dependerán de la lista de modelos. Lo incorporaremos lo antes posible; cuando esté disponible, bastará con cambiar el nombre del modelo para comparar.
Referencias
- Blog oficial de Moonshot: anuncio del lanzamiento de Kimi K3.1 Pro y resultados de rendimiento publicados por la propia compañía
- Nota: fuente de los datos de la categoría «publicados por la propia compañía» de este artículo. Las condiciones de prueba fueron
reasoning_effort=max,temperature=1.0ytop_p=0.95. - Documentación oficial de Moonshot: precios, calendario de retirada de K2, recomendaciones para cambiar de modelo e información sobre la suscripción a Kimi Code
- Nota: precios consultados el 2026-10-24, en dólares por millón de tokens y sin impuestos.
- Artificial Analysis: evaluación independiente de modelos realizada por terceros
- Enlace:
artificialanalysis.ai - Nota: fuente de los datos de la categoría «terceros» de este artículo, con fecha del 2026-10-23.
Autor: Equipo técnico de APIYI
Intercambio técnico: Puedes contactarnos desde la página de inicio del sitio web de APIYI. Encontrarás más información para la integración en el centro de documentación, en docs.apiyi.com. El nombre y el precio de Kimi K3.1 Pro dependerán de la lista de modelos de la plataforma. Haremos todo lo posible por ofrecer este modelo pronto.