Nota del autor: con una sola clave, un conjunto fijo de scripts y un fallo de inyección, comparamos en paralelo la capacidad de invocación de herramientas en múltiples turnos de varios modelos, y obtenemos conclusiones reproducibles y auditables.
Al elegir un modelo para construir un agente, muchos equipos se han topado con el mismo problema. En preguntas y respuestas de un solo turno, el rendimiento de los modelos es más o menos similar; pero en cuanto entran en el ciclo de múltiples turnos de “llamar a una herramienta → obtener el resultado → volver a llamar → gestionar el error → entregar una respuesta estructurada”, las diferencias aparecen. Este artículo presenta una pequeña prueba de invocación de herramientas en múltiples turnos con una sola clave para varios modelos, que te ayuda a convertir esas diferencias en datos registrables y revisables con un costo muy bajo.
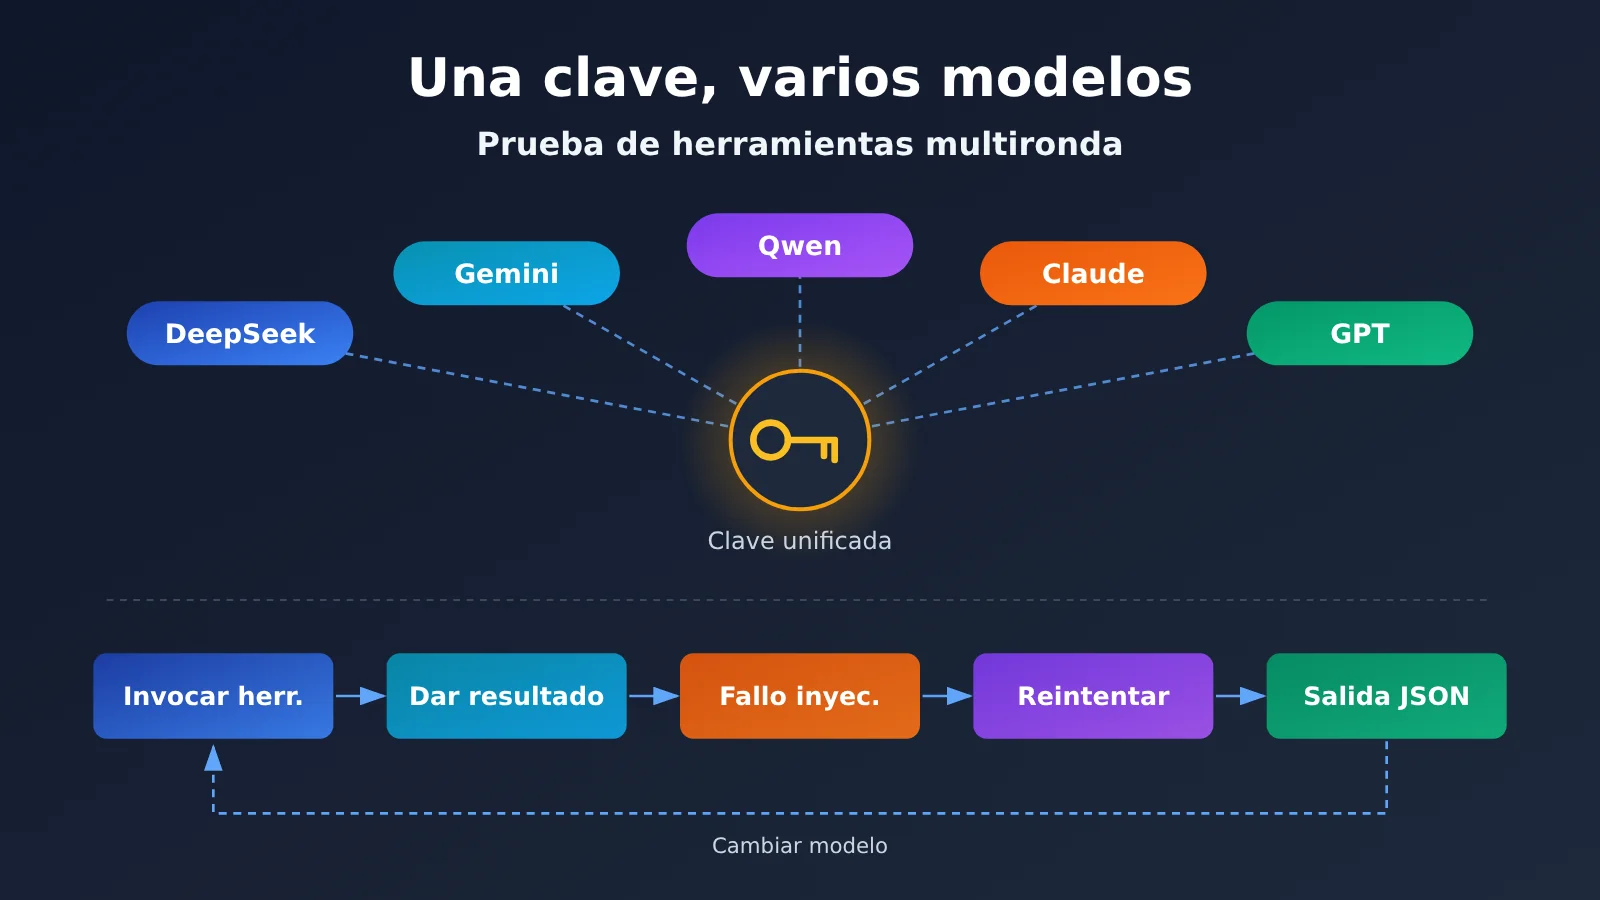
Esto no es un ranking de modelos. Este artículo no ofrece ninguna puntuación de benchmark que no haya sido probada; solo explica cómo diseñar la prueba para que llegues a conclusiones en tu propio escenario de negocio. La clave de la prueba es controlar las variables: la misma clave, el mismo conjunto de definiciones de herramientas y los mismos datos Mock, cambiando únicamente el nombre del modelo. Con plataformas agregadoras como APIYI apiyi.com, una sola clave permite invocar modelos de varios proveedores como DeepSeek, Gemini, Qwen, Claude y GPT, lo que reduce mucho el costo de cambio al comparar en paralelo.
Valor principal: al terminar de leer, podrás montar una prueba reproducible de invocación de herramientas en múltiples turnos de 5 pasos. Cubre cinco puntos clave: selección de herramientas, validación de parámetros, retorno del ID de llamada, reintento tras fallo y validación final del JSON.
Puntos clave de una prueba pequeña de invocación de herramientas en múltiples turnos
Antes de diseñar una prueba de invocación de herramientas en múltiples turnos, conviene aclarar qué significa “reproducible”. La misma entrada, ejecutada en momentos distintos y por personas distintas, debería producir resultados comparables del mismo tipo. Una salida vistosa aislada no sirve como conclusión. La siguiente tabla resume el esqueleto de toda la prueba.
| Punto clave | Descripción | Valor |
|---|---|---|
| Una sola clave, varios modelos | Todos los modelos pasan por el mismo punto de entrada de API; solo se cambia el campo model | Elimina interferencias de red, autenticación y versión del SDK |
| Herramientas Mock fijas | Los valores de retorno de las herramientas están codificados; no se conectan a bases de datos reales ni a servicios externos | En cada ejecución, los resultados de las herramientas son exactamente iguales |
| Inyectar un fallo una vez | La primera llamada a una herramienta devuelve siempre un error reintentable | Observar si el modelo reintenta correctamente y si inventa datos |
| Punto final estructurado | La respuesta final debe ser un JSON que cumpla con el Schema | Se puede determinar automáticamente por programa si pasa o falla |
| Trazabilidad completa | Guardar los parámetros de la solicitud, la respuesta original, el usage y el tiempo de ejecución | Las conclusiones se pueden revisar y permiten hacer regresión al cambiar la versión del modelo |
Por qué la prueba de invocación de herramientas en múltiples turnos debe ser «pequeña»
La prueba debe ser pequeña porque las pruebas grandes son difíciles de reproducir. La cadena de herramientas de un negocio real puede tener una decena de herramientas y depender de sistemas externos; cualquier fluctuación se confundiría con un problema del modelo. Una buena prueba pequeña solo necesita 2 o 3 herramientas de solo lectura, más un fallo inyectado artificialmente, para cubrir los puntos más propensos a error dentro del bucle de múltiples turnos.
La prueba también debe ser «completa». Tiene que ejecutar todo el bucle; no basta con ver si el modelo lanza una invocación de herramientas en el primer turno. Muchos modelos lo hacen bien en el primer turno, pero fallan en el segundo o tercero: no incluyen el ID de llamada correcto, se rinden tras recibir un error o inventan un número de seguimiento logístico cuando no tienen datos. Estos problemas solo se ven si se ejecuta el bucle hasta el último turno.
Principios de diseño para probar varios modelos con una sola clave
Controlar las variables es un requisito previo para una prueba comparativa. Si el modelo A usa el SDK oficial, el modelo B usa un SDK de terceros y el modelo C usa otra dirección de proxy, al final no se distingue si la diferencia viene del modelo o de la cadena. Con un punto de entrada unificado, la autenticación, la política de reintentos, la configuración de timeout y el formato de los logs se mantienen iguales; la única variable es el modelo en sí.
Inicio rápido para una prueba pequeña de llamadas a herramientas en múltiples turnos
Esta sección no incluye código; solo enumera los parámetros, las definiciones de herramientas y los pasos de ejecución. Puedes implementarlo en cualquier lenguaje que domines: Python, Node.js o un script de Shell. Lo importante es que cada elemento de configuración se escriba en un archivo de configuración fijo y se guarde junto con los resultados de la prueba.
Paso 1: Unificar la interfaz y los parámetros de ejecución
Primero define el punto de entrada de la interfaz y los parámetros de muestreo. APIYI es compatible tanto con el formato de OpenAI como con el de Anthropic; la misma clave puede usarse tanto en llamadas estilo Chat Completions como estilo Messages. La siguiente tabla enumera los elementos de configuración que conviene fijar.
| Elemento de configuración | Valor sugerido | Descripción |
|---|---|---|
| base_url (formato OpenAI) | https://api.apiyi.com/v1 |
Se llama a través del punto de entrada unificado de APIYI; la dirección concreta se rige por la documentación en docs.apiyi.com |
| base_url (formato Anthropic) | Consulta la dirección compatible con Anthropic en la documentación de APIYI | Se usa para probar el protocolo tool_use / tool_result |
| api_key | La misma clave | Compartida por todos los modelos, para excluir diferencias de autenticación |
| temperature | 0 o lo más bajo posible | Reduce la aleatoriedad; si algún modelo de razonamiento no lo admite, registra el valor real |
| max_tokens | Valor fijo | Evita falsos negativos por salidas truncadas |
| tool_choice | auto | Observa la decisión autónoma del modelo, sin forzar la llamada |
| Número máximo de iteraciones del bucle | Un límite superior fijo, por ejemplo, 6 iteraciones | Evita que el modelo entre en reintentos infinitos |
| Número de ejecuciones por modelo | Un número fijo, por ejemplo, 5 veces | Usa varios resultados para juzgar la estabilidad, no mires el rendimiento de una sola ejecución |
🚀 Sugerencia para empezar rápido: primero puedes registrarte en APIYI apiyi.com y obtener una clave; luego usa la misma clave para llamar a los modelos candidatos en orden. Cuando confirmes que cada modelo devuelve respuestas de llamada a herramientas normales, comienza la prueba formal. Las instrucciones de integración están en docs.apiyi.com.
Paso 2: Definir 2 o 3 herramientas de solo lectura
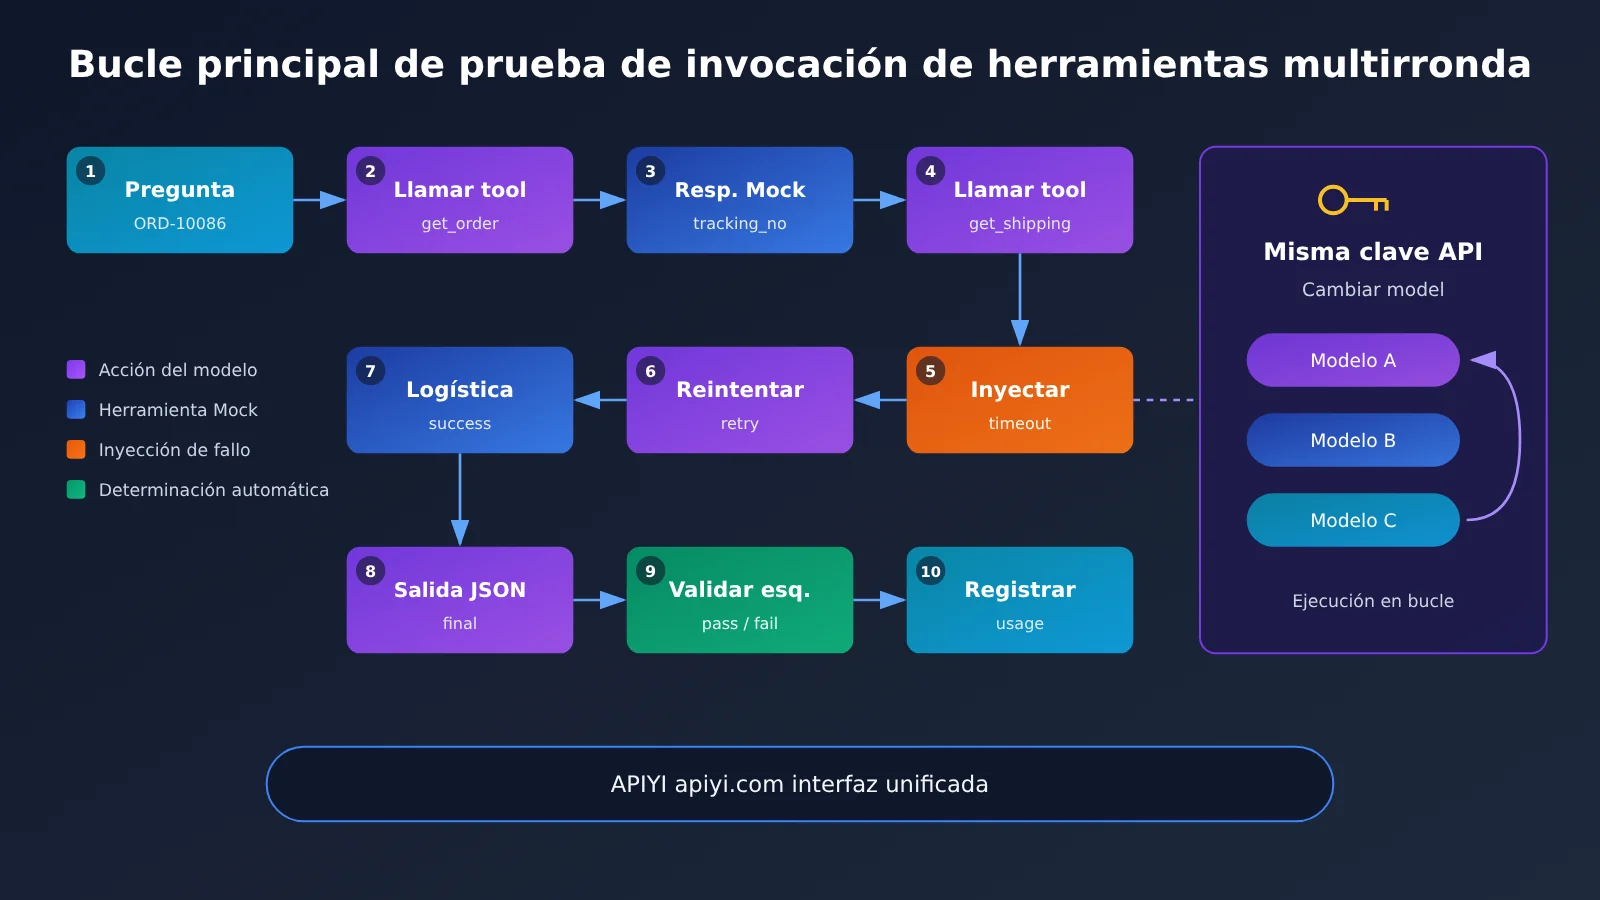
El diseño de las herramientas tiene dos requisitos: que sean de solo lectura y deterministas. Solo lectura para evitar que se disparen por error operaciones de escritura durante las pruebas, y deterministas para garantizar que cada llamada devuelva el mismo valor. Se recomienda usar un escenario ficticio de consulta de pedidos, con dos herramientas:
- get_order: el parámetro es order_id (cadena, con formato fijo «ORD-» más números). Devuelve siempre el estado del pedido, el nombre del producto y el número de seguimiento tracking_no.
- get_shipping: el parámetro es tracking_no (cadena). La primera llamada devuelve siempre un error cuyo contenido incluye error = timeout y retryable = true; la segunda llamada y las siguientes devuelven un estado logístico fijo y la fecha estimada de entrega.
- Herramienta de distracción opcional get_coupon: no tiene relación con la pregunta; sirve para observar si el modelo la invoca sin necesidad.
El Schema de parámetros debe definirse de forma estricta: tipos de campo, campos obligatorios y formato regex deben quedar explícitos. Los parámetros que genera el modelo deben pasar primero la validación del Schema antes de entregarse a la función Mock. Si la validación falla, hay que registrarlo como un «error de parámetros» y no corregirlo en silencio.
Paso 3: Escribir la indicación fija y la pregunta del usuario
La indicación de System solo contiene reglas, no respuestas. Se puede pedir al modelo que responda únicamente con los datos que devuelven las herramientas; que, si una herramienta da error y es reintentable, reintente como máximo 2 veces; y que al final emita solo un objeto JSON cuyos campos incluyan order_status, shipping_status, eta y data_source. La pregunta del usuario se fija en una sola frase, por ejemplo: «ayúdame a ver dónde está ahora el pedido ORD-10086».
Una vez fijada la indicación, no se modifica más. Si durante las pruebas se descubre que un modelo falla por ambigüedad en la indicación, lo correcto es abrir un nuevo número de versión y volver a probar todos los modelos con la nueva versión, en lugar de cambiar la indicación solo para ese modelo.
Paso 4: ejecutar el bucle e inyectar un fallo
La lógica de ejecución sigue este orden:
- Enviar los mensajes system y user, junto con la definición de las herramientas.
- Si la respuesta contiene llamadas a herramientas, validar los parámetros una por una, ejecutar la función Mock correspondiente y devolver el resultado según lo exige el protocolo.
- Para la primera llamada a get_shipping, devolver siempre un error reintentable.
- Repetir el paso 2 hasta que el modelo entregue una respuesta final sin llamadas a herramientas, o hasta alcanzar el número máximo de rondas.
- Validar la respuesta final con JSON Schema y guardar todos los mensajes, la respuesta original y el usage de cada ronda.
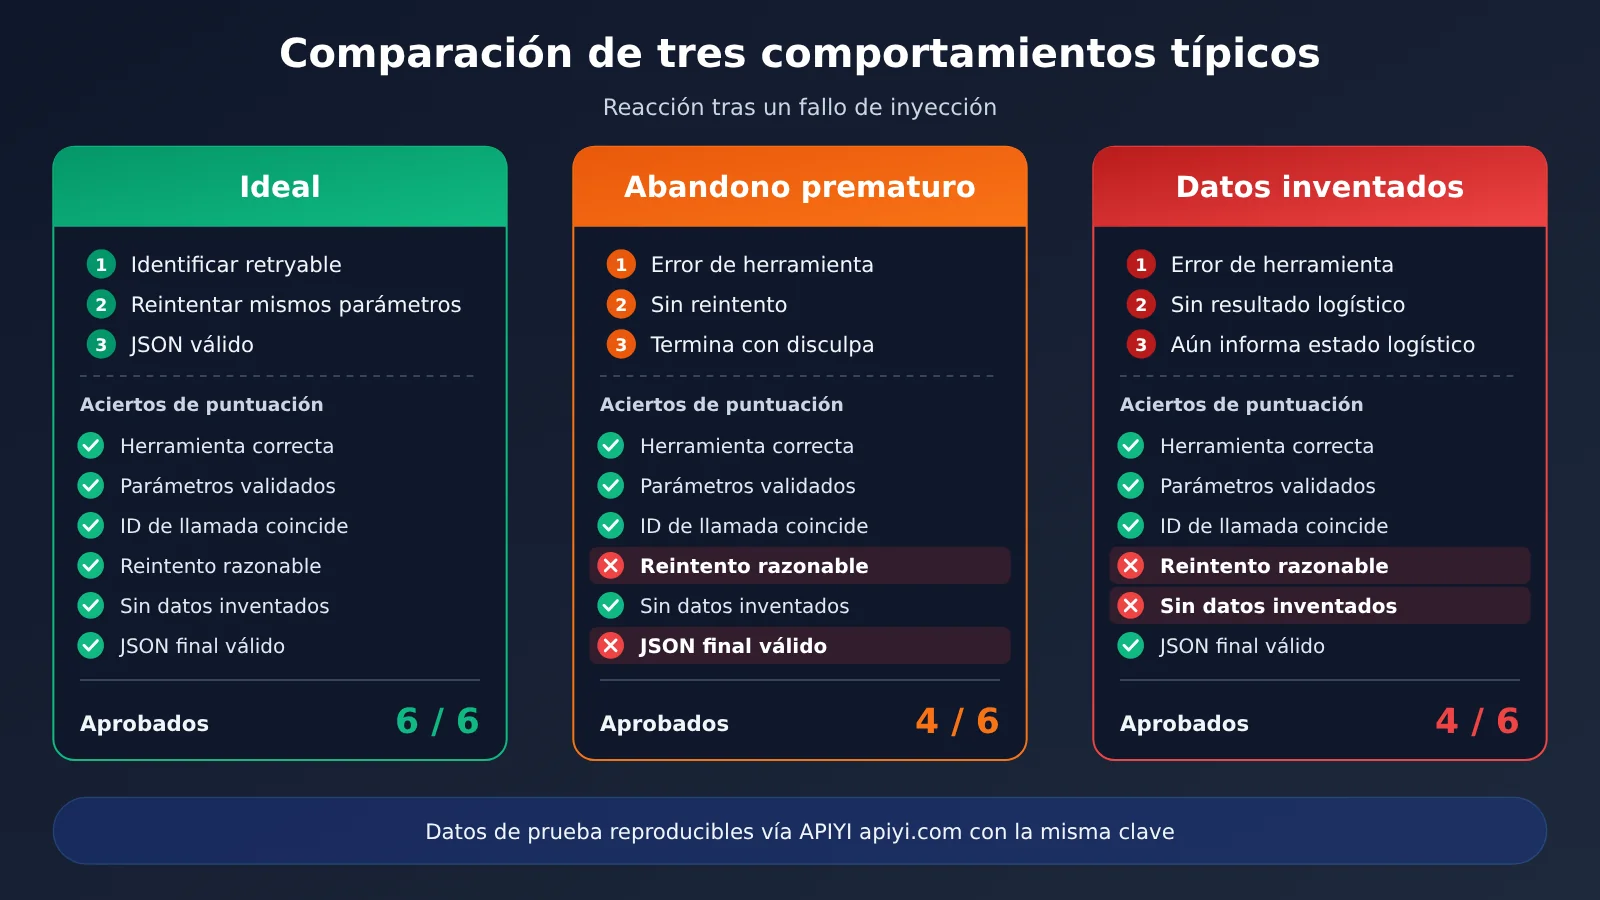
La inyección del fallo es la parte más discriminatoria de toda la prueba. El comportamiento ideal es que el modelo detecte que retryable es true y vuelva a llamar a get_shipping con los mismos parámetros. Hay tres comportamientos problemáticos habituales: disculparse con el usuario y terminar directamente; inventar un estado del envío; o modificar los parámetros y reintentar una y otra vez hasta superar el límite de rondas.
Paso 5: puntuar según la lista de verificación y dejar registro
Al terminar cada ejecución, evaluar cada punto mediante un programa, evitando en lo posible la puntuación subjetiva manual. La revisión humana se limita a las muestras que el programa marca como anómalas.
Diferencias en el protocolo de llamadas a herramientas multiturno: formatos de OpenAI y Anthropic
Para que una misma prueba funcione con ambos formatos de API, primero hay que entender las diferencias de protocolo. Un pequeño detalle puede provocar problemas como “funciona con curl, pero no con el cliente”. Conviene confirmar primero que el protocolo es correcto con una solicitud mínima y después empezar a comparar la capacidad de los modelos.
| Etapa | Formato compatible con OpenAI | Formato compatible con Anthropic |
|---|---|---|
| Definición de herramientas | array tools, cada elemento con type igual a function y los parámetros en parameters |
array tools, el esquema de parámetros se escribe en input_schema |
| El modelo inicia la llamada | tool_calls dentro de un mensaje assistant, cada uno con id |
bloques tool_use dentro del contenido de assistant, cada uno con id |
| Forma de los parámetros | arguments suele ser una cadena JSON y hay que analizarla por cuenta propia |
input es directamente un objeto JSON |
| Devolución del resultado | mensaje con role igual a tool, que lleva tool_call_id |
bloque de contenido tool_result dentro de un mensaje user, que lleva tool_use_id |
| Marcar errores | normalmente se define un campo de error personalizado dentro del contenido del resultado | tool_result admite la marca is_error |
| Llamadas en paralelo | una respuesta puede contener varios tool_calls |
una respuesta puede contener varios bloques tool_use |
Hay varios errores fáciles de cometer. Primero, en el formato OpenAI arguments es una cadena y algunos modelos a veces emiten caracteres de más, lo que hace fallar el análisis. Eso debería contar en la puntuación, no resolverse con tolerancia en el código. Segundo, al devolver resultados, los ID deben corresponder uno a uno con los de las llamadas iniciadas; hay que prestar especial atención al orden cuando hay llamadas en paralelo. Tercero, algunos modelos combinan texto y llamadas a herramientas en una misma respuesta, así que la lógica debe soportar ambos tipos de contenido a la vez.
💡 Consejo técnico: con el punto de acceso unificado de APIYI apiyi.com, puedes usar la misma clave para ejecutar la misma batería de pruebas con el formato OpenAI y con el formato Anthropic. Así podrás distinguir si el problema está en el modelo en sí o en la capa de adaptación del protocolo.
Lista de verificación de evaluación y plantilla de registro para llamadas multironda a herramientas
La lista de verificación es clave para que las conclusiones se puedan reproducir. Cada elemento debe poder evaluarse de forma programática y corresponder a un riesgo real de negocio. La siguiente tabla recoge los elementos recomendados; puedes añadir o quitar según tu negocio.
| Elemento de verificación | Criterio de evaluación | Riesgo de negocio asociado |
|---|---|---|
| Selección correcta de la herramienta | En la primera ronda se llama a get_order y no se llama a herramientas distractoras | Las llamadas innecesarias aumentan la latencia y el costo |
| Parámetros validados | Los parámetros cumplen el esquema, incluidos tipo, obligatoriedad y formato | Los parámetros incorrectos llegan al sistema real |
| ID de llamada correctamente correlacionado | El resultado devuelto coincide con el ID de la llamada iniciada | Se desordena el contexto entre rondas |
| Comportamiento de reintento razonable | Tras recibir un error reintentable, se reintenta con los mismos parámetros sin superar el límite | Abandonar demasiado pronto o reintentar sin límite |
| Sin datos inventados | Todos los campos de la respuesta final se encuentran en los valores devueltos por la herramienta | Las alucinaciones impactan directamente al usuario |
| JSON final válido | Pasa la validación de JSON Schema, sin texto adicional | Falla el parseo en el sistema posterior |
| Número de rondas y uso de tokens | Registrar las rondas totales y los tokens de entrada y salida | Evaluar costo y latencia |
Después de ejecutar cada modelo un número fijo de veces, consolida los resultados en una tabla. Las columnas sugeridas son: ID del modelo, formato de interfaz, número de ejecución, elementos aprobados, detalle de elementos fallidos, rondas totales, tokens de entrada, tokens de salida, duración y fecha de prueba. Guarda el encabezado de la tabla junto con el archivo de configuración en el repositorio de versiones. Cuando actualices el modelo o cambies a una versión nueva, vuelve a ejecutar el mismo conjunto de scripts para hacer una comparación de regresión.
Cómo registrar el criterio de costos en llamadas multironda a herramientas
El uso de tokens debe registrarse ronda por ronda, no solo en la última. En un bucle multironda, cada ronda vuelve a enviar como entrada los mensajes y los resultados de herramientas anteriores, así que los tokens de entrada se acumulan ronda a ronda. Cuantos más reintentos, mayor es el costo. Por eso el elemento “comportamiento de reintento razonable” merece una puntuación aparte.
Al calcular el costo, multiplica los tokens de entrada y de salida de usage (y los tokens de caché, si hay aciertos de caché) por el precio unitario correspondiente. Todos los precios de entrada, salida y caché, así como los criterios de facturación de los modelos, deben tomarse de los datos reales de la página de precios de APIYI: docs.apiyi.com/models. Este artículo no incluye cifras concretas porque los precios cambian y dejarlas fijas en el texto se vuelve obsoleto con facilidad.
Probar varios modelos con una sola clave: lista de modelos candidatos
Se recomienda que los modelos candidatos cubran distintos proveedores y distintos enfoques; por ejemplo, un modelo con buena relación calidad-precio, un modelo principal y un modelo con mayor capacidad de razonamiento. La siguiente tabla solo enumera las series de modelos y los puntos de interés de las pruebas; no ofrece conclusiones. Las conclusiones deben salir de tus propios datos de pruebas reales.
| Serie de modelo | Puntos a probar recomendados | Formato de interfaz recomendado | Plataformas disponibles |
|---|---|---|---|
| Serie DeepSeek | Estabilidad del análisis de cadenas de parámetros, reintento tras un fallo de inyección | Compatible con OpenAI | APIYI apiyi.com, API oficial |
| Serie Gemini | Tendencia a las llamadas en paralelo, si el JSON final incluye texto adicional | Compatible con OpenAI | APIYI apiyi.com, API oficial |
| Serie Qwen | Invocación accidental de herramientas de distracción, correspondencia de ID en múltiples turnos | Compatible con OpenAI | APIYI apiyi.com, API oficial |
| Serie Claude | Manejo de is_error en tool_result, control del número de turnos |
Compatible con Anthropic | APIYI apiyi.com, API oficial |
| Serie GPT | Cumplimiento estricto del esquema, consumo de tokens | Compatible con OpenAI | APIYI apiyi.com, API oficial |
Los ID y las versiones de modelo disponibles concretamente deben consultarse en la lista de modelos de APIYI. Al registrar resultados, escribe siempre el ID completo del modelo, no solo el nombre de la serie. Distintas versiones de una misma serie pueden comportarse de forma muy diferente en la invocación de herramientas.
💡 Consejo de selección: qué modelo elegir depende de la complejidad de tus herramientas, tu tolerancia a las alucinaciones y tu presupuesto. Te recomendamos ejecutar una ronda de pruebas con cada modelo candidato usando la misma clave en APIYI apiyi.com y, después, combinar los datos de precios de docs.apiyi.com/models para tomar una decisión integral.
Preguntas frecuentes (FAQ)
P1: ¿Qué es la mini prueba de llamadas a herramientas en varios turnos?
Es una prueba muy pequeña y con resultado determinista. Con 2 o 3 herramientas Mock y una falla inyectada, se hace que el modelo recorra completo el ciclo de “llamar herramientas, procesar resultados, reintentar y emitir una respuesta estructurada”; después, un programa evalúa punto por punto si pasa. Lo que importa es si el ciclo puede completarse de forma estable, no el nivel de conocimiento del modelo.
P2: ¿Por qué se insiste en probar varios modelos con una sola clave?
Para controlar las variables. Las claves, SDK y direcciones de proxy distintas introducen diferencias de autenticación, tiempos de espera y adaptación de protocolo, lo que distorsiona la comparación. Con un punto de entrada unificado, lo único que cambia es el campo model; así, las diferencias observadas se pueden atribuir al modelo en sí.
P3: ¿Poner temperature en 0 garantiza una reproducción exacta?
No del todo. Incluso con temperature en 0, algunos modelos siguen produciendo ligeras variaciones, y los modelos de razonamiento pueden no admitir bajar ese parámetro. Por eso la prueba debe ejecutarse varias veces en condiciones fijas y hay que mirar la tasa de aprobación y la distribución de fallos, no solo el resultado de una ejecución. También conviene registrar los valores de los parámetros que se usan realmente.
P4: ¿En qué escenarios encaja esta prueba?
– **Selección de agentes**: comparar, antes del lanzamiento, la estabilidad de los modelos candidatos en el ciclo de herramientas.
– **Regresión por actualización de modelo**: tras publicar una nueva versión, volver a ejecutar el mismo script para confirmar que no hay degradación.
– **Validación de migración de protocolo**: al pasar del formato de OpenAI al formato de Anthropic, confirmar que la capa de adaptación no tiene problemas.
P5: ¿Cómo empezar rápidamente a invocar estos modelos?
1. Entra en APIYI apiyi.com, regístrate y obtén una clave API.
2. Lee docs.apiyi.com y confirma la dirección compatible con OpenAI y la compatible con Anthropic.
3. Configura según la tabla de parámetros del paso 1 de este artículo y, primero, haz una solicitud mínima para confirmar que cada modelo puede devolver una llamada a herramienta.
APIYI admite la integración unificada de varios de los modelos mencionados en este artículo; para cambiar de modelo solo hay que modificar el campo model.
P6: ¿Cómo se estima el costo de la prueba?
El costo es aproximadamente “número de modelos × número de ejecuciones × tokens acumulados por ejecución × precio unitario”. Los tokens de entrada de un ciclo de varios turnos se van acumulando ronda a ronda, y los reintentos aumentan aún más el consumo. El precio unitario y las reglas de facturación de caché se basan en los datos reales de la página de precios de APIYI docs.apiyi.com/models. Se recomienda ejecutar primero 1 vez por modelo para estimar el consumo y, después, decidir cuántas ejecuciones formales hacer.
P7: ¿Qué limitaciones tiene esta prueba?
La mini prueba solo cubre modos de fallo típicos y no representa todos los negocios complejos. Los datos que devuelven las herramientas Mock son muy limpios; un sistema real puede devolver datos con formato desordenado o demasiado largos. Una vez que la prueba pase, se recomienda añadir muestras anómalas que hayan ocurrido realmente en el negocio y ampliar los casos poco a poco.
Puntos clave de la prueba rápida de invocación de herramientas en varios turnos
- Controla las variables primero: usa una sola clave API y una sola configuración, y cambia únicamente el campo
model. - Herramientas de solo lectura y deterministas: deja fijos los valores que devuelve el Mock para que cada ejecución vea siempre los mismos datos.
- Inyecta fallos sí o sí: un error reintentable es lo que mejor revela la capacidad de cada modelo para manejar bucles.
- Puntuación programática: cada comprobación debe poder evaluarse de forma automática; las personas solo se encargan de revisar las anomalías.
- Trazabilidad completa: guarda la respuesta original, el
usagede cada turno y el ID completo del modelo para facilitar las regresiones. - El precio manda desde la página oficial: para calcular costes, toma como referencia la página de precios de APIYI docs.apiyi.com/models.
- Un único punto de entrada ahorra trabajo: como APIYI es compatible con los formatos de OpenAI y Anthropic, un mismo script cubre ambos protocolos.
Conclusión
Una prueba rápida de invocación de herramientas en varios turnos para medir varios modelos con una sola clave API se apoya en tres pilares:
- Reproducible: configuración fija, datos Mock fijos y una misma versión de la indicación, ejecutándolo varias veces.
- Evaluable: usa validación de esquema y una lista de puntuación en lugar de impresiones subjetivas.
- Regresable: trazabilidad completa; cuando el modelo se actualice, puedes volver a medir con el mismo script.
Este método no te dirá «qué modelo es el mejor», pero sí te dirá cuál es más estable dentro de tu propia cadena de herramientas, cuál gasta menos tokens y cuál tiene un comportamiento más controlado cuando falla. Te sugiero empezar con el escenario de consulta de pedidos de este artículo para validar el flujo completo y después sustituirlo por las herramientas de tu propio negocio.
Recomiendo hacer la validación cruzada de varios modelos con la misma clave API a través de APIYI apiyi.com. La forma de integración está en docs.apiyi.com y los criterios de precios y facturación se rigen por docs.apiyi.com/models.
📚 Referencias
- Documentación de llamadas a funciones de OpenAI: explicación del protocolo de
tools,tool_callsy los mensajes con roltool - Enlace:
platform.openai.com/docs/guides/function-calling -
Descripción: entender cómo se manejan las cadenas de parámetros y el
tool_call_iden el formato compatible con OpenAI -
Documentación de uso de herramientas de Anthropic: explicación de los bloques de contenido
tool_useytool_result - Enlace:
docs.anthropic.com/en/docs/build-with-claude/tool-use -
Descripción: conocer el uso de
input_schema,tool_use_ideis_error -
Centro de documentación de APIYI: instrucciones de integración con la interfaz unificada
- Enlace:
docs.apiyi.com -
Descripción: consultar las direcciones compatibles con OpenAI y Anthropic, así como ejemplos de invocación
-
Página de modelos y precios de APIYI: lista de modelos y criterios de facturación
- Enlace:
docs.apiyi.com/models - Descripción: los precios unitarios de entrada, salida y caché se rigen por los datos reales de esta página
Autor: Equipo técnico de APIYI
Contacto técnico: puedes contactarnos en la página principal del sitio APIYI apiyi.com; para más material de integración, visita el centro de documentación docs.apiyi.com