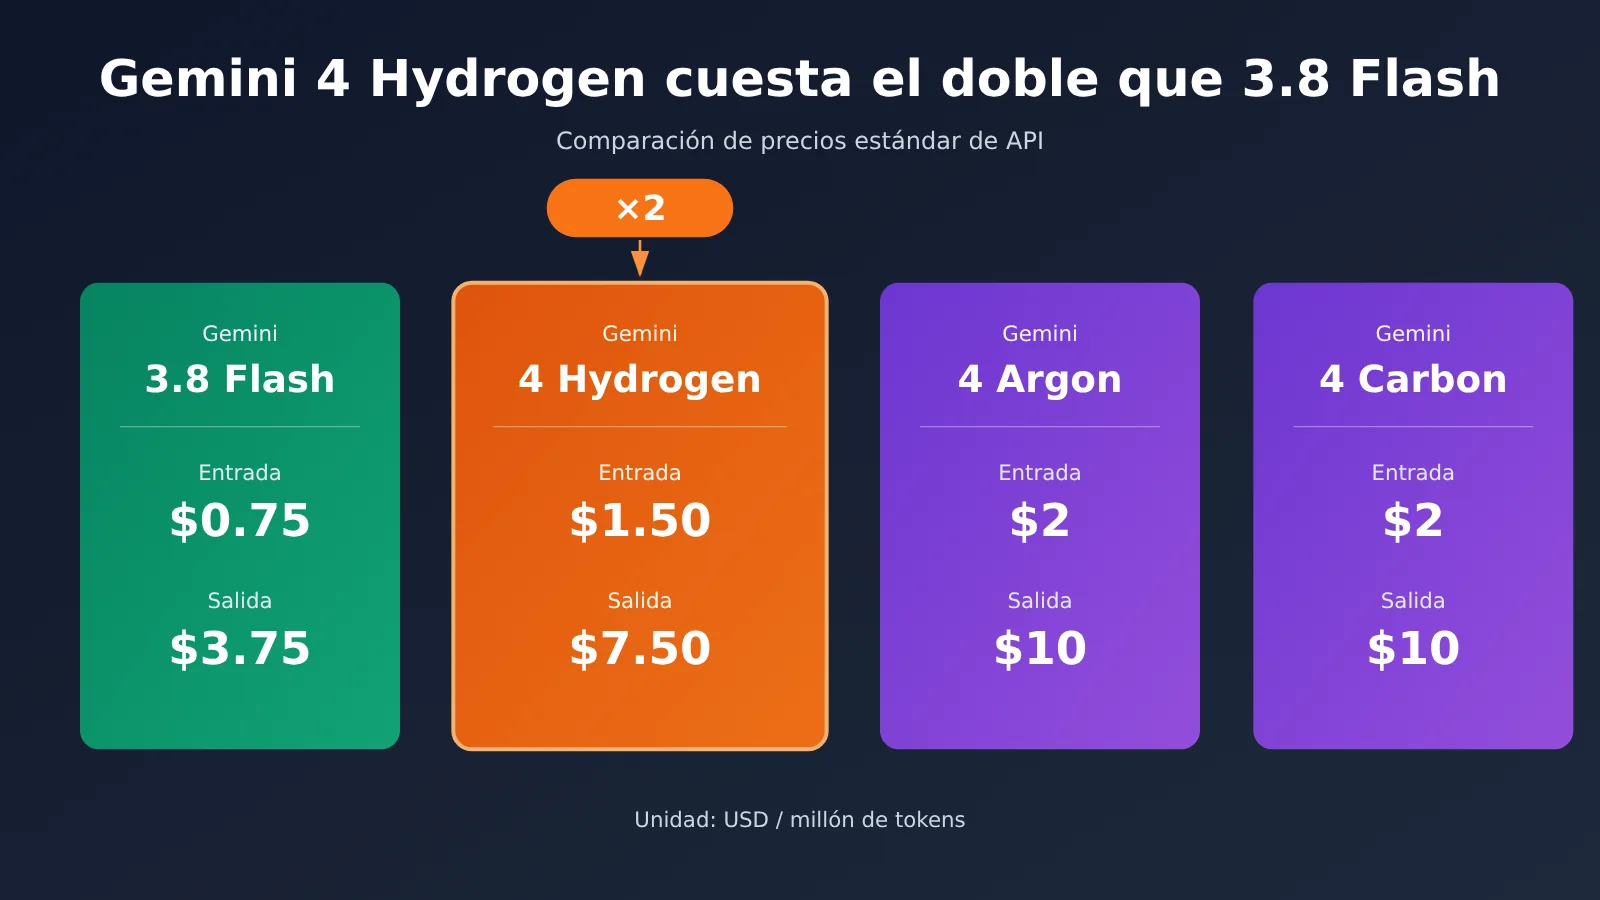
Nota del autor: con la misma carga de tokens, el precio estándar actual de Gemini 4 Hydrogen es el doble del de 3.8 Flash. Para elegir entre los cuatro modelos Gemini no basta mirar el precio unitario: también hay que considerar el costo de completar con éxito cada tarea y los ajustes de precios que ya se han anunciado oficialmente.
Google lanzó oficialmente Gemini 4 Hydrogen el 12 de noviembre de 2026. La primera reacción de muchos desarrolladores es «llegó la nueva generación de Flash, debería ser más barata». La realidad es justo lo contrario: según los precios estándar de la API de Google Gemini, el precio de Hydrogen por millón de tokens es el doble del de 3.8 Flash, aunque es más barato que Argon y Carbon de la misma familia.
Este no es un análisis tibio en el que todos ganan. Aquí usamos de forma uniforme los precios estándar de la API de Google Gemini (verificados el 13 de noviembre de 2026, en dólares por millón de tokens): primero calculamos cuánto costaría cada uno de los cuatro modelos para el mismo volumen de negocio, luego deducimos bajo qué condiciones Hydrogen resulta realmente rentable y, por último, combinando los ajustes de precios del 1 de diciembre y del 1 de enero del próximo año, damos recomendaciones de selección que se pueden ejecutar directamente.
Resumen en una frase: hoy el precio unitario por token de Hydrogen es 2 veces el de 3.8 Flash. Si vale la pena cambiar depende de si consigue reducir a la mitad el total de tokens facturados o duplicar la tasa de éxito de cada intento.
5 términos que conviene conocer antes de leer
Estos conceptos influyen directamente en cómo interpretas el precio de Gemini 4 Hydrogen, así que te recomiendo revisarlos primero:
- Token: unidad de medida que el modelo utiliza para procesar texto, imágenes y otros tipos de información. La API cobra por separado los tokens de entrada y los tokens de salida.
- Tokens de pensamiento: tokens que consume el modelo durante el razonamiento. La página oficial de precios de Google indica claramente que los tokens de pensamiento se cobran al precio de salida; por eso, calcular el costo mirando solo la longitud de la respuesta final da un resultado más bajo de lo real.
- Caché implícita: la plataforma reutiliza automáticamente prefijos de entrada que cumplen los requisitos. La parte que coincide con la caché se cobra al precio de caché. Hydrogen admite caché implícita, con un prefijo mínimo de 4096 tokens, y no admite caché explícita.
- Grounding: consiste en vincular la respuesta generada con evidencia externa recuperada, por ejemplo Google Search Grounding. Esta parte se cobra aparte según el número de solicitudes de búsqueda.
- API: interfaz que permite a programas llamar a un servicio. Los precios de este artículo se refieren todos al cobro cuando se invoca la API desde un programa, no a la suscripción a Gemini App.
Diferencias clave de precio entre Gemini 4 Hydrogen, 3.8 Flash, Argon y Carbon
Cómo se facturan los cuatro modelos Gemini tras el lanzamiento de Hydrogen
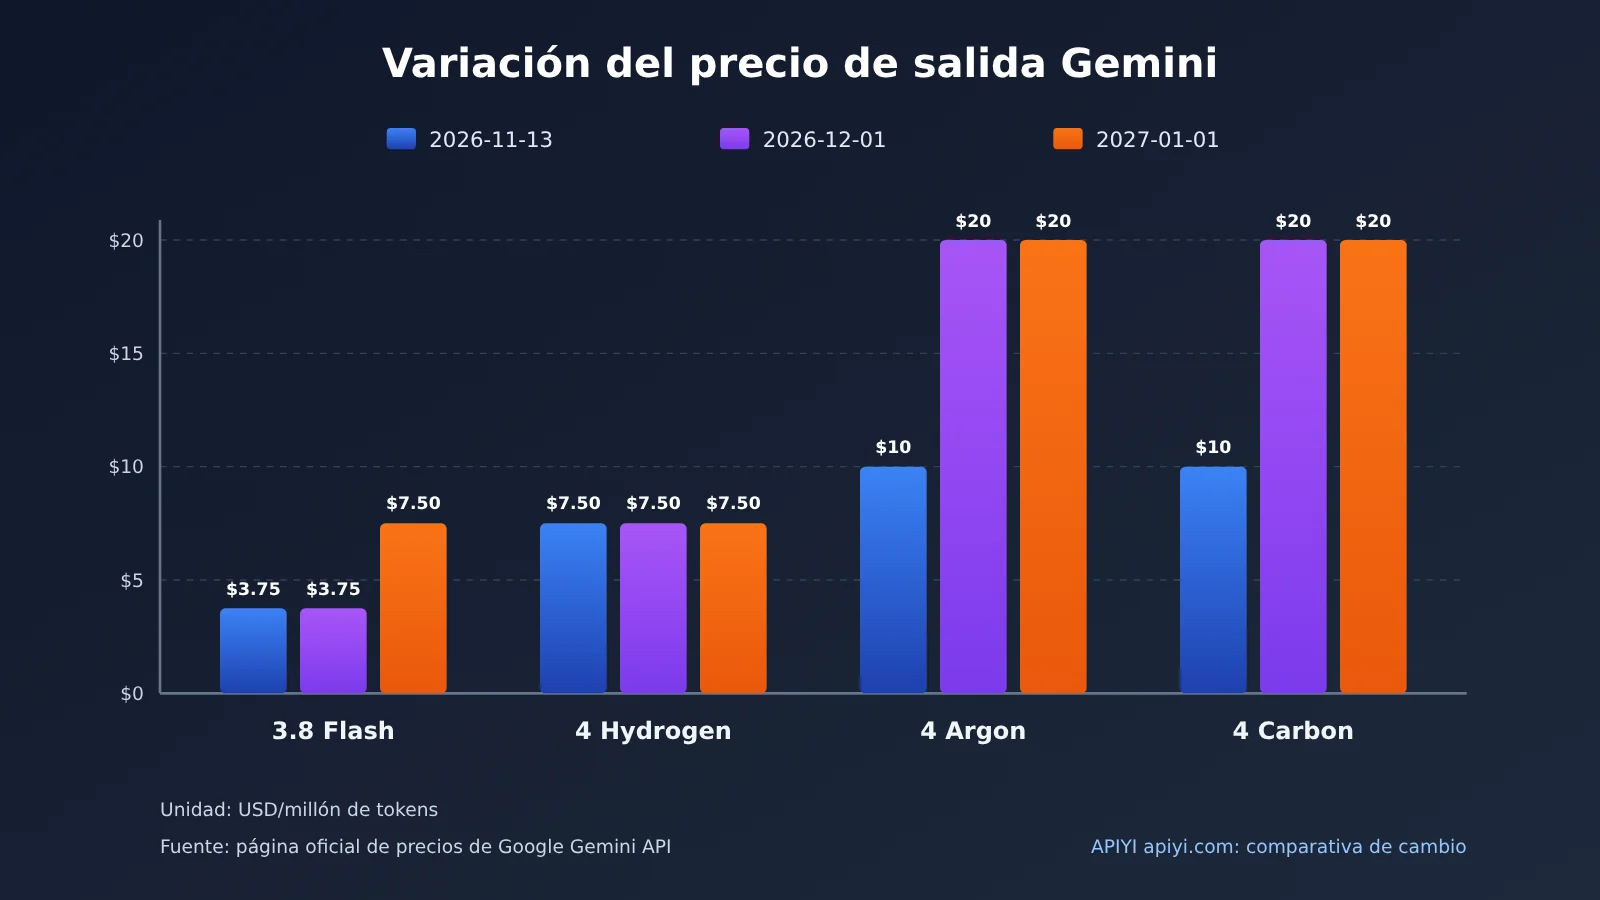
La siguiente tabla recoge los precios estándar de invocación de Google Gemini API, tomados de la página oficial de precios y verificados el 13 de noviembre de 2026.
| Modelo | Precio de entrada actual | Precio de salida actual | Ajuste anunciado | Posicionamiento oficial |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | Se ajusta a $1.50 / $7.50 a partir del 2027-01-01 | Modelo de alta relación calidad-precio de la generación anterior |
| Gemini 4 Hydrogen | $1.50 | $7.50 | Sin calendario público de ajuste escalonado por ahora | Programación diaria y ejecución de Agent |
| Gemini 4 Argon | $2.00 | $10.00 | Se ajusta a $4 / $20 a partir del 2026-12-01 | Razonamiento profundo complejo y de larga duración |
| Gemini 4 Carbon | $2.00 | $10.00 | Se ajusta a $4 / $20 a partir del 2026-12-01 | Razonamiento profundo complejo y de larga duración |
La unidad de precio en todos los casos es dólares por millón de tokens. Como se ve en la tabla, tanto el precio de entrada como el de salida de Hydrogen son exactamente el doble del precio actual de 3.8 Flash. Así que, para quien migra desde Flash, Hydrogen supone una subida de precio, no una rebaja del precio unitario.
En su cobertura, Ars Technica describe Hydrogen como el modelo que releva a la serie Flash, y eso fácilmente lleva a pensar que su precio también está en el rango de Flash. En realidad, su precio queda entre Flash y Argon/Carbon, en una franja intermedia.
Otros modos de facturación de Hydrogen
Además de la invocación estándar, Hydrogen maneja varios modos de facturación pensados para distintas exigencias de latencia:
- Invocación por lotes Batch / Flex: entrada $0.75, salida $3.75, exactamente la mitad del precio estándar.
- Invocación prioritaria Priority: entrada $2.70, salida $13.50.
- Entrada con acierto de caché implícita: $0.075 en invocación estándar, $0.0375 en Batch y Flex.
- Nivel gratuito de API: gratis, pero con límites de cuota. La documentación oficial indica que el contenido del nivel gratuito puede usarse para mejorar productos de Google, y que este nivel no incluye solicitudes gratuitas de Search Grounding.
Conviene señalar además que los precios de Google Cloud Agent Platform varían según la región. En regiones que no son Global, el precio estándar de Hydrogen es de $1.65 de entrada y $8.25 de salida, un 10% por encima del precio Global. Para mantener un criterio consistente, todas las comparaciones de este artículo usan los precios estándar de Google Gemini API y no mezclan las tarifas regionales de la plataforma empresarial.
Comparación de costos mensuales entre Gemini 4 Hydrogen y 3.8 Flash con el mismo volumen de negocio
Presupuesto mensual bajo un ejemplo unificado
La diferencia de precio unitario acaba reflejándose en la factura mensual. Aquí definimos una carga de ejemplo unificada: 1.000 llamadas al mes, con 8.000 tokens de entrada y 2.000 tokens de salida por llamada (incluidos los tokens de razonamiento), usando los precios estándar de la API, sin contar por ahora aciertos de caché, costos de herramientas ni reintentos.
La fórmula de cálculo es:
Costo mensual = (Tokens de entrada mensuales × Precio unitario de entrada + Tokens de salida mensuales × Precio unitario de salida) ÷ 1,000,000
Entrada mensual = 1,000 × 8,000 = 8,000,000 Token
Salida mensual = 1,000 × 2,000 = 2,000,000 Token
| Modelo | Cálculo | Presupuesto mensual al 2026-11-13 | Presupuesto tras los ajustes de precio ya anunciados |
|---|---|---|---|
| 3.8 Flash | 8 × 0.75 + 2 × 3.75 | $13.50 | $27.00 (a partir del 2027-01-01) |
| 4 Hydrogen | 8 × 1.50 + 2 × 7.50 | $27.00 | $27.00 |
| 4 Argon | 8 × 2.00 + 2 × 10.00 | $36.00 | $72.00 (a partir del 2026-12-01) |
| 4 Carbon | 8 × 2.00 + 2 × 10.00 | $36.00 | $72.00 (a partir del 2026-12-01) |
Este es un presupuesto de escenario calculado a partir de los precios oficiales, no una medición del consumo real de los modelos. Del cuadro se desprenden dos cosas: en noviembre, el gasto de Hydrogen es efectivamente el doble del de Flash; y según los hitos ya anunciados, para el 1 de enero de 2027 el precio unitario estándar de Flash igualará al del Hydrogen actual.
Impacto de los tokens de pensamiento, la caché, el procesamiento por lotes y la búsqueda en la factura de Gemini
El presupuesto anterior solo representa un escenario ideal; la factura real también se verá afectada por cuatro factores.
Primero, los tokens de pensamiento. El nivel de pensamiento predeterminado de Hydrogen es High (en 3.8 Flash, Medium), y los tokens de pensamiento se facturan al precio de salida. Si migras directamente sin ajustar el nivel, los tokens de salida probablemente aumentarán de forma notable. La evaluación independiente de Artificial Analysis muestra que, en los cuatro niveles Low, Medium, High y XHigh, el costo promedio de Hydrogen en tareas de referencia es de aproximadamente $0.29, $0.80, $1.87 y $3.16, respectivamente. Ten en cuenta que se trata de datos de sus tareas de evaluación estandarizadas y no equivalen al costo por una sola interacción en una conversación normal.
Segundo, la caché implícita. Supongamos que, de los 8,000 tokens de entrada de cada invocación, 6,000 son indicaciones de sistema fijas y prefijos de documentos (superan el umbral mínimo de 4,096 tokens) y todos aciertan en caché; entonces el costo mensual de Hydrogen sería: 2 × 1.50 + 6 × 0.075 + 2 × 7.50 = $18.45, alrededor de un tercio menos que $27. Esta es una derivación del editor basada en supuestos; la tasa real de aciertos debe verificarse con la factura.
Tercero, las invocaciones por lotes. Para tareas que no requieren respuesta en tiempo real, como análisis por lotes nocturnos, al cambiar a Batch, el costo mensual de ejemplo de Hydrogen baja a $13.50, igual al precio estándar de Flash.
Cuarto, las herramientas de búsqueda. En el nivel de pago, Google Search Grounding ofrece las primeras 5,000 solicitudes de búsqueda gratis cada mes (cuota compartida con Gemini 3 y modelos más recientes); al superarlas, se cobran $14 por cada 1,000 solicitudes, y una sola solicitud al modelo puede activar varias búsquedas. Las aplicaciones de tipo agente deben monitorear este apartado por separado.
🎯 Recomendación técnica: al evaluar costos, se recomienda usar el mismo conjunto de muestras reales de negocio para invocar los cuatro modelos por separado y registrar el campo usage de cada invocación. Con APIYI apiyi.com puedes usar una sola clave API y una interfaz compatible con OpenAI para alternar entre distintos modelos, reduciendo el trabajo de mantener varios SDK (los modelos disponibles concretos se consultan en la lista de modelos de la plataforma).
Cómo comparar con código el costo real de cuatro modelos Gemini
Ejemplo mínimo de invocación
El siguiente código invoca Hydrogen mediante la interfaz compatible con OpenAI e imprime el uso de tokens:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用三句话解释隐式缓存"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Presta atención a prompt_tokens y completion_tokens
Ver implementación completa: comparación por lotes del costo de cuatro modelos en una misma tarea
import openai

# Precio unitario: USD por millón de tokens, tarifa estándar de Google Gemini API, verificada el 2026-11-13
PRICES = {
    "gemini-3.8-flash":  (0.75, 3.75),
    "gemini-4-hydrogen": (1.50, 7.50),
    "gemini-4-argon":    (2.00, 10.00),
    "gemini-4-carbon":   (2.00, 10.00),
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_once(model: str, prompt: str) -> dict:
    """Invoca el modelo una vez y devuelve el uso y el costo estimado según el precio estándar"""
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    p_in, p_out = PRICES[model]
    # completion_tokens normalmente ya incluye los tokens de razonamiento; atente a los campos devueltos
    cost = (u.prompt_tokens * p_in + u.completion_tokens * p_out) / 1_000_000
    return {
        "model": model,
        "input": u.prompt_tokens,
        "output": u.completion_tokens,
        "cost_usd": round(cost, 6),
        "text": resp.choices[0].message.content,
    }

def compare(prompt: str, check) -> None:
    """check: función que determina si la salida completó la tarea con éxito"""
    for model in PRICES:
        try:
            r = run_once(model, prompt)
            ok = check(r["text"])
            print(f'{r["model"]:20} in={r["input"]:6} out={r["output"]:6} '
                  f'cost=${r["cost_usd"]:.5f} success={ok}')
        except Exception as e:
            print(f"{model:20} error: {e}")

if __name__ == "__main__":
    compare(
        "写一个 Python 函数,解析 ISO8601 日期并处理时区,附带单元测试",
        check=lambda t: "def " in t and "assert" in t,
    )
El valor de este script está en registrar juntos “si tuvo éxito” y “cuánto costó”. Con solo mirar el precio unitario no se llega a ninguna conclusión; tiene sentido como referencia cuando se ejecuta cada modelo varias decenas de veces y se calcula el costo promedio por éxito.
🚀 Inicio rápido: los nuevos usuarios pueden registrarse en APIYI apiyi.com, obtener crédito de prueba gratuito, ejecutar el script de comparación anterior con sus propias indicaciones reales y luego decidir qué modelo usar en producción.
Gemini 4 Hydrogen cuesta el doble: cuándo sigue mereciendo la pena usarlo
Del precio unitario al costo por tarea exitosa
Para tareas que requieren ejecución en varios pasos, lo que realmente hay que comparar es el costo esperado por tarea completada con éxito:
Costo por intento C = (T_in × P_in + T_out × P_out) ÷ 10^6
Costo por éxito = C ÷ tasa de éxito por intento
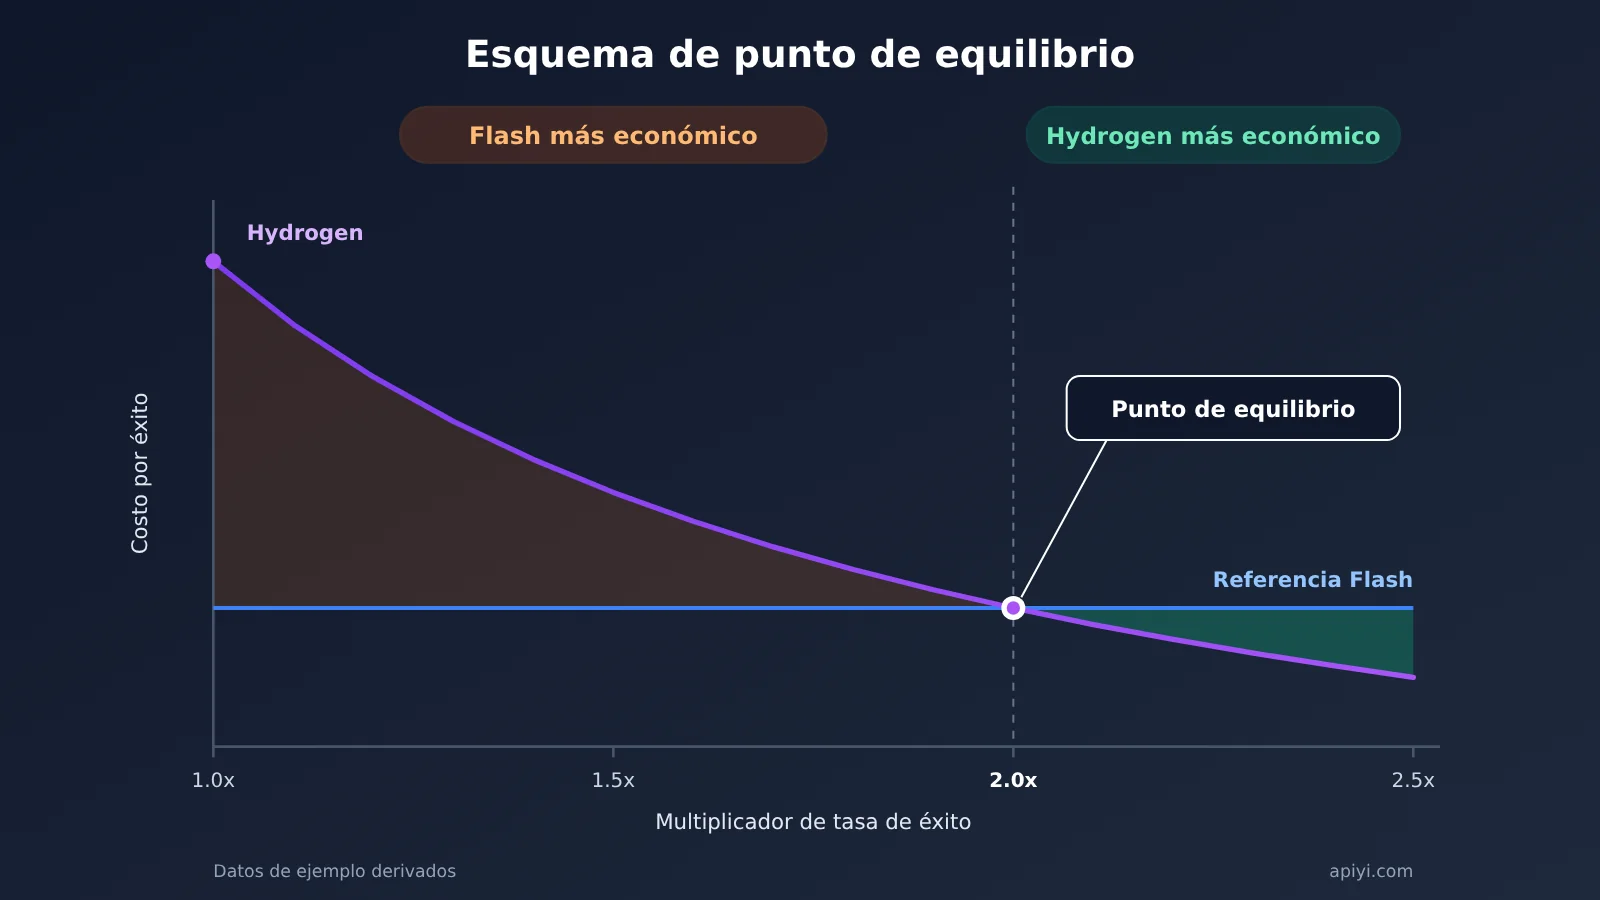
Con los precios de noviembre de 2026, el costo por token de Hydrogen es exactamente el doble del de Flash, de lo que se pueden deducir dos condiciones de equilibrio:
- Si ambos tienen la misma tasa de éxito, Hydrogen necesita reducir alrededor del 50 % el total de tokens facturados para que el costo se mantenga igual.
- Si ambos consumen la misma cantidad de tokens por intento, la tasa de éxito por intento de Hydrogen debe ser el doble de la de Flash para que el costo esperado por éxito sea igual.
A continuación, un ejemplo de derivación editorial; todas las tasas de éxito son valores hipotéticos, no resultados medidos:
| Escenario hipotético | Costo por intento | Tasa de éxito supuesta | Costo esperado por éxito |
|---|---|---|---|
| Flash procesa una tarea de agente de varios pasos | $0,0135 | 40 % | $0,0338 |
| Hydrogen procesa la misma tarea | $0,0270 | 80 % | $0,0338 (igual) |
| Hydrogen procesa la misma tarea | $0,0270 | 90 % | $0,0300 (más económico) |
| Flash procesa una tarea de clasificación simple | $0,0135 | 95 % | $0,0142 |
| Hydrogen procesa una tarea de clasificación simple | $0,0270 | 98 % | $0,0276 (casi el doble) |
La conclusión es directa: en tareas simples que Flash ya resuelve bien, el costo adicional de Hydrogen básicamente no se recupera; en tareas complejas donde Flash falla a menudo y requiere reintentos repetidos, Hydrogen tiene la oportunidad de igualar el costo o incluso reducirlo.
Qué revelan los datos oficiales de rendimiento
Los datos publicados por Google muestran que Hydrogen obtiene 57,0 % en Terminal-Bench 4.1, mientras que 3.8 Flash obtiene 18,2 %. La empresa también afirma que, en las mismas condiciones de prueba, la velocidad de finalización de tareas es aproximadamente 2,5 veces mayor y que la frecuencia con la que inventa datos se reduce más de 5 veces. En datos divulgados por socios, Box reduce el uso de tokens un 12 % en tareas de documentos empresariales, y STAN reduce su uso total de tokens un 23 %.
Estas cifras deben interpretarse con cautela. Son resultados de pruebas oficiales o de socios, y no pueden convertirse directamente en tu porcentaje de ahorro de costos. El ahorro de tokens de entre el 12 % y el 23 % sigue estando muy lejos del umbral de equilibrio del 50 %, por lo que la posibilidad de que Hydrogen ahorre dinero depende principalmente de la mejora de la tasa de éxito, no del ahorro de tokens. Además, la mayor velocidad puede reducir los tiempos de espera y el uso de máquinas, pero eso no se descuenta directamente de la factura de API.
Recomendaciones de escenarios para Gemini 4 Hydrogen, Flash, Argon y Carbon
Escenarios en los que elegir 3.8 Flash
- Tareas de procesamiento masivo con flujos estables: por ejemplo, clasificación de textos, extracción de campos, resúmenes o conversión de formatos. Flash ya tiene de por sí una alta tasa de éxito en este tipo de tareas, y usar Hydrogen solo haría que la factura se duplicara.
- Negocios sensibles al precio que toleran algún reintento ocasional: antes del 31 de diciembre de 2026, Flash es el modelo con el precio unitario más bajo de estos cuatro.
Escenarios en los que elegir Gemini 4 Hydrogen
- Generación y depuración de código: la documentación oficial insiste en que edita con precisión y evita tocar código que no viene al caso, lo que lo hace adecuado para corregir bugs, actualizar dependencias o ejecutar pruebas.
- Ejecución de agentes en varios pasos: llamar a herramientas de forma consecutiva, recuperar información en paralelo o ajustar la estrategia cuando una herramienta falla; estas son sus áreas de especialización.
- Procesamiento de documentos complejos: admite formatos como PDF, Word, Excel y PPT, y en una sola solicitud puede incluir hasta 3000 imágenes o documentos.
- Ejecutor dentro de sistemas multimodelo: Carbon o Argon se encargan de la planificación, y Hydrogen se encarga de la ejecución y la verificación sobre el terreno.
Escenarios en los que elegir Argon o Carbon
Google sitúa a Argon y Carbon en el terreno de las tareas de razonamiento profundo, complejo y prolongado, y la documentación de referencia no detalla diferencias más finas entre ambos. Según el reparto de funciones propuesto en este artículo, Argon encaja en trabajos complejos que exigen un razonamiento bastante profundo y a la vez valoran la eficiencia; Carbon encaja en diseño de arquitecturas, razonamiento de alta dificultad y proyectos de larga duración. El flujo de Antigravity Orchestrator que Google describe oficialmente sigue ese mismo reparto: Carbon analiza el repositorio y elabora un plan, Hydrogen ejecuta la edición y las pruebas, y cuando aparece un error complejo se lo devuelve a Carbon. La compañía afirma que este enfoque reduce de media el consumo de cuota un 24 % frente a usar Carbon por sí solo, y aumenta la velocidad de finalización un 19 %.
| Tipo de tarea | Modelo prioritario | Consideración de coste | Plataformas disponibles |
|---|---|---|---|
| Tareas por lotes como clasificación, extracción o resúmenes | 3.8 Flash | Precio unitario más bajo y tasa de éxito ya suficiente | Google oficial, APIYI apiyi.com |
| Programación diaria y corrección de bugs | 4 Hydrogen | La mejora en la tasa de éxito compensa el precio unitario 2 veces mayor | Google oficial, APIYI |
| Agentes de varios pasos y llamadas a herramientas | 4 Hydrogen | Menos reintentos y menos pasos de ejecución | Google oficial, APIYI |
| Razonamiento complejo con foco en la eficiencia | 4 Argon | El precio unitario se duplica después del 1 de diciembre | Google oficial, APIYI |
| Diseño de arquitecturas e ingeniería de largo plazo | 4 Carbon | Se recomienda combinarlo con Hydrogen para repartir la ejecución | Google oficial, APIYI |
La disponibilidad real de los modelos en APIYI se rige por la lista de modelos de la plataforma.
Recomendaciones de decisión tras el ajuste de precios de Gemini 4 Hydrogen
Cómo los dos hitos de ajuste de precios cambian la selección de modelos
| Periodo | Flash | Hydrogen | Argon / Carbon | Panorama de selección |
|---|---|---|---|---|
| 2026-11-13 a 11-30 | $0.75 / $3.75 | $1.50 / $7.50 | $2 / $10 | La diferencia de precio entre Hydrogen y Argon/Carbon es pequeña |
| 2026-12-01 a 12-31 | $0.75 / $3.75 | $1.50 / $7.50 | $4 / $20 | Argon/Carbon pasa a costar 2.67 veces lo de Hydrogen |
| A partir de 2027-01-01 | $1.50 / $7.50 | $1.50 / $7.50 | $4 / $20 | Flash pierde su ventaja de precio y queda al mismo nivel que Hydrogen |
Esta tabla deja claros dos puntos de planificación. A corto plazo, en noviembre Argon/Carbon cuesta solo alrededor de un tercio más que Hydrogen, así que las tareas que requieren razonamiento profundo pueden concentrarse y ejecutarse en este periodo. A medio plazo, a partir de enero del próximo año, Flash y Hydrogen tendrán el mismo precio unitario; Hydrogen, al ser más capaz, será la opción predeterminada más razonable en la mayoría de escenarios, siempre que Google no anuncie nuevos ajustes de precios durante este periodo.
Comprobaciones de compatibilidad antes de migrar a Hydrogen
Al migrar de 3.8 Flash a Hydrogen, las siguientes configuraciones no se pueden reutilizar tal cual; de lo contrario, pueden producirse errores o costos descontrolados:
- Los niveles
thinking_budgetyMINIMALya no son compatibles; usarlos devuelve HTTP 400. - El nivel de pensamiento predeterminado pasa de Medium a High, por lo que conviene evaluar activamente si reducirlo.
- Los valores personalizados de temperature, top_p y top_k se ignorarán.
- No se admite la caché explícita; hay que pasar a depender de la caché implícita y colocar el contenido fijo al principio de la indicación.
- En las llamadas de herramientas de varios turnos, es necesario guardar y reenviar correctamente las thought signatures.
💡 Recomendación de elección: no cambies todo de golpe basándote solo en el nombre del modelo. Conviene dividir el tráfico por tipo de tarea y medir por separado el costo de cada éxito. Con la interfaz unificada de APIYI apiyi.com, basta modificar el parámetro model para hacer una comparación A/B entre los cuatro modelos, lo que facilita definir una estrategia de enrutamiento basada en datos.
Preguntas frecuentes (FAQ)
Q1: ¿Qué tipo de modelo es Gemini 4 Hydrogen?
Hydrogen es un modelo publicado por Google DeepMind el 12 de noviembre de 2026, con ID de API `gemini-4-hydrogen`, orientado a la programación diaria de alta eficiencia y a la ejecución de AI Agents. La model card oficial indica que se adaptó a partir de Gemini 4 Carbon. El total de contexto es de 1,048,576 Tokens, compartido entre entrada, razonamiento y salida.
Q2: ¿Cuánto más caro es Gemini 4 Hydrogen que 3.8 Flash?
Según la tarifa estándar de Google Gemini API del 13 de noviembre de 2026, el precio de entrada y de salida de Hydrogen es el doble que el de 3.8 Flash ($1.50 / $7.50 frente a $0.75 / $3.75). Con la carga de ejemplo de este artículo, el coste mensual es de $27 y $13.50, respectivamente.
Q3: ¿Cuándo subirán de precio Argon y Carbon?
La página oficial de precios indica que Argon y Carbon pasarán de $2 / $10 a $4 / $20 a partir del 1 de diciembre de 2026. 3.8 Flash se ajustará a $1.50 / $7.50 a partir del 1 de enero de 2027. Hydrogen no tiene por ahora ningún ajuste escalonado de precios publicado.
Q4: ¿Qué nivel de razonamiento de Hydrogen es el más rentable?
La recomendación oficial es: Low para clasificación, Medium para programación convencional, High para Agents de múltiples pasos, XHigh para razonamiento profundo complejo. Los datos de Artificial Analysis muestran que XHigh solo supera a High en 3 puntos del índice de inteligencia (54 frente a 51), pero el coste medio por tarea de benchmark sube de $1.87 a $3.16. Por eso, en la mayoría de escenarios no conviene activar XHigh por defecto.
Q5: ¿Cómo comparar rápidamente el gasto real de los cuatro modelos Gemini?
La forma más sencilla es usar una interfaz agregada que admita múltiples modelos:
1. Regístrate en APIYI apiyi.com, obtén la clave API y el crédito de prueba gratuito;
2. Configura `base_url` en `https://api.apiyi.com/v1` en el código de este artículo;
3. Ejecuta el script de comparación con tus propias muestras de tareas reales y contabiliza el coste de cada ejecución exitosa.
Q6: ¿Qué deficiencias conocidas tiene Hydrogen?
La model card oficial enumera estos problemas: todavía puede generar alucinaciones; el conocimiento tiene corte en marzo de 2026; en comparación con 3.8 Flash, el indicador de rechazos injustificados empeoró 5.57 puntos porcentuales; el informe de seguridad completo aún no se había publicado en el momento de la verificación. En la fase inicial del lanzamiento, algunos usuarios también reportaron problemas de despliegue, como la desaparición de opciones del modelo y fallos de invocación; en Hacker News, un usuario mencionó que en algunas tareas de Agents presenta sobre-ejecución.
Q7: ¿Cómo pueden los equipos en China hacer pruebas estables de selección de modelos Gemini?
Google aplica una estrategia de despliegue gradual, por lo que los tiempos de disponibilidad pueden variar según la región y la cuenta. Para equipos que necesitan comparar al mismo tiempo Gemini, Claude, GPT y otros modelos, se puede acceder de forma unificada a través de APIYI apiyi.com mediante la interfaz compatible con OpenAI, con facturación por uso, de modo que los scripts de prueba no tienen que reescribirse para cada proveedor.
Gemini 4 Hydrogen comparación de precios: puntos clave
- Precio unitario duplicado: el precio unitario estándar actual de Hydrogen es el doble del de 3.8 Flash; se trata de una subida de precio, no de una bajada.
- Franja intermedia: el precio de Hydrogen es inferior al de Argon y Carbon, y tras diciembre la diferencia se amplía a 2,67 veces.
- Punto de equilibrio: solo si los tokens se reducen a la mitad o la tasa de éxito por operación se duplica, el coste de Hydrogen puede igualarse al de Flash.
- Variables de la factura: los tokens de pensamiento, la caché implícita, el modo Batch y el número de búsquedas alteran significativamente el coste real.
- Fechas de ajuste de precios: el 2026-12-01 suben Argon/Carbon; el 2027-01-01 Flash y Hydrogen igualan su precio.
- Método de validación: utilice muestras reales para calcular el coste por éxito y compare los cuatro modelos mediante la interfaz unificada de APIYI.
Conclusión
Los puntos clave para elegir entre Gemini 4 Hydrogen, 3.8 Flash, Argon y Carbon son los siguientes:
- Fíjese en el precio unitario: en noviembre Flash es el más barato, Hydrogen cuesta el doble, Argon y Carbon son más caros y duplicarán su precio el 1 de diciembre.
- Fíjese en el coste por éxito: para tareas sencillas, siga usando Flash; para programación y Agent, donde Flash falla con facilidad, puede evaluar el cambio a Hydrogen; el razonamiento profundo déjelo a Argon o Carbon y la ejecución a Hydrogen.
- Fíjese en la línea temporal: la planificación presupuestaria debe tener en cuenta las dos fechas de ajuste de precios; a partir de 2027 es muy probable que Hydrogen se convierta en la opción predeterminada por relación calidad-precio.
Esta elección es, en esencia, un equilibrio entre coste y valor de la tarea. El precio unitario se puede consultar directamente, pero la tasa de éxito de las tareas solo se puede medir con sus propios datos. Se recomienda ejecutar primero una ronda de comparación con tareas reales usando la cuota gratuita de APIYI apiyi.com, y luego definir la estrategia de enrutamiento de modelos según los resultados.
📚 Referencias
- Blog oficial de Google: presentación de Gemini 4 Hydrogen: anuncio de lanzamiento y casos de socios
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Descripción: posicionamiento oficial y comparación de rendimiento con 3.8 Flash
-
Precios oficiales de la API Gemini de Google: precios estándar de las cuatro versiones del modelo y puntos de ajuste de precios
- Enlace:
aistudio.google.com/docs/pricing -
Descripción: fuente de todos los precios de este artículo, verificados el 2026-11-13
-
Ficha del modelo de Google DeepMind: capacidades, limitaciones y evaluación de seguridad de Hydrogen
- Enlace:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Descripción: datos de evaluación comparativa entre modelos y limitaciones conocidas
-
Documentación técnica de Google Cloud: especificaciones de la API y consideraciones de migración
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Descripción: límites de contexto, reglas de caché y compatibilidad de parámetros
-
Precios regionales de Google Cloud: diferencia de precio entre Global y Non-global
- Enlace:
cloud.google.com/model-garden/pricing -
Descripción: referencia de precios regionales de la plataforma empresarial en la nube
-
Artificial Analysis: evaluación independiente de los cuatro niveles de pensamiento de Hydrogen
- Enlace:
artificialanalysis.ai/models/gemini-4-hydrogen -
Descripción: índice de inteligencia, tiempo de ejecución y costo por tarea de referencia de cada nivel
-
Blog de Google Antigravity: orquestación multimodelo con Orchestrator
- Enlace:
antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity - Descripción: datos oficiales sobre la colaboración y reparto de tareas entre Carbon e Hydrogen
Autor: Equipo técnico de APIYI
Consultas técnicas: Puedes contactarnos en la página principal de APIYI (apiyi.com); para más material de integración, visita el centro de documentación docs.apiyi.com