Anmerkung des Autors: Bei der Migration von Gemini 3.8 Flash auf Hydrogen müssen gleichzeitig SDK und Kontext, Thinking-Parameter, Sampling-Konfiguration, Caching sowie die Signaturverwaltung bei mehrrundigen Tool-Aufrufen angepasst werden.
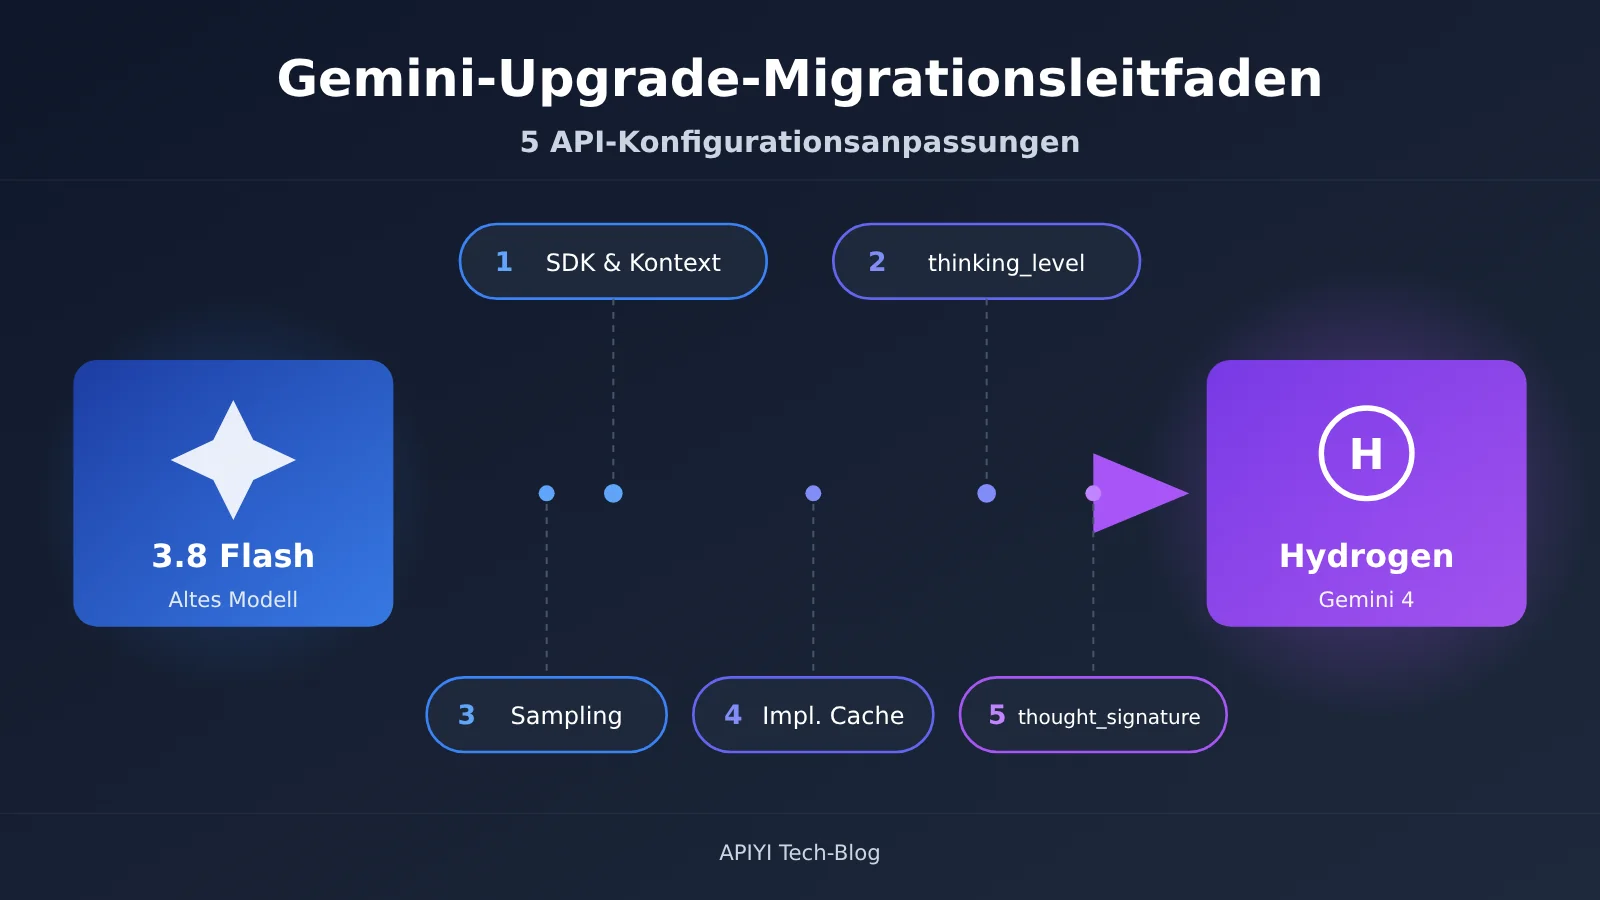
Google hat am 12. November 2026 Gemini 4 Hydrogen offiziell veröffentlicht; die API-Modell-ID lautet gemini-4-hydrogen, positioniert für alltägliche Programmierarbeit und die Ausführung von KI-Agenten. Viele Teams ersetzen als erste Reaktion den Modellnamen im Code und gehen live – und stoßen dann auf HTTP 400, wirkungslose Parameter, Fehler bei mehrrundigen Tool-Aufrufen und abgeschnittene lange Ausgaben. Dieser Artikel fasst die 5 API-Konfigurationen zusammen, die bei einem Upgrade von Gemini 3.8 Flash auf Hydrogen angepasst werden müssen; jede wird in der Reihenfolge „altes Verhalten → neues Verhalten → Änderungsmethode → typische Auswirkung“ erläutert.
Dies ist keine Nacherzählung der Produktankündigung. Die im Text genannten Parameternamen, zulässigen Werte, SDK-Versionsnummern und Fehlertypen stammen aus dem offiziellen Migrationsleitfaden von Google Cloud sowie aus den Modellspezifikationsdokumenten; Bewertungen von Drittanbietern und Community-Rückmeldungen werden mit separater Quellenangabe versehen.
Der zentrale Nutzen: Nach dem Lesen dieses Artikels können Sie mit einer Checkliste den vorhandenen Gemini-3.8-Flash-Aufrufcode Punkt für Punkt anpassen und Agent- sowie Batch-Prozesse reibungslos auf Hydrogen migrieren.
Die 5 Begriffe, die Sie bei der Hydrogen-Migration kennen müssen
Bevor Sie Änderungen vornehmen, sollten wir zunächst einige Begriffe vereinheitlichen, die in der Migrationsanleitung immer wieder auftauchen:
- thinking_level: Parameter für die Denkstufe, der die Tiefe der Modellinferenz steuert. Hydrogen ersetzt damit das alte
thinking_budget; zulässige Stufen sind Low, Medium, High und XHigh. - thought_signature: Signatur zur Verknüpfung des Denkprozesses, die das Modell in der Antwort zurückgibt. Bei mehrstufigen Dialogen und Tool-Aufrufen muss sie unverändert beibehalten und zurückgesendet werden, sonst kann das Modell den vorherigen Inferenzzustand nicht fortsetzen.
- continuation_token: Fortsetzungs-Token, mit dem sich der nächste Abschnitt einer langen Ausgabe anschließen lässt. Wenn ein einzelner Ausgabeblock das Limit erreicht, kann damit weiter generiert werden.
- Impliziter Cache: Die Plattform verwendet automatisch Eingabepräfixe wieder, die die Bedingungen erfüllen; der getroffene Teil wird zum Cache-Preis abgerechnet, ohne dass Entwickler manuell ein Cache-Objekt anlegen müssen.
- Kontextfenster: Der Informationsumfang, den ein einzelner Modellaufruf verarbeiten kann. Bei Hydrogen teilen sich Eingabe, Ausgabe, Denkprozess und Tool-Aufrufe gemeinsam das einheitliche Budget von 1,048,576 Tokens.
1. Warum ein Upgrade auf Hydrogen nicht nur den Austausch der Modell-ID erfordert
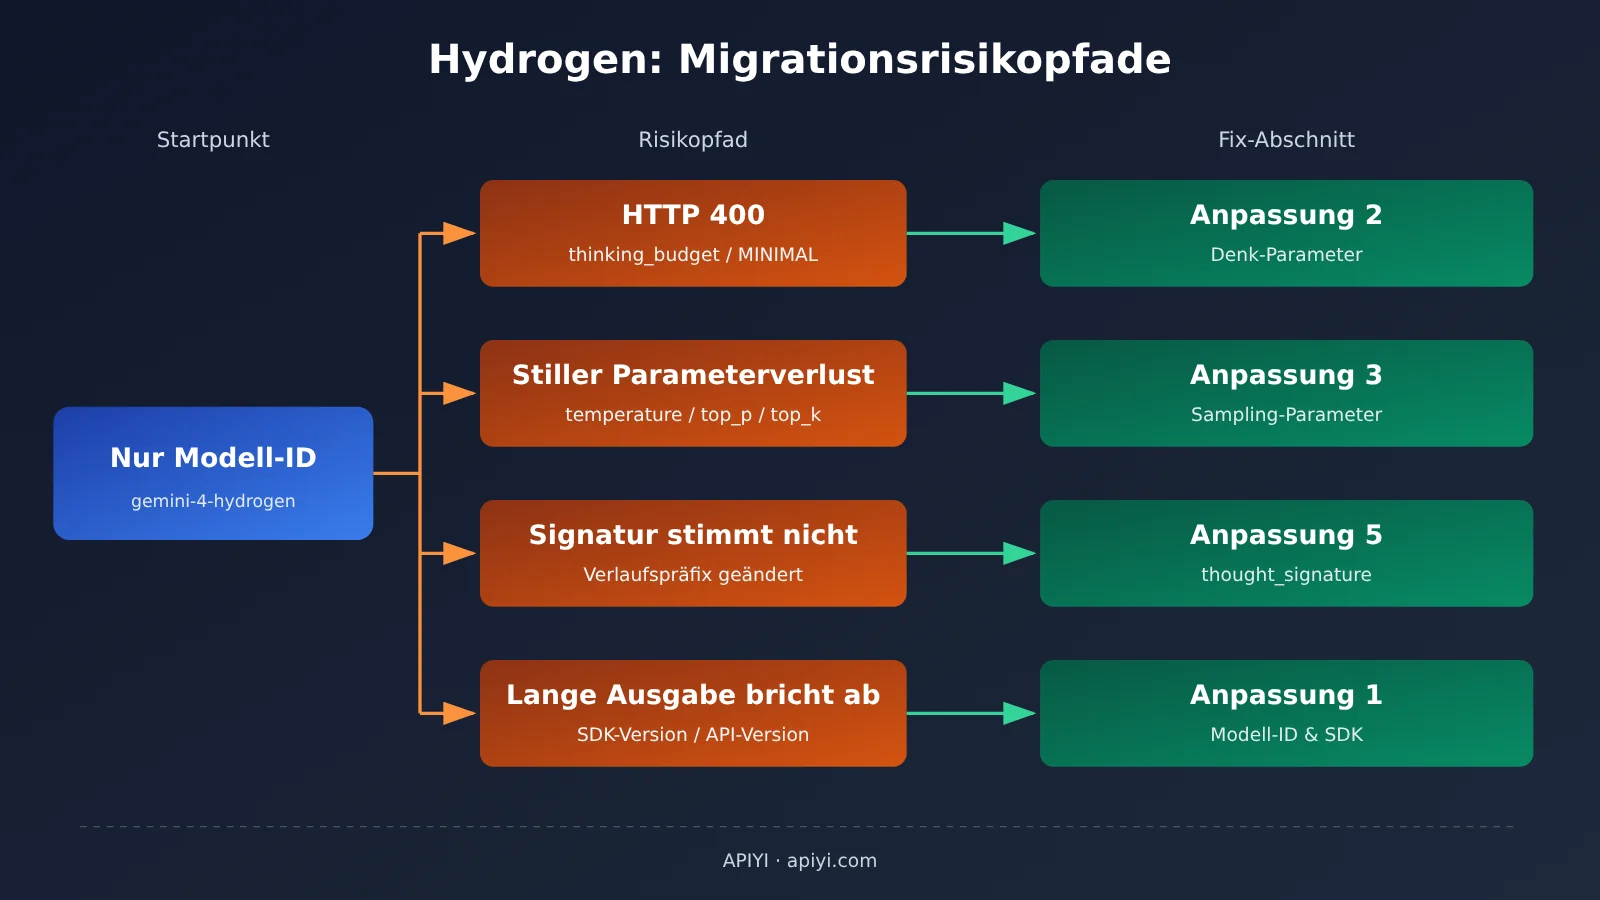
Gemini 3.8 Flash und Hydrogen gehören zwar beide zur Gemini-Familie, aber ihr API-Verhalten ist an mehreren Stellen inkompatibel. Laut offizieller Migrationsanleitung werden thinking_budget und die Denkstufe MINIMAL auf Hydrogen nicht unterstützt; die Anfrage liefert direkt HTTP 400 zurück. Sampling-Parameter wie temperature, top_p und top_k führen dagegen nicht zu einem Fehler, sondern werden stillschweigend ignoriert. Die erste Art von Problem fällt schon in der Testphase auf; bei der zweiten könnte man fälschlich annehmen, die Parameter würden noch wirken.
Darüber hinaus sind zwei weitere Risikokategorien schwerer zu erkennen. Erstens ist die Signaturverwaltung bei mehrstufigen Tool-Aufrufen strenger: Wenn der bisherige Dialog komprimiert oder gekürzt wurde, kann eine Signatur, die nicht zum Präfix passt, HTTP 400 auslösen. Zweitens wurde die Standard-Denkstufe von Medium auf High angehoben. Ohne explizite Einstellung verbraucht dieselbe Anfrage mehr Denk-Tokens und hat eine höhere Latenz. Die folgende Tabelle gibt einen Überblick über die fünf Anpassungen:
| Anpassung | Altes Verhalten (3.8 Flash) | Neues Verhalten (Hydrogen) | Folge, wenn nicht angepasst |
|---|---|---|---|
| Modell-ID, SDK und Kontext | Alte Modell-ID, alte SDK-Version nutzbar | gemini-4-hydrogen, für das Fortsetzen langer Ausgaben gilt eine Mindest-SDK-Version |
Lange Ausgaben brechen ab, Fortsetzen nicht verfügbar |
| Denkparameter | thinking_budget, Standard Medium |
thinking_level, Standard High |
HTTP 400 oder steigende Kosten und Latenz |
| Sampling- und Generierungsparameter | temperature, top_p, top_k usw. anpassbar | Festwerte, benutzerdefinierte Werte werden ignoriert; bestimmte Felder müssen entfernt werden | Ausgabestil nicht steuerbar, einige Anfragen schlagen bei der Validierung fehl |
| Cache | expliziter Cache cached_content unterstützt |
nur impliziter Cache, Mindestgröße 4,096 Tokens | Cache-Referenz ungültig, Kostenkalkulation weicht ab |
| thought_signature | Signaturregeln relativ locker | strenge Regeln für parallele Aufrufe und Präfixänderungen | mehrstufige Agenten melden Fehler oder die Inferenzkette bricht ab |
II. Anpassung 1: Modell-ID, SDK-Versionen und Kontextlimits bei Hydrogen
Altes Verhalten → Neues Verhalten: In der 3.8-Flash-Ära waren die meisten Projekte gegenüber der SDK-Version unempfindlich. Nach der Migration zu Hydrogen muss die Modell-ID auf gemini-4-hydrogen geändert werden; braucht man extrem lange Ausgaben, wird die SDK-Version zur harten Voraussetzung. Die offizielle Migrationsanleitung von Google nennt folgende Mindestversionen:
| Entwicklungssprache | GenerateContent automatische Fortsetzung | Interactions API automatische Fortsetzung |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | offiziell nicht separat aufgeführt | >= 1.77.0 |
| Java | offiziell nicht separat aufgeführt | >= 1.80.0 |
So passt man Kontext und lange Ausgaben bei Hydrogen an
Die 1,048,576 Tokens von Hydrogen sind ein einheitliches Kontingent: Eingaben samt Verlaufskontext, Thinking-Tokens, Tokens für Tool-Aufrufe und die finale Ausgabe werden alle aus diesem einen Pool abgezogen. Man kann also nicht zuerst eine Million Tokens eingeben und dann zusätzlich eine Million Tokens ausgeben. Bei Agents zur Analyse langer Dokumente muss man auf der Eingabeseite aktiv Platz für Thinking und Tool-Aufrufe einplanen.
Die Obergrenze für eine einzelne Vordergrundgenerierung liegt üblicherweise bei 65,536 Tokens. Wird diese Länge überschritten, gibt es drei Optionen: die automatische Fortsetzung mit einem unterstützten SDK, das Setzen von background=true in der Interactions API für eine lange Hintergrundgenerierung oder das eigene Verwalten eines continuation_token zum stückweisen Zusammensetzen. Besonders zu beachten: Die offizielle Einführungsdokumentation weist darauf hin, dass die Fortsetzung langer Ausgaben derzeit die v1beta1-API erfordert; die v1 der Agent Platform unterstützt diese Funktion nicht.
Typische Auswirkungen: Geschäftsprozesse, die in großem Umfang lange Berichte oder lange Codedateien generieren, tappen am ehesten in die Falle. Empfehlung: zuerst das SDK aktualisieren, dann die API-Version auf v1beta1 umstellen und schließlich mit einer Anfrage über 65,536 Tokens einen Regressionstest durchführen.
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
3. Anpassung 2: thinking_budget bei Hydrogen wird zu thinking_level
Bisheriges Verhalten: 3.8 Flash steuerte die Denklänge über thinking_budget anhand der Token-Anzahl; zusätzlich ließ sich die Stufe MINIMAL wählen, Standard war Medium.
Neues Verhalten: Hydrogen akzeptiert nur noch thinking_level mit den gültigen Werten Low, Medium, High und XHigh, Standard ist High. Wer weiterhin thinking_budget oder MINIMAL übergibt, bekommt HTTP 400 zurück. Die offiziell empfohlenen Einsatzzwecke sind: Low für Klassifikation, Medium für reguläre Programmierung, High für mehrstufige Agenten, XHigh für komplexes, tiefgehendes Reasoning.
Das unabhängige Analysehaus Artificial Analysis hat am 12. November eine eigene Bewertung aller vier Stufen durchgeführt (Intelligence Index v5.0.1), die hilft, die Unterschiede zwischen den Stufen einzuordnen. Die Zeiten und Kosten in der folgenden Tabelle sind Mittelwerte über die standardisierten Evaluierungsaufgaben und geben nicht die tatsächlichen Kosten einer einzelnen Unterhaltung eines normalen Nutzers wieder:
| Denkstufe | Offiziell empfohlener Einsatzzweck | Intelligenzindex (AA) | Ø Dauer der Evaluierung | Ø Kosten der Evaluierung |
|---|---|---|---|---|
| Low | Klassifikation, einfache Extraktion | 27 | 1,3 Minuten | $0,29 |
| Medium | Reguläre Programmierung | 41 | 3,7 Minuten | $0,80 |
| High (Standard) | Mehrstufige Agenten | 51 | 8,3 Minuten | $1,87 |
| XHigh | Komplexes, tiefgehendes Reasoning | 54 | 13,5 Minuten | $3,16 |
Aus den Daten geht hervor: High liegt zehn Punkte über Medium, während XHigh nur drei Punkte über High liegt – die Evaluierungskosten steigen dabei aber von 1,87 US-Dollar auf 3,16 US-Dollar. Das zeigt, dass die höchste Stufe nicht zwangsläufig die günstigste Wahl ist und dasselbe Modell je nach Stufe deutlich unterschiedlich leistungsfähig sein kann.
Hydrogen thinking_level – Beispiel für die Änderung
Die folgenden Beispiele verwenden die Syntax des offiziellen Google Gen AI SDK. Ob die Enum-Werte groß- oder kleingeschrieben werden, richtet sich nach den Typdefinitionen der installierten SDK-Version:
from google import genai
from google.genai import types

client = genai.Client()

# Alte Schreibweise (3.8 Flash): liefert bei Hydrogen HTTP 400
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# Neue Schreibweise: Medium für reguläre Programmieraufgaben
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# High für mehrstufige Agenten (auch der Standardwert, besser explizit angeben)
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="修复这个函数中的空指针问题:...",
    config=coding_config,
)
print(resp.text)
Typische Auswirkung: Da Thinking-Token zum Ausgabepreis abgerechnet werden, landen Projekte, die die Stufe nicht explizit setzen, nach der Migration automatisch auf High – Rechnung und Latenz steigen. Es empfiehlt sich, die alten thinking_budget-Bereiche auf Stufen abzubilden: kleinere Budgets entsprechen Low oder Medium, größere Budgets High.
4. Anpassung 3: Ungültige Generierungsparameter in Hydrogen bereinigen
Altes Verhalten: 3.8 Flash erlaubte es, die Zufälligkeit der Ausgabe über temperature, top_p und top_k zu steuern, und unterstützte außerdem Penalty-Parameter sowie mehrere Kandidatenausgaben.
Neues Verhalten: Bei Hydrogen liegt die Standardtemperatur bei 1.0, und eigene Werte bleiben wirkungslos; top_p ist fest auf 0.95 gesetzt, top_k fest auf 64. Diese drei Parameter werden nach dem Übergeben einfach ignoriert. Die offizielle Migrationsliste verlangt zusätzlich, folgende Felder zu behandeln:
| Feld oder Verhalten | Migrationsanforderung für Hydrogen | Hinweis zur Fehlersuche |
|---|---|---|
| temperature / top_p / top_k | Eigene Werte werden ignoriert | Keine Fehlermeldung – der Stil muss über die Eingabeaufforderung gesteuert werden |
| frequency_penalty / presence_penalty | Entfernen | Orientierung an der tatsächlichen Fehlermeldung; einheitliches Löschen ist am sichersten |
| candidate_count > 1 | Einstellung für mehrere Kandidaten entfernen | Wenn Vielfalt gebraucht wird, stattdessen mehrere Anfragen senden |
| Vorab gefüllte model-Gesprächsrunden | Entfernen | Das Format lässt sich nicht mehr über „dem Modell einen Anfang vorgeben“ steuern |
| cached_content | Keine explizite Cache-Referenz mehr | Siehe Anpassung 4 |
| thinking_budget | Auf ein gültiges thinking_level umstellen | Liefert HTTP 400 zurück |
Die offizielle Dokumentation weist ausdrücklich darauf hin, dass einige alte Parameter lediglich ignoriert werden, andere dagegen die Anfragevalidierung scheitern lassen. Deshalb darf die Fehlersuche nicht pauschal ausfallen: Bei einem 400 prüft man zuerst thinking_budget, MINIMAL und die zu entfernenden Felder; passt der Ausgabestil nicht zu den Erwartungen, prüft man, ob noch auf Temperaturparameter vertraut wird.
Vereinfachte Anfragekonfiguration für Hydrogen
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # Stabile Inhalte nach vorne, das unterstützt das implizite Caching
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # Strukturierte Ausgabe wird weiterhin unterstützt
    max_output_tokens=8192,
)
Typische Auswirkung: Projekte, die bisher auf eine niedrige Temperatur vertraut haben, um stabile JSON-Ausgaben zu gewährleisten, sollten auf die strukturierte Ausgabe umsteigen; Projekte, die das Format über vorab gefüllte model-Gesprächsrunden gesteuert haben, müssen die Formatvorgaben in die System-Eingabeaufforderung schreiben.
5. Anpassung 4: Hydrogen – aus explizitem Caching wird implizites Caching
Bisheriges Verhalten: Bei 3.8 Flash konnten Entwickler zuerst ein Cache-Objekt anlegen und es anschließend in der Anfrage über cached_content="cachedContents/xxx" referenzieren.
Neues Verhalten: Hydrogen unterstützt kein explizites Kontext-Caching mehr, sondern nur noch implizites Caching – und der persistente implizite Cache-Mechanismus ist standardmäßig aktiv. Die Mindest-Präfixlänge für einen Cache-Treffer sinkt von 6,144 Tokens bei 3.8 Flash auf 4,096 Tokens. Dadurch treffen auch relativ kurze gemeinsame System-Eingabeaufforderungen und festes Wissensmaterial häufiger.
So passen Sie es an: Entfernen Sie sämtliche caches.create-Aufrufe und alle cached_content-Referenzen und optimieren Sie stattdessen die Reihenfolge, in der die Eingabeaufforderung zusammengesetzt wird. Google empfiehlt, stabile gemeinsame Inhalte an den Anfang des Inputs zu stellen und die jeweils wechselnde Nutzerfrage ans Ende:
- System-Eingabeaufforderung und Rollendefinition (nahezu unverändert)
- Gemeinsame Wissensbasis, API-Dokumentation, Code-Richtlinien (ändern sich selten)
- Gesprächsverlauf (wird Runde für Runde ergänzt)
- Aktuelle Nutzerfrage (ändert sich bei jedem Aufruf)
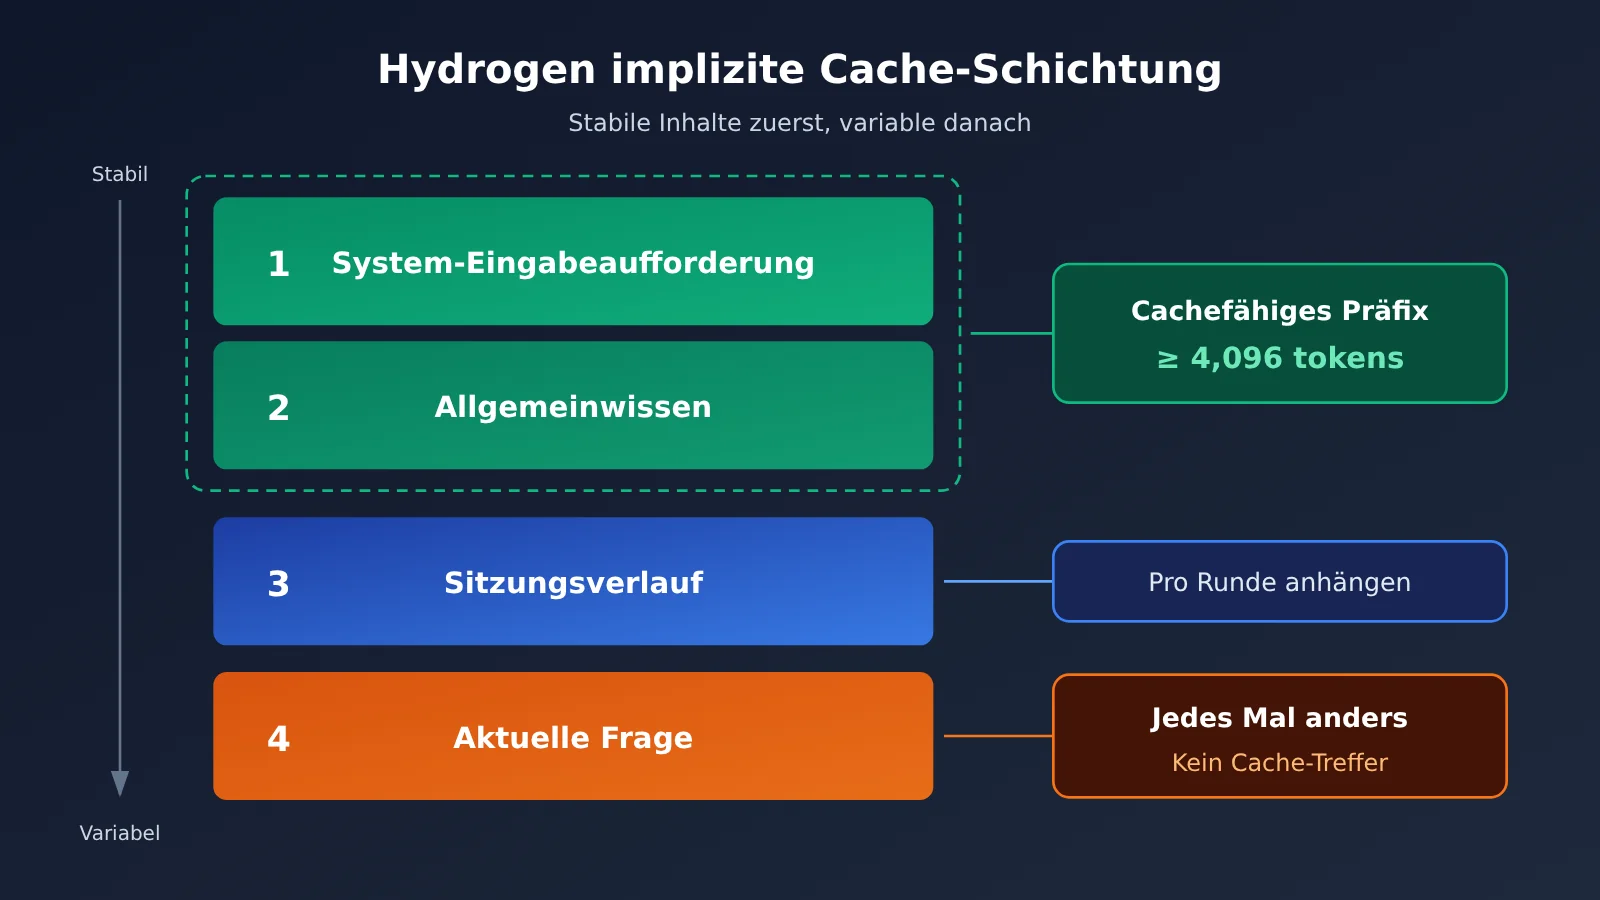
Typische Auswirkungen: Bei den Preisen gilt laut der offiziellen Preisseite von Google AI Studio (Stand: 13. November 2026, Angaben in US-Dollar pro eine Million Tokens): Bei einem impliziten Cache-Treffer kostet der Input für einen Standard-Aufruf von Hydrogen $0.075, im Batch- und Flex-Modus $0.0375 – deutlich weniger als die $1.50 für Standard-Input. Werden dynamische Variablen (Zeitstempel, Nutzer-IDs usw.) an den Anfang der Eingabeaufforderung gesetzt, unterscheidet sich das Präfix bei jedem Aufruf, und der Cache kann nicht greifen.
6. Anpassung 5: thought_signature in Hydrogen korrekt pflegen
Altes Verhalten: Bei 3.8 Flash haben viele Agent-Frameworks die Gesprächshistorie selbst neu aufgebaut und dabei nur den Text sowie die Tool-Aufrufergebnisse beibehalten. Der Verlust der Signatur hatte häufig keine erkennbaren Auswirkungen.
Neues Verhalten: Bei Multi-Turn-Dialogen mit Hydrogen müssen die Signaturen aller zuvor relevanten Teile erhalten bleiben – einschließlich der Signatur, die der abschließende Textteil trägt. Die offizielle Migrationsanleitung legt für parallele Tool-Aufrufe Folgendes fest:
- Mehrere parallele
functionCallmüssen sich in derselben Modellnachricht befinden; - Die
thought_signaturewird nur im ersten parallelenfunctionCall-Teil platziert; - Nachfolgende
functionResponsemüssen gemäß der jeweiligen Aufruf-ID, dem Namen und der Reihenfolge zurückgegeben werden; - Wenn dasselbe Modell die Signatur wiederverwendet und sich der Historienpräfix ändert, kann standardmäßig HTTP 400 zurückgegeben werden.
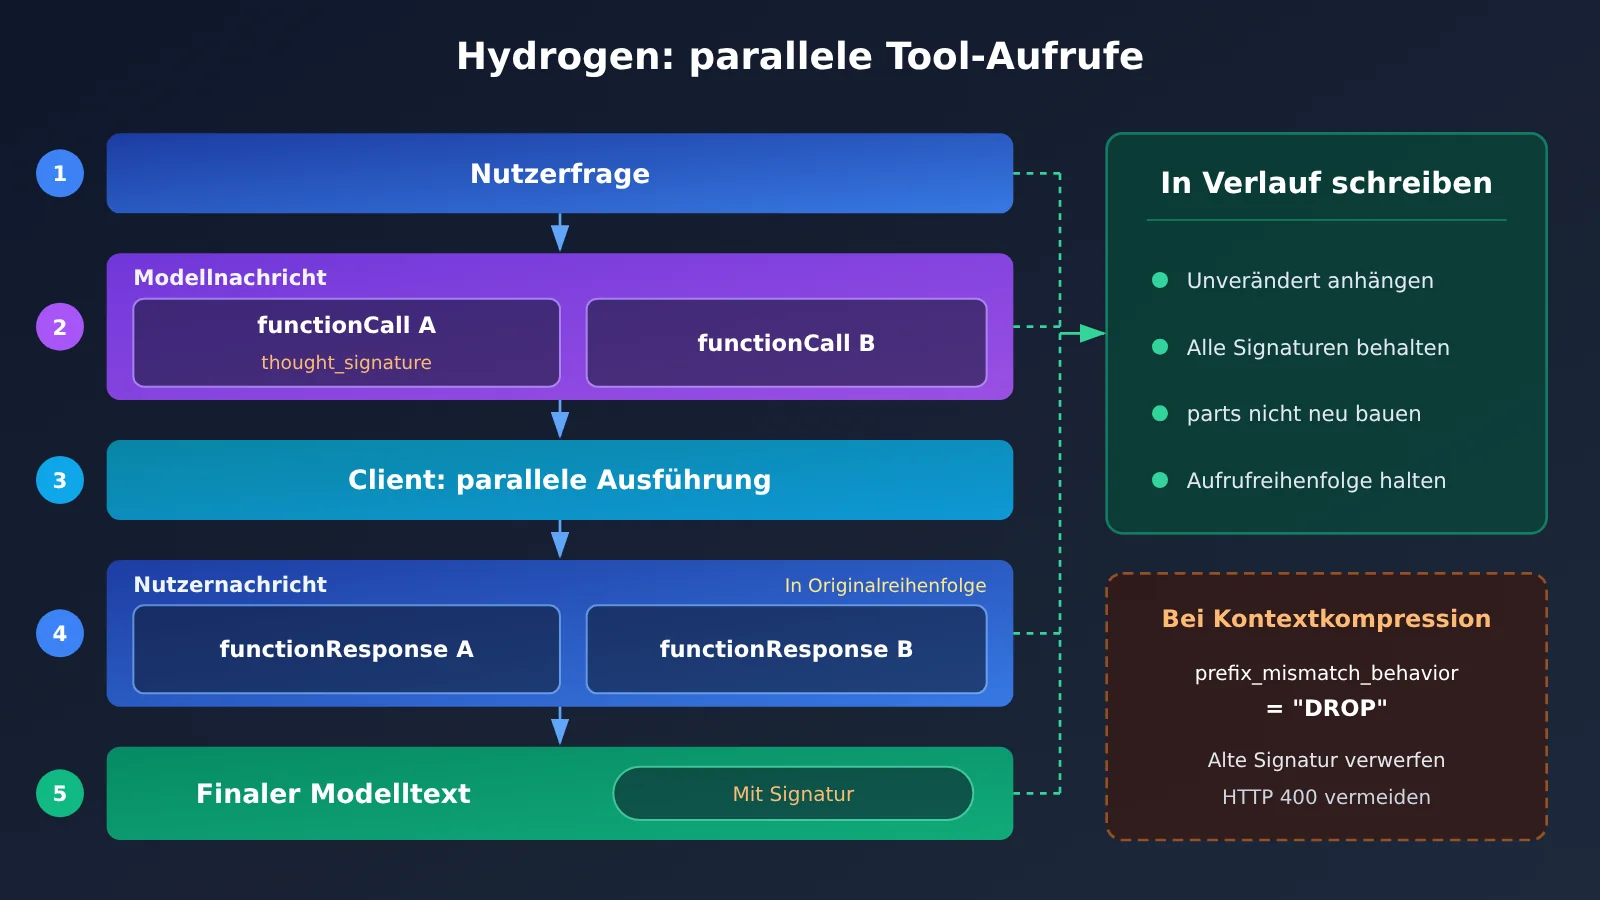
Vorgehensweise zur Pflege der Hydrogen-Signatur
Am zuverlässigsten ist es, die parts nicht manuell neu aufzubauen, sondern das vom Modell zurückgegebene content-Objekt unverändert an die Historie anzuhängen:
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # unverändert übernehmen, die Signatur bleibt erhalten

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # dieselbe Reihenfolge wie bei den functionCall beibehalten
]
history.append(types.Content(role="user", parts=responses))
Bei Agenten, die die Historie komprimieren oder kürzen (etwa gleitendes Fenster oder Ersetzen durch Zusammenfassungen), ändert sich der Historienpräfix zwangsläufig. In diesem Fall lässt sich gemäß der Migrationsanleitung prefix_mismatch_behavior="DROP" konfigurieren, damit das Modell bei einem Präfix-Konflikt die alte Signatur verwirft, statt einen Fehler zurückzugeben. Die genaue Position dieses Feldes in der Anfrage entnehmen Sie bitte der offiziellen Migrationsanleitung.
Typische Auswirkung: Selbst entwickelte Agent-Harnesses, Coding-Assistenten, die Dateien parallel durchsuchen, sowie Chatbots für lange Konversationen mit Kontextkomprimierung sind am stärksten betroffen. Es empfiehlt sich, für die Signaturrückgabe eigene Integrationstests zu schreiben.
7. Checkliste für die Hydrogen-Migration und minimales Aufrufbeispiel
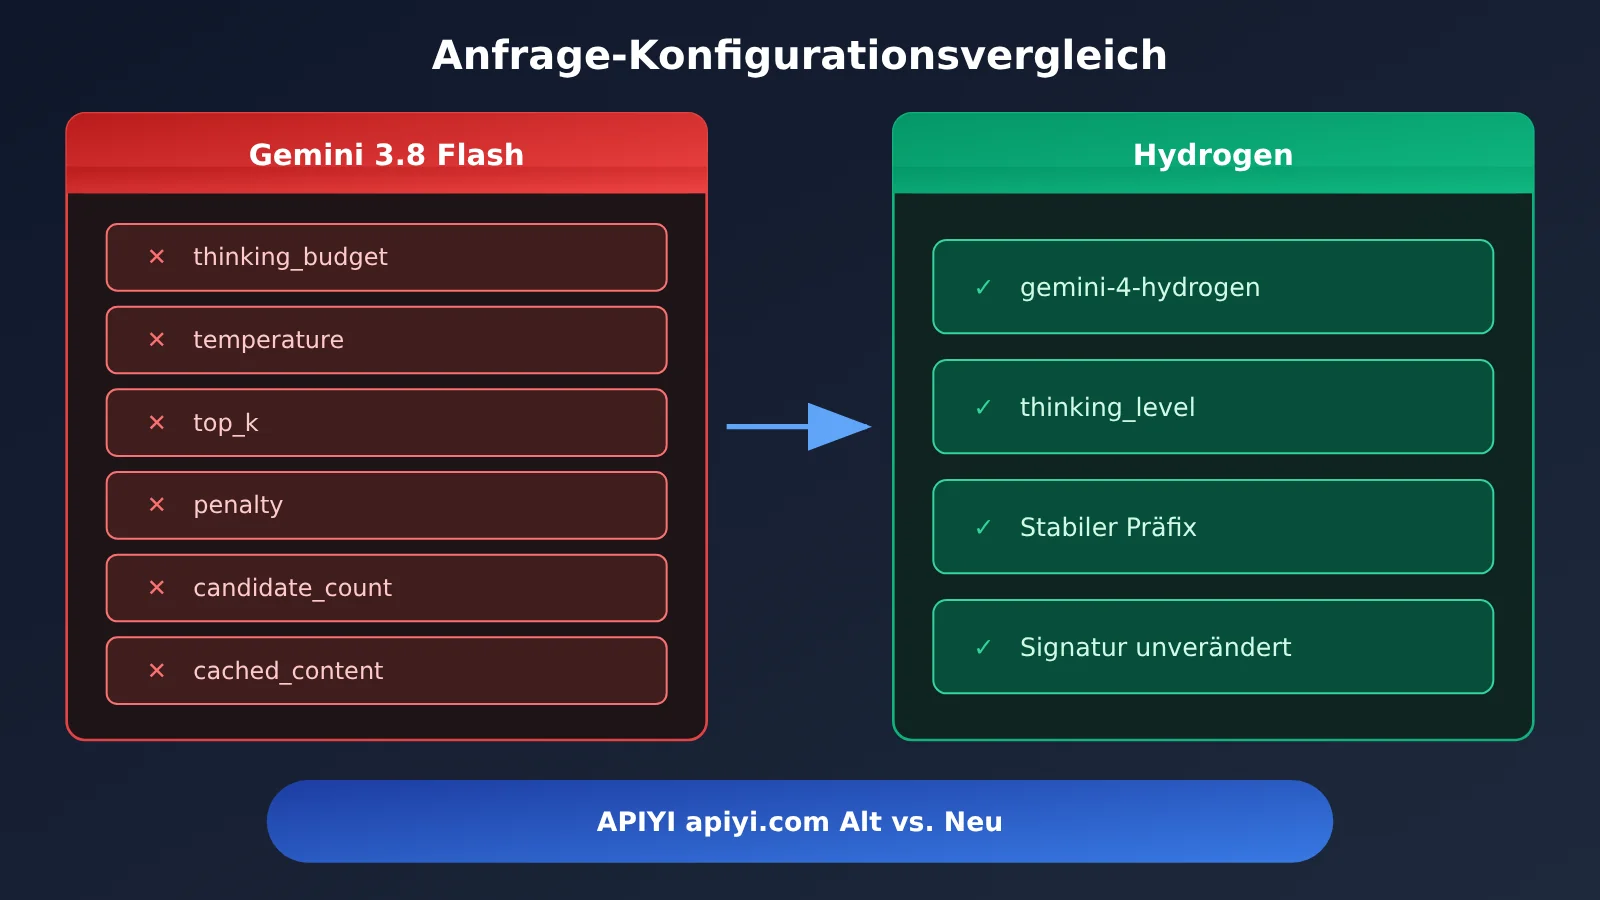
| Prüfpunkt | Vor der Migration (3.8 Flash) | Nach der Migration (Hydrogen) | Erledigt |
|---|---|---|---|
| Modell-ID | Alte Modell-ID | gemini-4-hydrogen |
☐ |
| SDK | Beliebige Version | Python >= 2.34.0, JS >= 2.32.0 (Interactions) | ☐ |
| API-Version | v1 | v1beta1 verwenden, wenn lange Ausgaben fortgesetzt werden sollen | ☐ |
| Denkparameter | thinking_budget / MINIMAL | thinking_level explizit setzen | ☐ |
| Generierungsparameter | temperature usw. anpassbar | penalty, candidate_count und Prefill-Runden entfernen | ☐ |
| Caching | cached_content | Stabile Inhalte voranstellen, Präfix ≥ 4.096 Tokens | ☐ |
| Tool-Aufrufe | Verlauf selbst rekonstruieren | Signatur unverändert beibehalten, parallele Antworten in Reihenfolge zurückgeben | ☐ |
| Fehlerbehandlung | Allgemeine Wiederholungsversuche | HTTP-400-Validierungsfehler von stillschweigendem Ignorieren unterscheiden | ☐ |
Schnelle Validierung über die OpenAI-kompatible Schnittstelle
Wenn der Geschäftscode Ihres Teams auf dem OpenAI SDK basiert, können Sie zunächst über die kompatible Schnittstelle schnell prüfen, wie gut die Ausgaben von Hydrogen sind, und dann entscheiden, ob eine Umstellung auf das native SDK sinnvoll ist. Ob das Modell gelistet ist und welche Parameter durchgereicht werden können, richtet sich nach der Modellliste und Dokumentation der Plattform:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 写一个带重试的 HTTP 请求函数"}],
)
print(resp.choices[0].message.content)
Vollständigen Implementierungscode anzeigen (mit Tool-Aufrufen und Beibehaltung des Verlaufs)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche Schnittstelle, praktisch für den Vergleich alter und neuer Modelle
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取仓库中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代码修复助手。只修改与问题相关的代码。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # Stabile Systemanweisung an den Anfang stellen, das verbessert die implizite Cache-Trefferquote
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # Die gesamte Assistant-Nachricht unverändert in den Verlauf zurückschreiben, keine Felder kürzen
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # Ergebnisse in der ursprünglichen Reihenfolge der tool_calls einzeln zurückgeben
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    print(run_agent("检查 utils.py 中的 parse_date 函数是否有时区问题"))
🚀 Tipp für den Schnellstart: Behalten Sie während der Migration 3.8 Flash als Kontrollgruppe bei und lassen Sie dieselbe Charge echter Anfragen gleichzeitig durch alte und neue Modelle laufen. Über APIYI apiyi.com können Sie mit einem API-Schlüssel beide Modelle gleichzeitig aufrufen. Neue Nutzer erhalten ein kostenloses Testkontingent – ideal, um zuerst einen Vergleich mit geringem Datenverkehr durchzuführen und erst danach vollständig umzustellen.
Häufig gestellte Fragen (FAQ)
F1: Was ist Gemini 4 Hydrogen?
Gemini 4 Hydrogen ist ein Modell, das Google DeepMind am 12. November 2026 veröffentlicht hat; die API-ID lautet `gemini-4-hydrogen`. Es wurde von Gemini 4 Carbon abgeleitet und legt den Schwerpunkt auf Geschwindigkeit, alltägliches Programmieren, Aufrufe mehrerer Tools und die Ausführung automatisierter Aufgaben. Es kann eigenständig verwendet werden oder in Multi-Modell-Systemen als Ausführender bzw. Prüfer dienen.
F2: Wie groß ist der Leistungsunterschied zwischen Hydrogen und Gemini 3.8 Flash?
Laut offiziellen Angaben von Google erreicht Hydrogen auf Terminal-Bench 4.1 57,0 %, 3.8 Flash 18,2 %; unter gleichen Testbedingungen ist die Aufgabenabschlussgeschwindigkeit etwa 2,5-mal höher. Das sind Ergebnisse aus offiziellen Tests oder von Partnern; sie lassen sich nicht ohne Weiteres auf alle realen Aufgaben übertragen.
F3: Sinken die Kosten nach der Migration auf Hydrogen?
Nicht zwangsläufig. Laut der offiziellen Preisseite von Google AI Studio (Stand: 13. November 2026) kostet ein Standardaufruf von Hydrogen $1.50 für den Input und $7.50 für den Output (US-Dollar pro Million Tokens), während 3.8 Flash bis zum 31. Dezember 2026 bei $0.75 / $3.75 liegt und ab dem 1. Januar 2027 auf $1.50 / $7.50 angepasst wird. Der Stückpreis ist derzeit doppelt so hoch wie bei 3.8 Flash; die Gesamtkosten hängen von der Länge der Denkprozesse, der Anzahl der Wiederholungsversuche und der Effizienz bei der Aufgabenbewältigung ab.
F4: Bei welchen Projekten sollte die Kompatibilität am dringendsten geprüft werden?
Im Wesentlichen bei diesen Kategorien:
– **Agenten mit parallelen Aufrufen mehrerer Tools**: Signaturpositionen und Antwortreihenfolge sind am fehleranfälligsten;
– **Systeme für lange Sitzungen mit Kontextkomprimierung**: Probleme durch nicht übereinstimmende Präfixe müssen behandelt werden;
– **Erzeugung langer Berichte und langer Codeblöcke**: SDK muss aktualisiert und auf v1beta1 umgestellt werden;
– **Batch-Systeme, die auf explizitem Caching zur Kostenkontrolle setzen**: müssen auf eine implizite Caching-Strategie umstellen.
F5: Wie lassen sich altes und neues Modell per API schnell vergleichen?
Empfohlenes Vorgehen:
1. Bei APIYI apiyi.com ein Konto registrieren und einen API-Schlüssel beziehen;
2. Mit dem OpenAI-kompatiblen Beispiel aus diesem Artikel `model` jeweils auf die alte bzw. neue Modell-ID setzen;
3. Dieselben Geschäftsanfragen verwenden, um Ausgabequalität, Latenz und Token-Verbrauch zu vergleichen.
Eine einheitliche Schnittstelle erspart es, Authentifizierung und Request-Code für beide Modelle getrennt zu pflegen.
F6: Welche bekannten Einschränkungen hat Hydrogen?
Die offizielle Model Card nennt: Halluzinationen sind weiterhin möglich; hohe Denkstufen erhöhen Zeit- und Kostenaufwand deutlich, gelegentlich kommt es zu Verzögerungen oder Timeouts; der Wissensstand endet im März 2026; im Vergleich zu 3.8 Flash verschlechtert sich der Indikator für unbegründete Ablehnungen um 5,57 Prozentpunkte. Zudem unterstützt Hydrogen weder die Live API noch Fine-tuning. In frühen Rückmeldungen aus der Community berichten einige Nutzer außerdem von übermäßiger Ausführung bei Agent-Aufgaben – das ist individuelles Erfahrungsfeedback.
F7: Wie lassen sich Kostenrisiken in der frühen Migrationsphase begrenzen?
Empfehlenswert ist es, zunächst explizit `thinking_level=“medium“` zu setzen und damit eine Baseline zu fahren; High aktivieren Sie dann gezielt für mehrstufige Agents. Prüfen Sie dabei auch die Trefferquote des impliziten Caches und den Anteil der Thinking-Tokens. Wenn Sie nach Verbrauch abrechnen und die Nutzung mehrerer Modelle zentral einsehen möchten, können Sie die einheitliche Abrechnung von APIYI apiyi.com für den Vergleich heranziehen.
Hydrogen-Migration: die wichtigsten Punkte (Key Takeaways)
- Nicht nur ein neuer Name: Die Modell-ID auf
gemini-4-hydrogenumzustellen ist nur der erste Schritt – vier weitere Konfigurationen müssen ebenfalls angepasst werden. - Das SDK ist die harte Hürde: Für die Fortsetzung langer Ausgaben sind Python >= 2.34.0 und JS >= 2.32.0 (Interactions API) erforderlich, außerdem muss v1beta1 verwendet werden.
- Neue Generation der Thinking-Parameter:
thinking_budgetundMINIMALliefern HTTP 400, die Standardstufe ist inzwischen High. - Sampling-Parameter ohne Wirkung: temperature, top_p und top_k werden ignoriert; penalty, mehrere Kandidaten und Prefill-Runden müssen entfernt werden.
- Caching folgt der Struktur: Explizites Caching entfällt; erst ein stabiler Präfix von 4.096 Tokens trifft den impliziten Cache.
- Signaturen müssen vollständig sein: Bei parallelen Aufrufen steht die Signatur nur beim ersten functionCall, die Antworten kommen in Reihenfolge zurück, und für komprimierte Historie lässt sich DROP setzen.
- Erst vergleichen, dann umstellen: Über APIYI apiyi.com mit demselben Key das alte und das neue Modell aufrufen und erst nach einem Test mit kleinem Traffic vollständig migrieren.
Zusammenfassung
Die Kernpunkte beim Upgrade von Gemini 3.8 Flash auf Hydrogen:
- Basisebene: Modell-ID und SDK aktualisieren und das einheitliche Kontingent von 1,048,576 Tokens sowie das Ausgabelimit von 65,536 Tokens pro Segment verstehen;
- Parameterebene:
thinking_levelstattthinking_budgetverwenden und veraltete Sampling- und Generierungsfelder bereinigen; - Zustandsebene: Die Struktur der Eingabeaufforderung neu gestalten, um den impliziten Cache zu treffen, und
thought_signatureunverändert beibehalten und zurücksenden.
Es empfiehlt sich, die Checkliste in diesem Artikel Punkt für Punkt umzusetzen, Regressionstests für Tool-Aufrufe und lange Ausgaben zu schreiben und erst dann den echten Traffic auf das neue Modell umzustellen. Für einen schnellen Vergleich der Ergebnisse von altem und neuem Modell empfehlen wir APIYI unter apiyi.com – die Plattform bietet eine OpenAI-kompatible Schnittstelle und kostenloses Testguthaben für neue Nutzer.
📚 Referenzen
- Gemini 4 Hydrogen – Entwickler-Migrationsleitfaden: Offizielle Kompatibilitätsänderungen und Migrationscheckliste
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Beschreibung: Erstquelle für Details wie Mindest-SDK-Version, Signaturregeln,
prefix_mismatch_behaviorund weitere -
Gemini 4 – Einstieg und Migrationsunterschiede im Vergleich: Erläuterung zu langen Ausgaben und API-Versionen
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
Beschreibung: Erklärt, dass die Fortsetzungsfunktion die v1beta1 API erfordert
-
Google Cloud Hydrogen – Modellspezifikationen: Tabelle zu Kontext, Parametern und Funktionsunterstützung
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Beschreibung: Feste Werte für temperature, top_p, top_k sowie Cache-Unterstützung
-
Offizieller Google-Blogbeitrag: Ankündigung von Gemini 4 Hydrogen
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Beschreibung: Produktpositionierung und offizielle Vergleichsdaten mit 3.8 Flash
-
Google AI Studio – Preisseite: Offizielle API-Preise
- Link:
aistudio.google.com/docs/pricing -
Beschreibung: Preise für Standard, Batch, Flex, Priority und Cache-Treffer
-
Artificial Analysis – Unabhängige Bewertung: Bewertung der vier Denkstufen
- Link:
artificialanalysis.ai/models/gemini-4-hydrogen -
Beschreibung: Intelligenzindex von Drittanbietern, Bewertungsdauer und Kostendaten
-
Google DeepMind – Modellkarte: Fähigkeiten, Einschränkungen und Sicherheitsbewertung
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Beschreibung: Bekannte Einschränkungen und offizielle modellübergreifende Bewertungen
Autor: Technikteam von APIYI
Technischer Austausch: Sollten bei der Migration Kompatibilitätsprobleme auftreten, können Sie sich gerne über die offizielle APIYI-Website mit uns austauschen. Weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com