
Zusammenfassung der Schreibtests von GPT, Claude und Kimi: zuerst die Einschätzung
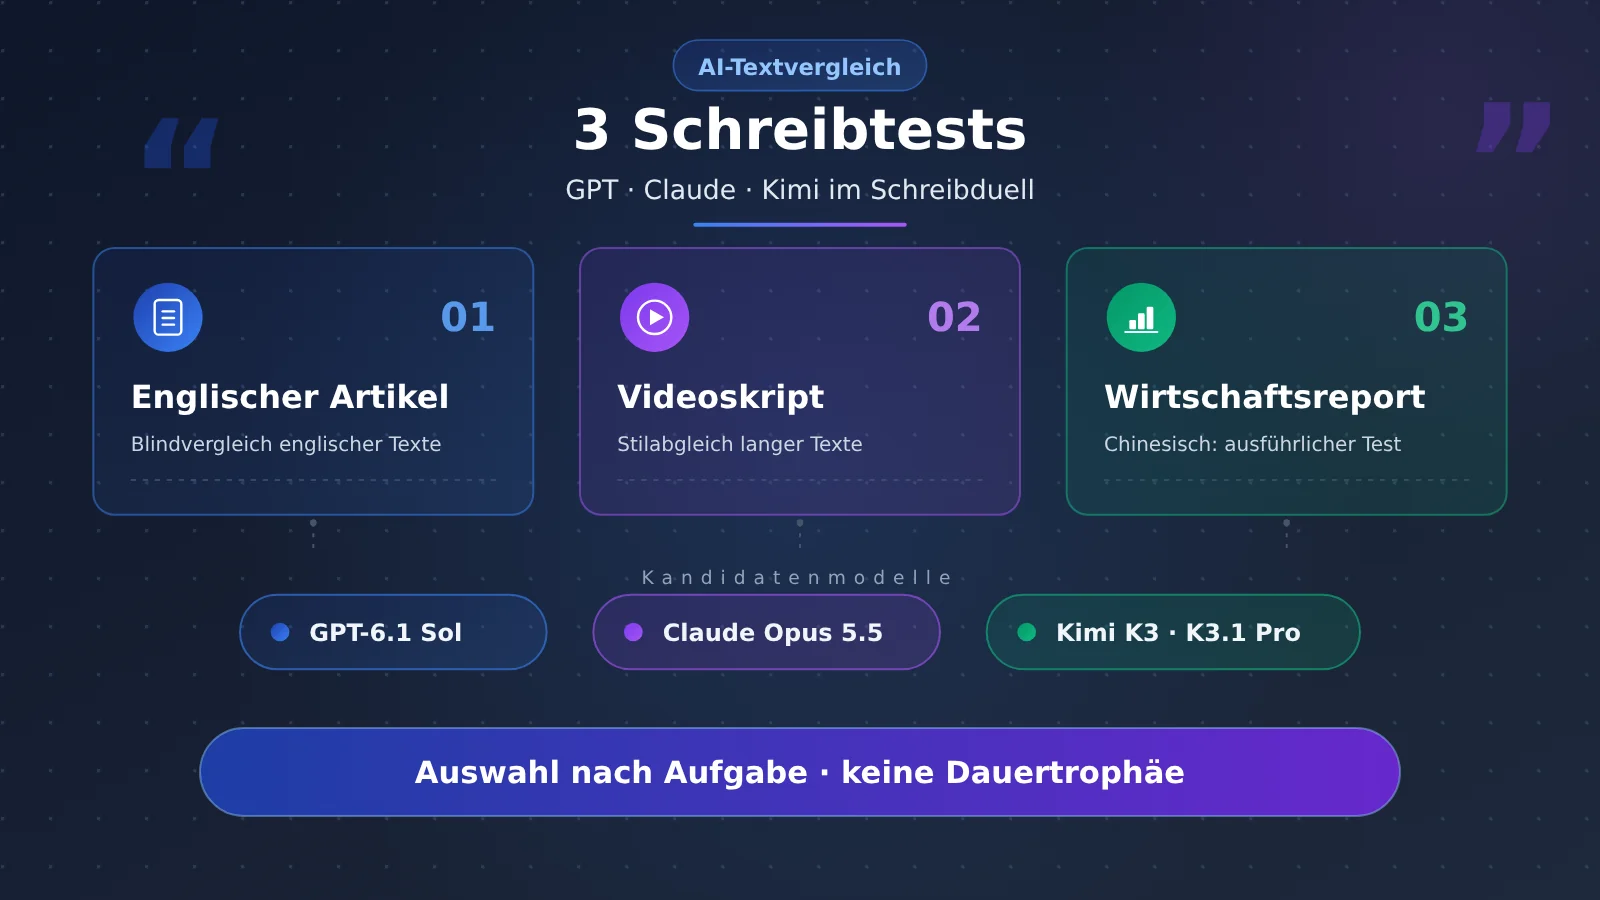
Für englische Artikel zuerst GPT-6.1 Sol ausprobieren; für lange Texte, bei denen es auf den Schreibstil ankommt, zuerst Claude Opus 5.5; für erklärende Populärwissenschaft lohnt es sich, Kimi K3 einzubeziehen. Auch Kimi K3.1 Pro zeigt im Englischen eine starke Gesamtleistung und liegt bei ToneBench nahe an GPT.
Die drei Tests decken unterschiedliche Aufgaben, Sprachen und Bewertungsmethoden ab. Die praktischste Schlussfolgerung: eine Kandidatenliste aufstellen und diese dann mit dem eigenen Manuskript überprüfen, statt einer der drei Modellfamilien einen dauerhaften Pokal zu verleihen.
Einstiegstipp: Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich die Kandidatenmodelle aufrufen und mit demselben Materialpaket die ersten Entwürfe vergleichen. Das kostenlose Testguthaben für neue Nutzer richtet sich nach den aktuellen Regeln der Plattform.
GPT, Claude, Kimi-Schreibtest: Was kommt als Nächstes?
Dieser Artikel zerlegt nacheinander die englische Schreib-Rangliste, den stilisierten Langtext-Test für Videos und den Praxistest mit einem tiefgehenden chinesischen Finanzartikel. Am Ende gibt es Szenarioauswahl, Blindtest-Schritte und Aufrufbeispiele – der Fokus liegt auf Artikelqualität und manuellem Redaktionsaufwand.
Zunächst zwei Begriffe: Schreibbenchmark ist ein Test, der Ausgaben anhand einer vorgegebenen Aufgabe bewertet; Blindbewertung bedeutet, Texte zu vergleichen, ohne die Modellidentität zu kennen. Die Blindbewertung kann von Menschen oder Modellen durchgeführt werden; beim Lesen der Ergebnisse muss man unterscheiden, wer der Prüfer ist.
GPT, Claude, Kimi-Schreibtest eins: Bei englischen Artikeln zählt GPT
AI Writing Benchmark ist ein englisches Schreibprojekt, das von Johannes Eva gepflegt wird und eigenen Angaben zufolge keine Zahlungen von Modellherstellern erhalten hat. Dieser Artikel verwendet Ergebnisse, die am 11. November 2026 aktualisiert und am 12. November abgefragt wurden.
Das Projekt umfasst 115 Modelle und dokumentiert 131.507 öffentliche Blindbewertungsduelle. Es bewertet Schreiben durch den Vergleich anonymisierter Texte; die Rangliste der KI-Prüfer und die Rangliste der menschlichen Abstimmungen werden getrennt dargestellt.
| Modell | Englische Gesamtpunktzahl | Bezugsrahmen |
|---|---|---|
| GPT-6.1 Sol | 95.3 | Platz eins der Gesamtliste |
| Claude Opus 5.5 | 92.9 | Platz zwei der Gesamtliste |
| Kimi K3.1 Pro | 91.9 | Platz drei der Gesamtliste |
Die Gesamtpunktzahl fasst mehrere Aufgabenklassen zusammen; die Aufgabenklassen-Punktzahl spiegelt nur eine bestimmte Art von Aufgaben wider. GPT-6.1 Sol erreicht in der Kategorie Artikel, Blogs und redaktionelle Inhalte eine Klassifizierungspunktzahl von 98.5 – diese muss getrennt von der Gesamtpunktzahl 95.3 erfasst werden.
Dies sind relative Punktzahlen innerhalb des Benchmarks. Das Projekt definiert 50 als die geschätzte Wahrscheinlichkeit von eins zu zwei, das aktuelle durchschnittliche Modell für Sprache und Kategorie zu schlagen. Leser sollten auf die Wettbewerbsposition achten und die Punktzahl nicht als veröffentlichbaren Inhaltsanteil interpretieren.
Offen gesagt: Wenn die Aufgabe ein englischer Blog oder ein redaktioneller Artikel ist, hat GPT-6.1 Sol gute Gründe, in die erste Testrunde zu kommen. Für chinesische Artikel braucht man andere chinesische Belege.
Ein weiteres beachtenswertes Ergebnis: Kimi K3 führt in der Kategorie Erklärung und Populärwissenschaft mit 94.9. Hier gewinnt K3, auf Platz drei der Gesamtliste steht K3.1 Pro – der Versionsname sollte zusammen mit dem Ergebnis gespeichert werden.
GPT, Claude, Kimi Schreibtest Teil 2: Bei langen Skripten punktet Claude im Stil
ToneBench lässt Modelle ein kreatives Briefing, ein Recherchepaket und einen Stilguide lesen und daraus ein vollständiges YouTube-Skript erstellen. Die Modelle sehen das fertige Skript des Originalautors nicht und können weder online gehen noch externe Tools aufrufen.
Dieser Artikel stützt sich auf Materialien mit Stand vom 10. November 2026. Die Aufgabe ist ein langes Videoskript für einen bestimmten Creator; die bereitgestellten Unterlagen führen nicht alle Aufgabensprachen explizit auf, deshalb wird hier der Skript-Kontext als Auslegung herangezogen.
Der Test umfasst 87 Modelle in 151 Konfigurationen, jede Konfiguration bearbeitet 10 Aufgaben, und jede Aufgabe wird 5-mal unabhängig generiert. Insgesamt entstehen 7.550 Manuskripte, die von vier KI-Juroren in 30.200 Bewertungen benotet werden.
Besonderes Augenmerk liegt auf der Stilübereinstimmung, also darauf, ob Tonfall, Rhythmus und Ausdrucksweise dem Ziel-Creator nahekommen. Die Stilübereinstimmung wiegt 19 %, Inhaltstiefe, Genauigkeit und Wert 15 %, zusätzlich werden Kohärenz und Längensteuerung bewertet.
Die folgende Tabelle verwendet den Writing Score der jeweils besten Konfiguration eines Modells sowie die im Material genannten Modellränge. Claude entspricht xhigh; für die beiden anderen Modelle nennt das Material keine konkreten Bezeichnungen der Inferenzkonfiguration – das sollte bei einer Nachprüfung ergänzt werden.
| Modell | Modellrang | Writing Score | Geschätzte Kosten pro Manuskript im Test |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85,8 | $1,003 |
| GPT-6.1 Sol | 8 | 82,4 | $0,239 |
| Kimi K3.1 Pro | 9 | 82,5 | $0,251 |
Der Writing Score ist die Kennzahl, die die Schreibqualität in diesem Test zusammenfasst, während sich die Rangliste auf die Elo-Skala bezieht. Dass Kimi 0,1 Punkte mehr erzielt, aber einen Platz tiefer liegt, sollte man deshalb als nahezu gleichwertige Leistung lesen.
Claude führt in dieser Ergebnisgruppe, die geschätzten Testkosten liegen etwa 4,2-mal so hoch wie bei GPT. Das ist eine Kostenschätzung von ToneBench und lässt sich nicht ohne Weiteres als Preis für Artikel auf anderen Plattformen übernehmen.
Um die Rangliste einzuordnen, sollte man Aufgaben und Bewertung im selben Bild betrachten. Bei einer Nachprüfung über den API-Proxy-Dienst APIYI apiyi.com empfiehlt es sich, die Konfigurationsprotokolle aufzubewahren und anschließend zum ursprünglichen Ranking zurückzukehren, um die Vergleichsgrundlage abzugleichen.
Die Konfidenzintervalle für den ersten und zweiten Platz bei ToneBench überschneiden sich, und selbst das Entfernen eines beliebigen Referenzskripts verschiebt die Spitzenposition. Die Studie zeigt außerdem eine gewisse Anbieterpräferenz der Juroren, doch nach Ausschluss der Einzelbewertungen bleibt Claude weiterhin vorn.
Der Kernbefund lautet: Wer lange Skripte braucht, die Material aufnehmen und die Stimme des Creators halten sollen, sollte Claude zuerst ausprobieren. Das Ergebnis eignet sich gut zur Orientierung bei der Kandidatenauswahl, die Größe des Vorsprungs muss man jedoch mit eigenen Manuskripten verifizieren.
Außerdem zu beachten: Der Einzelwert „Least Slop“ von GPT-6 Sol gehört zu einer anderen Version und einer anderen Kennzahl und kann den Writing Score von GPT-6.1 Sol nicht ersetzen.
GPT, Claude, Kimi im Schreibtest Nr. 3: Worauf es bei ausführlichen chinesischen Artikeln ankommt
Der Test von OmniTools lief vom 26. Oktober bis 3. November 2026 und untersuchte ausführliche chinesische Finanzartikel von PANews. Verglichen wurden 10 Modelle anhand von 26 Artikeln.
| Modell | KI-Blindbewertung | Anzahl getesteter Artikel | Bewertung der Natürlichkeit |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
In diesem Test schnitt Claude sowohl bei der Gesamtbewertung als auch bei der Natürlichkeit besser ab. Für ausführliche chinesische Finanzartikel ist Claude Opus 5.5 der Kandidat, den man zuerst ausprobieren sollte.
Allerdings ist die Stichprobe klein, die Artikelzahlen verteilen sich ungleich auf die Modelle, und Kimi hat gar nicht teilgenommen. Diese Daten liefern also nur ergänzende Belege für GPT und Claude im chinesischen Kontext – eine vollständige Rangliste der drei Modelle lassen sie nicht zu.
Bewertet wurde mit Claude Opus 5.5 und DeepSeek V4 Pro, wobei die Regel galt, dass kein Modell sich selbst bewertet. Der Herausgeber hat einen kommerziellen Hintergrund als API-Routing-Dienst – diese Herkunftsangabe sollte man beim Lesen im Hinterkopf behalten.
Die redaktionelle Bewertung ist eine separate Erhebung. Claudes 100-prozentige Übernahmequote durch die Redaktion bezieht sich nur auf 1/1 Durchgang und taugt daher eher als Fallbeispiel; für die langfristige Übernahme braucht es noch deutlich mehr Manuskripte.
Kurz gesagt: Hier zeigen sich positive Signale dafür, dass Claude lange chinesische Finanzartikel schreiben kann – der Belegumfang beschränkt sich aber genau auf dieses Szenario.
GPT, Claude, Kimi im Schreibtest: Kandidaten nach Szenario auswählen
Legt man die drei Ergebnisse nebeneinander, sollte daraus eine Auswahltabelle entstehen – und keine Addition von Punkten. Sprache des Artikels, Aufgabe und Zielstil entscheiden darüber, welche Belege für Sie relevant sind.
| Schreibszenario | Bevorzugter Kandidat | Auswahlkriterium |
|---|---|---|
| Englische Blogs, redaktionelle Artikel | GPT-6.1 Sol | Führend in der Kategorie englische Artikel |
| Lange Video-Skripte im Creator-Stil | Claude Opus 5.5 | Aktuell führend bei ToneBench |
| Chinesische Finanz-Deep-Dives | Claude Opus 5.5 | Führend in Praxistests mit kleinen chinesischen Stichproben |
| Englische Erklärtexte, Populärwissenschaft | Kimi K3 | Führend in den Kategorien Erklärung und Populärwissenschaft |
| Lange Inhalte auf Basis von Materialpaketen | Gemeinsamer Blindtest aller drei | GPT und Kimi liegen bei ToneBench nah beieinander |
| Plattform zur Aufrufvalidierung | APIYI apiyi.com | Einheitliche Schnittstelle erleichtert den Modellwechsel |
Chinesische Techniktutorials, Produktvorstellungen und ähnliche Szenarien werden von den drei vorliegenden Evidenzquellen nicht vollständig abgedeckt. Der sicherere Weg ist, die Kandidaten parallel zu testen und zu sehen, wer die Technik verständlich erklärt und die Fakten korrekt wiedergibt.
GPT, Claude, Kimi im Schreibtest: Wie führen Sie den Vergleich selbst durch?
Wählen Sie ein echtes Thema und geben Sie allen Modellen exakt dieselben Materialien, dieselbe Planung, denselben Umfang und dieselben Tool-Rechte. Lassen Sie jedes Modell mindestens drei Mal unabhängig generieren, blenden Sie die Modellnamen aus und übergeben Sie das Ergebnis einer redaktionellen Bewertung.
Die Bewertung kann mit fünf Kriterien beginnen: Faktenrichtigkeit, Umsetzung der Planung, Natürlichkeit des Ausdrucks, strukturelle Klarheit und inhaltlicher Wert. Die Gewichtung richtet sich nach der Aufgabe des Teams – und Sie sollten kennzeichnen, dass es sich um selbst aufgestellte Regeln handelt.
Erfassen Sie außerdem den redaktionellen Aufwand: also den Arbeitsaufwand, der nötig ist, bis der Text veröffentlichungsreif ist. Am besten halten Sie gleichzeitig Bearbeitungszeit, umgeschriebene Absätze, Faktenfehler und die letztlich übernommene Fassung fest.
Konfigurationstipp: Bei APIYI apiyi.com wechseln Sie mit einem einzigen API-Schlüssel zwischen den Modellen, was wiederholte Integrationsarbeit spart. Halten Sie beim Testen Modellversion, Parameter und den tatsächlichen Token-Verbrauch fest, damit sich das Ganze reproduzieren lässt.
Unten steht ein minimales Aufrufbeispiel. Setzen Sie dasselbe reale Materialpaket in brief ein und wechseln Sie nur den Modellnamen – schon entsteht ein Vergleichsentwurf. Der Schlüssel sollte sicher aus der Laufzeitumgebung bereitgestellt werden.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
Dieser Code dient als Einstieg. Für einen echten Blindtest sollten Sie mehrfach generieren, die Ergebnisse anonym präsentieren und die Konfiguration protokollieren. Wer das führende Modell in der Kategorie Erklärung verifizieren will, muss zusätzlich Kimi K3 aufnehmen.
FAQ zum GPT-, Claude- und Kimi-Schreibtest
In welcher Version sollte Kimi im GPT-, Claude- und Kimi-Schreibtest getestet werden?
Für erklärende Populärwissenschaft nehmen Sie vorrangig Kimi K3; für den Vergleich der Gesamtwertung in diesem Artikel mit den ToneBench-Ergebnissen verwenden Sie K3.1 Pro. Prüfen Sie vor dem Aufruf über APIYI apiyi.com die Modellliste und den genauen Modellnamen, um Versionsverwechslungen zu vermeiden.
Wie lassen sich die tatsächlichen Kosten im GPT-, Claude- und Kimi-Schreibtest vergleichen?
Vergleichen Sie die „Kosten pro akzeptablem Artikel“: kumulierte Aufrufkosten plus Bearbeitungsaufwand. Wenn Sie über APIYI apiyi.com testen, protokollieren Sie die tatsächliche Nutzung und die Anzahl der Wiederholungsversuche und kalkulieren Sie dann mit den Preisen zum jeweiligen Zeitpunkt. Das ist näher an der Produktion als die reine Betrachtung der Erstentwurfskosten.
Fazit zum GPT-, Claude- und Kimi-Schreibtest: Wählen Sie das Modell mit weniger Bearbeitungsaufwand
Für englischsprachige Artikel testen Sie zuerst GPT, für stilistisch ausgeprägte Longform-Texte und tiefgehende chinesische Finanzbeiträge zuerst Claude; für erklärende Populärwissenschaft beziehen Sie Kimi mit ein. Dies sind Prioritäten für konkrete Aufgaben, keine dauerhafte Rangliste der gesamten Modellfamilien.
Empfohlen: Testen Sie die Ergebnisse über APIYI apiyi.com mit demselben Materialpaket. Entscheiden Sie am Ende danach, welches Modell die Planung genauer umsetzt, mehr brauchbare Absätze beibehält und dem Redaktionsteam eine weitere Überarbeitungsrunde erspart.
Referenzmaterialien für Schreibtests mit GPT, Claude und Kimi
-
AI Writing Benchmark: aiwritingbenchmark.com
Englische Gesamt- und Kategorie-Rangliste, Stand: 11. November 2026. -
Towards AI ToneBench: benchmark.towardsai.com/models/
Tests für Videoskripte, Modell-Ranking, Konfiguration und Kostenschätzung, Stand: 10. November 2026. -
OmniTools – Praxistest für tiefgehendes Langform-Schreiben: omnitools.ai/evals/longform-writing
Test mit tiefgehenden chinesischen Finanzartikeln von PANews, Testzeitraum: 26. Oktober bis 3. November 2026.
Autor: APIYI-Team für technische Inhalte. Gerne können Sie sich über APIYI unter apiyi.com zu Modellkonfiguration, Blindtest-Methoden und Redaktionserfahrungen austauschen.


