Nach dem Wechsel von gemini-3.1-pro-preview zu Gemini 4 Argon ist vielen Entwicklern ein Problem aufgefallen: Bei derselben Eingabeaufforderung wirken Argons Antworten manchmal „weniger durchdacht“. Die Ursache liegt wahrscheinlich in der Standardeinstellung der Gemini 4 Argon-Schlussfolgerungsstufe. Laut der offiziellen Dokumentation von Google ist thinking_level bei Gemini 4 Argon standardmäßig auf medium statt auf high eingestellt. gemini-3.1-pro-preview verwendet dagegen standardmäßig die höchste Stufe, high. Wenn dein Code oder Client die Schlussfolgerungsstufe nie ausdrücklich festlegt, wird die Denktiefe des Modells nach der Migration unbemerkt um eine Stufe reduziert.
Noch komplizierter wird es dadurch, dass gängige Chat-Clients wie Cherry Studio neue Modelle oft erst mit Verzögerung unterstützen. Die Option für die Schlussfolgerungsstufe erscheint dann möglicherweise gar nicht im Eingabefeld. Dieser Artikel erklärt zunächst die verfügbaren Stufen, Standardwerte und Auswirkungen auf die Kosten von Gemini 4 Argon. Anschließend zeigen wir drei Möglichkeiten zur Einstellung: über die native API, eine OpenAI-kompatible Schnittstelle und benutzerdefinierte Parameter in Cherry Studio.
Das nimmst du mit: Nach der Lektüre kannst du die Schlussfolgerungsstufe von Gemini 4 Argon unabhängig von der Aufrufmethode auf den gewünschten Wert setzen und Stolperfallen wie die Kürzung durch max_tokens oder HTTP-400-Fehler wegen ungültiger Parameter vermeiden.
Die wichtigsten Fakten zur Gemini 4 Argon-Schlussfolgerungsstufe
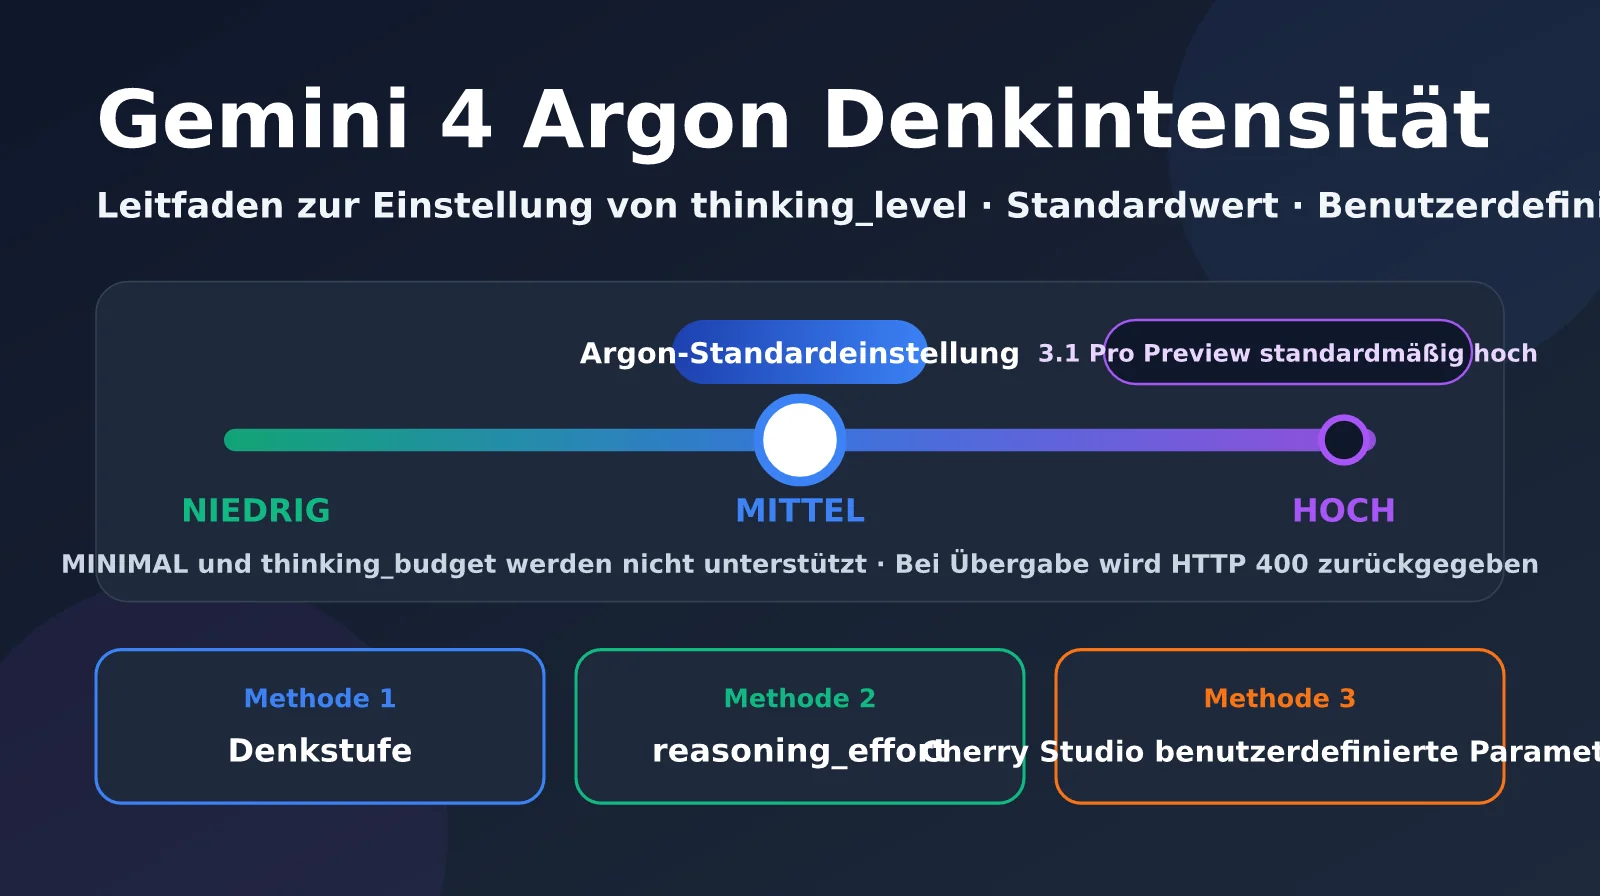
Gemini 4 Argon steuert die Schlussfolgerungsstufe über den Parameter thinking_level. Unterstützt werden nur die drei Stufen low, medium und high. Im Vergleich zu den Vorgängermodellen gibt es weder thinking_budget zur Festlegung einer Token-Anzahl noch die Stufe minimal. Werden diese Parameter verwendet, gibt die API direkt einen HTTP-400-Fehler zurück. Die folgende Tabelle fasst die offiziellen Angaben zu den drei Stufen im Entwicklerleitfaden von Google Cloud zusammen.
| Schlussfolgerungsstufe | Standard? | Empfohlene Einsatzbereiche laut Google | Merkmale |
|---|---|---|---|
| LOW | Nein | Klassifizierung, Zusammenfassungen, Extraktion von Metadaten | Geringste Latenz, erzeugt kaum Thinking-Tokens |
| MEDIUM | ✅ Standard für gemini-4-argon | Alltägliche Programmierung, Tool-Aufrufe, Fragen zu Dokumenten, Videoverständnis | Gute Balance zwischen Geschwindigkeit, Kosten und Genauigkeit |
| HIGH | ✅ Standard für die cyber-permissive-Version | Softwareentwicklung über mehrere Dateien hinweg, formale Beweise, Architekturentwurf, Schwachstellenanalyse | Am gründlichsten; die Latenz bis zum ersten Token und die Kosten steigen deutlich |
| MINIMAL | Nicht unterstützt | — | Führt zu HTTP 400 |
| thinking_budget | Nicht unterstützt | — | Bei Vorgängermodellen wurde der Wert stillschweigend umgewandelt; Argon gibt direkt HTTP 400 zurück |
Beachte: Die Version gemini-4-argon-cyber-permissive, die sich an die Verteidiger im Fairwind-Programm richtet, verwendet standardmäßig HIGH. Nur die Standardversion gemini-4-argon ist auf MEDIUM eingestellt. Außerdem wurden alle Ergebnisse von Argon in Googles Benchmark-Tabellen mit der höchsten Schlussfolgerungsstufe erzielt. Wenn du das Modell mit dem Standardwert medium aufrufst, erreichst du möglicherweise nicht die offiziell beworbene Leistung.
Standardwerte der Gemini 4 Argon-Schlussfolgerungsstufe im Vergleich zu Vorgängermodellen
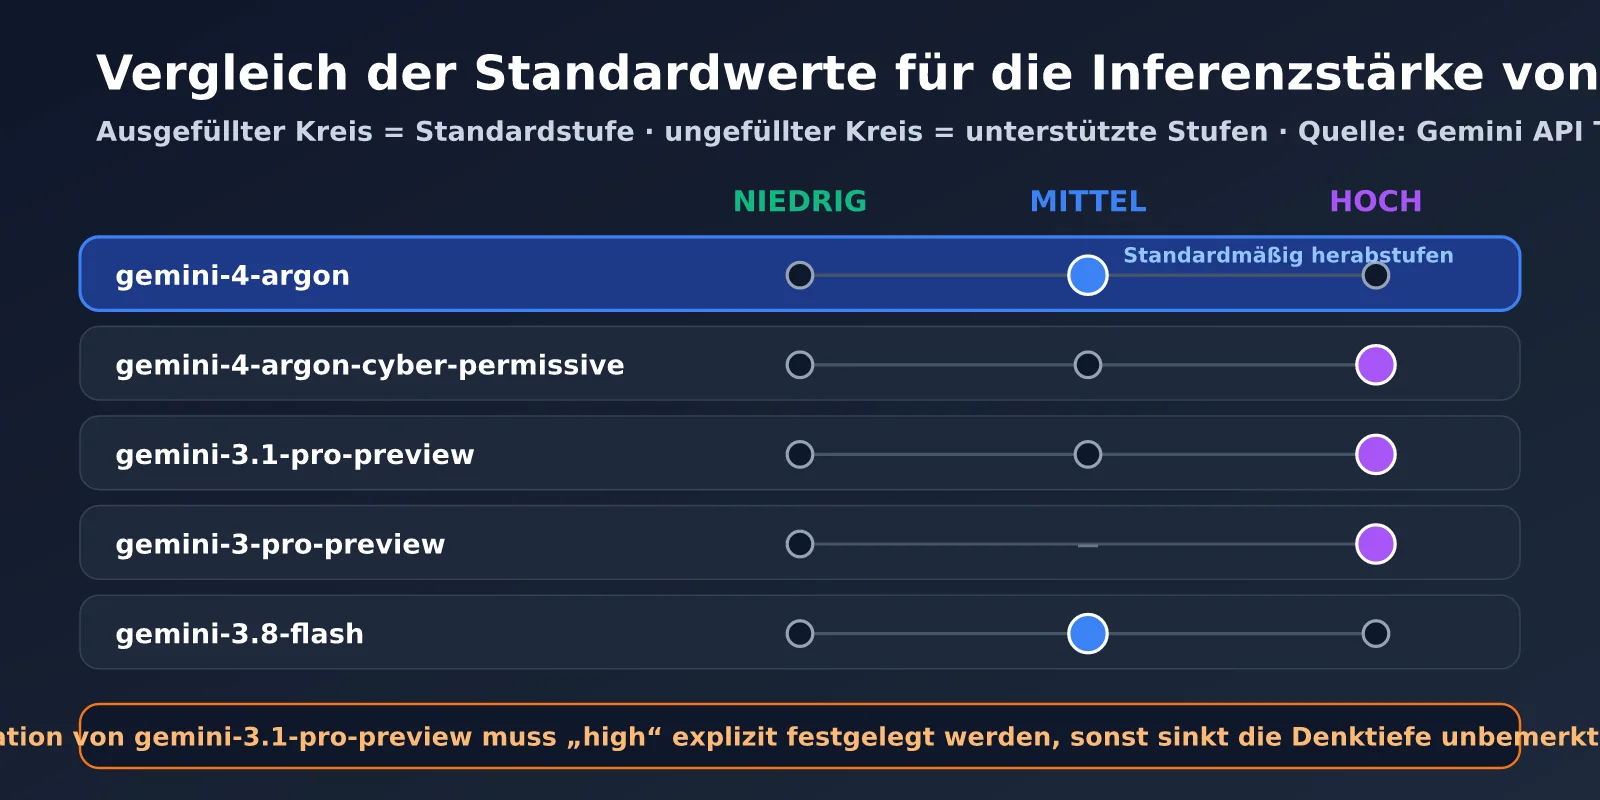
Ein Vergleich der Standardwerte von Gemini 4 Argon mit denen einiger aktueller Gemini-Modelle macht die Risiken einer Migration deutlich. Die folgenden Angaben stammen aus der offiziellen Dokumentation zu Thinking in der Google Gemini API.
| Modell | Standardstufe | Unterstützte Stufen |
|---|---|---|
| gemini-4-argon | medium | low, medium, high |
| gemini-4-argon-cyber-permissive | high | low, medium, high |
| gemini-3.1-pro-preview | high | low, medium, high |
| gemini-3-pro-preview | high | low, high |
| gemini-3.8-flash | medium | low, medium, high |
| gemini-3-flash-preview | high | minimal, low, medium, high |
Wie zu sehen ist, senkt Google bei neuen Modellen die standardmäßige Schlussfolgerungsstufe von high auf medium. Das gilt sowohl für Gemini 3.8 Flash als auch für Gemini 4 Argon. Dadurch sinken standardmäßig Latenz und Kosten. Wer jedoch daran gewöhnt ist, dass 3.1 Pro standardmäßig „mit voller Kraft nachdenkt“, muss bei der Migration zu Argon ausdrücklich high einstellen, um die bisherige Denktiefe beizubehalten.
🎯 Migrationstipp: Wenn du von gemini-3.1-pro-preview zu Gemini 4 Argon wechselst, solltest du die Schlussfolgerungsstufe zuerst ausdrücklich im Code festlegen und dann die Ausgabequalität der beiden Modelle vergleichen. Über die einheitliche Schnittstelle der Plattform APIYI apiyi.com kannst du beide Gemini-Modelle parallel für einen A/B-Vergleich aufrufen. Dafür musst du lediglich den Parameter
modeländern.
Zusammenhang zwischen Gemini 4 Argon-Schlussfolgerungsstufe und Kosten
Die Schlussfolgerungsstufe wirkt sich nicht nur auf die Qualität der Antworten aus, sondern auch direkt auf die Rechnung. Die Thinking-Tokens von Argon werden zum Preis für Ausgabetokens abgerechnet: während der Einführungsphase 10 US-Dollar pro Million Tokens, zum regulären Preis 20 US-Dollar. Der Denkprozess wird standardmäßig nicht vollständig für Nutzer angezeigt. Das heißt: Je höher die Stufe, desto mehr zahlst du für das „unsichtbare Denken“.
Bei einem groben Ansatz mit dem Einführungspreis kostet allein der Denkprozess einer einzelnen Anfrage mit der Stufe high etwa 0,015 US-Dollar, wenn dabei 1.500 Thinking-Tokens anfallen. Bei 10.000 Aufrufen pro Tag summieren sich die zusätzlichen Kosten im Monat auf rund 4.500 US-Dollar. Das ist auch ein praktischer Grund dafür, dass Google die Standardstufe von Argon auf medium gesenkt hat: Für die meisten alltäglichen Anfragen ist die tiefste Schlussfolgerung nicht nötig. Mit high als Standard würden viele Nutzer für Denkaufwand bezahlen, den sie gar nicht brauchen. Sinnvoller ist es daher, die Stufe je nach Aufgabentyp festzulegen, statt sie pauschal für alle Anfragen auf high zu setzen.
Drei Möglichkeiten, den Denkaufwand von Gemini 4 Argon einzustellen
Je nach Aufrufart gibt es drei Möglichkeiten, den Denkaufwand von Gemini 4 Argon festzulegen: thinking_level im nativen Google-SDK, reasoning_effort über die OpenAI-kompatible Schnittstelle oder die Weitergabe nativer Google-Parameter über extra_body. Diese Optionen dürfen nicht gleichzeitig verwendet werden, sonst wird ein Fehler zurückgegeben.
| Einstellung | Parameterposition | Zulässige Werte | Geeignet für |
|---|---|---|---|
Natives thinking_level |
thinking_config.thinking_level |
LOW / MEDIUM / HIGH | Google GenAI SDK, Vertex AI |
OpenAI-kompatibles reasoning_effort |
reasoning_effort auf oberster Ebene des Request-Bodys |
minimal / low / medium / high | OpenAI SDK und verschiedene kompatible Clients |
Weitergabe über extra_body |
extra_body.google.thinking_config |
low / medium / high | Wenn zusätzlich native Optionen wie Denkzusammenfassungen aktiviert werden sollen |
reasoning_effort in der OpenAI-kompatiblen Schnittstelle wird auf Argons thinking_level abgebildet. Laut der offiziellen Zuordnungstabelle von Google werden sowohl minimal als auch low auf low abgebildet, medium auf medium und high auf high. Höhere Stufen wie xhigh und max, die OpenAI und Anthropic verwenden, kennt Argon jedoch nicht. Werden sie übergeben, gibt die Schnittstelle direkt einen 400-Fehler zurück.
Methode 1: thinking_level im nativen SDK festlegen
Mit dem Google GenAI SDK kannst du die gewünschte Stufe direkt in ThinkingConfig angeben. Der Vertex-AI-Endpunkt unterstützt die drei Regionen global, us und eu.
from google import genai
from google.genai import types

client = genai.Client(enterprise=True, project="YOUR_PROJECT", location="global")

resp = client.models.generate_content(
    model="gemini-4-argon",
    contents="为多生产者单消费者场景设计一个无锁环形缓冲区",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="HIGH"),
        max_output_tokens=32768,
    ),
)
print(resp.text)
Methode 2: reasoning_effort über die OpenAI-kompatible Schnittstelle festlegen
Wenn dein Projekt auf dem OpenAI SDK basiert, ist der Aufruf von Argon über die kompatible Schnittstelle der einfachste Weg. Du musst lediglich den Parameter reasoning_effort hinzufügen.
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="high",      # Wird auf thinking_level=high abgebildet
    max_tokens=32000,             # Genügend Platz für Denk-Tokens einplanen
    messages=[{"role": "user", "content": "审查这段并发代码的竞态条件"}],
)
print(resp.choices[0].message.content)
print(resp.usage)
Vollständiger Code: Weitergabe über extra_body und Vergleich der drei Stufen
import time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
PROMPT = "一个 Kubernetes Pod 一直处于 CrashLoopBackOff,请给出系统的排查步骤和命令"


def call_with_effort(level: str):
    """Methode 2: OpenAI-kompatibles reasoning_effort"""
    start = time.time()
    resp = client.chat.completions.create(
        model="gemini-4-argon",
        reasoning_effort=level,
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
    )
    return resp, time.time() - start


def call_with_extra_body(level: str):
    """Methode 3: Native Google-Einstellung thinking_config über extra_body weitergeben
    Hinweis: Nicht gleichzeitig mit reasoning_effort verwenden"""
    return client.chat.completions.create(
        model="gemini-4-argon",
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
        extra_body={
            "google": {
                "thinking_config": {
                    "thinking_level": level,
                    "include_thoughts": True,
                }
            }
        },
    )


if __name__ == "__main__":
    for level in ("low", "medium", "high"):
        resp, cost_time = call_with_effort(level)
        u = resp.usage
        print(f"[{level:6}] 耗时 {cost_time:5.1f}s | 输出 {u.completion_tokens} token")
💡 Hinweis zum Aufruf: Die OpenAI-kompatible Schnittstelle ist der einfachste Weg, Gemini 4 Argon einzubinden. Bestehender Code auf Basis des OpenAI SDK muss dafür meist kaum geändert werden. Über APIYI apiyi.com kannst du ein Testguthaben erhalten. Mit dem Vergleichsskript oben kannst du zunächst prüfen, wie sich die verschiedenen Denkstufen bei typischen Aufgaben auswirken.
Denkaufwand von Gemini 4 Argon in Cherry Studio einstellen
Unten rechts im Eingabefeld von Cherry Studio gibt es ein Dropdown-Menü für den Denkaufwand. Diese Option wird allerdings nur bei Modellen angezeigt, die der Client als Reasoning-Modelle erkennt. Laut Community-Issues prüft Cherry Studio die Unterstützung anhand eines integrierten Modellverzeichnisses, das beim Erstellen der Anwendung aus models.dev und OpenRouter generiert wird. Zur Laufzeit abgerufene Informationen zu den Modellfähigkeiten werden dabei nicht berücksichtigt. Bei einem gerade veröffentlichten Modell wie Gemini 4 Argon wird das Dropdown-Menü daher möglicherweise erst angezeigt, wenn das Verzeichnis im Client aktualisiert wurde. Es kann auch vorkommen, dass die Option zwar verfügbar ist, aber keine Wirkung zeigt.
In diesem Fall ist die zuverlässigste Lösung die Funktion für benutzerdefinierte Parameter in Cherry Studio. Laut offizieller Dokumentation werden benutzerdefinierte Parameter direkt zum Request-Body hinzugefügt und haben Vorrang vor integrierten Parametern.
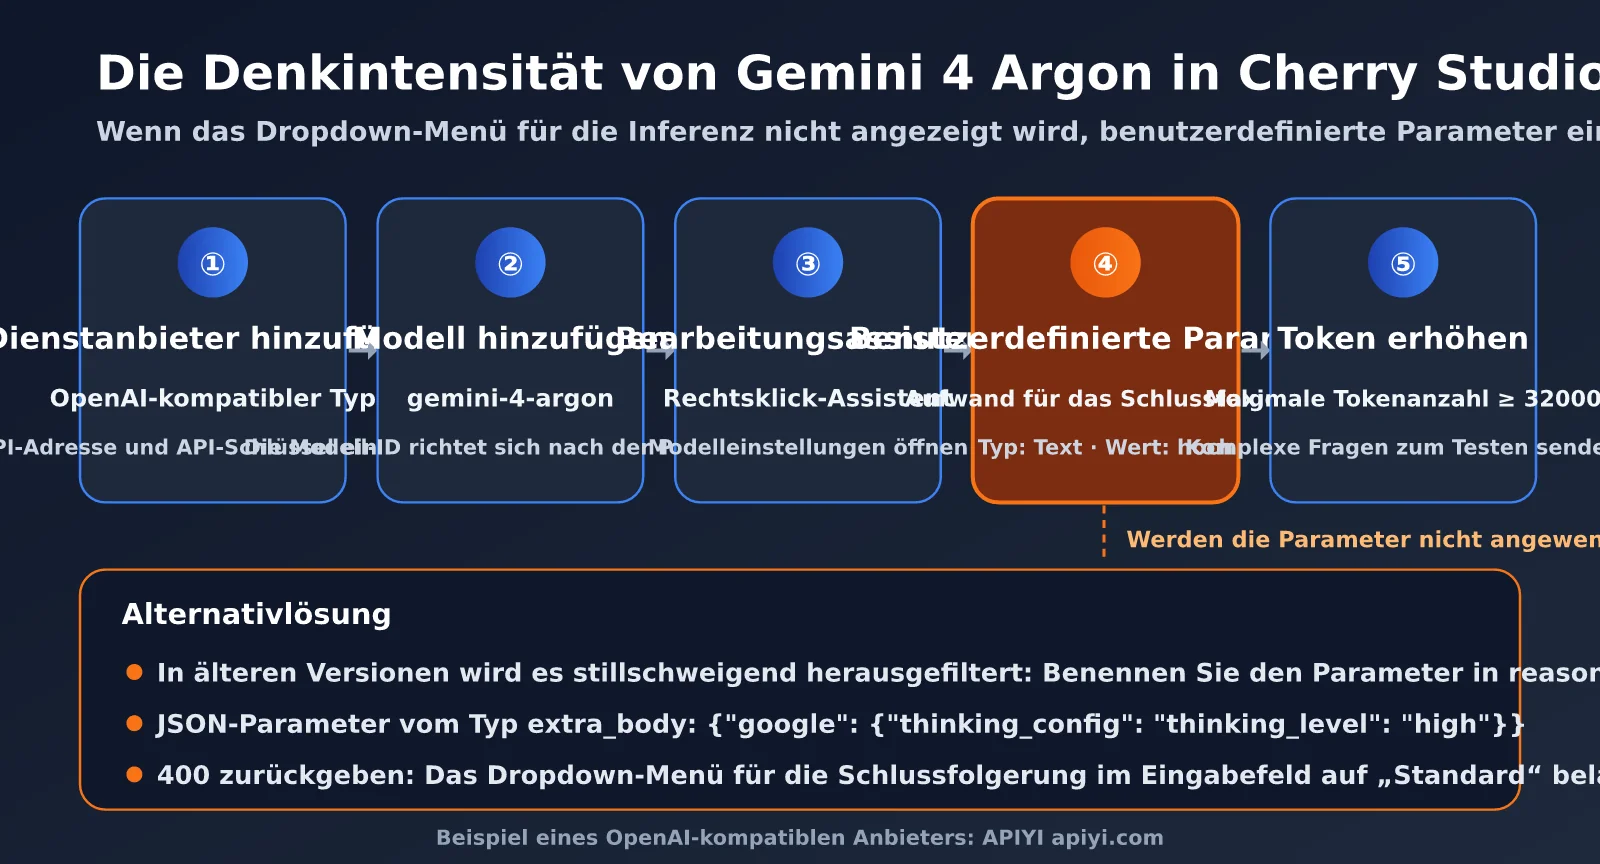
Benutzerdefinierte Parameter in Cherry Studio konfigurieren
Am Beispiel eines OpenAI-kompatiblen Anbieters sieht die Konfiguration so aus:
- Anbieter hinzufügen: Füge in den Einstellungen einen OpenAI-kompatiblen Anbieter hinzu und trage die API-Adresse sowie den API-Schlüssel ein, zum Beispiel
https://api.apiyi.comvon APIYI. - Modell hinzufügen: Füge beim Anbieter die Modell-ID
gemini-4-argonhinzu. - Assistenteneinstellungen öffnen: Klicke in der Assistentenliste mit der rechten Maustaste auf den gewünschten Assistenten, wähle „Assistent bearbeiten“ und öffne den Tab „Modelleinstellungen“.
- Benutzerdefinierten Parameter hinzufügen: Gib als Parameternamen
reasoning_effortein, wähle als Typ „Text“ und trage als Werthighein (oderlowbzw.medium). - Ausgabelimit erhöhen: Aktiviere „Maximale Token-Anzahl“ und setze den Wert höher. Empfohlen werden mindestens 32000 Token, damit genug Platz für den Denkprozess bleibt.
- Testanfrage senden: Teste die Einstellung mit einer Frage, die mehrstufiges Denken erfordert. Vergleiche Antwortzeit und Denkprozess vor und nach der Änderung.
Falls der Denkaufwand nach diesen Schritten noch immer nicht angepasst wird, kommen folgende häufige Ursachen infrage:
| Beobachtung | Mögliche Ursache | Lösung |
|---|---|---|
Nach dem Festlegen von reasoning_effort ändert sich nichts |
Ältere Versionen filtern den Parameter im OpenAI-kompatiblen Modus stillschweigend heraus | Auf die neueste Version aktualisieren oder stattdessen den Parameternamen reasoningEffort verwenden |
| Das Dropdown-Menü für den Denkaufwand wird im Eingabefeld nicht angezeigt | Argon ist noch nicht im integrierten Modellverzeichnis enthalten | Benutzerdefinierte Parameter verwenden; erfahrene Nutzer können die Angaben zu den Denkfähigkeiten in der Modellkonfiguration ergänzen |
| Die Anfrage gibt einen 400-Fehler zurück | Der Client sendet Stufen wie max oder xhigh, die Argon nicht unterstützt |
Das Dropdown-Menü auf „Standard“ lassen und low, medium oder high ausschließlich über benutzerdefinierte Parameter festlegen |
| Der Parameter wird von integrierten Einstellungen überschrieben | Die Denkoption im Eingabefeld steht im Konflikt mit dem benutzerdefinierten Parameter | Das Eingabefeld auf „Standard“ lassen und den Parameter nicht an zwei Stellen festlegen |
| Native Parameter sollen weitergegeben werden | Die Denkzusammenfassung soll zusätzlich aktiviert werden | Einen Parameter vom Typ JSON namens extra_body mit dem Wert {"google": {"thinking_config": {"thinking_level": "high"}}} hinzufügen |
Das Problem, dass reasoning_effort stillschweigend herausgefiltert wurde, hat Cherry Studio im März 2026 mit einem PR behoben. Neue Versionen wandeln den Parameter automatisch in das intern verwendete reasoningEffort um. Wenn du eine ältere Version nutzt, kannst du den Filter umgehen, indem du den Parameternamen direkt in camelCase als reasoningEffort angibst.
Bei anderen gängigen Chat-Clients ist das Vorgehen ähnlich: Suche nach einem Menüpunkt wie „Benutzerdefinierte Parameter“, „Zusätzlicher Request-Body“ oder „Erweiterte Parameter“ und füge reasoning_effort als Feld auf oberster Ebene des Request-Bodys hinzu. Wenn der Client nur JSON unterstützt, kannst du die native thinking_config über extra_body weitergeben. Vergleiche nach der Konfiguration Antwortzeit und Tokenverbrauch anhand derselben komplexen Frage, um sicherzustellen, dass der Parameter tatsächlich greift.
🚀 Empfehlung für den Client: Wenn du Gemini 4 Argon in Cherry Studio einbindest, empfiehlt sich ein OpenAI-kompatibler Anbieter, da die Parameter damit am zuverlässigsten weitergegeben werden. APIYI apiyi.com bietet eine einheitliche OpenAI-kompatible Schnittstelle. Nach einmaliger Konfiguration in Cherry Studio kannst du damit Modelle aus den Gemini-, Claude- und GPT-Familien verwenden.
Gemini 4 Argon: Praxistest zur Reasoning-Stufe und Tipps zur Fehlervermeidung
Die Reasoning-Stufe wirkt sich direkt auf Latenz, Kosten und Ausgabequalität aus. Der technische Blog ComputingForGeeks hat mit Argon eine Reihe von Vergleichstests für Aufgaben aus dem IT-Betrieb durchgeführt. Die Ergebnisse sind sehr aufschlussreich.
| Testkriterium | Standard (medium) | high | Unterschied |
|---|---|---|---|
| Durchschnittliche Anzahl ausgegebener Token | 463 | 1.836 | etwa 4-mal so viele |
| Durchschnittliche Latenz | 5,5 Sekunden | 15,3 Sekunden | etwa 2,8-mal so hoch |
| Erstes sichtbares Token | etwa 4,3 Sekunden | 12–13 Sekunden | zunächst werden etwa 1.400 Denk-Token ausgegeben |
| Kosten für 9 Aufrufe (Einführungspreis) | $0.045 | $0.169 | etwa 3,8-mal so hoch |
| Vergleich von low / medium mit Standard | nahezu identisch | — | Bei kurzen Aufgaben wurden in beiden Fällen keine Denk-Token erzeugt |
Die Daten zeigen zwei Dinge. Erstens gibt es bei einfachen, kurzen Aufgaben kaum Unterschiede zwischen low, medium und der Standardeinstellung. Keine dieser Stufen erzeugt Denk-Token – erst high sorgt für ein tatsächliches „tiefes Nachdenken“. Zweitens hat die Stufe high einen klaren Preis: Die Kosten sind fast viermal so hoch, und die Latenz bis zum ersten Token steigt um etwa 8 Sekunden. Zu beachten ist, dass der Test nur kurze Eingabeaufforderungen umfasst. Bei komplexen, längeren Aufgaben kann auch die Stufe medium einen Denkprozess erzeugen.
4 häufige Fehler bei der Einstellung der Gemini 4 Argon Reasoning-Stufe
Die Google-Migrationsanleitung und Praxistests aus der Community zeigen, worauf Sie bei der Einstellung der Gemini 4 Argon Reasoning-Stufe besonders achten sollten:
- Zu kleiner Wert für max_tokens führt zu einer leeren Antwort:
max_output_tokensumfasst sowohl Denk-Token als auch Token des Antworttexts. In einem Praxistest verwendete Argon bei der Stufe high mit einem max_tokens-Wert von 1024 alle 1021 Token für das Denken und gab am Ende eine leere Zeichenfolge zurück. Der Beendigungsgrund warMAX_TOKENS. Planen Sie bei der Stufe high mindestens 16K–32K ein. - Die Übernahme von thinking_budget führt direkt zu einem Fehler:
gemini-3.1-pro-previewordnetthinking_budgetstillschweigend einer Stufe zu, Argon gibt dagegen direkt den Fehler 400 zurück. Entfernen Sie den Parameter daher unbedingt bei der Migration. - Sampling-Parameter wie temperature werden ignoriert: Laut Google-Dokumentation ignoriert das Argon-Backend benutzerdefinierte temperature-Werte.
frequency_penalty,presence_penaltyundcandidate_countführen außerdem zu einem Fehler 400. Steuern Sie die Denktiefe am besten über die Reasoning-Stufe und das Ausgabeformat überresponse_schema. - Kosten mit max_tokens zu senken, kann nach hinten losgehen: Google empfiehlt, die Reasoning-Stufe zu senken, wenn Kosten und Latenz reduziert werden sollen – nicht den Wert für max_tokens. Andernfalls wird die Ausgabe leicht abgeschnitten.
📊 Empfehlung zur Stufenwahl: Für alltägliche Fragen und einfache Programmieraufgaben reicht die Standardeinstellung medium aus. Bei komplexen Architekturentwürfen, Refactorings über mehrere Dateien oder mathematischen Beweisen können Sie auf high wechseln. Vergleichen Sie in den Aufrufprotokollen der APIYI-Plattform apiyi.com den Tokenverbrauch der verschiedenen Stufen, um das beste Verhältnis zwischen Qualität und Kosten zu finden.
Häufig gestellte Fragen
F1: Ist die Reasoning-Stufe von Gemini 4 Argon standardmäßig auf high eingestellt?
Nein. Die Standardversion `gemini-4-argon` verwendet standardmäßig medium. Nur `gemini-4-argon-cyber-permissive`, das sich an Akteure im Bereich Cyberabwehr richtet, ist standardmäßig auf high eingestellt. Das unterscheidet sich von `gemini-3.1-pro-preview`, bei dem standardmäßig die höchste Stufe high aktiv ist. Wenn Sie die maximale Reasoning-Leistung benötigen, müssen Sie `thinking_level=“high“` oder `reasoning_effort=“high“` explizit setzen.
F2: Kann man bei Gemini 4 Argon das Denken deaktivieren oder minimal einstellen?
Nein. Argon unterstützt nur die drei Stufen low, medium und high. Die Einstellung minimal oder `thinking_budget` führt zu einem HTTP-Fehler 400. Wird über eine OpenAI-kompatible Schnittstelle `reasoning_effort=“minimal“` übergeben, wird der Wert auf low abgebildet. Wenn Sie eine sehr niedrige Latenz benötigen, kommen Modelle wie die Gemini-3.x-Flash-Reihe infrage, die eine minimal-Stufe unterstützen.
F3: Was kann ich tun, wenn die Option für die Reasoning-Stufe in Cherry Studio nicht angezeigt wird?
Der Grund dafür ist, dass Argon noch nicht im integrierten Modellverzeichnis von Cherry Studio aufgeführt ist. Sie können unter „Assistent bearbeiten → Modelleinstellungen“ den benutzerdefinierten Parameter `reasoning_effort` hinzufügen. Wählen Sie als Typ Text und setzen Sie den Wert auf `high`. Benutzerdefinierte Parameter haben Vorrang vor integrierten Parametern. Empfehlenswert sind OpenAI-kompatible Anbieter wie APIYI apiyi.com, bei denen Parameter besonders zuverlässig weitergeleitet werden.
F4: Wie kann ich prüfen, ob die Reasoning-Stufe tatsächlich angewendet wird?
Am einfachsten prüfen Sie die Anzahl der ausgegebenen Token in den Nutzungsdaten der Antwort sowie die Antwortzeit: Bei high sind die Zahl der ausgegebenen Token und die Latenz bis zum ersten Token deutlich höher als bei der Standardeinstellung. In Cherry Studio können Sie außerdem darauf achten, ob Denkinhalte angezeigt werden. Testen Sie am besten dieselbe komplexe Frage einmal mit der Standardeinstellung und einmal mit high und vergleichen Sie die Ergebnisse.
Zusammenfassung
Die wichtigste Erkenntnis zur Reasoning-Intensität von Gemini 4 Argon: Standardmäßig ist medium eingestellt, nicht high. Das unterscheidet sich von gemini-3.1-pro-preview, bei dem standardmäßig die höchste Stufe aktiv ist. Wenn Sie beim Wechsel das Niveau nicht ausdrücklich festlegen, sinkt die Denktiefe des Modells unbemerkt um eine Stufe. Argon unterstützt nur die drei Stufen low, medium und high. thinking_budget und minimal führen zu einem 400-Fehler. Bei high sollten Sie außerdem genügend max_tokens für die Thinking-Tokens vorsehen.
Bei den Aufrufen verwenden Sie im nativen SDK thinking_level und in der OpenAI-kompatiblen Schnittstelle reasoning_effort. Clients wie Cherry Studio, die Argons Reasoning-Optionen noch nicht unterstützen, können sie über benutzerdefinierte Parameter übergeben. Für alltägliche Aufgaben empfiehlt sich die Standardeinstellung medium. Bei komplexen Aufgaben können Sie je nach Bedarf auf high wechseln und die passende Stufe anhand praktischer Tests bestimmen.
Wir empfehlen, Gemini 4 Argon über die Plattform APIYI apiyi.com einheitlich über die OpenAI-kompatible Schnittstelle anzubinden. So können Sie in Ihrem Code und in Clients wie Cherry Studio die Reasoning-Intensität flexibel über den Parameter reasoning_effort steuern.
Referenzen:
- Google Gemini API-Dokumentation zu Thinking: ai.google.dev/gemini-api/docs/thinking
- Google Gemini API-Dokumentation zur OpenAI-Kompatibilität: ai.google.dev/gemini-api/docs/openai
- Google Cloud-Entwicklerleitfaden für Gemini 4 Argon: docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- Dokumentation zu den Assistenteneinstellungen von Cherry Studio: docs.cherryai.com.cn
- Cherry Studio GitHub-Issues Nr. 11987 und 19761: github.com/CherryHQ/cherry-studio
Autor: APIYI Team | Wir teilen regelmäßig Praxiserfahrungen zur Anbindung großer Sprachmodelle und zur Optimierung von Parametern. Weitere Tutorials zur Anbindung von KI-Modellen finden Sie auf APIYI apiyi.com.