Anmerkung des Autors: Alphabet meldet, dass die APIs seiner eigenen Modelle fast 32 Milliarden Token pro Minute verarbeiten. Dieser Artikel vergleicht Gemini 4 Argon, 3.8 Flash und 3.5 Flash-Lite anhand offizieller Preise, unabhängiger Tests und Kostensimulationen. So lässt sich berechnen, was eine Aufgabe insgesamt kostet, wenn das Ergebnis die Anforderungen erfüllt.
Am 28. Oktober 2026 gab Alphabet-CEO Sundar Pichai bei der Bekanntgabe der Quartalszahlen für das dritte Quartal bekannt, dass die APIs der hauseigenen Modelle derzeit fast 32 Milliarden Token pro Minute verarbeiten – mehr als viermal so viel wie im Vorjahr. Die Zahl zeigt, wie stark Entwickler und Unternehmen die Gemini API insgesamt nutzen. Sie bezieht sich nicht auf ein einzelnes Modell.
Dies ist keine weitere Empfehlung nach dem Motto „Nimm einfach das stärkste Modell“. Mit steigender Zahl an Modellaufrufen fallen Kosten und Modellwahl immer stärker ins Gewicht. Wer die falsche Modellklasse wählt, zahlt möglicherweise ein Vielfaches pro Monat. Oder muss Aufgaben wegen mangelnder Fähigkeiten wiederholt ausführen – und zahlt am Ende ebenfalls mehr.
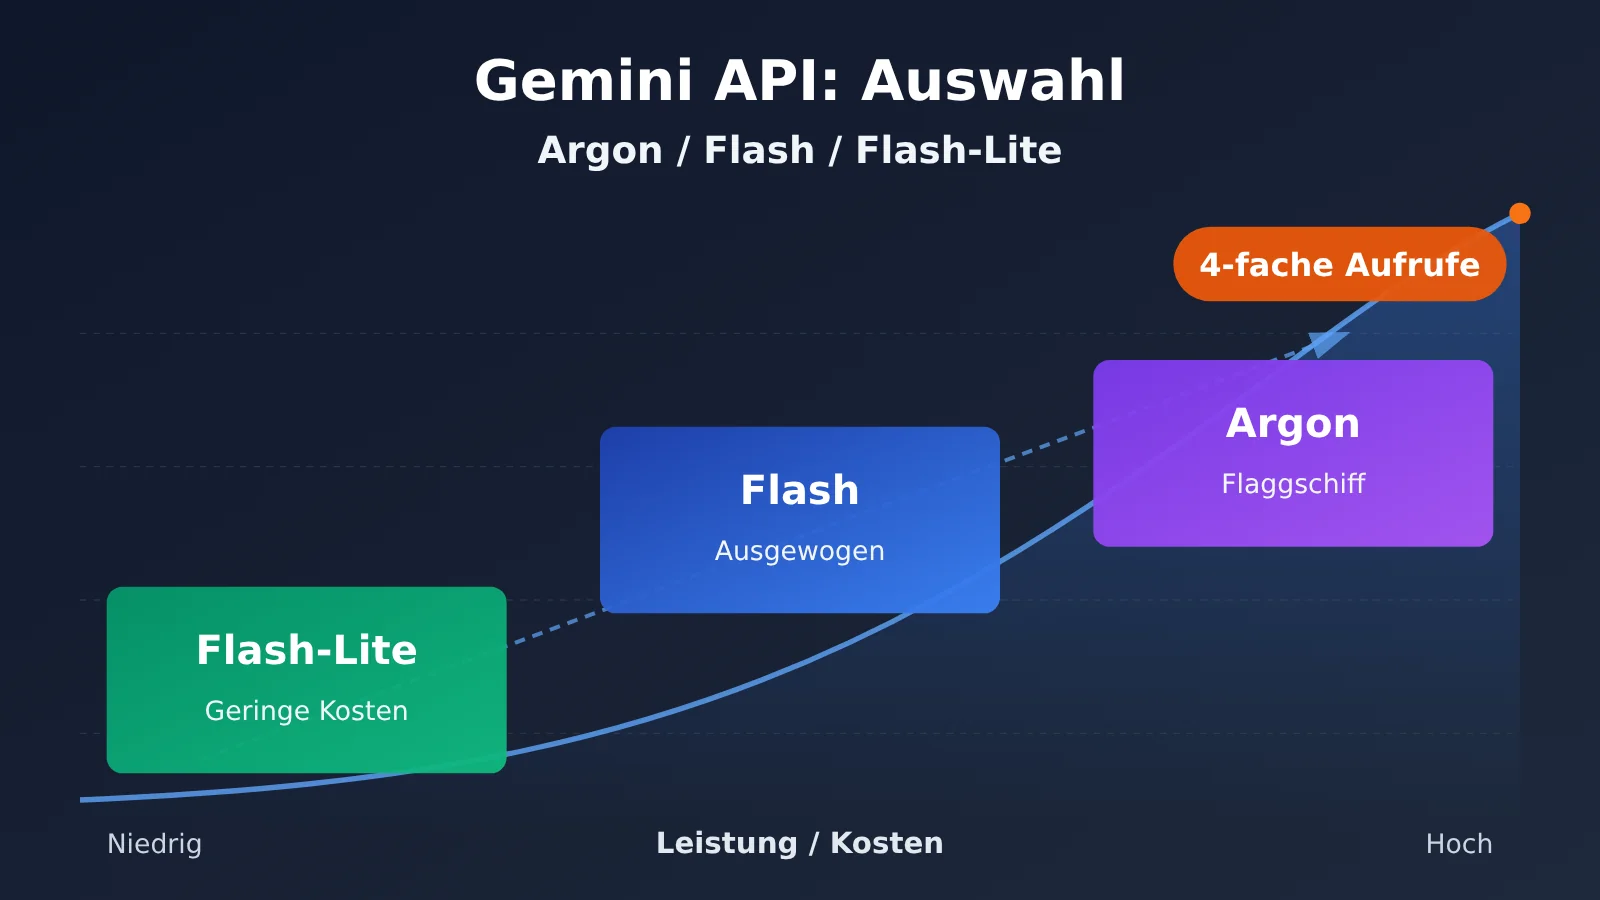
Was dieser Artikel bietet: Sie erfahren, wie sich die drei Gemini-Modelle Argon, Flash und Flash-Lite bei Fähigkeiten, Preis, Geschwindigkeit und Einsatzgebieten unterscheiden. Außerdem stellen wir eine praxistaugliche Testmethode vor, mit der Sie eine erste Modellauswahl für Ihren Anwendungsfall treffen können.
Gemini-API-Nutzung steigt rasant: Das Wichtigste im Überblick
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 28. Oktober 2026 (Alphabet-Quartalsbericht für Q3 2026) |
| Bekannt gegeben von | Alphabet-CEO Sundar Pichai |
| Kerndaten | Die API für eigene Modelle verarbeitet fast 32 Milliarden Token pro Minute – rund 40 % mehr als beim zuletzt veröffentlichten Quartalswert und mehr als viermal so viel wie im Vorjahr |
| Aktuelle wichtigste API-Modelle | Gemini 4 Argon, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite |
| Betroffene | Alle Entwickler und Unternehmen, die Anwendungen mit der Gemini Developer API erstellen |
Was 32 Milliarden Token pro Minute für Entwickler mit der Gemini API bedeuten
Der starke Nutzungsanstieg zeigt, dass die Modelle bereits in grossem Umfang produktiv eingesetzt werden. Das bedeutet aber nicht, dass jedes Projekt das teuerste Flaggschiffmodell braucht. Bei der Modellauswahl sollten Sie mindestens die Komplexität der Aufgabe, die Qualitätsanforderungen an die Ausgabe, das Anfragevolumen, die Antwortgeschwindigkeit, den Token-Verbrauch, die Fehlertoleranz des Anwendungsfalls, den Bedarf an einem langen Kontextfenster und Tool-Aufrufen sowie mögliche künftige Preisänderungen berücksichtigen.
Wichtig: Flash steht in diesem Artikel für Gemini 3.8 Flash, Flash-Lite für Gemini 3.5 Flash-Lite. Verwechseln Sie diese nicht mit der älteren Gemini-2.5-Flash-Serie. Ausserdem gilt: Wie hoch die weltweite Nutzung auch sein mag – für einzelne Entwickler gelten weiterhin Kontingente. Auf diese Aufruflimits gehen wir später gesondert ein.
Positionierung der drei Gemini-Modelle Argon, Flash und Flash-Lite
Google deckt mit drei Modellklassen unterschiedliche Anforderungen an Kosten und Leistung ab. Die folgende Tabelle basiert auf den offiziellen Modellangaben:
| Merkmal | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| API-ID | gemini-4-argon |
gemini-3.8-flash |
gemini-3.5-flash-lite |
| Offizielle Positionierung | Flaggschiff-Modell für Reasoning | Balance zwischen Effizienz und Leistung | Geringe Latenz, niedrige Kosten, hoher Durchsatz |
| Kontext | Rund 1 Million Token | Eingabe: 1048576 Token | Eingabe: 1048576 Token |
| Standardmäßiges Ausgabelimit | 65536 Token (über einen Mechanismus für lange Ausgaben erweiterbar) | 65536 Token | 65536 Token |
| Denkstufen | low / medium / high, Standard: medium | low / medium / high, Standard: medium | minimal / low / medium / high, Standard: minimal |
| Tool-Funktionen | Funktionsaufrufe, strukturierte Ausgabe, Search Grounding, Codeausführung | Funktionsaufrufe, strukturierte Ausgabe, Codeausführung, Dateisuche, Search Grounding | Strukturierte Ausgabe, Funktionsaufrufe, Caching |
| Eingabemodalitäten | Text, Bilder, Audio, Video, PDF | Text, Bilder, Audio, Video, PDF | Text, Bilder, Audio, Video, PDF |
| Kostenloser API-Tarif | Nicht verfügbar | Begrenzt verfügbar | Begrenzt verfügbar |
Wo die Grenzen der drei Gemini-Modelle liegen
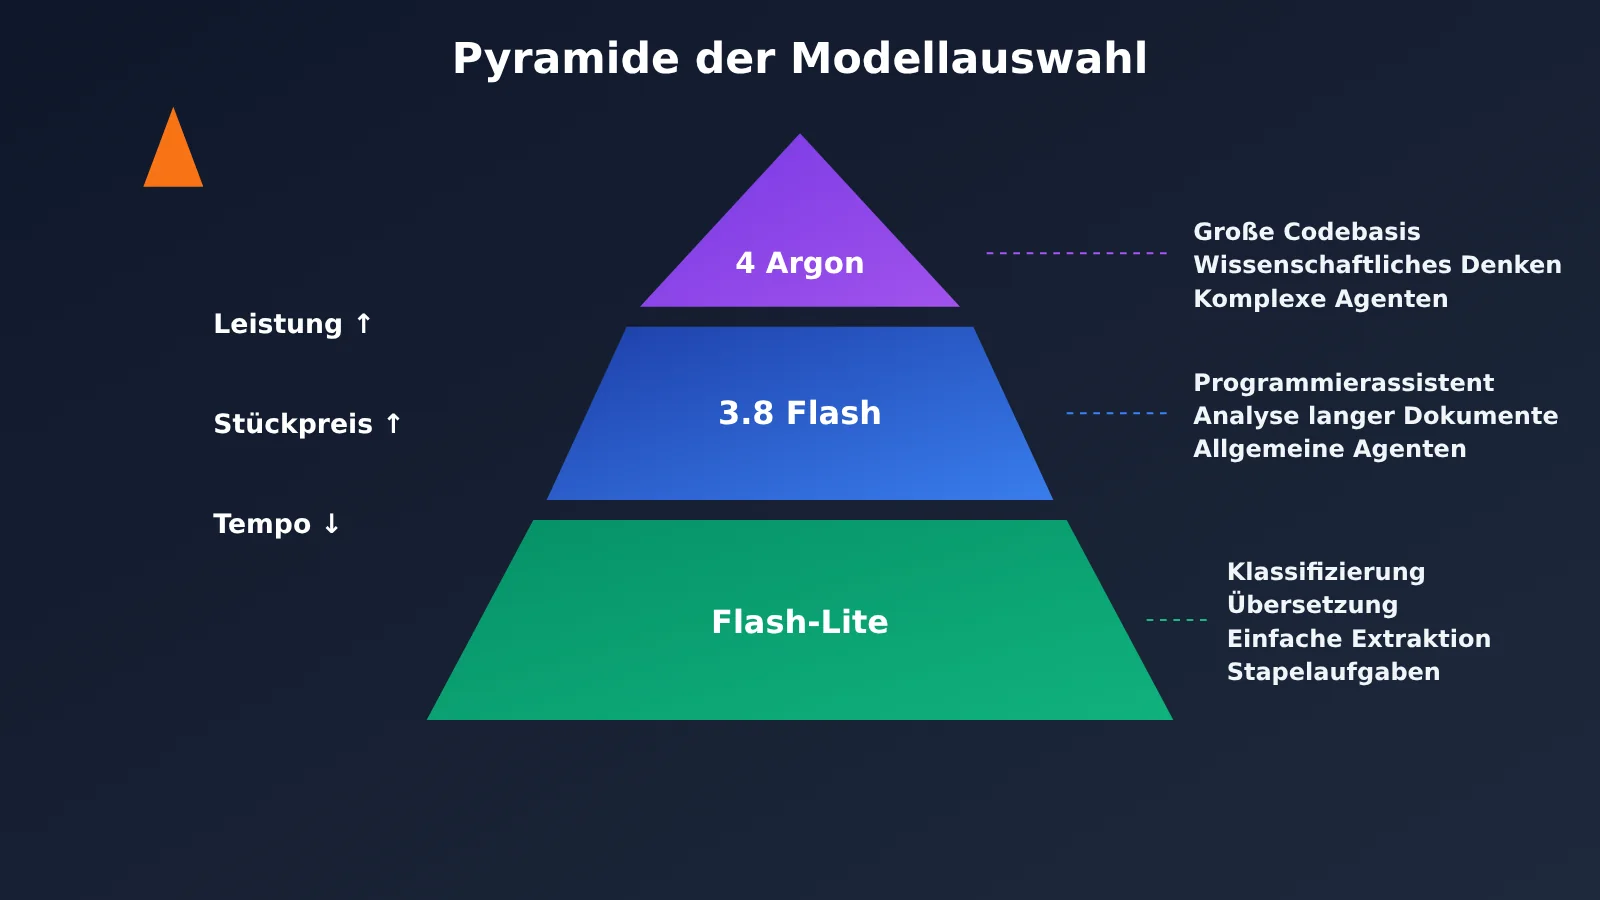
Argon wurde am 13. Oktober 2026 offiziell eingeführt und richtet sich vor allem an komplexes Software Engineering, mathematisches und wissenschaftliches Reasoning, autonome Agenten mit mehreren Arbeitsschritten und die Generierung langer Ausgaben. Für lange Ausgaben sind ein spezieller Mechanismus und eine entsprechende Ausführungskonfiguration nötig. Das Modell gibt also nicht bei jeder Anfrage unmittelbar 1 Million Token zurück.
3.8 Flash verfügt selbst über Reasoning-Fähigkeiten und ist keine „günstige Version, die nicht denken kann“. Es eignet sich für gewöhnliche Programmierassistenten, die Analyse langer Dokumente, das Schreiben von Inhalten und allgemeine Agenten-Workflows. 3.5 Flash-Lite wurde am 21. Juli 2026 veröffentlicht und ist für Klassifizierung, Übersetzung, einfache Extraktion, Dokumentenverarbeitung und einfache Teilaufgaben innerhalb von Agenten optimiert. Es kann auch bestimmte Programmier- und Reasoning-Aufgaben bewältigen. Die Unterschiede zu den leistungsstärkeren Modellen liegen vor allem in der Leistung und Stabilität bei komplexen Aufgaben sowie im Verhältnis von Kosten und Nutzen.
Offizielle Gemini-API-Preise: Kostenabstufung von Argon, Flash und Flash-Lite
Die folgende Tabelle zeigt die offiziellen Preise des standardmässigen kostenpflichtigen Tarifs der Gemini Developer API (US-Dollar pro 1 Million Token). Aufschläge von Drittanbietern, Unternehmenskonditionen und Kosten für Tool-Aufrufe sind nicht enthalten:
| Modell | Eingabe | Ausgabe | Eingabe bei Cache-Treffer | Gültigkeit |
|---|---|---|---|---|
| Gemini 4 Argon (aktuell) | $2.00 | $10.00 | $0.10 | Bis 2026-11-30 |
| Gemini 4 Argon (nach Anpassung) | $4.00 | $20.00 | $0.20 | Ab 2026-12-01 |
| Gemini 3.8 Flash (aktuell) | $0.75 | $3.75 | $0.075 | Bis 2026-12-31 |
| Gemini 3.8 Flash (nach Anpassung) | $1.50 | $7.50 | $0.15 | Ab 2027-01-01 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 | Offiziell kein Datum für eine Verdopplung angegeben |
Bei den aktuellen Preisen kostet die Eingabe bei Argon rund 2,67-mal so viel wie bei Flash und bei Flash 2,5-mal so viel wie bei Flash-Lite. Die Ausgabe kostet bei Argon viermal so viel wie bei Flash-Lite. Für Argon und Flash gelten derzeit Aktionspreise, die am 30. November beziehungsweise 31. Dezember 2026 enden. Danach verdoppeln sich die Preise. Bei der Jahresbudgetplanung für langfristige Projekte sollten Sie daher mit den angepassten Preisen rechnen.
Ein weiteres leicht zu übersehendes Detail: Google rechnet die internen Denk-Token des Modells als Ausgabe ab. Für die Rechnung zählt also nicht nur die Länge der für Nutzende sichtbaren Antwort. Eine hohe Denkstufe kann die Ausgabekosten deutlich erhöhen. Wenn eine Aufgabe keine Echtzeitantwort erfordert, können Sie die Batch API nutzen: Die Eingabe- und Ausgabepreise aller drei Modelle liegen damit 50 % unter den Standardpreisen. Allerdings unterscheiden sich Ausführungsmodus und Warteschlangenlimits von denen bei Echtzeitanfragen.
Unabhängige Benchmarks und Geschwindigkeitsvergleich der drei Gemini-Modelle
Die folgenden Daten stammen von der unabhängigen Bewertungsplattform Artificial Analysis. Sie basieren einheitlich auf dem Intelligence Index v5.0; Werte aus der älteren Version v4.x sind nicht enthalten:
| Kennzahl | Gemini 4 Argon(High) | Gemini 3.8 Flash(High) | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| Gesamtindex v5.0 | 50 | 31 | 12 |
| AutomationBench-AA | 78% | 60% | 25% |
| Terminal-Bench 4.0 | 57% | 20% | 1% |
| FrontierCode 2.0 | 26% | 19% | 6% |
| Beobachtete Ausgabegeschwindigkeit | über 80 Token/Sekunde | ca. 120–140 Token/Sekunde | über 400 Token/Sekunde |
| Verfügbar über | Offizielle Google API, APIYI apiyi.com | Offizielle Google API, APIYI | Offizielle Google API, APIYI |
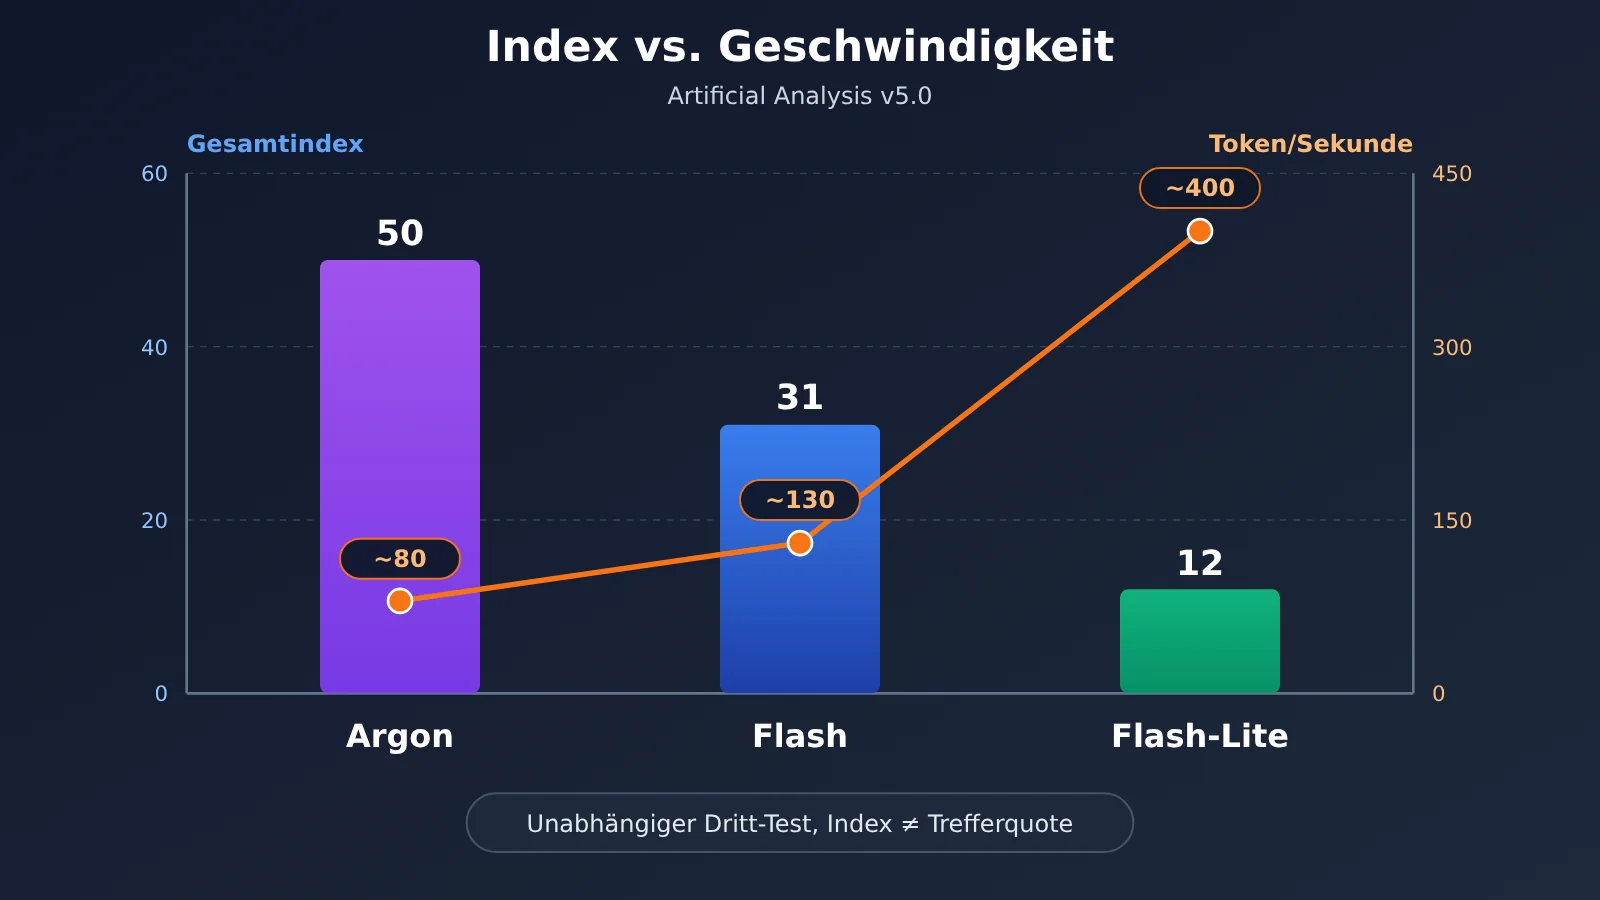
Um diese Daten richtig einzuordnen, sind drei Punkte wichtig:
- Der Index ist keine Trefferquote: 50, 31 und 12 sind Indexwerte des Bewertungssystems. Sie bedeuten nicht, dass beispielsweise 50 % der Antworten richtig waren.
- Bei komplexen Aufgaben sind die Unterschiede deutlich: In Benchmarks für komplexe Programmierung und Automatisierung liegt Argon vorn, Flash im Mittelfeld und Flash-Lite dahinter. Das belegt aber nicht, dass Argon bei jeder einfachen Aufgabe besser ist. Für Klassifizierung oder die Aufbereitung von Formaten können alle drei Modelle bereits ausreichen.
- Geschwindigkeit lässt sich nicht direkt in Bearbeitungszeit umrechnen: Der Durchsatz variiert je nach Auslastung des Dienstes. Die tatsächliche Dauer hängt auch von der Denkzeit, der Latenz bis zum ersten Token, Tool-Aufrufen, Wartezeiten und Netzwerkschwankungen ab.
💡 Hinweis zum Vergleich: Benchmark-Ergebnisse zeigen nur grob, wie sich die Leistungsfähigkeit der Modelle unterscheidet. Entscheidend sind die Ergebnisse bei Ihren eigenen Aufgaben. Über APIYI apiyi.com können Sie mit demselben API-Schlüssel zwischen den drei Gemini-Modellen wechseln und den Vergleich mit eigenen Beispielen nachvollziehen.
Gemini-API-Kostensimulation: Wie stark unterscheiden sich die Kosten für Argon, Flash und Flash-Lite?
Die folgenden Zahlen sind theoretische Beispiele und keine tatsächlich gemessenen Kosten. Wir nehmen an, dass die Ausgabe-Token bereits alle Denk-Token enthalten. Kosten für Caching, Suchtools und Wiederholungsversuche bleiben unberücksichtigt. Alle Berechnungen basieren auf den Standardpreisen vom Oktober 2026:
| Szenario | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| A: 1.000 Aufrufe pro Tag, jeweils 5.000 Eingabe- / 1.000 Ausgabe-Token (Tageskosten) | $20.00 | $7.50 | $4.00 |
| A: wie oben, über 30 Tage | ca. $600 | ca. $225 | ca. $120 |
| B: 100.000 Klassifizierungen, jeweils 1.000 Eingabe- / 200 Ausgabe-Token | $400 | $150 | $80 |
| B mit Batch API (halber Preis pro Token) | ca. $200 | ca. $75 | ca. $40 |
Szenario B zeigt nur die Preisunterschiede bei gleichem Token-Verbrauch. In der Praxis unterscheiden sich die Modelle bei der Zahl der Denk-Token, der Ausgabelänge und der Zahl der Wiederholungsversuche. Man kann also nicht ohne Weiteres annehmen, dass Flash-Lite für $80 dieselbe Qualität liefert wie Argon für $400. Sobald die Aktionspreise für Argon und Flash enden, verdoppeln sich zudem die Werte in diesen beiden Tabellenspalten.
Auswirkungen: Warum der Token-Preis bei der Gemini API nicht alles ist
Auswirkungen für Entwickler
Der „Preis“ eines Modells hat mindestens drei Ebenen: Erstens den Preis pro Token. Zweitens den tatsächlichen Token-Verbrauch einer Aufgabe, einschliesslich Eingabe, Ausgabe, Denken, wiederholtem Kontext und erneuten Versuchen. Drittens die Gesamtkosten für eine zufriedenstellend erledigte Aufgabe. Dazu gehören auch Erfolgsquote, manuelle Prüfung, erneute Versuche nach Fehlschlägen, Bearbeitungszeit und geschäftliche Verluste durch Fehler.
Wenn Flash-Lite bei einer einfachen Klassifizierung bereits die geschäftlichen Anforderungen erfüllt, wäre der Einsatz von Argon Verschwendung. Scheitert Flash-Lite dagegen wiederholt an einer komplexen Programmieraufgabe, während Argon sie mit weniger erneuten Versuchen löst, kann Argon insgesamt das bessere Preis-Leistungs-Verhältnis bieten. Das ist eine bedingte Schlussfolgerung zur Modellauswahl, keine statistische Aussage über die tatsächlichen Erfolgsquoten der drei Modelle.
Auch Rückmeldungen aus der Community verdeutlichen diesen Punkt. Ein Reddit-Nutzer setzte Argon High in einer OpenCode-Umgebung für Reverse Engineering ein. Bei einem einzelnen Durchlauf wurden rund 900.000 Token verbraucht, ohne dass die Aufgabe abgeschlossen wurde. Das ist ein persönlicher Test und kein Branchendurchschnitt. Er zeigt aber, dass komplexe Agenten-Workflows viele Token verbrauchen können, ohne den Erfolg zu garantieren. Ein anderer Nutzer berichtete, dass Argon im Abo für Privatkunden schnell das Nutzungslimit erreichte. Diese Erfahrung betrifft jedoch das Gemini-Abonnement und ist nicht mit den Limits der Developer API gleichzusetzen.
Auswirkungen auf die Branche
- Die Staffelung mehrerer Modelle wird zur Standardarchitektur: Google Cloud hat bereits öffentlich beschrieben, wie sich mit Multi-Modell-Orchestrierung und Smart Routing die Kosten für Unternehmen durch die Verteilung von Aufgaben senken lassen.
- Der Fokus verschiebt sich vom „Einzelpreis“ zu den „Kosten pro zufriedenstellend erledigter Aufgabe“: Je höher das Aufrufvolumen, desto wichtiger ist es, Modelle anhand geschäftlicher Testdatensätze statt anhand von Ranglisten auszuwählen.
- Budgetzyklen werden kürzer: Da Aktionspreise nach und nach auslaufen, müssen Teams ihre Modellkombination und ihr Budget vierteljährlich überprüfen.
Wie Entwickler zwischen Argon, Flash und Flash-Lite wählen
Die folgenden Empfehlungen gelten unter bestimmten Voraussetzungen. Ein Modell, das in allen Szenarien am besten ist, gibt es nicht:
- Klassifizierung grosser Datenmengen (z. B. 100.000 KI-Nachrichten in Kategorien wie Veröffentlichungen, Updates, Preise und Richtlinien einordnen): Testen Sie zuerst Flash-Lite. Voraussetzung ist, dass Genauigkeit und Formatkonformität im Stichprobentest die Anforderungen erfüllen. Falls nicht, wechseln Sie zu 3.8 Flash.
- Strukturierung umfangreicher Unterlagen (z. B. Geschäftsberichte und technische Dokumente in Faktentabellen aufbereiten): Testen Sie zuerst 3.8 Flash. Es verfügt über ein besseres Verständnis als Lite und ist günstiger als Argon. Bei der Erkennung von Widersprüchen zwischen Dokumenten oder bei schwierigen Schlussfolgerungen können Sie gezielt Argon einsetzen.
- Komplexe Codeprojekte (z. B. grosse Codebasen verstehen oder mehrstufige Refactorings durchführen): Testen Sie zuerst Argon. Sowohl seine offizielle Positionierung als auch unabhängige Programmierbenchmarks sprechen für seine stärkere Leistung. Erfolgsquote, Tool-Ausführung und Kosten sollten Sie dennoch im realen Projekt überprüfen.
- Einfache Übersetzungen in grossem Umfang: Testen Sie zuerst Flash-Lite. Bei hochspezialisierten Inhalten aus Bereichen wie Recht oder Medizin ist eine zusätzliche Qualitätsprüfung Pflicht. Nur weil das Modell günstig ist, sollten Sie es nicht ohne menschliche Kontrolle einsetzen.
- Unternehmens-Agenten: Hier empfiehlt es sich nicht, nur ein Modell zu verwenden. Flash-Lite kann Klassifizierung, Extraktion und Formatstandardisierung übernehmen, 3.8 Flash die allgemeine Planung und mehrstufige Workflows und Argon schwierige Schlussfolgerungen sowie die Fehlersuche bei kniffligen Problemen. Das ist eine empfohlene technische Strategie, keine verbindliche Vorgabe von Google.
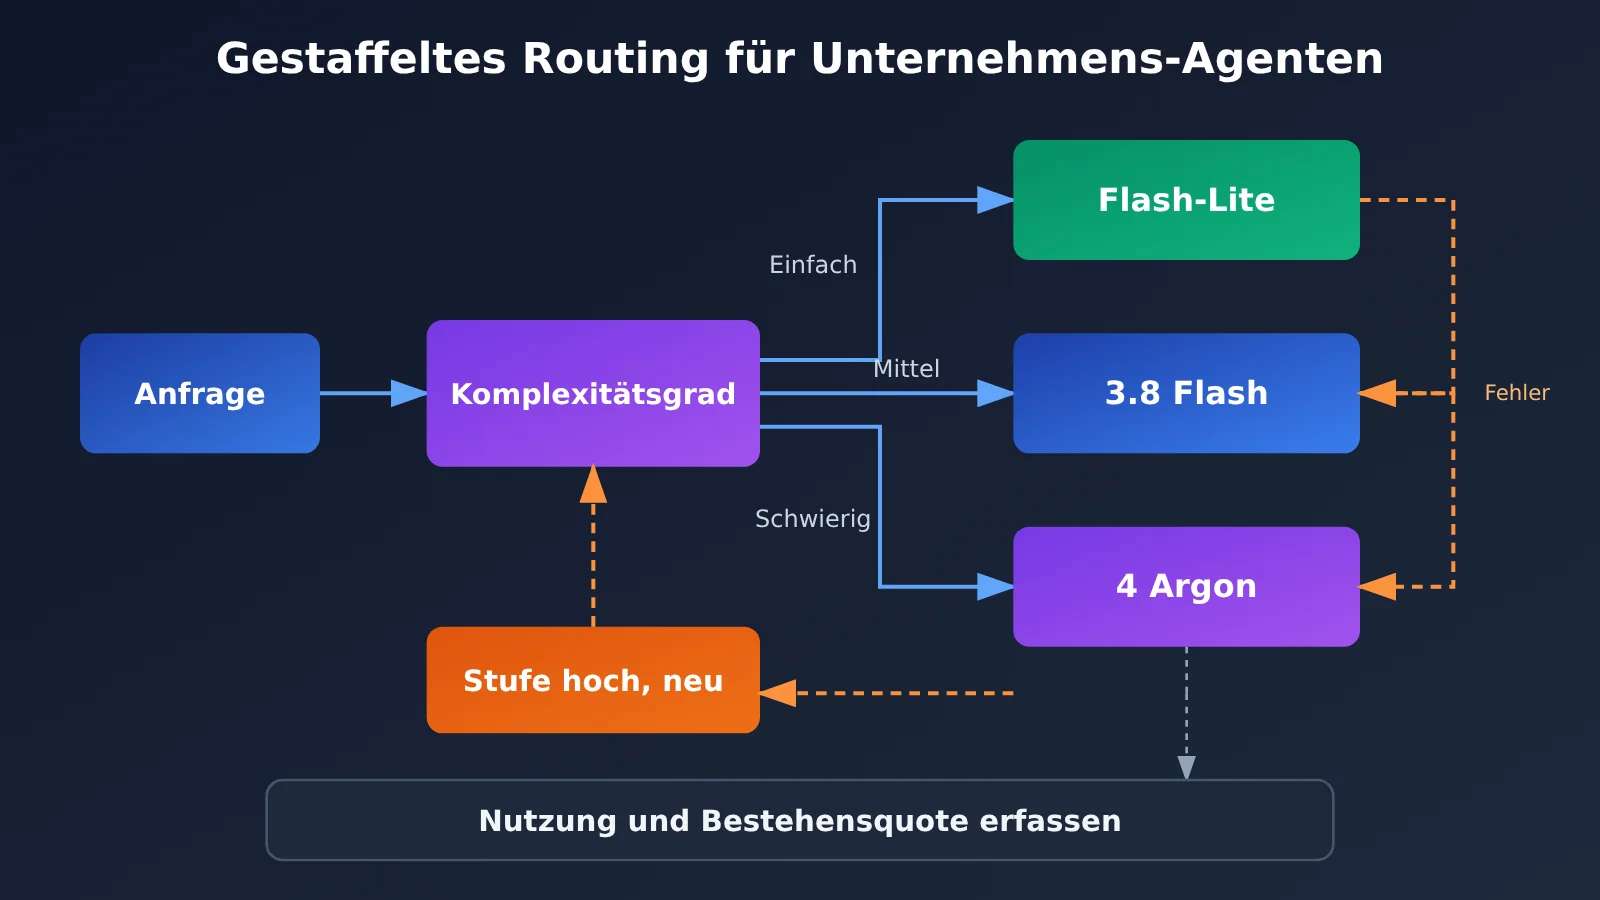
🎯 Empfehlung zur Auswahl: Der Schlüssel zum gestaffelten Routing ist, kostengünstig zwischen den drei Modellen wechseln zu können. APIYI apiyi.com bietet eine OpenAI-kompatible Schnittstelle, bei der Sie das Modell durch Ändern eines einzigen
model-Parameters wechseln können. Das eignet sich gut für erste Vergleichstests im kleinen Massstab.
Schnellstart: Drei Gemini-Modelle per API aufrufen
Minimalbeispiel
Für den Aufruf genügt das OpenAI SDK. Über model wechseln Sie zwischen Argon, Flash und Flash-Lite:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",
    messages=[{"role": "user", "content": "把这条新闻分类为:模型发布/产品更新/价格变化/行业政策"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 以实际计费 Token 为准,而非可见字数
Vollständigen Code für gestaffeltes Routing und Kostenschätzung anzeigen
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Google 官方标准价(美元/100万Token,2026年10月),仅用于估算
PRICE = {
    "gemini-3.5-flash-lite": (0.30, 2.50),
    "gemini-3.8-flash": (0.75, 3.75),    # 2027-01-01 起翻倍
    "gemini-4-argon": (2.00, 10.00),     # 2026-12-01 起翻倍
}
TIERS = ["gemini-3.5-flash-lite", "gemini-3.8-flash", "gemini-4-argon"]

def estimate_cost(model: str, usage) -> float:
    pin, pout = PRICE[model]
    # completion_tokens 应包含思考 Token,具体以返回字段为准
    return usage.prompt_tokens / 1e6 * pin + usage.completion_tokens / 1e6 * pout

def run(prompt: str, start_tier: int = 0, validator=None):
    """从低档模型开始,不合格则升级一档,记录每次成本"""
    total = 0.0
    for model in TIERS[start_tier:]:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        text = resp.choices[0].message.content
        cost = estimate_cost(model, resp.usage)
        total += cost
        print(f"{model}: tokens={resp.usage.total_tokens}, cost≈${cost:.5f}")
        if validator is None or validator(text):
            return {"model": model, "output": text, "total_cost": total}
    return {"model": None, "output": None, "total_cost": total}

result = run(
    "从以下文本抽取公司名和金额,输出JSON:...",
    validator=lambda t: t.strip().startswith("{"),
)
print(result)
🚀 Schnellstart: Holen Sie sich zunächst das kostenlose Testguthaben für Neukunden bei APIYI auf apiyi.com. Vergleichen Sie die drei Modellstufen anhand von 100–300 repräsentativen Beispielen, bevor Sie die Standardstufe für den Produktivbetrieb festlegen. Preise, Guthaben und Cache-Unterstützung können bei Drittanbietern von der direkten Nutzung über Google abweichen. Massgeblich sind die jeweiligen Bedingungen der Plattform.
Hinweise zur Bereitstellung der Gemini API
- Aufruflimits: Die Gemini API begrenzt Anfragen nach RPM, TPM und RPD. Die Limits gelten pro Projekt, nicht pro API-Schlüssel. Wird eines davon überschritten, tritt ein Fehler auf.
- Denk-Token: Der Preis für die Ausgabe umfasst auch Denk-Token. Prüfen Sie daher die Nutzungsmetadaten, statt die Kosten anhand der sichtbaren Antwortlänge zu schätzen.
- Caching: Argon unterstützt nur implizites, aber kein explizites Caching. Flash und Flash-Lite unterstützen Caching; die genaue Abrechnung hängt von der Konfiguration ab.
- Daten im kostenlosen Tarif: Daten aus dem kostenlosen Tarif können zur Verbesserung der Produkte verwendet werden. Legen Sie dort keine sensiblen Unternehmensdaten ab und prüfen Sie vor dem Produktivstart die Nutzungsbedingungen.
- Testkennzahlen: Erfassen Sie Erfolgsrate, sachliche Genauigkeit, Einhaltung der vorgegebenen Struktur, Anzahl der Halluzinationen, durchschnittliche und hohe Latenzen, tatsächlich verbrauchte Token, Anzahl der Wiederholungsversuche und Kosten pro erfolgreich abgeschlossener Aufgabe. Da sich die voreingestellten Denkstufen unterscheiden, sollte der Bericht die tatsächlich verwendete Konfiguration nennen.
Häufige Fragen zur Modellauswahl für die Gemini API
Q1: Was sind Gemini 4 Argon, 3.8 Flash und 3.5 Flash-Lite?
Die drei Modelle bilden Googles aktuelle Hauptmodellreihe für die Gemini API: Argon ist das Flaggschiff für komplexe Denkaufgaben, 3.8 Flash bietet ein Gleichgewicht zwischen Leistungsfähigkeit und Effizienz, und 3.5 Flash-Lite ist auf niedrige Latenz, geringe Kosten und hohen Durchsatz ausgelegt. Alle drei unterstützen ein Eingabekontextfenster von rund einer Million Token und geben Text aus.
Q2: Wann enden die Angebotspreise für Argon und Flash?
Der aktuelle Preis für Argon gilt bis zum 30. November 2026. Ab dem 1. Dezember verdoppeln sich die Einzelpreise für Eingabe, Ausgabe und Caching. Für 3.8 Flash gilt der aktuelle Preis bis zum 31. Dezember 2026; ab dem 1. Januar 2027 verdoppelt er sich. Für Flash-Lite hat Google derzeit kein vergleichbares Datum für eine Preisverdopplung angegeben.
Q3: Bedeutet eine Punktzahl von 50 bei Artificial Analysis, dass 50 % der Antworten richtig sind?
Nein. Die Werte 50, 31 und 12 sind Gesamtpunktzahlen im Intelligence Index v5.0 und keine prozentualen Trefferquoten. Sie eignen sich für einen groben Leistungsvergleich zwischen Modellen, lassen sich aber nicht direkt in die Erfolgsrate für Ihren Anwendungsfall umrechnen.
Q4: Wie lassen sich die drei Gemini-Modelle kostengünstig vergleichen?
Verwenden Sie am besten eine OpenAI-kompatible Schnittstelle, die mehrere Modelle unterstützt. Registrieren Sie sich bei APIYI auf apiyi.com und erhalten Sie einen API-Schlüssel sowie ein kostenloses Guthaben. Ersetzen Sie dann im Beispiel dieses Artikels `model` nacheinander durch die drei API-IDs und erfassen Sie für dieselben Testdaten jeweils den Verbrauch und die Erfolgsrate.
Q5: Auf Reddit heißt es, dass das Argon-Kontingent nach wenigen Gesprächsrunden aufgebraucht ist. Gilt das auch für die API?
Diese Rückmeldung bezieht sich auf das Gemini-Abonnement für Endnutzer und ist nicht mit den Limits der Developer API gleichzusetzen. Das API-Kontingent hängt vom Abrechnungstarif, Projektstatus und Modell ab und wird nach RPM, TPM und RPD bemessen. Bei Aufrufen über eine Aggregationsplattform gelten zusätzlich deren eigene Kontingentregeln. In der Konsole von APIYI auf apiyi.com können Sie prüfen, welche Modelle tatsächlich verfügbar sind und wie sie abgerechnet werden.
Q6: Welche bekannten Schwächen haben die drei Modelle?
Argon hat die höchsten Einzelpreise, ist am langsamsten und bietet keinen regulären kostenlosen Tarif. Komplexe Agentenaufgaben können zudem viele Token verbrauchen. 3.8 Flash liegt bei den anspruchsvollsten Terminal- und Programmier-Benchmarks deutlich hinter Argon. Flash-Lite schneidet bei komplexen Programmier- und Automatisierungsaufgaben schwächer ab; Übersetzungen in Fachgebieten sollten manuell geprüft werden.
Die wichtigsten Punkte zur Auswahl einer Gemini-API
- Hintergrund: Googles eigene Modell-APIs verarbeiten fast 32 Milliarden Token pro Minute. Das ist das Wachstum aller Modelle zusammen, nicht die Leistung eines einzelnen Modells.
- Drei Modellklassen: Argon übernimmt komplexe Denkaufgaben, 3.8 Flash ist der ausgewogene Allrounder und Flash-Lite eignet sich für einfache Aufgaben mit hohem Durchsatz.
- Preisabstufung: Die aktuellen Eingabepreise liegen bei 2 / 0,75 / 0,30 US-Dollar. Nach Ablauf der Aktionspreise verdoppeln sich die Preise für Argon und Flash.
- Benchmarks richtig lesen: Die AA-v5.0-Werte von 50 / 31 / 12 sind Indexwerte, keine Erfolgsquoten. Bei einfachen Aufgaben muss der Abstand nicht so groß ausfallen.
- Versteckte Kosten: Thinking-Token zählen zur Ausgabe. Zusammen mit Caching, erneuten Versuchen und Tool-Gebühren bestimmen sie die endgültige Rechnung.
- Einstieg: Über APIYI apiyi.com lassen sich die drei Modellklassen mit einem API-Schlüssel nutzen und anhand von 100–300 Beispielen vergleichen.
Fazit
Die stark steigende Nutzung der Gemini-API zeigt, dass große Sprachmodelle inzwischen in großem Maßstab produktiv eingesetzt werden. Die zentrale Frage bei der Modellauswahl bleibt aber dieselbe:
- Nach Aufgaben unterscheiden: Für Klassifizierung und Übersetzung zunächst Flash-Lite testen, für die Strukturierung von Dokumenten 3.8 Flash und für komplexen Code sowie anspruchsvolle Agentenaufgaben Argon.
- Kosten pro erfolgreich erledigter Aufgabe betrachten: Entscheidend sind die Gesamtkosten pro erfolgreich erledigter Aufgabe, nicht der niedrigste Preis pro Million Token.
- Preisfristen im Blick behalten: Der Aktionspreis für Argon endet am 30. November, der für Flash am 31. Dezember. Das Budget sollte auf Grundlage der angepassten Preise berechnet werden.
Entwickler brauchen nicht grundsätzlich das stärkste oder das günstigste Modell. Entscheidend ist eine Kombination, die Geschäftsaufgaben zuverlässig und zu vertretbaren Kosten erledigt. Empfehlenswert ist, zunächst über APIYI apiyi.com mit dem kostenlosen Guthaben alle drei Modellklassen zu vergleichen und danach die Routing-Strategie für die Produktionsumgebung festzulegen.
📚 Quellen
- CEO-Mitteilung zum Alphabet-Geschäftsbericht für Q3 2026: Quelle für die Angabe von 32 Milliarden Tokens pro Minute
- Link:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
Hinweis: Hintergrund zur Meldung und ursprüngliche Veröffentlichung zum Wachstum der API-Nutzung
-
Offizielle Preise der Gemini API: Standard-, Cache- und Batch-Preise für die drei Modelle
- Link:
ai.google.dev/gemini-api/docs/pricing -
Hinweis: Enthält das Enddatum der Aktionspreise und Angaben zur Abrechnung von Thinking-Tokens
-
Gemini-Modelldokumentation: Argon / 3.8 Flash / 3.5 Flash-Lite
- Link:
ai.google.dev/gemini-api/docs/models/gemini-4-argon -
Hinweis: Kontextfenster, Ausgabegrenzen, Thinking-Stufen und Tool-Funktionen
-
Modellvergleich von Artificial Analysis: unabhängige Bewertung durch Dritte, Version 5.0
- Link:
artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash -
Hinweis: Gesamtindex, spezialisierte Benchmarks und Geschwindigkeitsmessungen
-
Aufruflimits und Thinking-Mechanismus der Gemini API: RPM/TPM/RPD und Thinking-Konfiguration
- Link:
ai.google.dev/gemini-api/docs/rate-limits -
Hinweis: Wichtige Informationen zu Kontingenten und Thinking-Tokens vor dem produktiven Einsatz
-
Multi-Modell-Orchestrierung mit Google Cloud: Smart Routing und Kostenmanagement für Agenten
- Link:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - Hinweis: Googles Ansatz für mehrstufiges Routing in Unternehmen
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.