ملاحظة الكاتب: يقارن هذا المقال بين أداء Gemini 4 Carbon وClaude Fable 5.2 وGPT-6 Astra وزمن التنفيذ والتكلفة، باستخدام نظامي تقييم هما مؤشر AA الشامل واختبار MKA للمهام المهنية. كما يوضح إعدادات التقييم ونطاق انطباق الاستنتاجات الإحصائية.
قبل القراءة: 7 مصطلحات في مقارنة النماذج الثلاثة
- MKA (Multimodal Knowledge Agent): معيار لتقييم مهام العمل المهنية متعددة الوسائط. يختبر قدرة النموذج على قراءة ملفات معقدة مثل المخططات والمستندات الممسوحة ضوئيًا والصور الطبية، ثم تسليم نتيجة مهنية كاملة.
- Climb WSR: معدل الاستيفاء الموزون، ويُحسب فقط على بنود التقييم الأعلى قدرة على التمييز بين النماذج، ويُستخدم لإظهار الفروق بين النماذج الرائدة.
- Regression WSR: مؤشر موزون يقيس مدى استيفاء المتطلبات الأساسية، وهو بمثابة حد النجاح في التسليم المهني.
- مستوى الاستدلال: إعداد يحدد شدة الاستدلال المتاحة للنموذج، مثل LOW وMEDIUM وHIGH في Carbon، وMax وXhigh وغيرها من الإعدادات التي تظهر في القائمة لدى Fable وAstra.
- تكلفة المهمة: مجموع رسوم استدعاءات النموذج كلها لإنجاز مهمة محددة. وليست سعرًا ثابتًا لطلب API واحد.
- قراءة الكاش: إعادة استخدام مدخلات سبق تخزينها مؤقتًا، مع احتساب سعر أقل لها.
- الدلالة الإحصائية: مؤشر يحدد ما إذا كانت هناك أدلة إحصائية كافية على أن فرق الدرجات بين نموذجين حقيقي. وإذا لم يبلغ الفرق مستوى الدلالة، فلا يصح اعتباره فوزًا أو خسارة مؤكدة.
لم يعد من الممكن شرح المنافسة بين النماذج الرائدة بالاعتماد على قائمة ترتيب شاملة واحدة. في هذا المقال نقارن بين Gemini 4 Carbon وClaude Fable 5.2 وGPT-6 Astra من ثلاثة جوانب: القدرة الشاملة، والتسليم المهني، وتكلفة المهمة، ثم نقدم توصيات للاختيار بحسب نوع المهمة.
هذا المقال ليس قراءة لقائمة ترتيب تخلط كل الدرجات معًا. مؤشر AA الشامل واختبار MKA نظاما تقييم مختلفان، لذلك نفسّر كلًّا منهما على حدة، ونوضح أيضًا أي الفروق تسندها أدلة إحصائية وأيها لا تكفي أدلته.
القيمة الأساسية: بعد قراءة المقال ستعرف أي نموذج تفضّل بحسب متطلبات مهمتك من الجودة والسرعة والتكلفة.
أولًا: Gemini 4 Carbon وClaude Fable 5.2 وGPT-6 Astra في ساحة منافسة واحدة
جاءت هذه الجولة من المنافسة في فترة زمنية متقاربة جدًا. أعلنت Google عن Gemini 4 Carbon لأول مرة في 28 أكتوبر 2026، ثم أطلقت Anthropic نموذج Claude Fable 5.2 في 9 نوفمبر. وفي 10 نوفمبر فُتح Carbon رسميًا أمام المطورين والشركات والمستخدمين العاديين. وفي اليوم نفسه أطلقت Google DeepMind بالتعاون مع Artificial Analysis اختبار MKA. وفي 11 نوفمبر حُدّث Artificial Analysis Intelligence Index v5.0.1 وأُضيف إليه Fable 5.2.
تختلف النماذج الثلاثة بوضوح في التموضع المعلن. فـ Carbon مبني على Gemini 4 Argon، ويركّز على وكلاء الذكاء الاصطناعي (Agents) للمهام طويلة المدى، وهندسة البرمجيات المعقدة، والبحث العلمي، ويدعم إدخال النصوص والصور والصوت والفيديو. أما Fable 5.2 فيعتمد Adaptive Thinking، وتبلغ نافذة السياق فيه 1M Token، والحد الأقصى للمخرجات 128K Token. وأما GPT-6 Astra فله نتائج في الاختبارين المذكورين في هذا المقال، وكثيرًا ما يُستخدم مرجعًا لقياس الكفاءة.
| معيار المقارنة | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra | التقييم الحالي |
|---|---|---|---|---|
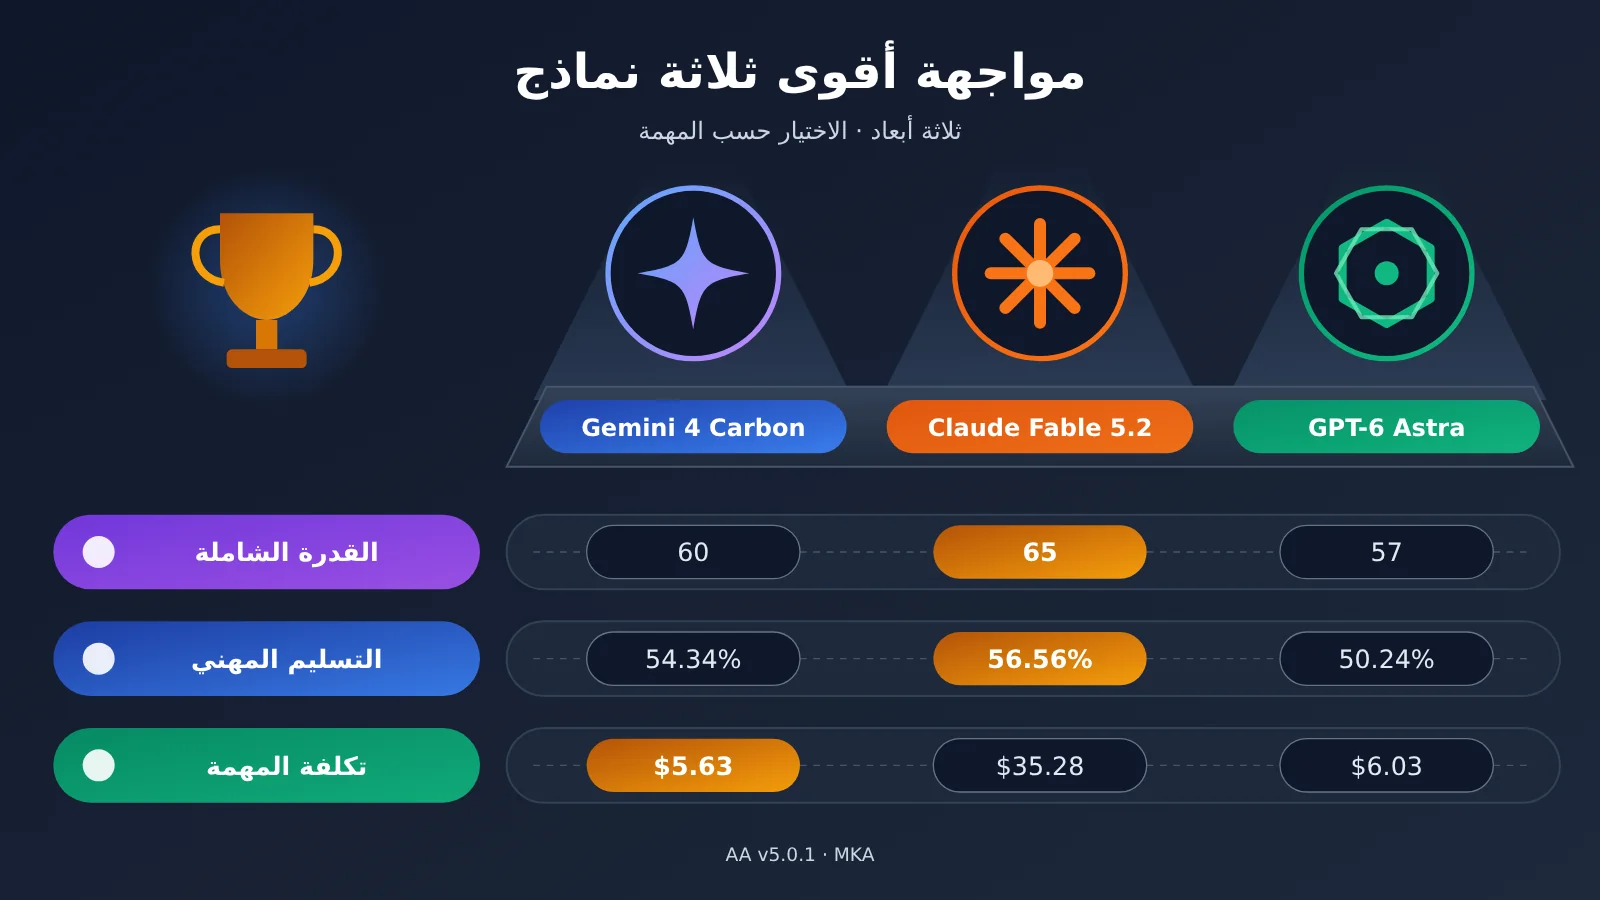
| القدرة الشاملة (AA v5.0.1) | 65 (Max) | 60 (High) | 57 (Max) | Fable في الصدارة |
| التسليم المهني (MKA Climb-WSR) | 56.56% | 54.34% | 50.24% | Fable وCarbon متقاربان، وكلاهما يتفوق على Astra |
| تكلفة المهمة الواحدة (MKA، الجدول 4) | $35.28 | $5.63 | $6.03 | Carbon الأقل تكلفة |
| زمن التنفيذ (MKA، الجدول 4) | 83.2 دقيقة | 29.2 دقيقة | 18.5 دقيقة | Astra الأسرع |
| استهلاك Token (MKA، الجدول 4) | 40.48M | 7.05M | 2.43M | Astra الأكثر توفيرًا |
عمود «التقييم الحالي» في الجدول يخص كل معيار على حدة. فلا يوجد نموذج واحد يتصدر في جميع الجوانب.
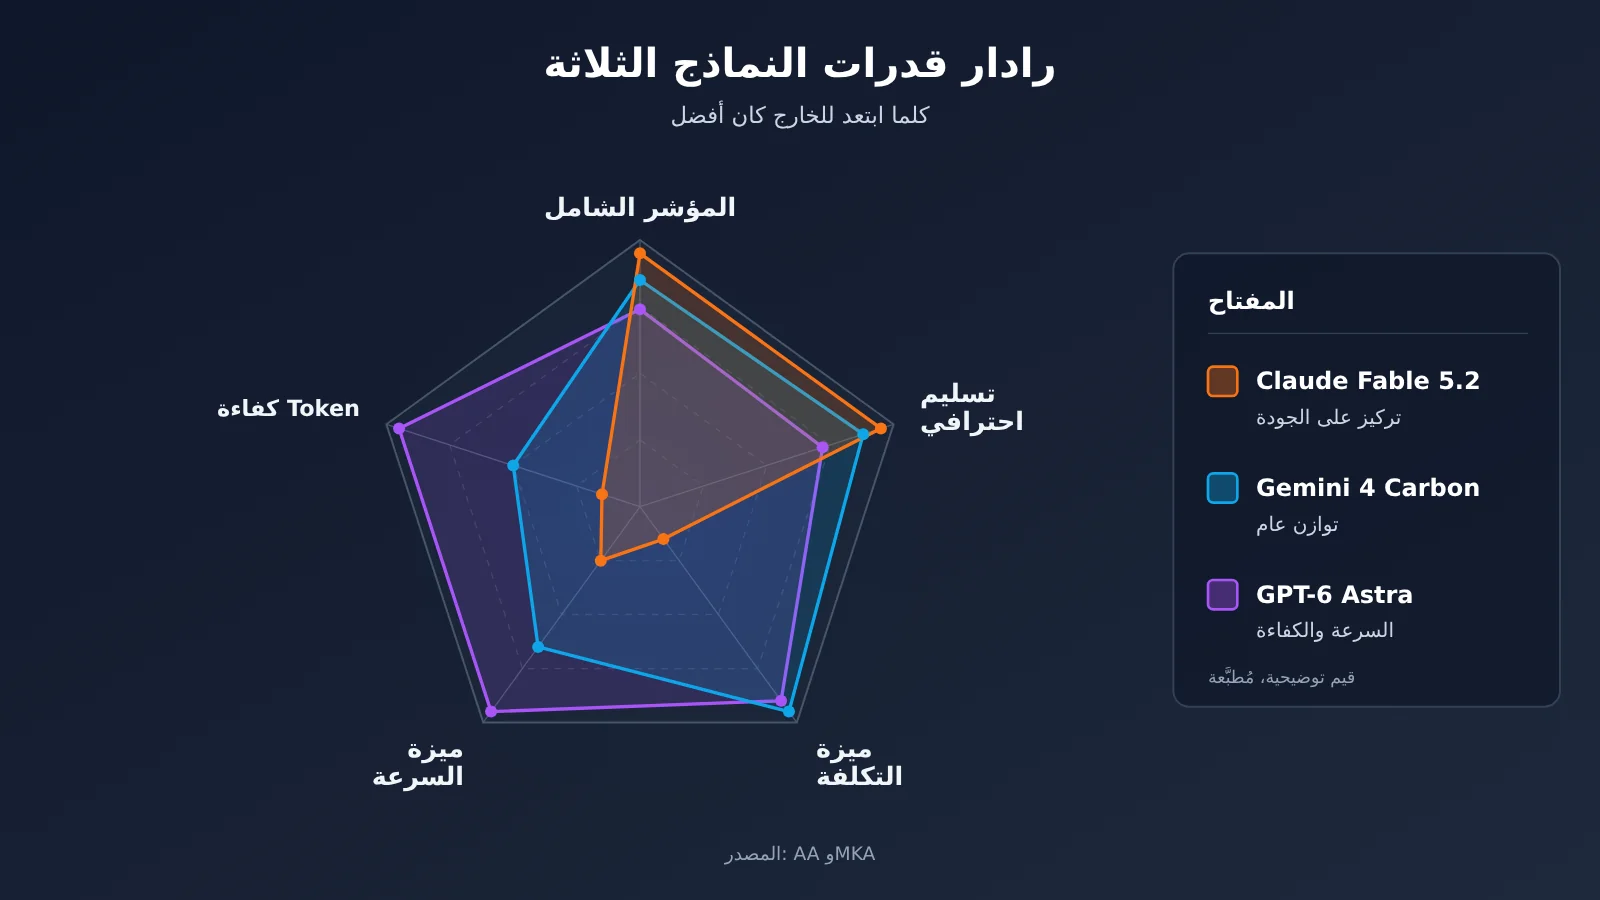
📊 ملاحظة حول البيانات: بيانات الجدول أعلاه مصدرها لقطة من قائمة AA والورقة التقنية لـ MKA، ولا يمكن تحويل أرقام أحدهما إلى الآخر لأن منهجية القياس مختلفة. إذا أردت التحقق من أداء النماذج في سيناريو عملك، يمكنك إجراء مقارنة صغيرة عبر APIYI apiyi.com باستخدام الموجه نفسه، ثم تلاحظ الفروق بين النماذج الثلاثة في ظروف تشغيل حقيقية.
ثانيًا: لوحة الصدارة الشاملة في AA: Claude Fable 5.2 يتصدر مؤقتًا وGemini 4 Carbon يليه مباشرة
يتألف مؤشر Artificial Analysis Intelligence Index v5.0.1 من 9 اختبارات: AA-Briefcase v1.1 وAutomationBench-AA وTerminal-Bench 4.0 وFrontierCode 2.0 وAA-Omniscience v1.1 وGDP.pdf وHLE-Diamond وCritPt v2 وTerminal-Bench-Science 0.1. وهي تغطي العمل المعرفي والأتمتة والبرمجة والاستدلال العلمي والموثوقية في الحقائق. والسؤال الذي يجيب عنه هذا المؤشر هو: «ما القوة الإجمالية للنموذج؟»
| إعدادات النموذج | AA Index v5.0.1 | التكلفة لكل مهمة اختبار | الزمن لكل مهمة |
|---|---|---|---|
| Claude Fable 5.2 Max | 65 | $26.54 | 44.4 دقيقة |
| Gemini 4 Carbon High | 60 | $7.76 | 24.9 دقيقة |
| GPT-6 Astra Max | 57 | $6.24 | 23.0 دقيقة |
انتبه إلى اختلاف الإعدادات في هذا الجدول. فالنماذج الثلاثة تعمل على مستويات Max وHigh وMax على التوالي، وميزانية الاستدلال ليست واحدة بينها، ولذلك لا يصح اعتبار النتائج مقارنة خالصة للقدرات في ظروف متكافئة. كما أن درجة النموذج نفسه تتغير عند تغيير المستوى: فمستويا Xhigh وHigh في Fable 5.2 يحصلان على 62 درجة لكل منهما، أما Carbon فيحصل على 58 درجة في مستوى Medium و54 درجة في مستوى Low.
وتستحق بيانات مستويات Carbon نظرة منفصلة. ففي حسابات AA بلغت تكلفة المهمة الواحدة في مستوى Medium نحو $6.59، أي أقل من $7.19 في مستوى Low. أما مستوى High فرغم أنه الأعلى درجة، فقد وصل فيه زمن الانتظار قبل أول Token في الإجابة إلى 67.54 ثانية. وهذا يعني أن رفع مستوى الاستدلال لا يعطي دائمًا مكسبًا متناسبًا معه. أما الرقم $7.76 في الجدول فهو متوسط تكلفة مهام AA محسوبًا وفق السعر القياسي لـ Carbon وهو $4/$20، وليس سعر طلب عادي واحد.
ثالثًا: MKA والتسليم المهني: قدرة النماذج الثلاثة على إنجاز العمل فعلًا
يقيس مؤشر AA القوة الشاملة للنموذج، أما MKA فيقيس ما إذا كان النموذج قادرًا على إنجاز عمل مهني حقيقي. هذه هي الإعدادات الواردة في الورقة التقنية لـ MKA:
- يضم الاختبار 200 مهمة حقيقية خاصة، تغطي 10 قطاعات و83 مهنة. وتعادل كل مهمة نحو 3 إلى 8 ساعات من عمل مختص بشري.
- لكل مهمة نحو 70 معيار تقييم موزونًا. وتتطلب 88% من المهام إنتاج ملفات مستقلة، مثل Word أو Excel أو PPT أو PDF أو HTML أو الصور.
- تعمل جميع النماذج داخل بيئة Stirrup Agent Harness نفسها، بالأدوات نفسها، وبميزانية موحدة قدرها 250 جولة، وتُشغَّل كل مهمة مرة واحدة.
| النموذج | Climb-WSR | Overall WSR | Regression-WSR |
|---|---|---|---|
| Claude Fable 5.2 | 56.56% | 73.26% | 95.71% |
| Gemini 4 Carbon | 54.34% | 71.89% | 96.36% |
| GPT-6 Astra | 50.24% | 69.34% | 95.17% |
لكل مقياس من المقاييس الثلاثة معنى مختلف. يعكس Regression-WSR مدى تلبية المتطلبات الأساسية، وقد تجاوزت النماذج الثلاثة فيه 95%، مع تقدم طفيف لـ Carbon. أما Climb-WSR فيحتسب البنود عالية الصعوبة فقط، وهو المعيار الرئيسي للتمييز بين النماذج الرائدة. ويمثل Overall WSR نسبة التلبية الموزونة الإجمالية لجميع البنود. وهذه الأرقام ليست نسب إجابات صحيحة عن أسئلة عادية، ولا تصح مقارنتها بدرجات مؤشر AA التي بلغت 65 و60 و57.
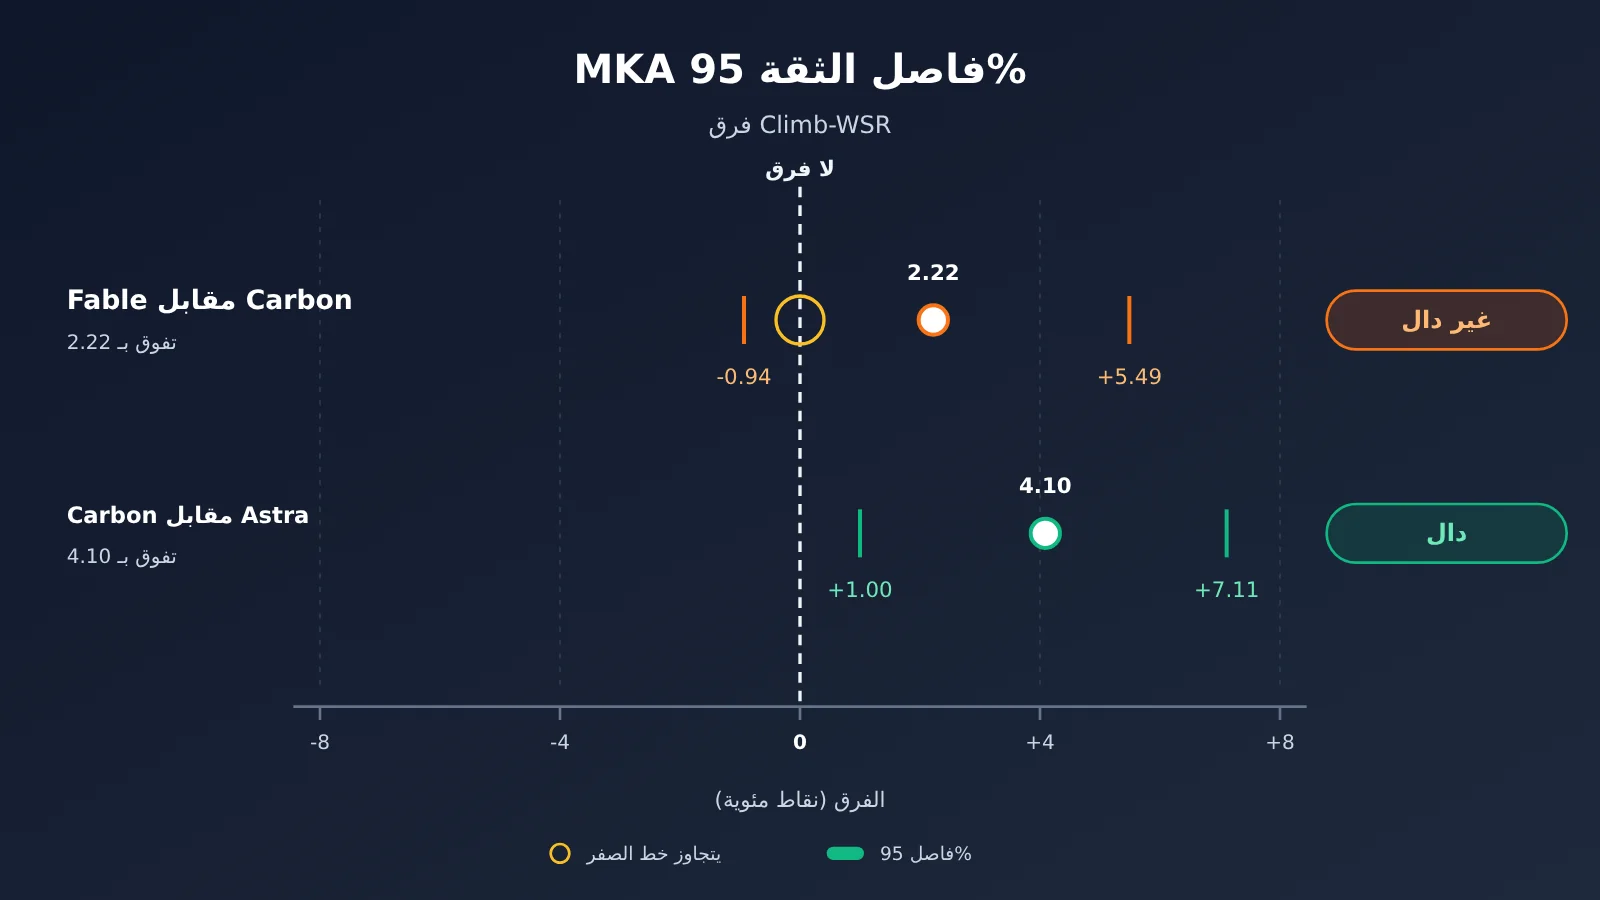
الدلالة الإحصائية بين Claude Fable 5.2 وGemini 4 Carbon
الدلالة الإحصائية هي أهم نقطة ينبغي الانتباه إليها عند قراءة نتائج MKA. هذه هي البيانات التي تعرضها الورقة:
- Fable مقابل Carbon: تقدم بمقدار 2.22 نقطة مئوية، وفترة الثقة 95% تمتد من -0.94 إلى +5.49. الفترة تعبر الصفر، لذا لم يصل الفرق إلى الدلالة الإحصائية.
- Carbon مقابل Astra: تقدم بمقدار 4.10 نقطة مئوية، وفترة الثقة 95% تمتد من +1.00 إلى +7.11. الفترة تقع كليًا فوق الصفر، لذا بلغ الفرق الدلالة الإحصائية.
لذلك فالصياغة الدقيقة هي: في MKA يقف Fable 5.2 وCarbon عند مستوى متقارب، ولا تكفي الأدلة الحالية للجزم بتفوق Fable بوضوح على Carbon. وخلاصة الورقة أن كلا النموذجين يتقدم على Astra تقدمًا ذا دلالة.
رابعًا: مقارنة تكلفة المهام: الثمن الفعلي الذي تدفعه النماذج الثلاثة لإنجاز المهمة نفسها
يعرض الجدول 4 في ورقة MKA متوسط الموارد المستهلكة لكل مهمة. وقد حُسبت تكلفة API وفق الأسعار المعلنة لكل شركة، مع تقدير فوترة التخزين المؤقت للموجّهات.
| متوسط المؤشرات لكل مهمة | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|---|
| إجمالي الرموز (Token) | 40.48M | 7.05M | 2.43M |
| رموز المخرجات (Token) | 378.9K | 129.5K | 42.0K |
| عدد جولات الوكيل (Agent) | 128.8 | 46.6 | 29.0 |
| زمن التنفيذ | 83.2 دقيقة | 29.2 دقيقة | 18.5 دقيقة |
| تكلفة المهمة الواحدة | $35.28 | $5.63 | $6.03 |
يمكن أن نخرج من هذا الجدول بثلاث ملاحظات:
- Fable يستهلك أكبر قدر من الموارد: إجمالي الرموز لديه يعادل 5.74 ضعف ما يستهلكه Carbon، وزمن التنفيذ يقارب 2.85 ضعف زمنه. فجودة نتائجه العالية قائمة على جولات استكشاف كثيرة واستدعاءات ضخمة.
- Carbon يتفوق بوضوح في نسبة الأداء إلى التكلفة: تكلفة مهمته الواحدة تقارب سدس تكلفة Fable، بينما يقل عنه في Climb-WSR بمقدار 2.22 نقطة مئوية فقط، وهذا الفارق ليس ذا دلالة إحصائية.
- Astra هو الأسرع والأقل استهلاكًا للرموز: فزمن التنفيذ واستهلاك الرموز لديه هما الأدنى، لكن تكلفة المهمة الواحدة تظل أعلى قليلًا من Carbon، كما أنه يتأخر عن Carbon بفارق ملحوظ في Climb-WSR.
الفرق بين سعر الرمز واستهلاك الرموز وفاتورة المهمة
يخلط كثيرون بين هذه المفاهيم الثلاثة. فبالنسبة لسعر الرمز، يبلغ سعر Fable 5.2 مبلغ $8 لكل مليون رمز إدخال و$40 لكل مليون رمز إخراج. أما Carbon فكان سعر إطلاقه قبل 30 نوفمبر $2/$10، ثم أصبح $4/$20 اعتبارًا من 1 ديسمبر. لكن انخفاض السعر لا يعني بالضرورة انخفاض الفاتورة. فاستهلاك Astra من الرموز يبلغ نحو ثلث استهلاك Carbon فقط، ومع ذلك فتكلفة مهمته أعلى قليلًا، وهذا يدل على أن بنية التسعير ونسبة إصابة التخزين المؤقت تؤثران في الفاتورة النهائية.
وقراءة التخزين المؤقت من المتغيرات التي كثيرًا ما تُهمل في سيناريوهات الوكلاء. فالوكيل يعيد إرسال كمية كبيرة من السياق في كل جولة، وفي حالة Carbon يبلغ سعر الإدخال المخزّن مؤقتًا نحو 5% من سعر الإدخال العادي. وإجمالي الرموز لدى Fable يصل إلى 40.48M، وجزء كبير منها سياق يُقرأ مرارًا، ولذلك تؤثر طريقة الفوترة مباشرة في الفاتورة. وإضافة إلى ذلك، تُحتسب رموز التفكير في Carbon ضمن رسوم المخرجات، وعند استخدام Grounding تُفرض رسوم منفصلة على طلبات البحث.
وهناك ثلاثة مقاييس لبيانات التكلفة ينبغي الاستشهاد بكل منها على حدة: الجدول 4 في ورقة MKA (Carbon عند $5.63 وFable عند $35.28)، ولوحة المتصدرين الديناميكية في MKA (Carbon عند $6.29 وFable عند $31.97)، وتكلفة المهمة في مؤشر AA ($7.76 و$26.54). نطاق الإحصاء يختلف في كل منها، فلا يصح الجمع بينها.
خامسًا: أين تظهر مزايا Gemini 4 Carbon متعدد الوسائط؟
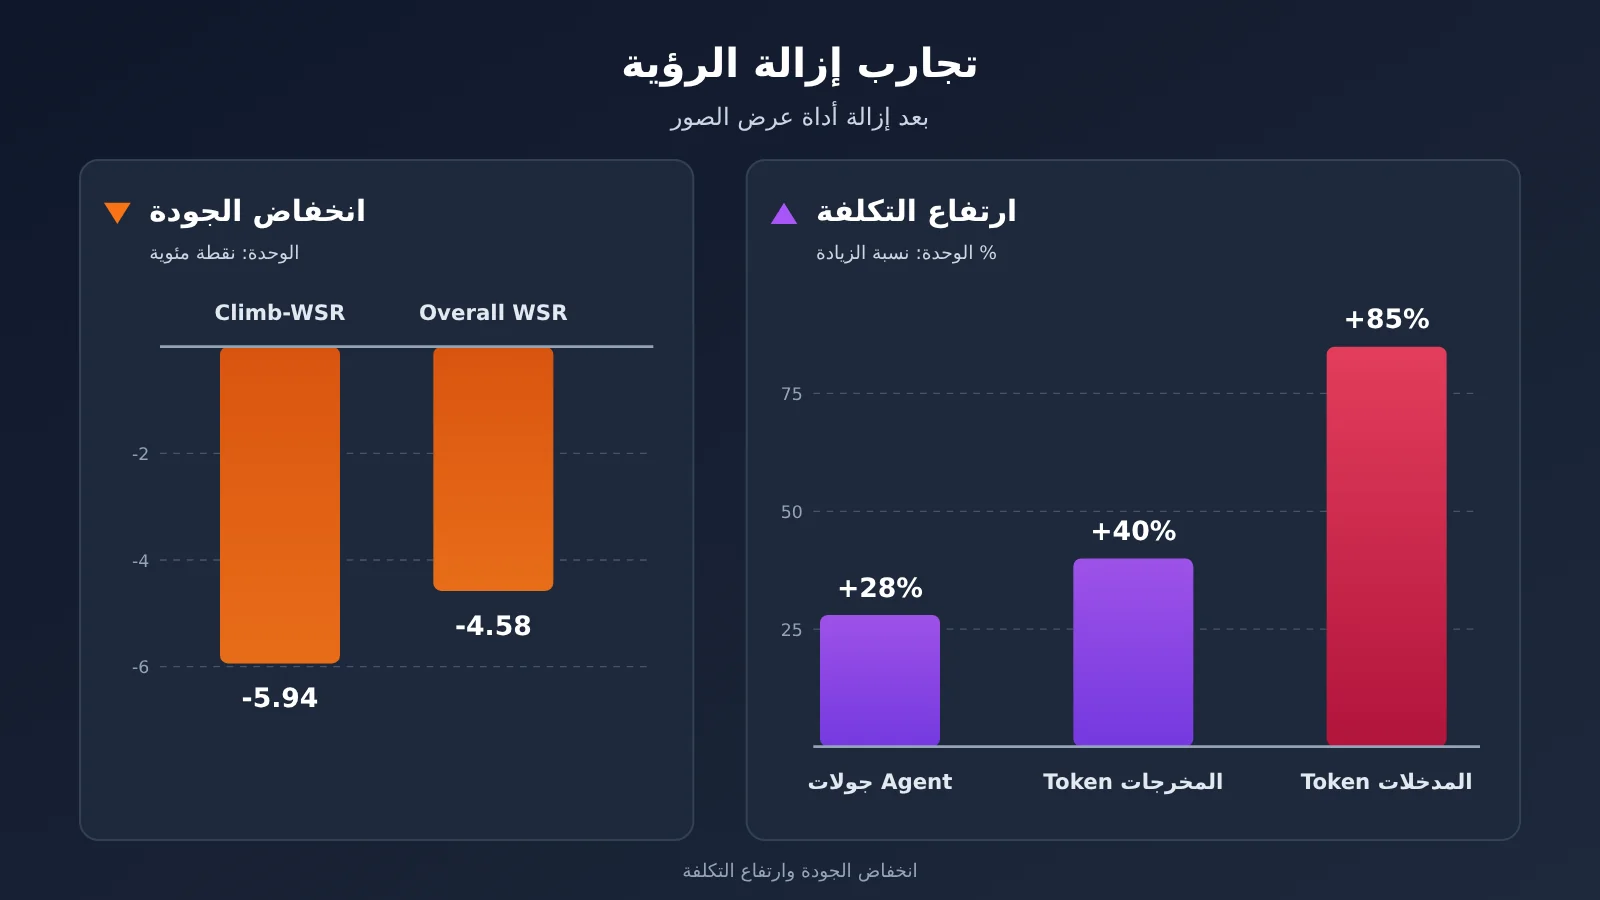
أجرى بحث MKA تجربة استئصال (Ablation): أزالوا من Carbon أداة عرض الصور view_image، وتركوه يعتمد فقط على OCR وتنفيذ الشفرة وطرق الرؤية الحاسوبية التقليدية لإنجاز المهام. وكانت النتائج كالتالي:
- انخفض Climb-WSR بمقدار 5.94 نقطة مئوية، وانخفض Overall WSR بمقدار 4.58 نقطة مئوية.
- زاد عدد جولات الوكيل (Agent) بنسبة 28%، وزادت رموز الإخراج (Token) بنسبة 40%، وزادت رموز الإدخال بنسبة 85%.
- حاول النموذج التعويض بوسائل مثل صور ASCII وUnicode Braille وOpenCV، لكنه ظل يفشل في الغالب مع الصور الفوتوغرافية الحقيقية والصور الطبية.
تدل هذه الأرقام على أن الفهم البصري في العمل المهني يصعب تعويضه باستخراج النصوص. فالعلاقات المكانية في المخططات المعمارية، وموقع الآفات في الصور الطبية، والترميز البصري في الرسوم البيانية، يضيع معظمها بعد المرور عبر OCR. وهكذا يضطر النموذج إلى كتابة الشفرات مرارًا ليخمّن محتوى الصورة، فتنخفض الجودة وترتفع التكلفة.
وتتفق نتائج قطاعات الصناعة في قائمة MKA مع ذلك. فقد تصدّر Carbon مجال الرعاية الصحية، وبرز مع Argon في مخرجات الصور. أما Fable 5.2 فتصدّر مجالات البرمجيات والبيانات، والهندسة، والخدمات اللوجستية والخرائط، والأعمال، والمالية، وتفوق في أنواع المخرجات مثل PDF وWord وجداول البيانات (Spreadsheet). ولم يتصدّر أي نموذج القطاعات العشرة كلها، وظلت ملفات Word والملفات النصية البسيطة أصعب أنواع المخرجات، إذ لم يتجاوز أي نموذج نسبة 52% في هذين النوعين.
سادسًا: التوصيات حسب السيناريو — المهام المناسبة لـ Gemini 4 Carbon وClaude Fable 5.2 وGPT-6 Astra
متى تختار Claude Fable 5.2
- التسليمات المهنية المعقدة التي تتطلب أعلى جودة في النتائج: مثل تقارير التحليل المالي، والحلول الهندسية، ومشاريع البرمجيات والبيانات. هذه المهام مكلفة عند الخطأ، ويمكنك فيها تحمّل زمن تنفيذ أطول وفاتورة أعلى.
- التسليمات التي تعتمد أساسًا على مستندات Office: مخرجات PDF وWord والجداول هي نقطة تفوّق Fable في MKA.
متى تختار Gemini 4 Carbon
- أعمال Agent المعقدة التي تحتاج إلى توازن بين الجودة والتكلفة: في MKA وصل Carbon إلى مستوى قريب إحصائيًا من Fable بتكلفة تقارب السدس.
- المهام التي تعتمد على الفهم البصري: مثل تحليل المخططات الهندسية، والتحليل المساعد للصور الطبية، والتسليمات المعتمدة على الصور. يُفضّل أن تبدأ بمستوى الاستدلال MEDIUM، فهو يقدّم نسبة أقل من الإجابات المختلقة في اختبار موثوقية الحقائق ضمن AA.
متى تختار GPT-6 Astra
- خطوط المعالجة التي تهتم بسرعة التنفيذ: سجّل أقصر زمن وأقل عدد من جولات Agent في MKA، ولذلك يناسب المهام التي تحتاج إلى استجابة سريعة.
- السيناريوهات الحساسة لميزانية Token أو لضغط نافذة السياق: يسجّل Astra أقل استهلاك إجمالي لـ Token، لكن عليك تقبّل فجوة في جودة التسليمات المهنية.
| نوع المهمة | النموذج المفضّل | النموذج البديل | الأساس الرئيسي | طريقة الوصول |
|---|---|---|---|---|
| تقارير مهنية عالية القيمة | Claude Fable 5.2 | Gemini 4 Carbon | أعلى درجات في AA وMKA | API الرسمي، APIYI |
| مهام Agent معقدة بكميات كبيرة | Gemini 4 Carbon | Claude Fable 5.2 | جودة متقاربة وتكلفة تقارب السدس | API الرسمي، APIYI |
| تحليل المخططات والصور | Gemini 4 Carbon | Claude Fable 5.2 | أدلة الاستئصال البصري (visual ablation) وتفوق في المجال الطبي | API الرسمي، APIYI |
| خطوط التنفيذ السريعة | GPT-6 Astra | Gemini 4 Carbon | أقل زمن وأقل استهلاك لـ Token | API الرسمي، APIYI |
سابعًا: كيف تختبر النماذج الثلاثة عبر واجهة موحدة
تصلح قوائم الترتيب العامة نقطة بداية فقط، فالحكم النهائي هو أداء النموذج في مهامك أنت. يستخدم المثال التالي واجهة متوافقة مع OpenAI، وكل ما عليك لاستدعاء نموذج مختلف هو تغيير المعامل model، مع بقاء الشفرة نفسها:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "用三点概括这份季度财报摘要的主要风险。"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # تسجيل استهلاك الرموز (Tokens) لاستخدامه لاحقًا في تقدير التكلفة
عرض الشفرة الكاملة لاختبار مقارنة النماذج الثلاثة
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# أسماء النماذج تعتمد على قائمة النماذج في المنصة، واسم GPT-6 Astra هنا للتوضيح فقط
MODELS = ["claude-fable-5-2", "gemini-4-carbon", "gpt-6-astra"]

# السعر لكل مليون رمز (Token) بالدولار، يُرجى تعبئته بحسب القناة الفعلية
# مثال: Fable 5.2 بسعره الرسمي المعلن؛ وCarbon بسعر الإطلاق الأول قبل 30 نوفمبر
PRICES = {
    "claude-fable-5-2": {"input": 8.0, "output": 40.0},
    "gemini-4-carbon": {"input": 2.0, "output": 10.0},
    "gpt-6-astra": None,  # أضف القيمة بنفسك
}

def build_messages(task, image_url=None):
    content = [{"type": "text", "text": task}]
    if image_url:
        content.append({"type": "image_url", "image_url": {"url": image_url}})
    return [{"role": "user", "content": content}]

def run_once(model, messages):
    start = time.time()
    resp = client.chat.completions.create(model=model, messages=messages)
    elapsed = time.time() - start
    usage = resp.usage
    cost = None
    price = PRICES.get(model)
    if price and usage:
        # تقدير تقريبي: لا يفرّق بين القراءة من الذاكرة المؤقتة وغيرها؛ وعادةً تُحتسب رموز التفكير ضمن المخرجات
        cost = (usage.prompt_tokens * price["input"]
                + usage.completion_tokens * price["output"]) / 1_000_000
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "est_cost_usd": round(cost, 4) if cost is not None else None,
        "answer": resp.choices[0].message.content[:200],
    }

if __name__ == "__main__":
    task = "根据这张户型图,列出各房间面积估算和三条改造建议。"
    msgs = build_messages(task, image_url="https://example.com/floor-plan.png")
    for m in MODELS:
        try:
            print(run_once(m, msgs))
        except Exception as e:
            print(m, "调用失败:", e)
هذه الشفرة تحسب تكلفة استدعاء واحد فقط. أما تكلفة مهمة Agent حقيقية فتتطلب جمع تكلفة جميع الجولات، وهذا ما تقصده هذه المقالة بـ«تكلفة المهمة». كما أن Carbon لا يدعم thinking_budget، وتمريره يُرجع خطأ HTTP 400، أما معاملات أخذ العينات مثل temperature فيتجاهلها النموذج. لذلك اضبط مستوى الاستدلال بالطريقة الموضحة في وثائق المنصة.
🚀 نصيحة للبدء السريع: احصل أولًا على رصيد تجريبي مجاني للمستخدمين الجدد من APIYI عبر apiyi.com، ثم شغّل سكربت المقارنة أعلاه على 5 إلى 10 عينات من عملك الفعلي. سجّل الزمن واستهلاك الرموز (Tokens) ودرجة الجودة، ثم قرّر أي نموذج ستعتمد عليه. تتيح المنصة الوصول إلى OpenAI وClaude وGemini وغيرها من النماذج الرئيسية بمفتاح API واحد، والمحاسبة حسب الاستهلاك، والتبديل بين النماذج لا يحتاج إلا إلى تغيير معامل واحد.
توصيات القرار: كيف تختار بين النماذج الثلاثة
عند الاختيار، حدّد أولًا القيد الأهم في مهمتك، ثم اعتمد المؤشر المناسب له:
- الجودة قيد صارم: اعتمد على مؤشر Climb-WSR في MKA، واختر بين Fable 5.2 وCarbon. الفارق بينهما ليس كبيرًا، لذا الأفضل أن تتحقق بنفسك على عيناتك.
- الميزانية قيد صارم: انظر إلى تكلفة المهمة الواحدة في الجدول 4 من MKA، لا إلى سعر الرمز (Token). يتفوق Carbon هنا بوضوح.
- الوقت قيد صارم: انظر إلى زمن التنفيذ وعدد جولات Agent. Astra هو الأسرع، لكن عليك أن تقبل أنه متأخر بوضوح في جودة المخرجات الاحترافية.
💡 نصيحة للاختيار: يمكنك أن تحذو حذو Google /swarm، فتضع النموذج القوي في مرحلتي التخطيط والمراجعة، والنموذج السريع في مرحلة التنفيذ الدفعي. وعبر الواجهة الموحدة في APIYI على apiyi.com، يمكنك إسناد نموذج مختلف لكل دور من أدوار Agent داخل المشروع نفسه، دون الحاجة إلى صيانة عدة حزم SDK.
الأسئلة الشائعة FAQ
Q1: ما موقع كلٍّ من Gemini 4 Carbon وClaude Fable 5.2 وGPT-6 Astra؟
النماذج الثلاثة من أفضل نماذج الاستدلال في النصف الثاني من 2026. يتصدر Fable 5.2 في الجودة الشاملة وجودة التسليم المهني. أما Carbon فيحقق توازنًا جيدًا بين الجودة والقدرات متعددة الوسائط وتكلفة المهمة. وتكمن ميزة Astra في سرعة التنفيذ وكفاءة استهلاك Token.
Q2: يتفوق Fable 5.2 على Carbon بمقدار 2.22 نقطة مئوية في MKA، فهل يعني ذلك أنه الأقوى؟
لا. فمجال الثقة 95% لهذا الفارق يمتد من -0.94 إلى +5.49، أي أنه يشمل الصفر، ولهذا لا يبلغ الفارق دلالة إحصائية. والأدق أن نقول إن النموذجين في مستوى متقارب، وإن كليهما يتفوق على Astra بوضوح.
Q3: هل يمكن مقارنة 65 نقطة في مؤشر AA مع 56.56% في MKA؟
لا يمكن. مؤشر AA درجة مركّبة من 9 اختبارات، ويستخدم كل نموذج فيها مستوى استدلال مختلفًا. أما MKA فهو معدل استيفاء مرجّح للتسليم المهني تحت إطار اختبار (Harness) موحّد. يختلف الاثنان في موضوع التقييم وطريقة احتساب الدرجات، فلا يمكن تحويل أحدهما إلى الآخر.
Q4: سعر Token في Carbon يساوي ربع سعره في Fable، فهل تكلفة المهمة ربع تكلفتها أيضًا؟
ليس بالضرورة. صحيح أن سعر Carbon خلال فترة الإطلاق يساوي 25% من سعر Fable 5.2، وسيصبح 50% ابتداءً من 1 ديسمبر. لكن الفاتورة الفعلية تعتمد على استهلاك Token، وToken التفكير، ونسبة إصابة التخزين المؤقت، واستدعاءات الأدوات. في الجدول 4 من MKA يبلغ الفارق في تكلفة المهمة الواحدة بين النموذجين نحو ستة أضعاف، لأن استهلاك Carbon أقل بكثير أيضًا.
Q5: كيف أختبر النماذج الثلاثة بنفسي بتكلفة منخفضة؟
أنصح باستخدام واجهة مجمّعة تدعم عدة نماذج:
1. سجّل في APIYI على apiyi.com، واحصل على مفتاح API ورصيد تجريبي مجاني؛
2. اضبط `base_url` في شفرة هذا المقال على `https://api.apiyi.com/v1`؛
3. شغّل المقارنة على ملفاتك ومهامك الحقيقية في العمل، وسجّل الجودة والزمن واستهلاك Token.
Q6: GPT-6 Astra هو الأوفر في Token، فلماذا لا تكون تكلفة مهمته الواحدة الأقل؟
قلة Token لا تعني انخفاض الفاتورة. فبنية أسعار الإدخال والإخراج والتخزين المؤقت تختلف من نموذج إلى آخر، والتكلفة النهائية هي مجموع حاصل ضرب كل كمية استهلاك في سعرها. في الجدول 4 من MKA، يستهلك Astra نحو ثلث Token الذي يستهلكه Carbon، ومع ذلك فتكلفته أعلى قليلًا.
Q7: ما حدود نتائج هذه التقييمات؟
MKA يشغَّل مرة واحدة فقط لكل مهمة، والحَكَم (Judge) فيه هو GPT-6 Luna Medium، وتبلغ نسبة اتفاقه مع المراجعين الخبراء 96%. أما قائمة AA فهي لقطة ديناميكية؛ فبعد تعديل أسعار Carbon في 1 ديسمبر ستتغير التكاليف المحسوبة وفق السعر القياسي أيضًا. وإذا أردت تتبّع التكلفة على المدى الطويل، يمكنك الرجوع إلى تفاصيل الاستخدام في APIYI على apiyi.com، حيث تستطيع احتساب الإنفاق الفعلي لكل نموذج واعتماده كبيانات التكلفة الخاصة بك.
أهم نقاط المقارنة بين النماذج الثلاثة Key Takeaways
- القدرة الشاملة: في AA v5.0.1 سجّل Fable 5.2 Max درجة 65، متقدمًا على Carbon High (60 درجة) وAstra Max (57 درجة).
- جودة التسليم المهني: في MKA لا يبدو الفرق بين Fable وCarbon كبيرًا، بينما يتفوق كلاهما على Astra بوضوح.
- تكلفة المهمة: بحسب منهجية الجدول 4 في الورقة البحثية، تبلغ تكلفة المهمة الواحدة في Carbon نحو 5.63 دولار، أي حوالي سدس تكلفة Fable.
- السرعة والكفاءة: يستغرق Astra 18.5 دقيقة لكل مهمة ويستهلك 2.43 مليون Token، فهو الأفضل في السرعة وكفاءة استهلاك Token.
- قيمة القدرات متعددة الوسائط: عند إزالة أداة عرض الصور تنخفض جودة Carbon وترتفع Token المُدخلة بنسبة 85%.
- حدود المقارنة: سعر Token واستهلاك Token وفاتورة المهمة ثلاثة مفاهيم مختلفة.
- كيف تبدأ: يمكنك إجراء اختبار مقارن على عيّنة صغيرة للنماذج الثلاثة باستخدام مفتاح واحد عبر APIYI على apiyi.com.
الخلاصة: لا يوجد مقياس واحد يحدد أقوى نموذج
لنعد إلى السؤال الذي بدأنا به. الفروق بين هذه النماذج الثلاثة المتصدرة تعود أساسًا إلى اختلاف المفاضلة بين الجودة والسرعة والتكلفة:
- Claude Fable 5.2: يتصدر في المؤشر الشامل وفي درجة التسليم المهني، لكن ثمن ذلك أطول زمن تنفيذ وأعلى تكلفة للمهمة.
- Gemini 4 Carbon: جودة التسليم المهني لديه قريبة إحصائيًا من Fable، وتكلفة المهمة هي الأقل، وميزته الفارقة هي الفهم البصري.
- GPT-6 Astra: الأسرع في التنفيذ والأوفر في الـ Token، لكن جودة التسليم المهني لديه متأخرة بوضوح عن النموذجين الآخرين.
القدرة الشاملة وجودة المهام وسرعة الاستجابة وتكلفة المهمة معايير يجب تقييم كلٍّ منها على حدة. وبدلًا من الاكتفاء بترتيب النماذج في لوحات الصدارة، الأكثر موثوقية أن تُجري اختبارًا مقارنًا على مهامك أنت. ننصحك بالتحقق السريع من أداء النماذج الثلاثة في سيناريوهات عملك عبر APIYI على apiyi.com، إذ توفر المنصة رصيدًا تجريبيًا مجانيًا وواجهة موحدة لعدة نماذج.
📚 المراجع
- الورقة التقنية لـ MKA: MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks
- الرابط:
storage.googleapis.com/deepmind-media/papers/mka_tech_paper.pdf -
الوصف: البيانات الأصلية لمعدل الفوز (WSR) للنماذج الثلاثة، وفترات الثقة، وتكاليف الجدول 4، وتجارب الاستبعاد البصري
-
لوحة صدارة النماذج من Artificial Analysis: Intelligence Index v5.0.1
- الرابط:
artificialanalysis.ai/leaderboards/models -
الوصف: لقطة حية للدرجات الشاملة وتكلفة كل مهمة والزمن المستغرق
-
قائمة تقييم MKA: ترتيب وكلاء المعرفة متعددي الوسائط
- الرابط:
artificialanalysis.ai/zh/evaluations/mka -
الوصف: نتائج تفصيلية للنماذج الرائدة في المجال ولأنواع الملفات المسلَّمة
-
بطاقة نموذج Gemini 4 Carbon: المصدر الرسمي من Google DeepMind
- الرابط:
deepmind.google/models/model-cards/gemini-4-carbon -
الوصف: الوسائط ونافذة السياق ومستويات الاستدلال والقيود المعروفة
-
صفحة تسعير Gemini API: السعر القياسي لـ Carbon وسعر التخزين المؤقت وسعر Batch
- الرابط:
ai.google.dev/gemini-api/docs/pricing -
الوصف: سعر الإطلاق والتعديل في الأسعار اعتبارًا من 1 ديسمبر
-
وثائق Claude Fable 5.2 API: الشرح الرسمي للنموذج من Anthropic
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview - الوصف: نافذة السياق وأقصى طول للمخرجات وسعر الـ Token ووضع Fast Mode
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، وللمزيد من مواد الربط يمكنكم زيارة مركز الوثائق docs.apiyi.com