Catatan penulis: artikel ini membandingkan performa, waktu pengerjaan, dan biaya Gemini 4 Carbon, Claude Fable 5.2, dan GPT-6 Astra memakai dua sistem evaluasi, yaitu Indeks Komposit AA dan evaluasi tugas profesional MKA. Artikel ini juga menjelaskan konfigurasi evaluasi dan batas berlakunya kesimpulan statistik.
Sebelum membaca: 7 istilah penting dalam perbandingan tiga model ini
- MKA (Multimodal Knowledge Agent): benchmark untuk menilai tugas kerja profesional yang bersifat multimodal. Benchmark ini menguji apakah model bisa membaca dokumen rumit seperti gambar teknik, hasil pindai, dan citra medis, lalu menyerahkan hasil kerja profesional yang utuh.
- Climb WSR: tingkat pemenuhan berbobot (weighted satisfaction rate) yang hanya dihitung dari butir penilaian dengan daya pembeda lebih tinggi. Metrik ini dipakai untuk memperlihatkan jarak antar model papan atas.
- Regression WSR: metrik berbobot yang mengukur apakah persyaratan dasar terpenuhi. Anggap saja ini garis batas lulus untuk hasil kerja profesional.
- Tingkat penalaran: pengaturan intensitas penalaran yang bisa dipakai model, misalnya LOW, MEDIUM, dan HIGH pada Carbon, serta konfigurasi seperti Max dan Xhigh pada Fable dan Astra di papan peringkat.
- Biaya tugas: total biaya semua pemanggilan model untuk menyelesaikan satu tugas tertentu. Ini bukan harga tetap per satu permintaan API.
- Pembacaan cache: cara memakai ulang input yang sudah tersimpan di cache, dengan tarif per satuan yang lebih murah.
- Signifikansi statistik: ukuran untuk menilai apakah selisih skor antara dua model punya bukti statistik yang cukup. Kalau selisihnya belum mencapai tingkat signifikan, jangan dianggap sebagai kemenangan yang pasti.
Persaingan model papan atas sekarang sulit dijelaskan hanya dengan satu papan peringkat komposit. Artikel ini membandingkan Gemini 4 Carbon, Claude Fable 5.2, dan GPT-6 Astra dari tiga sisi: kemampuan umum, hasil kerja profesional, dan biaya tugas. Di akhir, kami beri saran pemilihan model berdasarkan jenis tugas.
Ini bukan ulasan yang mencampur semua skor lalu membuat peringkat. Indeks komposit dan MKA adalah dua sistem evaluasi yang berbeda, jadi keduanya dibahas terpisah. Kami juga akan menjelaskan selisih mana yang punya bukti statistik dan mana yang buktinya belum cukup.
Manfaat utama: setelah membaca artikel ini, kamu bisa menentukan model mana yang sebaiknya didahulukan sesuai tuntutan tugasmu soal kualitas, kecepatan, dan biaya.
1. Gemini 4 Carbon, Claude Fable 5.2, dan GPT-6 Astra Bersaing di Arena yang Sama
Waktu rilis ketiga model ini berdekatan. Google pertama kali mengumumkan Gemini 4 Carbon pada 28 Oktober 2026, lalu Anthropic merilis Claude Fable 5.2 pada 9 November. Pada 10 November, Carbon resmi dibuka untuk developer, perusahaan, dan konsumen. Di hari yang sama, Google DeepMind dan Artificial Analysis meluncurkan evaluasi MKA. Pada 11 November, Artificial Analysis Intelligence Index v5.0.1 diperbarui dan memasukkan Fable 5.2.
Posisi publik ketiga model ini jelas berbeda. Carbon dibangun di atas Gemini 4 Argon dan difokuskan pada agen jangka panjang, rekayasa perangkat lunak yang kompleks, serta riset ilmiah. Model ini mendukung input teks, gambar, audio, dan video. Fable 5.2 memakai Adaptive Thinking, dengan jendela konteks 1M token dan output maksimum 128K token. GPT-6 Astra punya hasil di kedua evaluasi yang dikutip di artikel ini, dan sering dijadikan acuan efisiensi.
| Dimensi Perbandingan | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra | Penilaian Saat Ini |
|---|---|---|---|---|
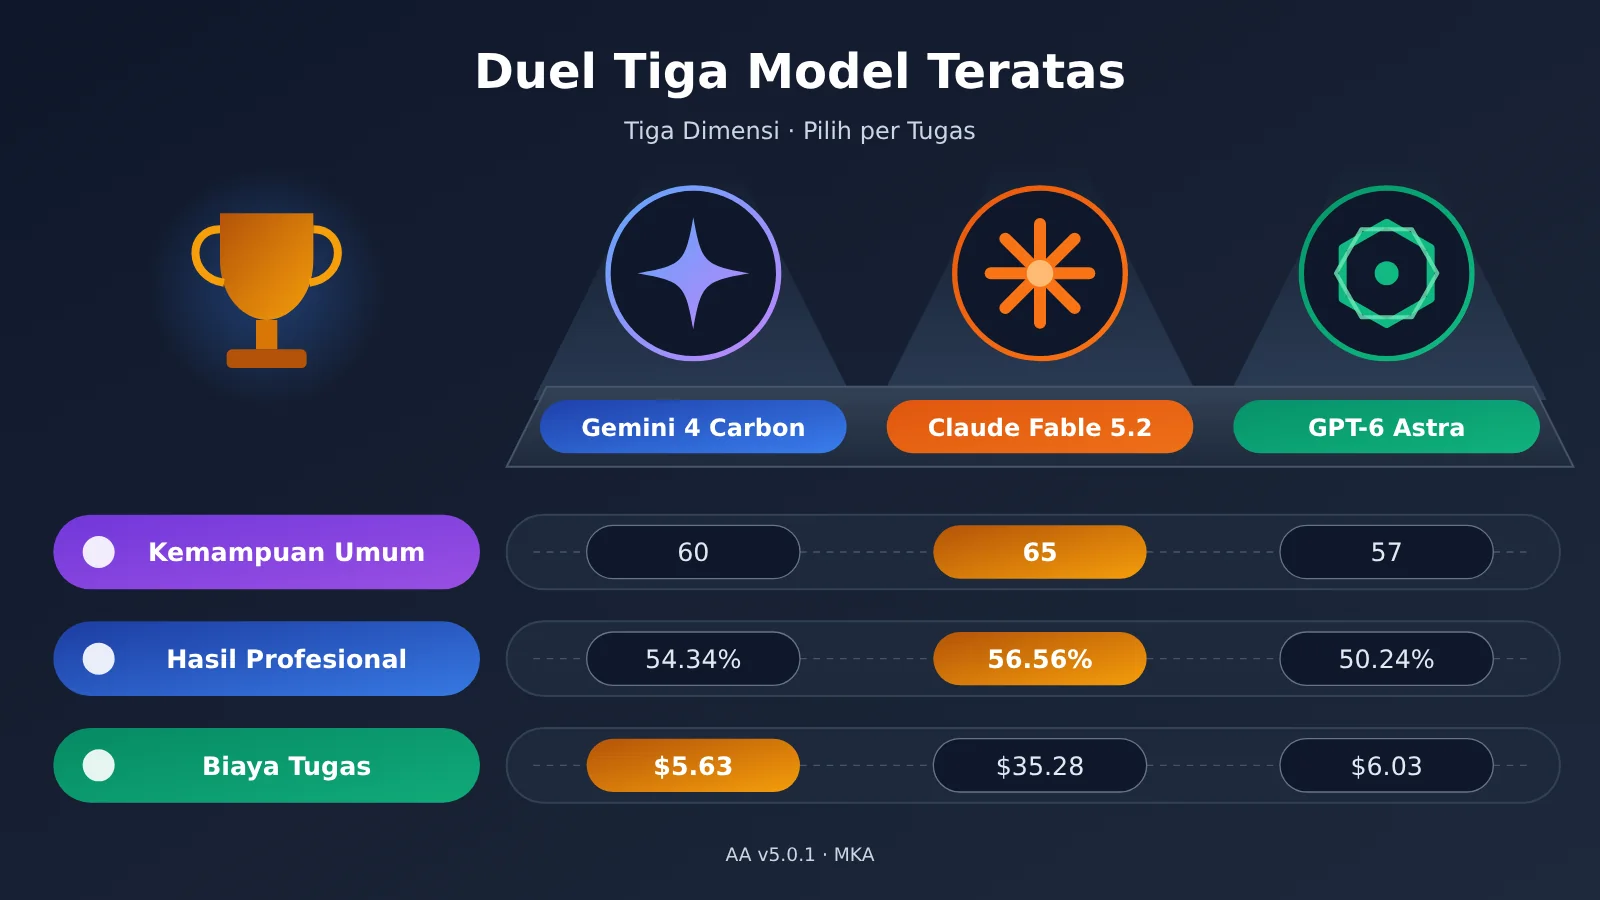
| Kemampuan keseluruhan (AA v5.0.1) | 65 (Max) | 60 (High) | 57 (Max) | Fable unggul |
| Hasil kerja profesional (MKA Climb-WSR) | 56,56% | 54,34% | 50,24% | Fable dan Carbon berdekatan, keduanya unggul atas Astra |
| Biaya per tugas (MKA Tabel 4) | $35,28 | $5,63 | $6,03 | Carbon paling rendah |
| Waktu eksekusi (MKA Tabel 4) | 83,2 menit | 29,2 menit | 18,5 menit | Astra tercepat |
| Konsumsi token (MKA Tabel 4) | 40,48M | 7,05M | 2,43M | Astra paling hemat |
Kolom “Penilaian Saat Ini” hanya berlaku untuk masing-masing indikator. Tidak ada satu model pun yang menempati peringkat pertama di semua dimensi.
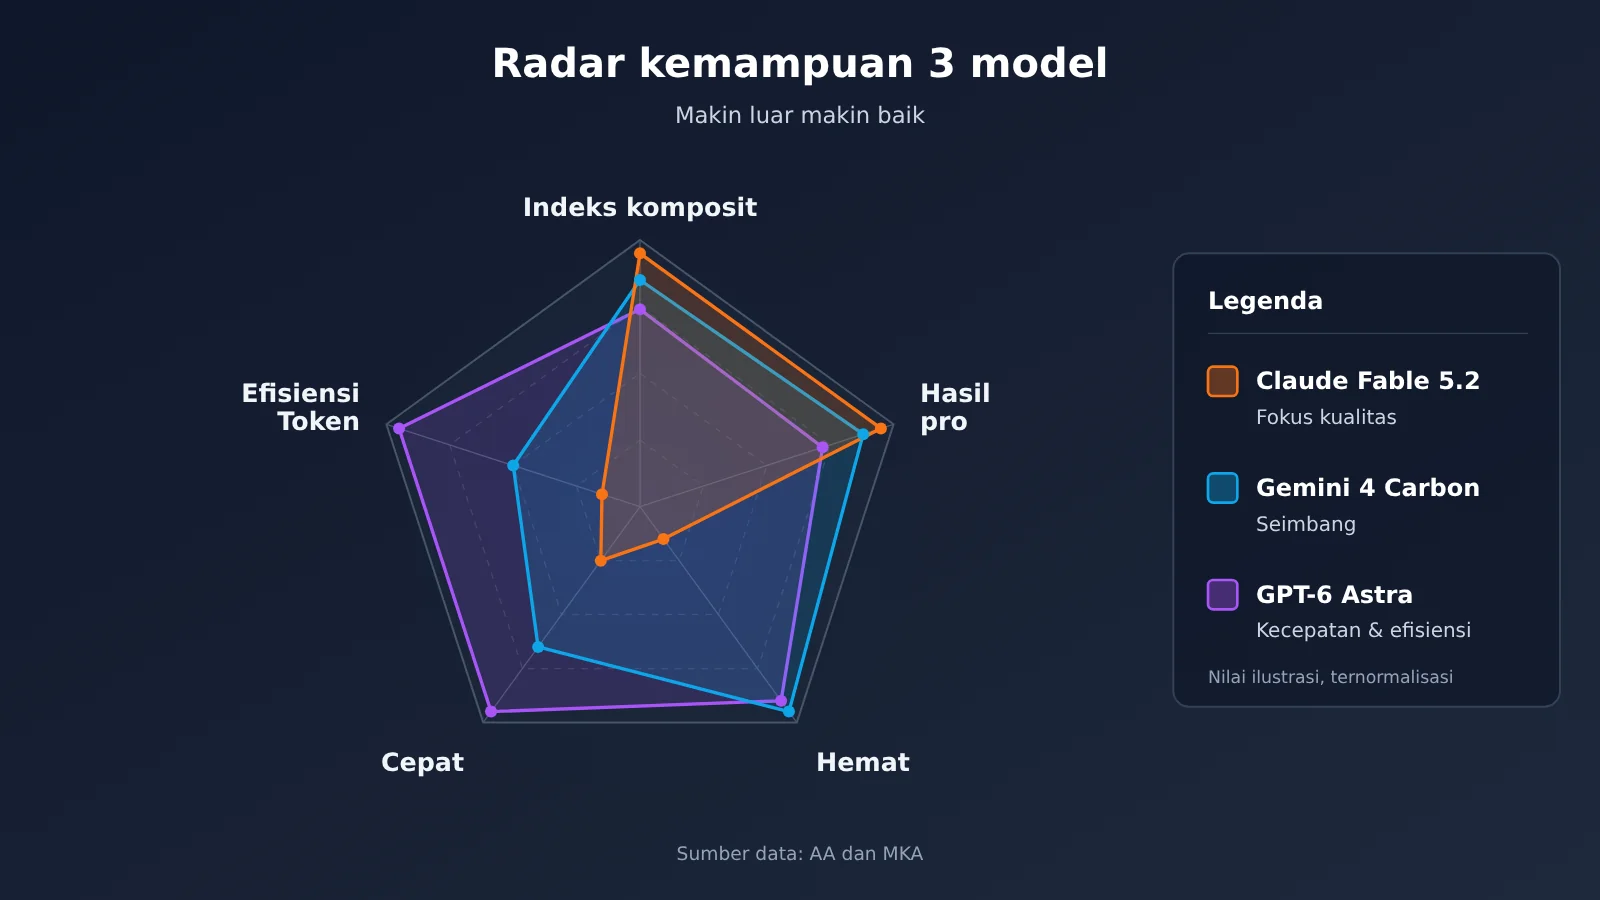
📊 Catatan data: Data pada tabel di atas berasal dari cuplikan papan peringkat AA dan makalah teknis MKA. Kedua metodologi ini tidak bisa saling dikonversi. Kalau ingin memverifikasi pada skenario bisnis Anda sendiri, Anda bisa memakai APIYI (apiyi.com) untuk menjalankan uji perbandingan kecil dengan petunjuk yang sama, lalu melihat perbedaan ketiga model di beban kerja nyata.
II. Peringkat Gabungan AA: Claude Fable 5.2 Unggul untuk Sementara, Gemini 4 Carbon Menyusul Ketat
Artificial Analysis Intelligence Index v5.0.1 terdiri dari 9 evaluasi: AA-Briefcase v1.1, AutomationBench-AA, Terminal-Bench 4.0, FrontierCode 2.0, AA-Omniscience v1.1, GDP.pdf, HLE-Diamond, CritPt v2, dan Terminal-Bench-Science 0.1. Cakupannya meliputi pekerjaan berbasis pengetahuan, otomatisasi, kode, penalaran ilmiah, dan keandalan fakta. Indeks ini menjawab pertanyaan “seberapa kuat kemampuan model secara keseluruhan”.
| Konfigurasi model | AA Index v5.0.1 | Biaya per tugas evaluasi | Waktu per tugas |
|---|---|---|---|
| Claude Fable 5.2 Max | 65 | $26,54 | 44,4 menit |
| Gemini 4 Carbon High | 60 | $7,76 | 24,9 menit |
| GPT-6 Astra Max | 57 | $6,24 | 23,0 menit |
Perhatikan perbedaan konfigurasi pada tabel ini. Ketiga model masing-masing memakai tingkat Max, High, dan Max, sehingga anggaran penalarannya tidak sama. Jadi hasilnya tidak bisa dianggap sebagai perbandingan kemampuan murni pada kondisi yang setara. Skor model yang sama juga berubah ketika tingkatnya diganti: Fable 5.2 di tingkat Xhigh dan High sama-sama 62 poin, sedangkan Carbon di tingkat Medium mendapat 58 poin dan di tingkat Low 54 poin.
Data antar-tingkat pada Carbon layak dilihat tersendiri. Dalam perhitungan AA, biaya per tugas di tingkat Medium adalah $6,59, justru lebih rendah daripada tingkat Low yang $7,19. Tingkat High memang skornya paling tinggi, tetapi latensi token jawaban pertamanya mencapai 67,54 detik. Ini menunjukkan bahwa menaikkan tingkat penalaran belum tentu memberi keuntungan yang sebanding. Angka $7,76 di tabel adalah rata-rata biaya tugas AA yang dihitung dari harga standar Carbon sebesar $4/$20, bukan harga satu permintaan biasa.
III. MKA Pengiriman Profesional: Kemampuan Tiga Model Menyelesaikan Pekerjaan Nyata
Indeks AA mengukur kemampuan secara menyeluruh, sedangkan MKA mengukur apakah sebuah model benar-benar bisa menyelesaikan pekerjaan profesional di dunia nyata. Berikut rancangan MKA berdasarkan makalah teknisnya:
- Ada 200 tugas nyata yang bersifat privat, mencakup 10 industri dan 83 jenis profesi. Setiap tugas setara dengan beban kerja tenaga profesional sekitar 3–8 jam.
- Setiap tugas punya sekitar 70 kriteria penilaian berbobot. Sebanyak 88% tugas menuntut model menghasilkan file mandiri, misalnya Word, Excel, PPT, PDF, HTML, atau gambar.
- Semua model dijalankan dalam Stirrup Agent Harness yang sama, dengan lingkungan alat yang sama dan anggaran putaran yang seragam, yaitu 250 putaran. Setiap tugas dijalankan satu kali.
| Model | Climb-WSR | Overall WSR | Regression-WSR |
|---|---|---|---|
| Claude Fable 5.2 | 56,56% | 73,26% | 95,71% |
| Gemini 4 Carbon | 54,34% | 71,89% | 96,36% |
| GPT-6 Astra | 50,24% | 69,34% | 95,17% |
Ketiga metrik ini punya arti masing-masing. Regression-WSR menunjukkan seberapa baik persyaratan dasar terpenuhi. Ketiga model berada di atas 95%, dengan Carbon sedikit lebih tinggi. Climb-WSR hanya menghitung butir-butir yang sulit, dan inilah acuan utama untuk membedakan model papan atas. Overall WSR adalah tingkat pemenuhan berbobot untuk seluruh butir. Angka-angka ini bukan tingkat akurasi tanya jawab biasa, jadi tidak bisa dibandingkan langsung dengan skor indeks AA yaitu 65, 60, dan 57.
Signifikansi Statistik antara Claude Fable 5.2 dan Gemini 4 Carbon
Signifikansi statistik adalah hal yang paling perlu diperhatikan saat membaca hasil MKA. Data dari makalahnya adalah sebagai berikut:
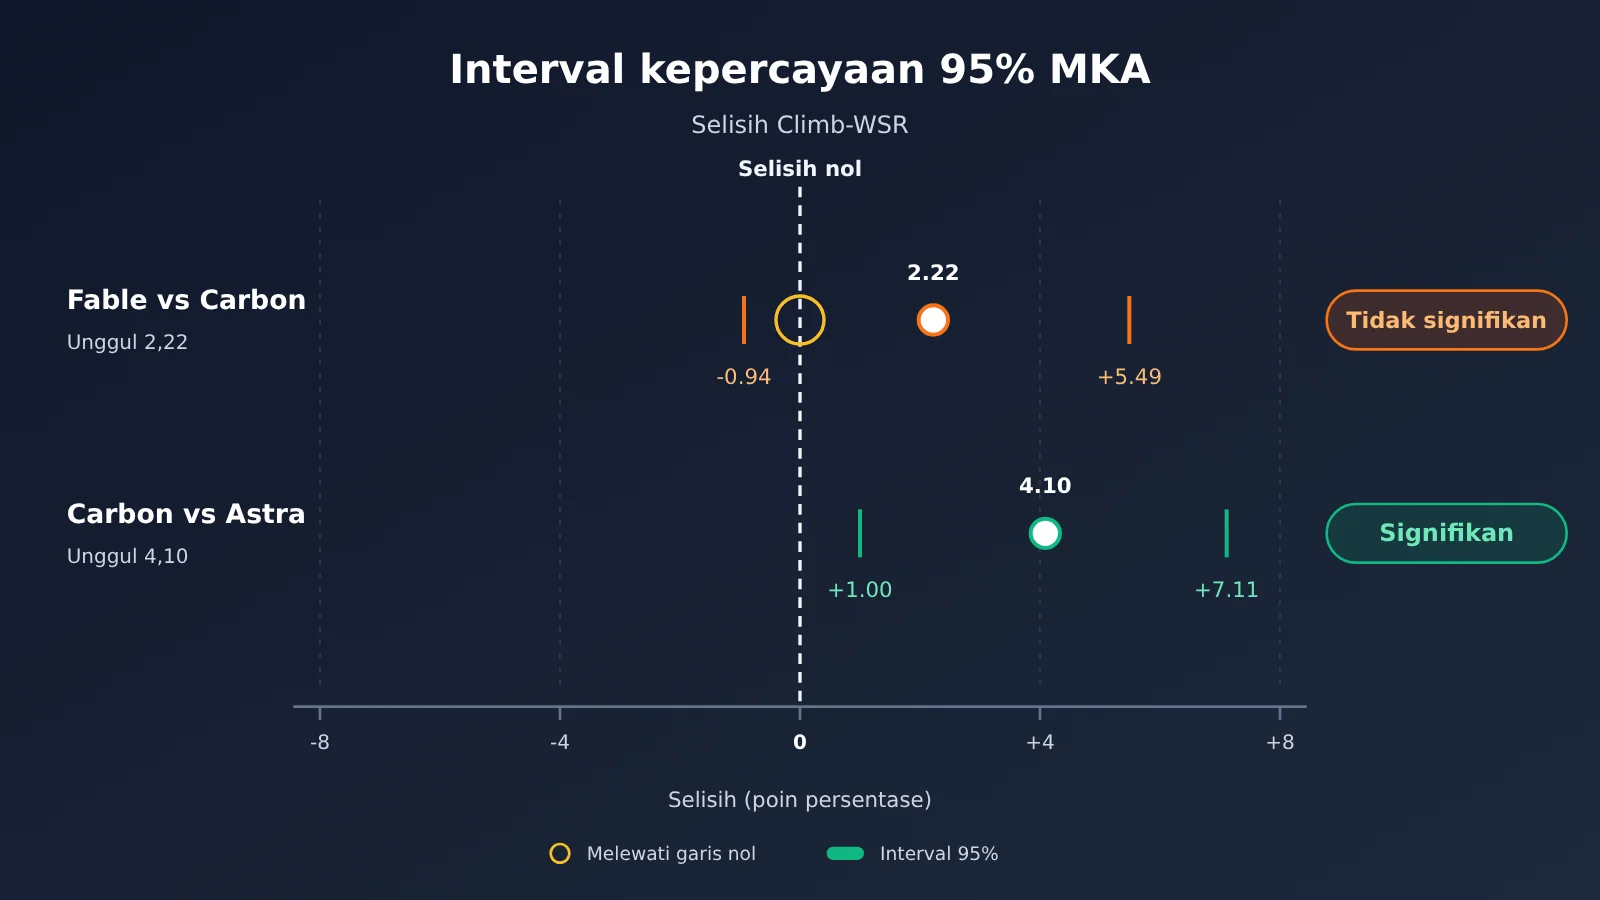
- Fable vs Carbon: unggul 2,22 poin persentase, dengan interval kepercayaan 95% dari -0,94 hingga +5,49. Intervalnya melewati angka 0, sehingga selisihnya tidak mencapai signifikansi statistik.
- Carbon vs Astra: unggul 4,10 poin persentase, dengan interval kepercayaan 95% dari +1,00 hingga +7,11. Intervalnya seluruhnya berada di atas 0, sehingga selisihnya signifikan secara statistik.
Jadi, pernyataan yang tepat adalah: di MKA, Fable 5.2 dan Carbon berada di level yang setara, dan bukti yang ada belum cukup untuk menyimpulkan bahwa Fable jelas mengungguli Carbon. Kesimpulan makalahnya adalah kedua model ini sama-sama unggul signifikan atas Astra.
Empat: Perbandingan Biaya Tugas — Berapa Harga Nyata Ketiga Model untuk Tugas yang Sama
Tabel 4 dalam makalah MKA menyajikan rata-rata konsumsi sumber daya untuk setiap tugas. Biaya API dihitung berdasarkan harga resmi masing-masing vendor, dengan memperhitungkan penagihan prompt caching.
| Rata-rata metrik per tugas | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|---|
| Total Token | 40,48 jt | 7,05 jt | 2,43 jt |
| Token output | 378,9 rb | 129,5 rb | 42,0 rb |
| Jumlah putaran Agent | 128,8 | 46,6 | 29,0 |
| Waktu eksekusi | 83,2 menit | 29,2 menit | 18,5 menit |
| Biaya per tugas | $35,28 | $5,63 | $6,03 |
Ada tiga hal yang bisa kita simpulkan dari tabel ini:
- Fable menggunakan sumber daya paling banyak: Total Token-nya 5,74 kali lipat Carbon, dan waktu eksekusinya sekitar 2,85 kali Carbon. Hasil berkualitas tingginya dibangun lewat eksplorasi berulang dan pemanggilan dalam jumlah besar.
- Carbon unggul dalam rasio harga-performa: Biaya per tugasnya sekitar seperenam Fable, sementara Climb-WSR-nya hanya lebih rendah 2,22 poin persentase, dan selisih itu tidak signifikan.
- Astra paling cepat dan paling hemat Token: Waktu eksekusi dan konsumsi Token-nya paling sedikit, tetapi biaya per tugasnya masih sedikit lebih tinggi daripada Carbon, dan Climb-WSR-nya juga tertinggal signifikan dari Carbon.
Perbedaan antara harga per Token, konsumsi Token, dan tagihan per tugas
Ketiga konsep ini sering tercampur. Soal harga per Token: Fable 5.2 dihargai $8 per sejuta Token input dan $40 per sejuta Token output. Carbon punya harga peluncuran $2/$10 sampai 30 November, lalu menjadi $4/$20 mulai 1 Desember. Namun harga per Token yang rendah tidak otomatis berarti tagihan yang rendah. Konsumsi Token Astra hanya sekitar sepertiga Carbon, tetapi biaya per tugasnya malah sedikit lebih tinggi. Artinya, struktur harga dan tingkat cache hit tiap model sama-sama memengaruhi biaya akhir.
Pembacaan cache sering luput dari perhatian dalam skenario Agent. Di setiap putaran, Agent mengirim ulang konteks dalam jumlah besar. Pada Carbon, misalnya, harga input dari cache sekitar 5% dari harga input biasa. Total Token Fable mencapai 40,48 jt, dan sebagian besarnya adalah konteks yang dibaca berulang, sehingga metode penagihan langsung memengaruhi tagihan. Selain itu, Token berpikir (thinking) pada Carbon dihitung sebagai biaya output, dan permintaan pencarian saat memakai Grounding ditagih tersendiri.
Data biaya punya tiga acuan yang harus dikutip secara terpisah: Tabel 4 makalah MKA (Carbon $5,63, Fable $35,28), papan peringkat dinamis MKA (Carbon $6,29, Fable $31,97), dan biaya tugas pada indeks AA ($7,76 dan $26,54). Cakupan statistik ketiganya berbeda, jadi jangan dicampur.
Lima, Di Mana Keunggulan Multimodal Gemini 4 Carbon Terlihat
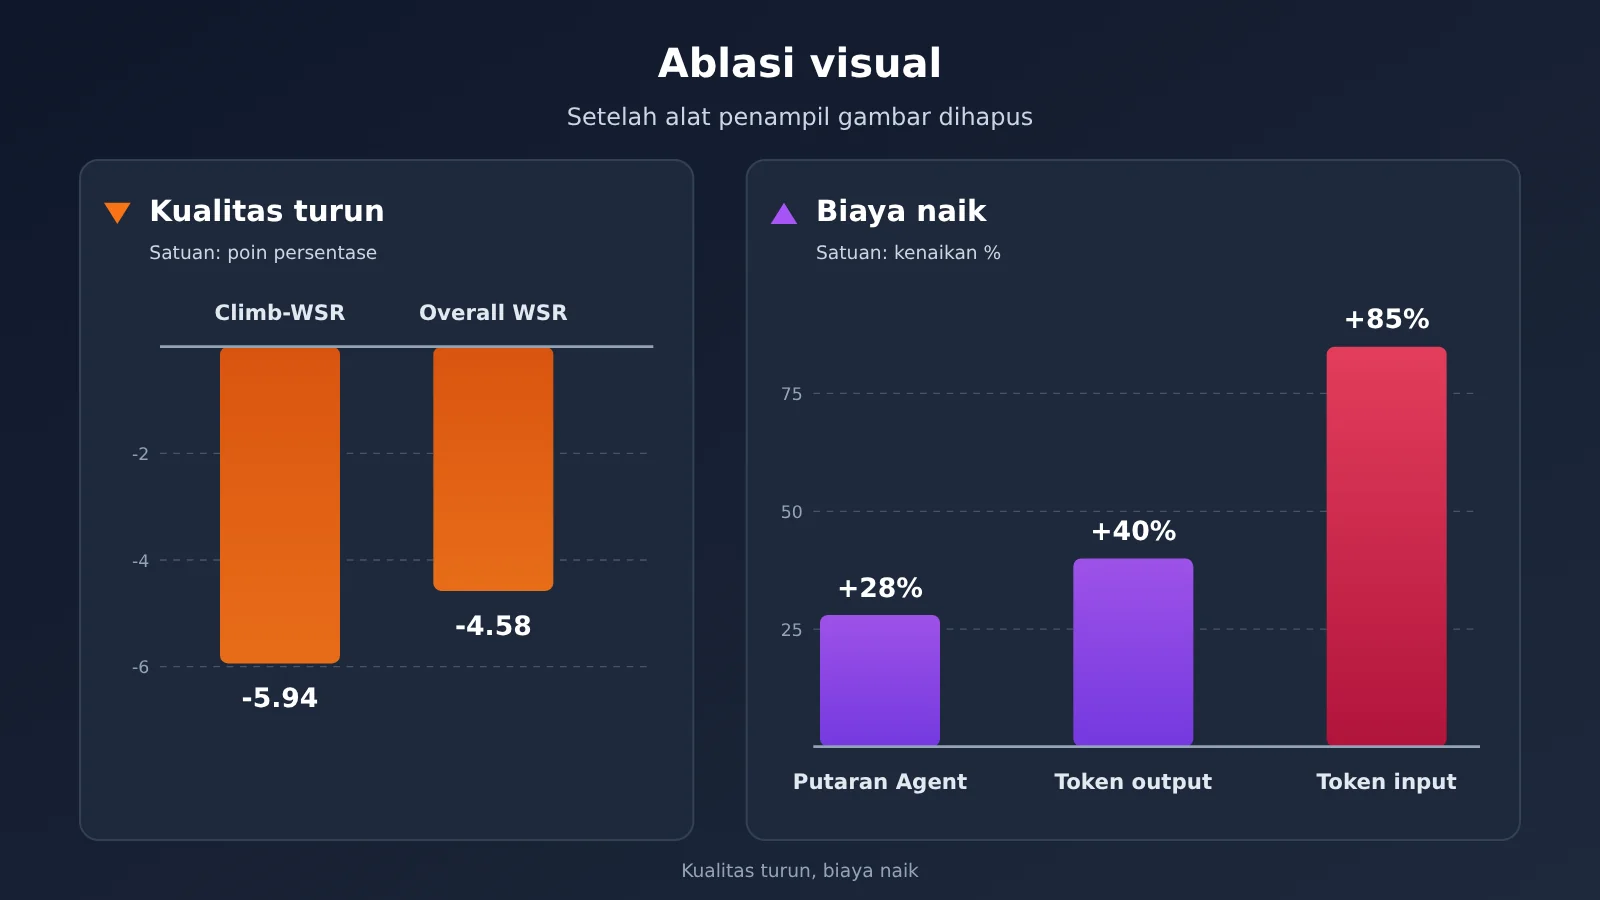
Makalah MKA melakukan satu eksperimen ablasi: alat view_image milik Carbon dihapus, sehingga model hanya bisa mengandalkan OCR, eksekusi kode, dan metode computer vision tradisional untuk menyelesaikan tugas. Hasilnya:
- Climb-WSR turun 5,94 poin persentase, sedangkan Overall WSR turun 4,58 poin persentase.
- Jumlah putaran Agent naik 28%, token output naik 40%, dan token input naik 85%.
- Model mencoba menutup kekurangan itu dengan gambar ASCII, Unicode Braille, OpenCV, dan sejenisnya, tetapi pada foto asli dan citra medis tetap mudah gagal.
Data ini menunjukkan bahwa pemahaman visual dalam pekerjaan profesional sulit digantikan oleh ekstraksi teks. Hubungan spasial pada gambar arsitektur, posisi lesi pada citra medis, dan pengodean visual pada grafik umumnya hilang setelah melewati OCR. Model terpaksa menulis kode berulang kali untuk menebak isi gambar. Akibatnya kualitas turun dan biaya naik.
Hasil per industri di papan peringkat MKA juga sejalan dengan temuan ini. Carbon unggul di bidang kesehatan medis, dan tampil menonjol pada hasil kerja berbentuk gambar bersama Argon. Fable 5.2 unggul di bidang perangkat lunak dan data, teknik, logistik dan peta, bisnis, serta keuangan, dan juga unggul pada jenis hasil kerja seperti PDF, Word, dan Spreadsheet. Tidak ada model yang memimpin di semua 10 industri. Word dan file teks biasa tetap menjadi jenis hasil kerja yang paling sulit, dan tidak ada model yang melampaui 52% pada kedua jenis tersebut.
Enam: Rekomendasi Skenario — Tugas yang Cocok untuk Gemini 4 Carbon, Claude Fable 5.2, dan GPT-6 Astra
Kapan memilih Claude Fable 5.2
- Pekerjaan profesional kompleks dengan tuntutan kualitas hasil tertinggi: misalnya laporan analisis keuangan, rancangan teknik, dan proyek perangkat lunak maupun data. Kesalahan pada tugas seperti ini mahal, jadi waktu eksekusi yang lebih lama dan tagihan yang lebih tinggi masih bisa diterima.
- Hasil kerja yang didominasi dokumen Office: keluaran berupa PDF, Word, dan spreadsheet adalah keunggulan Fable di MKA.
Kapan memilih Gemini 4 Carbon
- Pekerjaan Agent kompleks yang perlu menyeimbangkan kualitas dan biaya: di MKA, Carbon mencapai level yang secara statistik mendekati Fable dengan biaya sekitar seperenam.
- Tugas yang bergantung pada pemahaman visual: misalnya penguraian gambar teknik, analisis bantu citra medis, dan hasil kerja berbasis gambar. Untuk tingkat penalaran, sebaiknya mulai dari MEDIUM, karena pada uji keandalan fakta AA tingkat ini lebih jarang mengarang jawaban.
Kapan memilih GPT-6 Astra
- Pipeline yang mengutamakan kecepatan eksekusi: di MKA, Astra punya waktu tempuh paling singkat dan jumlah putaran Agent paling sedikit, sehingga cocok untuk tugas yang butuh umpan balik cepat.
- Skenario yang sensitif terhadap anggaran Token atau tekanan jendela konteks: total konsumsi Token Astra paling rendah, tetapi Anda harus menerima selisih kualitas pada hasil kerja profesional.
| Jenis tugas | Model utama | Model cadangan | Dasar pertimbangan utama | Cara akses |
|---|---|---|---|---|
| Laporan profesional bernilai tinggi | Claude Fable 5.2 | Gemini 4 Carbon | Skor tertinggi di AA dan MKA | API resmi, APIYI |
| Tugas Agent kompleks dalam jumlah besar | Gemini 4 Carbon | Claude Fable 5.2 | Kualitas mendekati, biaya sekitar seperenam | API resmi, APIYI |
| Analisis gambar teknik dan citra | Gemini 4 Carbon | Claude Fable 5.2 | Bukti ablasi visual, unggul di bidang medis | API resmi, APIYI |
| Pipeline eksekusi cepat | GPT-6 Astra | Gemini 4 Carbon | Waktu tempuh dan konsumsi Token paling rendah | API resmi, APIYI |
七、Cara Menguji Tiga Model Utama dengan Antarmuka Terpadu
Papan peringkat publik hanya cocok sebagai titik awal. Pada akhirnya, yang menentukan adalah performa model di tugas Anda sendiri. Contoh di bawah memakai antarmuka yang kompatibel dengan OpenAI. Anda cukup mengganti parameter model untuk memanggil model yang berbeda dengan kode yang sama:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

resp = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "用三点概括这份季度财报摘要的主要风险。"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Catat penggunaan Token, nanti dipakai untuk memperkirakan biaya
Lihat kode lengkap pengujian perbandingan tiga model
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Nama model mengikuti daftar model di platform; GPT-6 Astra di sini hanyalah nama contoh
MODELS = ["claude-fable-5-2", "gemini-4-carbon", "gpt-6-astra"]

# Harga satuan (USD per juta Token), isi sesuai saluran yang Anda pakai
# Contoh: Fable 5.2 memakai harga resmi; Carbon memakai harga peluncuran sebelum 30 November
PRICES = {
    "claude-fable-5-2": {"input": 8.0, "output": 40.0},
    "gemini-4-carbon": {"input": 2.0, "output": 10.0},
    "gpt-6-astra": None,  # Silakan lengkapi sendiri
}

def build_messages(task, image_url=None):
    content = [{"type": "text", "text": task}]
    if image_url:
        content.append({"type": "image_url", "image_url": {"url": image_url}})
    return [{"role": "user", "content": content}]

def run_once(model, messages):
    start = time.time()
    resp = client.chat.completions.create(model=model, messages=messages)
    elapsed = time.time() - start
    usage = resp.usage
    cost = None
    price = PRICES.get(model)
    if price and usage:
        # Perkiraan kasar: pembacaan cache tidak dibedakan; Token berpikir umumnya dihitung sebagai output
        cost = (usage.prompt_tokens * price["input"]
                + usage.completion_tokens * price["output"]) / 1_000_000
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "est_cost_usd": round(cost, 4) if cost is not None else None,
        "answer": resp.choices[0].message.content[:200],
    }

if __name__ == "__main__":
    task = "根据这张户型图,列出各房间面积估算和三条改造建议。"
    msgs = build_messages(task, image_url="https://example.com/floor-plan.png")
    for m in MODELS:
        try:
            print(run_once(m, msgs))
        except Exception as e:
            print(m, "调用失败:", e)
Kode di atas hanya menghitung satu kali pemanggilan. Pada tugas Agent yang sebenarnya, biaya harus dijumlahkan dari semua putaran, dan itulah yang dimaksud dengan biaya tugas dalam artikel ini. Perlu diingat juga bahwa Carbon tidak mendukung thinking_budget. Jika parameter itu dikirim, Anda akan mendapat HTTP 400. Parameter sampling seperti temperature juga akan diabaikan, jadi tingkat penalaran sebaiknya diatur dengan cara yang dijelaskan di dokumentasi platform.
🚀 Saran untuk memulai dengan cepat: Sebaiknya klaim kuota uji coba gratis untuk pengguna baru di APIYI (apiyi.com), lalu jalankan skrip perbandingan di atas dengan 5–10 sampel bisnis nyata. Catat waktu respons, jumlah Token, dan skor kualitasnya, baru tentukan model utama Anda. Platform ini memakai satu kunci API untuk mengakses model-model utama seperti OpenAI, Claude, dan Gemini dengan tagihan sesuai pemakaian, sehingga berpindah model cukup dengan mengubah satu parameter.
Saran Keputusan: Cara Memilih di Antara Tiga Model
Saat memilih model, tentukan dulu batasan terpenting dalam tugasmu, lalu pilih metrik yang sesuai:
- Kualitas adalah syarat mutlak: Jadikan Climb-WSR dari MKA sebagai acuan utama, lalu pilih salah satu antara Fable 5.2 dan Carbon. Karena selisih keduanya tidak signifikan, sebaiknya validasi dengan sampel milikmu sendiri.
- Anggaran adalah syarat mutlak: Lihat biaya per tugas di Tabel 4 MKA, bukan harga per Token. Di sisi ini Carbon unggul dengan jelas.
- Waktu adalah syarat mutlak: Lihat waktu eksekusi dan jumlah putaran Agent. Astra paling cepat, tetapi kamu juga harus menerima kesimpulan bahwa kualitas hasil kerja profesionalnya tertinggal cukup jauh.
💡 Saran pemilihan: Kamu bisa meniru pendekatan Google /swarm, yaitu menempatkan model yang kuat pada tahap perencanaan dan peninjauan, lalu menempatkan model yang cepat pada tahap eksekusi massal. Lewat antarmuka terpadu APIYI (apiyi.com), kamu bisa menetapkan model yang berbeda untuk tiap peran Agent dalam satu proyek, tanpa perlu mengelola banyak SDK.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa posisi Gemini 4 Carbon, Claude Fable 5.2, dan GPT-6 Astra masing-masing?
Ketiganya adalah model penalaran kelas atas yang rilis pada paruh kedua 2026. Fable 5.2 unggul dalam kualitas hasil secara keseluruhan dan pengerjaan profesional. Carbon cukup seimbang antara kualitas, kemampuan multimodal, dan biaya per tugas. Keunggulan Astra ada pada kecepatan eksekusi dan efisiensi Token.
Q2: Di MKA, Fable 5.2 unggul 2,22 poin persentase dari Carbon. Apakah itu berarti Fable lebih kuat?
Belum tentu. Interval kepercayaan 95% untuk selisih ini adalah -0,94 sampai +5,49, jadi melewati angka 0 dan tidak signifikan secara statistik. Kesimpulan yang lebih tepat: keduanya berada di level yang setara, dan sama-sama unggul jelas atas Astra.
Q3: Bolehkah skor 65 di Indeks AA dibandingkan dengan 56,56% di MKA?
Tidak boleh. Indeks AA adalah skor gabungan dari 9 evaluasi, dengan tingkat penalaran yang berbeda-beda untuk tiap model. MKA adalah tingkat pemenuhan berbobot untuk pengerjaan profesional di bawah Harness yang seragam. Objek evaluasi dan cara penilaiannya berbeda, jadi keduanya tidak bisa saling dikonversi.
Q4: Harga Token Carbon hanya seperempat Fable. Apakah biaya per tugasnya juga hanya seperempat?
Belum tentu. Pada masa peluncuran, harga satuan Carbon memang 25% dari Fable 5.2, lalu naik menjadi 50% mulai 1 Desember. Namun tagihan sebenarnya bergantung pada konsumsi Token, Token berpikir, cache hit, dan pemanggilan alat. Di Tabel 4 MKA, selisih biaya per tugas antara keduanya sekitar enam kali lipat, karena konsumsi Token Carbon juga jauh lebih sedikit.
Q5: Bagaimana cara memverifikasi ketiga model ini sendiri dengan biaya rendah?
Gunakan antarmuka agregator yang mendukung banyak model:
1. Daftar di APIYI (apiyi.com), lalu dapatkan kunci API dan kuota uji coba gratis;
2. Atur base_url pada kode di artikel ini ke `https://api.apiyi.com/v1`;
3. Jalankan perbandingan dengan file dan tugas nyata dari pekerjaan Anda, lalu catat kualitas, waktu, dan penggunaan Token.
Q6: GPT-6 Astra paling hemat Token, tapi kenapa biaya per tugasnya bukan yang terendah?
Token yang sedikit tidak otomatis berarti tagihan yang rendah. Struktur harga input, output, dan cache berbeda di tiap model, dan biaya akhir adalah jumlah dari konsumsi dikalikan harga masing-masing. Di Tabel 4 MKA, Token Astra sekitar sepertiga dari Carbon, tetapi biayanya justru sedikit lebih tinggi.
Q7: Apa saja keterbatasan dari kesimpulan evaluasi ini?
Setiap tugas di MKA hanya dijalankan satu kali. Judge-nya adalah GPT-6 Luna Medium, dengan tingkat kesesuaian 96% terhadap penilaian pakar. Peringkat AA adalah snapshot yang terus berubah, dan setelah harga Carbon disesuaikan pada 1 Desember, biaya menurut harga standar pun ikut berubah. Kalau Anda ingin memantau biaya dalam jangka panjang, lihat rincian penggunaan di APIYI (apiyi.com) yang bisa dikelompokkan per model, lalu jadikan itu data biaya Anda sendiri.
Poin Utama Perbandingan Tiga Model (Key Takeaways)
- Kemampuan menyeluruh: Di AA v5.0.1, Fable 5.2 Max meraih skor 65, unggul dari Carbon High (60) dan Astra Max (57).
- Hasil kerja profesional: Di MKA, selisih antara Fable dan Carbon tidak signifikan. Keduanya sama-sama unggul jauh dari Astra.
- Biaya per tugas: Menurut acuan Tabel 4 dalam makalah, Carbon menghabiskan $5,63 per tugas, sekitar seperenam biaya Fable.
- Kecepatan dan efisiensi: Astra mengerjakan satu tugas dalam 18,5 menit dengan 2,43M Token, sehingga paling cepat dan paling hemat Token.
- Nilai multimodal: Setelah alat untuk melihat gambar dihilangkan, kualitas Carbon menurun dan Token input naik 85%.
- Batasan acuan: Harga per Token, konsumsi Token, dan tagihan per tugas adalah tiga hal yang berbeda.
- Cara memulai: Lewat APIYI (apiyi.com), Anda bisa menguji ketiga model dengan sampel kecil memakai satu kunci API.
Kesimpulan: Tidak Ada Satu Metrik yang Menentukan Model Terbaik
Kembali ke pertanyaan di awal: perbedaan di antara tiga model papan atas ini terletak pada pertukaran antara kualitas, kecepatan, dan biaya.
- Claude Fable 5.2: Unggul dalam indeks menyeluruh maupun skor hasil kerja profesional, tetapi harganya adalah waktu eksekusi terlama dan biaya per tugas tertinggi.
- Gemini 4 Carbon: Kualitas hasil kerja profesionalnya secara statistik setara dengan Fable, biaya per tugasnya paling rendah, dan pemahaman visual menjadi keunggulan pembedanya.
- GPT-6 Astra: Eksekusi tercepat dan paling hemat Token, tetapi kualitas hasil kerja profesionalnya tertinggal jauh dari dua model lainnya.
Kemampuan menyeluruh, kualitas tugas, kecepatan respons, dan biaya per tugas perlu dinilai satu per satu. Daripada hanya melihat peringkat di papan skor, cara yang lebih bisa diandalkan adalah menjalankan uji perbandingan dengan tugas Anda sendiri. Kami menyarankan APIYI (apiyi.com) untuk memverifikasi dengan cepat performa ketiga model pada kebutuhan bisnis Anda. Platform ini menyediakan kuota uji coba gratis dan antarmuka multimodel yang terpadu.
📚 Referensi
- Makalah Teknis MKA: MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks
- Tautan:
storage.googleapis.com/deepmind-media/papers/mka_tech_paper.pdf -
Keterangan: Data mentah WSR tiga model, interval kepercayaan, biaya pada Tabel 4, dan eksperimen ablasi visual
-
Papan Peringkat Model Artificial Analysis: Intelligence Index v5.0.1
- Tautan:
artificialanalysis.ai/leaderboards/models -
Keterangan: Snapshot dinamis skor keseluruhan, biaya per tugas, dan durasi pengerjaan
-
Papan Peringkat Evaluasi MKA: Peringkat Agen Pengetahuan Multimodal
- Tautan:
artificialanalysis.ai/zh/evaluations/mka -
Keterangan: Hasil per kategori untuk model terdepan di industri dan jenis berkas yang dihasilkan
-
Model Card Gemini 4 Carbon: Materi resmi Google DeepMind
- Tautan:
deepmind.google/models/model-cards/gemini-4-carbon -
Keterangan: Modalitas, konteks, tingkat penalaran, dan keterbatasan yang diketahui
-
Halaman Harga Gemini API: Harga standar, harga cache, dan harga Batch untuk Carbon
- Tautan:
ai.google.dev/gemini-api/docs/pricing -
Keterangan: Harga peluncuran dan penyesuaian harga mulai 1 Desember
-
Dokumentasi API Claude Fable 5.2: Penjelasan model resmi dari Anthropic
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview - Keterangan: Konteks, output maksimum, harga per Token, dan Fast Mode
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat beranda situs APIYI. Materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com