作者注:本記事では AA 総合指数と MKA 専門タスク評価という2つの体系を使い、Gemini 4 Carbon、Claude Fable 5.2、GPT-6 Astra の性能・所要時間・コストを比較します。あわせて、評価時の設定と統計的な結論がどこまで当てはまるのかも説明します。
読む前に押さえておきたい用語7選
- MKA(Multimodal Knowledge Agent):マルチモーダルな専門業務タスクを評価するベンチマークです。図面、スキャン資料、画像といった複雑なファイルを読み解き、完成度の高い専門的な成果物を出せるかを見ます。
- Climb WSR:識別力の高い採点項目だけを対象に算出した加重達成率です。トップクラスのモデル同士の差を浮き彫りにするために使います。
- Regression WSR:基本要件を満たしているかを測る加重指標で、専門的な納品物の合格ラインに相当します。
- 推論レベル:モデルが使える推論強度の設定です。たとえば Carbon の LOW、MEDIUM、HIGH や、ランキング上の Fable、Astra における Max、Xhigh などの構成があります。
- タスクコスト:指定したタスクを完了するまでにかかった、すべてのモデル呼び出し費用の合計です。1回の API リクエストあたりの固定価格ではありません。
- キャッシュ読み取り:キャッシュ済みの入力内容を再利用し、より低い単価で課金される仕組みです。
- 統計的有意性:2つのモデルのスコア差に、十分な統計的根拠があるかを判断する指標です。差が有意水準に達していない場合、確かな勝敗とは言えません。
トップクラスのモデル同士の競争は、1枚の総合ランキングだけではもう語りきれません。本記事では、総合力、専門業務の成果物、タスクコストという3つの観点から Gemini 4 Carbon、Claude Fable 5.2、GPT-6 Astra を比較し、タスクの種類ごとにおすすめの選び方を紹介します。
これは、すべてのスコアを混ぜて順位付けするようなランキング解説ではありません。 総合指数と MKA は別々の評価体系なので、本記事でも分けて読み解きます。統計的な裏付けがある差と、根拠が足りない差も区別してお伝えします。
この記事で得られること:品質・速度・コストへの要求に応じて、どのモデルを優先して選ぶべきかを判断できるようになります。
一、Gemini 4 Carbon、Claude Fable 5.2、GPT-6 Astra が同じ土俵に
今回の競争は、発表のタイミングが非常に近いのが特徴です。Google は 2026 年 10 月 28 日に Gemini 4 Carbon を初めて公開し、Anthropic は 11 月 9 日に Claude Fable 5.2 をリリースしました。Carbon は 11 月 10 日に、開発者・企業・一般ユーザー向けに正式提供が始まっています。同じ日に、Google DeepMind と Artificial Analysis は MKA 評価を公開しました。さらに 11 月 11 日には Artificial Analysis Intelligence Index v5.0.1 が更新され、Fable 5.2 が加わりました。
3 つのモデルは、公開されている位置づけがはっきり異なります。Carbon は Gemini 4 Argon をベースに構築されており、長期間にわたるエージェントタスク、複雑なソフトウェアエンジニアリング、科学研究に力を入れています。入力はテキスト、画像、音声、動画に対応しています。Fable 5.2 は Adaptive Thinking を採用し、コンテキストウィンドウは 1M トークン、最大出力は 128K トークンです。GPT-6 Astra は、本記事で引用する 2 つの評価の両方で成績が出ており、効率面の比較対象としてよく使われます。
| 比較項目 | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra | 現時点での判断 |
|---|---|---|---|---|
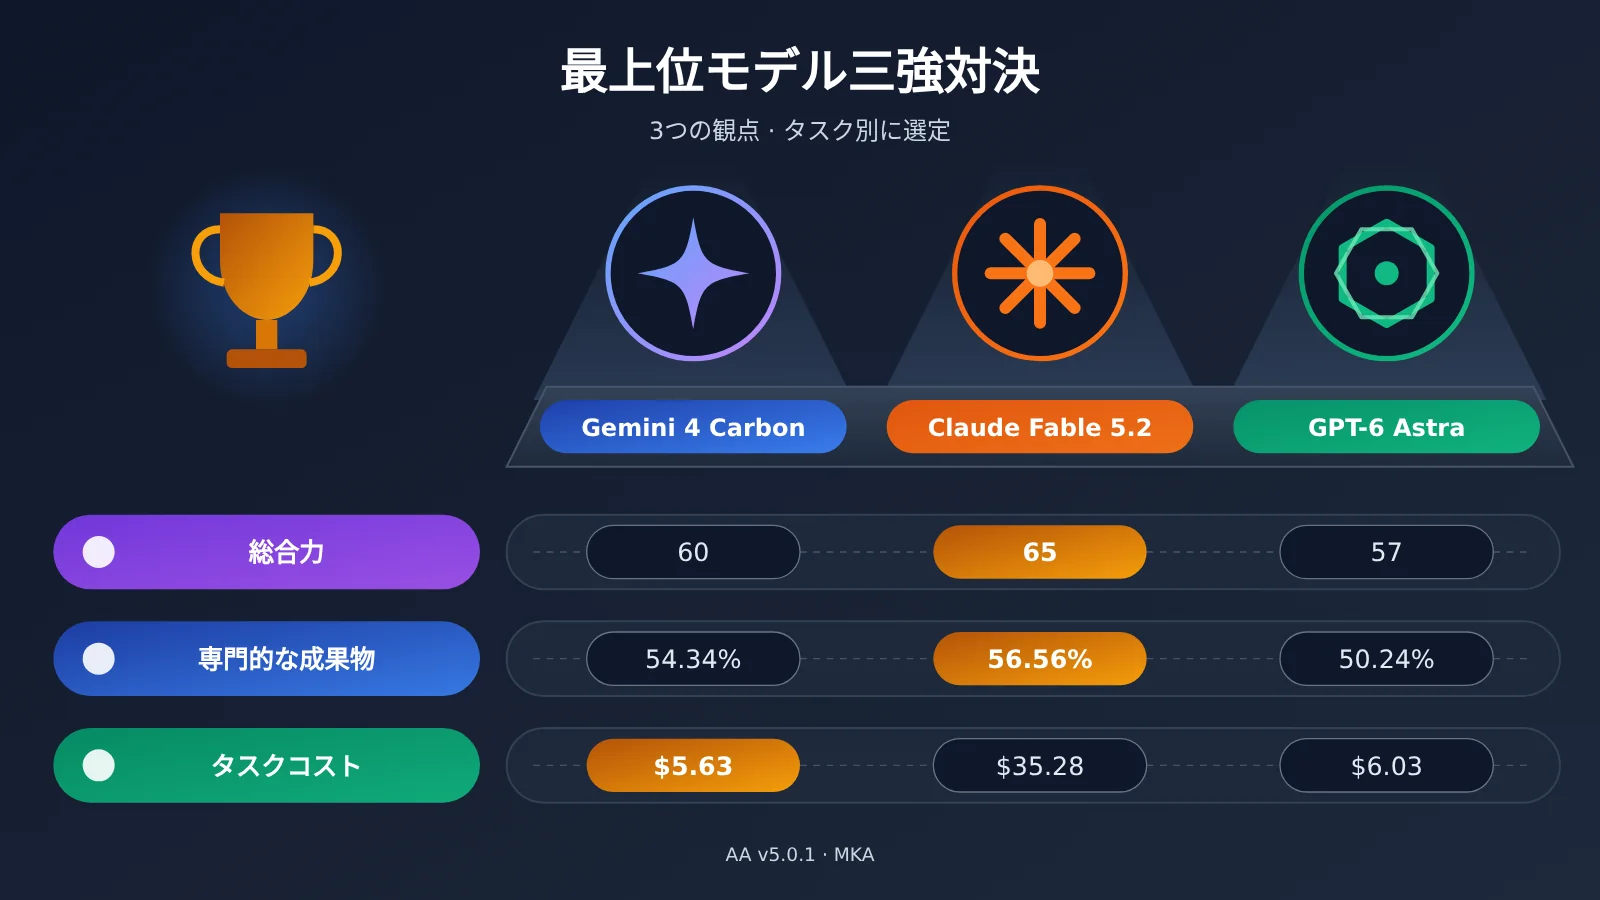
| 総合力(AA v5.0.1) | 65(Max) | 60(High) | 57(Max) | Fable がリード |
| 専門業務の成果(MKA Climb-WSR) | 56.56% | 54.34% | 50.24% | Fable と Carbon が接近、いずれも Astra をリード |
| 1 タスクあたりのコスト(MKA 表 4) | $35.28 | $5.63 | $6.03 | Carbon が最安 |
| 実行時間(MKA 表 4) | 83.2 分 | 29.2 分 | 18.5 分 | Astra が最速 |
| トークン消費量(MKA 表 4) | 40.48M | 7.05M | 2.43M | Astra が最少 |
表の「現時点での判断」は、それぞれの指標だけを見たものです。すべての項目で 1 位になっているモデルはありません。
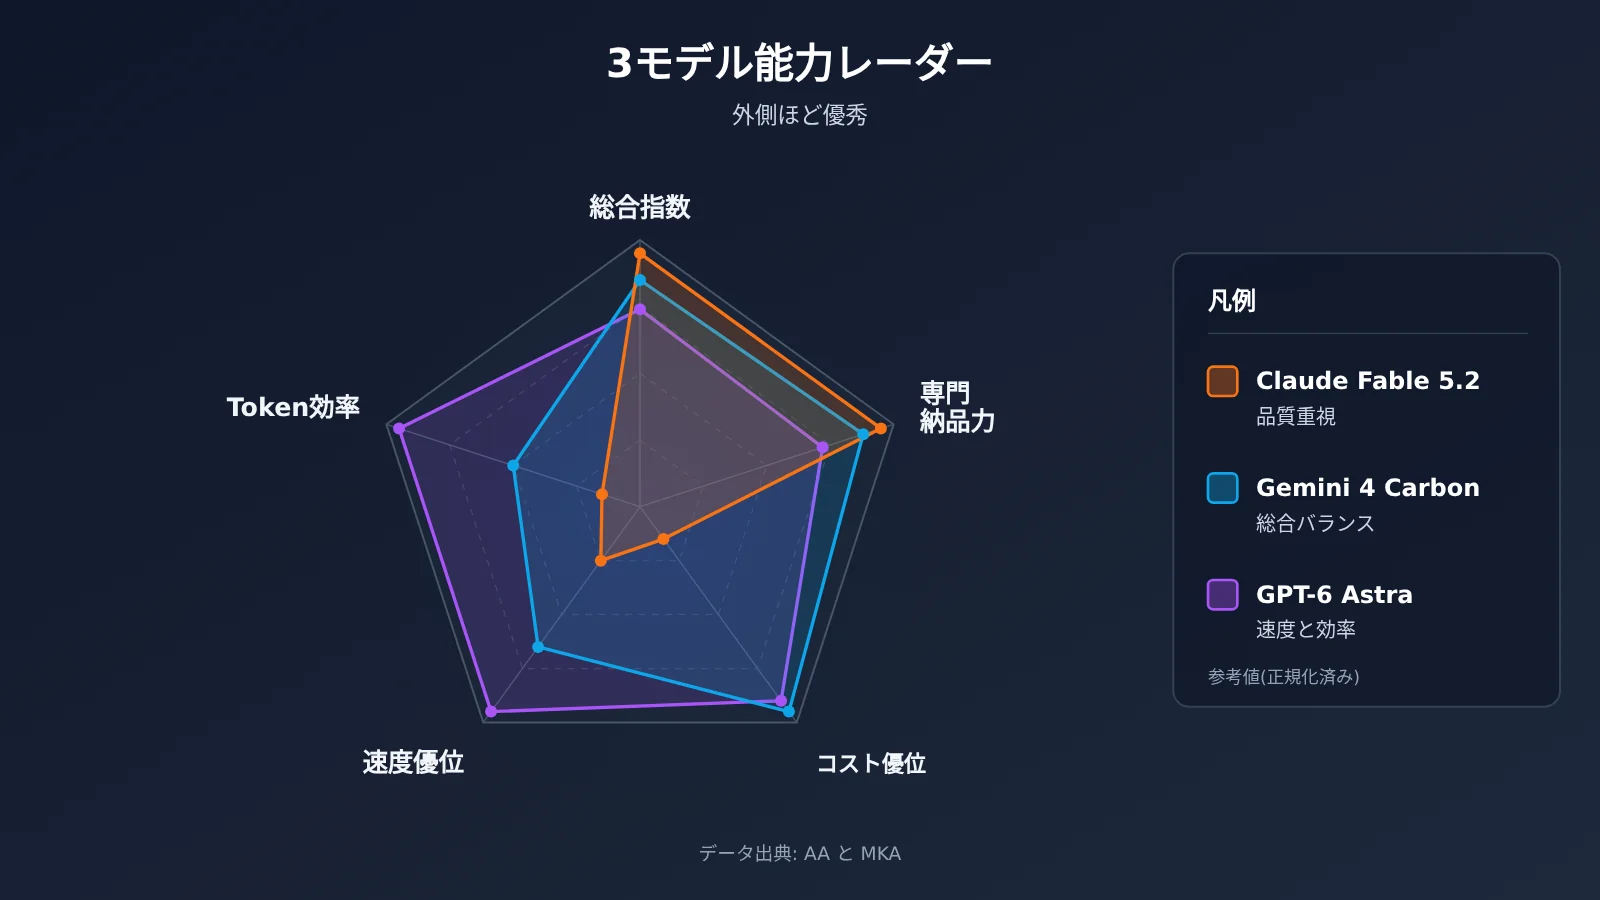
📊 データについて:上の表のデータは、AA のランキングのスナップショットと MKA の技術論文からそれぞれ引用したものです。2 つの評価は基準が異なるため、互いに換算できません。自社の業務シーンで検証したい場合は、APIYI(apiyi.com)を使い、同じプロンプトで小規模な比較テストを行うと、実際の負荷のもとでの 3 モデルの違いを確認できます。
二、AA 総合ランキング:Claude Fable 5.2 が暫定首位、Gemini 4 Carbon が僅差で追う
Artificial Analysis Intelligence Index v5.0.1 は、9 つの評価で構成されています。AA-Briefcase v1.1、AutomationBench-AA、Terminal-Bench 4.0、FrontierCode 2.0、AA-Omniscience v1.1、GDP.pdf、HLE-Diamond、CritPt v2、Terminal-Bench-Science 0.1 です。対象範囲は、ナレッジワーク、自動化、コード、科学的推論、事実の信頼性まで幅広くカバーしています。この指数が答えようとしているのは「モデルの総合力はどのくらいか」という問いです。
| モデル構成 | AA Index v5.0.1 | 評価タスクあたりのコスト | タスクあたりの所要時間 |
|---|---|---|---|
| Claude Fable 5.2 Max | 65 | $26.54 | 44.4 分 |
| Gemini 4 Carbon High | 60 | $7.76 | 24.9 分 |
| GPT-6 Astra Max | 57 | $6.24 | 23.0 分 |
この表を見るときは、構成の違いに注意が必要です。3 つのモデルはそれぞれ Max、High、Max というティアで測定されており、推論予算が同じではありません。そのため、同じ条件での純粋な能力比較として読むことはできません。同じモデルでもティアを変えるとスコアは変わります。Fable 5.2 は Xhigh と High がどちらも 62 点、Carbon は Medium が 58 点、Low が 54 点です。
Carbon のティア別データは、単独で見る価値があります。AA の試算では、Medium のタスクあたりコストは $6.59 で、Low の $7.19 よりかえって低くなっています。また High はスコアこそ最高ですが、最初の回答トークンが出るまでのレイテンシは 67.54 秒に達します。推論ティアを上げても、それに比例した効果が得られるとは限らないということです。表中の $7.76 は、Carbon の標準価格 $4/$20 をもとに算出した AA タスクの平均コストであり、通常の 1 回のリクエストの価格ではありません。
三、MKA プロフェッショナル納品:3つのモデルが実際に仕事をやり切る力
AA指数が測るのは総合的な実力です。一方のMKAが測るのは、モデルが実際の専門業務をこなせるかどうかです。MKAの技術論文では、次のように設定されています。
- 非公開の実務タスクを200件用意し、10業種・83職種をカバーしています。1件あたり、専門職の人が約3〜8時間かけて取り組む作業量に相当します。
- 各タスクには、重み付きの評価基準が約70項目あります。タスクの88%では、Word、Excel、PPT、PDF、HTML、画像といった独立したファイルの生成が求められます。
- すべてのモデルを同一のStirrup Agent Harnessで実行します。ツール環境は共通で、ターン数の上限は一律250ターン、各タスクの実行は1回です。
| モデル | Climb-WSR | Overall WSR | Regression-WSR |
|---|---|---|---|
| Claude Fable 5.2 | 56.56% | 73.26% | 95.71% |
| Gemini 4 Carbon | 54.34% | 71.89% | 96.36% |
| GPT-6 Astra | 50.24% | 69.34% | 95.17% |
3つの指標は、それぞれ意味が異なります。Regression-WSRは基本要件をどれだけ満たしているかを示す指標で、3モデルとも95%を超えており、Carbonがわずかに上回っています。Climb-WSRは難易度の高い項目だけを集計したもので、トップクラスのモデルを見分ける際の主な手がかりになります。Overall WSRは、全項目の重み付き達成率です。いずれの数値も通常の質問応答の正答率ではないため、AA指数の65・60・57と並べて比べることはできません。
Claude Fable 5.2とGemini 4 Carbonの統計的有意性
MKAを読み解くうえで、最も注意したいのが統計的有意性です。論文のデータは次のとおりです。
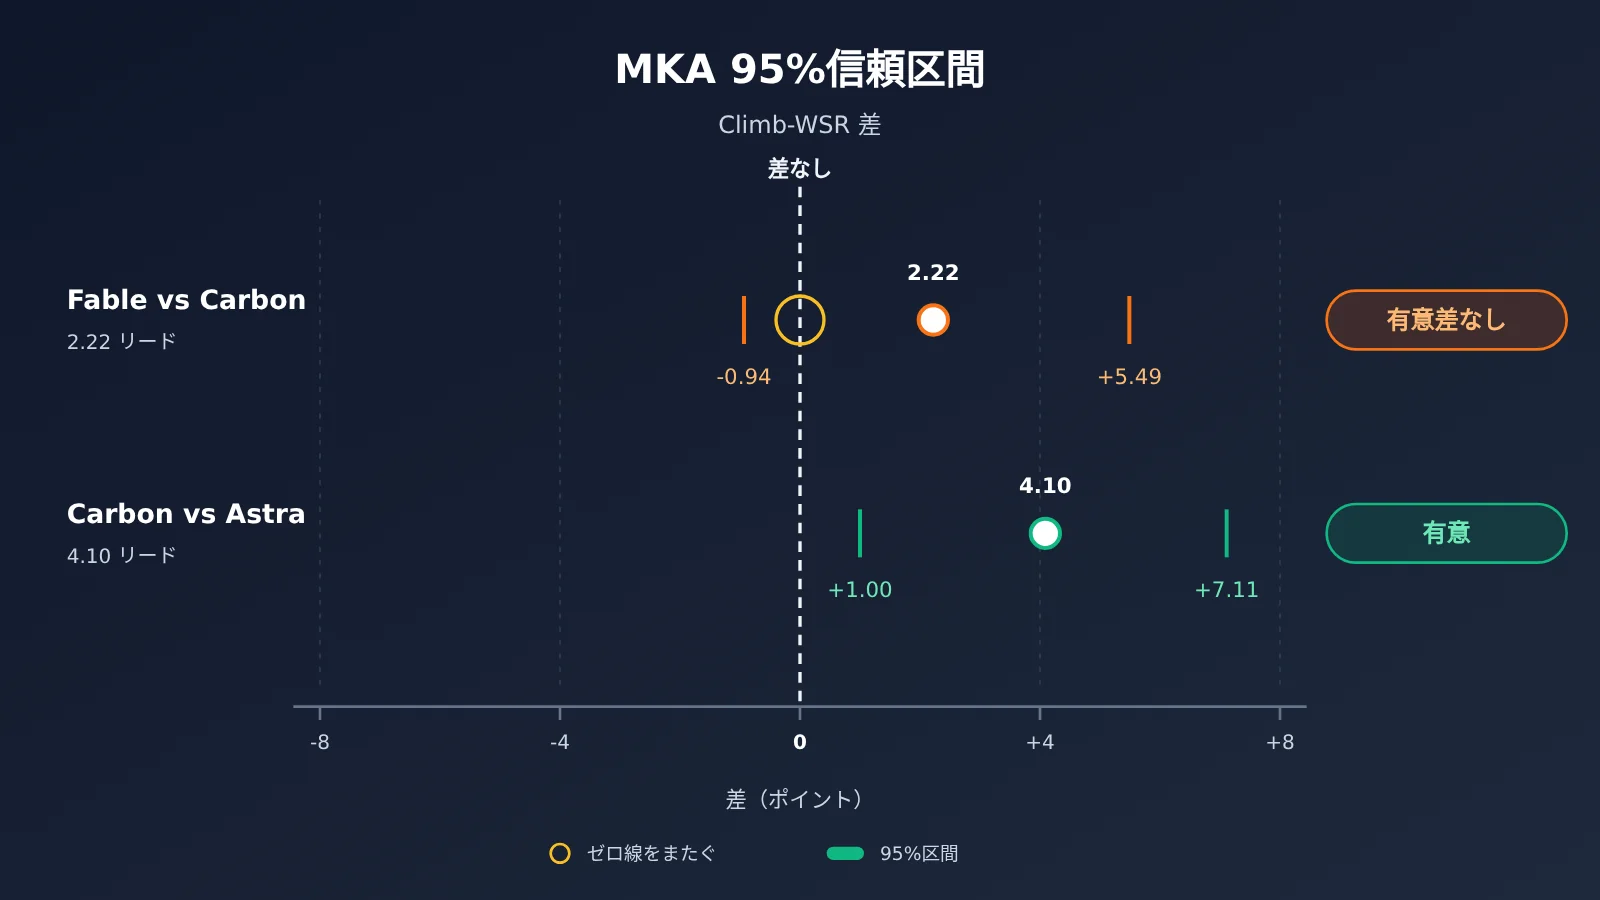
- Fable 対 Carbon:Fableが2.22ポイントリードしており、95%信頼区間は-0.94〜+5.49です。区間が0をまたいでいるため、差は統計的に有意とは言えません。
- Carbon 対 Astra:Carbonが4.10ポイントリードしており、95%信頼区間は+1.00〜+7.11です。区間がすべて0より上にあるので、差は統計的に有意です。
したがって、正確には次のように言えます。MKAではFable 5.2とCarbonは同程度の水準にあり、現時点の証拠だけでは、FableがCarbonを明確に上回っているとは断定できません。論文が示している結論は、この2つのモデルがどちらもAstraを有意に上回っている、という点です。
四、タスクコスト比較:3大モデルが同じタスクを完了するための実際のコスト
MKA 論文の表 4 には、タスクごとの平均リソース消費量が掲載されています。API コストは各ベンダーの定価をもとに、プロンプトキャッシュの課金も考慮して見積もられています。
| タスクあたりの平均指標 | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|---|
| 総トークン数 | 40.48M | 7.05M | 2.43M |
| 出力トークン数 | 378.9K | 129.5K | 42.0K |
| エージェントのターン数 | 128.8 | 46.6 | 29.0 |
| 実行時間 | 83.2 分 | 29.2 分 | 18.5 分 |
| タスクあたりのコスト | $35.28 | $5.63 | $6.03 |
この表から、次の3点が読み取れます。
- Fable は投入するリソースが最も多い:総トークン数は Carbon の 5.74 倍、実行時間は Carbon の約 2.85 倍です。高品質な成果は、何度も探索を重ね、大量にモデルを呼び出すことで成り立っています。
- Carbon のコストパフォーマンスが最も際立っている:タスクあたりのコストは Fable の約 6 分の 1 で、Climb-WSR の差はわずか 2.22 ポイントです。しかも、この差は有意ではありません。
- Astra は最速で、トークン消費も最少:実行時間もトークン消費量も最も少ないものの、タスクあたりのコストは Carbon よりやや高く、Climb-WSR も Carbon に大きく及びません。
トークン単価・トークン消費量・タスク請求額の違い
この3つの概念は、よく混同されます。まずトークン単価ですが、Fable 5.2 は入力が 100 万トークンあたり $8、出力が $40 です。Carbon は 11 月 30 日までのローンチ価格が $2/$10 で、12 月 1 日からは $4/$20 になります。ただし、単価が低いからといって、請求額も低くなるとは限りません。Astra のトークン消費量は Carbon の約 3 分の 1 しかないのに、タスクあたりのコストはやや高くなっています。このことから、モデルごとの単価体系やキャッシュヒット率の違いが、最終的な費用に影響することがわかります。
キャッシュ読み取りは、エージェント用途で見落とされがちな変数です。エージェントは毎ターン大量のコンテキストを繰り返し送信します。Carbon を例にとると、キャッシュ入力の価格は通常の入力価格の約 5% です。Fable の総トークン数は 40.48M にも達し、その大部分は繰り返し読み込まれるコンテキストです。そのため、課金方式が請求額に直接影響します。また、Carbon では思考トークンが出力料金に含まれ、Grounding を使う場合は検索リクエストにも別途料金がかかります。
コストデータには3種類の集計基準があるため、引用するときは区別する必要があります。MKA 論文の表 4(Carbon $5.63、Fable $35.28)、MKA のライブリーダーボード(Carbon $6.29、Fable $31.97)、そして AA インデックスのタスクコスト($7.76、$26.54)です。3つは集計範囲が異なるため、混ぜて使うことはできません。
五、Gemini 4 Carbon のマルチモーダルの強みはどこにあるのか
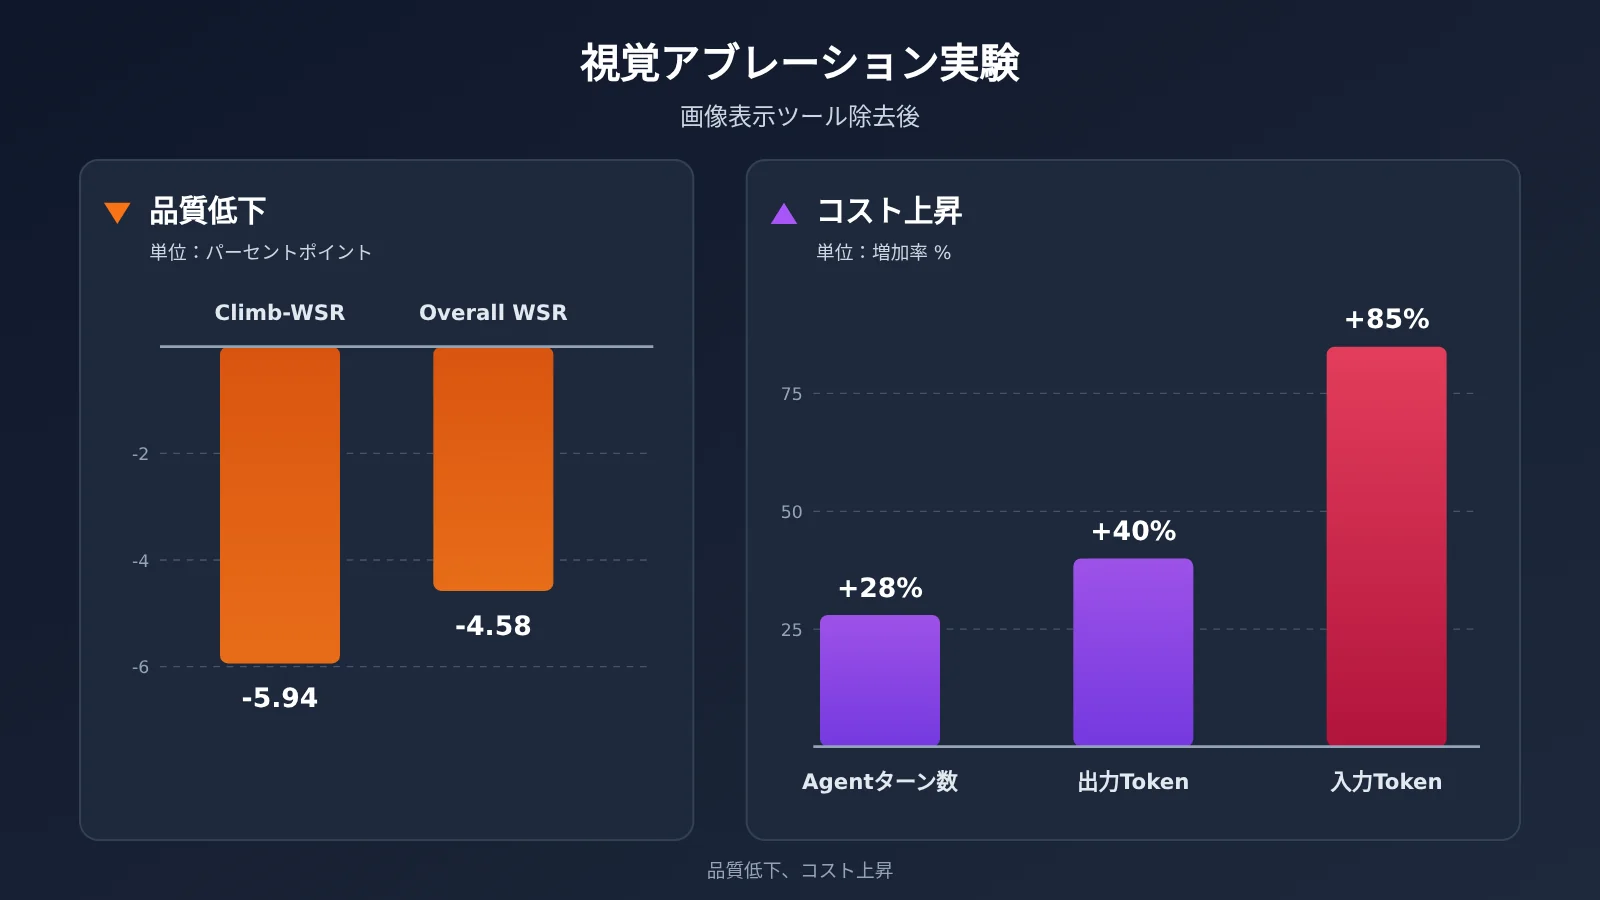
MKA の論文では、ある アブレーション実験が行われました。Carbon から画像閲覧ツール view_image を取り除き、OCR、コード実行、従来のコンピュータビジョン手法だけでタスクをこなさせたものです。結果は次のとおりです。
- Climb-WSR は 5.94 ポイント、Overall WSR は 4.58 ポイント低下しました。
- Agent のターン数は 28% 増え、出力トークンは 40%、入力トークンは 85% 増加しました。
- モデルは ASCII 画像、Unicode の点字(Braille)、OpenCV などで補おうとしましたが、実際の写真や医療画像ではやはり失敗しやすい結果でした。
このデータから、専門的な仕事における視覚理解は、テキスト抽出では代替しにくいことがわかります。建築図面の空間的な関係、画像内の病変の位置、グラフの視覚的なエンコーディングといった情報は、OCR を通すとほとんど失われてしまいます。モデルはコードを何度も書いて画像の中身を推測するしかなく、品質は下がり、コストは上がります。
MKA ランキングの業界別結果も、この傾向と一致しています。Carbon は医療・ヘルスケア分野でトップに立ち、画像系の成果物では Argon とともに目立った成績を残しました。Fable 5.2 は、ソフトウェア・データ、エンジニアリング、物流・地図、ビジネス、金融などの分野でトップとなり、PDF、Word、Spreadsheet といった成果物の種類でも優位に立っています。10 業界すべてでトップになったモデルは存在せず、Word とプレーンテキストファイルは依然として最も難しい成果物タイプで、すべてのモデルがこの 2 種類で 52% を超えられませんでした。
六、おすすめのシーン:Gemini 4 Carbon・Claude Fable 5.2・GPT-6 Astra の向いているタスク
Claude Fable 5.2 を選ぶシーン
- 成果物の品質を最優先したい、複雑で専門的な納品物:金融分析レポート、エンジニアリング案、ソフトウェア・データ系プロジェクトなどです。こうしたタスクはミスのコストが大きいため、実行時間が長くなったり請求額が高くなったりしても許容できる場合に向いています。
- Office ドキュメント中心の納品物:PDF、Word、表計算系の出力は、MKA における Fable の得意分野です。
Gemini 4 Carbon を選ぶシーン
- 品質とコストのバランスが必要な、複雑なエージェント作業:MKA では、Carbon は約6分の1のコストで、Fable と統計的にほぼ同水準の結果を出しました。
- 視覚理解に依存するタスク:図面の解析、医療画像の分析支援、画像系の納品物などです。推論レベルはまず MEDIUM から試すのがおすすめです。AA の事実信頼性テストで、でたらめな回答をする割合がより低かったためです。
GPT-6 Astra を選ぶシーン
- 実行速度を重視するパイプライン:MKA では所要時間が最も短く、エージェントのターン数も最少でした。素早いフィードバックが必要なタスクに向いています。
- トークン予算やコンテキストの負荷に敏感なシーン:Astra は総トークン消費量が最も少ない一方、専門的な納品物の品質では差がある点を受け入れる必要があります。
| タスクの種類 | 第一候補 | 次点 | 主な根拠 | 利用方法 |
|---|---|---|---|---|
| 高付加価値の専門レポート | Claude Fable 5.2 | Gemini 4 Carbon | AA・MKA のスコアが最高 | 公式 API、APIYI |
| 大量の複雑なエージェントタスク | Gemini 4 Carbon | Claude Fable 5.2 | 品質は同等水準で、コストは約6分の1 | 公式 API、APIYI |
| 図面・画像の分析 | Gemini 4 Carbon | Claude Fable 5.2 | 視覚アブレーションの根拠、医療分野でリード | 公式 API、APIYI |
| 高速実行パイプライン | GPT-6 Astra | Gemini 4 Carbon | 所要時間とトークン消費が最少 | 公式 API、APIYI |
七、統一インターフェースで3つのモデルを実測する方法
公開ランキングはあくまで出発点です。最終的には、自分のタスクでモデルがどれだけ使えるかを確かめる必要があります。以下のサンプルでは OpenAI 互換インターフェースを使っています。model パラメータを切り替えるだけで、同じコードのまま別のモデルを呼び出せます。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "用三点概括这份季度财报摘要的主要风险。"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # トークン使用量を記録し、後でコストの見積もりに使う
3モデル比較テストの完全なコードを見る
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# モデル名はプラットフォームのモデル一覧に従ってください。GPT-6 Astra はここでは例としての名称です
MODELS = ["claude-fable-5-2", "gemini-4-carbon", "gpt-6-astra"]

# 単価(USD/100万トークン)は実際のチャネルに合わせて記入してください
# 例:Fable 5.2 は公式の定価、Carbon は 11月30日までの先行発売価格
PRICES = {
    "claude-fable-5-2": {"input": 8.0, "output": 40.0},
    "gemini-4-carbon": {"input": 2.0, "output": 10.0},
    "gpt-6-astra": None,  # 各自で補ってください
}

def build_messages(task, image_url=None):
    content = [{"type": "text", "text": task}]
    if image_url:
        content.append({"type": "image_url", "image_url": {"url": image_url}})
    return [{"role": "user", "content": content}]

def run_once(model, messages):
    start = time.time()
    resp = client.chat.completions.create(model=model, messages=messages)
    elapsed = time.time() - start
    usage = resp.usage
    cost = None
    price = PRICES.get(model)
    if price and usage:
        # 概算:キャッシュ読み取りは区別していない。思考トークンは通常、出力に含まれる
        cost = (usage.prompt_tokens * price["input"]
                + usage.completion_tokens * price["output"]) / 1_000_000
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "est_cost_usd": round(cost, 4) if cost is not None else None,
        "answer": resp.choices[0].message.content[:200],
    }

if __name__ == "__main__":
    task = "根据这张户型图,列出各房间面积估算和三条改造建议。"
    msgs = build_messages(task, image_url="https://example.com/floor-plan.png")
    for m in MODELS:
        try:
            print(run_once(m, msgs))
        except Exception as e:
            print(m, "调用失败:", e)
このコードで集計しているのは、1回の呼び出しあたりの値です。実際のエージェントタスクのコストは、すべてのラウンドを合算して求める必要があります。これが本文で言う「タスクコスト」です。また、Carbon は thinking_budget に対応していません。このパラメータを渡すと HTTP 400 が返ります。temperature などのサンプリングパラメータも無視されます。推論レベルは、プラットフォームのドキュメントに記載された方法で設定してください。
🚀 すぐに始めるためのヒント:まず APIYI(apiyi.com)で新規ユーザー向けの無料テスト枠を受け取り、実際の業務サンプルを 5〜10 件使って上の比較スクリプトを実行しましょう。所要時間、トークン数、品質スコアを記録してから、メインで使うモデルを決めるのがおすすめです。このプラットフォームでは、1つの API キーで OpenAI・Claude・Gemini などの主要モデルを利用でき、従量課金で、モデルの切り替えもパラメータを1つ変えるだけです。
意思決定のヒント:3つのモデルをどう使い分けるか
モデルを選ぶときは、まずタスクにとって最も重要な制約を決め、それに対応する指標を見るのがおすすめです。
- 品質が絶対条件の場合:MKA の Climb-WSR を主な判断材料にして、Fable 5.2 と Carbon の2つから選びます。両者の差は大きくないため、自分のサンプルで検証しておくのが安心です。
- 予算が絶対条件の場合:トークン単価ではなく、MKA 表4の「1タスクあたりのコスト」を見ましょう。この項目では Carbon が明確に優位です。
- 納期・速度が絶対条件の場合:実行時間とエージェントのターン数を見ると、最速は Astra です。ただし、専門的な成果物の品質では大きく劣るという結果も受け入れる必要があります。
💡 選び方のヒント:Google の /swarm のやり方が参考になります。計画とレビューの段階には高性能なモデルを、バッチ実行の段階には高速なモデルを割り当てる方法です。APIYI(apiyi.com)の統一インターフェースを使えば、1つのプロジェクト内でエージェントの役割ごとに異なるモデルを割り当てられ、複数の SDK を管理する必要もありません。
よくある質問 FAQ
Q1:Gemini 4 Carbon、Claude Fable 5.2、GPT-6 Astra は、それぞれどのような位置づけですか?
3つとも2026年下半期のトップクラスの推論モデルです。Fable 5.2 は、総合力とプロフェッショナル向け成果物の品質でリードしています。Carbon は、品質・マルチモーダル対応・タスクあたりのコストのバランスに優れています。Astra の強みは、実行速度とトークン効率です。
Q2:MKA で Fable 5.2 が Carbon を 2.22 ポイント上回っていますが、Fable のほうが強いと言えますか?
言えません。この差の95%信頼区間は -0.94 〜 +5.49 で、0 をまたいでおり、統計的に有意とはいえません。より正確には、両者は同程度の水準にあり、どちらも Astra を有意に上回っている、という言い方になります。
Q3:AA 指数の65点と MKA の56.56%を並べて比較してもよいですか?
できません。AA 指数は9つの評価項目を総合したスコアで、モデルごとに推論レベルの設定も異なります。一方 MKA は、統一した Harness のもとで測る、プロフェッショナル向け成果物の加重充足率です。評価対象も採点方法も異なるため、相互に換算することはできません。
Q4:Carbon のトークン単価は Fable の4分の1ですが、タスクあたりのコストも4分の1になりますか?
そうとは限りません。ローンチ期間中、Carbon の単価は確かに Fable 5.2 の25%ですが、12月1日からは50%になります。さらに、実際の請求額はトークン消費量、思考トークン、キャッシュヒット、ツール呼び出しによって左右されます。MKA の表4では、両者の1タスクあたりのコストに約6倍の差がありますが、これは Carbon の消費量がはるかに少ないためです。
Q5:3つのモデルを低コストで自分で検証するには、どうすればよいですか?
複数のモデルに対応した集約インターフェースの利用がおすすめです。
1. APIYI(apiyi.com)に登録し、APIキーと無料のテスト枠を取得します。
2. 本記事のコードの base_url を `https://api.apiyi.com/v1` に設定します。
3. 業務で実際に使っているファイルやタスクで比較を行い、品質・所要時間・トークン使用量を記録します。
Q6:GPT-6 Astra はトークン消費が最も少ないのに、なぜタスクあたりのコストが最安ではないのですか?
トークンが少ないからといって、請求額が低いとは限りません。モデルごとに入力・出力・キャッシュの単価構成が異なり、最終的な費用は、消費量にそれぞれの単価を掛けた合計になります。MKA の表4では、Astra のトークン消費量は Carbon の約3分の1ですが、コストはわずかに高くなっています。
Q7:これらの評価結果には、どのような限界がありますか?
MKA は各タスクを1回ずつしか実行しておらず、Judge には GPT-6 Luna Medium を使用しています。専門家による評価との一致率は96%です。また、AA のランキングは動的なスナップショットであり、Carbon の価格が12月1日に改定されると、標準価格で計算したコストも変わります。コストを長期的に追跡したい場合は、APIYI(apiyi.com)の利用明細でモデルごとの実際の支出を集計し、自分自身のコストデータとして活用できます。
三大モデル比較の重要ポイント Key Takeaways
- 総合能力:AA v5.0.1 では Fable 5.2 Max が65点で、Carbon High の60点、Astra Max の57点をリードしています。
- プロフェッショナル向けの成果物:MKA では Fable と Carbon の差は有意ではなく、両者とも Astra を大きく上回っています。
- タスクあたりのコスト:論文の表4の基準で見ると、Carbon は1タスクあたり $5.63 で、Fable の約6分の1です。
- 速度と効率:Astra は1タスクあたり18.5分、2.43M トークンで、速度とトークン効率が最も優れています。
- マルチモーダルの価値:画像閲覧ツールを外すと、Carbon は品質が低下し、入力トークンが85%増加しました。
- 集計基準の境界:トークン単価、トークン消費量、タスクあたりの請求額は、それぞれ別の概念です。
- 始め方:APIYI(apiyi.com)なら、1つのキーで3モデルを少量サンプルで比較テストできます。
まとめ:最強のモデルを決める単一の指標はない
冒頭の問いに戻ると、この3つのトップモデルの違いは、品質・速度・コストのどこを優先するかというトレードオフにあります。
- Claude Fable 5.2:総合指数もプロフェッショナル向け成果物のスコアもトップですが、その代わり実行時間が最長で、タスクあたりのコストも最も高くなります。
- Gemini 4 Carbon:プロフェッショナル向け成果物の品質は Fable と統計的に近く、タスクあたりのコストは最も低くなっています。視覚理解が差別化ポイントです。
- GPT-6 Astra:実行が最速でトークンも最も節約できますが、プロフェッショナル向け成果物の品質は前の2つに大きく劣ります。
総合能力、タスク品質、応答速度、タスクあたりのコストは、それぞれ別々に評価する必要があります。リーダーボードの順位だけを見るよりも、自分のタスクで比較テストを行うほうが確実です。APIYI(apiyi.com)を使えば、3モデルが自社の業務でどの程度の成果を出すかをすばやく検証できます。無料のテスト枠と、複数モデルを統一的に扱えるインターフェースも用意されています。
📚 参考資料
- MKA 技術論文:MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks
- リンク:
storage.googleapis.com/deepmind-media/papers/mka_tech_paper.pdf -
説明:3モデルの WSR、信頼区間、表4のコスト、ビジュアルアブレーション実験の元データ
-
Artificial Analysis モデルランキング:Intelligence Index v5.0.1
- リンク:
artificialanalysis.ai/leaderboards/models -
説明:総合スコア、タスクごとのコストと所要時間の最新スナップショット
-
MKA 評価ランキング:マルチモーダル知識 Agent ランキング
- リンク:
artificialanalysis.ai/zh/evaluations/mka -
説明:業界をリードするモデルと、成果物ファイル形式別の結果
-
Gemini 4 Carbon モデルカード:Google DeepMind 公式資料
- リンク:
deepmind.google/models/model-cards/gemini-4-carbon -
説明:対応モダリティ、コンテキスト、推論レベル、既知の制限事項
-
Gemini API 料金ページ:Carbon の標準価格、キャッシュ価格、Batch 価格
- リンク:
ai.google.dev/gemini-api/docs/pricing -
説明:ローンチ時の価格と、12月1日以降の価格改定
-
Claude Fable 5.2 API ドキュメント:Anthropic 公式のモデル説明
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview - 説明:コンテキスト、最大出力、トークン単価、Fast Mode
著者:APIYI 技術チーム
技術交流:APIYI のウェブサイトトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com のドキュメントセンターでご覧いただけます。