작성자 노트: 이 글은 AA 종합 지수와 MKA 전문 과제 평가라는 두 가지 체계로 Gemini 4 Carbon, Claude Fable 5.2, GPT-6 Astra의 성능, 소요 시간, 비용을 비교해요. 평가 설정과 통계적 결론이 어디까지 적용되는지도 함께 설명해요.
읽기 전에 알아둘 점: 세 모델 비교에 나오는 용어 7가지
- MKA(Multimodal Knowledge Agent): 멀티모달 전문 업무 과제를 평가하는 벤치마크예요. 도면, 스캔본, 영상 같은 복잡한 문서를 모델이 읽어내고, 완성도 높은 전문 결과물까지 내놓을 수 있는지 살펴봐요.
- Climb WSR: 변별력이 높은 채점 항목만 대상으로 계산한 가중 충족률이에요. 최상위 모델끼리의 격차를 벌려서 보여 주는 데 쓰여요.
- Regression WSR: 기본 요건을 충족했는지 측정하는 가중 지표예요. 전문 산출물의 합격선에 해당해요.
- 추론 수준: 모델이 사용할 수 있는 추론 강도 설정이에요. Carbon의 LOW, MEDIUM, HIGH와 Fable, Astra가 순위표에서 쓰는 Max, Xhigh 같은 설정이 여기에 속해요.
- 과제 비용: 지정된 과제 하나를 끝내기까지 든 모든 모델 호출 비용의 합계예요. API 요청 한 건의 고정 가격이 아니에요.
- 캐시 읽기: 이미 캐시에 저장된 입력 내용을 재사용하고, 더 낮은 단가로 과금하는 방식이에요.
- 통계적 유의성: 두 모델의 점수 차이에 통계적 근거가 충분한지 판단하는 지표예요. 차이가 유의한 수준에 이르지 못하면 확실한 승패로 볼 수 없어요.
최상위 모델 간 경쟁은 이제 종합 순위표 하나만으로 설명하기 어려워졌어요. 이 글에서는 종합 능력, 전문 산출물, 과제 비용이라는 세 가지 관점에서 Gemini 4 Carbon, Claude Fable 5.2, GPT-6 Astra를 비교하고, 과제 유형별 선택 기준을 제안해요.
모든 점수를 한데 섞어 순위만 매기는 해설이 아니에요. 종합 지수와 MKA는 서로 다른 평가 체계라서 따로 나눠 살펴봐요. 어떤 차이는 통계적 근거가 있고 어떤 차이는 근거가 부족한지도 함께 짚어요.
핵심 가치: 이 글을 읽고 나면 과제에서 요구하는 품질, 속도, 비용에 따라 어떤 모델을 우선 선택해야 할지 판단할 수 있어요.
一、Gemini 4 Carbon、Claude Fable 5.2, GPT-6 Astra가 같은 무대에서 맞붙다
이번 경쟁은 시기가 아주 촘촘하게 몰려 있어요. Google은 2026년 10월 28일 Gemini 4 Carbon을 처음 공개했고, Anthropic은 11월 9일 Claude Fable 5.2를 출시했어요. Carbon은 11월 10일 개발자, 기업, 일반 소비자에게 정식으로 공개됐고요. 같은 날 Google DeepMind와 Artificial Analysis가 MKA 평가를 내놓았어요. 11월 11일에는 Artificial Analysis Intelligence Index v5.0.1이 업데이트되면서 Fable 5.2가 포함됐어요.
세 모델은 공개된 포지셔닝이 뚜렷하게 달라요. Carbon은 Gemini 4 Argon을 기반으로 만들어졌고, 장기 실행 에이전트, 복잡한 소프트웨어 엔지니어링, 과학 연구를 주력으로 내세워요. 텍스트, 이미지, 오디오, 비디오 입력을 지원해요. Fable 5.2는 Adaptive Thinking 방식을 채택했고, 컨텍스트 윈도우는 1M 토큰, 최대 출력은 128K 토큰이에요. GPT-6 Astra는 이 글에서 인용한 두 평가 모두에 점수가 있어서 효율성 기준점으로 자주 쓰여요.
| 비교 항목 | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra | 현재 판단 |
|---|---|---|---|---|
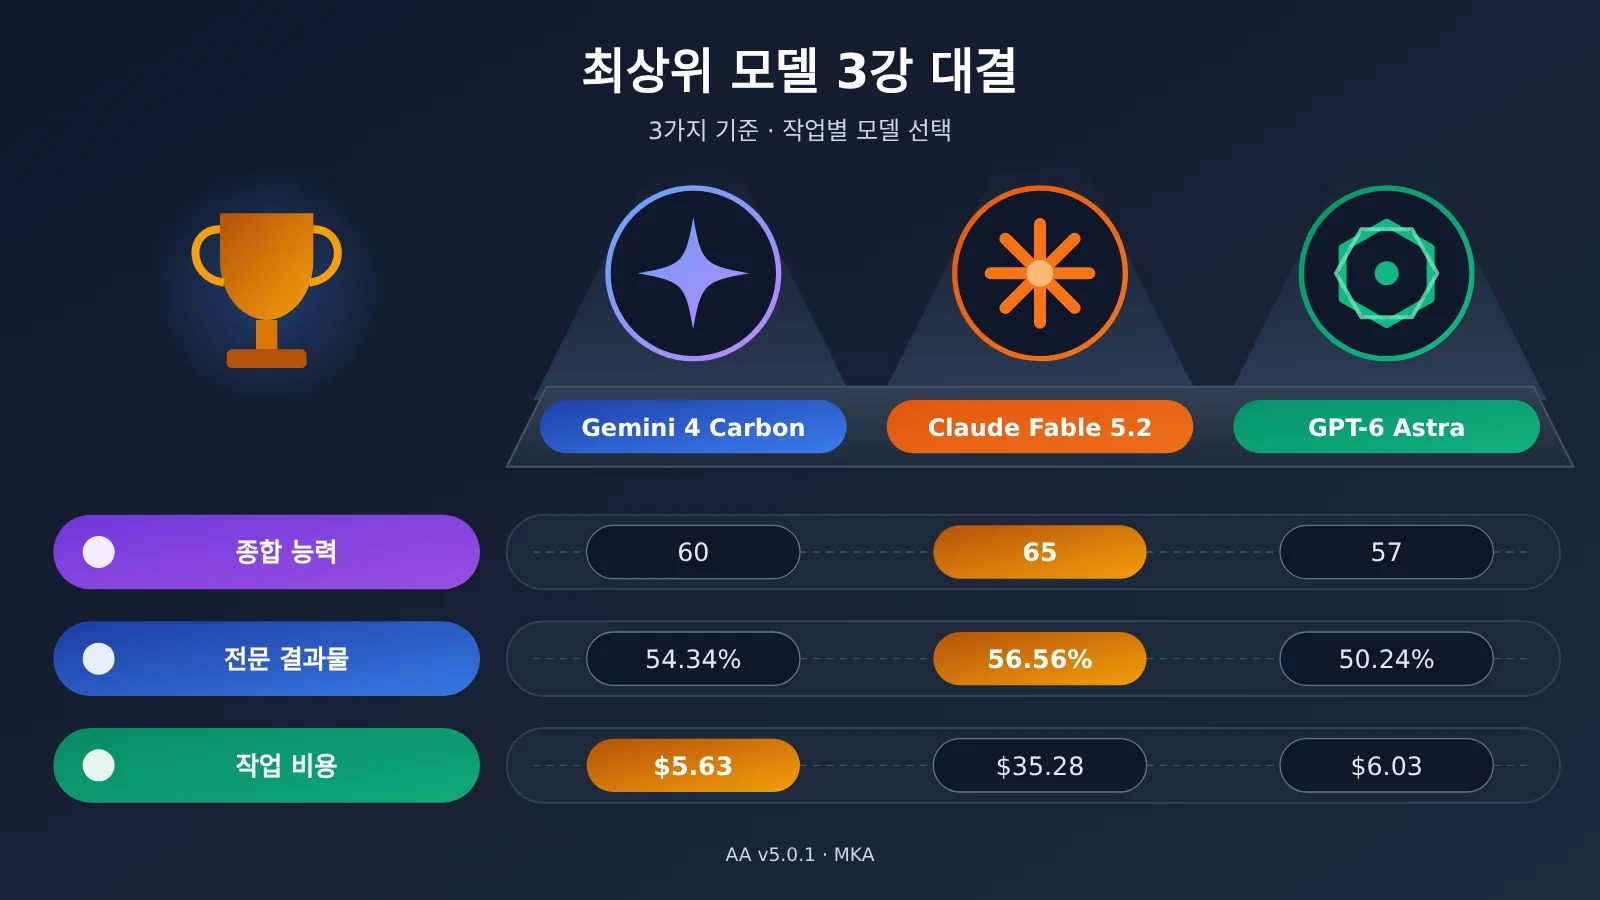
| 종합 능력 (AA v5.0.1) | 65 (Max) | 60 (High) | 57 (Max) | Fable 우세 |
| 전문 업무 수행 (MKA Climb-WSR) | 56.56% | 54.34% | 50.24% | Fable과 Carbon이 비슷하고, 둘 다 Astra보다 앞섬 |
| 작업당 비용 (MKA 표 4) | $35.28 | $5.63 | $6.03 | Carbon이 가장 낮음 |
| 실행 시간 (MKA 표 4) | 83.2분 | 29.2분 | 18.5분 | Astra가 가장 빠름 |
| 토큰 소비량 (MKA 표 4) | 40.48M | 7.05M | 2.43M | Astra가 가장 적게 씀 |
표의 ‘현재 판단’ 열은 해당 항목 하나만 기준으로 한 평가예요. 모든 항목에서 1위를 차지한 모델은 없어요.
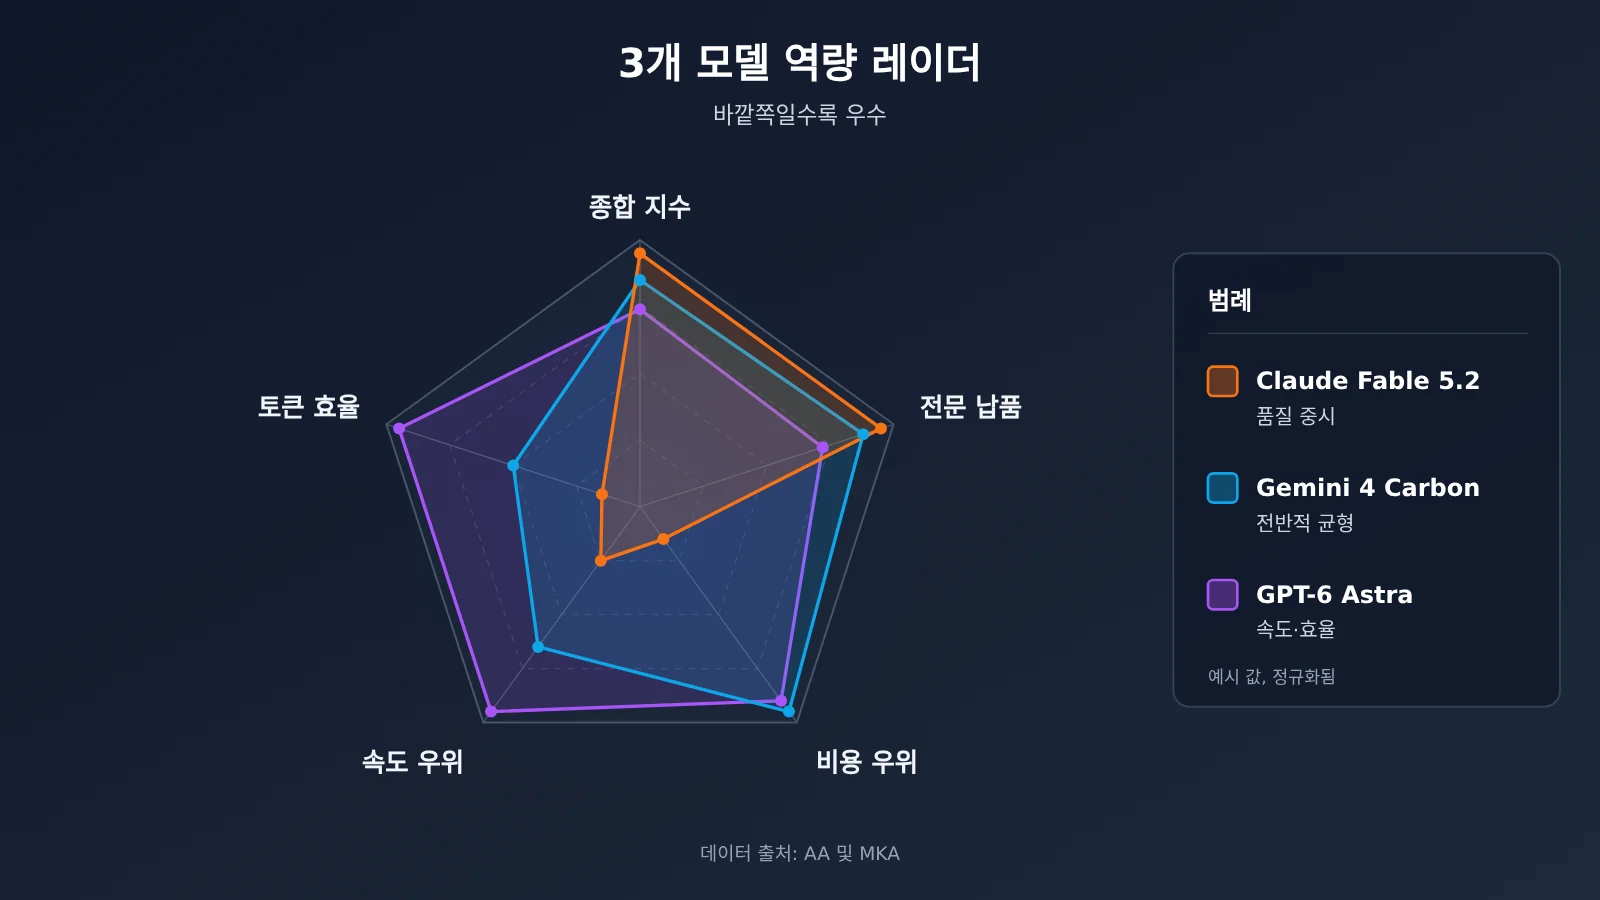
📊 데이터 안내: 위 표의 데이터는 각각 AA 순위표 스냅샷과 MKA 기술 논문에서 가져왔어요. 두 평가는 산정 기준이 달라서 서로 환산할 수 없어요. 직접 쓰는 업무 환경에서 확인해 보고 싶다면 APIYI(apiyi.com)를 통해 같은 프롬프트로 소규모 비교 테스트를 해보세요. 실제 부하에서 세 모델이 어떻게 달라지는지 확인할 수 있어요.
二、AA 종합 순위: Claude Fable 5.2가 잠시 앞서고, Gemini 4 Carbon이 바짝 추격 중이에요
Artificial Analysis Intelligence Index v5.0.1은 9개 평가 항목으로 구성돼요. AA-Briefcase v1.1, AutomationBench-AA, Terminal-Bench 4.0, FrontierCode 2.0, AA-Omniscience v1.1, GDP.pdf, HLE-Diamond, CritPt v2, Terminal-Bench-Science 0.1이 여기에 포함돼요. 지식 업무, 자동화, 코드, 과학적 추론, 사실 신뢰성까지 폭넓게 다루고 있어요. 이 지수가 답하려는 질문은 “모델의 전반적인 실력이 어느 정도인가”예요.
| 모델 구성 | AA Index v5.0.1 | 평가 작업당 비용 | 작업당 소요 시간 |
|---|---|---|---|
| Claude Fable 5.2 Max | 65 | $26.54 | 44.4분 |
| Gemini 4 Carbon High | 60 | $7.76 | 24.9분 |
| GPT-6 Astra Max | 57 | $6.24 | 23.0분 |
이 표를 볼 때는 구성(설정) 차이에 주의해야 해요. 세 모델은 각각 Max, High, Max 단계를 사용했고 추론 예산이 서로 달라요. 그래서 이 결과를 동일한 조건에서 비교한 순수 능력 평가로 보기는 어려워요. 같은 모델도 단계를 바꾸면 점수가 달라져요. Fable 5.2는 Xhigh와 High 모두 62점이고, Carbon은 Medium이 58점, Low가 54점이에요.
Carbon의 단계별 데이터는 따로 살펴볼 만해요. AA의 산정 결과에서 Medium의 작업당 비용은 $6.59로, Low의 $7.19보다 오히려 낮아요. High는 점수가 가장 높지만 첫 응답 토큰까지의 지연 시간이 67.54초나 돼요. 추론 단계를 높인다고 해서 항상 그만큼 이득이 따라오는 건 아니라는 뜻이에요. 표에 있는 $7.76은 Carbon의 표준 가격 $4/$20을 기준으로 계산한 AA 작업 평균 비용이고, 일반적인 요청 한 건의 가격이 아니에요.
三、MKA 전문 업무 수행: 세 모델이 실제로 일을 끝내는 능력
AA 지수가 종합 실력을 측정한다면, MKA는 모델이 실제 전문 업무를 완수할 수 있는지를 측정해요. MKA 기술 논문의 설정은 다음과 같아요.
- 비공개 실무 과제 200개로 구성되며, 10개 산업과 83개 직업을 아울러요. 각 과제는 전문가가 약 3~8시간 걸려 처리하는 분량이에요.
- 과제마다 가중치가 붙은 평가 기준이 약 70개 있어요. 과제의 88%는 Word, Excel, PPT, PDF, HTML, 이미지 같은 독립된 파일을 결과물로 요구해요.
- 모든 모델은 같은 Stirrup Agent Harness에서 실행돼요. 도구 환경은 동일하고, 턴 수 예산은 250턴으로 통일했으며, 과제당 한 번씩 실행했어요.
| 모델 | Climb-WSR | Overall WSR | Regression-WSR |
|---|---|---|---|
| Claude Fable 5.2 | 56.56% | 73.26% | 95.71% |
| Gemini 4 Carbon | 54.34% | 71.89% | 96.36% |
| GPT-6 Astra | 50.24% | 69.34% | 95.17% |
세 지표는 각각 의미가 달라요. Regression-WSR은 기본 요구사항을 얼마나 충족했는지를 보여주는데, 세 모델 모두 95%를 넘고 Carbon이 조금 더 높아요. Climb-WSR은 난도가 높은 항목만 집계한 값이라서 최상위 모델끼리 우열을 가르는 핵심 근거가 돼요. Overall WSR은 전체 항목의 가중 충족률이에요. 이 수치들은 일반적인 질의응답 정확도가 아니기 때문에, AA 지수의 65, 60, 57과 나란히 놓고 비교하면 안 돼요.
Claude Fable 5.2와 Gemini 4 Carbon의 통계적 유의성
MKA를 해석할 때 가장 주의해야 할 부분이 통계적 유의성이에요. 논문에서 제시한 데이터는 다음과 같아요.
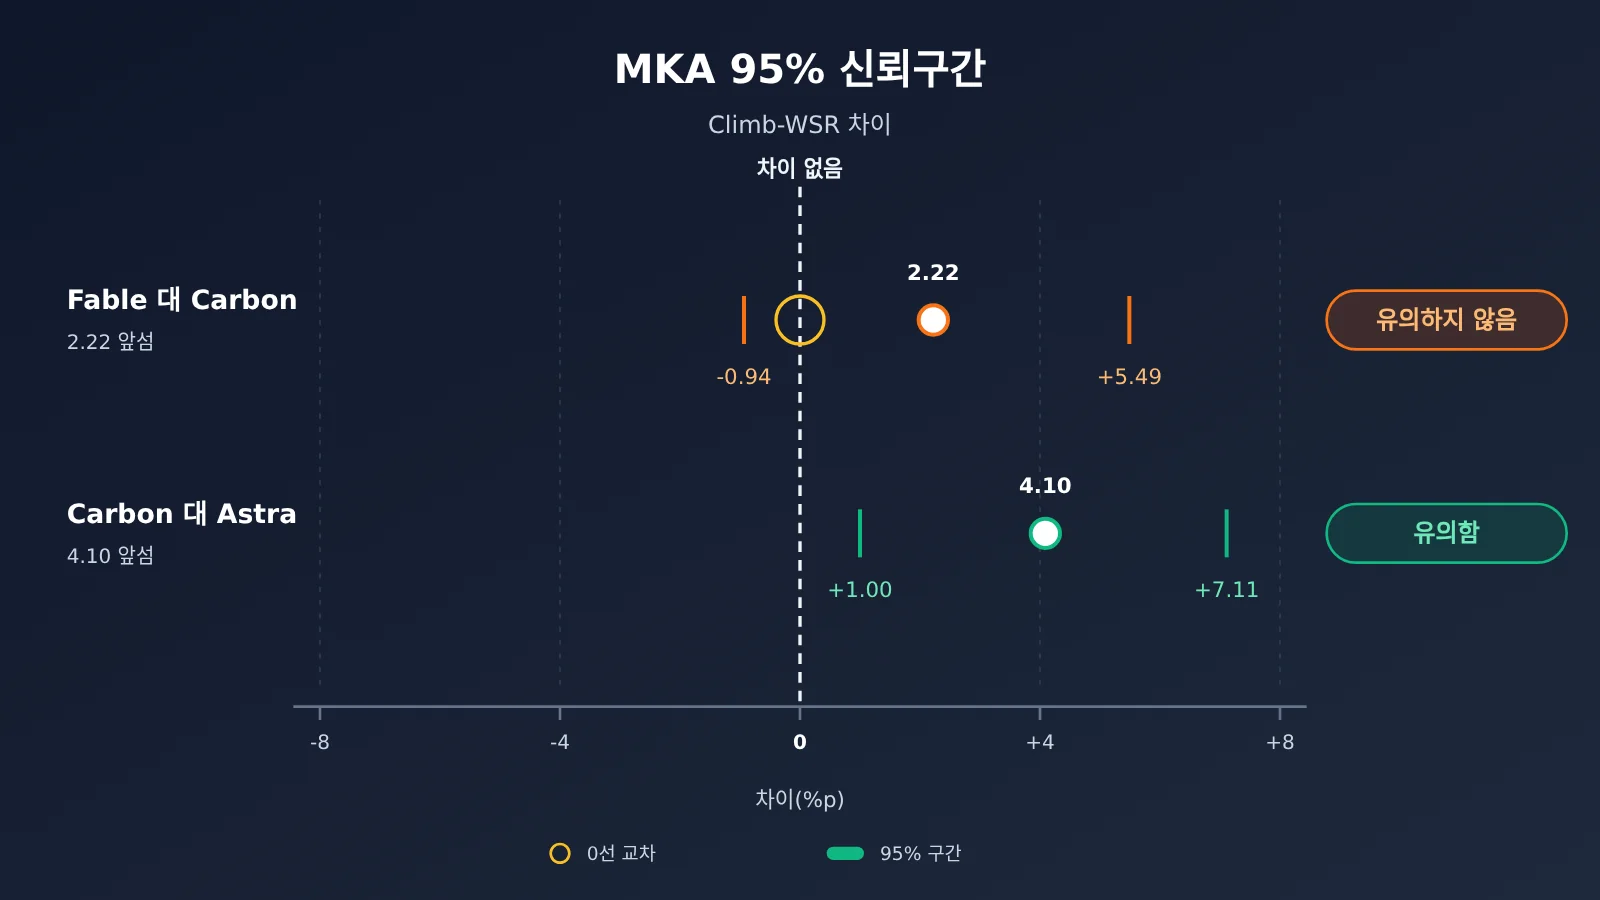
- Fable 대 Carbon: 2.22%p 앞서고, 95% 신뢰구간은 -0.94에서 +5.49예요. 구간이 0을 가로지르기 때문에 차이가 통계적으로 유의하지 않아요.
- Carbon 대 Astra: 4.10%p 앞서고, 95% 신뢰구간은 +1.00에서 +7.11이에요. 구간 전체가 0보다 위에 있어서 차이가 통계적으로 유의해요.
따라서 정확하게 말하면, MKA에서 Fable 5.2와 Carbon은 비슷한 수준이고, 현재 증거만으로는 Fable이 Carbon보다 확실히 낫다고 단정하기 어려워요. 논문의 결론은 이 두 모델이 Astra보다 모두 유의하게 앞선다는 거예요.
넷째, 작업 비용 비교: 세 모델이 같은 작업을 끝내는 데 드는 실제 비용
MKA 논문의 표 4에는 작업별 평균 리소스 소모량이 나와 있어요. API 비용은 각 제조사의 공시 가격을 기준으로 하고, 프롬프트 캐싱 과금을 반영해서 추산했어요.
| 작업당 평균 지표 | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|---|
| 총 토큰 | 40.48M | 7.05M | 2.43M |
| 출력 토큰 | 378.9K | 129.5K | 42.0K |
| 에이전트 턴 수 | 128.8 | 46.6 | 29.0 |
| 실행 시간 | 83.2분 | 29.2분 | 18.5분 |
| 작업당 비용 | $35.28 | $5.63 | $6.03 |
이 표에서 세 가지를 읽어낼 수 있어요.
- Fable이 가장 많은 리소스를 투입해요: 총 토큰은 Carbon의 5.74배이고, 실행 시간은 Carbon의 약 2.85배예요. Fable의 높은 품질은 여러 턴에 걸친 탐색과 대량의 호출 위에서 나온 결과예요.
- Carbon의 가성비가 가장 돋보여요: 작업당 비용이 Fable의 약 6분의 1인데, Climb-WSR 차이는 2.22%p에 불과하고 이 차이는 통계적으로 유의하지 않아요.
- Astra가 가장 빠르고 토큰도 가장 적게 써요: 실행 시간과 토큰 소모량은 가장 적지만, 작업당 비용은 여전히 Carbon보다 약간 높고 Climb-WSR도 Carbon에 눈에 띄게 뒤처져요.
토큰 단가, 토큰 소모량, 작업 청구액은 서로 달라요
이 세 개념은 자주 뒤섞여 쓰여요. 먼저 토큰 단가를 보면, Fable 5.2는 100만 토큰당 입력 $8, 출력 $40이에요. Carbon은 11월 30일까지는 출시 기념가인 $2/$10이고, 12월 1일부터는 $4/$20이에요. 하지만 단가가 낮다고 청구액까지 낮은 건 아니에요. Astra의 토큰 소모량은 Carbon의 약 3분의 1밖에 안 되는데도 작업당 비용은 오히려 약간 높아요. 모델마다 단가 구조와 캐시 적중 상황이 달라서 최종 비용에 영향을 준다는 뜻이에요.
캐시 읽기는 에이전트 환경에서 자주 놓치는 변수예요. 에이전트는 매 턴마다 방대한 컨텍스트를 반복해서 전송하는데, Carbon의 경우 캐시 입력 가격이 일반 입력 가격의 약 5%예요. Fable은 총 토큰이 40.48M에 달하고 그중 상당 부분이 반복해서 읽는 컨텍스트라서, 과금 방식이 청구액에 직접 영향을 줘요. 그 밖에 Carbon은 사고(thinking) 토큰이 출력 요금에 포함되고, Grounding을 쓰면 검색 요청에 별도 요금이 붙어요.
비용 데이터는 세 가지 기준이 있어서 구분해서 인용해야 해요. MKA 논문 표 4(Carbon $5.63, Fable $35.28), MKA 동적 리더보드(Carbon $6.29, Fable $31.97), AA 지수 작업 비용($7.76, $26.54)이에요. 세 가지는 집계 범위가 서로 달라서 섞어 쓰면 안 돼요.
五、Gemini 4 Carbon의 멀티모달 강점은 어디서 드러날까요
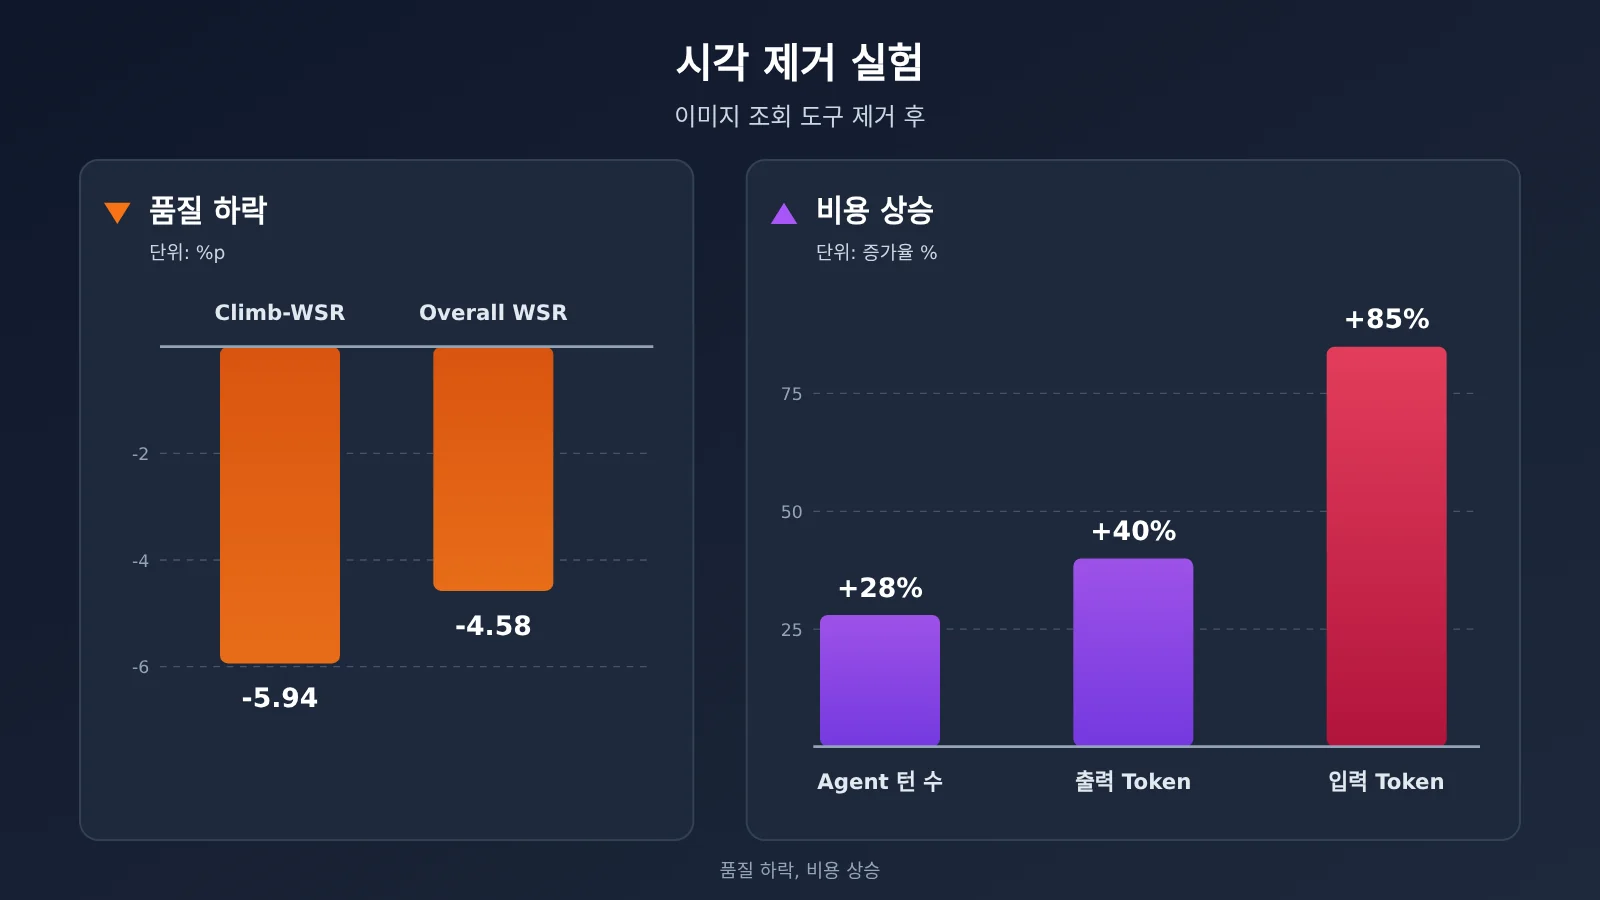
MKA 논문에서는 소거 실험(ablation study)을 하나 진행했어요. Carbon의 view_image 이미지 조회 도구를 제거하고, OCR, 코드 실행, 전통적인 컴퓨터 비전 기법만으로 작업을 처리하게 한 거예요. 결과는 다음과 같아요.
- Climb-WSR은 5.94%p, Overall WSR은 4.58%p 하락했어요.
- 에이전트 턴 수는 28%, 출력 토큰은 40%, 입력 토큰은 85% 늘어났어요.
- 모델이 ASCII 이미지, Unicode Braille, OpenCV 등으로 부족한 부분을 메우려 했지만, 실제 사진과 의료 영상에서는 여전히 실패하기 쉬웠어요.
이 수치는 전문 업무에서의 시각 이해를 텍스트 추출로 대체하기 어렵다는 점을 보여줘요. 건축 도면의 공간 관계, 영상 속 병변 위치, 차트의 시각적 인코딩은 OCR을 거치면 대부분 사라지거든요. 모델은 이미지 내용을 추측하려고 코드를 반복해서 작성할 수밖에 없고, 그 결과 품질은 떨어지고 비용은 올라가요.
MKA 리더보드의 산업별 결과도 이와 일치해요. Carbon은 의료·헬스케어 분야에서 앞서고, 이미지 형태의 결과물에서는 Argon과 함께 두드러진 성과를 냈어요. Fable 5.2는 소프트웨어·데이터, 엔지니어링, 물류·지도, 비즈니스, 금융 등의 분야에서 앞서고, PDF, Word, Spreadsheet 같은 결과물 유형에서도 우위를 보였어요. 10개 산업 전체에서 1위를 차지한 모델은 하나도 없었어요. 또한 Word와 순수 텍스트 파일은 여전히 가장 까다로운 결과물 유형이라, 모든 모델이 이 두 유형에서 52%를 넘지 못했어요.
6. 시나리오별 추천: Gemini 4 Carbon, Claude Fable 5.2, GPT-6 Astra에 어울리는 작업
Claude Fable 5.2를 선택할 만한 경우
- 결과물 품질이 무엇보다 중요한 복잡한 전문 작업 납품: 금융 분석 보고서, 엔지니어링 설계안, 소프트웨어·데이터 프로젝트가 대표적이에요. 이런 작업은 오류가 나면 치르는 대가가 크기 때문에, 실행 시간이 길어지고 비용이 더 들더라도 감수할 수 있는 경우에 적합해요.
- Office 문서 중심의 납품: PDF, Word, 스프레드시트 형태의 결과물은 MKA에서 Fable이 강점을 보인 항목이에요.
Gemini 4 Carbon을 선택할 만한 경우
- 품질과 비용을 함께 챙겨야 하는 복잡한 에이전트 작업: MKA에서 Carbon은 Fable의 약 6분의 1 비용으로 통계적으로 비슷한 수준의 성능을 냈어요.
- 시각 이해에 의존하는 작업: 도면 분석, 의료 영상 보조 분석, 이미지 형태의 결과물 등이 여기에 속해요. 추론 등급은 먼저 MEDIUM으로 시작하는 것을 추천해요. AA의 사실 신뢰성 테스트에서 답변을 지어내는 비율이 더 낮았거든요.
GPT-6 Astra를 선택할 만한 경우
- 실행 속도가 중요한 파이프라인: MKA에서 소요 시간이 가장 짧고 에이전트 턴 수도 가장 적어서, 빠른 피드백이 필요한 작업에 잘 맞아요.
- 토큰 예산이나 컨텍스트 부담에 민감한 경우: Astra는 총 토큰 소모량이 가장 낮아요. 다만 전문 납품물의 품질 면에서는 격차가 있다는 점을 받아들여야 해요.
| 작업 유형 | 1순위 모델 | 대안 모델 | 주요 근거 | 이용 방법 |
|---|---|---|---|---|
| 고부가가치 전문 보고서 | Claude Fable 5.2 | Gemini 4 Carbon | AA와 MKA 점수 최고 | 공식 API, APIYI |
| 대량 복잡 에이전트 작업 | Gemini 4 Carbon | Claude Fable 5.2 | 품질은 비슷하고 비용은 약 6분의 1 | 공식 API, APIYI |
| 도면 및 영상 분석 | Gemini 4 Carbon | Claude Fable 5.2 | 시각 소거 실험 근거, 의료 분야 선두 | 공식 API, APIYI |
| 빠른 실행 파이프라인 | GPT-6 Astra | Gemini 4 Carbon | 소요 시간과 토큰 소모량 최저 | 공식 API, APIYI |
7. 통합 인터페이스로 3대 모델 직접 테스트하기
공개 리더보드는 어디까지나 출발점일 뿐이에요. 결국 중요한 건 내 작업에서 모델이 얼마나 잘 동작하느냐예요. 아래 예제는 OpenAI 호환 인터페이스를 사용해요. model 파라미터만 바꾸면 같은 코드로 여러 모델을 호출할 수 있어요.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "用三点概括这份季度财报摘要的主要风险。"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 토큰 사용량을 기록해 두면 이후 비용 추산에 활용할 수 있음
3개 모델 비교 테스트 전체 코드 보기
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 모델 이름은 플랫폼의 모델 목록을 기준으로 하며, GPT-6 Astra는 여기서 예시 이름임
MODELS = ["claude-fable-5-2", "gemini-4-carbon", "gpt-6-astra"]

# 단가(달러/백만 토큰)는 실제 채널에 맞게 입력하세요
# 예시: Fable 5.2는 공식 정가, Carbon은 11월 30일까지 적용되는 출시 특가
PRICES = {
    "claude-fable-5-2": {"input": 8.0, "output": 40.0},
    "gemini-4-carbon": {"input": 2.0, "output": 10.0},
    "gpt-6-astra": None,  # 직접 채워 넣으세요
}

def build_messages(task, image_url=None):
    content = [{"type": "text", "text": task}]
    if image_url:
        content.append({"type": "image_url", "image_url": {"url": image_url}})
    return [{"role": "user", "content": content}]

def run_once(model, messages):
    start = time.time()
    resp = client.chat.completions.create(model=model, messages=messages)
    elapsed = time.time() - start
    usage = resp.usage
    cost = None
    price = PRICES.get(model)
    if price and usage:
        # 대략적인 추산: 캐시 읽기는 구분하지 않았으며, 사고 토큰은 보통 출력에 포함됨
        cost = (usage.prompt_tokens * price["input"]
                + usage.completion_tokens * price["output"]) / 1_000_000
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "est_cost_usd": round(cost, 4) if cost is not None else None,
        "answer": resp.choices[0].message.content[:200],
    }

if __name__ == "__main__":
    task = "根据这张户型图,列出各房间面积估算和三条改造建议。"
    msgs = build_messages(task, image_url="https://example.com/floor-plan.png")
    for m in MODELS:
        try:
            print(run_once(m, msgs))
        except Exception as e:
            print(m, "调用失败:", e)
이 코드가 집계하는 건 단일 호출 기준이에요. 실제 Agent 작업의 비용은 모든 턴을 합산해야 하는데, 이게 이 글에서 말하는 작업 비용이에요. 또 Carbon은 thinking_budget을 지원하지 않아서 이 값을 넘기면 HTTP 400이 반환돼요. temperature 같은 샘플링 파라미터도 무시되므로, 추론 단계는 플랫폼 문서에 안내된 방식으로 설정해야 해요.
🚀 빠르게 시작하는 방법: 먼저 APIYI(apiyi.com)에서 신규 사용자용 무료 테스트 크레딧을 받아, 실제 업무 샘플 5~10개로 위의 비교 스크립트를 돌려 보세요. 소요 시간, 토큰, 품질 점수를 기록한 뒤에 주력 모델을 정하는 걸 추천해요. 이 플랫폼은 API 키 하나로 OpenAI, Claude, Gemini 등 주요 모델에 접속할 수 있고, 사용한 만큼만 과금돼요. 모델을 바꿀 때도 파라미터 하나만 수정하면 돼요.
의사결정 가이드: 세 가지 모델 사이에서 어떻게 고를까
모델을 고를 때는 먼저 작업에서 가장 중요한 제약 조건이 무엇인지 정하고, 그에 맞는 지표를 보면 돼요.
- 품질이 필수 조건일 때: MKA의 Climb-WSR을 주요 기준으로 삼아 Fable 5.2와 Carbon 중에서 하나를 고르세요. 두 모델의 차이가 뚜렷하지 않으니, 가급적 직접 준비한 샘플로 검증해 보시는 게 좋아요.
- 예산이 필수 조건일 때: 토큰 단가가 아니라 MKA 표 4의 작업당 비용을 보세요. 이 항목에서는 Carbon이 확실히 유리해요.
- 속도가 필수 조건일 때: 실행 시간과 Agent 라운드 수를 확인하세요. Astra가 가장 빨라요. 다만 전문적인 결과물의 품질에서는 눈에 띄게 뒤처진다는 점도 함께 받아들여야 해요.
💡 선택 팁: Google /swarm 방식을 참고해 보세요. 성능이 뛰어난 모델은 계획과 검토 단계에, 빠른 모델은 대량 실행 단계에 배치하는 방식이에요. APIYI(apiyi.com)의 통합 인터페이스를 이용하면 한 프로젝트 안에서 Agent 역할별로 서로 다른 모델을 배정할 수 있어서, 여러 SDK를 따로 관리하지 않아도 돼요.
자주 묻는 질문 FAQ
Q1: Gemini 4 Carbon, Claude Fable 5.2, GPT-6 Astra는 각각 어떤 포지션인가요?
세 모델 모두 2026년 하반기를 대표하는 최상위 추론 모델이에요. Fable 5.2는 종합 성능과 전문 업무 결과물의 품질에서 앞서 있어요. Carbon은 품질, 멀티모달, 작업당 비용 사이에서 균형이 잘 잡혀 있고요. Astra의 강점은 실행 속도와 토큰 효율이에요.
Q2: MKA에서 Fable 5.2가 Carbon보다 2.22%p 높은데, Fable이 더 강하다고 말할 수 있나요?
말할 수 없어요. 이 차이의 95% 신뢰구간은 -0.94에서 +5.49로 0을 가로지르기 때문에 통계적으로 유의하지 않아요. 두 모델은 비슷한 수준이고, 둘 다 Astra보다는 유의미하게 앞선다고 보는 편이 더 정확해요.
Q3: AA 지수의 65점과 MKA의 56.56%를 서로 비교해도 되나요?
안 돼요. AA 지수는 9개 평가 항목을 종합한 점수이고, 모델마다 추론 단계 설정이 달라요. MKA는 동일한 Harness에서 전문 업무 결과물의 가중 충족률을 측정한 값이에요. 평가 대상과 채점 방식이 모두 달라서 서로 환산할 수 없어요.
Q4: Carbon의 토큰 단가가 Fable의 4분의 1이면, 작업당 비용도 4분의 1인가요?
꼭 그렇지는 않아요. 출시 기간에는 Carbon 단가가 Fable 5.2의 25%인 게 맞지만, 12월 1일부터는 50%로 바뀌어요. 다만 실제 청구 금액은 토큰 소비량, 사고(thinking) 토큰, 캐시 적중, 도구 호출에 따라 달라져요. MKA 표 4에서는 두 모델의 작업당 비용이 약 6배 차이 나는데, Carbon이 소비하는 토큰도 훨씬 적기 때문이에요.
Q5: 세 모델을 저렴하게 직접 검증하려면 어떻게 하나요?
여러 모델을 지원하는 통합 API를 쓰는 걸 추천해요.
1. APIYI(apiyi.com)에 가입하고 API 키와 무료 테스트 크레딧을 받으세요.
2. 이 글의 코드에서 base_url을 `https://api.apiyi.com/v1`로 설정하세요.
3. 실제 업무에서 쓰는 파일과 작업으로 비교 테스트를 돌려 보고, 품질, 소요 시간, 토큰 사용량을 기록하세요.
Q6: GPT-6 Astra는 토큰을 가장 적게 쓰는데, 왜 작업당 비용이 가장 낮지 않나요?
토큰이 적다고 청구 금액이 낮은 건 아니에요. 모델마다 입력, 출력, 캐시 단가 구조가 달라서, 최종 비용은 소비량에 각 단가를 곱해 합산한 값이거든요. MKA 표 4에서 Astra의 토큰 사용량은 Carbon의 약 3분의 1인데, 비용은 오히려 약간 더 높아요.
Q7: 이 평가 결과에는 어떤 한계가 있나요?
MKA는 작업마다 한 번씩만 실행했고, Judge는 GPT-6 Luna Medium이에요. 전문가 평가와의 일치율은 96%고요. AA 순위표는 수시로 바뀌는 스냅샷이어서, Carbon 가격이 12월 1일에 조정되면 표준 가격 기준 비용도 달라져요. 비용을 장기적으로 추적하고 싶다면 APIYI(apiyi.com)의 사용 내역에서 모델별 실제 지출을 집계해 나만의 비용 데이터로 활용해 보세요.
세 모델 비교 핵심 요약 Key Takeaways
- 종합 능력: AA v5.0.1에서 Fable 5.2 Max는 65점으로, Carbon High(60점)와 Astra Max(57점)를 앞섰어요.
- 전문 업무 결과물: MKA에서는 Fable과 Carbon의 격차가 뚜렷하지 않아요. 두 모델 모두 Astra보다 확실히 앞서 있어요.
- 작업당 비용: 논문 표 4 기준으로 Carbon은 작업당 $5.63으로, Fable의 약 6분의 1 수준이에요.
- 속도와 효율: Astra는 작업당 18.5분, 2.43M 토큰으로 속도와 토큰 효율이 가장 좋아요.
- 멀티모달 가치: 이미지 조회 도구를 제거하면 Carbon은 품질이 떨어지고 입력 토큰이 85% 늘어나요.
- 기준의 경계: 토큰 단가, 토큰 소모량, 작업별 청구 금액은 서로 다른 개념이에요.
- 시작 방법: APIYI(apiyi.com)에서 키 하나로 세 모델을 소규모 샘플로 비교 테스트해 볼 수 있어요.
정리: 하나의 지표만으로는 최강 모델을 가릴 수 없어요
처음 던진 질문으로 돌아가 볼게요. 이 세 최상위 모델의 차이는 결국 품질, 속도, 비용 사이에서 무엇을 우선하느냐에 달려 있어요.
- Claude Fable 5.2: 종합 지수와 전문 업무 결과물 점수 모두 가장 앞서요. 대신 실행 시간이 가장 길고 작업당 비용도 가장 높아요.
- Gemini 4 Carbon: 전문 업무 결과물 품질은 Fable과 통계적으로 비슷하고, 작업당 비용은 가장 낮아요. 시각 이해 능력이 차별화된 강점이에요.
- GPT-6 Astra: 실행이 가장 빠르고 토큰도 가장 적게 써요. 하지만 전문 업무 결과물 품질은 앞의 두 모델보다 확연히 떨어져요.
종합 능력, 작업 품질, 응답 속도, 작업당 비용은 각각 따로 평가해야 해요. 리더보드 순위만 보기보다 내 작업으로 직접 비교 테스트를 해 보는 쪽이 훨씬 믿을 만해요. APIYI(apiyi.com)를 이용하면 세 모델이 내 업무에서 어떤 성능을 보이는지 빠르게 확인할 수 있어요. 무료 테스트 크레딧과 통합 멀티 모델 인터페이스도 제공해요.
📚 참고 자료
- MKA 기술 논문: MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks
- 링크:
storage.googleapis.com/deepmind-media/papers/mka_tech_paper.pdf -
설명: 세 모델의 WSR, 신뢰구간, 표 4의 비용, 시각 요소 제거 실험(ablation)의 원본 데이터
-
Artificial Analysis 모델 리더보드: Intelligence Index v5.0.1
- 링크:
artificialanalysis.ai/leaderboards/models -
설명: 종합 점수, 작업당 비용, 소요 시간의 동적 스냅샷
-
MKA 평가 순위표: 멀티모달 지식 Agent 순위
- 링크:
artificialanalysis.ai/zh/evaluations/mka -
설명: 업계 선두 모델과 산출물 파일 유형별 세부 결과
-
Gemini 4 Carbon 모델 카드: Google DeepMind 공식 자료
- 링크:
deepmind.google/models/model-cards/gemini-4-carbon -
설명: 모달리티, 컨텍스트, 추론 단계, 알려진 한계
-
Gemini API 가격 페이지: Carbon 표준 가격, 캐시 가격, Batch 가격
- 링크:
ai.google.dev/gemini-api/docs/pricing -
설명: 출시 가격과 12월 1일부터 적용되는 가격 조정
-
Claude Fable 5.2 API 문서: Anthropic 공식 모델 설명
- 링크:
platform.claude.com/docs/en/models/fable-5-2/overview - 설명: 컨텍스트, 최대 출력, 토큰 단가, Fast Mode
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 첫 페이지에서 언제든 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.