أُطلق Claude Fable 5.2 في 9 نوفمبر 2026، وسعر وحدة API القياسي أقل بنسبة 20% مقارنةً بالإصدار 5.1.
سرعان ما يتبادر إلى أذهان كثير من الفرق سؤال: ما دام السعر قد انخفض، فهل يمكننا الانتقال مباشرةً إلى مستوى max؟
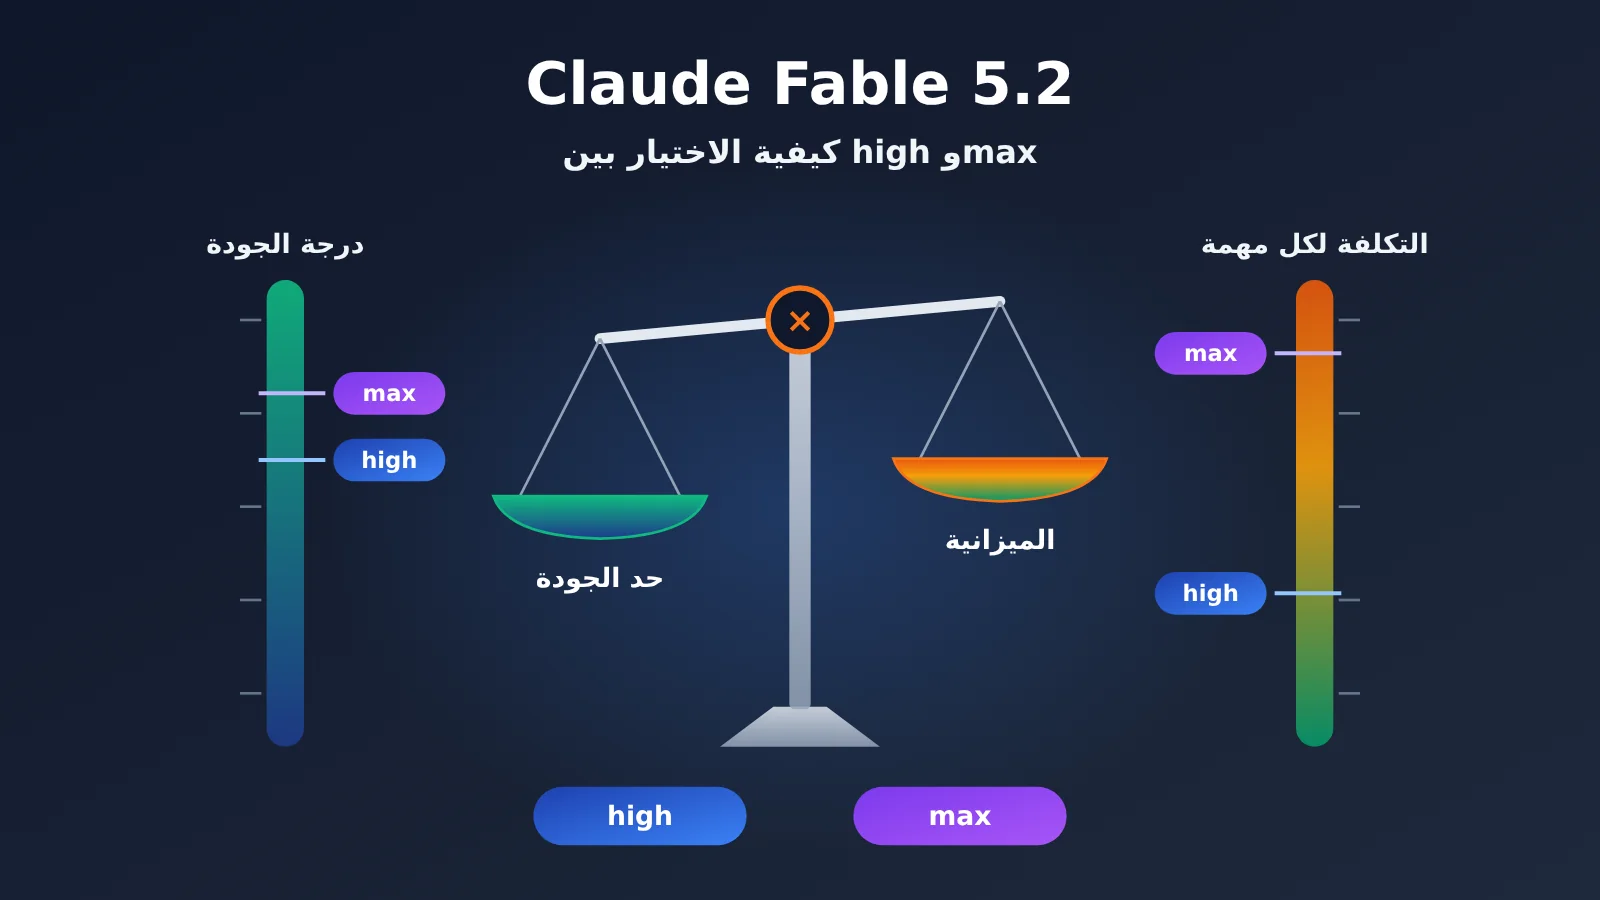
تقارن هذه المقالة بين Fable 5.2 high وFable 5.2 max ضمن إطار واحد، مع مراعاة الجودة وتكلفة كل مهمة.
الفائدة الأساسية: بعد قراءة المقالة، ستعرف متى يكون كل من مستويَي high وmax في Fable 5.2 مناسبًا، وستحصل أيضًا على قائمة تحقق يمكنك استخدامها مباشرةً لاعتماد الترقية.
جدول المحتويات
- تعرّف على المصطلحات المرتبطة باختيار مستوى Fable 5.2
- 1 ما الذي يغيّره مستويا high وmax في Fable 5.2؟ ليس السعر نفسه
- 2 مقارنة جودة Fable 5.2 وتكلفته في جدول واحد
- 3 التحقق من اتجاهات مستويَي Fable 5.2 باستخدام بيانات جهات مستقلة
- 4 اختيار مستوى Fable 5.2 حسب نوع المهمة
- 5 تحديد ما إذا كان ينبغي ترقية Fable 5.2 إلى max من خلال اختبارات القبول الخاصة بك
- الأسئلة الشائعة / أهم النقاط / الخلاصة
مصطلحات ينبغي معرفتها
| المصطلح | المعنى | ما ينبغي الانتباه إليه عند قراءة المقال |
|---|---|---|
| Effort | إعداد يتحكم في مقدار الجهد الذي يبذله النموذج في التفكير | القيمة الافتراضية في واجهة API لـ Fable 5.2 هي high |
| Adaptive thinking | آلية يوزّع النموذج من خلالها مقدار التفكير تلقائيًا | مفعّلة دائمًا في Fable 5.2 |
| Harness | بيئة تشغيل توفّر للنموذج الأدوات والجلسات وقواعد التنفيذ | تختلف بيئة Harness في Cursor عنها في AA |
| Intelligence Index | مؤشر مركّب تحسبه AA بترجيح نتائج عدة اختبارات تقييم | هو مؤشر، وليس نسبة دقة |
| النقطة المئوية | الفرق المطلق الناتج عن طرح نسبة مئوية من أخرى | الانتقال من 56.9% إلى 60.0% يعادل 3.1 نقاط مئوية |
| التكلفة لكل مهمة | تكلفة النموذج الموزّعة على مهمة واحدة ضمن ظروف اختبار معينة | لا تساوي فاتورة API الخاصة بك |
| حد القبول | متطلبات الجودة التي يجب أن تحققها المهمة | اجتز الحد أولًا، ثم قارن الميزانيات |
| تصنيف المهام | تقسيم المهام إلى مجموعات حسب الصعوبة وتبعات الإخفاق | يناسب كل مستوى نطاق مختلف |
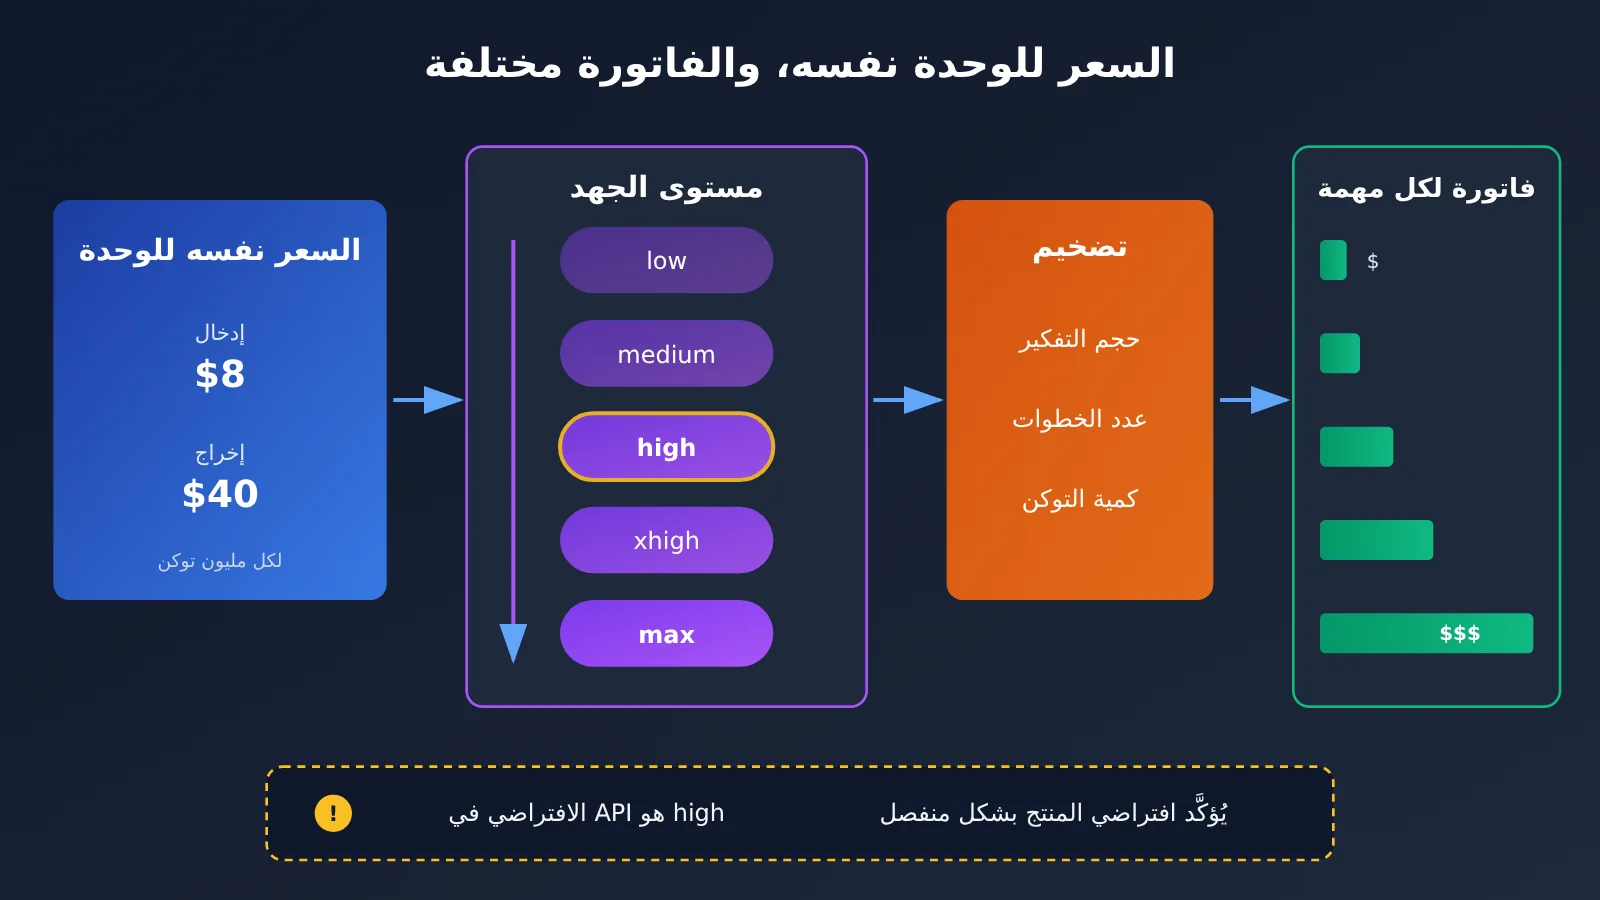
1 لا تغيّر high وmax في Fable 5.2 السعرَين الوحدويين نفسيهما
يظن كثيرون أن السعر الوحدوي يرتفع كلما زادت الفئة. لكن وفق الأسعار القياسية الرسمية من Anthropic، تبلغ تكلفة الإدخال في Fable 5.2 ثمانية دولارات لكل مليون token، وتكلفة الإخراج 40 دولارًا لكل مليون token، ولا يتغير هذان السعران بتغيّر الفئة.
ما يغيّره effort هو مقدار التفكير الذي يخصصه النموذج للمهمة، وعدد الخطوات التي ينفذها، والوقت الذي يستغرقه، وعدد token التي يستهلكها. لذلك، قد تتفاوت فاتورة المهمة عدة أضعاف، حتى مع ثبات السعر الوحدوي.
كيف تؤثر فئات Fable 5.2 في الفاتورة
في Fable 5.2، يكون التفكير التكيفي مفعّلًا دائمًا، ويحدد effort الحد الأقصى لمقدار التفكير وميله. وعادةً ما ينفذ النموذج مزيدًا من الاستدلال واستدعاءات الأدوات عند رفع الفئة، ما يزيد عدد token المفوترة.
لنفترض أن الإدخال يبلغ 100 ألف token في الحالتين، لكن الإخراج يرتفع من 20 ألفًا إلى 40 ألف token. عندها ترتفع تكلفة الوضع القياسي في الإصدار 5.2 من 1.60 دولار إلى 2.40 دولار، أي إنها تصبح أعلى من تكلفة الإصدار 5.1 البالغة دولارين عند حجم الاستخدام السابق.
ومن المهم أيضًا التمييز بين نوعين من «القيم الافتراضية». توضح وثائق النماذج الرسمية أن قيمة effort الافتراضية في API هي high. أما منتجات مثل Cursor، فلديها طبقة إعدادات خاصة بها؛ فسياقها الافتراضي، مثلًا، هو 300K، وهذا ليس ضمن المستوى نفسه لمواصفات 1M الواردة في وثائق API.
وهناك نقطة أخرى: ينبه دليل التوجيه الرسمي إلى أن مقدار التفكير قد يختلف بين الإصدارات حتى عند استخدام اسم الفئة نفسه. لذلك، لا يمكن تطبيق الخبرة المكتسبة من فئات الإصدار 5.1 على الإصدار 5.2 كما هي.
2 مقارنة جودة Fable 5.2 وتكلفته في جدول واحد
CursorBench 4.0 تقييم أجرته Cursor باستخدام مهامها وبيئة أدواتها الخاصة، لذا فهو ليس اختبارًا مستقلًا عامًا. لكنه يقارن المستويات الخمسة ضمن بيئة Harness واحدة، ما يجعله مناسبًا لملاحظة الفروق النسبية بينها. البيانات أدناه مأخوذة في 10 نوفمبر 2026.
| مستوى Fable 5.2 | النتيجة | التكلفة لكل مهمة (دولار) | tokens (حقل مجمّع) | عدد الخطوات |
|---|---|---|---|---|
| Low | 53.2% | 3.94 | 36,616 | 30 |
| Medium | 54.8% | 4.66 | 44,103 | 35 |
| High | 56.9% | 9.70 | 99,259 | 69 |
| Extra High | 56.3% | 15.48 | 161,251 | 108 |
| Max | 60.0% | 32.79 | 352,794 | 218 |
ملاحظة: عمود tokens هو حقل مجمّع من صفحة المعيار، ولا ينبغي فهمه على أنه يتضمن حجم المخرجات فقط. المصدر: CursorBench 4.0.
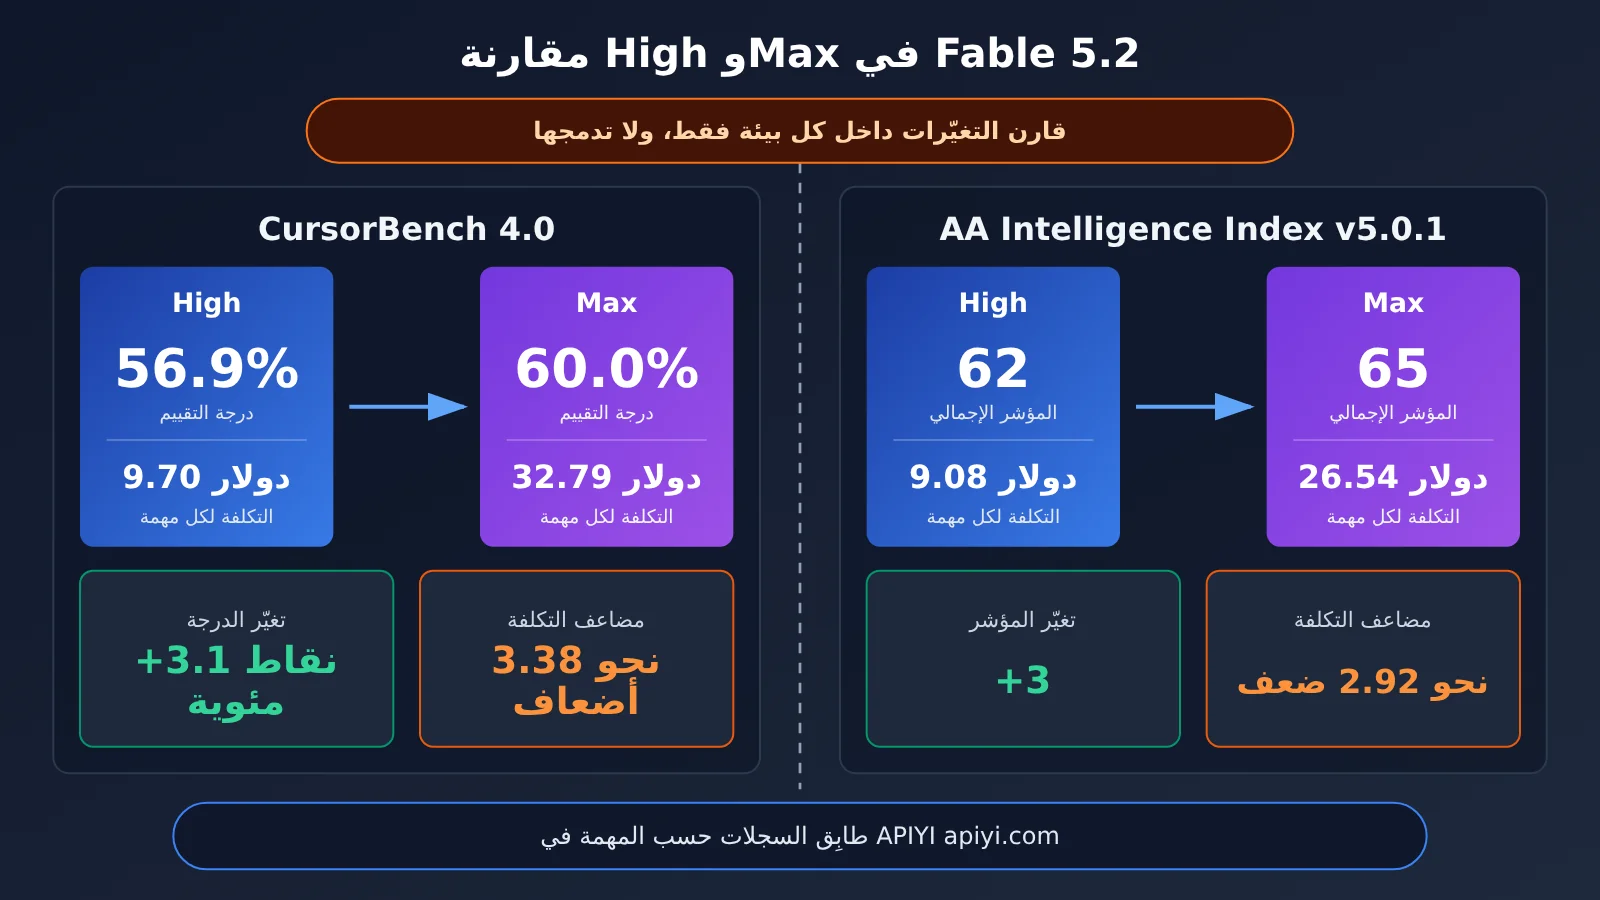
من Fable 5.2 High إلى Max: زيادة 3.1 نقاط مئوية وتكلفة أعلى بنحو 3.38 مرة
في هذا الجدول، ارتفعت النتيجة من 56.9% عند High إلى 60.0% عند Max، أي بزيادة 3.1 نقاط مئوية. أما تكلفة المهمة فارتفعت من 9.70 إلى 32.79 دولارًا، أي نحو 3.38 مرة، بزيادة تقارب 238%.
بحسب حسابات هذه المقالة، ارتفع حقل tokens إلى نحو 3.55 مرة، كما زاد عدد الخطوات من 69 إلى 218، أي نحو 3.16 مرة. ويُعزى ارتفاع التكلفة أساسًا إلى زيادة التفكير وخطوات التنفيذ، لا إلى سعر الوحدة.
لا تُظهر هذه البيانات سوى أن النتيجة الأعلى في هذه البيئة تقترن بتكلفة أكبر بوضوح.
كيف نفهم النتيجة غير المتوقعة لمستوى Extra High؟
هناك أمر آخر جدير بالملاحظة في الجدول: تكلفة Extra High أعلى من High بنحو 60%، لكن نتيجته أقل بمقدار 0.6 نقطة مئوية.
💡 نصيحة للاختيار: يمكن مقارنة الفروق بين المستويات ضمن الجدول نفسه، لكن لا يصح جمع أرقام تقييمات مختلفة ومقارنتها مباشرة. إذا أردت إجراء مقارنة مماثلة على مهامك، يمكنك استخدام واجهة API موحّدة وسجلات الاستدعاء لدى APIYI على apiyi.com لمراجعة النتائج، بشرط التأكد أولًا من معرّف النموذج والمستويات التي تدعمها المنصة في ذلك اليوم.
3. التحقق من اتجاهات مستويات Fable 5.2 باستخدام بيانات جهة مستقلة
قد تتأثر النتائج عند الاعتماد على بيئة تقييم واحدة بخصائص تلك البيئة نفسها. وتُعد AA جهة تقييم مستقلة، لذا يمكن الاستعانة بقائمتها للتحقق مما إذا كانت الاتجاهات التي رُصدت في Cursor تظهر أيضًا في بيئة أخرى. فيما يلي لقطة محدثة بتاريخ 10 نوفمبر 2026، باستخدام إصدار المنهجية Intelligence Index v5.0.1.
| الإعداد | Intelligence Index | التكلفة لكل مهمة (دولار) |
|---|---|---|
| Fable 5.2 medium | 56 | 3.80 |
| Fable 5.2 high | 62 | 9.08 |
| Fable 5.2 xhigh | 62 | 14.83 |
| Fable 5.2 max | 65 | 26.54 |
| Opus 5.5 max | 59 | 10.04 |
الدرجة 65 لا تعني دقة بنسبة 65%
توضح صفحة منهجية AA أن إصدار v5.0.1 من المؤشر يتألف من 9 تقييمات، وتتوزع أوزان فئات القدرات الأربع بالتساوي، بواقع 25% لكل فئة. لذا فإن 65 درجة مركّبة للمؤشر، وليست نسبة دقة تبلغ 65%. في بيئة AA، ترتفع درجة المؤشر بمقدار 3 نقاط من high إلى max، بينما تبلغ تكلفة المهمة نحو 2.92 ضعفًا. وحصول high وxhigh على الدرجة نفسها، وهي 62، يعني تساوي نتيجتيهما المركبتين، لا تطابق سلوكهما في كل مهمة.
تجب المقارنة داخل كل بيئة على حدة
تُظهر كلتا البيئتين الاتجاه نفسه: درجة أعلى مع max، وتكلفة تقارب ثلاثة أضعاف تكلفة high. وهذا يدعم الاتجاه من خلال ملاحظتين مستقلتين. لكن المهام وطرق التقييم وحساب التكاليف تختلف بين AA وCursor، لذلك لا يجوز جمع درجة 65 من AA مع دقة 60.0% من Cursor واعتبارهما نسبة دقة واحدة.
4 اختيار مستوى Fable 5.2 بحسب طبيعة المهمة
يقدّم دليل التوجيهات الرسمي منهجًا للبدء: استخدم مستوى high افتراضيًا عبر API، ثم ارفعه أو اخفضه بناءً على نتائج التقييم. يناسب medium سيناريوهات التفاعل، بينما يُخصَّص xhigh للمهام الصعبة والطويلة التي ثبت أن رفع المستوى يحقق فيها فائدة إضافية. أما max، فيُستخدم لتقييم الحد الأقصى لقدرات النموذج أو للمهام القليلة التي لا يهم فيها الوقت أو عدد الرموز. وانتبه أيضًا إلى احتمال انتهاء المهمة مبكرًا عند استخدام المستويات المنخفضة.
جدول المستويات المقترحة بحسب سيناريوهات Fable 5.2
السيناريوهات الثلاثة أدناه افتراضية، والغرض منها توضيح طريقة الاختيار.
| السيناريو الافتراضي | نقطة البدء المقترحة | متى تفكر في رفع المستوى؟ | ما الذي لا يُنصح به؟ |
|---|---|---|---|
| تغيير المتطلبات (تعديل الحقول، ضبط واجهة API، إضافة اختبارات) | تقييم medium، واستخدام high عند الحاجة |
إذا أنهى medium المهمة مبكرًا أو أغفل بعض التعديلات |
استخدام max افتراضيًا لتغييرات بسيطة |
| إصلاح معقد (أخطاء تمتد عبر وحدات متعددة، مشكلات التزامن) | high |
إذا لم يبلغ معدل نجاح high حد القبول |
الانتقال مباشرةً إلى xhigh من دون التحقق |
| بحث ممتد (مسائل مفتوحة، استكشاف الحلول) | البدء بـhigh |
إذا كانت للمسألة قيمة كبيرة وتكلفة الفشل مرتفعة، وأثبت التقييم أن max يحقق فائدة |
تعيين max افتراضيًا لجميع الطلبات |
متى تختار high في Fable 5.2؟
- لمعظم مهام API التي تتطلب استدلالًا قويًا، مع وجود معايير قبول واضحة؛
- عندما لا يكون لدى الفريق نظام لتقييم المستويات بعد، وتحتاج إلى نقطة بدء موصى بها رسميًا؛
- لمسارات الإنتاج ذات حجم الطلبات الكبير، حيث تكون تكلفة كل مهمة مهمة.
متى تختار max في Fable 5.2؟
- لتقييم الحد الأقصى لقدرات النموذج في نوع معين من المسائل؛
- للمسائل المفتوحة القليلة التي تفوق فيها تكلفة الفشل بكثير تكلفة النموذج؛
- عندما تثبت عيناتك أن
maxيرفع معدل النجاح فوق الحد المطلوب، بينما لا يحققهhigh.
🎯 نصيحة تقنية: اختر المستوى بحسب فئة المهمة، ولا حاجة إلى اتخاذ قرار مستقل لكل طلب. أفضل ممارسة موصى بها رسميًا هي البدء باستخدام
highعلى مجموعة من المهام التمثيلية. وإذا كنت تخطط لتوحيد الوصول عبر APIYI apiyi.com، فتحقّق على المنصة قبل بدء التشغيل الفعلي من معرّف النموذج والمجموعة ونقطة النهاية ومستويات effort المدعومة في ذلك اليوم.
5 حدّد بنفسك ما إذا كان ترقية Fable 5.2 إلى max تستحق
تعرض التقييمات المنشورة الاتجاهات العامة، لكن قرار الترقية يعتمد على نتائج اختبارات القبول الخاصة بك. يمكنك استخدام قائمة التسجيل التالية مباشرةً، والمبدأ الأساسي هو تغيير مستوى الجهد وحده في كل مرة.
| بند التسجيل | المتطلبات |
|---|---|
| المهمة والمدخلات | استخدم المجموعة نفسها من المهام، والمدخلات نفسها، وموجه النظام نفسه |
| أذونات الأدوات | حافظ على مجموعة الأدوات والأذونات كما هي تمامًا |
| النموذج ومستوى الجهد | سجّل معرّف النموذج ومستوى الجهد، وغيّر المستوى وحده في كل جولة |
| معايير النجاح | حدّد عتبة القبول مسبقًا، ولا تعدّلها بعد الاطلاع على النتائج |
| الاستهلاك | سجّل الإدخال وكتابة الذاكرة المؤقتة وقراءتها والإخراج كلًّا على حدة |
| الوقت وإعادة المحاولة | سجّل الوقت الإجمالي، وعدد مرات إعادة المحاولة، وعدد مرات الإنهاء المبكر |
| المبلغ المخصوم فعليًا | اعتمد المبلغ المخصوم فعليًا وفق سجلات المنصة، ولا تستعض عنه بتقديرات الأسعار الرسمية |
| حالات الإخفاق | احتفظ بالمخرجات الأصلية، وحلّل المشكلات التي عالجها max |
البدء السريع مع Fable 5.2: سجّل بيانات الاستخدام أولًا
يوضح هذا المثال المبسّط كيفية إرسال طلب وتسجيل بيانات الاستخدام فقط. لا يتناول هذا المقال طريقة تمرير المعامل effort؛ إذ يجب الرجوع إلى وثائق المنصة الصادرة في اليوم نفسه للتأكد من إتاحة Fable 5.2 على المنصة، ومن دعم تمرير هذا المعامل.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة متوافقة مع OpenAI من APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # أدخل معرّف النموذج الذي تؤكد المنصة إتاحته في ذلك اليوم
    messages=[{"role": "user", "content": "按验收标准修复以下函数……"}]
)
print(resp.usage)  # سجّل بيانات الاستخدام لمطابقتها لاحقًا
عرض الشفرة الكاملة لتسجيل البيانات ومطابقتها
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# الأسعار الرسمية القياسية لـ Anthropic (بالدولار لكل مليون رمز مميز)، للتقدير فقط ولا تمثل المبلغ المخصوم فعليًا
RATE_IN, RATE_OUT = 8.0, 40.0

def run_task(task_id: str, prompt: str, model: str, effort_label: str, passed_fn):
    """ينفّذ مهمة ويعيد سجلًا واحدًا لنتيجة التحقق. تُستخدم effort_label للتسجيل فقط."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    text = resp.choices[0].message.content
    u = resp.usage
    est_usd = u.prompt_tokens / 1e6 * RATE_IN + u.completion_tokens / 1e6 * RATE_OUT
    return {
        "task_id": task_id,
        "model": model,
        "effort": effort_label,
        "passed": passed_fn(text),          # دالة تحقق أُعدّت مسبقًا
        "prompt_tokens": u.prompt_tokens,
        "completion_tokens": u.completion_tokens,
        "est_usd": round(est_usd, 4),       # قيمة تقديرية
        "seconds": round(time.time() - start, 1),
        "output": text,                     # احتفظ بالنص الأصلي للحالات التي لم تجتز التحقق
    }

def quota_to_usd(quota: int) -> float:
    """المبلغ المخصوم فعليًا بالدولار، وفق سجلات المنصة، يساوي quota ÷ 500000."""
    return quota / 500000
تسرد وثائق سجلات APIYI حقولًا مثل model_name وprompt_tokens وcompletion_tokens وquota وduration_for_view وrequest_id. ويعادل quota÷500000 المبلغ المخصوم فعليًا بالدولار، فيما يحتوي حقل other على معلومات إضافية، مثل معامل المجموعة. اربط سجل التحقق بالسجل المقابل باستخدام request_id، وبذلك يمكنك حساب التكلفة الفعلية للمهام التي اجتازت التحقق، بدلًا من الاكتفاء بتكلفة الطلب الواحد.
🚀 بدء سريع: إذا أردت التحقق من سير العمل بعينة صغيرة أولًا، فسجّل في APIYI عبر apiyi.com واستخدم رصيد الاختبار المجاني المخصص للمستخدمين الجدد. جرّب طريقة التسجيل القائمة على «المهمة نفسها، وتغيير متغير واحد، وتسجيل المبلغ المخصوم فعليًا»، ثم قرر ما إذا كنت ستوسّع العينة.
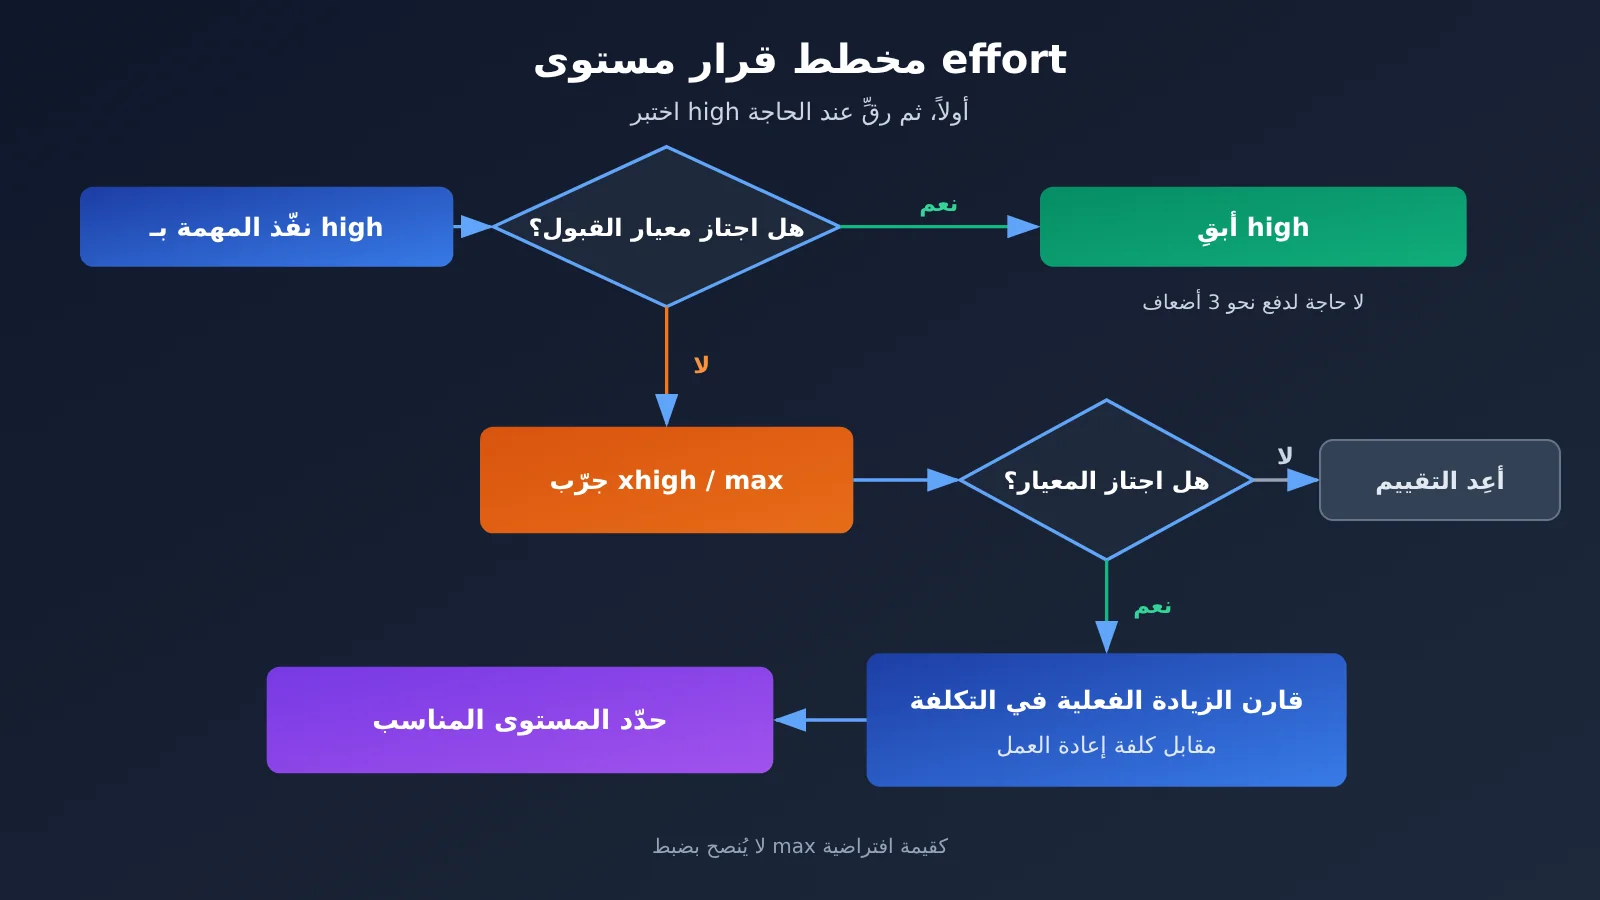
المبدأ النهائي للتقييم هو: تحقق أولًا مما إذا كان high يفي بمعيار الجودة المطلوب. إذا كان يفي به، فلا داعي لدفع تكلفة تقارب ثلاثة أضعاف مقابل تحسن لا يتجاوز بضع نقاط مئوية. لا تقارن التكلفة الإضافية لخيار max إلا إذا لم يحقق high المعيار المطلوب وكان max قادرًا على تحقيقه؛ عندها قيّم ما إذا كانت تلك التكلفة أقل من تكلفة الإخفاق أو إعادة العمل. لا يُنصح باعتماد max قيمة افتراضية لجميع الطلبات.
الأسئلة الشائعة
س1: ما مستويات effort في Claude Fable 5.2؟
يُستخدم effort للتحكم في مقدار الجهد الذي يبذله النموذج في التفكير، وتتراوح مستوياته من low إلى max. لا يغيّر هذا الإعداد سعر الرمز الواحد، بل يؤثر في مقدار التفكير وعدد الخطوات والوقت واستهلاك الرموز. لذلك قد تختلف تكلفة المهمة نفسها عدة أضعاف باختلاف المستوى. المستوى الافتراضي في API هو high.
س2: ما الفرق بين high وmax في Fable 5.2؟
في CursorBench 4.0، سجّل high نسبة 56.9% بتكلفة 9.70 دولارات، بينما سجّل max نسبة 60.0% بتكلفة 32.79 دولارًا. أي إن الفارق 3.1 نقاط مئوية، والتكلفة أعلى بنحو 3.38 أضعاف. وفي AA، سجّل high نتيجة 62 بتكلفة 9.08 دولارات، بينما سجّل max نتيجة 65 بتكلفة 26.54 دولارًا، أي إن التكلفة أعلى بنحو 2.92 ضعفًا. يمكن مقارنة مجموعتي البيانات كلٌّ ضمن بيئته فقط.
س3: متى جُمعت هذه البيانات؟ وهل يمكن أن تتغير؟
صدر Fable 5.2 في 9 نوفمبر 2026، والبيانات الواردة في هذه المقالة لقطة رُصدت في 10 نوفمبر. تُحدَّث صفحات AA وCursor باستمرار، وقد تتغير الأرقام مع صدور إصدارات لاحقة أو تغيّر مجموعات المهام أو خوارزميات حساب التكلفة. لذا ينبغي ذكر تاريخ الاطلاع عند الاستشهاد بها.
س4: كانت نتيجة Extra High أقل من High، فهل يعني ذلك أنه لا ينبغي استخدامه؟
هذه نتيجة واحدة في CursorBench 4.0، ولا تعني أن xhigh أسوأ في جميع المهام. توصي الشركة المطوّرة بتخصيص xhigh للمهام الصعبة والطويلة التي أثبتت تقييماتك الخاصة أنه يحقق فيها فائدة. ما لم ترصد هذه الفائدة، فلا حاجة إلى تفعيله افتراضيًا.
س5: كيف أقارن تكلفة مستويات Fable 5.2 المختلفة عبر API؟
استخدم المجموعة نفسها من المهام، وغيّر المستوى فقط، ثم سجّل بيانات usage والمبلغ المخصوم فعليًا من المنصة. عند الاستدعاء عبر الواجهة الموحدة لـ APIYI على apiyi.com، يمكنك احتساب المبلغ المخصوم بالدولار بقسمة quota الواردة في السجلات على 500000. قبل بدء الاختبار، تحقّق من معرّف النموذج والمجموعة ودعم effort على المنصة في ذلك اليوم. لا تقدّم هذه المقالة صيغة لتمرير الإعدادات لم يتم التحقق منها.
س6: ما حدود بيانات التقييم المنشورة؟
CursorBench تقييم يجريه مزوّد الأداة ضمن بيئته الخاصة، أما مؤشر AA فهو درجة مركّبة مرجّحة. ولا يعكس أي منهما معدل نجاحك في مهام عملك، كما لا تكفي فجوة تقارب 3 نقاط مئوية للحكم على دلالتها الإحصائية. ويمكن اعتبار انطباعات اليوم الأول على منصات التواصل مؤشرات أولية فحسب؛ أما الاستنتاج النهائي، فينبغي أن يستند إلى عينات القبول الخاصة بك.
س7: بعد خفض سعر API بنسبة 20%، هل يصبح استخدام max مجديًا؟
ليس بالضرورة. لا يؤدي خفض السعر إلى توفير النسبة نفسها إلا إذا ظل الاستهلاك ثابتًا. فقد يكون استهلاك الرموز وعدد الخطوات في max أكثر من ثلاثة أضعاف ما هما عليه في high، لذا قد يبدد ارتفاع الاستهلاك بسهولة أثر انخفاض سعر الوحدة. قارن «المبلغ المخصوم فعليًا لإنجاز مهمة»، لا سعر الوحدة وحده.
أهم النقاط حول Fable 5.2 high وmax
- ثبات سعر الوحدة لا يعني ثبات الفاتورة: يغيّر مستوى الجهد حجم التفكير وعدد الخطوات، وقد تختلف تكلفة المهام أضعافًا عند السعر نفسه.
- الإعداد الافتراضي في API هو high: توصي الجهة الرسمية بالبدء بـ high، ثم رفع المستوى أو خفضه بناءً على نتائج تقييمك.
- مقارنة Cursor: ارتفعت النتيجة 3.1 نقاط مئوية من high إلى max، فيما بلغت التكلفة نحو 3.38 أضعاف.
- مقارنة AA: ارتفع المؤشر من 62 إلى 65، فيما بلغت التكلفة نحو 2.92 ضعفًا؛ و65 لا تعني نسبة الدقة.
- لا تدمج بيئتي التقييم: تجب المقارنة داخل كل مجموعة على حدة، ولا يصح جمعهما في درجة موحدة للقيمة مقابل التكلفة.
- استخدم max لعدد محدود من المهام: يناسب تقييم الحد الأقصى للقدرات والأسئلة المفتوحة عالية القيمة.
- تحقق من المبلغ المخصوم فعليًا: استخدم المهمة نفسها، وغيّر متغيرًا واحدًا في كل مرة، وسجّل بيانات الاستخدام. ويمكنك الاستعانة بسجلات APIYI على apiyi.com لمطابقة الحسابات.
الخلاصة
يمكن تلخيص الاختيار بين Fable 5.2 high وmax في ثلاث نقاط:
- ميّز بين سعر الوحدة وتكلفة المهمة: لا يغيّر المستوى سعر الوحدة، بل يغيّر حجم الموارد المستثمرة.
- اقرأ البيانات ضمن البيئة نفسها: تُظهر نتائج Cursor وAA أن أداء max أعلى قليلًا، بينما تبلغ تكلفته نحو ثلاثة أضعاف تكلفة high. لكن لا ينبغي دمج نتائج البيئتين للمقارنة.
- اجعل معيار القبول هو الفيصل: إذا اجتاز high معيار القبول، فاستمر في استخدامه. ولا تقارن التكلفة الإضافية بتكلفة إعادة العمل إلا إذا أخفق high في اجتياز المعيار بينما نجح max.
بالنسبة إلى معظم الفرق، النهج الأكثر أمانًا هو البدء باستخدام high لتصنيف المهام وتوثيق نتائج القبول، ثم تقييم max على نحو منفصل لعدد قليل من المهام ذات القيمة العالية. ونوصي باستخدام APIYI عبر apiyi.com للتحقق بسرعة من النتائج على عيناتكم، بالاستفادة من واجهة موحّدة وسجلات الاستدعاء. تأكدوا من دعم النموذج والمستوى المطلوبين قبل التوسع.
📚 مراجع
- إعلان Anthropic: نطاق إطلاق Fable وMythos 5.2 وتقييم الشركة لنفسها
- الرابط:
anthropic.com/claude-fable-and-mythos-5-2 -
ملاحظة: تاريخ الإصدار هو 2026-11-09، ويتضمن معايير قياس السرعة وجدول التقييمات
-
أسعار Claude API: الأسعار الرسمية القياسية
- الرابط:
platform.claude.com/docs/en/about-claude/pricing -
ملاحظة: سعر الإدخال/الإخراج لـ Fable 5.2 هو 8 / 40 دولارًا لكل مليون token
-
مواصفات نموذج Fable 5.2: نافذة السياق والحد الأقصى للإخراج ومستوى الجهد الافتراضي
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview -
ملاحظة: التفكير التكيفي مفعّل دائمًا، والإعداد الافتراضي في API هو high
-
دليل التوجيه لـ Fable 5.2: توصيات رسمية لاختيار مستوى الجهد
- الرابط:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
ملاحظة: الحالات المناسبة لكل من medium وhigh وxhigh وmax
-
CursorBench 4.0: تقييم بخمسة مستويات ضمن بيئة Cursor الخاصة
- الرابط:
prod.cursor.com/evals -
ملاحظة: تقييم أجراه مزوّد الأداة ضمن بيئته، وليس إعادة تقييم مستقلة وعامة
-
قائمة نماذج Artificial Analysis: قائمة ديناميكية من جهة مستقلة
- الرابط:
artificialanalysis.ai/leaderboards/models -
ملاحظة: مؤشر Intelligence Index وتكلفة كل مهمة
-
منهجية تقييم Artificial Analysis: مكوّنات Intelligence Index v5.0.1
- الرابط:
artificialanalysis.ai/methodology/intelligence-benchmarking -
ملاحظة: 9 تقييمات، موزعة بالتساوي على أربع فئات من القدرات، بواقع 25% لكل فئة
-
كيف تقارن Cursor جودة النماذج؟: مدونة عن منهجية الإصدار السابق من المعيار
- الرابط:
prod.cursor.com/blog/cursorbench -
ملاحظة: للاستفادة منها في فهم الفكرة التصميمية فقط، ولا تصلح للاستناد إليها في استنتاجات إحصائية حول الإصدار 4.0
-
واجهة API للاستعلام عن سجلات APIYI: حقول السجلات وطريقة احتساب المبلغ المخصوم فعليًا
- الرابط:
docs.apiyi.com/api-capabilities/log-query - ملاحظة:
quota÷500000يساوي المبلغ المخصوم فعليًا بالدولار
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI apiyi.com. ويمكنكم الاطلاع على مزيد من المواد في مركز التوثيق docs.apiyi.com.