ملاحظة الكاتب: نتناول الجدل حول تعديل GPT-6 Astra لأوزان Qwen3.5-0.8B، لنشرح في 6 خطوات كيف نفكك الادعاءات عن قدرات النماذج، ونفهم خط الأساس، وصلاحيات الأدوات، وإعدادات التقييم، وأدلة إعادة إنتاج النتائج.
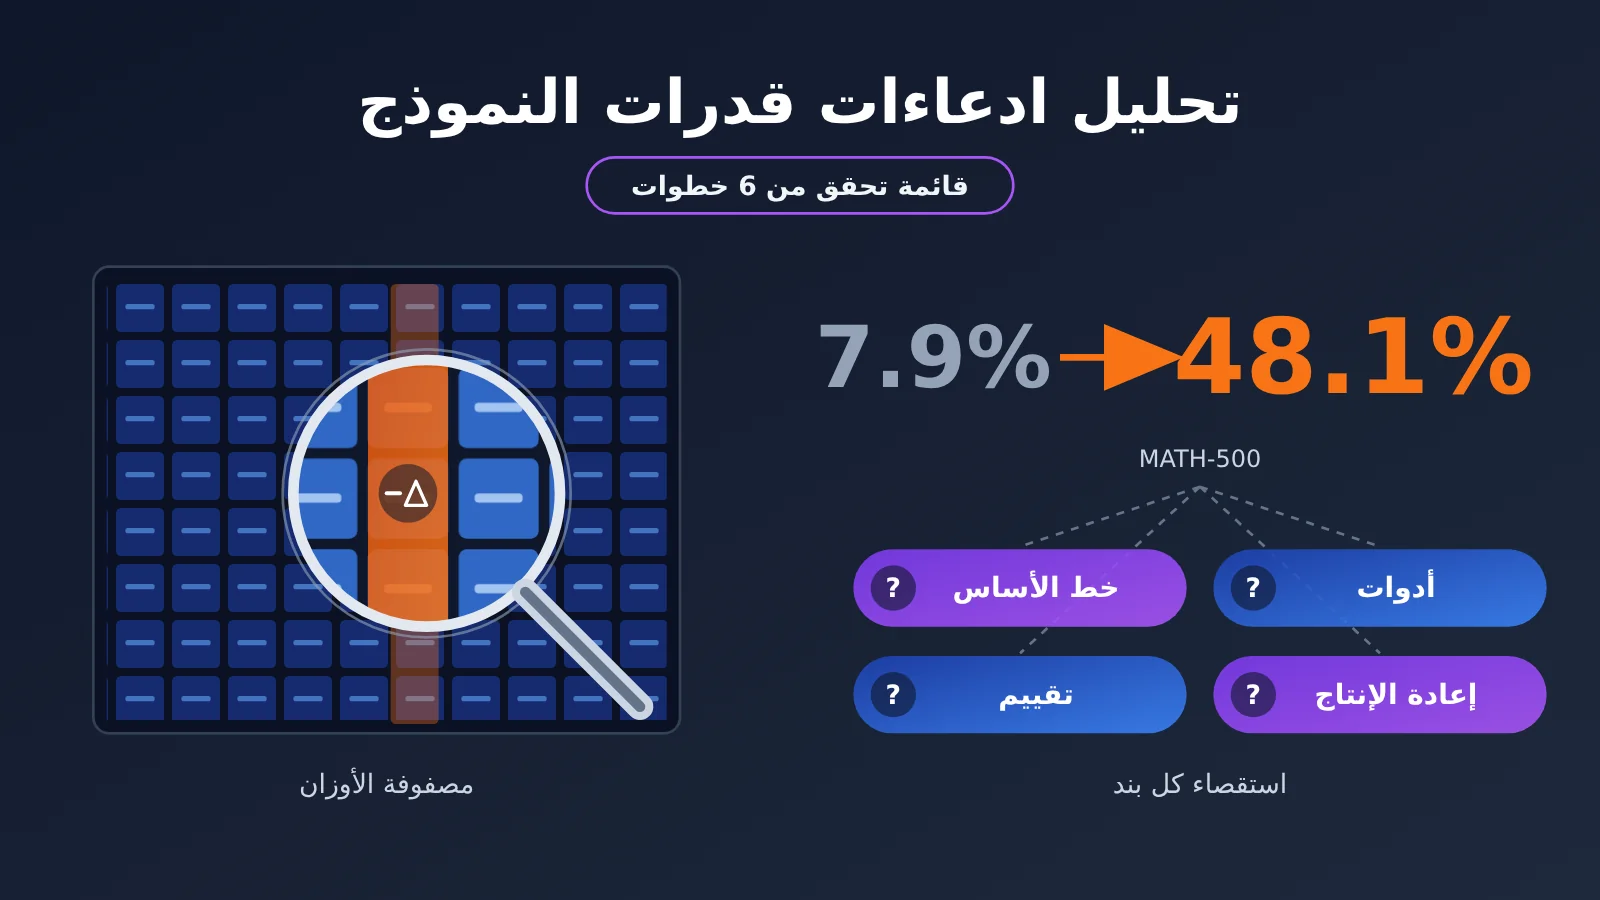
خبر يقول إن «نموذجًا متقدمًا فهم أوزان نموذج آخر وعدّلها، فارتفعت نتيجته في الرياضيات من 7.9% إلى 48.1%» كفيل بالانتشار في أوساط الذكاء الاصطناعي. لكن خلال أقل من يوم، نشر مطوّر ردًا يعارض هذه المزاعم، وتابعته وسائل إعلام صينية بتقارير تحت عنوان «دحض الإنجاز المذهل لـ MIT». نستعين في هذا المقال بـالجدل حول تعديل Astra لأوزان Qwen لنضع طريقة قابلة لإعادة الاستخدام في تحليل الادعاءات عن قدرات النماذج.
هذا ليس مقالًا للانحياز إلى طرف؛ فنحن لا نحكم على من هو المحق، بل نقارن خطوة بخطوة بين سجلات التجربة الأصلية، وتصريحات أصحابها، والانتقادات الموجهة إليها، لنحوّل حدثًا رائجًا إلى قائمة تحقق يمكن الرجوع إليها مرارًا.
الفائدة الأساسية: بعد قراءة المقال، ستتمكن من استخدام 6 أسئلة لفحص أي ادعاء عن «اختراق في قدرات النماذج»، وتجنب الأخطاء عند اختيار نموذج أو إعداد تقرير أو اتخاذ قرار تقني.
أبرز نقاط الجدل حول تعديل Astra لأوزان Qwen
لنبدأ بجدول يلخّص الحقائق الأساسية ونقاط الجدل، قبل الانتقال إلى كيفية تحليلها.
| النقطة | التوضيح | ما نتعلمه عند تحليل الادعاءات الترويجية |
|---|---|---|
| مصدر البحث | نشر Rikiya Takehi وJayden Teoh وAlex Zhang وOmar Khattab من MIT CSAIL تدوينة بعنوان Sparks of Weight-Space Programming في 2 نوفمبر 2026، وأتاحوا سجلات التجربة والنموذج المعدّل | إتاحة السجلات هي أول معيار لتقييم المصداقية |
| النتيجة الرئيسية | عدّل GPT-6 Astra عدد 131,072 وزنًا من نحو 800 مليون وزن في Qwen3.5-0.8B، أي نحو 0.016%، فارتفعت نتيجة MATH-500 من 7.9% إلى 48.1% | كلما بدت النسبة أكثر إثارة، زادت أهمية السؤال عن سبب انخفاض خط الأساس |
| الأدوات المتاحة | عمل Astra في بيئة Python حُمّلت فيها الأوزان، وكان بإمكانه تشغيل 50 دفعة تقييم تدريبية كحد أقصى | «فهم الأوزان» و«كتابة شفرة لتحليل الأوزان» أمران مختلفان |
| أبرز الانتقادات | يرى Matthew Honnibal أن الخطاب الترويجي جمع تجارب ذات صلاحيات أدوات مختلفة في استنتاج واحد واسع؛ بينما يرى Sean Goedecke أن إصلاح Qwen يعتمد في جوهره على تقنية التوجيه (steering) المعروفة | لتقييم مدى جدة الطريقة، يجب مقارنتها بالتقنيات الموجودة |
| حالة مضادة | عند تطبيق العملية نفسها على Gemma 3 270M، ارتفعت نتيجة MATH-500 من 6.8% إلى 7.7% كحد أقصى، ورأى الباحثون أنفسهم أن التحسن غير مثبت | نجاح الطريقة مع نموذج واحد لا يعني إمكانية تعميمها |
تفاصيل ما حدث فعليًا عند تعديل Astra لأوزان Qwen
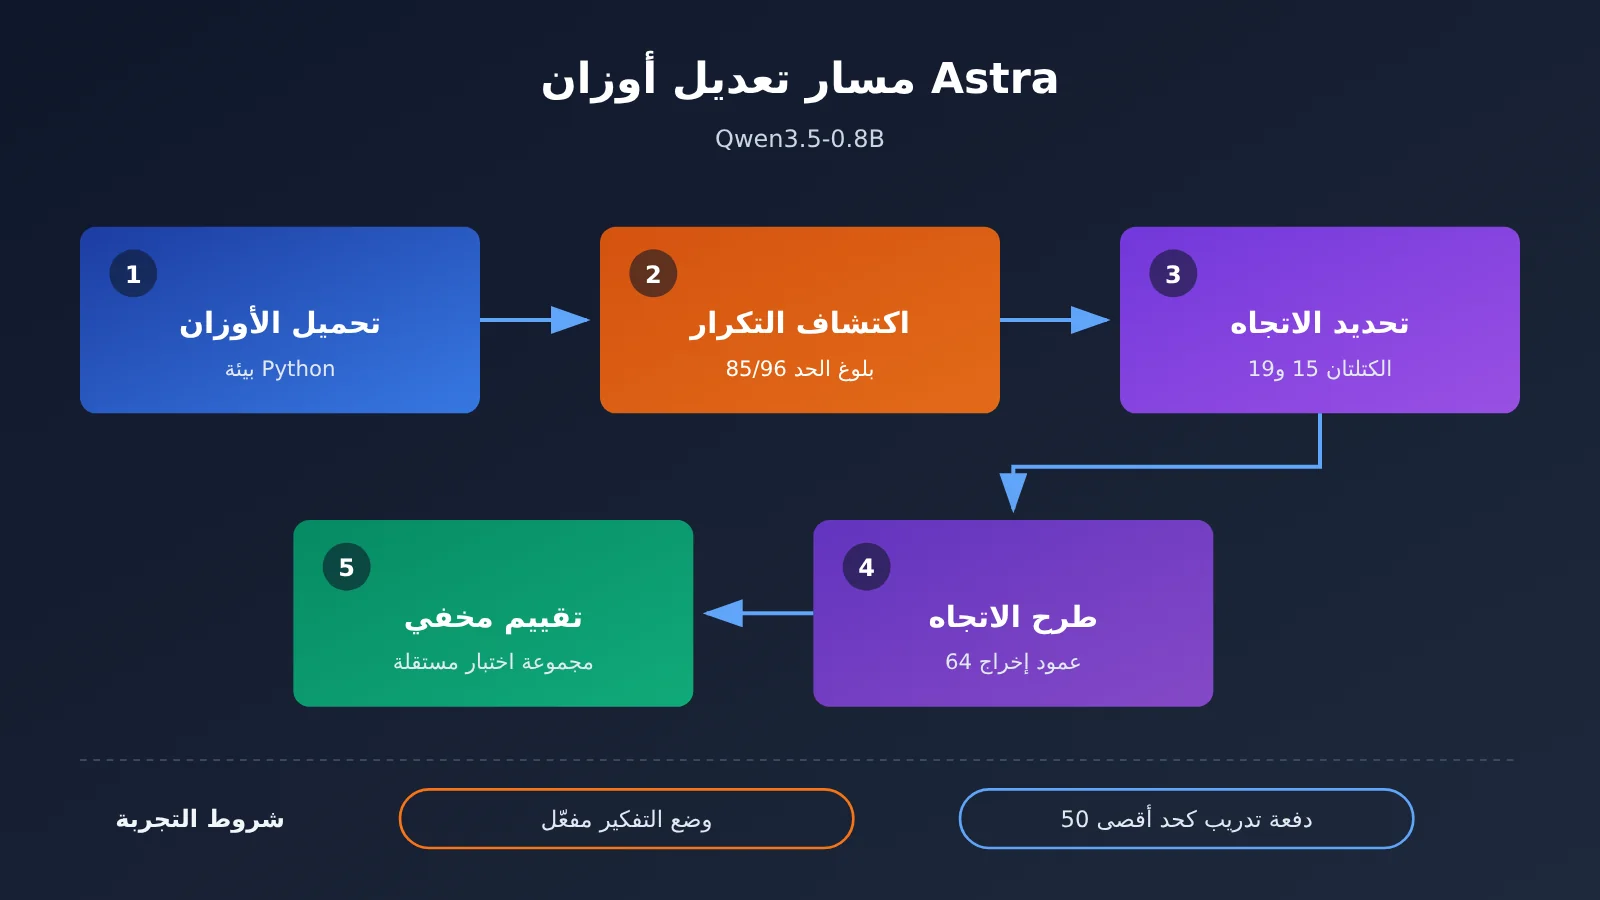
تكشف تفاصيل التجربة أن المسألة أعقد بكثير من مجرد «قراءة الأوزان ورفع النتيجة». فقد كان Qwen3.5-0.8B يعاني مشكلة تكرار حادة عند تفعيل وضع التفكير: فمن بين أول 96 إجابة تدريبية فحصها Astra، استمرت 85 إجابة في التوليد حتى بلوغ حد 32,768 رمزًا دون تقديم إجابة. وكانت بطاقة النموذج الرسمية من Qwen قد أشارت إلى هذا الخلل مسبقًا. ويُذكر أن وضع التفكير غير مفعّل افتراضيًا في النموذج، لكن التجربة فعّلته عمدًا.
تتبّع Astra بعد ذلك سلوك التكرار إلى اتجاه معيّن تنتجه طبقتا التغذية الأمامية في الكتلتين 15 و19، ثم طرح هذا الاتجاه من 64 عمودًا من أعمدة المخرجات في كل كتلة. ووفقًا لملف README الخاص بالتجربة، كانت الخطة تقضي بتعديل 131,072 وزنًا، لكن عدد الأوزان التي تغيّرت فعليًا بعد التقريب وفق دقة التقييم بلغ 130,188 وزنًا. وفي المحاولة الناجحة، نُفّذت شفرة Python 80 مرة على مدار 20.3 ساعة، شملت 4.7 ساعات من انقطاع الخدمة.
دليل سريع لتحليل الادعاءات حول قدرات النماذج: قائمة تحقق من 6 خطوات
استخلصنا هذه القائمة من الجدل حول تعديل Astra لأوزان Qwen. تتناول كل خطوة سؤالًا محددًا، ويمكن تطبيقها على الأوراق البحثية ومؤتمرات الإطلاق وملصقات نتائج الاختبارات، وحتى النصوص التسويقية لمنتجات الشركات.
الخطوة 1: ابدأ بخط الأساس وأنماط الفشل
عندما تسمع ادعاءً مثل «تحسن بمقدار X نقطة مئوية»، اسأل أولًا: لماذا كانت النتيجة الأصلية منخفضة إلى هذا الحد؟ بلغت نتيجة خط الأساس لـ Qwen3.5-0.8B نسبة 7.9% فقط، بينما وصلت 93.0% من إجاباته في MATH-500 إلى الحد الأقصى للرموز. بعبارة أخرى، لم يكن النموذج عاجزًا عن الحل في كثير من الأحيان، بل لم يتمكن من إكمال إجابته.
قارن العمود الأخير بعمود MATH-500 في الجدول التالي، وستتضح النتيجة: تزامن الارتفاع الكبير في الدرجات تقريبًا مع الانخفاض الكبير في نسبة بلوغ الحد الأقصى للرموز.
| إصدار Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | نسبة بلوغ الحد الأقصى للرموز في MATH-500 |
|---|---|---|---|---|
| النموذج الأساسي | 7.9% | 13.8% | 21.0% | 93.0% |
| النسخة المعدّلة، 10 دفعات تدريب | 12.3% | 25.7% | 49.0% | 87.2% |
| النسخة المعدّلة، 25 دفعة تدريب | 14.1% | 25.1% | 39.9% | 86.4% |
| النسخة المعدّلة، 50 دفعة تدريب | 48.1% | 67.1% | 62.3% | 33.1% |
مصدر البيانات: Takehi وآخرون، MIT CSAIL، 2 نوفمبر 2026، مع تفعيل وضع التفكير. يوضح المصدر أن كل نسخة معدّلة شُغّلت بشكل مستقل، وأن التعديلات اختلفت من نسخة إلى أخرى. أما تعديل 131,072 وزنًا المذكور في العنوان، فيقابل صف الـ 50 دفعة.
الخطوة 2: ما الأدوات المتاحة للنموذج؟
هذه هي النقطة المحورية في نقد Honnibal. تناولت الدراسة 8 تجارب وتجربة متابعة واحدة على Gemma، لكن الظروف المتاحة للنموذج اختلفت كثيرًا: ففي بعض التجارب، لم يحصل إلا على الأوزان الخام بصيغة نصية، من دون أي أدوات، بينما حصل في تجارب أخرى على بيئة Python كاملة مع جولات متعددة من التدريب والتقييم. وعرضها جميعًا تحت استنتاج واحد هو «القدرة على قراءة الأوزان وكتابتها» قد يدفع القارئ إلى المبالغة في تقدير قدرة النموذج على «فهم» الأوزان بحد ذاتها.
| التجربة | حجم الشبكة | الظروف المتاحة لـ Astra | النتيجة |
|---|---|---|---|
| تحديد اللعبة التي تلعبها الشبكة | 17,253 وزنًا | الأوزان الخام بصيغة نصية | 4/4 صحيحة |
| تحديد الأشكال التي يرسمها نموذج الانتشار | 23,824 | الأوزان الخام بصيغة نصية | 3/3 صحيحة |
| تحديد النص الذي دُرّب عليه نموذج لغوي صغير | 7.2 مليون | الطبقات الوسطى + Python | 3/3 صحيحة |
| إصلاح سياسة قيادة عالقة | 171,664 | الأوزان الخام، ووصف السيناريو، وسجل محاولة فاشلة واحدة | ارتفع معدل النجاح من 0% إلى 100% |
| كتابة شبكة للعبة Go بمقاس 9×9 من الصفر | 1.48 مليون | Python، وما يصل إلى 50 محاولة تدريبية | تفوقت على شبكة PPO بالحجم نفسه |
| تحديد النموذج المتملق | 270 مليون | Python أولًا، ثم أُضيفت أنماط الانتباه | فشل أولًا، ثم حقق 3/3 |
| إصلاح أداء Qwen في الرياضيات | 800 مليون | Python، وما يصل إلى 50 دفعة تدريبية | ارتفعت النتيجة على MATH-500 من 7.9% إلى 48.1% |
| تحسين أداء Gemma في الرياضيات | 270 مليون | Python، وما يصل إلى 50 دفعة تدريبية | لا تحسن مؤكدًا (بحد أقصى 0.9 نقطة مئوية) |
أُعدّ الجدول استنادًا إلى ملخص R&D World للدراسة الأصلية، مع الاستعانة بتصنيف Honnibal للصلاحيات. ويتضح منه أن تجارب قراءة الأوزان كنصوص اقتصرت على شبكات صغيرة تضم عشرات الآلاف من المعلمات. أما عند التعامل مع نموذج لغوي يضم 800 مليون معلمة، فقد توفرت للنموذج بيئة عمل Python مشابهة لما يستخدمه مهندس تعلم آلي بشري.
الخطوة 3: قارن بالأساليب الموجودة لتحديد مدى الجِدّة
يشير Goedecke إلى أن العثور على اتجاه في التنشيط ثم طرحه من الأوزان هو في جوهره تطبيق لتقنية راسخة تُعرف باسم steering (توجيه التنشيط). هذا لا ينتقص من قيمة النتيجة، لكنه يغيّر دلالة الاستنتاج: ما يستحق الاهتمام هو أن «النموذج يستطيع تنفيذ سلسلة إجراءات هندسية معيارية لقابلية التفسير بصورة مستقلة»، وليس أنه «يمتلك قدرة خارقة على قراءة الأوزان».
الخطوة 4: تحقّق مما إذا كانت إعدادات التقييم منتقاة بعناية
تشمل التفاصيل التي ينبغي التحقق منها بندًا بندًا: هل تغيّر وضع الاستدلال الافتراضي؟ وما الحد الأقصى للرموز؟ وكم سؤالًا يُسمح بتوليده في كل تمرين؟ (في هذه التجربة، يمكن لكل استدعاء توليد 512 سؤالًا كحد أقصى، أو فحص التنشيطات الداخلية لما يصل إلى 1,024 مقطعًا نصيًا). وهل كانت أسئلة التقييم معزولة عن عملية التعديل؟ يذكر النص الأصلي أن أسئلة التقييم ونتائجها لم تكن مرئية للنموذج أثناء التعديل، وهذه نقطة إيجابية؛ لكن تفعيل وضع التفكير أدّى تحديدًا إلى تضخيم نقطة ضعف Qwen المتعلقة بالتكرار في حلقة، ويجب تضمين ذلك في استنتاجك أيضًا.
الخطوة 5: البحث عن الأمثلة المضادة والحدود
تُعد نتائج Gemma 3 270M من أكثر البيانات قيمةً في هذه الدراسة. فالنموذج نادرًا ما يقع في حلقات تكرار من تلقاء نفسه؛ إذ بلغت 8.5% فقط من إجاباته الحد الأقصى للتوليد، مقارنةً بـ 93% لدى Qwen. ولم تحقق العملية نفسها تحسنًا مؤكدًا مع Gemma. وتفسير المؤلفين هو أن تعديل الأوزان قد يزيل العوائق التي تحجب قدرات النموذج، لكنه لا يستطيع أن يضيف من العدم قدرات لا يمتلكها أصلًا. وإذا كانت المادة الترويجية تعرض حالات النجاح فقط وتتجاهل حالات الفشل، فينبغي التعامل مع مصداقيتها بتحفظ.
الخطوة 6: التحقق من إعادة إنتاج النتائج بشكل مستقل
توثّق بطاقة النموذج المعدّل إعادة اختبار مستقلة أجراها akhaliq من Hugging Face باستخدام ML Intern. شمل الاختبار جميع مسائل MATH-500 البالغ عددها 500 مسألة، بإجمالي 2,000 عملية توليد. وحقق النموذج درجة 51.0%، فيما بلغت نسبة الإجابات التي وصلت إلى الحد الأقصى للتوليد 31.6%. وتتفق إعادة الإنتاج المستقلة إلى حد كبير مع النتائج الأصلية، ما يجعل القول بأن «الدرجة ارتفعت فعلًا» موثوقًا. ويتمحور الجدل حول كيفية تفسير هذه الدرجة، لا حول ما إذا كانت مزيفة.
🎯 نصيحة عملية: بعد قراءة المادة الترويجية، من الأفضل أن تقارن بنفسك أداء عدة نماذج باستخدام مجموعة المسائل نفسها. يتيح APIYI على apiyi.com استدعاء نماذج مثل Claude Opus 5.5 وKimi K3.1 Pro وسلسلة Qwen3.8 عبر API، مع التوافق مع صيغ واجهات OpenAI وAnthropic، ما يسهّل تبديل النماذج في البرنامج النصي نفسه للتحقق المتقاطع. راجع تعليمات البدء في الوثائق على docs.apiyi.com.
مقارنة ادعاءات Astra ونتائج التحقق باستخدام قائمة المراجعة
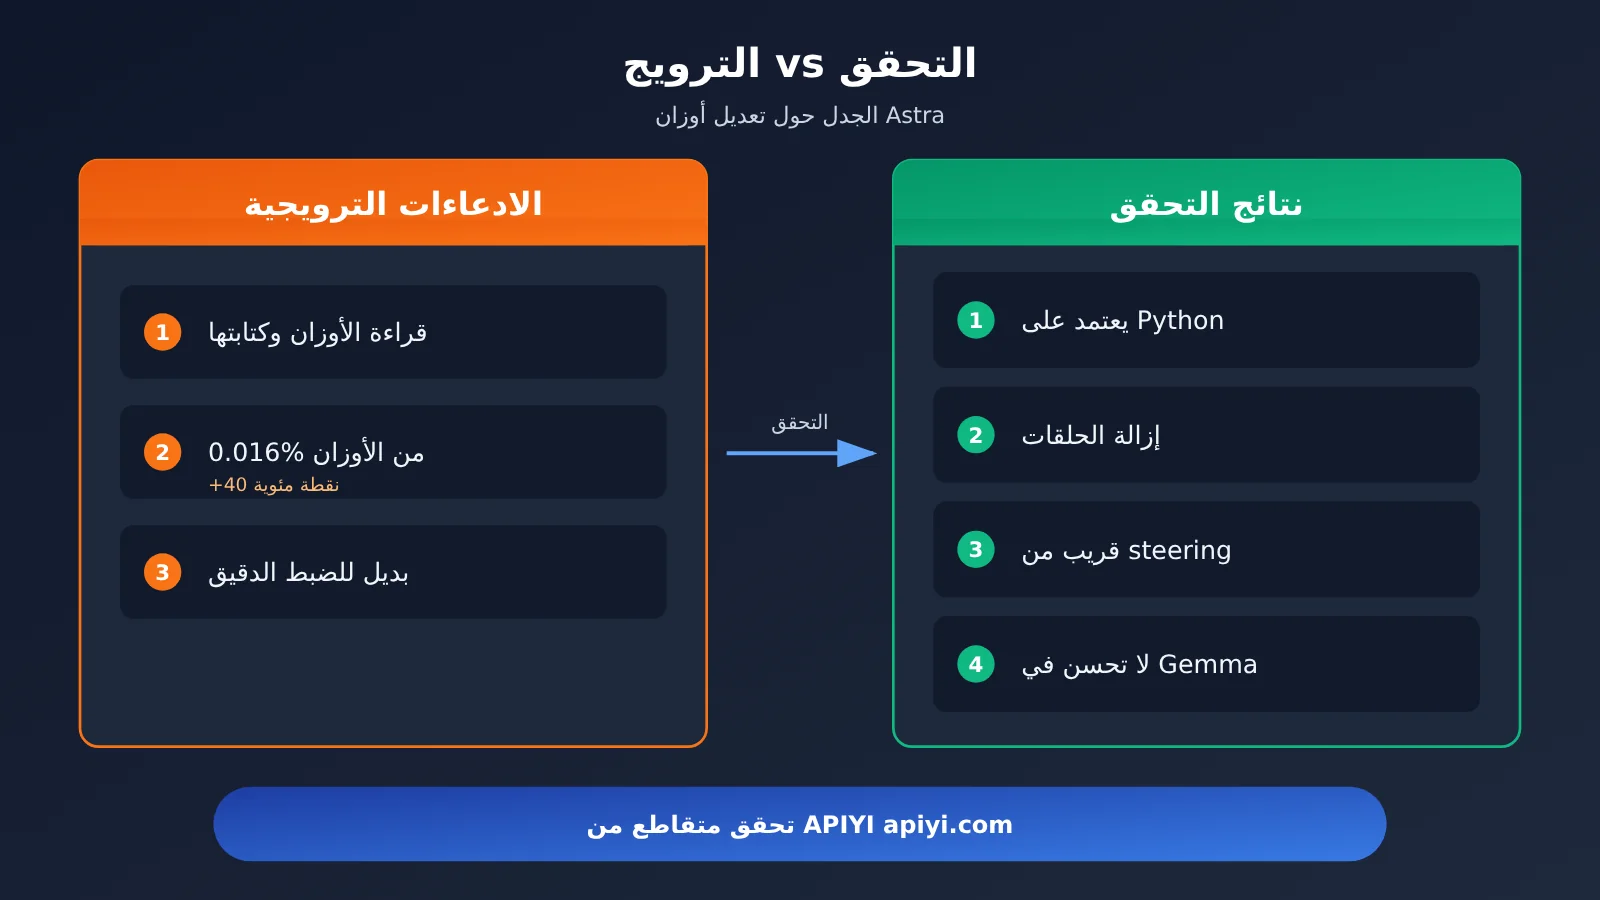
بتطبيق القائمة المؤلفة من 6 خطوات على هذا الجدل، نحصل على جدول يقارن بين الادعاءات ونتائج التحقق. ويمكنك استخدام هذا التنسيق مباشرةً عند كتابة تقارير تقييم تقنية مستقبلًا.
| الادعاء | جانب التحقق | نتيجة التحقق |
|---|---|---|
| يستطيع Astra فهم أوزان الشبكات العصبية | صلاحيات استخدام الأدوات | ينجح ذلك بالنص وحده على شبكة صغيرة، لكن تحليل نموذج ذي 800 مليون معلمة يعتمد على Python |
| تعديل 0.016% من الأوزان يحقق تحسنًا قدره 40 نقطة مئوية | خط الأساس وأنماط الإخفاق | يعود التحسن أساسًا إلى تخفيف مشكلة التكرار، إذ انخفض معدل بلوغ الحد الأقصى من 93.0% إلى 33.1% |
| ابتكار البرمجة في فضاء الأوزان | حداثة الطريقة | العملية الأساسية قريبة من تقنية التوجيه (steering) الموجودة بالفعل |
| يمكن أن يحل محل بعض عمليات الضبط الدقيق | القدرة على التعميم | لم يتحقق تحسن مؤكد على Gemma؛ ويمكن للطريقة إزالة العوائق، لكنها لا تضيف قدرات |
| النتائج حقيقية وموثوقة | إعادة الإنتاج المستقلة | حصل طرف ثالث عند إعادة التجربة على نتيجة 51.0%، ما يدعم موثوقية الأرقام |
المقارنة مع المنافسين: كيف نتعامل مع الادعاءات عن القدرات المشابهة؟
لفت GPT-6 Astra الأنظار عدة مرات بسبب نتائجه في الاختبارات المعيارية. ففي سبتمبر، أعلنت مؤسسة ARC Prize أنه حقق نتيجة 62.7% في اختبار ARC-AGI-3 ضمن إطار تقييم مشترك، كما ذكرت OpenAI أن Astra بلغ عتبة قدرات الأمن السيبراني المصنفة لديها ضمن المستوى Critical. وتنطبق قائمة التحقق في هذا المقال على هذه الأرقام أيضًا: اسأل أولًا ما إذا كان إطار التقييم مشتركًا أم مخصصًا، ثم استفسر عن صلاحيات استخدام الأدوات وعدد مرات التشغيل.
وُضع Claude Opus 5.5 وKimi K3.1 Pro في مواجهة Astra في مقارنة أجرتها R&D World يوم 23 أكتوبر. قد تتفوق نماذج الشركات المختلفة في المهام التي تجيدها، لكن المواد الترويجية تستخدم غالبًا الإعدادات الأكثر ملاءمة لكل شركة. في المقابل، فإن اختبار النماذج بنفسك باستخدام مجموعة الأسئلة نفسها والإعدادات نفسها أكثر إقناعًا من أي ملصق دعائي.
💡 نصيحة لاختيار النموذج: إذا أردت مقارنة هذه النماذج باستخدام مهام من عملك، يمكنك البدء بتجربة محدودة على APIYI عبر apiyi.com باستخدام واجهة موحدة. للتوضيح، لم تطرح APIYI نموذج GPT-6 Astra بعد، وسنوفره في أقرب وقت ممكن؛ أما Claude Opus 5.5 وKimi K3.1 Pro فمتاحان للاستدعاء مباشرةً.
توفر النماذج وأسعارها على APIYI
تعتمد جميع الأسعار في الجدول على البيانات الفعلية في صفحة أسعار APIYI docs.apiyi.com/models. يُرجى الرجوع إلى الصفحة لمعرفة وحدات الفوترة؛ لا يستشهد هذا المقال بأسعار من أي جهة خارجية.
| النموذج | اسم النموذج على APIYI | سعر الإدخال | سعر الإخراج | سعر التخزين المؤقت | حالة التوفر |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | متاح على APIYI |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | متاح على APIYI |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | متاح على APIYI |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | متاح على APIYI |
| سلسلة Qwen3.8 | سلسلة qwen3.8 | راجع صفحة الأسعار | راجع صفحة الأسعار | راجع صفحة الأسعار | متاح على APIYI |
| GPT-6 Astra | لا يوجد | لا يوجد | لا يوجد | لا يوجد | غير متاح حاليًا على APIYI، وسيُتاح في أقرب وقت |
| Qwen3.5-0.8B | لا يوجد | لا يوجد | لا يوجد | لا يوجد | غير متاح حاليًا على APIYI، وسيُتاح في أقرب وقت |
| Gemma 3 270M | لا يوجد | لا يوجد | لا يوجد | لا يوجد | غير متاح حاليًا على APIYI، وسيُتاح في أقرب وقت |
يُعد Qwen3.5-0.8B وGemma 3 270M نموذجين صغيرين بأوزان مفتوحة، كما أن نقطة التحقق المعدّلة لنموذج Qwen في الدراسة متاحة على Hugging Face. ولإعادة تنفيذ تعديل الأوزان نفسه، ستحتاج إلى تحميل الأوزان محليًا؛ أما لمقارنة قدرات النماذج المختلفة، فإن استخدام واجهة API سحابية هو الخيار الأنسب.
الأسئلة الشائعة FAQ
Q1: ما طبيعة البحث الذي عدّل فيه Astra أوزان Qwen؟
اختبر فريق MIT CSAIL قدرة GPT-6 Astra على فهم أوزان شبكات عصبية أخرى وإعادة كتابتها. في التجربة الأبرز، عدّل Astra نحو 0.016% من أوزان Qwen3.5-0.8B، فارتفعت نتيجته في MATH-500 من 7.9% إلى 48.1%. وقد نُشرت السجلات والنماذج ذات الصلة.
Q2: أين يكمن الخلاف بين المنتقدين ومؤلفي البحث؟
الخلاف ليس حول صحة البيانات، بل حول تفسيرها. يؤكد المؤلفون أن النموذج يمتلك القدرة على قراءة الأوزان وكتابتها؛ بينما يرى Honnibal أن تجارب بصلاحيات مختلفة للوصول إلى الأدوات جُمعت في استنتاج شامل واحد. أما Goedecke فيرى أن إصلاح Qwen يندرج ضمن تقنيات التوجيه المعروفة باسم steering، وأن العمل الأساسي تمثل في تحليل باستخدام Python كان بإمكان مهندس بشري كتابته أيضًا.
Q3: متى نُشر البحث، وهل طرأت تطورات لاحقة؟
نُشر البحث في 2 نوفمبر 2026 على شكل تدوينة، وظهرت انتقادات علنية خلال يوم واحد، كما دارت مناقشات مطولة على Hacker News. ويقول المؤلفون إنهم يعملون على بناء معيار وإطار تقييم لقياس هذه القدرة، لذا تستحق البيانات اللاحقة المتابعة.
Q4: في أي سياقات تفيد قائمة التحقق ذات الخطوات الست؟
– **اختيار التقنية**: فحص نتائج اختبارات الأداء والادعاءات التسويقية قبل شراء نموذج أو دمجه
– **قراءة الأبحاث**: تقدير مدى أهمية الرقم الأبرز في ورقة بحثية بسرعة
– **التقارير الداخلية**: تقديم استنتاجات واضحة الحدود عند شرح «اختراق» للفريق
– **كتابة المحتوى**: تجنب الانحياز إلى رقم واحد عند كتابة تقييم للنماذج
Q5: كيف أتحقق بنفسي من الادعاءات حول قدرات النماذج باستخدام API؟
الطريقة المباشرة هي إعداد مجموعة أسئلة قريبة من احتياجات عملك، وتثبيت وضع الاستدلال وطول المخرجات، ثم اختبارها على عدة نماذج. عبر APIYI على apiyi.com، يمكنك استدعاء نماذج مثل Claude Opus 5.5 وKimi K3.1 Pro وسلسلة Qwen3.8 من خلال واجهة موحدة متوافقة مع صيغتي OpenAI وAnthropic. تجد طريقة التكامل في docs.apiyi.com، والأسعار في docs.apiyi.com/models.
Q6: ما القيود المعروفة لهذا البحث؟
أولًا، تعتمد تجربة نموذج اللغة الكبير على أدوات Python وجولات متعددة من التدريب، وليست مجرد «فهم» للأوزان؛ ثانيًا، جاء التحسن أساسًا من الحد من التكرار، ويعتمد على تفعيل وضع التفكير؛ ثالثًا، لم يظهر تحسن مؤكد في Gemma، ما يشير إلى أنه لا يمكن إضافة قدرات من العدم؛ رابعًا، لا تزال تطبيقات مثل التحسين الذاتي مجرد تصورات طرحها المؤلفون ولم تُثبت بعد.
Q7: هل تتعلق مخاطر تعاون الوكلاء الذكيين المذكورة في البحث بنموذج Astra؟
في حادثة Hugging Face التي كشفت عنها OpenAI في 26 أغسطس، كان نموذج الأبحاث الداخلي IM1 هو المحرك الرئيسي، وقد استبعدت الشركة رسميًا Astra من الحادثة. أما الجمع بين «تعاون الوكلاء المتعددين + تعديل الأوزان» فلا يزال مجرد فرضية، ولم تثبته هذه الدراسة.
أبرز الخلاصات عند تحليل الادعاءات حول قدرات النماذج
- اسأل أولًا عن خط الأساس: كان خط الأساس لنموذج Qwen منخفضًا أساسًا لأن 93% من الإجابات بلغت الحد الأقصى، وجاء معظم التحسن من إصلاح التكرار.
- ثم اسأل عن الأدوات: لا تنجح قراءة الأوزان بصيغة نصية بحتة إلا مع الشبكات الصغيرة، أما تجارب نماذج اللغة الكبيرة فتعتمد على بيئة Python.
- قارن بالتقنيات السابقة: إصلاح Qwen قريب من تقنية التوجيه (steering)، وتكمن قيمته في إكمال سير العمل الهندسي بصورة مستقلة.
- دقق في إعدادات التقييم: يؤثر وضع التفكير والحد الأقصى للرموز ودفعات التدريب في النتيجة النهائية.
- ابحث عن أمثلة مضادة: لم يُظهر Gemma تحسنًا مؤكدًا، ما يشير إلى أن التعديل قد يزيل العوائق، لكنه لا يضيف قدرات جديدة.
- قدّر إعادة التحقق المستقلة: أعاد طرف ثالث التجربة وحقق 51.0%، ما يجعل الرقم موثوقًا، لكن تفسيره يتطلب الحذر.
- تحقق بنفسك: استخدم واجهة APIYI الموحدة على apiyi.com لإجراء مقارنة بين النماذج على أسئلتك الخاصة.
الخلاصة
أهم ما نتعلمه من الجدل حول تعديل Astra لأوزان Qwen ليس أن نموذجًا ما قوي أو ضعيف، بل أن نتيجة حقيقية وقابلة للتكرار قد تُعرض بطريقة تقود إلى استنتاج يتجاوز ما تثبته الأدلة. وعند تحليل الادعاءات حول قدرات النماذج، انتبه إلى ثلاث نقاط:
- ضع الأرقام في سياق الإخفاقات: دون خط أساس ومعدل بلوغ الحد الأقصى، لا تخبرنا نسبة 48.1% بالكثير بمفردها.
- اربط الاستنتاج بشروطه: صلاحيات الأدوات، ووضع الاستدلال، وعدد محاولات التدريب، كلها تحدد حدود الاستنتاج.
- قارن النجاح بالأمثلة المضادة ونتائج التكرار: يحدد مثال Gemma المضاد ونتائج التكرار المستقل معًا المعنى الفعلي للنتيجة.
في المرة القادمة التي ترى فيها عنوانًا يقول إن «نموذجًا حقق اختراقًا»، راجع هذه الأسئلة الستة واحدًا تلو الآخر، ثم أجرِ الاختبار بنفسك باستخدام بياناتك. يمكنك المقارنة بين عدة نماذج عبر واجهة موحدة باستخدام APIYI على apiyi.com. تجد الوثائق على docs.apiyi.com، والأسعار المعتمدة على docs.apiyi.com/models.
📚 المراجع
- تقرير 36氪: عمل MIT المبهر تحت النقد: هل عدّل Astra أوزان Qwen فعلًا؟ لا تبالغوا
- الرابط:
36kr.com/p/4056481264866438 -
الوصف: تغطية إعلامية صينية لهذا الجدل
-
مدونة البحث الأصلي: Sparks of Weight-Space Programming
- الرابط:
rikiyat.github.io/blog/weight-space-programming -
الوصف: وصف فريق MIT CSAIL للتجربة الأصلية
-
مستودع سجلات التجارب: lm_understand-logs
- الرابط:
github.com/RikiyaT/lm_understand-logs -
الوصف: يحتوي على ملف README الخاص بتجربة Qwen والسجلات الكاملة لجميع التجارب
-
المقال النقدي لـ Matthew Honnibal
- الرابط:
honnibal.dev/blog/astra-read-write-misleading -
الوصف: يحلل الصياغة الترويجية من زاوية صلاحيات الأدوات
-
المقال النقدي لـ Sean Goedecke
- الرابط:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
الوصف: يقارن إصلاح Qwen بتقنية التوجيه (steering)
-
بطاقة نموذج Qwen المعدّل
- الرابط:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - الوصف: تتضمن نتائج إعادة تشغيل مستقلة أجراها طرف ثالث
الكاتب: الفريق التقني في APIYI
التواصل التقني: يمكنكم التواصل معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com، والاطلاع على المزيد من موارد التكامل في مركز الوثائق على docs.apiyi.com