ملاحظة المؤلف: تقارن هذه المقالة بين Gemini 4 Argon وCarbon من حيث جهد الاستدلال وسرعة الاستجابة وتكلفة المهام، لتساعد المطورين على اختيار النموذج المناسب بحسب صعوبة المهمة.
أطلقت Google نموذج Gemini 4 Argon في 13 أكتوبر 2026، ثم أعلنت عن Gemini 4 Carbon لأول مرة في 28 أكتوبر، وفتحته رسميًا للمطورين والشركات والمستهلكين في 10 نوفمبر. وكان أول سؤال خطر لكثير من المطورين: هل Carbon هو النسخة المطوّرة التي ستحل محل Argon؟ في هذه المقالة نقارن الفروق الحقيقية بين Gemini 4 Argon وCarbon من خمسة أبعاد: جهد الاستدلال، وزمن الاستجابة، وتكلفة المهام، وسيناريوهات الاستخدام، ومستويات التفكير.
هذه ليست مقارنة تفترض أن «النسخة الأقوى أفضل دائمًا». توضح وثائق المطورين الرسمية من Google أن Argon ما زال الخيار الموصى به لمعظم أعمال الهندسة والعمل المعرفي، بينما يستهدف Carbon المهام التي تحتاج إلى استدلال أعمق ودورات تحقق أطول. تعتمد هذه المقالة أساسًا على وثائق Google الرسمية، وسنذكر إصدار التقييم ومستوى الاستدلال عند الاستشهاد ببيانات من جهات خارجية.
القيمة الأساسية: بعد قراءة المقالة ستعرف أي المهام تناسب Argon، وأيها تستحق Carbon، وكيف تتحكم في الجودة والسرعة والتكلفة عبر Thinking Level.
7 مصطلحات يجب فهمها قبل المقارنة بين Gemini 4 Argon وCarbon
عند المقارنة بين نموذجي استدلال، تختلط بعض المفاهيم بسهولة. لذلك نفصل بينها أولًا حتى لا تُفهم الأرقام اللاحقة فهمًا خاطئًا:
- مستوى الاستدلال (Thinking Level): إعداد يتحكم في مقدار الجهد الذي يبذله النموذج في التفكير. يوفر Carbon ثلاثة مستويات: LOW وMEDIUM وHIGH.
- رموز التفكير (Thinking Tokens): الرموز (Tokens) التي يولّدها النموذج أثناء الاستدلال، وتُحتسب تكلفتها ضمن رموز المخرجات.
- تكلفة المهمة: إجمالي تكلفة جميع عمليات استدعاء النموذج اللازمة لإنجاز مهمة واحدة، وهي لا تساوي تكلفة طلب واحد.
- زمن الاستجابة: الوقت الذي يمر من لحظة استقبال النموذج للطلب حتى ظهور النتيجة. نركّز في هذا المقال على زمن ظهور أول رمز من الإجابة.
- القراءة من الذاكرة المؤقتة (Cache Read): طريقة احتساب تعتمد على إعادة استخدام سياق مدخلات موجود مسبقًا، وسعرها أقل بكثير من سعر المدخلات العادية.
- الوكيل (Agent): كيان ذكي ينفّذ مهام متعددة الخطوات باستخدام الأدوات، مثل كتابة الشفرة وتشغيل الاختبارات ثم إصلاح الأخطاء.
- الاختبار المعياري (Benchmark): طريقة لتقييم النماذج ومقارنتها عبر مجموعة ثابتة من المهام، وتصحّ نتائجه فقط على إعدادات الاختبار نفسها.
لماذا أطلقت Google نموذجي Gemini 4 Argon وCarbon معًا
وفق بطاقة النموذج التي نشرتها Google DeepMind، فإن Gemini 4 Carbon مبني على Gemini 4 Argon. أي أن للنموذجين أساسًا مشتركًا، وأن Carbon نسخة عُزّزت فوق هذا الأساس للاستدلال الصعب، وهندسة البرمجيات المعقدة، وسير عمل الوكلاء طويل المدى، والأبحاث العلمية، والدفاع في مجال الأمن السيبراني. وتجدر الإشارة إلى أن Google لم تكشف عدد معاملات Carbon، ولم تنشر الفروق في البنية الحسابية الداخلية بين النموذجين، ولذلك لا يوجد أي أساس للقول إن Carbon أكبر من Argon بعدة أضعاف.
وما دام Carbon أقوى، فلماذا لا يحلّ محل Argon مباشرة؟ السبب أن كلًّا منهما يخدم نوعًا مختلفًا من العمل. فتطوير الميزات اليومي وتعديلات الشفرة المتكررة يحتاجان قبل كل شيء إلى سرعة الاستجابة وإلى خفض عدد الرموز المستهلكة في كل جولة. أما تصميم البنية، والتحقيق في الأسباب الجذرية التي تمتد عبر عدة أنظمة فرعية، والإثباتات العلمية، فتحتاج إلى نموذج قادر على طرح الفرضيات والتحقق منها وتصحيحها مرارًا. وتوصية Google في وثائق المطورين تقوم على توزيع الأدوار لا الاستبدال: يتولى Argon معظم الأعمال الهندسية اليومية، ويتولى Carbon مهام الاستدلال الأصعب والأطول مدى.
ويظهر هذا التوزيع في منتجات Google نفسها. ففي ميزة المعاينة متعددة الوكلاء /swarm في Antigravity، تقترح Google أن يتولى Carbon تصميم البنية العامة وتنسيق المهام ومراجعة الأمان، بينما تُسند كتابة الشفرة المعتادة وتعديل الملفات بالتوازي إلى نماذج أسرع وأخف. والأمر نفسه على مستوى المستهلكين: فاشتراك Google AI Pro يمنح الوصول إلى Argon بالدرجة الأولى، أما Carbon فيتوفر ضمن اشتراك Ultra.
الفرق الجوهري بين Gemini 4 Argon وCarbon: حجم الاستدلال في كل جولة
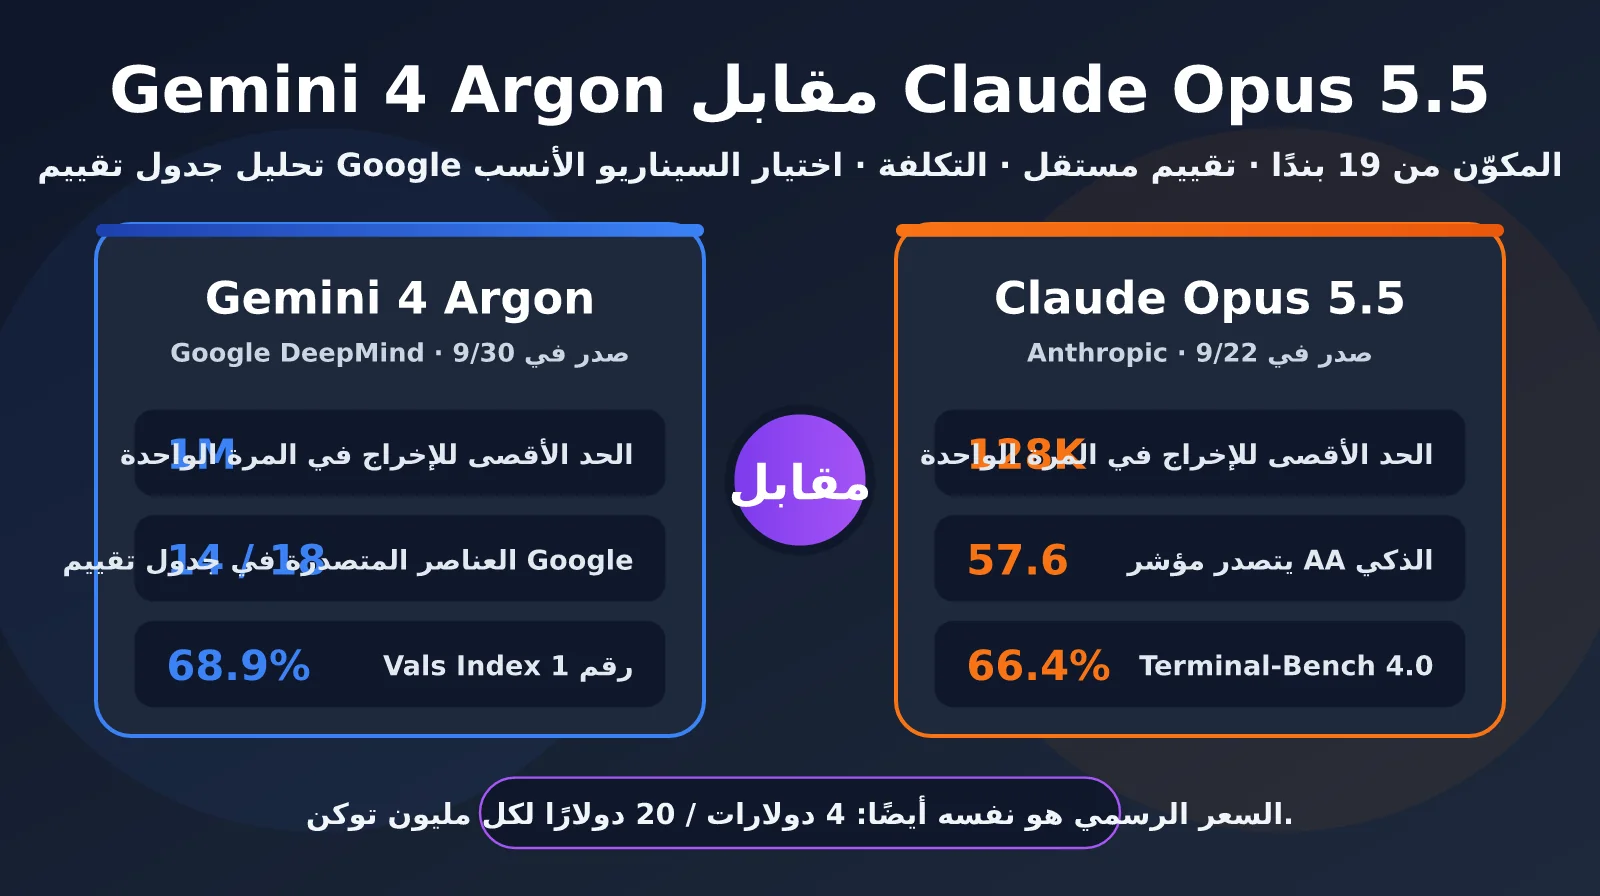
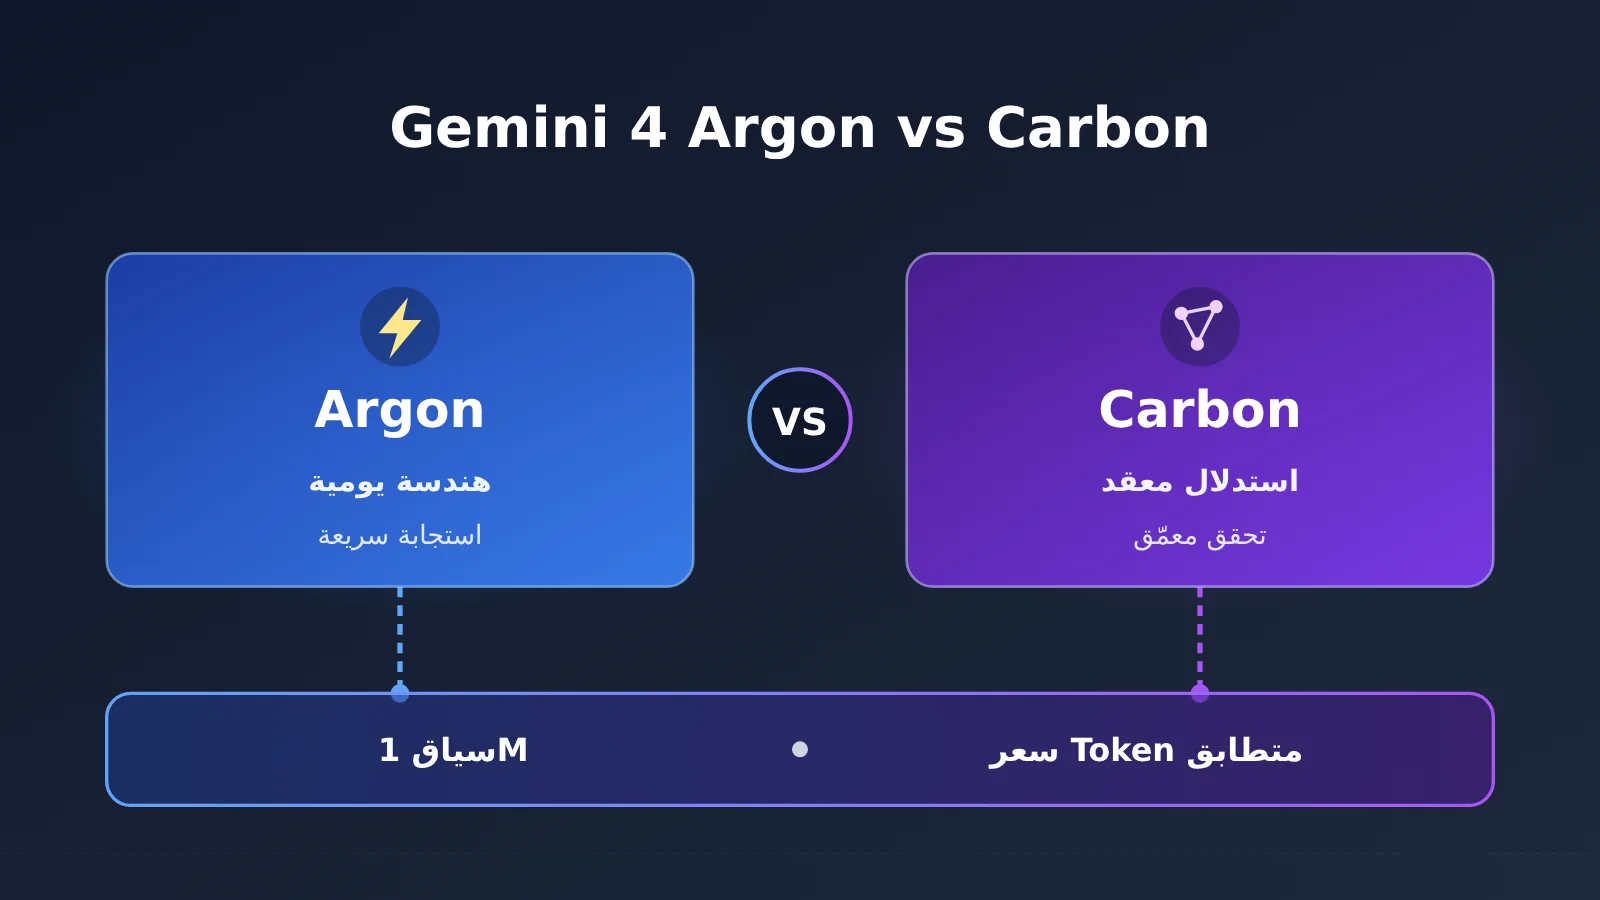
يقدّم دليل مطوّري Carbon من Google، في قسم “Choosing between Carbon and Argon”، أبسط تفسير للفرق بين النموذجين. فـ Carbon يستهلك في كل جولة عددًا أكبر من رموز التفكير (Tokens) ليستكشف عمله ويتحقق منه بصورة أوسع. أما Argon فيستجيب بسرعة أكبر ويستهلك رموزًا أقل في الجولة الواحدة، ما يناسب البرمجة التفاعلية وتطوير الميزات اليومية. ويشترك النموذجان في نافذة سياق موحّدة بحجم 1M رمز (1,048,576 رمزًا، تُشارَك بين المدخلات والمخرجات)، وفي قدرات الأدوات المدمجة، ويتبعان سعر الرمز نفسه.
| وجه المقارنة | Gemini 4 Argon | Gemini 4 Carbon | الأنسب |
|---|---|---|---|
| التموضع | نموذج استدلال عام عالي الأداء والكفاءة | نموذج استدلال أعمق للمهام المعقدة | حسب المهمة |
| رموز التفكير في كل جولة | أقل نسبيًا | أكثر في كل جولة | Argon أوفر |
| سرعة الاستجابة | أسرع | أبطأ في المهام المعقدة | Argon |
| التطوير التفاعلي | أنسب | يمكن استخدامه للمهام الصعبة | Argon |
| تطوير الميزات اليومية | موصى به | غير ضروري عادةً | Argon |
| تصميم البنية والبحث عن السبب الجذري | قادر على تنفيذها | أنسب للتحقيقات شديدة التعقيد والعميقة | Carbon |
| الإثباتات العلمية والتدقيق الأمني | قادر على تنفيذها / مدعوم | أنسب للاستدلال المعقد والتحقق | Carbon |
| السياق وسعر الرمز | سياق مشترك 1M، والسعر نفسه | سياق مشترك 1M، والسعر نفسه | متساويان |
يتضح من الجدول أن الخط الفاصل بين Gemini 4 Argon وCarbon ليس “هل يستطيع النموذج إنجاز المهمة؟” بل “هل يستحق الأمر مزيدًا من التفكير؟”. فـ Argon قادر على تصميم البنية والبحث عن السبب الجذري، لكن حين تتعقد المشكلة وتتطلب جولات متعددة من الفرضيات والتحقق، يكون Carbon مستعدًا لإنفاق رموز تفكير أكثر مقابل نتيجة أكثر موثوقية.
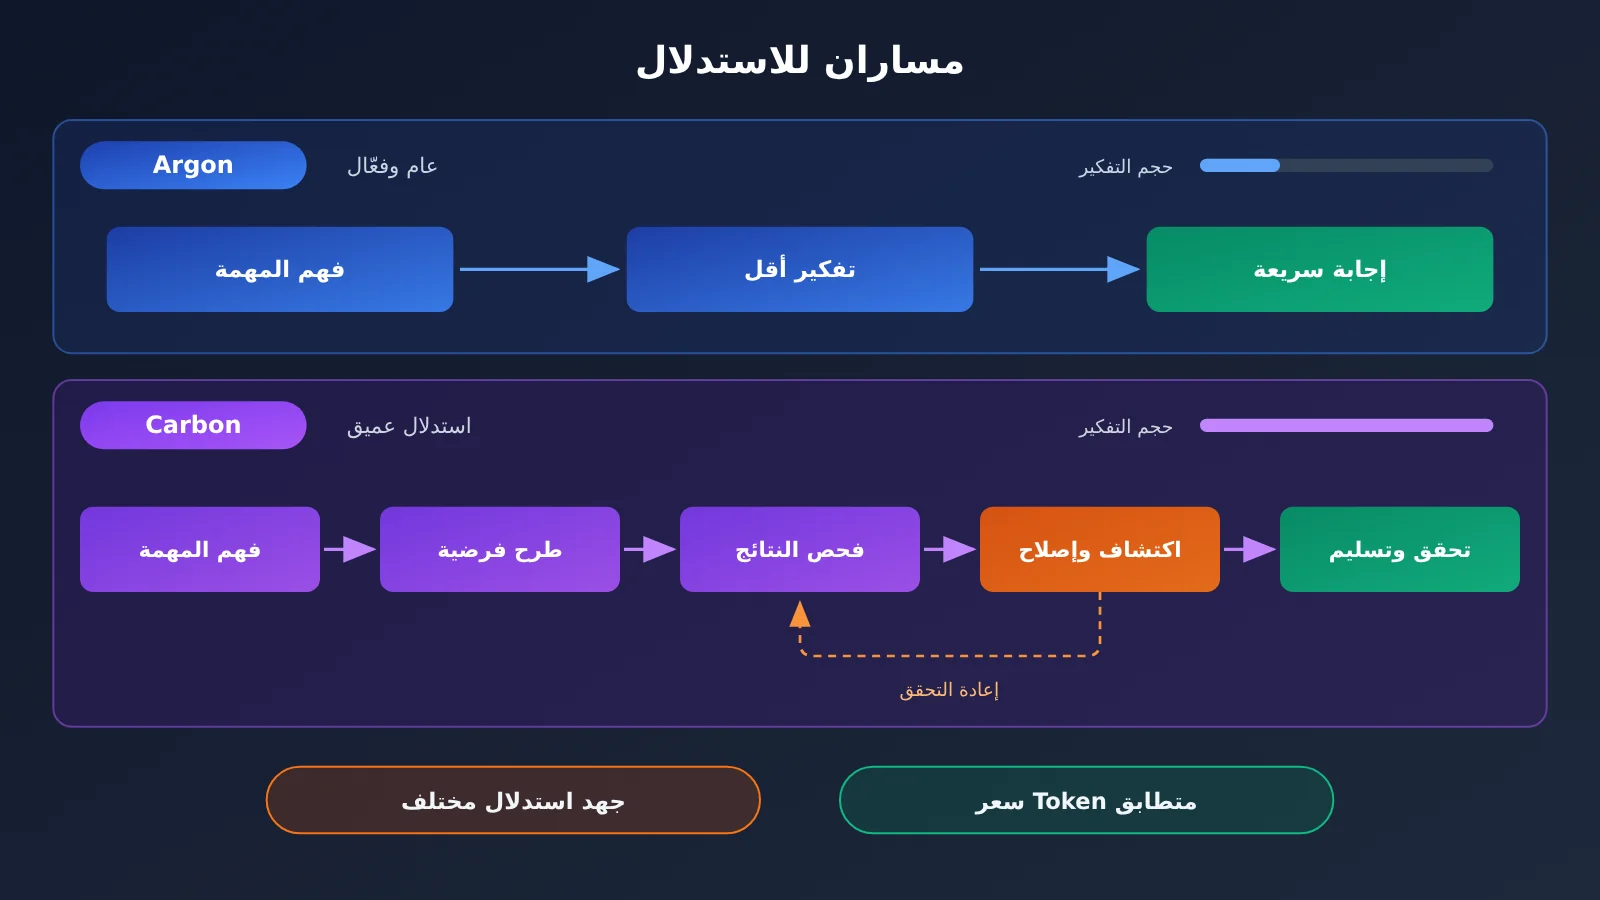
يقترب أسلوب عمل Carbon من حلقة تنفيذ متكاملة: فهم الهدف والقيود، وتقسيم المهمة، ووضع الخطة، واستدعاء الأدوات، وفحص النتائج الوسيطة، وتحديد الأخطاء، ثم التعديل وإعادة التحقق، وأخيرًا التسليم. وتمنحه هذه الحلقة أفضلية في المهام الطويلة، وتفسّر أيضًا لماذا يستغرق وقتًا أطول قبل تقديم أول إجابة.
مقارنة مستقلة بين Gemini 4 Argon وCarbon في اختبارات الأداء
لا يكفي الاعتماد على ما تقوله الجهة المطوّرة؛ نحتاج إلى بيانات مستقلة للتحقق. وفّرت Artificial Analysis في مؤشر الذكاء Intelligence Index v5.0.1 صفحة مقارنة مباشرة بين Carbon وArgon، وجميع الأرقام أدناه نتائج إعداد الاستدلال High.
| المقياس (AA v5.0.1، استدلال High) | Carbon High | Argon High | الفارق |
|---|---|---|---|
| مؤشر القدرات الشامل | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77.8% | 77.5% | تقريبًا متساويان |
| Terminal-Bench 4.0 | 65.2% | 57.1% | Carbon متقدم |
| FrontierCode 2.0 | 40.6% | 25.7% | Carbon متقدم بوضوح |
| AA-Omniscience (درجة موثوقية المعرفة) | 54 | 46 | Carbon متقدم |
| HLE-Diamond | 69.1% | 56.7% | Carbon متقدم |
| التكلفة لكل مهمة | $7.76 | $9.95 | Carbon أقل |
| الزمن لكل مهمة | 25.6 دقيقة | 28.9 دقيقة | Carbon أقصر |
| زمن وصول أول رمز (Token) في الإجابة | حوالي 68 ثانية | حوالي 37 ثانية | Argon أسرع |
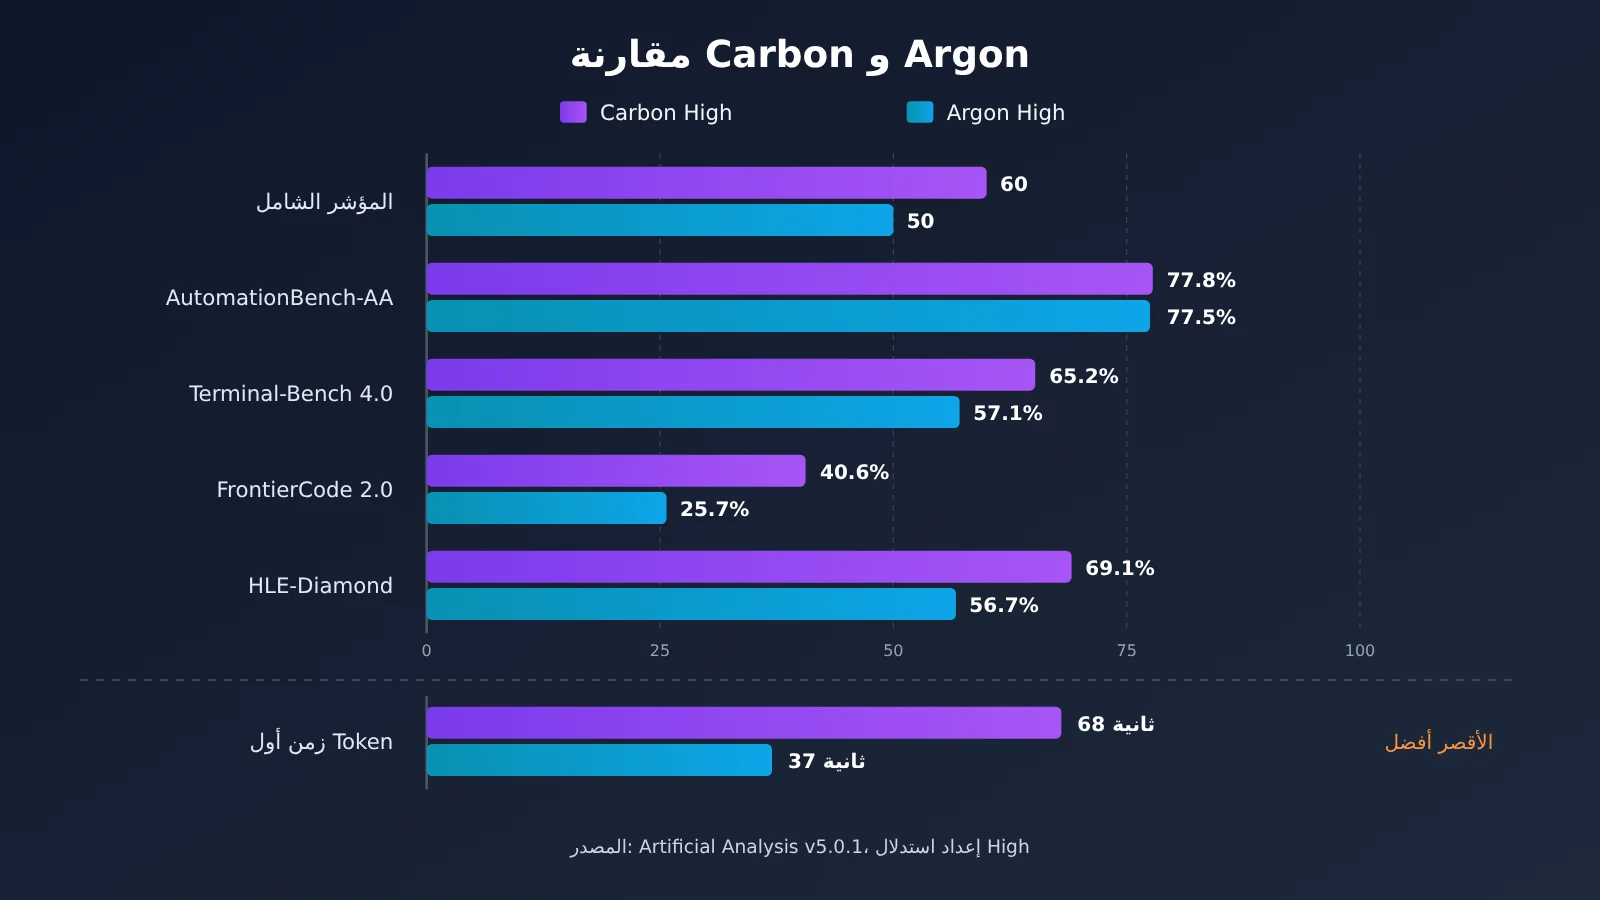
أبرز ما نخرج به من هذه الأرقام:
- أكبر فجوة في الهندسة المعقدة والاستدلال المعقد: يتقدم Carbon بنحو 15 نقطة مئوية في FrontierCode 2.0، وبنحو 12 نقطة في HLE-Diamond، وبنحو 8 نقاط في Terminal-Bench 4.0.
- الفجوة ضئيلة في مهام الأتمتة المعتادة: لا يفصل بينهما سوى 0.3 نقطة مئوية في AutomationBench-AA، أي أن Argon كافٍ تمامًا للمهام الآلية ذات المسارات المحددة.
- تحسّن في موثوقية المعرفة: درجة AA-Omniscience هي 54 مقابل 46. كما يُظهر اختبار Agentic Honesty Benchmark في بطاقة النموذج الصادرة عن Google أن Carbon يحقق 92% مقابل 70% لـ Argon.
- Argon أسرع بكثير في الاستجابة الأولى: حوالي 37 ثانية مقابل حوالي 68 ثانية، وهذا ثمن مباشر لما يستثمره Carbon من استدلال إضافي.
وتُظهر بطاقة النموذج الرسمية من Google (وقد أُشير إلى أن التقييم أُجري في أكتوبر 2026، وغالبًا باستخدام Pass@1 وأعلى مستوى استدلال متاح) الاتجاه نفسه: ففي SWE-sweep حقق Carbon نسبة 9.6% مقابل 4.3% لـ Argon؛ وفي GraphWalks (256k—1M، BFS F1) حقق Carbon نسبة 96.2% مقابل 84.2%؛ وفي Terminal-Bench Science 0.1 حقق Carbon نسبة 64.8% مقابل 52.9%. لكن بطاقة النموذج الرسمية وArtificial Analysis تعتمدان منظومتي تقييم مختلفتين وتواريخ مختلفة، ولذلك لا ينبغي دمج نتائجهما في ترتيب واحد. وتجدر الإشارة أيضًا إلى أن صفحة Carbon تعرض زمنًا لكل مهمة بإعداد High قدره 24.9 دقيقة، وهو يختلف قليلًا عن 25.6 دقيقة في صفحة المقارنة؛ وقد اعتمدنا في جدول المقارنة هنا أرقام صفحة المقارنة.
المعايير الرقمية ليست كل شيء. ففي تقييم MKA لعمل المعرفة متعدد الوسائط، الذي أطلقته Google DeepMind بالتعاون مع Artificial Analysis، لم يتصدّر أي نموذج في القطاعات العشرة كلها: تفوّق Argon في المجال العلمي، وتفوّق Carbon في مجال الرعاية الصحية. وهذا يذكّرنا بأن ارتفاع الدرجة الإجمالية لـ Carbon لا يعني بالضرورة أنه يتفوق على Argon في كل مجال بعينه.
💡 ملاحظة للمقارنة: اختبارات المعايير لا تعكس إلا الأداء على مجموعة مهام ثابتة. وأضمن طريقة لمعرفة ما إذا كانت حالة عملك تحتاج إلى Carbon هي أن تجرّب كلا النموذجين على مهامك الحقيقية. ومن خلال APIYI على apiyi.com يمكنك التبديل بين النموذجين باستخدام مفتاح API نفسه والشيفرة نفسها المتوافقة مع OpenAI، ما يسهّل إجراء اختبار مقارنة صغير.
لماذا يستهلك Gemini 4 Carbon رموزًا أكثر في كل جولة، ومع ذلك لا يكون بالضرورة أغلى
هذه من أكثر النقاط التي يُساء فهمها. سعر الرمز (Token) في Gemini 4 Argon وCarbon واحد: السعر الترويجي للإطلاق حتى 30 نوفمبر 2026 هو 2 دولار لكل مليون رمز إدخال و10 دولارات لكل مليون رمز إخراج. ومن 1 ديسمبر يرتفع إلى 4 دولارات و20 دولارًا. أما سعر الإدخال المخزّن مؤقتًا (Cache) فيعادل خصمًا قدره 95% من سعر الإدخال. وتُحتسب رموز التفكير ضمن رسوم رموز الإخراج، ولذلك فإن تفكير Carbon الأطول في كل جولة يجعل فاتورة الجولة الواحدة أعلى عادةً.
لكن فاتورة المهمة لا تساوي فاتورة الجولة. ففي مقارنة إعدادات High ضمن Artificial Analysis v5.0.1، بلغت تكلفة المهمة الواحدة مع Carbon نحو 7.76 دولار، مقابل 9.95 دولار مع Argon. أي إن Carbon أرخص بنحو 22%، كما أنه أسرع بنحو 3 دقائق. والتفسير المعقول لذلك أن تكلفة المهمة الكاملة تعتمد على عدد الجولات اللازمة لإنجازها، وعدد المسارات الخاطئة التي سُلكت، وعدد مرات إعادة العمل. فإذا فكّر Carbon أكثر في البداية وأخطأ أقل، فقد تقل جولات إعادة المحاولة والإصلاح لاحقًا.
| الإعداد (AA v5.0.1) | الدرجة الإجمالية | تكلفة المهمة | زمن المهمة | زمن أول إجابة |
|---|---|---|---|---|
| Carbon Low | 54 | $7.19 | 22.3 دقيقة | 12.37 ثانية |
| Carbon Medium | 58 | $6.59 | 23.3 دقيقة | 23.16 ثانية |
| Carbon High | 60 | $7.76 | 24.9 دقيقة | 67.54 ثانية |
| Argon High | 50 | $9.95 | 28.9 دقيقة | نحو 37 ثانية |
وتكشف هذه البيانات عن ملاحظة أخرى مخالفة للحدس: تكلفة المهمة في Carbon Medium أقل منها في Low. فكلما انخفض مستوى الاستدلال وفّرت كل جولة أكثر، لكن قد يلزم عدد أكبر من الجولات لإنجاز المهمة. ومع ذلك يجب الانتباه إلى حدود المقارنة:
- هذه التكاليف هي متوسط تكلفة المهمة الواحدة في نظام التقييم هذا، وهي محسوبة على أساس السعر القياسي 4/20 دولار، وليست سعر طلب API عادي. وإذا قدّرناها بالسعر الترويجي للإطلاق، فستنخفض التكلفة إلى نحو النصف عند استهلاك العدد نفسه من الرموز.
- أزمنة مثل 24.9 دقيقة هي زمن مرجَّح لمهام تقييم الوكلاء (Agent)، ولا تعني أن السؤال العادي يحتاج إلى الانتظار 25 دقيقة.
- الاستنتاج يقتصر على مهام AA Index هذه. فإذا كانت مهمتك بسيطة وتنتهي في جولة أو جولتين، فإن أفضلية Argon أو المستويات الأدنى في تكلفة الجولة الواحدة ستظهر مباشرةً في صورة فاتورة أقل.
💰 نصيحة بخصوص التكلفة: عند تقييم النماذج، سجّل «إجمالي الرموز وإجمالي الزمن اللازمين لإنجاز مهمة واحدة»، ولا تكتفِ بمقارنة سعر الوحدة. تعتمد APIYI (apiyi.com) الدفع حسب الاستهلاك، ويمكنك الاطلاع في لوحة التحكم على تفاصيل الاستخدام لكل استدعاء، وهذا مناسب لحساب التكلفة الفعلية للمهمة بين Argon وCarbon في عملك.
متى تختار Gemini 4 Argon ومتى تختار Carbon
بالاعتماد على توجيهات Google الرسمية والبيانات السابقة، يمكن توزيع المهام حسب صعوبتها. المبدأ الأساسي: اسأل أولًا هل تستحق المهمة استدلالًا أعمق، ثم اختر النموذج والمستوى.
| نوع المهمة | النموذج الموصى به | المستوى الموصى به | السبب |
|---|---|---|---|
| تطوير الميزات اليومية وتعديلات الشفرة المعتادة | Argon | الافتراضي أو المتوسط | استجابة سريعة وتكلفة منخفضة للجولة الواحدة، مناسب للتفاعل المتكرر |
| البرمجة التفاعلية والمساعدة الفورية داخل IDE | Argon | المتوسط | زمن الاستجابة الأولى أقل بوضوح |
| المشاريع المعقدة متعددة الملفات وتصميم البنية | Carbon | HIGH | فارق واضح في FrontierCode وTerminal-Bench |
| التحقيق العميق في الأسباب الجذرية عبر عدة أنظمة فرعية | Carbon | MEDIUM / HIGH | يتطلب استكشاف فرضيات متعددة وتحققًا متكررًا |
| الاستدلال العلمي الصعب والإثباتات الصورية | Carbon | HIGH | تصنّف Google الإثباتات الصورية رسميًا ضمن استخدامات HIGH |
| التدقيق الأمني واكتشاف الثغرات | Carbon | HIGH | التوجيه الرسمي يرشّحه أكثر لعمليات التدقيق المعقدة |
| التصنيف البسيط والتلخيص واستخراج البيانات الوصفية | مستوى استدلال منخفض | LOW | التكلفة حساسة هنا ولا حاجة لاستدلال عميق |
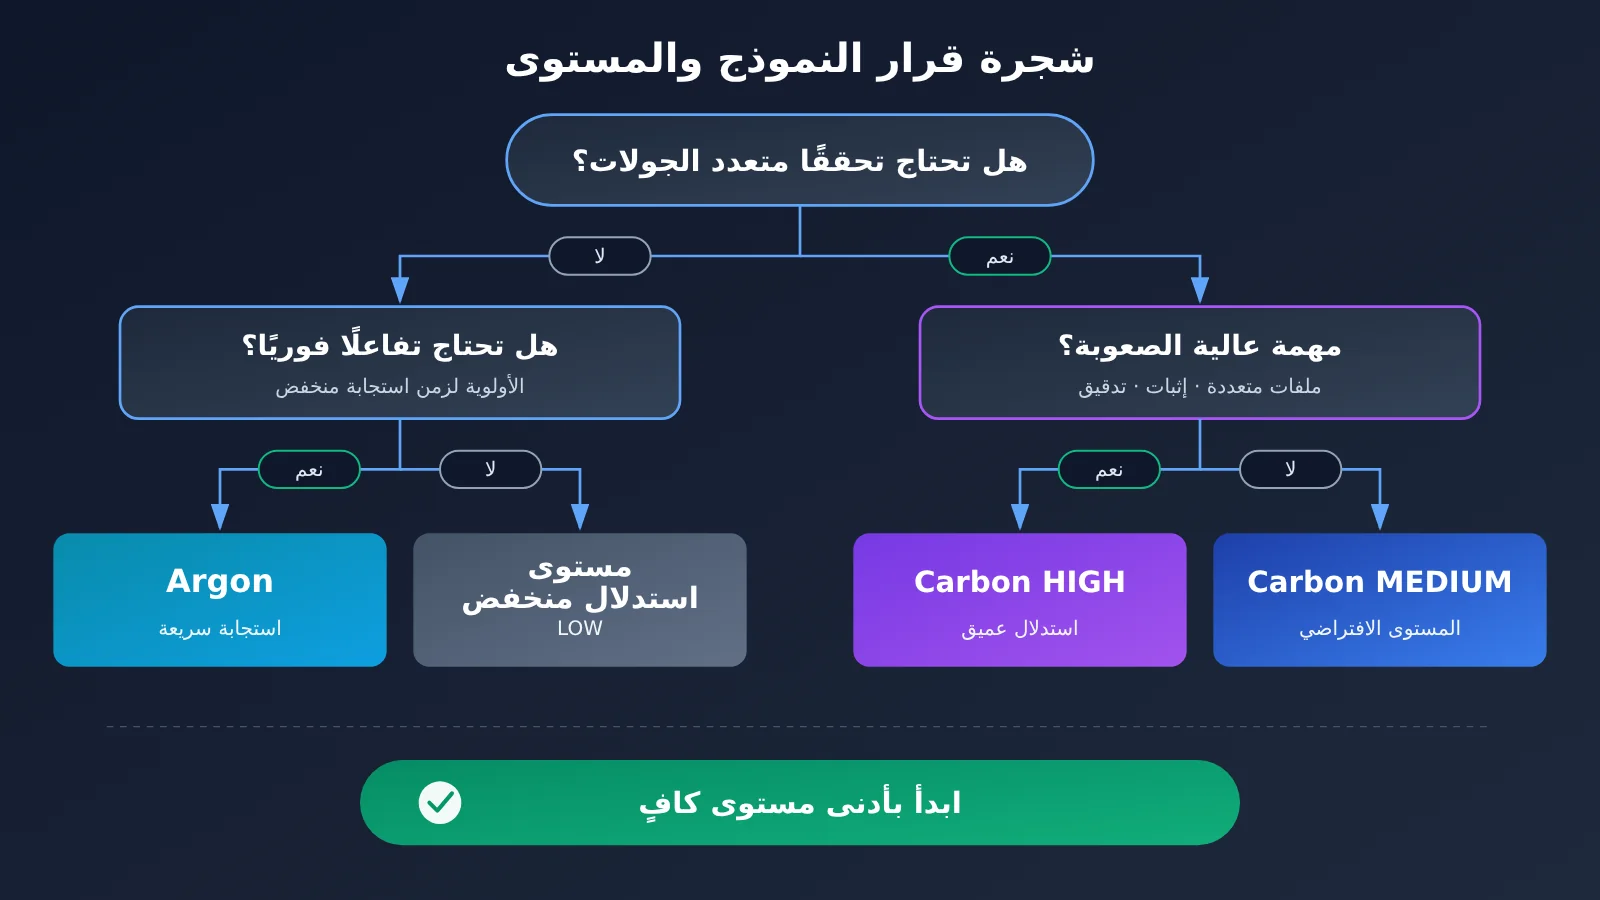
حالات اختيار Gemini 4 Argon
- العمل التطويري كثير التفاعل: كتابة دالة واحدة، أو تعديل تنسيق، أو إضافة اختبارات. الفرق بين انتظار 37 ثانية و68 ثانية يظهر بوضوح في تجربة الاستخدام.
- أعمال المعرفة العامة وسير العمل الآلي: النموذجان متقاربان تقريبًا في AutomationBench-AA، فلا داعي لدفع تكلفة إضافية مقابل فارق غير موجود.
- أعمال المعرفة العلمية: يتفوق Argon في المجال العلمي ضمن تقييم MKA، ويستحق أن يكون خيارك الأول للتجربة.
حالات اختيار Gemini 4 Carbon
- مهام الوكلاء طويلة الأمد التي تعمل في الخلفية: زمن الاستجابة الأول لا يهم فيها، والأهم أن تنجز المهمة بشكل صحيح من أول مرة.
- القرارات الهندسية والمعمارية المعقدة: ترحيل مشاريع متعددة الملفات، وإعادة هيكلة الأنظمة، وتدقيق الشفرات المعقدة.
- المهام التي تتطلب نتائج قابلة للتحقق: الاستدلال العلمي، والتدقيق الأمني، وتقارير التحليل التي تحتاج إلى فحص ذاتي.
وتؤكد الملاحظات المبكرة من المجتمع هذا التوزيع. يرى بعض المطورين على Hacker News وReddit أن Carbon يكتشف مشكلات فاتت نماذج أخرى، بينما اشتكى آخرون من طول الانتظار قبل أول إجابة وسرعة استهلاك الحصة. وذكر أحد مستخدمي Reddit أنه استخدم Carbon Medium لترحيل مكتبة في مشروع Go تضم 230 ملفًا، ونجح التشغيل من المرة الأولى. لكنه أوضح أيضًا أن العينة لا تتجاوز 4 مراحل وأنها ليست تجربة مضبوطة، فهي مجرد حالة مرجعية.
كيف تستخدم Thinking Level للتحكم في الجودة والسرعة والتكلفة في Gemini 4 Carbon
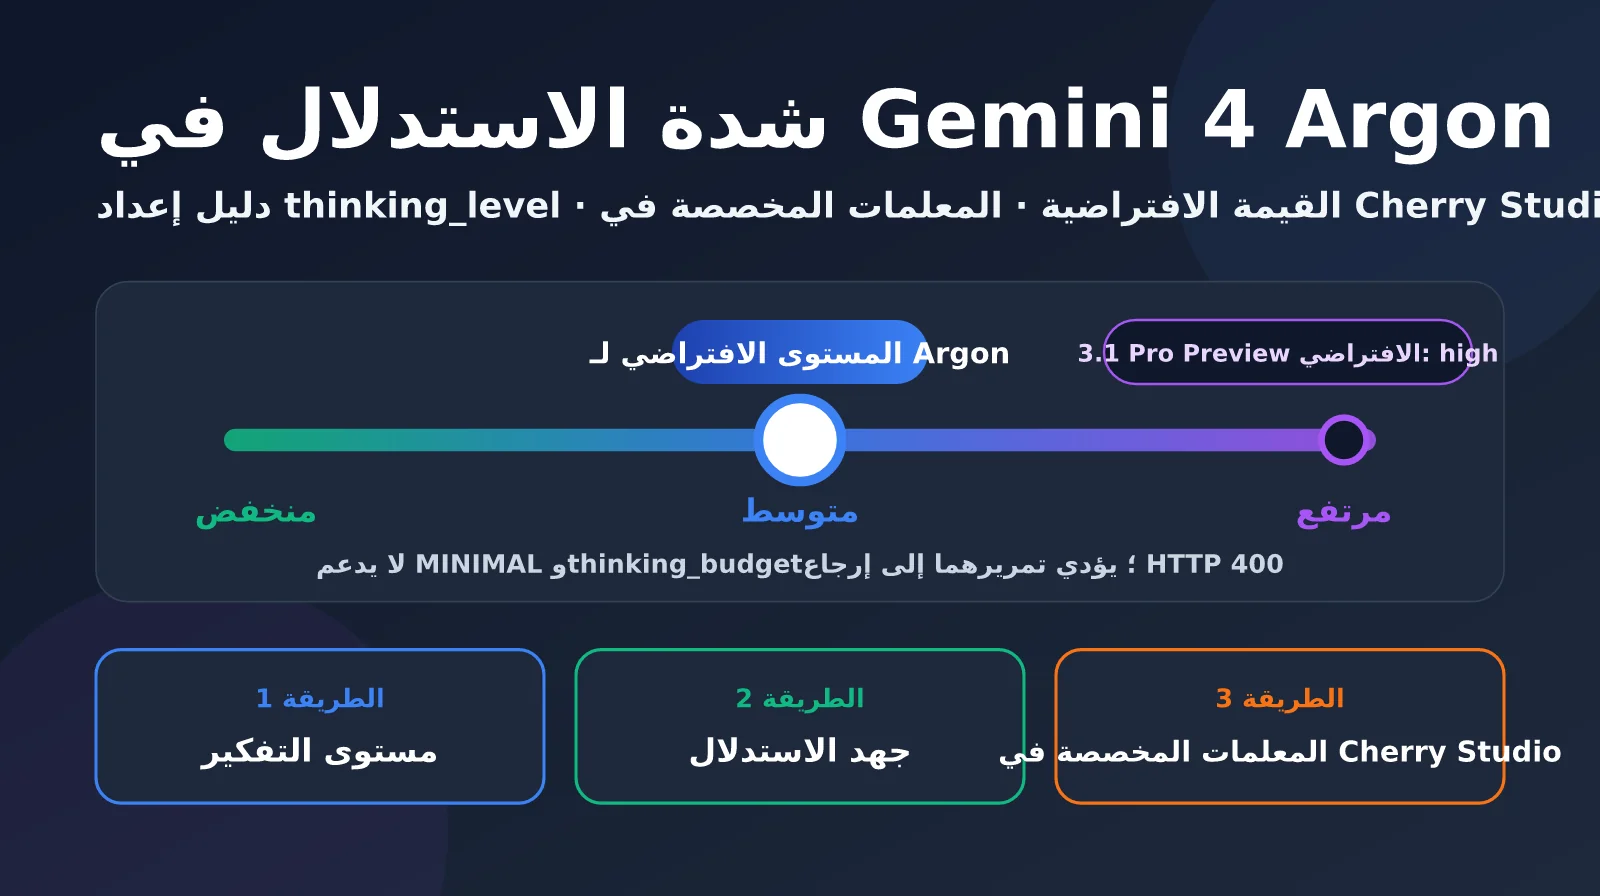
يوفّر Carbon ثلاثة مستويات للاستدلال: LOW وMEDIUM وHIGH، ويستخدم النموذج العام gemini-4-carbon المستوى MEDIUM افتراضيًا. وهذا هو التقسيم الذي توصي به الجهة الرسمية للاستخدامات:
- LOW: التصنيف، والتلخيص، واستخراج البيانات الوصفية.
- MEDIUM: كتابة الشفرة البرمجية المعتادة، واستدعاء الأدوات، والإجابة عن أسئلة المستندات، وفهم الفيديو.
- HIGH: هندسة البرمجيات متعددة الملفات، وتصميم البنية المعمارية، والإثباتات الصورية، واكتشاف الثغرات.
وللمستوى الافتراضي MEDIUM ما يبرره. ففي اختبار AA v5.0.1 حصل Carbon بمستوى Medium على درجة إجمالية قدرها 58، أي أقل من High بنقطتين فقط، مع أنه الأقل تكلفة لكل مهمة، وزمن أول إجابة فيه يقارب ثلث الزمن في High. أما في اختبار AA-Omniscience لموثوقية الحقائق، فكانت نسبة الإجابات المُختلَقة في Medium هي 4.2%، وهي أقل من 11.4% في High و20.0% في Low (وهذا مقياس خاص بهذا الاختبار تحديدًا، وليس معدّل هلوسة عامًا). وتنصح Google المطورين أيضًا بتجربة المستويات المختلفة واختيار أدنى مستوى يحقق متطلبات الجودة، بدلًا من استخدام HIGH دائمًا دون تفكير.
وهناك بضعة قيود تقنية في Carbon يجب الانتباه إليها عند الاستدعاء:
- المعامل
thinking_budgetغير مدعوم، واستخدامه يُرجع خطأ HTTP 400. - المستوى MINIMAL غير مدعوم.
- يتم تجاهل المعاملات
temperatureوtop_pوtop_k. - التخزين المؤقت الصريح للسياق (Context Caching) غير مدعوم، لكن إذا بلغت البادئة المشتركة في الموجه 4096 رمزًا (Token) أو أكثر، فيمكن أن يُفعَّل التخزين المؤقت الضمني تلقائيًا.
مثال مبسّط
فيما يلي استدعاء Gemini 4 Carbon عبر الواجهة المتوافقة مع OpenAI، وهو يعمل بأكثر من 10 أسطر من الشيفرة فقط:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # معرّف النموذج يُعتمد وفق قائمة النماذج في المنصة
    messages=[{"role": "user", "content": "分析这段服务超时日志的可能根因"}]
)
print(response.choices[0].message.content)
عرض الشيفرة الكاملة: توجيه المهام بين Argon وCarbon حسب صعوبتها
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# أسماء النماذج للتوضيح فقط، يُرجى اعتماد المعرّفات الفعلية في قائمة النماذج على المنصة
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """إرجاع (النموذج، مستوى الاستدلال) بحسب صعوبة المهمة"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # التصنيف، التلخيص، استخراج البيانات الوصفية
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # التطوير اليومي، التفاعل المتكرر
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # تحليل الأسباب الجذرية، مهام الوكلاء المعتادة
    return CARBON_MODEL, "high"         # هندسة متعددة الملفات، البراهين، التدقيق الأمني

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # طريقة ربط معامل مستوى الاستدلال تُعتمد وفق وثائق المنصة؛
        # Carbon لا يدعم thinking_budget، وتمريره يؤدي إلى خطأ 400
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # يشمل توكنات التفكير
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("为订单服务设计分库分表迁移方案,并列出验证步骤", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("输出 Token:", result["completion_tokens"])
🚀 نصيحة للبدء السريع: يُفضَّل أن تسجّل أولًا في APIYI على apiyi.com وتحصل على رصيد تجريبي مجاني، ثم تستخدم دالة التوجيه أعلاه لتمرير مجموعة المهام الحقيقية نفسها إلى مستويات مختلفة من Argon وCarbon، وتسجّل زمن التنفيذ وقيمة
completion_tokens. يكفيك مفتاح API واحد لإجراء كل المقارنات، دون الحاجة إلى ربط عدة حزم SDK منفصلة.
توصيات الاختيار بين Gemini 4 Argon وCarbon
إذا كان عليك أن تتذكر قاعدة واحدة فقط: استخدم Argon افتراضيًا، وانتقل إلى Carbon عندما تواجه مهمة تستحق التفكير العميق. ويمكن تطبيق ذلك عمليًا في ثلاث خطوات:
- ضع قواعد للتوجيه: قسّم المهام وفق جدول السيناريوهات أعلاه إلى أربع فئات: بسيطة، ويومية، ومعقدة، وصعبة للغاية. وتذهب المهام اليومية إلى Argon افتراضيًا.
- قارن على عينة صغيرة: اختر من كل فئة 10 إلى 20 مهمة حقيقية، وقارن بين Argon وCarbon في كل مستوى من مستوياتهما من حيث نسبة النجاح وإجمالي الرموز (Tokens) وإجمالي زمن التنفيذ.
- حدّد المستوى بحسب تكلفة المهمة: اختر أدنى مستوى يحقق خط الجودة المطلوب، وأعد الاختبار بانتظام، لأن النماذج والأسعار وقوائم الترتيب قد تتغير.
وفي الأنظمة متعددة الوكلاء (Agents)، يمكنك أيضًا الاستفادة من فكرة Google /swarm: يتولى Carbon التخطيط والتنسيق والمراجعة، بينما يتولى Argon أو نموذج أخف التنفيذ بالجملة. بهذه الطريقة تستفيد من الاستدلال العميق في Carbon دون أن تتحمل زمن استجابته في كل خطوة.
💡 نصيحة للاختيار: سعر الرمز (Token) متطابق في النموذجين، والفارق الحقيقي يكمن في بنية مهامك. نقترح أن تربط Argon وCarbon معًا عبر واجهة متوافقة مع OpenAI على APIYI (apiyi.com)، وأن تبدّل بينهما بالتوجيه في طبقة الشفرة، فلا تحتاج إلى تعديل شفرة منطق العمل عند تغيير الاستراتيجية لاحقًا.
الأسئلة الشائعة FAQ
س1: ما العلاقة بين Gemini 4 Argon وCarbon؟
وفقًا لبطاقة النموذج الصادرة عن Google DeepMind، بُني Gemini 4 Carbon على أساس Gemini 4 Argon. ينتمي النموذجان إلى سلسلة Gemini 4 للاستدلال، ويتشاركان نافذة سياق بحجم 1M رمز (Token) وإمكانات الأدوات المدمجة. يخصص Carbon عددًا أكبر من رموز التفكير في كل جولة للاستكشاف والتحقق، بينما يركّز Argon أكثر على سرعة الاستجابة وكفاءة الجولة الواحدة. لم تكشف Google عن عدد المعاملات ولا عن الفروق المعمارية بينهما.
س2: هل سيحل Carbon محل Argon بالكامل؟
لا. أكدت Google صراحةً أن Argon لا يزال الخيار الأمثل لمعظم مهام الهندسة وأعمال المعرفة، بينما يناسب Carbon المهام الأصعب والأطول مدى زمنيًا. وتشير البيانات إلى ذلك: فالنموذجان متقاربان تقريبًا في AutomationBench-AA، ويتقدم Argon في المجالات العلمية ضمن MKA. أي أن Argon ما زال منافسًا قويًا في كثير من السيناريوهات.
س3: هل سعر النموذجين واحد؟ ومتى يتغير السعر؟
تُظهر وثائق Google للمطورين أن النموذجين يعتمدان السعر نفسه لكل رمز. سعر الإطلاق هو 2/10 دولار لكل مليون رمز إدخال/إخراج، ويسري حتى 30 نوفمبر 2026؛ وابتداءً من 1 ديسمبر يُعدَّل إلى 4/20 دولار. تُحتسب رموز التفكير ضمن رسوم الإخراج، لذا فتساوي سعر الوحدة لا يعني تساوي تكلفة المهمة.
س4: Carbon بطيء في تقديم أول إجابة، فهل يناسب تطبيقات الدردشة؟
لا يناسب كثيرًا السيناريوهات التي تتطلب استجابة فورية. ففي AA v5.0.1 بلغ زمن وصول أول رمز من الإجابة لدى Carbon High نحو 68 ثانية، مقابل نحو 37 ثانية لدى Argon High، ونحو 12 ثانية لدى Carbon Low. للتفاعل الفوري يُنصح باستخدام Argon، أما Carbon فأنسب للتحليلات المعقدة في الخلفية ومهام الوكلاء (Agent) طويلة المدى.
س5: كيف أقارن بين Argon وCarbon بسرعة عبر API؟
يُنصح باستخدام منصة تجميع API تدعم نماذج متعددة:
1. زر APIYI على apiyi.com وسجّل حسابًا، ثم احصل على مفتاح API ورصيد تجريبي مجاني؛
2. اضبط `base_url` في الشفرة على `https://api.apiyi.com/v1`؛
3. غيّر معامل `model` فقط للتبديل بين النموذجين، ثم أضف مستويات الاستدلال المختلفة للمقارنة.
س6: هل يمكنني استخدام Carbon دون اشتراك Google AI Ultra؟
نعم. اشتراك Ultra يحدد فقط ما إذا كان بإمكان المستخدم النهائي اختيار Carbon مباشرةً في تطبيقات المستهلكين (مثل Gemini App)، أما AI Pro فيتضمن Argon بالأساس. يستطيع المطورون استدعاء Carbon عبر الشريحة المدفوعة من Gemini API دون شراء Ultra. ومن المهم الانتباه إلى أن واجهة Carbon API الرسمية من Google لا توفر شريحة مجانية.
س7: ما القيود المعروفة لـ Carbon؟
تعترف بطاقة النموذج بعدة قيود: قد تظهر الهلوسة، وقد تستهلك مستويات الاستدلال العالية عددًا كبيرًا من Token، وقد تكون الاستجابة بطيئة أو تنتهي المهلة، وتاريخ انقطاع المعرفة هو مارس 2026، وما زالت الحماية من حقن الموجّهات (Prompt Injection) بحاجة إلى تحسين. كما أن thinking_budget غير مدعوم، وتُتجاهل معاملات أخذ العينات، لذا ينبغي مراجعة الشفرة القديمة عند الانتقال إلى النموذج الجديد.
أبرز النقاط حول Gemini 4 Argon وCarbon (Key Takeaways)
- العلاقة بين النموذجين: يقوم Carbon على أساس Argon، والنموذجان يكمّل أحدهما الآخر في توزيع المهام، فليس أحدهما نسخة أقوى والآخر نسخة أضعف تحلّ محله.
- الفرق الجوهري: يفكر Carbon أكثر في كل جولة ويتحقق من نتائجه بدرجة أكبر، بينما يستجيب Argon أسرع ويكلّف أقل في الجولة الواحدة.
- الأداء في الاختبارات المعيارية: في إعداد AA v5.0.1 High، حصل Carbon على 60 نقطة إجمالًا مقابل 50 نقطة لـ Argon.
- حقيقة التكلفة: سعر الوحدة واحد للنموذجين، ومع ذلك فإن تكلفة كل مهمة في Carbon High أقل منها في Argon High ضمن مهام AA.
- اختيار المستوى: المستوى الافتراضي في Carbon هو MEDIUM، واختر بين LOW وMEDIUM وHIGH وفق مبدأ «أدنى مستوى يكفي للمهمة».
- طريقة البدء: يمكنك اختبار النموذجين معًا بشفرة واحدة متوافقة مع OpenAI عبر APIYI على apiyi.com.
الخلاصة
يمكن تلخيص الفرق بين Gemini 4 Argon وCarbon في ثلاث نقاط:
- اختلاف حجم الجهد في الاستدلال: Argon مصمَّم للكفاءة، أما Carbon فيستخدم عددًا أكبر من رموز التفكير (Tokens) ليبلغ حدود الاستدلال المعقّد.
- التأخير والتكلفة يُقيَّمان كلٌّ على حدة: استجابة Carbon الأولى أبطأ، لكن تكلفة المهمة الكاملة قد تكون أقل في بعض التقييمات المحددة.
- معيار الاختيار هو صعوبة المهمة: استخدم Argon للأعمال الهندسية اليومية، واترك الهندسة المعقدة والاستدلال العلمي ومراجعة الأمان لـ Carbon.
لا تُرسل كل الطلبات إلى أعلى مستوى استدلال. ابدأ باختبار مهامك الفعلية لتعرف “المستوى الكافي” لكل نوع من الأعمال، فهذا هو مفتاح الموازنة بين الجودة والسرعة والتكلفة. ننصحك بالتحقق السريع من أداء النموذجين على حالتك عبر APIYI على apiyi.com، إذ تدعم المنصة الدفع حسب الاستخدام وواجهة موحدة لعدة نماذج.
📚 المراجع
- Gemini 4 Carbon Model Card: بطاقة النموذج الرسمية من Google DeepMind
- الرابط:
deepmind.google/models/model-cards/gemini-4-carbon -
الوصف: بناء Carbon على Argon، ومواصفات السياق، والتقييمات الرسمية، والقيود المعروفة
-
Choosing between Carbon and Argon: وثائق المطورين في Google AI Studio
- الرابط:
aistudio.google.com/docs/whats-new-gemini-4-carbon -
الوصف: الفروق الرسمية في تموضع النموذجين، وتوصيات اختيار مستوى التفكير (Thinking Level)
-
Gemini 4 Carbon Developer Guide: دليل المطورين من Google Cloud
- الرابط:
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
الوصف: مستويات الاستدلال، وقيود معاملات API، وشرح فك الترميز الطويل
-
Gemini API Pricing: Google AI for Developers
- الرابط:
ai.google.dev/gemini-api/docs/pricing -
الوصف: سعر الإطلاق، وتعديل الأسعار في ديسمبر، وقواعد احتساب التخزين المؤقت ورموز التفكير
-
Gemini 4 Carbon vs Gemini 4 Argon: صفحة المقارنة في Artificial Analysis
- الرابط:
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
الوصف: مقارنة القدرات والتكلفة والتأخير ضمن إعداد AA Index v5.0.1 High
-
تقييم MKA لأعمال المعرفة متعددة الوسائط: Artificial Analysis
- الرابط:
artificialanalysis.ai/zh/evaluations/mka - الوصف: النماذج الرائدة في كل قطاع وبيانات تكلفة المهام
المؤلف: فريق APIYI التقني
للنقاش التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، وللمزيد من معلومات ربط النماذج زوروا مركز الوثائق docs.apiyi.com