ملاحظة المؤلف: عند الانتقال من Gemini 3.8 Flash إلى Hydrogen، ستحتاج إلى ضبط SDK والسياق ومعاملات التفكير وإعدادات أخذ العينات والتخزين المؤقت، بالإضافة إلى إدارة التوقيعات في استدعاءات الأدوات متعددة الجولات.
أعلنت Google رسميًا في 12 نوفمبر 2026 عن إطلاق Gemini 4 Hydrogen، وحمل معرّف النموذج في API الاسم gemini-4-hydrogen، وهو مخصص للبرمجة اليومية وتنفيذ وكلاء الذكاء الاصطناعي. ردّ الفعل الأول لدى كثير من الفرق هو استبدال اسم النموذج في الشيفرة ثم النشر مباشرة، لكنها تصطدم بأخطاء HTTP 400، ومعاملات لا تعمل، وأخطاء في استدعاء الأدوات متعدد الجولات، ومخرجات طويلة تُقتطع. يشرح هذا المقال خمسة إعدادات API يجب تعديلها عند الترقية من Gemini 3.8 Flash إلى Hydrogen، ويعرض كل إعداد بالترتيب: السلوك القديم ← السلوك الجديد ← طريقة التعديل ← التأثير النموذجي.
هذا ليس مجرد إعادة سرد لخبر إطلاق منتج. أسماء المعاملات والقيم الصالحة وإصدارات SDK وأنواع الأخطاء الواردة في المقال مأخوذة من دليل الترحيل الرسمي من Google Cloud ووثائق مواصفات النموذج، أما تقييمات الأطراف الثالثة وملاحظات المجتمع فسيُشار إلى مصادرها بشكل منفصل.
القيمة الأساسية: بعد قراءة هذا المقال، ستكون لديك قائمة تحقق يمكنك من خلالها تعديل شيفرة استدعاء Gemini 3.8 Flash الحالية بندًا بندًا، ونقل أعمال الوكلاء والمعالجة الدفعية بسلاسة إلى Hydrogen.
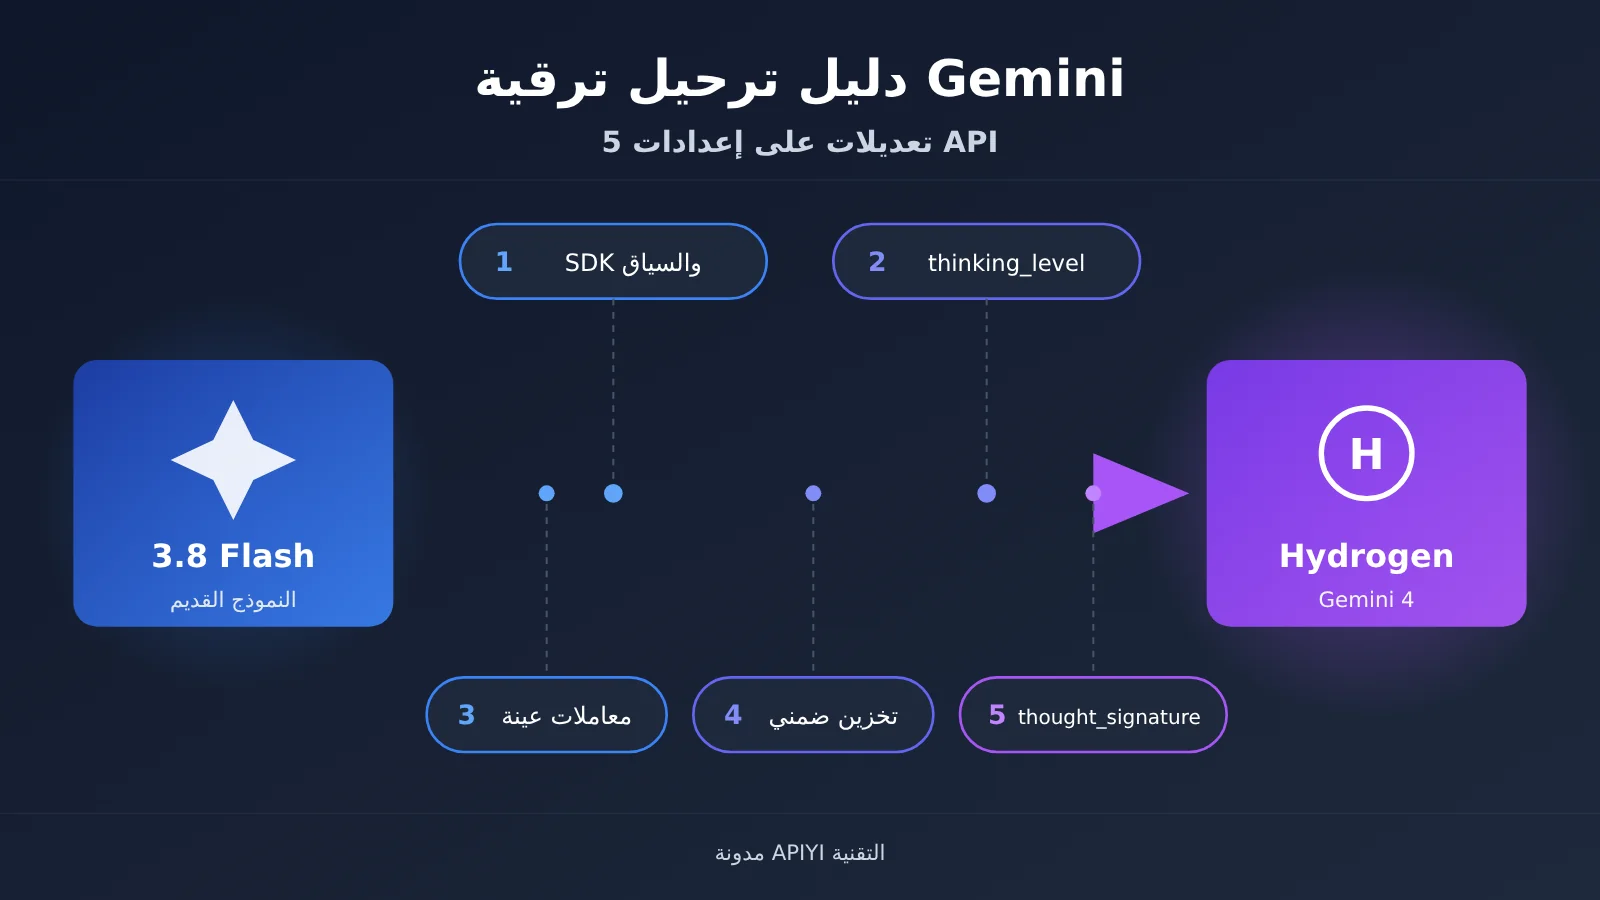
خمسة مصطلحات يجب معرفتها قبل الانتقال إلى Hydrogen
قبل أن تبدأ بالتعديل، لنوحّد أولاً بعض المفاهيم التي تتكرر كثيرًا في دليل الانتقال:
- thinking_level: معامل مستوى التفكير الذي يضبط عمق استدلال النموذج. استخدمه Hydrogen بدلاً من
thinking_budgetالقديم، والمستويات المسموح بها هي Low وMedium وHigh وXHigh. - thought_signature: توقيع مرتبط بالتفكير يعيده النموذج ضمن استجابته. يجب الحفاظ عليه وإعادة إرساله كما هو تمامًا في المحادثات متعددة الأدوار وعند استدعاء الأدوات، وإلا لن يستطيع النموذج مواصلة حالة الاستدلال السابقة.
- continuation_token: علامة استئناف تُستخدم لربط المقطع التالي عند توليد مخرجات طويلة. بعد أن يبلغ المقطع الواحد الحد الأقصى، يمكنك مواصلة التوليد بفضل هذه العلامة.
- التخزين المؤقت الضمني: تقوم المنصة تلقائيًا بإعادة استخدام بادئات المدخلات التي تستوفي الشروط، ويُحاسب الجزء المطابق بسعر التخزين المؤقت، من دون أن يضطر المطوّر إلى إنشاء كائنات تخزين مؤقت يدويًا.
- نافذة السياق: نطاق المعلومات التي يمكن معالجته في عملية نموذج واحدة. تشترك مدخلات Hydrogen ومخرجاته وتفكيره واستدعاءاته للأدوات في حدّ موحّد قدره 1,048,576 tokens.
أولاً: لماذا لا يكفي استبدال معرّف النموذج وحده عند الترقية إلى Hydrogen
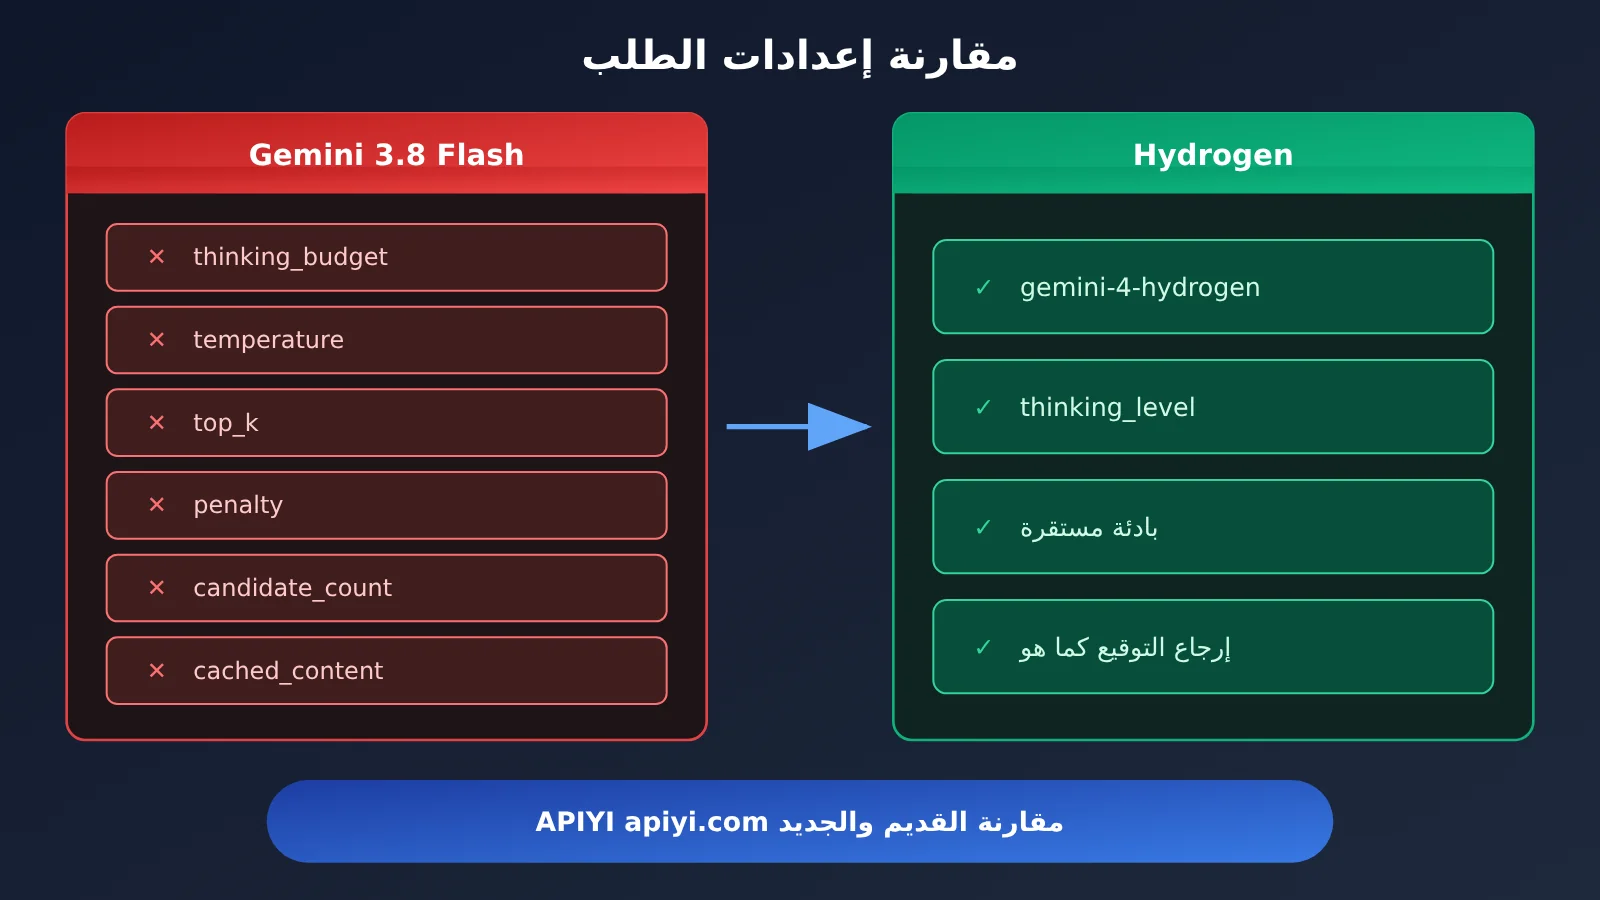
رغم أن Gemini 3.8 Flash وHydrogen ينتميان إلى عائلة Gemini نفسها، فإن سلوك واجهة API بينهما يتضمن اختلافات عديدة تمنع التوافق. وفقًا لدليل الترحيل الرسمي، فإن thinking_budget ومستوى التفكير MINIMAL غير مدعومين في Hydrogen، ويعيد الطلب مباشرةً رمز HTTP 400. أما معاملات أخذ العينات مثل temperature وtop_p وtop_k فلا تُظهر خطأً، لكنها تُتجاهل بصمت. النوع الأول من المشكلات يظهر سريعًا أثناء الاختبار، أما الثاني فقد يجعلك تظن أن «المعاملات ما زالت سارية».
هناك نوعان آخران من المخاطر أكثر خفاءً. الأول أن إدارة التوقيع في استدعاءات الأدوات متعددة الجولات أصبحت أكثر صرامة؛ فبعد ضغط المحادثة السابقة أو تقليمها، قد لا يتطابق التوقيع مع البادئة، ما قد يؤدي إلى HTTP 400. والثاني أن مستوى التفكير الافتراضي ارتفع من Medium إلى High، وإذا لم تضبطه صراحةً فسيستهلك الطلب نفسه توكنات تفكير أكثر وزمن استجابة أطول. يقدّم الجدول التالي نظرة عامة على التعديلات الخمسة:
| التعديل | السلوك القديم (3.8 Flash) | السلوك الجديد (Hydrogen) | نتيجة عدم التغيير |
|---|---|---|---|
| معرّف النموذج وSDK والسياق | معرّف النموذج القديم، وإصدار SDK القديم قابل للاستخدام | gemini-4-hydrogen، واستكمال المخرجات الطويلة له متطلب حد أدنى لإصدار SDK |
انقطاع المخرجات الطويلة، وعدم توفر الاستكمال |
| معاملات التفكير | thinking_budget، والافتراضي Medium |
thinking_level، والافتراضي High |
HTTP 400، أو ارتفاع التكلفة وزمن الاستجابة |
| معاملات أخذ العينات والتوليد | يمكن ضبط temperature وtop_p وtop_k وغيرها | قيم ثابتة، ويُتجاهل التخصيص؛ بعض الحقول يجب إزالتها | نمط المخرجات غير قابل للتحكم، وفشل التحقق من بعض الطلبات |
| التخزين المؤقت | يدعم التخزين المؤقت الصريح cached_content |
يدعم التخزين المؤقت الضمني فقط، بحد أدنى 4,096 توكن | مراجع التخزين المؤقت تصبح غير صالحة، وانحراف في تقدير التكلفة |
| thought_signature | قواعد التوقيع أكثر تسامحًا نسبيًا | قواعد صارمة للاستدعاءات المتوازية وتغيّر البادئة | أخطاء في وكيل متعدد الجولات أو انقطاع الاستدلال |
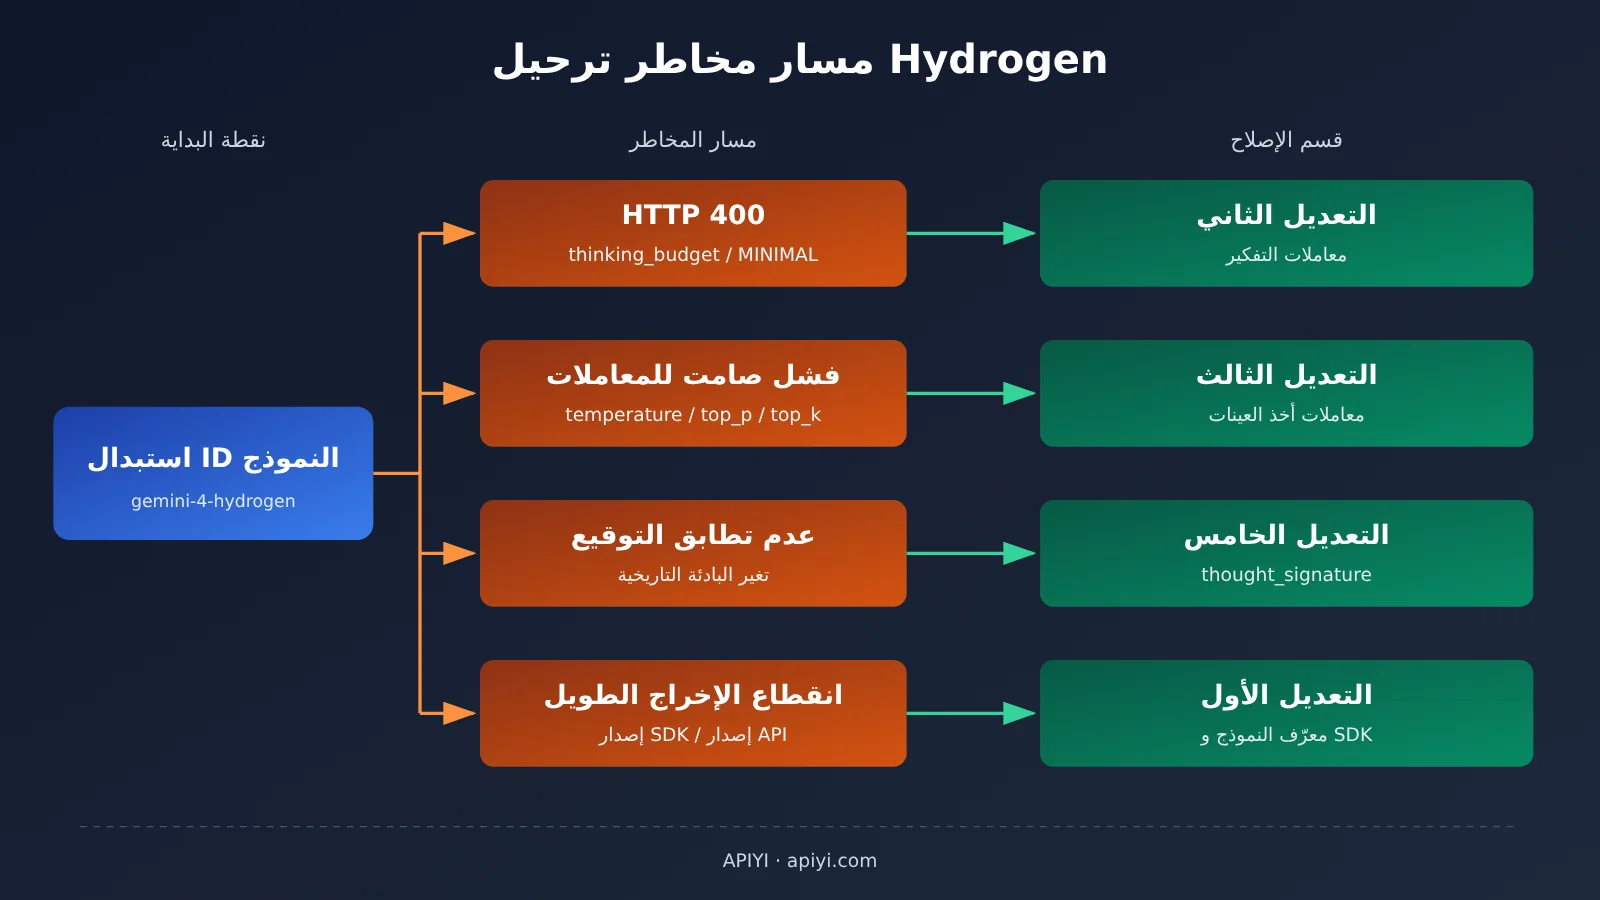
التعديل الأول: معرّف نموذج Hydrogen وإصدار SDK وحدود السياق
السلوك القديم ← السلوك الجديد: في عصر 3.8 Flash، لم تكن معظم المشاريع حساسة لإصدار SDK. وبعد الانتقال إلى Hydrogen، يجب تغيير معرّف النموذج إلى gemini-4-hydrogen؛ وإذا كنت بحاجة إلى مخرجات طويلة جدًا، يصبح إصدار SDK شرطًا إلزاميًا. الحد الأدنى للإصدارات التي يحددها دليل الانتقال الرسمي من Google كما يلي:
| لغة التطوير | الاستكمال التلقائي في GenerateContent | الاستكمال التلقائي في Interactions API |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | غير مذكور رسميًا بشكل منفصل | >= 1.77.0 |
| Java | غير مذكور رسميًا بشكل منفصل | >= 1.80.0 |
طريقة تعديل السياق والمخرجات الطويلة في Hydrogen
إن حد 1,048,576 tokens في Hydrogen هو حصة موحّدة؛ إذ تُخصم منه المدخلات وسياق المحادثة السابق وtokens التفكير وtokens المتعلقة باستدعاء الأدوات والمخرجات النهائية، كلها من هذا المجمع نفسه. بعبارة أخرى، لا يمكنك إدخال مليون tokens أولاً ثم الحصول على مليون tokens إضافية كمخرجات. أما الوكلاء المخصصون لتحليل المستندات الطويلة، فيحتاجون إلى ترك مساحة للتفكير واستدعاء الأدوات على جانب المدخلات بشكل استباقي.
عادةً ما يكون الحد الأقصى للتوليد الأمامي في مقطع واحد هو 65,536 tokens. وعند تجاوز هذا الطول، تتوفر ثلاثة خيارات: استخدام الاستكمال التلقائي عبر SDK مدعوم، أو ضبط background=true في Interactions API لتنفيذ توليد طويل في الخلفية، أو إدارة continuation_token بنفسك ودمج المقاطع تباعًا. يجب الانتباه خصوصًا إلى أن الوثائق التمهيدية الرسمية توضح أن استكمال المخرجات الطويلة يتطلب حاليًا واجهة v1beta1 API، وأن v1 في Agent Platform لا يدعم هذه الميزة.
التأثير النموذجي: الأعمال التي تولّد تقارير طويلة أو ملفات شفرة طويلة على نحو مجمّع هي الأكثر عرضة للمشكلات. يُنصح أولاً بترقية SDK، ثم تحويل إصدار API إلى v1beta1، وأخيرًا إجراء اختبار انحدار بطلب يتجاوز 65,536 tokens.
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
ثالثًا، التعديل الثاني: تغيير thinking_budget في Hydrogen إلى thinking_level
السلوك القديم: كان 3.8 Flash يستخدم thinking_budget للتحكم في طول التفكير بعدد الـ Tokens، وكان بإمكانه أيضًا اختيار الدرجة MINIMAL، والدرجة الافتراضية هي Medium.
السلوك الجديد: Hydrogen يقبل thinking_level فقط، وقيمه الصالحة هي أربع درجات: Low وMedium وHigh وXHigh، والافتراضية هي High. وإذا استمررت في تمرير thinking_budget أو MINIMAL فسيعيد HTTP 400. الاستخدامات الموصى بها رسميًا هي: Low للتصنيف، وMedium للبرمجة العادية، وHigh للـ Agent متعدد الخطوات، وXHigh للاستدلال المعقد والعميق.
أكملت مؤسسة الطرف الثالث Artificial Analysis في 12 نوفمبر تقييمًا مستقلًا للدرجات الأربع (Intelligence Index v5.0.1)، وهو ما يساعد على فهم الفروق بين الدرجات. الأوقات والتكاليف في الجدول التالي هي متوسطات مهام التقييم المعيارية الخاصة بهم، ولا تمثل التكلفة الفعلية لمحادثة واحدة لدى المستخدم العادي:
| مستوى التفكير | السيناريو الموصى به رسميًا | مؤشر الذكاء (AA) | متوسط وقت التقييم | متوسط تكلفة التقييم |
|---|---|---|---|---|
| Low | التصنيف والاستخراج البسيط | 27 | 1.3 دقيقة | $0.29 |
| Medium | البرمجة العادية | 41 | 3.7 دقيقة | $0.80 |
| High (الافتراضي) | Agent متعدد الخطوات | 51 | 8.3 دقيقة | $1.87 |
| XHigh | الاستدلال المعقد والعميق | 54 | 13.5 دقيقة | $3.16 |
من البيانات نرى أن High يتفوق على Medium بـ 10 نقاط، بينما XHigh لا يتفوق على High إلا بـ 3 نقاط فقط، ومع ذلك ترتفع تكلفة التقييم من 1.87 دولار إلى 3.16 دولار. وهذا يعني أن أعلى درجة ليست بالضرورة الأكثر جدوى، وأن الفروق في القدرات بين الدرجات المختلفة للنموذج الواحد كبيرة جدًا.
مثال على تعديل Hydrogen thinking_level
المثال التالي يستخدم صيغة Google Gen AI SDK الرسمية. أما كتابة الأحرف الكبيرة أو الصغيرة لقيم التعداد فيرجى الرجوع إلى تعريفات الأنواع في نسخة SDK المثبتة لديك:
from google import genai
from google.genai import types

client = genai.Client()

# الصيغة القديمة (3.8 Flash): ستعيد HTTP 400 على Hydrogen
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# الصيغة الجديدة: اختر Medium لمهام البرمجة العادية
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# اختر High للـ Agent متعدد الخطوات (وهو أيضًا القيمة الافتراضية، ويُفضّل كتابته صراحةً)
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="修复这个函数中的空指针问题:...",
    config=coding_config,
)
print(resp.text)
التأثير النموذجي: نظرًا لأن Tokens التفكير تُحاسَب بسعر الإخراج، فإن المشاريع التي لا تحدد الدرجة صراحةً ستنتقل تلقائيًا إلى High بعد الترحيل، وسترتفع الفاتورة وزمن الاستجابة. يُنصح بتعيين نطاقات thinking_budget القديمة إلى درجات: الميزانيات الأصغر تقابل Low أو Medium، والميزانيات الأكبر تقابل High.
رابعًا: التعديل الثالث — تنظيف معاملات التوليد غير الصالحة في Hydrogen
السلوك القديم: كان 3.8 Flash يسمح بضبط عشوائية المخرجات عبر temperature وtop_p وtop_k، وكان يدعم أيضًا معاملات العقوبة والمخرجات متعددة المرشحين.
السلوك الجديد: في Hydrogen تصبح درجة الحرارة الافتراضية 1.0 دون أن يعمل التخصيص، ويُثبَّت top_p على 0.95، وtop_k على 64، ويتم تجاهل هذه المعاملات الثلاثة عند تمريرها. كما تتطلب قائمة الترحيل الرسمية معالجة الحقول التالية:
| الحقل أو السلوك | متطلب الترحيل إلى Hydrogen | إرشادات التشخيص |
|---|---|---|
| temperature / top_p / top_k | يتم تجاهل القيم المخصصة | لا يُصدر خطأ، ويجب ضبط الأسلوب عبر الموجه |
| frequency_penalty / presence_penalty | الإزالة | اعتمد على الخطأ الفعلي، والحذف الموحّد هو الأكثر أمانًا |
| candidate_count > 1 | إزالة إعداد المرشحين المتعددين | عند الحاجة إلى التنويع، استخدم طلبات متعددة |
| الدورات التاريخية المعدّة مسبقًا للنموذج (model prefilling) | الإزالة | لم يعد ممكنًا استخدام طريقة “بدء الرد نيابة عن النموذج” لتوجيه التنسيق |
| cached_content | عدم الإشارة إلى التخزين المؤقت الصريح | راجع التعديل الرابع |
| thinking_budget | استخدم thinking_level الصالح بدلاً منه |
يعيد HTTP 400 |
تنبّه الجهة الرسمية إلى أن بعض المعاملات القديمة يتم تجاهلها فقط، بينما يؤدي بعضها الآخر إلى فشل التحقق من الطلب. لذلك لا يمكن أن يكون منطق التشخيص موحّدًا بشكل أعمى: عند مواجهة 400، افحص أولاً thinking_budget وMINIMAL والحقول التي يجب إزالتها؛ وعندما لا يطابق أسلوب المخرجات التوقعات، افحص بعدها ما إذا كنت لا تزال تعتمد على معاملات درجة الحرارة.
إعداد الطلب المبسّط في Hydrogen
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # ضع المحتوى الثابت في المقدمة، فهذا يساعد التخزين المؤقت الضمني
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # لا يزال المخرجات المهيكلة مدعومة
    max_output_tokens=8192,
)
التأثير النموذجي: المشاريع التي كانت تعتمد سابقًا على درجة حرارة منخفضة لضمان مخرجات JSON مستقرة، ينبغي لها التحول إلى قدرة المخرجات المهيكلة؛ والمشاريع التي كانت تعتمد على إعداد دورات النموذج مسبقًا للتحكم في التنسيق، تحتاج إلى كتابة متطلبات التنسيق داخل موجه النظام.
خامسًا، التعديل الرابع: تحويل التخزين المؤقت الصريح في Hydrogen إلى التخزين المؤقت الضمني
السلوك القديم: على 3.8 Flash، كان بإمكان المطور أولًا إنشاء كائن تخزين مؤقت، ثم الإشارة إليه في الطلب عبر cached_content="cachedContents/xxx".
السلوك الجديد: لا يدعم Hydrogen التخزين المؤقت الصريح للسياق، ويدعم التخزين المؤقت الضمني فقط، ويفعّل افتراضيًا آلية تخزين مؤقت ضمنية دائمة. وينخفض الحد الأدنى لطول بادئة التخزين المؤقت من 6,144 tokens في 3.8 Flash إلى 4,096 tokens، كما تصبح موجهات النظام العامة والمواد المعرفية الثابتة، حتى الأقصر نسبيًا منها، أسهل في مطابقة التخزين المؤقت.
طريقة التعديل: احذف كل استدعاءات caches.create وكل إشارات cached_content، واعتمد بدلًا من ذلك على تحسين ترتيب تركيب الموجه. توصي Google بوضع المحتوى العام الثابت في مقدمة الإدخال، ووضع سؤال المستخدم المتغير في كل مرة في النهاية:
- موجه النظام وتعريف الدور (ثابت تقريبًا)
- قاعدة المعرفة العامة، وثائق API، معايير الكود (تتغير بوتيرة منخفضة)
- سجل المحادثة (يُضاف دورًا بعد دور)
- سؤال المستخدم الحالي (يتغير في كل مرة)
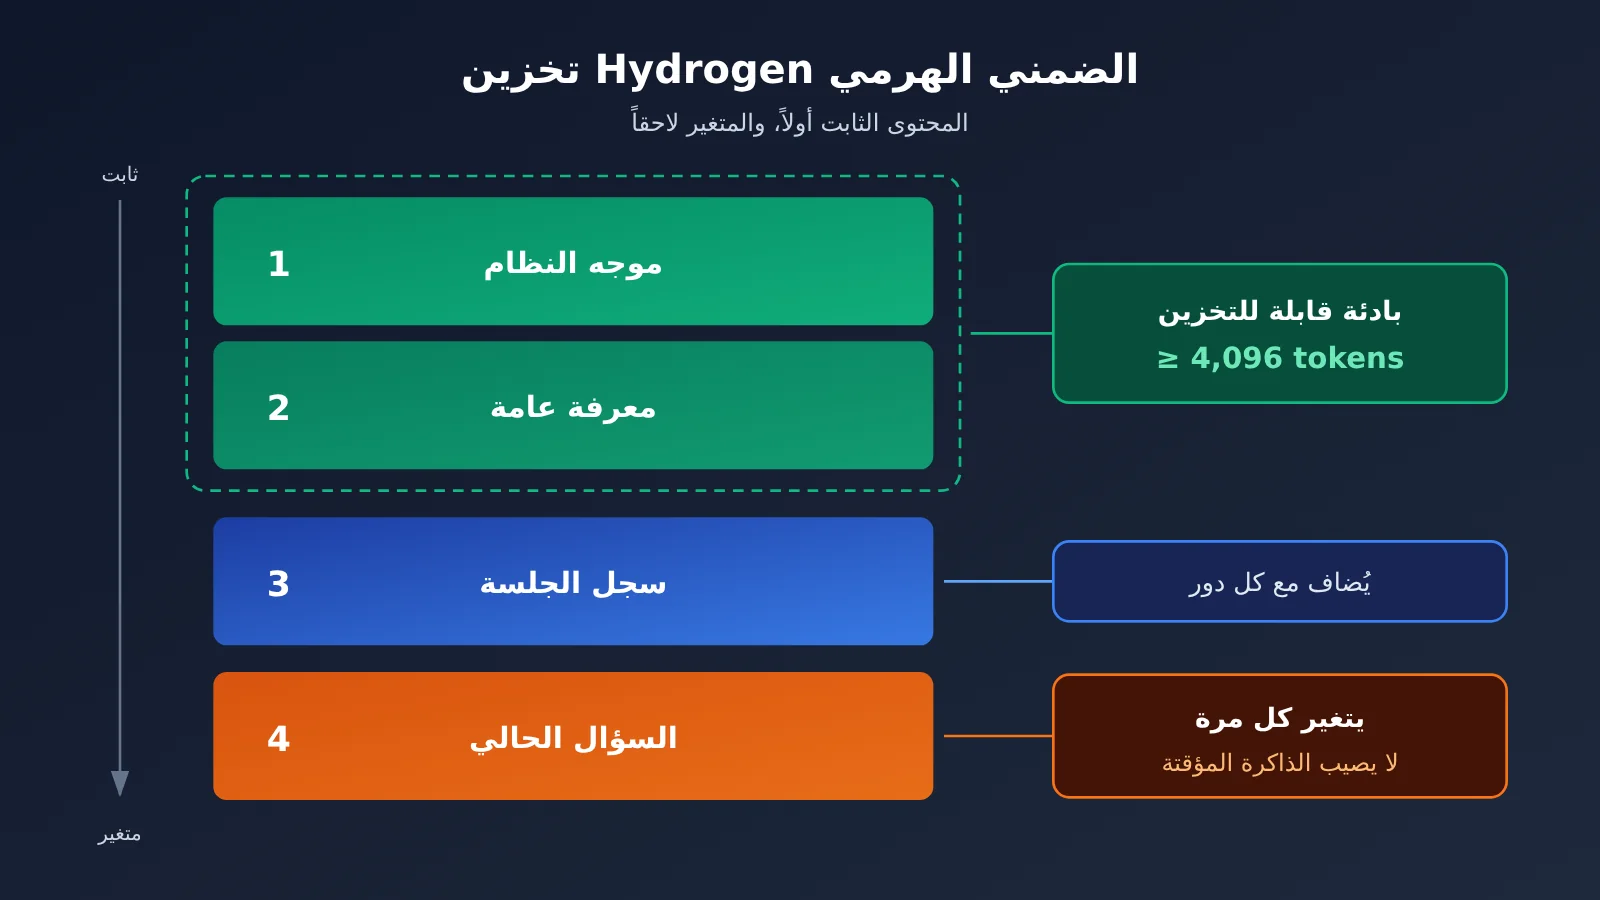
التأثير النموذجي: من حيث السعر، وفقًا لصفحة الأسعار الرسمية في Google AI Studio (تاريخ التحقق 13 نوفمبر 2026، والوحدة دولار لكل مليون tokens)، فإن إدخال مطابقة التخزين المؤقت الضمني في استدعاء Hydrogen القياسي هو $0.075، وفي وضعي Batch وFlex هو $0.0375، وهو أقل بكثير من $1.50 الخاص بالإدخال القياسي. وإذا أُدخلت متغيرات ديناميكية (مثل الطوابع الزمنية ومعرّفات المستخدم وغيرها) في بداية الموجه، فستختلف البادئة في كل مرة، ولن يتمكن التخزين المؤقت من المطابقة.
سادسًا، التعديل الخامس: الحفاظ على thought_signature بشكل صحيح في Hydrogen
السلوك القديم: على 3.8 Flash، كانت العديد من أطر عمل الوكلاء تعيد بناء سجل المحادثة بنفسها، مع الاحتفاظ بالنص ونتائج استدعاء الأدوات فقط؛ وكان فقدان التوقيع في الغالب بلا تأثير واضح.
السلوك الجديد: في Hydrogen، تتطلب المحادثة متعددة الأدوار الاحتفاظ بتوقيعات جميع الأجزاء ذات الصلة السابقة، بما في ذلك التوقيع الذي يحمله جزء النص النهائي. وينص دليل الترحيل الرسمي على ما يلي بشأن استدعاءات الأدوات المتوازية:
- يجب أن توجد عدة
functionCallمتوازية في رسالة النموذج نفسها؛ - يوضع
thought_signatureفي أول جزءfunctionCallفقط من بين الاستدعاءات المتوازية؛ - يجب أن تُعاد
functionResponseاللاحقة وفقًا لمعرّف الاستدعاء والاسم والترتيب المطابقين؛ - عند إعادة استخدام التوقيع مع النموذج نفسه، إذا تغيّرت بادئة السجل، فقد يُرجع HTTP 400 افتراضيًا.
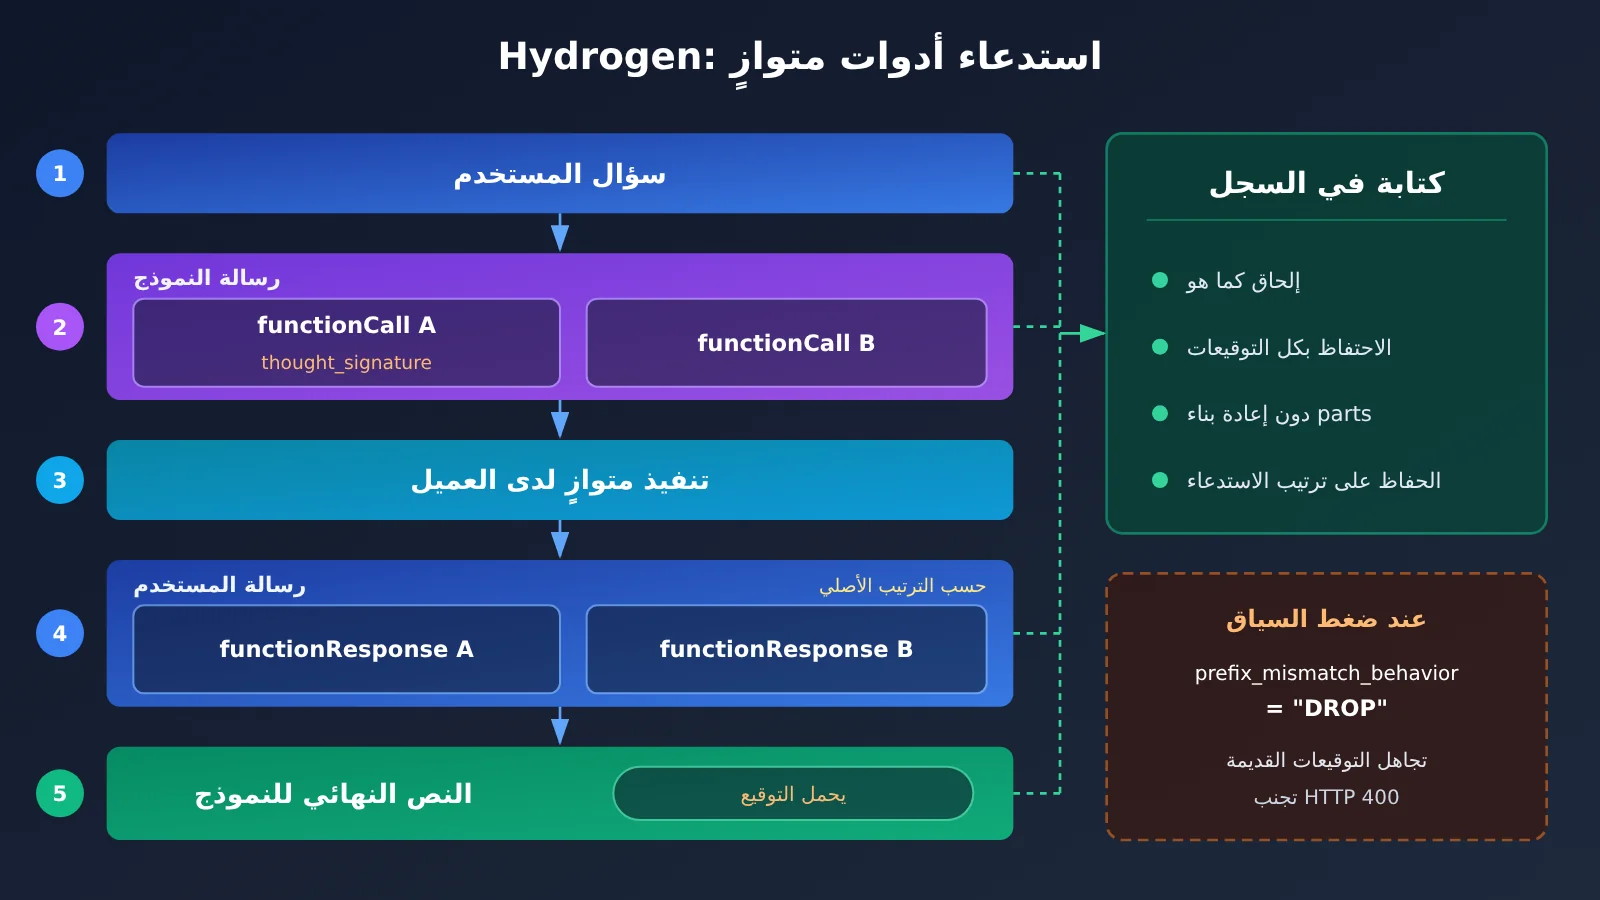
كيفية تعديل الحفاظ على التوقيع في Hydrogen
أكثر الطرق أمانًا هي عدم إعادة بناء الأجزاء يدويًا، بل إلحاق كائن content الذي يعيده النموذج كما هو بالسجل:
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # احتفظ به كما هو، فيبقى التوقيع معه

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # حافظ على الترتيب نفسه مثل functionCall
]
history.append(types.Content(role="user", parts=responses))
بالنسبة إلى الوكلاء الذين يضغطون السجل أو يقتطعونه (مثل النافذة المنزلقة أو الاستبدال بملخص)، فإن بادئة السجل ستتغير بالضرورة. في هذه الحالة يمكنك، وفقًا لدليل الترحيل، ضبط prefix_mismatch_behavior="DROP" حتى يتجاهل النموذج التوقيع القديم عند عدم تطابق البادئة بدلًا من الإبلاغ عن خطأ. ولمعرفة الموضع الدقيق لهذا الحقل في الطلب، ارجع إلى دليل الترحيل الرسمي.
الأثر النموذجي: يتأثر هذا أكثر من غيره بأدوات Agent Harness المطورة داخليًا، ومساعدي البرمجة الذين يجرون بحثًا متوازيًا في الملفات، وروبوتات الجلسات الطويلة المزودة بضغط السياق؛ ويُنصح بكتابة اختبار تكامل منفصل لإعادة إرسال التوقيع.
سابعًا: قائمة التحقق للانتقال إلى Hydrogen ومثال استدعاء بسيط
| عنصر التحقق | قبل الانتقال (3.8 Flash) | بعد الانتقال (Hydrogen) | تم |
|---|---|---|---|
| معرّف النموذج | معرّف النموذج القديم | gemini-4-hydrogen |
☐ |
| SDK | أي إصدار | Python >= 2.34.0، وJS >= 2.32.0 (Interactions) | ☐ |
| إصدار API | v1 | استخدم v1beta1 عند الحاجة إلى متابعة الإخراج الطويل | ☐ |
| معاملات التفكير | thinking_budget / MINIMAL | تعيين thinking_level صراحةً | ☐ |
| معاملات التوليد | يمكن ضبط temperature وغيره | احذف penalty وcandidate_count وجولات التعبئة المسبقة | ☐ |
| التخزين المؤقت | cached_content | ضع المحتوى المستقر أولاً، بحيث تكون البادئة ≥ 4,096 tokens | ☐ |
| استدعاء الأدوات | إعادة بناء السجل يدويًا | احتفظ بالتوقيع كما هو، وأعد الاستجابات المتوازية بالترتيب | ☐ |
| معالجة الأخطاء | إعادة محاولة عامة | ميّز بين خطأ التحقق HTTP 400 والتجاهل الصامت | ☐ |
التحقق السريع عبر واجهة متوافقة مع OpenAI
إذا كانت شيفرة أعمال فريقك مبنية على OpenAI SDK، فيمكنك أولاً التحقق بسرعة من جودة مخرجات Hydrogen عبر الواجهة المتوافقة، ثم تقرر ما إذا كان الأمر يستدعي التحويل إلى SDK الأصلي. أما مدى توفّر النموذج على المنصة والوسائط التي يمكن تمريرها، فالمرجع هو قائمة النماذج والوثائق المنشورة على المنصة:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 写一个带重试的 HTTP 请求函数"}],
)
print(resp.choices[0].message.content)
عرض الشيفرة الكاملة للتنفيذ (مع استدعاء الأدوات والاحتفاظ بالسجل)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة موحدة تسهّل مقارنة النماذج القديمة والجديدة
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取仓库中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代码修复助手。只修改与问题相关的代码。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # يوضع موجه النظام الثابت في المقدمة لتعزيز إصابة التخزين المؤقت الضمني
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # تُعاد رسالة assistant كاملةً إلى السجل كما هي دون حذف أيٍّ من حقولها
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # إرجاع النتائج واحدة تلو الأخرى بالترتيب الأصلي لـ tool_calls
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    print(run_agent("检查 utils.py 中的 parse_date 函数是否有时区问题"))
🚀 نصيحة للبدء السريع: يُستحسن الإبقاء على 3.8 Flash كمجموعة مرجعية أثناء فترة الترحيل، وتشغيل النموذجين القديم والجديد في الوقت نفسه على الدفعة نفسها من الطلبات الحقيقية. وعبر APIYI على apiyi.com يمكنك استدعاء النموذجين معًا بمفتاح API واحد، كما يحصل المستخدمون الجدد على حصة اختبار مجانية، وهو ما يناسب البدء بمقارنة محدودة الحجم قبل التحويل الكامل.
الأسئلة الشائعة
س1: ما هو Gemini 4 Hydrogen؟
Gemini 4 Hydrogen هو نموذج أصدرته Google DeepMind في 12 نوفمبر 2026، ومعرّف API الخاص به هو `gemini-4-hydrogen`. وقد طُوّر انطلاقًا من Gemini 4 Carbon، ويُركّز على السرعة والبرمجة اليومية واستدعاء أدوات متعددة وتنفيذ مهام الأتمتة، ويمكن استخدامه بمفرده أو بصفته منفّذًا أو مدقّقًا داخل نظام متعدد النماذج.
س2: ما مدى الفرق في القدرات بين Hydrogen وGemini 3.8 Flash؟
وفقًا للبيانات التي أعلنتها Google رسميًا، حقّق Hydrogen نسبة 57.0% على Terminal-Bench 4.1، بينما حقّق 3.8 Flash نسبة 18.2%؛ وفي ظروف الاختبار نفسها تكون سرعة إنجاز المهام أسرع بنحو 2.5 مرة. هذه نتائج اختبارات رسمية أو من شركاء، ولا يمكن تعميمها مباشرةً على جميع المهام الفعلية.
س3: هل ستنخفض التكلفة بعد الانتقال إلى Hydrogen؟
ليس بالضرورة. فوفقًا لصفحة الأسعار الرسمية على Google AI Studio (تاريخ التحقق 13 نوفمبر 2026)، يبلغ سعر الاستدعاء القياسي لـ Hydrogen $1.50 للإدخال و$7.50 للإخراج (دولار لكل مليون tokens)، بينما كان سعر 3.8 Flash قبل 31 ديسمبر 2026 هو $0.75 / $3.75، ثم يُعدّل إلى $1.50 / $7.50 اعتبارًا من 1 يناير 2027. سعر الوحدة حاليًا ضعف سعر 3.8 Flash، والتكلفة الإجمالية تعتمد على طول التفكير وعدد مرات إعادة المحاولة وكفاءة إنجاز المهام.
س4: ما المشاريع التي تحتاج إلى فحص التوافق أولًا وبأولوية؟
تشمل بشكل أساسي الفئات التالية:
– **وكلاء يستدعون أدوات متعددة بالتوازي**: مواضع التوقيع وترتيب الاستجابات هما الأكثر عرضةً للأخطاء؛
– **أنظمة الجلسات الطويلة مع ضغط السياق**: تحتاج إلى معالجة مشكلة عدم تطابق البادئة؛
– **توليد التقارير الطويلة والأكواد الطويلة**: يحتاج إلى ترقية SDK والانتقال إلى v1beta1؛
– **أنظمة المعالجة الدُفعية التي تعتمد على التحكم الصريح في التخزين المؤقت لضبط التكلفة**: تحتاج إلى التحويل إلى استراتيجية التخزين المؤقت الضمني.
س5: كيف يمكن مقارنة النموذجين القديم والجديد بسرعة عبر API؟
الطريقة الموصى بها هي:
1. زيارة APIYI على apiyi.com لتسجيل حساب والحصول على مفتاح API؛
2. استخدام المثال المتوافق مع OpenAI الوارد في هذا المقال، مع ضبط `model` على معرّف النموذج القديم أو الجديد كلٌّ على حدة؛
3. استخدام الدفعة نفسها من طلبات الأعمال لمقارنة جودة المخرجات وزمن الاستجابة وكمية استخدام Token.
الواجهة الموحّدة تُغني عن صيانة أكواد المصادقة والطلبات لكل نموذج على حدة.
س6: ما القيود المعروفة في Hydrogen؟
تشير بطاقة النموذج الرسمية إلى أنه لا يزال من الممكن أن ينتج هلوسات؛ وأن مستوى التفكير العالي يزيد بشكل ملحوظ من الوقت والتكلفة، مع حدوث تأخير أو مهلة عرضية؛ وأن المعرفة محدّثة حتى مارس 2026؛ وأن مؤشر الرفض غير المبرر تدهور بنسبة 5.57 نقطة مئوية مقارنة بـ 3.8 Flash. بالإضافة إلى ذلك، لا يدعم Hydrogen واجهة Live API والضبط الدقيق (Fine-tuning). كما ورد في التعليقات المجتمعية المبكرة أن بعض المستخدمين أبلغوا عن تنفيذ مفرط في مهام الوكيل (Agent)، وهي تُعد تجربة فردية.
س7: كيف يمكن السيطرة على مخاطر التكلفة في بداية الترحيل؟
يُنصح أولاً بتعيين `thinking_level=”medium”` بشكل صريح لتشغيل خط الأساس، ثم تفعيل High بشكل منفصل لمهام الوكيل متعددة الخطوات؛ وفي الوقت نفسه، تحقق من معدل إصابة التخزين المؤقت الضمني ونسبة رموز التفكير (Thinking Tokens). إذا كنت ترغب في الفوترة حسب الاستخدام وعرض استخدام النماذج المتعددة في مكان واحد، يمكنك أيضًا الاستعانة بفاتورة APIYI الموحدة على apiyi.com للمقارنة.
النقاط الأساسية لترحيل Hydrogen Key Takeaways
- ليس مجرد تغيير الاسم: تغيير معرّف النموذج إلى
gemini-4-hydrogenهو الخطوة الأولى فقط، وهناك أربعة إعدادات أخرى يجب تعديلها بشكل متزامن. - حزمة SDK شرط أساسي صارم: يتطلب استئناف الإخراج الطويل Python >= 2.34.0 و JS >= 2.32.0 (واجهة Interactions API)، مع استخدام v1beta1.
- تغيّر جيل معاملات التفكير: يُرجع
thinking_budgetوMINIMALخطأ HTTP 400، وأصبح المستوى الافتراضي هو High. - تعطّل معاملات أخذ العينات: يتم تجاهل temperature و top_p و top_k، ويجب إزالة penalty والمرشّحات المتعددة وجولات التعبئة المسبقة (prefill).
- التخزين المؤقت يعتمد على البنية: أُلغي التخزين المؤقت الصريح، ولا يتحقق التخزين المؤقت الضمني إلا عندما تصل البادئة المستقرة إلى 4,096 رمزًا (tokens).
- يجب أن تكون التوقيعات كاملة: توجد توقيعات الاستدعاء المتوازي فقط في أول functionCall، وتُعيد الاستجابات بالترتيب، ويمكن تعيين ضغط السجل إلى DROP.
- قارن أولاً ثم بدّل: استدعِ النموذجين القديم والجديد عبر APIYI apiyi.com باستخدام نفس المفتاح (Key)، وبعد التحقق بحركة مرور صغيرة، انتقل بالكامل.
الملخص
النقاط الأساسية للترقية من Gemini 3.8 Flash إلى Hydrogen:
- الطبقة الأساسية: تحديث معرّف النموذج وSDK، وفهم الحصة الموحّدة البالغة 1,048,576 tokens والحد الأعلى لإخراج المقطع الواحد البالغ 65,536 tokens؛
- طبقة المعاملات: استبدال
thinking_budgetبـthinking_level، وتنظيف حقول أخذ العينات والتوليد التي لم تبقَ فعّالة؛ - طبقة الحالة: إعادة تصميم بنية الموجه (البرومبت) لتحقيق إصابة الذاكرة المؤقتة الضمنية، والاحتفاظ بـ
thought_signatureوإعادته كما هو.
يُوصى بإجراء التعديلات بندًا بندًا وفق قائمة التحقق الواردة في هذه المقالة، وكتابة اختبارات انحدار لاستدعاءات الأدوات والمخرجات الطويلة، ثم تحويل حركة المرور الفعلية إلى النموذج الجديد. كما نوصي بإتمام مقارنة نتائج النموذجين القديم والجديد بسرعة عبر APIYI على apiyi.com، إذ تقدّم المنصة واجهة متوافقة مع OpenAI ورصيدًا تجريبيًا مجانيًا للمستخدمين الجدد.
📚 المراجع
- دليل ترحيل المطوّرين إلى Gemini 4 Hydrogen: تغييرات التوافق الرسمية وقائمة الترحيل
- الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
الوصف: المصدر المباشر لتفاصيل مثل الحد الأدنى لإصدار SDK وقواعد التوقيع وprefix_mismatch_behavior
-
مقدمة Gemini 4 ومقارنة فروق الترحيل: شرح المخرجات الطويلة وإصدارات API
- الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
الوصف: توضّح أن ميزة الاستكمال تتطلب استخدام v1beta1 API
-
مواصفات نموذج Google Cloud Hydrogen: جدول السياق والمعاملات ودعم الميزات
- الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
الوصف: القيم الثابتة لـ temperature وtop_p وtop_k وحالة دعم التخزين المؤقت
-
مدونة Google الرسمية: إعلان إصدار Gemini 4 Hydrogen
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
الوصف: تحديد موقع المنتج والبيانات الرسمية للمقارنة مع 3.8 Flash
-
صفحة أسعار Google AI Studio: أسعار API الرسمية
- الرابط:
aistudio.google.com/docs/pricing -
الوصف: أسعار الفئات القياسية وBatch وFlex وPriority وأسعار إصابة الذاكرة المؤقتة
-
تقييم Artificial Analysis المستقل: تقييم مستويات التفكير الأربعة
- الرابط:
artificialanalysis.ai/models/gemini-4-hydrogen -
الوصف: مؤشر الذكاء من طرف ثالث وبيانات مدة التقييم والتكلفة
-
بطاقة نموذج Google DeepMind: القدرات والقيود وتقييم الأمان
- الرابط:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - الوصف: القيود المعروفة والتقييم الرسمي عبر النماذج
المؤلف: فريق APIYI التقني
التواصل التقني: إذا واجهت مشكلات توافق أثناء الترحيل، يسعدنا التواصل معك عبر الموقع الرسمي لـ APIYI. ولمزيد من مواد التكامل، يمكنك الرجوع إلى مركز الوثائق docs.apiyi.com