ملاحظة المؤلف: تُظهر لوحة ترتيب Artificial Analysis Search Index بتاريخ 2026-11-09 أنه إذا ثبّتنا نموذج الإجابة وتغيّرنا إعدادات البحث وحدها، يمكن أن تنتقل الدرجة الإجمالية من 33 نقطة إلى 83 نقطة. لكن عند اختيار الحل المناسب لا يكفي ذلك، إذ يجب أن ننظر في الوقت نفسه إلى تكلفة المهمة والزمن المستغرق وحدود التقييم.
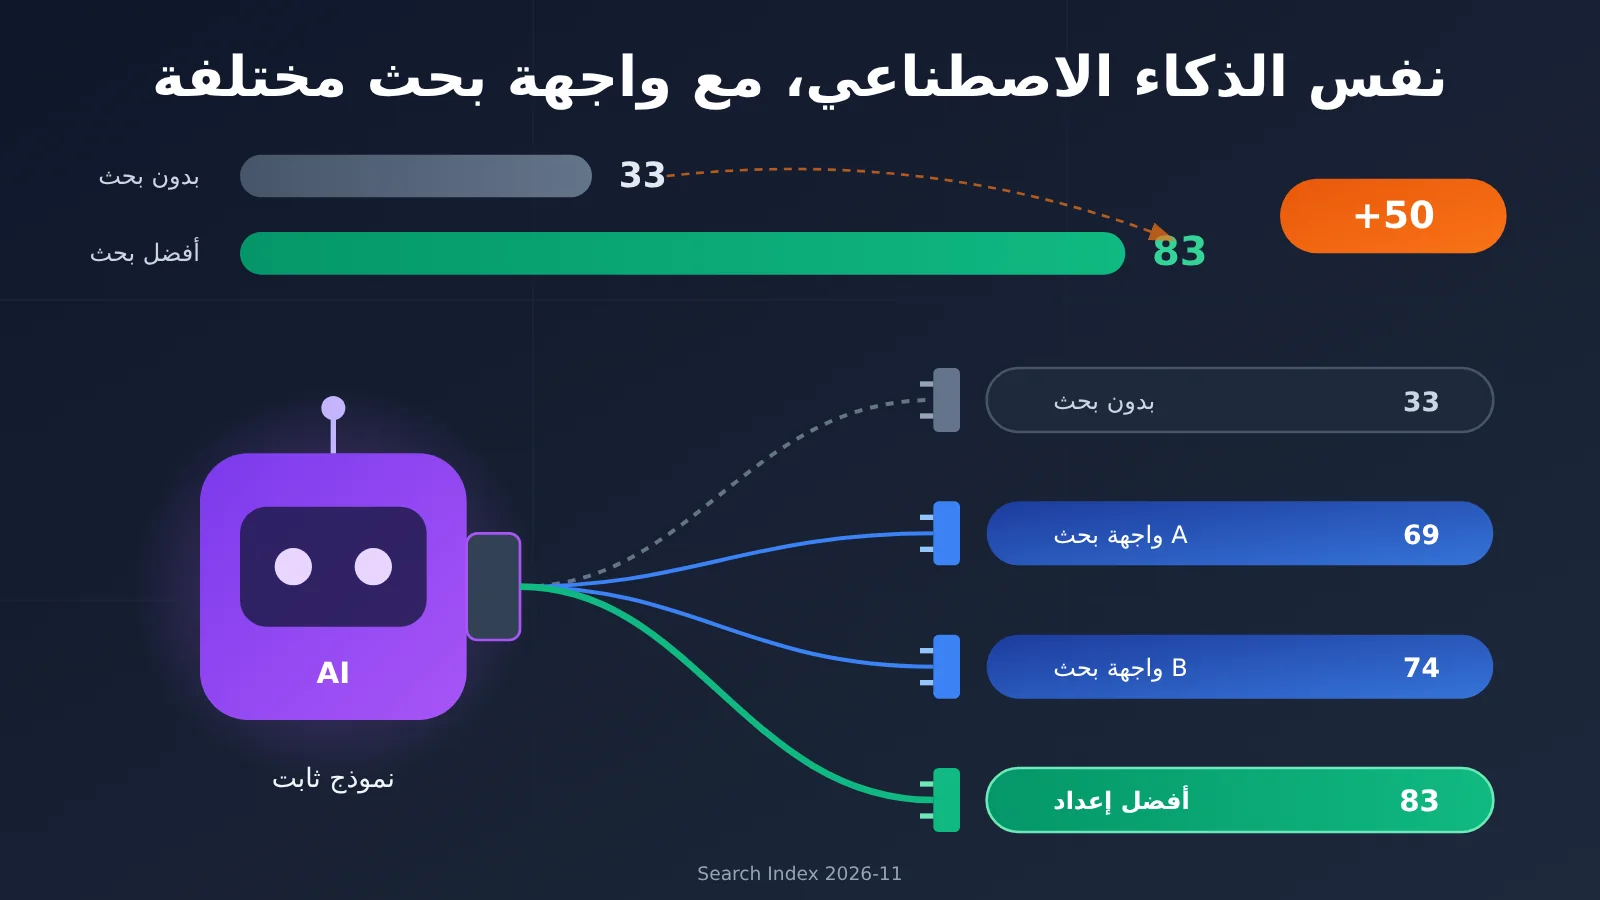
كثيرون عند بناء Agent يبدأون باختيار النموذج، ثم يربطون به أداة بحث على سبيل الاستكمال. وفي نظر كثير من الفرق، البحث ليس إلا ملحقًا «يكفي أن يكون متصلًا بالإنترنت». لكن Search Index الذي حدّثه Artificial Analysis في 9 نوفمبر 2026 قدّم نتيجة مختلفة: النموذج نفسه، دون ربط بالبحث، يحصل على 33 نقطة، ومع أفضل إعداد لواجهة API البحث يمكن أن يصل إلى 83 نقطة.
هذه ليست نسخة أخرى من لوحة ترتيب من نوع «لكل طرف مزاياه». ستشرح هذه المقالة كيفية حساب الـ83 نقطة وشروط الاختبار، ثم تضع الجودة والزمن الكامل للمهمة ورسوم البحث ورسوم النموذج في مقارنة واحدة. وأخيرًا توضّح، بحسب السيناريو، أي قرارات يمكن أن تُبنى على هذه اللوحة، وأين لا يمكن تطبيقها مباشرة.
القيمة الأساسية: بعد قراءة هذه المقالة ستتمكن من استخدام اللوحة العلنية لتصفية مرشحي API البحث، ثم إجراء مقارنة ثانية مع مهامك الخاصة، لتتجنّب اتخاذ القرار بناءً على أعلى درجة وحدها.
المصطلحات التي يجب معرفتها قبل قراءة لوحة ترتيب واجهات برمجة تطبيقات البحث
خلاصة في سطر واحد: يقارن Search Index أداء النموذج نفسه في إعدادات بحث مختلفة، وقد يبلغ الفارق بين الدرجات 50 نقطة كحد أقصى. لكن “الدرجة الأعلى” لا تعني بالضرورة “الأنسب لك”، فعليك أيضًا مراعاة التكلفة والوقت المستغرق ونطاق التقييم.
قبل قراءة اللوحة، لنوحّد المصطلحات التالية أولًا:
- Search Index: درجة إجمالية تُجمَّع وفق قواعد محددة من معيار استرجاع معيّن. ويشير هنا تحديدًا إلى مؤشر تقييم واجهات برمجة تطبيقات البحث من Artificial Analysis، بدرجة كاملة 100.
- F1: المتوسط التوافقي بين الدقة والاستدعاء. وعندما تكون الإجابة “مجموعة من الكيانات”، يُستخدم لقياس مدى دقة الإجابة وشمولها.
- Harness: إطار اختبار ينظّم إدخال النموذج وتنفيذ الأدوات وتقييم المهام. وتُسمى حلقة الوكيل التي تستخدمها Artificial Analysis باسم Stirrup.
- Search API: واجهة تُعيد نتائج استرجاع مثل روابط صفحات الويب والعناوين والمقتطفات ذات الصلة بناءً على الاستعلام، مثل Exa وBrave وPerplexity Search API.
- Token: وحدة قياس النص التي يعالجها النموذج. فكلما كانت نتائج البحث أكثر إسهابًا، زاد عدد الـ Token المُرسَلة إلى النموذج، وارتفعت تكلفة النموذج.
هل يمكن لـ API البحث أن يُحدث فرقًا بمقدار 50 نقطة في النموذج نفسه؟
أطلقت Artificial Analysis في 18 أغسطس 2026 معيارًا قياسيًا (benchmark) لـ API البحث. آخر تحديث للبيانات المنشورة كان في 9 نوفمبر 2026، ويغطي 14 مزود خدمة و26 منتجًا أو إعدادًا من إعدادات Search API. ما يجري تقييمه هنا ليس النموذج، بل الأداء الفعلي لخدمة البحث بعد وضعها داخل الوكيل (Agent).
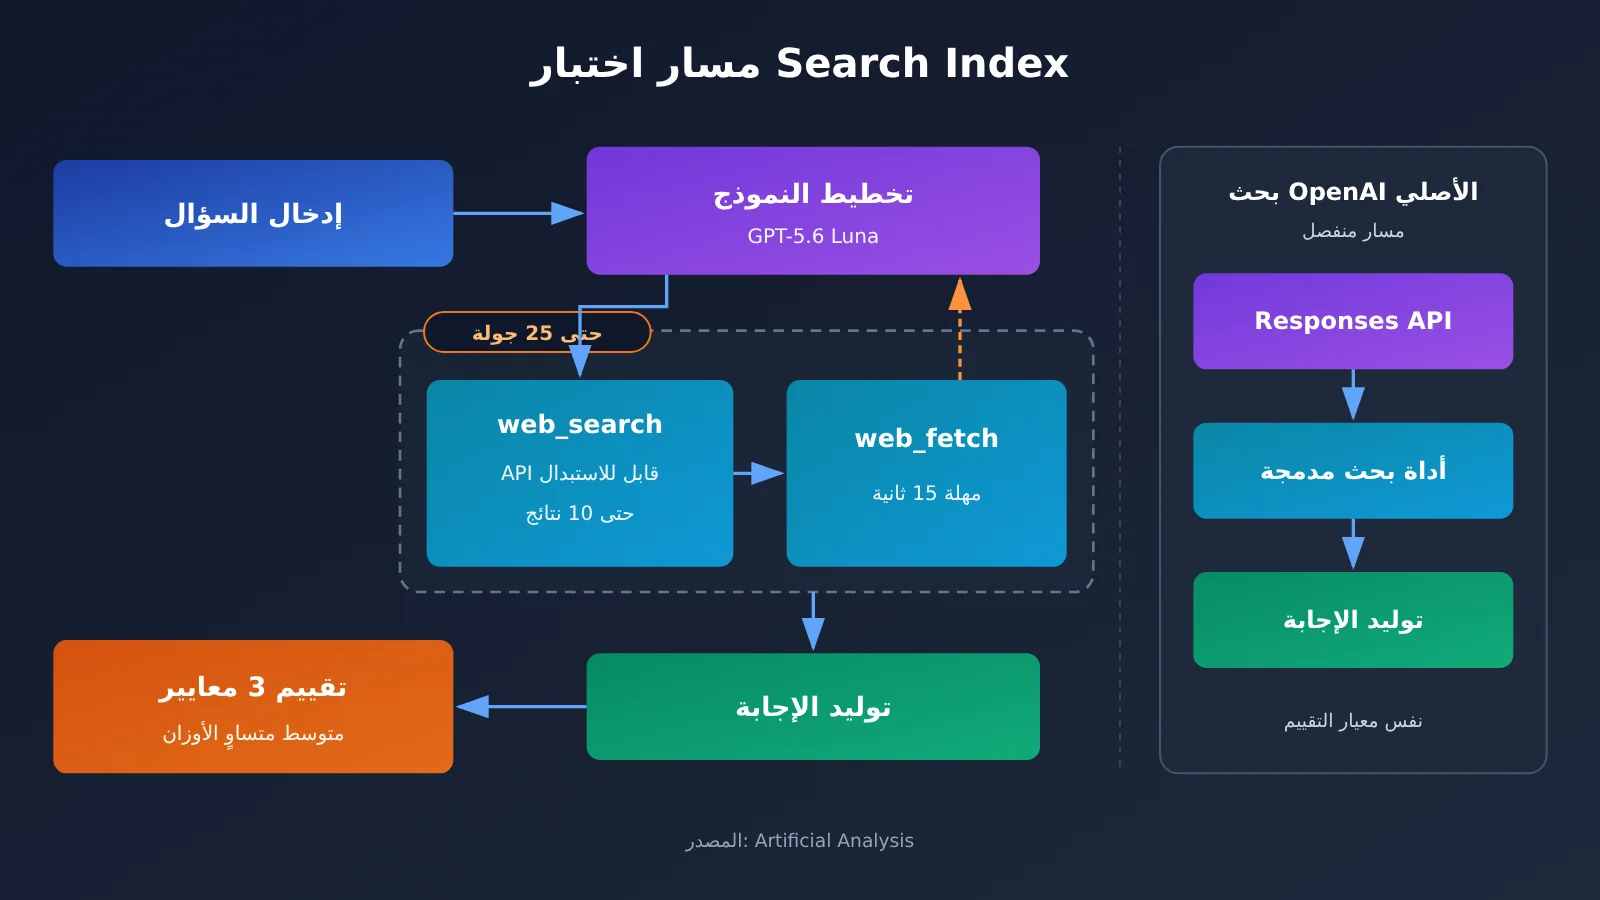
يكمن جوهر تصميم التجربة في «ضبط المتغيرات». نموذج الإجابة المرشح ثابت عند GPT-5.6 Luna (medium)، وإطار الـ Agent ثابت أيضًا، ولا يُستبدل سوى خدمة البحث. في هذه الظروف، كانت خط الأساس بدون أداة بحث 33 نقطة فقط، بينما بلغ Keenable Pro في المرتبة الأولى 83 نقطة، أي فرق 50 نقطة مؤشرية. وحتى بين الإعدادات المتصلة بالبحث، فإن الفرق من 69 نقطة لدى DeepSeek Search Summary إلى 83 نقطة لدى Keenable Pro يبلغ 14 نقطة.
وهناك استثناء واحد يحتاج إلى توضيح منفصل: طريقة تشغيل Web Search الأصلية من OpenAI مختلفة. فباقي واجهات Search API المستقلة تعمل داخل حلقة الـ Agent الخارجية الخاصة بـ Artificial Analysis. أما OpenAI Web Search فيستخدم تدفق الأدوات المدمجة في Responses API، حيث تحدد OpenAI بنفسها عدد عمليات البحث وطريقة تنفيذها. لذلك يمكن اعتبار نتيجته البالغة 74 نقطة مرجعًا، لكنها لا تُعتبر تجربة «تبديل API» في ظروف متطابقة تمامًا.
ويجب الانتباه أيضًا إلى أن هذه النقاط الخمسين هي أثر تعزيز البحث داخل منظومة التقييم نفسها. وهي لا تعني أن أي شخص يستخدم أي نموذج مع البحث سيحصل على تحسين قدره 50 نقطة مئوية.
كيف تُقاس فعليًا نتيجة 83 في Search Index؟
المعايير الثلاثة في Search Index وطريقة حساب النقاط
النتيجة الإجمالية هي متوسط متساوي الأوزان لثلاثة معايير، كل معيار يمثل الثلث:
| المعيار | حجم المهام | نوع المهمة | مقياس التقييم |
|---|---|---|---|
| DeepSearchQA | 900 مهمة | بحث حقائقي معقّد، والإجابات غالبًا مجموعات | F1 لمجموعة الإجابات |
| BrowseComp | 200 مهمة | أسئلة وأجوبة استرجاع ويب عالية الصعوبة | دقة الإجابة الدقيقة |
| AA-Omniscience | 600 مهمة | أسئلة حقائق | دقة الإجابة على أسئلة الحقائق |
مجموع المهام في المعايير الثلاثة 1,700 مهمة، لكن النتيجة الإجمالية ليست نسبة الإجابات الصحيحة بعد دمج الأسئلة الـ1,700 في حساب واحد. فبأخذ Keenable Pro مثالًا، جاءت النتائج الثلاثة بالترتيب 88 و87 و73، ومتوسطها نحو 82.67، وبعد التقريب تظهر 83. لذا فإن 83 نقطة لا تعني «نسبة إجابات صحيحة 83%».
شروط اختبار Search Index
الإعدادات الأساسية المعلنة في المنهجية هي التالية:
| بند التجربة | الإعداد الفعلي |
|---|---|
| نموذج توليد الإجابات المرشحة / نموذج التقييم | GPT-5.6 Luna (medium) |
| الحد الأقصى لدورات الوكيل | 25 دورة، مع عدم تحديد عدد استدعاءات الأدوات داخل الدورة |
| الأدوات المتاحة | web_search وweb_fetch (قراءة صفحة ويب مستقلة) |
| نتائج كل عملية بحث | 10 نتائج كحد أقصى |
| مهلة جلب نص الصفحة | 15 ثانية لكل صفحة |
| المحتوى المُعاد إلى النموذج | المحتوى الأصلي من استجابة مزوّد الخدمة |
| خط الأساس بدون بحث | النموذج نفسه، دون استخدام أدوات البحث |
من هذا الجدول يمكن استخلاص نقطتين. أولًا، ما يُعاد إلى النموذج هو «استجابة مزوّد الخدمة الأصلية»، أي أن طول المقتطف وطريقة التلخيص وتنظيم التظليل كلها تدخل في سياق النموذج، وبالتالي فإن النتيجة تعكس ليس فقط جودة فهرس الويب الأساسي، بل أيضًا طريقة تنظيم المعلومات. ثانيًا، الأخطاء القاتلة مثل 429 أو 5xx أو انتهاء المهلة يجري إعادة المحاولة فيها باستمرار حتى تنجح، ولا تُحتسب ضمن النتيجة النهائية. وهذا يعني أن القائمة تقيس الجودة «عند نجاح التشغيل»، ولا يمكن الاستدلال بها على جاهزية الخدمة أو معدل الأعطال لدى كل مزوّد في بيئة الإنتاج.
أحدث ترتيب Search Index: من يقدّم أفضل نتائج API للبحث؟
في الجدول أدناه، تأتي درجة الجودة وBrowseComp من قائمة 2026-11-09. أما الأوقات فهي القيم المقروءة من قائمة 2026-11-13، وتعني متوسط الوقت من بداية مهمة اختبار قياسية إلى نهايتها، وليست زمن الاستجابة الشبكي لطلب واحد إلى API البحث.
| إعداد البحث | الدرجة الإجمالية (11-09) | BrowseComp | متوسط وقت المهمة (11-13) |
|---|---|---|---|
| Keenable Pro | 83 | 87% | 16.6 ثانية |
| Keenable Realtime | 82 | 86% | 16.0 ثانية |
| Exa Auto + Dynamic Highlights | 80 | 83% | 36.7 ثانية |
| Perplexity Search Medium | 80 | 87% | 31.1 ثانية |
| Exa Lite + Dynamic Highlights | 79 | 81% | 19.4 ثانية |
| Parallel Advanced | 75 | 77% | غير مدرج في تحديث الأوقات هذا |
| Brave LLM Context | 75 | 77% | غير مدرج في تحديث الأوقات هذا |
| OpenAI Web Search Medium (العملية المدمجة في Responses) | 74 | 74% | 33.1 ثانية |
| DeepSeek Search Summary | 69 | 63% | 22.4 ثانية |
| خط الأساس بدون بحث | 33 | 17% | — |
ثلاثة فروق نموذجية في ترتيب API البحث
الدرجة نفسها، لكن السرعة مختلفة. Exa Auto وPerplexity Medium حصل كلاهما على 80 درجة، لكن وقت المهمة الكامل بلغ 36.7 ثانية و31.1 ثانية على التوالي. أما Keenable Pro فدرجته أعلى، ومع ذلك لا يتجاوز وقته نحو 16.6 ثانية. وبالنسبة إلى وكيل (Agent) يحتاج إلى استجابة فورية، فإن هذا الفرق يلمسه المستخدم مباشرة.
BrowseComp لا يتبع الدرجة الإجمالية تمامًا. حقق Perplexity Medium في BrowseComp نسبة 87%، وهو نفس مستوى Keenable Pro، لكن درجته الإجمالية أقل بثلاث نقاط. والفرق يعود أساسًا إلى المعيارين الآخرين. وإذا كان نشاطك التجاري أقرب إلى «استرجاع صفحات الويب للمسائل الصعبة»، فيمكنك الرجوع إلى عمود BrowseComp وحده.
الأنماط المختلفة لدى المورّد نفسه تتباين كثيرًا. الفرق بين Exa Lite وExa Auto نقطة واحدة فقط، لكن الوقت يتضاعف تقريبًا. لذلك ينبغي قراءة النتائج بحسب نمط المنتج المحدد، ولا ينبغي دمج Exa Lite وExa Auto في «درجة Exa» واحدة.
💡 توضيح البيانات: الدرجات أعلاه هي نتائج تقييم طرف ثالث من Artificial Analysis، والأوقات هي أوقات مهام قياسية. وإذا أردت إعادة إنتاج مقارنة مشابهة على مسائل عملك، فيمكنك عبر APIYI apiyi.com تثبيت نموذج إجابة واحد، ثم ربط أدوات بحث مختلفة لإجراء اختبار A/B.
هل أعلى درجة في API البحث هي الأكثر اقتصادًا حقًا؟
تنشر Artificial Analysis أيضًا تقديرات التكلفة لكل 1,000 مهمة من مهام المعيار، مقسّمة إلى رسوم البحث ورسوم النموذج (قائمة 2026-11-09، بالدولار الأمريكي). عمود «التكلفة لكل نقطة» استنتجه محرر هذا المقال بشكل تقريبي من «التكلفة الإجمالية ÷ الدرجة الإجمالية»، وهو للاستخدام كمرجع أفقي فقط وليس مؤشرًا رسميًا.
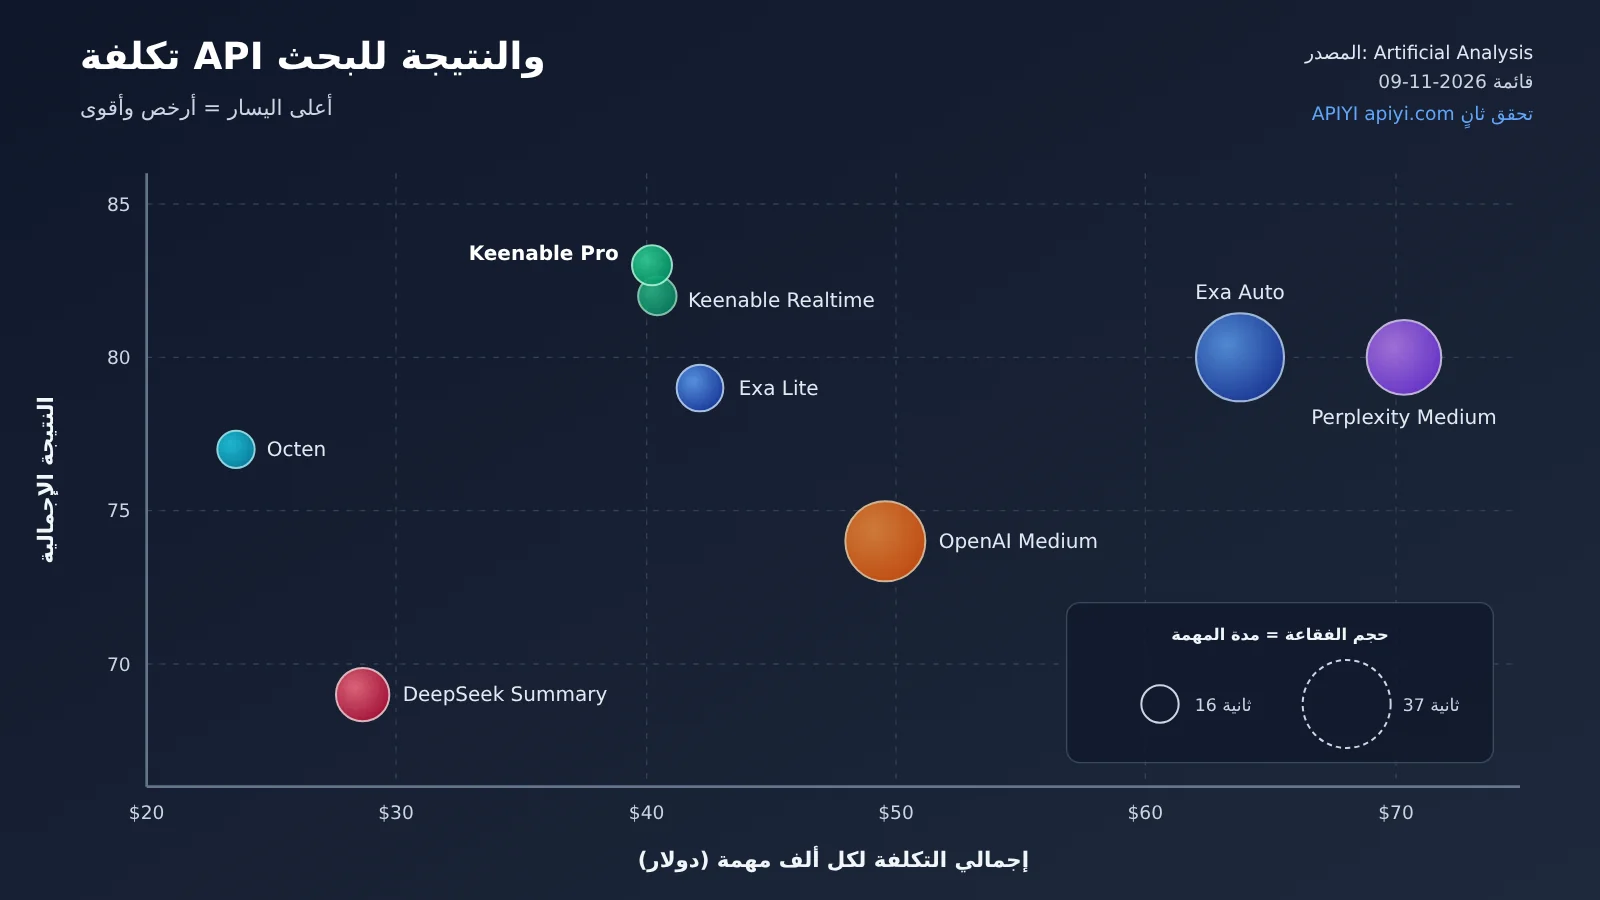
| إعدادات البحث | درجة الجودة | رسوم البحث + رسوم النموذج | التكلفة الإجمالية/1000 مهمة | التكلفة لكل نقطة (استنتاج المحرر) | زمن المهمة (11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | نحو $0.48 | 16.6 ثانية |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | نحو $0.49 | 16.0 ثانية |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | نحو $0.80 | 36.7 ثانية |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | نحو $0.88 | 31.1 ثانية |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | نحو $0.53 | 19.4 ثانية |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | نحو $0.31 | 15.6 ثانية |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | نحو $0.67 | 33.1 ثانية |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | نحو $0.42 | 22.4 ثانية |
ثلاثة استنتاجات من جدول تكاليف واجهات البحث
أعلى درجة ليست بالضرورة الأعلى تكلفة. يتصدّر Keenable Pro القائمة بدرجة 83 نقطة، بتكلفة تقارب 40.22 دولارًا لكل ألف مهمة، أي نحو 0.04 دولار للمهمة الواحدة، وهو مستوى متوسط ضمن العيّنة. أما Perplexity Medium فدرجته أقل بـ3 نقاط، لكن تكلفته الإجمالية تزيد بنحو 75%.
فارق نقطة واحدة قد يعني فرقًا في التكلفة يتجاوز الثلث. حقق Exa Lite + Highlights درجة 79 نقطة بتكلفة 42.15 دولارًا لكل ألف مهمة، بينما حقق Exa Auto + Highlights درجة 80 نقطة بتكلفة 63.77 دولارًا لكل ألف مهمة؛ أي أن الأول أرخص بنحو 34% وأسرع أيضًا. وبالرجوع إلى صفحة التسعير الرسمية لـ Exa (بيانات حتى 2026-11-13)، فإن فئة Lite تكلف 4 دولارات لكل 1,000 طلب، وفئة Auto تكلف 7 دولارات لكل 1,000 طلب. وهذا التباين في رسوم البحث على القائمة يتوافق مع بنية التسعير هذه.
انخفاض رسوم البحث قد يرافقه ارتفاع في رسوم النموذج. رسوم البحث في DeepSeek Search Summary لا تتجاوز 8.47 دولارًا، لكن رسوم النموذج تبلغ 20.19 دولارًا، وهي الأعلى في الجدول. أما Octen فإجمالي تكلفته هو الأدنى، لكن رسوم النموذج لديه أعلى أيضًا من Keenable وExa وPerplexity. فعندما لا تكون نتائج البحث مفيدة بما يكفي، يضطر الوكيل الذكي إلى البحث أكثر لعدة دورات وقراءة صفحات إضافية، فيرتفع استهلاك الرموز (Tokens) تبعًا لذلك. لذلك ينبغي عند حساب التكلفة الاعتماد على «التكلفة الإجمالية لإنجاز مهمة واحدة» بدلًا من النظر فقط إلى السعر المعلن لكل استدعاء في واجهة البحث.
ما القرارات العملية التي يمكن أن يرشدنا إليها تصنيف Search Index؟
Search Index هو تقييم عام للاسترجاع الواقعي (fact retrieval) يغلب عليه المحتوى الإنجليزي، وليس معيارًا مخصصًا للإنترنت الصيني. في ما يلي نربطه بأشهر سيناريوهات الـ Agent، ونوضح أي السيناريوهات يمكن الاعتماد فيها على التصنيف مباشرة، وأيها يحتاج إلى اختبارات إضافية.
| سيناريو الـ Agent | المؤشر الأهم | قيمة الاعتماد على التصنيف | المرشحون المقترحون |
|---|---|---|---|
| الأسئلة الواقعية | الدقة، ودقة الاستشهادات | عالية، ويمكن الاعتماد مباشرة على AA-Omniscience | Keenable، Exa Lite، Perplexity |
| البحث المعقد متعدد المصادر | الاسترجاع متعدد الخطوات، واستدعاء المجموعات | عالية، مع التركيز على DeepSearchQA و BrowseComp | Keenable Pro، Exa Auto، Perplexity Medium |
| Agent منخفض زمن الاستجابة | الزمن الكلي لإنجاز المهمة، وزمن استجابة P95 | متوسطة، فالزمن الكلي للمهمة لا يُعد سوى مؤشر مرجعي | Keenable Realtime، Octen، Exa Lite |
| استرجاع الأخبار بالصينية | تغطية المصادر الصينية، وإمكانية الوصول إلى المواقع المحلية | منخفضة، وتحتاج إلى بناء مجموعة اختبار صينية خاصة بك | أضف إليها Baidu Qianfan وBocha وAlibaba Cloud Bailian للمقارنة |
| استرجاع الوثائق البرمجية | تغطية الوثائق الرسمية، ومعلومات الإصدارات | منخفضة إلى متوسطة، وتحتاج إلى إعادة اختبار بأسئلة تقنية حقيقية | Exa، Perplexity، Parallel |
طريقة استخدام Search Index في مقارنة ثانية لواجهات البحث API
النهج الأكثر منطقية هو التعامل مع التصنيفات العامة باعتبارها “أداة فرز أولي”، ثم إجراء مقارنة ثانية بمهامك الخاصة:
- اختر ٣–٤ إعدادات مرشحة من التصنيف وفق ثلاثة معايير: الجودة، والزمن المستغرق، والتكلفة الإجمالية؛
- جهّز ٥٠–١٠٠ سؤال من أسئلة عملك الفعلية، تغطي الحقائق البسيطة، والأخبار الحديثة، والأسئلة متعددة الخطوات، والاستعلامات بالصينية وبين اللغات المختلفة؛
- ثبّت نموذج الإجابة نفسه، والحد الأقصى نفسه لعدد الجولات، وعدد النتائج نفسه، وغيّر أداة البحث فقط؛
- سجّل الدقة، ودقة الاستشهادات، والتكلفة الإجمالية لكل مهمة، وزمن P50/P95، وعدد مرات النتائج الفارغة والمهلات الزمنية (timeouts)؛
- اجري اختبار إجهاد منفصلًا لاستقرار بيئة الإنتاج، لأن التصنيف قد استبعد بالفعل الأخطاء الفادحة التي تظهر بعد إعادة المحاولة.
توصيات قرار اختيار API البحث والبدء السريع
🎯 توصية الاختيار: إذا كنت تبحث عن الجودة الشاملة والسرعة، فاختبر أولاً Keenable Pro/Realtime؛ وإذا كنت حساسًا للتكلفة وتريد جودة قريبة من 80 نقطة، فإن Exa Lite + Highlights وOcten يستحقان اختبارًا جديًا؛ أما الفرق التي تستخدم منظومة OpenAI بعمق فيمكنها استخدام Web Search المدمج مباشرة، لكن عليها تقبّل أن تدفق تنفيذه غير قابل للتحكم. عند التطبيق الفعلي، نوصي باستدعاء نموذج الإجابة بشكل موحد عبر APIYI apiyi.com، وجعل أداة البحث وحدة قابلة للتركيب، بحيث لا تحتاج إلى تعديل الكود الخاص بجانب النموذج عند تغيير API البحث.
مثال بسيط: النموذج يستخدم واجهة موحدة
يثبّت الكود التالي نموذج الإجابة، ويُعلن أداة البحث كدالة، ويمكنك استبدال أي موفر Search API ينفّذها فعليًا في الكود المحلي:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، النموذج قابل للاستبدال
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # استبدله بالنموذج الذي تريد تقييمه
    messages=[{"role": "user", "content": "Exa 3.0 是哪天发布的?"}],
    tools=tools,
)
print(resp.choices[0].message)
عرض الكود الكامل: مقارنة A/B لعدة Search API باستخدام نفس النموذج
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # نموذج إجابة ثابت، للحفاظ على متغير التحكم
MAX_TURNS = 25          # حد أقصى للدورات متوافق مع Search Index

# دوال التكيّف مع كل موفر Search API، نفّذها بنفسك وفق الوثائق الرسمية
def search_provider_a(query: str) -> list:
    return []  # إرجاع [{"title":..., "url":..., "snippet":...}]

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Perplexity 何时推出独立 Search API?", fn))
🚀 البدء السريع: يمكن للمستخدمين الجدد الحصول على رصيد تجريبي مجاني من APIYI على apiyi.com، ابدأ بتشغيل سكربت A/B أعلاه على عدد قليل من أسئلة العمل، ثم قرّر أي موفر Search API ستدخله في خطتك الرسمية.
الأسئلة الشائعة FAQ
س1: ما هو Search Index؟
Search Index هو مؤشر تقييم واجهات برمجة تطبيقات البحث (API) الذي أطلقه Artificial Analysis. يعتمد على تثبيت نموذج الإجابة وإطار عمل الـ Agent، ويستبدل خدمة البحث فقط، ثم يقيس فعالية البحث عبر متوسط متساوي الأوزان لثلاثة معايير: DeepSearchQA وBrowseComp وAA-Omniscience، بدرجة كاملة 100.
س2: هل درجة 83 تعني نسبة إجابات صحيحة 83%؟
لا. الرقم 83 هو متوسط درجات المعايير الثلاثة، كما أن مؤشراتها نفسها مختلفة: DeepSearchQA يستخدم F1، بينما يستخدم المعياران الآخران الدقة. وبالنسبة إلى Keenable Pro جاءت الدرجات الثلاث على التوالي 88 و87 و73، بمتوسط يقارب 82.67، ويُعرض على شكل 83.
س3: إلى أي تاريخ تعود بيانات القائمة؟
بيانات درجات الجودة والتكلفة مأخوذة من تحديث القائمة بتاريخ 2026-11-09، أما أزمنة المهام الكاملة فهي القيم المقروءة بتاريخ 2026-11-13. القائمة تُحدَّث باستمرار، لذا يُنصح بذكر التاريخ عند الاستشهاد بها.
س4: هل يمكن اعتبار الزمن المذكور في القائمة سرعة استجابة واجهة البحث API؟
لا. الزمن في الجدول هو الزمن الكامل لمهمة قياسية واحدة، ويشمل عدة جولات بحث وقراءة صفحات ويب واستدلال النموذج. أما زمن تأخير طلب HTTP الواحد فيحتاج إلى قياس منفصل، ويُفضَّل تسجيل P50 وP95 معًا.
س5: كيف أقارن بسرعة بين واجهات بحث API مختلفة داخل أعمالي؟
ثبِّت نموذج إجابة واحدًا، واستبدل أداة البحث فقط. يمكنك استدعاء النموذج عبر APIYI apiyi.com باستخدام واجهة متوافقة مع OpenAI، مع ضبط `base_url` على `https://api.apiyi.com/v1`، ثم تطبيق سكربت A/B الوارد في هذا المقال. وإذا أردت أيضًا رؤية تغيّر نتائج البحث بعد تبديل النموذج، فيمكنك بمفتاح API نفسه التبديل بين نماذج OpenAI وClaude وGemini وغيرها.
س6: ما القيود التي يفرضها Search Index؟
أربعة قيود رئيسية: فهو ليس معيارًا مخصصًا للإنترنت الصيني؛ وعملية تنفيذ البحث الأصلي في OpenAI تختلف عن بقية الإعدادات؛ والأخطاء مثل 429 و5xx والمهلة الزمنية لا تُحتسب في النتائج بعد إعادة المحاولة، وبالتالي لا تعكس استقرار بيئة الإنتاج؛ والتكلفة مبنية على تقديرات مهام التقييم وقد لا تتطابق مع فاتورتك الفعلية. وللبحث في الأخبار الصينية والوثائق التقنية المحلية، يُنصح ببناء مجموعة اختبار خاصة، والتحقق منها بالاشتراك بين APIYI apiyi.com والنماذج الصينية المحلية.
اختيار Search API وفق مؤشر Search Index: أهم النقاط
- البحث متغيّر مستقل: النموذج نفسه ارتفع من 33 نقطة إلى 83 نقطة، أي أن اختيار Search API يؤثر مباشرة في جودة الـ Agent.
- 83 نقطة ليست نسبة الدقة: إنها متوسط متساوي الأوزان لثلاثة معايير تقييم، ولكل معيار طريقة مختلفة في احتساب الدرجات.
- الزمن يُقاس على المهمة الكاملة: Keenable حوالي 16 ثانية، وExa Auto حوالي 37 ثانية، وكلاهما ليس زمن تأخير استدعاء API واحد.
- التكلفة يجب أن تُفكَّك: قد تقابل رسوم البحث المنخفضة رسومٌ أعلى للنموذج، لذا ينبغي المقارنة بإجمالي تكلفة المهمة الواحدة.
- نقطة واحدة قد تعني فرق 34%: الفرق بين Exa Lite وAuto نقطة واحدة فقط، لكن الأول أرخص بنحو الثلث.
- القائمة تصلح للفرز الأولي فقط: في سيناريوهات اللغة الصينية ووثائق البرمجة وغيرها، تحتاج إلى مقارنة A/B ثانية باستخدام مهامك الخاصة.
الخلاصة
أكثر ما يستحق الاهتمام في قائمة Search Index هذه هو أنها صُممت على أساس «النموذج نفسه، وأدوات بحث مختلفة»، فعزلت تأثير جودة البحث في الـ Agent وقاسَته بشكل منفصل:
- الجودة: بدون بحث 33 نقطة، وبحد أقصى 83 نقطة. وحتى مع إضافة البحث في كل الحالات، يبقى فرق بنحو 14 نقطة بين الإعدادات المختلفة؛
- السرعة: عند نفس الدرجة 80، يمكن أن يختلف زمن المهمة الكاملة بأكثر من 5 ثوانٍ؛ والإعدادات ذات الدرجات العالية يمكن أن تكون سريعة أيضًا؛
- التكلفة: Keenable Pro هو الأعلى جودة، وتكلفته متوسطة؛ وExa Lite وOcten متميزان في كفاءة التكلفة؛ ومثال DeepSeek Summary يوضح أن انخفاض رسوم البحث لا يعني انخفاض التكلفة الإجمالية.
أنصح أولاً باختيار 3–4 مرشحين من القائمة، ثم تثبيت النموذج نفسه وإجراء اختبار A/B على مجموعة أسئلتك الخاصة. ويُفضّل توحيد استدعاء نموذج الإجابة عبر APIYI على apiyi.com، مع جعل أداة البحث وحدة قابلة للاستبدال، ثم حسم الحل النهائي اعتمادًا على ثلاثة بيانات: الجودة والسرعة والتكلفة.
المراجع
- قائمة Artificial Analysis Search API: بيانات درجة الجودة والتكلفة والزمن
- الرابط:
artificialanalysis.ai/agents/search-api -
الوصف: المصدر الرئيسي للدرجات والتكاليف والزمن في هذا المقال
-
منهجية تقييم Artificial Analysis Search API: إعدادات الاختبار وقواعد احتساب الدرجات
- الرابط:
artificialanalysis.ai/methodology/search-api -
الوصف: تشمل شرح النماذج وعدد الجولات وعدد النتائج وقواعد إعادة المحاولة وغيرها
-
تسعير Exa: تسعير فئات Lite وAuto وغيرها
- الرابط:
exa.ai/pricing -
الوصف: يُستخدم لفهم الفرق في رسوم البحث بين أوضاع Exa المختلفة في القائمة
-
إعلان Exa 3.0: وضع Lite وDynamic Highlights
- الرابط:
exa.ai/blog/exa-3 -
الوصف: نُشر في 2026-10-19، ويحتوي على بيانات اختبار ذاتي من المزوّد
-
وثائق OpenAI Web Search: أداة البحث المدمجة في Responses API
- الرابط:
developers.openai.com/api/docs/guides/tools-web-search -
الوصف: للتعرف على طريقة تنفيذ البحث الأصلي في OpenAI ومعاملاته
-
تسعير Perplexity Search API: الفئتان القياسية وFast
- الرابط:
docs.perplexity.ai/docs/getting-started/pricing - الوصف: للتعرف على قواعد الفوترة حسب الطلب
المؤلف: فريق APIYI التقني
التواصل التقني: مرحبًا بك للتواصل معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من مواد التكامل يمكنك زيارة مركز الوثائق docs.apiyi.com