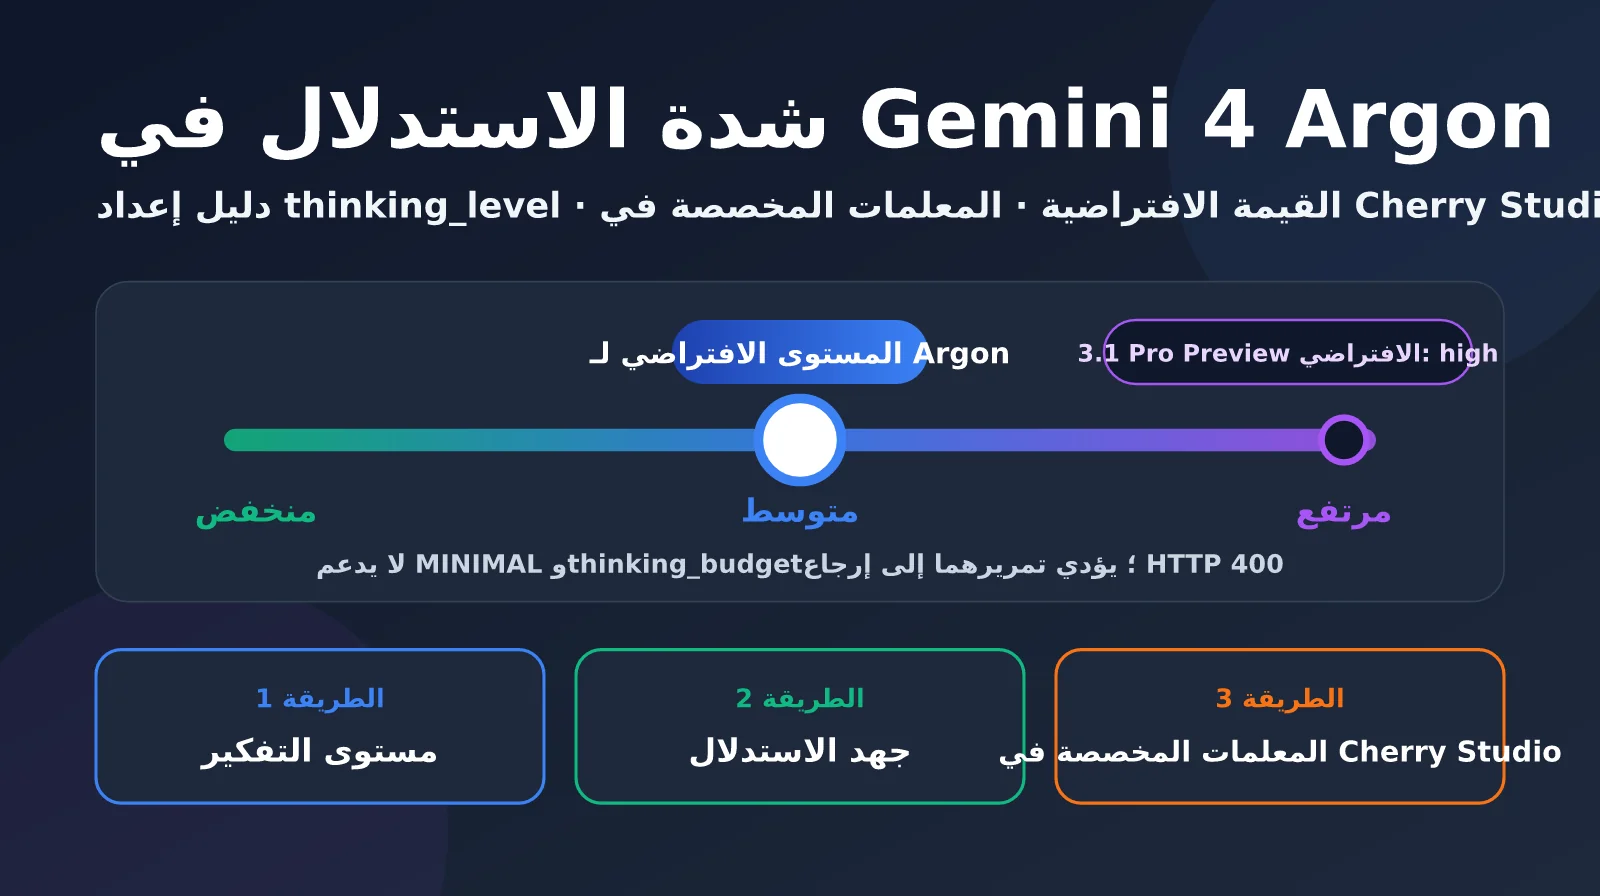
بعد الانتقال من gemini-3.1-pro-preview إلى Gemini 4 Argon، لاحظ عدد من المطورين مشكلة: مع استخدام موجهات متطابقة، تبدو إجابات Argon أحيانًا أقل عمقًا في التفكير. وقد يكون السبب هو القيمة الافتراضية لـ مستوى الاستدلال في Gemini 4 Argon. فوفقًا لوثائق Google الرسمية، القيمة الافتراضية لـ thinking_level في Gemini 4 Argon هي medium، وليست high، بينما القيمة الافتراضية لـ gemini-3.1-pro-preview هي أعلى مستوى، أي high. إذا لم يسبق لك ضبط مستوى الاستدلال صراحةً في الشفرة أو العميل الذي تستخدمه، فقد تنخفض درجة عمق تفكير النموذج بصمت بعد الانتقال.
والأمر الأكثر إزعاجًا هو أن عملاء المحادثة الشائعين، مثل Cherry Studio، يتأخرون غالبًا في دعم معلمات الاستدلال الخاصة بالنماذج الجديدة، وقد لا يظهر خيار مستوى الاستدلال في مربع الإدخال أصلًا. يوضح هذا المقال أولًا القيم المتاحة لمستوى الاستدلال في Gemini 4 Argon وقيمته الافتراضية وتأثيره في الفوترة، ثم يعرض ثلاث طرق لضبطه: واجهة API الأصلية، والواجهة المتوافقة مع OpenAI، والمعلمات المخصصة في Cherry Studio.
الفائدة الأساسية: بعد قراءة المقال، ستتمكن من ضبط مستوى الاستدلال في Gemini 4 Argon كما تريد، أيًا كانت طريقة استدعائه، وتجنّب مشكلات الترحيل مثل اقتطاع max_tokens وأخطاء HTTP 400 الناتجة عن المعلمات.
أهم النقاط حول مستوى الاستدلال في Gemini 4 Argon
يُضبط مستوى الاستدلال في Gemini 4 Argon عبر المعلمة thinking_level، التي تدعم ثلاثة مستويات فقط: low وmedium وhigh. وعلى خلاف النماذج السابقة، ألغى Argon خيار thinking_budget الذي يحدد المستوى بعدد الرموز، كما أنه لا يدعم المستوى minimal. وسيؤدي ضبط أيٍّ منهما إلى استجابة مباشرة بخطأ HTTP 400. يلخص الجدول التالي التوضيحات الرسمية للمستويات الثلاثة الواردة في دليل مطوري Google Cloud.
| مستوى الاستدلال | هل هو افتراضي؟ | الاستخدامات الموصى بها رسميًا | الخصائص |
|---|---|---|---|
| LOW | لا | التصنيف، والتلخيص، واستخراج البيانات الوصفية | أقل زمن استجابة، ولا ينتج تقريبًا أي رموز تفكير |
| MEDIUM | ✅ المستوى الافتراضي في gemini-4-argon | البرمجة المعتادة، واستدعاء الأدوات، والأسئلة والأجوبة حول المستندات، وفهم الفيديو | توازن بين السرعة والتكلفة والدقة |
| HIGH | ✅ المستوى الافتراضي في إصدار cyber-permissive | هندسة البرمجيات متعددة الملفات، والبراهين الصورية، وتصميم البنية، واكتشاف الثغرات | أعمق تفكير، مع ارتفاع ملحوظ في زمن ظهور أول رمز والتكلفة |
| MINIMAL | غير مدعوم | — | يؤدي ضبطه إلى خطأ HTTP 400 |
| thinking_budget | غير مدعوم | — | كانت النماذج السابقة تحوّله بصمت، أما Argon فيُرجع خطأ 400 مباشرةً |
يجدر الانتباه إلى أن إصدار gemini-4-argon-cyber-permissive الموجّه إلى المدافعين عن الشبكات ضمن برنامج Fairwind يستخدم HIGH افتراضيًا، بينما الإصدار القياسي gemini-4-argon وحده يستخدم MEDIUM افتراضيًا. كذلك، أُجريت جميع تقييمات Argon الواردة في جداول Google على أعلى مستوى للاستدلال. لذلك، إذا استدعيت النموذج باستخدام المستوى الافتراضي medium، فقد لا يصل أداؤه الفعلي إلى المستوى الذي تروّج له Google.
مقارنة القيمة الافتراضية لمستوى الاستدلال في Gemini 4 Argon بالنماذج السابقة
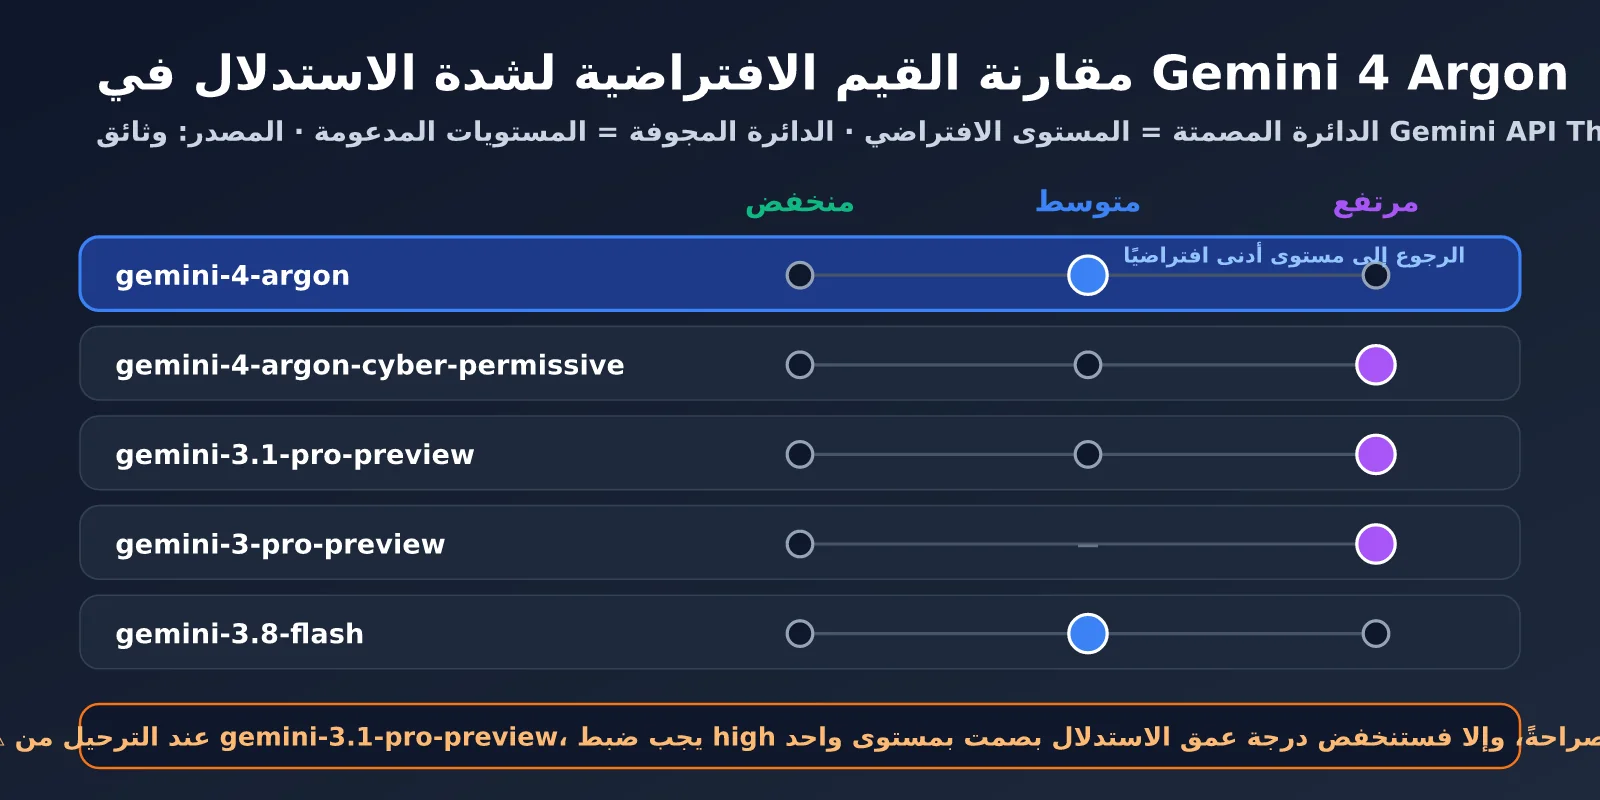
تتضح مخاطر الترحيل عند مقارنة القيم الافتراضية لمستوى الاستدلال في Gemini 4 Argon مع عدد من نماذج Gemini الحديثة. البيانات التالية مأخوذة من وثائق Google الرسمية حول التفكير في Gemini API.
| النموذج | مستوى الاستدلال الافتراضي | المستويات المدعومة |
|---|---|---|
| gemini-4-argon | medium | low، medium، high |
| gemini-4-argon-cyber-permissive | high | low، medium، high |
| gemini-3.1-pro-preview | high | low، medium، high |
| gemini-3-pro-preview | high | low، high |
| gemini-3.8-flash | medium | low، medium، high |
| gemini-3-flash-preview | high | minimal، low، medium، high |
يتضح أن Google تخفّض المستوى الافتراضي للاستدلال في نماذجها الجديدة من high إلى medium، كما فعلت مع Gemini 3.8 Flash وGemini 4 Argon. يقلل هذا التغيير زمن الاستجابة والتكلفة افتراضيًا، لكن إذا اعتدت على أن يفكر 3.1 Pro بأقصى قدر افتراضيًا، فعليك ضبط المستوى high صراحةً عند الانتقال إلى Argon للحفاظ على عمق الاستدلال نفسه.
🎯 نصيحة للترحيل: عند الانتقال من
gemini-3.1-pro-previewإلى Gemini 4 Argon، يُستحسن ضبط مستوى الاستدلال صراحةً في الشفرة أولًا، ثم مقارنة جودة مخرجات النموذجين. ومن خلال الواجهة الموحدة لمنصة APIYI على apiyi.com، يمكنك استدعاء نموذجي Gemini الجديد والقديم معًا لإجراء اختبار A/B، بمجرد تغيير معلمةmodel.
العلاقة بين مستوى الاستدلال في Gemini 4 Argon والفوترة
لا يؤثر مستوى الاستدلال في جودة الإجابة فحسب، بل يحدد الفاتورة أيضًا. تُحتسب رموز التفكير في Argon بسعر رموز الإخراج: 10 دولارات لكل مليون رمز خلال الفترة التمهيدية، و20 دولارًا بالسعر الرسمي. ولا تُعرض عملية التفكير كاملةً للمستخدم افتراضيًا. أي إن رفع مستوى الاستدلال يعني دفع المزيد مقابل «تفكير غير مرئي».
وبتقدير تقريبي وفق السعر التمهيدي، إذا أنتج طلب واحد بمستوى high نحو 1500 رمز تفكير، فستضيف مرحلة التفكير وحدها حوالي 0.015 دولار إلى التكلفة. ومع 10 آلاف استدعاء يوميًا، قد تصل الزيادة خلال شهر إلى نحو 4500 دولار. وهذا أحد الأسباب العملية التي دفعت Google إلى خفض المستوى الافتراضي لـ Argon إلى medium: فمعظم الطلبات اليومية لا تحتاج إلى أعمق مستويات الاستدلال، بينما يجعل المستوى الافتراضي high كثيرًا من المستخدمين يدفعون مقابل تفكير لا يحتاجون إليه. لذلك، الأفضل توزيع مستويات الاستدلال بحسب نوع المهمة، بدلًا من ضبط high على مستوى النظام كله.
ثلاث طرق لضبط مستوى الاستدلال في Gemini 4 Argon
بحسب طريقة الاستدعاء، تتوفر ثلاث طرق لضبط مستوى الاستدلال في Gemini 4 Argon: thinking_level في حزمة Google SDK الأصلية، وreasoning_effort في الواجهة المتوافقة مع OpenAI، وتمرير المعلمات الأصلية من Google عبر extra_body. لا يمكن استخدام هذه الطرق معًا في الوقت نفسه، وإلا فسيظهر خطأ.
| طريقة الضبط | موضع المعلمة | القيم المتاحة | حالات الاستخدام |
|---|---|---|---|
thinking_level الأصلي |
thinking_config.thinking_level |
LOW / MEDIUM / HIGH | Google GenAI SDK وVertex AI |
reasoning_effort المتوافق مع OpenAI |
الحقل العلوي reasoning_effort في نص الطلب |
minimal / low / medium / high | OpenAI SDK والعملاء المتوافقون المختلفون |
التمرير عبر extra_body |
extra_body.google.thinking_config |
low / medium / high | عند الحاجة إلى تفعيل خيارات Google الأصلية الأخرى، مثل ملخصات التفكير |
تُحوَّل قيمة reasoning_effort في الواجهة المتوافقة مع OpenAI إلى thinking_level في Argon. ووفقًا لجدول التحويل الرسمي من Google، تتحول كل من minimal وlow إلى low، وتتحول medium إلى medium، وhigh إلى high. لكن Argon لا يتعرف على المستويات الأعلى التي تستخدمها OpenAI وAnthropic، مثل xhigh وmax، وسيُرجع خطأ 400 مباشرةً عند تمريرها.
الطريقة الأولى: ضبط thinking_level باستخدام الحزمة الأصلية
عند استخدام Google GenAI SDK، يكفي تحديد المستوى مباشرةً ضمن ThinkingConfig. وتدعم نقطة نهاية Vertex AI ثلاث مناطق: global وus وeu.
from google import genai
from google.genai import types

client = genai.Client(enterprise=True, project="YOUR_PROJECT", location="global")

resp = client.models.generate_content(
    model="gemini-4-argon",
    contents="为多生产者单消费者场景设计一个无锁环形缓冲区",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="HIGH"),
        max_output_tokens=32768,
    ),
)
print(resp.text)
الطريقة الثانية: ضبط reasoning_effort عبر الواجهة المتوافقة مع OpenAI
إذا كان مشروعك يعتمد على OpenAI SDK، فإن استدعاء Argon عبر الواجهة المتوافقة هو الخيار الأسهل، إذ لا يتطلب سوى إضافة المعلمة reasoning_effort.
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="high",      # 映射为 thinking_level=high
    max_tokens=32000,             # 必须为思考 token 预留空间
    messages=[{"role": "user", "content": "审查这段并发代码的竞态条件"}],
)
print(resp.choices[0].message.content)
print(resp.usage)
عرض الشفرة كاملة: التمرير عبر extra_body واختبار مقارنة المستويات الثلاثة
import time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
PROMPT = "一个 Kubernetes Pod 一直处于 CrashLoopBackOff,请给出系统的排查步骤和命令"


def call_with_effort(level: str):
    """方式二:OpenAI 兼容的 reasoning_effort"""
    start = time.time()
    resp = client.chat.completions.create(
        model="gemini-4-argon",
        reasoning_effort=level,
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
    )
    return resp, time.time() - start


def call_with_extra_body(level: str):
    """方式三:extra_body 透传 Google 原生 thinking_config
    注意:不能与 reasoning_effort 同时使用"""
    return client.chat.completions.create(
        model="gemini-4-argon",
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
        extra_body={
            "google": {
                "thinking_config": {
                    "thinking_level": level,
                    "include_thoughts": True,
                }
            }
        },
    )


if __name__ == "__main__":
    for level in ("low", "medium", "high"):
        resp, cost_time = call_with_effort(level)
        u = resp.usage
        print(f"[{level:6}] 耗时 {cost_time:5.1f}s | 输出 {u.completion_tokens} token")
💡 نصيحة للاستدعاء: الواجهة المتوافقة مع OpenAI هي أسهل طريقة لبدء استخدام Gemini 4 Argon، إذ لا تحتاج الشفرة الحالية المعتمدة على OpenAI SDK إلى تغييرات تُذكر. يُنصح بالحصول على رصيد تجريبي عبر APIYI apiyi.com، ثم تشغيل نص المقارنة أعلاه لاختبار أداء مهامك المعتادة مع مستويات الاستدلال المختلفة.
ضبط مستوى الاستدلال في Gemini 4 Argon عبر Cherry Studio
تحتوي الزاوية اليمنى السفلية من مربع الإدخال في Cherry Studio على قائمة منسدلة لمستوى الاستدلال، لكن هذا الخيار لا يظهر إلا للنماذج التي يتعرف عليها العميل بوصفها نماذج استدلال. وتشير مشكلات المجتمع إلى أن Cherry Studio يحدد دعم النموذج لمستوى الاستدلال بالاعتماد على دليل النماذج المدمج الذي يُنشأ أثناء البناء من models.dev وOpenRouter، ولا يقرأ معلومات القدرات التي تُرجعها الواجهة أثناء التشغيل. لذلك، قد لا تظهر القائمة المنسدلة لنموذج جديد مثل Gemini 4 Argon قبل تحديث دليل النماذج في العميل، أو قد يظهر الخيار ويكون بالإمكان تحديده من دون أن يُطبَّق فعليًا.
في هذه الحالة، فإن الطريقة الأكثر موثوقية هي استخدام ميزة المعلمات المخصصة في Cherry Studio. ووفقًا للوثائق الرسمية، تُضاف المعلمات المخصصة مباشرةً إلى نص الطلب، كما أن أولويتها أعلى من المعلمات المدمجة.
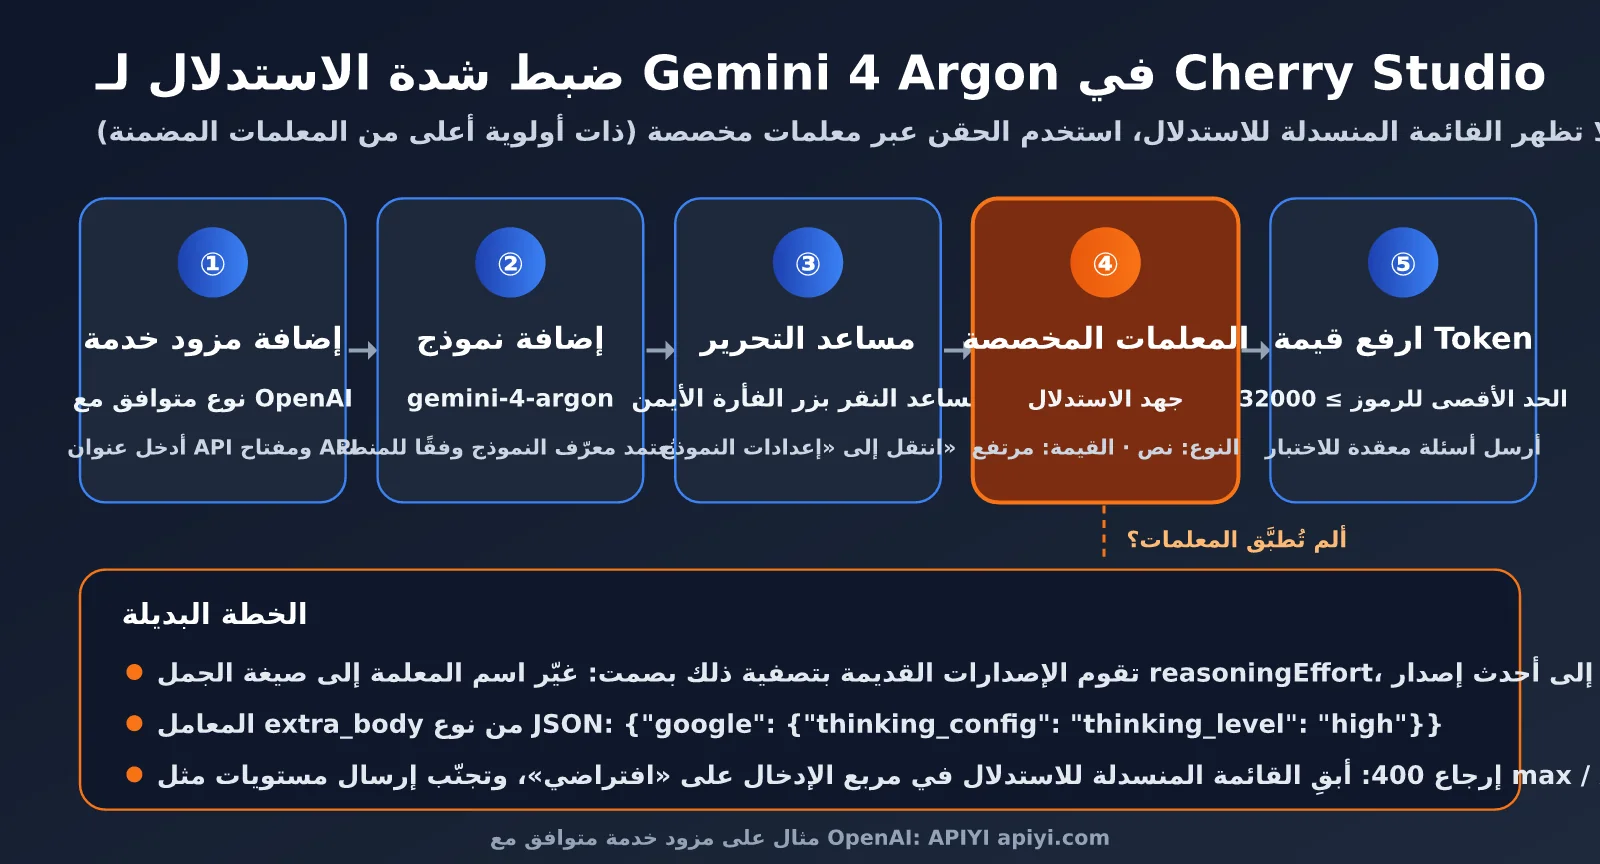
خطوات ضبط المعلمات المخصصة في Cherry Studio
فيما يلي خطوات الإعداد كاملة، باستخدام مزوّد خدمة متوافق مع OpenAI مثالًا:
- إضافة مزوّد خدمة: أضف في الإعدادات مزوّد خدمة متوافقًا مع OpenAI، ثم أدخل عنوان API والمفتاح، مثل
https://api.apiyi.comالخاص بـ APIYI. - إضافة النموذج: أضف معرّف النموذج
gemini-4-argonضمن مزوّد الخدمة. - فتح إعدادات المساعد: انقر بزر الفأرة الأيمن على المساعد المطلوب في قائمة المساعدين، واختر «تحرير المساعد»، ثم انتقل إلى علامة التبويب «إعدادات النموذج».
- إضافة معلمة مخصصة: أدخل
reasoning_effortفي خانة اسم المعلمة، واختر «نص» نوعًا لها، ثم أدخلhighقيمةً (أوlowأوmedium). - زيادة الحد الأقصى للإخراج: فعّل خيار «الحد الأقصى لعدد الرموز» وارفع قيمته. يُنصح بتعيينه إلى 32000 على الأقل لإتاحة مساحة كافية لعملية التفكير.
- إرسال طلب تجريبي: اختبر الإعداد بسؤال يتطلب استدلالًا متعدد الخطوات، وقارن زمن الاستجابة ومحتوى التفكير قبل ضبط المعلمة وبعده.
إذا لم يعمل مستوى الاستدلال بعد تطبيق الخطوات أعلاه، فتحقق من الحالات الشائعة التالية:
| المشكلة | السبب المحتمل | الحل |
|---|---|---|
لا يتغير شيء بعد ضبط reasoning_effort |
الإصدارات القديمة قد تتجاهل هذه المعلمة بصمت في وضع التوافق مع OpenAI | حدّث التطبيق إلى أحدث إصدار، أو استخدم اسم المعلمة reasoningEffort |
| قائمة مستوى الاستدلال المنسدلة في مربع الإدخال غير ظاهرة | لم يُضف Argon بعد إلى دليل النماذج المدمج | استخدم المعلمات المخصصة؛ ويمكن للمستخدمين المتقدمين إضافة معلومات قدرات الاستدلال إلى إعدادات النموذج |
| يعيد الطلب خطأ 400 | أرسل العميل مستوى غير مدعوم في Argon، مثل max أو xhigh |
أبقِ القائمة المنسدلة على «افتراضي»، وحدد low أو medium أو high عبر المعلمات المخصصة فقط |
| تطغى الإعدادات المدمجة على المعلمة | تعارض خيار الاستدلال في مربع الإدخال مع المعلمة المخصصة | أبقِ خيار مربع الإدخال على «افتراضي» لتجنب ضبط المعلمة في موضعين |
| الحاجة إلى تمرير معلمات أصلية | الرغبة في تفعيل ملخصات التفكير أيضًا | أضف معلمة من نوع JSON باسم extra_body، واجعل قيمتها {"google": {"thinking_config": {"thinking_level": "high"}}} |
أصلحت Cherry Studio مشكلة تجاهل reasoning_effort بصمت عبر طلب دمج في مارس 2026، وأصبحت الإصدارات الحديثة تحوّلها تلقائيًا إلى reasoningEffort المستخدم داخليًا. إذا كنت تستخدم إصدارًا أقدم، يمكنك كتابة اسم المعلمة بصيغة camelCase مباشرةً: reasoningEffort، لتجاوز التصفية.
تنطبق الفكرة نفسها على عملاء المحادثة الشائعين الآخرين، وليس Cherry Studio وحده: ابحث أولًا عن خيار مثل «المعلمات المخصصة» أو «نص طلب إضافي» أو «معلمات متقدمة»، ثم أضف reasoning_effort بوصفه حقلًا في المستوى الأعلى لنص الطلب. وإذا كان العميل لا يدعم إلا صيغة JSON، فاستخدم extra_body لتمرير thinking_config الأصلي. بعد الإعداد، قارن زمن الاستجابة واستهلاك الرموز عند طرح السؤال المعقد نفسه، للتأكد من تطبيق المعلمة فعليًا.
🚀 توصية بشأن العميل: عند استخدام Gemini 4 Argon عبر Cherry Studio، يُنصح باختيار مزوّد خدمة متوافق مع OpenAI، لأن تمرير المعلمات يكون أكثر استقرارًا. توفر APIYI apiyi.com واجهة موحدة متوافقة مع OpenAI؛ يكفي إعدادها مرة واحدة في Cherry Studio لاستخدام نماذج Gemini وClaude وGPT وغيرها.
اختبار عملي لمستويات الاستدلال في Gemini 4 Argon ودليل لتجنب الأخطاء الشائعة
يؤثر مستوى الاستدلال مباشرةً في زمن الاستجابة والتكلفة وجودة المخرجات. أجرى موقع ComputingForGeeks التقني المستقل مجموعة اختبارات مقارنة على مهام تشغيلية باستخدام Argon، وجاءت النتائج مفيدة جدًا.
| مؤشر الاختبار | الافتراضي (medium) | high | الفرق |
|---|---|---|---|
| متوسط عدد رموز الإخراج | 463 | 1,836 | نحو 4 أضعاف |
| متوسط زمن الاستجابة | 5.5 ثوانٍ | 15.3 ثانية | نحو 2.8 ضعف |
| أول رمز مرئي | نحو 4.3 ثوانٍ | 12–13 ثانية | يُخرج أولًا نحو 1400 رمز تفكير |
| تكلفة 9 استدعاءات (بسعر الإطلاق) | $0.045 | $0.169 | نحو 3.8 أضعاف |
| مقارنة low وmedium بالإعداد الافتراضي | متقاربة جدًا | — | لم يُنتج أيٌّ منها رموز تفكير في المهام القصيرة |
تكشف هذه البيانات أمرين. أولًا، لا يكاد يكون هناك فرق بين الإعدادات low وmedium والافتراضي في المهام القصيرة والبسيطة؛ إذ لا يُنتج أيٌّ منها رموز تفكير، ولا يبدأ «التفكير العميق» فعليًا إلا عند استخدام high. ثانيًا، تكلفة high واضحة: تقارب 4 أضعاف، مع زيادة زمن ظهور أول رمز بنحو 8 ثوانٍ. وتجدر الإشارة إلى أن الاختبار اقتصر على الموجهات القصيرة، وقد يُنتج الإعداد medium عملية تفكير في المهام المعقدة والطويلة.
4 أخطاء شائعة عند ضبط مستوى الاستدلال في Gemini 4 Argon
استنادًا إلى دليل الترحيل من Google والاختبارات العملية التي أجراها المجتمع، إليك أكثر الأخطاء شيوعًا عند ضبط مستوى الاستدلال في Gemini 4 Argon:
- ضبط
max_tokensعلى قيمة صغيرة جدًا يؤدي إلى رد فارغ: يشملmax_output_tokensرموز التفكير ورموز النص الأساسي معًا. أظهرت الاختبارات أن Argon استخدم 1021 رمزًا من أصل 1024 المسموح بها للتفكير عند ضبط المستوى على high، ثم أعاد سلسلة فارغة، وكان سبب الإنهاءMAX_TOKENS. عند استخدام high، خصص ما لا يقل عن 16K–32K. - الإبقاء على
thinking_budgetيؤدي مباشرةً إلى خطأ: يحوّلgemini-3.1-pro-previewقيمةthinking_budgetضمنيًا إلى مستوى، بينما يعيد Argon خطأ 400 مباشرةً. لذا احذف هذا الخيار عند الترحيل. - تجاهل معلمات أخذ العينات مثل
temperature: توضح وثائق Google أن الواجهة الخلفية لـ Argon تتجاهل قيمةtemperatureالمخصصة، بينما تؤديfrequency_penaltyوpresence_penaltyوcandidate_countإلى خطأ 400. يُنصح بالتحكم في عمق التفكير عبر مستوى الاستدلال، وفي تنسيق المخرجات عبرresponse_schema. - استخدام
max_tokensلخفض التكلفة قد يأتي بنتيجة عكسية: توصي Google بخفض مستوى الاستدلال لتقليل التكلفة وزمن الاستجابة، لا بتقليل قيمةmax_tokens؛ لأن ذلك قد يؤدي إلى اقتطاع المخرجات.
📊 اقتراح لاختيار المستوى: تكفي القيمة الافتراضية medium للأسئلة اليومية والبرمجة البسيطة، أما تصميم البنى المعقدة وإعادة هيكلة ملفات متعددة والبراهين الرياضية، فيُفضّل استخدام high. يمكنك مقارنة استهلاك الرموز في سجلات الاستدعاءات على منصة APIYI apiyi.com لموازنة الجودة والتكلفة على النحو الأمثل.
الأسئلة الشائعة
س1: هل مستوى الاستدلال الافتراضي في Gemini 4 Argon هو high؟
لا. المستوى الافتراضي في الإصدار القياسي `gemini-4-argon` هو medium، بينما يكون high هو المستوى الافتراضي في `gemini-4-argon-cyber-permissive` المخصص لجهات الدفاع السيبراني. وهذا يختلف عن `gemini-3.1-pro-preview`، الذي يكون high، أي أعلى مستوى، هو إعداده الافتراضي. إذا كنت بحاجة إلى أقوى قدرات الاستدلال، فعليك ضبط `thinking_level=”high”` أو `reasoning_effort=”high”` صراحةً.
س2: هل يمكن إيقاف التفكير في Gemini 4 Argon أو ضبطه على minimal؟
لا. يدعم Argon ثلاثة مستويات فقط: low وmedium وhigh. ويؤدي ضبطه على minimal أو استخدام `thinking_budget` إلى استجابة HTTP 400. أما عند تمرير `reasoning_effort=”minimal”` عبر الواجهة المتوافقة مع OpenAI، فتُحوَّل القيمة إلى low. وإذا كنت تحتاج إلى زمن استجابة منخفض جدًا، فيمكنك استخدام نماذج مثل سلسلة Gemini 3.x Flash التي تدعم مستوى minimal.
س3: ماذا أفعل إذا لم يظهر خيار مستوى الاستدلال في Cherry Studio؟
ذلك لأن دليل النماذج المدمج في Cherry Studio لم يُدرج Argon بعد. يمكنك إضافة المعلمة المخصصة `reasoning_effort` من خلال «تحرير المساعد ← إعدادات النموذج»، مع ضبط نوعها على نص وقيمتها على `high`. تكون أولوية المعلمات المخصصة أعلى من أولوية المعلمات المدمجة. ويُنصح باستخدام مزود خدمة متوافق مع OpenAI، مثل APIYI apiyi.com، إذ يضمن تمرير المعلمات بثبات أكبر.
س4: كيف أتأكد من أن مستوى الاستدلال قد طُبّق فعلًا؟
أسهل طريقة هي الاطلاع على عدد رموز الإخراج في `usage` ضمن الاستجابة، وعلى مدة الاستجابة: إذ يكون عدد رموز الإخراج وزمن ظهور أول رمز أعلى بوضوح عند استخدام high مقارنةً بالإعداد الافتراضي. ويمكنك أيضًا ملاحظة ما إذا كان محتوى التفكير يظهر في Cherry Studio. يُنصح باختبار السؤال المعقد نفسه مرةً بالإعداد الافتراضي ومرةً باستخدام high، ثم مقارنة النتائج.
الخلاصة
أهم ما ينبغي معرفته عن مستوى الاستدلال في Gemini 4 Argon هو أن الإعداد الافتراضي هو medium، وليس high. وهذا يختلف عن gemini-3.1-pro-preview، الذي يستخدم أعلى مستوى افتراضيًا. لذا، إذا انتقلت إلى Argon من دون ضبط المستوى صراحةً، فستنخفض عمق عملية التفكير في النموذج بصمت درجةً واحدة. يدعم Argon ثلاثة مستويات فقط: low وmedium وhigh. أما thinking_budget وminimal، فسيؤدي استخدامهما إلى ظهور خطأ 400. وعند اختيار مستوى high، احرص أيضًا على تخصيص قيمة كافية لـ max_tokens لاستيعاب رموز التفكير.
في طريقة الاستدعاء، تستخدم حزم SDK الأصلية thinking_level، بينما تستخدم الواجهة المتوافقة مع OpenAI reasoning_effort. ويمكن للعملاء مثل Cherry Studio، الذين لم يضيفوا بعد دعم خيارات الاستدلال في Argon، تمريرها عبر معلمات مخصصة. نوصي بالإبقاء على المستوى الافتراضي medium للمهام اليومية، والتبديل إلى high عند الحاجة للمهام المعقدة، مع تحديد المستوى الأنسب بناءً على نتائج الاختبارات العملية.
نوصي باستخدام منصة APIYI apiyi.com للاتصال بـ Gemini 4 Argon عبر واجهة متوافقة مع OpenAI، ما يتيح لك التبديل بمرونة بين مستويات الاستدلال باستخدام المعلمة reasoning_effort نفسها، سواء في الشيفرة أو في عملاء مثل Cherry Studio.
المراجع:
- وثائق التفكير في Google Gemini API: ai.google.dev/gemini-api/docs/thinking
- وثائق التوافق مع OpenAI في Google Gemini API: ai.google.dev/gemini-api/docs/openai
- دليل المطورين لـ Google Cloud Gemini 4 Argon: docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- وثائق إعدادات المساعد في Cherry Studio: docs.cherryai.com.cn
- مشكلتا Cherry Studio على GitHub رقم #11987 و#19761: github.com/CherryHQ/cherry-studio
الكاتب: فريق APIYI | نشارك باستمرار تجاربنا في ربط نماذج اللغة الكبيرة وضبط معلماتها. للاطلاع على مزيد من دروس ربط نماذج الذكاء الاصطناعي، تفضّل بزيارة APIYI apiyi.com