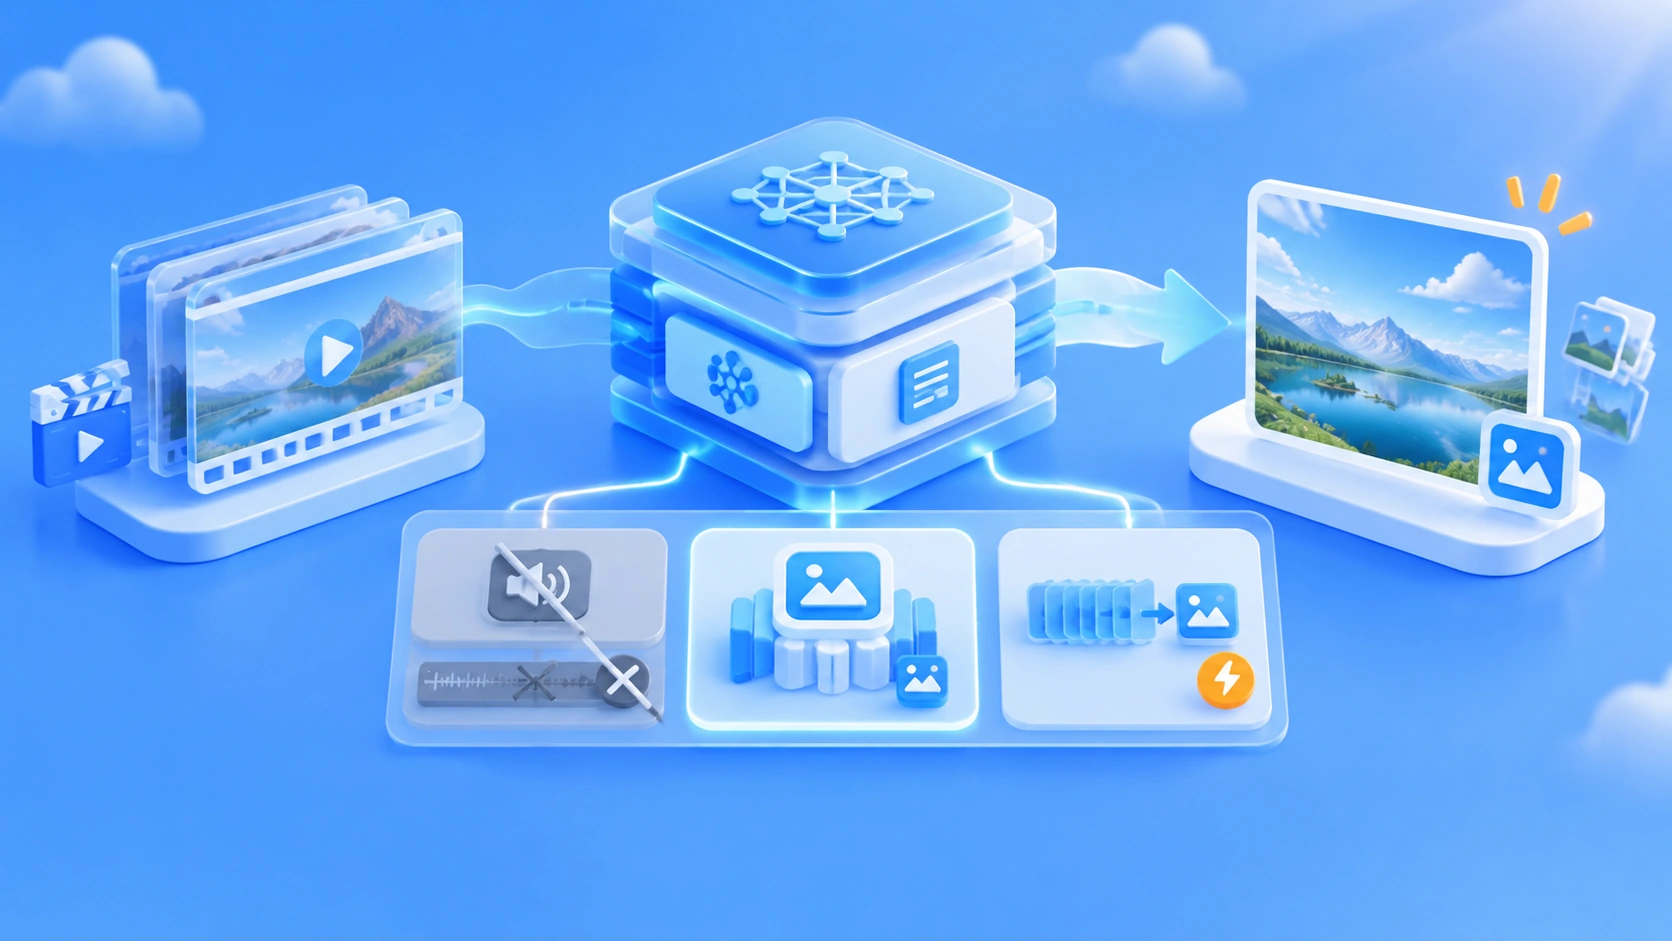
ملاحظة الكاتب: أعاد H3-Image استخدام البنية الأساسية متعددة الوسائط في H3، وأضاف إليها مكونات مخصصة للصور، ثم أعاد تحسين مرحلتي التدريب والاستدلال، فصار نموذجًا مستقلًا لتوليد الصور. يشرح هذا المقال ما ورثه عن H3 وما حذفه وما أضافه.
6 مصطلحات تحتاجها قبل فهم معمارية MiniMax H3
سنعود إلى هذه المفاهيم كثيرًا في بقية المقال، لذا نبدأ بشرح كل منها في جملة واحدة.
| المصطلح | شرح مبسّط | دوره في MiniMax H3 |
|---|---|---|
| Transformer | شبكة عصبية تعالج البيانات المتسلسلة، وتجيد التقاط العلاقات بين عناصر التسلسل | H3-Omni-Transformer هو قلب عائلة النماذج كلها |
| DiT | نموذج انتشار (Diffusion) مبني على Transformer، ويولّد المحتوى بإزالة الضوضاء تدريجيًا | الجزء الرئيسي في H3-Image هو DiT أحادي المسار بـ 33.1B معامل |
| VAE | نموذج يرمّز البيكسلات إلى تمثيل مضغوط ويفكّ ترميزه، أي أشبه بـ«ضاغط + فاك ضغط» | يستخدم H3 مرمّزًا تلقائيًا متغيرًا (VAE) للصورة وآخر للصوت، ويستبدل H3-Image بهما VAE مخصصًا للصور |
| المتغيرات الكامنة (Latent) | تمثيل مضغوط ومكثّف للبيانات الأصلية، والحساب فيه أقل كلفة بكثير من معالجة البيكسلات مباشرة | ما يتنبأ به Transformer هو المتغيرات الكامنة، وليس البيكسلات |
| RoPE | ترميز موضعي دوّار، يخبر النموذج بموضع كل token في التسلسل | يستخدم H3 ترميز 3D Multimodal RoPE للتعبير عن الموضع في الزمن والمكان |
| التقطير (Distillation) | تدريب النموذج على إنجاز عملية معقدة تحتاج خطوات كثيرة في خطوات قليلة فقط | جرى تقطير H3-Image ليحتاج إلى 6 خطوات أخذ عينات فقط |
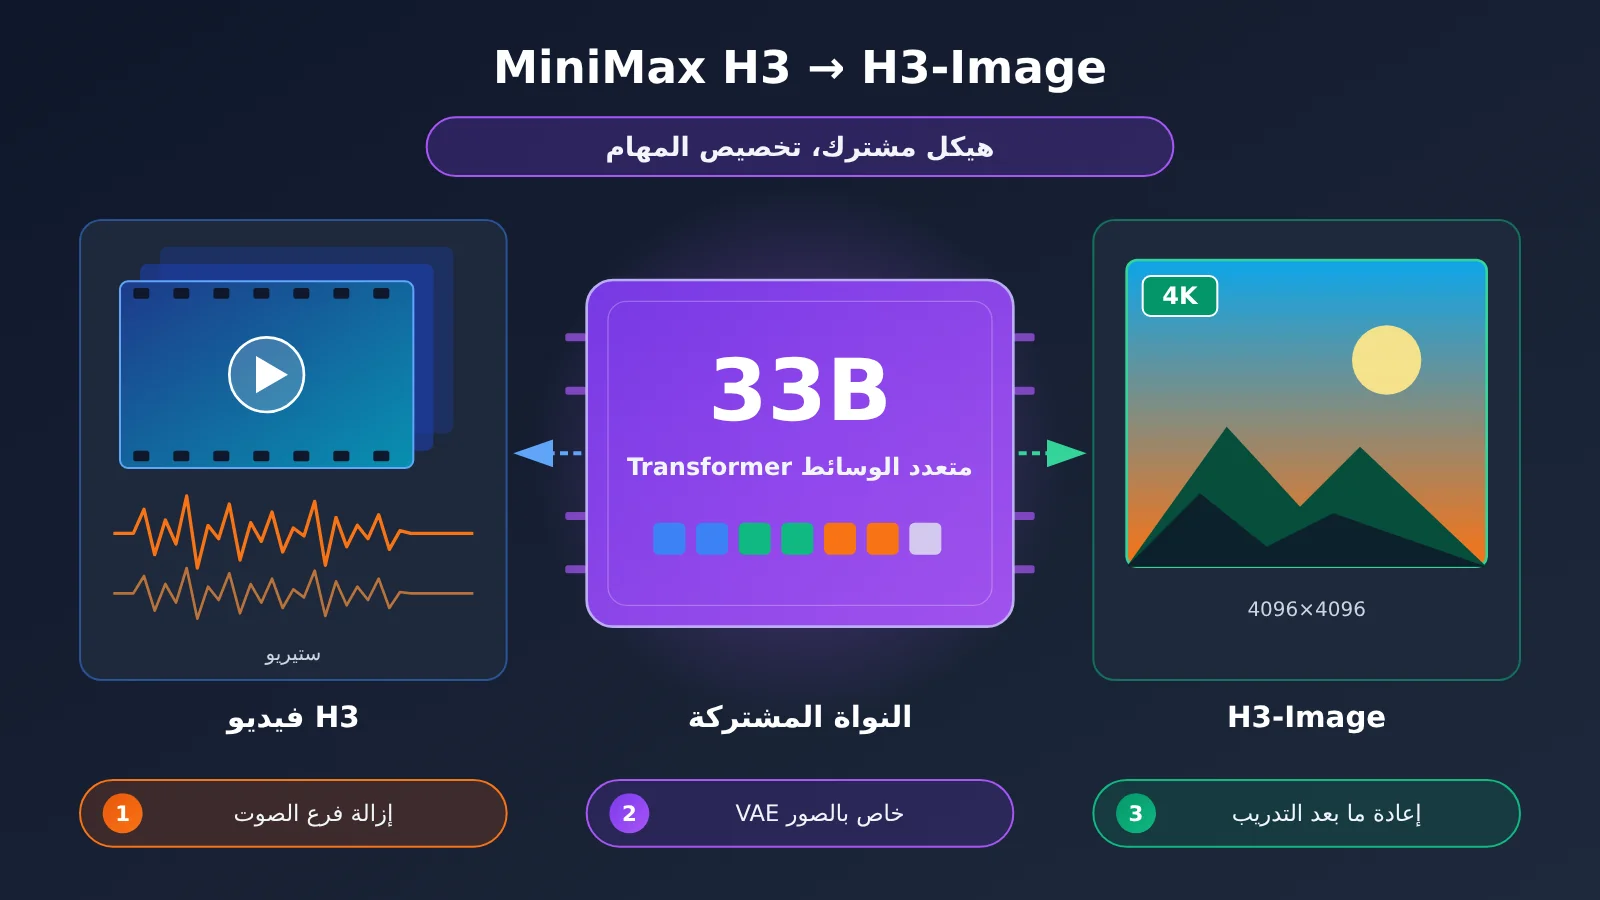
في نوفمبر 2026، أتاحت MiniMax أوزان نموذج توليد الصور H3-Image. أما H3، الذي فُتح مصدره قبل ثلاثة أشهر، فهو نموذج يولّد فيديو مع صوت ستيريو. والنموذج الجديد في المستوى نفسه تقريبًا من حيث عدد المعاملات (33B)، وتعود بنيته الأساسية إلى H3.
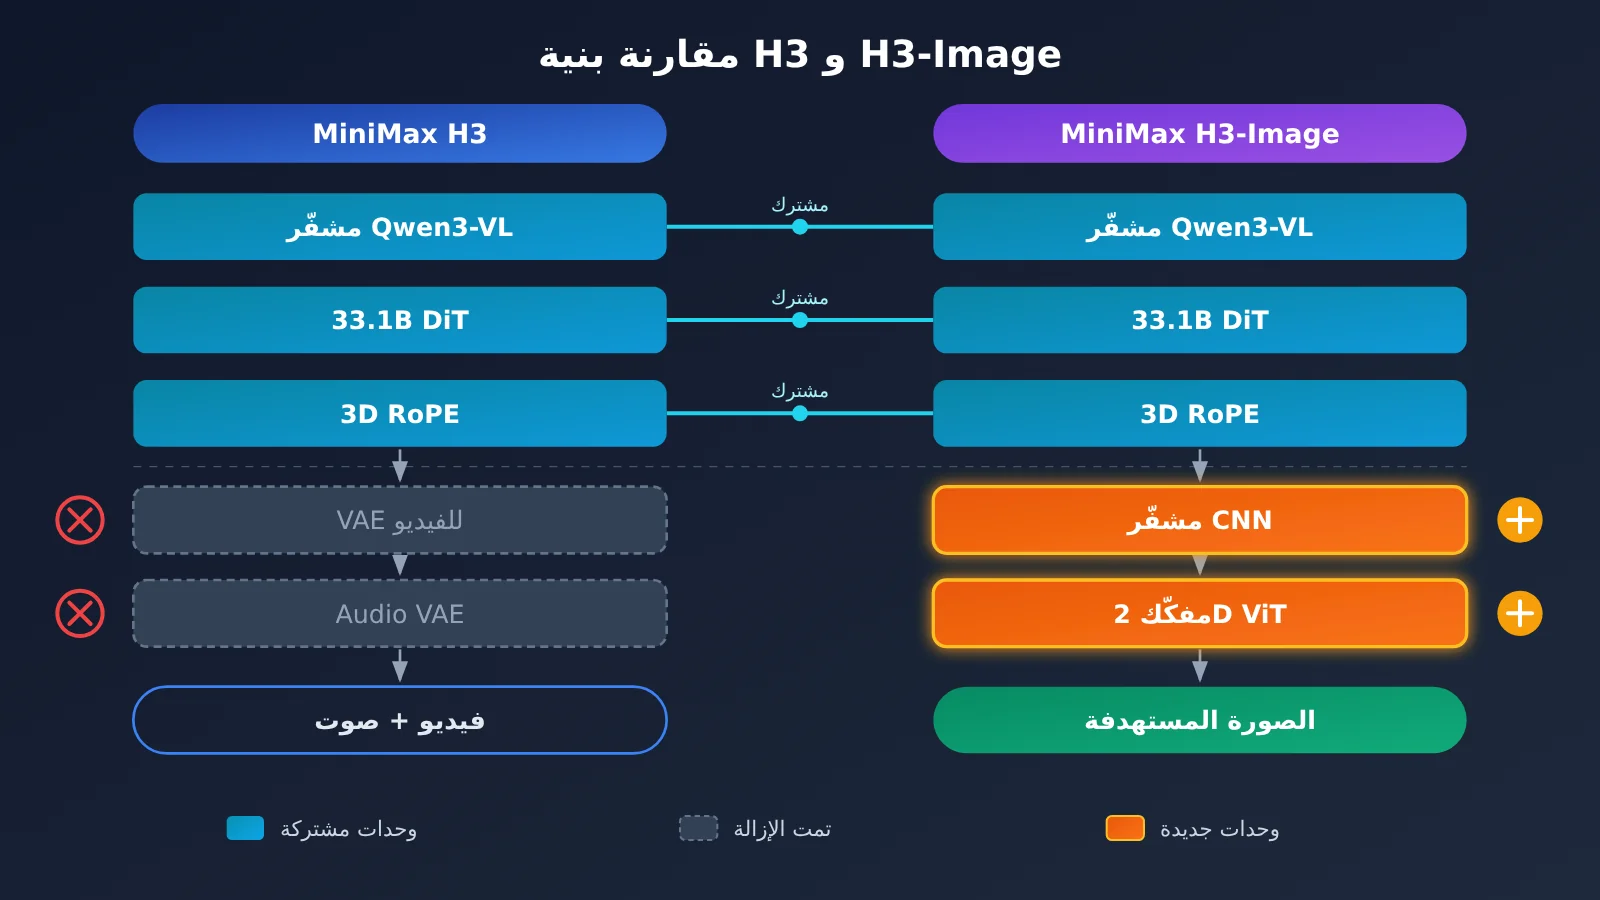
المسألة ليست مجرد «تغيير مخرجات نموذج الفيديو إلى إطار واحد». تشير بطاقة النموذج الرسمية لـ H3-Image والمدونة الرسمية للإصدار إلى أنه احتفظ بنموذج Transformer متعدد الوسائط الأساسي ومرمّز النص من H3، وحذف فرع توليد الصوت، واستبدل VAE بآخر مخصص للصور، وأعاد تصميم مرحلة ما بعد التدريب وعملية الاستدلال لتناسب مهام الصور.
القيمة الأساسية: بعد قراءة هذا المقال ستعرف ما الذي تغيّر تحديدًا حين انتقلت بنية 33B نفسها من الفيديو إلى الصور، ولماذا جرى كل تغيير، وما الذي أكّدته الجهة الرسمية وما الذي لا يتجاوز كونه استنتاجًا على مستوى الصناعة.
MiniMax H3 من الفيديو إلى الصورة: ماذا أطلقت MiniMax؟
لنرتّب الجدول الزمني أولًا. كثيرون يخلطون بين إصدارين عندما يقرؤون خبر «MiniMax H3 مفتوح المصدر»، لكن H3 وH3-Image إصداران منفصلان بينهما نحو ثلاثة أشهر.
| التاريخ | الحدث | الوصف |
|---|---|---|
| 2026-07-31 | MiniMax تنشر تعريفًا بنموذج H3 | المدونة التقنية الرسمية تكشف عن بنية H3 للمرة الأولى |
| 2026-08-03 | MiniMax H3 يفتح أوزانه رسميًا | نموذج توليد فيديو متعدد الوسائط بالكامل، والمفتوح منه هو H3-Base |
| 2026-11-10 | التاريخ المدوَّن في رخصة H3-Image Community License | فتح أوزان نموذج توليد الصور |
| 2026-11-11 | مدونة MiniMax الرسمية بالإنجليزية تنشر تعريفًا بـ H3-Image | الكشف عن تفاصيل ما بعد التدريب وتحسينات الاستدلال |
مهمة كل من MiniMax H3 وH3-Image
المهمتان مختلفتان تمامًا. H3 نظام لتوليد الفيديو متعدد الوسائط بالكامل. يفهم مدخلات النص والصور والفيديو والصوت في آن واحد، ويُخرج فيديو مدته 4–15 ثانية بمعدل 24 إطارًا في الثانية مع صوت ستيريو أصلي بتردد 32kHz. الدقة الافتراضية للإخراج 768px للضلع الأقصر، وتصل في سير العمل الكامل إلى 2K. أما H3-Image فيتخصص في توليد الصور عالية الدقة وتحريرها. المواصفات الرسمية تذكر حدًا أقصى يقارب 16MP (مثل 4096×4096)، وتقول إنه يستطيع توليد صورة 4K في أقل من 10 ثوانٍ.
وهنا يظهر السؤال الأساسي في هذا المقال: أحدهما يصنع «فيديو بصوت» والآخر يصنع «صورًا ثابتة عالية الدقة»، فلماذا ينتميان إلى عائلة تقنية واحدة؟ الجواب في التصميم الأساسي لـ H3.
البنية التحتية لـ MiniMax H3: Transformer موحّد متعدد الوسائط
قلب H3 اسمه H3-Omni-Transformer. وبحسب التعريف التقني الرسمي، هو Transformer أحادي المسار وكثيف (single-stream, dense) بحجم يقارب 33B معامل. “أحادي المسار” يعني أن معلومات الوسائط المختلفة لا تمر عبر شبكات منفصلة لكل منها، بل تُدمج في تسلسل واحد تعالجه مجموعة المعاملات نفسها. أما “كثيف” فيعني أن كل رمز (token) يمر عبر جميع المعاملات في الحساب، بخلاف بنية MoE التي لا تفعّل سوى جزء من الخبراء.
كيف يرمّز MiniMax H3 الوسائط المختلفة
مسار المعالجة المعلن رسميًا يسير تقريبًا على النحو التالي:
- النص: يُرمَّز عبر H3-Encoder إلى تمثيل دلالي يخبر النموذج “ماذا تريد أن يحدث في المشهد”.
- الصور والفيديو: تمر في الوقت نفسه عبر مرمّز النص (text encoder) وعبر Visual VAE. الأول مسؤول عن فهم دلالات محتوى المشهد، والثاني يضغط البكسلات إلى متغيرات كامنة (latents).
- الصوت: يُضغط عبر Audio VAE إلى متغيرات كامنة صوتية.
- التسلسل الموحّد: تُجمع تمثيلات كل الوسائط السابقة في تسلسل واحد يُرسَل إلى الـ Transformer.
- التنبؤ المشترك: يتنبأ الـ Transformer بالمتغيرات الكامنة للفيديو والصوت معًا، ثم تُسلَّم كل مجموعة إلى الـ VAE المناسب لفك ترميزها إلى صورة وصوت.
يمكنك تخيّل الأمر على أنه “الجميع يتحدث اللغة نفسها”. سواء كان المدخل الأصلي جملة أم صورة أم مقطعًا موسيقيًا، فإنه يُترجَم قبل دخول الـ Transformer إلى تسلسل من الرموز. ولا يهتم النموذج بالوسيط الذي جاء منه كل رمز، فمهمته أن يكتشف العلاقات بين هذه الرموز ويولّد الرموز المطلوبة.
دور 3D Multimodal RoPE
للفيديو محور زمني وبُعدان مكانيان في آن واحد، ولذلك يستخدم H3 ترميز 3D Multimodal RoPE لتمثيل المواقع: فلا يكفي أن يعرف الرمز إحداثياته الأفقية والعمودية داخل المشهد، بل يجب أن يعرف أيضًا إلى أي إطار ينتمي. وقد أكدت الجهة الرسمية هذا التصميم صراحةً. وهو مهم لفهم H3-Image لاحقًا، لأن الصورة الواحدة يمكن اعتبارها حالة خاصة “بُعدها الزمني إطار واحد فقط”.
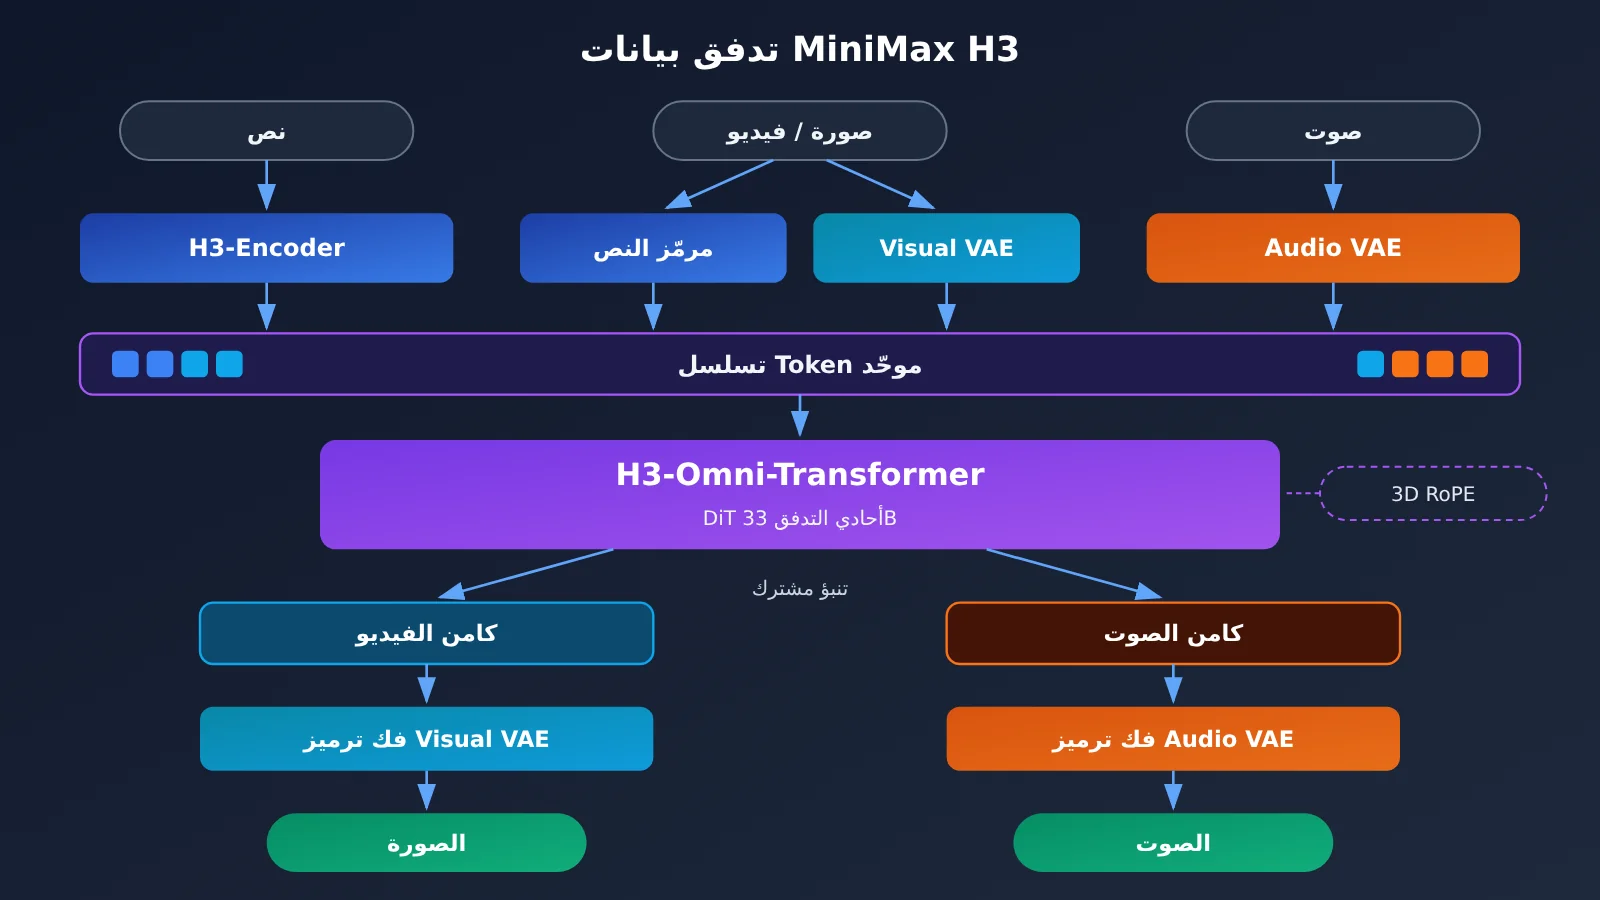
【استنتاجنا】 لأن H3 صُمّم منذ البداية على أساس “تسلسل موحّد + Transformer موحّد”، وليس كخط معالجة لمهمة واحدة من نوع “نص يدخل وفيديو يخرج”، فإن شبكته الأساسية تملك أرضية تسمح بنقلها إلى مهام توليد أخرى. الجهة الرسمية لم تصغ هذه النقطة بهذه الطريقة مباشرة، وهي خلاصة توصلنا إليها من تصميم البنية.
ما الذي ورثه MiniMax H3-Image، وما الذي حذفه وأضافه
هذا أهم جزء يستحق التوقف عنده في مسار تطور هذه التقنية. الجدول التالي مأخوذ من بطاقة النموذج الرسمية لـ H3-Image:
| الفئة | المكوّن | ما تم فعليًا |
|---|---|---|
| موروث | مشفّر النصوص Qwen3-VL | استخدام مشفّر النصوص الكامل من H3 كما هو، مع أخذ الحالة المخفية من الطبقة 50 |
| موروث | DiT أحادي المسار بحجم 33.1B | الاحتفاظ بالبنية الأساسية H3-Omni-Transformer |
| موروث | 3D Multimodal RoPE | يستمر استخدامه لترميز العلاقات الموضعية |
| محذوف | فرع الصوت | لم يعد يدعم التوليد المشترك للفيديو والصوت |
| مستبدل | VAE مخصص للصور | مشفّر CNN + مفكّك ترميز 2D ViT من 24 طبقة |
| متغيّر | هدف التوليد | ترميز النص والصور المرجعية في تسلسل موحّد، ثم التنبؤ بالمتغيرات الكامنة للصورة المستهدفة |
الموروث الأول: مشفّر النصوص Qwen3-VL والحالة المخفية من الطبقة 50
توضح بطاقة نموذج H3-Image أنه يستخدم مشفّر النصوص المبني على Qwen3-VL من H3، ويعتمد الحالة المخفية من طبقته الخمسين كمدخل شرطي. وبما أن Qwen3-VL نموذج للرؤية واللغة، فهو لا يفهم النص فحسب، بل يفهم أيضًا محتوى الصور المرجعية، وهذه بالضبط القدرة التي يحتاجها تحرير الصور بعدة صور مرجعية.
【ممارسة شائعة في المجال】 أما سبب اختيار طبقة وسطى بدل الطبقة الأخيرة، فلم تشرحه الجهة الرسمية. ويرى كثيرون في المجال أن الطبقات الأخيرة من نموذج اللغة تميل إلى مهمة «التنبؤ بالكلمة التالية»، بينما تحتفظ الطبقات الوسطى بسمات دلالية أغنى وأعم. وتعتمد كثير من نماذج الانتشار (Diffusion) أسلوبًا مشابهًا.
الإرث الثاني: نموذج DiT بحجم 33.1B وترميز 3D RoPE
المواصفات الأساسية لنموذج DiT في H3-Image كما يلي:
| المعامل | القيمة | الشرح المبسّط |
|---|---|---|
| عدد المعاملات | 33.1B | من رتبة الهيكل الأساسي لنموذج H3 نفسه (نحو 33B) |
| عدد الطبقات | 50 طبقة | تمرّ المعلومات بخمسين عملية تحويل |
| Hidden Size | 5376 | بُعد التمثيل الخاص بكل token |
| Attention Heads | 56 | يتابع العلاقات بين الـ tokens من 56 زاوية في الوقت نفسه |
| FFN Size | 14336 | العرض الوسيط لشبكة التغذية الأمامية في كل طبقة |
| خفض الأبعاد المكانية في VAE | 16 ضعفًا | ضغط ضلع الصورة من 4096 بكسل إلى 256 |
| قنوات المتغيّر الكامن | 24 | كل موضع في الفضاء الكامن يحمل 24 قيمة رقمية |
| تغطية الـ token الواحد | نحو 32×32 بكسل | يحدد طول التسلسل وحجم الحساب |
إذا افترضنا أن كل token يقابل نحو 32×32 بكسل، فإن صورة بدقة 4096×4096 تعادل تقريبًا 128×128 = 16384 token (وهذا تقدير أجريناه نحن اعتمادًا على المعاملات الرسمية). وإذا أضفنا عدة صور مرجعية، يصبح التسلسل أطول، وهذا ما يفسّر أهمية تحسين سرعة الاستدلال بالنسبة لهذا النموذج.
【استنتاجنا】 ما زال ترميز 3D RoPE مفيدًا في مهام الصور. فالصورة الهدف إطار واحد فقط، لكن الصور المرجعية والصورة الهدف تحتاج إلى التمييز بينها داخل التسلسل، أي معرفة “أيّها أيّ”، ويمكن للبُعد الإضافي أن يتولى هذا التمييز. لم تعلن الجهة الرسمية عن آلية توزيع المواضع بالتفصيل، وما نطرحه هنا مجرد تفسير معقول.
حذف: إزالة فرع الصوت
الصورة لا تمتد عبر الزمن ولا يصاحبها صوت، لذلك فإن الإبقاء على فرع الصوت لا يفعل سوى إهدار موارد التدريب والاستدلال. وبعد إزالته، يتقلّص هدف التعلّم لدى النموذج من «التوزيع المشترك للفيديو والصوت» إلى «توزيع الصور» فقط، فتصبح إشارة التدريب أكثر تركيزًا.
استبدال: VAE مخصص للصور
يحتاج Visual VAE في H3 إلى مراعاة الاستمرارية الزمنية للفيديو، أما H3-Image فقد استبدله بـ VAE مصمم خصيصًا للصور الثابتة. يعتمد المُرمِّز (Encoder) على شبكة CNN، وهي بارعة في استخراج الملمس المحلي بكفاءة، بينما المُفكِّك (Decoder) عبارة عن ViT ثنائي الأبعاد من 24 طبقة، ويستطيع مراعاة البنية العامة للصورة أثناء استعادة البكسلات. أما خفض الأبعاد بمعامل 16 مع 24 قناة فيعني حفظ المعلومات في عدد أقل من المواضع المكانية وعدد أكبر من القنوات، وهذا أمر حاسم للحصول على مخرجات عالية الدقة بمستوى 16MP. كما يؤكد الإعلان الرسمي أن النتائج عالية الدقة في H3-Image تُولَّد مباشرة، دون الاعتماد على مكبّرات الدقة (Super-resolution) التقليدية.
التغيير: من «التنبؤ بالفيديو والصوت» إلى «التنبؤ بالصورة المستهدفة»
تسير عملية التوليد النهائية على النحو التالي: يُرمَّز الموجه النصي والصور المرجعية معًا في تسلسل موحّد، ثم يُزيل نموذج DiT الضوضاء تدريجيًا في فضاء المتغيرات الكامنة ليتنبأ بالمتغيرات الكامنة للصورة المستهدفة، وبعدها يفك مُرمِّز الصور VAE تشفيرها إلى الصورة النهائية. أما عدد الصور المرجعية، فالحد الأقصى في بطاقة النموذج هو 16 صورة، بينما تذكر وصفة النشر في vLLM أن الحد الأقصى 9 صور. المعيار مختلف بين الاثنين، لذلك يتحدد العدد الفعلي المتاح بحسب إطار الاستدلال المستخدم.
ما التحسينات التي أجرتها MiniMax في H3-Image لجعله أسرع وأسهل استخدامًا
تعديل البنية وحده لا يكفي. ذكرت MiniMax في مدونة إطلاق H3-Image أنها، بناءً على قدرات التدريب المسبق الموروثة من H3، أجرت تحسينات على مسار ما بعد التدريب في خمسة جوانب: بيانات التدريب، والتعلّم المعزَّز، وضغط عدد خطوات أخذ العينات، وتحسين الموجّه (Prompt Enhancement)، وتحسين النشر. لم تكشف الشركة رسميًا عن تفاصيل البيانات والتعلّم المعزَّز، لذلك سنركز فيما يلي على الجوانب التي تتوفر عنها معلومات علنية أكثر.
أخذ العينات على 6 خطوات بالتقطير وإلغاء CFG
تولّد نماذج الانتشار الصور بالبدء من الضوضاء ثم إزالتها خطوة بعد خطوة، وتحتاج الطريقة المعتادة عادةً إلى عشرات الخطوات. وإلى جانب ذلك، تعتمد نماذج الانتشار التقليدية في الغالب على CFG (التوجيه دون مصنِّف، Classifier-Free Guidance). ففي كل خطوة يجب تشغيل النموذج مرتين: مرة مع الموجه ومرة بدونه، ثم تُمزج النتيجتان بنسبة معينة لتعزيز الالتزام بالموجه.
يضغط H3-Image عملية أخذ العينات إلى 6 خطوات فقط بفضل التقطير، ولا يحتاج بعد ذلك إلى CFG. الأول يقلّص عدد الخطوات كثيرًا، والثاني يجعل كل خطوة تتطلب تمريرة أمامية واحدة فقط. وفي نموذج يبلغ عدد معاملاته 33.1 مليار، وتصل فيه الصورة الواحدة إلى عشرات الآلاف من الرموز (tokens)، يشكّل اجتماع الأمرين الأساس التقني لما تعلنه الجهة المطوّرة من «توليد صورة 4K في 10 ثوانٍ». ولا تنسَ أن الثواني العشر رقم تصرّح به الشركة المطوّرة، أما السرعة الفعلية فتتوقف على العتاد وإعدادات النشر.
تحسين الموجّه: تحويل وصف قصير إلى تعليمات قابلة للتنفيذ
يوفّر H3-Image نموذجًا اختياريًا باسم PE (Prompt Enhancement)، يبلغ حجم أوزانه نحو 17.9GB. وظيفته توسيع الوصف القصير الذي يكتبه المستخدم إلى موجّه أكثر تفصيلًا وأسهل على النموذج فهمًا. وإن لم ترغب في نشر هذا النموذج الإضافي الآن، فيمكنك تطبيق فكرة المعالجة المسبقة نفسها باستخدام نموذج لغة كبير عام. إليك مثالًا مختصرًا جدًا:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # استخدام واجهة APIYI الموحّدة
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把这句扩写成详细的图像生成提示词:雨夜的赛博朋克街头"}]
)
print(resp.choices[0].message.content)
عرض التطبيق الكامل لتحسين الموجّه
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是图像生成提示词工程师。请把用户的简短描述扩写为结构化提示词,"
    "依次包含:主体、构图、光线、材质细节、色彩、镜头与画幅。"
    "如果用户提供了参考图说明,请明确每张参考图在画面中的作用。"
    "只输出提示词正文,不要解释。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"参考图{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# مثال: تركيب غرفة معيشة من غرفة فارغة + صور مرجعية للأثاث
print(enhance_prompt(
    "把这些家具摆进空客厅,北欧风,午后自然光",
    ["空房间照片", "灰色布艺沙发", "橡木茶几", "落地灯"],
))
نصيحة: عند بناء سير عمل لتوليد الصور، يمكنك في مرحلة المعالجة المسبقة للموجّه أن تبدأ بربط عدة نماذج لغة كبيرة رئيسية عبر APIYI على apiyi.com، ثم تقارن جودة التوسيع بين النماذج، وبعد ذلك تقرر هل تنشر نموذج PE المخصص أم لا. أسماء النماذج المعتمدة هي الموجودة في قائمة النماذج على المنصة.
تحسين النشر ودعم الدقة العالية
تشمل أطر النشر الموصى بها رسميًا كلًّا من SGLang وvLLM-Omni وDiffusers وComfyUI. وتتضمن قائمة العتاد المدعوم وحدات NVIDIA H200 وRTX PRO 6000 Blackwell وAMD Instinct MI350X، مع حلول للتوازي عبر عدة وحدات معالجة رسومية (GPU). ولا يتحقق الإخراج المباشر بالدقة العالية إلا بتضافر ثلاثة عناصر: نسبة الضغط العالية في VAE الخاص بالصور، والتوليد بـ 6 خطوات دون CFG، وتحسينات الاستدلال على مستوى الإطار. وبفضل هذه العناصر مجتمعةً يمكن توليد صور بنسب أبعاد مثل 16:9 (5472×3072) و9:16 (3072×5472) و21:9 (6272×2688) مباشرةً.
تحليل تأثير إعادة استخدام معمارية MiniMax H3
التأثير على المطورين
- أساس مشترك، لكن غير قابل للتبديل: يتشارك H3 وH3-Image المُرمِّز النصي نفسه، وتصفه بطاقة النموذج بأنه “مُرمِّز H3 النصي المشترك” (نحو 66.7GB). لكن أوزان DiT ومُشفّر VAE منفصلة لكل منهما، ولذلك لا يمكنك استخدام أوزان الفيديو الخاصة بـ H3 لتوليد الصور مباشرة.
- عتبة النشر ما زالت مرتفعة جدًا: يبلغ حجم النموذج الرئيسي للصور نحو 68.65GB، وبإضافة المُرمِّز النصي يصل حجم التنزيل الكامل إلى نحو 135.35GB. وهذا هو حجم التخزين فقط، وليس متطلبات ذاكرة الفيديو (VRAM).
- يجب النظر إلى كل ترخيص على حدة: لكل من H3 وH3-Image ترخيص مجتمعي (Community License) مختلف، وشروط التفعيل بينهما متباينة بوضوح، كما يوضح الجدول التالي.
| البند | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| نطاق المصدر المفتوح | H3-Base فقط؛ أما Context-IR وRegenerate-2K فيتطلبان استدعاء واجهة API الرسمية | أوزان نموذج الصور، والمُرمِّز النصي المشترك، ونموذج PE الاختياري |
| ما يمكن الحصول عليه محليًا | توليد صوت وفيديو بدقة 768p؛ أما سير عمل 2K الكامل فيعتمد على واجهة API الرسمية | تذكر الجهة الرسمية أنه يمكن إخراج صور بدقة تصل إلى نحو 16MP مباشرة |
| شرط تفعيل الترخيص التجاري | إيرادات سنوية للمنتجات والخدمات التجارية تتجاوز 20 مليون دولار | إيراداتك السنوية و/أو إيرادات الجهات التابعة لك تتجاوز مليون دولار، أو تقديم خدمات استضافة لأي طرف ثالث |
| التزامات أخرى | القيود الإقليمية وغيرها، ويجب مراجعة نص الترخيص الأصلي | القيود الإقليمية، واستخدام المخرجات، وعلامات المنتج، ويجب مراجعة نص الترخيص الأصلي |
ملاحظة على المقارنة: أُعدّ الجدول أعلاه استنادًا إلى نصَّي الترخيصين الأصليين وبطاقة النموذج الرسمية، وهو للاستئناس في اختيار التقنية فقط، ولا يُعد استشارة قانونية. وإذا لم تتوفر لديك حاليًا إمكانات النشر الذاتي أو شروط الترخيص، يمكنك أولًا استدعاء نماذج أخرى رائدة لتوليد الصور ونماذج متعددة الوسائط عبر APIYI apiyi.com لبناء نموذج أولي لسير العمل.
التأثير على القطاع
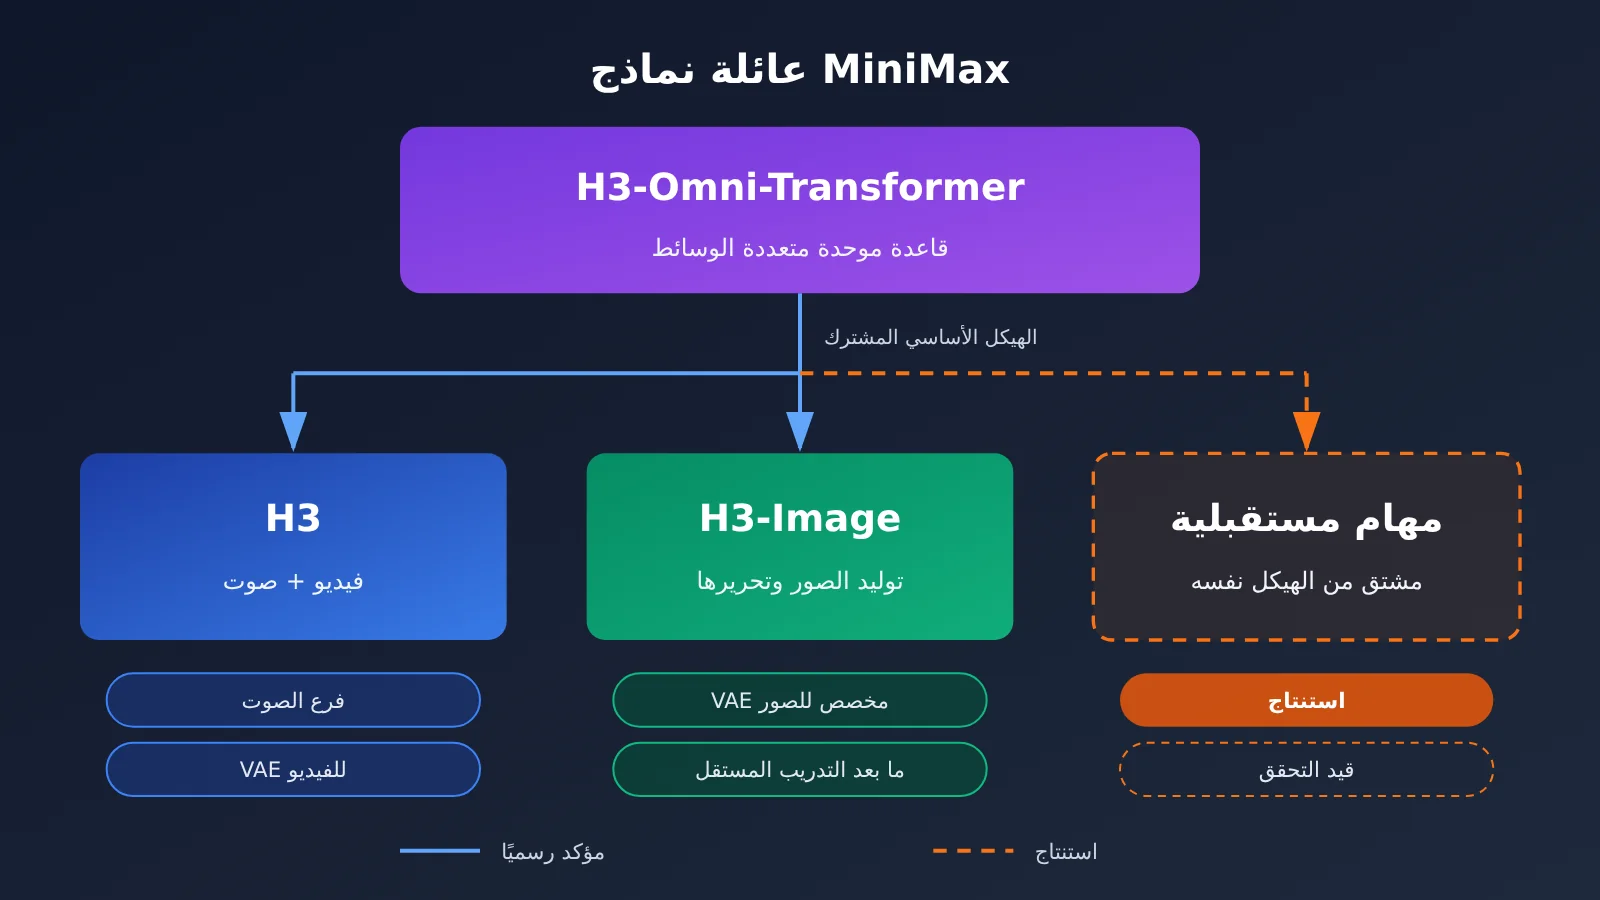
【تأكيد رسمي】 يعيد H3-Image استخدام نواة Transformer ومُرمِّز النص الخاصين بـ H3، ويستخدم في الوقت نفسه VAE مخصصًا ومسار تدريب لاحقًا (post-training) مستقلًا.
【استنتاجنا】 يدل ذلك على أن توليد الفيديو وتوليد الصور يمكن أن يتشاركا قدرًا كبيرًا من القدرات الأساسية، مثل فهم الدلالات، والمواءمة بين الوسائط، ونمذجة المواقع المكانية، لكن كل مهمة ما زالت تحتاج إلى مكونات ترميز وفك ترميز مخصصة وتدريب موجّه. ويبدو أن مسار MiniMax أقرب إلى “بناء أساس موحّد متعدد الوسائط أولًا، ثم تخصيصه لكل مهمة”، بدلًا من تدريب نموذج من الصفر لكل نوع من مهام التوليد. وإذا نجح هذا المسار، فمن المرجح أن تظهر لاحقًا نماذج مشتقة أكثر مبنية على الشبكة الأساسية نفسها، لكن هذا مجرد تخمين في القطاع حتى الآن.
الأسئلة الشائعة FAQ
س1: هل H3-Image هو نموذج الفيديو H3 نفسه بعد تحويل مخرجاته إلى صور؟
لا. يرث H3-Image من H3 مشفّر النصوص Qwen3-VL، وبنية DiT أحادية المسار بحجم 33.1B، وترميز 3D RoPE، لكنه يحذف فرع الصوت، ويستبدل به VAE مخصصًا للصور يجمع بين مشفّر CNN ومفكّك ترميز 2D ViT. كما خضع لمراحل ما بعد التدريب الخاصة به، من بيانات وتعلّم معزز وتقطير.
س2: لماذا يكاد عدد معاملات MiniMax H3 وH3-Image يكون متطابقًا؟
لأن نواة Transformer في النموذجين تنتمي إلى البنية نفسها: نحو 33B في H3، و33.1B في DiT الخاص بـ H3-Image. تقارب عدد المعاملات يعني أن الشبكة الأساسية بقيت كما هي في مجملها، وأن الفروق تتركز في مكوّنات الترميز وفك الترميز وفي أهداف التدريب.
س3: كم عدد الصور المرجعية التي يدعمها H3-Image فعليًا؟
الحد الأقصى في بطاقة النموذج الرسمية هو 16 صورة، بينما تذكر وصفة النشر على vLLM 9 صور كحد أقصى. الرقم الأول إعلان من الشركة المطوِّرة، والثاني إعداد اختباري خاص بإطار معين. عند الاستخدام الفعلي، اعتمد على ما يسمح به إطار الاستدلال الذي اخترته.
س4: هل يؤثر أخذ العينات في 6 خطوات وإلغاء CFG على جودة الصورة؟
ترى الجهة الرسمية أن النموذج يحافظ على جودة مخرجات عالية بعد التقطير، لكن ما نُشر علنًا حتى الآن هو في الغالب عروض من الشركة نفسها. ننصحك بإجراء اختبارات مقارنة على حالات استخدامك الفعلية، مع التركيز على الالتزام بالتعليمات المعقدة ودمج عدة صور مرجعية.
س5: ليس لديّ بطاقة رسوميات بمستوى H200، فكيف أتحقق أولًا من سير عمل توليد الصور؟
يمكنك البدء بواجهة API السحابية لتشغيل سير العمل وتجربته:
1. سجّل في APIYI على apiyi.com واحصل على مفتاح API ورصيد تجريبي مجاني.
2. استخدم شفرة تحسين الموجه الواردة في هذه المقالة (قيمة base_url هي `https://api.apiyi.com/v1`) لإعداد مرحلة المعالجة المسبقة.
3. اربطها بنماذج توليد الصور الرائجة المتاحة على المنصة، وتحقق من السلسلة كاملة، ثم قرّر هل يستحق الأمر النشر الذاتي.
س6: هل يمكنني نشر H3-Image وتقديم خدمة API للآخرين؟
يلزم الحذر الشديد هنا. وفقًا لترخيص H3-Image، يتطلب تقديم أي خدمة استضافة لأي طرف ثالث الحصول مسبقًا على إذن كتابي من MiniMax، بغض النظر عن حجم الإيرادات. يُرجى الرجوع إلى نص الترخيص الأصلي لمعرفة الشروط التفصيلية، واستشارة مختص قانوني عند الحاجة.
النقاط الأساسية في تطور بنية MiniMax H3 Key Takeaways
- أصل واحد واستخدامات مختلفة: يعيد H3-Image استخدام المحوّل (Transformer) الأساسي ومشفّر النصوص الخاصَّين بـ H3، فالأمر ليس مجرد تبديل لوضع الإخراج
- ثلاثة تعديلات رئيسية: حذف فرع الصوت، واستبدال VAE بآخر مخصص للصور، وتغيير هدف التوليد إلى التنبؤ بالمتغيرات الكامنة للصورة
- الفهم الدلالي يأتي من Qwen3-VL: يؤخذ الطور المخفي من الطبقة 50، ليفهم النص والصورة المرجعية معًا
- السرعة تأتي من التقطير: أخذ عينات في 6 خطوات دون الحاجة إلى CFG، وهذا هو الأساس التقني لما تعلنه الجهة الرسمية عن “4K في 10 ثوانٍ”
- للترخيص جانبان منفصلان: الخدمة المستضافة لـ H3-Image وحدّ الإيرادات البالغ مليون دولار كلاهما يستوجب الحصول على ترخيص
- تحقّق أولًا ثم انشر: يمكنك بناء نموذج أولي بعدة نماذج عبر APIYI على apiyi.com، ثم تقييم تكلفة الاستضافة الذاتية
الخلاصة
يمكن تلخيص جوهر تطور MiniMax H3 من الفيديو إلى الصورة في ثلاث نقاط:
- أساس مشترك: بقي المحوّل متعدد الوسائط أحادي التدفق بحجم 33B، ومشفّر النصوص Qwen3-VL، وترميز 3D RoPE كما هي بالكامل.
- تخصيص المهمة: حُذف فرع الصوت، وأُضيف VAE للصور يعتمد على CNN مع 2D ViT، وتحوّل هدف التوليد من متغيرات كامنة للفيديو والصوت إلى متغيرات كامنة للصورة.
- إعادة بناء التدريب والاستدلال: البيانات، والتعلّم المعزَّز، والتقطير إلى 6 خطوات دون CFG، وتحسين الموجّه، وتحسينات النشر، كلها تتضافر لدعم مخرجات بدقة تصل إلى 16MP.
أما بالنسبة للمطورين، فالأجدر بالدراسة هو: أي القدرات يمكن مشاركتها، وأيها يجب تدريبه خصيصًا، إضافةً إلى تكلفة العتاد وراء الأوزان والتزامات الترخيص. وقبل أن تقرر الاستضافة الذاتية، ننصحك بمقارنة عدة نماذج عبر واجهة موحدة من APIYI على apiyi.com، لتشغّل سير عمل الصور لديك بسرعة.
📚 المراجع
- التعريف التقني الرسمي بنموذج MiniMax H3: شرح معمارية H3-Omni-Transformer
- الرابط:
minimax.io/blog/minimax-h3 -
الوصف: الوصف الرسمي لمسار الترميز متعدد الوسائط وتقنية 3D Multimodal RoPE
-
مدونة الإطلاق الرسمية لنموذج MiniMax H3-Image: ما بعد التدريب وتحسين الاستدلال
- الرابط:
minimax.io/blog/minimax-h3-image -
الوصف: تحسينات البيانات والتعلم المعزز والتقطير على 6 خطوات وتعزيز الموجّه
-
بطاقة نموذج H3-Image على Hugging Face: معاملات المعمارية الكاملة
- الرابط:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
الوصف: المواصفات التفصيلية لكل من DiT وVAE ومشفّر النص
-
بطاقة النموذج الأصلية لـ H3 والترخيص: مواصفات نموذج الفيديو وشروط الترخيص
- الرابط:
huggingface.co/MiniMaxAI/MiniMax-H3 -
الوصف: مواصفات H3 والنص الأصلي للترخيص في
blob/main/LICENSE -
النص الأصلي لترخيص H3-Image: شروط الترخيص التجاري
- الرابط:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
الوصف: بنود الخدمات المستضافة وحدود الإيرادات وغيرها
-
وصفة نشر vLLM: إعدادات اختبار الإطار
- الرابط:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - الوصف: المعايير على مستوى الإطار، مثل عدد الصور المرجعية
المؤلف: فريق APIYI التقني
للنقاش التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com، ويمكنكم الاطلاع على مزيد من المواد في مركز التوثيق docs.apiyi.com