ملاحظة الكاتب: تتصدر المجموعة نفسها من نماذج اللغة الكبيرة الصينية مفتوحة المصدر ترتيب الإنفاق لدى Menlo Ventures وترتيب الطلبات لدى OpenRouter بترتيب يكاد يكون معكوسًا. يشرح هذا المقال معايير القياس في القائمتين، ويقدم طريقة من 5 خطوات يمكن تطبيقها مباشرة لاختيار النموذج المناسب.
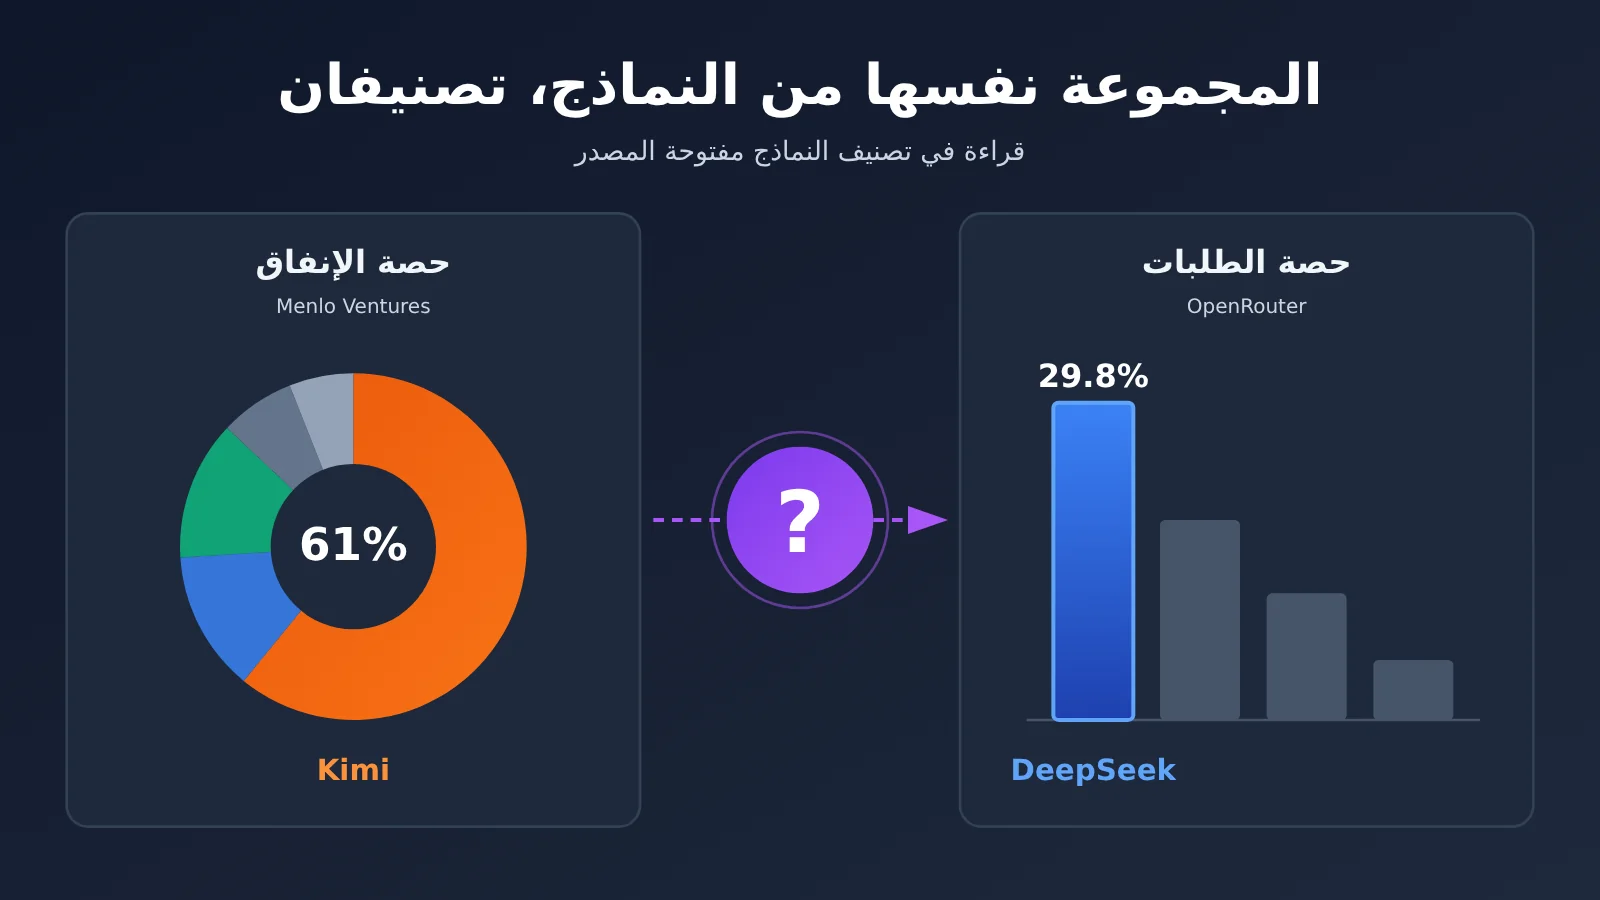
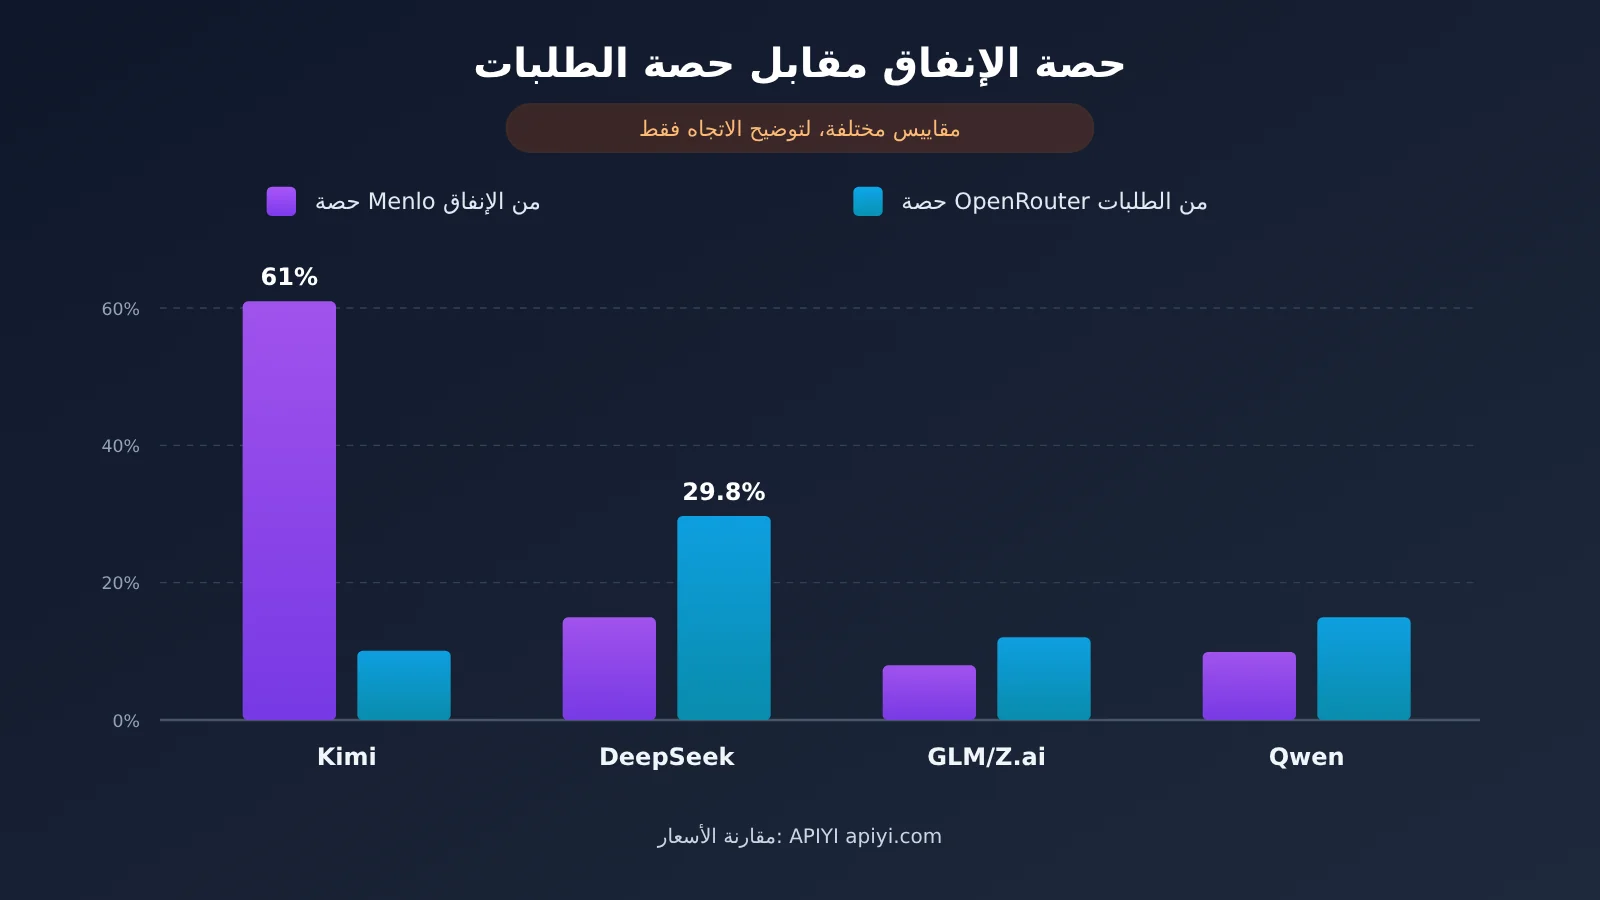
صدرت في أوائل نوفمبر مجموعتان من البيانات. أظهر تقرير Menlo Ventures أن Kimi استحوذ على 61% من إنفاق الشركات الأمريكية على النماذج مفتوحة المصدر. بينما أظهر التصنيف الأسبوعي لـ OpenRouter أن DeepSeek استحوذ على 29.8% من الطلبات النصية على المنصة. المتصدر ليس هو نفسه في القائمتين، والترتيب بينهما يكاد يكون معكوسًا. وكان رد فعل كثير من المسؤولين التقنيين: أي القائمتين نصدق؟
الجواب أن القائمتين لا تتعارضان، فكل منهما تقيس شيئًا مختلفًا. قائمة الإنفاق ترصد «الجهات التي تدفع لها الشركات»، أما قائمة الطلبات فترصد «النماذج التي يستدعيها المطورون على منصة معينة». عند اختيار نموذج، لا يكفي اتباع إحدى القائمتين كما هي؛ بل ينبغي الحكم وفقًا لنوع المهام وطريقة حساب التكلفة لديك. القوائم تساعدك على تضييق نطاق المرشحين، لكنها لا تختار النموذج نيابةً عنك.
هذا المقال ليس مجرد استعراض آخر للترتيب. سنوضح عينة كل قائمة والفترة الزمنية التي تغطيها وحدود الاستفادة منها، ثم نشرح أثر «انخفاض سعر الوحدة وارتفاع الاستخدام» على هيكل التكلفة، ونختم بقائمة من 5 خطوات لاختيار النموذج.
أبرز معلومات تصنيفات النماذج مفتوحة المصدر: لماذا تصدّرت Kimi قائمة وDeepSeek أخرى؟
الخلاصة: تقيس Menlo Ventures إنفاق الشركات، بينما تقيس OpenRouter طلبات المنصة. وتختلف القائمتان في العينة والفترة الزمنية وما تقيسانه.
غالبًا ما تُناقش هاتان المجموعتان من البيانات معًا، لكن لكل منهما أساسًا مختلفًا لحساب النسب. تستند بيانات Menlo Ventures إلى استبيان لصنّاع قرارات الذكاء الاصطناعي في الشركات الأمريكية، وهي تقديرات مبنية على المسح وليست فواتير مدققة. أما بيانات OpenRouter فتستند إلى إحصاءات الطلبات على منصتها، ولا تعكس إلا سلوك مستخدميها، ولا تمثل السوق بأكمله.
| القائمة | ما تقيسه | العينة/الفترة | أبرز النتائج | ما الذي تساعد على تقييمه؟ |
|---|---|---|---|---|
| تقرير Menlo Ventures عن واقع الذكاء الاصطناعي في الشركات لعام 2026 | حصة الإنفاق على النماذج مفتوحة المصدر لدى الشركات الأمريكية | قرابة 400 من صنّاع قرارات الذكاء الاصطناعي في الشركات الأمريكية؛ أُجري المسح من 8 إلى 26 سبتمبر 2026، ونُشر في 3 نوفمبر | Kimi بنسبة 61%، وDeepSeek بنسبة 15%، وGLM بنسبة 11%، وMeta Llama بنسبة 7%، وQwen بنسبة 3% | تفضيلات شراء الشركات، واتجاهات الميزانيات، والنماذج التي أُدرجت في عقود رسمية |
| تصنيف OpenRouter الأسبوعي | حصة طلبات النصوص على المنصة | منصة OpenRouter، من 26 أكتوبر إلى 1 نوفمبر | DeepSeek بنسبة 29.8%، وOpenAI بنسبة 18.8%، وZ.ai بنسبة 11.9%، وQwen بنسبة 5.6% في المركز السادس | نشاط المطورين، والاستدعاءات الحساسة للسعر، ومدى رواج النماذج في المجتمع |
يتضح من الجدول أن القائمتين لا تضمان حتى الجهات نفسها. فتحصي Menlo نماذج المصدر المفتوح فقط، بينما تشمل OpenRouter أيضًا شركات النماذج المغلقة مثل OpenAI وGoogle. لذلك، فإن المقارنة المباشرة بين النسبتين تستند إلى معيارين مختلفين.
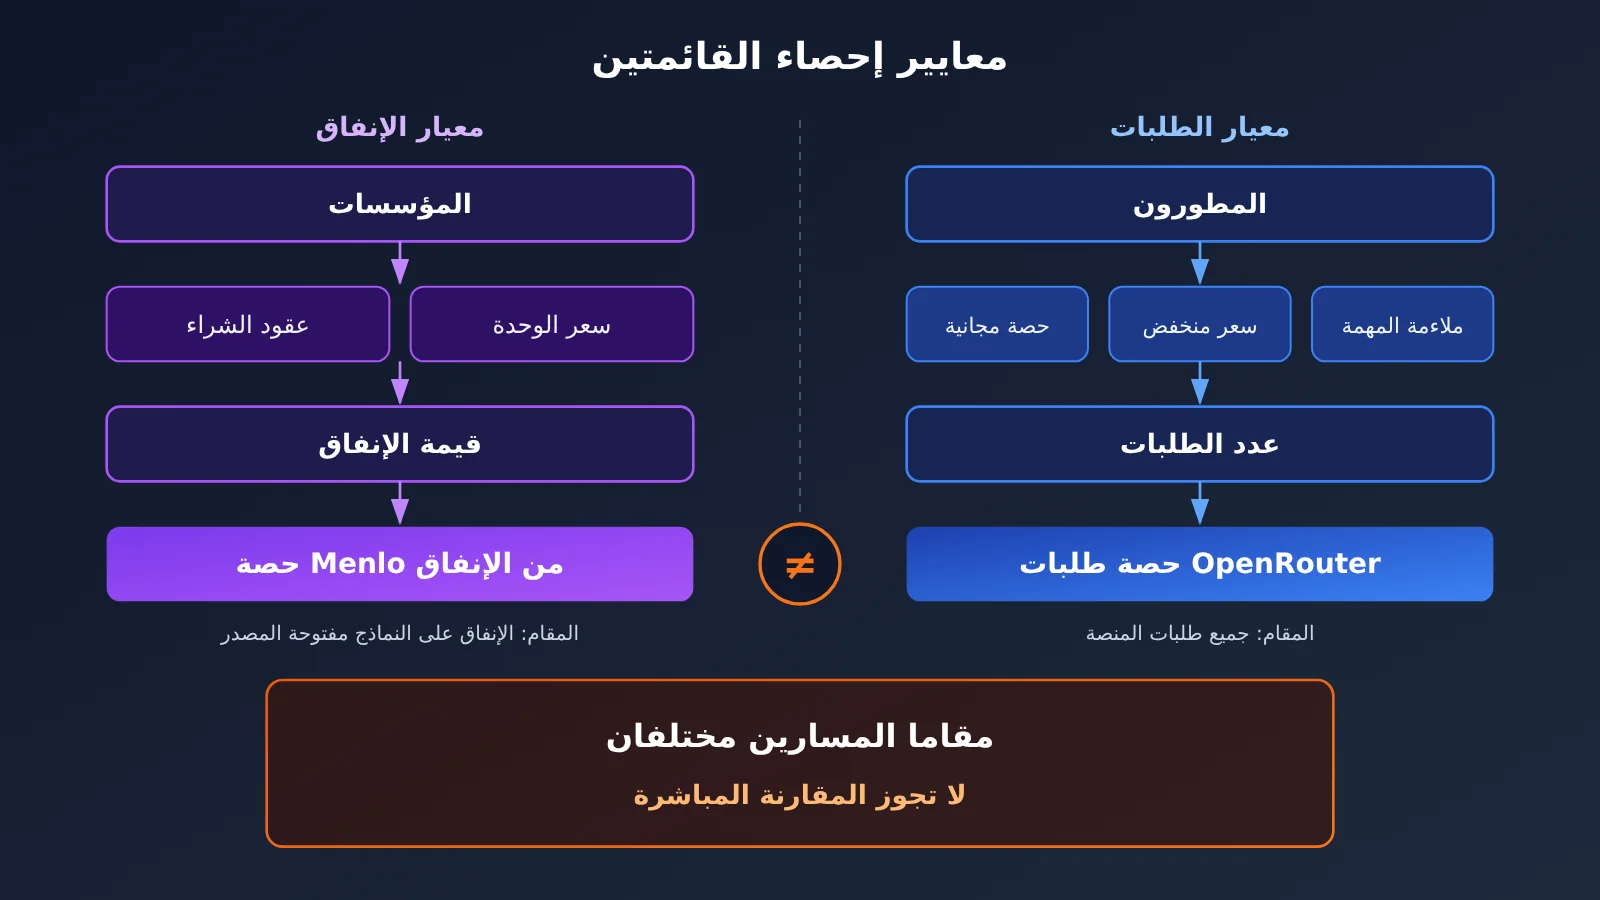
كيف نقرأ قائمة الإنفاق لدى Menlo Ventures: حصة Kimi تبلغ 61% من الإنفاق على النماذج مفتوحة المصدر
الخلاصة: تشير بيانات Menlo Ventures إلى أن النماذج الصينية مفتوحة المصدر دخلت بالفعل ميزانيات الشركات الأمريكية، لكنها تقديرات مسحية وليست ترتيبًا للقدرات.
الرقم الذي حظي بأكبر قدر من الاهتمام في التقرير هو أن النماذج الصينية تستحوذ على 89% من إنفاق الشركات الأمريكية على النماذج مفتوحة المصدر. وتبلغ حصة Kimi وحده 61%، يليه DeepSeek بنسبة 15%، ثم GLM بنسبة 11%، وQwen بنسبة 3%. أما بين النماذج غير الصينية، فتبلغ حصة Meta Llama نحو 7%.
| النموذج | حصته من إنفاق الشركات الأمريكية على النماذج مفتوحة المصدر | ما ينبغي معرفته |
|---|---|---|
| Kimi | 61% | صاحب الحصة الأكبر، وقد يرتبط ذلك بقنوات الشراء لدى الشركات وسعر الوحدة |
| DeepSeek | 15% | يحتل المرتبة الثانية في الإنفاق، لكنه أكثر نشاطًا من حيث الاستدعاءات |
| GLM | 11% | يحظى بحضور مستقر في ميزانيات الشركات |
| Meta Llama | 7% | صاحب الحصة الأكبر بين النماذج غير الصينية مفتوحة المصدر |
| Qwen | 3% | حصته من الإنفاق صغيرة، لكنه يحظى بحضور ملحوظ من حيث الاستدعاءات |
تتضح الصورة أكثر عند وضع هذه الأرقام في سياقها العام. يقدّر التقرير الإنفاق السنوي العالمي للشركات على نشر الذكاء الاصطناعي بنحو 176.8 مليار دولار، بزيادة تجاوزت 100 ضعف خلال ثلاث سنوات. وتستحوذ مختبرات النماذج المتقدمة على 69% من إنفاق النشر، بينما لا تمثل النماذج مفتوحة المصدر سوى 4% من إجمالي الإنفاق على النماذج. لذلك، فإن «حصة Kimi البالغة 61%» تعني 61% من شريحة النماذج مفتوحة المصدر الصغيرة، وليس من سوق الذكاء الاصطناعي للشركات بأكمله.
كذلك، تعتمد بيانات الاستبيان على تقديرات المشاركين لميزانيات شركاتهم، كما أن العينة التي تضم قرابة 400 مشارك لا تشمل سوى الشركات الأمريكية. والقراءة المعقولة هي أن هذه البيانات تكشف اتجاهًا عامًا في مشتريات الشركات، أما النسب المحددة فهي تقديرات مسحية تحتاج إلى مزيد من البيانات للتحقق منها.
كيف نقرأ ترتيب OpenRouter للطلبات؟ DeepSeek يستحوذ على 29.8% منها
الخلاصة: يعكس ترتيب OpenRouter الأسبوعي مدى إقبال المطورين على استدعاء النماذج عبر المنصة. يمكن الاستفادة منه لرصد الاتجاهات، لكنه لا يمثل حصص السوق بأكملها.
في الأسبوع من 26 أكتوبر إلى 1 نوفمبر، تصدّر DeepSeek القائمة بحصة 29.8% من الطلبات النصية، بزيادة 7% عن الأسبوع السابق. وجاءت OpenAI ثانيةً بحصة 18.8%، بينما تراجعت حصة Google عن 14.4%. وحلّت Z.ai رابعةً بحصة 11.9%، وQwen سادسةً بحصة 5.6%.
| الترتيب | الشركة | حصة الطلبات | التغير |
|---|---|---|---|
| الأول | DeepSeek | 29.8% | +7% مقارنة بالأسبوع السابق |
| الثاني | OpenAI | 18.8% | — |
| تراجع | انخفضت عن 14.4% | تراجع الحصة | |
| الرابع | Z.ai | 11.9% | — |
| السادس | Qwen | 5.6% | — |
هناك اتجاهان آخران يستحقان الانتباه. فقد تجاوز حجم استخدام الرموز في النماذج الصينية نظيره في النماذج الأمريكية للأسبوع السابع والعشرين على التوالي، وشغلت النماذج الصينية أربعة من المراكز الخمسة الأولى في حجم الاستدعاءات الأسبوعية للنموذج الواحد. وفي الفترة نفسها، حدّثت DeepSeek نموذجها إلى DeepSeek V4.1-Flash-1017 دون تغيير طريقة استدعاء API أو الأسعار، ما يجعل تكلفة الانتقال منخفضة للمطورين الذين يستخدمون الخدمة بالفعل.
ومن المهم أيضًا الانتباه إلى الاستقرار. ففي 3 نوفمبر، شهد كل من واجهة الويب وواجهة API لدى DeepSeek انقطاعًا جزئيًا استمر نحو ساعة. ولا يعني ارتفاع حجم الاستدعاءات أن الخدمة متاحة دائمًا، وهذا سبب أهمية الاحتفاظ بنموذج بديل، كما سنوضح لاحقًا. وبعد إطلاق الإصدار الجديد، يُرجى الرجوع إلى قائمة النماذج في لوحة تحكم APIYI على apiyi.com للتحقق من معرّف النموذج المحدد وطريقة الفوترة.
لماذا يختلف ترتيب النماذج مفتوحة المصدر بين قائمة الإنفاق وقائمة الطلبات؟
الخلاصة: يعود اختلاف الترتيب أساسًا إلى خمسة عوامل: سعر الوحدة، وطريقة الشراء، والحصة المجانية، ومدى ملاءمة النموذج للمهمة، ونطاق بيانات كل منصة. ولا يعني ذلك أن إحدى القائمتين «خاطئة».
تعادل حصة الإنفاق تقريبًا «حجم الاستخدام × سعر الوحدة»، مع تأثير عوامل العقود والشراء أيضًا. أما حصة الطلبات فتحسب عدد الاستدعاءات فقط، بصرف النظر عن تكلفة كل منها. فإذا كان سعر وحدة النموذج أعلى وكانت الشركات مستعدة لتوقيع عقود لشرائه، فسيتقدم في قائمة الإنفاق. أما إذا كان سعره منخفضًا ويستخدمه المطورون بكثرة، فسيتقدم في قائمة الطلبات.
| العامل المؤثر | أثره في حصة الإنفاق | أثره في حصة الطلبات |
|---|---|---|
| سعر الوحدة | ارتفاع السعر يزيد تكلفة الاستخدام نفسه، فتزداد حصة الإنفاق | انخفاض السعر يشجع على التجربة، فيزداد عدد الطلبات |
| شراء الشركات | تُحتسب العقود والنشر الخاص واتفاقيات الخدمة ضمن الإنفاق | قد لا تمر الاستدعاءات عبر OpenRouter، فلا تظهر على المنصة |
| الحصة المجانية | لا تنتج عن الاستدعاءات المجانية نفقات | تُحتسب الاستدعاءات المجانية ضمن عدد الطلبات |
| ملاءمة المهمة | المهام التي تستهلك عددًا كبيرًا من الرموز، مثل معالجة المستندات الطويلة ووكلاء الذكاء الاصطناعي، ترفع التكلفة | المحادثات القصيرة والمهام الصغيرة المجمّعة ترفع عدد الطلبات |
| نطاق بيانات المنصة | يشمل فقط الشركات الأمريكية التي شملها الاستطلاع | يشمل فقط مستخدمي OpenRouter |
وفقًا لهذا الإطار، قد يتمتع Kimi بميزة في قنوات شراء الشركات وسعر الوحدة، ما يفسر ارتفاع حصته من الإنفاق. أما DeepSeek فسعر وحدته أقل ومجتمع مطوريه نشط، لذا يسجل عددًا كبيرًا من الطلبات. وهذا استنتاج معقول يستند إلى اختلاف نطاق البيانات، لكنه غير مؤكد؛ إذ لا يقدم التقريران تفصيلًا لكل عامل على حدة.
وهناك تفصيل آخر كثيرًا ما يُغفل: تختلف أرقام الإنفاق والاستدعاءات أيضًا باختلاف إصدارات النموذج نفسه، وقنوات الوصول إليه، ومعدلات الاستفادة من ذاكرة التخزين المؤقت. فإذا استفاد فريق من ذاكرة التخزين المؤقت بكثرة، فستظل طلباته محسوبة، لكن إنفاقه الفعلي سيكون أقل بكثير.
أسعار النماذج مفتوحة المصدر واستخدامها: ماذا يعني انخفاض سعر الوحدة بنحو 70% وزيادة الاستخدام 22.5 ضعفًا؟
الخلاصة: انخفاض سعر الوحدة لا يعني انخفاض التكلفة الإجمالية. والمقارنة على أساس «تكلفة إتمام مهمة واحدة» أكثر موثوقية من المقارنة بسعر كل مليون token.
يتضمن تقرير Menlo مجموعة من الأرقام المهمة: انخفض متوسط سعر token من 0.45 دولار/مليون token إلى 0.13 دولار/مليون token، أي بنحو 70%، فيما زاد الاستخدام خلال الفترة نفسها بمقدار 22.5 ضعفًا. وبحساب تقريبي استنادًا إلى هذين الرقمين، يتضح أن الإنفاق الإجمالي لم ينخفض، بل ارتفع إلى نحو 6.5 أضعاف مستواه السابق. وهذا مجرد حساب توضيحي مبني على متوسطات التقرير؛ وقد تختلف النتائج الفعلية من فريق إلى آخر.
وتبرز الصورة بصورة أوضح مع النماذج مفتوحة المصدر: فهي تستحوذ على 19% من استهلاك الشركات للـ token، لكنها لا تمثل سوى 4% من الإنفاق على النماذج. بعبارة أخرى، يُستهلك عدد كبير من token عبر نماذج مفتوحة المصدر منخفضة التكلفة، لكن الجزء الأكبر من الإنفاق يذهب إلى النماذج المتقدمة مغلقة المصدر.
بالنسبة للمطورين، يشجع انخفاض سعر الوحدة على زيادة عدد الاستدعاءات، خصوصًا في مهام الوكلاء (Agent) والمهام الدفعية. لكن حساب التكلفة الفعلية يتطلب أيضًا النظر في المتغيرات التالية:
- إصابة ذاكرة التخزين المؤقت: تحدد إمكانية الاستفادة من التخزين المؤقت لموجهات النظام المتكررة والسياقات الطويلة سعر الوحدة الفعلي مباشرةً.
- طول السياق: في مهام المستندات الطويلة، غالبًا ما يفوق عدد token المدخلة عدد token الناتجة بكثير.
- عدد مرات إعادة المحاولة: تؤدي إعادة المحاولة بسبب عدم استقرار المخرجات أو أخطاء التنسيق إلى مضاعفة التكلفة.
- عدد جولات استدعاء الأدوات: قد تتطلب مهمة واحدة للوكيل أكثر من عشر جولات ذهابًا وإيابًا؛ فيكون سعر الوحدة منخفضًا لكن عدد الجولات كبيرًا.
عند مقارنة الأسعار، يُنصح أولًا بالاطلاع على الأسعار المعلنة وطرق الفوترة للنماذج المرشحة في لوحة تحكم APIYI على apiyi.com، والتأكد من كيفية احتساب المدخلات والمخرجات والتخزين المؤقت كلٍّ على حدة. بعد ذلك، شغّل عينة صغيرة من مهامك واحسب «تكلفة إتمام مهمة واحدة»؛ فهذا الرقم أكثر فائدة في المقارنة من سعر الوحدة المعلن.
كيفية اختيار نموذج مفتوح المصدر: استخدم قوائم التصنيف لتضييق الخيارات، واحتكم إلى المهمة لاتخاذ القرار
الخلاصة: تمنحك قوائم التصنيف قائمة بالنماذج المرشحة، لكن القرار النهائي يعتمد على ملاءمة المهمة والتكلفة والاستقرار والتحقق بعينة صغيرة.
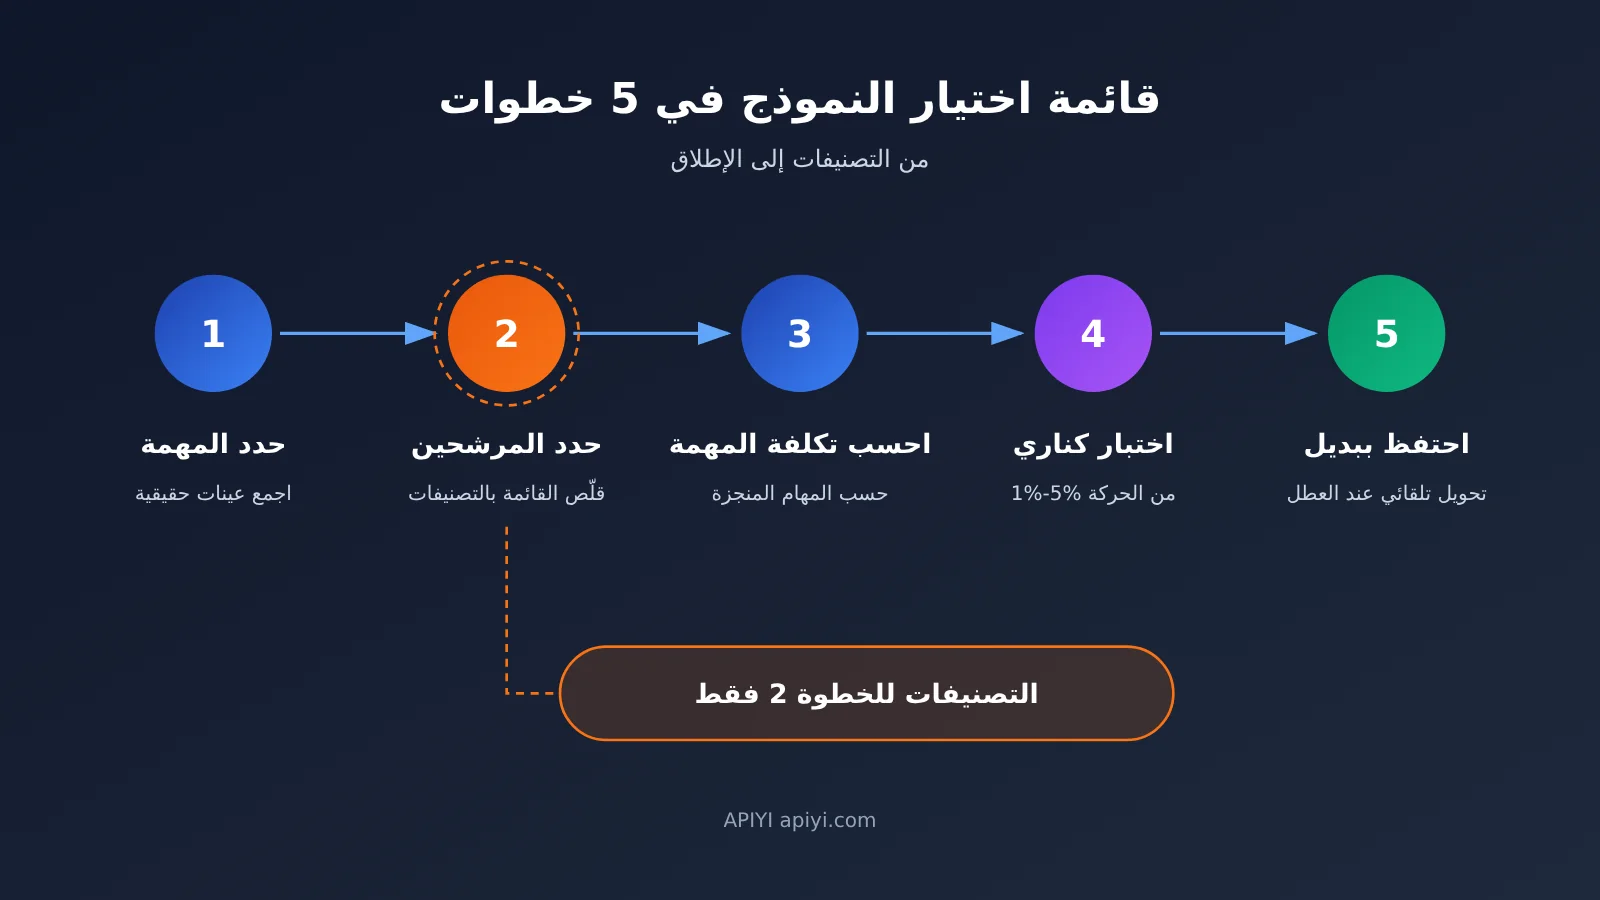
يمكن ترتيب عملية الاختيار كالتالي: المهمة ← التكلفة ← الاستقرار ← التحقق ← البديل. يوضح الجدول الأسئلة التي ينبغي طرحها وطرق التحقق لكل جانب.
| الجانب | ما الأسئلة التي ينبغي طرحها؟ | كيف تتحقق؟ | التأثير على التكلفة |
|---|---|---|---|
| ملاءمة المهمة | هل الاستخدام الأساسي هو البرمجة، أم المستندات الطويلة، أم المهام متعددة الوسائط، أم استدعاء الأدوات بواسطة الوكلاء؟ | جهّز 30-100 عينة من مهام حقيقية، وقيّم المخرجات يدويًا | ضعف الملاءمة يزيد محاولات إعادة التنفيذ والتعديلات اليدوية |
| السعر والتخزين المؤقت | ما تكلفة المدخلات والمخرجات والاستفادة من التخزين المؤقت؟ | راجع قائمة النماذج وتفاصيل الفوترة في لوحة التحكم، واحسب معدل الاستفادة من التخزين المؤقت | يحددان التكلفة الفعلية لكل مليون token |
| السياق | ما طول أطول مدخل؟ وهل يتراجع الأداء عند تجاوز طول معين؟ | اختبر اقتطاع النص واسترجاع المعلومات باستخدام أطول مستند حقيقي لديك | تزيد نافذة السياق الطويلة عدد وحدات token للمدخلات مباشرةً |
| حدود المعدل | هل حدود الطلبات المتزامنة والطلبات في الدقيقة كافية؟ | أجرِ اختبار ضغط وفقًا لحجم حركة المرور في وقت الذروة | عند بلوغ الحد، يلزم الانتظار في قائمة أو التبديل، ما يؤثر في زمن الاستجابة |
| التوفر حسب المنطقة | هل يمكن الوصول إلى النموذج باستقرار من منطقة النشر؟ | استدعِ النموذج فعليًا من منطقة بيئة الإنتاج | إذا لم يكن متاحًا، فستحتاج إلى قناة أخرى |
| الاستقرار | هل حدثت انقطاعات مؤخرًا؟ وكم يستغرق التعافي منها؟ | راجع سجل الأعطال وراقب سجلات معدل الأخطاء | تتسبب الانقطاعات في تكاليف إعادة المحاولة وخسائر للأعمال |
تستغرق مقارنة النماذج المتعددة معظم الوقت في هذه المرحلة. فإذا كان كل نموذج مرشح يتطلب تسجيلًا منفصلًا وتكاملًا مستقلًا مع SDK، فقد تستغرق عملية الربط وحدها عدة أيام. عبر APIYI على apiyi.com، يمكنك استخدام مفتاح API واحد لاستدعاء نماذج من OpenAI وClaude وGemini، بالإضافة إلى DeepSeek وKimi وغيرها. الواجهة متوافقة مع صيغة OpenAI؛ اضبط base_url على https://api.apiyi.com/v1 وغيّر المعامل model في الطلب للتبديل بين النماذج. بذلك يمكنك اختبار المجموعة نفسها من العينات بسرعة ومقارنة النتائج.
لا يكفي الاعتماد على إعلانات المورّدين لتقييم الاستقرار. يذكّرنا انقطاع DeepSeek في 3 نوفمبر بأن أي نموذج منفرد قد يصبح غير متاح مؤقتًا. في لوحة تحكم APIYI على apiyi.com، يمكنك الاطلاع على الاستخدام وسجلات الاستدعاء حسب النموذج، بما في ذلك معدل الأخطاء وزمن الاستجابة واستهلاك token، وهو ما يساعدك على مراقبة الأداء الفعلي للنماذج المرشحة خلال مرحلة النشر التجريبي. تعتمد المنصة على النشر عبر عقد متعددة والتوجيه الذكي، وتوفر أيضًا انتقالًا تلقائيًا إلى بديل. ويمكن لفريق العمل إعداد نموذج احتياطي للتبديل إليه عند تعطل النموذج الأساسي، ما يحد من أثر وجود نقطة فشل واحدة.
يُنصح ببدء النشر التجريبي بنسبة 1%-5% من حركة المرور الحقيقية، مع مراقبة معدل الأخطاء وزمن الاستجابة وتكلفة المهمة الواحدة لعدة أيام. بعد استقرار البيانات، زد النسبة تدريجيًا، ولا تنتقل إلى النموذج الجديد بالكامل دفعة واحدة بمجرد الاطلاع على قوائم التصنيف.
الأسئلة الشائعة حول قوائم ترتيب النماذج مفتوحة المصدر FAQ
الخلاصة: تغطي الأسئلة الخمسة التالية أكثر المفاهيم الخاطئة شيوعًا عند قراءة قوائم ترتيب النماذج مفتوحة المصدر.
السؤال 1: تبلغ حصة Kimi من الإنفاق 61%، فهل يعني ذلك أن نموذج Kimi أفضل؟
لا. تعكس حصة الإنفاق الجهة التي تذهب إليها الأموال، وتتأثر بسعر الوحدة وعقود مشتريات الشركات وقنوات الشراء، ولا ترتبط مباشرة بقدرات النموذج. إضافة إلى ذلك، تستند بيانات مينلو إلى تقديرات مسحية لا تغطي سوى إنفاق الشركات الأمريكية على النماذج مفتوحة المصدر. «الأول في الإنفاق» لا يعني «الأول في القدرات»؛ ولتقييم القدرات، استخدم مهامك الخاصة.
السؤال 2: هل يعكس ترتيب الطلبات على OpenRouter مشتريات الشركات؟
لا. يحصي OpenRouter حصة الطلبات على منصته فقط، ويتألف مستخدموه أساسًا من المطورين والفرق الصغيرة والمتوسطة. ولا تشمل الإحصاءات العقود المباشرة للشركات أو عمليات النشر الخاص أو القنوات الأخرى. لذا تصلح لمتابعة رواج النماذج بين المطورين واتجاهات الاستدعاءات الحساسة للسعر، لكنها لا تصلح لاستنتاج توزيع ميزانيات الشركات.
السؤال 3: هل يعني انخفاض سعر وحدة النموذج بالضرورة انخفاض التكلفة الإجمالية؟
ليس بالضرورة. إذا احتاج النموذج الأقل سعرًا إلى مزيد من المحاولات أو موجهات أطول أو جولات إضافية من استدعاء الأدوات، فقد يكون إجمالي استهلاك الرموز أعلى. يُنصح بحساب تكلفة «إنجاز مهمة واحدة»: راجع استخدام الرموز وسجلات التكلفة لكل استدعاء في لوحة تحكم APIYI على apiyi.com، ثم قارن إجمالي تكلفة إنجاز مجموعة المهام نفسها باستخدام نماذج مختلفة.
السؤال 4: هل تستطيع النماذج مفتوحة المصدر أن تحل محل النماذج مغلقة المصدر بالكامل؟
يعتمد ذلك على المهمة. تشير بيانات مينلو إلى أن النماذج مفتوحة المصدر استُخدمت في معالجة 19% من رموز الشركات، لكنها لم تمثل سوى 4% من الإنفاق. وهذا يشير إلى أن فرقًا كثيرة تسند المهام الروتينية والمهام واسعة النطاق إلى النماذج مفتوحة المصدر، وتترك المهام المعقدة للنماذج المتقدمة مغلقة المصدر. ومن الأسلم استخدام النوعين معًا: يمكنك عبر APIYI على apiyi.com الوصول إلى النماذج مفتوحة ومغلقة المصدر باستخدام مفتاح API واحد، ثم توجيه المهام وفقًا لصعوبتها.
السؤال 5: كم مرة ينبغي متابعة قوائم ترتيب النماذج مفتوحة المصدر؟
يمكنك تصفح القوائم الأسبوعية مرة كل شهر لمتابعة الاتجاهات بدلًا من التركيز على تقلبات أسبوع واحد. واقرأ تقارير الاستطلاعات السنوية أو الفصلية بعناية عند صدورها، مع الانتباه إلى أي تغييرات في نطاق القياس أو العينة. أما ما يؤثر فعليًا في قراراتك فهو المتابعة المستمرة لمؤشرات أعمالك، مثل معدل الأخطاء وتكلفة المهمة الواحدة وملاحظات المستخدمين؛ ويُنصح بمراجعتها أسبوعيًا.
خلاصة قراءة قوائم النماذج مفتوحة المصدر: قائمة من 5 خطوات للاختيار
الخلاصة أولًا: تقيس القائمتان أمرين مختلفين. لقراءتهما بشكل صحيح، اسأل أولًا عن طريقة القياس، ثم انظر إلى العينة، وأخيرًا اختبر النتائج على مهامك الخاصة.
أبرز النقاط:
- الإنفاق ≠ الاستدعاءات: تقيس Menlo إنفاق الشركات، بينما تقيس OpenRouter طلبات منصتها. أساس القياس مختلف، لذا لا تصح المقارنة المباشرة.
- الاستطلاع ≠ التدقيق: تستند بيانات Menlo إلى تقديرات من استطلاع شمل نحو 400 من صنّاع القرار في الشركات الأمريكية، بينما تمثل بيانات OpenRouter منصتها فقط.
- رخص السعر ≠ توفير المال: انخفض سعر الوحدة بنحو 70%، لكن الاستخدام زاد بمقدار 22.5 ضعفًا، فارتفع إجمالي الإنفاق. لذلك يجب الحساب على أساس تكلفة المهمة.
- الشعبية ≠ الاستقرار: حتى النموذج الأول من حيث عدد الاستدعاءات قد يتعرض لانقطاع، لذا يجب تجهيز بديل مسبقًا.
- تساعدك القوائم على تضييق نطاق المرشحين، لكنها لا تختار النموذج بدلًا منك.
يمكنك استخدام القائمة التالية مباشرة عند اختيار نموذجك المقبل:
- حدد المهمة: اكتب أنواع المهام الرئيسية بوضوح، مثل البرمجة أو المستندات الطويلة أو المهام متعددة الوسائط أو الوكلاء (Agent)، واجمع 30-100 عينة حقيقية مع معايير تقييمها.
- ضع قائمة بالمرشحين: اختر 2-3 نماذج من كل من قائمة الإنفاق وقائمة الطلبات، ثم أضف نموذجًا مغلق المصدر للمقارنة، واحصر القائمة في 3-5 نماذج.
- احسب تكلفة المهمة: اختبر جميع المرشحين على مجموعة العينات نفسها، وسجّل استهلاك الرموز (tokens)، ومعدل الاستفادة من ذاكرة التخزين المؤقت، وعدد مرات إعادة المحاولة، ثم احسب تكلفة المهمة الواحدة ودرجة الجودة.
- أجرِ اختبارًا تدريجيًا: وجّه 1%-5% من حركة المرور الفعلية إلى النموذج المختار، وراقب معدل الأخطاء وزمن الاستجابة والتكلفة لبضعة أيام، ثم زد النسبة بعد استيفاء المعايير.
- جهّز بديلًا: أعدّ نموذجًا احتياطيًا واحدًا على الأقل من مزوّد مختلف، وحدد قواعد التحويل إليه، واختبرها دوريًا.
إذا أردت تنفيذ الخطوات من الثالثة إلى الخامسة عبر واجهة واحدة، يمكنك استخدام APIYI على apiyi.com للوصول إلى النماذج المرشحة بمفتاح واحد، ومقارنة الأسعار والاستخدام والسجلات في لوحة التحكم، ثم إعداد التحويل إلى النموذج الاحتياطي باستخدام ميزة التخفيض التلقائي في المنصة. ويحصل المستخدمون الجدد على رصيد تجريبي مجاني، مناسب لبدء الاختبار بعينة صغيرة.
مصادر بيانات المقال
- تقرير Menlo Ventures عن واقع الذكاء الاصطناعي في الشركات لعام 2026: نُشر في 3 نوفمبر 2026
- الرابط:
menlovc.com -
توضيح: بيانات إنفاق الشركات على الذكاء الاصطناعي، وحصة النماذج مفتوحة المصدر من الإنفاق، وتغير أسعار الرموز هي تقديرات قائمة على استطلاع.
-
تصنيف نماذج OpenRouter: التصنيف الأسبوعي للفترة من 26 أكتوبر إلى 1 نوفمبر 2026
- الرابط:
openrouter.ai/rankings - توضيح: بيانات حصة الطلبات النصية واتجاهات استدعاء الرموز تمثل المنصة وحدها.
الكاتب: الفريق التقني في APIYI
للتواصل التقني: إذا واجهت أسئلة حول الأسعار أو حدود الطلبات أو التحويل بين النماذج، يمكنك التواصل معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com. ولمزيد من معلومات التكامل، تفضل بزيارة مركز التوثيق على docs.apiyi.com.