ملاحظة الكاتب: يقارن هذا المقال بين طريقتين لإضافة الترجمات المكتوبة إلى الفيديو المولَّد بالذكاء الاصطناعي: حرق الترجمة عبر موجه Seedance، وتفريغ المسار الصوتي للفيديو النهائي إلى نص. ويوضح أي الترجمات يمكن تعديلها وترجمتها، وأي جزء من التكلفة يوفره تغيير نموذج الفيديو فعلًا.
كثيرون ينجحون في تشغيل واجهة الفيديو على APIYI، ثم لا تكون العقبة جودة الصورة بل الترجمات المكتوبة في الفيديو النهائي. الفكرة الشائعة أن Seedance مكلف في كل مقطع، فيُستبدل بـ Grok أو Hailuo أو Wan، مع البحث عن نموذج «يجهّز الترجمات جاهزة مباشرة». وهذه خلاصة تأخذها معك: الترجمات القابلة للتعديل لا تأتي مباشرة من نموذج الفيديو. وإذا أردت ترجمات قابلة للتعديل والترجمة إلى لغات أخرى، فاستخرجها بتفريغ المسار الصوتي للفيديو النهائي.
لا يوجد حاليًا بين نماذج الفيديو المتاحة نموذج يُخرج ملف ترجمات قابلًا للتعديل ضمن مخرجاته. يستطيع Seedance حرق النص في بكسلات الصورة وفق ما ورد في «دليل موجهات سلسلة Seedance 2.0» من Volcano Engine. لكن الدليل نفسه يعترف بأن الفيديو قد يُخرج ترجمات عشوائية حتى لو لم تكتب شيئًا عنها في الموجه، وأنه لا يمكن إزالتها بنسبة 100%. أما صفحات Wan3.0 وWan2.7 وHappyHorse وMiniMax H3 وOxygen وGrok Imagine فتتحدث عن المسار الصوتي أو التوليد المدفوع بالصوت فقط، ولا تذكر أي معامل للترجمات. لذلك فإن الانتقال إلى نموذج فيديو أغلى لن يحل مشكلة الترجمات.
هذا ليس تحليلًا يقول «لكلٍّ مزاياه». يقارن المقال بين طريقتين فقط: الحرق عبر الموجه، والتفريغ بعد الإنتاج. ثم يحدد الاختيار مباشرة في ثلاثة سيناريوهات نموذجية. جميع نماذج الفيديو المذكورة في المقال يمكن استدعاؤها عبر APIYI على apiyi.com، وتُعتمد الإصدارات والأسعار كما في قائمة النماذج على المنصة.
القيمة الأساسية: بعد القراءة ستتمكن من اتخاذ قرارين. الأول: هل تطلب حرق الترجمات في الموجه لهذا المقطع أم لا؟ والثاني: إذا أردت توفير المال، فأي فئة من النماذج تنتقل إليها؟
قبل أي شيء: المسار الصوتي ليس ترجمة نصية
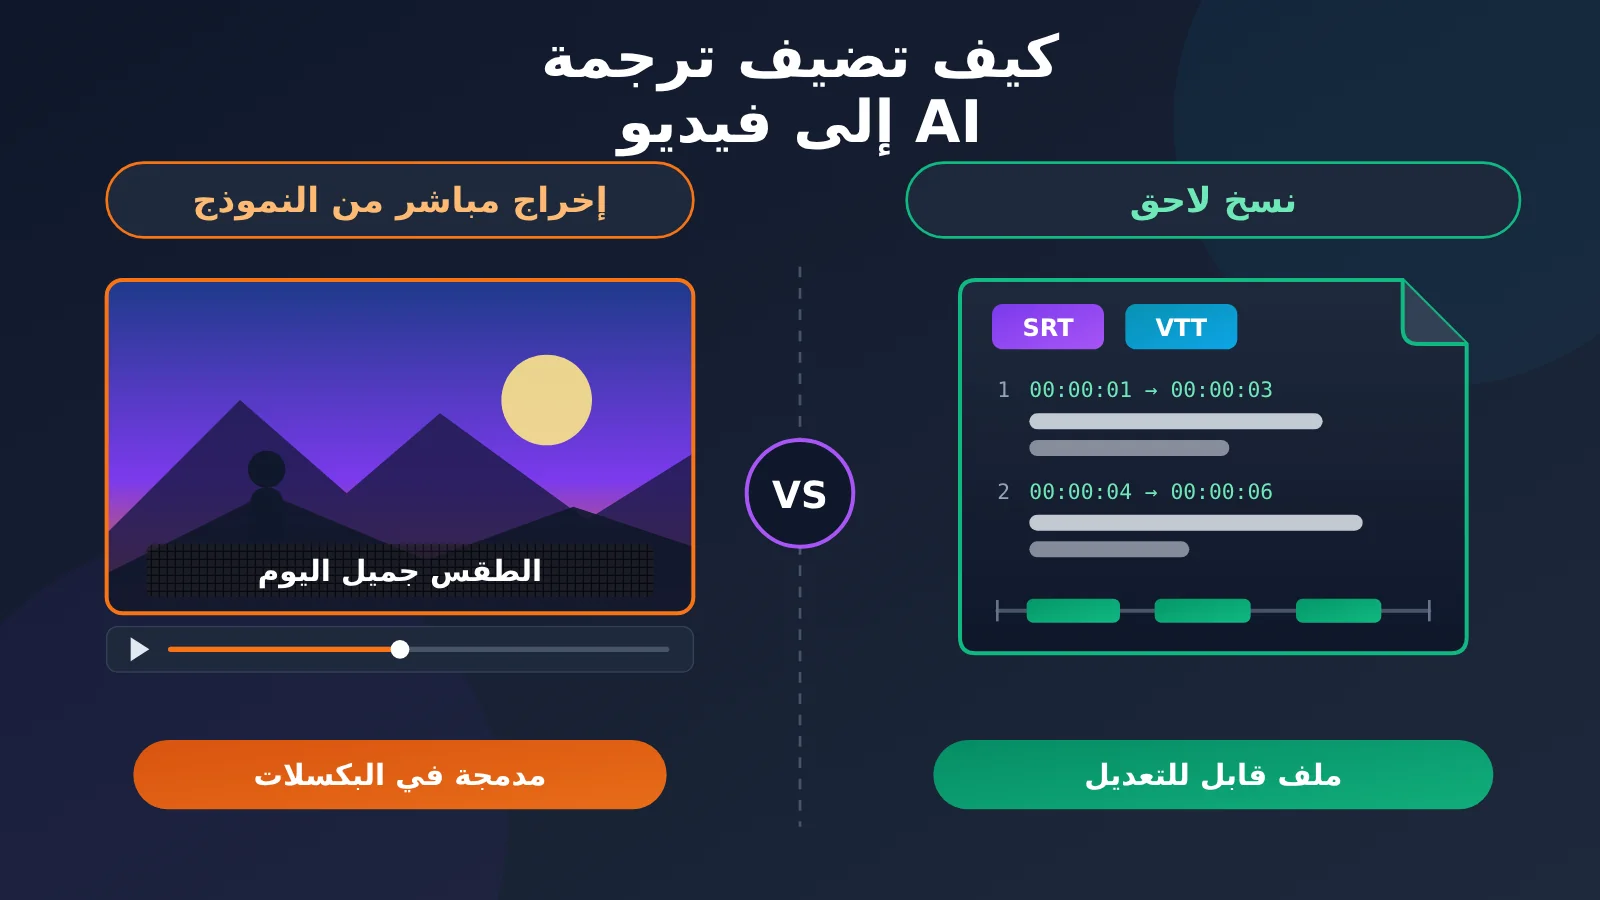
قبل الحديث عن إضافة الترجمة النصية (الترجمات المصاحبة) إلى مقاطع الفيديو المولَّدة بالذكاء الاصطناعي، علينا أن نفصل بين «الصوت» و«الترجمة النصية». نماذج الفيديو تولّد الحوار والمؤثرات الصوتية والصورة معًا، فتحصل على مسار صوتي مدمج داخل المقطع النهائي. وجود الحوار في المسار الصوتي لا يعني أن المقطع يحتوي على ترجمة نصية. وحتى لو ظهرت كلمات على الشاشة، فإذا كانت «محروقة» في البكسلات فهي جزء من الصورة، وليست مسار ترجمة نصية.
نقصد بعبارة «ترجمة نصية قابلة للاستخدام» في هذه المقالة ما يحقق ثلاثة شروط معًا. الأول: أن تكون الكلمات صحيحة، بلا أخطاء إملائية ولا كلمات ناقصة ولا رموز مشوّهة بدل الأحرف النادرة. الثاني: أن يتطابق توقيت ظهورها مع الحوار. الثالث: أن يبقى بالإمكان تعديل النص لاحقًا وترجمته إلى لغات أخرى. النص المحروق في البكسلات قد يحقق الشرطين الأولين على أفضل تقدير، أما الثالث فلن يحققه أبدًا: تصحيح خطأ إملائي واحد يعني إعادة توليد المقطع كاملًا، وإصدار نسخة إنجليزية يعني إعادة توليده كذلك.
دليل الموجهات (prompts) من Volcano Engine يتبنى التصور نفسه: فهو يصنّف «الترجمة النصية» نوعًا من النص المعروض على الشاشة، ويضعها في القسم ذاته مع الشعارات الإعلانية وفقاعات الحوار، ولا يتناول الدليل ملفات SRT أو VTT ولا مسار ترجمة مستقلًا. وإذا فهمنا هذا، أمكننا إعادة صياغة السؤال «أي نموذج فيديو يقدّم ترجمة نصية أفضل؟» ليصبح: هل تريد كلمات على الشاشة، أم ملف ترجمة نصية قابلًا للتحرير؟
الفروق الجوهرية بين طريقتين لإضافة الترجمة إلى فيديوهات الذكاء الاصطناعي
الفرق بين المسارين لا يتعلق بجودة الصورة ولا بمستوى النموذج، بل بالمكان الذي تُحفظ فيه الترجمة في النهاية. المسار الأول يحفظ الترجمة داخل البكسلات، والمسار الثاني يحفظها في ملف مستقل. يقارن الجدول التالي بين المسارين وفق ثلاثة معايير لما يجعل الترجمة “صالحة للاستخدام”.
| وجه المقارنة | المسار الأول: حرق الترجمة عبر الموجه | المسار الثاني: تفريغ الترجمة من المسار الصوتي للمقطع النهائي | الأفضل |
|---|---|---|---|
| دقة الحروف | تعتمد على توليد النموذج، ويشترط الدليل استخدام الحروف الشائعة وتجنب الحروف النادرة والرموز الخاصة | تأتي من التعرف على الكلام في المسار الصوتي، ويمكن مراجعتها يدويًا | المسار الثاني |
| التوافق مع الحوار | يمكن كتابة «متزامنة تمامًا مع إيقاع الصوت» في الموجه، لكن النتيجة تعتمد على الحظ (مثل سحب البطاقات) | يجري ضبطها بالطوابع الزمنية للتفريغ أو ببرنامج المونتاج، ويمكن تعديلها بدقة | المسار الثاني |
| تعديل النص أو ترجمته لاحقًا | غير ممكن، فتعديل النص يعني إعادة توليد الفيديو كاملًا | ممكن، يكفي تعديل الملف، ويمكن إخراج نسخ بلغات متعددة | المسار الثاني |
| النماذج المدعومة | الدليل الرسمي لـ Seedance وحده يذكر هذه القدرة | أي مقطع نهائي يحتوي على مسار صوتي | المسار الثاني |
| خطوات إضافية | لا شيء، فالفيديو يخرج وفيه الترجمة | يحتاج إلى خدمة تفريغ أو برنامج مونتاج | المسار الأول |
| عند الرغبة في إزالة الترجمة | يوضح الدليل الرسمي أنه لا يمكن تجنب ظهور ترجمة غير مرغوبة بنسبة 100% | لا توجد هذه المشكلة | المسار الثاني |
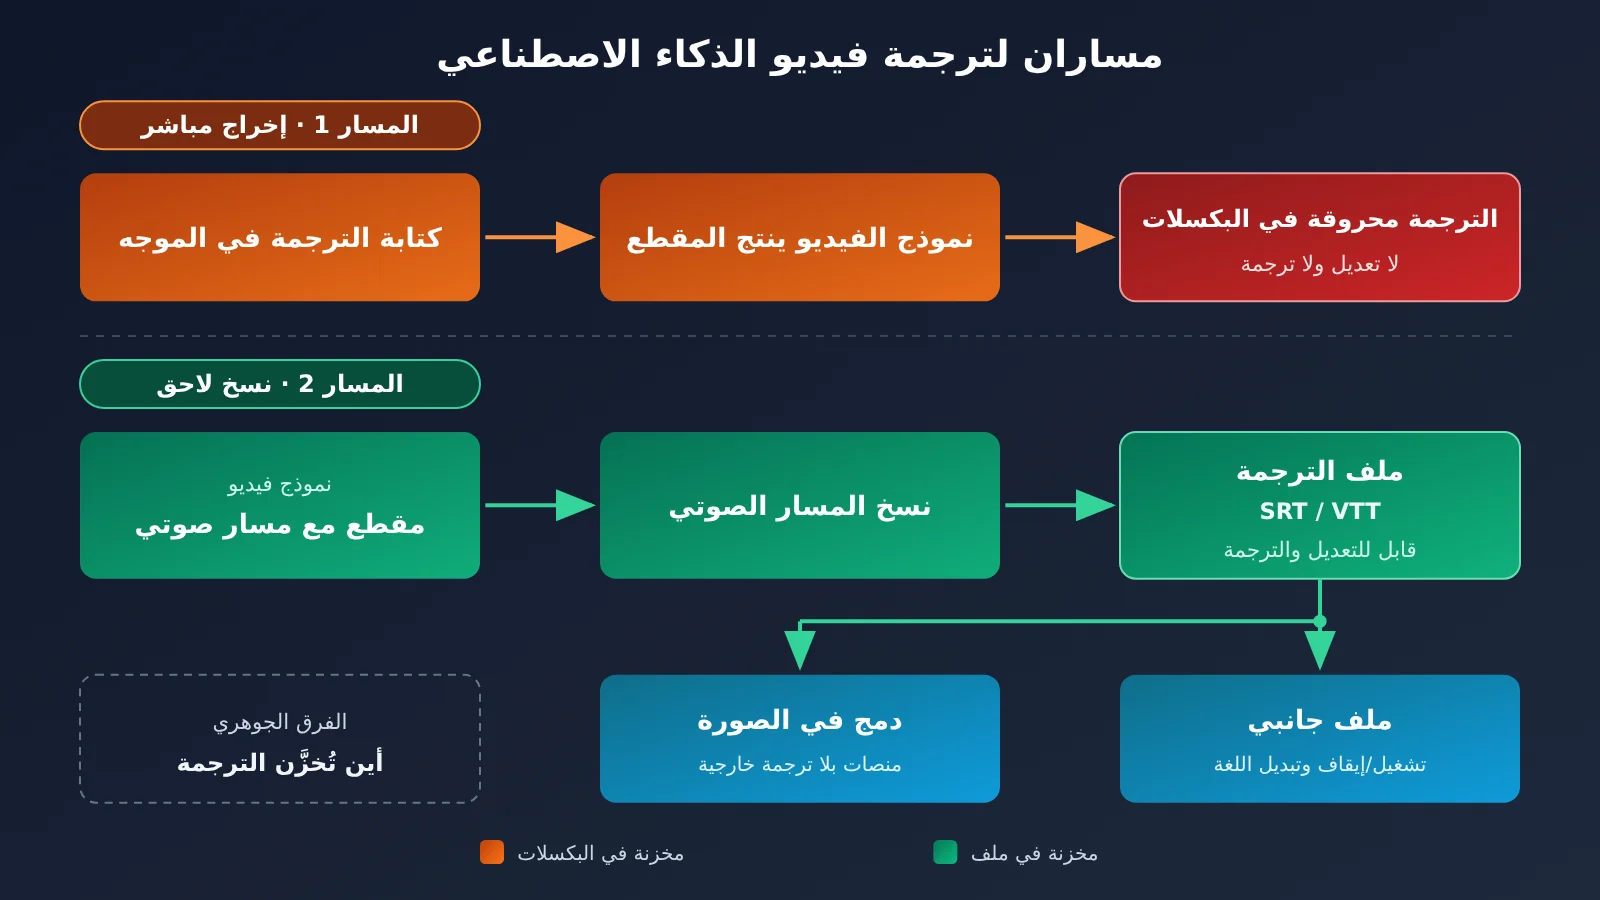
الطريقة الأولى: حرق الترجمة النصية في الفيديو عبر موجه Seedance
Seedance هو النموذج الوحيد في السلسلة المتاحة حاليًا الذي يذكر دليل الموجهات الرسمي فيه أمرين معًا: أنه “يستطيع إنشاء ترجمة نصية”، وأنه “قد يُخرج ترجمات عشوائية”. يوضح قسم توليد النصوص في الدليل أن النموذج يدعم توليد النصوص الشائعة، ويمكنك تحديد لونها وأسلوبها وطريقة ظهورها وتوقيت ظهورها ومكانها. وتشمل حالات الاستخدام الشعارات الإعلانية والترجمات النصية وفقاعات الحوار. وتجدر الإشارة إلى أن عنوان الدليل هو سلسلة 2.0، ولا يوجد تصريح مستقل بأن قدرة الترجمة النصية في 2.5 تختلف عن 2.0، ولذلك لا يصح اعتبار حرق الترجمة ميزة خاصة بـ 2.5 وحده.
يلخص الجدول التالي الصياغات المتعلقة بالترجمة النصية في دليل الموجهات الرسمي، ويمكنك الاعتماد عليها مباشرة في كتابة موجهاتك:
| الغرض | الصياغة في دليل الموجهات الرسمي | ملاحظات |
|---|---|---|
| تحديد محتوى الترجمة | «تظهر ترجمة نصية في أسفل الإطار، ومحتواها هو «……»، ويجب أن تتزامن الترجمة تمامًا مع إيقاع الصوت.» | يُفضَّل أن يتكون محتوى الترجمة من أحرف شائعة |
| إظهار الترجمة حسب الحوار | «تظهر الترجمة في أسفل الإطار وفق الحوار» «تظهر في أسفل الإطار ترجمة الحوار المقابل» | يبقى الناتج نصًا مرسومًا بالبكسل، ولا يوجد ملف خط زمني |
| عدم إظهار ترجمة | «ابقَ بلا ترجمة» «تجنب توليد أي نص أو ترجمة» | يوضح الدليل الرسمي أنه لا يمكن حاليًا ضمان تجنبها بنسبة 100% |
| أسلوب النص | يمكن تحديد اللون والأسلوب وطريقة الظهور والتوقيت والمكان | تجنب الأحرف النادرة والرموز الخاصة |
ميزة هذه الطريقة أنها لا تحتاج إلى أي خطوة إضافية: يخرج المقطع وفيه الترجمة، وهي مناسبة للمقاطع الرأسية القصيرة على منصات الفيديو القصير. أما عيبها فواضح أيضًا: إذا كان في الترجمة خطأ فلا حل إلا إعادة التوليد، وتدفع تكلفة المقطع في كل محاولة إلى أن تحصل على نتيجة مرضية. وإذا أردت نسخة بلغة أخرى فعليك التوليد من الصفر.
وهناك عدة مزالق على مستوى الاستدعاء. عند إنشاء الرمز في لوحة تحكم APIYI على apiyi.com، اختر المجموعة SeeDance2 (المعامل 0.18x)، ويجب أن يكون نمط الفوترة “الاستهلاك أولًا” أو “الدفع حسب الاستهلاك”. ونقطة النهاية هي /seedance/api/v3/...، لا تستخدم /v1/videos. فالصفحة المخصصة توضح أن نقطة النهاية العامة تمرر الدقة بشكل خاطئ بينما تُحتسب الفاتورة على الناتج الفعلي. وإضافة إلى ذلك، القيمة الافتراضية لـ generate_audio هي true، ولإخراج مقطع صامت يجب تمرير false صراحةً.
الطريق الثاني: تفريغ المسار الصوتي للمقطع النهائي لتوليد ترجمات الفيديو بالذكاء الاصطناعي
توزيع المهام في أسلوب المعالجة اللاحقة واضح: نموذج الفيديو يكتفي بإنتاج مقطع نهائي يتضمن مسارًا صوتيًا، وتُترك الترجمة لخدمة تفريغ مستقلة أو لبرنامج المونتاج. ينتج التفريغ ملف ترجمة بمحور زمني، ولهذا الملف استخدامان. الأول دمج الترجمة في الصورة نفسها (burn-in) للمنصات التي لا تدعم الترجمات الخارجية. والثاني توزيعه كملف جانبي (sidecar) مع الفيديو، فيستطيع المشاهد تشغيل الترجمة أو إيقافها، أو التبديل بين اللغات من المشغّل.
عند اختيار خدمة التفريغ انتبه إلى وضعها الحالي. يوصي دليل تحويل الكلام إلى نص من OpenAI حاليًا باستخدام gpt-transcribe لتفريغ الملفات، وواجهته POST /v1/audio/transcriptions، وهي تعيد النص واللغة التي تعرّفت عليها، بحد أقصى 25 ميغابايت للملف الواحد. أما أمثلة الطوابع الزمنية على مستوى الكلمة أو الجملة فما زالت تشير إلى المعامل timestamp_granularities الخاص بـ whisper-1، وهذا المعامل يدعم whisper-1 فقط. وقد وُسمت النماذج whisper-1 وgpt-4o-transcribe وgpt-4o-mini-transcribe وغيرها بأنها مهجورة، وموعد إيقافها هو 2027-02-26.
وهناك نقطة أخرى: في الجدول الإجمالي لنماذج APIYI بتاريخ 2026-11-10 الساعة 15:40 لا يوجد whisper-1 ولا gpt-transcribe. فخطوة المعالجة اللاحقة هذه ليست ضمن قائمة نماذج الفيديو في هذا المقال، وتحتاج إلى خدمة تفريغ مستقلة أو إلى التعرف على الكلام المدمج في برنامج المونتاج. ويمكن أيضًا ترك مزامنة المحور الزمني لبرنامج المونتاج، بحيث تقتصر مهمة التفريغ على التعرف الدقيق على النص.
نظرة على قدرات الترجمة النصية في نماذج توليد الفيديو بالذكاء الاصطناعي المتاحة
يلخّص الجدول التالي كيف تتناول الصفحة المخصصة لكل نموذج فيديو موضوعَي الصوت والترجمة النصية. أما عمود معاملات الترجمة فنتيجته من بحث نصي شامل في جميع الصفحات المخصصة بتاريخ 2026-11-11، وكانت كلمات البحث: “الترجمة النصية” (字幕)، وSRT، وحرق الترجمة في الفيديو، ومسار الترجمة.
| السلسلة | معرّف النموذج | ما يتعلق بالصوت (كما ورد في الصفحة المخصصة) | معاملات الترجمة النصية | نقاط الاستدعاء |
|---|---|---|---|---|
| Seedance | doubao-seedance-2-5-260628، doubao-seedance-2-0-260128، doubao-seedance-2-0-fast-260128، doubao-seedance-2-0-mini-260615 |
الخيار generate_audio مفعّل افتراضيًا |
لا يوجد ملف ترجمة؛ يمكن حرق الترجمة في الفيديو عبر الموجّه وفق دليل Volcano | مجموعة SeeDance2، والمسار /seedance/api/v3/... |
| Wan3.0 | wan3.0-video، wan3.0-video-prime |
الخيار audio قيمته الافتراضية true، والمخرجات تتضمن مسارًا صوتيًا |
لا يوجد | الإرسال إلى /wan/api/v1/services/aigc/video-generation/video-synthesis مع الترويسة X-DashScope-Async: enable |
| Wan2.7 | wan2.7-t2v، wan2.7-i2v، wan2.7-r2v، wan2.7-videoedit |
النموذج wan2.7-i2v وحده يدعم driving_audio لمزامنة حركة الشفاه |
لا يوجد | دقة 720P / 1080P فقط، والمدة من 2 إلى 15 ثانية |
| HappyHorse 1.1 | happyhorse-1.1-t2v، happyhorse-1.1-i2v، happyhorse-1.1-r2v، happyhorse-1.0-video-edit |
تحويل الصورة إلى فيديو لا يدعم driving_audio، ولا تذكر الصفحة المخصصة حوارًا افتراضيًا |
لا يوجد | المدة من 2 إلى 15 ثانية، ولمزامنة حركة الشفاه يجب استخدام Wan2.7 بدلًا منه |
| MiniMax H3 | MiniMax-H3 |
يأتي بمسار صوتي ستيريو مدمج لا يمكن إيقافه | لا يوجد | دقة 768P فقط، والمسار /hailuo/v2/video_generation |
| Oxygen | oxygen-1.0 |
الفيديو الناتج يتضمن مسارًا صوتيًا | لا يوجد | متوافق مع OpenAI Videos، عبر POST /v1/videos |
| Grok Imagine | grok-imagine-video، grok-imagine-video-1.5، grok-imagine-video-1.5-lite |
يأتي بمسار صوتي افتراضيًا، وإيقاف الصوت لا يخفّض السعر | لا يوجد | يتطلب تفعيل مجموعة GrokOfficial |
الخلاصة التي يوضحها هذا الجدول: باستثناء Seedance، لا تتضمن الصفحات المخصصة للنماذج الأخرى أي محتوى متعلق بالترجمة النصية، لذلك لا يصح افتراض أنها “تستطيع أيضًا إنتاج ترجمة نصية عبر الموجّه”. يمكنك استدعاء جميع النماذج أعلاه بحساب واحد على APIYI (apiyi.com)، أما الإصدارات المتاحة والمجموعات المدعومة فالمرجع فيها قائمة النماذج على المنصة.
هناك بضع تفاصيل تستحق أن نتوقف عندها. المعامل driving_audio في Wan2.7 يجعل حركة الشفاه تتبع الصوت، فهو من قدرات مزامنة الشفاه ولا علاقة له بالترجمات النصية. وتوصية الصفحة المخصصة نفسها واضحة: استخدم 2.7 عندما تحتاج إلى مزامنة الشفاه بالاعتماد على الصوت، واستخدم Wan3.0 عندما تريد مسارًا صوتيًا افتراضيًا ومدة أطول وسعرًا أقل. أما MiniMax H3 على APIYI فهو نموذج مفتوح الأوزان يُنشر ذاتيًا، وليس إعادة توجيه لواجهة API الأصلية من الجهة المطوِّرة. مساره الصوتي لا يمكن إيقافه، وتمرير generate_audio=false يعيد خطأ 400 مع الحقل unsupported field generate_audio، كما يُرفض طلب دقة 2K بالطريقة نفسها.
حالة نماذج Grok Imagine الثلاثة خاصة بعض الشيء: الصفحة المخصصة تعرض أسعارها، لكن الجدول الكامل للنماذج بتاريخ 2026-11-10 الساعة 15:40 لا يتضمن هذه الأسطر الثلاثة. هذا لا يعني أنها غير متاحة، لكن عليك قبل الاستدعاء أن تتأكد من لوحة التحكم أن مجموعة GrokOfficial مفعّلة.
ترجمات الفيديو المولَّد بالذكاء الاصطناعي وتكلفة الإنتاج: ماذا توفّر عند تغيير النموذج؟
بما أن الترجمات النصية لا تتغير بتغيير نموذج الفيديو، فإن الذي يمكن توفيره عند الانتقال إلى نموذج آخر هو رسوم إنتاج المقطع فقط. فيما يلي مقارنة بالأسعار المعلنة في التوثيق لمقطع واحد مدته 5 ثوانٍ. ويجب التنبيه أولًا إلى أن الدقة تختلف من صف إلى آخر، لذا يصلح هذا الجدول لمقارنة التكلفة فقط، ولا يصلح مقارنةً لجودة الصورة كأنها المقطع نفسه.
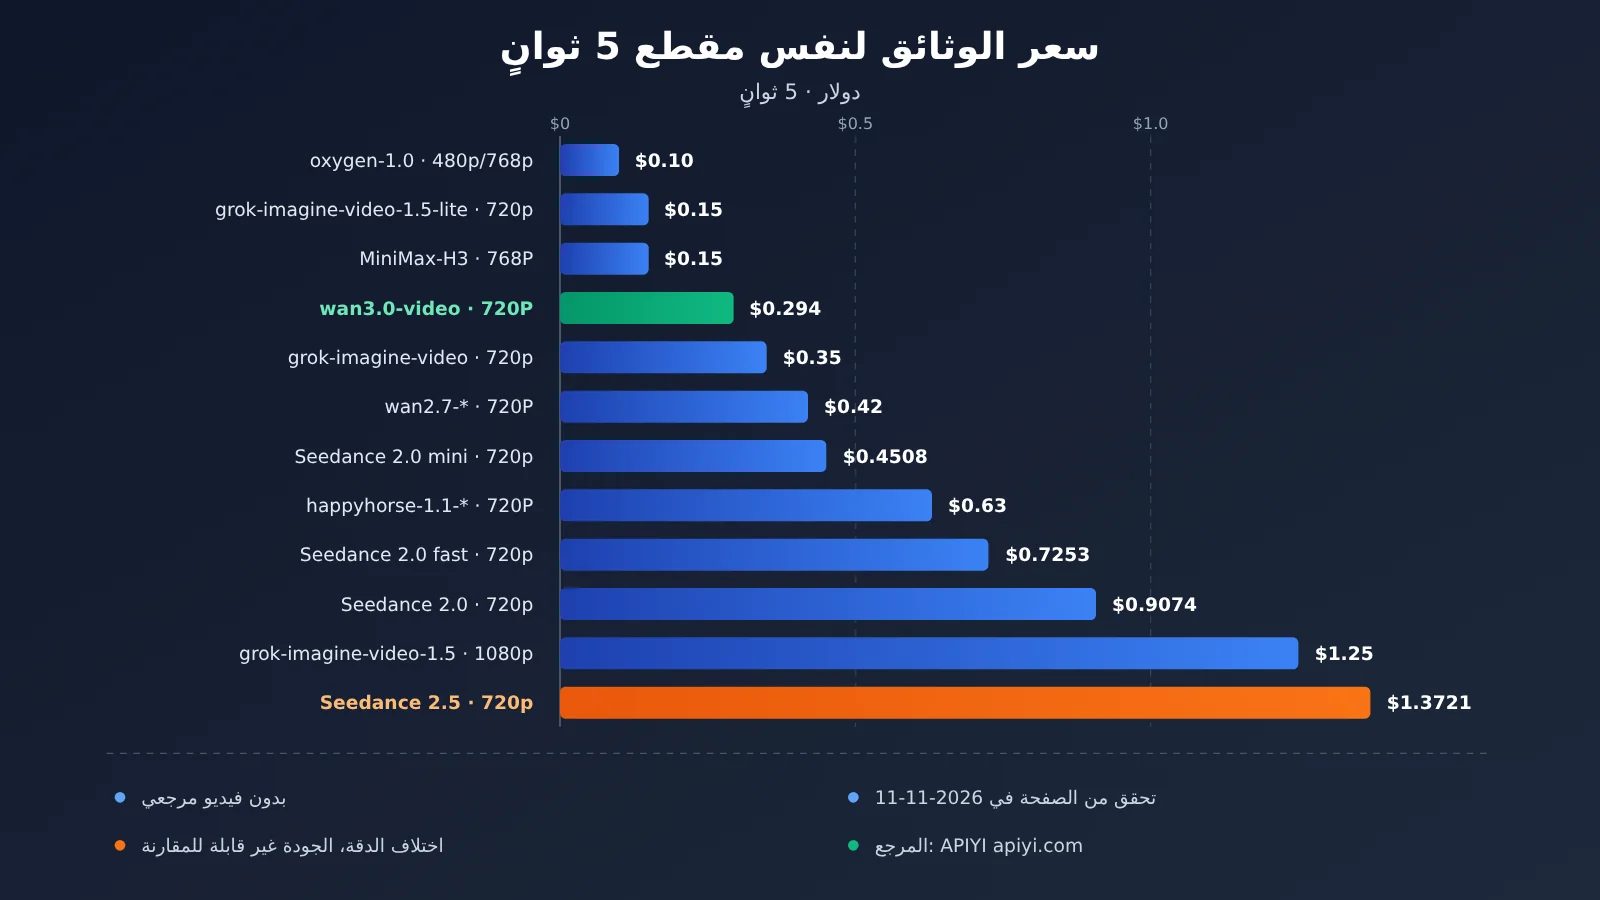
| معرّف النموذج | الدقة | المدة | فيديو مرجعي | السعر في الوثائق | مصدر السعر | تاريخ البيانات |
|---|---|---|---|---|---|---|
oxygen-1.0 |
480p أو 768p (السعر نفسه) | 5 ثوانٍ | غير مشمول | $0.10 | سعر الثانية في الصفحة المخصصة × 5 | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
grok-imagine-video-1.5-lite |
480p / 720p | 5 ثوانٍ | غير مشمول (الصورة المُدخلة غير محتسبة) | $0.10 / $0.15 | سعر الثانية في الصفحة المخصصة × 5 | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
wan3.0-video |
480P / 720P / 1080P | 5 ثوانٍ | غير مشمول | $0.147 / $0.294 / $0.588 | إجمالي سعر 5 ثوانٍ في الصفحة المخصصة | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
MiniMax-H3 |
768P | 5 ثوانٍ | غير مشمول | $0.15 | الصفحة المخصصة | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
grok-imagine-video |
480p / 720p | 5 ثوانٍ | غير مشمول (الصورة المُدخلة غير محتسبة) | $0.25 / $0.35 | سعر الثانية في الصفحة المخصصة × 5 | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
wan2.7-* |
720P / 1080P | 5 ثوانٍ | غير مشمول | $0.42 / $0.70 | إجمالي سعر 5 ثوانٍ في الصفحة المخصصة | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
doubao-seedance-2-0-mini-260615 |
720p | 5 ثوانٍ | غير مشمول | $0.4508 | جدول الأسعار في الصفحة المخصصة | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
happyhorse-1.1-* |
720P / 1080P | 5 ثوانٍ | غير مشمول | $0.63 / $1.12 | إجمالي سعر 5 ثوانٍ في الصفحة المخصصة | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
doubao-seedance-2-0-fast-260128 |
720p | 5 ثوانٍ | غير مشمول | $0.7253 | جدول الأسعار في الصفحة المخصصة | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
doubao-seedance-2-0-260128 |
720p | 5 ثوانٍ | غير مشمول | $0.9074 | جدول الأسعار في الصفحة المخصصة | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
grok-imagine-video-1.5 |
1080p | 5 ثوانٍ | غير مشمول (الصورة المُدخلة غير محتسبة) | $1.25 | سعر الثانية في الصفحة المخصصة × 5 | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
doubao-seedance-2-5-260628 |
720p | 5 ثوانٍ | غير مشمول | $1.3721 | جدول الأسعار في الصفحة المخصصة (يُحتسب بالمساحة × المدة، وانحراف ±5% أمر طبيعي) | تم التحقق من الصفحة المخصصة بتاريخ 2026-11-11 |
عند تثبيت الدقة على 720p والمدة على 5 ثوانٍ مع استبعاد الفيديو المرجعي (بحسب التحقق من الصفحة المخصصة بتاريخ 2026-11-11)، يبلغ سعر Seedance 2.5 نحو $1.3721، أي ما يقارب 4.7 أضعاف سعر wan3.0-video البالغ $0.294، وحوالي 3.0 أضعاف سعر نسخة mini البالغ $0.4508. هذه النسبة تعبّر عن تكلفة إنتاج المقطع فقط، ولا تعني أن جودة الترجمات النصية أفضل. كما أن الصفحة المخصصة تتضمن في قسم الأسئلة الشائعة سعرًا لنسخة 2.5 يختلف قليلًا عمّا ورد في جدول الأسعار، وقد اعتمدنا في هذا المقال سعر الجدول.
عند قراءة الجدول الإجمالي هناك أيضًا بعض الخانات التي يسهل فهمها خطأً. خانات Seedance هي السعر الأساسي لكل مليون توكن قبل ضربه في مضاعف المجموعة 0.18، وليست تكلفة الفيديو الواحد بالدولار. أما wan3.0-video فله في الجدول الإجمالي خانة واحدة فقط بسعر الثانية، وهذه الخانة تخص دقة 480P، وليست سعرًا موحدًا لكل الدقات. وفي الجدول نفسه يظهر HappyHorse بسعر أساسي حسب الاستهلاك، وليس بسعر الثانية، فإذا أردت الحساب بالثانية فارجع إلى صفحته المخصصة. عند مطابقة الأسعار، يُستحسن الاعتماد على قائمة النماذج في APIYI (apiyi.com) مع أسعار الفئات الموجودة في الصفحة المخصصة لكل نموذج.
التوصيات لإضافة الترجمات إلى الفيديو المولَّد بالذكاء الاصطناعي
السيناريو الأول: فيديو مولَّد تحتاج ترجماته إلى التعديل والترجمة
يشمل ذلك الفيديوهات التعليمية، وعروض المنتجات، وأي محتوى يلزم إصداره بعدة لغات. ترجمات هذا النوع من الفيديوهات ستحتاج إلى التعديل عاجلًا أو آجلًا: عميل يلاحظ خطأً إملائيًا، أو مصطلحات تحتاج إلى توحيد، أو سوق يطلب نسخة إنجليزية. الحل المضمون الوحيد هو النسخ النصي في مرحلة ما بعد الإنتاج، ويقتصر دور نموذج الفيديو على إخراج المقطع النهائي مع المسار الصوتي.
في هذا السيناريو يمكنك اختيار نموذج الفيديو حسب احتياجات الصورة والميزانية، فالترجمات ليست عاملًا في الاختيار. لكن انتبه إلى أن المقطع النهائي يجب ألا يحمل ترجمات عشوائية محروقة في الصورة، وإلا تداخلت ترجمات ما بعد الإنتاج مع النصوص الظاهرة في الصورة. إذا كنت تستخدم Seedance فأضف إلى الموجه قيدًا يمنع الترجمات. وإذا كنت تستخدم سلسلة أخرى، فحتى لو لم تذكر صفحتها المخصصة قدرة على الترجمات، فافحص الصورة بعد التوليد.
السيناريو الثاني: فيديو قصير يحتاج فقط إلى سطر الحوار في أسفل الشاشة ويقبل إعادة التوليد
إذا كان المقطع فيديو عموديًا قصيرًا للنشر على المنصات، ويكفيه سطر حوار في أسفل الشاشة، ولا مانع لديك من خطأ عرضي تعالجه بإعادة التوليد، فيمكنك الاكتفاء بـ Seedance وكتابة الترجمات المحروقة وفق قالب Volcano Engine. اكتب في الموجه محتوى الترجمة بوضوح، واطلب مزامنتها مع إيقاع الصوت، والتزم بالحروف الشائعة وتجنب الحروف النادرة والرموز الخاصة.
ولا تنسَ أن هذا ليس أسلوب تسليم مستقرًا. فعندما يظهر خطأ في أحد الحروف، تكون تكلفة إعادة التوليد هي رسوم مقطع جديد. لذلك اضبط الموجه أولًا باستخدام mini أو fast، وبعد التأكد من ثبات صيغة كتابة الترجمة فكّر في الفئات الأعلى. ولا تقفز مباشرة إلى 2.5 لمجرد تحسين الترجمات.
السيناريو الثالث: مقطع نهائي لا يجوز أن يظهر فيه أي ترجمة
تحتاج الأفلام الدعائية للعلامات التجارية، والمواد التي ستخضع لمونتاج ثانٍ، واللقطات الأساسية التي ستُضاف إليها ترجمات بعدة لغات لاحقًا، إلى صورة نظيفة. إذا كنت تستخدم Seedance فيجب أن تكتب في الموجه عبارات مثل «ابقَ بلا ترجمات» و«تجنب توليد أي نص أو ترجمات». وأزل أيضًا أي نص من الصور المرجعية أو الفيديوهات المرجعية، وحاول إخراج الفيديو بالعرض الأفقي. يوضح الدليل الرسمي أن احتمال ظهور ترجمات عشوائية في الفيديو الأفقي أقل بوضوح منه في العمودي، وفي العمودي يمكن تدارك الأمر بالقص أثناء المونتاج.
وحتى لو نفّذت النقاط الثلاث جميعها، فإن الموقف الرسمي أنه لا يمكن تجنب ذلك بنسبة 100%. لذلك يجب فحص المقطع يدويًا بعد التوليد. وفي المشاريع التي تشترط نظافة عالية جدًا، يمكنك ترك مساحة للقص ضمن تكوين الكادر.
توصيات اختيار طريقة إضافة الترجمة النصية إلى الفيديو المُولَّد بالذكاء الاصطناعي
لخّصتُ كل ما سبق في جدول قرار واحد، ترجع إليه عند التعامل مع أي فيديو بعينه:
| احتياجك | المسار | اتجاه نموذج الفيديو | ما لا تفعله |
|---|---|---|---|
| ترجمة نصية قابلة للتعديل والترجمة ومتزامنة زمنيًا | المسار الثاني: التفريغ النصي في مرحلة ما بعد الإنتاج | اختر حسب الصورة والميزانية، المهم أن يحتوي على مسار صوتي | انتظار أن ينتج أي نموذج فيديو ملف ترجمة نصية |
| نص الحوار في أسفل الفيديو القصير، مع قبول إعادة التوليد | المسار الأول: الحرق عبر Seedance | جرّب الموجه أولًا مع mini / fast | الترقية إلى 2.5 من أجل تأثير الترجمة النصية |
| الفيديو النهائي يجب ألا يحتوي على ترجمة نصية | المسار الثاني، أو Seedance مع قيد منع الترجمة النصية | الأفضلية للعرض الأفقي، وأزل النصوص من المواد المرجعية أولًا | تصديق أن كلمات القيد ستزيلها بنسبة 100% |
| مزامنة الشفاه | المسار الثاني مع الترجمة النصية | driving_audio في wan2.7-i2v |
استخدام تحويل الصورة إلى فيديو في HappyHorse لمزامنة الشفاه |
| مسار صوتي افتراضي وسعر منخفض | المسار الثاني مع الترجمة النصية | Oxygen وWan3.0 480P وGrok 1.5-lite وMiniMax H3 | الظن أن الفئات الرخيصة تفتقر إلى قدرات الترجمة النصية |
يمكن تلخيص الفرق بين المسارين في جملة واحدة. الحرق عبر الموجه يتفوق في أن الفيديو يخرج وعليه النص جاهزًا دون أي خطوة إضافية، لكن النص يصبح جزءًا من البكسلات، فلا يمكن تعديله ولا ترجمته، وإذا أردت إزالته فلن تنجح في تنظيفه تمامًا. أما التفريغ النصي في مرحلة ما بعد الإنتاج فيضيف خطوة، لكنه يتفوق في دقة الترجمة النصية وتزامنها الزمني وإمكانية إعادة استخدامها بعدة لغات، لذلك يناسب كل فيديو مخصص للتسليم.
وبهذا تتضح أيضًا طريقة توفير تكاليف الاختبار. إذا كانت المدة 15 ثانية أو أقل وكانت دقة 720p كافية، فابدأ بـ Seedance mini أو النسخة القياسية من Wan3.0. وإن أردت مسارًا صوتيًا افتراضيًا بسعر منخفض، فانظر في Oxygen وWan3.0 480P وGrok 1.5-lite وMiniMax H3. أما الفروق بين Grok وHailuo وSeedance، فلا توجد في الصفحة المخصصة مقارنة بالموضوع نفسه من حيث الترجمة النصية، فلا تجعل «أي منها أفضل في الترجمة النصية» سببًا لتبديل النموذج.
💡 نصيحة الاختيار: حدّد طريقة الترجمة النصية أولًا ثم اختر نموذج الفيديو. يمكنك على منصة APIYI (apiyi.com) استخدام مفتاح API نفسه لتشغيل عينات للموضوع نفسه على فئتين أو ثلاث من النماذج، وقارن الصورة والمسار الصوتي فقط. اترك الترجمة النصية كلها لمرحلة ما بعد الإنتاج، فتكون المقارنة على الجزء الذي تدفع مقابله فعلًا.
وهناك قناتان خارج نطاق التوصية. وفق إعلان APIYI بتاريخ 2026-11-09، أوقفت Google في 2026-10-22 كلًا من veo-3.1-generate-preview وveo-3.1-fast-generate-preview، وتوقفت قناة VEO 3.1 الرسمية في APIYI، فلا تتوفر حاليًا أي قناة فيديو من منظومة Google. وبحسب الإعلان نفسه، أُوقفت أيضًا القنوات المتعلقة بـ Sora 2.
الأسئلة الشائعة (FAQ) حول إضافة الترجمات النصية إلى الفيديو المولَّد بالذكاء الاصطناعي
Q1: ما المقصود بـ«الترجمات القابلة للاستخدام» في الفيديو المولَّد بالذكاء الاصطناعي؟
تكون الترجمات قابلة للاستخدام حين تتحقق ثلاثة شروط معًا: أن يكون النص صحيحًا، وأن يتطابق توقيته مع الحوار، وأن يمكن تعديل النص أو ترجمته لاحقًا. نماذج الفيديو تولّد مسارًا صوتيًا، أما النص المحروق في البكسلات فلا يمكن تعديله بمعزل عن الصورة، ولذلك لا يُعدّ ترجمات قابلة للاستخدام.
Q2: إذا انتقلت إلى Grok أو Hailuo (海螺) أو Wan (万相)، فأيّها ينجز الترجمات مباشرة؟
لا أحد منها. صفحات Wan3.0 وWan2.7 وHappyHorse وMiniMax H3 وOxygen وGrok Imagine لا تذكر سوى المسار الصوتي أو التوليد المدفوع بالصوت، وليس فيها معاملات للترجمات، ولم تُجرَ مقارنة بالموضوع نفسه للترجمات. ما توفره بتغيير النموذج هو تكلفة إنتاج المقطع فقط، أما الترجمات فما زالت تحتاج إلى نسخ صوتي لاحق.
Q3: هل حرق الترجمات في Seedance 2.5 أقوى منه في 2.0؟
لا يوجد ما يسمح بقول ذلك. عنوان دليل الموجهات من Volcano Engine (火山引擎) هو سلسلة 2.0، ولا يصرّح بأن قدرة الترجمات في 2.5 مختلفة. تكمن مزايا 2.5 في مدة تتراوح بين 4 و30 ثانية، وعدد أكبر من الصور المرجعية، وإخراج mov، وليست في الترجمات.
Q4: لم أجد Grok Imagine في جدول النماذج الكامل، فهل هو غير مُدرج؟
ليس كذلك. للنماذج الثلاثة من Grok Imagine أسعار في صفحاتها المخصصة، لكن جدول النماذج الكامل بتاريخ 2026-11-10 15:40 لا يعرض هذه الصفوف الثلاثة. قبل الاستدعاء تأكد من تفعيل مجموعة `GrokOfficial` في لوحة تحكم APIYI على apiyi.com. وتجدر الإشارة إلى أن إيقاف الصوت لا يخفّض السعر.
Q5: كيف أستدعي نماذج الفيديو هذه عبر API بسرعة؟
سجّل في APIYI واحصل على مفتاح API (للمستخدمين الجدد رصيد اختبار مجاني)، ثم استدعِ النماذج حسب نقطة النهاية المذكورة في صفحة كل نموذج:
– عنوان base_url المتوافق مع OpenAI هو `https://api.apiyi.com/v1`، ويستخدم Oxygen المسار `POST /v1/videos` تحته
– يعمل Seedance عبر `/seedance/api/v3/…`، واختر للرمز المميز مجموعة `SeeDance2`
– يُرسل Wan3.0 إلى `/wan/api/v1/services/aigc/video-generation/video-synthesis`، مع الترويسة `X-DashScope-Async: enable`
– يعمل MiniMax H3 عبر `/hailuo/v2/video_generation`
لا تستخدم المسار `/v1/videos` مع Seedance ولا مع Wan3.0.
Q6: ما الخدمة التي أستخدمها للنسخ الصوتي اللاحق؟
جدول النماذج الحالي في APIYI لا يتضمن `whisper-1` ولا `gpt-transcribe`، لذا يلزم استخدام خدمة مستقلة أو برنامج مونتاج للنسخ الصوتي. توصي OpenAI حاليًا باستخدام `gpt-transcribe` لإخراج النص. أما مثال الطوابع الزمنية على مستوى الكلمة في الوثائق فما زال يشير إلى `whisper-1`، وتاريخ إيقافه 2027-02-26. الحد الأقصى للملف الواحد 25 MB، ويُفضَّل في الفيديوهات الطويلة استخراج المسار الصوتي أولًا ثم نسخه.
Q7: ما القيود المعروفة لحرق الترجمات عبر الموجهات؟
– لا يمكن تعديل الترجمة المكتوبة (الترجمة النصية) أو ترجمتها إلى لغة أخرى لأنها محفورة داخل البكسلات، فأي تعديل يعني إعادة توليد الفيديو بالكامل
– قد تظهر ترجمات نصية في الفيديو حتى لو لم تطلبها، والجهة الرسمية تقرّ بأنه لا يمكن تجنّب ذلك بنسبة 100%
– احتمال ظهور ترجمات عشوائية في الفيديو العمودي أعلى منه في الأفقي، ووجود نصوص داخل المواد المرجعية يزيد هذا الخطر
– الحروف النادرة والرموز الخاصة معرّضة للأخطاء، لذا يُفضَّل استخدام الحروف الشائعة
أهم النقاط حول إضافة الترجمة النصية إلى الفيديو المولَّد بالذكاء الاصطناعي (Key Takeaways)
- المسار الصوتي ليس ترجمة نصية: نماذج الفيديو تنتج صوتًا مدمجًا في الفيديو النهائي، وليس ملف ترجمة
- Seedance وحده ذكر الحفر داخل الصورة: يدعم دليل Volcano حفر الترجمة في البكسلات، لكنه لا يوفّر ملف ترجمة
- إزالة الترجمة لا تنجح بنسبة 100%: تحتاج إلى كلمات تقييد في الموجّه مع إزالة النصوص من المواد المرجعية، مع تفضيل الفيديو الأفقي
- لا توجد معاملات للترجمة في بقية السلاسل: الصفحات المخصصة لـ Wan وHappyHorse وMiniMax H3 وOxygen وGrok تذكر المسار الصوتي فقط
- الترجمة القابلة للتعديل تأتي في مرحلة ما بعد الإنتاج: انسخ الصوت من الفيديو النهائي إلى نص، ثم احفره في الصورة أو احتفظ به كملف جانبي (sidecar)
- تغيير النموذج يوفّر تكلفة التوليد فقط: لا تترقَّ إلى 2.5 من أجل الترجمة وحدها، بل جرّب أولًا الفئات الأدنى مثل mini وWan3.0
- طريقة البدء: استخدم مفتاحًا واحدًا على APIYI لتشغيل عيّنات من فئات متعددة، والأسعار تخضع لقائمة النماذج على المنصة
الخلاصة
إضافة ترجمة إلى فيديو مولَّد بالذكاء الاصطناعي تقوم على ثلاث نقاط:
- لا تعتمد على النموذج لإخراج ترجمة قابلة للتعديل: لا يوجد نموذج فيديو واحد يُخرج ملف ترجمة نصية جاهزًا. إذا أردت ترجمة يمكن تعديلها وترجمتها، فاستخدم النسخ النصي في مرحلة ما بعد الإنتاج.
- حرق النص في الصورة مع Seedance حل مؤقت: يتيح دليل الموجهات من Volcano Engine كتابة النص داخل الصورة مباشرة، وهذا يناسب المقاطع القصيرة التي تتحمل إعادة التوليد. لكنه ليس حلًا مستقرًا للتسليم، ولا يمكن إزالة النص منه بالكامل لاحقًا.
- للتوفير، غيّر فئة الإخراج بدل مطاردة الترجمة: عند الدقة 720p ومدة 5 ثوانٍ ودون فيديو مرجعي (بحسب الصفحة المخصصة، وتم التحقق منها في 2026-11-11)، تكلّف النسخة 2.5 نحو 4.7 أضعاف النسخة القياسية من Wan3.0. هذا الفارق في السعر لن يشتري لك ترجمة أفضل.
الخطوة التالية المقترحة: حدّد أسلوب الترجمة أولًا، ثم اختر نموذج الفيديو. يمكنك استخدام رصيد الاختبار المجاني على APIYI عبر apiyi.com لتجربة مقاطع أولية بفئات منخفضة التكلفة مثل mini وWan3.0 وOxygen، والتأكد من الصورة والمسار الصوتي، ثم تترك الترجمة كلها لمرحلة ما بعد الإنتاج.
📚 المراجع
- دليل موجهات سلسلة Doubao Seedance 2.0 من Volcano Engine: شرح كتابة النصوص والترجمات المرافقة (الترجمات النصية)، والقيود الخاصة بمنع ظهور الترجمات، وطريقة التعامل مع الترجمات التي تظهر دون طلب
- الرابط:
docs.volcengine.com/docs/ark/seedance-2-0-prompt-guide -
ملاحظة: قالب الترجمات في المسار الأول من هذا المقال، وعبارة “لا يمكن تجنبها بنسبة 100%”، مأخوذان من هذا الدليل، وقد اطّلعنا عليه بتاريخ 2026-11-11
-
دليل OpenAI لتحويل الكلام إلى نص: شرح واجهة النسخ
gpt-transcribeومعاملات الطوابع الزمنية - الرابط:
platform.openai.com/docs/guides/speech-to-text -
ملاحظة: مصدر واجهة حل النسخ اللاحق، وحدود حجم الملفات، وتواريخ إيقاف الإصدارات المهجورة، وقد اطّلعنا عليه بتاريخ 2026-11-11
-
مركز وثائق APIYI · صفحة نماذج الفيديو: معاملات وأسعار الشرائح لنماذج Seedance وWan3.0 وWan2.7 وHappyHorse وMiniMax H3 وOxygen وGrok Imagine
- الرابط:
docs.apiyi.com/api-capabilities/ - ملاحظة: مصدر أسماء الإصدارات ونقاط الوصول (endpoints) والمجموعات وسعر الوثائق لمدة 5 ثوانٍ؛ أما إعلان إيقاف VEO 3.1 فيوجد في الموقع نفسه عبر
/live/2026-11/veo-3-1-official-offline
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من معاملات النماذج وتعليمات الاستدعاء يمكنكم زيارة مركز الوثائق docs.apiyi.com