ملخص: في استدعاءات Responses API متعددة الجولات مع GPT-6.2، قد يؤدي تعديل المدخلات المبكرة إلى تقليل إصابات التخزين المؤقت، وقد يجعل بعض عناصر الاستدلال تفقد أهلية إعادة الاستخدام. يمكن للمطورين التحوّل إلى بنية سياق تعتمد الإضافة فقط، ثم استخدام سجلات استخدام مقترنة لتحديد فروق التكلفة.
نبدأ بالخلاصة. عادةً لا يكون سبب ارتفاع الفاتورة واحدًا فقط، بل قد يأتي من موضعين في الوقت نفسه: أولًا، بعد تغيير بادئة المدخلات، تقل قراءات التخزين المؤقت، فتُحاسب المدخلات التي كانت تُحاسب بسعر التخزين المؤقت بسعر المدخلات العادي؛ ثانيًا، أزال GPT-6.2 عناصر استدلال مبكرة بسبب prefix_mismatch، ما يضطر النموذج إلى إعادة الاستدلال، وقد تظهر تكلفة استدلال إضافية. ويعتمد ظهور هذين البندين ونصيب كل منهما على إصدار النموذج وموضع التعديل وقيمة usage الفعلية. الأمثلة الحسابية أدناه تهدف فقط إلى توضيح طريقة تفصيل الفاتورة، ولا تمثل أي فاتورة حقيقية. وإذا كنت تستدعي النموذج عبر APIYI (apiyi.com)، يُنصح ببناء مجموعة ضابطة من سجل input الذي تديره بنفسك، ثم احتساب الفرق وفق سجلات الاستهلاك.
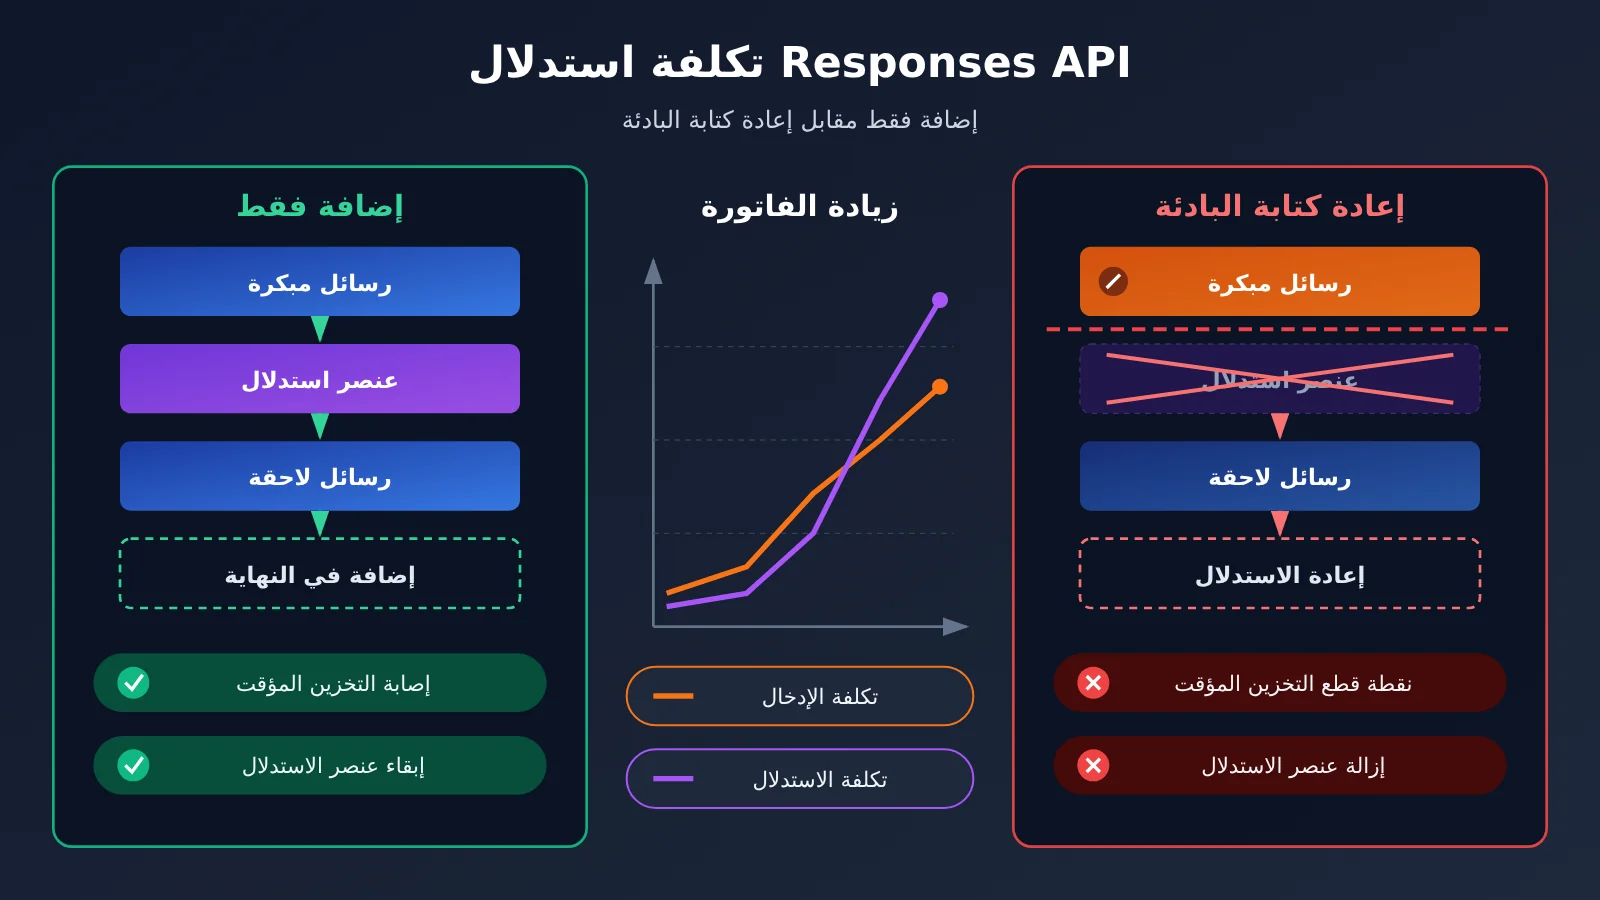
خريطة معرفية لتكلفة الاستدلال في OpenAI Responses API
يسرد الجدول أدناه محتوى الأقسام الأربعة والعلاقات بينها، ويوضح ترتيب القراءة. يشرح القسم 1 من أين تأتي التكلفة، ويوضح القسم 2 أي العمليات تؤدي إلى تفعيلها، ويقدّم القسم 3 طريقة القياس، أما القسم 4 فيحوّل الأرقام المقاسة إلى مبالغ مالية، ويقدّم خطة تحسين.
| الرقم | السؤال الذي يجيب عنه | ما يقدّمه للقسم التالي | ما يمكنك فعله بعد القراءة |
|---|---|---|---|
| 1 | أين ترتفع التكلفة | خطّان للمراقبة: قراءة ذاكرة التخزين المؤقت، والمخرجات الجديدة | فهم معنى الحقول ذات الصلة في usage |
| 2 | أي إجراءات تحرير تؤدي إلى التفعيل | قائمة بمواضع الشفرة التي يجب فحصها | تحديد ما إذا كانت طريقة صيانة السياق لديك محفوفة بالمخاطر |
| 3 | كيف نعزل التغيّر | مجموعة من البيانات المزدوجة القابلة للمقارنة | تأكيد وجود المشكلة عبر تجربة ضابطة |
| 4 | كم يبلغ فرق التكلفة، وكيف نصلحه | معادلة تفصيل الفاتورة وثلاثة تحسينات | تقدير الفرق، ومطابقة الخصم الفعلي باستخدام معرّف الطلب |
إذا تأكدت بالفعل من وجود إعادة كتابة للبادئة، فيمكنك البدء مباشرة من القسم 3. ويمكن استخدام القسمين 1 و2 كمرجع للمقارنة أثناء الفحص.
للإلمام: مصطلحات تكلفة الاستدلال في Responses API
| المصطلح | شرح موجز |
|---|---|
| Responses API | واجهة OpenAI الموحدة لمعالجة استجابات النموذج والاستدلال واستدعاء الأدوات |
| بادئة الإدخال | محتوى الإدخال المبكر وإعداداته التي تبقى بالترتيب نفسه في بداية الطلبات متعددة الجولات |
| إصابة الذاكرة المؤقتة | إعادة استخدام رموز إدخال سبق معالجتها في هذا الطلب، وتُحسب هذه الجزئية بسعر قراءة الذاكرة المؤقتة |
| عنصر الاستدلال | نوع من العناصر المهيكلة في استجابة نماذج الاستدلال، ويمكن إعادة استخدامه في طلبات لاحقة متوافقة |
prefix_mismatch |
قيمة سبب في تشخيصات الخاصة بـ GPT-6.2، تعني أن بادئة أقدم قد تغيّرت، ما أدى إلى إزالة عنصر الاستدلال |
| الإلحاق فقط | أسلوب صيانة للسجل يحافظ على المحتوى والترتيب الأصليين، ويضيف الأحداث اللاحقة في النهاية فقط |
reasoning_tokens |
بند فرعي للاستدلال داخل استخدام الإخراج، يُستخدم لمراقبة استهلاك الاستدلال |
x-request-id |
معرّف الطلب في ترويسة الاستجابة، يُستخدم لربط استجابة العميل بسجلات المزوّد |
1. لماذا ترتفع تكلفة الاستدلال في Responses API في موضعين
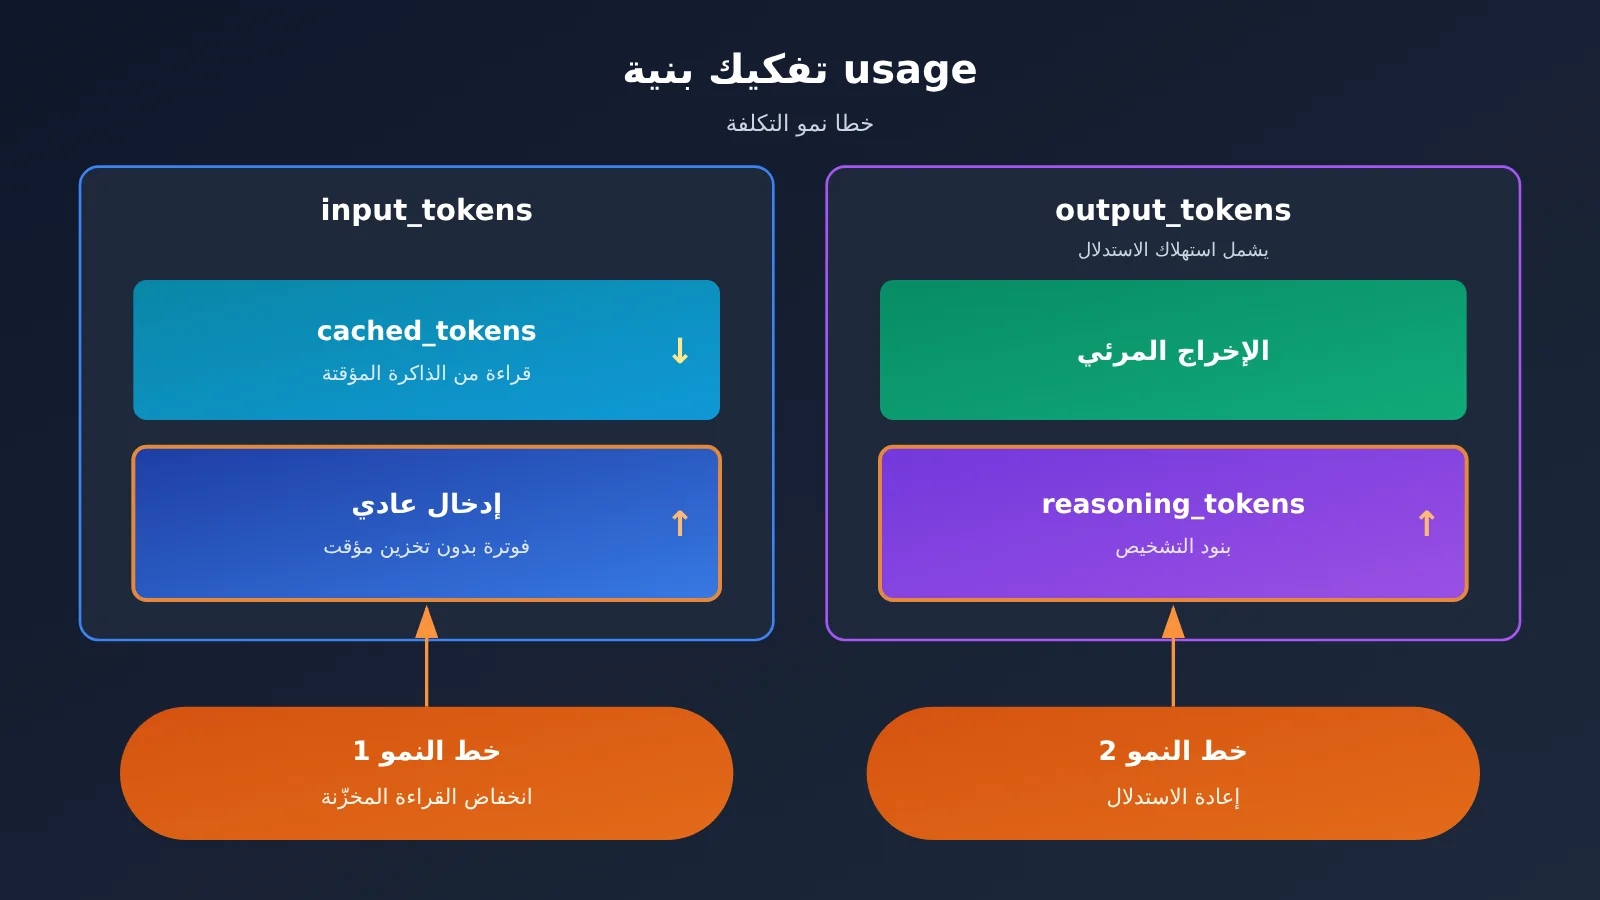
1.1 الخط الأول: انخفاض قراءة الذاكرة المؤقتة
وفقًا لشرح OpenAI في «Prompt caching»، تبدأ مطابقة ذاكرة التخزين المؤقت للموجه من بداية الطلب. وبمجرد إعادة كتابة أي مقطع مبكر، يصبح كل ما يأتي بعد نقطة التعديل غير قابل للحساب بسعر قراءة الذاكرة المؤقتة، ويُحسب بسعر الإدخال العادي. ولنأخذ سعر gpt-6.2-sol للسياق القصير في جدول أسعار APIYI كمثال: الإدخال العادي 2 دولار لكل مليون رمز، وقراءة الذاكرة المؤقتة 0.10 دولار، أي أن الفرق بينهما 20 ضعفًا.
هذا التغير في التكلفة له حقول مقابلة في usage: قد يبقى إجمالي input_tokens ثابتًا تقريبًا، لكن cached_tokens بداخله يقل. ولا يمكن اكتشاف هذه المشكلة بمجرد النظر إلى إجمالي كمية الإدخال، بل لا بد من تسجيل كمية قراءة الذاكرة المؤقتة بشكل منفصل.
1.2 الخط الثاني: إخراج جديد بعد فقدان عنصر الاستدلال أهلية إعادة الاستخدام
في سجل تغييرات API بتاريخ 2026-11-17، صنّفت OpenAI سلوك «تعديل التاريخ المبكر يؤدي إلى إزالة عنصر الاستدلال بسبب prefix_mismatch» على أنه سلوك يبدأ اعتبارًا من GPT-6.2. وبعد إزالة عنصر الاستدلال، لا يرى النموذج محتوى الاستدلال السابق في الجولات اللاحقة، وقد يحتاج إلى إعادة الاستدلال، ما قد يترتب عليه تكلفة استدلال إضافية.
ينعكس هذا الخط على جانب الإخراج، في صورة زيادة reasoning_tokens وإجمالي الإخراج. وقد يحدث هذا في الوقت نفسه مع انخفاض قراءة الذاكرة المؤقتة، لكنهما حقلان مستقلان في usage، ويجب مراقبتهما كلًا على حدة عند التشخيص.
1.3 علاقة الاحتواء بين output_tokens وreasoning_tokens
وفقًا لوثيقة OpenAI «Counting tokens»، فإن output_tokens تشمل بالفعل استهلاك الاستدلال، وأن output_tokens_details.reasoning_tokens ليست سوى بند تشخيصي فرعي ضمنها. وعند حساب التكلفة، يكفي ضرب output_tokens في سعر الإخراج. وإذا أضفت reasoning_tokens مرة أخرى بشكل منفصل، فستحسبها مرتين.
2. عمليات تحرير البادئة التي قد ترفع تكلفة الاستدلال
2.1 العمليات الشائعة التي تؤدي إلى prefix_mismatch
وفقًا لما ورد في وثيقتَي OpenAI «Keep the prefix unchanged» و«Reasoning models»، تُعد العمليات التالية بمثابة إعادة كتابة للبادئة، وقد يؤدي تنفيذها على GPT-6.2 إلى إزالة عناصر الاستدلال:
| العملية | سيناريو برمجي نموذجي | المخاطر |
|---|---|---|
| إعادة كتابة الرسائل القديمة | الرجوع لتعديل صياغة رسالة المستخدم في الجولة الثانية، أو إضافة طابع زمني إلى رسالة قديمة | إعادة كتابة البادئة |
| إعادة كتابة نتائج الأدوات القديمة | تقصير JSON الذي أرجعته أداة سابقة لتوفير الرموز (Token) | إعادة كتابة البادئة (التقصير يُعد إعادة كتابة أيضًا) |
| إدراج محتوى قبل عنصر استدلال ذي صلة | إقحام مواد مسترجعة حديثًا في منتصف السجل | إعادة كتابة البادئة |
| حذف عنصر كامل مع بقاء بقية المحتوى دون تغيير | حذف رسالة قديمة كاملة | لا يفعّل سبب الإزالة هذا، لكن حجم إصابة ذاكرة التخزين المؤقت قد يتغير |
| الإلحاق بعد عنصر استدلال | إضافة رسائل جديدة بالترتيب الزمني | لا يفعّل سبب الإزالة هذا |
قد يبدو «تقصير مخرجات الأدوات القديمة» وكأنه يوفّر الرموز (Token)، لكنه في الواقع إعادة كتابة. ولا يحدث prefix_mismatch إلا عند حذف عنصر كامل مع بقاء بقية العناصر دون تغيير. ومع ذلك، فقد تتغير نقطة بداية المطابقة في ذاكرة التخزين المؤقت، وما زال حجم القراءة من ذاكرة التخزين المؤقت بحاجة إلى قياس فعلي.
2.2 الفروق بين الإصدارات ومستويات الاستدلال وتبديل عائلة النماذج
يجب الحكم على هذه الأنواع من التغييرات بشكل منفصل:
- فروق الإصدارات: توضح OpenAI صراحةً أن إزالة عناصر الاستدلال بسبب
prefix_mismatchسلوك يبدأ من GPT-6.2. يدعم GPT-6.1 Sol الخيارreasoning.context: all_turns، ويمكنه عرض الاستدلالات الأقدم عندما يتوفر سجل متوافق. عند الانتقال من 6.1 إلى 6.2، تحتاج طريقة الحفاظ على السياق الحالية إلى إعادة التحقق. - مستويات الاستدلال: توفّر كلتا نسختي Sol المستويات الخمسة
lowوmediumوhighوxhighوmax، بينما يرفض Sol 6.2 القيمةnone. النهج الذي وثّقه مقال طرف ثالث من OrcaRouter هو عدم تعديلreasoning.effortمباشرةً بين الطلبات، بل إضافة عنصرconfiguration_updateإلىinput. يشير المقال أيضًا إلى أن السجل الذي يحتوي على عناصر من هذا النوع سيُقطَع تلقائيًا، وسيرفضه/responses/compact. قبل اعتماد هذا النهج، راجع وثائق OpenAI الرسمية للتحقق. - تبديل عائلة النماذج والتخفيض إلى نموذج أقل قدرة: وفقًا لتوضيح OpenAI، قد يؤدي تبديل عائلة النماذج أو استخدام نموذج أقل قدرة أيضًا إلى إزالة عناصر الاستدلال الموجودة. وهذا سبب مختلف عن
prefix_mismatch، وينبغي تصنيفهما بشكل منفصل عند إعداد الإحصاءات.
2.3 موضع حقل instructions العلوي في GPT-6.2 وكيفية احتساب تكلفته
يوضح دليل OpenAI «Using GPT-6.2» أن حقل instructions العلوي في GPT-6.2 يُضاف بعد input، وتُحتسب تكلفته كمدخلات غير مخزّنة مؤقتًا. لذلك فهو مناسب لتوجيهات المطوّر المؤقتة في الدور الحالي، وغير مناسب لكتل إعدادات النظام الكبيرة الثابتة على المدى الطويل.
أما التعليمات التي ستُعيد استخدامها على المدى الطويل، فينبغي وضعها كأول رسالة developer داخل input حتى تُخزّن مؤقتًا. وإذا احتجت إلى تعديل التعليمات طويلة الأمد، فأضف رسالة developer جديدة في نهاية السجل، ولا تعُد لتعديل الرسالة الأولى.
3. عزل تغيّرات تكلفة الاستدلال في Responses API باستخدام طلبات ضابطة
3.1 تصميم المجموعة الضابطة
ثبّت النموذج ومستوى الاستدلال وتعريفات الأدوات وحجم المدخلات، وغيّر متغيرًا واحدًا فقط: طريقة صيانة السجل التاريخي. المجموعة A تكتفي بالإضافة فقط، أما المجموعة B فتعيد كتابة موضع واحد من المحتوى في مرحلة مبكرة. تشغّل كل مجموعة عدة جولات، وتستخدم المجموعتان مجموعة المهام نفسها.
يُسجّل كل طلب وفق الجدول أدناه بالشكل نفسه. أما جودة المهمة فتحتاج إلى تقييم بشري أو تقييم من سكربت قياس، لأن انخفاض التكلفة يجب ألا يكون على حساب تراجع النتائج.
| الحقل | المصدر | الغرض |
|---|---|---|
| المجموعة | مُعرَّف ذاتيًا | للتمييز بين مجموعة الإضافة فقط ومجموعة إعادة الكتابة |
cached_tokens |
usage.input_tokens_details |
لمراقبة المؤشر الأول |
reasoning_tokens |
usage.output_tokens_details |
لمراقبة المؤشر الثاني |
output_tokens |
usage |
لحساب تكلفة المخرجات |
| زمن الاستجابة | قياس من جهة العميل | زيادة الاستدلال عادةً ما تصاحبها مدة أطول |
| جودة المهمة | تقييم بشري أو تقييم آلي | لاستبعاد حالات مقايضة الجودة بالتكلفة |
x-request-id |
ترويسة الاستجابة | للمطابقة والتسوية |
3.2 مثال على الاستدعاء بأسلوب الإلحاق فقط
يحتفظ الكود التالي بنفسه بسجلّ input، ويضيف إلى نهايته فقط في كل جولة، مع كتابة الاستخدام ومعرّف الطلب في ملف السجل:
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # ثابت طوال الجلسة، ولا يُعدَّل بين الجولات

# بادئة ثابتة: تُوضع التعليمات القابلة لإعادة الاستخدام في أول عنصر من input، ثم لا تُعدَّل بعد ذلك
history = [{"role": "developer", "content": "你是代码审查助手,回答简洁。"}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # يجب التحقق أولاً مما إذا كانت المجموعة الهدف تُرجع هذا الحقل
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # إلحاق فقط: تُعاد مخرجات هذه الجولة (بما فيها عناصر الاستدلال) كما هي إلى نهاية السجل
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
مجموعة إعادة الكتابة تعيد استخدام الدالة نفسها: قبل الجولة رقم N عدّل محتوى history[1]، واضبط variant على "early_rewrite"، مع إبقاء بقية المعاملات كما هي دون تغيير.
🚀 بداية سريعة: عند بناء مجموعة المقارنة، يمكنك التبديل بين
gpt-6.1-solوgpt-6.2-solعبر APIYI على apiyi.com باستخدام مفتاح API نفسه. وبالاعتماد على البنية نفسها للسجلات، تستطيع مقارنة أثر اختلاف الإصدار على التخزين المؤقت واستخدام الاستدلال.
3.3 التشخيص المساعد عند الاتصال المباشر بالخدمة الرسمية
عند الاتصال المباشر بـ OpenAI، يمكنك ضبط prompt_cache_options.comparison_response_id على معرّف (ID) استجابة سابقة، ثم قراءة سبب التشخيص وعدد رموز الذاكرة المؤقتة العائدة في الاستجابة. يسرد الحقل input_transformations في الاستجابة عناصر الاستدلال التي أُزيلت وأسباب إزالتها، ويمكن مطابقة prefix_mismatch بالمعرّف مع عنصر الاستدلال المقابل في مخرجات الاستجابة القديمة.
# للاتصال المباشر بخدمة OpenAI الرسمية فقط
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
لهذا التشخيص قيدان: تشخيص الذاكرة المؤقتة يبلّغ عن أول اختلاف فقط وفق مبدأ أفضل جهد، كما أنه لا يستطيع تأكيد ما إذا كان النموذج قد أعاد استخدام الاستدلال المحتفظ به فعلاً. فهو يستطيع أن يقول لك «أُزيل عنصر الاستدلال»، لكنه لا يستطيع أن يقول لك «كم كلّفك ذلك إضافيًا»، إذ تبقى التكلفة بحاجة إلى الاستخدام المزدوج المذكور في القسم 3.1 للحكم عليها.
3.4 ملاحظات عند الاستدعاء عبر APIYI
يدعم الاتصال المباشر بـ OpenAI استئناف حالة الجلسة باستخدام previous_response_id. يذكر متن الدليل الأصلي لاستدعاء Responses API لدى APIYI (docs.apiyi.com) أن أسلوب التسلسل هذا لا يعمل، لكن قسم الأسئلة الشائعة في الصفحة نفسها يسجّل أنه يعمل فعليًا عند الاختبار في 2026-09-02. وبما أن القولين متعارضان، فإن الأساس الأسلم هو إدارة سجل input بنفسك، على النحو الوارد في القسم 3.2.
قد يختلف السلوك الفعلي لاستئناف الحالة، ولإعادة إرسال عناصر الاستدلال المشفّرة، ولحقول التشخيص المذكورة أعلاه، باختلاف مجموعة الرموز، لذا يلزم التحقق منها بشكل منفصل على المجموعة المستهدفة. وإذا لم تكن حقول التشخيص متاحة، فلا تزال سجلات الاستخدام المزدوجة صالحة كأساس للحكم.
4. تحليل تكلفة الاستدلال في Responses API بالأرقام وتنفيذ التعديلات
4.1 الأسعار القياسية المستخدمة في التقدير
فيما يلي الأسعار القياسية الافتراضية للسياق القصير من جدول الأسعار العام لدى APIYI على apiyi.com (محدثة في 2026-11-20 15:17 بتوقيت بكين، والوحدة دولار لكل مليون Token). يعتمد الخصم الفعلي أيضًا على مجموعة الرموز التي ينتمي إليها النموذج وعلى تكلفة إعادة شحن الرصيد، ويلزم التحقق من كل منهما على حدة.
| معرّف نموذج APIYI | إدخال عادي | قراءة من الذاكرة المؤقتة | إخراج |
|---|---|---|---|
gpt-6.2-sol، gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
يتطلب السياق الطويل حسابًا منفصلًا. عندما يتجاوز إدخال gpt-6.2-sol 272,000 Token، يكون سعر الإدخال المدرج في الجدول العام الحالي لدى APIYI هو $3، بينما تدرج صفحة طرازات Standard الرسمية من OpenAI السعر $4. أما gpt-6.1-sol، فسعر إدخال السياق الطويل لديه هو $4 في الجانبين. بالنسبة إلى سعر الذاكرة المؤقتة وسعر الإخراج لفئة السياق الطويل، يُرجى التحقق منهما وفق قواعد الفوترة الفورية الخاصة بكل قناة.
4.2 مثال على تفصيل تكلفة طلبين
الافتراضات: سياق قصير، وتسعير APIYI Sol الافتراضي، ويحتوي كل من الطلبين على 12,000 Token من المدخلات، ولا توجد كتابة تخزين مؤقت منفصلة، ولا رسوم أدوات. جميع الأرقام التالية افتراضية وليست بيانات مقاسة فعليًا.
| البند | بادئة محفوظة | بادئة معاد كتابتها |
|---|---|---|
| قراءة التخزين المؤقت | 9,000 × $0.10/M = $0.0009 | 3,000 × $0.10/M = $0.0003 |
| مدخلات عادية | 3,000 × $2/M = $0.0060 | 9,000 × $2/M = $0.0180 |
| إجمالي المخرجات | 1,000 × $10/M = $0.0100 | 1,600 × $10/M = $0.0160 |
| الإجمالي | $0.0169 | $0.0343 |
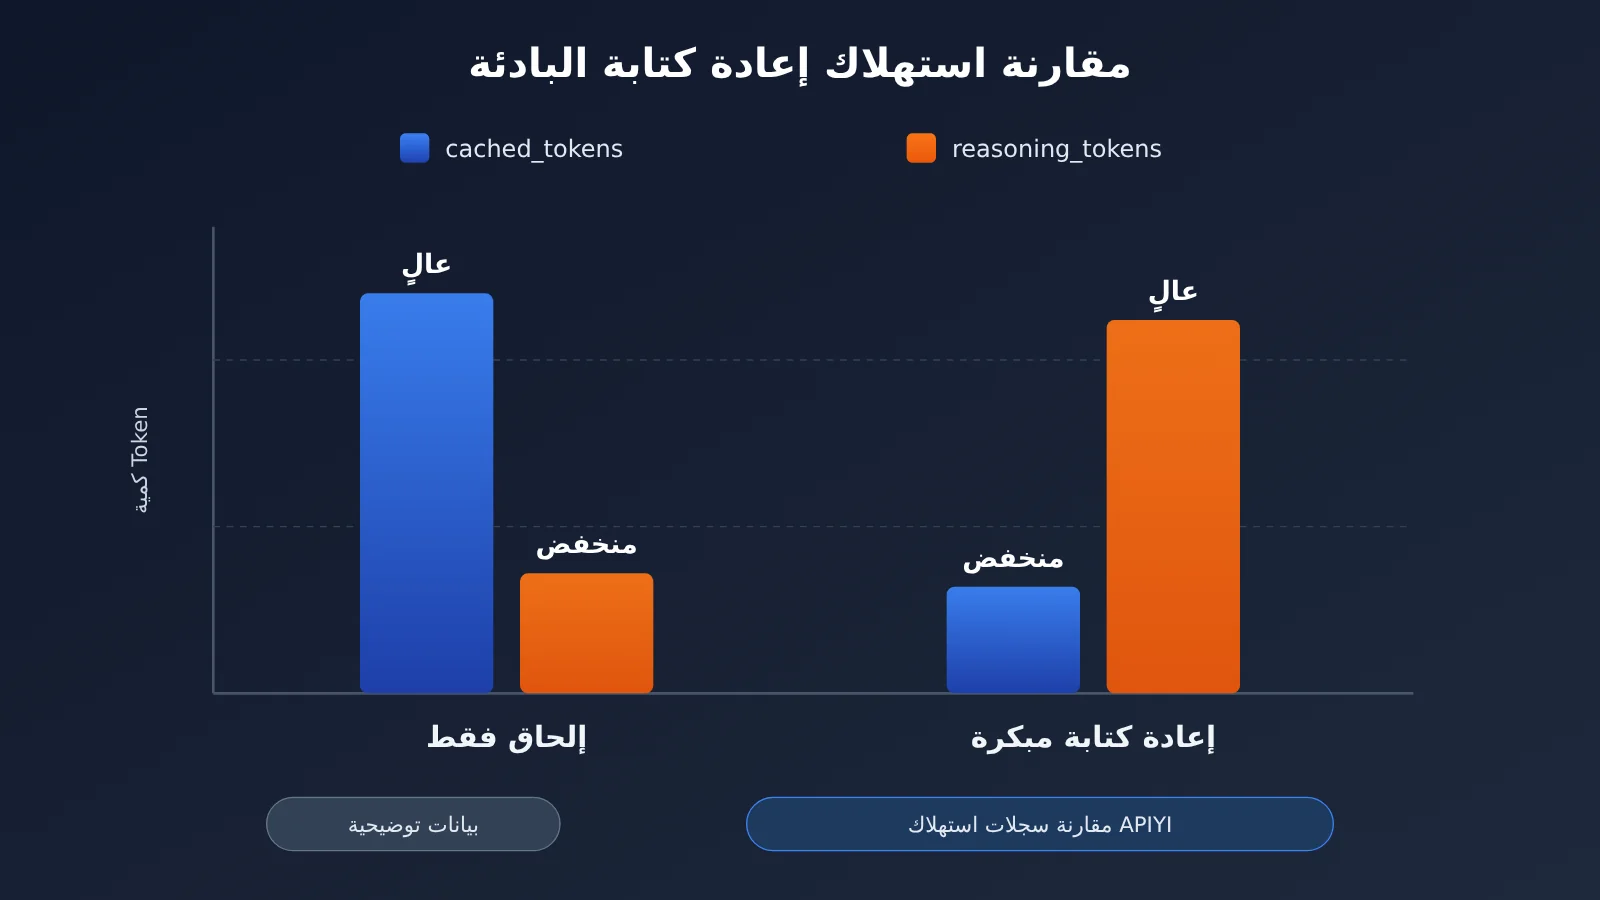
الفرق بين الطلبين هو $0.0174، ويمكن تفصيله إلى جزأين: $0.0114 ناتج عن انتقال 6,000 توكن من المدخلات من سعر التخزين المؤقت إلى سعر المدخلات العادي، أي 6,000 × ($2 − $0.10) / 1,000,000؛ و$0.0060 ناتج عن 600 توكن إضافية في إجمالي المخرجات. ويتوافق هذان الجزآن مع البندين المذكورين في القسم 1. ويجب الاعتماد على usage الخاص بك لتحديد الفرق الفعلي. وإذا وُجدت كتابة تخزين مؤقت منفصلة، فيجب الحساب ضمن ثلاث فئات متبادلة: المدخلات العادية، وقراءة التخزين المؤقت، وكتابة التخزين المؤقت.
4.3 التسوية باستخدام معرّف الطلب
بعد التقدير، يأتي دور التحقق من الخصم الفعلي. في سجل الاستهلاك على APIYI apiyi.com، استخدم x-request-id الموجود في ترويسة الاستجابة للعثور على السجل المقابل ذي type=2، ثم احسب quota ÷ 500,000 لتحصل على المبلغ الفعلي بالدولار. وسجّل في الوقت نفسه النموذج ومجموعة الرموز والفترة الزمنية للاستدعاء، إضافةً إلى حجم الإدخال والإخراج المستخدمين في ذلك الطلب.
لا توجد حتى الآن فاتورة مقارنة بادئة منشورة على APIYI لنفس مجموعة الرموز ونفس المهمة. لذلك، عند تقييم أثر التعديلات، ينبغي الاعتماد على سجلات الطلبات المترافقة وسجلات الخصم الخاصة بك.
💰 نصيحة للتسوية: اربط
request_idمن سجلات القسم 3.2 بسجل الاستهلاك بندًا بندًا، لتحصل على ثلاثة أعمدة: «حقل الاستخدام → المبلغ المقدّر → الخصم الفعلي». وأي عمود يظهر فيه انحراف، فاعلم أن المشكلة تكمن في تلك المرحلة بالتحديد.
4.4 ثلاثة تعديلات
- تثبيت تعريفات الأدوات والتعليمات الثابتة: حافظ على الترتيب الأصلي لتعريفات الأدوات، ولا تعدّلها في منتصف الجلسة؛ وضع التعليمات طويلة الأمد في أول رسالة developer داخل
input، أما التوجيهات المؤقتة الخاصة بالدورة الحالية فيمكن استخدام الحقل الأعلى مستوىinstructionsفي GPT-6.2 لها، لكن يجب أن تتوقع احتسابها ضمن الإدخال غير المخزّن مؤقتًا. - إلحاق السياق بالترتيب: تُلحق الرسائل الجديدة ونتائج الأدوات الجديدة والمواد المسترجعة الجديدة في النهاية. وعند الحاجة الفعلية إلى التقليص، احذف عناصر كاملة، ولا تعد كتابة محتواها.
- اختبار السياق الطويل وترحيل الإصدارات بشكل منفصل: عندما يتجاوز السياق الطويل 272,000 رمز إدخال تُطبّق فئة سعرية أخرى، لذا ينبغي إنشاء مجموعة تحكم منفصلة. وعند الانتقال من
gpt-6.1-solإلىgpt-6.2-sol، أو تعديل الفئة، أو تبديل عائلة النموذج، تحقّق أولاً بطريقة المقارنة الواردة في القسم 3، ثم انشر التغيير على الجميع.
بعد إتمام التعديلات أعلاه، يمكنك اختبار الأثر على هذا النحو: أعد تشغيل مجموعتَي المقارنة على مجموعة المهام نفسها. فإذا استقرت نسبة cached_tokens في مجموعة الإلحاق فقط، ولم ترتفع reasoning_tokens على نحو غير طبيعي، وتطابق الخصم الفعلي المُدقّق عبر معرّف الطلب مع التقدير، فهذا يعني أن هذه التكلفة أصبحت تحت السيطرة.
المراجع
- OpenAI «Keep the prefix unchanged»: الحفاظ على البادئة دون تغيير وتشخيص
prefix_mismatch- الرابط:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- الرابط:
- OpenAI «Reasoning models»: إعادة استخدام عناصر الاستدلال، والاستثناء الخاص بحذف العنصر بالكامل
- الرابط:
developers.openai.com/api/docs/guides/reasoning
- الرابط:
- OpenAI «Prompt caching» و«Counting tokens»: قواعد مطابقة ذاكرة التخزين المؤقت وحقول الاستخدام
- الرابط:
developers.openai.com/api/docs/guides/prompt-caching
- الرابط:
- سجل تغييرات OpenAI API (بند GPT-6.2، 2026-11-17)
- الرابط:
developers.openai.com/api/docs/changelog
- الرابط:
- OrcaRouter «GPT-6.2 Preserved Reasoning»: طريقة إعادة الكتابة بالاعتماد على الإضافة فقط، كما جمعها طرف ثالث
- الرابط:
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- الرابط:
- APIYI «جدول أسعار النماذج الشامل»
- الرابط:
docs.apiyi.com/models
- الرابط:
- APIYI «واجهة برمجة تطبيقات استعلام السجلات»
- الرابط:
docs.apiyi.com/api-capabilities/log-query
- الرابط:
- APIYI «دليل الاستدعاء الأصلي لواجهة OpenAI Responses API»
- الرابط:
docs.apiyi.com/api-capabilities/openai/native
- الرابط:
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من المواد يمكنكم زيارة مركز التوثيق docs.apiyi.com