ملاحظة من الكاتب: نفصل درجات Gemini 4 Neon المعلنة إلى ثلاث فئات — البرمجة، والعمل المعرفي، والعلوم — ونضع مصدر كل رقم بجانبه، لنساعدك على تحديد نوع المهام التي تناسب تسليمها إليه.
في 18 نوفمبر 2026، أعلنت Google عن Gemini 4 Neon، ولخّص سوندار بيتشاي في منشور الإعلان موقعَه بأنه أسرع في إنجاز المهام المعقدة في هندسة البرمجيات والعمل المعرفي والعمليات العلمية. وفي اليوم نفسه، نشرت DeepMind بطاقة النموذج (model card)، كما نشرت Artificial Analysis مقالًا عن قياساتها من طرف ثالث وصفحة خاصة بالنموذج، فصار لدينا دفعة واحدة عدة مجموعات من البيانات المعلنة.
المشكلة أن هذه المجموعات من الأرقام لا تتبع المعيار نفسه. فمدونة Google تعتمد على الإبلاغ الرسمي الذاتي؛ وجدول المقارنة في بطاقة النموذج يذكر Claude Opus 5.5 وGPT-6.2 Sol، لكن ملاحظات التقييم تنص على أن نتائج النماذج غير التابعة لـ Gemini مصدرها الافتراضي هو الإبلاغ الذاتي من كل جهة؛ أما Artificial Analysis فهي الجهة الوحيدة التي تقيس من طرف ثالث. اعتمدنا في هذا المقال تاريخ 19 نوفمبر 2026 يومًا للتحقق من البيانات، وأبقينا على وسم المصدر عند كل بند، وكتبنا الأرقام المتباينة بين المجموعتين جنبًا إلى جنب، دون حساب متوسط.
القيمة الأساسية: بعد قراءة هذا المقال ستحصل على جدول مرتّب حسب نوع المهمة، تعرف فيه في أي بنود البرمجة وقراءة المواد والعلوم يقول المصدر الرسمي إن Gemini 4 Neon في المقدمة، وفي أي بنود يتفوق عليه منافس وفق بطاقة النموذج، وفي أي بنود يتقدم عليه طرف ثالث بفارق نقطة واحدة فقط.
Gemini 4 Neon: النقاط الأساسية — ابدأ من المدخل، ثم فصّل الأجزاء الثلاثة
الدرجة الإجمالية هي الرقم الأول الذي تلتقطه عين معظم الناس. تُظهر مقالة Artificial Analysis أن Gemini 4 Neon يحصل على درجة ذكاء 61 في مستوى التفكير xhigh، وفي المركز الثالث إجمالًا، متأخرًا عن GPT-6.2 Astra (max) وClaude Fable 5.2 (max). وتذكر مدونة Google (التقييم الرسمي الذاتي) الرقم 61 والمركز الثالث أيضًا، مضيفةً عبارة: «متأخر عن نماذج أكبر وأبطأ». وفي عمود AA Index v5.0.1 ببطاقة النموذج يظهر الرقم 61 كذلك، بينما يأتي Opus 5.5 المقارن عند 59 وSol عند 57.
الرقم 61 متطابق في المصادر الثلاثة، لكنه مجرد مدخل. فالدرجة الإجمالية تخلط البرمجة وقراءة المواد والعلوم معًا، بينما العمل الذي تُسلّمه عادةً ينتمي إلى جزء واحد منها فقط. يوضّح الجدول التالي طبيعة أنواع المصادر الثلاثة، ثم نفصّل كل جزء في الأقسام اللاحقة.
| المصدر | الطبيعة | ما نستخدمه لرؤيته في هذا المقال |
|---|---|---|
| مدونة Google | تقييم رسمي ذاتي | العناصر التي تدّعي Google أنها الأولى فيها، ودرجات كل عنصر |
| بطاقة نموذج DeepMind | تجميع رسمي، ونتائج النماذج غير Gemini غالبًا تقييمات ذاتية من كل جهة | مقارنة بندًا ببند بين الأعمدة الثلاثة: Neon وOpus 5.5 وSol |
| مقالة Artificial Analysis | قياس طرف ثالث | Coding Agent Index وGDP.pdf وMKA وغيرها |
| صفحة نموذج Artificial Analysis | قياس طرف ثالث، مقسّمة حسب مستوى التفكير | فروق درجة الذكاء بين مستويات التفكير الأربعة |
موقع Gemini 4 Neon داخل العائلة
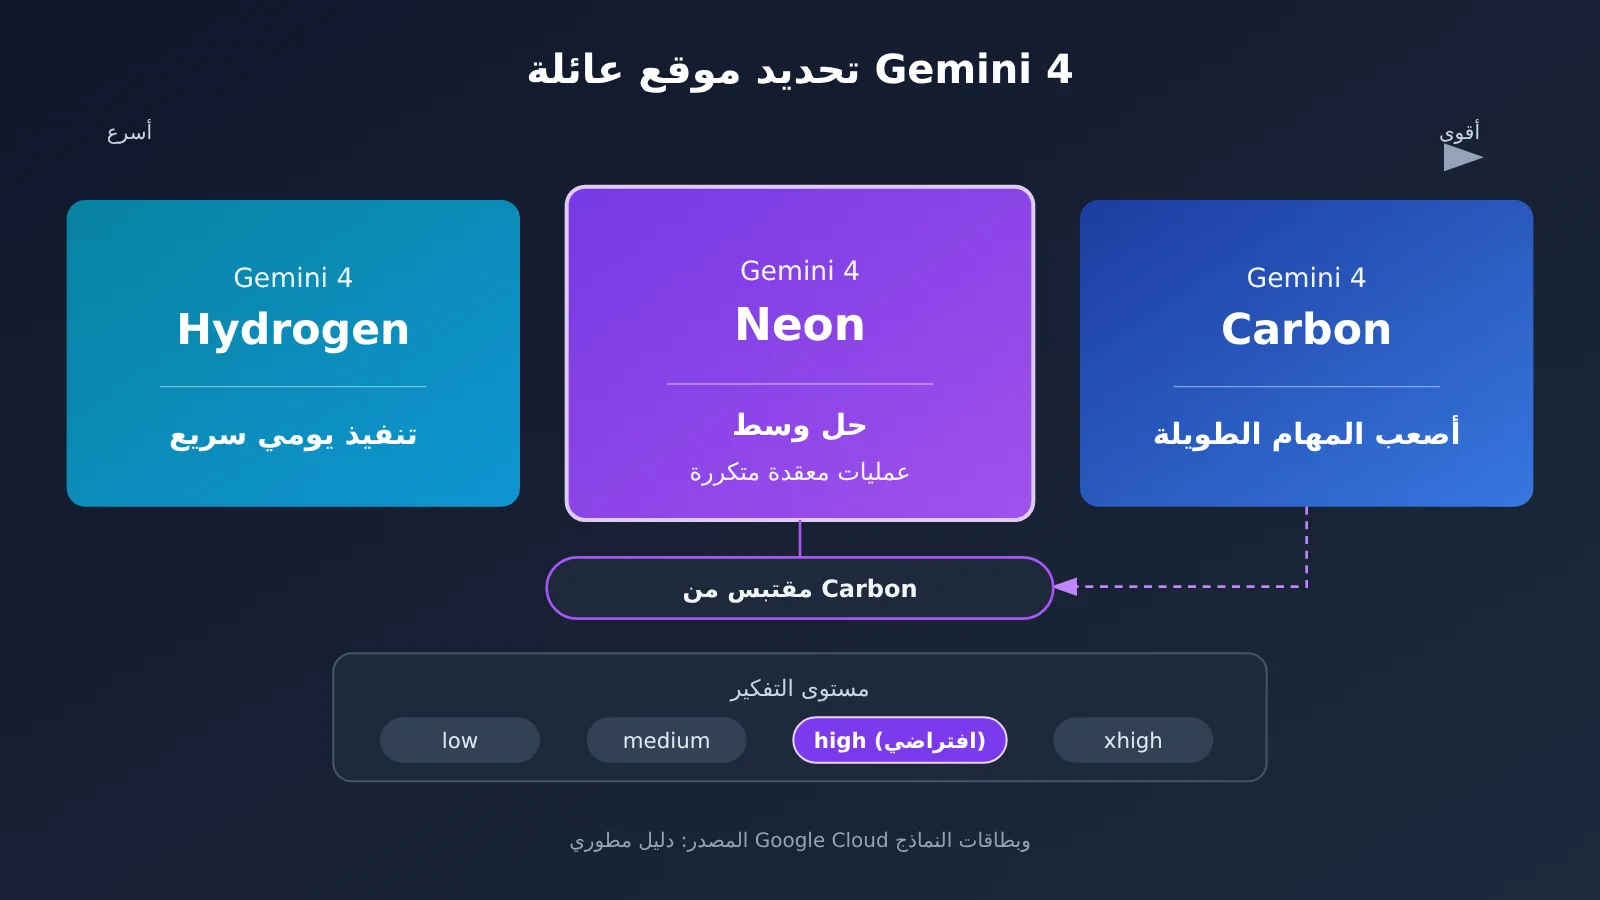
تنص بطاقة النموذج على أن Gemini 4 Neon مشتق من Gemini 4 Carbon، وأن المعرفة محدّثة حتى مارس 2026، وأن المدخلات تدعم النص والصور والصوت والفيديو، مع نافذة موحّدة تصل إلى مليون token كحد أقصى. ويضعها دليل مطوّري Google Cloud بين Hydrogen (الدورة اليومية السريعة) وCarbon (المهام الطويلة المعقّدة)، وتصفها المدونة الرسمية بأنها موجّهة إلى التدفقات المعقّدة عالية التكرار.
فهم هذا الموقع يساعد على قراءة الدرجات اللاحقة. ويختلف طرف المقارنة بالنسبة إلى Neon من مصدر إلى آخر: فبطاقة النموذج تضم عمودين فقط هما Opus 5.5 وSol، دون Fable 5.2 وAstra وCarbon؛ بينما تقارنها Artificial Analysis أساسًا بـ Carbon وFable وOpus. وعند المقارنة بندًا ببند، لن نستخدم خلايا أخرى لملء الفراغات.
قدرات Gemini 4 Neon في البرمجة: تقدم في موضعين، وتفوق طفيف لـ Opus في موضعين
البرمجة هي الجزء الذي خصصت له مدونة Google أكبر قدر من التفاصيل. وتعلن Google رسميًا أن Gemini 4 Neon حقق 58.6 على مؤشر Artificial Analysis Coding Agent Index، في المرتبة الأولى إجمالًا. أما الرقم الذي يرد في مقال Artificial Analysis فهو 59، وظروف القياس هي Neon xhigh على Antigravity CLI. الرقمان 58.6 و59 يردان من مصدرين مختلفين، ونحتفظ بهما معًا في هذا المقال.
الفارق مع الأطراف الثالثة يحتاج إلى قراءة منفصلة. في مقال Artificial Analysis، جاء Fable xhigh على Claude Code وOpus 5.5 max عند 58، وCarbon high عند 55. أي أن تقدم Neon على هذين النموذجين من Claude يبلغ نقطة واحدة.
وتقدّم بطاقة النموذج تفصيلًا أدق للبنود، وفي بندين منهما يتقدم Opus 5.5.
| بند البرمجة (بطاقة النموذج) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | لا يوجد |
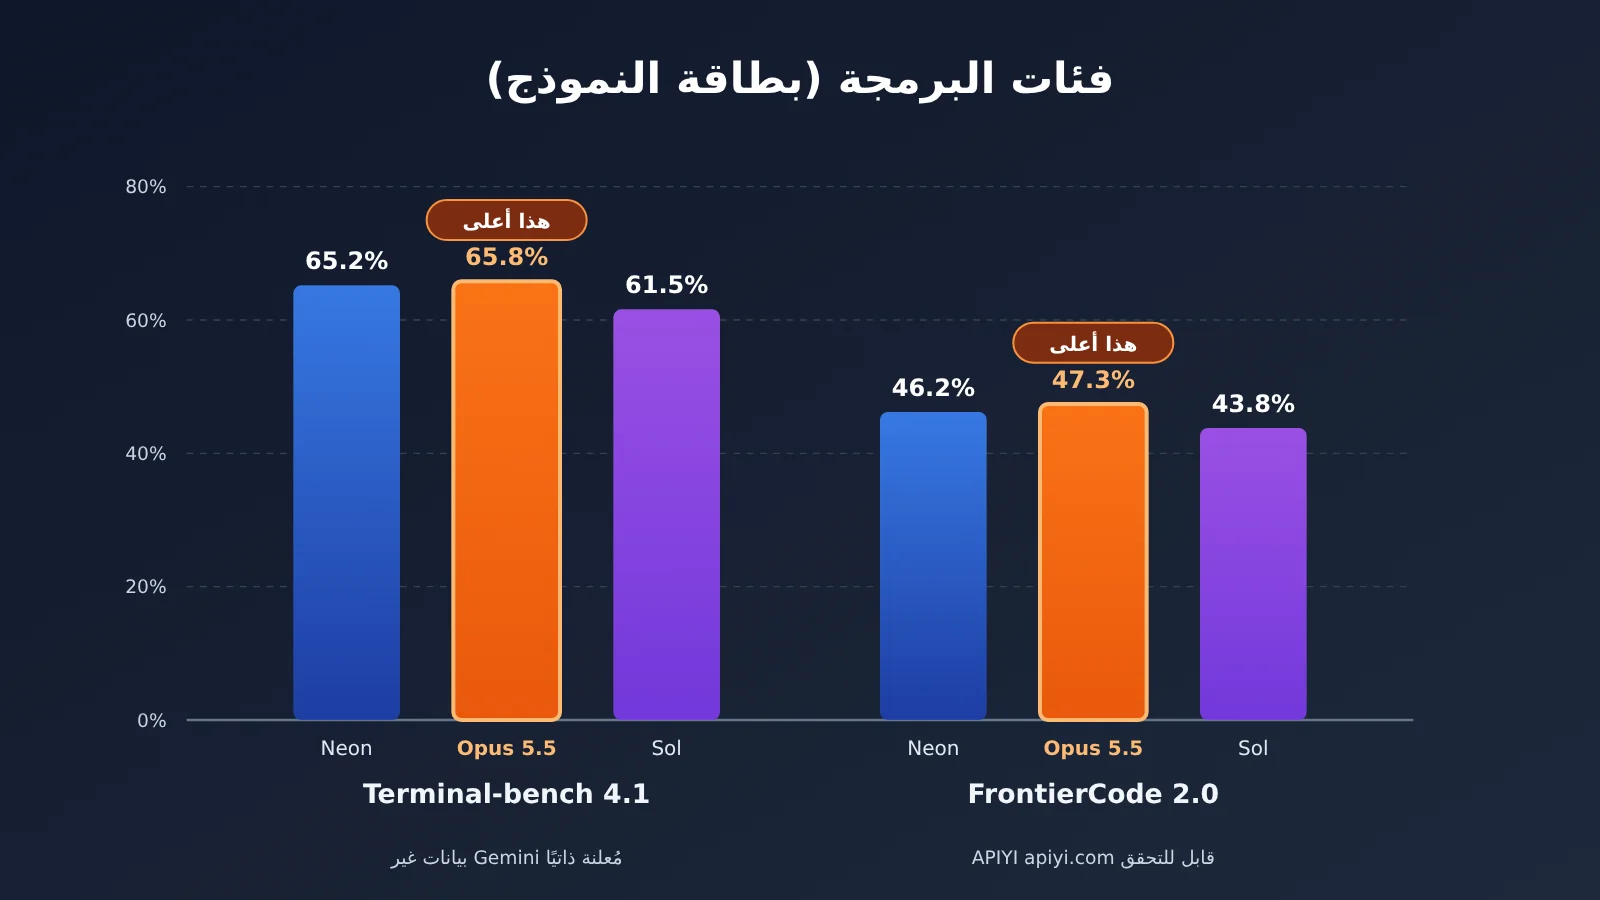
| Terminal-bench 4.1 (بعد تعديل الغش) | 65.2% | 65.8% | 61.5% |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% |
| SWE-sweep مع harness المزوّد | 39.0% | 10.1% | 8.3% |
| SWE-sweep مع mini-SWE harness | 12.8% | 3.6% | 11.6% |
كيف تُقرأ درجات Gemini 4 Neon في البرمجة
في Terminal-bench 4.1، يبلغ Opus 5.5 نسبة 65.8% مقابل 65.2% لـ Neon؛ وفي FrontierCode 2.0، يحقق Opus 5.5 نسبة 47.3% مقابل 46.2% لـ Neon. الفارق في البندين نحو نقطة مئوية واحدة، لكن الاتجاه لصالح Opus قليلًا. وفي المدونة الرسمية، وُصفت نسبة 46.2% في FrontierCode 2.0 بأنها عند المستوى الافتراضي high.
الرقمان في SWE-sweep هما الأكثر عرضة للفهم الخاطئ. نسبة 12.8% هي النتيجة تحت mini-SWE harness، أما 39.0% فهي النتيجة داخل Google Antigravity (بيئة تقييم المزوّد). وتصف المدونة الرسمية الفارق بينهما بأنه تفعيل قدرات إضافية بفضل harness، وهو يعكس أثر سلسلة الأدوات، ولا ينبغي فهمه على أن النماذج نفسها تختلف بمعامل ثلاثة. ومن الجدير بالانتباه أيضًا إلى أن Sol يحقق 11.6% تحت mini-SWE harness، وهي قريبة جدًا من 12.8% لـ Neon.
Gemini 4 Neon في العمل المعرفي: التقدم في معظم الفئات، وChartography هي الفئة الوحيدة التي يتفوق فيها Sol
في مجال العمل المعرفي، أوردت المدونة الرسمية عددًا من المراتب الأولى. فقد ادّعيت المرتبة الأولى في كل من Legal Research Bench وTax Agent Bench، لكن المدونة لم تذكر النسب المئوية لهذين البندين. وعلى منصة Surge، ادّعيت أيضًا المرتبة الأولى في معظم مهام التمويل والمحاسبة ونمذجة الجداول والمهام ذات القيود المعقدة، دون تقديم درجات لكل بند. لذلك لا يمكن تسجيل هذه إلا بوصفها ترتيبات أعلنتها الجهة رسميًا، ولن نضيف أرقامًا من عندنا في هذا المقال.
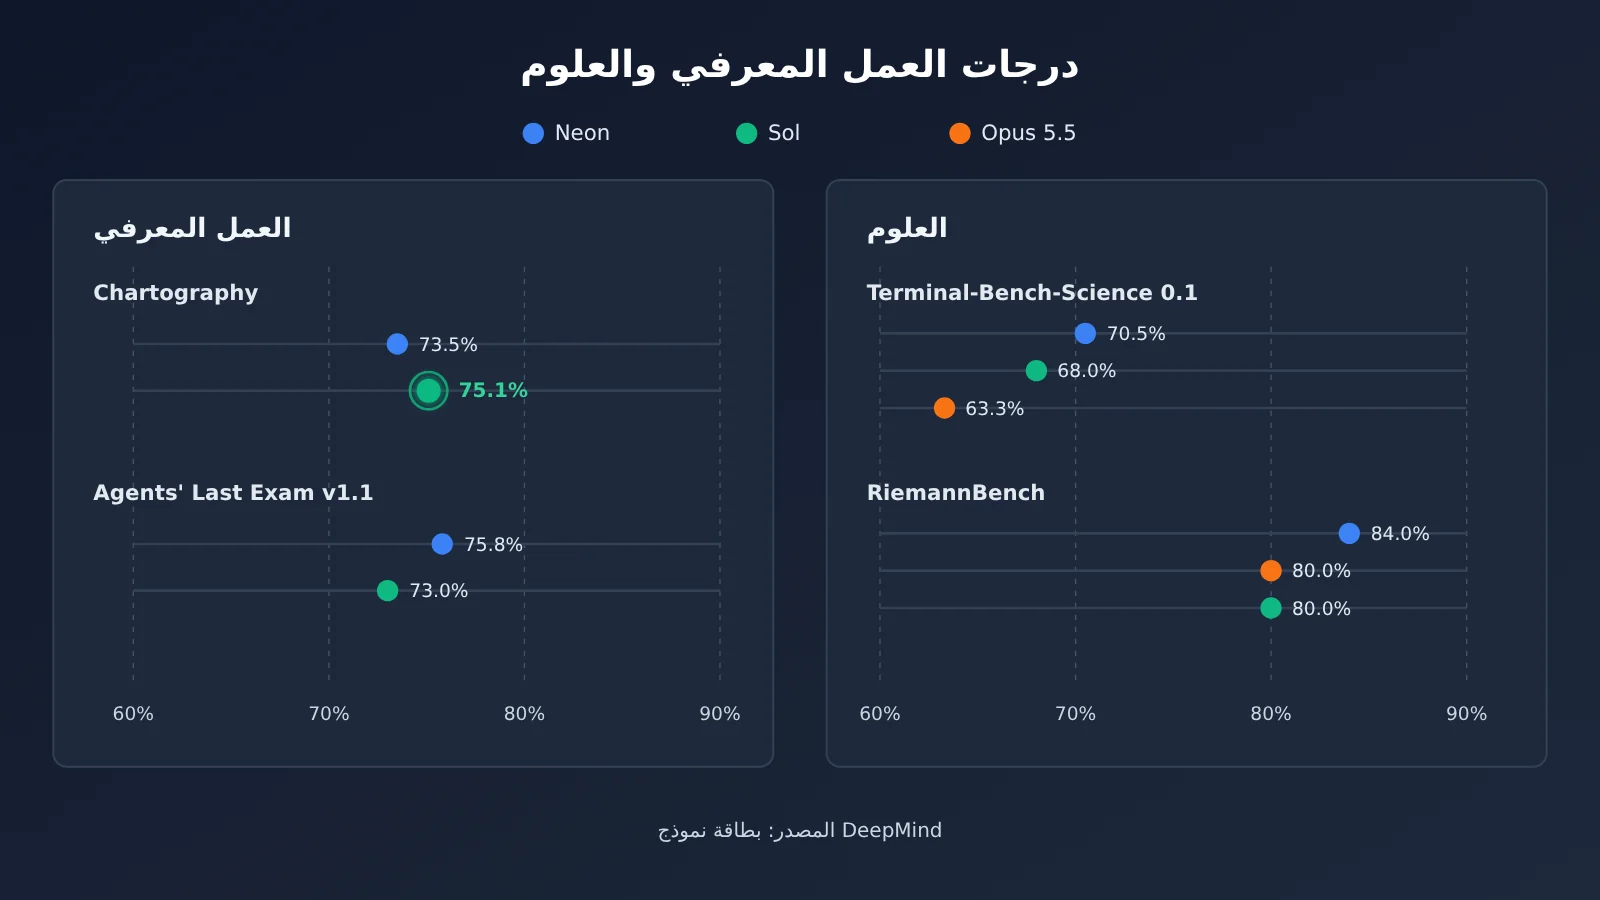
أما البنود التي تتوفر لها درجات فيمكن مقارنتها ببطاقة النموذج. في Zapier AutomationBench، تحتل المدونة الرسمية المرتبة الأولى بنسبة 56.3%، وفي Andon Labs Vending-Bench 2 المرتبة الأولى بقيمة 16843 دولارًا. أما Chartography فهي البند الوحيد في هذا القسم الذي يتفوق فيه Sol: إذ بلغ Sol 75.1% مقابل 73.5% لـ Neon.
وقد قدّمت قياسات طرف ثالث تفاصيل أكثر. أظهر مقال Artificial Analysis أن Neon high على GDP.pdf بلغ 33.4%، بينما جاء Neon xhigh عند 28.0% فقط، وCarbon high عند 28.4%، ما يدل على أن رفع مستوى التفكير لا يعني بالضرورة الحصول على درجة أعلى. وفي AA-Briefcase، حقق Neon xhigh نتيجة إجمالية 1700 Elo، وجودة عرض 1771 Elo، وهو أعلى من 1726 لـ Claude Sonnet 5.5 max. وفي بند MKA، كتب مقال Artificial Analysis أن Neon بلغ 56%، قريبًا من 57% لـ Fable max، وأعلى من Carbon بفارق نقطتين؛ بينما تذكر بطاقة النموذج 56.5%، ونحتفظ بكل من الرقمين كما هو.
قدرات Gemini 4 Neon العلمية: ثلاث نتائج يصفها الموقع الرسمي بأنها «الأفضل في فئتها»
قطاع العلوم هو الجزء الذي جاءت فيه صياغة الموقع الرسمي الأقوى بين الأجزاء الثلاثة. تقول مدونة Google إن Terminal-Bench Science بنسبة 70.5% وRiemannBench بنسبة 84.0% وHLE-Diamond بنسبة 71.3% هي ثلاث نتائج «best in class»، وهذه أرقام مُعلنة من الشركة نفسها. وجدول المقارنة في بطاقة النموذج متوافق مع ذلك، إذ إن نتائج Neon الثلاث أعلى من Opus 5.5 وSol، لكن عمود المقارنة هو أيضًا تجميع لأرقام تُعلنها كل شركة عن نفسها.
| عناصر المعرفة والعلوم (بطاقة النموذج) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| GraphWalks (256k–1M، BFS F1) | 95.2% | 66.8% | 80.1% |
| MKA Climb WSR | 56.5% | 53.0% | 52.7% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
نتيجة GraphWalks البالغة 95.2% في نطاق السياق الطويل من 256k إلى 1M تبتعد كثيرًا عن 66.8% التي حققها Opus 5.5، لذا تستحق اهتمامًا خاصًا في حالات قراءة المواد فائقة الطول. أما في Terminal-Bench-Science فقد سجّل Sol نسبة 68.0%، بفارق 2.5 نقطة مئوية عن 70.5% لـ Neon، وهو أصغر فارق بين العناصر العلمية الثلاثة.
Gemini 4 Neon حسب نوع المهمة: جدول شامل
عندما نجمع الأجزاء الثلاثة معًا، ونرتبها وفق الحالات الثلاث: «الجهة الرسمية تقول إنه الأول» و«بطاقة النموذج تضع المنافس في مرتبة أعلى» و«الطرف الثالث يتقدم بفارق نقطة واحدة فقط»، نحصل على الجدول التالي الذي يقسّم الأمور حسب نوع المهمة. هذا الجدول لا يجيب عن سؤال: مَن الأقوى بشكل شامل؟ بل يوضّح لك على أي دليل تستند درجة كل نوع من المهام.
| نوع المهمة | المركز الأول بحسب الجهة الرسمية | بطاقة النموذج: المنافس أعلى | فارق الطرف الثالث: نقطة واحدة |
|---|---|---|---|
| البرمجة | Coding Agent Index 58.6، المركز الأول إجمالًا | Terminal-bench 4.1 وFrontierCode 2.0: Opus 5.5 أعلى | Coding Agent Index 59 مقابل 58 لـ Fable xhigh وOpus 5.5 max |
| العمل المعرفي | Legal Research Bench وTax Agent Bench وAutomationBench وVending-Bench 2 | Chartography: Sol أعلى | MKA 56% مقابل 57% لـ Fable max (Neon أقل بنقطة واحدة) |
| العلوم | Terminal-Bench Science وRiemannBench وHLE-Diamond | لا يوجد | لا توجد درجة علوم منفصلة من طرف ثالث |
| المدخل الشامل | Vals Index المركز الثاني (70.9%) | لا يوجد | درجة الذكاء في AA هي 61، أعلى بنقطة واحدة من Carbon high |
تحليل مزايا وعيوب Gemini 4 Neon
المزايا
- تقدم متسق في ثلاثة اختبارات علمية: تشير البيانات التي أعلنتها الشركة رسميًا وبطاقة النموذج إلى أن نتائج Terminal-Bench Science وRiemannBench وHLE-Diamond أعلى من النموذجين المرجعيين.
- قدرة قوية على قراءة السياق الطويل: تذكر بطاقة النموذج أن GraphWalks يحقق في نطاق 256k–1M دقة BFS F1 تبلغ 95.2%، وهو ما يقابل نافذة موحدة بسعة مليون token.
- أثر مضاعف واضح لسلسلة الأدوات: يبلغ SWE-sweep نسبة 39.0% ضمن أداة الاختبار الخاصة بالمورّد، ما يشير إلى عائد أكبر عند العمل مع بيئات وكلاء مثل Antigravity.
- مدخلات متعددة الوسائط مكتملة: توضح بطاقة النموذج دعم إدخالات النص والصورة والصوت والفيديو؛ بينما تعرض صفحة النموذج Opus 5.5 في Artificial Analysis أن الإدخال يقتصر على النص والصورة.
القيود
- البرمجة ليست الأولى في كل اختبار: على Terminal-bench 4.1 وFrontierCode 2.0 يتفوق Opus 5.5 بفارق ضئيل؛ لذا يُنصح باختبار النموذجين في مهام الطرفية الخالصة أو مهام البرمجة المتقدمة.
- في فهم الرسوم البيانية يتفوق منافس: يحقق Sol نتيجة أعلى في Chartography، لذا يمكن إدراج Sol في المقارنة عند تنفيذ مهام التقارير المكثفة بالرسوم البيانية.
- المستويات العليا من التفكير لا تضمن درجات أعلى: في مقال Artificial Analysis، جاء مستوى xhigh في GDP.pdf أقل من high؛ لذلك يجب ضبط مستوى التفكير وفقًا للمهمة.
- قيود المعاملات صارمة نسبيًا: يوضح دليل المطور أن تمرير
thinking_budgetأوMINIMALسيؤدي إلى إرجاعHTTP 400، وأن التخزين المؤقت الصريح للسياق غير مدعوم، ولا يُستخدم سوى التخزين المؤقت الضمني للبادئات المشتركة التي تتجاوز 4096 token.
نكتفي في هذا المقال بجملة واحدة عن السعر والسرعة: توجد مقاييس مختلفة لمقارنة تكلفة المهمة الواحدة بـCarbon؛ ففي حين أعلنت Google انخفاضًا بنسبة 32%، يقدّر مقال Artificial Analysis انخفاضًا بنحو 17%. ونترك التفاصيل لمقالة مخصصة للتسعير؛ كما نترك زمن الاستجابة وسرعة الإخراج لكل مستوى تفكير لمقالة مخصصة للسرعة.
بدء سريع مع Gemini 4 Neon: حدّد المهمة أولاً، ثم مستوى التفكير
نقترح أن تكون خطوات البدء ثلاثاً: أولاً اختَر نوع المهمة وفق الجدول العام أعلاه، ثم اختَر مستوى التفكير، وأخيراً راجع قائمة APIYI الإجمالية للتأكد من أن طرازات عائلة Gemini 4 المتاحة تكفي احتياجك.
- اختيار نوع المهمة: أعطِ الأولوية لنقاط قوة Neon في الاستدلال العلمي وقراءة المواد الطويلة؛ أما البرمجة في الطرفية وفهم المخططات، فأدرِج Opus 5.5 أو Sol ضمن الخيارات.
- اختيار مستوى التفكير: يوضح دليل المطورين أن Neon لا يملك سوى أربعة مستويات هي
lowوmediumوhighوxhigh، والافتراضي هوhigh. وتعرض صفحة النموذج في Artificial Analysis درجات الذكاء للمستويات الأربعة كالتالي: 44 و55 و60 و61. لا يفصل بينhighوxhighسوى نقطة واحدة، بل إنhighيحصل على درجة أعلى في GDP.pdf؛ لذلك يكفي أن تبدأ معظم المهام بالمستوى الافتراضي. - التحقق من الطرازات المتاحة: في مهام التنسيق، يمكنك اتباع أسلوب دليل المطورين: أسند التحكم الرئيسي إلى نموذج قوي، وأسند المهام الفرعية السريعة إلى
gemini-4-hydrogen؛ أما أصعب المهام طويلة المدى فاستخدم لهاgemini-4-carbon.
أما عن عنوان الاستدعاء، ففي الواجهة المتوافقة مع OpenAI اضبط base_url على https://api.apiyi.com/v1، وفي واجهة Gemini الأصلية استخدم https://api.apiyi.com واختر الإصدار v1beta. اقرأ المفتاح من متغير بيئة مثل APIYI_API_KEY، ولا تكتب المفتاح الصريح داخل الشيفرة. عند الاستدعاء، املأ model بـ gemini-4-carbon أو gemini-4-hydrogen، فكلاهما في قائمة APIYI الإجمالية له نقطتا النهاية chat وgemini.
يلخّص الجدول التالي الطرازات التي يمكن الاستعانة بها للمقارنة، كما وردت في قائمة APIYI الإجمالية المحدّثة في 2026-11-16 (docs.apiyi.com/models.md) وواجهة التسعير التي تم الاستعلام عنها في 2026-11-19 (api.apiyi.com/api/pricing، بإجمالي 285 طرازاً)، والوحدة هي دولار لكل مليون token.
| معرّف النموذج | الإدخال | قراءة الذاكرة المؤقتة | الإخراج | المنصات المتاحة |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | قائمة APIYI الإجمالية، واجهة التسعير |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | قائمة APIYI الإجمالية، واجهة التسعير |
claude-opus-5-5 |
4 | 0.2 | 20 | قائمة APIYI الإجمالية، واجهة التسعير |
gpt-6.2-sol |
2 (إذا تجاوز الإدخال 272000 token يصبح 3) | 0.1 | 10 (الفئة الأعلى في واجهة التسعير نحو 11.25) | قائمة APIYI الإجمالية، واجهة التسعير |
السعران 2/10 لـ gemini-4-carbon هما سعر الرف الحالي في APIYI، ويقابلان سعر Google التقديمي حتى 2026-11-30. أما Gemini 4 Neon، فالسعر المعلن عنه في صفحة تسعير Google AI Studio هو 3.00 للإدخال و15.00 للإخراج دولاراً لكل مليون token، ولا توجد فئة مجانية؛ وهو لم يظهر بعد في قائمة APIYI الإجمالية ولا في واجهة التسعير. لم يُدرج بعد، وسندرج هذا النموذج في أقرب وقت ممكن؛ وتُعتمد الطرازات والأسعار وفق قائمة الطرازات في المنصة.
🚀 نصيحة للبدء: قبل طرح Neon، يمكنك أولاً عبر APIYI على apiyi.com استخدام نفس مفتاح API لاستدعاء كلٍّ من
gemini-4-carbonوclaude-opus-5-5وgpt-6.2-solبشكل منفصل، ثم تشغيل مهامك البرمجية أو مهام إعداد التقارير على كل نموذج مرة واحدة، لتحديد أي نوع من المهام يحتاج فعلاً إلى قدرات بمستوى Neon.
الأسئلة الشائعة (FAQ)
س1: ما هي مكانة نموذج Gemini 4 Neon؟
هو الفئة الوسطى من عائلة Gemini 4 التي أعلنت عنها Google في 18 نوفمبر 2026، وهو نسخة مقتبسة من Carbon. يضعه دليل المطورين بين Hydrogen وCarbon، ويصفه المنشور الرسمي على المدونة بأنه موجّه للعمليات المعقدة عالية التكرار. معرّف النموذج هو `gemini-4-neon`.
س2: الدرجة الإجمالية 61 — أي مرتبة يحتلها Gemini 4 Neon؟
يبيّن مقال Artificial Analysis أن درجة فئة xhigh هي 61 والمرتبة الإجمالية الثالثة، ويسبقه GPT-6.2 Astra (max) وClaude Fable 5.2 (max). الرقم 61 في منشور Google وفي بطاقة النموذج مطابق لذلك، لكن الدرجة الإجمالية تصلح كنقطة دخول فقط، وينبغي النظر إلى الدرجات الفرعية بحسب المهمة.
س3: هل الرقم في Coding Agent Index هو 58.6 أم 59؟
الرقمان صحيحان، لكن المصدرين مختلفان. الرقم 58.6 هو ما أعلنته Google في منشورها على المدونة (تصريح رسمي منها)، أما 59 فهو رقم مقال Artificial Analysis مقاسًا على Neon بنمط xhigh عبر Antigravity CLI. ولا ينبغي دمجهما أو حساب متوسط بينهما.
س4: الفرق الكبير بين 12.8% و39.0% في SWE-sweep، ماذا يعني؟
هما نتيجتان لبيئتَي harness مختلفتين: 12.8% من mini-SWE harness، و39.0% من Google Antigravity. ويعزو المنشور الرسمي الفرق إلى ما يفتحه harness من إمكانات، ولذا فعند اختيار النموذج ينبغي التركيز على بيئة الـ agent التي تستخدمها فعليًا.
س5: في أي المشاريع يتفوّق المنافسون على Gemini 4 Neon؟
في بطاقة النموذج يتقدّم Claude Opus 5.5 قليلًا في Terminal-bench 4.1 وFrontierCode 2.0، ويتقدّم GPT-6.2 Sol قليلًا في Chartography. وفي مقال Artificial Analysis سجّل MKA لدى Fable بنمط max نسبة 57% مقابل 56% لـ Neon.
س6: هل يمكن الآن استدعاء Gemini 4 Neon عبر API؟
أعلنتها Google عبر قنوات مثل Gemini API في AI Studio. أما الجدول الإجمالي وواجهة التسعير في APIYI apiyi.com فلا تحتويان حاليًا على `gemini-4-neon`، أي إن النموذج غير متاح على المنصة بعد، وسنعمل على إتاحته في أقرب وقت؛ ويُعتمد اسم النموذج وسعره وفق قائمة النماذج في المنصة.
س7: ما النماذج التي يمكن استخدامها للاختبار البديل قبل الإتاحة؟
يمكنك عبر APIYI apiyi.com استخدام العنوان المتوافق مع OpenAI `https://api.apiyi.com/v1` لاستدعاء `gemini-4-carbon` أو `gemini-4-hydrogen`، وبالمفتاح نفسه يمكنك التبديل إلى `claude-opus-5-5` و`gpt-6.2-sol` لعمل مقارنة أفقية، وللمستخدمين الجدد حصة اختبار مجانية.
س8: ما قيود الاستدعاء في Gemini 4 Neon؟
يوضح دليل المطورين ما يلي: مستويات التفكير أربعة فقط من `low` إلى `xhigh`، وإرسال `thinking_budget` أو `MINIMAL` يعيد `HTTP 400`؛ ولا يدعم التخزين المؤقت الصريح للسياق؛ والحد الأعلى الموحّد هو 1048576 token ويشمل الإدخال والإخراج، مع حد افتراضي للإخراج يصل إلى 65536 في المقطع الواحد.
Gemini 4 Neon: أهم النقاط الأساسية
- النتيجة الإجمالية ليست سوى نقطة دخول: درجة الذكاء AA البالغة 61 والمركز الثالث متطابقان في ثلاثة مصادر، لكن اختيار النموذج يجب أن يظل مقسّمًا حسب المهمة.
- في البرمجة، تجاوزه منافس في معيارين: في بطاقة النموذج، سجّل Opus 5.5 نتائج أعلى قليلًا في Terminal-bench 4.1 وFrontierCode 2.0.
- في البرمجة يتقدم لدى طرف ثالث بفارق نقطة واحدة: Coding Agent Index بنتيجة 59 مقابل 58 لـ Fable xhigh وOpus 5.5 max.
- يتقدم في معظم أعمال المعرفة: كان Sol أعلى في Chartography، بينما كانت ميزة GraphWalks في السياق الطويل هي الأوضح.
- ثلاثة معايير علمية تصفها الجهة الرسمية بأنها الأفضل في فئتها: وفي المقارنة الواردة في بطاقة النموذج يتقدم كذلك، لكن بيانات المنافسين هي مما أعلنته كل جهة عن نفسها.
- مستوى التفكير يبدأ من high: الفرق في درجة الذكاء بين high وxhigh نقطة واحدة فقط، وعلى GDP.pdf كان high أعلى.
- ابدأ باختبار النماذج المتاحة بالفعل: قبل توفّر Neon، يمكنك على APIYI apiyi.com تشغيل المهام أولًا باستخدام Carbon وHydrogen.
الخلاصة
كم يبلغ Gemini 4 Neon من القوة؟ سيصبح الأمر أوضح بكثير إذا نظرنا إليه عبر ثلاثة جوانب:
- البرمجة: تحتل المرتبة الأولى في Coding Agent Index بحسب ما أعلنته الجهة الرسمية، بينما لا يتقدم طرف ثالث إلا بفارق نقطة واحدة، وفي بطاقة النموذج يتفوق Opus 5.5 قليلًا في معيارين.
- أعمال المعرفة: يتقدم في معظم المعايير مثل AutomationBench وGraphWalks للسياق الطويل، بينما كان Sol أعلى في Chartography.
- العلوم: ثلاثة معايير توصف رسميًا بأنها الأفضل في فئتها، وتتفق مقارنة بطاقة النموذج على تقدمه، وهي المجموعة الأكثر اتساقًا في الأدلة بين الجوانب الثلاثة.
نقترح أولًا تصنيف مهمتك ضمن أحد هذه الأنواع، ثم الرجوع إلى الجدول الإجمالي في هذا المقال لتحديد ما إذا كنت بحاجة إلى Neon. قبل الإطلاق، يمكنك عبر APIYI apiyi.com استدعاء Gemini 4 Carbon وHydrogen بالإضافة إلى Opus وSol من خلال واجهة موحدة لإجراء المقارنة، وبعد إطلاق gemini-4-neon استبدل معرّف النموذج مباشرة وأعد الاختبار.
📚 المراجع
-
مدونة Google – Introducing Gemini 4 Neon: مقال الإصدار الرسمي والدرجات المعلنة ذاتيًا
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - الوصف: الترتيب ودرجات البرمجة والعلوم كما أعلنتها الجهة المطوّرة نفسها
- الرابط:
-
بطاقة نموذج DeepMind – Gemini 4 Neon: جدول مقارنة بثلاثة أعمدة ومواصفات النموذج
- الرابط:
deepmind.google/models/model-cards/gemini-4-neon/ - الوصف: درجات Neon وOpus 5.5 وSol بندًا بندًا، والنتائج غير الخاصة بـ Gemini مأخوذة افتراضيًا من إعلانات كل جهة عن نفسها
- الرابط:
-
دليل مطوّري Google Cloud – Gemini 4 Neon: المعاملات وقيود الاستدعاء
- الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - الوصف: مستويات التفكير، والحد الأقصى لعدد الـ tokens، والتخزين المؤقت، ورموز الأخطاء
- الرابط:
-
مقال Artificial Analysis – Gemini 4 Neon intelligence gain: قياس من طرف ثالث
- الرابط:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - الوصف: Coding Agent Index 59، وGDP.pdf، وMKA، وغيرها
- الرابط:
-
صفحة نموذج Artificial Analysis – Gemini 4 Neon: المؤشرات موزّعة حسب مستوى التفكير
- الرابط:
artificialanalysis.ai/models/gemini-4-neon - الوصف: مقارنة درجات الذكاء عبر المستويات الأربعة
- الرابط:
-
جدول نماذج APIYI الشامل: الطرازات المتاحة والأسعار
- الرابط:
docs.apiyi.com/models.md - الوصف: الطرازات والأسعار وفقًا لقائمة النماذج على المنصة
- الرابط:
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من المواد يمكنكم زيارة مركز الوثائق docs.apiyi.com