ملاحظة المؤلف: بعد أن تدخل جلسة WebRTC في GPT-Live-1.1 إلى وضع الانتظار، ينخفض سعر الدقيقة الصوتية من 0.05 دولار إلى 0.02 دولار. يشرح هذا المقال كيفية الإعداد، وكيفية مطابقة الفواتير، وكم يمكن أن توفر مكالمة واحدة فعليًا.
ملخص في جملة واحدة: عندما تستوفي جلسة WebRTC في GPT-Live-1.1 الشروط وتدخل في حالة الانتظار، ينخفض سعر الدقيقة الصوتية من 0.05 دولار إلى 0.02 دولار. أما مقدار التوفير الفعلي فيعتمد على نسبة الوقت الذي تكون فيه الجلسة نشطة مقابل وقت الانتظار، وكذلك على استهلاك نموذج الخلفية والأدوات.
الاستنتاج له شروط مسبقة. لا يمكنك الحصول على سعر الانتظار البالغ 0.02 دولار في الدقيقة إلا داخل جلسة WebRTC مُهيّأة لوضع الانتظار ومتوقف فيها الاستدلال. وبناءً على هذا الشرط، فإن نسبة التوفير تساوي تقريبًا «نسبة مدة الانتظار × 60%». أما إذا كان هناك من يتحدث باستمرار طوال الجلسة، أو إذا كان الاتصال عبر WebSocket أو اتصال SIP الرئيسي، فهذا التخفيض لن تستفيد منه عمليًا. وبالإضافة إلى ذلك، يُحسب الاستدلال في الخلفية واستدعاء الأدوات بشكل منفصل، وفي المكالمات الطويلة غالبًا ما تتجاوز هذه التكلفة تكلفة الصوت نفسها.
هذا ليس خبرًا عاجلًا يعيد نقل جدول الأسعار. يفكك الجزء التالي شروط الفوترة وحقول الإعداد وفق وثائق OpenAI الرسمية، ويقدّم طريقة حسابية يمكن مطابقتها مع الفواتير. جميع أمثلة السيناريوهات الواردة في هذا المقال افتراضية، وتُستخدم فقط لتوضيح طريقة الحساب، ولا تمثل فواتير حقيقية.
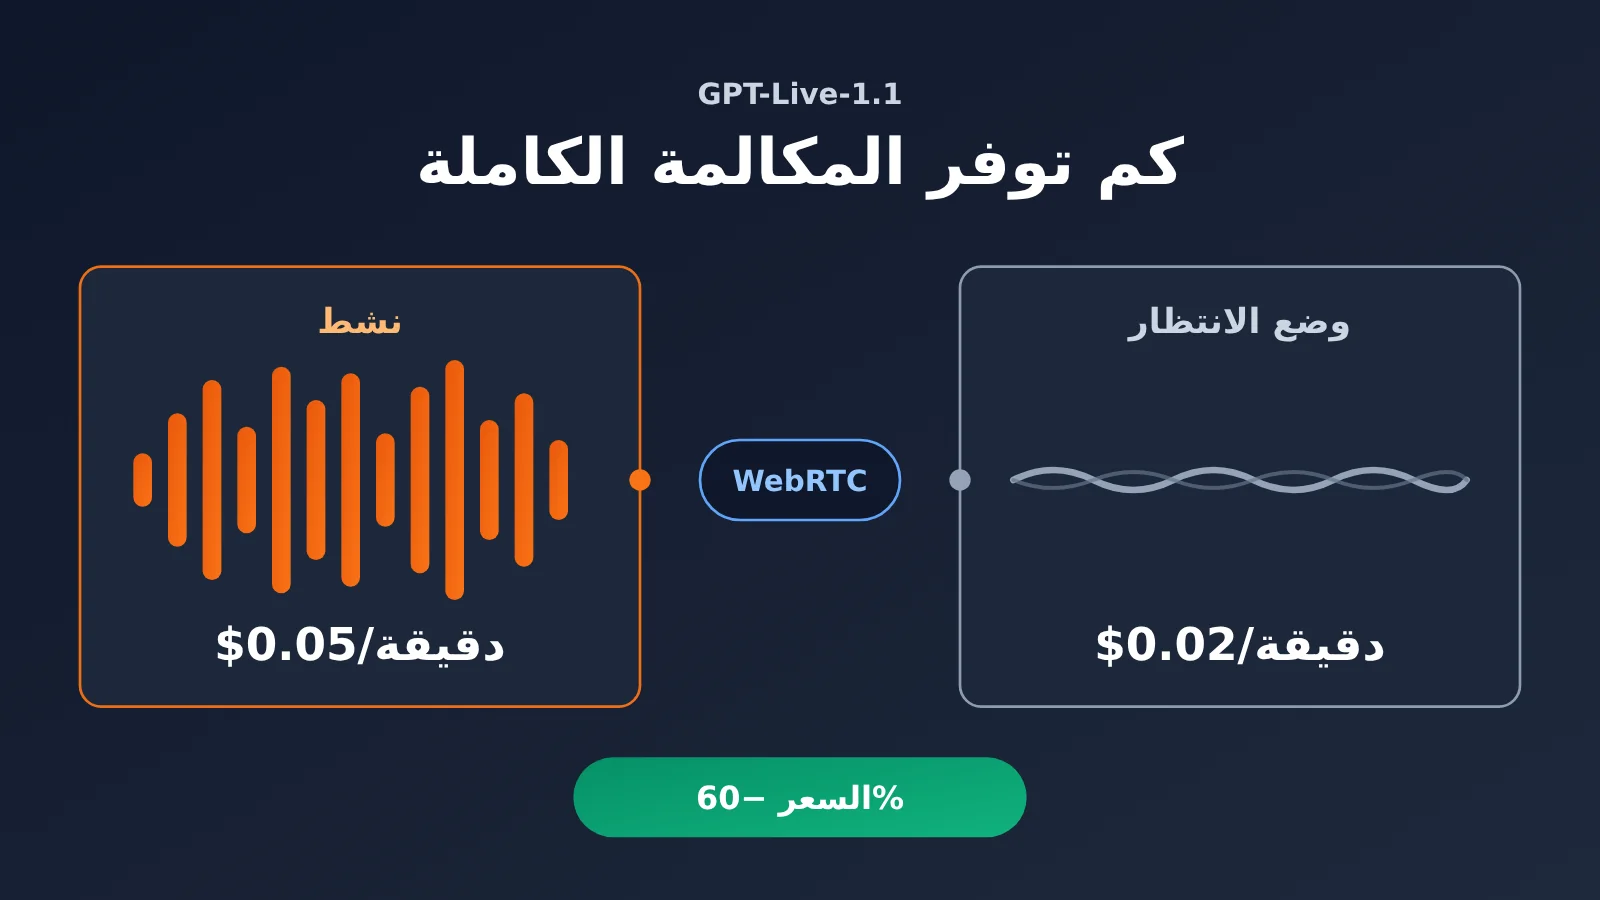
مصطلحات وضع الاستعداد في WebRTC لدى GPT-Live-1.1 (للعلم)
لنوحّد أولاً بعض المصطلحات، فكل ما يتعلق بالفوترة والإعداد لاحقًا سيُبنى على هذه التعريفات:
- WebRTC: مجموعة تقنيات اتصال تنقل الصوت والوسائط الأخرى في الوقت الفعلي بين المتصفح والأجهزة، وهي أيضًا طريقة النقل الوحيدة الصالحة لوضع الاستعداد الأصلي في GPT-Live.
- WebSocket: اتصال ثنائي الاتجاه يبقى مفتوحًا لفترة طويلة. يمكن للتطبيق أن يستخدمه لنقل الصوت أو أحداث الجلسة أو رسائل التحكم الجانبية.
- SIP: بروتوكول شائع في شبكات الهاتف لإنشاء الجلسات والتحكم فيها، وعبره يمر الاتصال الهاتفي في GPT-Live.
- وضع الاستعداد: في هذا المقال يشير تحديدًا إلى حالة الفوترة التي تبقى فيها جلسة WebRTC المستوفية للشروط متصلة، لكنها تتوقف عن الاستدلال.
- الوقت النشط: المرحلة التي تُحاسب فيها بالسعر النشط، وقد تتضمن فترة الهدوء التي تسبق بلوغ شرط الإيقاف المؤقت.
- الاستيقاظ الصوتي: أن تبدأ الخدمة الاستدلال أو تستأنفه بعد اكتشاف أن أحدًا يتحدث.
- عتبة الخمول: تحدد المدة التي تمر دون صوت قبل أن تدخل الجلسة وضع الاستعداد، وهي قابلة للضبط.
- الاتصال الجانبي: اتصال منفصل عن اتصال الصوت الرئيسي، يُستخدم لتحكم الخادم ومراقبة الأحداث، وشكله الشائع هو WebSocket من نوع sideband.
النقاط الأساسية لوضع الانتظار في WebRTC ضمن GPT-Live-1.1
| النقطة | الشرح | القيمة بالنسبة للمطوّر |
|---|---|---|
| سعران مختلفان | الوضع النشط $0.05/دقيقة، وانتظار WebRTC المؤهل $0.02/دقيقة (OpenAI Pricing) | انخفاض سعر الدقيقة بنسبة 60% في أوقات الصمت |
| الفوترة بالثانية | كلا السعرين يُحاسبان بالثانية، دون تقريب إلى دقائق كاملة | حتى التوقفات القصيرة تُحسب ضمن التوفير |
| WebRTC فقط | سعر الانتظار المنخفض الأصلي ينطبق فقط على جلسات WebRTC المُهيّأة للانتظار والتي تم تعليق الاستدلال فيها | عليك مراعاة التكلفة منذ لحظة اختيار وسيلة النقل |
| الخادم الخلفي يُحاسب منفصلاً | استخدام النموذج الخلفي والأدوات يُفوتر على حدة | الانتظار يحسّن بندًا واحدًا فقط في الفاتورة |
| تأخير الدور الأول | بعد الاستيقاظ من الانتظار، قد تكون استجابة الدور الأول للكلام القصير أبطأ | الأمر يتطلب موازنة بين التكلفة والتجربة |
كيف نقرأ مقام نسبة الـ 60% في انتظار GPT-Live-1.1 من جدول الفوترة
لنبدأ بمسألة التاريخ. سجل OpenAI API Changelog هذه التحديث بتاريخ 2026-11-19، بينما تعرض صفحة إعلان الإطلاق في مجتمع مطوّري OpenAI تاريخ 2026-11-20. الفرق يوم واحد، ومن المرجح أن سببه اختلاف في ضبط المنطقة الزمنية، ولذلك سأذكر المصدر عند كل تاريخ يرد في هذا المقال. ووفق صفحة OpenAI Pricing، يبلغ سعر الصوت النشط في كلا طرازَي GPT-Live $0.05/دقيقة، وسعر انتظار WebRTC المؤهل $0.02/دقيقة، مع فوترة بالثانية، بينما يُحاسب استخدام النموذج الخلفي والأدوات بشكل منفصل.
كثيرًا ما يُفهم «انخفاض بنسبة 60%» خطأً على أنه «توفير 60% في المكالمة بأكملها». مقام نسبة الـ 60% هو سعر الدقيقة النشطة: (0.05 − 0.02) ÷ 0.05 = 60%، وهو يصف فقط مقدار انخفاض سعر الدقيقة بعد الانتقال إلى وضع الانتظار. أما نسبة التوفير في المكالمة كاملة، فيجب أن تُضرب أيضًا في نسبة مدة الانتظار من إجمالي مدة الفوترة.
ولنأخذ مثالاً افتراضيًا. في جلسة مدتها 10 دقائق، كانت مدة الفوترة الفعلية 4 دقائق نشطة و6 دقائق في وضع الانتظار، فتكون تكلفة الصوت 4×0.05 + 6×0.02 = $0.32. ولو كانت الدقائق العشر كلها نشطة لبلغت $0.50. وبالمقارنة بين الحالتين، تنخفض تكلفة الصوت بنسبة 36%، وهي بالضبط 60% × نسبة 60% من الوقت الذي قضيته في وضع الانتظار.
| بند الفوترة | السعر (السعر الرسمي من OpenAI) | وحدة الفوترة | هل يتأثر بوضع الانتظار؟ |
|---|---|---|---|
| الصوت النشط | $0.05/دقيقة | بالثانية | نعم، إذ يحل وضع الانتظار محل جزء منه |
| صوت انتظار WebRTC | $0.02/دقيقة | بالثانية | فقط في WebRTC المؤهل |
| رموز النموذج الخلفي | حسب سعر النموذج المختار | حسب الرمز (token) | لا |
| استدعاء الأدوات | حسب سعر الأداة | حسب المرة أو حسب الحجم | لا |
كيفية إعداد وضع الاستعداد في GPT-Live-1.1 WebRTC: من إعدادات الجلسة إلى مطابقة الفواتير
وفقًا لوثيقة OpenAI «Managing GPT-Live sessions»، لا توجد خيارات كثيرة لإعداد وضع الاستعداد في WebRTC، لكن كل خيار منها يؤثر مباشرة في كيفية تقسيم مراحل الفوترة.
| الحقل / الحدث | القيمة أو المعنى | نقطة الإعداد |
|---|---|---|
session.wake_policy.type |
يُضبط على "speech" |
تنتظر الجلسة حتى يُكتشف الكلام لتبدأ الاستدلال، ولا تبدأ الاستدلال بمجرد الاتصال |
session.idle_timeout_s |
عدد صحيح من 5 إلى 60 (بالثواني) | إذا لم يُضبط، يبقى الاستدلال نشطًا باستمرار بعد أول تنشيط |
session.wake_policy.vad_threshold |
من 0 إلى 1، والافتراضي 0.5 (حسب تنظيم طرف ثالث OrcaRouter للوثائق) | ارفع القيمة عند ضوضاء البيئة أو تكرار التنشيط الخاطئ |
session.paused |
يتوقف الاستدلال بعد انتهاء مهلة الخمول | يُسجَّل كبداية لوضع الاستعداد |
session.resumed |
الاستدلال جاهز للاستئناف، ويُفعَّل أيضًا عند أول تنشيط | يُسجَّل كبداية للنشاط |
session.closed |
انتهاء الجلسة، ويشمل usage.seconds النهائي |
يُستخدم لمطابقة الفاتورة |
الخطوات الأربع لتكوين وضع الاستعداد في GPT-Live-1.1
- تفعيل الاستيقاظ الصوتي عند إنشاء جلسة WebRTC: اضبط
session.wake_policy.type = "speech". - ضبط حدّ الخمول: تأخذ
session.idle_timeout_sقيمة صحيحة بين 5 و60. كلما كان الحدّ أقصر، دخلت الجلسة في وضع الاستعداد أبكر، لكن توقّف المستخدم لفترة أطول قليلًا قد يُفعّل الإيقاف المؤقت. - إبقاء مسار الميكروفون نشطًا: يجب أن يظل مسار الميكروفون نشطًا خلال فترة الاستعداد كي تتمكن الخدمة من كشف الكلام والاستيقاظ. يبقى معرّف الاتصال ومعرّف الجلسة دون تغيير، وعند الاستعادة يُستأنف سجلّ المحادثة.
- الاستماع إلى الأحداث وتسجيل الطوابع الزمنية: من خلال
session.pausedوsession.resumedتعرف المرحلة التي تمرّ بها الخدمة على الخادم حاليًا.
فيما يلي مقتطف توضيحي لتكوين الجلسة. مسارات الحقول مأخوذة من الوثائق الرسمية، والبنية الكاملة للطلب تتبع وثيقة OpenAI بعنوان《Create session》:
{
  "session": {
    "wake_policy": {
      "type": "speech",
      "vad_threshold": 0.5
    },
    "idle_timeout_s": 15
  }
}
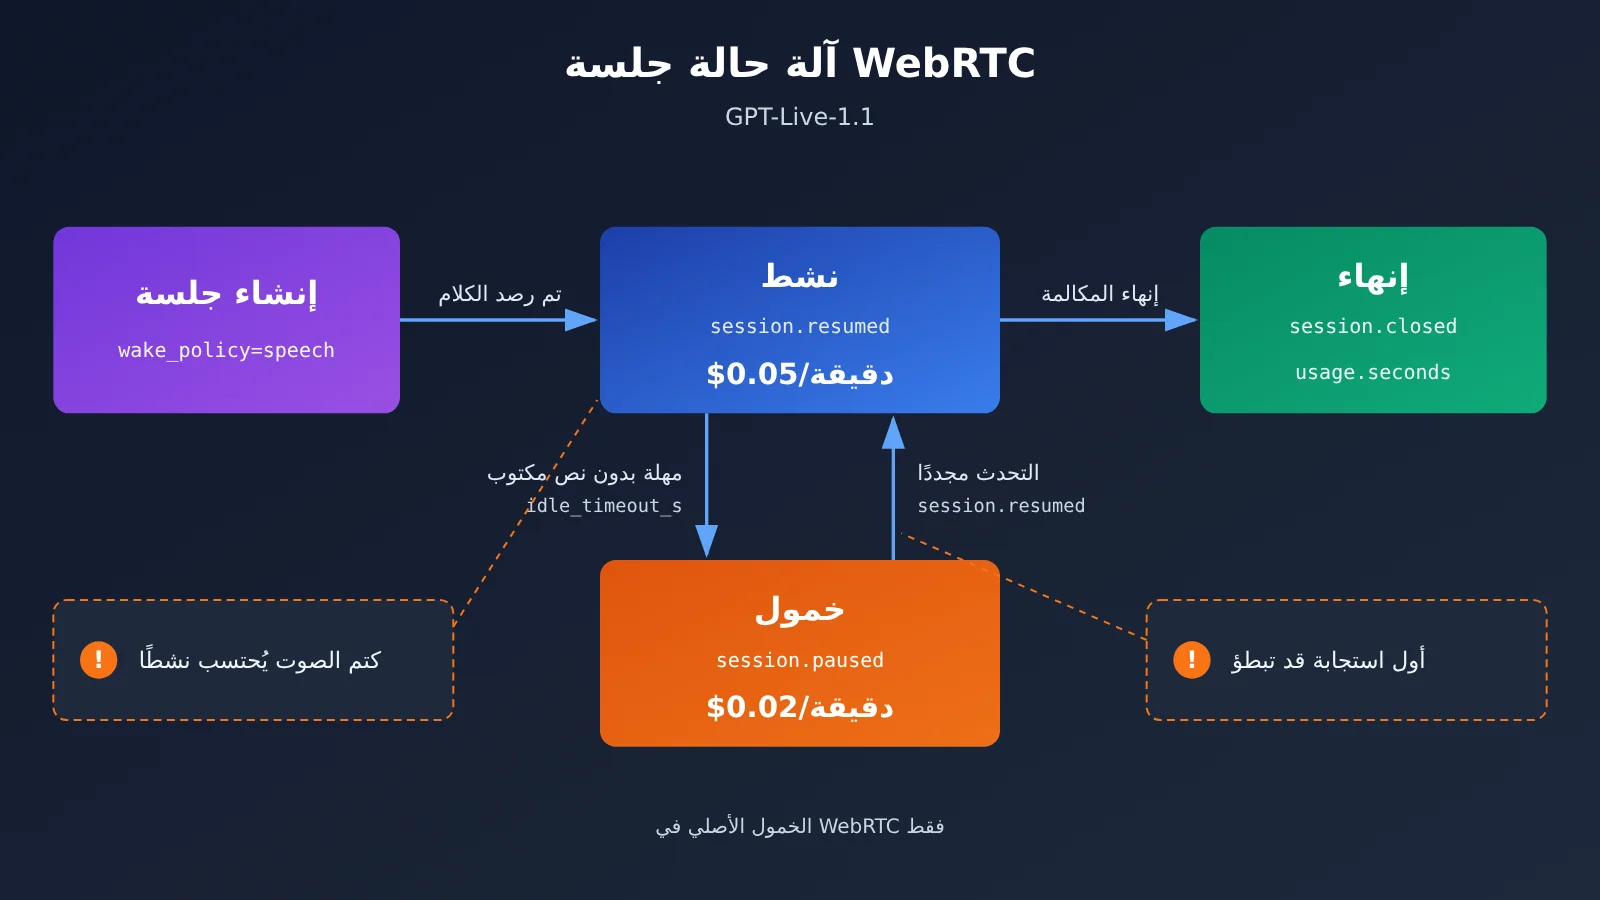
أي فترات هدوء لا تزال تُحتسب بسعر النشاط
هناك ثلاثة أنواع من «الهدوء» هي الأكثر عرضة للخطأ في الحساب:
- فترة الهدوء قبل انقضاء المهلة: من نهاية الجملة الأخيرة حتى انقضاء
idle_timeout_s، تظل الجلسة محسوبة كنشطة. فإذا ضبطت العتبة على 30 ثانية، فإن كل توقف سيُحتسب منه 30 ثانية على الأقل بسعر النشاط. - كتم الميكروفون: عندما ينقر المستخدم على كتم الصوت في التطبيق، لا تدخل الجلسة بسبب ذلك في وضع الاستعداد، بل تبقى نشطة.
- انتظار عودة الخادم: الوقت الذي لا يتوقف فيه الاستدلال، أي أثناء انتظار نتيجة النموذج الخلفي أو الأداة، يُحتسب أيضًا ضمن مرحلة النشاط.
وهناك أيضًا رسوم تهيئة. وفقًا لتنظيم OrcaRouter للوثائق الرسمية، عند إنشاء جلسة WebRTC باستخدام POST /v1/live/sessions، تُحتسب أولًا 15 ثانية من مدة الصوت، ثم تُخصم من رسوم المدة بعد بدء تشغيل الجلسة. وبالنسبة للتطبيقات التي تُنشئ جلسات استكشافية بشكل متكرر، فهذه تكلفة حقيقية، والمرجع الفعلي هو OpenAI Pricing.
مطابقة الفواتير باستخدام أوقات الأحداث
فكرة مطابقة الفواتير هي: تقدير مدة كل مرحلة باستخدام الطوابع الزمنية للأحداث، ثم مقارنة usage.seconds النهائية الموجودة في session.closed بالفاتورة الفعلية. فيما يلي نموذج توضيحي لمسجّل أحداث. أما القناة التي تصل منها الأحداث (قناة بيانات WebRTC أو اتصال جانبي)، فتُحدد وفقًا للوثائق الرسمية:
const timeline = [];
function onServerEvent(evt) {
  if (["session.resumed", "session.paused", "session.closed"].includes(evt.type)) {
    timeline.push({ type: evt.type, t: Date.now() / 1000 });
  }
  if (evt.type === "session.closed") {
    console.log("usage.seconds =", evt.usage?.seconds, timeline);
  }
}
عند الاختبار، شغّل نفس النص ونفس الخادم ونفس التسجيل الصوتي مرة مع «تفعيل الاستعداد» ومرة مع «إيقاف الاستعداد»، وسجّل أيضًا وقت عودة أول مقطع صوتي، لقياس تكلفة التأخير في الجولة الأولى بعد الاستيقاظ.
وهناك تنبيه على مستوى سير العمل أيضًا. نشرت CellCog مجموعة من التجارب المقارنة بنفس الإعدادات: 560 اجتماعًا مُنصَّبًا أولًا، ثم 120 اجتماعًا لإعادة الاختبار. كان النص الأصلي يبدأ بالأسئلة مبكرًا؛ النسخة القديمة أحالت 134 من أصل 160 سؤالًا إلى الخادم، بينما أحالت النسخة 1.1 عددًا قدره 91 سؤالًا، أي نحو 84% مقابل 57%. وفي إعادة الاختبار، بعد نقل السؤال الأول إلى ما بعد الثانية العاشرة، أصبحت النتيجة 48/60 (80%) لكلا النسختين. هذا مجرد أداء إحالة من فريق واحد في اجتماعات قصيرة وبموجهات محددة، ولم تُقس فيه تكلفة الاستعداد، لكنه يوضح نقطة واحدة: عدد الإحالات إلى الخادم يتغير مع النص، بينما رسوم الخادم لا تتأثر بالاستعداد.
حدود تطبيق وضع الانتظار في GPT-Live-1.1 بين WebSocket وSIP
يدعم OpenAI ثلاثة أنواع من اتصالات Live: WebRTC وWebSocket وSIP الهاتفي، لكن الانتظار الأصلي منخفض التكلفة متاح فقط مع WebRTC. وهنا يجب توضيح نقطة مهمة: جلسة WebRTC أو SIP يمكن أن تحمل إلى جانبها اتصال WebSocket جانبيًا لأغراض التحكم والمراقبة، وهذا أمر مختلف تمامًا عن «استخدام WebSocket لنقل الصوت الرئيسي». فالاتصال الرئيسي عبر WebRTC يظل قادرًا على استخدام وضع الانتظار حتى لو كان مرتبطًا باتصال WebSocket جانبي.
| نقل الصوت الرئيسي | الانتظار الأصلي بسعر $0.02 | المعالجة الرسمية لحالة الخمول | ملاحظة التكلفة |
|---|---|---|---|
| WebRTC | ✅ يُطبَّق عند تحقق الشروط | wake_policy + idle_timeout_s | الفترة الهادئة قبل انتهاء المهلة تُحسب ضمن النشاط |
| WebRTC + WebSocket جانبي | ✅ يُطبَّق على الاتصال الرئيسي | الاتصال الجانبي مسؤول فقط عن التحكم والأحداث | الاتصال الجانبي بحد ذاته لا يغيّر مرحلة الفوترة |
| WebSocket رئيسي | ❌ لا سند له | كشف الخمول من جهة التطبيق، ثم الإغلاق وإعادة الإنشاء | إعادة إنشاء الجلسة تترتب عليها تكلفة تهيئة |
| هاتف SIP | ❌ لا سند له | تحقّق أولًا من تأثير إغلاق الجلسة على المكالمة الواردة | تُحسب مدة الحفاظ على المكالمة ضمن الميزانية النشطة |
طريقة التعامل مع WebSocket الرئيسي: إدارة حالة الخمول في جانب التطبيق، وتتبّع دخول الصوت وخروجه وحالة التشغيل والمهام التي ينتظر الخادم إتمامها. ولا تستدعي session.close وتنتظر session.closed إلا بعد فترة صمت طويلة و عندما يكون قطع الاتصال مسموحًا به. وعندما يعود المستخدم تُعيد إنشاء الجلسة، ويمكنك إما تنفيذ fork على الجلسة القديمة إن كانت مسموحًا بحفظها وسجلها مكتملًا، وإما استعادة السياق من الحالة النصية التي حفظها تطبيقك بنفسه. وإذا كنت مفعّلًا للاستيقاظ الصوتي المحلي، فخزّن مؤقتًا الصوت في البداية حتى لا تُفقد كلمات أثناء إنشاء الاتصال.
طريقة التعامل مع SIP: إغلاق الجلسة قد يؤثر على اتصال المكالمة الواردة نفسه، لذلك لا يمكن اعتبار «إعادة الاتصال بعد الإغلاق» بمثابة انتظار في المكان. وإذا كان لا بد من بقاء المكالمة الهاتفية مفتوحة، فدع التطبيق أو نظام الهاتف يتولى تدفق الانتظار، واحسب تكاليف الصوت النشط لدى OpenAI ضمن الميزانية. وهناك بديل آخر هو بناء جسر وسائط خاص بك، بحيث تستخدم وضع الانتظار في WebRTC فعليًا على جانب OpenAI وتتحقق منه. كل ما سبق حدود تنفيذية على مستوى النقل وحالة الجلسة، ولا يوجد أي سند يشير إلى أن النقل غير WebRTC يمكنه أيضًا الاستفادة من سعر الانتظار $0.02.
كم يمكن أن توفر مكالمة كاملة: بداية سريعة مع تكلفة الاستعداد في GPT-Live-1.1
تقدير التكلفة بأبسط صورة
الدالة التالية تحوّل قاعدة «نسبة التوفير = نسبة الاستعداد × 60%» إلى كود، والمدخلات تُحسب بالثواني:
ACTIVE, STANDBY = 0.05, 0.02  # السعر الرسمي من OpenAI، دولار/دقيقة

def voice_cost(active_s: float, standby_s: float) -> tuple[float, float]:
    with_standby = active_s / 60 * ACTIVE + standby_s / 60 * STANDBY
    all_active = (active_s + standby_s) / 60 * ACTIVE
    return round(with_standby, 4), round(1 - with_standby / all_active, 4)

print(voice_cost(240, 360))      # 10 دقائق: نشط 4 دقائق + استعداد 6 دقائق
print(voice_cost(60, 30))        # 90 ثانية: نشط 60 ثانية + استعداد 30 ثانية
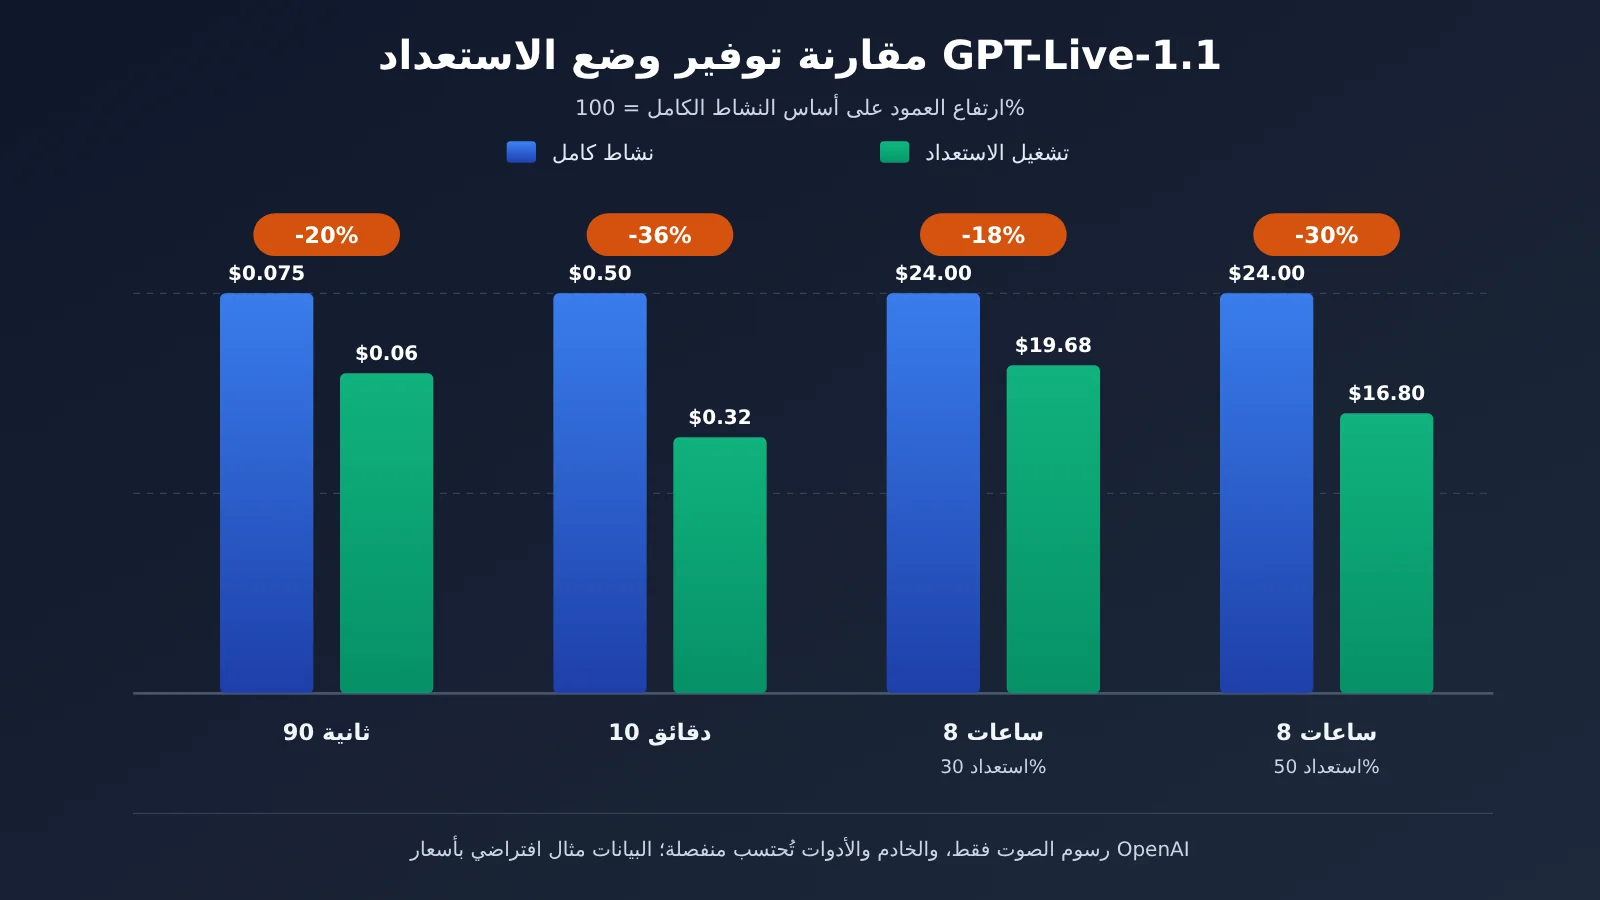
| السيناريو المفترض | نشط / استعداد | تكلفة الصوت مع تفعيل الاستعداد | تكلفة الصوت بنشاط طوال المدة | نسبة انخفاض تكلفة الصوت |
|---|---|---|---|---|
| المثال الرسمي (كما نقله OrcaRouter) | 60 ثانية / 30 ثانية | $0.06 | $0.075 | 20% |
| استشارة 10 دقائق (افتراض هذا المقال) | 4 دقائق / 6 دقائق | $0.32 | $0.50 | 36% |
| حراسة 8 ساعات، 30% استعداد (مثال OrcaRouter) | 5.6 ساعة / 2.4 ساعة | $19.68 | $24.00 | 18% |
| حراسة 8 ساعات، 50% استعداد (مثال OrcaRouter) | 4 ساعة / 4 ساعة | $16.80 | $24.00 | 30% |
الجدول يحسب تكلفة الصوت فقط. وفي النشر الفعلي، غالبًا ما تكون تكاليف النموذج الخلفي والأدوات بندًا أكبر في الفاتورة. ويذكر مقال OrcaRouter أن وثائق OpenAI توصي بالبدء بـ gpt-6-luna، ثم التحول إلى gpt-6-sol للمهام الخلفية المعقدة، وكلاهما يُحاسَب بالتوكن وفق السعر القياسي. وفي المكالمات الطويلة، من الممكن تمامًا أن تتجاوز تكاليف الواجهة الخلفية تكلفة الصوت.
💡 نصيحة للتقدير: كل ما في الجدول أعلاه أمثلة افتراضية مشتقة من الأسعار الرسمية، والفاتورة الحقيقية يُرجَع فيها إلى
usage.secondsوإلى فاتورة المنصة. وإذا كنت تقيّم في الوقت نفسه حلول صوت فورية أخرى، يمكنك استخدام رصيد الاختبار المجاني من APIYI على apiyi.com لمقارنة نماذج Realtime التي تُحاسَب بالتوكن باستخدام السيناريو الصوتي نفسه.
اختيار طبقة الصوت ونموذج الخادم ومدخل API لـ GPT-Live-1.1 بشكل منفصل
حتى تاريخ البحث (2026-11-20)، فإن واجهة الجلسات المخصصة لـ GPT-Live-1.1 وتعرفة الفوترة بالدقيقة تأتيان من OpenAI الرسمية. ووفقًا لتجميع طرف ثالث OrcaRouter، لا يمكن الوصول إلى GPT-Live إلا عبر نقطة نهاية Live sessions، ولا يدعم نقاط نهاية أخرى مثل Chat Completions وResponses وRealtime.
من جهة APIYI، لا توجد في سجل النماذج العام (المُنشأ في 2026-11-20 15:17، UTC+8، بإجمالي 289 سجلًا) أي سجل لـ gpt-live-1 أو gpt-live-1.1، ولا يوجد في الأرشيف الديناميكي أي إعلان إطلاق مقابل. لذلك، لا يمكن افتراض أن APIYI توفر بالفعل سلسلة GPT-Live أو /v1/live/sessions أو الفوترة بالدقيقة. ولا يمكن استنتاج دعمها لمثل هذه الجلسات الصوتية المخصصة لمجرد أن APIYI متوافقة مع واجهات OpenAI.
خيارات الصوت في الوقت الفعلي المنشورة بالفعل في APIYI هي منتج Realtime مستقل:
| الخيار | طريقة الوصول | طريقة الفوترة | وضع الاستعداد / WebRTC / SIP | المنصة المتاحة |
|---|---|---|---|---|
| GPT-Live-1.1 | /v1/live/sessions، WebRTC / WebSocket / SIP |
نشط $0.05، استعداد $0.02 لكل دقيقة، ويُحسب الخادم الخلفي بشكل منفصل | WebRTC يدعم وضع الاستعداد الأصلي | OpenAI الرسمية |
| gpt-realtime-2.1 | /v1/realtime WebSocket |
إدخال/إخراج الصوت $32/$64 لكل مليون token صوتي | WebRTC وSIP غير متاحين | APIYI apiyi.com |
| gpt-realtime-2.1-mini | /v1/realtime WebSocket |
إدخال/إخراج الصوت $10/$20 لكل مليون token صوتي | WebRTC وSIP غير متاحين | APIYI |
تأتي أسعار Realtime في APIYI من توثيقها (تشير الصفحة إلى مطابقة الحسابات في 2026-09-14)، وأبعاد الفوترة هي token النص والصوت والصور، ولا يمكن تحويلها مباشرة إلى الفوترة بالدقيقة في GPT-Live.
مثال اتصال مبسّط بـ APIYI Realtime
import os, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # الواجهة الموحدة لـ APIYI
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1"

async def main():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        print(await ws.recv())  # طباعة أول حدث قادم من الخادم

asyncio.run(main())
عرض الكود الكامل: الإغلاق من جانب التطبيق عند خمول WebSocket الرئيسي
import os, time, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # مدخل APIYI Realtime
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1-mini"
IDLE_LIMIT_S = 45          # حد الخمول على مستوى التطبيق، قابل للتعديل حسب متطلبات العمل
pending_backend_tasks = 0  # يديره التطبيق بنفسه: عدد المهام غير المكتملة في الواجهة الخلفية
is_playing = False         # يديره التطبيق بنفسه: هل يجري تشغيل الصوت الآن

async def run_session():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    last_activity = time.monotonic()
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        async def reader():
            nonlocal last_activity
            async for _ in ws:
                last_activity = time.monotonic()  # أي حدث من الخادم يُعدّ نشاطًا

        task = asyncio.create_task(reader())
        while True:
            await asyncio.sleep(1)
            idle = time.monotonic() - last_activity
            busy = pending_backend_tasks > 0 or is_playing
            if idle > IDLE_LIMIT_S and not busy:
                print(f"空闲 {idle:.0f}s,主动关闭,用户回来后再重建")
                await ws.close()
                break
        task.cancel()

asyncio.run(run_session())
تنسيق الأحداث ومعاملات الاستعلام يخضعان لوثائق APIYI بعنوان «Realtime الصوتي الفوري (WebSocket)». وأسلوب الإغلاق ثم إعادة الإنشاء هذا لا يفعل شيئًا سوى إلغاء الاتصالات الخاملة على مستوى التطبيق، ولا يقابل أي سعر رسمي مخفّض لوضع الانتظار.
🚀 توصية للربط: في سيناريوهات WebRTC التي تحتاج إلى وضع الانتظار الأصلي في GPT-Live، اتصل مباشرةً بـ OpenAI في الوقت الحالي. أما إذا كنت تريد بناء نموذج أولي للصوت الفوري بسرعة عبر WebSocket وإدارة عدة نماذج بطريقة موحّدة، فيمكنك أولاً تشغيل المسار كاملًا باستخدام
gpt-realtime-2.1-miniعلى APIYI عبر apiyi.com، ثم تحديد الخطة الرسمية بناءً على التكلفة.
الأسئلة الشائعة FAQ
س1: ما المقصود بوضع الانتظار عبر WebRTC في GPT-Live-1.1؟
هذه إحدى حالات الفوترة في جلسات WebRTC: فبعد إعداد الاستيقاظ الصوتي وحدود الخمول، تتوقف الجلسة عن الاستدلال خلال الفترات التي لا يوجد فيها صوت، لكن الاتصال يبقى قائمًا ويُحتسب بسعر $0.02/دقيقة. وعندما يتحدث أحدهم مرة أخرى، يُستأنف الاستدلال مع الاحتفاظ بسجل المحادثة السابق.
س2: هل خفض السعر بنسبة 60% يعني أن المكالمة كاملة أصبحت أرخص بنسبة 60%؟
لا. النسبة 60% هي مقدار انخفاض سعر الدقيقة في وضع الانتظار مقارنة بسعر الدقيقة في وضع النشاط. أما انخفاض تكلفة الصوت في المكالمة كاملة فيساوي نسبة وقت الانتظار مضروبة في 60%: فإذا كان الانتظار يشغل نصف الوقت، تُوفّر نحو 30% من تكلفة الصوت. ولا تتأثر تكاليف الخادم الخلفي والأدوات.
س3: متى أصبح GPT-Live-1.1 متاحًا عبر API؟
تاريخ الإدخال في OpenAI API Changelog هو 2026-11-19، بينما تعرض صفحة الإعلانات في مجتمع مطوري OpenAI التاريخ 2026-11-20، وقد يعود الفرق إلى اختلاف في المناطق الزمنية. وكان GPT-Live-1 قد أصبح متاحًا رسميًا في وقت سابق بتاريخ 2026-09-10 (وفقًا لما جمعه OrcaRouter).
س4: في أي السيناريوهات يكون تفعيل وضع الانتظار هو الأكثر فائدة؟
– **انتظار العملاء في طابور خدمة العملاء**: يبقى العميل على الخط لكنه لا يتحدث لفترات طويلة.
– **مساعد داخل السيارة أو على المكتب**: اتصال دائم واستيقاظ من حين لآخر.
– **مقاعد المناوبة الطويلة**: كلما ارتفعت نسبة وقت الانتظار، زاد التوفير.
أما الجلسات القصيرة المكثفة بالحوار فنسبة الانتظار فيها منخفضة، فضلًا عن أنها تتحمل كلفة بطء الجولة الأولى بعد الاستيقاظ، لذا تكون الفائدة محدودة.
س5: هل يمكن استدعاء GPT-Live-1.1 عبر APIYI؟
حتى 2026-11-20، لا توجد سلسلة GPT-Live في سجل النماذج العام لدى APIYI، ولا يوجد أي إعلان عن إطلاقها. إذا كنت بحاجة إلى صوت فوري، يمكنك استخدام `gpt-realtime-2.1` / `gpt-realtime-2.1-mini` المنشورين علنًا على APIYI apiyi.com، عبر الاتصال بـ WebSocket على `/v1/realtime` والفوترة حسب رموز الصوت. ويحصل المستخدمون الجدد على حصة تجريبية مجانية يمكنهم التحقق بها أولًا.
س6: ما القيود المعروفة لوضع الانتظار في GPT-Live-1.1؟
– يقتصر على WebRTC فقط؛ فلا يوجد سند لسعر $0.02 في WebSocket والاتصال الرئيسي عبر SIP.
– تُحتسب فترة الصمت قبل انتهاء المهلة، وكتم الميكروفون، ووقت انتظار الخادم الخلفي، ضمن فئة النشاط.
– قد تكون الجولة الأولى من الرد أبطأ بعد الاستيقاظ عند وجود مقطع صوتي قصير.
– لا تتوفر حاليًا بيانات طرف ثالث عن استيقاظ وضع الانتظار ومطابقة الفواتير، كما أن الدرجات في تصنيف Artificial Analysis تخص GPT-Live-1 فقط ولا يمكن تعميمها على 1.1.
النقاط الأساسية لخاصية الانتظار في WebRTC عبر GPT-Live-1.1
- سعر الوحدة: الجلسة النشطة $0.05/الدقيقة، ووضع الانتظار في WebRTC المؤهل $0.02/الدقيقة، والفوترة تُحتسب بالثانية في الحالتين.
- طريقة الحساب: نسبة انخفاض تكلفة الصوت للمكالمة كاملة تساوي نسبة وقت الانتظار مضروبة في 60%، وليست 60% ثابتة.
- الإعداد: استخدم
wake_policy.type="speech"معidle_timeout_sبين 5 و60 ثانية، مع إبقاء مسار الميكروفون نشطًا. - مراجعة الفاتورة: اعتمد على الطوابع الزمنية لـ paused/resumed لتقدير مدة كل مرحلة، ثم قارن
usage.secondsبالفاتورة. - الحدود: لا يمكن إعادة إنشاء WebSocket وSIP إلا بعد إغلاقهما من جانب التطبيق، لذا لا يمكن اعتبارهما انتظارًا منخفض التكلفة.
- المدخل: يتطلب GPT-Live اتصالاً مباشرًا بـ OpenAI، ويمكن تجربة نماذج Realtime للصوت الفوري عبر WebSocket على APIYI apiyi.com.
الخلاصة
النقاط الأساسية لخاصية الانتظار في WebRTC عبر GPT-Live-1.1:
- التخفيض مشروط: تُحتسب بـ $0.02/الدقيقة فقط جلسات WebRTC التي ضُبط فيها وضع الانتظار وتوقف فيها الاستدلال.
- التوفير يعتمد على النسبة: إذا كانت المكالمة 10 دقائق منها 6 دقائق انتظار، تنخفض تكلفة الصوت من $0.50 إلى $0.32، أي توفير نحو 36%.
- الفاتورة تُقرأ ككل: تُحتسب النماذج الخلفية والأدوات بشكل منفصل، ووضع الانتظار يحسّن بندًا واحدًا فقط من بنودها.
أنصح بالبدء بإجراء اختبار A/B بنفس النص الحواري مع تشغيل وضع الانتظار وإيقافه، وتسجيل أوقات الأحداث وزمن التأخير في الجولة الأولى، ثم تحديد عتبة الخمول المناسبة. وإذا كنت ما تزال تقارن بين حلول مختلفة للصوت الفوري، فمن المستحسن تشغيل نموذج Realtime أولاً عبر APIYI apiyi.com، ومقارنة التكلفة والتجربة باستخدام الحصة المجانية.
📚 المراجع
-
تسعير OpenAI API: أسعار GPT-Live في الوضع النشط والوضع الخامل
- الرابط:
developers.openai.com/api/docs/pricing - الوصف: مصدر السعرين الرسميين $0.05 و $0.02
- الرابط:
-
إدارة جلسات GPT-Live في OpenAI: إعدادات الوضع الخامل وشرح الأحداث
- الرابط:
developers.openai.com/api/docs/guides/live-conversations - الوصف: wake_policy و idle_timeout_s وحدود النقل
- الرابط:
-
سجل تغييرات OpenAI API: بند تحديث GPT-Live-1.1
- الرابط:
developers.openai.com/api/docs/changelog - الوصف: تاريخ البند 2026-11-19
- الرابط:
-
تجربة المقارنة من CellCog: GPT-Live-1.1 مقابل GPT-Live-1
- الرابط:
cellcog.ai/blog/gpt-live-1-1-vs-gpt-live-1/ - الوصف: بيانات التفويض من 680 اجتماعًا قائمًا على سيناريو نصي، دون احتساب تكلفة الوضع الخامل
- الرابط:
-
تحليل إصدار OrcaRouter: تحليل فوترة الوضع الخامل في GPT-Live-1.1
- الرابط:
orcarouter.ai/blog/gpt-live-1-1-api-release-standby-pricing - الوصف: نقل المثال الحسابي الرسمي وحساب وردية العمل لمدة 8 ساعات
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا أن تتواصلوا معنا عبر الصفحة الرئيسية لموقع APIYI، وللاطلاع على تفاصيل تكامل Realtime يمكنكم مراجعة مركز الوثائق docs.apiyi.com