الملخص: عند اختيار نموذج لتطوير الألعاب، ينبغي النظر إلى معدل النجاح في المهمة نفسها، ووقت التنفيذ، وتكلفة API، وتكلفة الإصلاح اليدوي؛ أما جداول الأسعار والمعايير البرمجية العامة فليست سوى أدلة مساعدة.
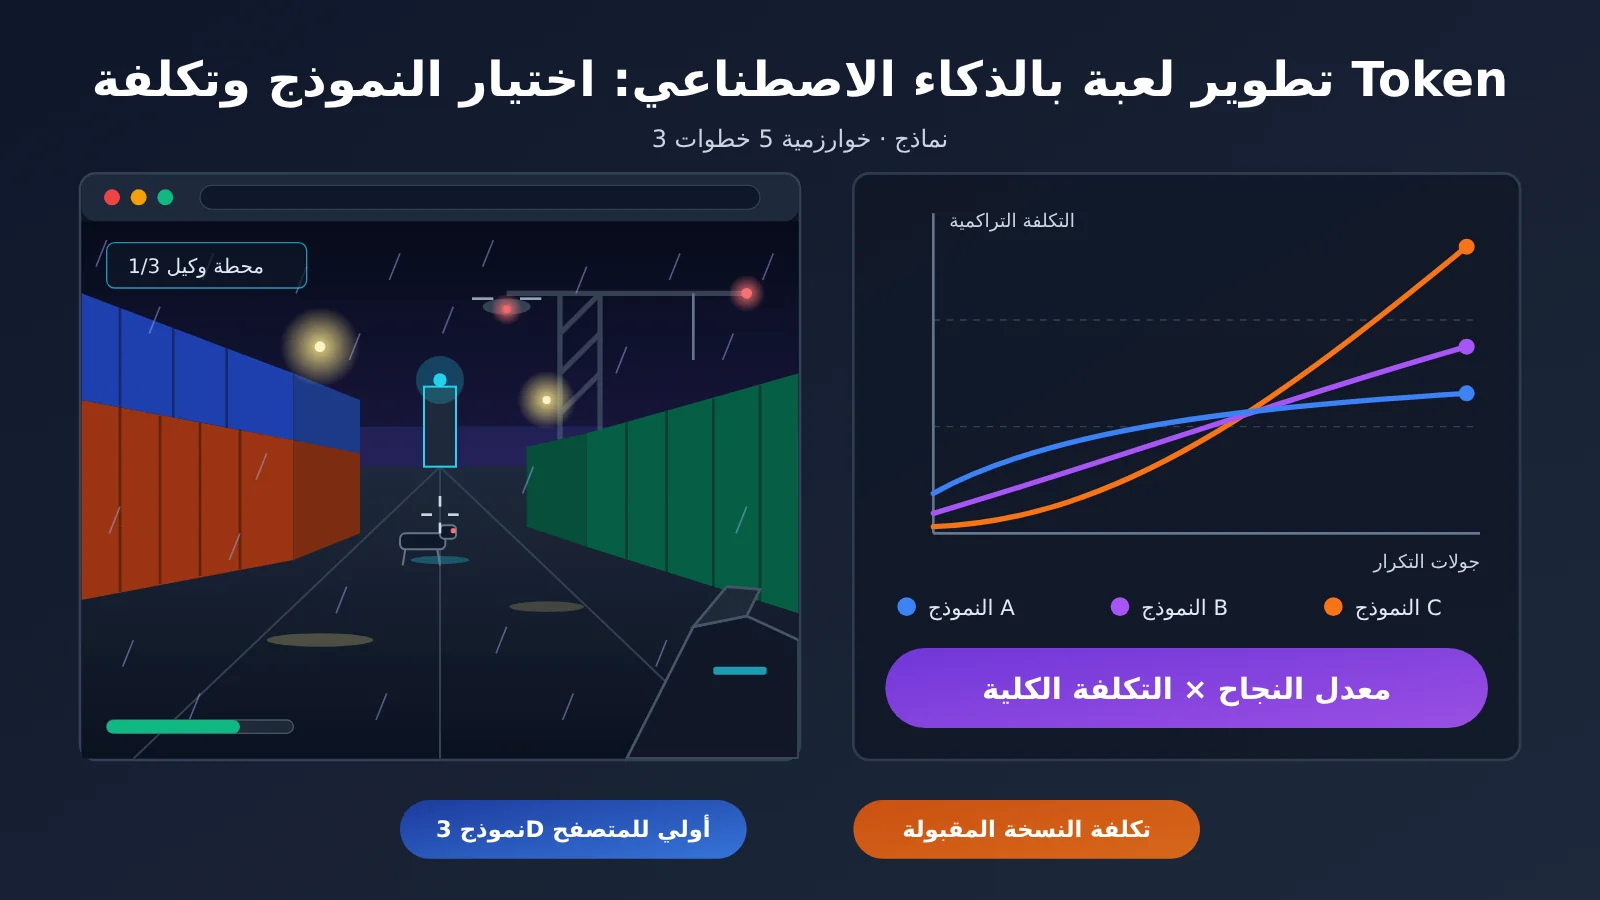
الخلاصة أولاً: عندما تترك الذكاء الاصطناعي يطوّر لعبة بشكل مستقل، فإن ما ينبغي مقارنته في النهاية هو التكلفة الشاملة من البداية إلى النهاية لإنتاج نسخة قابلة للتسليم، وليس السعر المعلن لكل مليون توكن. في حالة Saltline، استخدم Claude Fable 5.2 نحو 8 ساعات، ونحو 445 مليون توكن إدخال و2.7 مليون توكن إخراج، لينتج نموذجًا أوليًا للعبة تصويب ثلاثية الأبعاد تعمل في المتصفح. وقدّر المطوّر التكلفة وفق أسعار API بنحو 550 دولارًا، وكان معظم الإدخال قد مرّ عبر ذاكرة التخزين المؤقت. حتى 16 نوفمبر 2026، بلغ الفارق الأقصى في سعر الوحدة القياسي لـ API بين النماذج الثلاثة نحو 5 أضعاف، لكن النموذج الأرخص سعرًا قد يحتاج إلى دورات أكثر، ما قد يجعل التكلفة الإجمالية أعلى. لذلك فإن الطريقة الموثوقة لاختيار النموذج هي: تسليم المهمة نفسها إلى النماذج المرشحة، وتشغيلها عدة مرات، وحساب معدل النجاح والتوكن والوقت المستغرق وحجم الإصلاح اليدوي، ثم حساب «تكلفة كل نسخة مقبولة».
نظرة على المحتوى: يفكك القسم الأول بنية فاتورة التوكن في تجربة تطوير لعبة بالذكاء الاصطناعي باستخدام Saltline. ويقارن القسم الثاني الأسعار الرسمية للنماذج الثلاثة، ويوضح تأثير التخزين المؤقت على التكلفة الإجمالية. ويعرض القسم الثالث ما يمكن أن يوضحه كل من SWE-bench Verified وAider Polyglot وتقييمات NIST التاريخية. ويقدم القسم الرابع خطة تقييم متخصصة وقابلة للتكرار لتطوير الألعاب مع الشيفرة البرمجية. ويحوّل القسم الخامس النتائج إلى استراتيجية لاختيار النموذج.
To Know: مصطلحات اختيار نماذج تطوير ألعاب الذكاء الاصطناعي
| المصطلح | الشرح |
|---|---|
| رمز الإدخال (Input Token) | مقياس المحتوى المُرسل إلى النموذج لمعالجته، ويشمل الموجه وملفات الشفرة ونتائج الأدوات المُرجَعة وغيرها |
| رمز الإخراج (Output Token) | مقياس المحتوى الذي يولّده النموذج، مثل الشفرة والنصوص التوضيحية ومعاملات استدعاء الأدوات |
| قراءة التخزين المؤقت | إعادة استخدام سياق مخزّن مسبقًا، وتكلفتها أقل بكثير من الإدخال العادي |
| كتابة التخزين المؤقت | تكلفة تخزين السياق في الذاكرة المؤقتة لأول مرة، وعادة ما تكون أعلى قليلًا من الإدخال العادي |
| SWE-bench Verified | معيار يضم 500 مهمة هندسة برمجيات حقيقية من مشاريع مفتوحة المصدر خضعت للتحقق البشري |
| Aider Polyglot | تقييم لتعديل الشفرة يغطي 6 لغات برمجة و225 تمرينًا |
| Harness | إطار تنفيذ ينظّم النموذج والأدوات وحلقة المهام، مثل سقالة الوكيل (Agent scaffolding) |
| معدل نجاح المهام | نسبة المهام المكتملة وفق معايير القبول المحددة مسبقًا |
| التكلفة من البداية إلى النهاية | مجموع تكاليف استدعاء النموذج وتنفيذ الأدوات والعمل البشري لإنجاز المهمة بأكملها |
| الإصلاح اليدوي | تعديلات بشرية تُجرى للوصول بالنتائج المولدة إلى معايير القبول |
| التوليد الإجرائي | توليد الأشكال الهندسية والأنسجة والأصوات بالشفرة والدوال الرياضية بدلًا من استيراد ملفات الأصول |
| Shader | برنامج يعمل على وحدة معالجة الرسوميات (GPU) لحساب الألوان والإضاءة والمواد وغيرها من التأثيرات البصرية |
1 حالة تكلفة تطوير لعبة مستقلة بالذكاء الاصطناعي: كم أنفقت Saltline من التوكنات
1.1 ما حجم لعبة Saltline؟
في 9 نوفمبر 2026، نشر المهندس في Anthropic، Felix Rieseberg، تجربة برمجية باستخدام Claude Fable 5.2. أعطى النموذج مُوجّهًا واحدًا فقط، وطلب منه صنع لعبة إطلاق نار صغيرة الحجم بمنظور الشخص الأول، ببصريات قريبة قدر الإمكان من ألعاب AAA، دون تقديم أي ملاحظات بشرية طوال العملية. وكانت النتيجة Saltline: لعبة إطلاق نار ثلاثية الأبعاد تعمل مباشرة في المتصفح، تدور أحداثها في ميناء حاويات ليلة ممطرة، حيث يجب على اللاعب إغلاق ثلاث محطات لإعادة إرسال الإشارة ثم الانسحاب، مع أعداء من المسيّرات الدورية الجوية والكلاب الآلية الأرضية.
من حيث الحجم، Saltline نموذج أولي قابل للعب، للاعب واحد ومرحلة واحدة. وهنا يمثل “3A” هدف التجربة والمقارنة البصرية، أي لوصف أسلوب الصورة، لكن حجمه أصغر بكثير من منتجات 3A التجارية. أما “几猫·国产3A大作” المتداولة في الصين فهي نسخة صينية من Saltline أو نسخة معاد تعبئتها؛ جاء الاسم من عملية التداول، ولا تشير إلى الجهة المطورة.
1.2 الوقت والرموز والتكلفة بحسب رواية المطوّر
البيانات التالية مأخوذة من منشورات المطوّر نفسه على منصة X، وهي تقديرات شخصية لم تخضع لتدقيق طرف ثالث:
- وقت التطوير: نحو 8 ساعات
- رموز الإدخال: نحو 445 مليون رمز، استُخدم كثير منها عبر التخزين المؤقت
- رموز الإخراج: نحو 2.7 مليون رمز
- التكلفة المقدّرة وفق تسعير API: نحو 550 دولارًا
- طريقة التطوير: موجّه واحد، من دون تكرارات تعتمد على ملاحظات بشرية
هذا المبلغ هو تكلفة إنشاء لمرة واحدة. بعد توليد ملفات اللعبة، تعمل هذه الملفات محليًا داخل متصفح اللاعب، ولا يستدعي اللاعب Claude API أثناء اللعب؛ لذلك لا يمكن توزيع مبلغ 550 دولارًا على أساس أنه «تكلفة الذكاء الاصطناعي لكل لاعب».
1.3 تفصيل الفاتورة باستخدام سعر الوحدة الرسمي
وفق السعر القياسي الرسمي لـ Claude Fable 5.2، أي 40 دولارًا لكل مليون رمز إخراج، فإن 2.7 مليون رمز إخراج تساوي نحو 108 دولارات. ويقابل المبلغ المتبقي، نحو 440 دولارًا، جانب الإدخال، بما يشمل الكتابة إلى التخزين المؤقت والقراءة منه والإدخال العادي. ولم ينشر المطوّر أعداد كل فئة من هذه الفئات الثلاث، لذا لا يمكن تقسيم المبلغ أكثر من ذلك.
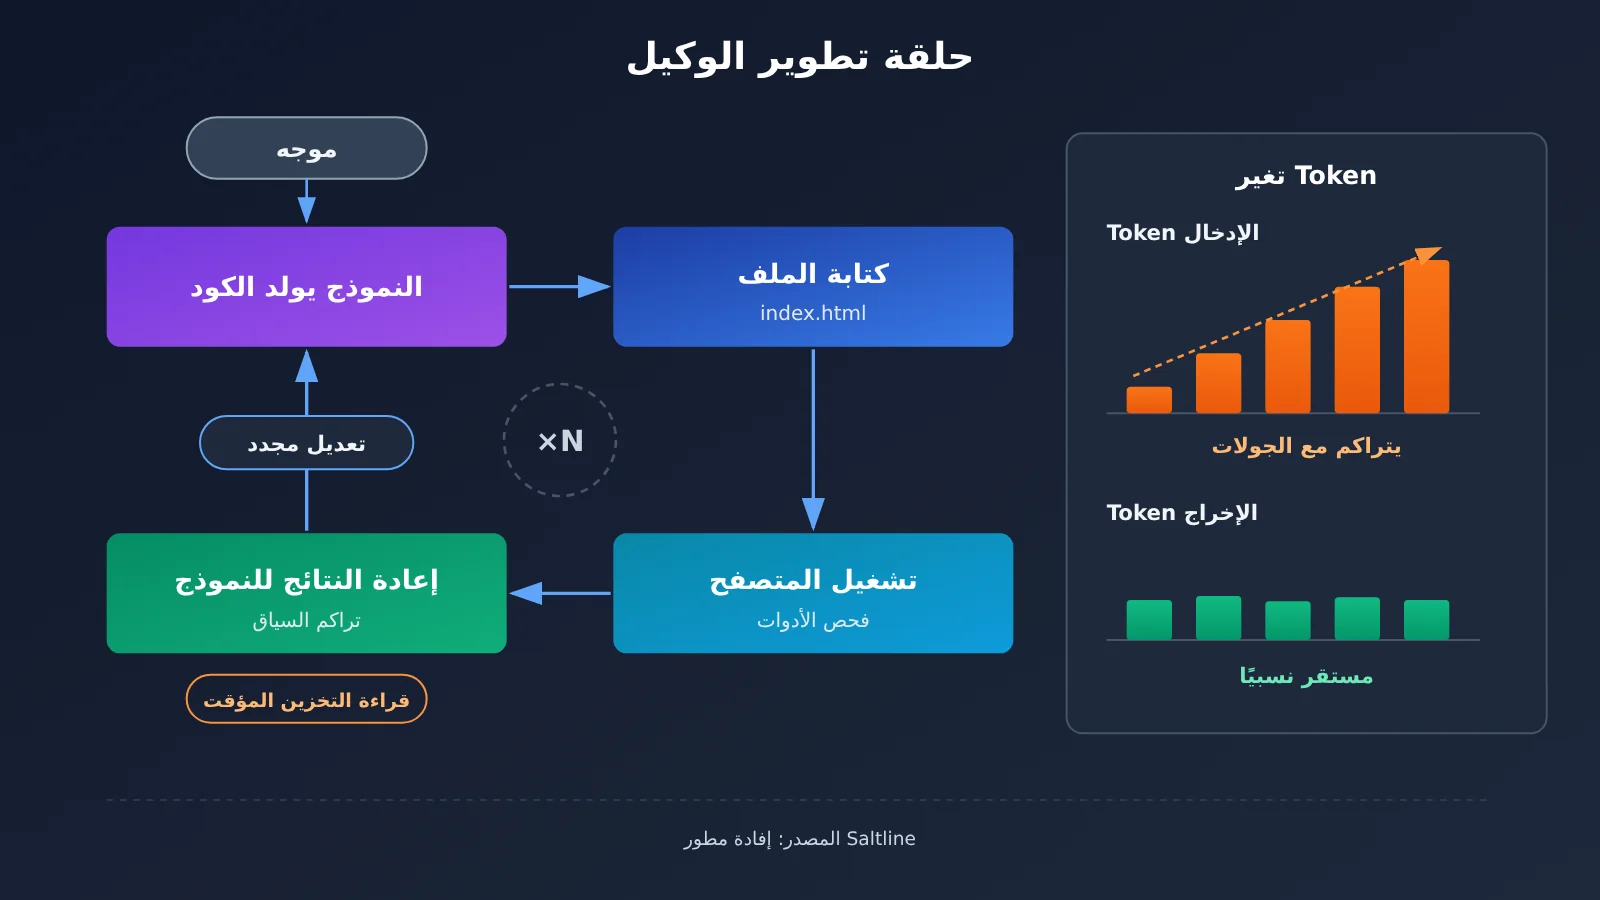
تكفي مقارنة قيمتين حدّيتين لإظهار أثر التخزين المؤقت: لو احتُسبت رموز الإدخال البالغة 445 مليونًا كلها بسعر الإدخال العادي البالغ 8 دولارات، لكانت التكلفة نحو 3,560 دولارًا؛ ولو احتُسبت كلها بسعر القراءة من التخزين المؤقت البالغ 0.20 دولار، لكانت نحو 89 دولارًا. ويقع التقدير الفعلي بين القيمتين، ويقترب بوضوح من الحد الأدنى. وهذا يعني أنه في مهام تطوير الوكيل الذكي طويلة التشغيل، تحدد نسبة إصابة التخزين المؤقت في جانب الإدخال ترتيب حجم الفاتورة، بينما يبقى تأثير سعر وحدة الإخراج ثانويًا نسبيًا.
1.4 لماذا يمكن لملف بحجم 1.4MB أن يستهلك 445 مليون توكن؟
تبلغ النسخة المستقلة بصيغة HTML من Saltline نحو 1.43MB (1,425,707 بايت). يوضح المطوّر أن المجسمات والخامات في اللعبة كلها كود؛ فالبنية الهندسية تُبنى برمجيًا، وملمس السطح يُحسب عبر Shader، والصوت يُولّد برمجيًا أيضًا، من دون ملفات صور أو أصول مجسمات ثلاثية الأبعاد منفصلة.
الناتج صغير، لكن العملية طويلة جدًا. خلال 8 ساعات، ظل الوكيل يقرأ مرارًا ملفات الكود المتنامية، ويشغّل الأدوات، ويفحص النتائج ثم يعدّلها؛ وفي كل جولة كان يعيد إرسال كمية كبيرة من السياق إلى النموذج. في النهاية، جاء استهلاك التوكنات أساسًا من هذه الحلقة، لا من طول الملف النهائي. ولهذا السبب تحديدًا، يجب قياس «تكلفة العملية» عند تقييم نماذج تطوير الألعاب.
2 مقارنة أسعار نماذج تطوير الألعاب: اختلافات فوترة الـ Token عبر واجهات API الثلاث
2.1 الأسعار القياسية الرسمية للنماذج الثلاثة
جميع الأسعار في الجدول أدناه مأخوذة من الصفحات الرسمية لكل جهة، حتى 16 نوفمبر 2026، والوحدة دولار لكل مليون Token، وفئة الفوترة هي سعر API القياسي، ولا تشمل خصومات القنوات الأخرى أو الرسوم الإضافية الإقليمية.
| النموذج | إدخال عادي | إخراج | قراءة من الذاكرة المؤقتة | ملاحظات |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | كتابة الذاكرة المؤقتة لمدة 5 دقائق $10، وكتابة الذاكرة المؤقتة لمدة ساعة $16؛ السياق 1M، وأقصى إخراج 128K |
| GPT-6 Astra | $10 | $50 | $1 | فئة المعالجة القياسية؛ قد تختلف الأسعار في خيارات السرعة الأخرى والمعالجة بالدفعات والخيارات الإقليمية |
| Gemini 4 Argon | $2 | $10 | $0.10 | يسري هذا السعر حتى 30 نوفمبر 2026؛ ومن المقرر تعديله اعتبارًا من 1 ديسمبر إلى إدخال $4 وإخراج $20 |
لدى Claude Fable 5.2 أيضًا وضع Fast Mode، الإدخال $16 والإخراج $80، وتقول الجهة الرسمية إن سرعة الإخراج قد ترتفع حتى 2.5 ضعف. بالنسبة للمهام الطويلة التي يجب إكمالها خلال وقت محدد، فإن فئة السرعة تغيّر مدة التنفيذ والتكلفة في الوقت نفسه، وينبغي تسجيلها كإعداد مستقل عند التقييم.
💡 اقتراح للمقارنة: تختلف واجهات النماذج الثلاثة وحقول الفوترة الخاصة بها، لذا يجب ربط كل منها على حدة عند بناء بيئة التقييم بنفسك. يوفر APIYI apiyi.com واجهة موحدة متوافقة مع OpenAI، ويمكن باستخدام مفتاح API واحد استدعاء نماذج Claude وGPT وGemini وغيرها، ما يسهل تبديل النماذج ضمن مجموعة واحدة من سكربتات التقييم. أما النماذج المتاحة والأسعار الفعلية فتخضع لقائمة المنصة.
2.2 اختلاف الأسعار المعلنة عند الكمية نفسها من التوكنات
لإدراك حجم الفجوة في سعر الوحدة بشكل مباشر، يمكن إدخال حجم مخرجات Saltline البالغ 2.7 مليون توكن في أسعار النماذج الثلاثة: Claude Fable 5.2 بنحو 108 دولارات، وGPT-6 Astra بنحو 135 دولارًا، وGemini 4 Argon بنحو 27 دولارًا. وإذا كانت المدخلات البالغة 445 مليون توكن تُقرأ كلها من ذاكرة التخزين المؤقت، فستكون التكلفة لدى الثلاثة نحو 89 دولارًا و445 دولارًا و45 دولارًا على الترتيب.
هذه الأرقام توضح هيكل الفوترة فقط، وتفترض أن النماذج الثلاثة تستهلك التوكنات نفسها بالضبط، وهو افتراض لا يكاد يتحقق في الواقع. فعدد الجولات اللازمة لإنجاز المهمة نفسها، وحجم السياق المقروء في كل جولة، وطول الكود المولّد، تختلف من نموذج لآخر، كما أن إعادة التشغيل بعد الفشل قد تضاعف التكلفة عدة مرات.
2.3 سعر ذاكرة التخزين المؤقت يستحق اهتمامًا أكبر من سعر الإدخال
في التطوير بأسلوب الوكيل، تكون معظم المدخلات سياقًا متكررًا. سعر قراءة ذاكرة التخزين المؤقت لدى GPT-6 Astra يساوي 1/10 من سعر الإدخال العادي، ولدى Claude Fable 5.2 يساوي 1/40، ولدى Gemini 4 Argon يساوي 1/20. وكلما انخفضت نسبة سعر قراءة ذاكرة التخزين المؤقت إلى سعر الإدخال العادي، أصبح ضغط تكلفة الإدخال في المهام الطويلة أسهل.
كما أن لكتابة ذاكرة التخزين المؤقت تكلفة، ولها أيضًا مدة صلاحية. تختلف تكلفة كتابة ذاكرة التخزين المؤقت لمدة 5 دقائق عن تكلفة كتابة ذاكرة التخزين المؤقت لمدة ساعة لدى Claude، وإذا كان الفاصل بين استدعاءين متتاليين للوكيل أطول من مدة صلاحية ذاكرة التخزين المؤقت، فيجب إعادة الكتابة. وعند تقدير تكلفة المهام الطويلة، يجب أن يدخل الحساب في الاعتبار عدد مرات كتابة ذاكرة التخزين المؤقت ومعدل إصابة ذاكرة التخزين المؤقت ومدة الصلاحية معًا.
3 ما الذي يمكن أن توضحه معايير البرمجة: مرجع لقدرات نماذج تطوير الألعاب
3.1 SWE-bench Verified: مهام هندسة البرمجيات في المستودعات الحقيقية
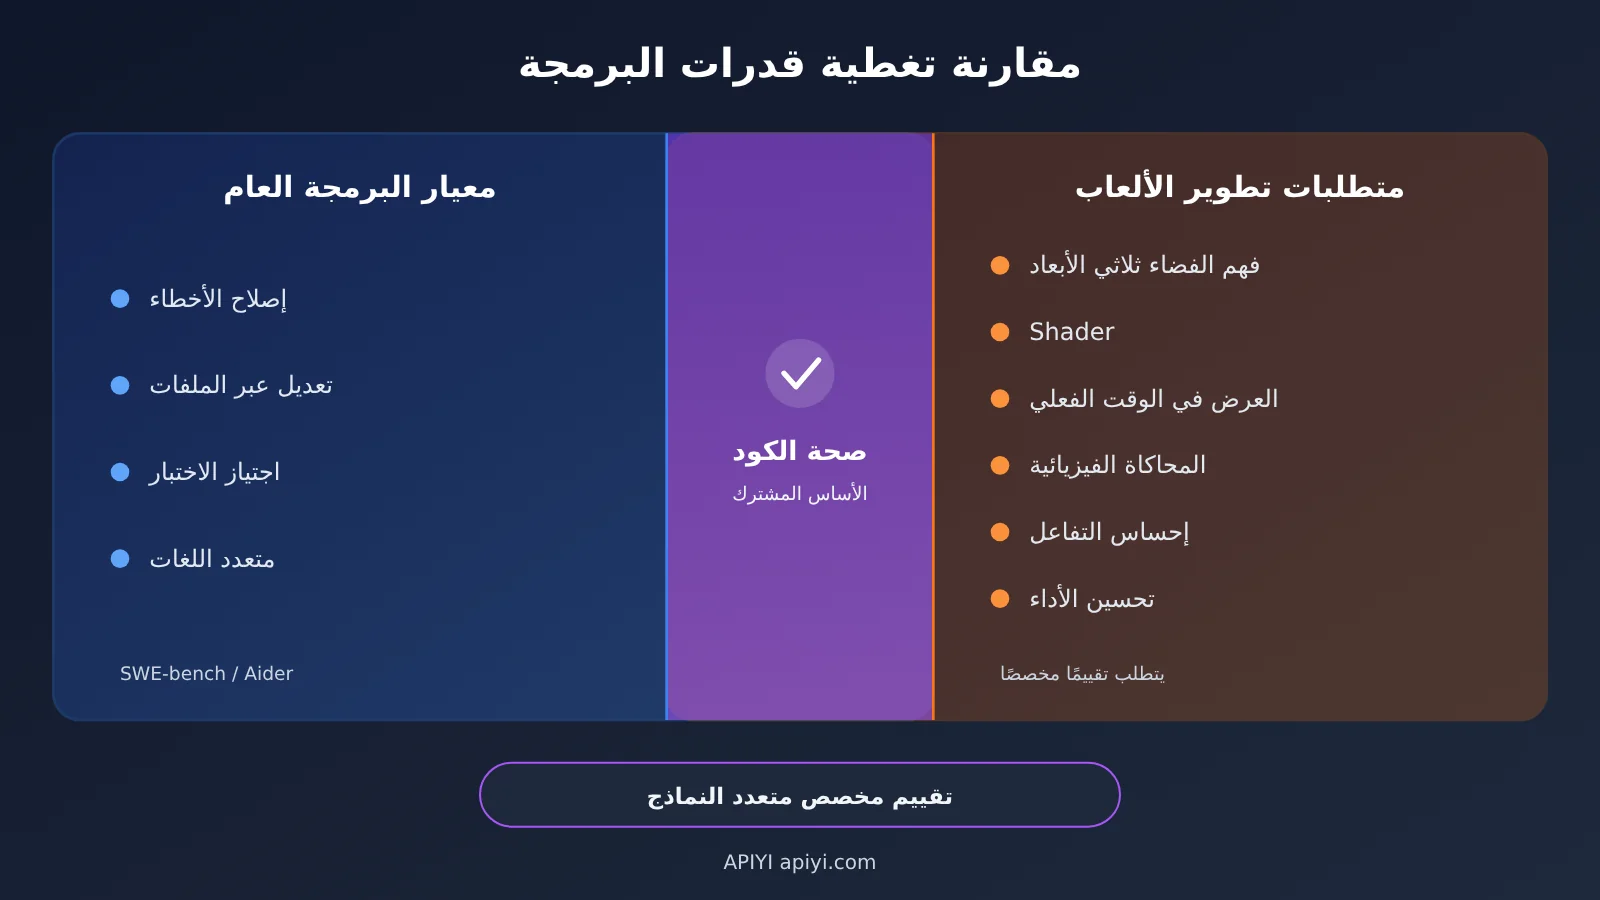
يضم SWE-bench Verified 500 مسألة خضعت للفرز والتحقق البشري، مأخوذة من مشاريع مفتوحة المصدر حقيقية. يحتاج النموذج إلى فهم سياق المستودع، وإتمام إصلاح الأخطاء، وتعديل الشيفرة القائمة، وحل حالات فشل الاختبارات، والتعديل عبر الملفات، وهو ما يقترب من الهندسة الواقعية أكثر من مجرد إكمال الشيفرة.
عند استخدامه ينبغي الانتباه إلى تأثير Harness. توضح الوثائق الرسمية أن لوحة الصدارة الكاملة تمزج بين أنظمة Agent مختلفة، وأن المقارنة بين النماذج وحدها يجب أن تعتمد إعداد mini-SWE-agent موحدًا. فإعداد Agent والأدوات والموجهات والإصدارات كلها تغيّر الدرجات، ولذلك ينبغي النظر إلى نتائج الإعدادات المختلفة بمعزل عن بعضها.
3.2 Aider Polyglot: تسجيل الدقة والتكلفة في آنٍ واحد
يستخدم Aider Polyglot عددًا من التمارين البرمجية يبلغ 225 تمرينًا تغطي C++ وGo وJava وJavaScript وPython وRust، ويعتمد على حالات الاختبار للحكم على ما إذا كان النموذج قد عدّل الشفرة بشكل صحيح. ونتائجه المنشورة لا تقتصر على الدقة فحسب، بل تسجّل أيضًا استهلاك الرموز (Token)، وتكلفة التشغيل، والمخرجات الخاطئة، وأخطاء التنسيق، ووقت تنفيذ كل مهمة.
وبالنسبة لاختيار النموذج، فإن طريقة التسجيل هذه التي تجمع بين «الدقة + التكلفة» ذات قيمة كبيرة، وهي تتماشى مع فكرة إطار التقييم الذي سنتناوله لاحقًا في هذا المقال. أما الأسئلة نفسها فهي تمارين تدريبية مستقلة، وحجمها وطبيعتها يختلفان اختلافًا واضحًا عن مشروع لعبة ثلاثية الأبعاد كامل.
3.3 تقييم NIST التاريخي: انتبه إلى إصدار النموذج والزمن
في تقرير تقييم النماذج الذي أصدره مركز CAISI التابع للمعهد الوطني الأمريكي للمعايير والتقنية (NIST) في عام 2025، جرى اختبار نتائج مجموعة من النماذج على معيار SWE-bench Verified. وجميع البيانات التالية تخص نماذج وإعدادات تجريبية تاريخية وردت في ذلك التقرير، ولا تمثل ترتيب أحدث النماذج في نوفمبر 2026.
| النموذج (إصدار الاختبار في تقرير 2025) | نتيجة SWE-bench Verified |
|---|---|
| Anthropic Opus 4 | 66.7% |
| GPT-5 | 63.0% |
| DeepSeek V3.1 | 54.8% |
| DeepSeek R1-0528 | 44.6% |
| gpt-oss | 42.6% |
| DeepSeek R1 | 25.4% |
ويقدّم التقرير أيضًا الخطأ المعياري، مما يوضح أن درجات المعيار نفسه تحمل تقلبات إحصائية. والفروق التي تبلغ بضع نقاط مئوية قد لا تكون ذات قدرة فعلية على التمييز ضمن نطاق الخطأ. أما النماذج التي يقارنها هذا المقال — Claude Fable 5.2 وGPT-6 Astra وGemini 4 Argon — فلم تظهر في هذا التقرير، لذا عند اختيار النموذج يجب البحث عن أحدث تقييم يخص الإصدار الحالي ويحدد الإعدادات، أو اختباره بنفسك.
3.4 الفجوة بين قدرات البرمجة العامة وقدرات تطوير الألعاب
يشمل تطوير الألعاب الكثير من الأعمال التي لا تغطيها معايير هندسة البرمجيات العامة تغطيةً كافية: فهم الفضاء ثلاثي الأبعاد، وكتابة الـ Shader، والعرض الفوري، وأنظمة الرسوم المتحركة، ومحاكاة الفيزياء، وإحساس التفاعل، وتحسين أداء التشغيل. كما تتطلب مشاريع مثل Saltline من النموذج توليد أصول بصرية بالكود، وهذا يعتمد على إلمامه بالرسوميات الحاسوبية والمؤثرات البصرية.
قد يكون النموذج بارعًا في إصلاح الأخطاء داخل مستودعات Python، لكنه متوسط الأداء في مشهد WebGL معقد. لذلك فإن SWE-bench وAider مناسبان لاستبعاد المرشحين الذين تضعف قدراتهم البرمجية بشكل واضح، أما الترتيب النهائي فيحتاج إلى تقييم متخصص في تطوير الألعاب ليحسم الأمر.
4 كيفية مقارنة نماذج تطوير ألعاب الذكاء الاصطناعي: خطة تقييم متخصصة للمهمة نفسها
4.1 تصميم مهمة موحدة لألعاب ثلاثية الأبعاد في المتصفح
بالإشارة إلى شكل Saltline، يمكن تعريف المهمة على النحو التالي: توليد نموذج أولي للعبة ثلاثية الأبعاد تعمل في المتصفح من موجه واحد. تستخدم جميع النماذج المرشحة المتطلبات نفسها تمامًا:
- توليد مشروع كامل يمكن تشغيله مباشرة في المتصفح
- يتضمن شخصية قابلة للتحكم وبيئة ثلاثية الأبعاد
- يتضمن تصادمًا أو فيزياء أساسية
- يتضمن أهداف المهمة وشروط الفوز والخسارة بشكل واضح
- لا يُسمح بتعديل الشيفرة الأساسية يدويًا أثناء عملية التقييم
يجب أن تكون صعوبة المهمة قريبة من احتياجاتك الفعلية. فريق يصنع ألعابًا صغيرة غير رسمية، إذا اختبر باستخدام نموذج أولي FPS فسيبالغ في تقدير فئة النموذج المطلوبة؛ وفريق يعمل على مشاريع ثلاثية الأبعاد معقدة، إذا اختبر بمهمة ثنائية الأبعاد بسيطة فسيقلل من التقدير.
4.2 عشرة مؤشرات للتقييم
| البعد | المحتوى المُقيَّم | طريقة التسجيل المقترحة |
|---|---|---|
| اكتمال الوظائف | هل تم تنفيذ وظائف اللعبة الأساسية | وضع علامة على كل بند في قائمة الوظائف |
| الجودة البصرية | المشاهد، المواد، الإضاءة، الرسوم المتحركة | تقييم بالدرجات من عدة أشخاص دون معرفة مصدر العمل |
| قابلية التشغيل | هل يبدأ التشغيل بشكل طبيعي | نعم / لا |
| اكتمال التفاعل | هل المدخلات والاستجابة طبيعيان | اختبار كل بند وفق قائمة العمليات |
| الاستقرار | هل توجد أعطال واضحة | تسجيل عدد الأعطال خلال لعب لمدة محددة |
| الأداء | FPS، زمن بدء التشغيل، الذاكرة | قياس فعلي على جهاز ثابت |
| جودة الشفرة | قابلية القراءة، التقسيم إلى وحدات، معالجة الأخطاء | تقييم عبر مراجعة الشفرة |
| تكلفة الرموز (Token) | المدخلات، المخرجات، التخزين المؤقت | التراكم من حقل API usage |
| الوقت الإجمالي | من البداية حتى نسخة قابلة للتشغيل | قياس الزمن |
| الإصلاح اليدوي | التدخل البشري اللازم للوصول إلى المعيار | تسجيل ساعات العمل البشرية |
تُعدّ «قابلية التشغيل» و«اكتمال الوظائف» و«اكتمال التفاعل» شروط قبول إلزامية لتحديد ما إذا كانت الجولة ناجحة؛ أما الجودة البصرية والأداء وجودة الشفرة فتُستخدم لترتيب النتائج الناجحة فيما بينها.
4.3 التحكم في بيئة الاختبار
تتوقف إمكانية مقارنة نتائج التقييم على ضبط المتغيرات. فالشروط التي يجب توحيدها تشمل: المتصفح نفسه، والجهاز نفسه، والموجه نفسه، وإجراءات الاختبار نفسها، والميزانية الزمنية نفسها، وما إذا كان الاتصال بالإنترنت مسموحًا به. وإذا كان يُسمح للنموذج باستدعاء الأدوات بنفسه أو البحث عن المعلومات أو إنشاء الملفات، فيجب أيضًا أن تكون صلاحيات الأدوات متطابقة لدى جميع النماذج.
كذلك يجب تثبيت إطار العمل (Harness). فإذا انتقل النموذج نفسه إلى إطار عمل Agent آخر، فقد تتغير نسبة النجاح واستهلاك الـ Token تغيرًا كبيرًا، لذا يجب أن يوضّح تقرير التقييم الإطار المستخدم وإصداره ومعلماته، مثل درجة الحرارة والحد الأقصى لطول المخرجات ومستوى السرعة.
4.4 تشغيل كل نموذج عدة مرات على الأقل
توليد النماذج اللغوية الكبيرة يتسم بالعشوائية؛ فقد يكون النجاح مرة واحدة محض حظ، وقد يكون الفشل مرة واحدة أمرًا عارضًا. لذلك ينبغي تشغيل كل نموذج عدة مرات في الظروف نفسها (مثلًا من 5 إلى 10 مرات)، وحساب نسبة النجاح، ومتوسط الـ Token والزمن وجودة النتائج في العينات الناجحة. وتجربة Saltline نفسها كانت تجربة منفردة، وقد أثبتت أن هذا الأمر قابل للتحقيق، لكنها لا تستطيع أن تعطي نسبة نجاح النموذج في مهام من هذا النوع.
يستخدم السكربت التالي واجهة متوافقة مع OpenAI لاستدعاء النموذج، ويحسب تكلفة الاستدعاء الواحد انطلاقًا من حقل usage ووفق أسعار القسم 2:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، يكفي تغيير model لتبديل النموذج
)

# الوحدة: دولار / مليون Token، وفق السعر الرسمي القياسي حتى 2026-11-16
PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

def call_and_price(model: str, messages: list) -> tuple[str, float]:
    resp = client.chat.completions.create(model=model, messages=messages)
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + u.completion_tokens * p["output"]) / 1_000_000
    return resp.choices[0].message.content, cost
يرجى الاعتماد على قائمة النماذج في المنصة التي تستدعيها فعليًا لتحديد أسماء النماذج. أما تكلفة كتابة الذاكرة المؤقتة والرسوم الإضافية لمستوى السرعة فتحتاج إلى إضافتها إلى الحساب وفقًا لقواعد كل مزوّد.
عرض سكربت التقييم متعدد الجولات وتجميع التكاليف
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # استدعاء عدة نماذج مرشحة عبر APIYI
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """حلقة وكيل مبسطة: التوليد → الفحص → إعادة إرسال النتيجة → التعديل"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # نفّذها بنفسك: كتابة الملف، تشغيل المتصفح بلا واجهة، تنفيذ قائمة الوظائف
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 بداية سريعة: عند إعداد هذا النوع من التقييمات، من الأفضل أولاً تشغيل السكربت على مهمة صغيرة للتأكد من أنه يعمل، ثم استبدالها بمهمة اللعبة الكاملة. توفر APIYI عبر apiyi.com حصة تجريبية مجانية للمستخدمين الجدد، ويمكنك استخدامها للتحقق من منطق أداة الاختبار (Harness) ومن حساب التكاليف قبل تخصيص ميزانية التقييم الفعلي.
5 كيف تختار النموذج في تطوير الألعاب بالذكاء الاصطناعي: التحكم في تكلفة Token للمهام المعقدة
5.1 معدل النجاح يحدد التكلفة الإجمالية
تتكون تكلفة التطوير الكاملة من ثلاثة أجزاء:
إجمالي تكلفة المهمة = تكلفة استدعاء النموذج + تكلفة تنفيذ الأدوات + تكلفة الإصلاح اليدوي
عند إدخال معدل النجاح في الحساب، يصبح المؤشر العملي للمقارنة هو «تكلفة كل نسخة صالحة»: إجمالي ما أُنفق على كل المحاولات مقسومًا على عدد مرات النجاح. لنفترض أن النموذج A تكلفة المحاولة الواحدة فيه 100 دولار ومعدل نجاحه 80%، فإن تكلفة كل نسخة صالحة تبلغ نحو 125 دولارًا؛ أما النموذج B فتكلفة المحاولة الواحدة 30 دولارًا ومعدل نجاحه 20%، ما يجعل تكلفة كل نسخة صالحة نحو 150 دولارًا، إضافة إلى وقت تشخيص النسخ الفاشلة. في هذا المثال، النموذج الأقل سعرًا لكل محاولة هو الأغلى في النتيجة النهائية.
غالبًا ما تكون تكلفة الإصلاح اليدوي هي البند الأكبر. فإذا أنفق مهندس عدة ساعات لإصلاح النتيجة المولدة، فقد تتجاوز تكلفة العمالة إجمالي تكلفة استدعاء API. لذلك، عند التقييم، سجّل مدة التدخل البشري بصدق، ثم حوّلها إلى تكلفة بناءً على أجر العمل الفعلي لدى الفريق، وأضفها إلى التكلفة الإجمالية.
5.2 ثلاث استراتيجيات لاختيار النماذج
| الاستراتيجية | سيناريوهات الاستخدام | المزايا | التكاليف التي يجب الانتباه إليها |
|---|---|---|---|
| نموذج عالي القدرة | البنية المعقدة، التطوير بنافذة سياق طويلة، التعاون متعدد الوحدات، تحديد الأخطاء المعقدة | معدل نجاح مرتفع، يقلل من إعادة التشغيل والإصلاح اليدوي | سعر الوحدة مرتفع، ويعتمد على التخزين المؤقت للتحكم في تكلفة الإدخال |
| نموذج منخفض التكلفة | الوظائف البسيطة، شرح الشفرة، التعديلات المتكررة، مساعدة الاختبار | سعر الوحدة منخفض، مناسب للاستدعاءات عالية التكرار | قد تفشل المهام المعقدة في عدة جولات، وقد ترتفع التكلفة الإجمالية بدلاً من ذلك |
| التعاون بين نماذج متعددة | نموذج يتولى البنية، وآخر يتولى التنفيذ، ونموذج مستقل يراجع الشفرة | مطابقة القدرات والسعر حسب المرحلة | عمليات التسليم بين النماذج تعيد نقل السياق، مما يزيد من الرموز (Token) وتكاليف التنسيق |
تعتمد فعالية التوفير في التعاون بين النماذج المتعددة على تكلفة التسليم. ففي كل عملية تسليم، يجب إعادة إرسال سياق المشروع إلى نموذج آخر، ولا يمكن مشاركة التخزين المؤقت بين النماذج المختلفة. ولا يصبح حل التعاون مجديًا إلا عندما تكون المراحل التي يتولاها النموذج منخفض التكلفة كثيرة بما يكفي وعدد عمليات التسليم منخفضًا بما يكفي، وهذا أيضًا يحتاج إلى تأكيد بالاختبار الفعلي.
💰 نصيحة للتكلفة: يتطلب التعاون بين النماذج المتعددة استدعاء عدة نماذج في مشروع واحد في الوقت نفسه. ومن خلال APIYI على apiyi.com، يمكنك الاتصال باستخدام نفس المفتاح ونفس مجموعة الشفرة، مما يقلل من عبء إدارة الحسابات المتعددة وتكييف الواجهات، ويسهل توزيع البنية والتنفيذ والمراجعة على نماذج مختلفة ثم حساب التكاليف بشكل موحد.
5.3 عملية اختيار قابلة للتنفيذ من خمس خطوات
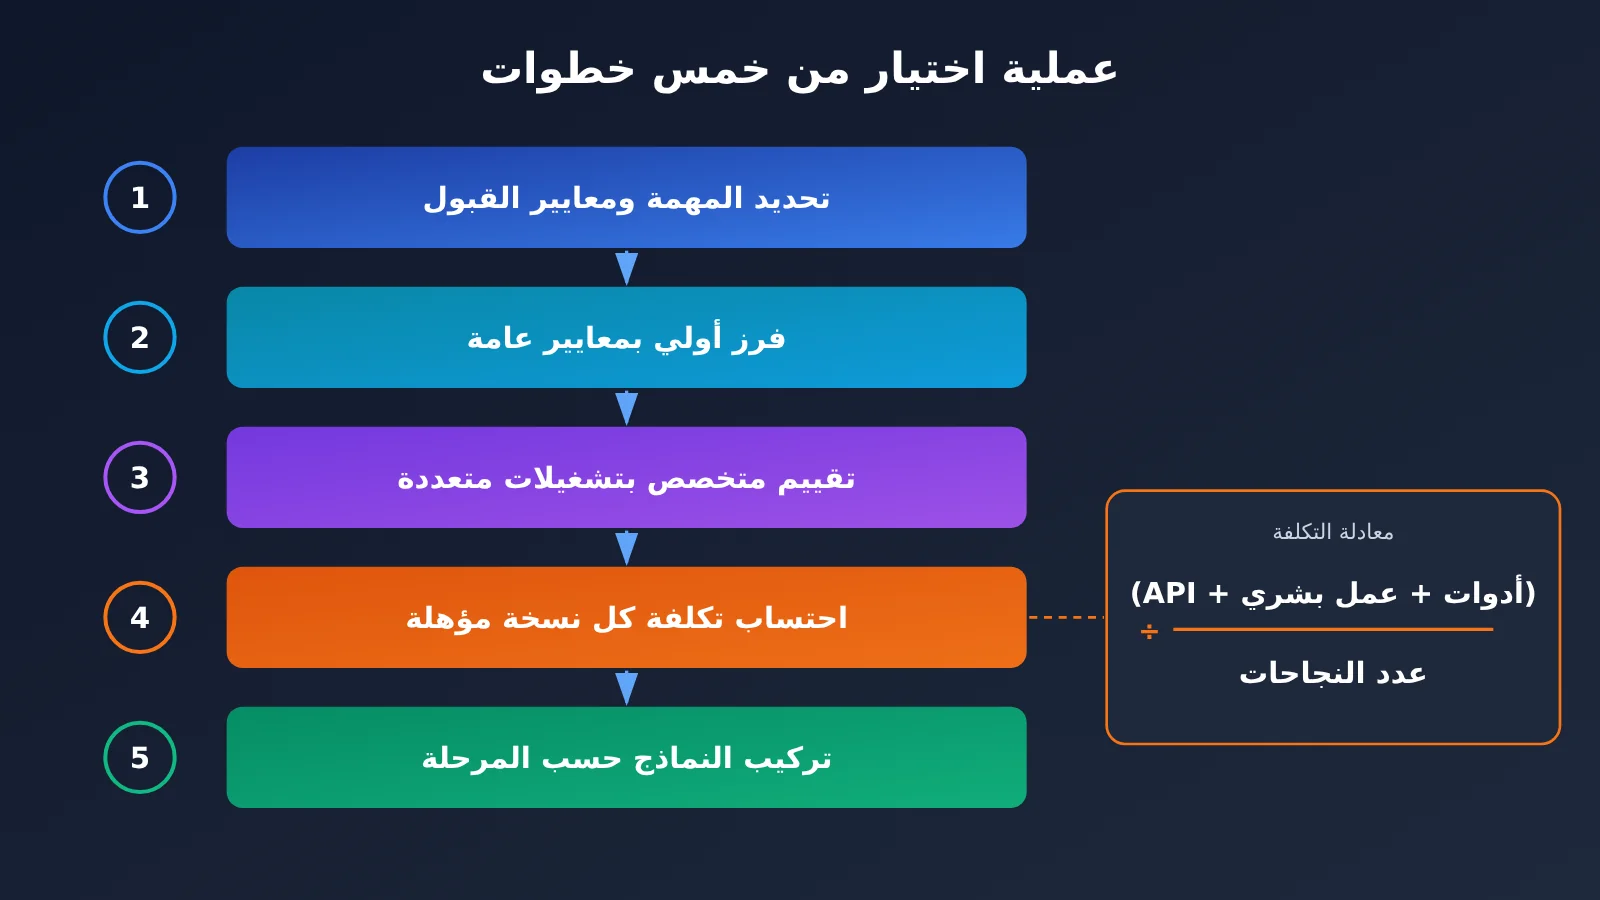
- حدِّد المهمة ومعايير القبول: اكتب قائمة الميزات والمنصات المستهدفة والحد الأدنى للأداء بشكل واضح، لتكون هي الأساس الذي تحدد عليه النجاح.
- استخدم المعايير العامة للفرز الأولي: راجع نتائج SWE-bench Verified وAider Polyglot الخاصة بالإصدار الحالي وبإعدادات واضحة، واستبعد النماذج التي تبيّن ضعفًا كبيرًا في قدرات البرمجة.
- شغِّل تقييمًا متخصصًا: في بيئة موحَّدة، شغِّل المهمة البرمجية نفسها من 5 إلى 10 مرات لكل نموذج مرشح، وسجِّل المؤشرات العشرة الواردة في القسم 4.2.
- احسب تكلفة كل إصدار مؤهَّل: رسوم API زائد رسوم الأدوات زائد تكلفة الإصلاح اليدوي، ثم اقسم الناتج على عدد مرات النجاح.
- ركِّب النماذج حسب المرحلة: أسلِم المراحل المعقدة إلى النماذج ذات معدل النجاح العالي، وأسلِم المراحل التكرارية إلى النماذج منخفضة التكلفة، ثم اختبر فعليًا هل التركيبة أصبحت أرخص فعلًا أم لا.
الأسعار تتغير، فقد أعلنت Gemini 4 Argon مثلًا عن خطة تعديل الأسعار اعتبارًا من 1 ديسمبر. لذلك يجب الاحتفاظ ببيانات الـ Tokens الأصلية في نتائج التقييم، بحيث يكفي بعد تغيُّر السعر أن تعيد إدخال سعر الوحدة لتحديث الاستنتاجات.
6. الأسئلة الشائعة حول اختيار نماذج الذكاء الاصطناعي في تطوير الألعاب
س1: هل مبلغ 550 دولارًا المنسوب إلى Saltline فاتورة حقيقية؟
لا، هو ليس فاتورة مدقّقة. مبلغ 550 دولارًا تقديرٌ حسبه المطوّر Felix Rieseberg اعتمادًا على أسعار API، والبيانات المرافقة (نحو 8 ساعات، ونحو 445 مليون Token إدخال، ونحو 2.7 مليون Token إخراج) جاءت أيضًا من روايته الشخصية. وقد استُخدم التخزين المؤقت بكثافة في المدخلات، لكن نسب كتابة التخزين المؤقت وقراءته لم تُنشر.
س2: هل النموذج الأقل سعرًا هو الأكثر توفيرًا؟
الأمر يتوقف على معدل النجاح. فسعر الوحدة يحدد فقط ثمن كل Token، أما عدد الـ Tokens التي يحتاجها النموذج لإتمام المهمة، وعدد مرات إعادة التشغيل، وحجم الإصلاح اليدوي المطلوب، فكلها تحددها قدرة النموذج. المقارنة المجزية هي «التكلفة الإجمالية ÷ عدد المرات الناجحة».
س3: هل النموذج الأول في ترتيب SWE-bench هو الأنسب لتطوير الألعاب؟
يقيس SWE-bench Verified قدرة هندسة البرمجيات داخل مستودعات مفتوحة المصدر حقيقية، لكن تغطيته محدودة عندما يتعلق الأمر بـ Shader وفهم الفضاء ثلاثي الأبعاد والعرض في الزمن الحقيقي وإحساس التفاعل. يصلح للفرز الأولي، أما الترتيب النهائي في تطوير الألعاب فيحتاج إلى تقييم متخصص.
س4: هل يمكن أن تمثّل الدرجات الواردة في تقرير NIST النماذج الحالية؟
لا. صدر تقرير NIST CAISI في عام 2025، وقد اختبر نماذج تاريخية مثل GPT-5 وOpus 4 وDeepSeek V3.1 وإعدادات تجريبية محددة. أما نماذج نوفمبر 2026 فتحتاج إلى البحث عن تقييمات جديدة مخصصة لإصداراتها.
س5: كيف أبني تقييمًا سريعًا لمقارنة عدة نماذج؟
أسهل طريقة هي استخدام منصة تجميع توفر واجهة متوافقة مع OpenAI. سجّل في APIYI apiyi.com واحصل على مفتاح API، ثم اضبط `base_url` في سكربت هذه المقالة على `https://api.apiyi.com/v1` وغيّر معامل model، لتصبح قادرًا على اختبار عدة نماذج بالسكربت نفسه. ويمكن للمستخدمين الجدد التحقق من السكربت أولاً باستخدام الحصة المجانية.
س6: كيف أحسب تكلفة الـ Token بأقصى دقة أثناء التقييم؟
اعتمد على حقل usage في استجابة API، واجمع تباعًا Tokens الإدخال العادية وقراءة التخزين المؤقت والإخراج، ثم احسبها وفق الأسعار الرسمية وشرائح الفوترة السارية في يوم الاستدعاء. أما الرسوم الإضافية مثل كتابة التخزين المؤقت وفئات السرعة فتُضاف كلٌّ حسب قواعد مزوّدها. وعند الاستدعاء عبر APIYI apiyi.com يمكنك أيضًا مطابقة إحصاءاتك مع سجلات الاستهلاك في لوحة تحكم المنصة.
س7: هل يمكن نشر نماذج الألعاب الأولية التي يولّدها الذكاء الاصطناعي مباشرة؟
تثبت النماذج الأولية مثل Saltline أن النموذج قادر على إنتاج نسخة قابلة للّعب دون أي تغذية راجعة بشرية، لكن الإطلاق التجاري يتطلب أيضًا التوافق مع متصفحات متعددة، والتكيّف مع الأجهزة المحمولة، وتحسين الأداء، والصيانة على المدى الطويل. تخضع ألعاب المتصفح لقيود العتاد المحلي والمتصفح؛ كما تحذّر صفحة Saltline نفسها من مشكلات مثل بطء التهيئة الأولية وضرورة التبديل إلى جودة رسم منخفضة عند حدوث تقطيع، لذا ينبغي احتساب تكاليف الاختبار والتحسين قبل الإطلاق ضمن التكلفة الكاملة للتطوير.
7 خلاصات رئيسية لاختيار نموذج تطوير ألعاب AI
- المؤشر الأساسي: مقارنة التكلفة من البداية إلى النهاية لكل نسخة مؤهلة، وليس سعر المليون Token.
- فاتورة Saltline: نحو 550 دولارًا وفق تقدير صرّح به المطوّر نفسه؛ يمثل الإخراج نحو 108 دولارات، والباقي في جانب الإدخال.
- التخزين المؤقت يحدد الحجم: في المهام الطويلة يشكل الإدخال الغالبية العظمى، وسعر قراءة التخزين المؤقت ونسبة الإصابة هما الأكثر تأثيرًا.
- الأسعار عرضة للتغير مع الوقت: أسعار هذا المقال حتى 2026-11-16، ومن المخطط تعديل سعر Gemini 4 Argon اعتبارًا من 1 ديسمبر.
- المعايير تُستخدم للفرز الأولي: يقيس SWE-bench وAider البرمجة العامة، أما قدرات الألعاب فتحتاج إلى تقييم متخصص.
- تشغيل عدة مرات: شغّل كل نموذج من 5 إلى 10 مرات تحت نفس الظروف، واستنتج بناءً على معدل النجاح لا نتيجة تشغيل واحدة.
- طريقة البدء: بدّل بين النماذج عبر الواجهة الموحدة لـ APIYI apiyi.com، ما يسهّل مقارنة التكلفة باستخدام السكربت نفسه.
8 الخلاصة: منهج اختيار النموذج لتمكين الذكاء الاصطناعي من تطوير لعبة بشكل مستقل
عندما نريد أن يطور الذكاء الاصطناعي لعبة بنفسه، تبرز ثلاث نقاط أساسية في اختيار النموذج:
- احسب التكلفة كاملة: تشمل التكلفة الإجمالية للمهمة استدعاء النموذج وتشغيل الأدوات والإصلاح البشري، ورسوم API ليست سوى بند واحد منها.
- اختبر القدرات عمليًا: تُستخدم المعايير العامة للفرز الأولي، أما الترتيب النهائي لتطوير الألعاب فيأتي من اختبارات متخصصة متكررة ضمن ظروف موحدة.
- اجمع النماذج حسب المرحلة: استخدم نموذجًا ذا معدل نجاح مرتفع في المراحل المعقدة، ونموذجًا منخفض التكلفة في المراحل المتكررة، مع التحقق من الحل المدمج بالاختبار أيضًا.
قدّم Saltline مرجعًا تقريبيًا يمكن الاستفادة منه: موجه واحد، ونحو 8 ساعات، وتكلفة تقديرية تبلغ حوالي 550 دولارًا، لإنتاج نموذج أولي ثلاثي الأبعاد قابل للعب في المتصفح. أما مقدار ما يحتاجه مشروعك فيعتمد على تعقيد المهمة ومعدل نجاح النموذج الذي تختاره، وأكثر الطرق موثوقية هي تشغيل جولة تقييم خاصة بك باستخدام الإطار الوارد في هذا المقال.
نوصي بإعداد بيئة سريعة لمقارنة عدة نماذج عبر APIYI على apiyi.com؛ إذ توفر المنصة واجهات متوافقة مع OpenAI ورصيدًا مجانيًا للمستخدمين الجدد، ما يسهّل قياس الأسعار ومعدلات النجاح ضمن السكربت نفسه.
المراجع
- صفحة تجربة Saltline المستقلة: عرض تجريبي للعبة وشرح الأسئلة الشائعة
- الرابط:
saltline.games -
الوصف: تتضمن معلومات التجربة مثل التهيئة الأولية وتبديل جودة الرسوم وطريقة التحكم
-
نسخة مرآة من كود Saltline مع ملف README: توضيح نسب البيانات إلى المطوّر
- الرابط:
github.com/realcodebear/saltline-fable-5.2 -
الوصف: تسجّل مصدر وقت التوليد وعدد الـ Token والتكلفة المقدّرة
-
مستودع النسخة الصينية من Jimao: أرشيف النسخة المُغلّفة بالصينية من Saltline
- الرابط:
github.com/Megasu/jimao-3a-game -
الوصف: يوفّر بيانات مثل حجم ملف index.html
-
مواصفات وأسعار نموذج Claude Fable 5.2: الوثائق الرسمية من Anthropic
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview -
الوصف: أسعار الإدخال والإخراج والتخزين المؤقت ووضع Fast Mode
-
وثائق نموذج GPT-6 Astra: الأسعار الرسمية من OpenAI
- الرابط:
developers.openai.com/api/docs/models/gpt-6-astra -
الوصف: تُعتبر المرجع المعتمد لأسعار فئة المعالجة القياسية
-
SWE-bench Verified: الصفحة الرسمية لمعيار هندسة البرمجيات
- الرابط:
swebench.com/verified.html -
الوصف: 500 مهمة تم التحقق منها يدويًا، مع توضيح الإعداد الموحّد لـ mini-SWE-agent
-
Aider Leaderboards: نتائج تقييم Aider Polyglot
- الرابط:
aider.chat/docs/leaderboards -
الوصف: تسجّل في الوقت نفسه معدل الدقة واستهلاك الـ Token وتكلفة التشغيل
-
تقرير تقييم NIST CAISI (عام 2025): تقييم مستقل للنماذج السابقة
- الرابط:
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - الوصف: يتضمن النتائج التاريخية لـ SWE-bench Verified والخطأ المعياري
المؤلف: فريق APIYI التقني
التواصل التقني: نرحب بالتواصل معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ولمزيد من مواد التكامل يمكن زيارة مركز الوثائق docs.apiyi.com