Resumo: ao escolher um modelo para desenvolvimento de jogos, considere a taxa de sucesso na mesma tarefa, o tempo de execução, os custos de API e o custo de correção manual; tabelas de preços e benchmarks genéricos de código são apenas referências auxiliares.
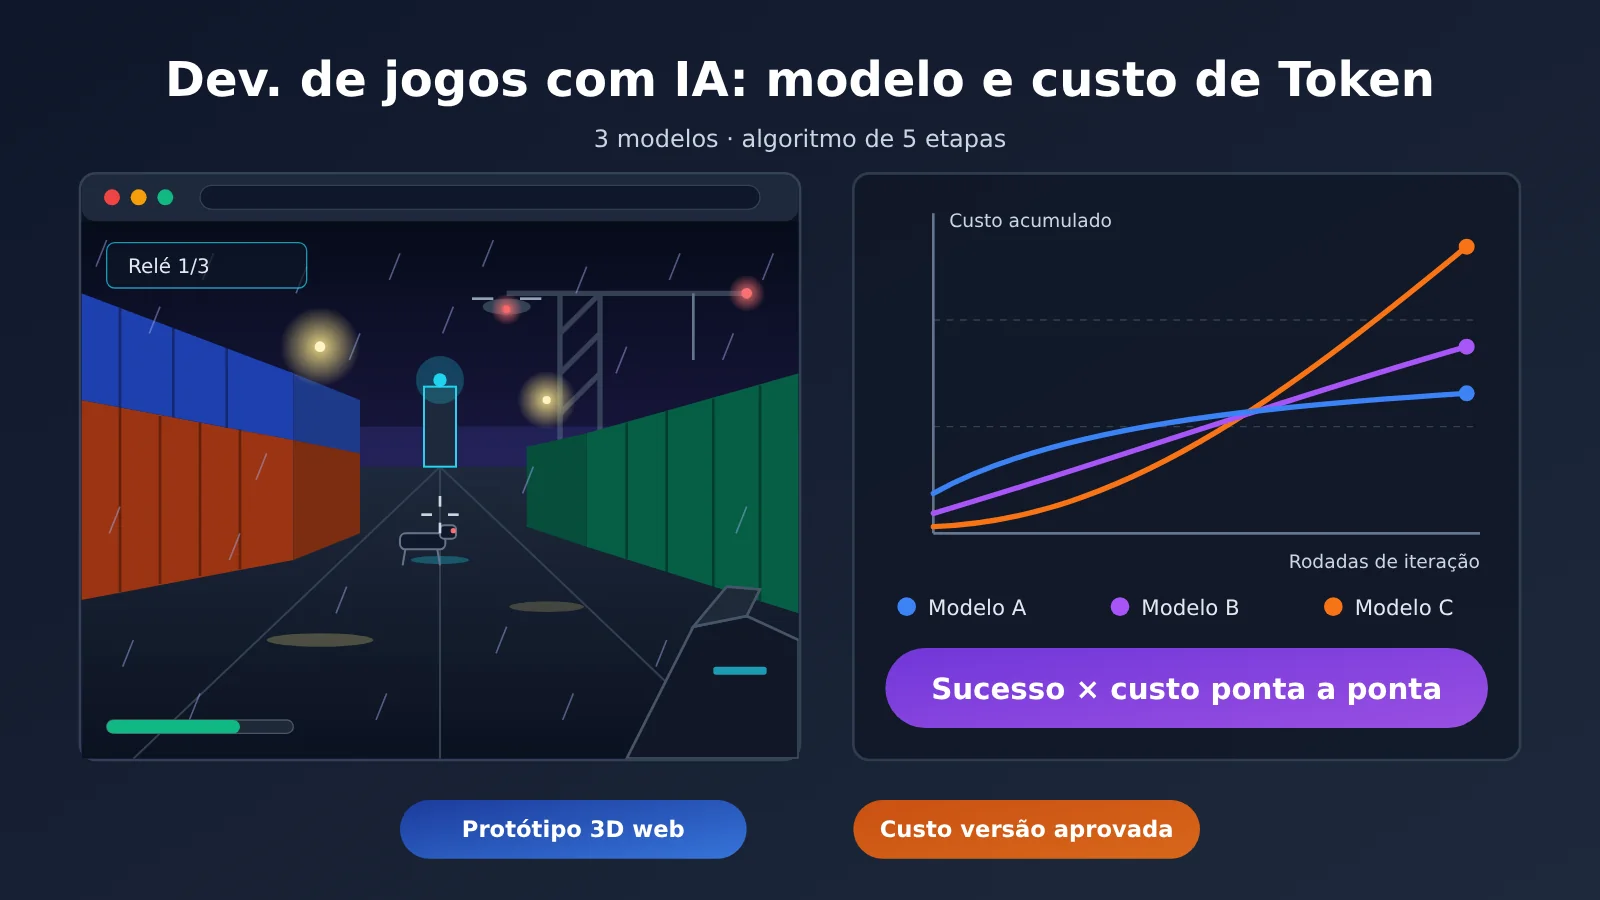
Conclusão antecipada: quando a IA desenvolve um jogo de forma independente, o que realmente importa comparar é o custo ponta a ponta para concluir uma versão entregável, e não o preço anunciado por milhão de tokens. No caso do Saltline, o Claude Fable 5.2 levou cerca de 8 horas e consumiu aproximadamente 445 milhões de tokens de entrada e 2,7 milhões de tokens de saída para gerar um protótipo de jogo de tiro 3D que roda no navegador. O custo estimado pelo desenvolvedor com base nos preços de API ficou em cerca de US$ 550, e a maior parte da entrada passou pelo cache. Em 16 de novembro de 2026, os preços unitários padrão de API dos três modelos diferem em até cerca de cinco vezes, mas, quando o modelo de preço unitário mais baixo precisa de mais rodadas, o custo total pode acabar sendo maior. Por isso, o método confiável para escolher um modelo é: entregar a mesma tarefa de desenvolvimento de jogo aos modelos candidatos, executar várias vezes, medir a taxa de sucesso, os tokens, o tempo gasto e o esforço de correção manual e, então, calcular o “custo por versão aprovada”.
Prévia do conteúdo: a seção 1 usa o Saltline para detalhar a estrutura da fatura de tokens de um experimento de desenvolvimento de jogos com IA. A seção 2 compara os preços oficiais dos três modelos e explica como o cache afeta o custo total. A seção 3 mostra o que SWE-bench Verified, Aider Polyglot e as avaliações históricas do NIST podem indicar, cada um a seu modo. A seção 4 apresenta um plano de avaliação reproduzível, específico para desenvolvimento de jogos, além do código. A seção 5 transforma os resultados em uma estratégia de seleção de modelo.
Para conhecer: Terminologia de seleção de modelos para desenvolvimento de jogos com IA
| Termo | Explicação |
|---|---|
| Token de entrada | Medida do conteúdo enviado ao modelo para processamento, incluindo comandos, arquivos de código, resultados retornados por ferramentas etc. |
| Token de saída | Medida do conteúdo gerado pelo modelo, como código, texto explicativo e parâmetros de invocação de ferramentas. |
| Leitura de cache | Reutilização de contexto já armazenado em cache, com cobrança muito menor que a da entrada normal. |
| Gravação no cache | Custo de armazenar o contexto no cache pela primeira vez, geralmente um pouco maior que o da entrada normal. |
| SWE-bench Verified | Benchmark com 500 tarefas de engenharia de software de projetos de código aberto reais, verificadas manualmente. |
| Aider Polyglot | Avaliação de modificação de código que cobre 6 linguagens de programação e 225 exercícios. |
| Harness | Estrutura de execução que organiza o modelo, as ferramentas e o ciclo de tarefas, por exemplo, o scaffolding de um agente. |
| Taxa de sucesso da tarefa | Proporção de tarefas concluídas de acordo com critérios de aceitação previamente definidos. |
| Custo ponta a ponta | Soma dos custos de invocação do modelo, execução de ferramentas e trabalho humano para concluir a tarefa inteira. |
| Correção manual | Modificações manuais feitas para que o resultado gerado atenda aos critérios de aceitação. |
| Geração procedural | Gerar geometria, texturas e sons com código e funções matemáticas, em vez de importar arquivos de assets. |
| Shader | Programa executado na GPU para calcular cores, iluminação, materiais e outros efeitos visuais. |
1 Caso de custo de desenvolvimento independente de jogo com IA: quantos Tokens o Saltline consumiu
1.1 Qual é a escala do jogo Saltline
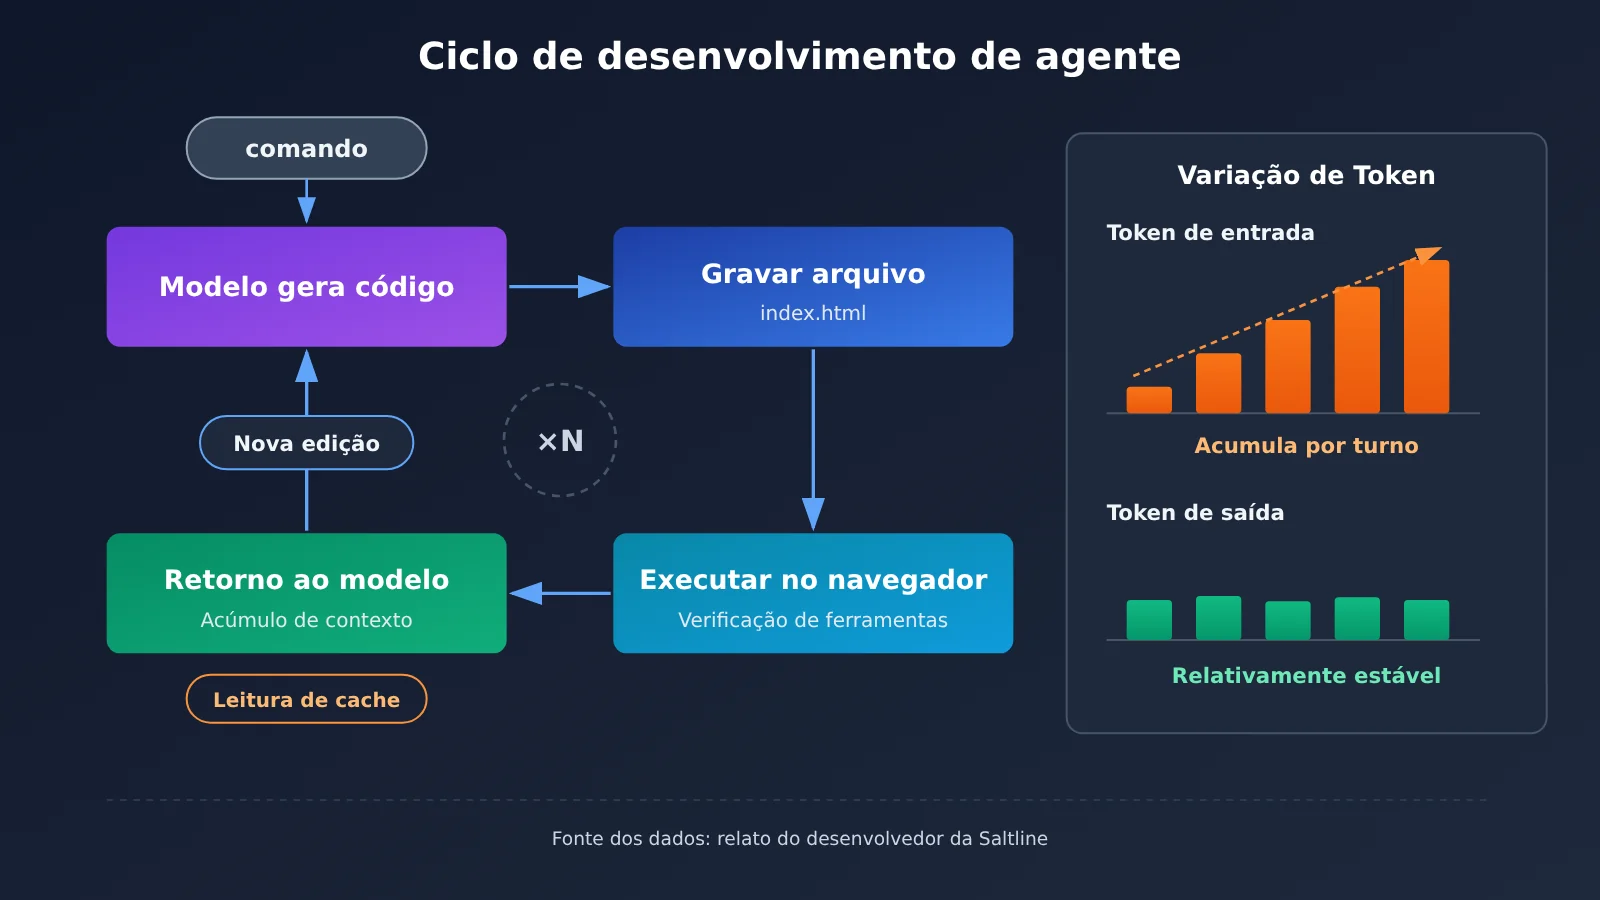
Em 9 de novembro de 2026, o engenheiro da Anthropic Felix Rieseberg divulgou publicamente um experimento de programação com Claude Fable 5.2. Ele forneceu ao modelo apenas um único comando, pedindo que criasse um jogo de tiro em primeira pessoa de pequena escala com visual o mais próximo possível de um jogo AAA, sem oferecer nenhum feedback humano durante todo o processo. O resultado foi o Saltline: um jogo de tiro 3D que roda diretamente no navegador, ambientado em um porto de contêineres em uma noite chuvosa, no qual o jogador precisa desativar três estações de retransmissão de sinal e evacuar, enfrentando inimigos como drones de patrulha aérea e cães mecânicos terrestres.
Em termos de escala, o Saltline é um protótipo jogável para um único jogador e um único nível. “3A” aqui é um objetivo experimental e uma analogia visual, usada para descrever o estilo gráfico; seu porte está muito distante de um produto 3A comercial. O “几猫·国产3A大作” divulgado no país é a versão em chinês ou uma versão reembalada do Saltline, e o nome vem do processo de difusão, não representando a autoria do desenvolvimento.
1.2 Tempo, tokens e custo segundo o próprio desenvolvedor
Os dados a seguir vêm de publicações do próprio desenvolvedor no X e são estimativas autorrelatadas, sem auditoria de terceiros:
- Tempo de desenvolvimento: cerca de 8 horas
- Tokens de entrada: cerca de 445 milhões, com bastante uso de cache
- Tokens de saída: cerca de 2,7 milhões
- Custo estimado com base nos preços da API: cerca de 550 dólares
- Forma de desenvolvimento: um único comando, sem iterações com feedback humano
Esse valor é um custo único de geração. Depois que os arquivos do jogo são gerados, eles rodam localmente no navegador do jogador; durante o jogo, não há chamadas à API do Claude. Portanto, os 550 dólares também não podem ser rateados como “custo de IA por jogador”.
1.3 Detalhando essa conta com os preços unitários oficiais
De acordo com o preço padrão oficial do Claude Fable 5.2 (saída US$ 40 / milhão de tokens), 2,7 milhões de tokens de saída custam aproximadamente US$ 108. Os cerca de US$ 440 restantes correspondem ao lado da entrada, incluindo gravação em cache, leitura de cache e entrada normal. O desenvolvedor não divulgou as quantidades de cada um dos três, então não dá para detalhar mais.
Comparando os dois valores extremos, dá para ver o efeito do cache: se todos os 445 milhões de tokens de entrada fossem cobrados pelo preço normal de entrada, US$ 8, isso daria cerca de US$ 3.560; se todos fossem cobrados pelo preço de leitura de cache, US$ 0,20, daria cerca de US$ 89. A estimativa real fica entre os dois, e claramente mais perto do limite inferior. Isso mostra que, em tarefas longas de desenvolvimento com agentes, a taxa de acerto de cache no lado da entrada determina a ordem de grandeza da conta, enquanto o impacto do preço unitário de saída é relativamente secundário.
1.4 Por que um arquivo de 1,4 MB pode consumir 445 milhões de tokens
A versão HTML independente do Saltline tem cerca de 1,43 MB (1.425.707 bytes). Segundo o desenvolvedor, os modelos e as texturas do jogo são código: a geometria é construída por procedimentos, o aspecto da superfície é calculado por shaders e até o áudio é gerado por código. Não há imagens nem recursos de modelos 3D separados.
O produto final é pequeno, mas o processo é longo. Ao longo de 8 horas, o Agent leu repetidamente o arquivo de código em crescimento constante, executou ferramentas, conferiu resultados e voltou a editar, e a cada rodada precisou reenviar um grande volume de contexto ao modelo. O consumo final de tokens vem principalmente desse ciclo, não do tamanho do arquivo final. É por isso que, ao avaliar modelos para desenvolvimento de jogos, é preciso medir o “custo do processo”.
2 Comparação de preços de modelos para desenvolvimento de jogos: diferenças de cobrança por Token entre três APIs
2.1 Preços padrão oficiais dos três modelos
Os preços da tabela abaixo vêm das páginas oficiais de cada fornecedor, com data de referência de 16 de novembro de 2026, em dólares por milhão de Token, na faixa de cobrança de preço padrão da API, sem descontos de outros canais nem taxas adicionais por região.
| Modelo | Entrada normal | Saída | Leitura de cache | Observações |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | Escrita de cache de 5 minutos $10, escrita de cache de 1 hora $16; contexto 1M, saída máxima 128K |
| GPT-6 Astra | $10 | $50 | $1 | Faixa de processamento padrão; preços de outras opções de velocidade, processamento em lote e região podem variar |
| Gemini 4 Argon | $2 | $10 | $0.10 | Este preço vale até 30 de novembro de 2026; a partir de 1º de dezembro está previsto ajuste para entrada $4 e saída $20 |
O Claude Fable 5.2 também tem um Fast Mode, com entrada de $16 e saída de $80, e a fabricante afirma que a velocidade de saída pode chegar a até 2,5 vezes mais. Para tarefas longas que precisam ser concluídas dentro de um tempo fixo, a faixa de velocidade altera tanto o tempo gasto quanto o custo, então na avaliação ela deve ser registrada como uma configuração separada.
💡 Dica de comparação: as interfaces e os campos de cobrança dos três modelos são diferentes entre si, então ao montar seu próprio ambiente de avaliação é preciso integrar cada um separadamente. O APIYI apiyi.com oferece uma interface unificada compatível com OpenAI, em que uma única chave API permite chamar modelos como Claude, GPT, Gemini, o que facilita alternar entre modelos no mesmo script de avaliação; os modelos disponíveis e os preços devem ser conferidos na lista da plataforma.
2.2 Diferenças de preço de tabela com o mesmo volume de Token
Para perceber de forma intuitiva a diferença de preço unitário, dá para aplicar o volume de saída do Saltline (2,7 milhões de Token) aos preços dos três: Claude Fable 5.2 cerca de 108 dólares, GPT-6 Astra cerca de 135 dólares e Gemini 4 Argon cerca de 27 dólares. Se os 445 milhões de unidades de entrada acertarem totalmente a leitura de cache, os três ficam em cerca de 89, 445 e 45 dólares, respectivamente.
Esses números servem apenas para ilustrar a estrutura de cobrança, partindo do pressuposto de que os três modelos consomem exatamente o mesmo Token, mas na prática esse pressuposto quase nunca se sustenta. Modelos diferentes precisam de números diferentes de rodadas para concluir a mesma tarefa, leem contextos de tamanhos diferentes a cada rodada e geram códigos de comprimentos diferentes; além disso, reexecutar após falhas multiplica as despesas.
2.3 O preço de cache merece mais atenção do que o preço de entrada
No desenvolvimento no estilo Agent, a maior parte da entrada é contexto repetido. O preço de leitura de cache do GPT-6 Astra é 1/10 da entrada normal, o do Claude Fable 5.2 é 1/40 e o do Gemini 4 Argon é 1/20. Quanto menor a razão entre o preço de leitura de cache e o preço de entrada normal, mais fácil fica comprimir o custo de entrada de tarefas longas.
O cache também tem custo de escrita e validade. As escritas de cache de 5 minutos e de 1 hora do Claude têm preços diferentes, e se o intervalo entre duas chamadas do Agent ultrapassar a validade do cache, é preciso gravar novamente. Ao estimar o custo de tarefas longas, é necessário incluir no cálculo o número de escritas de cache, a taxa de acerto e a validade, todos juntos.
3 O que os benchmarks de programação podem revelar: uma referência de capacidade para modelos de desenvolvimento de jogos
3.1 SWE-bench Verified: tarefas de engenharia de software em repositórios reais
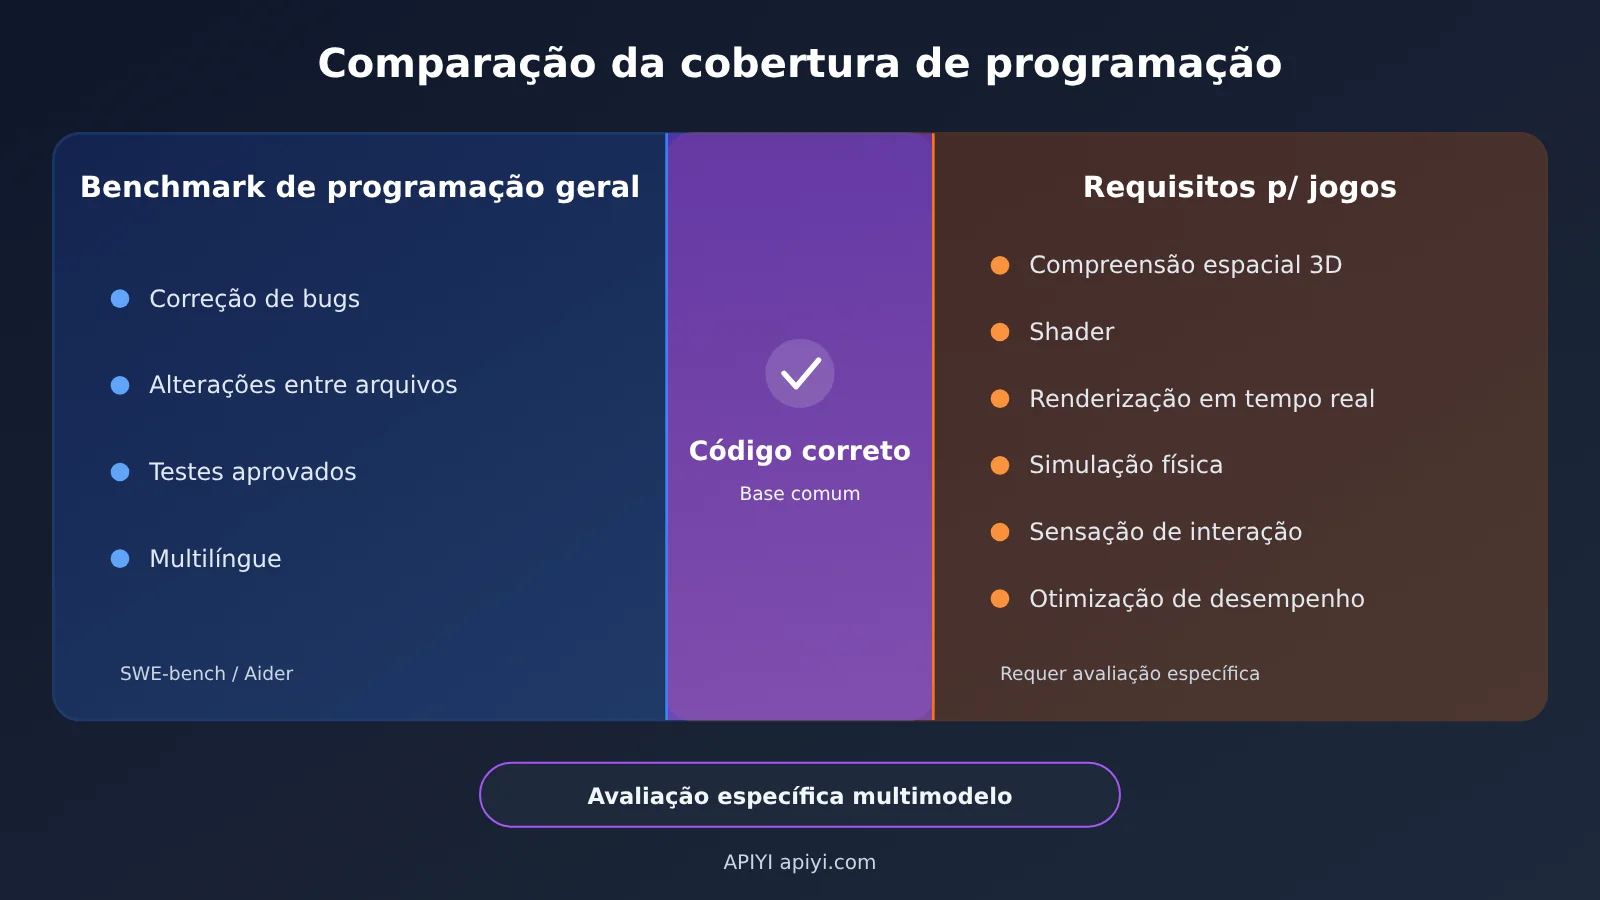
O SWE-bench Verified reúne 500 problemas selecionados e validados manualmente, extraídos de projetos open source reais. O modelo precisa entender o contexto do repositório e dar conta de tarefas como corrigir bugs, alterar código existente, resolver testes que falham e fazer mudanças que atravessam vários arquivos — algo bem mais próximo da engenharia de verdade do que o simples autocompletar de código.
Ao usar esse benchmark, vale ficar de olho no efeito do Harness. A documentação oficial deixa claro que o ranking completo mistura diferentes sistemas de Agent, e que, para comparar modelos puramente entre si, o certo é usar a configuração unificada do mini-SWE-agent. Configuração do Agent, ferramentas, comando e versão mudam a pontuação, então resultados obtidos com configurações diferentes devem ser analisados separadamente.
3.2 Aider Polyglot: registrando precisão e custo ao mesmo tempo
O Aider Polyglot usa 225 exercícios de programação, cobrindo C++, Go, Java, JavaScript, Python e Rust, e utiliza casos de teste para julgar se as modificações de código feitas pelo modelo estão corretas. Seus resultados públicos, além da precisão, também registram o consumo de tokens, o custo de execução, as saídas de erro, os erros de formato e o tempo de execução de cada tarefa.
Para a escolha do modelo, essa forma de registrar “precisão + custo” é muito valiosa e está alinhada com a abordagem do framework de avaliação que veremos mais adiante neste artigo. Os problemas em si são exercícios independentes, e a escala e o formato têm uma diferença evidente em relação a um projeto completo de jogo 3D.
3.3 Avaliações históricas do NIST: atenção à versão do modelo e ao momento
No relatório de avaliação de modelos publicado em 2025 pelo CAISI, órgão subordinado ao Instituto Nacional de Padrões e Tecnologia dos Estados Unidos (NIST), foram testadas as pontuações no SWE-bench Verified de um conjunto de modelos. Todos os dados abaixo são de modelos históricos e configurações experimentais desse relatório, e não representam o ranking dos modelos mais recentes de novembro de 2026.
| Modelo (versão testada no relatório de 2025) | Pontuação no SWE-bench Verified |
|---|---|
| Anthropic Opus 4 | 66.7% |
| GPT-5 | 63.0% |
| DeepSeek V3.1 | 54.8% |
| DeepSeek R1-0528 | 44.6% |
| gpt-oss | 42.6% |
| DeepSeek R1 | 25.4% |
O relatório também apresenta o erro padrão, mostrando que as pontuações de um mesmo benchmark têm flutuações estatísticas próprias. Diferenças de alguns pontos percentuais podem não ter distinção real dentro da margem de erro. O Claude Fable 5.2, o GPT-6 Astra e o Gemini 4 Argon comparados neste artigo não aparecem nesse relatório; na hora de escolher, é preciso buscar avaliações mais recentes voltadas para a versão atual, com a configuração declarada, ou testar por conta própria.
3.4 A lacuna entre capacidade geral de programação e capacidade de desenvolvimento de jogos
O desenvolvimento de jogos envolve muitas tarefas que os benchmarks de engenharia de software geral não cobrem adequadamente: compreensão espacial 3D, escrita de Shader, renderização em tempo real, sistemas de animação, simulação física, sensação de interação e otimização de desempenho em execução. Projetos como Saltline também exigem que o modelo gere ativos visuais por meio de código, o que depende de domínio de gráficos e efeitos visuais.
Um modelo pode ser muito bom em corrigir bugs em repositórios Python, mas ter desempenho apenas mediano em cenários WebGL complexos. SWE-bench e Aider são adequados para eliminar candidatos com capacidade de código claramente insuficiente; a ordenação final precisa ser decidida por avaliações específicas de desenvolvimento de jogos.
4 Como comparar modelos de IA para desenvolvimento de jogos: um plano de avaliação específica para a mesma tarefa
4.1 Projetar uma tarefa unificada de jogo 3D no navegador
Inspirando-nos no formato do Saltline, podemos definir a tarefa assim: gerar, a partir de um comando, um protótipo de jogo 3D executável no navegador. Todos os modelos candidatos usam exatamente os mesmos requisitos:
- Gerar um projeto completo que possa ser aberto e executado diretamente no navegador
- Incluir um personagem jogável e um ambiente 3D
- Incluir colisão ou física básica
- Incluir objetivos de missão claros e condições de vitória e derrota
- Não permitir modificação manual do código principal durante a avaliação
A dificuldade da tarefa deve ficar próxima das suas necessidades reais. Equipes que fazem jogos casuais simples tendem a superestimar o nível de modelo necessário ao testar com um protótipo de FPS; equipes que trabalham com projetos 3D complexos tendem a subestimar esse nível ao testar com tarefas 2D simples.
4.2 Dez indicadores de avaliação
| Dimensão | Conteúdo da avaliação | Forma sugerida de registro |
|---|---|---|
| Completude funcional | Se as funções centrais do jogo foram implementadas | Marcar item por item conforme a lista de funções |
| Qualidade visual | Cenário, materiais, iluminação, animação | Pontuação por avaliação cega com várias pessoas |
| Executabilidade | Se inicia corretamente | Sim / Não |
| Completude da interação | Se entrada e feedback funcionam corretamente | Testar item por item conforme a lista de operações |
| Estabilidade | Se há travamentos evidentes | Registrar o número de travamentos em uma sessão de duração fixa |
| Desempenho | FPS, tempo de inicialização, memória | Medição real em dispositivo fixo |
| Qualidade do código | Legibilidade, modularização, tratamento de erros | Pontuação por revisão de código |
| Custo de tokens | Entrada, saída, cache | Acumular a partir do campo usage da API |
| Tempo total | Do início até a versão executável | Cronometrar |
| Correção manual | Intervenção humana necessária para atingir o padrão | Registrar horas de trabalho manual |
Entre eles, “executabilidade”, “completude funcional” e “completude da interação” devem ser critérios de aceitação obrigatórios, usados para determinar se uma execução foi bem-sucedida; qualidade visual, desempenho e qualidade do código servem para ordenar os resultados bem-sucedidos.
4.3 Controlar o ambiente de teste
Só dá para comparar resultados de avaliação se as variáveis estiverem sob controle. As condições que precisam ser padronizadas incluem: mesmo navegador, mesmo dispositivo, mesmo comando, mesmo fluxo de teste, mesmo orçamento de tempo e se o acesso à internet é permitido. Se for permitido que o modelo chame ferramentas por conta própria, pesquise informações ou crie arquivos, as permissões de ferramentas de todos os modelos também precisam ser iguais.
O Harness também precisa ser fixado. Trocar o mesmo modelo para outro framework de Agent pode mudar bastante a taxa de sucesso e o consumo de tokens. Por isso, o relatório de avaliação deve especificar o framework usado, a versão e os parâmetros, como temperatura, comprimento máximo de saída e nível de velocidade.
4.4 Executar cada modelo várias vezes, no mínimo
A geração de um Modelo de Linguagem Grande tem aleatoriedade: um sucesso pode ser sorte, e uma falha também pode ser ocasional. Cada modelo deve ser executado várias vezes nas mesmas condições (por exemplo, de 5 a 10 vezes), calculando a taxa de sucesso e, para as amostras bem-sucedidas, a média de tokens, tempo e pontuação de qualidade. O próprio Saltline também é um experimento único: ele prova que isso é possível, mas não fornece a taxa de sucesso desse modelo em tarefas semelhantes.
O script abaixo chama o modelo por uma interface compatível com OpenAI e, com base no campo usage e nos preços da seção 2, calcula o custo de cada invocação:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI; para trocar de modelo, basta alterar model
)

# Unidade: dólares / milhão de tokens; preço oficial padrão em 2026-11-16
PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

def call_and_price(model: str, messages: list) -> tuple[str, float]:
    resp = client.chat.completions.create(model=model, messages=messages)
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + u.completion_tokens * p["output"]) / 1_000_000
    return resp.choices[0].message.content, cost
Os nomes dos modelos devem seguir a lista de modelos da plataforma de invocação real. Os custos de gravação em cache e as taxas extras por nível de velocidade precisam ser adicionados ao cálculo separadamente, conforme as regras de cada fornecedor.
Ver script de avaliação multiturno e resumo de custos
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Chamar vários modelos candidatos via APIYI
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """Loop de Agent simplificado: gerar → verificar → devolver resultado → corrigir"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # implemente você mesmo: gravar o arquivo, subir o navegador headless, rodar o checklist de funcionalidades
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 Início rápido: ao montar esse tipo de avaliação, a recomendação é primeiro fazer o script rodar de ponta a ponta com uma tarefa pequena e só depois trocar pela tarefa completa do jogo. O APIYI apiyi.com oferece créditos de teste gratuitos para novos usuários: use-os para validar o Harness e a lógica de contabilização de custos antes de comprometer o orçamento de avaliação de verdade.
5 Como escolher modelos no desenvolvimento de jogos com IA: controlar o custo de tokens em tarefas complexas
5.1 A taxa de sucesso determina o custo total
O custo completo de desenvolvimento é formado por três partes:
Custo total da tarefa = custo de invocação do modelo + custo de execução das ferramentas + custo de correção manual
Ao considerar a taxa de sucesso, uma métrica mais útil para comparação é o “custo por versão aprovada”: o gasto total com todas as tentativas dividido pelo número de sucessos. Suponha que o modelo A custe 100 dólares por tentativa e tenha 80% de sucesso; o custo por versão aprovada fica em cerca de 125 dólares. Já o modelo B custa 30 dólares por tentativa e tem 20% de sucesso; o custo por versão aprovada fica em cerca de 150 dólares, sem contar o tempo gasto investigando as versões que falharam. Neste exemplo, o modelo com preço unitário mais baixo acaba saindo mais caro.
A correção manual costuma ser o maior item. Se um engenheiro passa algumas horas consertando o resultado gerado, o custo de mão de obra pode superar toda a despesa de API daquela execução. Por isso, ao avaliar, registre com transparência o tempo de intervenção humana e converta esse tempo em custo usando o valor real da hora da sua equipe, incluindo-o no custo total.
5.2 Três estratégias de seleção de modelo
| Estratégia | Cenário de aplicação | Vantagem | Custo a observar |
|---|---|---|---|
| Modelo de alta capacidade | Arquitetura complexa, desenvolvimento com contexto longo, colaboração entre múltiplos módulos, localização de bugs complexos | Alta taxa de sucesso, reduz reexecuções e correções manuais | Preço unitário alto; depende de cache para controlar o custo de entrada |
| Modelo de baixo custo | Funcionalidades simples, explicação de código, modificações repetitivas, auxílio em testes | Preço unitário baixo, adequado para chamadas de alta frequência | Tarefas complexas podem falhar em várias rodadas, fazendo o custo total subir |
| Colaboração entre múltiplos modelos | Um modelo cuida da arquitetura, outro da implementação, e um modelo independente faz a revisão de código | Combina capacidade e preço de acordo com cada etapa | A transferência entre modelos retransmite o contexto, aumentando Tokens e custos de coordenação |
O efeito de economia da colaboração entre múltiplos modelos depende do custo de transferência. A cada transferência, o contexto do projeto precisa ser enviado novamente a outro modelo, e o cache não pode ser compartilhado entre modelos diferentes. Só quando o modelo de baixo custo assume etapas suficientes e o número de transferências é suficientemente pequeno é que o esquema de colaboração compensa — e isso também exige confirmação por teste real.
💰 Dica de custo: A colaboração entre múltiplos modelos exige chamar vários fornecedores de modelo ao mesmo tempo dentro de um único projeto. Usando APIYI apiyi.com para acessar com a mesma Key e o mesmo conjunto de código, você reduz o trabalho de gerenciamento de múltiplas contas e de adaptação de interfaces, facilitando distribuir arquitetura, implementação e revisão entre modelos diferentes e depois contabilizar os custos de forma unificada.
5.3 Fluxo executável de seleção em cinco etapas
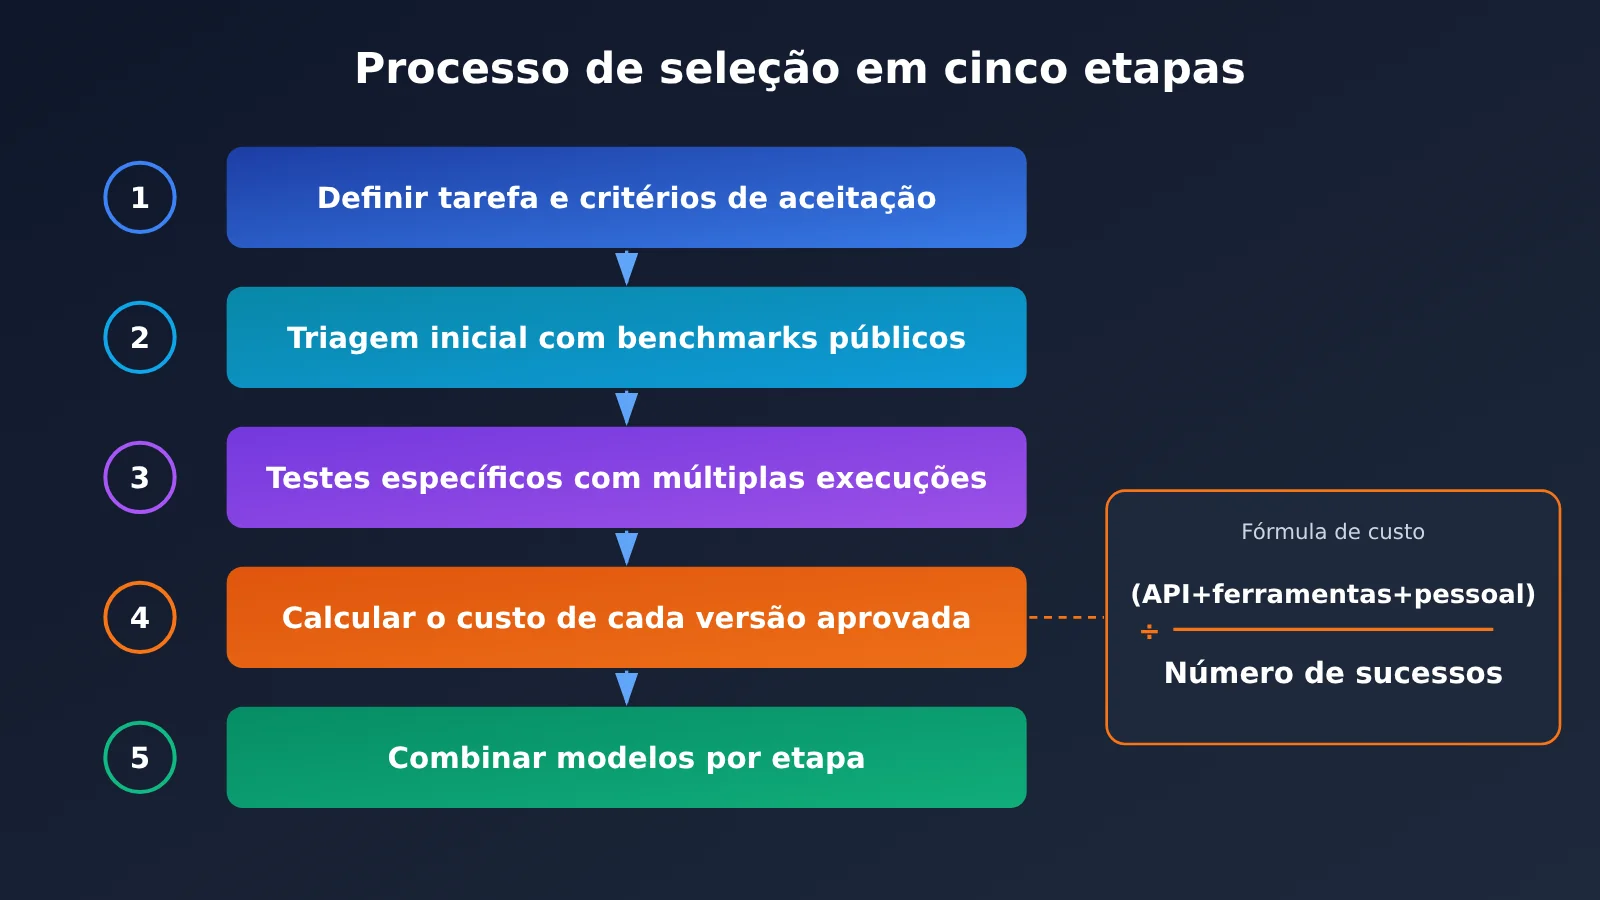
- Definir tarefa e critérios de aceitação: especifique a lista de funcionalidades, as plataformas-alvo e o piso de desempenho, que servirão de base para determinar o sucesso.
- Fazer uma triagem inicial com benchmarks públicos: consulte os resultados atualizados e com configuração bem definida do SWE-bench Verified e do Aider Polyglot, descartando os modelos com capacidade de código claramente insuficiente.
- Rodar avaliações específicas: em um ambiente unificado, execute a mesma tarefa de jogo de 5 a 10 vezes com cada modelo candidato, registrando os dez indicadores da seção 4.2.
- Calcular o custo de cada versão aprovada: custo de API + custo de ferramentas + custo de correção manual, dividido pelo número de execuções bem-sucedidas.
- Combinar modelos por etapa: entregue as etapas complexas aos modelos com alta taxa de sucesso e as etapas repetitivas aos modelos de baixo custo; depois, teste na prática se a solução combinada realmente economiza mais.
Os preços mudam — o Gemini 4 Argon, por exemplo, já anunciou um plano de reajuste válido a partir de 1º de dezembro. Os resultados da avaliação devem manter os dados brutos de tokens; quando os preços mudarem, basta substituir os valores unitários para atualizar as conclusões.
6 Perguntas frequentes (FAQ) sobre a escolha de modelos de IA para desenvolvimento de jogos
P1: Os US$ 550 do Saltline correspondem a uma conta real?
Não é uma conta auditada. Os US$ 550 são uma estimativa de custo feita pelo desenvolvedor Felix Rieseberg com base nos preços da API. Os dados que acompanham essa estimativa (cerca de 8 horas, cerca de 445 milhões de tokens de entrada e cerca de 2,7 milhões de tokens de saída) também são declarações do próprio desenvolvedor. Grande parte da entrada usou cache, mas a proporção exata de gravação e leitura de cache não foi divulgada.
P2: O modelo com menor preço unitário é o mais econômico?
Depende da taxa de sucesso. O preço unitário determina apenas o preço por token; quantos tokens o modelo precisa para concluir a tarefa, quantas vezes ele precisa ser executado novamente e quanto trabalho humano de correção será necessário dependem da capacidade do modelo. Só faz sentido comparar usando “custo total ÷ número de sucessos”.
P3: O modelo em primeiro lugar no SWE-bench é o mais adequado para jogos?
O SWE-bench Verified mede a capacidade de engenharia de software em repositórios de código aberto reais, com cobertura limitada para shaders, compreensão espacial 3D, renderização em tempo real e sensação de interação. Ele serve para uma triagem inicial, mas a classificação final para desenvolvimento de jogos exige avaliações específicas.
P4: As pontuações no relatório do NIST representam os modelos atuais?
Não. O relatório do NIST CAISI foi publicado em 2025 e testou modelos históricos como GPT-5, Opus 4 e DeepSeek V3.1, além de configurações experimentais específicas. Os novos modelos de novembro de 2026 precisam de novas avaliações específicas para suas versões.
P5: Como montar rapidamente uma avaliação comparativa de vários modelos?
Usar uma plataforma agregadora com interface compatível com OpenAI é o mais prático. Depois de se registrar no APIYI (apiyi.com) e obter uma chave API, defina o `base_url` do script deste artigo como `https://api.apiyi.com/v1` e altere o parâmetro `model` para testar vários modelos com o mesmo script. Novos usuários podem primeiro validar o script com a cota gratuita.
P6: Como contar os custos de tokens da forma mais precisa durante a avaliação?
Use o campo usage na resposta da API como referência, acumulando a cada chamada os tokens normais de entrada, de leitura de cache e de saída, e depois calcule com os preços oficiais e as faixas de cobrança do dia da chamada. Taxas adicionais, como gravação de cache e faixas de velocidade, precisam ser somadas separadamente conforme as regras de cada fornecedor. Ao chamar via APIYI (apiyi.com), também é possível conferir os resultados com os registros de consumo no painel da plataforma.
P7: Os protótipos de jogos gerados por IA podem ir direto para produção?
Protótipos como o Saltline provam que o modelo pode produzir uma versão jogável sem feedback humano, mas a publicação comercial ainda envolve compatibilidade com vários navegadores, adaptação para mobile, otimização de desempenho e manutenção de longo prazo. Jogos de navegador são limitados pelo hardware local e pelo navegador; a própria página do Saltline também avisa sobre inicialização mais lenta e necessidade de mudar para qualidade gráfica mais baixa em caso de travamento. Os custos de teste e otimização antes do lançamento devem ser incluídos no custo total de desenvolvimento.
7 Principais conclusões sobre a escolha de modelos para desenvolvimento de jogos com IA
- Métrica central: compare o custo ponta a ponta de cada versão aprovada, não o preço por milhão de tokens.
- A fatura da Saltline: cerca de US$ 550 é uma estimativa declarada pelo próprio desenvolvedor; a saída representa aproximadamente US$ 108, e o restante fica do lado da entrada.
- O cache define a ordem de grandeza: em tarefas longas, a entrada domina, e o preço de leitura do cache e a taxa de acerto são os fatores que mais pesam.
- Preço tem prazo de validade: os preços deste artigo são de 16/11/2026, e o Gemini 4 Argon tem reajuste previsto a partir de 1º de dezembro.
- Benchmarks servem para triagem inicial: SWE-bench e Aider medem programação genérica; a capacidade em jogos exige avaliação específica.
- Várias execuções: rode cada modelo de 5 a 10 vezes nas mesmas condições e conclua pela taxa de sucesso, não por um resultado isolado.
- Como começar: use a interface unificada do APIYI apiyi.com para alternar entre modelos e comparar custos com o mesmo script.
8 Conclusão: como escolher modelos para deixar a IA desenvolver um jogo sozinha
Para que a IA desenvolva um jogo sozinha, a escolha do modelo se resume a três pontos:
- Faça as contas completas: o custo total da tarefa inclui invocação do modelo, execução de ferramentas e correção manual — a conta da API é apenas um dos itens.
- Meça a capacidade na prática: benchmarks públicos servem para a triagem inicial, mas a ordenação final para desenvolvimento de jogos vem de várias avaliações específicas sob condições padronizadas.
- Combine por etapa: use modelos com alta taxa de sucesso nas etapas complexas e modelos de baixo custo nas etapas repetitivas; a solução combinada também precisa ser validada na prática.
A Saltline dá uma ordem de grandeza de referência: um único comando, cerca de 8 horas e um custo estimado de aproximadamente US$ 550 para produzir um protótipo 3D de navegador jogável. Quanto o seu projeto vai custar depende da complexidade da tarefa e da taxa de sucesso dos modelos escolhidos — o método mais confiável é rodar sua própria avaliação com o framework deste artigo.
Recomendamos montar rapidamente um ambiente de comparação multi-modelo com o APIYI apiyi.com: a plataforma oferece interface compatível com OpenAI e crédito gratuito para novos usuários, o que facilita medir preço e taxa de sucesso no mesmo conjunto de scripts.
Referências
- Página de experiência independente do Saltline: demonstração do jogo e explicações de perguntas frequentes
- Link:
saltline.games -
Descrição: inclui informações de experiência como inicialização, alternância de qualidade gráfica e modos de operação
-
Espelho de código e README do Saltline: explicação sobre a atribuição de dados do desenvolvedor
- Link:
github.com/realcodebear/saltline-fable-5.2 -
Descrição: registra a origem do tempo de geração, Token e custo estimado
-
Repositório da versão chinesa Jima o: arquivo da versão com empacotamento em chinês do Saltline
- Link:
github.com/Megasu/jimao-3a-game -
Descrição: fornece dados como o tamanho do arquivo index.html
-
Especificações e preços do modelo Claude Fable 5.2: documentação oficial da Anthropic
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Descrição: preços de entrada, saída, cache e Fast Mode
-
Documentação do modelo GPT-6 Astra: preço oficial da OpenAI
- Link:
developers.openai.com/api/docs/models/gpt-6-astra -
Descrição: os preços do nível de processamento padrão se baseiam neste documento
-
SWE-bench Verified: página oficial do benchmark de engenharia de software
- Link:
swebench.com/verified.html -
Descrição: 500 tarefas verificadas manualmente e explicação da configuração unificada do mini-SWE-agent
-
Aider Leaderboards: resultados da avaliação Aider Polyglot
- Link:
aider.chat/docs/leaderboards -
Descrição: registra simultaneamente a taxa de acerto, o consumo de Token e o custo de execução
-
Relatório de avaliação NIST CAISI (2025): avaliação independente de modelos históricos
- Link:
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - Descrição: inclui pontuações históricas do SWE-bench Verified e o erro padrão
Autor: Equipe técnica da APIYI
Contato técnico: fique à vontade para nos contatar pela página inicial do site APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com